

著者: 伊藤 雅博, 株式会社日立製作所
はじめに
DebeziumはChange Data Capture(CDC)を実現するオープンソース(OSS)のプラットフォームです。主要なデータベース(DB)に対応しており、DB間のリアルタイムなデータ連携をはじめ、幅広い用途で利用されています。
DebeziumはApache Kafkaと組み合わせて利用する「Kafka Connect」方式に加え、Kafkaを必要としない「Debezium Server」「Debezium Engine」という実行方式も提供されています。
本稿では、CDCとDebeziumの基本をおさらいしたうえで、3種類の実行方式の特徴と違いを整理します。その後、Kafka Connect方式を中心に、アーキテクチャと設定・チューニングのポイントを解説します。最後に参考として、アーキテクチャの章で解説したDebeziumの内部動作を、最小構成の実機で確認します。
本稿は2026年9月29日にリリースされたDebezium 3.7の情報をベースに記載しています。詳細は以下の公式ドキュメントをご参照ください。
CDCの概要
CDCとは
CDC(Change Data Capture、変更データキャプチャ)とは、DBのテーブルにおける行(レコード)単位の変更、すなわち追加(INSERT)、更新(UPDATE)、削除(DELETE)をイベントとしてほぼリアルタイムに検知・取得して、別のシステムに配信する仕組みです。

既存システムのDBや業務アプリケーションに手を加えずに、最新データをほぼリアルタイムに他のシステムで利用可能となります。
従来のデータ連携方法との違いを以下に示します。
| データ連携方法 | 特徴 |
|---|---|
| 夜間バッチで一括コピー | データが最大1日古く、コピー処理中はDBに大きな負荷がかかる |
| アプリケーションを改修して両方のDBに書き込む | 既存システムの改修が必要で、片方の書き込み漏れによるデータ不整合のリスクがある |
| CDC | 変更を自動で検知して即座に配信し、既存システムやアプリケーションの改修が不要 |
CDCのユースケース
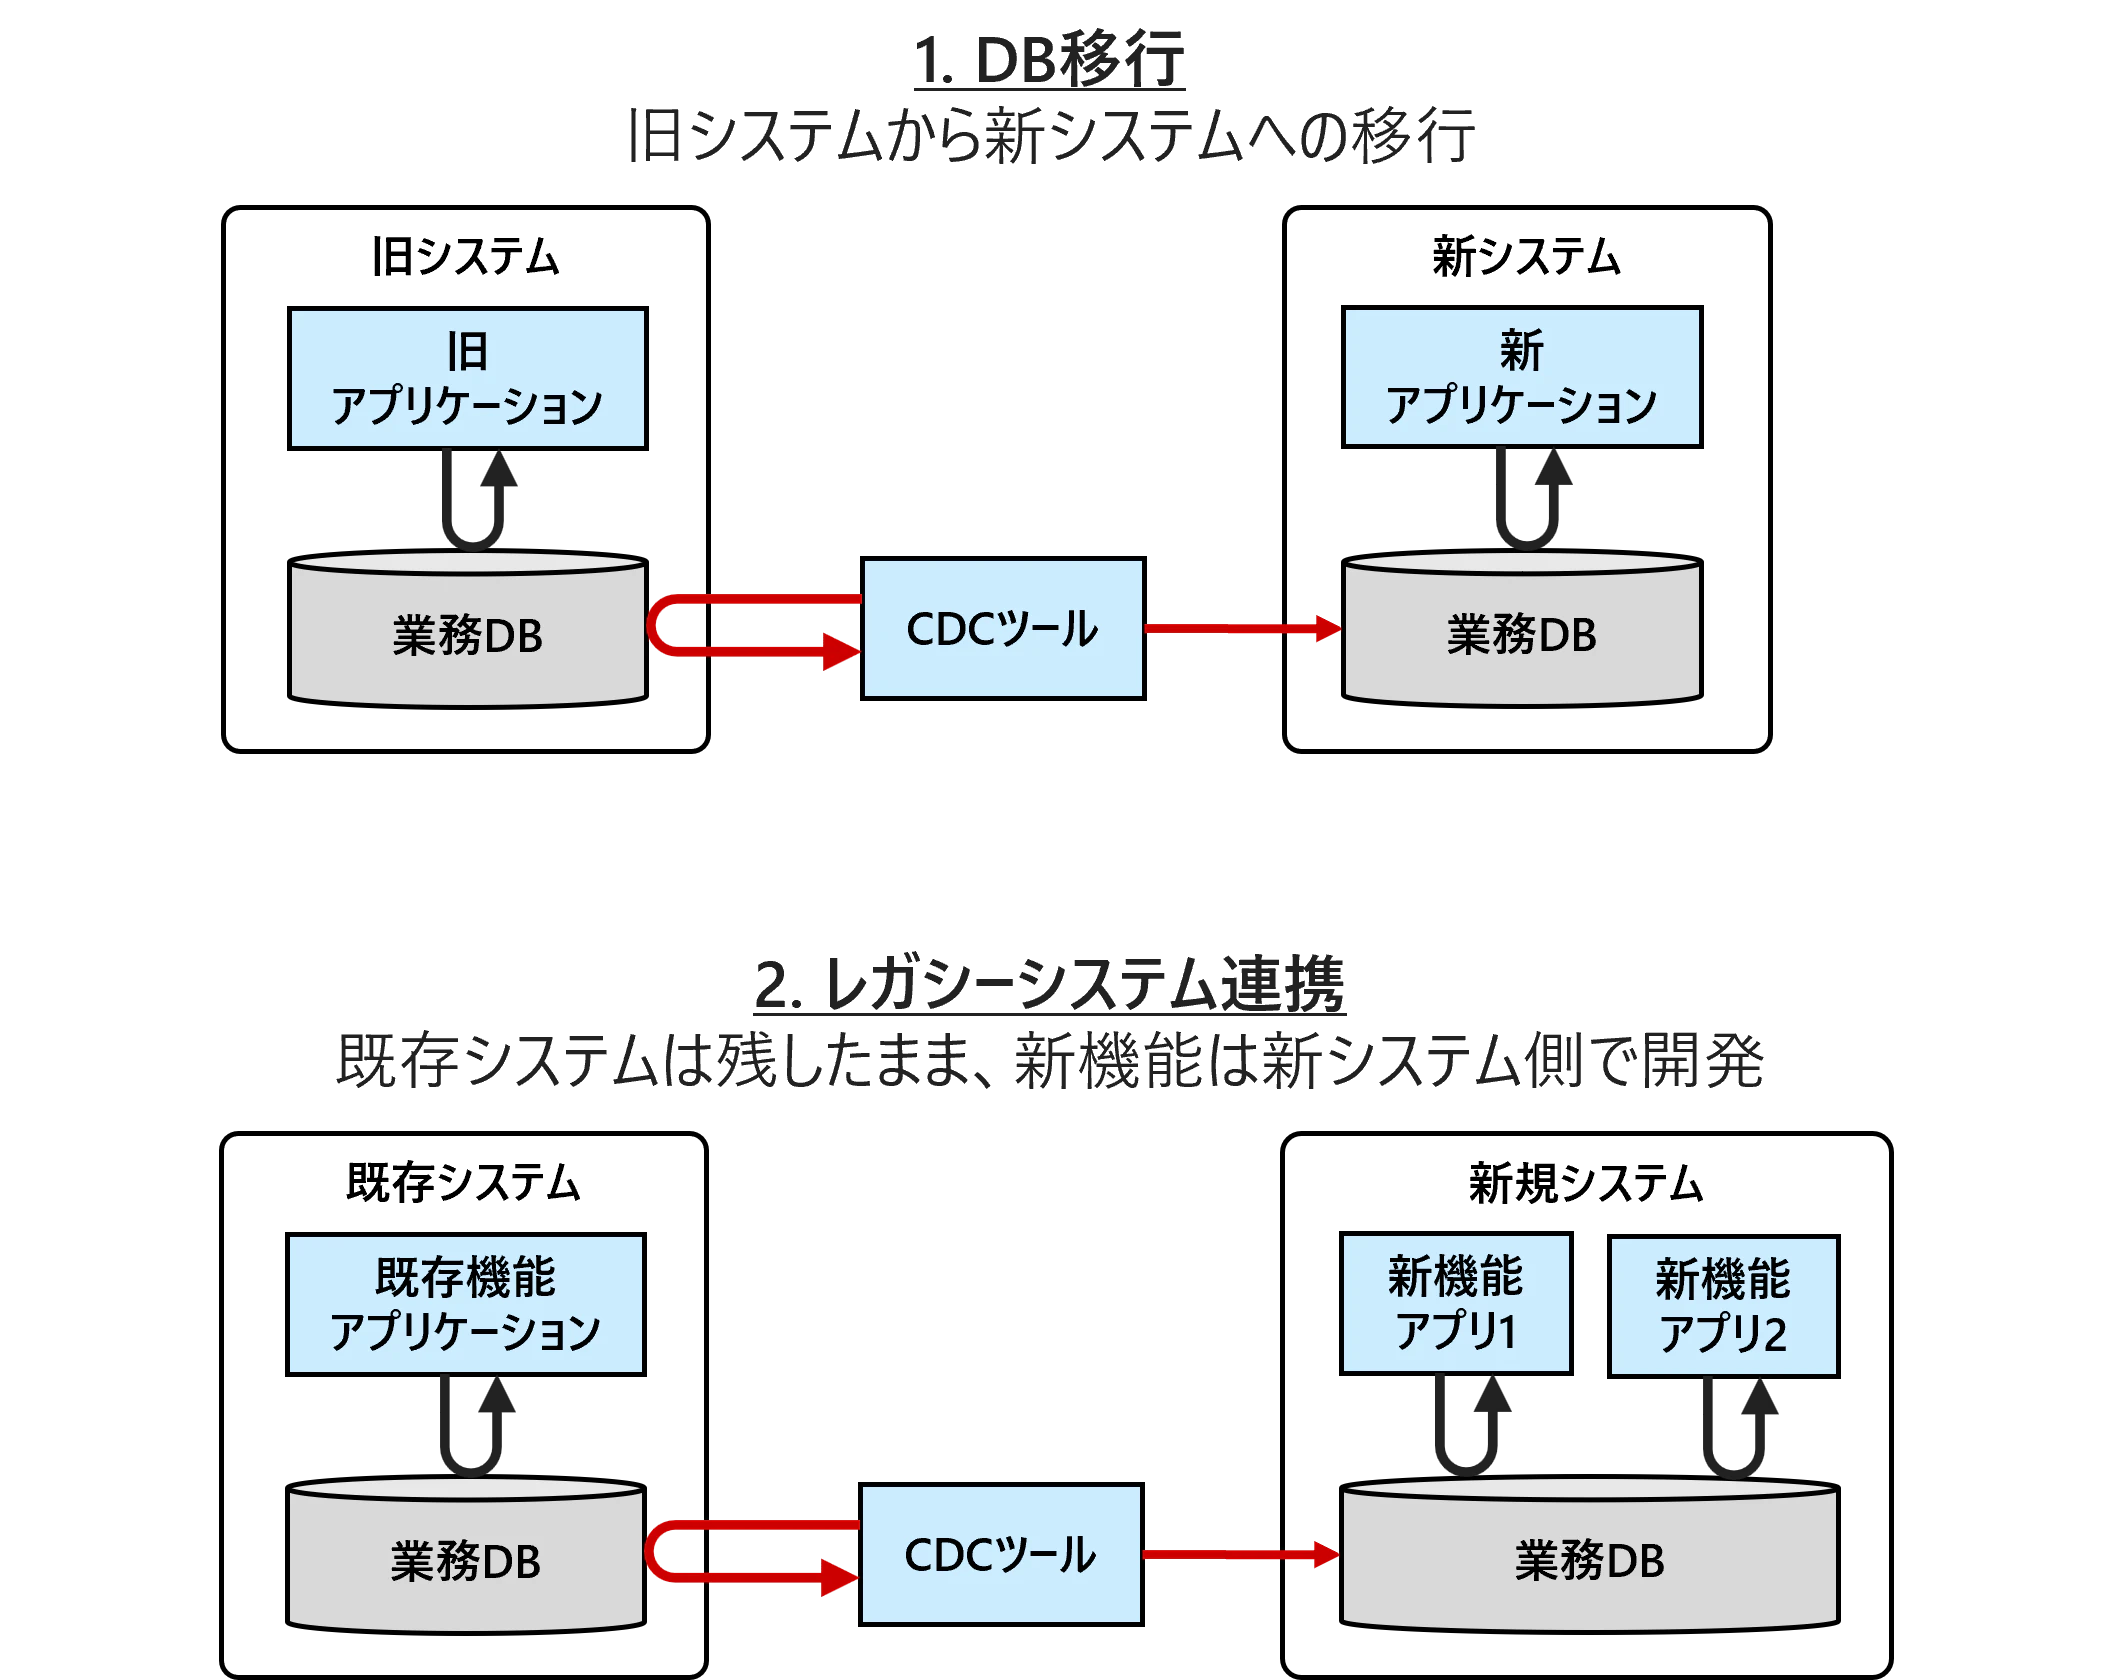
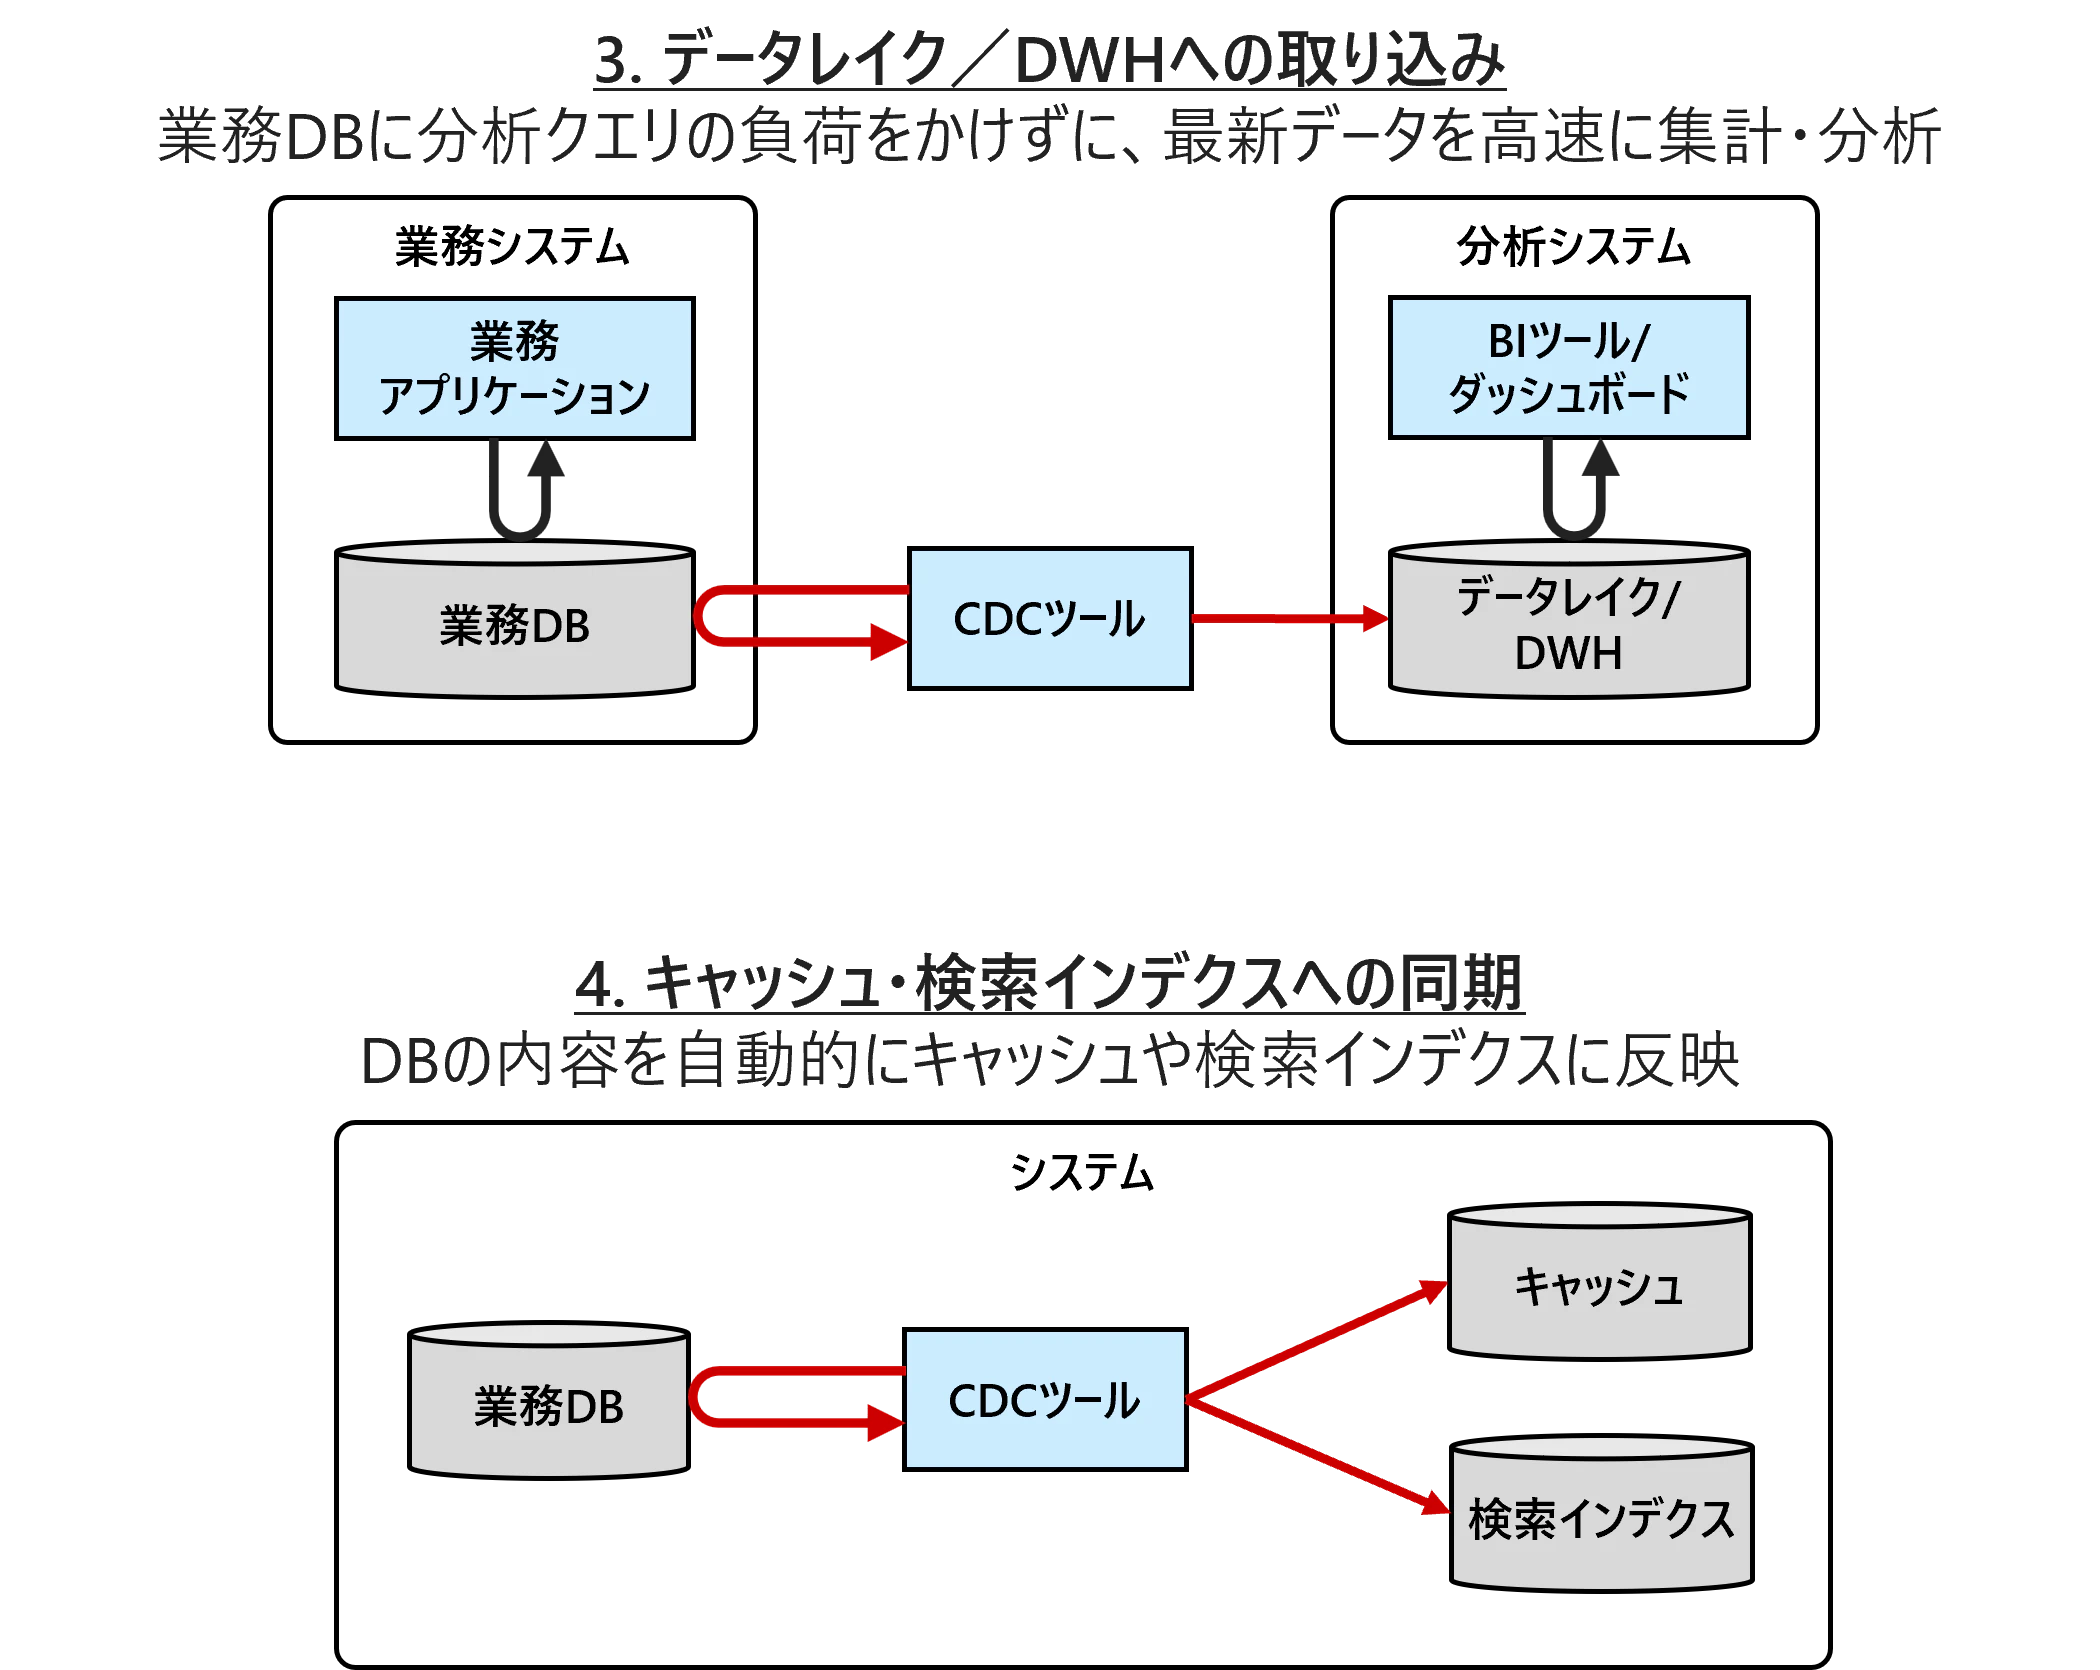
CDCの主なユースケースを以下に示します。
| # | ユースケース | 概要と利点 |
|---|---|---|
| 1 | DB移行 | 旧DBの変更差分を新DBへ継続的に同期する。旧システムを稼働させたまま移行でき、切り替え時の停止時間を短縮できる |
| 2 | レガシーシステム連携 | 既存システムのDBの変更を新システムのDBへ同期する。メインフレームなど改修が難しい基幹システムに手を入れずに、新機能を新システム側で開発できる |
| 3 | データレイク/DWHへの取り込み | 業務用DBの変更を分析基盤へ継続的に反映する。業務DBに分析クエリの負荷をかけずに、最新に近いデータで大量データを集計・分析できる |
| 4 | キャッシュ・検索インデクスへの同期 | DBの変更をRedisなどのキャッシュや、Elasticsearchなどの検索エンジンへ反映する。アプリケーションで二重書き込みを実装せずに、DBと内容を一致させられる |
| 5 | ベクトルDBへの同期 | DBの変更をMilvusなどのベクトルDBへ反映する。RAGでAIが参照するデータを、元のDBと同じ最新の状態に保つことで、AIは常に最新のデータを反映した回答ができる |
| 6 | マイクロサービス間の連携 | Transactional OutboxパターンによるDB経由のサービス間通信で、Outboxテーブルに書き込んだイベントをCDCで読み取り、メッセージブローカ経由で宛先サービスに転送する。DBの業務テーブル更新とイベント発行を同じトランザクションで実施することで、整合性を保ちながらサービス間を疎結合にできる |

Debeziumの概要
Debeziumとは
Debeziumは、主要なデータベースに対応するオープンソースのCDCプラットフォームであり、Apache License 2.0で公開されています。
CDCのプラットフォームとしては、クラウド環境ではAWS DMSやGoogle Cloud Datastreamなどのマネージド型CDCサービスも存在します。一方、オンプレミス環境やOSSで構成するシステムでは、複数のデータベースを横断的にサポートするプロジェクトは限られており、Debeziumがデファクトスタンダードといえる立ち位置にあります。
また、DebeziumはRed Hat主導で開発が進められており、Red Hat社はその商用サポート付きディストリビューションとしてRed Hat build of Debeziumを提供しています。
Debeziumの特徴:ログベースCDC
Debeziumはテーブルの変更を検知するために、SQLでテーブルをポーリングして差分を探すのではなく、DBの変更ログ(トランザクションログ、変更ストリーム、CDCテーブルなど)を読み取ります。この方式をログベースCDCと呼び、以下のようなメリットがあります。
- 変更が発生した差分のみを確実に、少ない負荷で、素早く取得できる
- レコードの追加(INSERT)と更新(UPDATE)だけでなく、削除(DELETE)も検知できる
- テーブルにレコードの更新を識別するための列(最終更新時刻など)の追加が不要
- DBの機能や設定によっては、変更前のレコード、トランザクションID、実行されたクエリも取得できる

Debeziumの機能
Debeziumには、変更データ取得の制御や運用に役立つ以下の機能があります。
| # | 機能 | 概要 |
|---|---|---|
| 1 | スナップショット | 初回起動時などに、テーブルの既存レコードをSQLで一括取得。実行中に取得できるインクリメンタルスナップショットにも対応 |
| 2 | ストリーミング | スナップショット以降の変更差分を、DBの変更ログから継続的に取得(ログベースCDC) |
| 3 | フィルタリング | 取得対象のデータベース(スキーマ)・テーブル・列を指定 |
| 4 | マスキング | 機密データなど、特定の列の値をマスク |
| 5 | メッセージ変換 | 変更イベントのルーティング、フィルタリング、フラット化など、メッセージ単位の変換(SMT:Single Message Transformation)が可能 |
| 6 | スキーマ変更検知 | テーブルに対する列の追加・削除・変更などのスキーマ変更を検知 |
| 7 | 監視メトリクス公開 | スナップショットやストリーミングの状況を示すJMXメトリクスを提供 |

Debeziumの対応データベース
Debeziumは、データベースから変更イベントをキャプチャするためのソースコネクタ群を提供しています。Debezium 3.7が対応するDBのソースコネクタを以下に示します。
正式版
| データベース | 対応バージョン | 変更の取得方法 |
|---|---|---|
| MySQL | 8.0.x、8.4.x、9.7 | バイナリログ(binlog) |
| MariaDB | 11.4.x、11.8.x、12.3 | バイナリログ(binlog) |
| PostgreSQL | 14〜18 | 論理デコーディング(pgoutput/decoderbufs) |
| Oracle | 19c、21c、23ai、26ai | LogMiner/XStream/OpenLogReplicator |
| SQL Server | 2017、2019、2022 | CDCテーブル |
| Db2 | 11.5 | CDCテーブル |
| MongoDB | 6.0、7.0、8.0 | Change Streams |
| Cassandra | 4.1.x、5.0.x | コミットログ |
| CockroachDB | 25.4.x | Changefeed |
Incubating
Incubating(インキュベーション中)のコネクタは評価・検証を目的としたものです。メッセージ形式や設定項目が後方互換性なく変更される可能性があるため、本番環境での利用は推奨されていません。
| データベース | 対応バージョン | 変更の取得方法 |
|---|---|---|
| Db2 for IBM i | 7.4 | ジャーナル |
| Informix | 12、14、15 | Change Data Capture API(論理ログ) |
| Ingres | 12.1 | Change Data Capture API(ジャーナル) |
| Spanner | 6.x | Change Streams |
| Vitess | 12.0.x | VStream |
| YashanDB | 23.4 | YStream |
| Milvus | 2.5以降 | 内部MQ+etcd |
| SQLite | 3.x | トリガ+CDCログテーブル |
| TiDB | 8.0以降 | TiCDC |
参考:
Debezium導入の前提条件
-
DBがDebeziumサポート対象であること
- DBとそのバージョンが、Debeziumのサポート対象であること
-
DebeziumがDBの変更を取得可能であること(DB側の設定)
- DB側で、Debeziumが変更ログを読み取るための設定が有効であること
- 例えばMySQLの場合、バイナリログ(binlog)を有効にし、
binlog_format=ROW、binlog_row_image=FULLに設定する - 詳細は各コネクタのドキュメントを参照: Debezium Source Connectors
- 例えばMySQLの場合、バイナリログ(binlog)を有効にし、
- DebeziumのDB接続用に、変更ログの読み取りとスナップショット(SELECT)に必要な権限を持つ専用ユーザがあること
- DB側で、Debeziumが変更ログを読み取るための設定が有効であること
-
取得対象テーブルのレコードを一意に特定できること
- 主キー(PK: Primary Key)または一意キー(レコードを一意に特定できる列の組み合わせ)があること
- 変更を反映する先でUPDATEやDELETEの対象レコードを特定するために必要
Debeziumの実行方式
実行方式の種類
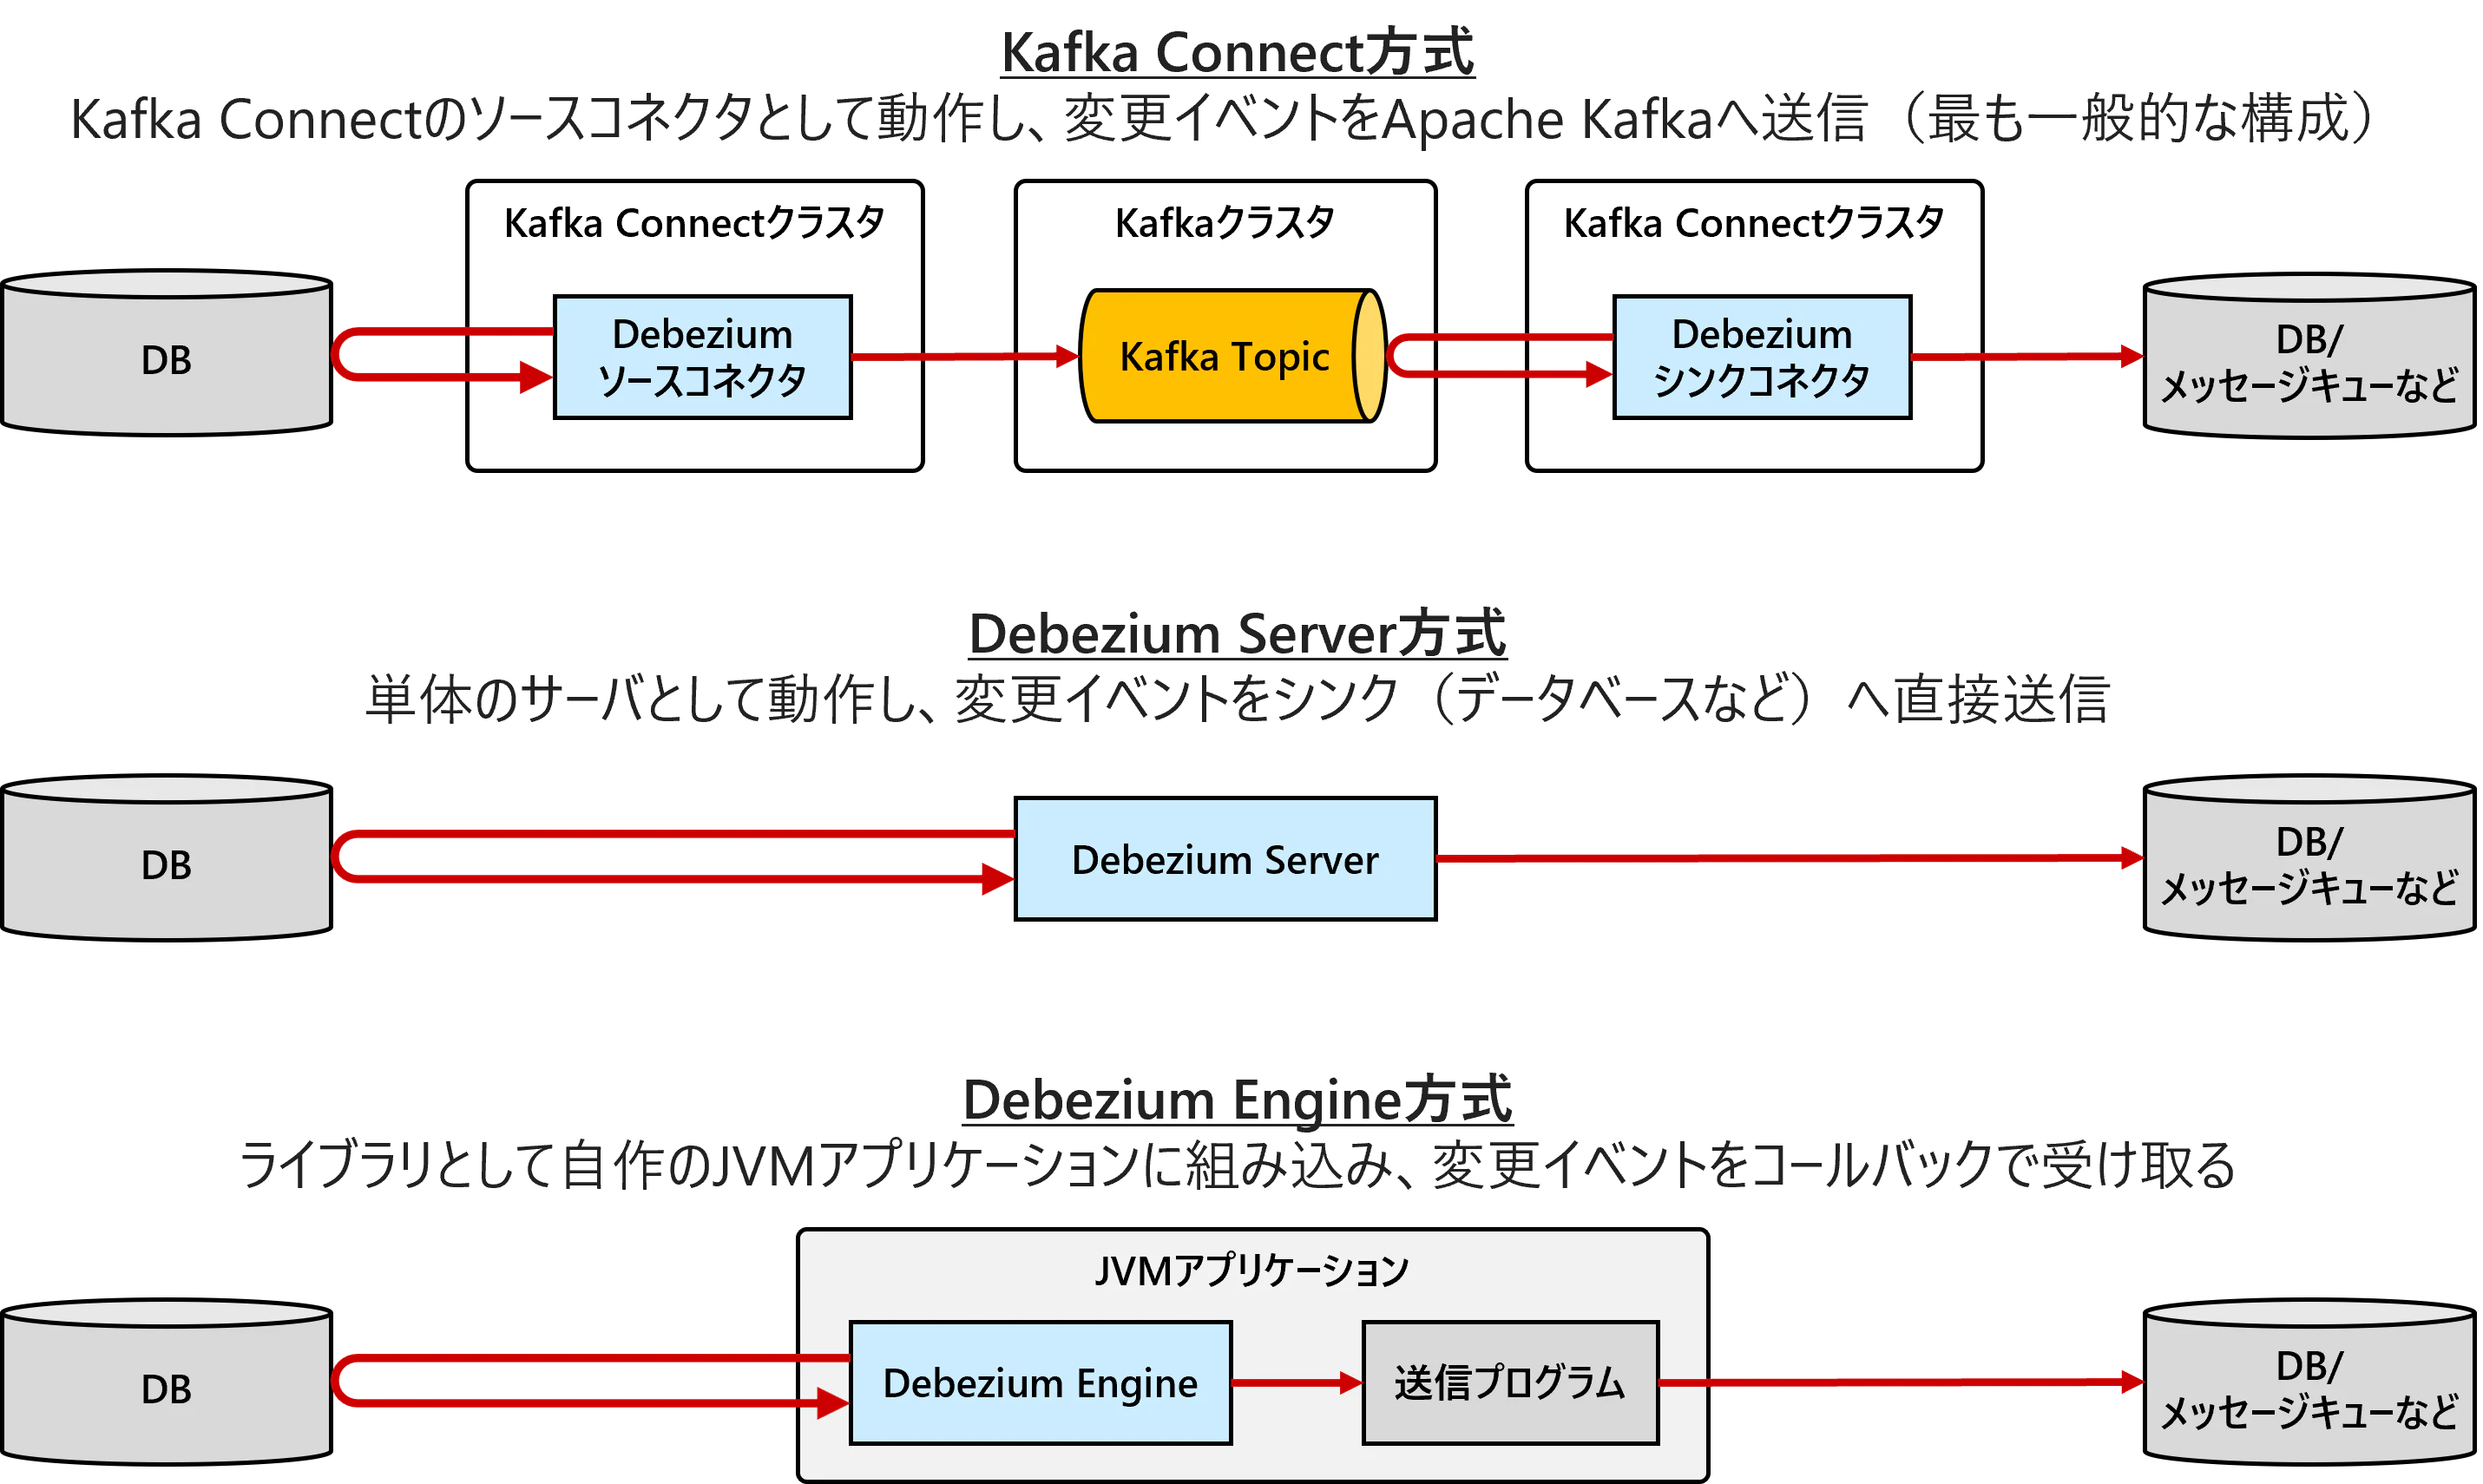
Debeziumは、以下の3種類の実行方式(デプロイモデル)を提供しています。
-
Kafka Connect
- Kafka Connectのソースコネクタとして動作し、変更イベントをApache Kafkaへ送信する(最も一般的な構成)
-
Debezium Server
- Quarkusフレームワーク上に構築されたJavaアプリケーションで、単体のサーバとして動作し、変更イベントをシンク(データベース、メッセージング基盤など)へ直接送信する
-
Debezium Engine
- ライブラリとして自作のJVMアプリケーションに組み込み、変更イベントをコールバックで受け取る
実行方式の比較
いずれもDebeziumのソースコネクタ実装を共通して利用しますが、実行基盤とスケーラビリティの面で明確な違いがあります。3種類の実行方式の比較を以下に示します。
| 観点 | Kafka Connect | Debezium Server | Debezium Engine |
|---|---|---|---|
| 前提インフラ | Kafkaクラスタ+Kafka Connectクラスタ | 不要 | 不要 |
| スケールアウト | 複数サーバで分散処理可能 | 単一プロセス内のみ | 単一プロセス内のみ |
| 高可用性 | サーバ間で自動フェイルオーバー | なし | なし |
| 対応する送信先 | Kafka Connectのシンクコネクタを利用(100種類以上) | Debezium Server内蔵のシンクを利用(20種類以上) | アプリケーション内で任意に実装 |
| Red Hat商用サポート | あり(GA:正式サポート) | なし(Technology Preview:本番環境のサポート対象外) | なし |
Kafka Connect方式は、複数Workerによる分散処理、Worker障害時の自動フェイルオーバーなどに対応しており、高いスループットや常時稼働など、性能・可用性が求められる本番環境に適しています。DebeziumとKafkaを組み合わせることで得られるメリットを以下に示します。
| メリット | 内容 |
|---|---|
| ① スケールアウト | Kafkaクラスタ/Kafka Connectクラスタの台数を増やして、並列分散処理により性能をスケールアウトできる |
| ② 高可用性 | 一部のサーバが停止しても、他のサーバが処理を引き継いで稼働を継続できる(フォールトトレランス) |
| ③ データの耐久性 | Kafkaクラスタ内でTopicのデータを複製するため、一部サーバのディスク障害でもデータを失わない |
| ④ 拡張性 | Kafka Topicを介して送信と受信を切り離す(疎結合にする)ことで、取得元DB/送信先DBを後から柔軟に追加・削除できる |
| ⑤ 1対多の配信 | DBの変更を1回取得してKafka Topicに書き込めば、そこから複数のDBに同期できる(ファンアウト) |
| ⑥ 負荷の平準化 | Kafka Topicに変更イベントをいったん溜めることで、送信先DBの処理能力に合わせたペースで書き込める。送信先DBが高負荷や障害で一時的に停止しても、取得元DBに影響が伝播しない |

一方、Debezium ServerおよびDebezium Engineは単一プロセスで動作し、複数ノードによる分散処理や自動フェイルオーバー機能は用意されていません。そのため、検証環境や小規模環境向けといえます。
また、商用ディストリビューションのRed Hat build of Debezium(バージョン3.6.3、2026年11月時点)が正式にサポートする実行方式はKafka Connectのみであり、Debezium Serverは「Technology Preview(テクノロジープレビュー)」という位置づけにとどまり、本番環境ではサポート対象外です。
参考:Release Notes for Red Hat build of Debezium 3.6.3
対応する送信先
Debeziumの実行方式により、対応する送信先が異なります。Kafka ConnectとDebezium Serverは、あらかじめ用意されたシンクコネクタを利用して変更イベントを送信します。一方、Debezium Engineにはシンクコネクタがないため、送信先との連携処理をアプリケーション内で独自に実装する必要があります。
Kafka Connectのシンクコネクタ
Kafka Connectでは、Debeziumプロジェクトが提供するシンクコネクタに加え、100種類以上のサードパーティー製のシンクコネクタを利用できます。
Debeziumプロジェクトが提供するシンクコネクタ:
| コネクタ | シンク(送信先) |
|---|---|
| JDBC | CockroachDB、Db2、IBMi、MariaDB、MySQL、Oracle、PostgreSQL、SingleStore、SQL Server、StarRocks |
| MongoDB | MongoDB |
サードパーティー製の主要なシンクコネクタ:
| 分類 | 主要なシンク(送信先) |
|---|---|
| データベース | JDBC対応データベース、ClickHouse、SingleStore |
| NoSQL/KVS | MongoDB、Couchbase、Redis、Azure Cosmos DB、Aerospike、Apache Cassandra、Neo4j |
| DWH/レイクハウス | Snowflake、Google BigQuery、Databricks、Azure Data Explorer、Firebolt |
| データストア/データレイク | Amazon S3、HDFS |
| クラウドサービス | Amazon EventBridge、Amazon Kinesis、Amazon SQS、Amazon SNS、Azure Event Hubs |
| 検索エンジン | Elasticsearch |
| ベクトルDB/AI | Milvus、Qdrant、Weaviate |
| 監視/オブザーバビリティ | Splunk、New Relic |
| 汎用 | HTTP |
Debezium Serverの内蔵シンクコネクタ
Debezium 3.7では、20種類以上のシンク(送信先)に対応しています。対応するシンクを用途別に示します。詳細は公式ドキュメントを参照してください。
| 分類 | シンク(送信先) |
|---|---|
| データベース | JDBC対応データベース(MySQL、PostgreSQLなど) |
| メッセージング/ストリーミング | Apache Kafka、Apache Pulsar、Apache RocketMQ、Apache Fluss、RabbitMQ Stream、RabbitMQ Native Stream、NATS Streaming、NATS JetStream、Pravega |
| クラウドサービス | Amazon Kinesis、Google Cloud Pub/Sub、Google Cloud Pub/Sub Lite、Azure Event Hubs、Databricks Zerobus Ingest |
| データストア/データレイク | Apache Iceberg、Infinispan、Redis Stream |
| ベクトルDB/AI | Milvus、Qdrant、InstructLab |
| 汎用 | HTTP Client |
Debeziumのアーキテクチャ
最も一般的な構成であるKafka Connect方式をもとに、Debeziumのアーキテクチャを解説します。
Debeziumのシステム構成例
Kafka Connect方式のDebeziumでは、前提インフラとしてKafkaクラスタとKafka Connectクラスタが必要です。冗長構成では最低でもKafkaサーバが3台(BrokerとControllerを同居させた場合)、Kafka ConnectのWorkerサーバが2台必要となります。
DBのテーブル2個をコピーするシステムの構成例を以下に示します。

Kafkaクラスタ
Apache Kafkaは、大量のストリーミングデータを扱う分散メッセージング基盤のデファクトスタンダードです。複数のサーバでクラスタを組むことで、スケールアウトと高可用性(フォールトトレランス)を実現します。
KRaftモードのKafkaクラスタは、Topicのメッセージを保持するBrokerと、クラスタのメタデータを管理するControllerで構成されます。Brokerはメッセージを複製する台数(replication.factor)以上が必要で、3台に複製して1台障害に対応する構成が一般的です。Controllerは過半数が稼働している必要があり、N台の同時障害に耐えるには2N+1台(通常は3台または5台)を配置します。BrokerとControllerは同じサーバに同居できますが、ControllerがBrokerの負荷や障害の影響を受けるため、Kafkaの公式ドキュメントは重要な本番環境では同居を避けるよう推奨しています。
Kafkaクラスタの構成例を以下に示します。
| 構成 | サーバ台数 | Broker | Controller | 効果 |
|---|---|---|---|---|
| 最小 | 1台 | 1台 | 1台(同居) | 停止中はクラスタ全体が停止し、ディスク障害で全データを失う |
| 冗長化(同居) | 3台 | 3台(複製3) | 3台(同居) | 1台障害に対応。Brokerの負荷がControllerに影響する |
| 冗長化(分離) | 6台 | 3台(複製3) | 3台(専用) | BrokerとControllerそれぞれ1台の障害に対応。Brokerの負荷がControllerに影響しない |
| 大規模 | 7台以上 | 4台以上(複製3) | 3台または5台(専用) | Broker障害時の性能低下が小さい。Controllerは5台なら2台障害に対応 |
冗長化(同居)の構成図を以下に示します。

Kafkaの詳細については以下の投稿をご参照ください。
Kafka Connectクラスタ
Kafka Connectとは、Kafkaと外部のシステムとの間でデータを連携する「コネクタ」を動かすフレームワークです。Kafka Connectを活用することで、Kafkaを介して様々なシステム間でデータを転送できます。
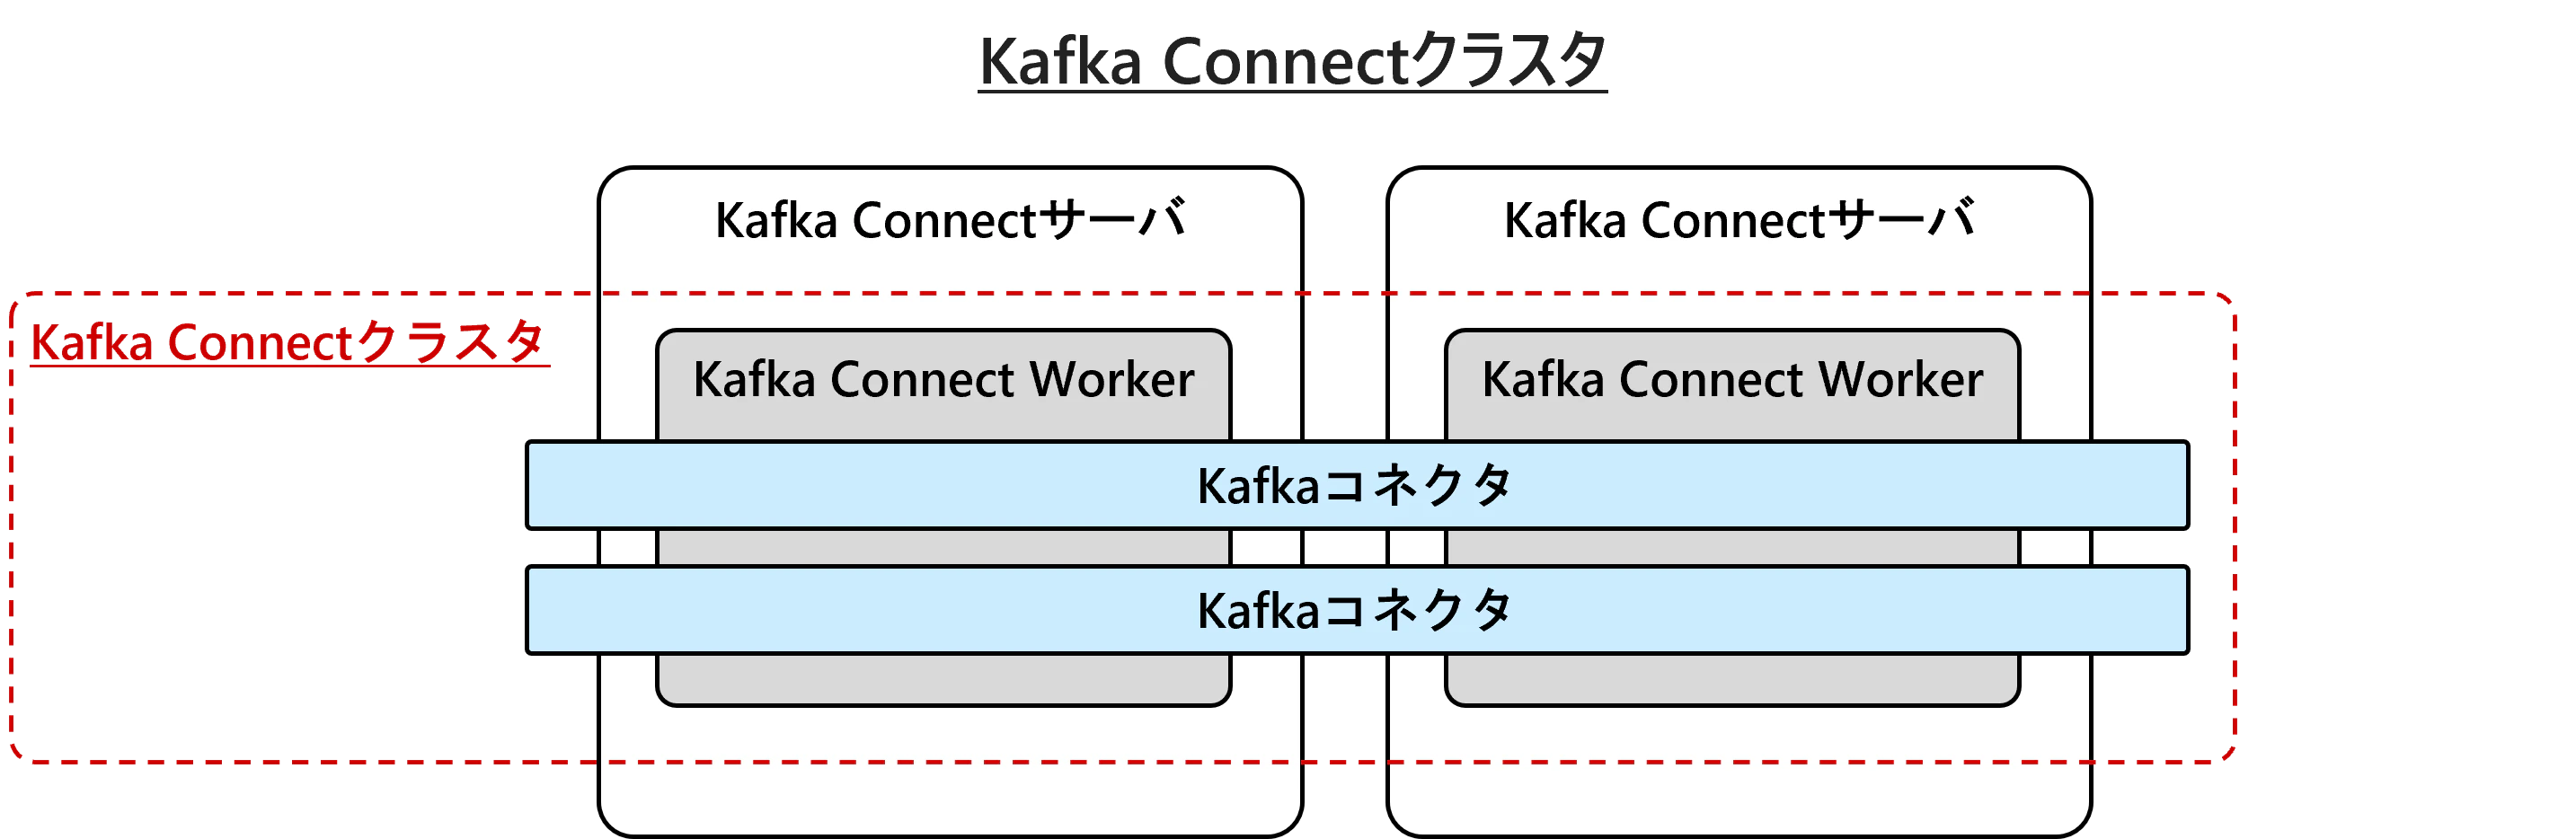
Kafka Connectは複数のWorkerサーバでクラスタ(グループ)を組みます。Debeziumはこのクラスタ上でコネクタとして動作します。Debeziumのスケールアウトと高可用性(フォールトトレランス)は、このKafka Connectクラスタの仕組みを利用します。
-
スケールアウト
- Worker台数とコネクタの処理プロセス(Task)数を増やして、並列分散処理が可能
-
高可用性(フォールトトレランス)
- Workerサーバで障害発生時は、自動的に別のWorkerが処理(Task)を引継ぎ、稼働を継続可能
Kafka Connectクラスタの構成例を以下に示します。Workerはコネクタの設定やOffsetをKafkaの管理用Topicに保存しており、Worker自身は状態を持ちません。そのため、同じgroup.idのWorkerを起動するだけでクラスタに参加でき、台数の増減も容易です。
| 構成 | Worker台数 | 効果 |
|---|---|---|
| 最小 | 1台 | 冗長化なし。Worker停止中はすべてのコネクタが停止 |
| 冗長化 | 2台 | 1台障害に対応。停止したWorkerのTaskは残りのWorkerが自動的に引き継ぐ。停止中は1台に負荷が集中 |
| 大規模 | 3台以上 | Taskが複数のWorkerに分散され、1台障害時の性能低下が小さい |
冗長化(2台)の構成図を以下に示します。
Kafka Connectの詳細については以下の投稿をご参照ください。
Debeziumの処理の流れ
ここでは例として、DebeziumでMySQLのテーブルをPostgreSQLにコピーする流れを示します。
Debeziumは初回起動時にテーブルの既存データを取得する「スナップショット」を行い、完了後はトランザクションログから変更を継続的に取得する「ストリーミング」に移ります。処理の流れは以下の4ステップです。
- Kafka Connectクラスタの起動:コネクタを動かすWorkerを起動し、管理用のTopicを自動作成します
- Debeziumコネクタの起動:取得元DB用のソースコネクタと、送信先DB用のシンクコネクタを起動します
- スナップショットの実行:初回起動時に、テーブルの既存レコードを一括で取得して送信先に反映します
- ストリーミングの開始:以降はDBの変更ログから変更(INSERT/UPDATE/DELETE)を継続的に取得して反映します
Kafka Connectクラスタの起動
Kafka ConnectのWorkerを2台起動して、Workerクラスタを構成します。
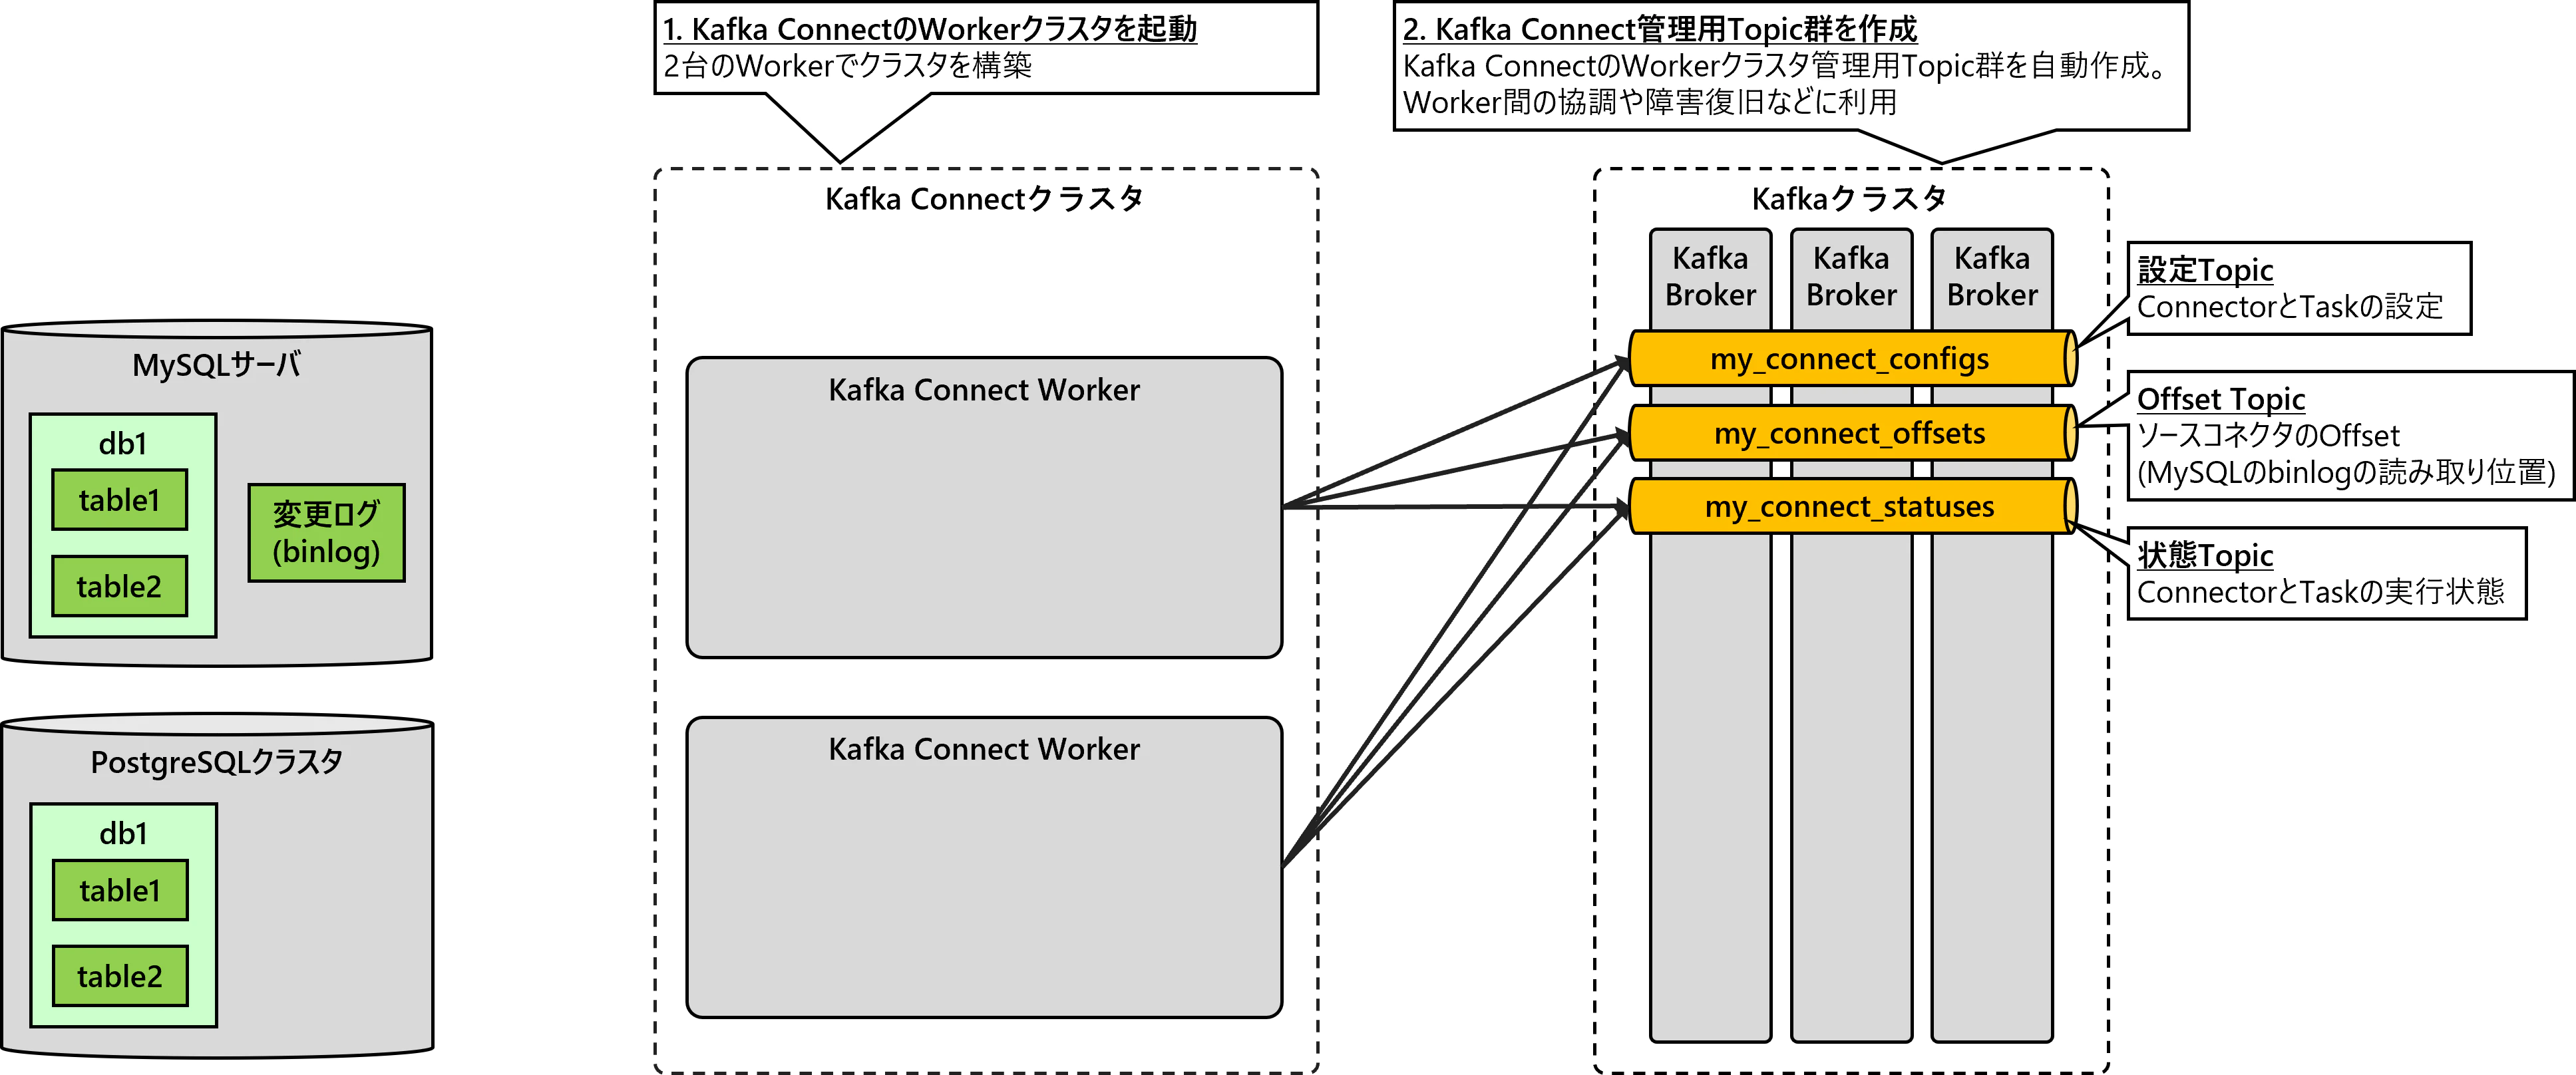
Workerクラスタが起動すると、以下のWorkerクラスタ管理用のTopicが、Kafkaクラスタ上に自動作成されます。これらはWorker同士の連携や、障害発生時の復旧に利用されます。
| Topic | 名前(本稿の検証での例) | 内容 |
|---|---|---|
| 設定Topic |
config.storage.topicで指定( my_connect_configs) |
コネクタとTaskの設定 |
| 状態Topic |
status.storage.topicで指定( my_connect_statuses) |
コネクタとTaskの実行状態 |
| Offset Topic |
offset.storage.topicで指定( my_connect_offsets) |
ソースコネクタの読み取り位置(Offset)。Debezium MySQLコネクタの場合はbinlogの位置 |
Debeziumコネクタの起動
Kafka ConnectのWorkerクラスタ上に、DebeziumのMySQLソースコネクタと、JDBCシンクコネクタを起動します。各コネクタは、コネクタを管理する1個のConnectorと、実際の処理を実行する1個以上のTaskで構成され、Worker間に分散配置されます。
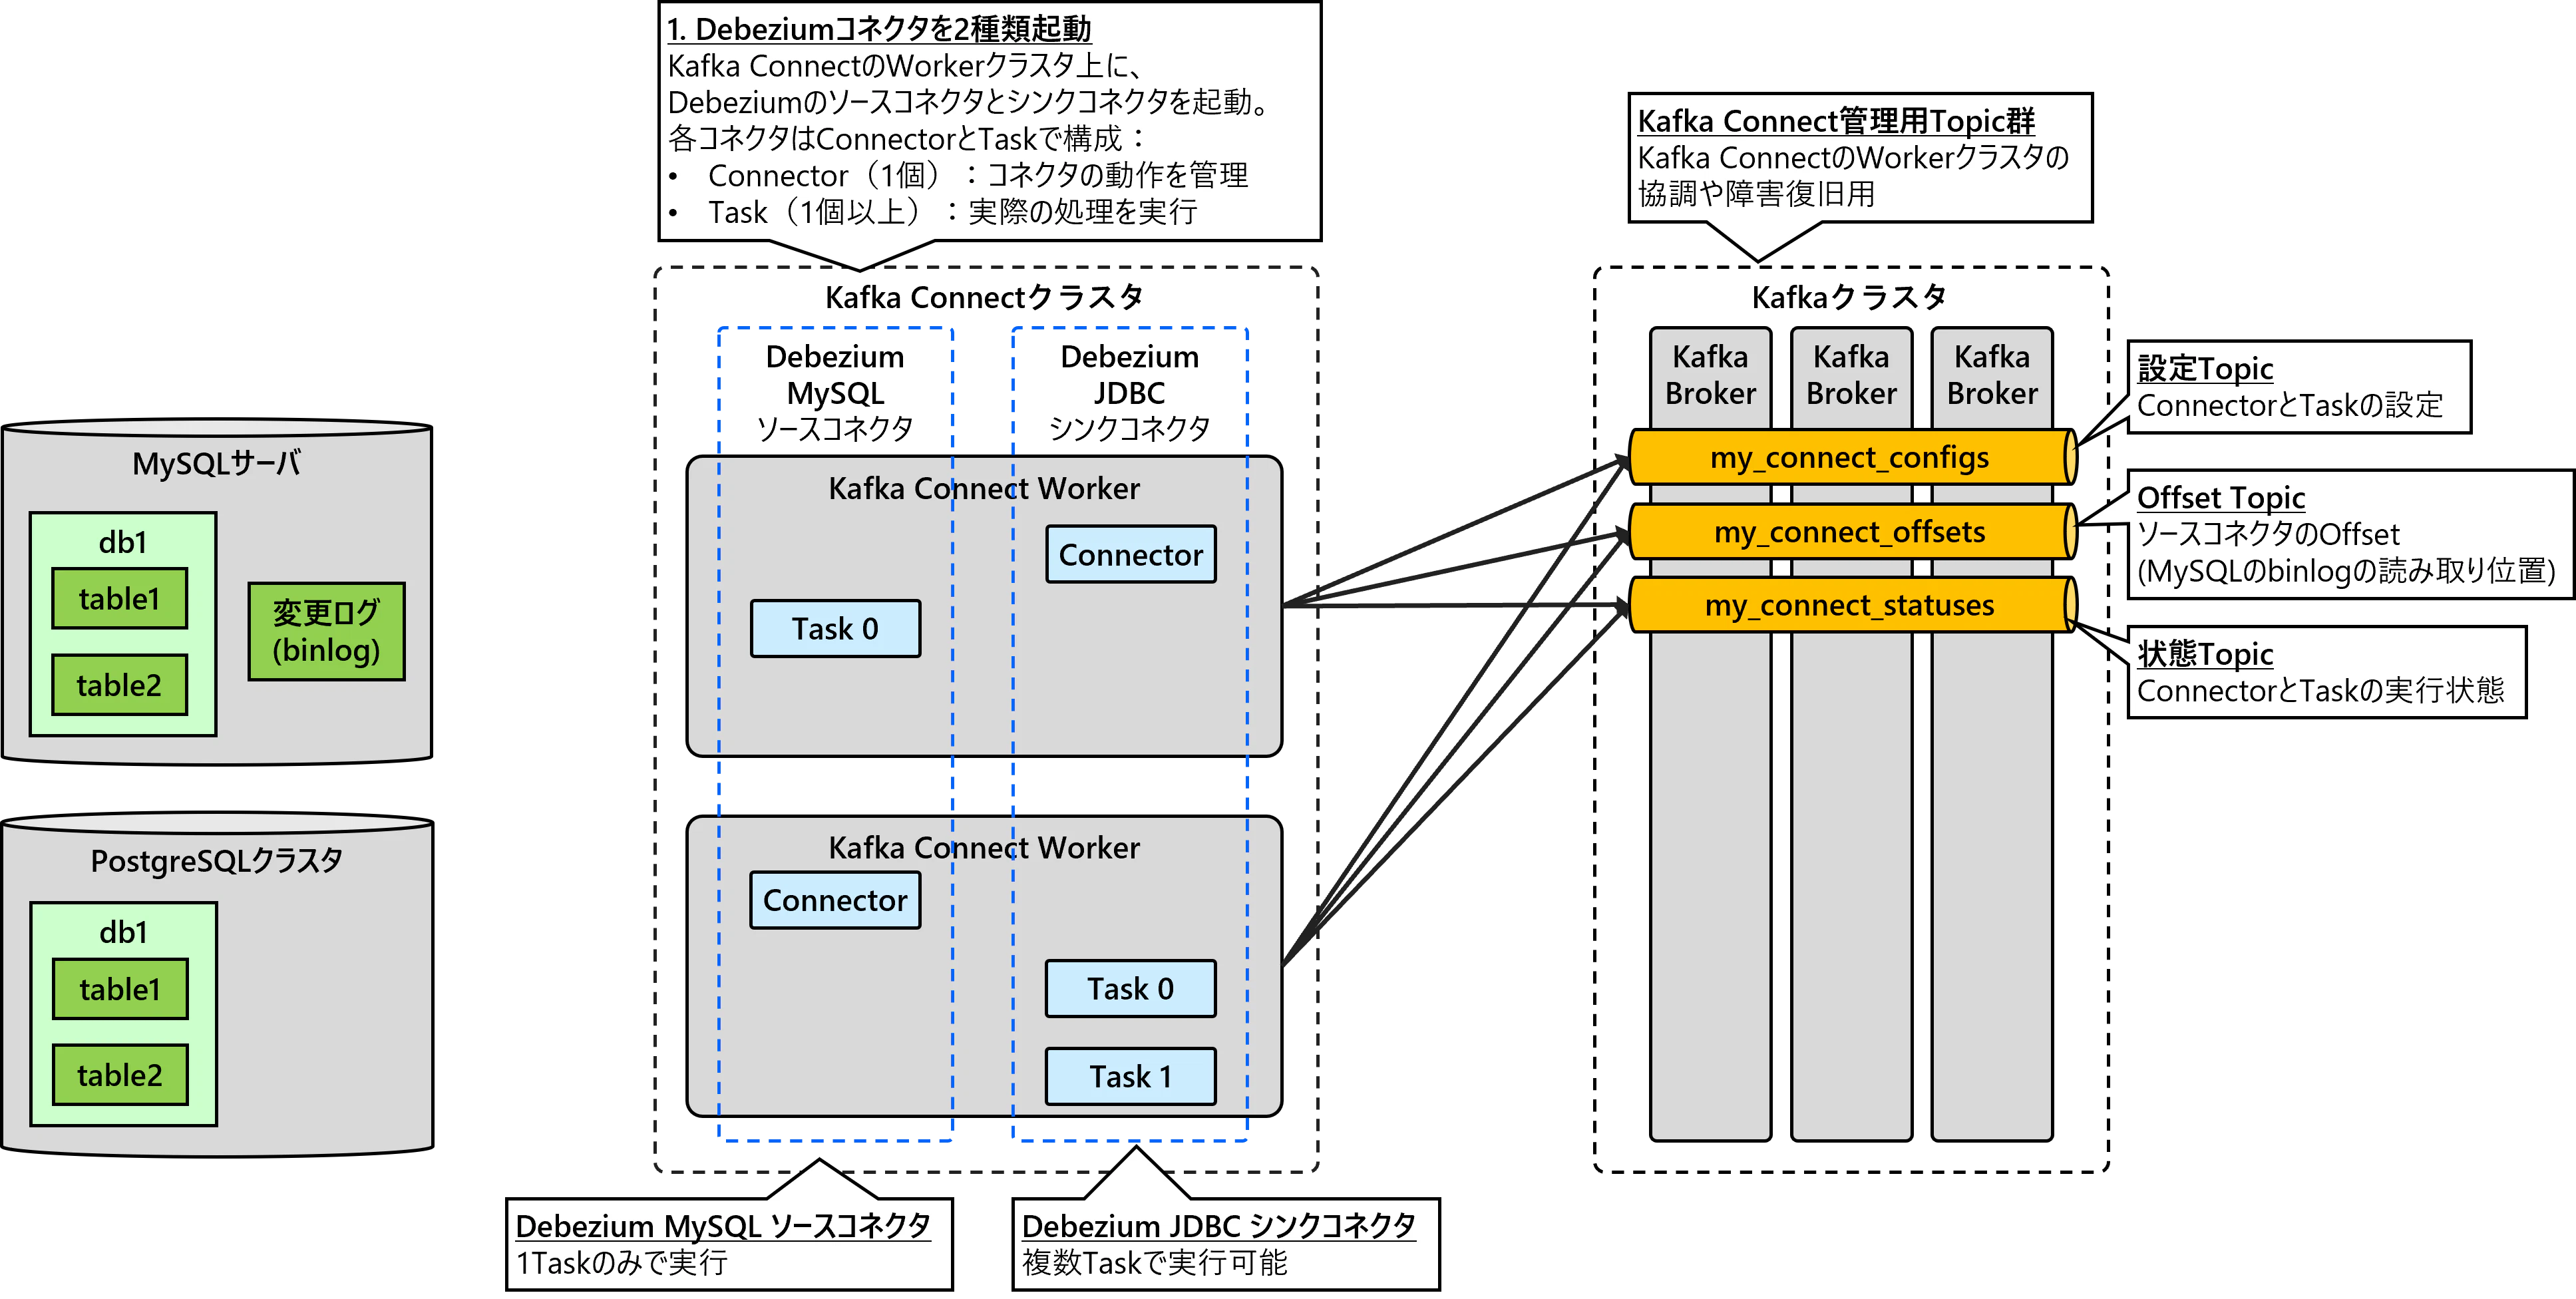
ソースコネクタは取得元のDBサーバごとにデプロイします。MySQLソースコネクタの場合、Task数は1で固定です。ソースコネクタが取得するテーブルごとに、レコード変更Topicが作成されます。
シンクコネクタも送信先のDBサーバごとにデプロイします。JDBCシンクコネクタのTask数は設定可能です。以下の条件の場合、ソースコネクタが取得するテーブル数と同数のTaskで並列処理が可能です。
- 各レコード変更TopicのPartition数を1に設定(各Topic内のレコードの順序を維持するため)
- シンクコネクタのTask(Consumer)へのPartitionの割り当て方式は
CooperativeStickyAssignorを設定(設定とチューニングの章の「シンクコネクタ」の構成上の注意点で説明)
以下では、2個のテーブルを2個のTaskで処理する例を示します。
スナップショットの実行
デフォルト設定ではコネクタの初回起動時に、対象テーブルの既存データを一括で読み取るスナップショットを実行します。スナップショットでは、DBのトランザクションログからではなく、SELECT文などのクエリでテーブルから直接レコードを取得し、変更イベントとして送信します。

-
既存データを取得(スナップショット)
MySQLソースコネクタが、SELECT文などのクエリで対象テーブルの既存レコードを直接取得します。あわせて、スナップショット開始時点のテーブル構造を取得し、スキーマ履歴Topicとスキーマ変更Topicに書き込みます。 -
変更イベントを転送
取得したレコードを1行ずつ変更イベント(読み取りを表すop: r)に変換して、Kafkaのレコード変更Topicに格納します。このTopicは取得元のテーブル単位で存在します。 -
変更イベントを取得
JDBCシンクコネクタが、レコード変更Topicから変更イベントを取得します。 -
初期データを反映
JDBCシンクコネクタが同期先DBにJDBC経由で接続して、SQL(INSERT)で既存レコードを同期先テーブルに反映します。
Debeziumは、スナップショット開始時点のトランザクションログの位置を記録します。スナップショット完了後は、その位置からログの読み取り(ストリーミング)を開始するため、スナップショット中に発生した変更も取りこぼしません。
このとき、コネクタは以下のTopicを使用します。スキーマ履歴Topicは、存在しない場合にコネクタが作成します。スキーマ変更Topicとレコード変更Topicは、Workerのtopic.creation.enableが有効(デフォルト)で、コネクタにtopic.creation.default.*を指定している場合、各Topicへの最初のイベント送信時に自動作成されます。Kafka Brokerのauto.create.topics.enableが有効な場合は、topic.creation.default.*を指定しなくてもBrokerのデフォルト設定でTopicが作成されますが、Partition数やレプリカ数を意図どおりにするにはtopic.creation.default.*で指定します。
| Topic | 名前(本稿の検証での例) | 内容 |
|---|---|---|
| スキーマ履歴Topic |
schema.history.internal.kafka.topicで指定( schema-changes.inventory) |
スキーマの変更履歴(DDLの履歴)。コネクタ再起動時のテーブル構造復元用 |
| スキーマ変更Topic |
topic.prefixで指定( dbserver1) |
DDLなどのスキーマ変更イベント配信用。外部アプリケーション向け |
| レコード変更Topic |
<topic.prefix>.<DB名>.<Table名>( dbserver1.db1.table1) |
テーブルごとのレコード変更イベント配信用 |
スキーマ履歴Topicはコネクタが内部利用するものであり、外部のアプリケーションからは利用しないでください。外部のアプリケーションからスキーマの変更履歴を参照したい場合は、スキーマ変更Topicを使用します。
ストリーミングの開始
スナップショットを取得した時点の変更ログ位置から、変更の取得を開始します。

-
変更イベントを収集
MySQLソースコネクタがDBの変更ログからテーブルの変更イベント(INSERT/UPDATE/DELETE)を収集します。収集方式はソースコネクタごとに異なります。MySQLソースコネクタの場合は、MySQLに常時接続してバイナリログ(binlog)から更新を検知・取得します。 -
変更イベントを転送
更新内容を変更イベントに変換して、Kafkaのレコード変更Topicに格納します。このTopicは取得元のテーブル単位で存在します。スキーマ変更は変更ログから検知して、変更があった場合にスキーマ履歴Topicとスキーマ変更Topicに書き込みます。 -
変更イベントを取得
JDBCシンクコネクタが、レコード変更Topicから変更イベントを取得します。 -
変更を反映
JDBCシンクコネクタがDBにJDBC経由で接続して、SQLで変更イベントを反映します。
変更イベントの種類
変更イベントは、キーと値で構成されるKafkaのメッセージです。キーは変更された行の主キーで、値は変更内容です。値のopフィールドが操作の種類(変更イベントの種類)を表し、beforeとafterに変更前後の行が入ります。
op |
操作 | before |
after |
|---|---|---|---|
r |
読み取り(Read):スナップショットによる既存データの読み取り | null |
読み取った行 |
c |
作成(Create):INSERT | null |
追加した行 |
u |
更新(Update):UPDATE | 更新前の行 | 更新後の行 |
d |
削除(Delete):DELETE | 削除前の行 | null |
イベントの各フィールドは、動作検証の章で実際のイベントを見ながら確認します。
参考:Debezium connector for MySQL - Data change events
配信保証(At-least-onceとExactly-once)
Debeziumソースコネクタは「少なくとも1回の配信(At-least-once)」を保証しており、テーブルの変更を取りこぼしません。システムが正常に動作している間は各変更イベントを1回だけ配信しますが、障害や再起動などの際に、同じ変更イベントが重複して配信される場合があります。
Kafka Connect方式では、対応するソースコネクタ(MySQLなど)で、Kafka Connectのexactly-onceサポートを利用して「厳密に1回の配信(Exactly-once)」を実現できます。ただし、この機能はKafkaのトランザクションに依存しており、公式ドキュメントでは関連する既知の問題(未解決のIssue)が挙げられています。そのため、重複が発生しないことは完全には保証されない点に注意が必要です。
Debezium JDBCシンクコネクタも「少なくとも1回の配信」を保証しており、Kafka Topicの変更イベントを取りこぼしません。また、同期先テーブルへの冪等書き込みを設定することで、同じキーのレコードはUPSERTクエリで上書きされます。これにより、重複したイベントを受け取っても、同期先の結果は変わりません。
そのため、データベース間で結果としてExactly-onceと同じ状態を得るには、JDBCシンクコネクタで冪等書き込みを有効にします。ソースコネクタのExactly-once機能は、Topicへの重複を減らしたい場合に追加で有効にします。この機能は、Kafka Connectが分散モードで、バージョンが3.3.0以上の場合に使用できます。必要な設定を以下に示します。各設定の詳細は、設定章の各表を参照してください。
- Debezium JDBCシンクコネクタ(必須): DBへの冪等書き込みを有効化
insert.mode=upsertprimary.key.mode=record_key
- Kafka Connect Worker(任意): Exactly-onceの配信機能を有効化
exactly.once.source.support=enabled
- Debeziumソースコネクタ(任意): Exactly-onceの配信機能を有効化
exactly.once.support=required-
transaction.boundary=poll(デフォルト)
Debeziumの設定とチューニング
Debeziumの設定を、構成に必要な「基本設定」と、性能調整の対象となる「チューニング設定」に分けて示します。チューニング設定はデフォルト値を起点に、処理遅延、メモリ使用量、DB負荷を測定して調整します。
ここでは本番向けの構成(Kafka Broker 3台、Kafka Connect Worker 2台の分散モード、複数テーブルの取得)を前提にした設定を示します。後述の動作検証の章は最小構成のため一部の値が異なります。違いは、動作検証の章の「本番環境向け設定との違い」にまとめます。
前提バージョン:
| ソフトウェア | バージョン |
|---|---|
| Apache Kafka (Kafka Connect) | 4.3 |
| Debezium | 3.7 |
前提構成:
| サーバ | 台数 |
|---|---|
| Kafka Broker | 3台 |
| Kafka Connect Worker | 2台 |
Debeziumはコネクタにより設定項目が異なります。今回はDebeziumプロジェクトが提供しているMySQLソースコネクタとJDBCシンクコネクタを例に示します。
Kafka Connect
Worker設定ファイルに指定します。
基本設定
| パラメータ | 設定値 | 概要 |
|---|---|---|
bootstrap.servers |
Brokerのアドレス一覧(必須) | 接続先Broker |
group.id |
Workerクラスタ固有のID(必須) | Workerクラスタの識別子 |
config.storage.topicoffset.storage.topicstatus.storage.topic
|
Workerクラスタ固有のTopic名(必須) | Worker管理用のTopic名 |
config.storage.replication.factoroffset.storage.replication.factorstatus.storage.replication.factor
|
3(デフォルト) |
Worker管理用Topicのレプリカ数 |
key.convertervalue.converter
|
org.apache.kafka.connect.json.JsonConverter(必須) |
変更イベントの形式 |
key.converter.schemas.enablevalue.converter.schemas.enable
|
true(デフォルト) |
イベントにスキーマ情報を含める |
plugin.path |
Debeziumコネクタの配置パス(必須) | コネクタプラグインを読み込む親ディレクトリ |
topic.creation.enable |
true(デフォルト) |
Topicの自動作成を許可 |
connector.client.config.override.policy |
All(デフォルト) |
コネクタによるクライアント設定の上書きを許可 |
exactly.once.source.support |
disabled(デフォルト) |
ソースコネクタのExactly-once配信を有効化 |
構成上の注意点:
-
group.idが同じWorkerが、1つのWorkerクラスタを構成します。 -
config.storage.topic、offset.storage.topic、status.storage.topicは、同じKafkaクラスタ上の別のWorkerクラスタと重複させません。 -
config.storage.replication.factor、offset.storage.replication.factor、status.storage.replication.factorは、Broker台数以下にします。Broker 3台構成のため、デフォルトの3のままとします。 -
key.converter.schemas.enableとvalue.converter.schemas.enableをfalseにすると、イベントのスキーマ情報から同期先テーブルの列を決定するJDBCシンクコネクタが動作しません。 -
topic.creation.enableは、ソースコネクタのtopic.creation.default.*でTopicを自動作成するために必要です。 -
connector.client.config.override.policyは、シンクコネクタのconsumer.override.*でConsumerの設定を上書きするために必要です。 -
exactly.once.source.supportは、ソースコネクタでExactly-once配信を使う場合に、Workerクラスタ内の全Workerでenabledにします。分散モードのKafka Connect 3.3.0以上で利用できます。仕組みは「配信保証(At-least-onceとExactly-once)」を参照してください。
チューニング設定
| パラメータ | 初期値 | 調整方針 |
|---|---|---|
offset.flush.interval.ms |
60000 |
Offset(読み取り位置)の保存間隔(ミリ秒) |
調整時の注意点:
-
offset.flush.interval.msは、ソースコネクタが取得元の読み取り位置(binlogの位置)をOffset Topicに保存する間隔であり、シンクコネクタがKafka Topicの読み取り位置(Consumer GroupのOffset)をコミットする間隔でもあります。再開時は最後に保存した位置から読み直すため、長いほどクラッシュ時に重複配信されるイベントが増え、短いほどOffsetの保存頻度が増えます。
ソースコネクタ(Debezium MySQLコネクタ)
設定項目は取得元DBによって異なります。ここではMySQLコネクタを例に示します。
ソースコネクタの設定JSONに指定します。
基本設定
| パラメータ | 設定値 | 概要 |
|---|---|---|
name |
コネクタ名(必須) | コネクタの一意な名前 |
connector.class |
io.debezium.connector.mysql.MySqlConnector(必須) |
コネクタのクラス |
database.hostname |
取得元DBのアドレス(必須) | 接続先の取得元DBのホスト名 |
database.port |
3306(デフォルト) |
取得元DBのポート番号 |
database.userdatabase.password
|
取得元DBの接続ユーザ(必須) | 接続用のDBユーザ |
database.server.id |
一意の数値(必須) | レプリケーションクライアントのID |
database.include.listtable.include.list
|
取得対象のDB、テーブル | 取得対象の絞り込み。未設定は全テーブル |
topic.prefix |
例:dbserver1(必須) |
レコード変更Topic名の接頭辞、かつスキーマ変更Topic名 |
schema.history.internal.kafka.bootstrap.servers |
Brokerのアドレス一覧(必須) | スキーマ履歴TopicのBroker |
schema.history.internal.kafka.topic |
例:schema-changes.inventory(必須) |
スキーマ履歴Topicの名前 |
topic.creation.default.partitions |
1(明示指定) |
TopicのPartition数。1個でテーブル内のイベント順序を維持 |
topic.creation.default.replication.factor |
3(明示指定) |
Topicのレプリカ数。Broker 3台以上の構成で3に設定 |
snapshot.mode |
initial(デフォルト) |
初回起動時にスナップショットを実行してからストリーミング |
signal.data.collection |
例:db1.debezium_signal
|
シグナル用テーブル |
include.schema.changes |
true(デフォルト) |
スキーマ変更TopicへDDLイベントを出力 |
tombstones.on.delete |
true(デフォルト) |
DELETEイベントの後にTombstoneを送信 |
decimal.handling.mode |
precise(デフォルト) |
DECIMAL/NUMERIC列の表現形式 |
time.precision.mode |
adaptive_time_microseconds(デフォルト) |
日付・時刻列の表現形式 |
exactly.once.support |
requested(デフォルト) |
Exactly-once配信の要求レベル |
transaction.boundary |
poll(デフォルト) |
Kafkaトランザクションの区切り |
構成上の注意点:
-
database.userのDBユーザには、binlogの読み取りとスナップショットに必要な権限を付与します。 -
database.server.idは、MySQLクラスタ内の他のレプリケーションクライアント(レプリカや他のコネクタ)と重複させません。 -
database.include.listとtable.include.listを未設定にすると、システムテーブルを除く全DBの全テーブルが取得対象になります。 -
topic.prefixはコネクタ間で一意にし、設定後は変更しません。変更すると、以降のイベントは新しい名前のTopicに出力され、スキーマ履歴Topicも引き継げなくなります。 -
topic.creation.default.partitionsとtopic.creation.default.replication.factorは、defaultグループで必須です。 -
snapshot.modeのinitialは、Offsetが未記録の場合のみスナップショットを実行してからストリーミングを開始し、Offsetが記録済みの再起動時はストリーミングのみを再開します。 -
signal.data.collectionは、インクリメンタルスナップショットを使用する場合に指定します。シグナルは実行中のコネクタに指示を送る仕組みで、取得元DBに作成した専用テーブル(シグナル用テーブル)に指示の行をINSERTすると、コネクタがbinlog経由で読み取って実行します。代表的な指示が、指定したテーブルのインクリメンタルスナップショットの開始です。table.include.listを指定する場合は、シグナル用テーブルも含めます。テーブル経由でシグナルを受け取るsourceチャネルはデフォルトで有効です。 -
include.schema.changesの出力先であるスキーマ変更Topicは、名前がtopic.prefixの値(例:dbserver1)で、レコード変更Topic(例:dbserver1.db1.table1)とは別のTopicです。 -
tombstones.on.deleteで送信するTombstoneは、ログ圧縮(log compaction)を有効にしたTopicから、削除済みキーのメッセージを消去するために使います。 -
decimal.handling.modeのpreciseは、DECIMAL/NUMERIC列を精度を保ったバイナリ(Kafka ConnectのDecimal論理型)で表現し、JSONではBase64文字列になります。人が読める形にする場合は、stringか、精度が落ちることのあるdoubleに変更します。 -
time.precision.modeのadaptive_time_microsecondsは、日付・時刻列を列の精度(ミリ秒、マイクロ秒、ナノ秒)に合わせたエポックからの経過時間の整数で表現します(TIME型は常にマイクロ秒精度)。connectに変更するとKafka Connect組み込みの型(ミリ秒精度)になり、マイクロ秒以下の精度が失われます。 -
decimal.handling.modeとtime.precision.modeは、同期先がMySQLであれば、デフォルトのままでJDBCシンクコネクタが元の型に戻して書き込みます。同期先が別のDBや、JSONを直接読むコンシューマの場合は、扱いやすい形式への変更を検討します。 -
exactly.once.supportとtransaction.boundaryは、Exactly-once配信を使う場合に、Workerのexactly.once.source.support=enabledとあわせて指定します。exactly.once.supportをrequiredにすると、起動時にExactly-once配信が可能な構成かを検証し、できない場合は起動に失敗します。transaction.boundaryはDebeziumではpollのみに対応しており、Taskがpoll()で返すバッチごとにKafkaトランザクションをコミットします。仕組みは「配信保証(At-least-onceとExactly-once)」を参照してください。
チューニング設定
Debezium MySQLソースコネクタのチューニングポイントと初期値(デフォルト値)を以下に示します。
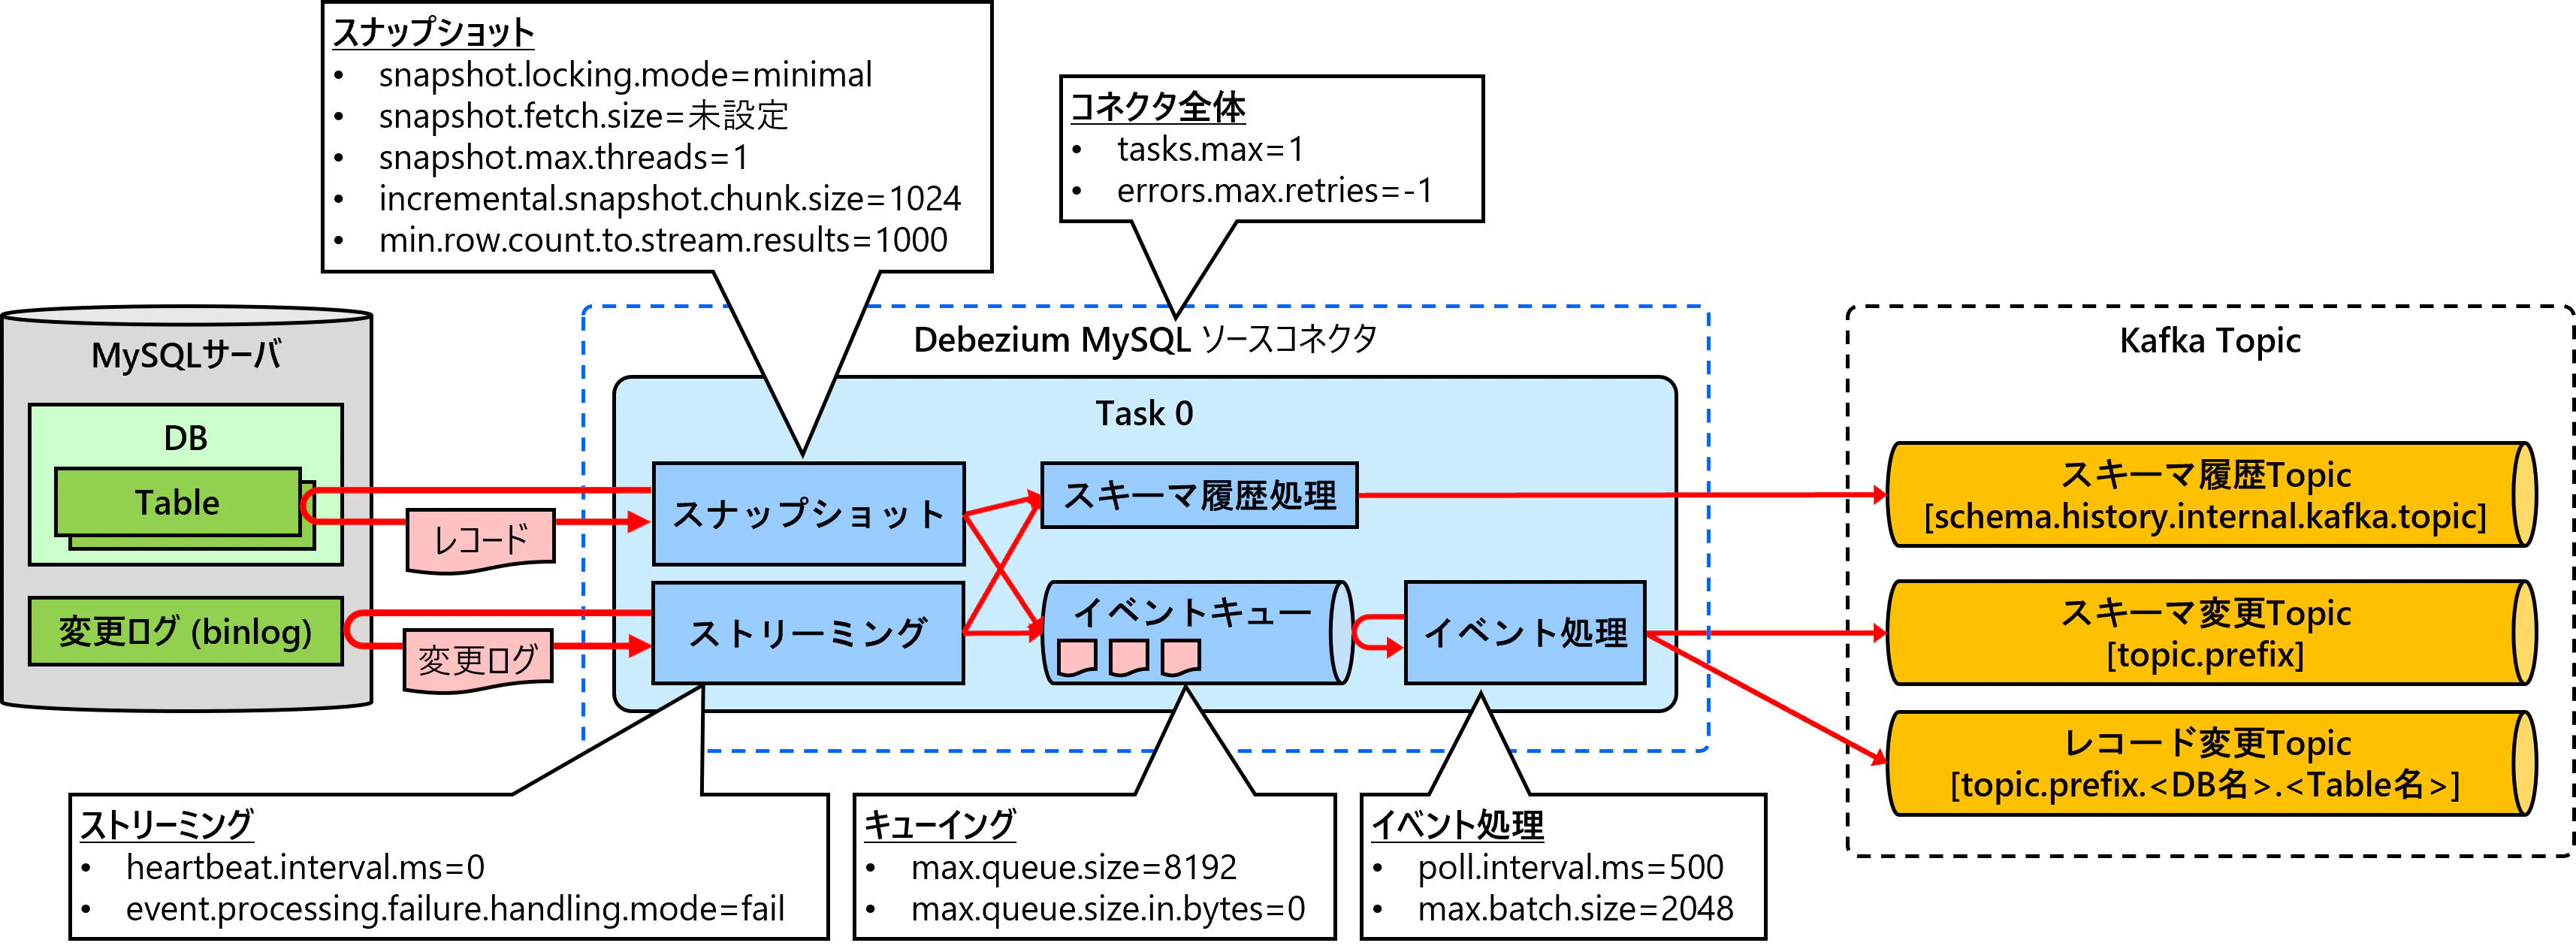
いずれも初期値で動作しますが、必要に応じて調整します。
| パラメータ | 初期値 | 調整方針 |
|---|---|---|
tasks.max |
1 |
Taskの最大数。MySQLは1固定 |
errors.max.retries |
-1 |
エラー時の最大再試行回数。-1は無制限 |
snapshot.locking.mode |
minimal |
スナップショット中のロックの範囲 |
snapshot.fetch.size |
未設定 | スナップショットの取得行数。未設定を維持 |
snapshot.max.threads |
1 |
初回スナップショットのスレッド数。DB負荷を見て増加 |
incremental.snapshot.chunk.size |
1024 |
インクリメンタルスナップショットのチャンク行数 |
min.row.count.to.stream.results |
1000 |
ストリーミング読み取りに切り替える行数 |
heartbeat.interval.ms |
0 |
ハートビート間隔(ミリ秒)。0は送信なし |
event.processing.failure.handling.mode |
fail |
処理できないイベントの扱い |
max.queue.size |
8192 |
キューの最大件数。max.batch.sizeより大きくする |
max.queue.size.in.bytes |
0 |
キューの最大容量(バイト)。0は無制限 |
poll.interval.ms |
500 |
バッチ処理前に変更イベントを待つ最大時間(ミリ秒) |
max.batch.size |
2048 |
1回に処理する最大件数 |
調整時の注意点:
-
errors.max.retriesは、DB接続断などの再試行可能なエラーでコネクタが自動再起動する回数です。無制限のままだと障害に気づきにくいため、監視と合わせて上限を検討します。 -
snapshot.locking.modeのminimalは、テーブル構造の読み取り中のみグローバル読み取りロックを保持し、行の読み取りはREPEATABLE READトランザクションで行います。extendedはスナップショット全体で書き込みをブロックし、noneはロックを取りませんが、スナップショット中にスキーマ変更が発生しないことが前提です。 -
snapshot.fetch.sizeは未設定を推奨します。未設定の場合、MySQLは結果セットを1行ずつストリーミングしますが、値を設定すると結果セット全体をメモリに取得しようとして性能問題が起きる場合があります。 -
snapshot.max.threadsを増やすと、主キーの範囲でテーブルを分割して並列処理します(主キーがないテーブルは単一スレッド)。この並列処理はIncubating機能であり、今後変更される可能性があります。 -
min.row.count.to.stream.results以上の行数を持つテーブルは、スナップショットで結果セットをメモリに保持せず、ストリーミングで読み取ります。0にすると常にストリーミングで読み取ります。 -
heartbeat.interval.msは、変更イベントの受信状況の監視や、再起動時の再送削減が必要な場合に設定します。 -
event.processing.failure.handling.modeは、処理できないイベントが発生した場合に、failでコネクタを停止、warnでログ出力してスキップ、skipで無視します。Kafka ConnectのDead Letter Queue(DLQ)はシンクコネクタ専用のため、スキップしたイベントはDLQに退避されず、ログでしか確認できません。 -
max.queue.size、max.queue.size.in.bytes、incremental.snapshot.chunk.sizeを増やす場合は、メモリ使用量を確認します。キューの件数と容量を併用すると、どちらかの上限に達した時点で書き込みが待機します。 -
poll.interval.msは、キューに新しい変更イベントが溜まるのを待つ最大時間です。binlogの読み取りは別スレッドが常時行ってキューに入れ、コネクタ本体はキューにmax.batch.size件が溜まるかこの時間が経過するかの早い方でバッチを取り出してKafkaへ送信します。長くするとバッチが大きくなる一方で遅延が増え、短くすると遅延は減りますが空振りのポーリングが増えます。DBへのSQLポーリング間隔ではありません。5000を超える値は5000として扱われます。 - 共通:調整の判断には、JMXの
MilliSecondsBehindSource(取得元との遅延)とQueueRemainingCapacity(キューの空き容量)を監視します。
参考:Debezium connector for MySQL - Connector properties
シンクコネクタ(Debezium JDBCシンクコネクタ)
シンクコネクタの設定JSONに指定します。
基本設定
| パラメータ | 設定値 | 概要 |
|---|---|---|
name |
コネクタ名(必須) | コネクタの一意な名前 |
connector.class |
io.debezium.connector.jdbc.JdbcSinkConnector(必須) |
コネクタのクラス |
connection.urlconnection.usernameconnection.password
|
同期先DBの接続情報(必須) | 同期先DBへの接続先とユーザ |
topics.regex |
レコード変更Topicのみ(必須) | 購読するTopicの正規表現 |
insert.mode |
upsert(デフォルトはinsert) |
書き込み方式。upsertは冪等 |
primary.key.mode |
record_key(デフォルトはnone) |
同期先の主キーの決め方 |
delete.enabled |
true(デフォルトはfalse) |
取得元のDELETEを同期先に反映 |
schema.evolution |
basic(デフォルトはnone) |
同期先テーブルの自動作成と列追加 |
collection.name.format |
${topic}(デフォルト) |
同期先テーブル名のパターン |
consumer.override.partition.assignment.strategy |
org.apache.kafka.clients.consumer.CooperativeStickyAssignorのみ |
TaskへのPartition割り当て方式 |
構成上の注意点:
-
connection.urlの同期先がMySQLで、同じサーバ内の別データベースに同名のテーブルがある場合は、JDBCドライバのパラメータnullCatalogMeansCurrent=trueを付けます。付けない場合、schema.evolutionのテーブル存在確認が別データベースの同名テーブルを拾い、同期先テーブルが作成されずに書き込みが失敗します(動作検証の章で説明します)。 -
topics.regexの設定例はJSON表記でdbserver1\\.db1\\..*で、スキーマ変更Topic(dbserver1)は一致しないため含まれません。購読するTopicはtopics(カンマ区切りの列挙)かtopics.regex(正規表現)のどちらか一方で指定し、両方を指定した場合も、どちらも指定しない場合もエラーになります。本稿では、テーブルが増えても設定を変えずに済むtopics.regexを使います。 -
insert.modeがinsertのままだと、再起動やリバランスで再配信されたイベントが主キー制約違反になります。upsertは、主キーが存在すれば更新、なければ挿入するため、同じイベントを再度受け取っても結果が変わりません。 -
primary.key.modeは、upsertとdelete.enabledの利用に必須です(none以外を指定)。record_keyでは、Debeziumの変更イベントのキー(取得元テーブルの主キー)が、同期先テーブルの主キー列になります。 -
delete.enabledは、primary.key.modeがrecord_key、record_value、record_headerのいずれかの場合に使用できます。falseの場合、取得元のDELETEは同期先に反映されません。 -
schema.evolutionがnoneの場合は、事前に同期先テーブルを作成します。basicは、テーブルの自動作成と列の追加に対応しますが、列の型変更、列の削除、主キーの変更には追従しません。 -
collection.name.formatの${topic}はTopic名(.は_に置換)に置換されます。例:${topic}→dbserver1_db1_table1。 -
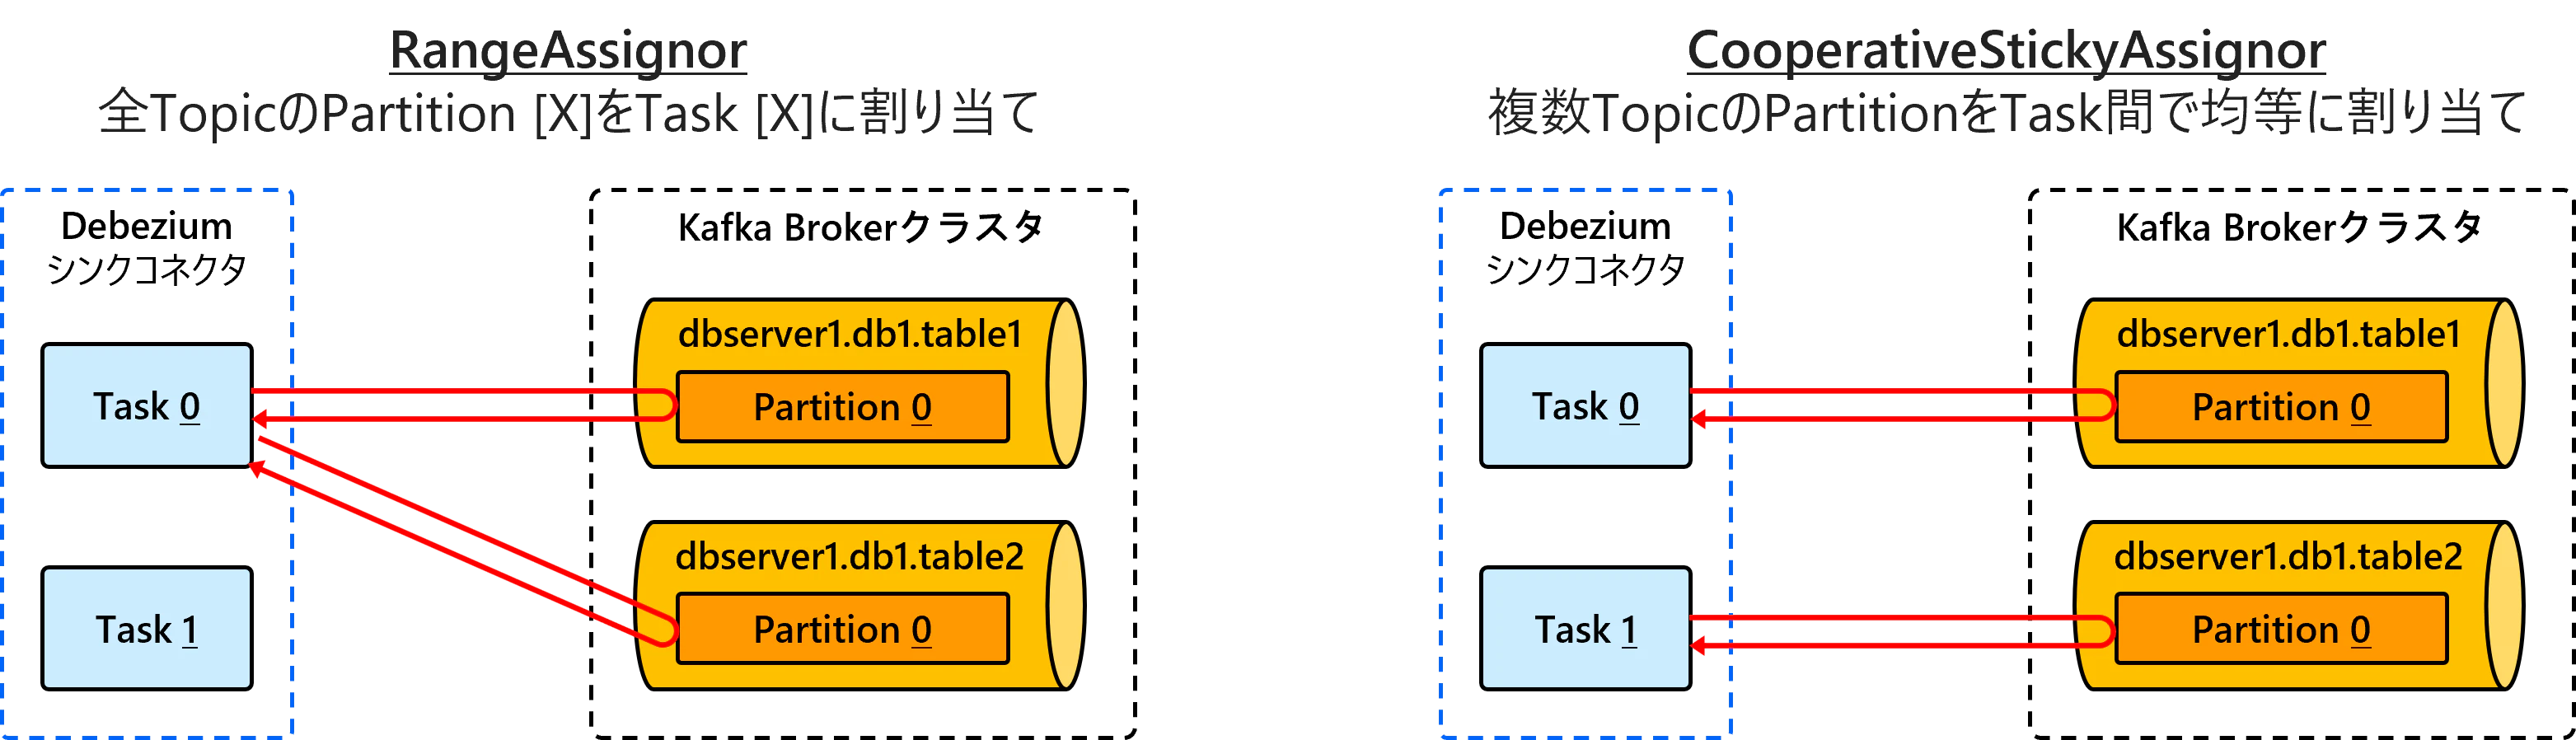
consumer.override.partition.assignment.strategyを指定しない場合、Kafka Consumerのデフォルト(RangeAssignorとCooperativeStickyAssignorのリスト)の先頭にあるRangeAssignorで割り当てられます。RangeAssignorは各TopicのPartition 0をすべてTask 0に割り当てるため、Partition数が1個のTopicではTask数を増やしても並列化されません。CooperativeStickyAssignorのみを指定すると、複数TopicのPartitionをTask間で均等に割り当て、既存の割り当てをできるだけ維持する協調的リバランスで処理への影響も抑えられます。
チューニング設定
Debezium JDBCシンクコネクタのチューニングポイントと初期値(デフォルト値)を以下に示します。

いずれも初期値で動作しますが、必要に応じて調整します。
| パラメータ | 初期値 | 調整方針 |
|---|---|---|
tasks.max |
1 |
Taskの最大数。Topic数を上限に増加 |
consumer.override.max.poll.records |
500 |
1回に取得する最大件数。batch.size以上にする |
batch.size |
500 |
DB書き込みのバッチ件数 |
connection.pool.max_size |
32 |
同期先DBへの最大接続数 |
use.reduction.buffer |
false |
同一主キーのイベントを1件に集約 |
flush.max.retries |
5 |
書き込み失敗時の最大リトライ回数 |
flush.retry.delay.ms |
1000 |
リトライの待機時間(ミリ秒) |
errors.tolerance |
none |
処理できないイベントの扱い |
errors.deadletterqueue.topic.name |
未設定 | スキップしたイベントの退避先Topic(DLQ) |
errors.deadletterqueue.context.headers.enable |
false |
DLQのメッセージにエラー情報のヘッダーを付与 |
調整時の注意点:
-
tasks.maxは、本稿では各Topicが1Partitionのため、レコード変更Topic数が上限の目安です。それを超えるTaskにはPartitionが割り当てられず、処理を行いません。増やす場合は同期先DBの最大接続数も確認します。 -
consumer.override.max.poll.recordsの500は、Kafka Consumerのデフォルト値と同じです。batch.sizeより小さいと、指定したバッチ件数に達しません。 -
use.reduction.bufferは、同一主キーへの複数の変更を1回の書き込みにまとめてDB負荷を減らします。途中の行の状態が失われて制約を満たせなくなる場合があるため、同期先に副次ユニーク制約がある場合は有効にしません。 -
flush.max.retriesを超えて書き込みに失敗すると、TaskはFAILEDになります。リトライの合計時間(flush.retry.delay.ms×flush.max.retries)がmax.poll.interval.ms(デフォルト5分)を超えるとリバランスが発生するため、それより短くします。 -
errors.toleranceとerrors.deadletterqueue.topic.nameは、Kafka Connectがシンクコネクタ共通で提供するエラー処理の設定で、対象はコネクタに渡す前の変換(キー/値/ヘッダーのConverterやSMT)で失敗したイベントだけです。none(デフォルト)では該当イベントが1件でもあるとTaskがFAILEDになり、allでは該当イベントをスキップして処理を続けます。スキップしたイベントは同期先に反映されないため、allにする場合はDLQ用のTopicを指定して退避し、後から確認・再処理できるようにします。errors.deadletterqueue.context.headers.enable=trueにすると、エラーの原因がDLQのメッセージのヘッダーに記録されます。noneのままDLQ用のTopicを指定すると、コネクタの起動に失敗します(Debezium 3.7)。同期先DBへの書き込み失敗は対象外で、flush.max.retriesの再試行後もエラーならTaskがFAILEDになります。
参考:Debezium connector for JDBC - Connector properties
Debeziumの動作検証
本章では、アーキテクチャの章で解説したDebeziumの内部動作を実機で確認します。検証環境は、Kafka BrokerとKafka Connect Workerが各1台の最小構成です。
動作検証は、Debezium公式の以下のチュートリアルをもとに行います。
このチュートリアルでは、Kafka、Kafka Connect(Debeziumコネクタ同梱)、MySQL(サンプルデータ付き)の3つのDockerコンテナを使用します。
本稿ではKafka Connect方式で、MySQLのinventory.customersテーブルの変更をDebezium MySQLソースコネクタで取得し、チュートリアルにはないDebezium JDBCシンクコネクタで同じMySQLサーバ内のsinkdb.customersテーブルへ反映します。
同期先テーブルへの反映結果に加えて、内部動作を理解するために、Kafka Topicに保存される変更イベントの中身も確認します。また、ソースコネクタの取得対象はinventory.customersテーブルのみに絞ります。
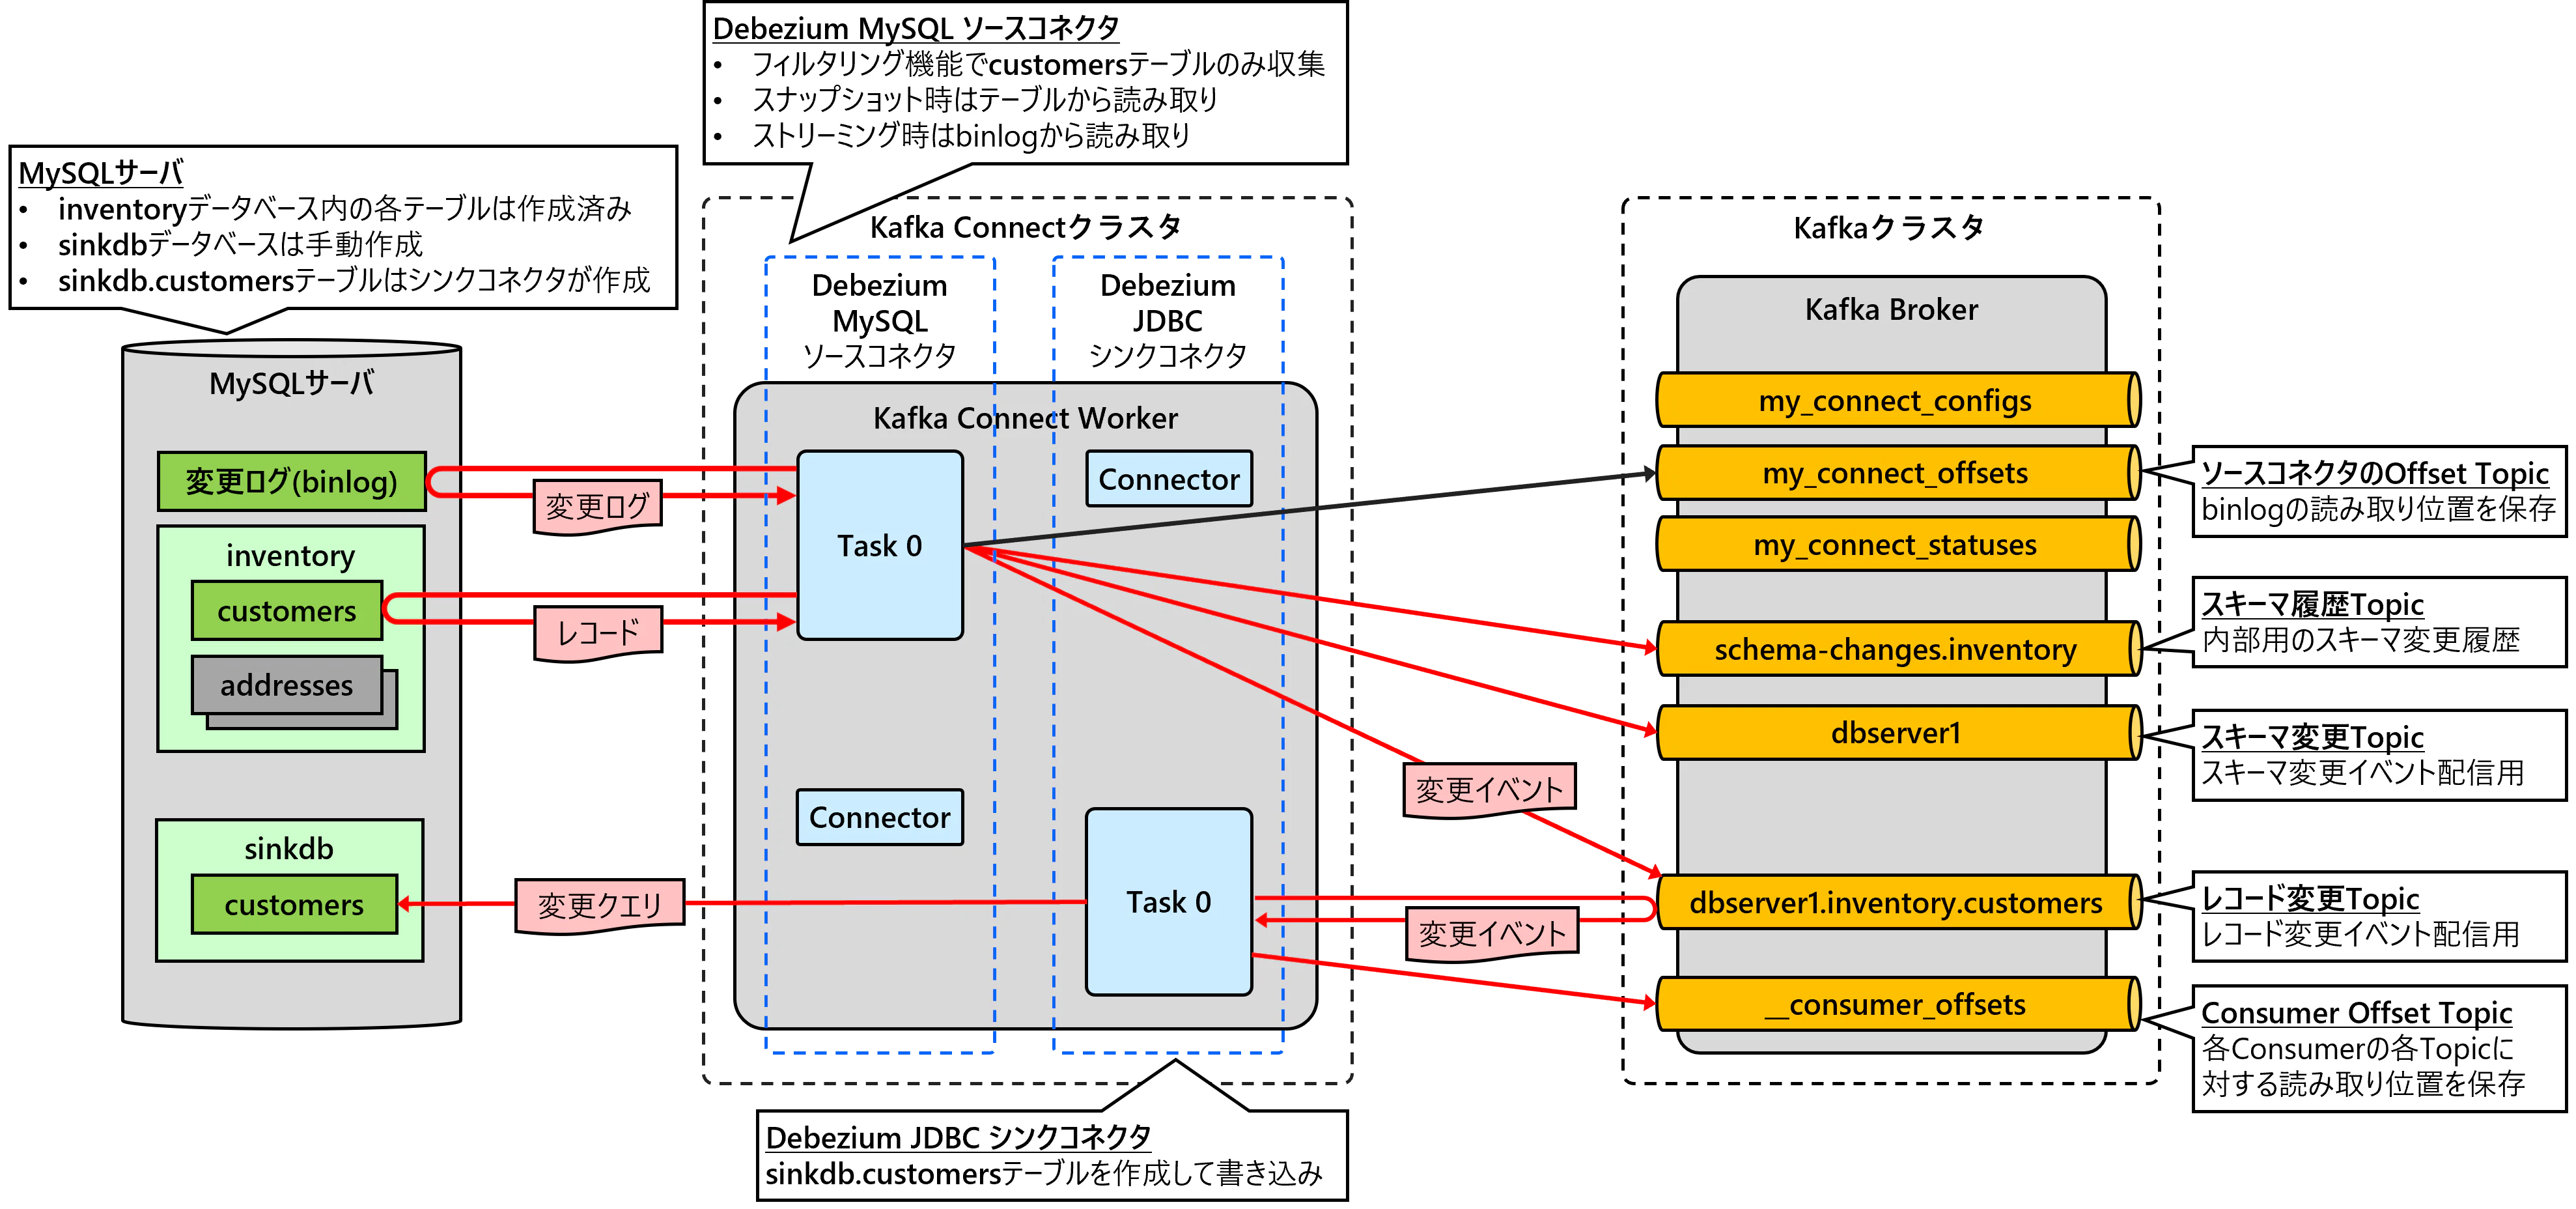
確認項目一覧
以下の各操作について、Kafka Topicの変更イベントと、同期先テーブルへの反映結果を確認します。
| 確認項目 | 確認内容 |
|---|---|
| スナップショット | 既存レコードを一括で読み取り、Readイベント(op: r)の発生と、同期先への反映を確認 |
| INSERT(追加) | レコードをINSERTクエリで追加して、Createイベント(op: c)の発生と、同期先への反映を確認 |
| UPDATE(更新) | レコードをUPDATEクエリで更新して、Updateイベント(op: u)の発生と、同期先への反映を確認 |
| DELETE(削除) | レコードをDELETEクエリで削除して、Deleteイベント(op: d)とTombstoneの発生、同期先への反映を確認 |
| スキーマ変更 | 取得元テーブルに列を追加して、同期先への反映を確認 |
| Kafka Connectの停止と復旧 | Kafka Connect停止中のテーブル変更が、再起動後に同期先へ反映されることを確認 |
| メッセージ変換(SMT) | フラット化のSMTを適用して、変更イベントの構造の変化を確認 |
| 取得元と同期先の一致確認 | すべての操作の後に、取得元と同期先のテーブルの全行が一致することを確認 |
検証環境の概要
1台のEC2インスタンス上に検証環境を構築しました。
EC2インスタンス構成
| ホスト名 | インスタンスタイプ | OS | ストレージ(EBS) |
|---|---|---|---|
debezium-demo |
t3.large(2 vCPU、8 GiB) | Amazon Linux 2023 | gp3, 100 GiB |
コンテナ構成
| コンテナ | イメージ | 役割 |
|---|---|---|
kafka |
quay.io/debezium/kafka |
Kafka BrokerとControllerの同居(KRaftモード) |
connect |
quay.io/debezium/connect |
Kafka Connect Worker |
mysql |
quay.io/debezium/example-mysql |
MySQLサーバ(取得元inventory、同期先sinkdbは本稿で作成) |
参考:
本番環境向け設定との違い
検証環境は最小構成のため、設定とチューニングの章に記載した本番向け設定とは以下の点が異なります。
| 項目 | 本番向け | 本検証(最小構成) |
|---|---|---|
| Kafka Broker/Controllerの台数 | 3台以上 | 1台(同居) |
| Kafka Connect Workerの台数 | 2台以上 | 1台 |
Worker管理用Topicのレプリカ数(config.storage.replication.factorなど) |
3 |
1(connectイメージのデフォルト) |
変更Topicのレプリカ数(topic.creation.default.replication.factor) |
3 |
1 |
| 取得対象テーブル | 複数 |
inventory.customersの1個 |
シンクコネクタのTask数(tasks.max) |
テーブル数まで | 1 |
| シンクコネクタの購読Topicの指定 | topics.regex |
topics |
Partition割り当て方式(consumer.override.partition.assignment.strategy) |
CooperativeStickyAssignor |
指定なし(Task 1個のため不要) |
同期先テーブル名(collection.name.format) |
${topic} |
customers(固定名) |
前提環境の起動
EC2ホスト(debezium-demo)上で、Docker Composeを使って全コンテナを起動します。Composeのサービス名がそのままホスト名として名前解決されるため、コンテナ間はkafka、connect、mysqlの名前で通信します。
Dockerの準備
Amazon Linux 2023の標準リポジトリからDockerを導入し、ec2-userがsudoなしでDockerを使えるようにします。
# Amazon Linux 2023の標準リポジトリからDockerを導入
sudo dnf install -y docker jq

# 自動起動を有効化
sudo systemctl enable --now docker

# `ec2-user`を`docker`グループに追加して`sudo`なしで使えるようにする
sudo usermod -aG docker ec2-user

# dockerグループを反映
newgrp docker
Amazon Linux 2023のdockerパッケージにはDocker Composeが含まれていないため、Docker公式の手順に従ってプラグインを手動で配置します。バージョンはGitHubのリリースページで最新の安定版を確認して指定します。
# Docker composeプラグインを手動で配置
sudo mkdir -p /usr/local/lib/docker/cli-plugins
sudo curl -SL https://github.com/docker/compose/releases/download/v5.6.0/docker-compose-linux-x86_64 \
  -o /usr/local/lib/docker/cli-plugins/docker-compose
sudo chmod +x /usr/local/lib/docker/cli-plugins/docker-compose

# Docker ComposeとDockerのバージョンを確認
docker compose version
## Docker Compose version v5.6.0

docker version
## Client:
##  Version:           25.0.14
参考:Install the Docker Compose plugin
Composeファイルの作成
公式サンプルリポジトリ(debezium-examples)のdocker-compose-mysql.yamlをもとに、下記2個のファイルを作成しました。Composeファイルの内容は公式のものと同じです。公式ではイメージのバージョン(DEBEZIUM_VERSION)をシェルの環境変数で渡しますが、本稿では.envファイルに記載して、docker composeが自動で読み込むようにしています。
.env:
DEBEZIUM_VERSION=3.7.0.Final
docker-compose.yaml:
services:
  kafka:
    image: quay.io/debezium/kafka:${DEBEZIUM_VERSION}
    ports:
      - 9092:9092
      - 9093:9093
    environment:
      - CLUSTER_ID=oh-sxaDRTcyAr6pFRbXyzA
      - NODE_ID=1
      - NODE_ROLE=combined
      - KAFKA_CONTROLLER_QUORUM_VOTERS=1@kafka:9093
      - KAFKA_LISTENERS=PLAINTEXT://kafka:9092,CONTROLLER://kafka:9093
      - KAFKA_ADVERTISED_LISTENERS=PLAINTEXT://kafka:9092

  mysql:
    image: quay.io/debezium/example-mysql:${DEBEZIUM_VERSION}
    ports:
      - 3306:3306
    environment:
      - MYSQL_ROOT_PASSWORD=debezium
      - MYSQL_USER=mysqluser
      - MYSQL_PASSWORD=mysqlpw

  connect:
    image: quay.io/debezium/connect:${DEBEZIUM_VERSION}
    ports:
      - 8083:8083
    depends_on:
      - kafka
      - mysql
    environment:
      - BOOTSTRAP_SERVERS=kafka:9092
      - GROUP_ID=1
      - CONFIG_STORAGE_TOPIC=my_connect_configs
      - OFFSET_STORAGE_TOPIC=my_connect_offsets
      - STATUS_STORAGE_TOPIC=my_connect_statuses
コンテナの起動
全コンテナをまとめて起動します。connectはdepends_onでkafkaとmysqlの後に起動します。
# 全コンテナを起動
docker compose up -d

# 3つのコンテナがrunningであることを確認
docker compose ps
## NAME                 IMAGE                                        COMMAND                  SERVICE   CREATED         STATUS         PORTS
## debezium-connect-1   quay.io/debezium/connect:3.7.0.Final         "/docker-entrypoint.…"   connect   5 minutes ago   Up 5 minutes   8778/tcp, 0.0.0.0:8083->8083/tcp, [::]:8083->8083/tcp, 9092/tcp
## debezium-kafka-1     quay.io/debezium/kafka:3.7.0.Final           "/docker-entrypoint.…"   kafka     5 minutes ago   Up 5 minutes   0.0.0.0:9092-9093->9092-9093/tcp, [::]:9092-9093->9092-9093/tcp
## debezium-mysql-1     quay.io/debezium/example-mysql:3.7.0.Final   "/entrypoint.sh mysq…"   mysql     5 minutes ago   Up 5 minutes   0.0.0.0:3306->3306/tcp, [::]:3306->3306/tcp, 33060-33061/tcp
(参考)コンテナの停止:
データを初期化する場合は、全コンテナを停止して削除します。KafkaとMySQLのイメージはデータ領域を匿名ボリュームとして宣言しているため、-vを付けてボリュームも削除します。これにより、登録したコネクタの設定、Kafka Topic、MySQLのデータがすべて削除されます。
# 全コンテナを停止し、ボリュームごと削除
docker compose down -v
MySQLの確認
MySQLコンテナは、Debezium公式のサンプルイメージ(example-mysql)です。binlogが有効化され、サンプルのinventoryデータベースと、Debezium接続用ユーザ(debezium)が作成済みです。MySQLのバージョンとサンプルデータを確認します。
# mysqluserでinventoryデータベースにログイン
docker compose exec mysql mysql -u mysqluser -pmysqlpw inventory
## mysql>
-- MySQLのバージョンを確認
SELECT VERSION();
-- +-----------+
-- | VERSION() |
-- +-----------+
-- | 8.2.0     |
-- +-----------+
-- 1 row in set (0.00 sec)

-- inventoryデータベース内のテーブルを表示
SHOW TABLES;
-- +---------------------+
-- | Tables_in_inventory |
-- +---------------------+
-- | addresses           |
-- | customers           |
-- | geom                |
-- | orders              |
-- | products            |
-- | products_on_hand    |
-- +---------------------+
-- 6 rows in set (0.00 sec)

-- customersテーブルのレコードを表示(本章で確認する対象)
SELECT * FROM customers;
-- +------+------------+-----------+-----------------------+
-- | id   | first_name | last_name | email                 |
-- +------+------------+-----------+-----------------------+
-- | 1001 | Sally      | Thomas    | sally.thomas@acme.com |
-- | 1002 | George     | Bailey    | gbailey@foobar.com    |
-- | 1003 | Edward     | Walker    | ed@walker.com         |
-- | 1004 | Anne       | Kretchmar | annek@noanswer.org    |
-- +------+------------+-----------+-----------------------+
-- 4 rows in set (0.00 sec)

-- ログアウト
exit;
続けて、同期先のsinkdbデータベースを作成します。テーブルはJDBCシンクコネクタが自動作成するため、事前の作成は不要です。JDBCシンクコネクタが同期先への接続に使うユーザmysqluser(サンプルイメージで作成済み)に、sinkdbに対する全権限(テーブルの作成・変更と書き込み)を付与します。データベースの作成と権限付与にはrootユーザが必要なため、いったんmysqluserのセッションを抜けてrootでログインし直します。
# rootユーザでログイン
docker compose exec mysql mysql -u root -pdebezium
## mysql>
-- 同期先データベースを作成
CREATE DATABASE sinkdb;

-- mysqluserにsinkdbへの全権限を付与
GRANT ALL PRIVILEGES ON sinkdb.* TO 'mysqluser'@'%';
FLUSH PRIVILEGES;

-- ログアウト
exit;
Kafka Connectの確認
Kafka Connectが起動し、必要なコネクタが読み込まれていることを、REST API(ポート8083)で確認します。Kafka Connectの起動には数十秒かかるため、応答がない場合は少し待ってから再実行します。
# Kafka Connectが応答すること(versionはKafkaのバージョン)
curl -s http://localhost:8083/ | jq
## {
##   "version": "4.3.1",
##   "commit": "26b251a451ce941d",
##   "kafka_cluster_id": "oh-sxaDRTcyAr6pFRbXyzA"
## }

# 読み込まれているコネクタのプラグイン一覧を表示
curl -s http://localhost:8083/connector-plugins | jq '.[].class'
## "io.debezium.connector.jdbc.JdbcSinkConnector"
## "io.debezium.connector.mongodb.MongoDbSinkConnector"
## "io.debezium.connector.cockroachdb.CockroachDBConnector"
## "io.debezium.connector.db2.Db2Connector"
## "io.debezium.connector.db2as400.As400RpcConnector"
## "io.debezium.connector.informix.InformixConnector"
## "io.debezium.connector.mariadb.MariaDbConnector"
## "io.debezium.connector.mongodb.MongoDbConnector"
## "io.debezium.connector.mysql.MySqlConnector"
## "io.debezium.connector.oracle.OracleConnector"
## "io.debezium.connector.postgresql.PostgresConnector"
## "io.debezium.connector.spanner.SpannerConnector"
## "io.debezium.connector.sqlserver.SqlServerConnector"
## "io.debezium.connector.vitess.VitessConnector"
## "org.apache.kafka.connect.mirror.MirrorCheckpointConnector"
## "org.apache.kafka.connect.mirror.MirrorHeartbeatConnector"
## "org.apache.kafka.connect.mirror.MirrorSourceConnector"
connectイメージには、Debeziumの主なソースコネクタが同梱されています。本稿で使用するio.debezium.connector.mysql.MySqlConnectorとio.debezium.connector.jdbc.JdbcSinkConnectorが一覧に含まれていることを確認できます。
Debeziumのデプロイ
Kafka Connect上にDebeziumコネクタをデプロイします。
Debezium MySQLコネクタ(ソース)のデプロイ
ソースコネクタの設定ファイルを作成し、Kafka Connect REST APIで登録します。設定の要点は以下のとおりです。
-
table.include.listで、取得対象をinventory.customersテーブルのみにします。同期先のsinkdbは取得対象に含まれないため、書き込みを再取得することもありません。 - Topicの自動作成には、
defaultグループのpartitionsとreplication.factorが必要です。 -
topic.creation.default.partitionsは、イベントの順序を維持するため1にします。 -
topic.creation.default.replication.factorは、検証環境のBrokerが1台のため1にします。
mysql-source.json:
{
  "name": "inventory-connector",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "tasks.max": "1",
    "database.hostname": "mysql",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "dbz",
    "database.server.id": "184054",
    "topic.prefix": "dbserver1",
    "table.include.list": "inventory.customers",
    "schema.history.internal.kafka.bootstrap.servers": "kafka:9092",
    "schema.history.internal.kafka.topic": "schema-changes.inventory",
    "topic.creation.default.partitions": "1",
    "topic.creation.default.replication.factor": "1"
  }
}
# ソースコネクタを登録
curl -s -X POST http://localhost:8083/connectors \
  -H "Content-Type: application/json" \
  --data @mysql-source.json

# コネクタとTaskがRUNNINGであることを確認
curl -s http://localhost:8083/connectors/inventory-connector/status | jq
## {
##   "name": "inventory-connector",
##   "connector": {
##     "state": "RUNNING",
##     "worker_id": "172.18.0.4:8083",
##     "version": "3.7.0.Final"
##   },
##   "tasks": [
##     {
##       "id": 0,
##       "state": "RUNNING",
##       "worker_id": "172.18.0.4:8083",
##       "version": "3.7.0.Final"
##     }
##   ],
##   "type": "source"
## }
コネクタを登録するとスナップショットが始まり、続いてbinlogからの変更の取得(ストリーミング)が始まります。コネクタは以下のTopicに書き込みます。
| Topic | 内容 |
|---|---|
dbserver1 |
スキーマ変更Topic。テーブルに適用されたDDLが書き込まれる |
schema-changes.inventory |
スキーマ履歴Topic。コネクタが内部で使用する |
dbserver1.inventory.customers |
レコード変更Topic。customersテーブルの変更イベントが書き込まれる |
Topic一覧で、これら3つのTopicが作成されていることを確認します。
# Topic一覧を確認
docker compose exec kafka /kafka/bin/kafka-topics.sh \
  --bootstrap-server kafka:9092 --list
## __consumer_offsets
## dbserver1
## dbserver1.inventory.customers
## my_connect_configs
## my_connect_offsets
## my_connect_statuses
## schema-changes.inventory
上記3つ以外のTopicは、Kafka Connectの管理用Topic(my_connect_configs、my_connect_offsets、my_connect_statuses)と、KafkaがConsumerグループのOffsetを保存する内部Topic(__consumer_offsets)です。
Debezium JDBCシンクコネクタ(シンク)のデプロイ
dbserver1.inventory.customersTopicの変更イベントを、MySQLのsinkdb.customersテーブルへ反映するシンクコネクタを登録します。設定の要点は以下のとおりです。
-
topicsで購読するTopicを直接指定します。購読するTopicが1つのため、設定章のtopics.regexは使いません。 -
insert.modeはupsertにして、同じイベントを再度受け取っても結果が変わらないようにします。 -
primary.key.modeはrecord_keyにして、変更イベントのキー(取得元の主キーid)を同期先の主キーにします。 -
delete.enabledをtrueにして、取得元のDELETEを同期先に反映します。primary.key.modeがrecord_key、record_value、record_headerのいずれかである必要があります。 -
schema.evolutionはbasicにして、同期先テーブルの自動作成と列追加への追従を有効にします。 -
collection.name.formatは固定名のcustomersにします。指定しない場合はTopic名からdbserver1_inventory_customersになります。固定名は、購読するTopicが1つの場合に使えます。 -
connection.urlには、JDBCドライバのパラメータnullCatalogMeansCurrent=trueを付けます。本検証では取得元のinventoryと同期先のsinkdbが同じMySQLサーバにあり、どちらにもcustomersテーブルが存在することになるため、この指定がないとテーブルの存在確認がinventory.customersを拾い、sinkdb.customersが作成されません。 -
tasks.maxは1のため、Partition割り当て方式(consumer.override.partition.assignment.strategy)の指定は省略します。
mysql-sink.json:
{
  "name": "mysql-sink-connector",
  "config": {
    "connector.class": "io.debezium.connector.jdbc.JdbcSinkConnector",
    "tasks.max": "1",
    "topics": "dbserver1.inventory.customers",
    "connection.url": "jdbc:mysql://mysql:3306/sinkdb?nullCatalogMeansCurrent=true",
    "connection.username": "mysqluser",
    "connection.password": "mysqlpw",
    "insert.mode": "upsert",
    "delete.enabled": "true",
    "primary.key.mode": "record_key",
    "schema.evolution": "basic",
    "collection.name.format": "customers"
  }
}
# シンクコネクタを登録
curl -s -X POST http://localhost:8083/connectors \
  -H "Content-Type: application/json" \
  --data @mysql-sink.json

# コネクタとTaskがRUNNINGであることを確認
curl -s http://localhost:8083/connectors/mysql-sink-connector/status | jq
## {
##   "name": "mysql-sink-connector",
##   "connector": {
##     "state": "RUNNING",
##     "worker_id": "172.18.0.4:8083",
##     "version": "3.7.0.Final"
##   },
##   "tasks": [
##     {
##       "id": 0,
##       "state": "RUNNING",
##       "worker_id": "172.18.0.4:8083",
##       "version": "3.7.0.Final"
##     }
##   ],
##   "type": "sink"
## }
JDBCシンクコネクタはTaskの起動時に同期先DBへ接続するため、TaskがRUNNINGであれば、connectイメージに同梱されたMySQLのJDBCドライバでsinkdbへの接続に成功しています。同期先テーブルsinkdb.customersは、最初の変更イベントを受け取った時点で自動作成されます。
確認項目の実施
この節では、主に2つのターミナルを使います。1つはSQLを実行して変更イベントを発生させるMySQLクライアント用、もう1つはKafka Topicから変更イベントを読み出すKafka Consumer用で、どちらも以降の確認で開いたままにしておきます。スキーマ変更TopicやOffset Topicなど、別のTopicを一時的に読み出すときは、その都度ターミナルを追加します。
opの種別は、アーキテクチャの章の「変更イベントの種類」を参照してください。
MySQLクライアントのターミナル
以降のSQLは、次のコマンドでMySQLにログインして実行します。取得元はinventory、同期先はsinkdbのテーブルで、SQLではデータベース名を付けて区別します。
# データベースを指定せずにログイン
docker compose exec mysql mysql -u mysqluser -pmysqlpw
## mysql>
まず、取得元のcustomersテーブルの現在の内容を確認しておきます。この4行が、スナップショットで取得される既存データです。
-- 取得元テーブルの全行を表示
SELECT * FROM inventory.customers;
-- +------+------------+-----------+-----------------------+
-- | id   | first_name | last_name | email                 |
-- +------+------------+-----------+-----------------------+
-- | 1001 | Sally      | Thomas    | sally.thomas@acme.com |
-- | 1002 | George     | Bailey    | gbailey@foobar.com    |
-- | 1003 | Edward     | Walker    | ed@walker.com         |
-- | 1004 | Anne       | Kretchmar | annek@noanswer.org    |
-- +------+------------+-----------+-----------------------+
-- 4 rows in set (0.00 sec)
Kafka Consumerのターミナル
dbserver1.inventory.customersTopicを先頭から読み出します。以降、SQLを実行するたびに、このターミナルに変更イベントが出力されます。
# Topicの先頭から、キーと値を表示しながら読み出す
docker compose exec kafka /kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server kafka:9092 \
  --from-beginning \
  --formatter-property print.key=true \
  --topic dbserver1.inventory.customers
## {"schema":{...},"payload":{"id":1001}} {"schema":{...},"payload":{"before":null,"after":{"id":1001,...},"source":{...},"op":"r",...}}
## {"schema":{...},"payload":{"id":1002}} {"schema":{...},"payload":{"before":null,"after":{"id":1002,...},"source":{...},"op":"r",...}}
## {"schema":{...},"payload":{"id":1003}} {"schema":{...},"payload":{"before":null,"after":{"id":1003,...},"source":{...},"op":"r",...}}
## {"schema":{...},"payload":{"id":1004}} {"schema":{...},"payload":{"before":null,"after":{"id":1004,...},"source":{...},"op":"r",...}}
イベントは1件につき1行で、キーのJSONと値のJSONがスペース区切りで出力されます(上記は長いため...で省略しています)。起動直後に、先ほどの4行に対応するスナップショットのイベントが表示されます。内容は次節で確認します。
スナップショット
MySQLソースコネクタが起動すると、自動的にcustomersテーブルの既存4行がスナップショットで取得され、Kafka Topicに4件の読み出しイベント(イベント種別は"op": "r")が出力されます。
各イベントでは、キーと値の2つのJSONドキュメントが出力されます。キーには行の主キーが、値には取得した行の内容や操作の種類などが含まれます。以下では、idが1004の行に対応する4件目のイベントを例に、キーと値の構造を確認します。
スナップショットイベントの確認
イベントのキー
以下は、4件目のイベントのキーです。スキーマとペイロードの2つの部分から構成されており、customersテーブルの主キーidが1004の行のイベントであることを示しています。
イベントのJSONを表示
{
  // ペイロードのスキーマ
  "schema": {
    "type": "struct",
    // 主キー列のスキーマ(int32型のidという名前の必須フィールド)
    "fields": [
      {
        "type": "int32",
        "optional": false,
        "field": "id"
      }
    ],
    "optional": false,
    // キーであることを示す名前
    "name": "dbserver1.inventory.customers.Key"
  },
  // ペイロード(主キー列の値)
  "payload": {
    "id": 1004
  }
}
イベントの値
以下は、4件目のイベントの値です。スナップショットで既存の行(idが1004の行)が読み取られたことを示しています。スキーマ部分は主要な構造のみ示します。
イベントのJSONを表示
{
  "schema": {
    "type": "struct",
    "fields": [
      // イベント発生前の行の状態(オプションフィールド)
      {
        "type": "struct",
        "fields": [
          { "type": "int32",  "optional": false, "field": "id" },
          { "type": "string", "optional": false, "field": "first_name" },
          { "type": "string", "optional": false, "field": "last_name" },
          { "type": "string", "optional": false, "field": "email" }
        ],
        "optional": true,
        "name": "dbserver1.inventory.customers.Value",
        "field": "before"
      },
      // イベント発生後の行の状態(オプションフィールド。beforeと同じ構造のため省略)
      { "type": "struct", "fields": [ /* 省略 */ ], "optional": true, "name": "dbserver1.inventory.customers.Value", "field": "after" },
      // イベントのソースメタデータ(必須フィールド)
      { "type": "struct", "fields": [ /* 省略 */ ], "optional": false, "name": "io.debezium.connector.mysql.Source", "field": "source" },
      // トランザクションのメタデータ(オプションフィールド。provide.transaction.metadataが有効な場合のみ値が入る)
      { "type": "struct", "fields": [ /* 省略 */ ], "optional": true, "name": "event.block", "field": "transaction" },
      // 操作の種類(必須フィールド)
      { "type": "string", "optional": false, "field": "op" },
      // コネクタがイベントを処理した時刻(オプションフィールド)
      { "type": "int64", "optional": true, "field": "ts_ms" },
      { "type": "int64", "optional": true, "field": "ts_us" },
      { "type": "int64", "optional": true, "field": "ts_ns" }
    ],
    "optional": false,
    "name": "dbserver1.inventory.customers.Envelope",
    "version": 2
  },
  "payload": {
    // イベント発生前の行の状態(スナップショットのためnull)
    "before": null,
    // イベント発生後の行の状態
    "after": {
      "id": 1004,
      "first_name": "Anne",
      "last_name": "Kretchmar",
      "email": "annek@noanswer.org"
    },
    // イベントのソースメタデータ
    "source": {
      "version": "3.7.0.Final",
      "connector": "mysql",
      // Topic接頭辞(topic.prefix)
      "name": "dbserver1",
      // DBで変更が発生した時刻(スナップショットでは読み取り時刻)
      "ts_ms": 1791975509000,
      // スナップショットにおけるこのイベントの位置(last:最後のイベント)
      "snapshot": "last",
      // 影響を受けたデータベース名・テーブル名
      "db": "inventory",
      "sequence": null,
      "ts_us": 1791975509000000,
      "ts_ns": 1791975509000000000,
      "table": "customers",
      // MySQLサーバID(スナップショットではbinlog由来でないため0)
      "server_id": 0,
      "gtid": null,
      // スナップショット開始時点のbinlogファイル名と位置。ストリーミングはここから開始する
      "file": "mysql-bin.000003",
      "pos": 751,
      // イベント内の行番号
      "row": 0,
      // 変更を行ったMySQLスレッドID
      "thread": null,
      "query": null
    },
    "transaction": null,
    // 操作の種類(r:スナップショットによる読み取り)
    "op": "r",
    // コネクタがイベントを処理した時刻(Kafka Connectタスクを実行しているJVMのシステムクロック)
    "ts_ms": 1791975509355,
    "ts_us": 1791975509355727,
    "ts_ns": 1791975509355727110
  }
}
- 4件のイベントはいずれも
"op": "r"で、beforeはnull、afterの内容は節の冒頭で確認した取得元テーブルの4行と一致しています。 -
source.snapshotは、イベントがスナップショットのどの位置にあたるかを示します。今回の4件では、1件目がfirst、2件目と3件目がtrue、4件目(最後)がlastでした。 - スキーマの
snapshotフィールドは列挙型(io.debezium.data.Enum)で、取りうる値としてtrue、first、first_in_data_collection、last_in_data_collection、last、false、incrementalが定義されています。ストリーミングで取得したイベントではfalseになります。
同期先テーブルの確認
JDBCシンクコネクタがスナップショットのイベントを反映し、sinkdb.customersテーブルが自動作成されて、取得元と同じ4行が入っていることを確認します。
-- 同期先テーブルの全行を表示
SELECT * FROM sinkdb.customers ORDER BY id;
-- +------+------------+-----------+-----------------------+
-- | id   | first_name | last_name | email                 |
-- +------+------------+-----------+-----------------------+
-- | 1001 | Sally      | Thomas    | sally.thomas@acme.com |
-- | 1002 | George     | Bailey    | gbailey@foobar.com    |
-- | 1003 | Edward     | Walker    | ed@walker.com         |
-- | 1004 | Anne       | Kretchmar | annek@noanswer.org    |
-- +------+------------+-----------+-----------------------+
-- 4 rows in set (0.00 sec)
取得元と同じ4行が、同期先のsinkdb.customersテーブルに反映されています。
INSERT(追加)
レコードを1件追加して、追加イベント(op: c)の取得と、同期先への反映を確認します。
取得元テーブルへの行の追加
INSERT INTO inventory.customers (first_name, last_name, email)
VALUES ('Alex', 'Smith', 'alex.smith@example.com');

-- 追加した行のidと内容を確認(idはAUTO_INCREMENTで採番される)
SELECT * FROM inventory.customers WHERE email = 'alex.smith@example.com';
-- +------+------------+-----------+------------------------+
-- | id   | first_name | last_name | email                  |
-- +------+------------+-----------+------------------------+
-- | 1005 | Alex       | Smith     | alex.smith@example.com |
-- +------+------------+-----------+------------------------+
-- 1 row in set (0.00 sec)
追加した行にはidとして1005が採番されました。
追加イベントの確認
Kafka Consumerのターミナルに、追加した行のイベントが出力されることを確認します。
以下は、追加イベントのキーと値です。スキーマはスナップショットのイベントと同じため省略し、ペイロードのみ示します。
イベントのキー:
イベントのJSONを表示
{
  "schema": { /* 省略 */ },
  // 追加した行の主キー
  "payload": {
    "id": 1005
  }
}
イベントの値:
イベントのJSONを表示
{
  "schema": { /* 省略 */ },
  "payload": {
    // 追加前の行は存在しない
    "before": null,
    // 追加した行の内容
    "after": {
      "id": 1005,
      "first_name": "Alex",
      "last_name": "Smith",
      "email": "alex.smith@example.com"
    },
    "source": {
      "version": "3.7.0.Final",
      "connector": "mysql",
      "name": "dbserver1",
      // DBでINSERTがコミットされた時刻
      "ts_ms": 1791978319000,
      // ストリーミングで取得したイベントのためfalse
      "snapshot": "false",
      "db": "inventory",
      "sequence": null,
      "ts_us": 1791978319000000,
      "ts_ns": 1791978319000000000,
      "table": "customers",
      // 変更を記録したMySQLサーバのserver_id(スナップショットの0とは異なり、binlogの値)
      "server_id": 223344,
      "gtid": null,
      // 変更が記録されたbinlogファイル名と位置
      "file": "mysql-bin.000003",
      "pos": 2078,
      "row": 0,
      // INSERTを実行したMySQLのスレッドID
      "thread": 26,
      "query": null
    },
    "transaction": null,
    // 操作の種類(c:追加)
    "op": "c",
    // コネクタがイベントを処理した時刻
    "ts_ms": 1791978320004,
    "ts_us": 1791978320004927,
    "ts_ns": 1791978320004927940
  }
}
- イベント種別は
"op": "c"で、beforeはnull、afterは追加した行の内容と一致しています。キーのidも、MySQLで採番された1005と一致しています。 - スナップショットのイベントと異なり、
source.snapshotはfalse、server_idとthreadにはbinlogに記録された値が入っています。source.ts_msはDBでコミットされた時刻、ペイロード直下のts_msはコネクタが処理した時刻で、その差が取得の遅延にあたります。
同期先テーブルの確認
-- 追加した行が同期先に反映されていることを確認
SELECT * FROM sinkdb.customers WHERE email = 'alex.smith@example.com';
-- +------+------------+-----------+------------------------+
-- | id   | first_name | last_name | email                  |
-- +------+------------+-----------+------------------------+
-- | 1005 | Alex       | Smith     | alex.smith@example.com |
-- +------+------------+-----------+------------------------+
-- 1 row in set (0.00 sec)
取得元で追加した行と同じid、first_name、last_name、emailが、同期先に反映されています。
UPDATE(更新)
レコードを1件更新して、更新イベント(op: u)の取得と、同期先への反映を確認します。
取得元テーブルの行の更新
-- id=1004の行のfirst_nameを更新
UPDATE inventory.customers SET first_name='Anne Marie' WHERE id=1004;

-- 更新後の行を確認
SELECT * FROM inventory.customers WHERE id=1004;
-- +------+------------+-----------+--------------------+
-- | id   | first_name | last_name | email              |
-- +------+------------+-----------+--------------------+
-- | 1004 | Anne Marie | Kretchmar | annek@noanswer.org |
-- +------+------------+-----------+--------------------+
-- 1 row in set (0.00 sec)
更新イベントの確認
Kafka Consumerのターミナルに、更新イベントが出力されます。キーはスナップショットのイベントと同じ{"id": 1004}です。
以下は、更新イベントの値です。スキーマに変更はないため省略し、ペイロードのみ示します。
イベントのJSONを表示
{
  "schema": { /* 省略 */ },
  "payload": {
    // 更新前の行の内容
    "before": {
      "id": 1004,
      "first_name": "Anne",
      "last_name": "Kretchmar",
      "email": "annek@noanswer.org"
    },
    // 更新後の行の内容
    "after": {
      "id": 1004,
      "first_name": "Anne Marie",
      "last_name": "Kretchmar",
      "email": "annek@noanswer.org"
    },
    "source": {
      "version": "3.7.0.Final",
      "connector": "mysql",
      "name": "dbserver1",
      // DBでUPDATEがコミットされた時刻
      "ts_ms": 1791978691000,
      "snapshot": "false",
      "db": "inventory",
      "sequence": null,
      "ts_us": 1791978691000000,
      "ts_ns": 1791978691000000000,
      "table": "customers",
      "server_id": 223344,
      "gtid": null,
      // 変更が記録されたbinlogファイル名と位置(INSERTのイベントより後ろ)
      "file": "mysql-bin.000003",
      "pos": 2759,
      "row": 0,
      "thread": 26,
      "query": null
    },
    "transaction": null,
    // 操作の種類(u:更新)
    "op": "u",
    // コネクタがイベントを処理した時刻
    "ts_ms": 1791978691909,
    "ts_us": 1791978691909180,
    "ts_ns": 1791978691909180069
  }
}
- イベント種別は
"op": "u"で、beforeに更新前、afterに更新後の行の内容が入っています。両者を比較すると、first_nameだけが変わったことが分かります。 -
sourceのfileとposは、この変更が記録されたbinlogの位置です。INSERTのイベント(pos: 2078)より後ろの位置になっており、sourceの値を比較することで、イベント同士の前後関係や、同じトランザクションで発生したかどうかを判断できます。
同期先テーブルの確認
-- 更新が同期先に反映されていることを確認
SELECT * FROM sinkdb.customers WHERE id = 1004;
-- +------+------------+-----------+--------------------+
-- | id   | first_name | last_name | email              |
-- +------+------------+-----------+--------------------+
-- | 1004 | Anne Marie | Kretchmar | annek@noanswer.org |
-- +------+------------+-----------+--------------------+
-- 1 row in set (0.00 sec)
同期先のfirst_nameもAnne Marieに更新されています。
DELETE(削除)とTombstone
レコードを1件削除して、削除イベント(op: d)とTombstoneの出力、および同期先への反映を確認します。
Tombstoneは、削除イベントの直後に送信される、同じキーで値がnullのメッセージです(tombstones.on.delete、デフォルトtrue)。ログ圧縮を有効にしたTopicで、削除された行のキーのメッセージを消去するためのものです。本検証のTopicにはログ圧縮を設定していないため、確認できるのはTombstoneの出力までです。
取得元テーブルの行の削除
addressesテーブルが外部キーでcustomersテーブルを参照しているため、先にaddressesテーブルの該当行を削除してから、customersテーブルの行を削除します。addressesテーブルは取得対象外のため、その削除に対する変更イベントは出力されません。
-- 外部キーで参照している行を先に削除
DELETE FROM inventory.addresses WHERE customer_id=1004;

-- customersテーブルの行を削除
DELETE FROM inventory.customers WHERE id=1004;
削除イベントとTombstoneの確認
Kafka Consumerのターミナルに、2つのイベントが続けて出力されます。キーはどちらも{"id": 1004}です。
1つ目は削除イベントです。以下はその値で、スキーマは省略しています。
イベントのJSONを表示
{
  "schema": { /* 省略 */ },
  "payload": {
    // 削除前の行の内容(UPDATEで更新した後の値)
    "before": {
      "id": 1004,
      "first_name": "Anne Marie",
      "last_name": "Kretchmar",
      "email": "annek@noanswer.org"
    },
    // 削除後の行は存在しない
    "after": null,
    "source": {
      "version": "3.7.0.Final",
      "connector": "mysql",
      "name": "dbserver1",
      // DBでDELETEがコミットされた時刻
      "ts_ms": 1791978838000,
      "snapshot": "false",
      "db": "inventory",
      "sequence": null,
      "ts_us": 1791978838000000,
      "ts_ns": 1791978838000000000,
      "table": "customers",
      "server_id": 223344,
      "gtid": null,
      // 変更が記録されたbinlogファイル名と位置
      "file": "mysql-bin.000003",
      "pos": 3896,
      "row": 0,
      "thread": 26,
      "query": null
    },
    "transaction": null,
    // 操作の種類(d:削除)
    "op": "d",
    // コネクタがイベントを処理した時刻
    "ts_ms": 1791978838425,
    "ts_us": 1791978838425925,
    "ts_ns": 1791978838425925807
  }
}
2つ目はTombstoneイベントです。Kafka Consumerのターミナルには、キーのJSONに続けて値のnullだけが表示されます。
イベントのJSONを表示
// キー
{
  "schema": { /* 省略 */ },
  "payload": {
    "id": 1004
  }
}
// 値
null
- 削除イベントは
"op": "d"で、beforeに削除前の行の内容が入り、afterはnullです。INSERTとはbeforeとafterの関係が逆になります。 - Tombstoneイベントは、削除イベントと同じキーで、値が
nullのメッセージです。tombstones.on.deleteがデフォルトのtrueのため、削除イベントの直後に送信されています。 - JDBCシンクコネクタは、
delete.enabled=trueの場合、削除イベントとTombstoneのどちらを受け取っても、同期先の該当行を削除します。
同期先テーブルの確認
-- 削除が同期先に反映され、行が存在しないことを確認
SELECT * FROM sinkdb.customers WHERE id = 1004;
-- Empty set (0.00 sec)
同期先のidが1004の行も削除され、結果は0行になっています。
スキーマ変更
取得元テーブルに列を追加して、同期先への反映を確認します。Kafka ConsumerとMySQLクライアントのターミナルは、前節のものをそのまま使います。
取得元テーブルへの列の追加
-- phone列を追加
ALTER TABLE inventory.customers ADD COLUMN phone VARCHAR(20);

-- 追加した列に値を設定
UPDATE inventory.customers SET phone='090-0000-0000' WHERE id=1001;
-- Query OK, 1 row affected (0.01 sec)
-- Rows matched: 1  Changed: 1  Warnings: 0
変更イベントの確認
DDLは、スキーマ変更Topic(dbserver1)に書き込まれます。customersテーブルのレコード変更Topicには、列の追加だけではイベントは出力されません。スキーマ変更Topicに出力されたDDLイベントと、レコード変更Topicに出力されたUPDATEのイベントをそれぞれ確認します。
スキーマ変更Topicの確認
Kafka Consumerのターミナルはdbserver1.inventory.customersTopicを読み出し続けているので、スキーマ変更Topicは別のターミナルで読み出します。スナップショット時に取得したテーブル構造(CREATE TABLE)に続いて、今回のALTER TABLEのイベントが出力されることを確認します。
# スキーマ変更Topicを先頭から読み出す(確認後はCtrl+Cで終了)
docker compose exec kafka /kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server kafka:9092 \
  --from-beginning \
  --topic dbserver1
## {"schema":{...},"payload":{"source":{...,"snapshot":"true",...},"ts_ms":1791975508807,"databaseName":"","schemaName":null,"ddl":"SET character_set_server=utf8mb4, collation_server=utf8mb4_0900_ai_ci","tableChanges":[]}}
## {"schema":{...},"payload":{"source":{...,"snapshot":"true",...},"ts_ms":1791975508847,"databaseName":"inventory","schemaName":null,"ddl":"DROP TABLE IF EXISTS `inventory`.`addresses`","tableChanges":[{"type":"DROP",...}]}}
## (スナップショット時に記録されたDDLイベントが続く)
## {"schema":{...},"payload":{"source":{...,"snapshot":"false",...},"ts_ms":1791979043833,"databaseName":"inventory","schemaName":null,"ddl":"ALTER TABLE inventory.customers ADD COLUMN phone VARCHAR(20)","tableChanges":[{"type":"ALTER",...}]}}
最初に、スナップショット時に記録されたDDLイベントが出力されます。table.include.listで取得対象をcustomersに絞っていても、スナップショットではinventoryデータベース内の全テーブルの構造を取得するため、6テーブル分のDROP TABLEやCREATE TABLEが含まれます。最後に、今回実行したALTER TABLEのイベントが出力されます。
以下は、ALTER TABLEのイベントの値です。スキーマは省略し、tableChangesの列定義はphone列のみ示します。
イベントのJSONを表示
{
  "schema": { /* 省略 */ },
  "payload": {
    "source": {
      "version": "3.7.0.Final",
      "connector": "mysql",
      "name": "dbserver1",
      // DDLがコミットされた時刻
      "ts_ms": 1791979043000,
      // ストリーミングで取得したイベント(スナップショット時のDDLはtrue)
      "snapshot": "false",
      "db": "inventory",
      "sequence": null,
      "ts_us": 1791979043000000,
      "ts_ns": 1791979043000000000,
      "table": "customers",
      "server_id": 223344,
      "gtid": null,
      // DDLが記録されたbinlogファイル名と位置
      "file": "mysql-bin.000003",
      "pos": 4431,
      "row": 0,
      "thread": null,
      "query": null
    },
    // コネクタがイベントを処理した時刻
    "ts_ms": 1791979043833,
    "databaseName": "inventory",
    "schemaName": null,
    // 実行されたDDL文
    "ddl": "ALTER TABLE inventory.customers ADD COLUMN phone VARCHAR(20)",
    // DDL適用後のテーブル構造
    "tableChanges": [
      {
        "type": "ALTER",
        "id": "\"inventory\".\"customers\"",
        "table": {
          "defaultCharsetName": "utf8mb4",
          "primaryKeyColumnNames": ["id"],
          "columns": [
            /* id、first_name、last_name、emailの定義は省略 */
            // 追加されたphone列の定義
            {
              "name": "phone",
              "jdbcType": 12,
              "nativeType": null,
              "typeName": "VARCHAR",
              "typeExpression": "VARCHAR",
              "charsetName": "utf8mb4",
              "length": 20,
              "scale": null,
              "position": 5,
              "optional": true,
              "autoIncremented": false,
              "generated": false,
              "comment": null,
              "defaultValueExpression": null,
              "enumValues": null
            }
          ],
          "comment": null
        }
      }
    ]
  }
}
-
ddlフィールドに実行したDDL文がそのまま入り、tableChangesにDDL適用後のテーブル構造が入っています。columnsには5番目の列としてphone(VARCHAR、長さ20、optional: true)が追加されています。 - レコード変更イベントと異なり、
before/afterやopはなく、payload直下にdatabaseName、ddl、tableChangesが並ぶ構造です。
レコード変更Topicの確認
Kafka Consumerのターミナルには、UPDATEのイベントが出力されます。イベントのスキーマ(beforeとafterの構造)にphoneフィールドが追加され、ペイロードではbeforeのphoneがnull、afterのphoneが設定した値になっていることを確認します。
以下は、UPDATEイベントの値です。スキーマは省略しています。
イベントのJSONを表示
{
  // beforeとafterのスキーマにphoneフィールドが追加されている(省略)
  "schema": { /* 省略 */ },
  "payload": {
    // 更新前の行の内容(phoneは列追加直後のためnull)
    "before": {
      "id": 1001,
      "first_name": "Sally",
      "last_name": "Thomas",
      "email": "sally.thomas@acme.com",
      "phone": null
    },
    // 更新後の行の内容
    "after": {
      "id": 1001,
      "first_name": "Sally",
      "last_name": "Thomas",
      "email": "sally.thomas@acme.com",
      "phone": "090-0000-0000"
    },
    "source": {
      "version": "3.7.0.Final",
      "connector": "mysql",
      "name": "dbserver1",
      "ts_ms": 1791979069000,
      "snapshot": "false",
      "db": "inventory",
      "sequence": null,
      "ts_us": 1791979069000000,
      "ts_ns": 1791979069000000000,
      "table": "customers",
      "server_id": 223344,
      "gtid": null,
      // ALTER TABLEのイベント(pos: 4431)より後ろの位置
      "file": "mysql-bin.000003",
      "pos": 4818,
      "row": 0,
      "thread": 26,
      "query": null
    },
    "transaction": null,
    // 操作の種類(u:更新)
    "op": "u",
    "ts_ms": 1791979069392,
    "ts_us": 1791979069392023,
    "ts_ns": 1791979069392023108
  }
}
beforeとafterの両方にphoneフィールドが現れ、beforeでは列追加直後の値であるnull、afterでは設定した090-0000-0000になっています。Debeziumはbeforeとafterに同じ(変更後の)テーブル構造を使うため、beforeにも追加した列が含まれます。
同期先テーブルの確認
schema.evolutionをbasicにしているため、JDBCシンクコネクタは、phoneを含む最初のイベント(UPDATE)を受け取った時に、同期先テーブルにphone列を追加します。phone列はNULLを許可するため、既存の行はNULLのまま列を追加できます。
-- 同期先テーブルの列定義を確認
DESCRIBE sinkdb.customers;
-- +------------+----------+------+-----+---------+-------+
-- | Field      | Type     | Null | Key | Default | Extra |
-- +------------+----------+------+-----+---------+-------+
-- | id         | int      | NO   | PRI | NULL    |       |
-- | first_name | longtext | NO   |     | NULL    |       |
-- | last_name  | longtext | NO   |     | NULL    |       |
-- | email      | longtext | NO   |     | NULL    |       |
-- | phone      | longtext | YES  |     | NULL    |       |
-- +------------+----------+------+-----+---------+-------+
-- 5 rows in set (0.00 sec)

-- 追加した列の値が同期先に反映されていることを確認
SELECT * FROM sinkdb.customers WHERE id = 1001;
-- +------+------------+-----------+-----------------------+---------------+
-- | id   | first_name | last_name | email                 | phone         |
-- +------+------------+-----------+-----------------------+---------------+
-- | 1001 | Sally      | Thomas    | sally.thomas@acme.com | 090-0000-0000 |
-- +------+------------+-----------+-----------------------+---------------+
-- 1 row in set (0.00 sec)
同期先テーブルにphone列が追加され、idが1001の行に値が反映されています。
同期先テーブル自動作成時の注意点:
同期先の文字列型の列は、取得元のVARCHAR(255)やVARCHAR(20)ではなくlongtextで作成されています。JDBCシンクコネクタは変更イベントのスキーマ(Kafka ConnectのSTRING型)から列の型を決めるため、デフォルトでは取得元の長さの情報を持たず、MySQLではlongtextになります。取得元と同じ型で作成したい場合は、ソースコネクタでcolumn.propagate.source.typeを設定して、取得元の型と長さをイベントのスキーマに含めます。
Kafka Connectの停止と復旧
Kafka Connectが停止している間に取得元テーブルを変更しても、再起動後に変更を取りこぼさず取得し、同期先へ反映されることを確認します。
ソースコネクタとシンクコネクタは、同じKafka Connect上で動作しています。そのため、connectコンテナを停止すると、両方のコネクタが停止します。
再起動後は、それぞれ次の位置から処理を再開します。
- ソースコネクタ:Kafkaに保存した、読み取り済みのbinlogの位置(Offset)から再開します。停止中の変更も取得できます(停止中に該当するbinlogが削除されていないことが前提です。binlogの保持期間は
binlog_expire_logs_secondsで設定します)。 - シンクコネクタ:Kafka Topicの、読み取り済みの位置から再開します。
ソースコネクタのOffsetは、Kafka ConnectのOffset Topic(my_connect_offsets)に、コネクタ名をキーにしてbinlogのファイル名と位置が保存されています。
なお、Kafka Connectのプロセスがクラッシュした場合は、最後に保存したOffsetから再開するため、Offsetの保存前に処理していた変更イベントがTopicに重複して出力されることがあります。今回のdocker compose stopは正常停止で、停止時にOffsetが保存されるため重複は発生しません。docker compose kill connectで異常停止させると、最後のOffset保存後に処理したイベントがある場合に、この重複を再現できます。重複が発生しても、シンクコネクタはinsert.mode=upsertで同じ主キーのレコードを上書きするため、同期先テーブルの結果は変わりません。
Kafka Connectの停止
# Kafka Connectを停止(ソースコネクタとシンクコネクタの両方が停止する)
docker compose stop connect
取得元テーブルへの行の追加
-- Kafka Connectの停止中に行を追加
INSERT INTO inventory.customers (first_name, last_name, email)
VALUES ('Sarah', 'Thompson', 'kitt@acme.com');
-- Query OK, 1 row affected (0.00 sec)
Kafka Connectの停止中は、同期先に該当の行がないことを確認します。
-- 停止中は同期先に反映されない
SELECT * FROM sinkdb.customers WHERE email = 'kitt@acme.com';
-- Empty set (0.00 sec)
Kafka Connectの起動
# Kafka Connectを起動
docker compose start connect

# しばらく待ち、2つのコネクタとTaskがRUNNINGであることを確認
curl -s http://localhost:8083/connectors/inventory-connector/status | jq
## {
##   "name": "inventory-connector",
##   "connector": {
##     "state": "RUNNING",
##     "worker_id": "172.18.0.4:8083",
##     "version": "3.7.0.Final"
##   },
##   "tasks": [
##     {
##       "id": 0,
##       "state": "RUNNING",
##       "worker_id": "172.18.0.4:8083",
##       "version": "3.7.0.Final"
##     }
##   ],
##   "type": "source"
## }

curl -s http://localhost:8083/connectors/mysql-sink-connector/status | jq
## {
##   "name": "mysql-sink-connector",
##   "connector": {
##     "state": "RUNNING",
##     "worker_id": "172.18.0.4:8083",
##     "version": "3.7.0.Final"
##   },
##   "tasks": [
##     {
##       "id": 0,
##       "state": "RUNNING",
##       "worker_id": "172.18.0.4:8083",
##       "version": "3.7.0.Final"
##     }
##   ],
##   "type": "sink"
## }
Kafka Connectの再起動後、登録済みのコネクタは設定Topicから設定を読み込んで自動的に再開します。コネクタを登録し直す必要はありません。
追加イベントの確認
Kafka Consumerのターミナルに、停止中に追加した行(idは1006)のイベントが1件だけ出力されます。イベント種別が"op": "c"であることと、同じイベントが重複して出力されていないことを確認します。前節でphone列を追加済みのため、afterにもphoneが含まれます。
以下は、追加イベントの値です。スキーマは省略しています。
イベントのJSONを表示
{
  "schema": { /* 省略 */ },
  "payload": {
    "before": null,
    // 追加した行の内容(phoneは未設定のためnull)
    "after": {
      "id": 1006,
      "first_name": "Sarah",
      "last_name": "Thompson",
      "email": "kitt@acme.com",
      "phone": null
    },
    "source": {
      "version": "3.7.0.Final",
      "connector": "mysql",
      "name": "dbserver1",
      // DBでINSERTがコミットされた時刻(Kafka Connectの停止中)
      "ts_ms": 1791979607000,
      "snapshot": "false",
      "db": "inventory",
      "sequence": null,
      "ts_us": 1791979607000000,
      "ts_ns": 1791979607000000000,
      "table": "customers",
      "server_id": 223344,
      "gtid": null,
      "file": "mysql-bin.000003",
      "pos": 5846,
      "row": 0,
      "thread": 26,
      "query": null
    },
    "transaction": null,
    // 操作の種類(c:追加)
    "op": "c",
    // コネクタがイベントを処理した時刻(再起動後)
    "ts_ms": 1791979691502,
    "ts_us": 1791979691502357,
    "ts_ns": 1791979691502357598
  }
}
- イベントは
"op": "c"で1件だけ出力され、重複はありません。ソースコネクタがOffsetに記録されたbinlogの位置から読み取りを再開し、停止中に記録された変更を取得したことが分かります。 -
source.ts_ms(DBでのコミット時刻)とペイロード直下のts_ms(コネクタの処理時刻)の差は約85秒で、Kafka Connectを停止していた時間にあたります。通常のストリーミングでは、この差は1秒前後です(INSERT、UPDATE、DELETEの各節のイベントでは0.4〜1.0秒。binlogのタイムスタンプが秒精度のため、実際の遅延より最大1秒大きく見えます)。
同期先テーブルの確認
-- 停止中に追加した行が同期先に反映されていることを確認
SELECT * FROM sinkdb.customers WHERE email = 'kitt@acme.com';
-- +------+------------+-----------+---------------+-------+
-- | id   | first_name | last_name | email         | phone |
-- +------+------------+-----------+---------------+-------+
-- | 1006 | Sarah      | Thompson  | kitt@acme.com | NULL  |
-- +------+------------+-----------+---------------+-------+
-- 1 row in set (0.00 sec)
Kafka Connectの停止中に追加した行が、再起動後に同期先へ1件だけ反映されています。
メッセージ変換(SMT)
Debeziumのメッセージ変換は、変更イベントを1件ずつ選別・変換する仕組みです。Kafka Connectの機能であるSMT(Single Message Transformation)を使用し、ソースコネクタとシンクコネクタのどちらにも適用できます。用意されたSMTを使う場合は、コネクタの設定に変換処理を記述するだけで適用でき、プログラムの実装は不要です。
ここでは、フラット化のSMT(New Record State Extraction、ExtractNewRecordState)を適用し、変更イベントの構造がどう変わるかを確認します。変更イベントはbefore、after、sourceなどを含む入れ子の構造です。フラット化するとafterの内容だけが残り、列名と値のシンプルな構造になります。Debezium形式のイベントを扱えないシンクコネクタや、コンシューマ向けに使います。
参考:New Record State Extraction
Debezium JDBCシンクコネクタは、Debezium形式の変更イベントをそのまま処理できるため、フラット化は不要です。
フラット化を適用したソースコネクタのデプロイ
既存のコネクタと同期先に影響しないよう、フラット化を適用したソースコネクタを別に登録します。設定の要点は以下のとおりです。
-
name、topic.prefix、database.server.id、schema.history.internal.kafka.topicは、既存のソースコネクタと重ならない値(inventory-connector-flat、dbserver2、184055、schema-changes.inventory-flat)にします。同じMySQLサーバに複数のコネクタを接続する場合、database.server.idはコネクタごとに一意である必要があります。 -
table.include.listは既存のコネクタと同じinventory.customersです。同じテーブルを2つのコネクタで取得しても、それぞれが独立してbinlogを読むため互いに影響しません。 -
include.schema.changesをfalseにして、スキーマ変更Topic(dbserver2)は作成しません。 -
transforms以下の3つがSMTの設定です(後述)。
mysql-source-flat.json:
{
  "name": "inventory-connector-flat",
  "config": {
    "connector.class": "io.debezium.connector.mysql.MySqlConnector",
    "tasks.max": "1",
    "database.hostname": "mysql",
    "database.port": "3306",
    "database.user": "debezium",
    "database.password": "dbz",
    "database.server.id": "184055",
    "topic.prefix": "dbserver2",
    "table.include.list": "inventory.customers",
    "include.schema.changes": "false",
    "schema.history.internal.kafka.bootstrap.servers": "kafka:9092",
    "schema.history.internal.kafka.topic": "schema-changes.inventory-flat",
    "topic.creation.default.partitions": "1",
    "topic.creation.default.replication.factor": "1",
    "transforms": "unwrap",
    "transforms.unwrap.type": "io.debezium.transforms.ExtractNewRecordState",
    "transforms.unwrap.add.fields": "op,table"
  }
}
SMTに関する設定は以下のとおりです。
| 設定 | 値 | 説明 |
|---|---|---|
transforms |
unwrap |
適用するSMTに付ける任意の名前。複数ある場合はカンマ区切りで、記載順に適用 |
transforms.unwrap.type |
io.debezium.transforms.ExtractNewRecordState |
SMTのクラス |
transforms.unwrap.add.fields |
op,table |
元のイベントのメタデータを__で始まるフィールドとして追加 |
transforms.unwrap.delete.tombstone.handling.mode |
tombstone(デフォルト、未指定) |
削除イベントとTombstoneの扱い |
-
transformsに付けた名前(unwrap)が、transforms.unwrap.*のように個別の設定のプレフィックスになります。 -
transforms.unwrap.delete.tombstone.handling.modeのデフォルトtombstoneでは、削除イベント(op: d)は出力されず、Tombstoneだけが出力されます。フラット化したイベントを受け取るコンシューマの多くが削除イベントを扱えないためで、削除を伝えたい場合はrewrite(__deleted: trueを付けて出力)などに変更します。本節では削除は扱いません。
# フラット化を適用したソースコネクタを登録
curl -s -X POST http://localhost:8083/connectors \
  -H "Content-Type: application/json" \
  --data @mysql-source-flat.json

# コネクタとTaskがRUNNINGであることを確認
curl -s http://localhost:8083/connectors/inventory-connector-flat/status | jq
## {
##   "name": "inventory-connector-flat",
##   "connector": {
##     "state": "RUNNING",
##     "worker_id": "172.18.0.4:8083",
##     "version": "3.7.0.Final"
##   },
##   "tasks": [
##     {
##       "id": 0,
##       "state": "RUNNING",
##       "worker_id": "172.18.0.4:8083",
##       "version": "3.7.0.Final"
##     }
##   ],
##   "type": "source"
## }

# 3つのコネクタがすべてRUNNINGであることを確認
curl -s "http://localhost:8083/connectors?expand=status" | jq 'map_values(.status.connector.state)'
## {
##   "mysql-sink-connector": "RUNNING",
##   "inventory-connector": "RUNNING",
##   "inventory-connector-flat": "RUNNING"
## }
既存の2つのコネクタもRUNNINGのままです。database.server.idを既存のコネクタと別の値にしたことで、同じMySQLサーバに2つのソースコネクタが接続した状態になっています。
フラット化したイベントの確認
別のターミナルで、フラット化用コネクタのレコード変更Topic(dbserver2.inventory.customers)を読み出します。
# フラット化したイベントを先頭から読み出す
docker compose exec kafka /kafka/bin/kafka-console-consumer.sh \
  --bootstrap-server kafka:9092 \
  --from-beginning \
  --formatter-property print.key=true \
  --topic dbserver2.inventory.customers
## {"schema":{...},"payload":{"id":1001}} {"schema":{...},"payload":{"id":1001,"first_name":"Sally","last_name":"Thomas","email":"sally.thomas@acme.com","phone":"090-0000-0000","__op":"r","__table":"customers"}}
## {"schema":{...},"payload":{"id":1002}} {"schema":{...},"payload":{"id":1002,...,"__op":"r","__table":"customers"}}
## {"schema":{...},"payload":{"id":1003}} {"schema":{...},"payload":{"id":1003,...,"__op":"r","__table":"customers"}}
## {"schema":{...},"payload":{"id":1005}} {"schema":{...},"payload":{"id":1005,...,"__op":"r","__table":"customers"}}
## {"schema":{...},"payload":{"id":1006}} {"schema":{...},"payload":{"id":1006,...,"__op":"r","__table":"customers"}}
コネクタを登録するとスナップショットが実行され、現在のcustomersテーブルの全行(これまでの操作の結果、idが1001、1002、1003、1005、1006の5行)がイベントとして出力されます。値のペイロードは列名と値が直下に並ぶ構造で、__opには元のイベントのopの値が入るため、スナップショットのイベントでは5件ともrになっています。
以下は、1件目(idが1001)のイベントの値です。フラット化によってスキーマも単純になるため、省略せずに示します。
イベントのJSONを表示
{
  "schema": {
    "type": "struct",
    // 列と追加フィールドが同じ階層に並ぶ
    "fields": [
      { "type": "int32",  "optional": false, "field": "id" },
      { "type": "string", "optional": false, "field": "first_name" },
      { "type": "string", "optional": false, "field": "last_name" },
      { "type": "string", "optional": false, "field": "email" },
      { "type": "string", "optional": true,  "field": "phone" },
      // add.fieldsで追加したメタデータのフィールド
      { "type": "string", "optional": true,  "field": "__op" },
      { "type": "string", "optional": true,  "field": "__table" }
    ],
    "optional": false,
    // Envelopeではなく、行の構造を表すValue
    "name": "dbserver2.inventory.customers.Value"
  },
  "payload": {
    // afterの内容がペイロードの直下に展開される
    "id": 1001,
    "first_name": "Sally",
    "last_name": "Thomas",
    "email": "sally.thomas@acme.com",
    "phone": "090-0000-0000",
    // 元のイベントのopとsource.table
    "__op": "r",
    "__table": "customers"
  }
}
続いて、取得元テーブルの行を更新し、更新イベントを確認します。
-- フラット化の確認用にphone列を更新
UPDATE inventory.customers SET phone='090-1111-1111' WHERE id=1001;
-- Query OK, 1 row affected (0.01 sec)
-- Rows matched: 1  Changed: 1  Warnings: 0
以下は、更新イベントの値です。スキーマはスナップショットのイベントと同じため省略します。
イベントのJSONを表示
{
  "schema": { /* 省略 */ },
  "payload": {
    // 更新後の行の内容(元のイベントのafterに相当)
    "id": 1001,
    "first_name": "Sally",
    "last_name": "Thomas",
    "email": "sally.thomas@acme.com",
    "phone": "090-1111-1111",
    // 元のイベントのop(u:更新)とsource.table
    "__op": "u",
    "__table": "customers"
  }
}
- 元の変更イベント(
dbserver1.inventory.customers)と比べて、before、after、source、transactionの入れ子がなくなり、列名と値がペイロードの直下に並んでいます。スキーマもEnvelopeではなく行の構造を表すValueになっています。 - 更新前の値(
before)やbinlogの位置(source)は失われるため、これらが必要なコンシューマにはフラット化を適用しません。操作の種類やテーブル名が必要な場合は、add.fieldsで__opや__tableのように追加します。
取得元と同期先の一致確認
最後に、ここまでの操作をすべて終えた時点で、取得元と同期先のテーブルが同じ内容になっていることを確認します。取得元には、スナップショット時の4行にINSERTで2行(idが1005と1006)が加わり、DELETEで1行(1004)が消えた5行が残っています。SMTの節で行ったphoneの更新も、inventory-connectorが取得して同期先に反映されているはずなので、あわせて確認します。
-- 取得元テーブルの全行
SELECT * FROM inventory.customers ORDER BY id;
-- +------+------------+-----------+------------------------+---------------+
-- | id   | first_name | last_name | email                  | phone         |
-- +------+------------+-----------+------------------------+---------------+
-- | 1001 | Sally      | Thomas    | sally.thomas@acme.com  | 090-1111-1111 |
-- | 1002 | George     | Bailey    | gbailey@foobar.com     | NULL          |
-- | 1003 | Edward     | Walker    | ed@walker.com          | NULL          |
-- | 1005 | Alex       | Smith     | alex.smith@example.com | NULL          |
-- | 1006 | Sarah      | Thompson  | kitt@acme.com          | NULL          |
-- +------+------------+-----------+------------------------+---------------+
-- 5 rows in set (0.00 sec)

-- 同期先テーブルの全行
SELECT * FROM sinkdb.customers ORDER BY id;
-- +------+------------+-----------+------------------------+---------------+
-- | id   | first_name | last_name | email                  | phone         |
-- +------+------------+-----------+------------------------+---------------+
-- | 1001 | Sally      | Thomas    | sally.thomas@acme.com  | 090-1111-1111 |
-- | 1002 | George     | Bailey    | gbailey@foobar.com     | NULL          |
-- | 1003 | Edward     | Walker    | ed@walker.com          | NULL          |
-- | 1005 | Alex       | Smith     | alex.smith@example.com | NULL          |
-- | 1006 | Sarah      | Thompson  | kitt@acme.com          | NULL          |
-- +------+------------+-----------+------------------------+---------------+
-- 5 rows in set (0.00 sec)
取得元と同期先はどちらも5行で、全行の内容が一致しています。idが1001のphoneは、SMTの節で更新した090-1111-1111が同期先にも反映されており、フラット化用のコネクタを追加しても既存の同期に影響がなかったことが分かります。
以上で動作検証は完了です。検証環境を破棄する場合は、「コンテナの起動」の参考に示したdocker compose down -vで全コンテナを停止し、ボリュームごと削除します。
おわりに
本稿では、CDCとDebeziumの基本、3種類の実行方式、Kafka Connect方式のアーキテクチャと本番向けの設定・チューニングのポイントを整理しました。また、Debeziumの内部動作をMySQLテーブル間のCDCで実機確認しました。要点を以下に示します。
- 実行方式:本番環境では、分散処理と自動フェイルオーバーを備えたKafka Connect方式が基本です。Red Hat build of Debeziumの商用サポート対象も、2026年11月時点でKafka Connect方式のみです。Debezium ServerはKafkaを持たない小規模環境向け、Debezium Engineはアプリケーションへの組み込み向けです。
- 設定とチューニング:設定は、構成に必要な基本設定と、性能調整のためのチューニング設定に分かれます。チューニング設定はデフォルト値のままで動作するため、処理遅延、メモリ使用量、DB負荷を測定しながら必要な箇所だけを調整します。
本稿が、CDCの導入やDebeziumの構成を検討する際の参考になれば幸いです。
※ 本稿に記載されている会社名、製品名、サービス名等は、各社の商標または登録商標です。