
対象:
too many connectionsやmax client connections reachedに出くわした方/出くわす前に手順を決めておきたい方/「とりあえずプールサイズを上げればいい?」と思っている方
所要時間: 読むだけなら20分、手元で再現するなら2時間前後 / 使うもの: Docker、Supabase CLI、Node.js、ターミナル
確認日: 2026-11-04(料金や仕様は変わります)
前の記事(接続数のしくみ編): https://qiita.com/tomozilla/items/7cf2bc93881abb530845
サンプルコード一式(GitHub。前の記事と同じリポジトリです): https://github.com/tomozilla/connection-budget-ja-demo
前の記事では、「接続はどう数えるのか」を調べました。今回は、その続きです。もう足りなくなってしまったとき、何をするか。
正直に言うと、私はこの順番を間違えていました。エラーを見た瞬間に「プールサイズを上げよう」と思ったのです。実際に試したら、上げると悪化する場合がありました(7章)。しかも、いちばん困ったのはその前の段階でした。満杯のデータベースには、postgres でもログインできません(2章)。調べようとして、調べる手段ごと失っていたわけです。
そこで、ローカルのラボでわざと満杯にして、手当てを1つずつ試しました。この記事は、その手順書です。
0. 先に伝えておきたいこと
- 費用は0ドルです。 今回の新しい実験は、すべて自分のPCのDocker(ローカルのSupabase)で動かしました。再掲するホスト版の数字は、前の記事で使い捨てのプロジェクトを1つ作って測ったもので、そちらは約0.02ドルでした。
- 満杯にする実験は、ローカルだけです。 公開されているプロジェクトのデータベースを満杯にするのは、共有の設備に迷惑なのでやっていません。だから「満杯のとき何が起きるか」は、すべてラボの結果です。ホスト版で測ったことには、その都度「ホスト版」と書きます。
- ラボは
max_connections = 90、プーラーのプールサイズ15、クライアント上限200。ホスト版のNano/Microに近づけた設定です。 - 各実験は数回しか回していません。形は見えますが、細かい数字を信じすぎないでください。
- 試していないこと: ホスト版のデータベースを満杯にすること、満杯のときにダッシュボードのSQLエディタが動くか(クライアント接続とは別の経路ですが、満杯の状態では試していません)、ホスト版での
reserved_connections、リードレプリカ、サポートに連絡する系の復旧。 - 使ったデータは架空です。ラボのパスワードはCLIのローカル用の初期値で、本物のデータベースには使えません。
1. まず、「どの上限」に当たったのかを見分ける
ここがいちばん大事です。「接続が足りない」と言っても、上限は1つではありません。エラーの文面で、当たった上限が分かります。直し方も違います。
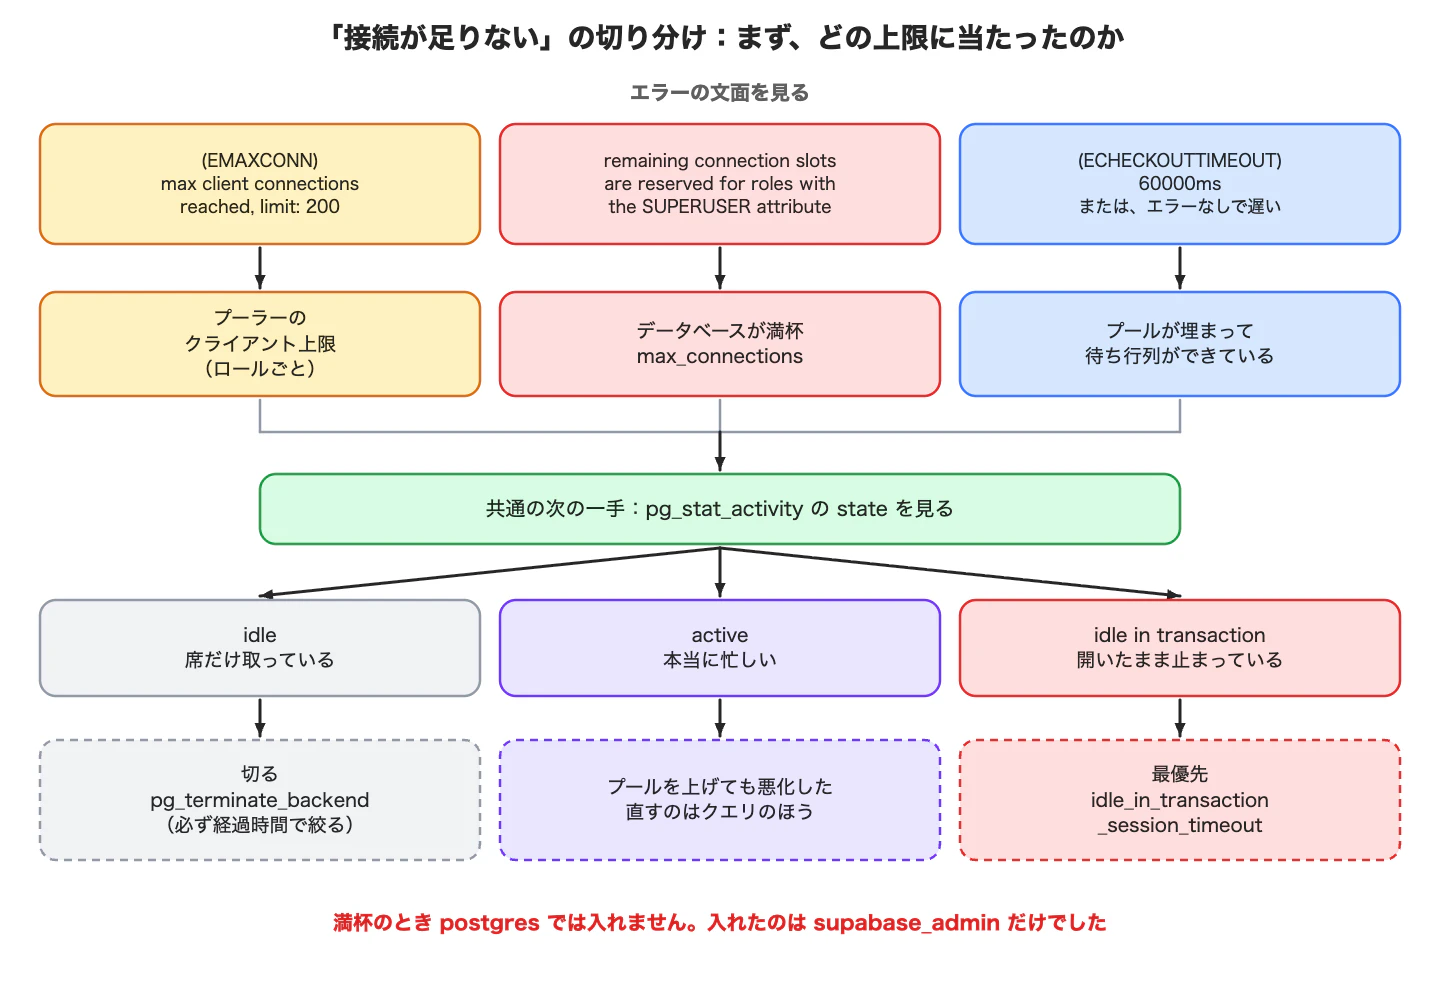
| 出ているもの | 当たった上限 | 最初にやること |
|---|---|---|
(EMAXCONN) max client connections reached, limit: 200 |
プーラーのクライアント上限(ロールごと) | アプリ1コピーあたりのプールを減らす。コピー数を減らす。6章 |
(EMAXCONNSESSION) max clients reached in session mode |
セッションモードのプール | トランザクションモードに移せないか見る |
(ECHECKOUTTIMEOUT) ... after 60000ms in Transaction mode |
トランザクションプールが埋まって、60秒待った | 7章(プールを上げるべきか、そうでないか) |
FATAL: remaining connection slots are reserved for roles with the SUPERUSER attribute(53300) |
max_connectionsそのもの |
2〜4章(満杯。いちばん重い) |
(EAUTHQUERY) authentication query failed: connection to database not available |
プーラー自身がログイン確認の接続を取れない | 同上。原因は max_connections 満杯 |
504 PGRST003 |
Data API(PostgREST)の自前のプール | 遅いクエリを探す。前の記事の7章 |
too many connections for role "..." |
ロールの CONNECTION LIMIT
|
上限がプールサイズ+1以上か確認。8章 |
| エラーは出ない。ただ遅い | 待ち行列 | 7章。p95を見る |
いちばん下の行を忘れないでください。エラーが出ていないから大丈夫、ではありません。 前の記事で測ったときは、クライアントを5人から100人に増やしても、1秒あたりにさばける数は変わらず、増えたのは待ち時間だけ(0.1秒→0.6秒)で、エラーは1件も出ませんでした。
上の3つ(EMAXCONN、EMAXCONNSESSION、ECHECKOUTTIMEOUT)はプーラーの中の話で、データベース自体はまだ余裕があるかもしれません。4つめの53300は、データベースそのものが満杯です。重さが違います。
2. 満杯のとき、あなたは入れない(ここが本当の問題)
これが、今回いちばん驚いたところです。
ラボで、max_connections(90)を使い切るまで、ロールr1でアイドルの接続を開きました。51本開いたところで、残りは拒否されました(残りは、ほかのサービスとプーラーが使っています)。
filled: held 51, refused 39
  remaining connection slots are reserved for roles with the SUPERUSER attribute
その状態で、いろいろなロールでログインを試しました。
| ログインを試したロール | 結果 |
|---|---|
r1(アプリのロール) |
失敗 remaining connection slots are reserved for roles with the SUPERUSER attribute
|
r2(別のアプリのロール) |
失敗(同上) |
postgres |
失敗(同上) |
supabase_admin |
成功(3ミリ秒) |
postgres も入れません。Supabaseでは postgres はスーパーユーザーではないので、予約枠(superuser_reserved_connections、ホスト版でもラボでも3)を使えないのです。つまり、ふだん管理に使っているロールは、いちばん必要なときに使えません。
ここから分かることは、手当てというより準備です。
- 満杯になってから入る方法を探しても、遅いです。先に決めておきます。
- ダッシュボードのSQLエディタは、クライアント接続とは別の経路で動きます(私のホスト版の確認は、満杯ではない状態でしたが、そちらは動いていました)。満杯のときにも使えるかは、確かめていません。
- PostgreSQL 17には
reserved_connectionsという枠があり、ロールにpg_use_reserved_connectionsを渡しておくと、満杯でも入れます。ラボでは動きました(前の記事の12章)。ただしホスト版でこの設定ができるかは、確かめていません(ホスト版の値は0でした)。 - 現実的には、ダッシュボードを開ける人を決めておくのがいちばん確実です。
3. 何が接続を使っているのかを見る
入れたら、まず数えます。犯人探しではなく、「どの上限に当たったか」を確かめるためです。
select usename,
       application_name,
       state,
       count(*) as n,
       max(now() - state_change)::interval(0) as longest_in_state
from pg_stat_activity
where backend_type = 'client backend'
group by 1, 2, 3
order by n desc;
見るところは3つです。
-
usename: どのロールが多いか。1つのロールだけが突出していたら、そこが原因です。supabase_auth_admin(Auth)やsupabase_storage_admin(Storage)が多いなら、アプリではなくサービス側です。 -
application_name:Supavisorならプーラー経由、PostgREST 14.xならData API、空ならたいてい直接接続です。 -
state: ここが決め手です。
state |
意味 | 読み方 |
|---|---|---|
active |
いまクエリを実行中 | 本当に忙しい。7章へ |
idle |
つないだまま、何もしていない | 席だけ取っている。4章で切れる |
idle in transaction |
トランザクションを開いたまま止まっている | いちばん危険。8章 |
idle が大量にあるなら、接続の数の問題です。active が大量なら、接続ではなくクエリの速さの問題です。この見分けを飛ばすと、7章で間違った手当てをします。
4. 止血①:切る
idle が犯人なら、切ります。即効性があります。
-- 実際の障害では、開いたばかりの接続まで切らないよう、必ず経過時間で絞ります
select pg_terminate_backend(pid)
from pg_stat_activity
where backend_type = 'client backend'
  and usename = 'r1'
  and state = 'idle'
  and now() - state_change > interval '1 minute';
ラボで、満杯の状態から実行しました。
満杯の状態で、ふつうの接続を試す → 失敗(53300)
pg_terminate_backend で r1 のアイドル接続を切る → 51本、12ミリ秒
その直後に、同じ接続を試す          → 成功(3ミリ秒)
51本が12ミリ秒で切れて、その3ミリ秒後には、ふつうの接続が通りました。 復旧は一瞬です。
注意が2つあります。
- 上のSQLで
state = 'idle'を外すと、実行中のクエリも切ります。書き込みの途中なら、そのトランザクションは巻き戻ります。まずはidleだけにしてください。 - 切られたクライアントが何を見るかは、ライブラリによります。前の記事で測ったときは、node-postgresの
Poolはerrorハンドラがないとプロセスごと落ちました(Unhandled 'error' event)。ハンドラを付けていれば、次のクエリから復帰します。プーラー経由だと、イベントすら出ずに成功しました(プーラーが裏で入れ替えたようです)。 - そして、切っても原因は消えていません。同じアプリが同じように開き直せば、数分で元どおりです。止血のあとに、8章へ進んでください。
5. 止血②:プールサイズを変える(再起動は要りません)
プーラー経由で詰まっているなら、プールサイズが効きます。ここで気になるのは「変更したら再起動が必要なのか」でした。本番で再起動は怖いですから。
ホスト版で確かめました。 8秒かかるクエリを10クライアントが同時に投げる、という同じ負荷を、プールサイズだけ変えて2回流します。変更はダッシュボードの入力欄を書き換えて保存しただけです。
| プールサイズ | 開いたバックエンド | 10本のクエリが終わるまで | エラー |
|---|---|---|---|
| 3 | 4本 | 25.3秒 | 0 |
| 15 | 10本 | 9.3秒 | 0 |
再起動なしで、すぐに効きました。 下げるほうも同じです。1つのロールが使いすぎているとき、そのプロジェクトのプールサイズを一時的に下げれば、ほかのロールに枠を戻せます。
ただし、ここで7章の落とし穴が待っています。「じゃあ上げればいいのでは」が、いつも正しいとは限りません。
6. 止血③:ロールを分ける(クライアント上限のときだけ)
EMAXCONN(クライアント上限200)に当たっているなら、話は別です。この200は、ロールごとでした。ホスト版でも確かめています。
| 試したこと(ホスト版、クエリなしの接続のみ) | 結果 |
|---|---|
| 1つのロールで215本つなぐ | ちょうど200本成功、残りは (EMAXCONN) ... limit: 200
|
| 2つのロールで150本ずつ(合計300本) | 300本すべて成功。拒否ゼロ |
なので、「バッチ用のロールを分ける」のは、EMAXCONN の応急処置として本当に効きます。
でも、ここで安心しないでください。 そのとき、データベース側のバックエンドは2本しかありませんでした(ロールごとに1本)。クエリを投げていなかったからです。
クライアント 300本(2ロール) → バックエンド 2本
つまり、ロールを足して増えるのはクライアントの枠だけで、max_connections の枠は1本も増えません。 その300本がいっせいにクエリを投げ始めたら、今度は53300のほうに当たります。混雑を消したのではなく、別の上限に移しただけです。
7. 「プールを増やせばいい」は、半分だけ正しい
ここが、この記事で私がいちばん学んだところです。
3章で見た state を思い出してください。バックエンドが idle で待っているのか、active でCPUを使っているのかで、答えが逆になります。
確かめるために、どちらも約100ミリ秒かかる2種類のクエリを用意しました。
-
wait:pg_sleep(0.1)。バックエンドは何もせず待っています(外部APIの応答待ち、ロック待ちのイメージ)。 -
cpu: 200万行のcount(*)。バックエンドはCPUを使い切っています(重い集計のイメージ)。
60クライアントで、終わったら次を投げ続けて、プールサイズ15と30で比べました(ラボ)。
| クエリ | プール15(バックエンド16本) | プール30(バックエンド31本) | どうなったか |
|---|---|---|---|
wait(待っている) |
154回/秒、p50 409ms | 295〜300回/秒、p50 204ms | さばける数がほぼ2倍、待ち時間は半分 |
cpu(CPUを使っている) |
48〜51回/秒、p50 1149〜1230ms、p95 1328〜1465ms | 38〜44回/秒、p50 1235〜1493ms、p95 1456〜2160ms | さばける数は減り、p95は悪化 |
cpu のほうは3回測って38、44、44回/秒でした。プール15の48〜51回/秒より、はっきり下です。
理由は、言われてみれば当たり前でした。CPUは増えていないからです。 31本のバックエンドで同じCPUを取り合うと、1本あたりが遅くなり、切り替えの手間が増える分だけ、全体では損をします。待っているだけのクエリなら、何本増やしても取り合うものがないので、素直に倍になります。
だから、手順はこうなります。
- 3章の
stateを見る。 -
idleや待ちが多い → プールサイズを上げる価値があります(5章。再起動なしで効きます)。 -
activeが多い → プールを上げても悪化します。直すのはクエリのほうです。pg_stat_statementsで遅いクエリを探す、インデックスを足す、返す行を減らす。それが無理なら9章(コンピュートを上げる)。
「とりあえずプールを上げる」は、2の場合だけ正解でした。
8. 原因を消す(ここをやらないと、また来ます)
接続リーク:idle in transaction
3章で idle in transaction が見えたら、最優先です。トランザクションを開いたまま止まっているので、その接続は永遠に戻りません。しかも、テーブルのバキュームまで止めます。
ラボで、begin だけして放置してみました。
state: idle in transaction, held: 2 秒(そのまま放置すれば、ずっと)
直し方は、ロールに時間制限をかけることです。
alter role r1 set idle_in_transaction_session_timeout = '5s';
試すと、5.0秒で切れました。
terminating connection due to idle-in-transaction timeout
アプリ側のバグ(例外でロールバックし忘れる、など)を直すのが本筋ですが、この設定は、直す前の保険として先に入れておけます。
1つのロールが全部を食い尽くす
ロールごとに上限をかけられます。ただし前の記事で測ったとおり、上限は「プールサイズ + 1」以上にしてください。
connection limit |
バックエンド | 40クエリ中の失敗 |
|---|---|---|
| 15(プールサイズちょうど) | 15 | 25本が即失敗 |
| 16(プールサイズ + 1) | 16 | 0(残りは待つ) |
ぴったりにすると、16本目のバックエンドが拒否されて、待てるはずのクライアントまでエラーになります。
クライアントに外されない後ろ盾
statement_timeout は、クライアントが自分で SET statement_timeout = 0 と書けてしまいます。権限では止められません。セッションの外から止める仕組みが要ります。前の記事では、pg_cron で5秒おきに見回って、6秒を超えたクエリを pg_cancel_backend するジョブを置きました。自分で制限を外したクライアントの30秒のクエリも、10〜11秒で止まりました。
接続が消えるまでの時間を見込む
クライアントを閉じても、プーラーの接続はすぐには消えません。私の実測ではラボもホスト版も約2分、ドキュメントには最大5分とあります。短いテストを続けて回すと、誰も使っていないのに満杯に見えます。 障害対応中に「切ったのに減らない」と焦らないでください。
9. 最後の手段:コンピュートを上げる
7章で「active が多い」側だったなら、最後はここです。実際に上げて、何が増えるのかを確かめました(ホスト版、使い捨てプロジェクト、2026-11-04)。
| Micro | Small | |
|---|---|---|
max_connections |
60 | 90 |
| プーラーのクライアント上限 | 200 | 400 |
| プールサイズの既定 | 15 | 15のまま |
| 月額(ダッシュボードの表示) | 9.68ドル | 14.83ドル |
接続の枠もクライアントの枠も増えました。でも、プールサイズは15のままです。 インスタンスを大きくしても、プールは自動では広がりません。5章のとおり、自分で上げる必要があります。ここを知らないと、「お金を払ったのに速くならない」になります。
費用について、もう1つ。前の記事にも書きましたが、プランを上げるだけでは接続は増えません。Nanoの60と、Pro(有料)のMicroの60は同じです。増えるのは、コンピュートのサイズを上げたときだけでした。コンピュートは時間単位の課金で、Spend Capの対象外です(ドキュメントより)。
10. 再発防止のチェックリスト
障害が落ち着いたら、ここまで戻ります。
-
満杯のときに入れる人を決める。
postgresでは入れません(2章)。 - 3章のSQLを、すぐ貼れるところに置いておく。
stateの3種類の意味も一緒に。 -
idle_in_transaction_session_timeoutをロールに入れておく(8章)。 - ロールごとの
connection limitを「プールサイズ + 1」以上で入れておく(8章)。 - クエリの時間制限は、セッションの外にも後ろ盾を置く(8章)。
- 監視は、エラーの数ではなく待ち時間のp95を見る(1章の最後の行)。
- 前の記事の式で、いまの構成が収まっているか計算しておく。ロールの数 × モードの数 × (プール + 1) + Data API + Auth + Storage + 監視。
11. つまずいたこと(正直に)
- ラボでプールサイズを30に上げたのに、バックエンドは16本のままでした。
config.tomlのdefault_pool_sizeは、すでに作られたテナントには効きません。CLIのプーラーは、設定を_supabaseデータベースの_supavisor.tenantsと_supavisor.usersに持っています。両方を30にしてsupabase_pooler_labを再起動したら、やっと31本になりました。危うく「プールを上げても何も変わらない」と書くところでした。 - 「切る」実験で、最初は経過時間で絞って切ろうとしたのですが、1本も該当しませんでした。開いたばかりの接続だったからです。実験では絞りを外して全部切りましたが、本番では必ず経過時間で絞ってください(記事のSQLはそう書いてあります)。
-
postgresで入れると思い込んでいました。2章は、その思い込みが壊れたところです。 - 最初に書いた7章は「プールを上げれば速くなる」でした。
cpuのほうを測って、逆になることが分かりました。1種類のクエリだけで測っていたら、間違った手順書を書いていました。
12. まとめ
- 「接続が足りない」は1つの症状ではありません。まずエラーの文面で、どの上限かを見分ける(1章)。
- 満杯のとき、
postgresでは入れません。入れるのはsupabase_adminだけでした。入る手段は、先に決めておく(2章)。 -
pg_stat_activityのstateを見る。idleなら接続の問題、activeならクエリの問題、idle in transactionは最優先(3章)。 - 止血は、切る(51本が12ミリ秒、復旧は3ミリ秒後)、プールサイズを変える(再起動なしで即効)、ロールを分ける(クライアント上限のときだけ)(4〜6章)。
- 「プールを増やせばいい」は半分だけ正しい。 待っているクエリなら、さばける数がほぼ倍になりました(154→295回/秒)。CPUを使うクエリでは、減りました(48→44回/秒、p95も悪化)(7章)。
- ロールを分けても、バックエンドの枠は1本も増えません。300クライアントが握っていたバックエンドは2本でした(6章)。
- 再発防止は、
idle_in_transaction_session_timeout、ロールのconnection limit(プールサイズ + 1以上)、セッションの外の後ろ盾(8章)。 - コンピュートを上げると接続もクライアント枠も増えますが、プールサイズは15のままです。自分で上げてください(9章)。
- 満杯にする実験はローカルだけです。ホスト版で確かめたのは、クライアント上限の数え方、プールサイズの即時反映、コンピュートを上げたときの値だけです。
手順書は、落ち着いているうちに作るものだと痛感しました。同じ場面に出くわした方の、最初の5分が短くなればうれしいです。