
対象: アクセスが増えたときの接続数が気になる方/
too many clientsやPGRST003が不安な方/Prisma・SQLAlchemy・Djangoの既定値が気になる方
前提: Supabaseを少し触ったことがあればOK。プーラーやpg_stat_activityは、出てきたところで説明します
所要時間: 25分 / 確認日: 2026-11-04(料金や仕様は変わります)
続きの記事(接続が足りなくなったら、何をするか): https://qiita.com/tomozilla/items/b3aa86507a7f24aa64bf
サンプルコード一式(GitHub。ラボの設定、番号つきのテスト、結果の表): https://github.com/tomozilla/connection-budget-ja-demo
ビジネス編(やさしい解説・note): https://note.com/tomozilla/n/nd25ab07546ea
「プールサイズ」(プーラーがデータベースに開く接続の最大数)を15にしたのに、データベースには30本の接続が並んでいました。その「なぜ」が分からないままでは、自分のアプリが何本使うのかも予想できません。そこで、自分のPCにNano(無料プランのいちばん小さいコンピュートサイズ)相当の上限を再現したSupabase(以下「ラボ」)を立てて、上限の先まで押してみました。ホスト版でしか分からないことは、使い捨てのプロジェクトを作って測り、同じ日に消しています。
先に、いちばん大事な3つ
危ないものから並べます。
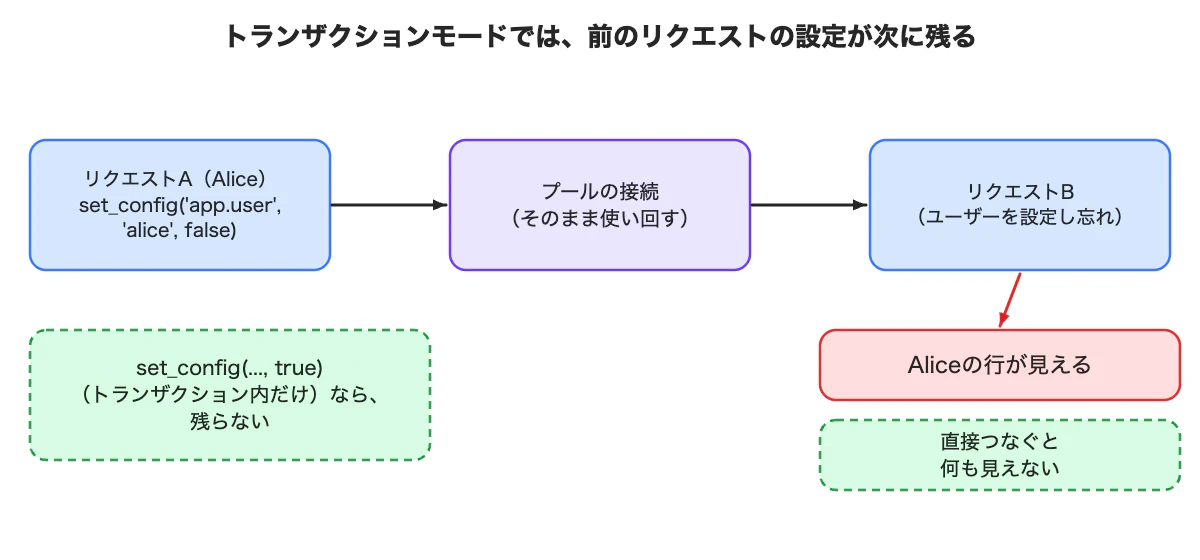
- トランザクションモード(接続文字列のポートが 6543 のとき)では、前のリクエストの設定が次のリクエストに残ります。 1本の接続をリクエストごとに別の人が使い回すためです。その結果、RLSで守ったはずの他人の行と、管理者ロールの権限まで見えました。容量ではなく、情報漏れの話です(→ 6章)。
- 接続は足し算ではなく掛け算で増えます。 プール(使い回される接続のひとかたまり)は「ロール × モード」ごとに作られ、しかもトランザクションモードは設定より1本多く使います。そしてプランを上げるだけでは接続は増えません。有料の最小構成Microの上限は、無料のNanoと同じ60でした。増えるのはコンピュートサイズを上げたときで、1つ上のSmallにすると90になります(どちらも[ホスト版]で実測。→ 1〜3章、13章)。
- 満杯になると、「新しい接続が必要なもの」から止まります。 ラボではログインが最初に壊れましたが、ホスト版のAuthは一度使われると、使い終わっても閉じずに10本ほど持ち続けるので、同じ順番になるとは限りません(→ 4〜5章)。
今日やること(5つ)
- 自分のアプリが使うライブラリとバージョンを書き出し、1コピーが何本開くか調べる(→ 7章の表)。
-
コピー数 × ライブラリのプールと、ロール数 × モード数 × (プールサイズ + 1)を、それぞれ計算する(→ 1章)。「コピー」の意味は下の用語表に書きました。 -
pg_stat_activityをusenameごとに数えて、Supabase自身のサービスが何本使っているかを引いておく(→ 5章)。 - 接続文字列のポートが 6543(トランザクションモード)なら、コードで
SETを使っていないか確認する。使っていたらset_config(..., true)に直す(→ 6章)。 - タイムアウトの「はしご」を揃える。とくにPrisma 7のpgアダプタには、既定の待ち上限がありません(→ 8章)。
どの章から読むか
| あなた | 読む章 |
|---|---|
| セキュリティが気になる | 6章(セッション状態の漏れ)だけでも |
| Prismaを使っている | 8章(タイムアウト)と 7章(既定のプール)。Prisma 6→7のアップグレードは8章 |
| サーバーレス(Vercel、Lambdaなど) | 3章(クライアント上限)と 7章(掛け算) |
| Data APIだけ使っている | 9章(PostgREST=Data APIの中身)と 5章 |
| postgres.jsを使っている | 10章(ハングの原因と対処) |
| とにかく見積もりたい | 1章 → 2章 → 5章。リポジトリに、数字を入れると見積もれる計算ページも置いてあります |
読む前に:どこで測ったか
数字には、測った場所のタグを付けます。[ラボ] は自分のPC、[ホスト版] は実際のSupabaseプロジェクト、[ドキュメント] は公式ドキュメントです。
-
[ラボ]: Nano相当の上限(
max_connections90、プールサイズ15、クライアント上限200)を再現した、ローカルのSupabase CLI環境です。上限を超える実験は、すべてここで行いました。 - [ホスト版]: 共有プーラーに迷惑をかけないよう、無料プロジェクトではプールサイズを3に下げ、数本のクライアントを数秒〜1分だけつないで、終了後に元へ戻しました。有料プランでしか見えない項目だけ、使い捨てのProプロジェクトを作って読み、同じ日に消しています。
- ラボのプーラー(Supavisor 2.9.12)はホスト版と同じオープンソースですが、設定まで同じとは限りません。
- 各実験は数回しか回していません。遅延の表は1マスにつき6秒を1回です。形は見えますが、細かい数字を信じすぎないでください。
用語(ここだけ先に読んでください)
この記事に出てくる言葉を、先にまとめます。とくに最初の2つは、混同すると以降の話が全部ずれます。
| 言葉 | 意味 |
|---|---|
| クライアント接続 | アプリ(のライブラリ)が、プーラーに向かって開く接続 |
| バックエンド接続 | プーラーやAPIが、PostgreSQL本体に対して開く接続。クライアント接続とは数も上限も別物です |
| プーラー | アプリとPostgreSQLの間に立ち、少ない接続を使い回す中継役。Supabaseが使っているソフトの名前が Supavisor |
| 共有プーラー / 専用プーラー | 共有プーラーは既定で全員が使う方。専用プーラー(PgBouncer)は有料の追加オプションで、既定では使いません |
| プールサイズ | プーラーが1つのプールでPostgreSQLに開く接続の最大数。ダッシュボードの Project Settings → Database → Connection pooling で設定します(既定15) |
| トランザクションモード / セッションモード | 接続文字列のポート番号で決まります。6543 がトランザクションモード、5432 がセッションモード。プーラーを通さない直接接続も5432ですが、ホスト名が db.<プロジェクトref>.supabase.co になります |
| コピー | 同時に動いているアプリのプロセスのこと。Vercelの関数インスタンス、gunicornのワーカー、node cluster の各プロセス、開発中のホットリロードなど |
| Nano / Micro / Small | コンピュートサイズ。Project Settings → Compute and disk で確認できます。Nanoは無料プラン |
| p50 / p95 | 速い順に並べたときの真ん中が p50、遅いほうから5%の線が p95。平均より、詰まりに気づきやすい指標です |
| prepared statement | ライブラリが「このクエリは解析済み」と名前を付けて、接続に覚えさせる仕組み。その接続が別のクライアントに渡ると、覚えが食い違って壊れます |
自分がどのモードか分からないときは、ダッシュボードの Connect ボタンから接続文字列を開き、ポート番号を見てください。 この記事のいちばん重い結果(6章)は、6543のときだけ起きます。
全体像:リクエストは、どこを通って「接続」になるのか

図の下の帯が、見落としやすいところです。あなたのアプリが1本も接続していなくても、Data API、Auth、Realtime、Storage、監視は、それぞれ自分のぶんを使っています。 その実測は5章にあります。
1. 接続は、結局何本まで使えるのか
答え: 3つの式で決まります。①バックエンドの合計 ≤ max_connections − 予約分、②クライアントの合計 ≤ プーラーの上限、③同時に使う数 = 秒間クエリ数 × 1クエリの秒数。このうち①が、いちばん先に効きます。
なぜ気にするか: この3つを混同すると、「クライアントは200まで大丈夫」と思っている間に、①の57本で先に詰まります。
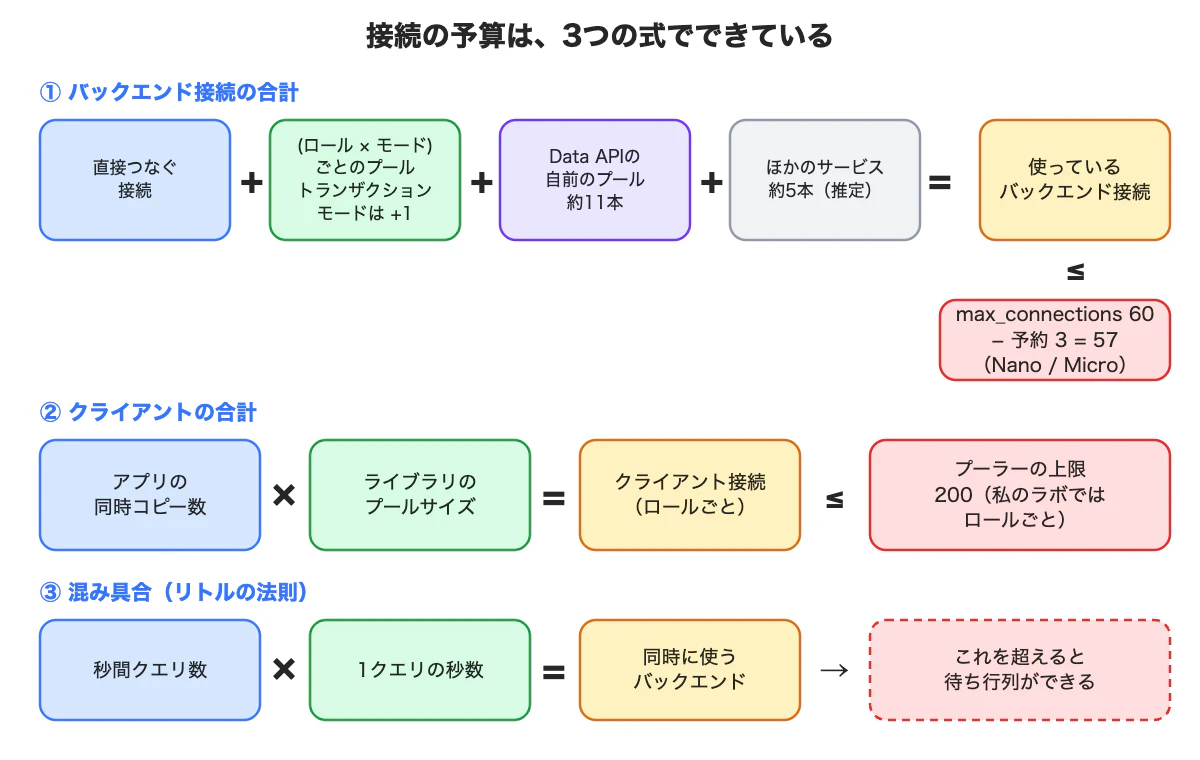
① バックエンド接続の合計
直接つなぐ接続
 + 共有プーラーのプールが開いている本数の合計
     プールは (ロール, データベース, モード) の組ごとに1つ
     1つのプールが開くのは min(そのプールのクライアント数, プールサイズ)
     ただしトランザクションモードは プールサイズ + 1
 + 専用プーラーのバックエンド接続(両方使うなら。プールサイズは、2つのプーラーに別々に効きます)
 + Data APIの自前のプール(10 + LISTEN用の1本 = 11)
 + Auth、Storage、Realtime、監視・ヘルスチェックの、それぞれの自前のプール
 ≤ max_connections − superuser_reserved_connections − reserved_connections
Nano/Microなら 60 − 3 − 0 = 57 です。予約分の内訳は superuser_reserved_connections(3)と、PostgreSQL 17の reserved_connections(既定0)で、どちらも[ホスト版]で確認しました。
自分のプロジェクトの値は、ダッシュボードのSQLエディタで次を実行すると分かります。
show max_connections;
show superuser_reserved_connections;
見落としやすいのは最後の行、つまりSupabase自身のサービスです。[ドキュメント](Pooling and limits)も合計に含めるものとして「Auth、Storage、PostgREST、ヘルスチェッカー」を挙げています。しかもこれらは本数が固定ではなく、使われると増えて、そのまま持ち続けるものもあります(→ 5章)。
② クライアント接続の合計
アプリの同時コピー数 × ライブラリのプールサイズ が、プーラーの上限(Nano/Microは200)を超えられません。この200はロールごとでした(→ 3章)。ただし「ロールを増やせば余裕ができる」とは読まないでください。増えるのはクライアントの枠だけで、①のバックエンドの枠は1本も増えません。
③ 混み具合(リトルの法則)
同時に使うバックエンド数は 秒間クエリ数 × 1クエリの秒数 です。たとえば毎秒100リクエスト・1クエリ0.2秒なら20本必要で、プールが16本(既定のプールサイズ15 + トランザクションモードの1本。→ 2章)しかなければ待ち行列ができます。
注意 [ドキュメント] Connection management の目安は「Data APIをよく使うならプールサイズは max_connections の約40%まで、使わないなら最大約80%」(Nanoなら24または48)。これが1つのプールではなく全部の合計に対する数字だというのは私の解釈ではなく、SupavisorのFAQに「プーラー全体の使用量を、使える接続の40%未満に保つように」と書かれています。
実際に当てはめると、既定のプールサイズ15でロールもモードも1つなら16本なので、24本の目安には収まります。超え始めるのは、ロールやモードが増えたときです(ロール2つ・モード2つなら、プールは4つ=64本)。
あなたがやること: ①の式に自分の数字を入れて、57(または自分のコンピュートサイズの値)と比べる。
2. プールは、何の単位で作られるのか
答え: 「ロール × データベース × モード」ごとに1つずつです。さらにトランザクションモードは、設定より1本多く使います。
なぜ気にするか: プールサイズ15でも、2ロール × 2モードならプールは4つ、4 × 16 = 64本になります。足し算で見積もっていると、ここで倍以上ずれます。
[ドキュメント](Connection management)には、こう書かれています。
このプールサイズは、プロジェクト全体の1つの合計としてではなく、データベースのユーザー(ロール)ごとに適用されます。プーラー経由でつなぐロールのそれぞれが、この本数までの独自のプールを持つので、プーラーが開ける接続の合計は、使うロールの数に比例して増えます。
モードについても測りました。同じロールに、トランザクションモードとセッションモードのクライアントを20本ずつ同時に流します。
[ラボ] r1 backends: 31   (ポート6543 = 16本 + ポート5432 = 15本)
[ホスト版] プールサイズ3で: 7   (ポート6543 = 4本 + ポート5432 = 3本)
→ モードごとに別のプールでした。 16 + 15 = 31なので、1つのプールサイズでは説明できません。
ロールを増やすと、こうなります[ラボ]。
ここからの「/ 87」は、ラボの上限です(ラボは max_connections を90にしてあり、予約3本を引いて87本使えます)。ホスト版のNano/Microなら、同じ表は「/ 57」になります。
| ロールの数 | ロールごとのバックエンド | 合計(ラボ、上限87) |
|---|---|---|
| 1 | r1: 16 | 53〜63(Supabase自身の分を含む) |
| 2 | r1: 16、r2: 16 | 70〜80 / 87 で収まる |
| 3 | r1: 15、r2: 16、r3: 7〜16 | 87 / 87、満杯 |
→ 3ロール目で上限に達しました。 1ロールずつ見れば「15本だけ」でも、掛けると超えます。
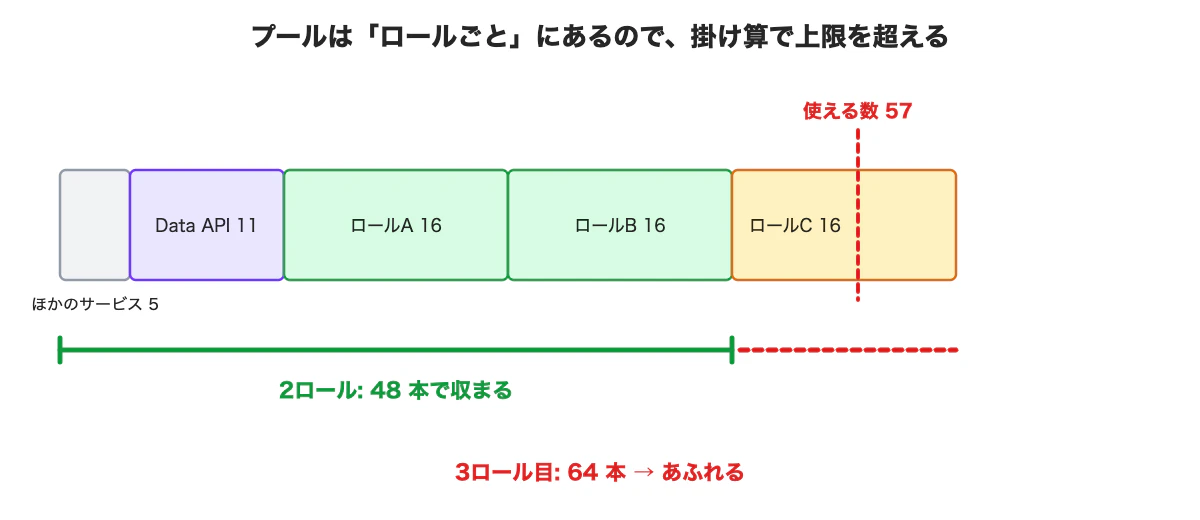
次に、表の「16」です。プールサイズ15のはずが、トランザクションモードでは16本でした。
| 入口 | プールサイズ15のときのバックエンド |
|---|---|
| Supavisor トランザクション [ラボ] | 16 |
| Supavisor セッション [ラボ] | 15 |
| PgBouncer 1.26.1(同じDBの前に置いた)[ラボ] | 15 |
→ トランザクションモードだけ、設定より1本多い。 [ホスト版]でもプールサイズ3でトランザクションが4本、セッションが3本でした。理由は分かりません。数本の差ですが、3ロールなら3本違い、「ぎりぎり収まる」と「あふれる」の境目になります。
注意 [ドキュメント] SupavisorのFAQに「クライアントがプーラーに接続している間は、少なくとも1本のホットな接続が維持されます」とあり、これが「+1」の正体かもしれません。確かめるため[ホスト版]でトランザクションモードのクライアントを1本だけつないで放置したところ、バックエンドは1本のまま137秒後も維持されていました(使われない接続は約2分で消えるので、これは「維持されている」ということです)。ただし「+1」と同じ仕組みかどうかは確かめられていません。
あなたがやること: ロール数 × モード数 × (プールサイズ + 1) で数える。粒度の書き方は[ドキュメント]内でも3通り(Connection managementは「ロールごと」、SupavisorのFAQは「ユーザー・DB・モードの組ごと」、ダッシュボードは「user+db」)あるので、いちばん多く数える「ロール × DB × モード」で見積もるのが安全です。
「ロール数」とは、自分の場合いくつか。 数えるのは、接続文字列に書いたユーザー名の種類です。ふつうのSupabaseプロジェクトなら、プーラー経由でつなぐときのユーザー名は既定で
postgresの1つだけなので、ロール数は1です。バッチ用や分析用に自分で別のロールを作れば、そのぶん増えます。
なおanonとauthenticatedは、ここでは数えません。supabase-js(Data API)を使うとき、PostgRESTがauthenticatorという1つのロールでつなぎ、リクエストごとに内部でanon/authenticatedに切り替えているからです。Data APIのぶんは、式①の「Data API 11本」で別に数えています。
3. クライアント上限の200は、プロジェクト全体? ロールごと?
答え: ロールごとです。[ホスト版]でも確かめました。ただし、ロールを足してもバックエンドの枠は増えません。
なぜ気にするか: サーバーレスで1コピー10本(node-postgresの既定)なら、21コピー目で拒否されます。そのとき「ロールを分ける」が有効な応急処置になるか否かが変わります。
まず、上限そのものの挙動です[ラボ]。
connected 200
client 201: (EMAXCONN) max client connections reached, limit: 200   (0.5 s)
→ 201本目は0.5秒で拒否され、待たされません。
次に単位です。[ドキュメント](Pooling and limits)は、この上限を「同時にプーラーへ接続できるクライアント数=コンピュートサイズで決まる値」と説明し、ロールの話は出てきません。Proプロジェクトの設定画面にも「この値はコンピュートサイズMicroに基づいて200に固定されていて、変更できません」とあります。どちらもプロジェクト単位に読めます。読むだけでは決着しないので、[ホスト版]で測りました(クエリは1本も投げず、接続を開いて数秒持つだけ)。
| 試したこと [ホスト版] | 結果 |
|---|---|
| 1つのロールで215本つなぐ |
ちょうど200本が成功、残りは (EMAXCONN) ... limit: 200
|
| 2つのロールで150本ずつ(合計300本) | 300本すべて成功。拒否ゼロ |
→ 上限はロールごとでした。 設定画面の「200に固定」は、プロジェクト全体の合計ではありません。
厳密には、Supavisorのソースが数えている単位はプール、つまりロール × モードの組です。私が測ったのはロールを分けた場合で、同じロールでモードだけ分けた場合は測っていません。見積もるときは「ロールごとに200」で数えておけば、足りなくなることはありません。
ただし、ここで喜ぶのは早すぎました。同じとき、データベース側のバックエンドはこうでした。
クライアント 300本(2ロール) → バックエンド 2本
→ クエリを投げていないので、バックエンドはロールごとに1本だけ。 つまりロールを足して増えるのはクライアントの枠だけで、①のバックエンドの枠(Nano/Microで57本)は1本も増えません。その300本がいっせいにクエリを投げ始めれば、今度は①で止まります。
あなたがやること: まずは1コピーあたりのライブラリのプールを減らす(これが根本です)。それでも足りず EMAXCONN が出るなら、ロールを分ける手もあります。その場合はSQLエディタでロールを作り、接続文字列のユーザー名を差し替えます。
create role batch_user login password '<自分で決めた強いパスワード>';
grant usage on schema public to batch_user;
-- 必要なテーブルへの権限も grant します
接続文字列のユーザー名は batch_user.<プロジェクトref> の形になります(プーラー経由の場合)。ただしこれは混雑を①に移しただけだと理解しておいてください。
4. 満杯になると、何から止まるのか
答え: そのとき新しい接続が必要なものから止まります。「Authが先」のような固定の順番ではありません。
なぜ気にするか: 「画面は動いているのに新規ログインだけができない」という、原因の分かりにくい形で現れるからです。
3つのロールでプールを使い切り、データベースを満杯(87/87)にした状態で、ほかのサービスを呼びました[ラボ]。
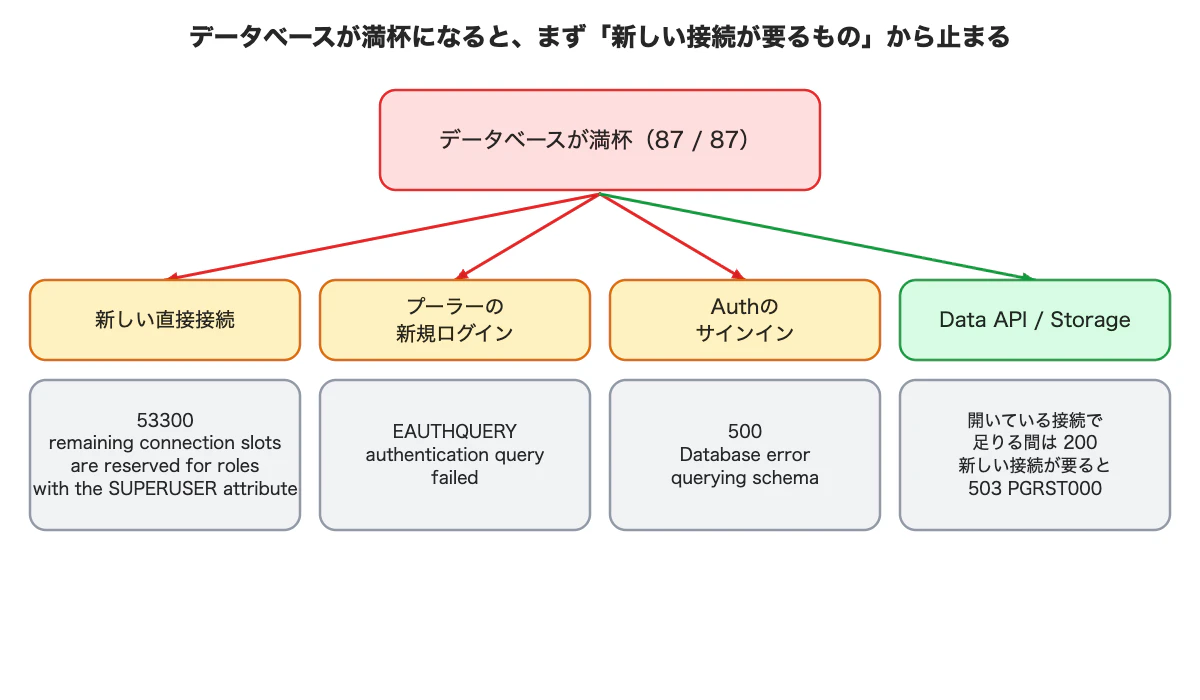
| 満杯のとき [ラボ] | 結果 |
|---|---|
| 新しい直接接続 |
FATAL: remaining connection slots are reserved for roles with the SUPERUSER attribute(53300) |
| プーラー経由の新しいログイン |
(EAUTHQUERY) authentication query failed(プーラーもログイン確認に接続を1本使う) |
| Authのサインイン/サインアップ |
500(Database error querying schema) |
Data API(rpc/ping) |
200(すでに開いている接続で足りた) |
| Storage(アップロード、一覧) |
200(同上) |
→ すでに接続を持っていたサービスは動き続け、新しく要るものだけが落ちました。
この順番は環境によって変わります。別の回に2ロールだけで満杯にしたときは、PostgRESTが新しい接続を必要とした瞬間に、Data APIが 503 PGRST000 を返しました(9章に出てくる 504 PGRST003 とは別物です。PGRST003 はプールが埋まっていて待ちきれなかったとき、PGRST000 はそもそもデータベースにつなげなかったときに出ます)。つまり「満杯ならData APIは503」とも「満杯ならAuthが先」とも言えません。
注意 [ホスト版] ラボのAuthは接続を持っていなかったので先に倒れましたが、ホスト版のAuthは一度使われると10本ほど温めて持っています(→ 5章)。そのためホスト版で同じ順番になるとは限りません。ホスト版を満杯にする実験はしていないので、ここは「ラボの順番をそのまま当てはめてはいけない」という注意までです。
もう1つ。重いクライアントが止まったあとも、サインインは約1分のあいだ HTTP 500 を返し続けました(62秒の時点でプーラーが1本手放して、やっと 200 に戻りました)。接続はすぐには戻りません(→ 11章)。
あなたがやること: 監視は「エラーが出たか」ではなく「新規ログインが通るか」を見る。具体的には、テスト用アカウントで定期的にサインインを試す外形監視(UptimeRobotのような外部サービスや、小さな定期ジョブ)を1つ置くのが手軽です。1つのロールの使いすぎが、ほかのロールやAuthまで巻き込みます。
5. Supabase自身のサービスは、何本使うのか
答え: 何もしていないときは3〜4本ですが、使われると増えます。[ホスト版]でAuthは9〜10本、Storageは8本まで増え、Storageは返しませんでした。
なぜ気にするか: 57本のうち8本が恒久的に減るなら、見積もりが8本ずれます。
まず、何もしていないときです。
表に出てくるロール名は、authenticator がData API(PostgREST)のもの、supabase_admin がSupabaseの管理・監視用、pgbouncer はプーラーがログイン確認に使うものです(名前はPgBouncer由来ですが、共有プーラーのSupavisorもこのロールを使います)。
| 環境 | 何もしていないときの使用数 |
|---|---|
| [ホスト版] Free/Nano(2026-11-03) | 4本(authenticator 1、pgbouncer 1、supabase_admin 2)。空きは 57 − 4 = 53本
|
| [ホスト版] Pro/Micro(作りたて、2026-11-04) | 3本(authenticator 1、pgbouncer 1、supabase_admin 1) |
| [ラボ] 全サービス起動 | 36本(Supavisor自身29本 + 7本)。空きは 87 − 36 = 51本(ラボは max_connections 90、予約3本を引いて87) |
ラボの「Supavisor自身29本」は、プーラーをデータベースと同じ場所で動かしているラボだけの分です。ホスト版にはこの29本はありません。
→ 空きは53本と51本でほぼ同じなので、ラボはホスト版の代わりとして使えます。
ここで、Proプロジェクトを作って分かった大きなことが1つあります。Microの max_connections は、Nanoと同じ60でした。 つまり、プランを有料にするだけでは接続は増えません。
増えるのはコンピュートサイズを上げたときです。同じプロジェクトをMicroからSmallに上げて測り直すと、こうなりました[ホスト版]。
| Micro | Small | |
|---|---|---|
max_connections |
60 | 90 |
| プーラーのクライアント上限 | 200 | 400 |
| プールサイズの既定 | 15 | 15のまま |
→ 接続もクライアント枠も増えますが、プールサイズは据え置きです。 大きいインスタンスにしても、プールは自分で広げる必要があります。
次に、使ったあとです。作りたてのプロジェクトはAuthもStorageも0本なので、そこへサインインを40本同時に、別の回に公開バケットへのリクエストを40本同時に投げ、usename ごとに数えました。
| サービス [ホスト版 Pro] | 何もしていないとき | 負荷のあと | そのあと |
|---|---|---|---|
Auth(supabase_auth_admin) |
0本 | 9〜10本 | 約1分で0本に戻った(46秒では10本、61秒で0本) |
Storage(supabase_storage_admin) |
0本 | 8本 | 14分後も8本のまま |
→ Authは借りて返すが、Storageは持ち続ける。 ファイルを1度でも配信したら、57本のうち8本は戻らないものとして見積もってください。
注意 [ドキュメント] SupavisorのFAQには「Storageサーバーも独自の user+db+mode の組み合わせとしてSupavisorを使う」とありますが、私が測ったプロジェクトではStorageの接続の application_name は Supabase Storage API で、プーラー経由(Supavisor)ではありませんでした。1プロジェクト・1回の観察なので断定はしません。
あなたがやること: 自分のプロジェクトで下のSQLを流し、式①から「サービスの分」を先に引く。
select usename, state, count(*) from pg_stat_activity
where backend_type = 'client backend' and pid <> pg_backend_pid() group by 1, 2;
6. セッションの状態は、次のクライアントに残るのか(安全の話)
答え: 残ります。 その結果、他人の行と管理者ロールの権限が見えました。これがこの記事でいちばん重い結果です。
なぜ気にするか: RLSで守っているつもりのテーブルが、設定を1つ書き忘れただけで他人に見えるからです。可用性ではなく、情報漏れです。
[ドキュメント](Connecting to Postgres)は、こう書いています。
セッションレベルの状態は、トランザクションの間で失われます。これは
setとreset、セッションレベルのアドバイザリロック、listenとnotify、一時テーブルが対象です。
「失われる」と読むと、動かなくなるだけで危なくはなさそうに思えます。ところが私が測ったのは、消えるのではなく、次のクライアントに残るほうでした。トランザクションモードでは1本のバックエンドをクエリごとに別のクライアントが使い回すので、前の人の設定がそのまま引き継がれるのです。
| 操作 | プーラー(トランザクション)[ラボ] | 直接 |
|---|---|---|
set_config('app.user','alice',false)(セッション全体) |
次のクライアントに8回中8回漏れた | 0回 |
set_config(..., true)(トランザクション内だけ) |
漏れない | 漏れない |
SET statement_timeout = 0 |
次のクライアントも0(ガードレールが静かに外れる) | 漏れない |
| セッションのアドバイザリロック | クライアントが去っても保持 | 保持しない |
| 名前つきprepared statement | prepared statement "q1" already exists |
OK |
LISTEN/NOTIFY
|
通知なし | 通知あり |
→ トランザクション内だけの設定(第3引数 true)以外は、すべて漏れました。
設定が漏れるだけなら地味に見えます。しかし、RLSのポリシーが owner = current_setting('app.user', true) を信じる作りだと、行が漏れます。
プーラー(トランザクション):
  A (alice, set_config(...,true))        : alice の行
  B (トランザクション内だけの設定のあと)  : 何も見えない      ← 安全
  A (alice, set_config(...,false))       : alice の行
  B (ユーザーの設定を忘れたリクエスト)    : alice の行が見える ← 漏れた
  A (管理作業: SET ROLE r_admin)          : alice, bob
  B (ふつうのリクエスト)                  : r_admin として、alice と bob が見える
直接:
  B は、どちらも何も見えない
→ SET ROLE は権限ごと漏れます。 管理者ロールに切り替えたあとそのバックエンドを受け取ったリクエストが、RLSを無視する r_admin として動きました。
対照としてData APIも確かめました。PostgRESTはリクエストごとの設定を、そのリクエストのトランザクションの中だけに入れます。2人のユーザーで40本の混ぜたリクエストを同時に流したところ、他人のデータを受け取ったのは0件でした。つまり、この問題は「プーラーを使うと必ず起きる」のではなく、設定の入れ方で決まります。
あなたがやること: トランザクションモードでは SET を使わない。リクエストごとにトランザクションを開き、その中で set_config(..., true) を使う。既存コードの SET と SET ROLE を今日grepしてください。
7. ライブラリは、1コピーで何本開くのか
答え: 10本前後が多いものの、バージョンで変わります。実際に動かして数えるしかありません。
なぜ気にするか: ②の式の「ライブラリのプールサイズ」がここで決まり、プロセス数と掛け算になるからです。
| ライブラリ(バージョン) | 既定のプール | 20〜30並列での実測 [ラボ] |
|---|---|---|
node-postgres 8.23.1 Pool
|
max 10 | 10 |
| postgres.js 4.0.0 | max 10 | 10 |
| Drizzle | 自前のプールなし。ドライバのもの | (pg: 10) |
| Prisma 6.19.3 | 物理コア数 × 2 + 1 | 21(10コアのMac。サーバーレスでは割り当てられたCPU数で変わるので、実測してください) |
Prisma 7.10.1 + @prisma/adapter-pg
|
pgドライバ(max 10) | 10 |
| SQLAlchemy 2.1.6 | pool_size 5 + max_overflow 10 | 15(使い終わったあとも5本残る) |
| psycopg_pool 3.3.3 | min_size 4、max_size = min_size | 4 |
| Django 5.2.18(既定) | プールなし。処理中のスレッド1つにつき1本 | 20(20スレッドで) |
Django 5.2.18 OPTIONS pool=True
|
psycopg_poolの既定 | 4 |
→ 同じPrismaでも、メジャーバージョンの間で21から10に変わりました。 ブログ記事で見た数字には、必ずバージョンが付いているか確認してください。
掛け算も測りました[ラボ]。node-postgresの Pool(max 10) を持つコピー(プロセス)を増やすと、直接接続のバックエンドは1つで10、3つで30、5つで50でした(この回だけ、50本を観察するために max_connections を150に上げています)。5コピーでNanoの上限に迫ります。 gunicornのワーカー、node cluster、開発中のホットリロードで、気づかないうちに増えます。一方、プーラー経由なら5プロセスの50クライアントは16本のバックエンドに収まりました。
あなたがやること: 自分のライブラリとバージョンで1コピーの本数を数え、コピー数 × を計算する。
8. 待たされる時間に、上限はあるのか
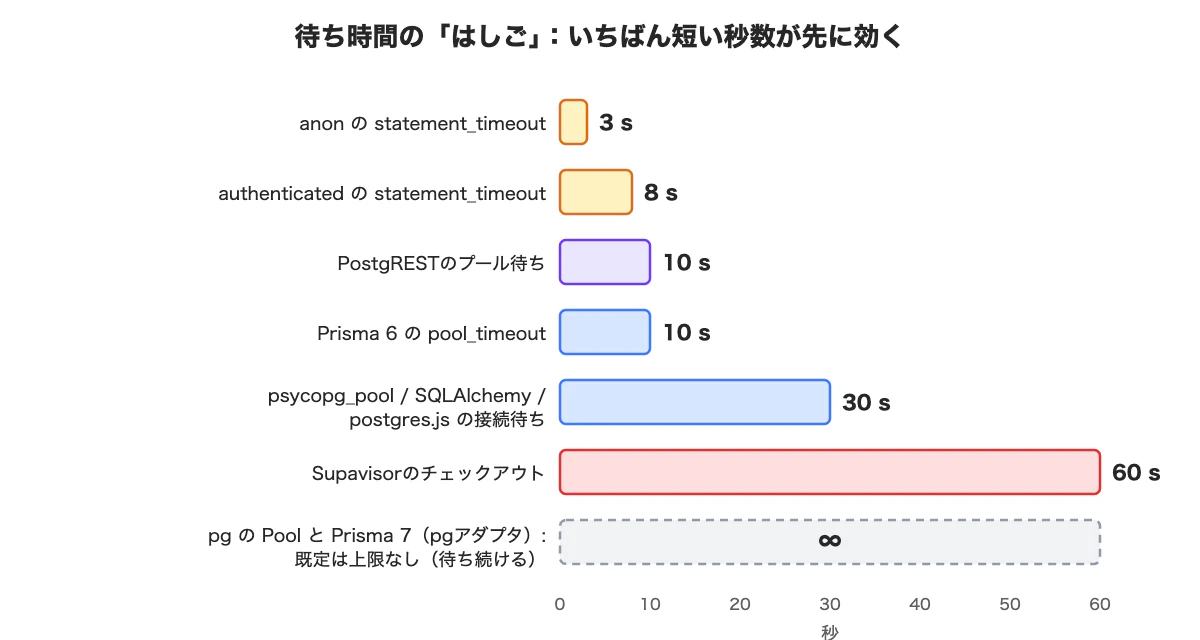
答え: あります。しかも何段も重なっていて、いちばん短いものが先に効きます。そしてPrisma 7のpgアダプタとnode-postgresには、既定の上限がありません(無限に待ちます)。
なぜ気にするか: 上限がばらばらだと、どこで失敗するかが予想できません。上限がないと、詰まったときに止まりません。
まず、プーラー側です[ラボ]。
- トランザクションモード(プール15): 18クライアントが30秒ずつ保持 → 16本が動き、2本は待って、全部終わるまで60秒。17クライアントが65秒ずつ保持 → 待っていた1つはちょうど60秒で
(ECHECKOUTTIMEOUT) ... after 60000ms in Transaction mode。 - セッションモード(18クライアント、プール15): 3本が0秒で
(EMAXCONNSESSION)。待たされません。
→ トランザクションモードは60秒待ってから落ち、セッションモードは即断られます。
この60秒は、計算で予想できます。ここでの「閉じたループ」とは、1つ終わったら次を投げるクライアントのことです(逆に、前が終わるのを待たずに一定のペースで届くのが「オープンループ」で、実際のユーザーの流入はこちらです)。
閉じたループなら、1クライアントの待ちはおおよそ (クライアント数 − バックエンド数) ÷ バックエンド数 × クエリの秒数 になります。そこで199クライアントを同時に走らせ、バックエンド16本に対してクエリの長さだけを変えました。計算上は、クエリが5秒を超えたあたりで待ちが60秒に届くはずです。
| クエリの時間 [ラボ] | 予想の待ち(キュー時間) | 実測のp50(待ち + 実行、成功分のみ) | 結果 |
|---|---|---|---|
| 4.5秒 | 51.5秒 | 54.1秒 | 551件が成功、エラーなし |
| 5.5秒 | 62.9秒 | 60.6秒 | 464件が成功、46件が ECHECKOUTTIMEOUT(510件中46件、約9%) |
→ 「5秒あたりが境目」という予想どおりでした。 式で予想できるということは、事前に避けられるということです。
次に、ライブラリ側です[ラボ、直接接続]。
| ライブラリ | 接続を待つときの既定 | 確かめたこと |
|---|---|---|
node-postgres Pool
|
無制限(connectionTimeoutMillis: 0) |
プール1本・3秒のクエリで、2本目は6.0秒、3本目は9.0秒まで待った。connectionTimeoutMillis: 2000 を付けると2.0秒で timeout exceeded when trying to connect
|
| Prisma 6 |
pool_timeout 10秒 |
connection_limit=1 で3秒のクエリ5本: 4本目が10.0秒で P2024
|
Prisma 7 + @prisma/adapter-pg |
なし | プール1本、3秒のクエリ5本: 5本目まで15.1秒待って全部成功。connectionTimeoutMillis: 2000 で2.0秒で失敗 |
| psycopg_pool | 30秒 |
timeout=4 で PoolTimeout
|
| SQLAlchemy |
pool_timeout 30秒 |
pool_timeout=2 で QueuePool limit ... timed out
|
| postgres.js |
connect_timeout 30秒 |
接続待ちの上限は見つけていない |
Django 5.2 pool=True
|
psycopg_poolの既定(4本、30秒) | 終わりに connection.close() する形なら20スレッド×2秒が10.1秒で成功。閉じないスレッドが4本いると、他16本が OperationalError
|
→ Prisma 6からアップグレードする方は、ここがいちばん大事です。 6にあった10秒の安全網(pool_timeout)が7(pgアダプタ)では既定でなくなり、待ちが無制限になります。PrismaPg に connectionTimeoutMillis を必ず渡してください。
import { PrismaPg } from '@prisma/adapter-pg'

const adapter = new PrismaPg({
  connectionString: process.env.DATABASE_URL,
  connectionTimeoutMillis: 5000, // これがないと、詰まったとき無限に待ちます
})
ロール側の既定も、同じはしごの一部です。[ドキュメント](Timeouts)によると anon は3秒、authenticated は8秒、service_role はなし(未設定なら authenticator の8秒)、postgres はロールごとの設定がなく既定のグローバルタイムアウトで2分に制限されます。[ホスト版]で pg_settings を読むと statement_timeout は確かに 120000、つまり2分でした。管理用のスクリプトやバッチを postgres でつないでいるなら、はしごのいちばん下は2分です。
注意 [ラボ] 到着が止まらない「オープンループ」では、話がさらに厳しくなります。1リクエストごとに新しい接続を開く形で毎秒200回(処理能力の約150回を超える)を流すと、4秒でクライアントが200に達し、以降は到着の約4分の1が (EMAXCONN) で拒否されました。閉じたループは待つのが上手なので、過負荷を隠します。つまり、自分で回す負荷テストが平気でも、実際のユーザー流入では拒否が出ることがあります。
あなたがやること: 自分のタイムアウトを1枚の表にして、いちばん短いものがどこか確かめる。Prisma 7なら connectionTimeoutMillis を今日足す。
9. Data APIは、何本使うのか
答え: 11本(プール10本 + LISTEN 用1本)です。そして埋まると、10秒で 504 PGRST003 を返します。
なぜ気にするか: supabase-jsやfetchしか使っていなくても、57本のうち11本はここで消えています。
slow(2.5)(2.5秒かかる関数)を、Data API経由で50本同時に呼びました[ラボ]。
200  x 40   待ち時間 2.5〜10.1 秒
504 PGRST003 x 10   10 秒ちょうど
→ 10本ぶんが順に処理され、あふれた10本は10秒で諦めました。 バックエンドの authenticator は11本で、内訳はプール10本と LISTEN "pgrst" の1本です(pg_stat_activity の query で確認)。
また、anon ロールには statement_timeout = 3s があるため、4秒の関数を呼ぶと HTTP 500 と、PostgreSQLのエラーコード 57014(クエリが時間切れで打ち切られた、という意味)が返ります。
注意 公開された遅い関数は、外部の人にData APIのプールを握らせます。今回の slow() は検証のため anon から呼べるようにしていますが、本物のプロジェクトでこういう関数を公開しないでください。
あなたがやること: 式①に「Data API 11本」を固定で入れる。公開している関数に重いものがないか確認する。
10. トランザクションモードで壊れるものは何か
答え: prepared statement(ライブラリが「このクエリは解析済み」と名前を付けて接続に覚えさせる仕組み。接続が別のクライアントに渡ると、その記憶が食い違って壊れます)と、パイプライン(1本の接続に複数のクエリを重ねて送ること)です。postgres.jsのハングは後者が原因で、prepare: false だけでは直りませんでした。
なぜ気にするか: 「動かない」ではなく「固まって返ってこない」ので、タイムアウトを設定していないと気づけません。
[ドキュメント](Connecting to Postgres)は、いまははっきり書いています。
クエリのパイプラインはサポートされません。トランザクションモードは、1つの応答が終わったのを見た時点で接続をプールに返すので、クライアントがその接続にすでに次のクエリを積んでいても返してしまいます。
注意:
postgres.jsは既定でクエリをパイプライン化するので、この組み合わせはクエリを固まらせたり、食い違った行を返したりすることがあります。
私が見たのは、この「固まる」ほうです。原因を1つずつ切り分けました。
| 設定 | [ラボ] トランザクション | [ホスト版] プール3 | 直接 |
|---|---|---|---|
| 既定 | ハング | ハング | OK |
prepare: false だけ |
ハング | ハング | |
max_pipeline: 1 だけ |
OK(1.0秒) | OK | |
| 両方 | OK | OK |
→ 効いたのは max_pipeline: 1 のほうで、prepare: false ではありません。 定番の対処として知られているのは prepare: false ですが、それだけでは直りませんでした。
「エラーが出ないのは、postgres.jsが黙ってやり直しているからでは」という疑いも確かめました(ここは細かい確認なので、飛ばして構いません)。クライアントがサーバーに送る「Parse」というメッセージの数を数えたところ、max_pipeline: 1 だけのときは接続の数(10)しか送られていませんでした。やり直しがあれば、もっと増えるはずです。データベースとSupavisorのログにも 26000 の行はありませんでした。→ やり直しで隠しているのではなく、そもそもエラーが起きていません(なぜ起きないのかは分かりません)。
ドキュメントが警告するもう1つ、食い違った行も探しました。1クエリごとに違う目印を送り、返りを全部照合します。
| 設定(プーラー、トランザクション)[ラボ] | 300クエリ / 10接続 | 食い違った行 |
|---|---|---|
| 既定 | ハング(この回は69件で停止。位置は毎回変わる) | — |
prepare: false だけ |
ハング(この回は144件) | — |
max_pipeline: 1 だけ |
OK(58ミリ秒) | 0件 |
prepare: false かつ max_pipeline: 1
|
OK(38ミリ秒) | 0件 |
| (対照)直接つなぐ、既定 | OK(15ミリ秒) | 0件 |
→ 上の表(300クエリ×10接続)に加えて、1000クエリ×20接続も3回流しましたが、食い違った行は1件も出ませんでした。 私の環境では、食い違う前に固まります。ただし「出なかった」は「起きない」ではないので、ドキュメントの警告のほうを信じてください。
max_pipeline: 1 をすすめる以上、トランザクションを壊さないかも確かめる必要がありました。[ドキュメント]の Postgres.js のページ には「max_pipeline: 0 は sql.begin() のトランザクションを壊す」とありますが、私がすすめているのは 1 です。
| 設定(プーラー、トランザクションモード)[ラボ] | 結果 | 値の食い違い | トランザクションの分断 |
|---|---|---|---|
| 既定 | OK(16ミリ秒) | 0 | 0 |
max_pipeline: 1 |
OK(18ミリ秒) | 0 | 0 |
prepare: false かつ max_pipeline: 1
|
OK(17ミリ秒) | 0 | 0 |
max_pipeline: 0 |
エラー 42P05 prepared statement "..." already exists
|
— | — |
prepare: false かつ max_pipeline: 0
|
OK、ただし2029ミリ秒 | 0 | 0 |
→ max_pipeline: 1 は sql.begin() を壊しませんでした(8〜30トランザクションで3回繰り返し)。一方 max_pipeline: 0 はパイプラインを完全に止めるため、クエリが1本ずつ順番待ちになり、100倍以上遅くなりました(max_pipeline: 1 の18ミリ秒に対して、2029ミリ秒)。
prepared statementが原因のものも、ちゃんとありました[ラボ]。
-
Prisma 6: URLに
?pgbouncer=trueがないと、30クエリのうち22本がprepared statement "sN" does not existで失敗(付けると0本)。紛らわしい名前ですが、共有プーラー(Supavisor)のトランザクションモードでも、このオプションが必要です。 -
psycopg 3: 同じクエリを5回以上流すと自動でprepareされて壊れます。
prepare_threshold=Noneで0本。1回ずつの試しでは気づけません。 - Prisma 7 + pgアダプタ、node-postgres: 壊れませんでした。
注意 同じ検査をPgBouncer 1.26.1(同じDBの前に置いたもの)に流すと、postgres.jsの既定もpsycopgもPrisma 6も、すべてエラーなしでした。ただしこれはコンテナの既定値であり、ホスト版の専用プーラーと同じ設定とは限りません。
あなたがやること: postgres.jsなら、次のように書いたうえで、自分のトランザクションで検証してから使う(ドキュメントに載っている対処ではありません)。
const sql = postgres(process.env.DATABASE_URL, {
  max: 10,
  max_pipeline: 1, // トランザクションモード(ポート6543)で固まるのを防ぐ
})
Prisma 6なら接続URLに ?pgbouncer=true、psycopg 3なら prepare_threshold=None を付けてください。
11. 接続は、いつ消えるのか
答え: 実測では約2分です。ただし[ドキュメント](Supavisor FAQ)は最大5分と書いているので、見積もりは5分でしてください。
なぜ気にするか: 「もう止めたのに枠が空かない」という状態が数分続き、復旧の判断を誤らせるからです。
[ドキュメント](SupavisorのFAQ)には3つの主張があります。3つとも測りました。
| [ドキュメント]の主張 | 私が測ったもの |
|---|---|
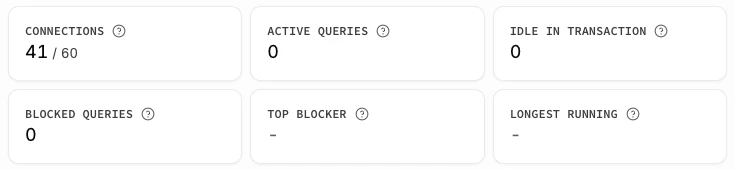
| トランザクションモードは、5分使われなければ閉じる | [ラボ] 約2分(105秒では残り、120秒で消えた。2回)。[ホスト版] 106秒では6本のまま、122秒で0本。どちらも約2分で、5分ではありません |
| クライアントがいる間は、最低1本は維持される | [ホスト版] クライアント1本を放置 → バックエンドは1本のまま137秒後も維持。確かに維持されていました |
| セッションモードは、すぐ閉じる | [ホスト版] 1本つないで切断 → バックエンドは3分以上残り、あとから来たクライアントに再利用されました。消えたのはアイドル4〜5分ごろ。「すぐ」ではありません |
→ 3つのうち2つは、実測と違いました。 それでも見積もりには大きいほう(5分)を使ってください。私が測ったのはプロジェクト1つ・数回ぶんだからです。
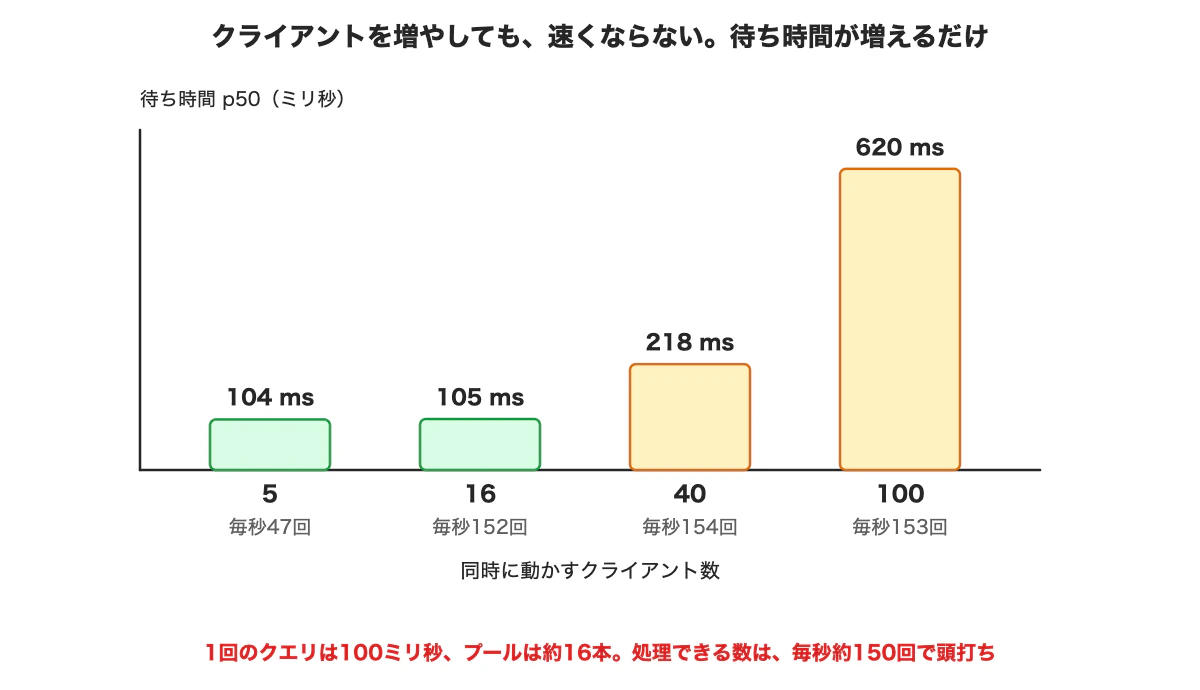
上の画面は、テストを止めた直後のものです。誰も使っていないのに41本が残っているのが、この「消えるまでの時間」です。
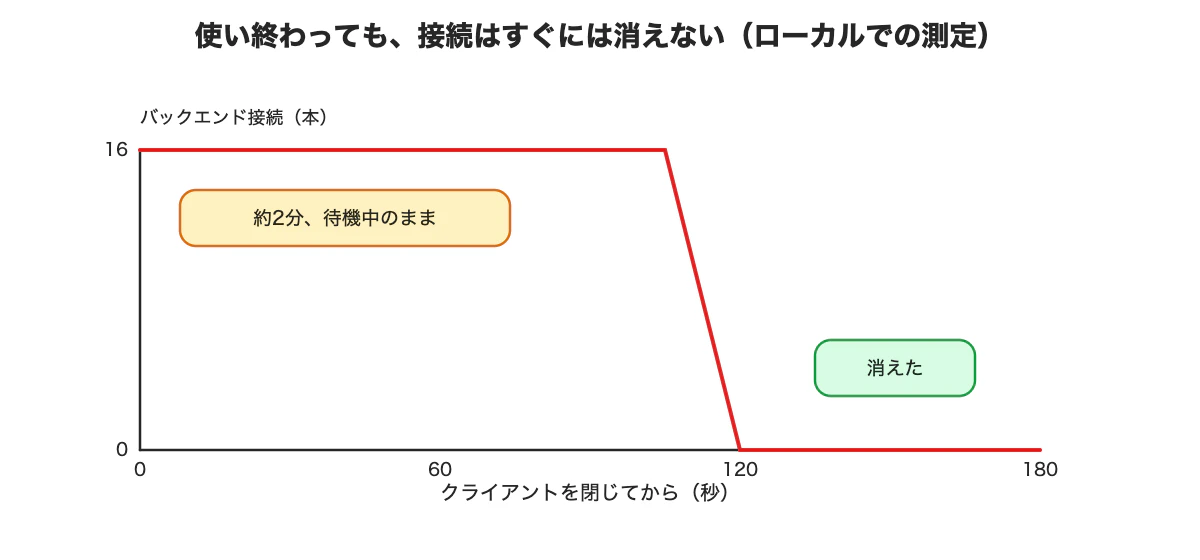
関連して、「エラーが出ないまま遅くなる」ことも確かめました。1ロール・トランザクションモード・クエリ100ミリ秒で、クライアント数だけを変えます[ラボ]。
| クライアント | 毎秒のクエリ | p50 | p95 |
|---|---|---|---|
| 5 | 47 | 104 ms | 112 ms |
| 16 | 152 | 105 ms | 108 ms |
| 40 | 154 | 218 ms | 312 ms |
| 100 | 153 | 620 ms | 724 ms |
→ 16本を超えると毎秒約150回で頭打ちになり、増えるのは待ち時間だけ。エラーは1件も出ません。 だからp95を見ないと気づけません。
注意 [ラボ] データベース側がアイドルの接続を切った(pg_terminate_backend)とき、node-postgresの Pool は error ハンドラなしだとプロセスごと落ちました。pool.on('error', ...) を付けておけば、次のクエリから復帰します。SQLAlchemyは最初のクエリが失敗したので、create_engine(..., pool_pre_ping=True) を付けてください。
あなたがやること: 監視にp95を入れる。短いテストを連続で回すときは、前のテストの接続が残っている前提で数える。
12. 1つのロールに、みんなを巻き込ませないために
答え: ロールごとの connection limit が効きます。ただしプールサイズ + 1以上にしてください。statement_timeout だけでは守れません。
なぜ気にするか: 4章のとおり、1つのロールの使いすぎがAuthやほかのロールまで巻き込むからです。
どのロールに付けるのか。 下の
r1はラボで作ったロールです。あなたのプロジェクトでは、自分で作ったロール(たとえば前章のbatch_userのようなバッチ用)に付けてください。authenticatorには付けないでください(Data APIが止まります)。postgresに付けるのも避けたほうが安全です(ダッシュボードや管理作業が入れなくなります)。
ロールごとの接続上限: alter role r1 connection limit 10 とすると、r1は10本で止まり、20クエリのうち10本が too many connections for role "r1" で即座に失敗しました。ほかのロール(r2)は影響なしです。ただし上限の値には注意が要ります[ラボ、プール15、40クライアント×5秒クエリ]。
connection limit |
r1のバックエンド | 失敗したクエリ |
|---|---|---|
| 15(プールサイズと同じ) | 15 | 25 / 40(すぐに失敗) |
| 16(プールサイズ + 1) | 16 | 0(残りは待つ) |
→ ぴったりにすると16本目が拒否され、待てるはずのクライアントまでエラーになります。 2章の「+1」がここで効いてきます。
ロールごとのタイムアウト: alter role r1 set statement_timeout = '2s' で4秒のクエリは2.0秒で止まりました。ただし、どのロールも自分の statement_timeout を変えられます。 クライアントが SET statement_timeout = 0 を実行でき、しかもトランザクションモードでは次のクライアントにも0が残ります(6章)。つまり権限では防げません。
そのため、セッションの外に後ろ盾が要ります。pg_cron で5秒ごとに、長すぎるクエリを打ち切るジョブを動かしました。
-- 拡張機能 pg_cron を有効にしてから
select cron.schedule('cancel-long-queries', '5 seconds', $$
  select pg_cancel_backend(pid)
  from pg_stat_activity
  where usename = 'batch_user'          -- 対象は自分で作ったロールだけに絞る
    and state = 'active'
    and now() - query_start > interval '6 seconds'
$$);
これを動かしたところ、SET statement_timeout = 0 をしたクライアントの30秒クエリが10〜11秒(6秒 + ジョブ間隔)で止まりました。
監視用のロール: 満杯のときに監視ロールがつながらないと、原因が見えません。PostgreSQL 17では reserved_connections を設定しロールに pg_use_reserved_connections を渡すと、満杯でもつながりました[ラボ]。reserved_connections を使うなら、式①の上限からその数を引いてください。
注意 reserved_connections を[ホスト版]で変更できるかは確かめていません(Nanoでは値は0でした)。変えられない可能性があるので、この手は当てにせず、満杯のときはダッシュボードから入る前提で考えておくほうが安全です。
あなたがやること: プーラーを使うロールの connection limit を「プールサイズ + 1」以上に設定する。長いクエリを止める定期ジョブを用意する。
13. 費用
- 今回の実験は約0.02ドルでした。ほとんどが自分のPCのDocker(0ドル)と無料プロジェクトでの短い確認で、使い捨てのProプロジェクト(Micro)を約1.5時間だけ動かし、終わったあと削除しました。
- [ドキュメント](Compute and disk、2026-11-04): Nanoは無料。有料プランのいちばん小さいコンピュートはMicroで月約10ドル、上限はNanoと同じ(直接60、クライアント200、プールサイズ15)。この「Nanoと同じ」はProプロジェクトで実際に読んで確かめました。 Smallは約15ドル(90/400)、Mediumは約60ドル(120/600)、XLは約210ドル(240/1000)。
- Largeはページによって数字が違い、Compute and diskでは約110ドル、Manage your usage / Computeでは約111ドルです。どちらも時間単価は0.1517ドルなので、月換算のしかたの違いです(0.1517 × 730 = 110.74)。
- Proプランは月25ドルで、コンピュートのクレジット10ドル分が含まれMicro 1プロジェクトぶんをまかないます。プランを上げるだけでは接続の余裕は増えません。 増えるのはコンピュートのサイズを上げたときです。
- コンピュートは時間単位で課金され、上限(Spend Cap)の対象外です[ドキュメント]。つまり、コンピュートサイズを上げたぶんの料金は、Spend Capでは止まりません。
- 専用プーラーにつなぐにはIPv6が必要で、IPv4だけの回線からはIPv4アドオン(月4ドル)が要ります。私は使わなかったので、専用プーラーの実測はありません。
14. 実際の運用にするなら(まだ試していません)
- プールサイズは、
(ロール数 × モード数 × (プール + 1)) + Data API + Auth + Storage + Realtime + 監視が、max_connectionsから予約を引いた数に収まるかで決める。設定場所は Project Settings → Database → Connection pooling です。専用プーラーも同時に使うなら、そのぶんも足す。
実測値は、Data API 11本、Auth 10本(使われたあと。約1分で手放す)、Storage 8本(使われたあと、持ったまま)[ホスト版]。Realtimeは[ラボ]で5〜7本、監視は[ホスト版]で1〜2本でしたが、Realtimeの本数は同時接続数で変わるはずで、ホスト版では測っていません。ここは自分のプロジェクトで数えてください(→ 5章のSQL)。 -
アプリのコピー数 × ライブラリのプールを、クライアント上限(ロールごとに200、コンピュートサイズで固定)と比べる。サーバーレスはとくに。ただしロールを足してもバックエンドの枠は増えません。 - 待ち時間の上限(Supavisor 60秒、PostgREST 10秒、
anon3秒、Prisma 6の10秒、ライブラリ30秒、postgresロールは2分。Prisma 7のpgアダプタとnode-postgresは既定で無制限)を、ひとつの「はしご」として揃える。 - ロールごとの
connection limit(プールサイズ + 1以上)、statement_timeout、idle_in_transaction_session_timeout。SETではなくset_config(..., true)。クライアントに外されない後ろ盾として、長いクエリを止める定期ジョブ。 - postgres.jsを使うなら、
max_pipeline: 1を自分のトランザクションで確かめる。 - 監視ロールが満杯のときにもログインできるかを、使い捨ての環境で確かめる。
- [ホスト版]でのさらなる確認(クライアント接続数のグラフ、PostgRESTのプール設定、+1が全リージョンで同じか、専用プーラーのバックエンド本数、満杯のときのAuthの粘り)。
15. 検証メモ:つまずきと、考えを変えたところ
結果だけ読みたい方は、ここは飛ばしてください。再現する方のための記録です。
ラボ作りでのつまずき
-
max_connectionsは[db]ではなく[db.settings]に書きます。最初に[db]へ書いても効かず、alter system setで設定したところ、その値がpostgresql.auto.confに残って後から[db.settings]を効かなくしました。alter system reset max_connectionsと再起動で解決します(pg_settingsのsourceで確認できます)。 - ラボを90本にしたのは、「空き」をホスト版のNano(60本)に合わせるためです。ローカルのプーラーは管理用に29本(
supavisor_meta27本 + クラスタ用2本)をデータベース内に開きますが、ホスト版ではその分が外にあります。数字が合わないと思ったら、これでした(application_nameを見るまで気づきませんでした)。 - 満杯のとき、数える側の接続まで拒否されました。数える専用に、予約枠のある
supabase_adminを使います。 - シェルの引数の渡し方で、4種類のテストが全部同じ条件で走っていました(zshは引用符なしの変数を単語に分けません)。
- バッチで続けて走らせると、前のテストの接続が残って数が膨らみます(Prisma 7が10本のはずが26本に見えた)。テストごとにプーラーを再起動して測り直しました。
考えを変えたところ
- 最初に書いた式①は、実験データと合いませんでした。ラボの満杯は「57/60」で、残り3本は管理者用の予約です。式を
max_connectionsではなく「予約を引いた数」に直し、トランザクションモードの「+1」も足しました。 - 「満杯ならData APIは503」と思い込んでいましたが、満杯でも200のことがあります。分かれ目は、持っている接続で足りるかどうかでした。
- 「Authが先に止まる」も同じ種類の思い込みでした。Authが先だったのは、そのときAuthが接続を持っていなかったからです。
- 「何もしていないときに0本だから、Authは接続を持たない」と書きかけました。Proプロジェクトで負荷をかけたら10本持っていました。「測っていない」と「0である」は別物です。
- ドキュメントは2026年10月末に書き換わりました。以前は「プールサイズはポート5432と6543で共有される」という記述がありましたが、現在その文はなく、「ロールごと」に変わっています。古い記事を読むときは日付を見てください。
- 状態漏れのテストで、
set_config(..., true)の確認が前の実験で漏れた値に引きずられ、漏れたように見えました。キー名と順番を直しました。 - 「食い違った行」を探す最初のテストで一時テーブルを使い、「食い違い」が3件出て一瞬再現したと思いました。違いました。一時テーブルは接続ごとに残るので、同じ接続を使い回した2つ目以降のトランザクションが前の行まで読んでいただけです。私のテストのバグでした。トランザクションモードを試すときは、テスト自身が状態を共有していないかを先に疑ってください。
- Djangoのプールの実験で
connection.close()を忘れ、全滅しました。これも私のバグですが、長く生きるスレッド(バックグラウンド処理など)では本番でも起こります。
まとめ
- 危険度順の3つ: ①トランザクションモードでセッション状態が次のクライアントに残り、行と権限が漏れる。②接続は掛け算で増え、有料プランにしても増えない。③満杯になると「新しい接続が必要なもの」から止まる。
- 接続の予算は3つの式: ①バックエンドの合計 ≤
max_connections− 予約、②クライアントの合計 ≤ プーラーの上限、③同時に使う数 = 毎秒のクエリ × 1クエリの秒数。 - プールは「ロール × データベース × モード」ごと。トランザクションモードは「+1」。
- クライアント上限200もロールごと(ソース上の単位はプール=ロール × モード)。ただしロールを足してもバックエンドの枠は増えない(300クライアントが握っていたバックエンドは2本)。
- 式①にはAuth、Storage、Realtime、監視も入れる。Authは使われたあと10本(約1分で手放す)、Storageは8本(14分後も保持)。
- 待ち時間の上限は、プーラー60秒、PostgREST 10秒、
postgresロール2分。エラーが出ないまま遅くなるのでp95を見る。Prisma 7のpgアダプタには既定の上限がない。 - postgres.jsのハングの原因はパイプライン。
max_pipeline: 1で直り、sql.begin()も壊しませんでした。 - 接続が消えるまでは実測で約2分だが、見積もりは[ドキュメント](Supavisor FAQ)の5分で。
-
connection limitは「プールサイズ + 1」以上に。statement_timeoutはクライアントが外せるので、セッションの外に後ろ盾を。 - ライブラリの既定値はバージョンで変わる。実際に動かして数える。
参考にした公式ドキュメント(2026-11-04時点)
記事中で [ドキュメント] と書いたものの出どころです。内容は変わるので、読むときは日付を確かめてください。
- Connection management — プールサイズはロールごと、40%/80%の目安
- Connecting to Postgres — トランザクションモードの制限、パイプライン、セッション状態
- Pooling and limits — クライアント接続とバックエンド接続の上限、合計に含めるサービス
- Supavisor FAQ — プールの単位、接続が消えるまでの時間、ホットな接続
-
Postgres.js —
max_pipelineとsql.begin() -
Timeouts — ロールごとの
statement_timeoutの既定値 - Compute and disk / Manage your usage: Compute — コンピュートサイズごとの上限と料金
- Cost control(Spend Cap) — コンピュートがSpend Capの対象外であること
サンプルコード(ラボのスクリプト、結果の表、この式をそのまま計算できるページ)は、冒頭のリポジトリにあります。
続きの記事では、実際に接続が足りなくなったときに何をするかを、症状の見分け方から順に試しました。