
この記事は、30 日の連載を 1 枚の地図と 3 つの判断に畳む最終回です。道具が 20 を超えると、明日「この施策は効いたのか」と聞かれたとき、どこから思い出せばよいかが分からなくなります。新しい道具は出さず、30 本を描き直した地図と、手法選定の 3 分岐のフロー、全 30 回の総索引で振り返ります。
登場人物
遠藤顧問: データ分析の社外顧問。答えを言わずに問いで返す/さくら: データアナリスト 1 年目。数字を出すのは速いが、相関を因果と読み違える


1. 1 文で言うと
1 文で言うと
30 日分の道具は、3 つの流派が「どの仮定を買うか」の違いとして 1 枚の地図に畳めます。手法選定は 3 つの分岐で終わり、明日から手が動く形で残った判断は 3 つだけでした。
- 今日の数字: 明日から手が動く判断は 3 つ でした。

2. 今日の問い
今日の問い
30日で20を超える道具を並べました。では明日、手元のデータで「この施策は効いたのか」と聞かれたとき、30本のどこから思い出せばよいのか。
覚えておくべきものを3つに絞るとしたら、何が残るか?
読み終えたら、30 日分の道具が「どの仮定を買うか」の 1 枚の地図に畳める理由と、手法選定が 3 つの分岐で終わることを説明できます。
道具の一覧を暗記しても、現場では役に立ちません。役に立つのは、道具を選ぶ前に自分へ投げる問いの順番と、その道具が何を代わりに信じさせるのかの対応関係です。今日はまず地図を描き、次に3つの判断へ絞り、総索引で30本を見渡してから、最後に選定のフローに落とします。前の回から使うのは次の 2 つです。
- Day 3(三大流派): Rubin・Pearl・計量経済は同じ操作の別の言葉、という粗い地図
- Day 27(落とし穴チェックリスト): 15 項目は、どの仮定を買ったかの申告
3. 概念
先に、手元の道具との違いを置きます。予測モデルなら、検証データでスコアを比べて、いちばん当たる道具を選べます。A/B テストなら、無作為割付が仮定を保証してくれます。今日の場面は、道具が 20 を超え、どれを選んでも「効果」という数字が出ますが、その数字が正しいかを手元のデータでは採点できません。因果推論の道具は、当たり外れではなく、どの仮定を買ったかで選ぶので、予測精度の物差しでは並べられません。
3.1 30日を1枚に描き直す
この小節が今日の主役です。30 日分の道具を、買う仮定の違いとして 1 枚に描き直し、識別が中央にあって ML の層はその下流にいることを読み取ります。

Day 3 で3つの流派を地図にしたときは、「同じ因果に別の言葉で迫る3系統がある」という粗い理解でした。30日を通したいまは、3流派の違いがどの仮定を買うかの違いだったと言えます。Rubin流は割付の過程を疑い、Pearl流は構造そのものを図に描いて宣言し、計量経済デザインは世の中に転がっている外生の割付の断片を拾います。どれを選んでも、最後は「検証できない何かを信じた」という同じ地点に着地します。
30 本の札を工程 × 流派に並べた地図は、位置づけの Fig 0 です。札の住所はそれで引けますが、どの仮定を買ったかは見えません。そこで同じ 30 本を、流派ごとの問いと買う仮定でつなぎ直したのが Fig 1a と Fig 1b です。


この 2 枚で一番言いたいのは、識別の箱が中央にあって、ML の層はその下流にしかいないことです。Day 24 で見たように、機械学習は「ニュイサンスをうまく当てはめる」ところでは強力ですが、どの変数で条件付けるべきかを決めてはくれません。識別が壊れていれば、精密な推定量は壊れた量を精密に推定するだけです。Day 22 で Phase 4 を2系統に分けたのも、この上下関係を混ぜないためでした。
もう1つ、3つの流派の下の「買う仮定」の箱は、どれもデータからは検証できないという共通点を持ちます。非交絡性(Day 6)、DAG の描かれなかった矢印(Day 10)、除外制約(Day 17)、平行トレンド(Day 18)。30日でいちばん繰り返した文は、たぶんこれです。

3.2 30日で身についた判断は3つだけ
道具は20以上ありましたが、明日から手が動く形で残ったのは3つでした。それぞれ「破ったときに何が起きたか」を、連載中に自分で出した数字で書きます。
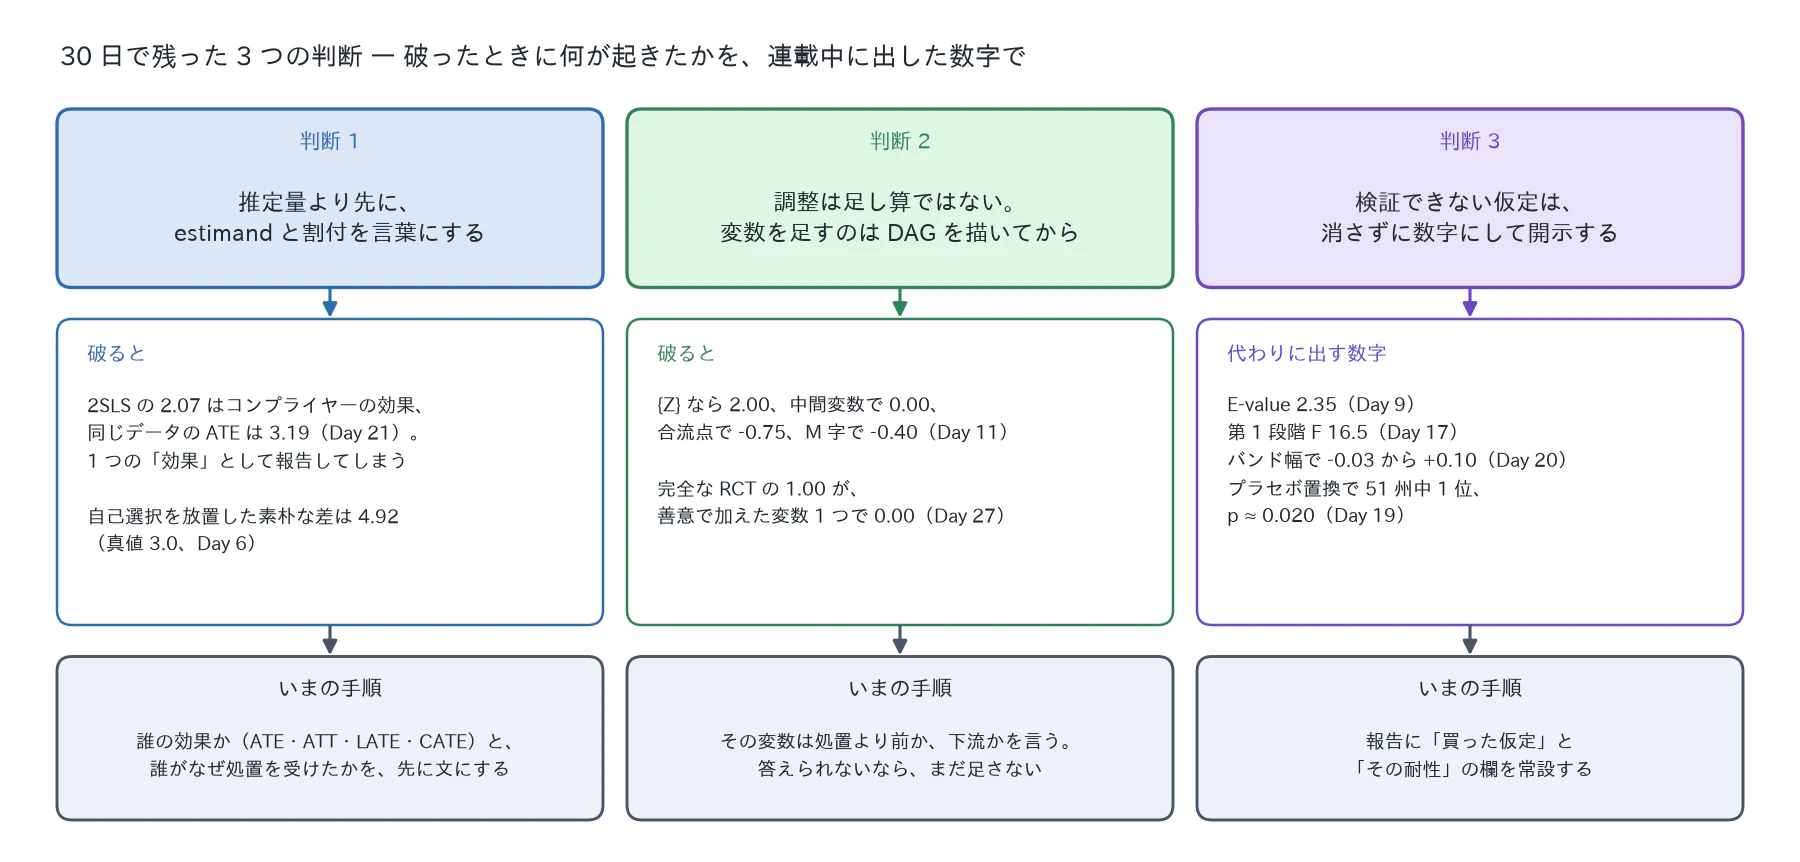
判断1 推定量を選ぶ前に、estimand と割付を言葉にする
以前の私は「効果を出してください」と言われたら、まずどのモデルで推定するかを考えていました。いまは先に2つを文にします。「いま推定したいのは誰の効果か(ATE・ATT・LATE・CATE のどれか)」と、「誰がなぜ処置を受けたのか」です。
これは趣味の問題ではありません。Day 21 のオラクル合成では、2SLS が返した 2.07 はコンプライヤーの効果で、同じデータの ATE は 3.19 でした。どちらも正しい数字で、答えている問いが違うだけです。estimand を先に決めていなければ、この2つを1つの「効果」として報告してしまいます。割付のほうも同じで、Day 6 では自己選択を放置した素朴な引き算が 4.92(真値3.0)でした。誰がなぜ処置を受けたかを言葉にできないうちは、何で調整すべきかも決まりません。
判断2 調整は足し算ではない。変数を1つ足すのはDAGを描いてから
機械学習の癖で、私は「使える特徴量は全部入れる」側の人間でした。因果推論ではこれが最も危険な癖です。Day 11 では、バックドア基準を満たす集合 {Z} なら真値 2.00 に戻るのに、中間変数を足すと効果が 0.00 に消え、合流点を足すと -0.75 に符号反転し、M字バイアスでは真の効果ゼロが -0.40 の「効果」に化けました。Day 27 のデモに至っては、完全な RCT の 1.00 が、善意で加えた変数1つで 0.00 になりました。

いまは、調整セットに変数を足すときに「その変数は処置より前に決まるか、処置の下流か」を必ず言います。答えられないなら、その変数はまだ足しません。DAG を描くのは絵が好きだからではなく、この問いに答える順序を強制するためです。
判断3 検証できない仮定は、消そうとせず数字にして開示する
30日でいちばん考え方が変わったのがここです。以前は「非交絡性が怪しい」と言われるのが怖くて、共変量を増やして怪しさを消そうとしていました。増やしても消えません(判断2のとおり、増やすと悪化することすらあります)。
代わりにやるのは、仮定がどれだけ破れたら結論が覆るかを数字にすることです。Day 9 の E-value 2.35 は「測ったものを全部調整してなお、処置ともアウトカムともリスク比2.35で結びつく隠れ交絡がなければ、この効果はゼロにならない」という言い方に翻訳してくれます。デザインごとに同じ役割の数字があります。操作変数なら第1段階F(Day 17 では 16.5、F≈2 まで落ちると推定は真値1.0に対し中央値 1.56 へ歪みました)、RDDならバンド幅感度(Day 20 では -0.03 から +0.10 まで動きました)、合成コントロールならプラセボ置換(Day 19 では51州中1位、p ≈ 0.020)です。
私の主戦場である空間データでは、ここがさらに切実になります。自治体単位の施策評価では、隣接自治体への漏れ(SUTVA)と、空間に構造を持つ未観測交絡が同時に効いてくるからです(Day 28)。仮定を消せない以上、報告に「買った仮定」と「その耐性」の欄を常設するほうが速い、というのが30日の結論です。
4. 総索引、Day 1から30まで1行ずつ
各回の核心を1行に圧縮しました。数字はすべて記事内で実行したコードの出力です。
| Day | テーマ | 核心の1文 |
|---|---|---|
| Day 1 | 相関と因果 | 相関が因果に化ける罠は偶然・交絡・選択バイアスの3つ。アイスと水難の r = 0.68 は気温で層別すると 0.01 |
| Day 2 | 潜在的結果 | 因果は Y(1) と Y(0) の引き算。片方は永遠に欠測(根本問題)なので、ATE・ATT・CATE という平均で攻める |
| Day 3 | 三大流派 | Rubin・Pearl・計量経済は同じ操作の別の言葉。1つのデータで層別・バックドア調整・回帰が同じ 50 に一致する |
| Day 4 | RCTは黄金律 | 無作為割付は交絡を調整で消すのではなく設計で生まない。共変量を足しても効果は 0.4496 → 0.4488 と動かない |
| Day 5 | FisherとNeyman | 「効果がない」は2種類。並べ替え検定は p < 0.0001、反復サンプリングは 95%CI [41.0, 49.1]pt を返す |
| Day 6 | 割付メカニズムと非交絡性 | 素朴な 4.92 は X 調整で 3.00(真値3.0)に戻る。ただし隠れ交絡があると真値ゼロが +2.15 に化け、バランス診断は合格に見える |
| Day 7 | 傾向スコアとIPW | 高次元の X を e(x) 1本に潰す。nhefs の 2.54 kg は IPW で 3.42 kg、年齢のSMDは 0.28 → 0.01 |
| Day 8 | マッチング | 実験 +1,794ドルに対しCPS素朴比較は -8,498ドル。傾向スコアマッチングで ATT +2,202ドル、人種SMD 2.43 → 0.08 |
| Day 9 | 感度分析とE-value | 検証できない仮定を「覆すのに必要な交絡の強さ」に翻訳する。+3.46 kg(RR 1.49)のE-valueは 2.35 |
| Day 10 | DAGの読み方 | DAGはデータから出ず、仮定の宣言。条件付けで連鎖 +0.58 → 0.00、分岐 +0.50 → 0.00、合流は 0.00 → -0.50 と逆に生まれる |
| Day 11 | d分離とバックドア | 調整セットは規則で選べる。{Z} で真値 2.00、中間変数で 0.00、合流点で -0.75、M字バイアスで -0.40 |
| Day 12 | do演算子と介入 | 条件付けは母集団の絞り込み、do は書き換え。腎結石データでは全体で勝つB(82.6%)より do ではA(83.3%)が正解 |
| Day 13 | フロントドア基準 | 交絡を測れなくても媒介を計測器にすれば点識別できる。推定 0.242 は真値 0.239 に当たるが、前提が1つ崩れると外れる |
| Day 14 | 反事実の計算 | アブダクション・介入・予測の3ステップで個体の if を解く。個体の反事実 86 は、集団の介入平均 70 では答えられない量 |
| Day 15 | DoWhyの4ステップ | model → identify → estimate → refute の本体は仮定の明示化。refute は証明ではなく壊れ方の検査 |
| Day 16 | 回帰は主力 | 回帰係数は層内分散で重み付けた層別比較の平均。FWLで係数 0.0746 は残差×残差と差 1.5e-16 で一致する |
| Day 17 | 操作変数法 | 外生のてこで内生性を外す。OLS 0.075 が2SLSで 0.134 へ。確認できるのは第1段階F 16.5 だけで、除外制約は検証できない |
| Day 18 | 差分の差分法 | 前後差を2回引いて時代の波を消す。効果は -2.2ポイント。平行トレンドは水準ではなく動きの仮定で、証明はできない |
| Day 19 | 合成コントロール | 50州の凸結合で対照群を作る。重みはFL 37%・NY 36%・IL 27%、乖離は51州中1位で p ≈ 0.020 |
| Day 20 | 回帰不連続デザイン | 閾値の際は擬似ランダム。推定は +0.10 だがバンド幅次第で -0.03 から +0.10 まで動き、語れるのは近傍だけ |
| Day 21 | ITTとLATE | 割付と受療は別物。ITT 0.82 ÷ 遵守率 0.397 = 2.07 はコンプライヤーの効果で、同じデータのATE 3.19 とは別の量 |
| Day 22 | 効果の異質性 | ATE -0.005 の裏で真の効果は ±2 に割れている。24部分群を漁ると 43.2% で「有意な部分群」が出る |
| Day 23 | メタラーナー | 教師ラベル τ は誰にも観測できない。PEHEはX 0.239・S 0.329・T 0.677 で、S-learnerは正則化がτを潰す |
| Day 24 | Double ML | ML丸投げは正則化バイアスで100回中100回上振れ(0.581)。残差×残差と交差適合で 0.512 に戻る |
| Day 25 | Causal Forest | 分割規準を効果差にすると木は効果の段差を選ぶ。区間の生命線はhonestyで、外すとカバレッジが 81.3% に落ちる |
| Day 26 | アップリフトモデリング | 反応率が高い人と効果が高い人は別人。上位20%配布で +2,636件、「買いそうな人」順だと -959件 |
| Day 27 | 落とし穴チェックリスト | 設計4・調整4・推定4・解釈3の15項目。チェックリストは合格判定ではなく、どの仮定を買ったかの申告 |
| Day 28 | 空間データと因果推論 | 隣が効くとSUTVAが崩れ、未観測交絡が空間に構造を持つ。個体の処置効果の定義そのものを書き直す回 |
| Day 29 | ベイズと因果推論 | 効果を点ではなく事後分布で語る。識別の仮定は何も軽くならず、変わるのは不確実性の語り方 |
| Day 30(本記事) | 総括 | 3流派の地図・選定フロー・総索引と、30日で残った3つの判断 |

成り立つ場合と成り立たない場合
| 操作変数の仮定(てこが十分強い) | データに出るもの | 2SLS の推定の読み方 |
|---|---|---|
| 成り立つ | 第 1 段階 F が大きい(Day 17 では 16.5) | てこの弱さによる歪みの目印は出ていないので、推定を読める |
| 成り立たない | F が 2 前後まで落ちる | 推定が歪む(真値 1.0 に対し中央値 1.56) |
5. 判断の基準
どの手法をいつ使うか。Day 27 で組んだ選定フローを、分岐だけに削ったものです。順番に意味があります。上から順に「買う仮定が増えていく」向きに並んでいます。

- Q1 は設計の問いです。 処置を自分でランダムに割り付けられるなら、RCT(Day 4・5)が仮定を設計で保証してくれます。割付どおりに従わない人がいれば、ITT と LATE(Day 21)で「誰の効果か」を言い分けます。
- Q2 は、データからは検証できない仮定を信じるかの問いです。 信じるなら、回帰(Day 16)・IPW(Day 7)・マッチング(Day 8)の調整で推定し、ワークフローは DoWhy(Day 15)でたどります。そのうえで、仮定がどれだけ破れたら結論が覆るかを感度分析(Day 9)で数字にします。
- Q3 は、外生の割付の断片が転がっているかの問いです。 外生のてこがあれば操作変数・2SLS(Day 17)、閾値で機械的に割り付けていれば回帰不連続(Day 20)、処置前後のパネルがあれば差分の差分(Day 18。処置ユニットが 1 つなら合成コントロール Day 19)、媒介の通り道を観測できればフロントドア(Day 13)。何もなければ点推定は諦め、感度分析・境界で語ります(Day 9)。
着地した箱の名前は、手法名であると同時に買った仮定の名前です。「DID でやりました」は「平行トレンドを買いました」と同義で、「2SLS でやりました」は「除外制約を買いました」と同義です。会議でこの言い換えができるかどうかが、報告の質をいちばん分けると感じています。
注記 なお、異質効果の系譜(Day 22〜26)はこのフローの外にあります。どの箱に着地したとしても、その上で「誰に効くか」を問う話だからです。

6. 確認問題
問 1(自分の言葉で説明する) 30 日分の道具が「どの仮定を買うか」の 1 枚の地図に畳める理由と、その地図の中で ML の層がどこにいるかを、本文を見ずに 2 文で説明してください。
答えと解説
模範解答: 3 つの流派は入口(割付を疑う、構造を描く、外生の断片を探す)が違っても、どれも検証できない仮定を買って識別に着地するので、流派の違いは買う仮定の違いとして畳めます。ML の層は識別の下流にあり、どの変数で条件付けるかは決めてくれません。
次の 2 点のどちらかが抜けたら不十分です。
- 流派の違いは、買う仮定の違いであること
- ML の層は識別の下流で、識別を代わりにやらないこと
詰まったら 3.1 に戻ってください。
問 2(別の場面へ移す) ある通販サイトが、クーポンを無作為に配った群と配らなかった群で購入率を比べ、差は 1.0 ポイントでした。そこへ、クーポンを配ったあとに決まる「クーポン画面の閲覧回数」を調整に足すと、差は 0.0 ポイントになりました。判断 2 に従うと、報告として最も適切なものはどれでしょうか。
ア 閲覧回数で調整したほうが精密なので、効果は 0.0 ポイントと報告する イ 閲覧回数を足したので、隠れ交絡が消えて効果が正確になったと報告する ウ 閲覧回数は配布の下流の変数なので足さず、無作為割付のままの 1.0 ポイントを報告する エ 変数は多いほど交絡が減るので、さらに変数を足して差を確かめる
答えと解説
ウ。調整は足し算ではありません。足す前に、その変数が処置より前に決まるか、処置の下流かを言います。閲覧回数は配布のあとに決まる下流の変数なので、足すと効果が消えます。Day 27 のデモでも、完全な RCT の 1.00 が、善意で加えた変数 1 つで 0.00 になりました。
- ア(精密さと正しさを取り違える読み違い): 下流の変数を足して 0.0 になった数字は、効果が消えただけで、精密になったわけではありません。
- イ(足すと交絡が消えると読む読み違い): 無作為割付には消すべき交絡がありません。足したのは下流の変数です。
- エ(変数は多いほどよいと読む読み違い): 足すと悪化することすらあります(判断 2)。
問 3(出力を読む) Day 21 のオラクル合成で、2SLS が返した数字は 2.07、同じデータの ATE は 3.19 でした。読み方として最も適切なのはどれでしょうか。
ア 2.07 は小さすぎるので誤りで、3.19 だけが正しい イ 2.07 はコンプライヤーの効果、3.19 は全体の平均の効果で、どちらも正しく、答えている問いが違う ウ 2 つの違いは偶然のばらつきなので、標本を増やせば同じ値になる エ どちらも「効果」なので、手法を選ぶ前に誰の効果かを決める必要はない
答えと解説
イ。2SLS が返した 2.07 はコンプライヤーの効果で、同じデータの ATE は 3.19 でした。どちらも正しい数字で、答えている問いが違うだけです。estimand を先に決めていなければ、この 2 つを 1 つの「効果」として報告してしまいます(判断 1)。
ア: どちらかが誤りなのではありません。ウ: ばらつきではなく、推定している量が違います。エ: 誰の効果か(ATE・ATT・LATE・CATE のどれか)を先に決めないと、数字の意味が決まりません。
7. おわりに

30 日分の道具は、3 つの流派が「どの仮定を買うか」の違いとして 1 枚の地図に畳めます。手法選定は 3 つの分岐で終わり、明日から手が動く形で残った判断は 3 つだけでした。推定対象と割付を先に言葉にする、変数は DAG を描いてから足す、検証できない仮定は消さずに数字で開示する。最後に確かめます。30 日分の道具が「どの仮定を買うか」の 1 枚の地図に畳める理由と、その地図の中で ML の層がどこにいるかを、本文を見ずに 2 文で言えますか。詰まったら 3.1 に戻ってください。
7.1 連載を書いてみての正直な振り返り
淡々と書きます。うまくいかなかったことのほうが学びが大きかったので、そちらを多めに。
- 「分かっている」と「説明できる」の差が想像以上に大きかった。 いちばん効いたのは Day 12 と Day 14 です。do 演算子も反事実も業務で言葉としては使っていましたが、「条件付けは母集団の絞り込み、do は割付機構の書き換え」という対比を、図とコードの両方で書ける状態にはなっていませんでした。集団の do と個体の反事実の違いを、証拠でノイズを縛るかどうかとして書けたのは、Day 14 の原稿を3回書き直したあとです。
- 予測の精度は因果の正しさを何も保証しない、を数字で殴られた。 機械学習エンジニアとしての痛点はここでした。Day 24 で素朴なMLプラグインをモンテカルロ100回回したら、100回すべてが同じ向きに上振れしました。偶然のばらつきではなく系統的な機構だと目で見たのは初めてで、正則化が交絡の係数を縮めた分が処置の係数へ漏れる、という説明を自分の言葉で書けるようになりました。
- 書くと嘘がつけない。設計を2回組み直した。 Day 21 は当初、実データだけで LATE まで見せる予定でしたが、教材データに下流のアウトカムが無く、オラクル合成との二段構成に変えました。Day 25 の honesty も、ライブラリのフラグを切り替えて見せるつもりが、それだと分散推定まで一緒に変わってしまうと分かり、手組みの因果木でモンテカルロを回す構成に差し替えました。コードを実行して数値を本文に載せる縛りは重かったのですが、この縛りがなければ両方とも気づかずに書いていたと思います。
- 反省点。難所ほど詰め込みすぎた。 Day 13 のフロントドアは、識別の式と前提の壊し方を同じ回に入れたせいで読者に厳しい回になりました。回を分けるか、前提の破壊は感度分析側に寄せるべきだったと今は思います。30本を通すと、易しい回の価値を軽く見がちだという自分の癖も見えました。
learning-first の基準では、30本公開したことより「30本ぶんの学びノートが手元に残った」ことを上に置いています。その意味では、書き直した回が多いほど収穫は大きかったです。
7.2 連載の終わりに
30日前に立てた目標は「本を読んだで終わらせない」でした。終わってみると、終わっていない論点のリストのほうが長くなっています。段階導入のDID、媒介、検出力、干渉の一般論、そして空間と因果の本丸。どれも自分の業務でそのまま必要になるものばかりです。
8. 参考(本棚)
8.1 この記事の下敷き
- 本連載 Day 1〜29 の各回の参考節。原典・データ出典・ライセンスは各回に記載
- 本記事にコードはありません。引用した数値はすべて Day 1〜27 の本文コードの実行結果です
- 地図の列の下敷きは 8.2 の本です。左列は Imbens & Rubin、中列は Pearl、右列と推定層は Facure と Ness
8.2 次に読む本
この連載と本記事の地図の下敷きになった原典です。順番も含めておすすめします。潜在的結果から入るなら Imbens & Rubin、構造から入るなら Pearl、実装から入るなら Facure が最短でした。
- Imbens & Rubin『Causal Inference for Statistics, Social, and Biomedical Sciences』。設計を推定に先行させる思想で、本連載 Day 2・4〜9・21 の骨格
- Pearl, Glymour & Jewell『入門 統計的因果推論』と Pearl (2009) Causal Inference in Statistics: An Overview。DAG・do演算子・バックドア・フロントドア・反事実、つまり Day 10〜14 の骨格
- Matheus Facure『Causal Inference in Python』。実装から入るならここ。Day 7・10・16・18〜19・22〜23 で繰り返し使いました
- Hernán & Robins『Causal Inference: What If』。nhefs の本家で、疫学側からの厳密な議論
- Scott Cunningham『Causal Inference: The Mixtape』と Nick Huntington-Klein『The Effect』。準実験デザインの実データ教材で、Day 18〜20 のデータはここから
- Robert Osazuwa Ness『因果AI』。ML×因果の見取り図で、Day 15・24〜26 の下敷き
- 伊藤公一朗『データ分析の力』と安井翔太『効果検証入門』。数式を落として全体像をつかむ和書2冊で、最初と最後に読むと効きます
この記事の位置づけ
因果推論を「本を読んだ」で終わらせず、自分の言葉で説明でき、コードで再現できる状態まで落とす 30 日連載の Day 30 です。

図は縦が分析の工程、横が流派です。この記事は 5 つの系統に共通する土台「総括と地図の描き直し」で、工程は「④ 検証して報告する(仮定の耐性と見せ方)」です(図の横長の黒い札)。前提になるのは Day 27(落とし穴チェックリスト)。連載の最後の回です。
9. Season 2 へ
Season 2
30日から意識的に外した論点です。体系の幹を通すことを優先して落としました。ここから先が Season 2 の候補になります。
- 段階導入のDID(Day 18 で1段落だけ触れた宿題)。Goodman-Bacon (2021)、Callaway & Sant'Anna (2021)、Sun & Abraham (2021)。処置のタイミングがユニットごとに違うと、TWFE の係数が「すでに処置された群を対照に使う」比較を混ぜ込みます
- 媒介分析。VanderWeele『Explanation in Causal Inference』、Imai, Keele & Tingley (2010)。Day 13 で媒介を識別の道具に使いましたが、媒介それ自体を推定対象にすると別の仮定群が必要になります
- 検出力とサンプルサイズの設計。Gelman & Carlin (2014) の Type S・Type M エラー。「有意だった」の裏で符号と大きさがどれだけ壊れているかの話で、実務にいちばん近い宿題です
- 干渉の理論。Hudgens & Halloran (2008)、Aronow & Samii (2017)。Day 28 の空間干渉を一般化した枠組みで、exposure mapping はここから
- 時系列の因果。Brodersen et al. (2015) の Bayesian structural time-series(CausalImpact)。Day 19 と Day 29 の交点にあります
- neural SCM。Xia et al. (2021) The Causal-Neural Connection、Pawlowski, Castro & Glocker (2020) の Deep SCM。Day 14 の反事実をニューラルネットで解く系譜
- 因果とLLM。Kıcıman, Ness, Sharma & Tan (2023)。LLM が因果の知識をどこまで持つのか、DAG の下書きに使えるのかという問い
ここまで読んでいただき、ありがとうございました。次は Season 2 で、この30日で意識的に外した論点から始めます。まずは、Day 18 で宿題にした段階導入のDIDからです。