
この記事は、「アイスが売れる週ほど水難事故も多い」というデータから、アイスが事故の原因なのかを確かめる回です。夏に増えるのはアイスの売上だけではないので、数字が一緒に動く理由は 1 つとは限りません。相関が因果に化ける 3 つの罠を整理し、中心の交絡を numpy の合成データで作って、条件付けで消えるところまで確かめます。
登場人物
遠藤顧問: データ分析の社外顧問。答えを言わずに問いで返す/さくら: データアナリスト 1 年目。数字を出すのは速いが、相関を因果と読み違える
1. 1 文で言うと
1 文で言うと
2 つの量が一緒に動く(相関)ことと、片方が片方を動かす(因果)ことは別物で、ズレを生む罠は ①偶然(疑似相関)/②交絡(共通の原因)/③選択バイアス(サンプルの選ばれ方) の 3 つに整理できます。②と③は処方箋が真逆で、交絡は「調整すべき」、選択バイアス(合流点)は「調整してはいけない」です。
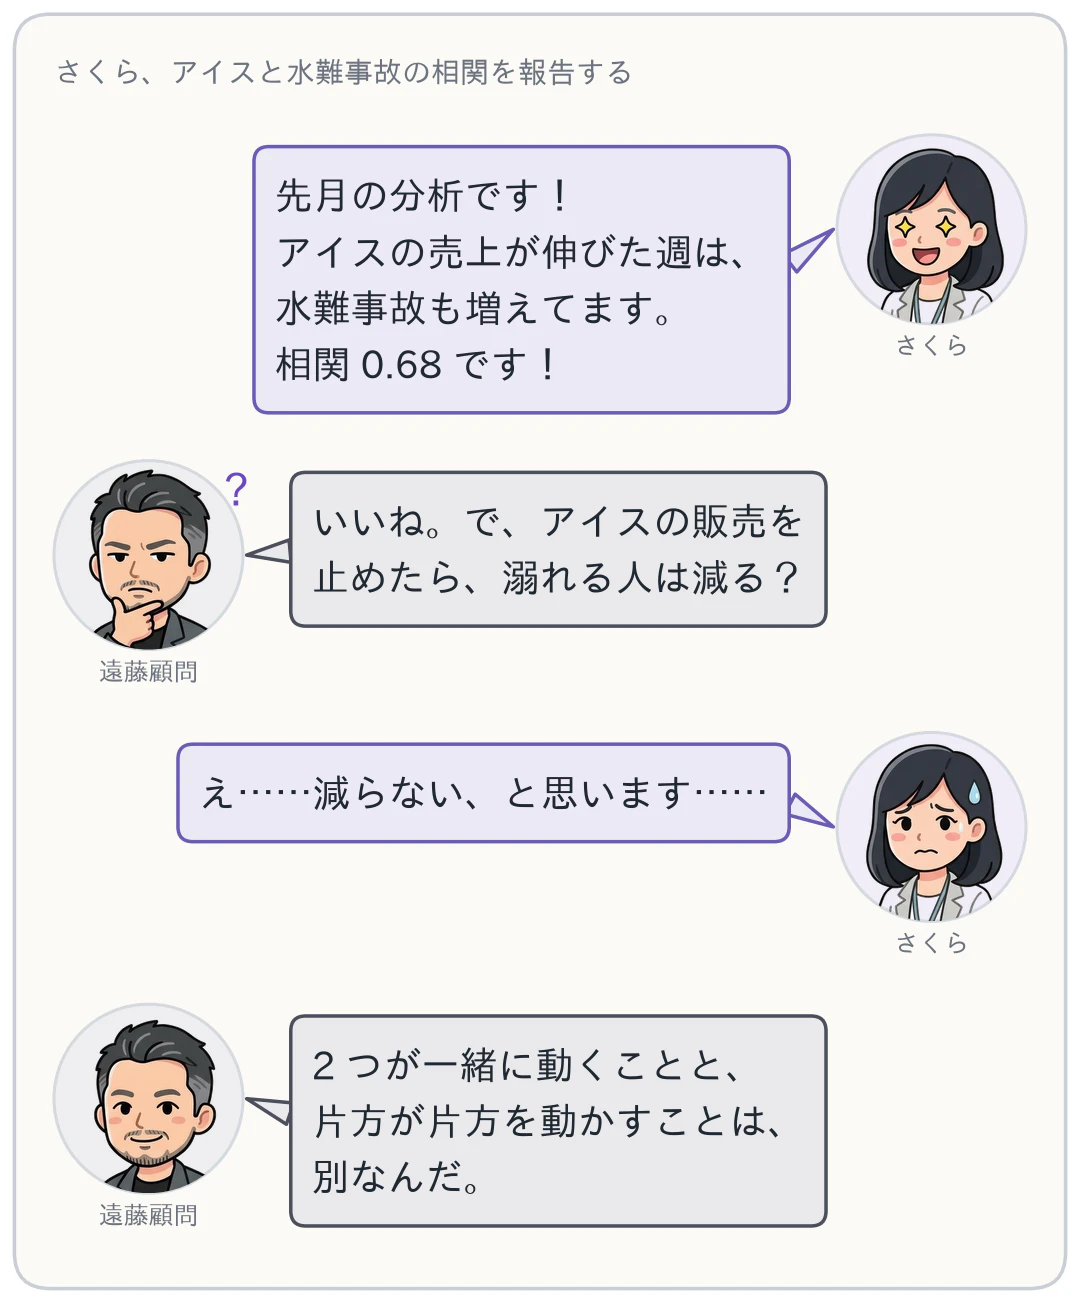
- 今日の数字: 「アイス売上」と「水難事故」の見かけの相関 0.68 は、共通原因の気温で層別化すると 0.01 まで消えます(=交絡)。

2. 今日の問い
今日の問い
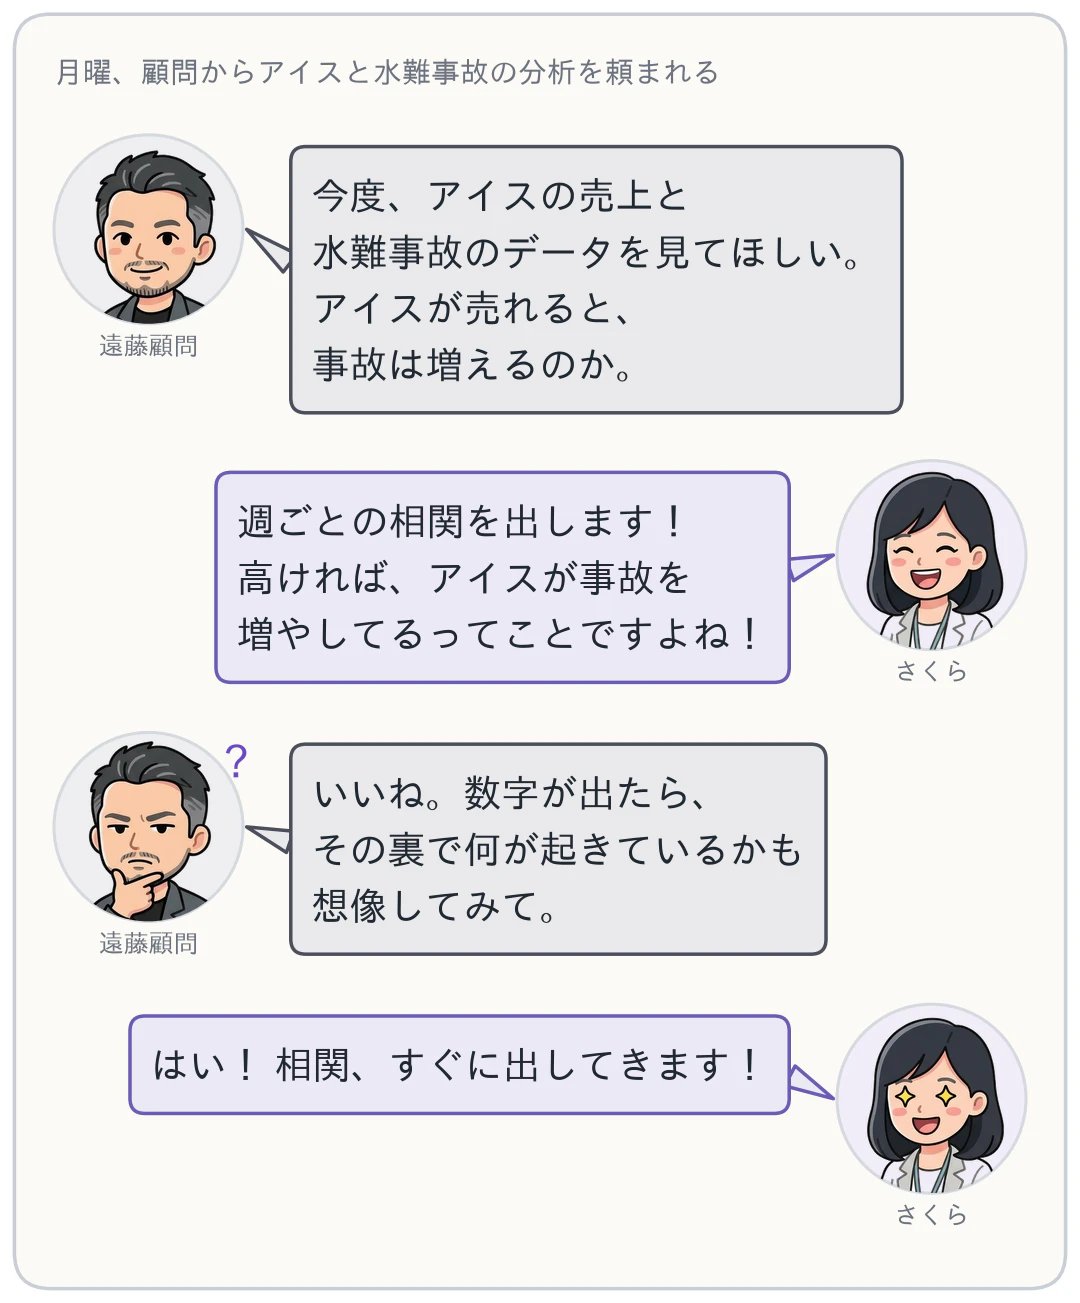
夏になるとアイスクリームの売上が伸び、同じ時期に水難事故も増える。データを取れば両者はきれいに正の相関を示す。
では、アイスの販売を止めれば、溺れる人は減るのか?
読み終えたら、相関が因果からズレる 3 つの罠と、交絡と選択バイアスで調整の向きが逆になる理由を説明できます。
直感で「減るわけがない」と分かります。この直感の正体を言語化するのが今日のゴールです。相関が因果からズレる理由を3つに分解し、うち中心的な「交絡」を numpy で作って、条件付けで消えるところまで手を動かします。
答えは 2 段構えです。3 で 3 つの罠を言葉で整理し、4 で numpy の合成データを使って、交絡・選択バイアス・偶然の順に確かめます。この回は連載の最初なので、前の回はありません。手元の知識から使うのは次の 2 つです。
- 機械学習の予測: 目的変数と一緒に動く特徴量は、予測に使える。ただし、動かして結果が変わるかどうかは別の問い
- 相関係数: 2 つの量が一緒に動く強さを 1 つの数で表す。0.68 のような値は、因果の強さを表すものではない
この連載は 1 日 1 テーマで、各回にコピペで動く最小コードを必ず付けます。学習計画や下書きは Claude に全面的に協力してもらい、伴走しながら自分の理解を深める 1 人アドベントカレンダーの企画です。
改訂について(2026 年 11 月) 全 30 回を公開したあと、各回に「連載の地図の中での位置づけ」「遠藤顧問とさくらの会話」「判断の基準」「確認問題」を足す全面改訂をしました。本文の数値とコードは初版のままです。
3. 相関が因果に化ける3つの罠
先に、手元の道具との違いを置きます。機械学習の予測モデルは、目的変数と一緒に動く特徴量ほど「効く」ものとして使えるので、相関が高ければ十分です。A/B テストなら、アイスの販売を実際に止めて比べられます。今日の場面はどちらでもありません。アイスを止めたら事故が減るのかは介入の問いで、止められない観測データしか手元にありません。相関は共通の原因や絞り込みからも生まれるので、予測の物差しでは、一緒に動いた理由までは分かりません。
「2つの量が一緒に動く(相関)」ことと「片方が片方を動かす(因果)」ことは別物です。ズレを生む典型を3つに整理します。
3.1 罠1:疑似相関(ただの偶然)
因果関係も共通原因もない、純粋な偶然です。無関係な系列でも、たくさん探せば必ず「相関するペア」が見つかります(多重比較。試す回数が増えるほど、偶然の当たりを引きやすくなる現象です)。有名な例が「ニコラス・ケイジの年間出演本数」と「プールでの溺死者数」。笑い話に見えますが、特徴量を大量に試す ML の現場でも同じ罠が口を開けています(あとで10万ペアで実演します)。
3.2 罠2:交絡(共通の原因)★今日の主役
この小節が今日の主役です。共通の原因 Z が、因果のない X と Y に相関をつくる仕組みを読みます。
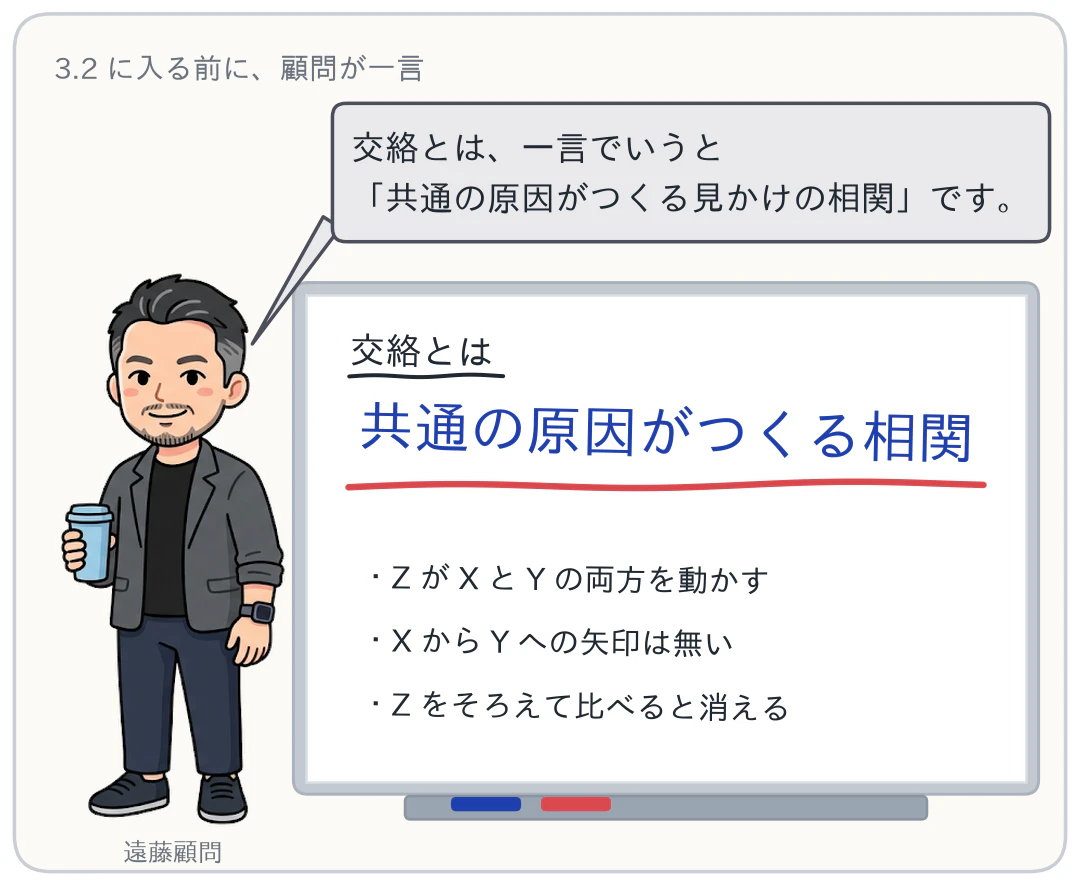
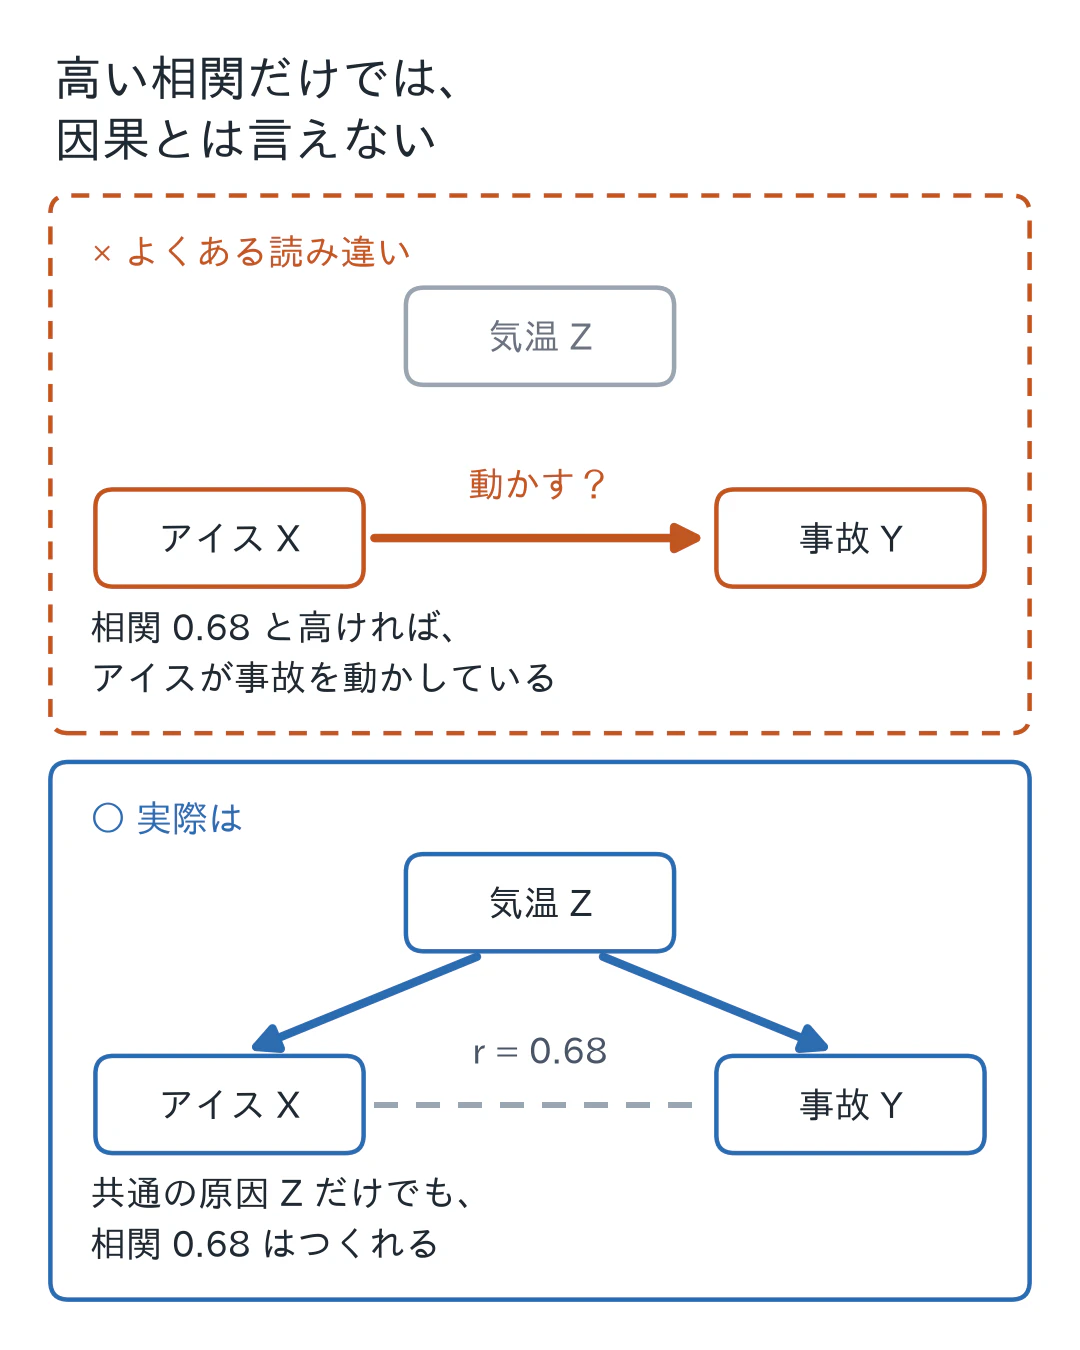
XとYに共通の原因Zがあると、XとYは因果関係がなくても一緒に動きます。アイス(X)と水難事故(Y)はまさにこれで、共通原因は**気温/季節(Z)**です。
XからYへの矢印は無いのに、Z → X と Z → Y の**裏道(バックドア経路)**を通って相関が漏れてきます。これが交絡です。
3.3 罠3:選択バイアス(サンプルの選ばれ方)
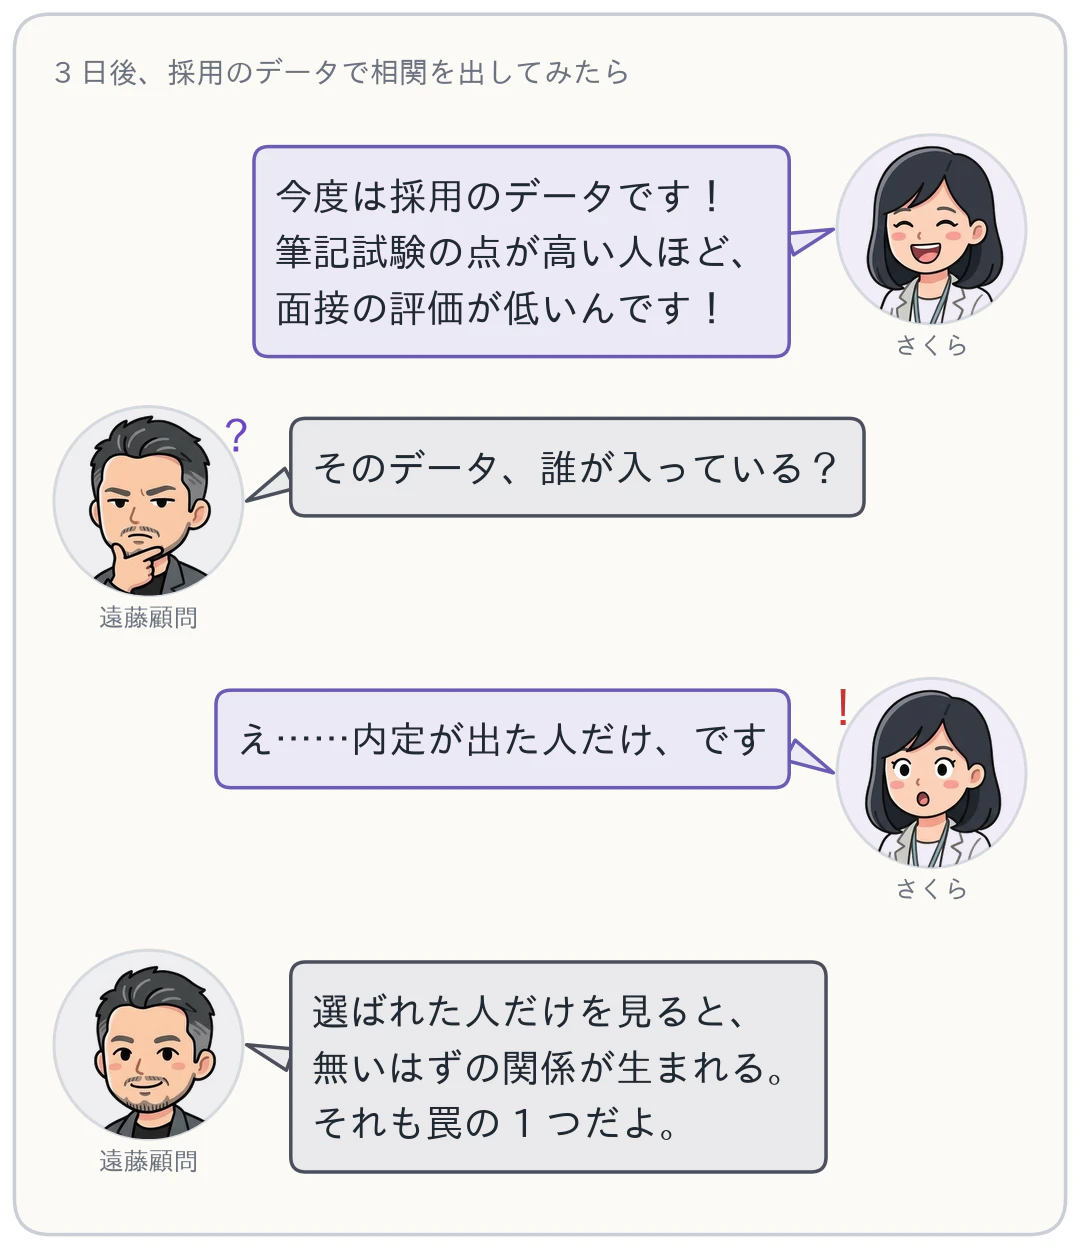
XとYが共通の結果Cを持ち、そのCで絞り込む(選抜する)と、無関係だったXとYに見かけの相関が生まれます。Cを**合流点(collider)**と呼びます。
才能と美貌が世間全体では無相関でも、「才能か美貌のどちらかが高くないと芸能人になれない」なら、芸能人だけを見ると両者は負の相関に見えます(才能が低い芸能人は美貌が高いはず、という選抜の副作用)。生存者バイアスもこの仲間です。
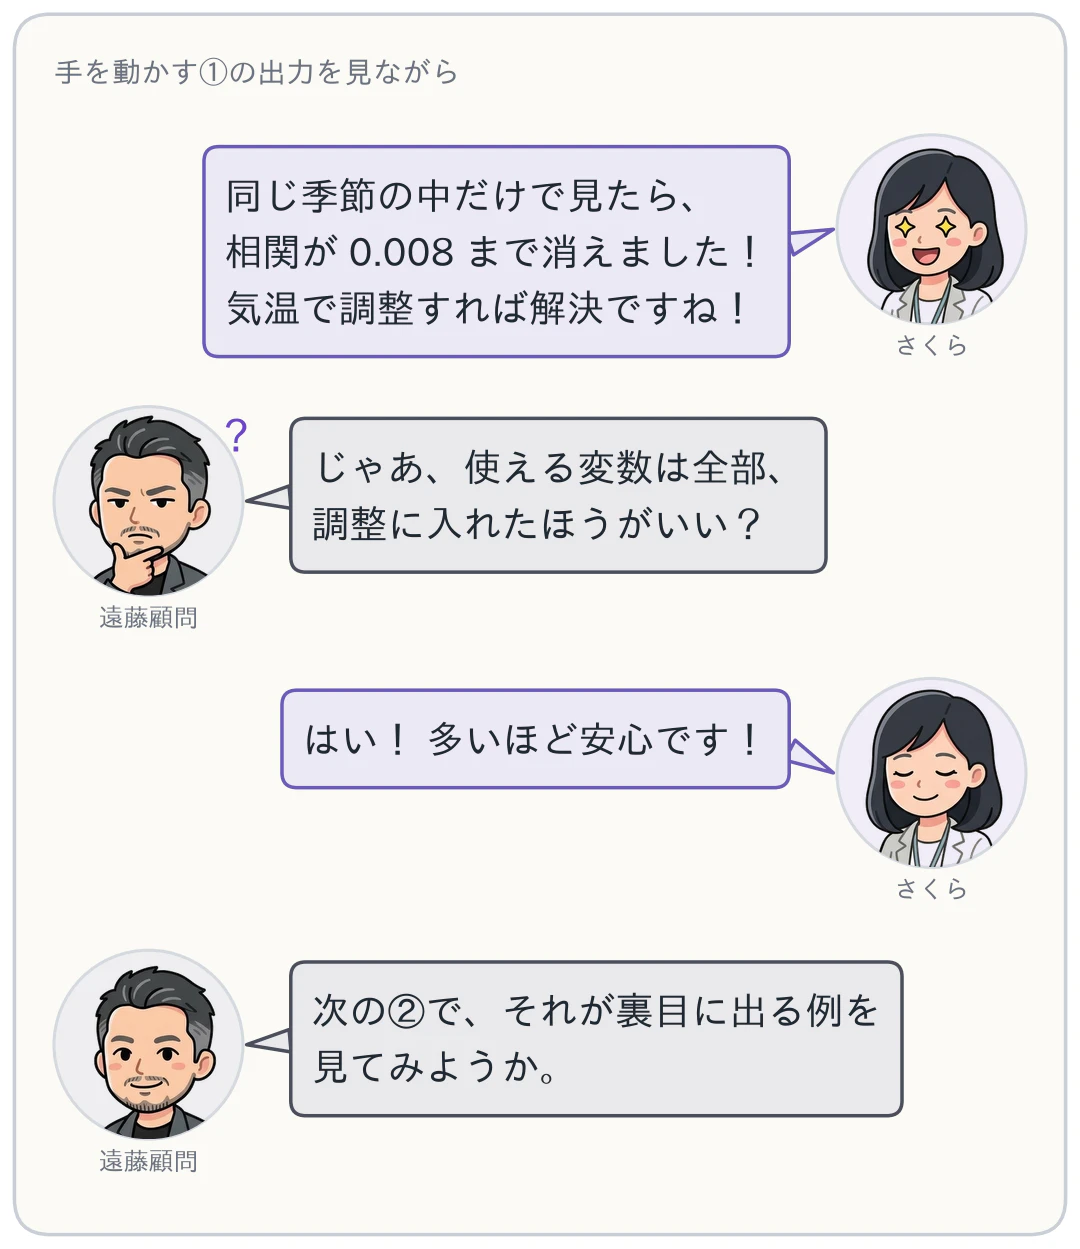
ここが今日いちばん大事:交絡(罠2)は「Zで調整すると消える」。しかし選択バイアス(罠3)は逆で、合流点Cで調整(層別化・コントロール)すると、むしろバイアスが生まれます。「とりあえず共変量を全部入れて調整」は危険で、何で調整すべきかは因果構造(DAG)で決まります。DAG とは、どの変数がどの変数の原因かを矢印で描いた図のことです。これが Day 10〜11 の伏線です。
4. 手を動かす
4.1 交絡を作って、条件付けで消す
罠2をコードで再現します。方針は「XはYの原因ではないが、共通原因Zで両方を動かす」データを作り、素朴な相関 → 気温で層別化した相関、を比べます。
コード
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
n = 2000

# Z(交絡)= 季節/気温レベル 0:真冬 … 4:真夏。ice も drown もこれが原因。
season = rng.integers(0, 5, n)
ice   = 10 + 8 * season + rng.normal(0, 4, n)   # アイス売上
drown =  2 + 3 * season + rng.normal(0, 4, n)   # 水難事故(ice には一切依存しない)
df = pd.DataFrame({"season": season, "ice": ice, "drown": drown})

# (1) 素朴な相関(見かけの相関)
print("全体の相関 r(ice, drown) = %.3f" % df["ice"].corr(df["drown"]))

# (2) 気温(季節)で層別化 = Z を一定にして相関を見る
names = ["真冬", "冬", "春秋", "夏", "真夏"]
rs = []
for s in range(5):
    g = df[df["season"] == s]
    r = g["ice"].corr(g["drown"])
    rs.append(r)
    print("  %s の中だけ: r = %+.3f" % (names[s], r))
print("層内相関の平均 = %.3f" % np.mean(rs))
実行結果(乱数シード固定なので手元でも一致します):
出力
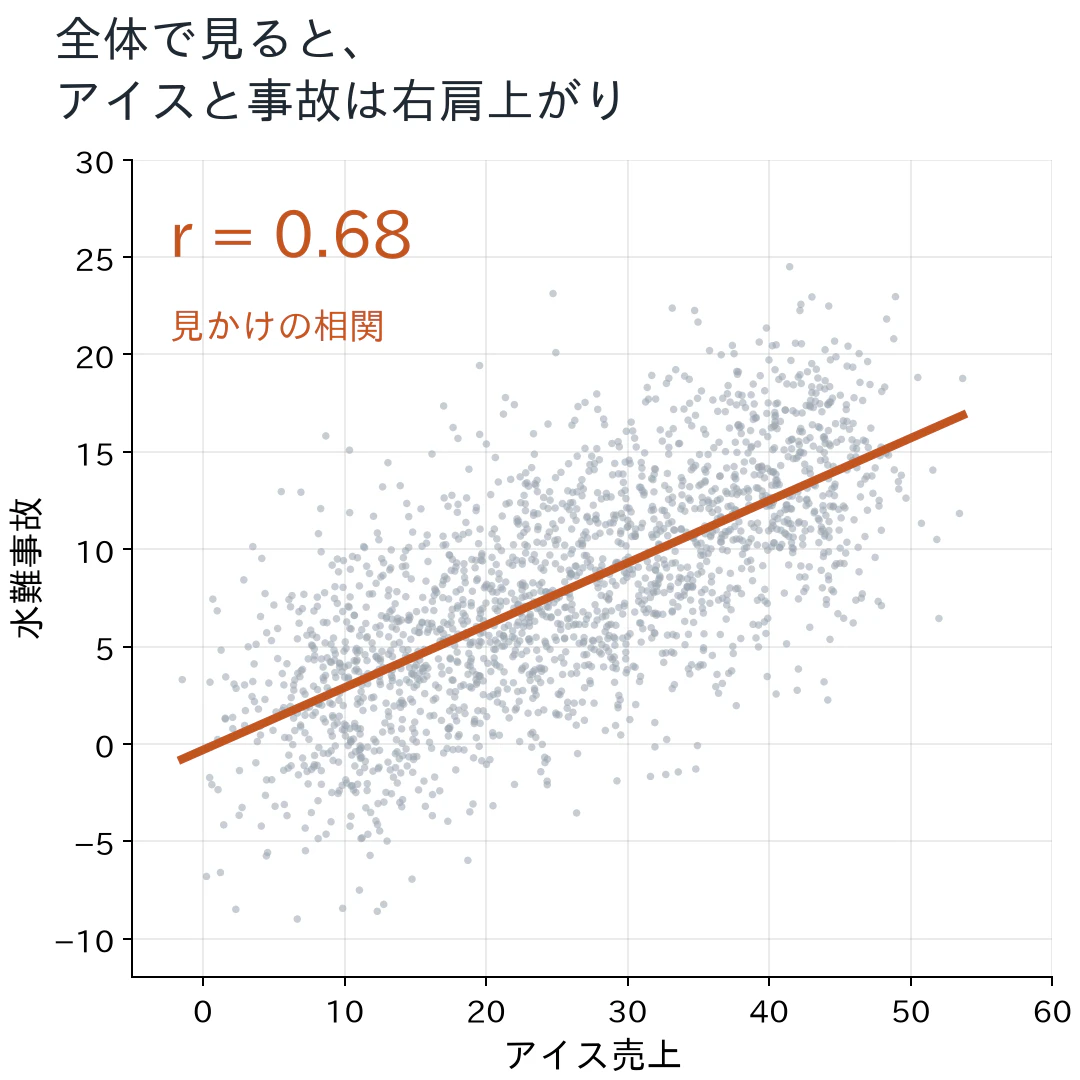
全体の相関 r(ice, drown) = 0.681
  真冬 の中だけ: r = +0.054
  冬 の中だけ: r = -0.026
  春秋 の中だけ: r = -0.016
  夏 の中だけ: r = -0.027
  真夏 の中だけ: r = +0.055
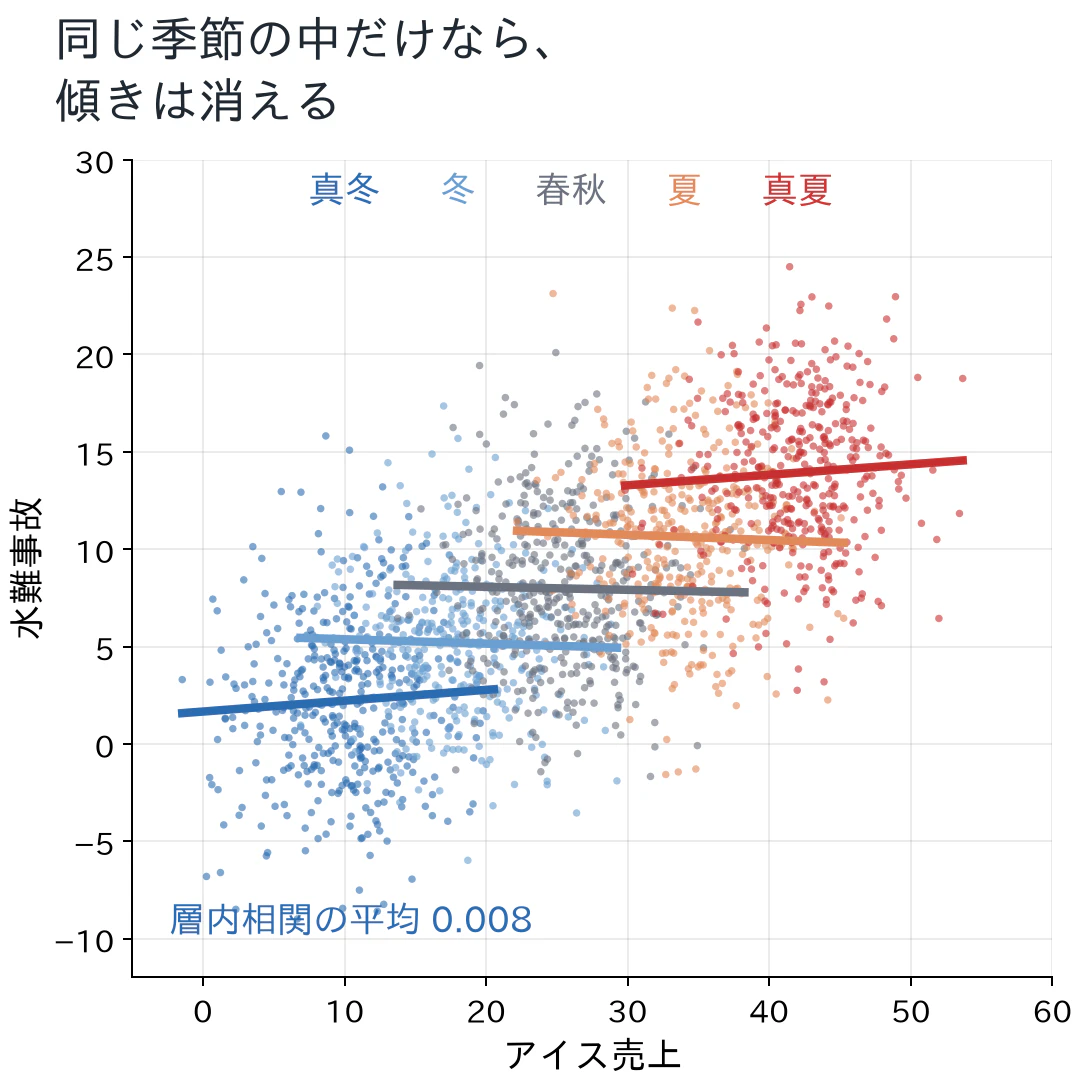
層内相関の平均 = 0.008
全体で 0.68 あった相関が、同じ季節の中だけで見ると 0.008 まで消えました。 コードの中で drown は ice に一切依存させていない(=真の因果効果はゼロ)ので、これは正しい答えです。0.68 は「気温という共通原因の影」だったわけです。
図にすると一目瞭然です(任意・matplotlib)。2 枚目の色が季節です。全体では右肩上がりに見えますが、同じ色の点の塊(=同じ季節)の中には傾きが無いのがポイントです。
コード
import matplotlib.pyplot as plt
import matplotlib_fontja  # 日本語ラベル用(pip install matplotlib-fontja)

def ols_line(ax, x, y, **kw):          # 最小二乗の直線を引く
    b, a = np.polyfit(x, y, 1)   # 1次式で最小二乗フィット(b=傾き, a=切片)
    xs = np.array([x.min(), x.max()])
    ax.plot(xs, a + b * xs, **kw)

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4.7), sharex=True, sharey=True)
colors = plt.cm.coolwarm([0.0, 0.25, 0.5, 0.75, 1.0])

# 左: 全体をまとめて見る(見かけの相関)
ax1.scatter(df["ice"], df["drown"], s=14, color="#8899AA", alpha=0.5)
ols_line(ax1, df["ice"], df["drown"], color="#E8703A", lw=2.6)
ax1.set_title("① 全体をまとめて見る → r = %.2f" % df["ice"].corr(df["drown"]))
ax1.set_xlabel("アイス売上"); ax1.set_ylabel("水難事故")

# 右: 同じ季節の中だけで見る(層別化)
for s in range(5):
    g = df[df["season"] == s]
    ax2.scatter(g["ice"], g["drown"], s=14, color=colors[s], alpha=0.75, label=names[s])
    ols_line(ax2, g["ice"], g["drown"], color=colors[s], lw=2.2)
ax2.set_title("② 同じ季節の中だけで見る → r ≈ 0.01")
ax2.set_xlabel("アイス売上"); ax2.legend(title="季節(気温レベル)")

plt.tight_layout()
plt.savefig("fig1_confounding.png", dpi=130, bbox_inches="tight")
「Zを一定にすると相関が消える」。この条件付け(層別化)が、因果推論のいちばん素朴な調整です。連載を通してやることは、突き詰めれば「正しいZで条件付ける方法」を色々な角度から手に入れることです。
偏相関でも確認できます。気温を線形回帰で除いた残差同士の相関(偏相関)も 0.009 で、層別化と同じ結論になります。層別化=離散で条件付け、偏相関=連続で条件付け、という違いだけです。
4.2 無相関が「選抜」で負に化ける(選択バイアス)
罠3も再現します。才能と美貌を独立に生成し、「合計が高い=芸能人」だけに絞ると何が起きるでしょうか。
コード
import numpy as np
rng = np.random.default_rng(7)
m = 4000
talent = rng.normal(0, 1, m)      # 才能
looks  = rng.normal(0, 1, m)      # 美貌(才能とは独立に生成)

star = (talent + looks) > 1.5     # 芸能人 = どちらか高ければ選抜される「合流点 C」

print("母集団全体   r(才能, 美貌) = %+.3f" % np.corrcoef(talent, looks)[0, 1])
print("芸能人だけ   r(才能, 美貌) = %+.3f" % np.corrcoef(talent[star], looks[star])[0, 1])
出力
母集団全体   r(才能, 美貌) = -0.001
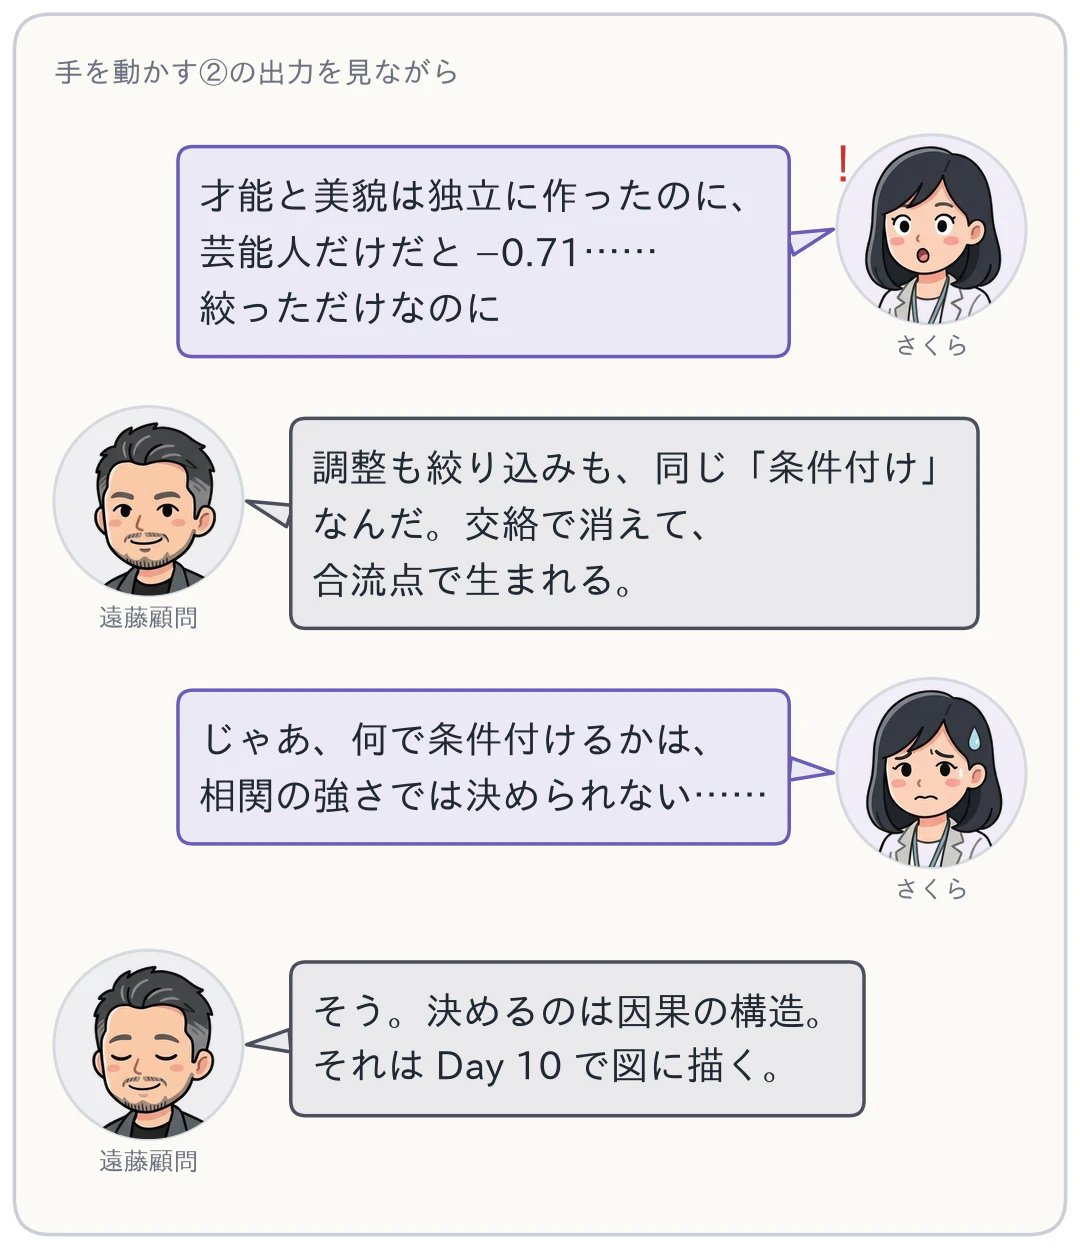
芸能人だけ   r(才能, 美貌) = -0.710
1行目が世の中全員を見たときの相関、2行目が芸能人だけに絞ったときの相関です。


1 枚目が全員、2 枚目が芸能人だけの散布図です。全員では雲が丸いのに、選抜された 2 枚目では右下がりに傾いています。これは『因果推論の科学』で**説明効果(explaining away)**と呼ばれているトリックです。
生成時に相関ゼロ(−0.001)だったものが、選抜という「合流点での条件付け」で −0.71 まで負に化けました。罠2と見比べてください。条件付けが、交絡では相関を消し、合流点では相関を作ります。同じ「絞り込む」操作が、因果構造しだいで真逆に働きます。
4.3 (おまけ)偶然でここまで相関する
罠1の実感です。長さ12の無関係な系列を10万ペア用意し、その中の最大相関を見ます。
ここでのポイントは、「10万組」作成するということです。
まず、長さ12の乱数を1組だけ作ってみます(rng は下のコードと同じ np.random.default_rng(0) です)。
コード
a = rng.normal(0, 1, (12, 1))  # 平均0, 標準偏差1, 形状[1, 12]の乱数配列
b = rng.normal(0, 1, (12, 1))  # 平均0, 標準偏差1, 形状[1, 12]の乱数配列
中身を覗くと、こうなります。
出力
>>> a[0]
array([ 0.12573022, -0.13210486,  0.64042265,  0.10490012, -0.53566937,
        0.36159505,  1.30400005,  0.94708096, -0.70373524, -1.26542147,
       -0.62327446,  0.04132598])
>>> b[0]
array([-0.63556367,  0.77278602,  0.91370425,  0.40274777,  0.39820202,
       -2.0565533 , -0.23560398,  0.59515886,  0.83801342,  1.40550379,
        0.58454769, -0.54382252])
2本の並びに似たところはなく、全く相関がなさそうなペアです。そりゃそうなります。
しかし、10万ペアを用意すると、中には激しく相関するペアが出てきます。
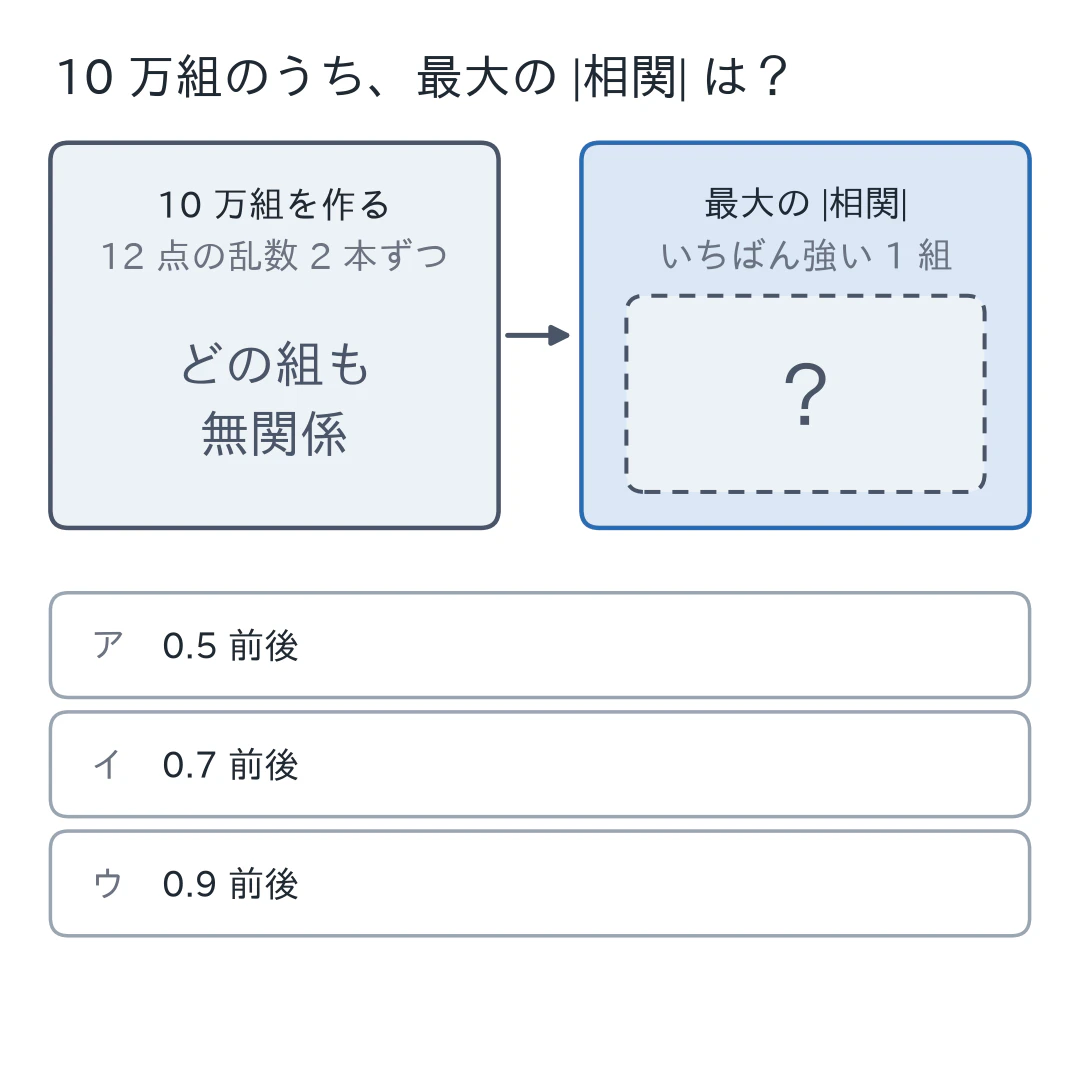
出力を開く前に予想してください。10 万組のうち、いちばん強い相関(|相関|)は、いくつくらいでしょうか。
コード
import numpy as np
rng = np.random.default_rng(0)
T, K = 12, 100_000
a = rng.normal(0, 1, (K, T)); b = rng.normal(0, 1, (K, T))
am = a - a.mean(1, keepdims=True); bm = b - b.mean(1, keepdims=True)
r = (am * bm).sum(1) / np.sqrt((am**2).sum(1) * (bm**2).sum(1))
print("最大 |相関| = %.3f" % np.abs(r).max())
print("|相関|>0.7 の割合 = %.2f%%" % ((np.abs(r) > 0.7).mean() * 100))
出力
最大 |相関| = 0.934
|相関|>0.7 の割合 = 1.09%
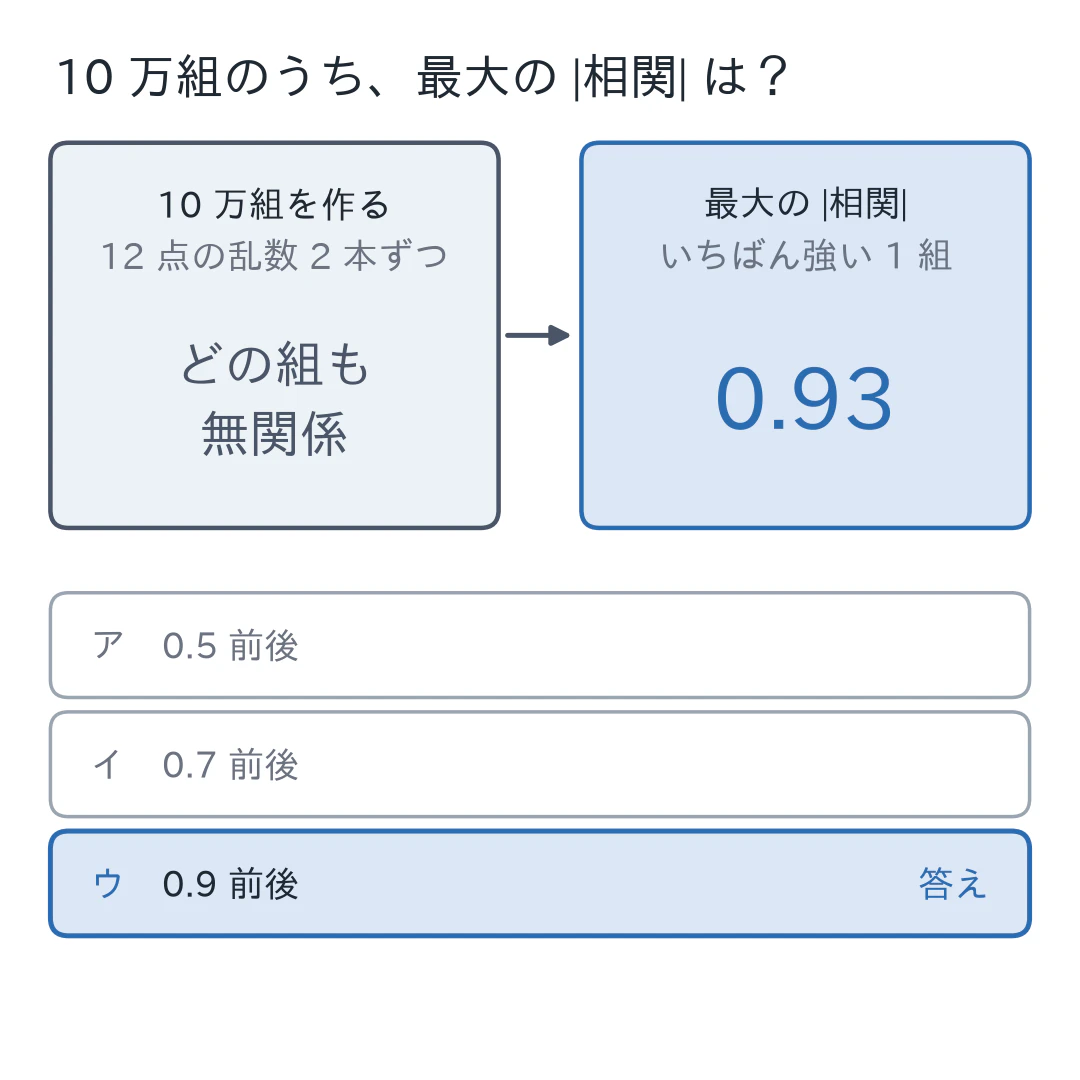
1行目は10万ペアの中でいちばん強く相関したペアの相関係数、2行目は「見た目にはかなり相関している」と言いたくなる |r|>0.7 のペアが全体の何%あったか、です。
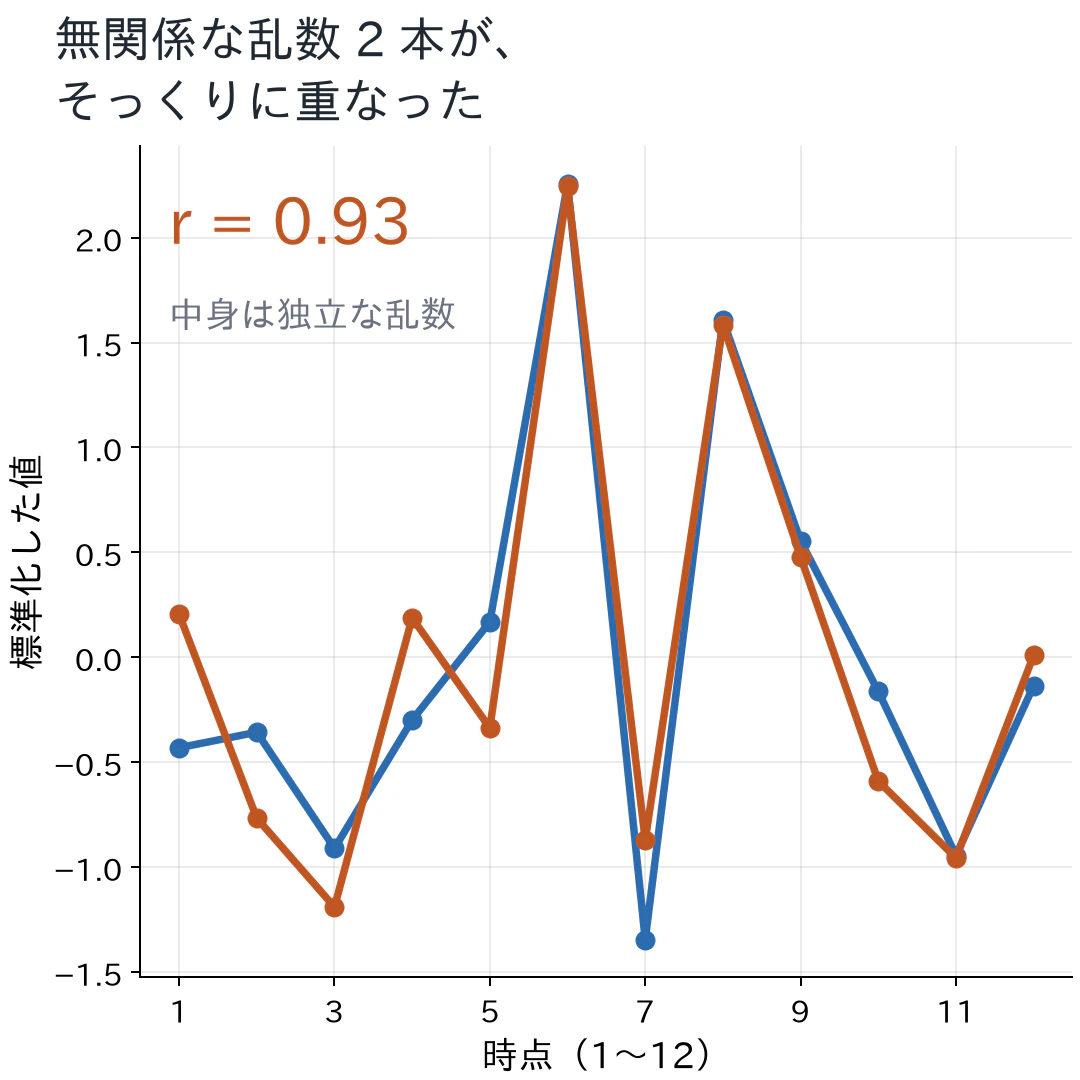
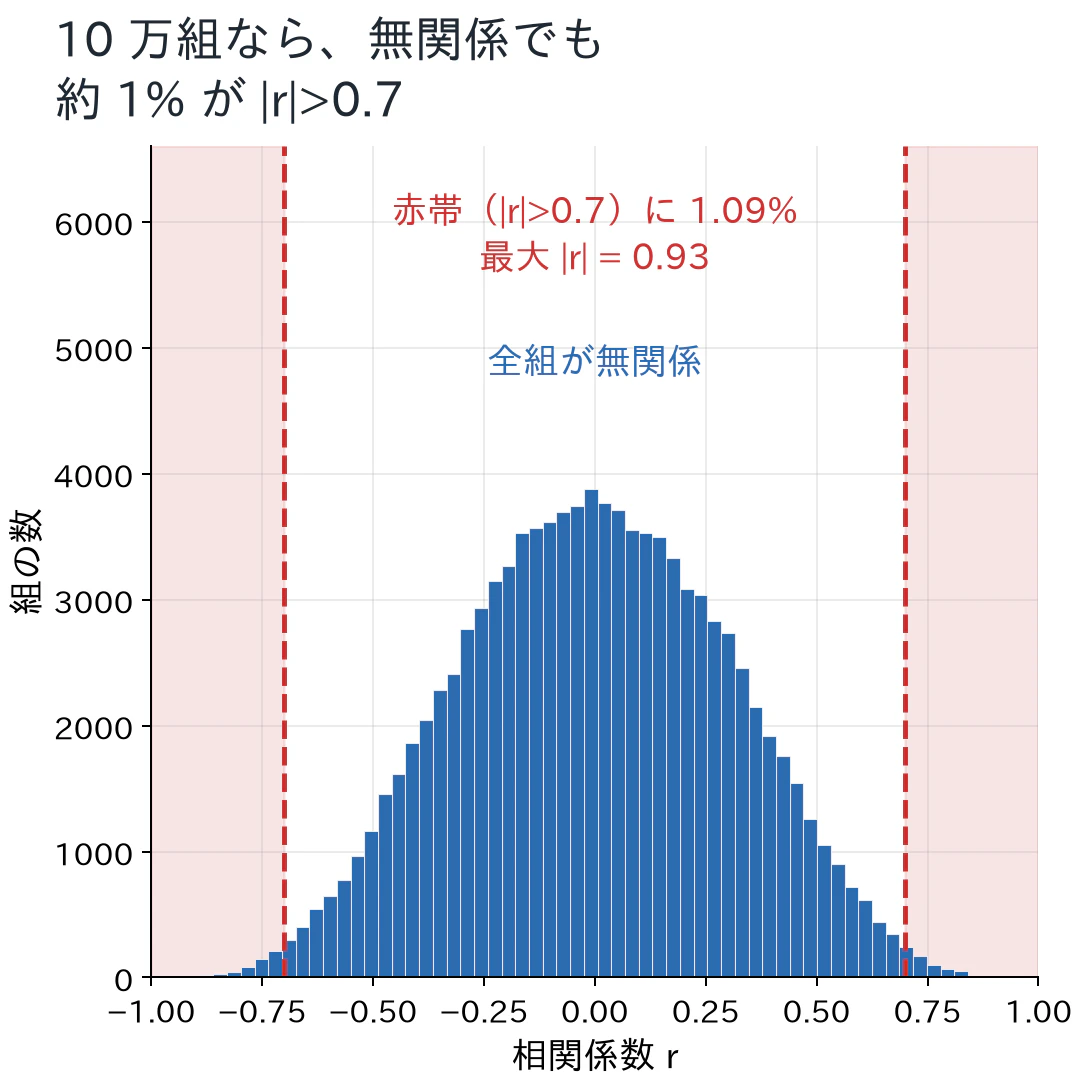
1 枚目が、たまたま r = 0.93 になった1組の折れ線です。2本がそっくり重なって見えますが、中身はただの独立な乱数です。2 枚目は10万組ぶんの相関係数のヒストグラムで、山の中心はちゃんとゼロにあるものの、裾が赤帯(|r|>0.7)まで伸びています。
完全に無関係でも、探せば 相関0.93 のペアが出るし、約1%は |r|>0.7 です。特徴量を大量に試して「効いてそうな変数」を拾うと、この偶然を掴まされます。
成り立つ場合と成り立たない場合
| 仮定 | データに出るもの | 今日の数字の読み方 |
|---|---|---|
| 共通の原因 Z が X と Y の両方を動かしている(交絡) | 全体の相関 0.681、同じ季節の中だけでは 0.008 | 0.68 は Z がつくった見かけの相関。Z で調整すると消える |
| 共通の結果 C で絞り込まれている(選択バイアス) | 母集団全体の相関 −0.001、芸能人だけでは −0.710 | −0.71 は絞り込みがつくった相関。C で調整してはいけない |
5. 判断の基準
相関を見つけたとき、因果と言う前に通す問いを 3 つに絞りました。上から順にたどり、最初に右へ出たところが、いま踏んでいる罠です。

- Q1 を最初に置く理由は、偶然を落とさないまま交絡や選抜を議論しても全部が無駄になるからです。仮説を事前に 1 つに絞ったか、別のデータでも再現したか、だけを見ます。
- Q2 と Q3 は処方箋が真逆です。Q2 で引っかかったら「その変数で調整する」、Q3 で引っかかったら「絞り込みを外す、または絞られ方を模型に入れる」。Q3 の状況で調整すると、手を動かす②のように無いはずの相関を自分で作ります。
- 3 つとも通ったら因果の候補として先へ進めます。ただし「何で調整するか」は相関の強さではなく因果の構造(DAG)で決めます。それは Day 10〜11 の仕事です。
相関がない=因果がない、も誤りです。 逆向きの効果や複数の経路が打ち消し合うと、因果があるのに相関が 0 に見えることがあります(連載の中盤で扱う抑圧・相殺)。相関は因果の必要条件ですらありません。この判断フローは「相関を見たとき」の問いであって、「相関がないとき」に因果を否定する道具ではないことに注意してください。
自分の仕事に当てるなら、次の問いから始められます。予測モデルで目的変数と相関が高かった特徴量を 1 つ選び、その特徴量と目的変数の両方を動かす共通の原因が無いかを、書き出してみましょう。
6. 確認問題
問 1(自分の言葉で説明する) 交絡と選択バイアスでは、調整の向きが逆になります。その理由を、本文を見ずに 2 文で説明してください。
答えと解説
模範解答: 交絡では、共通の原因 Z が X と Y の両方を動かしているので、Z で条件付けて裏道をふさぐと、見かけの相関が消えます。選択バイアスでは、共通の結果 C で絞り込むこと自体が相関をつくるので、C で調整するとむしろ無かった相関が生まれ、調整してはいけません。
次の 2 点のどちらかが抜けたら不十分です。
- 交絡は Z で調整すると消えること
- 合流点 C で調整すると相関が生まれること(だから調整しない)
詰まったら 3.2 と 3.3 に戻ってください。
問 2(別の場面へ移す) あるニュースアプリで、通知を開く回数が多い人ほど月の課金額が高く、相関は 0.6 でした。ところが、利用日数が同じ人どうしに分けて見ると、どの層でも相関は 0.05 前後でした。この結果の読み方として最も適切なものはどれでしょうか。
- ア 通知を増やせば課金が増える。0.6 は十分に高い相関だから
- イ 層に分けて下がった 0.05 が偽物で、全体の 0.6 が本当の関係だ
- ウ 0.6 の大半は、利用日数という共通の原因がつくった見かけの相関で、通知の効果は小さいと読む
- エ 課金額が通知の原因なので、通知と課金の関係は逆向きだ
答えと解説
ウ。利用日数が通知を開く回数も課金額も動かしているなら、今日のアイスと水難事故と同じ形です。同じ層の中でほぼ消えた 0.6 は、共通の原因の影と読みます(4.1)。
- ア(相関の高さを因果と読む読み違い): 相関の強さは、因果の証拠にも反証にもなりません。
- イ(全体の数字を本物と読む読み違い): 共通の原因をそろえて比べた 0.05 のほうが、通知と課金の関係に近い数字です。
- エ(向きの取り違え): 逆向きの因果を支持する根拠は何もなく、共通の原因で説明がつきます。
問 3(出力を読む) 次の出力を得ました。2 行目の −0.710 をどう読むのが正しいでしょうか。
母集団全体   r(才能, 美貌) = -0.001
芸能人だけ   r(才能, 美貌) = -0.710
ア 芸能界では才能と美貌がトレードオフの関係にある(因果) イ 「才能+美貌が高い人だけ」という選抜で生まれた見かけの負の相関 ウ 乱数シードの偶然で、別のシードなら消える エ 芸能人のサンプルが小さいための誤差
答えと解説
イ。生成コードで才能と美貌は独立に作っています(1 行目の −0.001 がその確認)。絞り込みの条件「才能+美貌 > 1.5」が合流点で、そこで条件付けたことによる見かけの相関です。
ア: データ生成に因果は入っていません。ウ: シードを変えても同じ向きの負の相関が出ます(選抜の仕組みが原因なので)。エ: 誤差なら符号も大きさも安定しませんが、これは安定して −0.7 付近に出ます。
7. おわりに
2 つの量が一緒に動く(相関)ことと、片方が片方を動かす(因果)ことは別物で、ズレを生む罠は ①偶然(疑似相関)/②交絡(共通の原因)/③選択バイアス(サンプルの選ばれ方) の 3 つに整理できます。②と③は処方箋が真逆で、交絡は「調整すべき」、選択バイアス(合流点)は「調整してはいけない」です。何で調整するかは相関の強さではなく因果の構造で決めます。この 3 つが、30 日の出発点です。最後に確かめます。相関を見たら疑う 3 つの罠と、交絡と選択バイアスで調整の向きが逆になる理由を、本文を見ずに 2 文で言えますか。詰まったら 3.2 と 3.3 に戻ってください。
8. 参考(本棚)
- Matheus Facure『Causal Inference in Python』第1章
- 伊藤公一朗『データ分析の力』第1章
- 『はじめての統計的因果推論』
- Judea Pearl・Dana Mackenzie『因果推論の科学』(説明効果・合流点の直感的な説明)
この記事の位置づけ
因果推論を「本を読んだ」で終わらせず、自分の言葉で説明でき、コードで再現できる状態まで落とす 30 日連載の Day 1 です。

図は縦が分析の工程、横が流派です。この記事は 5 つの系統に共通する土台「相関と因果の3つの罠」で、工程は「① 問いを立てる(何の効果を誰について)」です(図の横長の黒い札)。前提になる回はありません(この記事から読めます)。ここで覚える考え方や道具は Day 6(割付と非交絡性)・Day 7(傾向スコアとIPW)・Day 11(d分離とバックドア)・Day 16(回帰とFWL)・Day 27(落とし穴チェックリスト) で再登場します。
9. 次回予告(Day 2)
Day 2(潜在的結果と推定対象)
「アイスを止めても溺死は減らない」を個体レベルで厳密に言うための言葉、**潜在的結果(もし処置していたら/していなかったら)**と、因果推論の根本問題をやります。ATE/ATT/CATE を定義し、「観測できるのは片方だけ」をコードで可視化します。