
この記事は、「平均すると効果ゼロの施策は、本当に誰にも効かないのか」を確かめる回です。効く人と逆効果の人が混ざっていれば、平均は打ち消し合ってゼロになりえます。平均の内側にある効果の地形 CATE と、事前に決めた群で地形を粗く読む GATE を、真の効果を握った合成データ(年齢で効果が反転する RCT、4,000 人)で確かめます。
登場人物
遠藤顧問: データ分析の社外顧問。答えを言わずに問いで返す/さくら: データアナリスト 1 年目。数字を出すのは速いが、相関を因果と読み違える
1. 1 文で言うと
1 文で言うと
CATE $\tau(x) = E[Y(1) - Y(0) \mid X = x]$ は、特徴 $x$ ごとの平均効果を並べた効果の地形図で、ATE はそれを 1 つの数字に押し潰した要約です。地形を覗くときに最初に効くのは新しい推定量ではなく、群を処置前の変数で、分析の前に、少数だけ決めるという規律です。
- 今日の数字: 推定ATEは −0.005 でしたが、真の効果は30歳で +1.93、70歳で −1.93 でした。
2. 今日の問い
今日の問い
ある施策のRCTを回したら、推定ATEはほぼゼロだった。「効果なし、撤退」と報告してよいか?
もし半分の人に+2、残り半分に−2なら、平均ゼロでも正解は撤退ではなく「効く半分にだけ届ける」のはず。平均の裏にある効果の地形を、罠を踏まずに覗く方法はあるか?
読み終えたら、平均がゼロでも効果の地形が平らとは限らない理由と、地形を罠なしで粗く読む条件を、説明できます。
今日のゴールは3つです。まず、効果の地形を指す言葉 CATE を定義します。次に、地形を覗こうとした人が最初に踏む罠、サブグループ解析の偽陽性をシミュレーションで踏んでみせます。最後に、罠を避けて地形を粗く読む GATE を正しく出します。あわせて、この地形の推定が「平均より桁違いに難しい」理由と、Phase 4 の残り4日間の地図を描きます。前の回から使うのは次の 2 つです。
- Day 2(潜在的結果): 個人の効果は、1 人について受けた場合と受けなかった場合の片方しか観測できない
- Day 4(RCT): 無作為に割り付ければ、処置群の平均から対照群の平均を引いた差が効果の推定になる
3. 概念
先に、手元の道具との違いを置きます。A/B テストなら、無作為に分けた 2 群の平均を引き算して、全体の効果を 1 つの数字で出します。回帰や予測モデルなら、年齢などの特徴を入れて、結果 $Y$ を当てにいきます。今日の場面は、そのどちらでも足りません。1 つ目は、平均がゼロでも、効く人と逆効果の人が混ざっていないかを教えてくれません。2 つ目は、$Y$ を当てる精度が高くても、1 人ひとりの効果は観測できないので、効果の地形そのものは答え合わせができません。そこで、特徴ごとの平均効果という新しい量を定義し、罠を避けて読む手順から入ります。
3.1 CATE:平均の内側にある効果の地形
この小節が今日の主役です。前半で CATE の式を縦棒の右から読み、後半で推定の式と、地形を粗く読む GATE を押さえます。
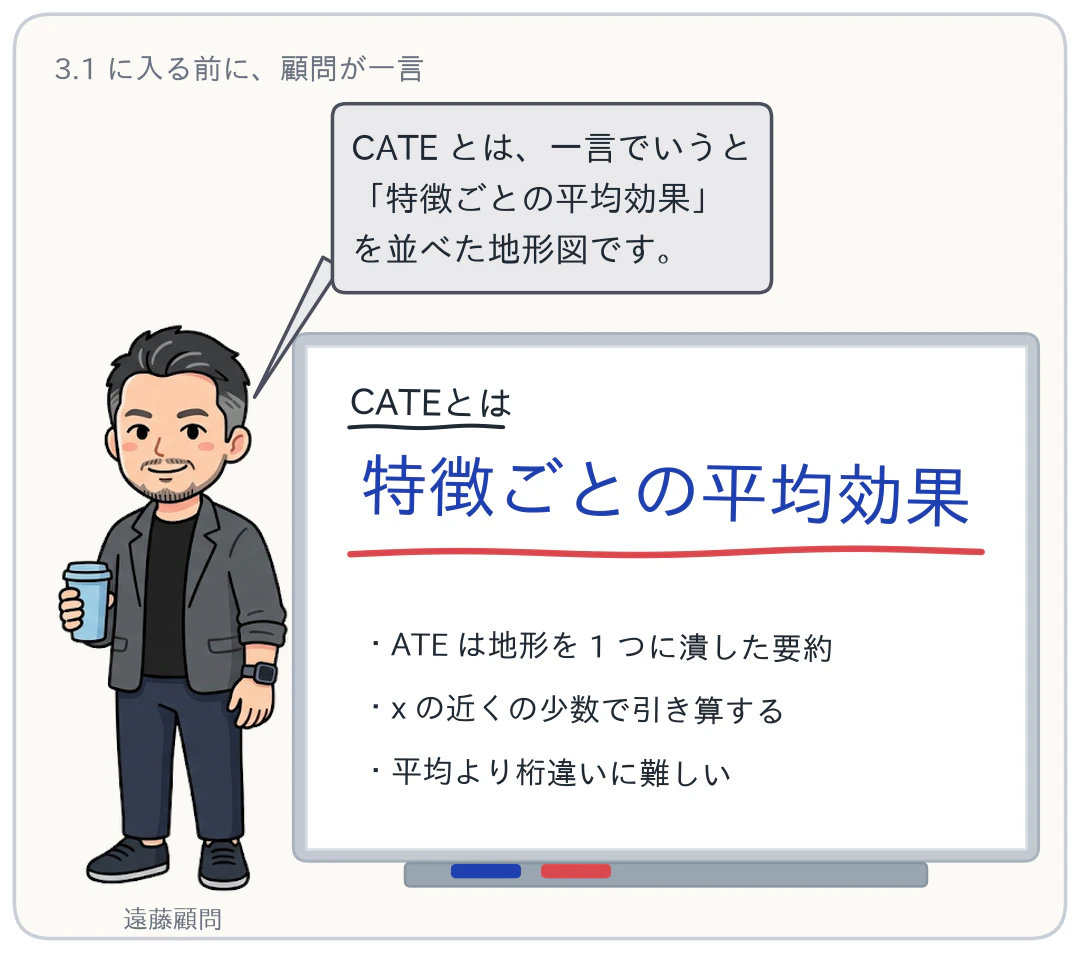
欲しかったのは「この施策は、誰に効くのか」という答えです。ところが 1 人ひとりの効果は観測できず、全員の平均では、効く人と逆効果の人が混ざって打ち消し合います。個人までは降りられないし、全員では粗すぎる。そこで「特徴が同じ人たちの中での平均効果」を考え、特徴ごとに並べて地形図にします。それに名前を付けたのが CATE です。

Day 2 で定義した個人の処置効果 $\tau_i = Y_i(1) - Y_i(0)$ は、根本問題のせいで誰のものも観測できませんでした。だからまず全員の平均 ATE に逃がした、というのがこれまでの流れです。その中間に、共変量で条件付けた平均があります。
$$
\tau(x) = E[,Y(1) - Y(0) \mid X = x,]
$$
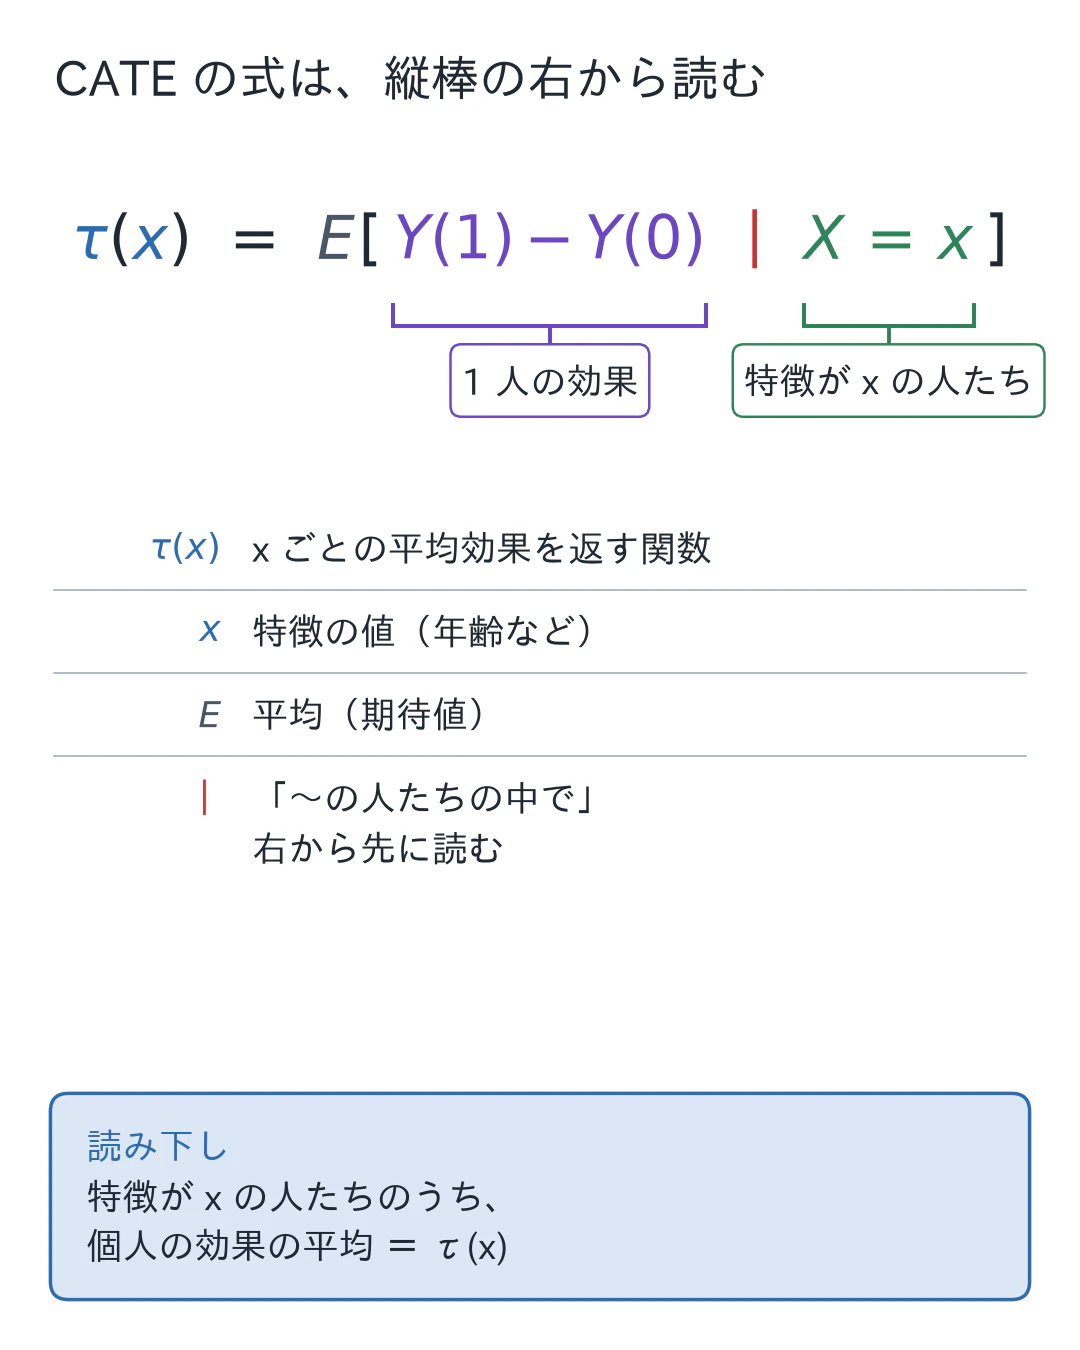
これが CATE(conditional average treatment effect、条件付き平均処置効果)です。「年齢30歳の人たちでの平均効果」「管齢40年の鋳鉄管での平均効果」のように、特徴 $x$ ごとの平均効果を並べた関数で、効果の地形図にあたります。
式は左からではなく、縦棒の右から読みます。3 つに分けて読みます。
- 「$X = x$」は「特徴が $x$ の人たち」(たとえば 30 歳の人たち)で、縦棒はその人たちの中で、という条件の印です。
- 「$Y(1) - Y(0)$」は 1 人ひとりの、処置を受けた場合と受けなかった場合の結果の差、つまり個人の効果 $\tau_i$ です。
- $E$ はその平均(期待値)を表します。
つなげると「特徴が $x$ の人たちのうち、個人の効果を平均した値」。$x$ を入れると数字が 1 つ出てくる関数なので、左辺は $\tau(x)$ と $x$ の関数の形で書きます。
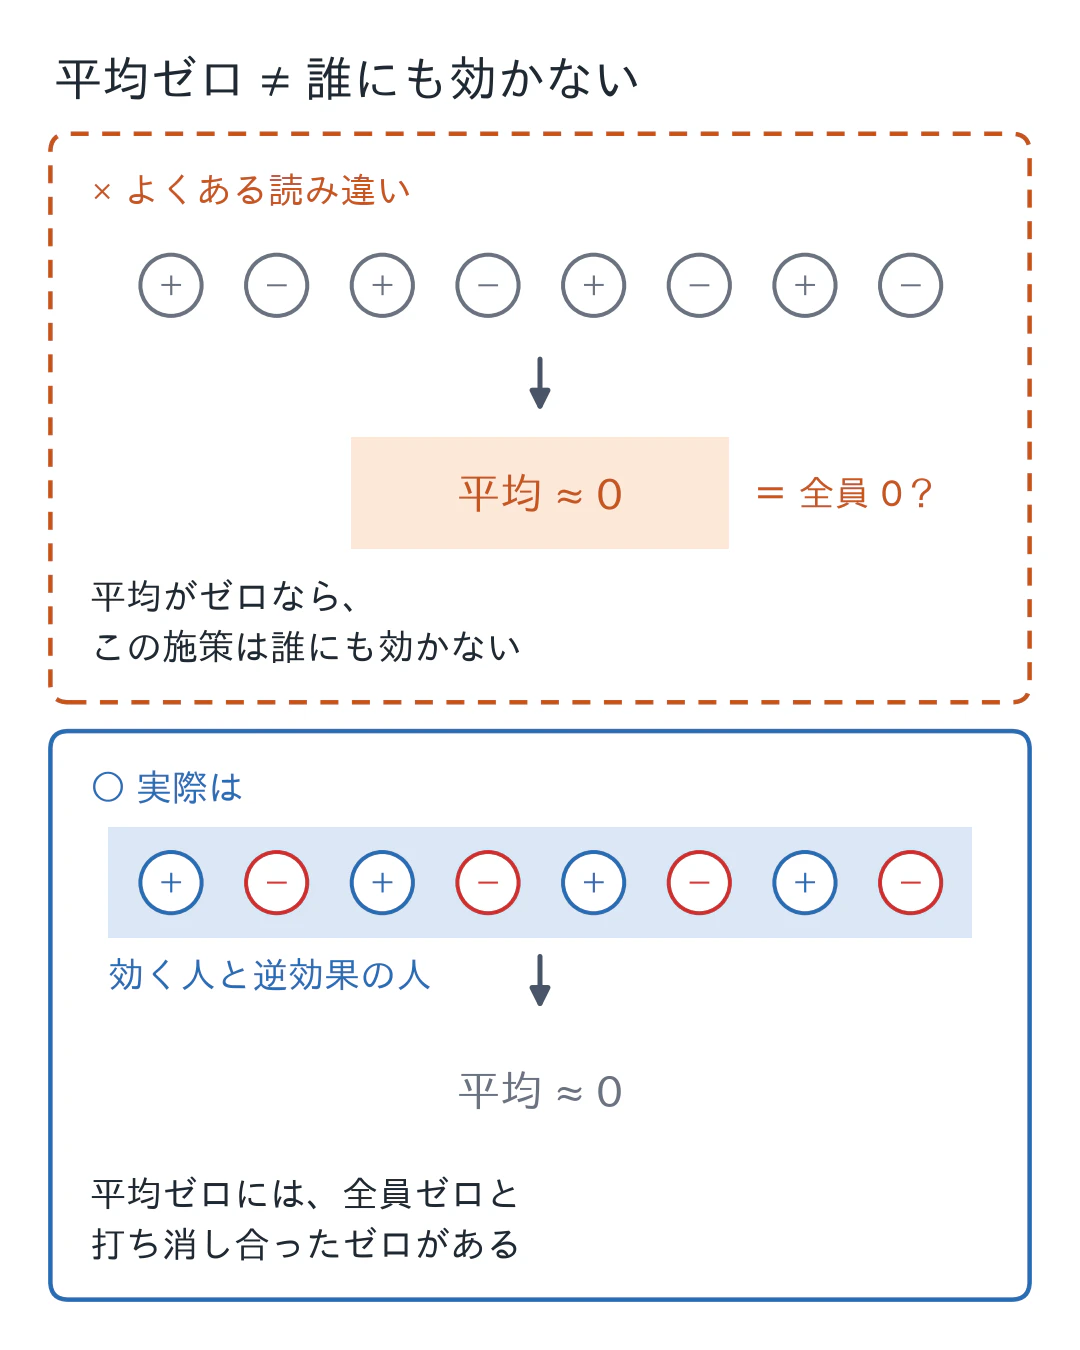
式にしたご利益は、「誰に効くか」を ATE と同じ言葉で書けることです。ATEはその全平均 $E[\tau(X)]$ なので、地形を1つの数字に押し潰した要約です。押し潰す前の地形が平坦ならATEだけで足りますが、山と谷(正と負)があるなら、ATEがゼロでも施策を捨てるのは早い。谷を避けて山にだけ届ければよいからです。
推定の入口は素直です。RCTなら(観察データなら Day 6 の非交絡性のもとで)、
$$
\tau(x) = E[Y \mid W=1, X=x] - E[Y \mid W=0, X=x]
$$
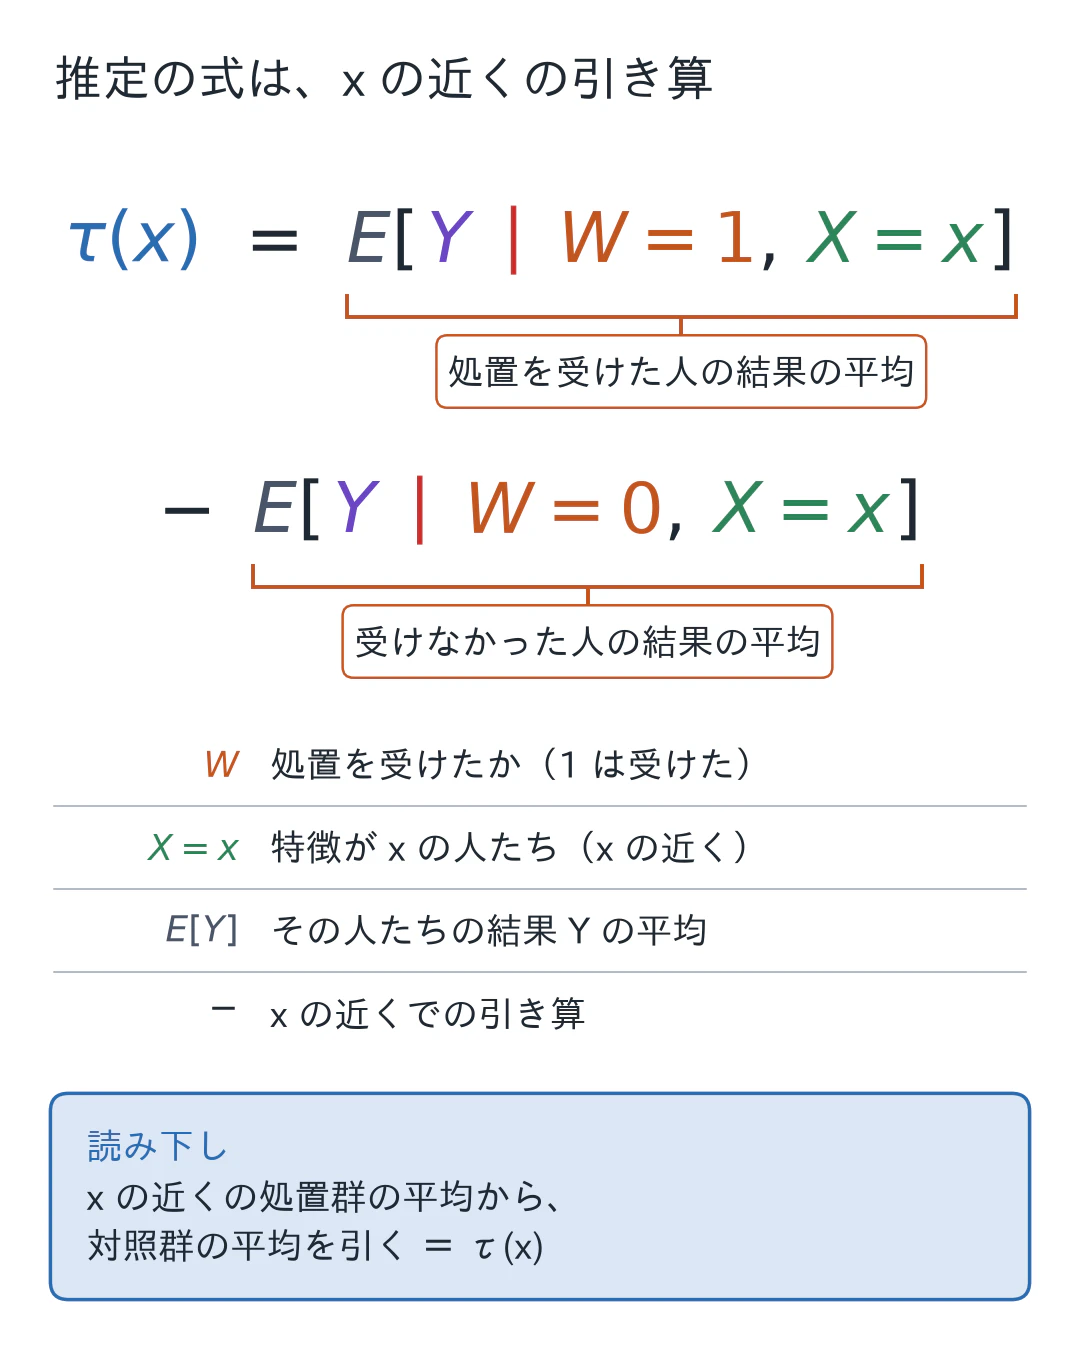
と、$x$ の近くでの引き算に落ちます。$W$ は処置を受けたかどうかの印です。右辺は「特徴が $x$ で処置を受けた人たちの平均」から「特徴が $x$ で処置を受けなかった人たちの平均」を引いた値、と読みます。
ただし、ここで心づもりを1つしておきます。ATEの推定は、標本全員を2群に分けた引き算1回で済みました。τ(x) の推定は、$x$ の近くにいる少数の人だけで引き算をやり直す作業を、あらゆる $x$ で繰り返すことです。1点1点のデータは薄く、ノイズは平均のときの何倍も効きます。おまけに正解ラベル $\tau_i$ は1人分も観測できないので、答え合わせも普通の予測問題のようにはできません(この難所は Day 23 で正面から扱います)。**効果の異質性の推定は、平均の推定より桁違いに難しい。**これが Phase 4 全体を通す前提です。
そこで実務では、$x$ 1点ごとではなく、事前に決めた群ごとの平均効果に粗くして推定します。
$$
\mathrm{GATE}_k = E[,\tau(X) \mid X \in G_k,]
$$
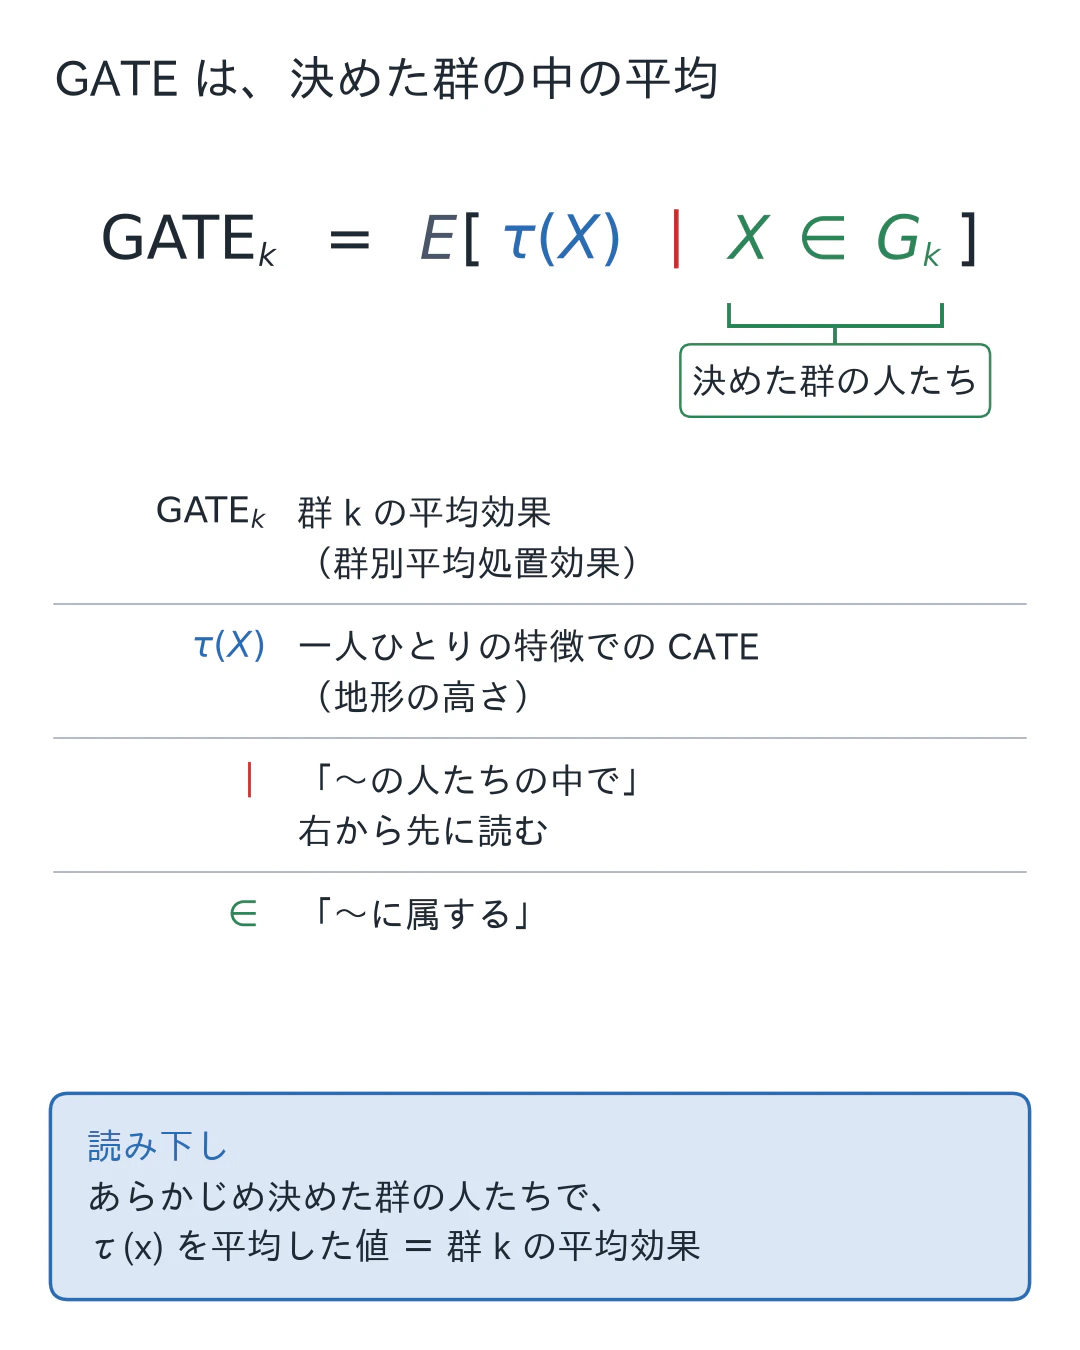
これが **GATE(group average treatment effect、群別平均処置効果)**です。右辺は、あらかじめ決めた群 $G_k$ に属する人たちについて $\tau(x)$ を平均した値を表します。ATEが全員での平均、CATEが1点ごと、GATEはその中間にあたります。群 $G_k$ の中はDay 4 の引き算がそのまま使えるので、道具立ては何も新しくありません。新しいのは規律のほうで、それが 3.2 の主題です。
3.2 サブグループ解析の罠:多重検定と事後の切り分け
1988年、アスピリンが心筋梗塞の死亡を減らすことを示した大規模RCT、ISIS-2(対象17,187人)の論文には、奇妙なサブグループ解析が載っています。星座別の解析です。ふたご座と天秤座の患者ではアスピリンがわずかに不利に見え、残りの星座でははっきり有益に見えました。もちろん星座で薬効が変わるはずはなく、著者たちはこれを「部分群を十分たくさん切れば、偶然だけでこういう結果が出る」という警告としてわざと載せました。罠は2つに分解できます。
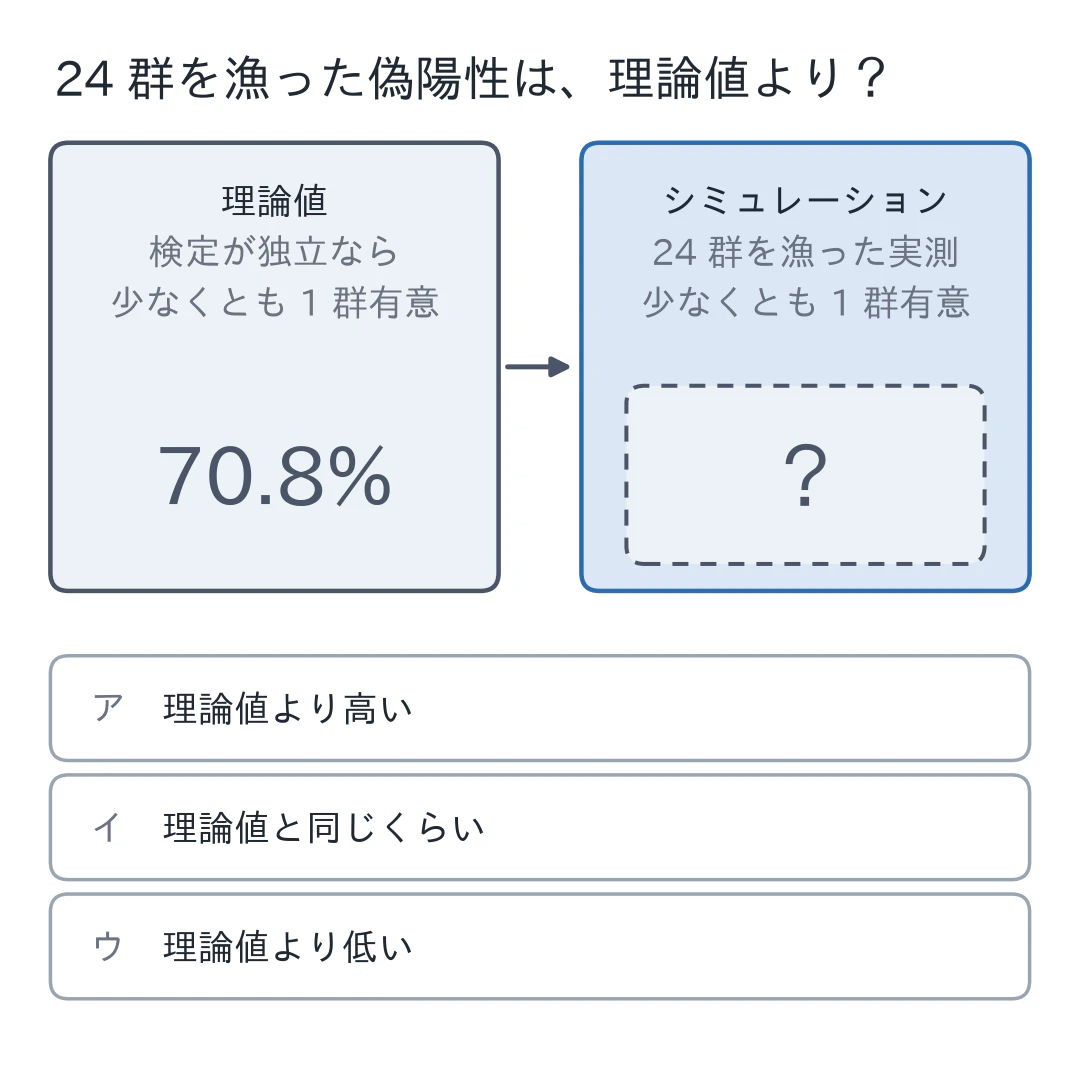
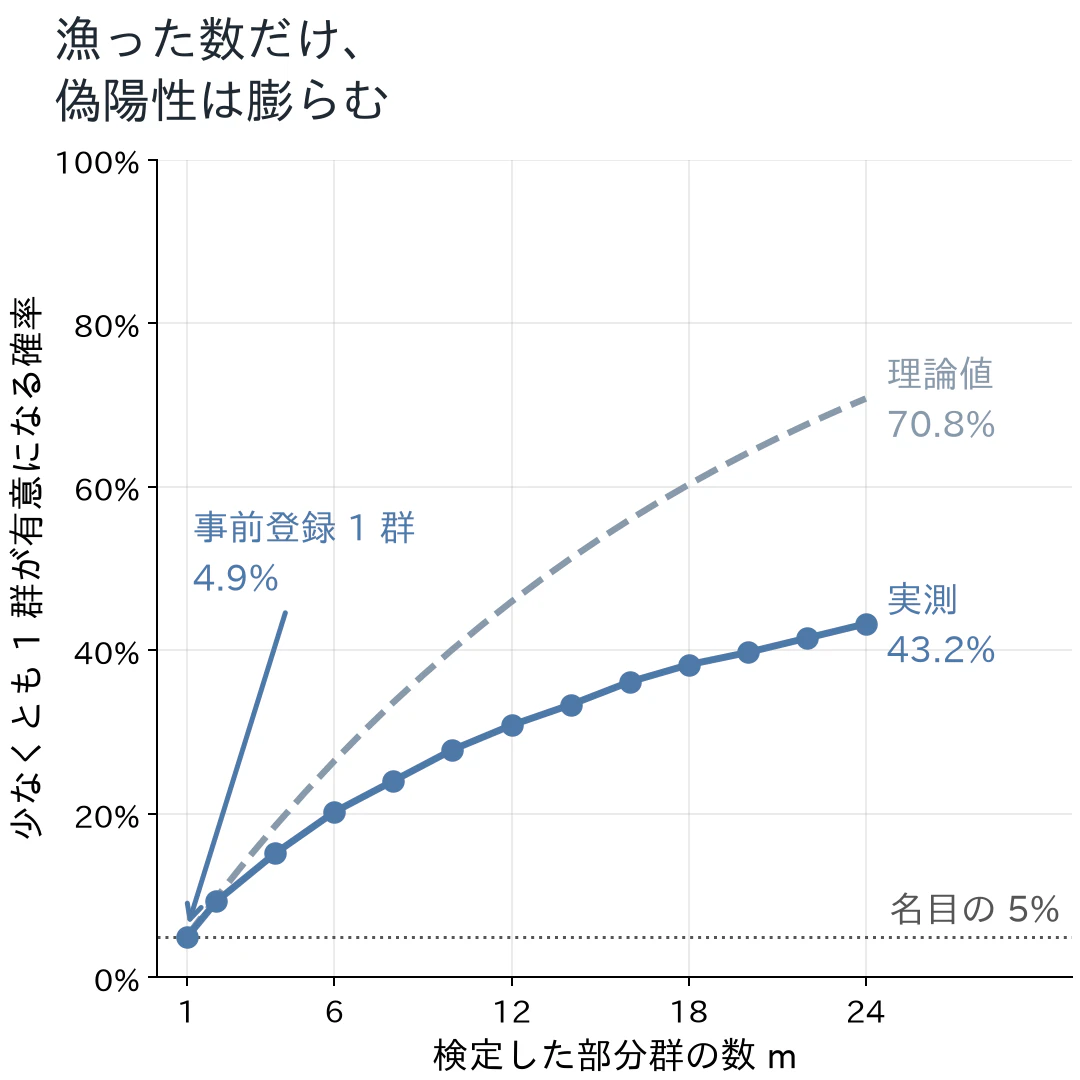
1つ目は多重検定です。部分群を $m$ 個作り、それぞれを有意水準5%で検定すると、全部の真の効果がゼロでも「少なくとも1つ有意」になる確率は、検定が独立なら $1 - 0.95^m$ まで膨らみます。$m=24$ で 70.8%。コインを24回投げれば、どれかは表が出ます。
2つ目は事後の切り分けです。データを見てから「60歳で切ろう、だめなら55歳、だめなら女性だけ、都市部だけ」と境界を動かすやり方で、こちらのほうが質が悪い。試した切り方の総数がどこにも記録されないので、多重性の補正すら不可能になります。Gelman と Loken はこれを「分かれ道の庭」と呼びました。有意になった時点で探索が止まるため、報告される1本の検定の裏に、見えない検定が何本も積もっています。
GATEが正しく機能する条件は、この2つの罠の裏返しです。群は処置前の共変量で、分析の前に、少数だけ決める。そうすれば検定の数は群の数と一致して隠れず、必要ならBonferroni補正のような道具で多重性を制御でき、群の中では割付のランダム性が生きています。道具ではなく手順が結論の信頼性を決める、というDay 5 の並べ替え検定以来の教訓が、ここでも効いています。

3.3 ML × 因果の 2 系統(Day 22〜26)
Phase 3 までの答えは、すべて「平均」でした。今日から Phase 4、機械学習と因果推論の交差点に入ります。ここで、残り4日間の地図を描いておきます。Phase 4(ML×因果)と呼んでいる区間には、目的の違う2つの系統が同居しているからです。
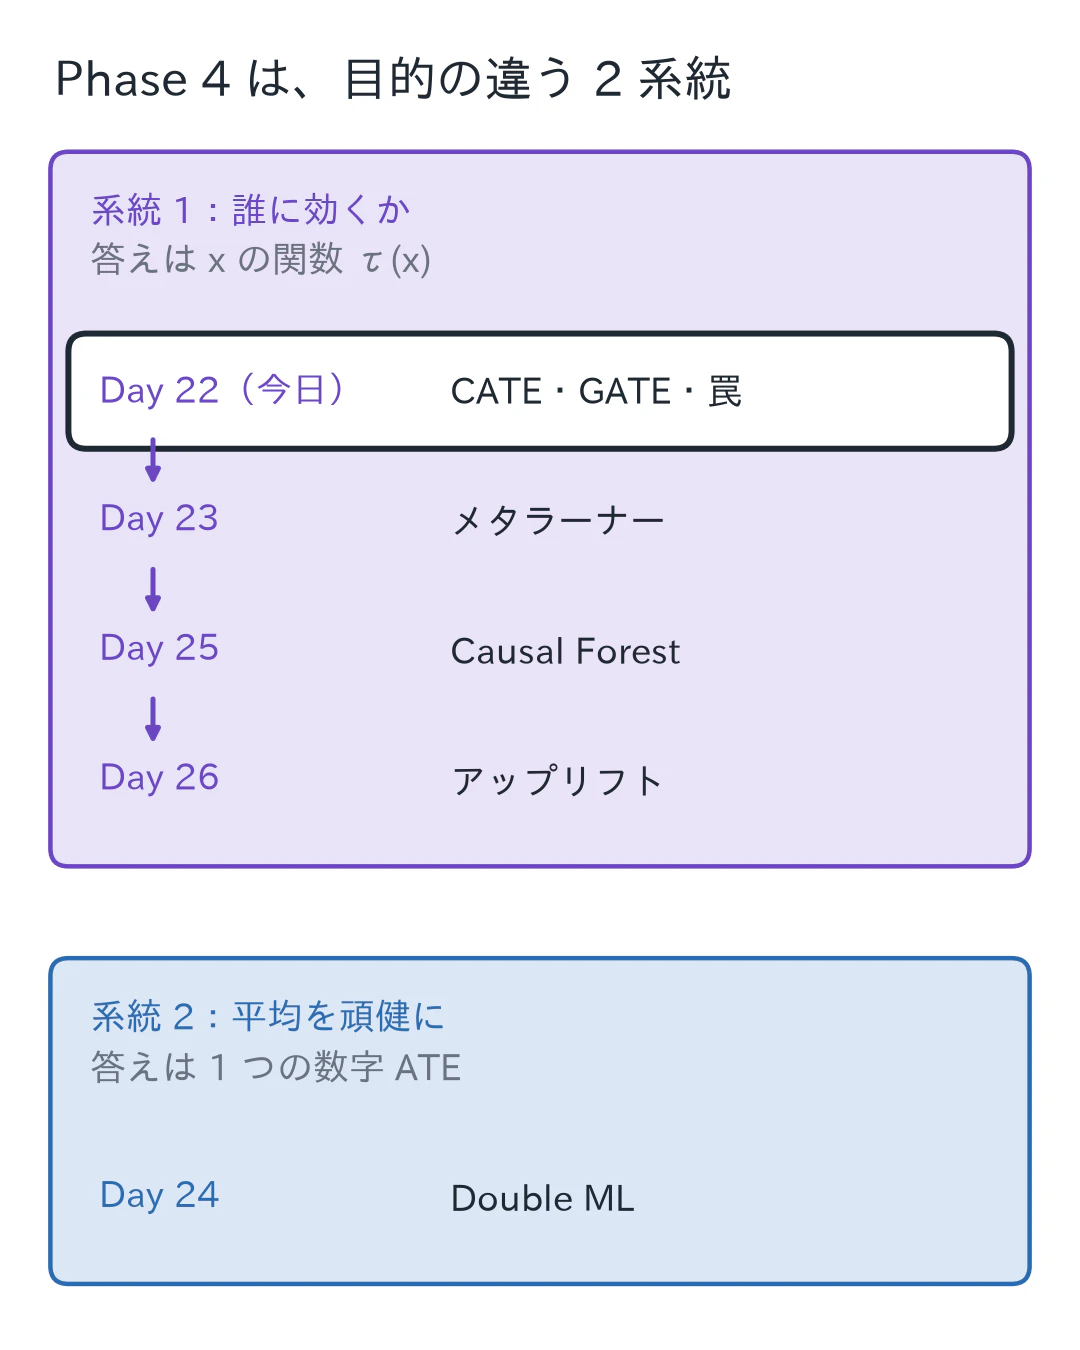
系統1は「誰に効くか」。今日のCATEを出発点に、τ(x) を機械学習で推定し(Day 23)、信頼区間を付け(Day 25)、意思決定に接続します(Day 26)。系統2は「平均を頑健に」。推定対象はあくまでATE 1つの数字で、機械学習は高次元の交絡を柔軟に調整する裏方として使います(Day 24)。同じ「ML×因果」でも、答えたい問いが違えば道具の設計も評価も変わります。Day 24 を読むときに「これはCATEの話ではない」と迷わないための地図です。
4. 手を動かす
4.1 ATE ≈ 0 でも、τ(x) は反転している
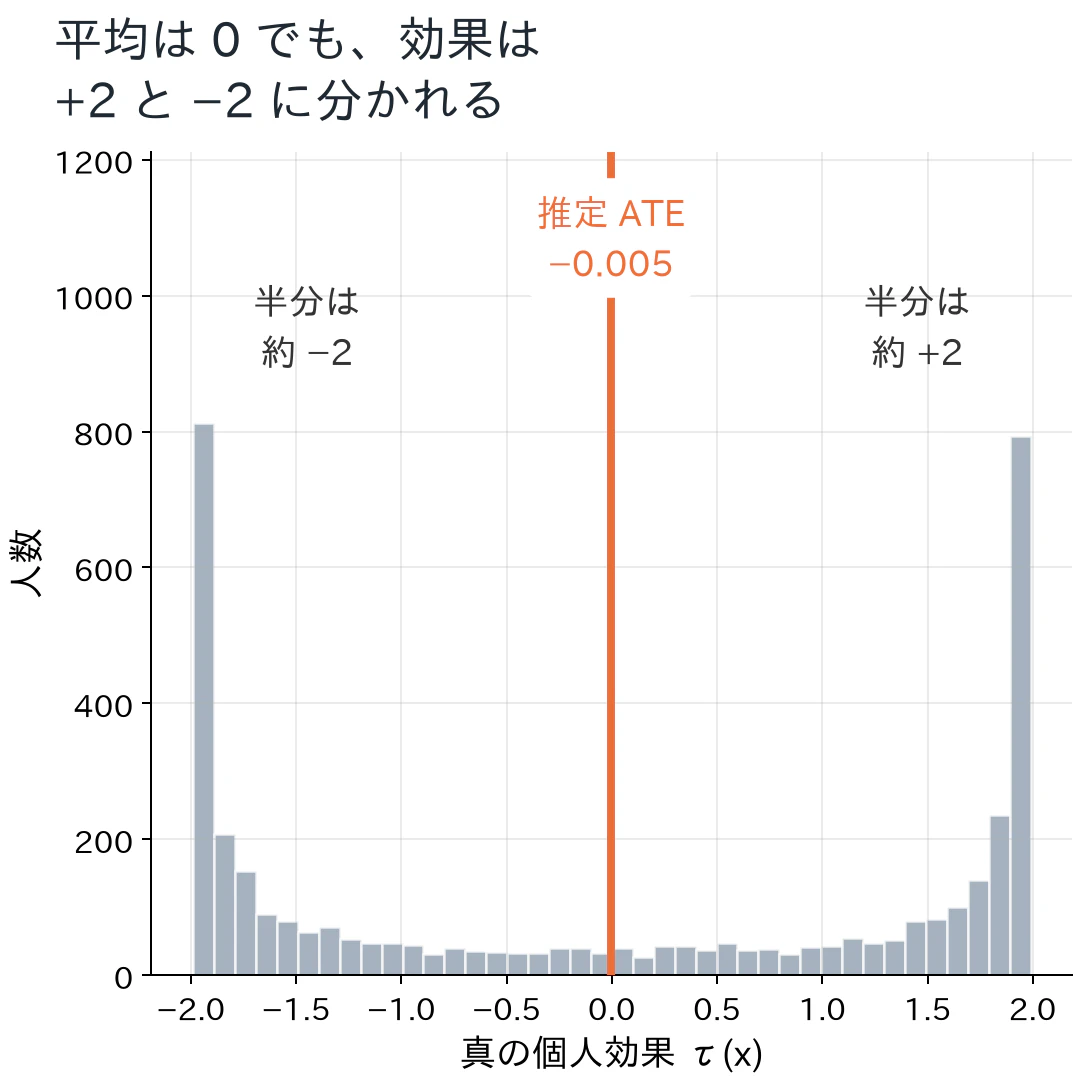
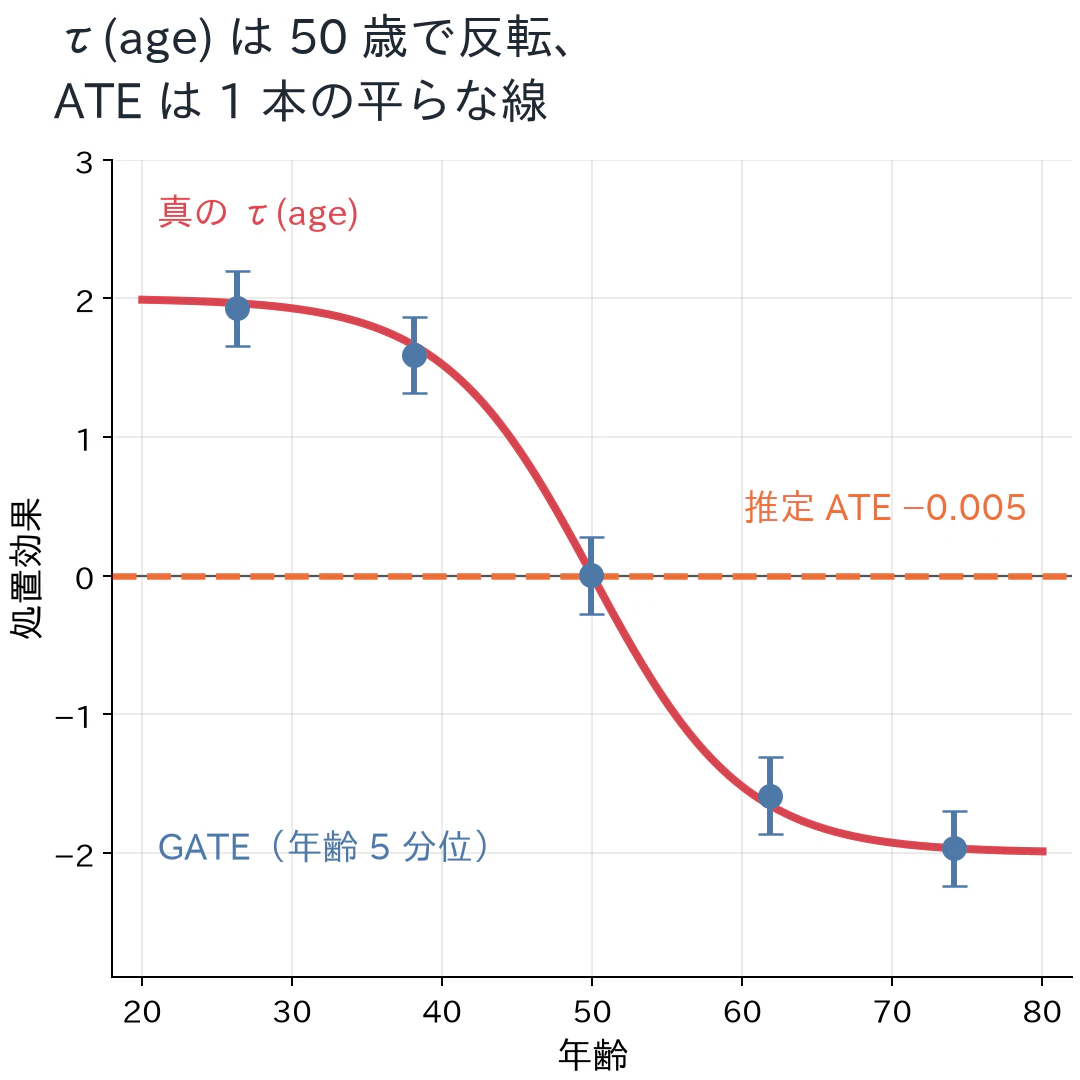
ここからの図はすべて合成データで、真の効果 τ(x) を私たちが握った状態で見せます。効果が年齢で反転する処置をRCTで試した世界を合成します。真の効果は $\tau(\mathrm{age}) = 2 - 4\sigma((\mathrm{age}-50)/5)$($\sigma$ はロジスティック関数。0から1へなめらかに立ち上がるS字の曲線です)で、若い人には約+2、50歳を境になめらかに符号が変わり、高齢の人には約−2。年齢は20〜80歳の一様分布なので、真のATEはちょうどゼロになる設計です。
コード
import numpy as np

rng = np.random.default_rng(398)
N = 4000
age = rng.uniform(20, 80, N)                      # 年齢(処置前の共変量)
tau = 2.0 - 4.0 / (1 + np.exp(-(age - 50) / 5))   # 真の効果 τ(age):50歳を境に +2 から −2 へ反転
w   = rng.binomial(1, 0.5, N)                     # RCT:割付はコイン投げ
y   = 10 + 0.05 * age + rng.normal(0, 2, N) + tau * w   # 観測アウトカム

ate = y[w == 1].mean() - y[w == 0].mean()
se  = np.sqrt(y[w == 1].var(ddof=1) / (w == 1).sum() + y[w == 0].var(ddof=1) / (w == 0).sum())
print("推定ATE = %.3f (95%%CI [%.2f, %.2f])" % (ate, ate - 1.96 * se, ate + 1.96 * se))
print("真のATE = %.3f / τ(x) > 0 の人の割合 = %.1f%%" % (tau.mean(), 100 * (tau > 0).mean()))
print("真のτ(30歳) = %+.2f / 真のτ(70歳) = %+.2f"
      % (2 - 4 / (1 + np.exp(-(30 - 50) / 5)), 2 - 4 / (1 + np.exp(-(70 - 50) / 5))))
出力
推定ATE = -0.005 (95%CI [-0.14, 0.13])
真のATE = 0.004 / τ(x) > 0 の人の割合 = 50.3%
真のτ(30歳) = +1.93 / 真のτ(70歳) = -1.93
推定ATEは −0.005、95%CIはゼロをまたぎ、報告書なら「有意な効果なし」の一行で終わる数字です。でも真実の側を見ると、30歳では +1.93、70歳では −1.93。効く人と逆効果の人がほぼ半々(τ>0 は50.3%)にいて、打ち消し合った残骸が「ゼロ」でした。RCTは正しく機能しています。壊れているのはデータではなく、「平均だけ見れば施策の価値が分かる」という読み方のほうです。全員に配れば価値ゼロ、50歳未満にだけ配れば1人あたり約+1.5、50歳以上にだけ配れば約−1.5。同じATEゼロの世界で、配り方しだいで施策の価値は正にも負にもなります。

4.2 事前登録した部分群 vs 事後に漁った部分群
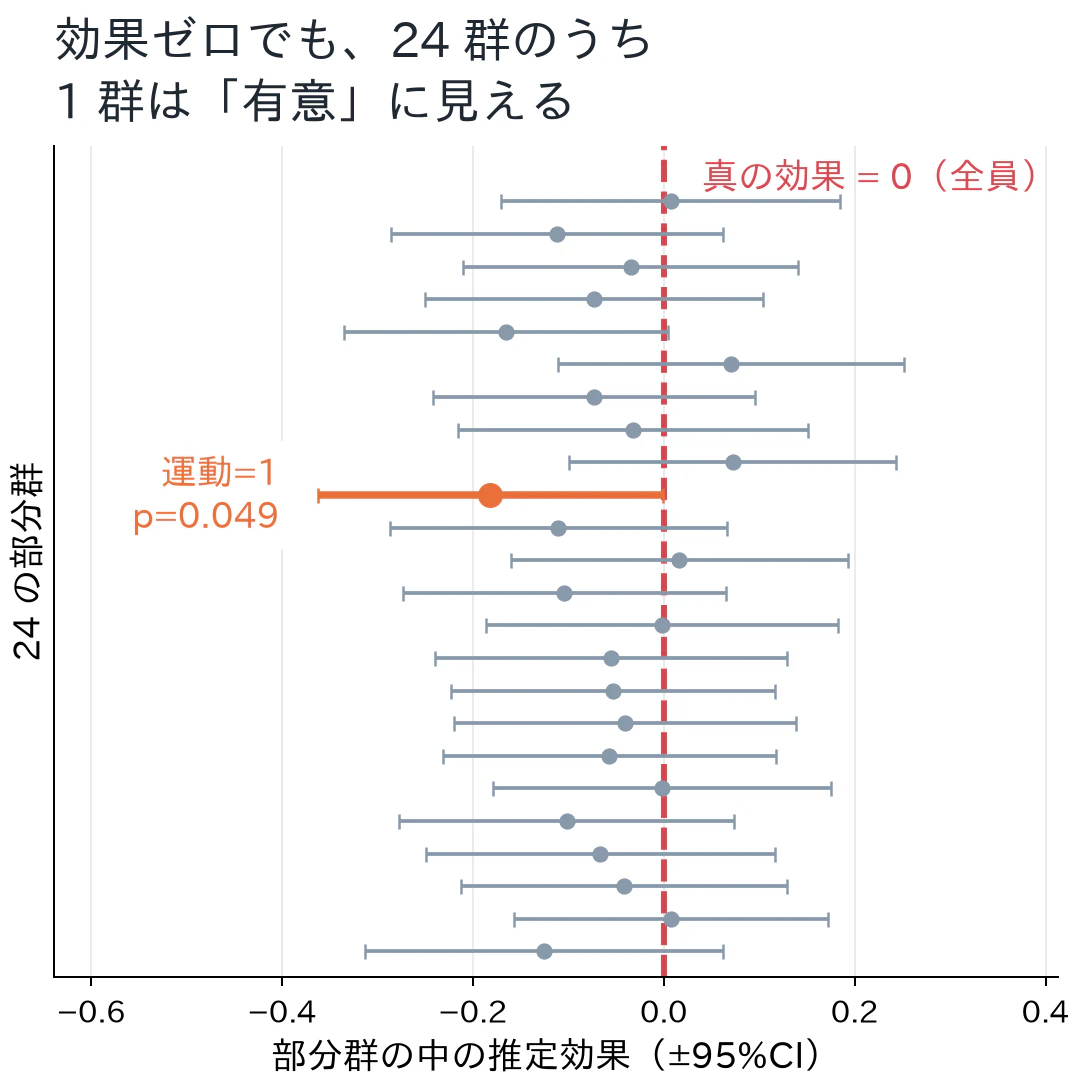
「では部分群ごとに見よう」とした瞬間に罠が口を開けます。今度は真の効果が全員ゼロのRCTを合成し、性別・地域・喫煙のような二値共変量を12個持たせます。各共変量は0/1の2群に分かれるので、部分群は24個。この24個を漁って「どれか有意な部分群はないか」と探すやり方と、分析前に見る群を1つ決めて宣言しておくやり方(事前登録)で、偽陽性率(本当は効果ゼロなのに有意が出る確率)がどれだけ違うかを2000回の反復で測ります。
出力を開く前に予想してください。24部分群を漁ったときの偽陽性率は、検定が独立なら 70.8% になるという理論値より、高いでしょうか、低いでしょうか、同じくらいでしょうか。
コード
import numpy as np
from scipy import stats

def subgroup_p(y, w, mask):
    """部分群 mask の中の処置効果を z 検定し、p値を返す"""
    y1, y0 = y[mask & (w == 1)], y[mask & (w == 0)]
    z = (y1.mean() - y0.mean()) / np.sqrt(y1.var(ddof=1) / len(y1) + y0.var(ddof=1) / len(y0))
    return 2 * stats.norm.sf(abs(z))

def one_trial(rng, N=1000, K=12):
    """真の効果ゼロのRCTを1回行い、(事前登録した1群のp値, 24部分群の最小p値) を返す"""
    w = rng.binomial(1, 0.5, N)               # 割付はランダム
    y = rng.normal(0, 1, N)                   # 真の効果は全員ゼロ
    X = rng.binomial(1, 0.5, (N, K))          # 性別・地域・喫煙などのつもりの二値共変量
    pvals = [subgroup_p(y, w, X[:, k] == g) for k in range(K) for g in (0, 1)]
    return pvals[0], min(pvals)               # pvals[0] が事前登録した1部分群

rng = np.random.default_rng(22)
res = np.array([one_trial(rng) for _ in range(2000)])
print("事前登録した1部分群の偽陽性率 = %.1f%%" % (100 * (res[:, 0] < 0.05).mean()))
print("24部分群を漁ったときの偽陽性率 = %.1f%%" % (100 * (res[:, 1] < 0.05).mean()))
print("独立なら 1 - 0.95**24 = %.1f%%" % (100 * (1 - 0.95 ** 24)))
出力
事前登録した1部分群の偽陽性率 = 4.9%
24部分群を漁ったときの偽陽性率 = 43.2%
独立なら 1 - 0.95**24 = 70.8%

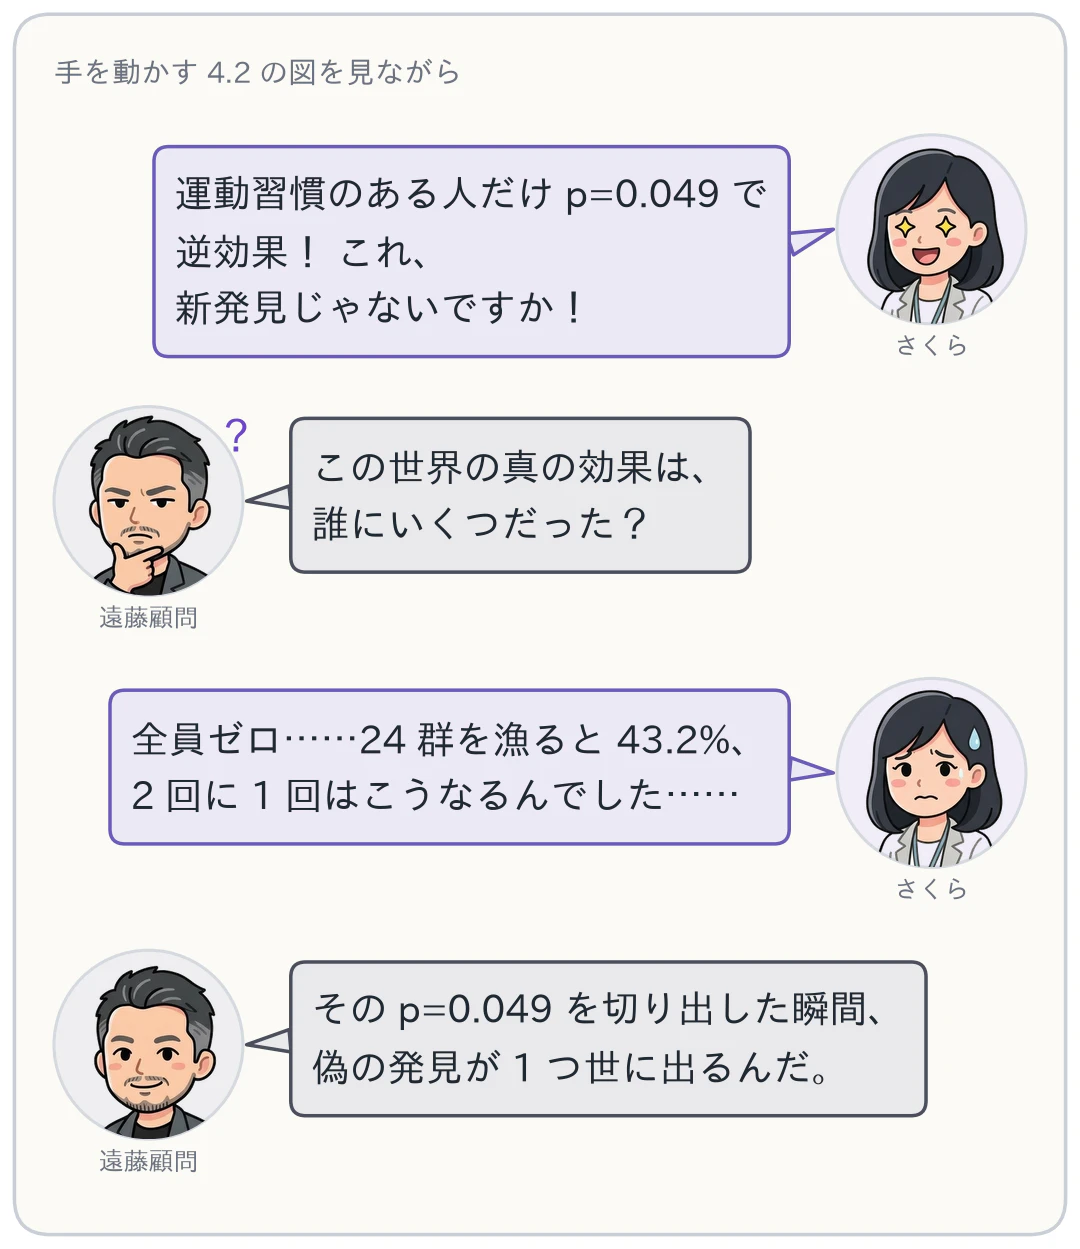
事前登録した1群の偽陽性率は 4.9% で、名目の5%どおり。検定は約束を守っています。ところが24部分群を漁ると 43.2%、およそ2回に1回「有意な部分群」が見つかります。真の効果は全員ゼロなのに、です。独立を仮定した理論値70.8%より低いのは、24個の検定が同じ実験データを使い回しているからです。部分群同士が重なるぶん推定値が正に相関し、実効的な検定の数は24より少なくなります。それでも、名目の5%の9倍近くまで膨らんでいます。下の図(Fig 8a)は反復の中の1回分の実験で、24部分群のうち「運動=1」の群だけが p=0.049 で有意な逆効果に見えます。この p=0.049 を「運動習慣のある人には逆効果らしい」と切り出して報告した瞬間、偽の発見が1つ世に出ます。43.2%という数字は頭では知っていましたが、2回に1回という体感を私が持ったのは、この2000回を回した後でした。ダッシュボードの区分を切り替えながら効いて見える層を探した覚えがあるので、なおさら他人事になりません。しかもこれは検定の数が明示されている行儀のよい漁りで、事後に境界を動かす「分かれ道の庭」では、この膨張を測ることすらできません。
4.3 GATE を正しく出す
同じ地形を、今度は罠を踏まずに読みます。4.1 のデータに戻り、群を事前に決めます。使うのは処置前の共変量である年齢の5分位。境界はデータを見て動かさず、分位点で機械的に固定します。群の中はRCTのままなので、推定はDay 4 の引き算と、その95%CIだけです。
コード
# ①のデータ(age, w, y, tau)をそのまま使う
edges = np.quantile(age, np.linspace(0, 1, 6))   # 事前に決めた年齢の5分位
bins = np.digitize(age, edges[1:-1])             # 0〜4 の分位群ラベル
print("年齢5分位のGATE(±は95%CI)")
for k in range(5):
    m = bins == k
    y1, y0 = y[m & (w == 1)], y[m & (w == 0)]
    gate = y1.mean() - y0.mean()
    se = np.sqrt(y1.var(ddof=1) / len(y1) + y0.var(ddof=1) / len(y0))
    print("Q%d(%2.0f〜%2.0f歳): GATE = %+.2f ± %.2f(真値 %+.2f)"
          % (k + 1, edges[k], edges[k + 1], gate, 1.96 * se, tau[m].mean()))
出力
年齢5分位のGATE(±は95%CI)
Q1(20〜32歳): GATE = +1.93 ± 0.27(真値 +1.96)
Q2(32〜44歳): GATE = +1.59 ± 0.28(真値 +1.60)
Q3(44〜56歳): GATE = +0.00 ± 0.28(真値 +0.02)
Q4(56〜68歳): GATE = -1.59 ± 0.28(真値 -1.59)
Q5(68〜80歳): GATE = -1.97 ± 0.27(真値 -1.96)
5群すべてで、真値が95%CIの中に収まりました。若い2群は 約+1.9と+1.6、真ん中はゼロ、高齢の2群は 約−1.6と−2.0。ATEが1本の水平線に潰していた反転の地形が、5個の点として姿を現します(Fig 7b の青い点がこのGATEです)。4.2 と 4.3 でやった計算自体はほぼ同じであることに注意してください。部分群を切って、引き算して、不確かさを付ける。違いは群を決めた時点と決め方だけです。データを見る前に、処置前の変数で、少数の群を宣言したから、この5つの数字は信用に足ります。効果の異質性で最初に効くのは、新しい推定量ではなく古い規律でした。とはいえ5分位はあくまで地形の粗い読みで、境界の位置も群の数も手で決めています。この手作業を機械学習に任せ、τ(x) を関数として推定するのが Day 23 以降です。

成り立つ場合と成り立たない場合
| 群の決め方 | データに出るもの | 今日の数字の読み方 |
|---|---|---|
| 分析の前に、処置前の変数で、少数だけ決めた(年齢5分位) | 5群すべてで、真値が95%CIの中。GATEは約+1.9から−2.0まで並ぶ | 推定ATE −0.005 の裏の地形として、そのまま読める |
| データを見てから、24群を漁って選んだ | 真の効果が全員ゼロでも、43.2% で「有意な部分群」が出る(事前登録した1群は 4.9%) | 見つけた群は偽の発見かもしれない。報告するなら仮説として扱う |
5. 判断の基準
部分群の効果を報告してよいか、報告するなら何を確かめるか。問いを 3 つに絞りました。上から順にたどり、最初に右へ出たところが、いまやることです。
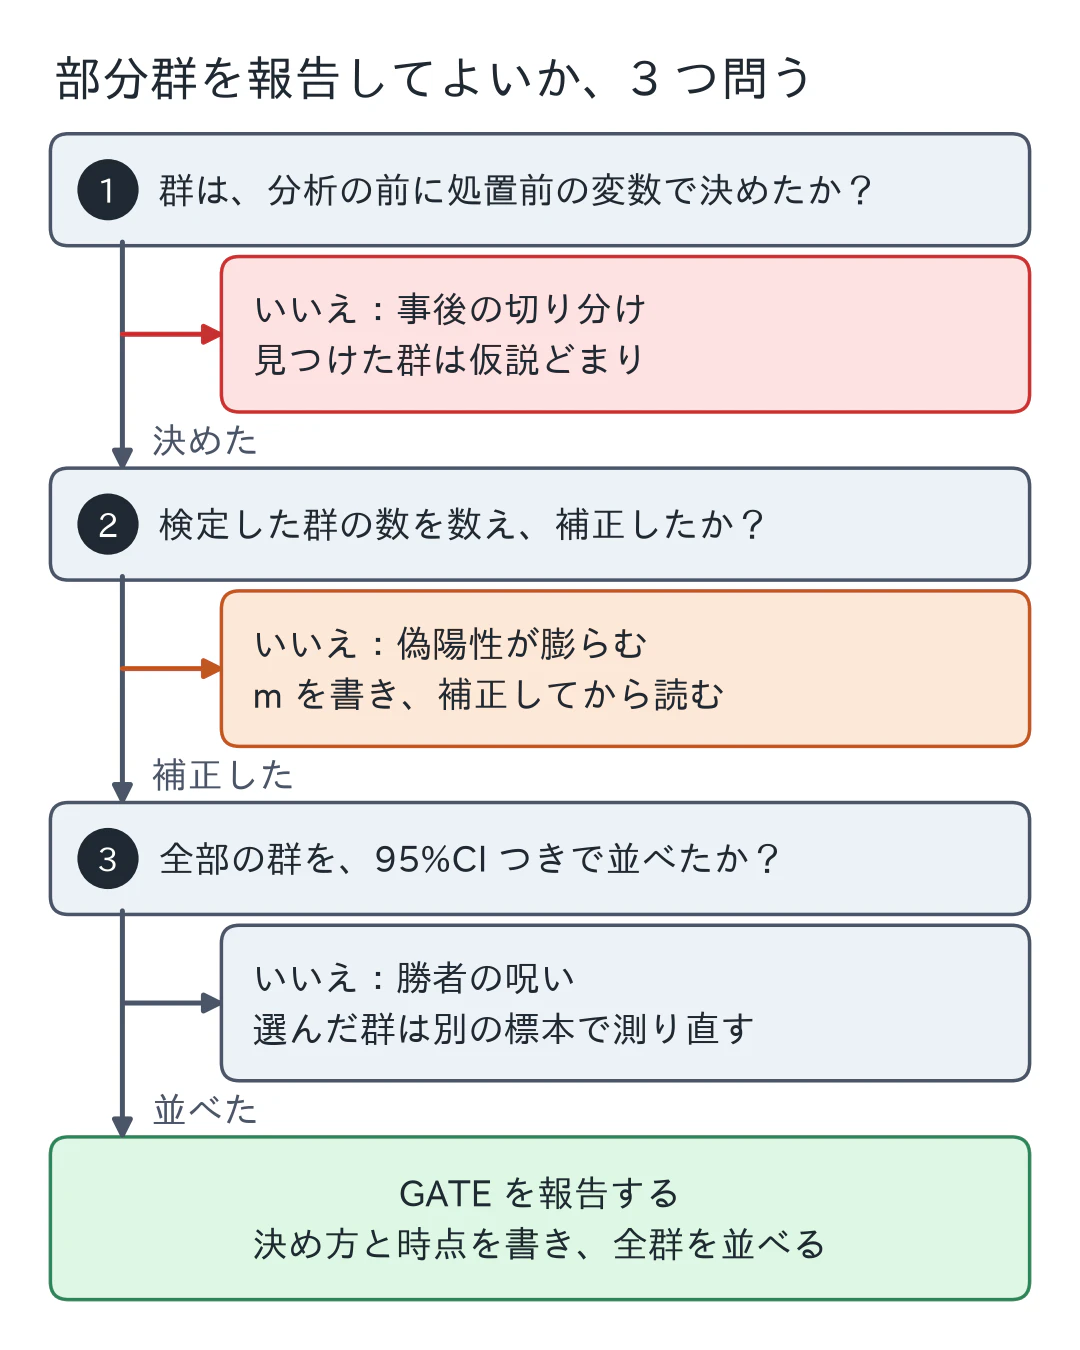
- Q1 は設計の話で、データからは確かめられません。 異質性の検討は「事後の敗者復活戦」ではなく、どの群を見るかまで含めて設計段階で決めておくものです。部分群は処置前の変数で切ります。「効果が出た人」「よく利用した人」のような、処置の後に決まる変数で切った比較(いわゆるresponder解析)は、割付のランダム性を壊して因果の読みを失います。切ってよいのは、割付の瞬間より前に値が決まっている変数だけです。あとから見つけた群は、確かめ済みの結論ではなく仮説として扱います。
- Q2 と Q3 はデータと報告で点検できます。 Q2 は、検定した群の数を報告に書き、Bonferroni 補正のような道具で多重性を制御したか。4.2 のとおり、真の効果が全員ゼロでも 24 群を漁れば 43.2% で「有意な部分群」が見つかります(事前登録した 1 群なら 4.9%)。Q3 は 4.3 の手順そのもので、群の中は RCT のままなので Day 4 の引き算と 95%CI で足ります。1 群だけを切り出さず、全群を並べます(理由は下の注記)。
- 全部通ったら報告へ。 群の決め方と決めた時点を書き、全群の GATE を 95%CI 付きで並べます。ただし 5 分位は地形の粗い読みで、境界の位置も群の数も手で決めています。この手作業を機械学習に任せ、τ(x) を関数として推定するのが Day 23 以降です。
注記 「一番効いて見えた部分群」の効果は過大です。複数の群から最大の推定値を選ぶ操作は、真の効果だけでなく上振れノイズも一緒に選びます(勝者の呪い)。その群に絞って施策を打つと、実際の成果は見積もりを系統的に下回ります。選択後の効果を誠実に報告する道具(標本を2つに割り、群を選ぶ側と効果を測る側で別々に使う honest な分割と信頼区間)は Day 25 の Causal Forest で扱います。
自分の仕事に当てるなら、次の問いから始められます。いま「効く群」を報告している分析があれば、その群は、データを見る前に、処置前の変数で決めたものでしょうか。
6. 確認問題
問 1(自分の言葉で説明する) 推定 ATE がほぼゼロ(95%CI はゼロをまたぐ)の RCT でも「施策は誰にも効かない」と言い切れない理由と、効果の地形を覗くときに最初に守る規律を、本文を見ずに 2 文で説明してください。
答えと解説
模範解答: ATE は効果の地形 τ(x) を 1 つの数字に押し潰した要約で、効く人と逆効果の人が打ち消し合えば、効果が反転していても ATE はゼロになります。地形を覗くときは、群を処置前の変数で、分析の前に、少数だけ決め、全群を 95%CI 付きで並べるという規律を最初に守ります。
次の 2 点のどちらかが抜けたら不十分です。
- 打ち消し合えば、地形が反転していても ATE はゼロになること
- 群は処置前の変数で、分析の前に、少数だけ決めること
詰まったら 3.1 と 3.2 に戻ってください。
問 2(別の場面へ移す) あるウェブサービスが、新しい通知を無作為に半分のユーザーへ出しました。全体では、利用時間の差(処置群 − 対照群)は −0.1 分で、ほぼゼロでした。登録時に聞いた年代で 2 群に分けると、30 歳未満は +3 分、30 歳以上は −3 分で、人数は半々でした。読み方として最も適切なものはどれでしょうか。
ア 全体の差が −0.1 分でほぼゼロなので、通知は誰にも効かず、やめてよい イ 結果を見てから、差がいちばん大きく出る年齢の線を探して分ければ、効く層をいちばん正確に見つけられる ウ 年代は処置前に決まる変数なので、分析の前に決めた群なら、+3 分と −3 分を 95%CI 付きで読んでよい エ 通知を開いたユーザーと開かなかったユーザーで分ければ、効いた人と効かなかった人が分かる
答えと解説
ウ。+3 分と −3 分は半々で打ち消し合い、全体の −0.1 分になっています。年代は割付より前に値が決まる変数なので、分析の前に決めた群なら、4.3 の GATE と同じ手順で読めます。
ア: ATE がゼロでも、地形が平らとは限りません。30 歳未満にだけ通知を出せば、利用時間は伸びます。イ: 事後の切り分け(分かれ道の庭)です。試した線の本数が残らないので、多重性の補正すらできません。エ: 通知を開いたかどうかは処置の後に決まる変数です。responder 解析は割付のランダム性を壊して、因果の読みを失います。
問 3(出力を読む) 4.2 で次の出力を得ました。24 部分群を漁ったときの偽陽性率 43.2% が、独立を仮定した理論値 70.8% より低くなっています。この理由として正しいものはどれでしょうか。
事前登録した1部分群の偽陽性率 = 4.9%
24部分群を漁ったときの偽陽性率 = 43.2%
独立なら 1 - 0.95**24 = 70.8%
ア 2000 回の反復では偶然の揺れが大きく、本当は 70.8% に近いから イ 24 個の検定が同じ実験データを使い回すので推定値が正に相関し、実効的な検定の数が 24 より少ないから ウ 事前登録した 1 群が 24 群の中に含まれているから エ 真の効果がわずかに正だったから
答えと解説
イ。部分群同士が重なるぶん推定値が正に相関し、実効的な検定の数は 24 より少なくなります。それでも名目の 5% の 9 倍近くまで膨らんでいます。しかもこれは検定の数が明示されている行儀のよい漁りで、事後に境界を動かすやり方では、この膨張を測ることすらできません。
ア: 差の理由は反復の回数ではなく、検定同士の相関です(同じ反復で、事前登録した 1 群は名目どおりの 4.9% に収まっています)。ウ: 含まれているのは事実ですが、24 群の最小の p 値を見ている以上、理論値より低くなる理由にはなりません。エ: このシミュレーションの真の効果は全員ゼロです( y = rng.normal(0, 1, N) )。
7. おわりに
CATE $\tau(x) = E[Y(1) - Y(0) \mid X = x]$ は、特徴 $x$ ごとの平均効果を並べた効果の地形図で、ATE はそれを 1 つの数字に押し潰した要約です。地形を覗くときに最初に効くのは新しい推定量ではなく、群を処置前の変数で、分析の前に、少数だけ決めるという規律です。最後に確かめます。推定 ATE がゼロでも「誰にも効かない」と言い切れない理由と、地形を覗くときに最初に守る規律を、本文を見ずに 2 文で言えますか。詰まったら 3.1 と 3.2 に戻ってください。
8. 参考(本棚)
- Matheus Facure『Causal Inference in Python』第6章。効果の異質性とCATEの導入。今日の下敷き
- ISIS-2 Collaborative Group (1988) "Randomised trial of intravenous streptokinase, oral aspirin, both, or neither among 17,187 cases of suspected acute myocardial infarction: ISIS-2." The Lancet 332(8607)。星座別サブグループ解析をあえて載せた古典。ふたご座と天秤座でアスピリンが不利に見える
- Gelman, A. & Loken, E. (2013) "The garden of forking paths"。事後の切り分けが「1回しか検定していないつもりの多重検定」になる仕組み
- データはすべて合成です。真の τ(x) を握ることで、ATEが隠す反転・漁りの偽陽性率・GATEの正しさを数値で確認しました。
この記事の位置づけ
因果推論を「本を読んだ」で終わらせず、自分の言葉で説明でき、コードで再現できる状態まで落とす 30 日連載の Day 22 です。
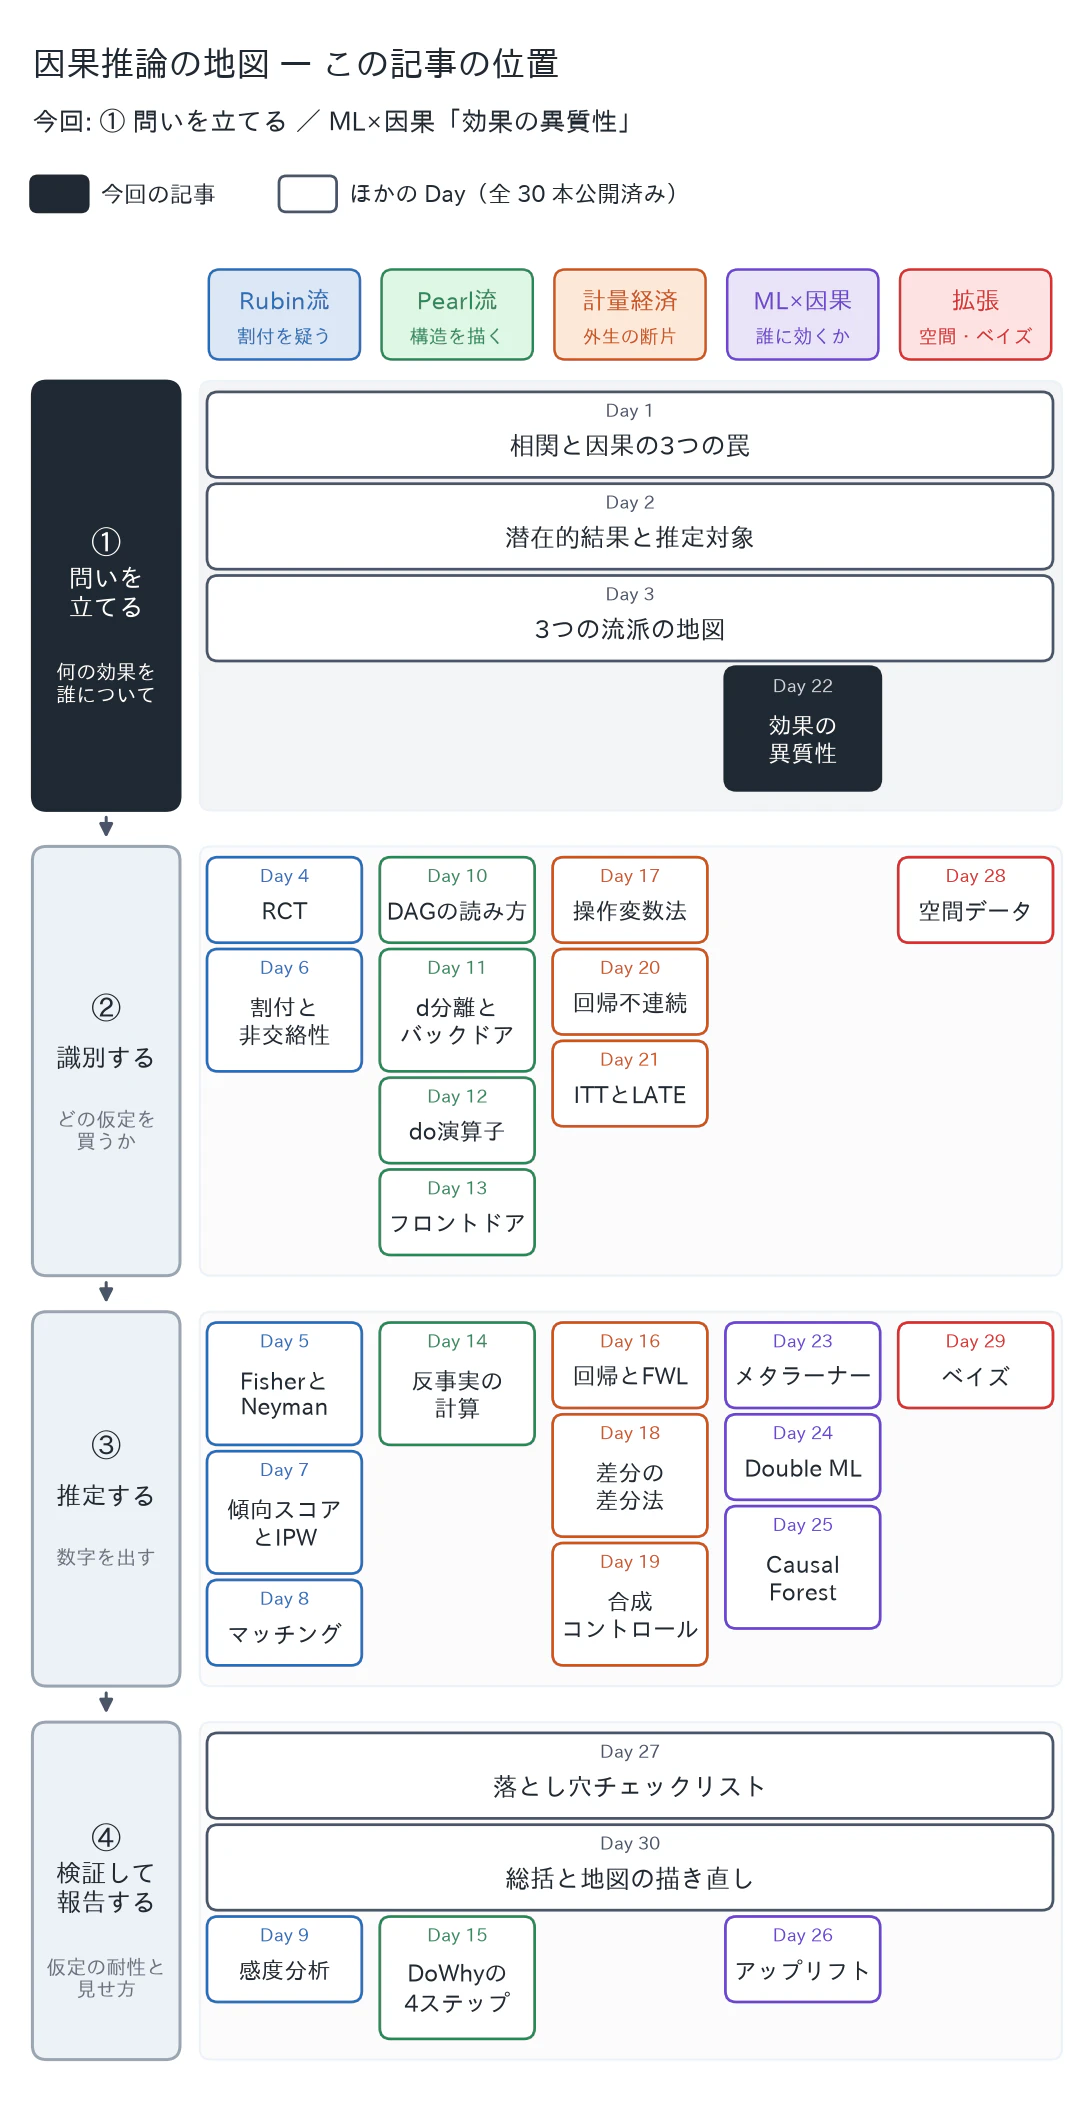
図は縦が分析の工程、横が流派です。この記事は「① 問いを立てる(何の効果を誰について)」の、ML×因果(誰に効くか)の「効果の異質性」を扱います(図の黒い札)。前提になるのは Day 2(潜在的結果と推定対象)・Day 7(傾向スコアとIPW)。ここで覚える考え方や道具は Day 23(メタラーナー)・Day 25(Causal Forest)・Day 26(アップリフト) で再登場します。
9. 次回予告(Day 23)
Day 23(メタラーナー)
GATEは効果の地形の粗い読みで、群の切り方は結局人間が手で決めています。これをデータに任せ、τ(x) を関数として推定できないか。発想の転換は「CATEの推定を、手持ちの機械学習が解ける予測問題に翻訳する」ことです。次回はその翻訳装置であるメタラーナー(S/T/X-learner)を、sklearnだけで1つずつ手組みします。ただし正解ラベル τ_i は誰にも観測できないという根本問題がここで再来し、「精度の良い予測モデル」と「良いCATE推定」が同じでないことを思い知る回でもあります。