
この記事は、因果推論に 3 つある考え方の流派を、どう使い分ければよいかを確かめる回です。職業訓練なら、意欲の高い人ほど訓練を受けやすく収入も高いという偏り(交絡)があり、その直し方を Rubin流・Pearl流・計量経済が別々の言葉で説明します。3 つの流派を 1 枚の地図にまとめ、交絡を入れた職業訓練の合成データに、それぞれの調整を当てます。
登場人物
遠藤顧問: データ分析の社外顧問。答えを言わずに問いで返す/さくら: データアナリスト 1 年目。数字を出すのは速いが、相関を因果と読み違える
1. 1 文で言うと
1 文で言うと
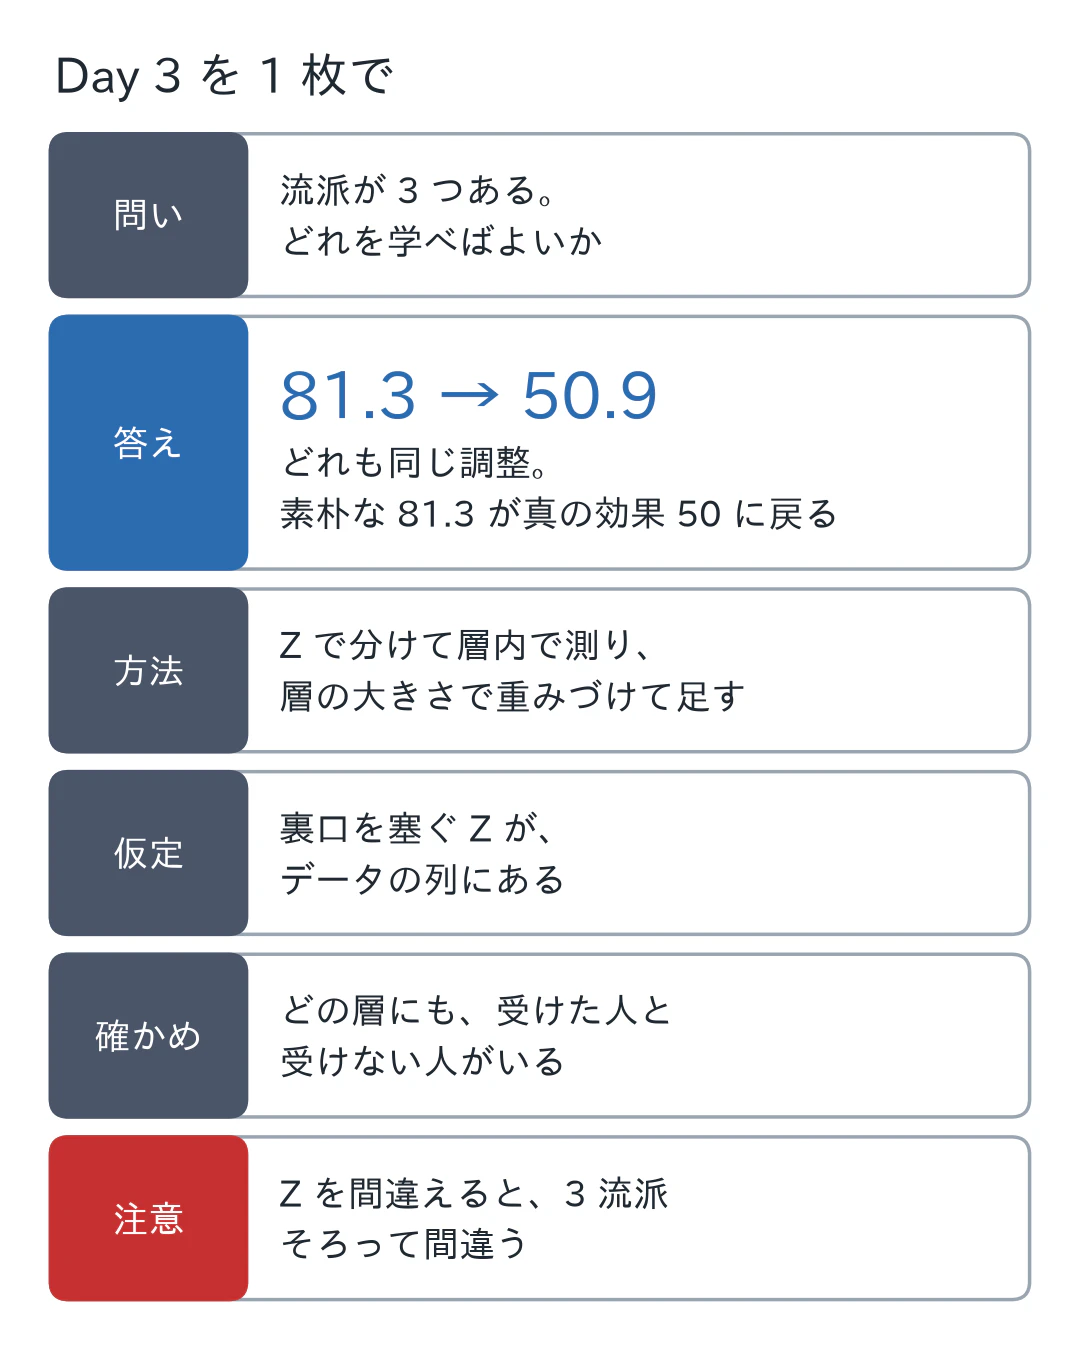
因果推論の主要な3つの流派、Rubin流(潜在的結果)/Pearl流(DAG・do演算子)/計量経済(準実験デザイン) は対立していません。「正しい変数 $Z$ で条件付けて交絡を消す」という同じ調整を、別の言葉で正当化しています。
- 今日の数字: 素朴な比較の 81.3 が、層別化・バックドア調整・回帰のどれでも 50.9 になり、真の効果 50 に戻りました。
2. 今日の問い
今日の問い
Day 2まで「潜在的結果」で話してきた。ところが他の流派では、DAG、do演算子、操作変数、差分の差分…と、別の言葉が次々に出てくる。
これらは違う理論なのか、結局どれを学べばいいのか?
読み終えたら、3 つの流派が同じ調整を別の言葉で言っていることと、その調整が正しくなる条件を説明できます。
結論から言うと、3つの主要な流派があり、対立ではなく役割分担です。今日はその地図を描き、最後に「3つの言葉が同じ答えに着く」ところまでコードで確かめます。
前の回から使うのは次の 2 つです。
- Day 1(相関と因果): 交絡があると、受けた人と受けない人の平均の差に、訓練以外の違いが混ざる
- Day 2(潜在的結果): 一人ひとりに受けた場合の $Y(1)$ と受けなかった場合の $Y(0)$ があり、効果はその差 $Y(1)-Y(0)$ と定義できる
3. 概念
先に、手元の道具との違いを置きます。A/B テストなら、無作為に分けた 2 群の平均を比べれば、そのまま効果として読めます。回帰や予測モデルなら、意欲 $Z$ も説明変数に入れて係数を読みたくなります。今日の場面は、意欲の高い人ほど訓練を受けやすく、割り当てが無作為ではありません。回帰の係数も予測の当たりやすさも、それだけでは因果効果である保証になりません。3 つの流派は、その保証を何の仮定で買うかを、それぞれ別の言葉で言う枠組みです。
3.1 3つの流派を1枚で
まず全体像です。「Xを変えたらYはどう変わる?」という1つの問いに、3つの流派が別の入り口から迫ります。Rubin流は反事実との差から、Pearl流は変数どうしの因果の構造から、計量経済は観察データの中にある擬似ランダムから入ります。入り口は違っても、正しく調整すれば同じ因果効果に着きます。
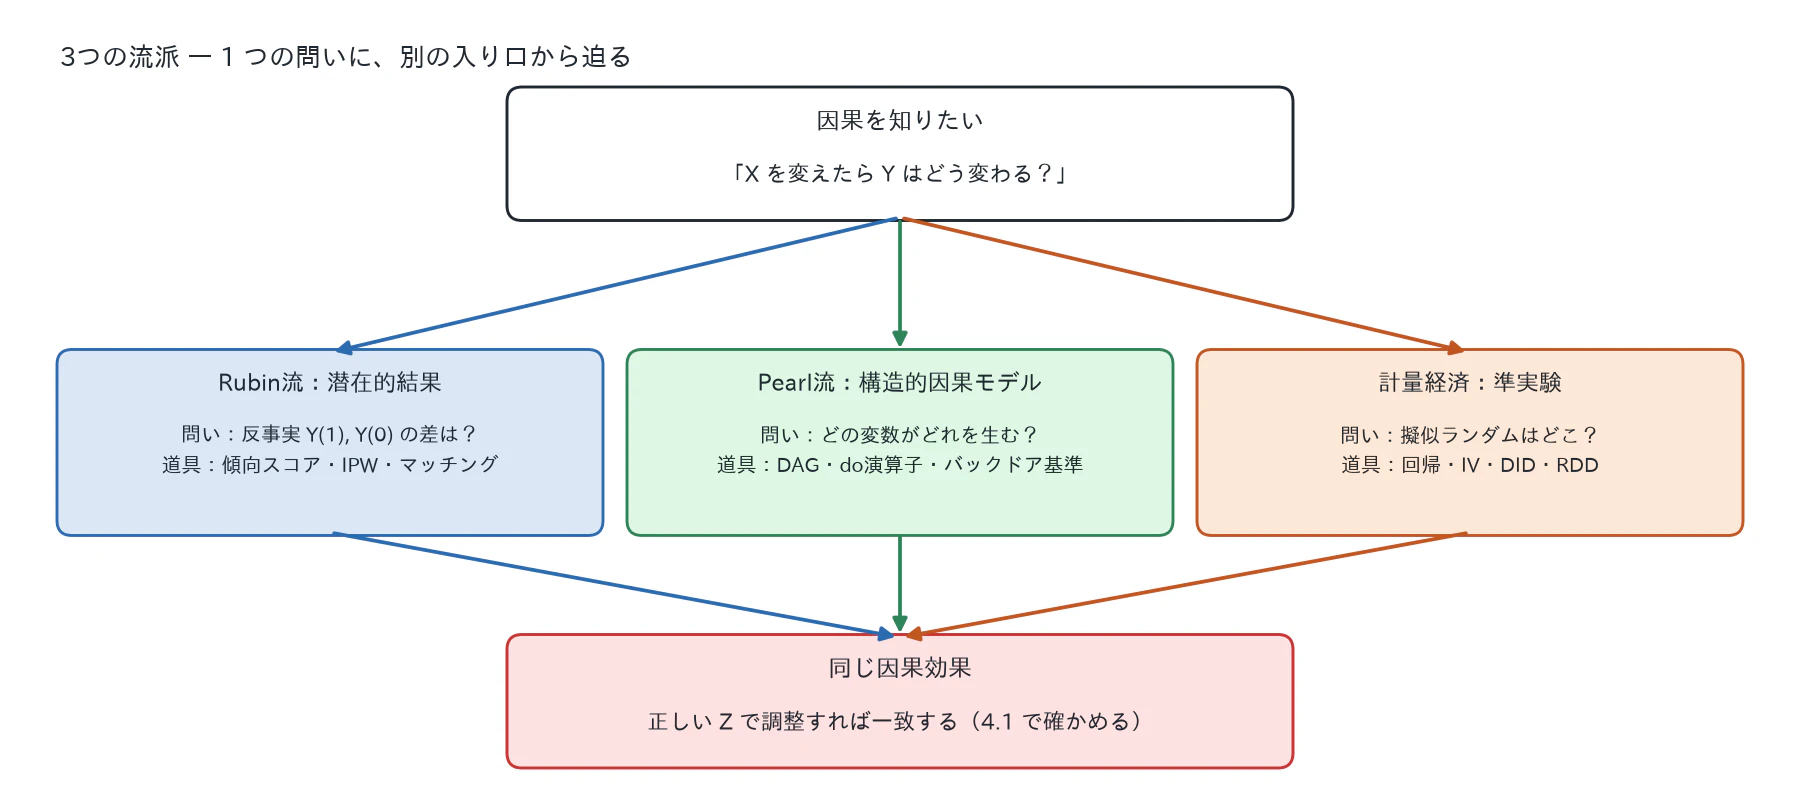
表にすると、それぞれの「性格」がはっきりします。
| 観点 | Rubin流(潜在的結果) | Pearl流(構造的因果モデル) | 計量経済(準実験) |
|---|---|---|---|
| 中心の問い | 反事実との差 $Y(1)-Y(0)$ は? | どの変数がどれを生む? どの経路が因果? | "擬似ランダム"はどこにある? |
| 原始概念 | 潜在的結果・割付メカニズム | DAG・構造方程式・do演算子 | 外生性・自然実験 |
| 「調整」の道具 | 傾向スコア・IPW・マッチング | バックドア基準で調整集合を決める | 回帰・IV・DID・RDD |
| 主な仮定 | 条件付き無視可能性 | バックドア基準を満たす $Z$ | 条件付き外生性/操作変数の妥当性 |
| 得意なこと | 効果の推定・欠測データとしての整理 | 「何で調整すべきか」の識別 | 観察データから因果を取り出す設計 |
| 代表的な人 | Rubin, Imbens, Rosenbaum | Pearl | Angrist, Imbens, Card |
| 連載での担当 | Day 4〜9 | Day 10〜15 | Day 16〜21 |
面白いのは、人が流派をまたぐことです。Imbens は Rubin 流の中心人物でありながら、計量経済学者として Angrist と共にノーベル経済学賞(2021)を受賞しました。流派は「対立する宗派」ではなく「同じ山への登山ルート」に近いようです。
3.2 Rubin流の考え方:欠けた片方を、似た人で埋める
3つの考え方を、順に見ていきます。まず Rubin流です。Rubin流は、因果効果を定義するところから始めます。訓練を受けた A さん 1 人について、受けた場合の収入 $Y(1)$ と受けなかった場合の収入 $Y(0)$ の両方を考え、その差 $Y(1)-Y(0)$ を「A さんにとっての訓練の効果」と呼びます。これが Day 2 で見た潜在的結果です。主役は「変数」ではなく「一人ひとりの 2 つの結果」で、Rubin流の道具はすべてここから組み立てられます。
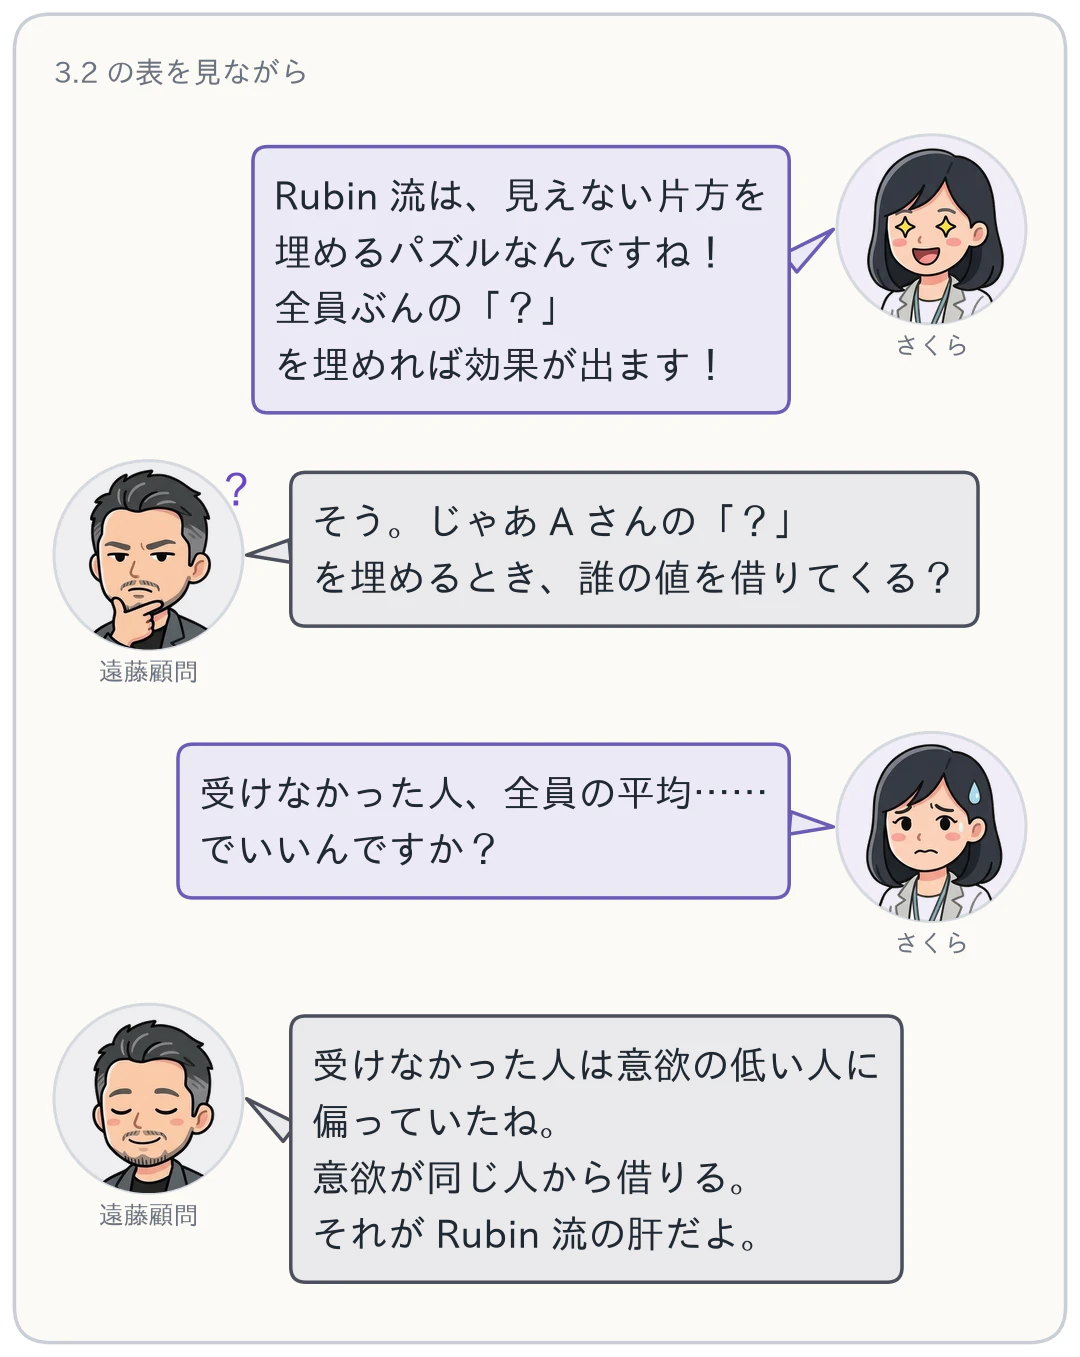
ところが、A さんが訓練を受けたなら、見えるのは $Y(1)$ だけです。受けなかった場合の $Y(0)$ は起こらなかった世界の値(反事実)で、どうやっても観測できません。全員について片方が欠けた表ができあがります。

Rubin流の見方では、因果推論とはこの 「?」を埋める欠測データの問題 です。そして、どう埋めてよいかを決めるのが 割付メカニズム、つまり「誰が訓練を受けたかの決まり方」です。コイン投げで受ける人が決まっていれば(Day 4 の RCT)、受けた人と受けなかった人は背景が同じなので、受けなかった人たちの平均で受けた人の「?」を埋めてかまいません。今日の訓練データではそうはいきません。意欲の高い人ほど受講していて、受けなかった人の平均を借りると、意欲の低い人の値で埋めることになるからです。そこで「意欲 $Z$ が同じ人の中なら、誰が受けたかは結果と無関係だ」と仮定し、$Z$ が同じ人の値で埋めます。この仮定を Rubin流は 条件付き無視可能性 と呼びます。
層別化($Z$ で分けて層ごとに比べる)、マッチング($Z$ の近い相手を 1 人ずつ探す)、傾向スコアと IPW(受けやすさで重みづける)は、どれも「似た人で埋める」技術の違いです(Day 4〜9)。Rubin流の強みは、何を仮定すれば何が推定できるかの対応がはっきりしていること、欠測データの統計学がそのまま使えること、そして ATE や ATT のように「誰の上で取った平均か」を最初に決めさせることです。
一方で、何を $Z$ に選ぶかは Rubin流の枠組みの外から持ち込みます。条件付き無視可能性は「正しい $Z$ があれば」という仮定であって、どの変数が正しい $Z$ なのかを教えてはくれません。そこを図で考えるのが、次の Pearl流です。
3.3 Pearl流の考え方:因果の地図を先に描く
Pearl流は、効果を定義する前に 変数どうしの因果の構造を図に描く ところから始めます。丸と矢印の図を DAG(有向非巡回グラフ)と呼び、矢印 $Z \to D$ は「$Z$ は $D$ の原因である」という意味です。今日の訓練データなら、意欲 $Z$ が受講 $D$ と収入 $Y$ の両方に矢印を伸ばし、$D$ から $Y$ にも矢印がある、という 3 本の矢印の図になります。大事なのは、この図は データから出てくるものではなく、分析者が宣言する仮定 だということです。Pearl流は、その仮定を式ではなく図の形で、誰が見ても検討できるように外に出します。
図ができると、Pearl流の中心にある区別が使えます。「見る」と「する」の区別 です。$P(Y \mid D=1)$ は「訓練を受けた人たちを眺めたときの収入」、$P(Y \mid do(D=1))$ は「全員に訓練を受けさせたときの収入」で、do は介入を表す Pearl流の記号です。観察データで数えられるのは前者だけですが、知りたいのは後者です。図の上では、介入は「$D$ に入ってくる矢印を全部切って、$D$ の値を自分で決める」操作にあたります。

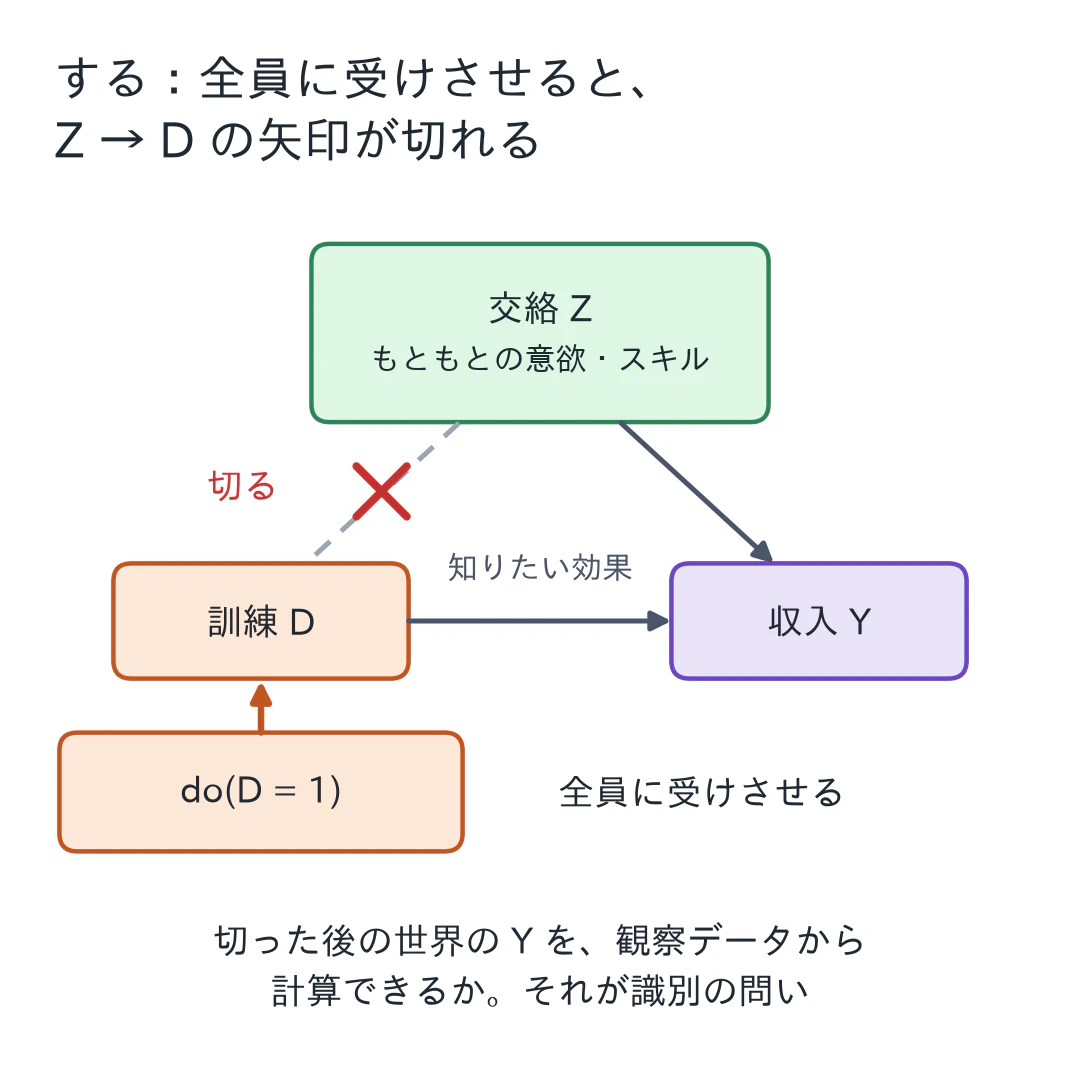
矢印を切った後の世界は、実験をしなければ見えません。それでも、観察データの確率だけから計算できることがあります。できるかどうかを図の形だけで判定するのが 識別 で、そのための代表的な道具が バックドア基準 です。$D$ から $Y$ へ向かう本来の経路とは別に、$D$ に矢印が入ってくる側から $Y$ へ抜ける経路(裏口)があれば、その経路の途中の変数で条件付けして塞ぎます。今日の図では裏口は $D \leftarrow Z \to Y$ の 1 本で、$Z$ で塞げます。塞いだ後の計算式がバックドア調整式です。
$$P(y \mid do(d)) = \sum_{z} P(y \mid d, z), P(z)$$
左辺は「する」世界の確率、右辺は観察データで数えられるものだけでできています。縦棒の右から読むと、「$Z$ が $z$ の層の中で、$D = d$ の人の $y$ を見る」を層ごとに行い、層の大きさ $P(z)$ で重みづけて足す、という意味になります。

Pearl流の強みは、何で調整すべきか、そして何で調整してはいけないか が図から読めることです。交絡を見落とせば裏口が開いたままですし、逆に合流点($D$ と $Y$ の共通の結果)で条件付けすると、閉じていた経路を自分で開けてしまいます(Day 1 の罠 3)。効果を出せるかどうかを、推定を始める前に判定できるのも大きな利点です。一方で、図は仮定であり、矢印 1 本の有無をデータは教えてくれません。また Pearl流は「どの量を計算すればよいか」を教えてくれますが、有限のデータからその量をどう精度よく推定するかは、Rubin流や回帰の道具を借りるのが普通です。DAG の読み方と描き方は Day 10〜15 で練習します。

3.4 計量経済の考え方:データの中の「くじ引き」を探す
計量経済は、結果を式で書く ところから始めます。収入 $Y$ を、訓練 $D$ と意欲 $Z$ と「それ以外のすべて」(誤差)の足し算で表し、知りたい効果を $D$ の係数として置きます。4.1 のコードの Y ~ D + Z がその形です。問題は、誤差に入っている測れていない要因が $D$ と相関していないか、です。相関していれば係数は因果効果ではありません(内生性)。$D$ が誤差と無関係であることを 外生性 と呼び、計量経済の議論はほぼすべて「この $D$ は外生と言えるか」をめぐって進みます。
ここで計量経済らしいのは、外生性を仮定として宣言するだけでなく、データの中に「誰が受けるかを偶然が決めた部分」を探しに行く ことです。コイン投げの代わりになる、自然のくじ引きを使います。制度の境目のすぐ両側の人(回帰不連続)、政策が導入された地域とされなかった地域の前後の変化(差分の差分)、本人の意思とは無関係に受講を押した要因(操作変数)などで、Day 16〜21 の主役です。設計がうまくはまれば、測れない交絡が残っていても因果を取り出せます。
計量経済の強みは、観察データから因果を取り出す 設計 と、回帰という 1 つの道具の上で推定と検定が一体になっていることです。弱みは、見つけた「くじ引き」が本当に偶然かどうかをデータだけでは保証できず、制度や現場の知識が要ることです。今日の訓練データにはくじ引きがありません。その代わり交絡 $Z$ がすべて測れているので、「$Z$ を入れれば $D$ は外生」という 条件付き外生性 の形で回帰を使います。
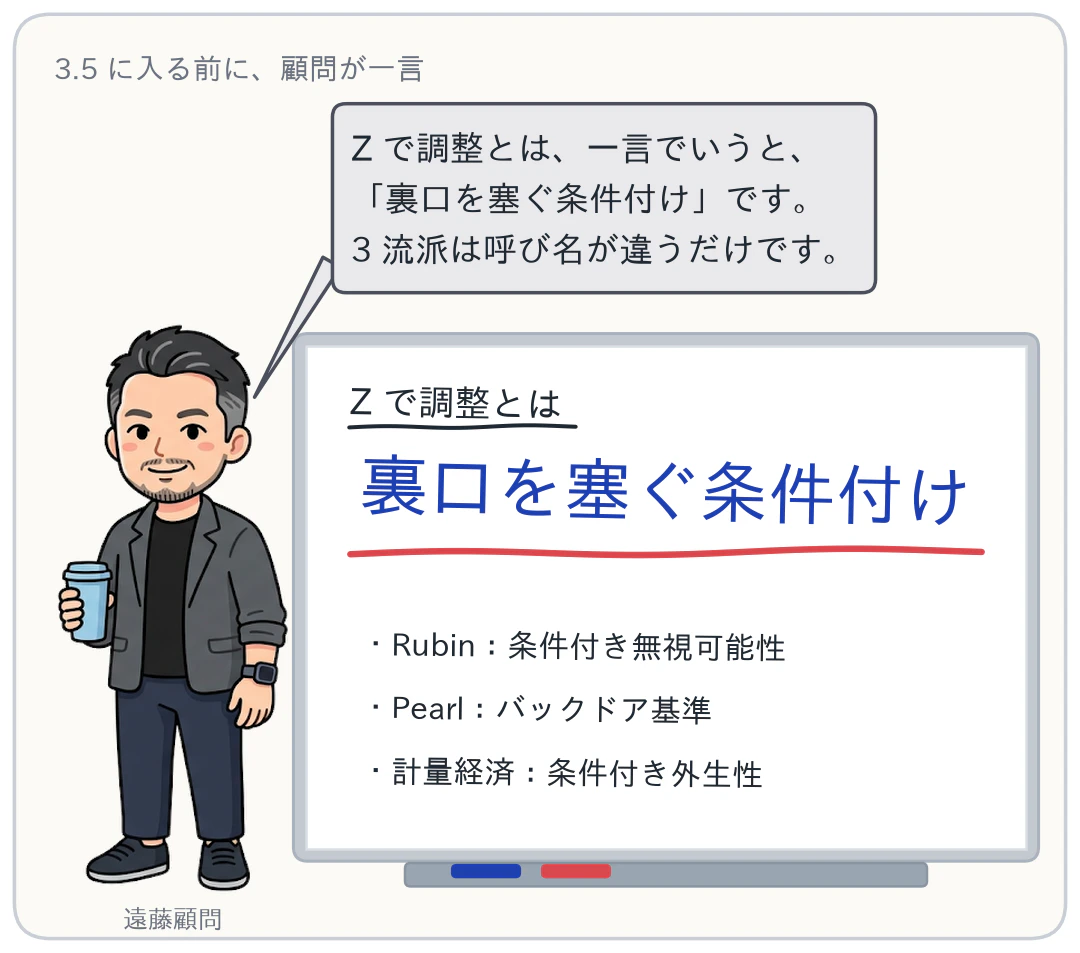
3.5 じつは3流派は「同じ調整」を別の言葉で言っている
この小節が今日の主役です。1 つの DAG の上で、3 つの流派が「$Z$ で調整せよ」を別の言葉で言っていることを読みます。
3.2〜3.4 の 3 つの考え方を、1 つの DAG の上に重ねてみます。いちばん腑に落ちるのは、同じDAGを3つの言葉で読むことです。Day 1・2の「訓練→収入」で、もともとの意欲・スキル $Z$ が交絡している状況を考えてみましょう。
「意欲の高い人ほど訓練を受けやすく($Z \to D$)、意欲が高いほど元々稼ぐ($Z \to Y$)」。この裏口(バックドア経路 $D \leftarrow Z \to Y$)を塞ぐには、$Z$ で条件付けます。ここは3流派とも同じ結論に達します。違うのは言い方だけです。
| 流派 | 「$Z$ で調整せよ」をどう言うか |
|---|---|
| Rubin | 条件付き無視可能性:$Z$ で条件付ければ $(Y(0),Y(1)) \perp D$(割付が潜在的結果と独立になる) |
| Pearl | バックドア基準:$Z$ は裏口 $D \leftarrow Z \to Y$ を塞ぐ調整集合である |
| 計量経済 | 条件付き外生性:$Z$ を回帰に入れれば $D$ は誤差と無相関(selection on observables) |
同じ「$Z$で調整」を、Rubinは欠測データの言葉で、Pearlはグラフの言葉で、計量経済は回帰の言葉で正当化しています。計量経済の言う「外生性」とは、処置 $D$ が回帰の誤差項と無関係であること、つまり誰が処置を受けるかが結果 $Y$ の測れていない要因に引っ張られていない状態です。selection on observables は「選択の偏りは観測できている変数だけで説明がつく」という同じ主張の英語表現です。では本当に同じ答えになるのか、手を動かして確かめます。
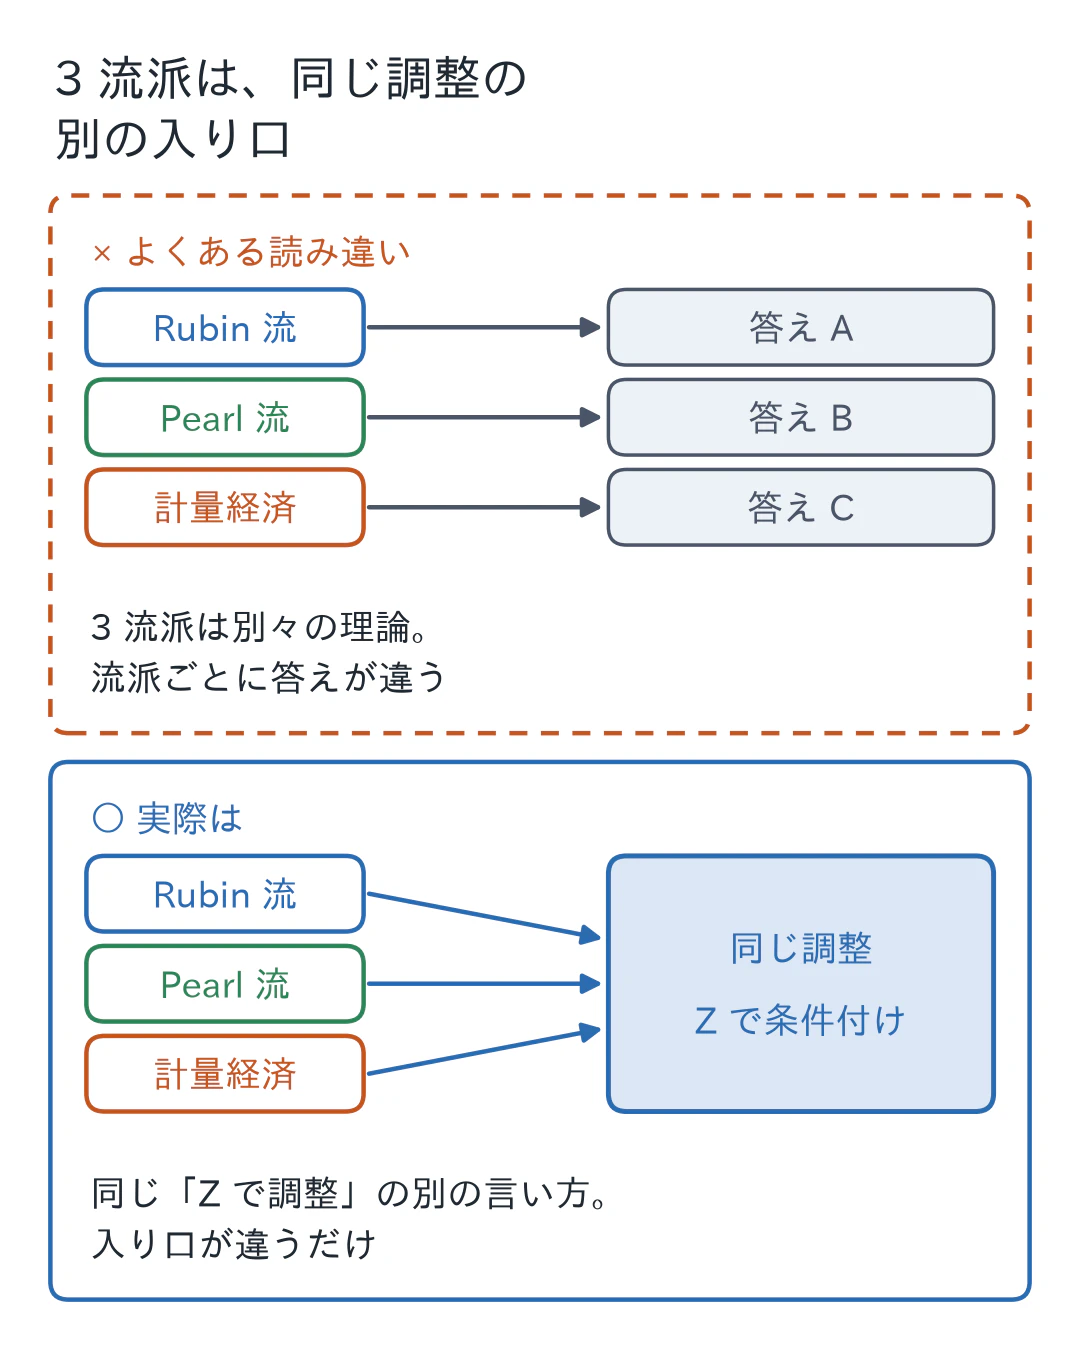
4. 手を動かす
4.1 1つのデータに3流派の調整を当てる
Day 1・2と地続きの「トレーニングを受ける → 収入上昇(万円)」を、今回は交絡ありの観察データとして作ります。真の効果は全員 +50 に固定しておきます(答え合わせのため)。
コード
import numpy as np, pandas as pd
import statsmodels.formula.api as smf

rng = np.random.default_rng(3)
n = 4000
Z = rng.integers(0, 2, n)                                     # 交絡: 1=もともと高スキル/意欲
D = (rng.random(n) < np.where(Z==1, 0.7, 0.3)).astype(int)   # 訓練(処置): 高Zほど受けやすい
Y = 200 + 80*Z + 50*D + rng.normal(0, 20, n)                 # 収入: Zで底上げ + 訓練効果50
df = pd.DataFrame({"Z": Z, "D": D, "Y": Y})

# 素朴(調整なし)= 受けた人と受けない人の平均差
naive = df[df.D==1].Y.mean() - df[df.D==0].Y.mean()
print("素朴(調整なし) = %.1f" % naive)
出力
素朴(調整なし) = 81.3
真の効果は50なのに、素朴な比較は 81.3 です。差の31は「訓練を受けた人はもともと意欲が高い($Z$の影)」が上乗せされた交絡バイアスです。ここまでは Day 1 の復習です。
まず、なぜ81に膨らむのか、このデータの前提を2枚のグラフで見ておきます。交絡の正体は、$Z$(もともとの意欲・スキル)が「受講」と「収入」の両方を押し上げていることです。
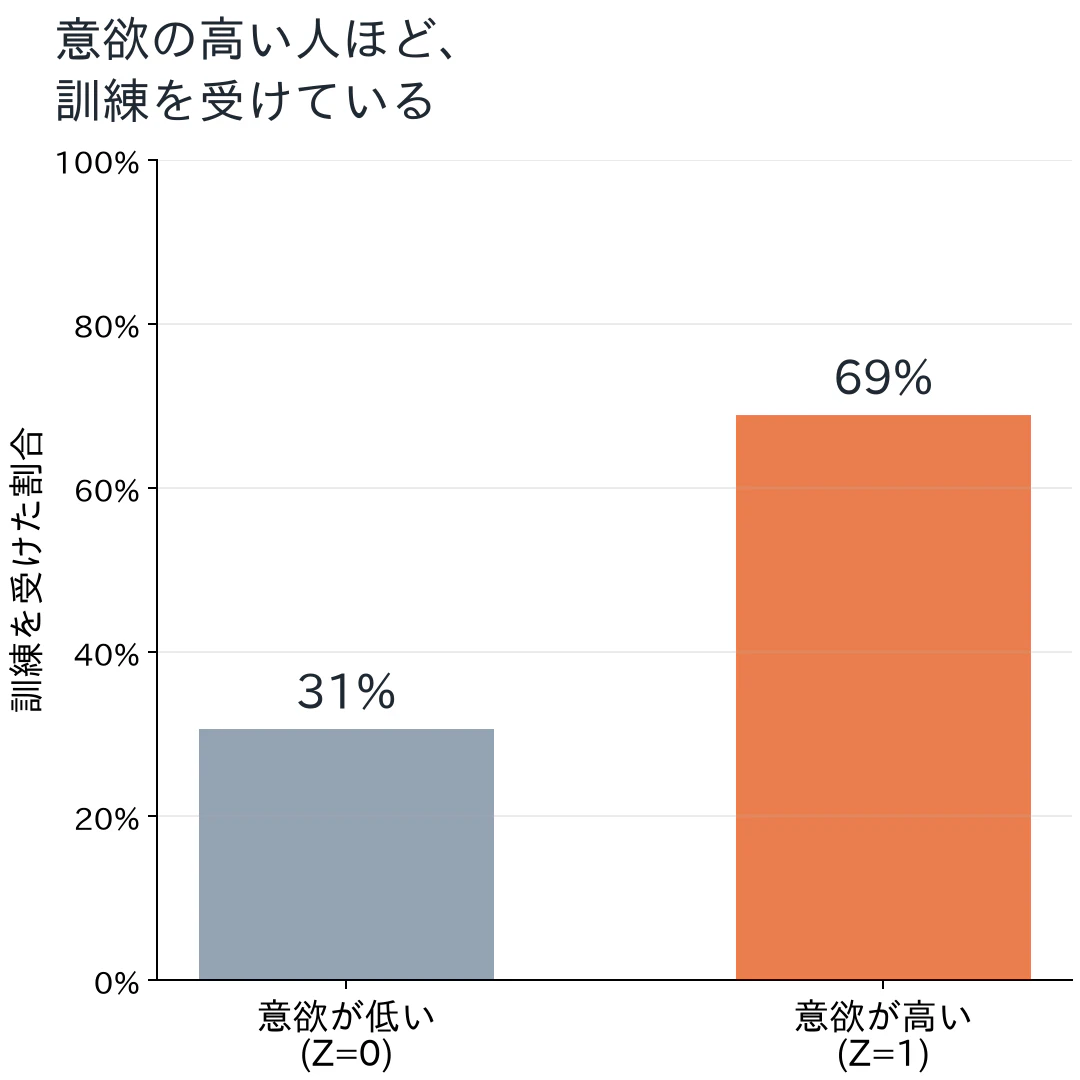
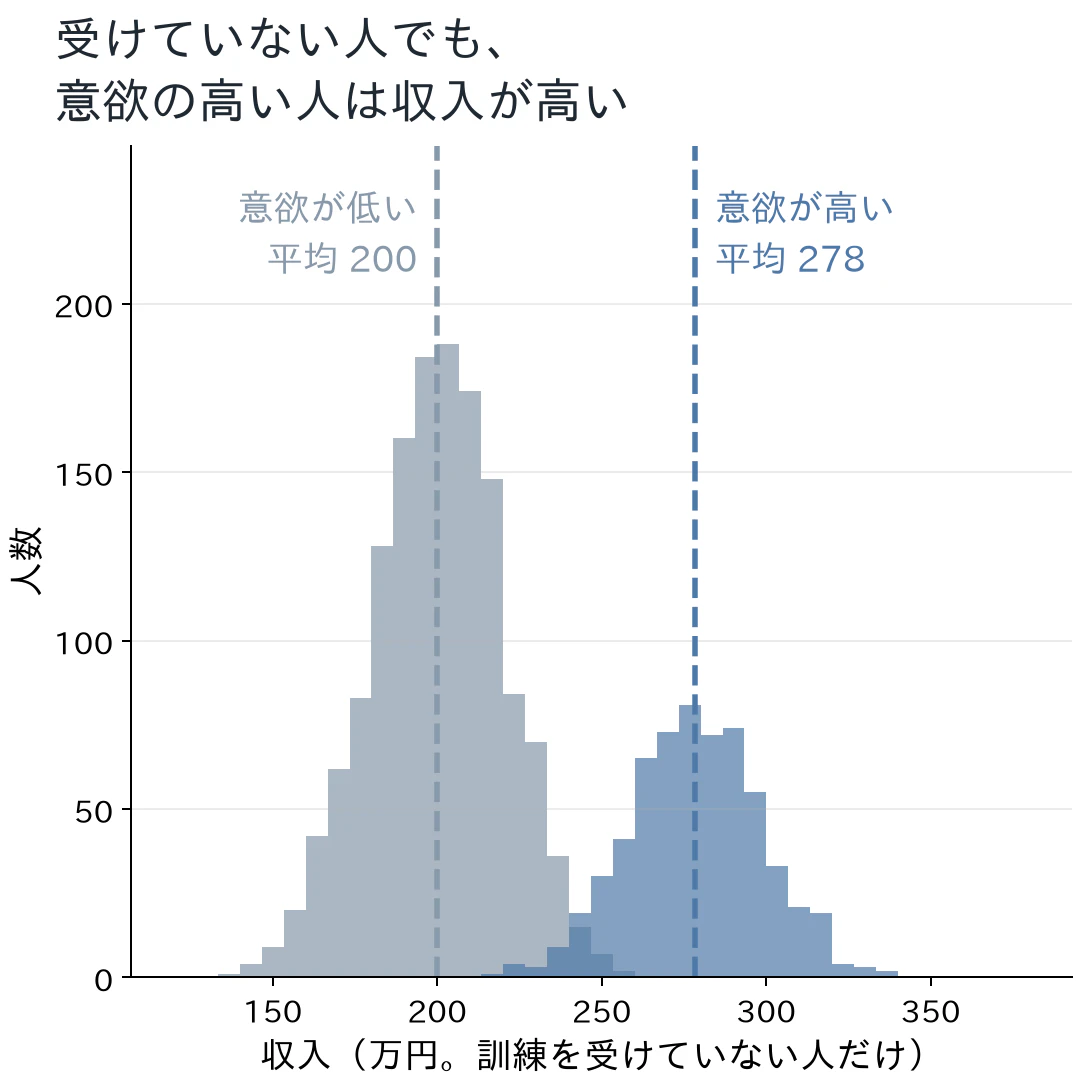
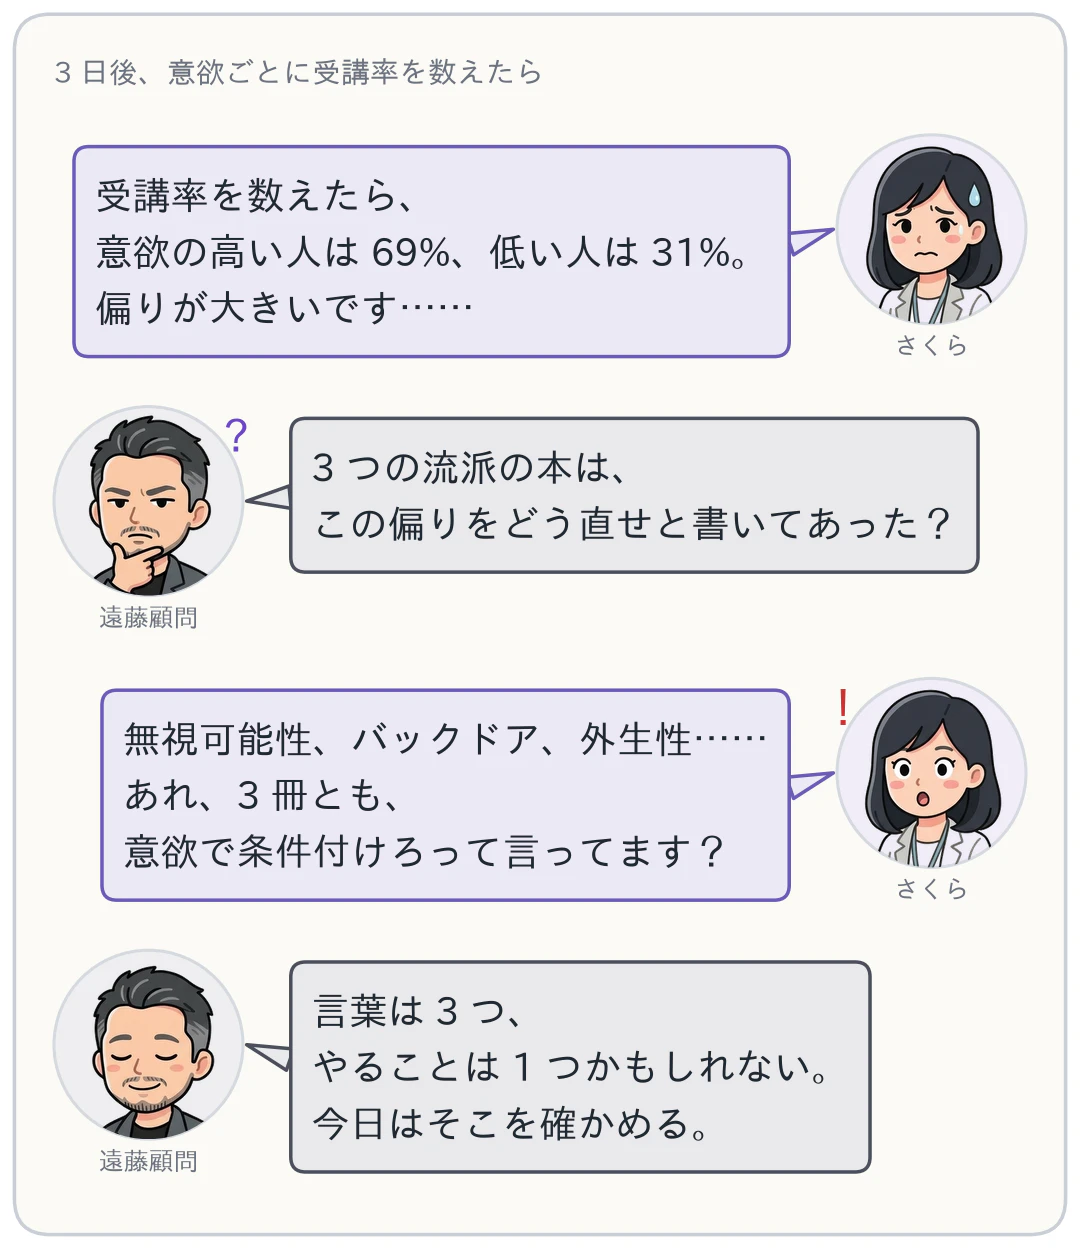
Fig 5a は $Z$ ごとの受講率で、意欲の高い人(Z=1)は 69% が受講、低い人(Z=0)は 31% しか受けません(=処置の自己選択、$Z \to D$)。Fig 5b は訓練を受けていない人だけの収入分布で、それでも Z=1 のほうが平均が高くなっています($Z \to Y$)。この2本の矢印が重なると、「受講者はもともと稼ぐ人が多い」ぶん素朴な比較が水増しされます。
この交絡を、3流派はそれぞれの言葉で調整します。ただしやっている手順はどれも共通です。$Z$ で分け、層内で効果を測り、$P(Z)$ で加重平均します。$P(Z)$ は「その層に全体の何割の人がいるか」の比率で、それを重みにして層ごとの効果を足し合わせる、という意味です。

Fig 6 は上から下へ、①全体をそのまま比べると交絡で +81、②同じ $Z$ の中で分けると層内には交絡がなく、Z=0 層で +50、Z=1 層で +52、③それを層の大きさで加重平均して +50.9、という3ステップです。3 段目の下の 2 行は、この同じ手順を3流派がそれぞれ層別化・バックドア調整式・回帰と呼び分けていることを示しています。
言葉が違うだけで計算は同じ、をコードで確かめます。
コード
# ① Rubin流:Zで層別化 → 層内の効果を P(Z) で加重平均
strata = [(df[(df.D==1)&(df.Z==z)].Y.mean() - df[(df.D==0)&(df.Z==z)].Y.mean(),
           (df.Z==z).mean()) for z in (0, 1)]
rubin = sum(diff * w for diff, w in strata)

# ② Pearl流:バックドア調整式 Σ_z [E(Y|D=1,z) - E(Y|D=0,z)] P(z)  ← ①と同じ計算
pearl = rubin

# ③ 計量経済流:Zを入れた回帰 Y ~ D + Z の D の係数
econ = smf.ols("Y ~ D + Z", data=df).fit().params["D"]

print("① Rubin  層別化     = %.1f" % rubin)
print("② Pearl  バックドア = %.1f" % pearl)
print("③ 計量経済 回帰     = %.1f" % econ)
出力
① Rubin  層別化     = 50.9
② Pearl  バックドア = 50.9
③ 計量経済 回帰     = 50.9
3流派とも 50.9。真の効果 50 にぴたりと戻りました。 しかも①と②は書き方が違うだけで、まったく同じ計算です(Pearlのバックドア調整式は、Rubinの層別化加重平均そのもの)。③の回帰も、線形で効果が層ごとに変わらなければ、同じ調整を別の道具でやっているだけです。
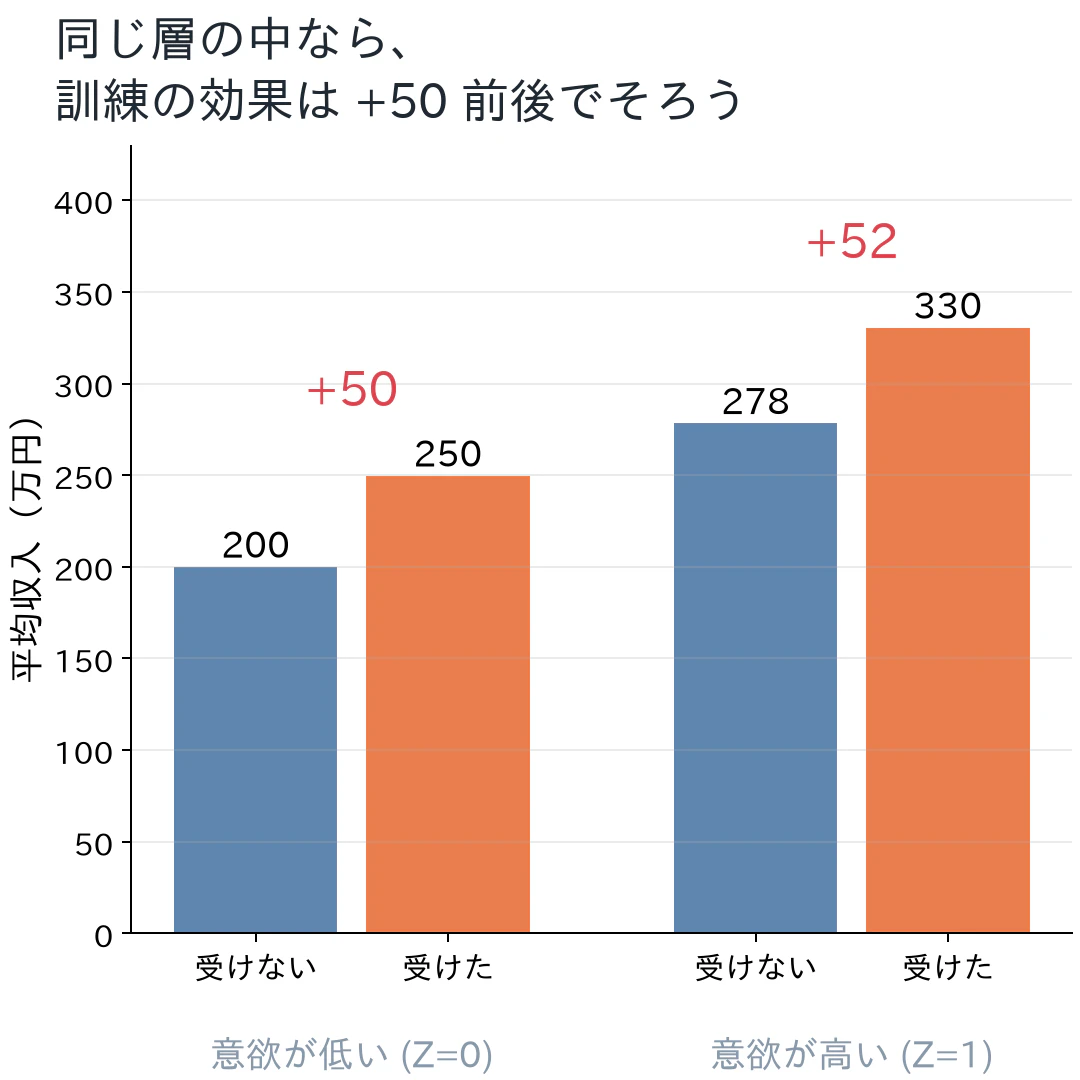

Fig 7a は交絡の構造です。同じスキル層(Z)の中だけを見れば、訓練の効果はどちらの層でもほぼ+50です。 ところが処置群(受けた人)は高スキル層に偏っているので、層を無視して全体を平均すると素朴な81に膨らみます。Fig 7b がその答え合わせで、素朴だけが飛び出し、3流派の調整はすべて赤い真値ライン(50)に着地しています。
「同じ因果、3つの言葉」。これがDay 3のいちばん伝えたいことです。
成り立つ場合と成り立たない場合
| 調整の仮定 | データに出るもの | 今日の数字の読み方 |
|---|---|---|
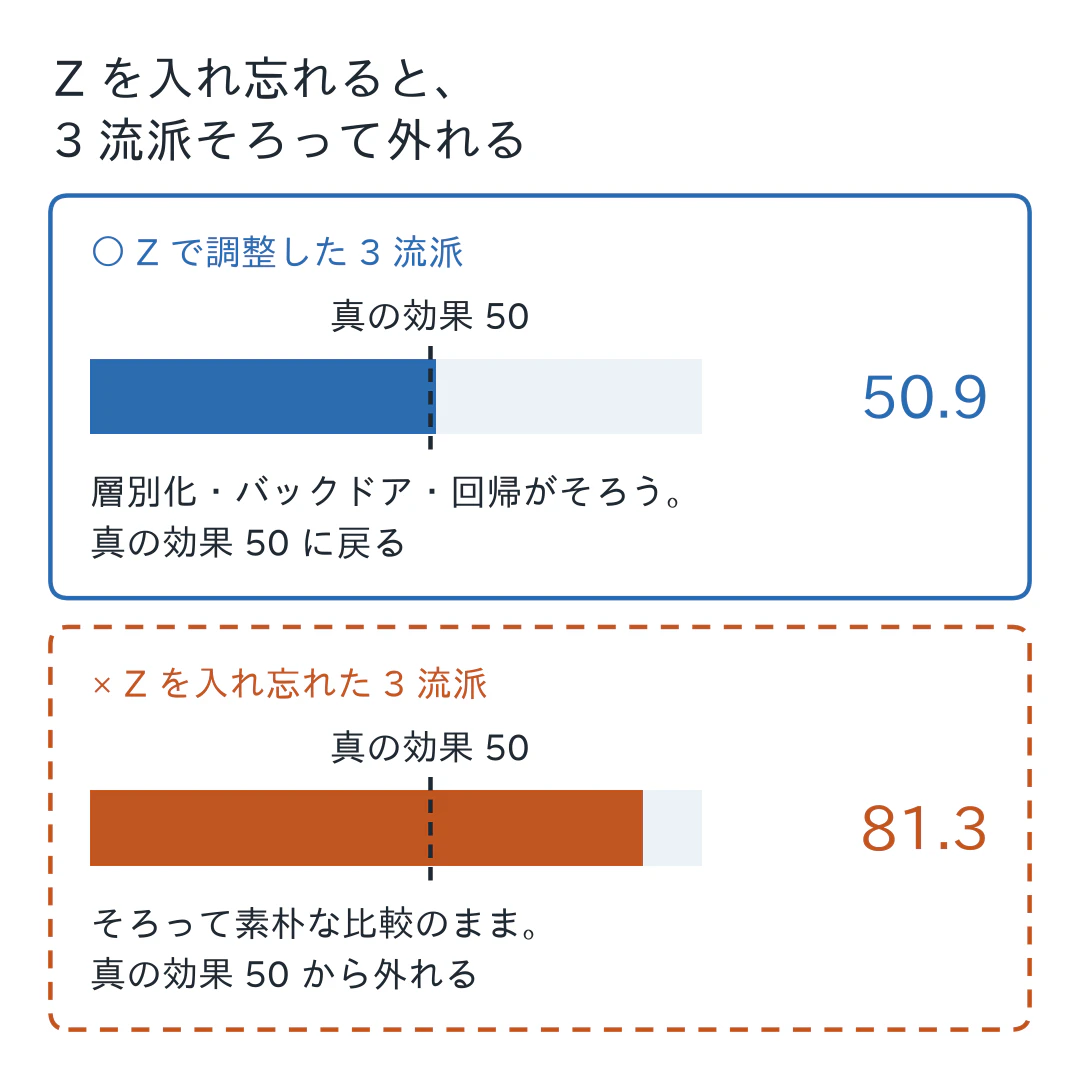
| 裏口を塞ぐ $Z$ で調整した(今日の合成データ) | 層別化・バックドア調整・回帰がどれも 50.9 | 同じ調整なので一致する。真の効果 50 に戻ったと言えるのは、$Z$ が裏口を塞ぎ、ほかに交絡が無いことをデータの作り方から知っているから |
| $Z$ を調整に入れ忘れた | 3 つそろって素朴な比較の 81.3 | そろって間違う。一致は正しさの証拠にならない |
5. 判断の基準
3つの流派は、1つを選んでほかを捨てるものではありません。実務では「Pearlで何を調整すべきかを決め、Rubinや回帰で推定する」のように混ぜて使うのが普通で、どの流派の言葉から入るかは、問題のどこで止まったかで決まります。問いを3つに絞りました。上から順にたどり、最初に右へ出たところが、その問題の入り口です。
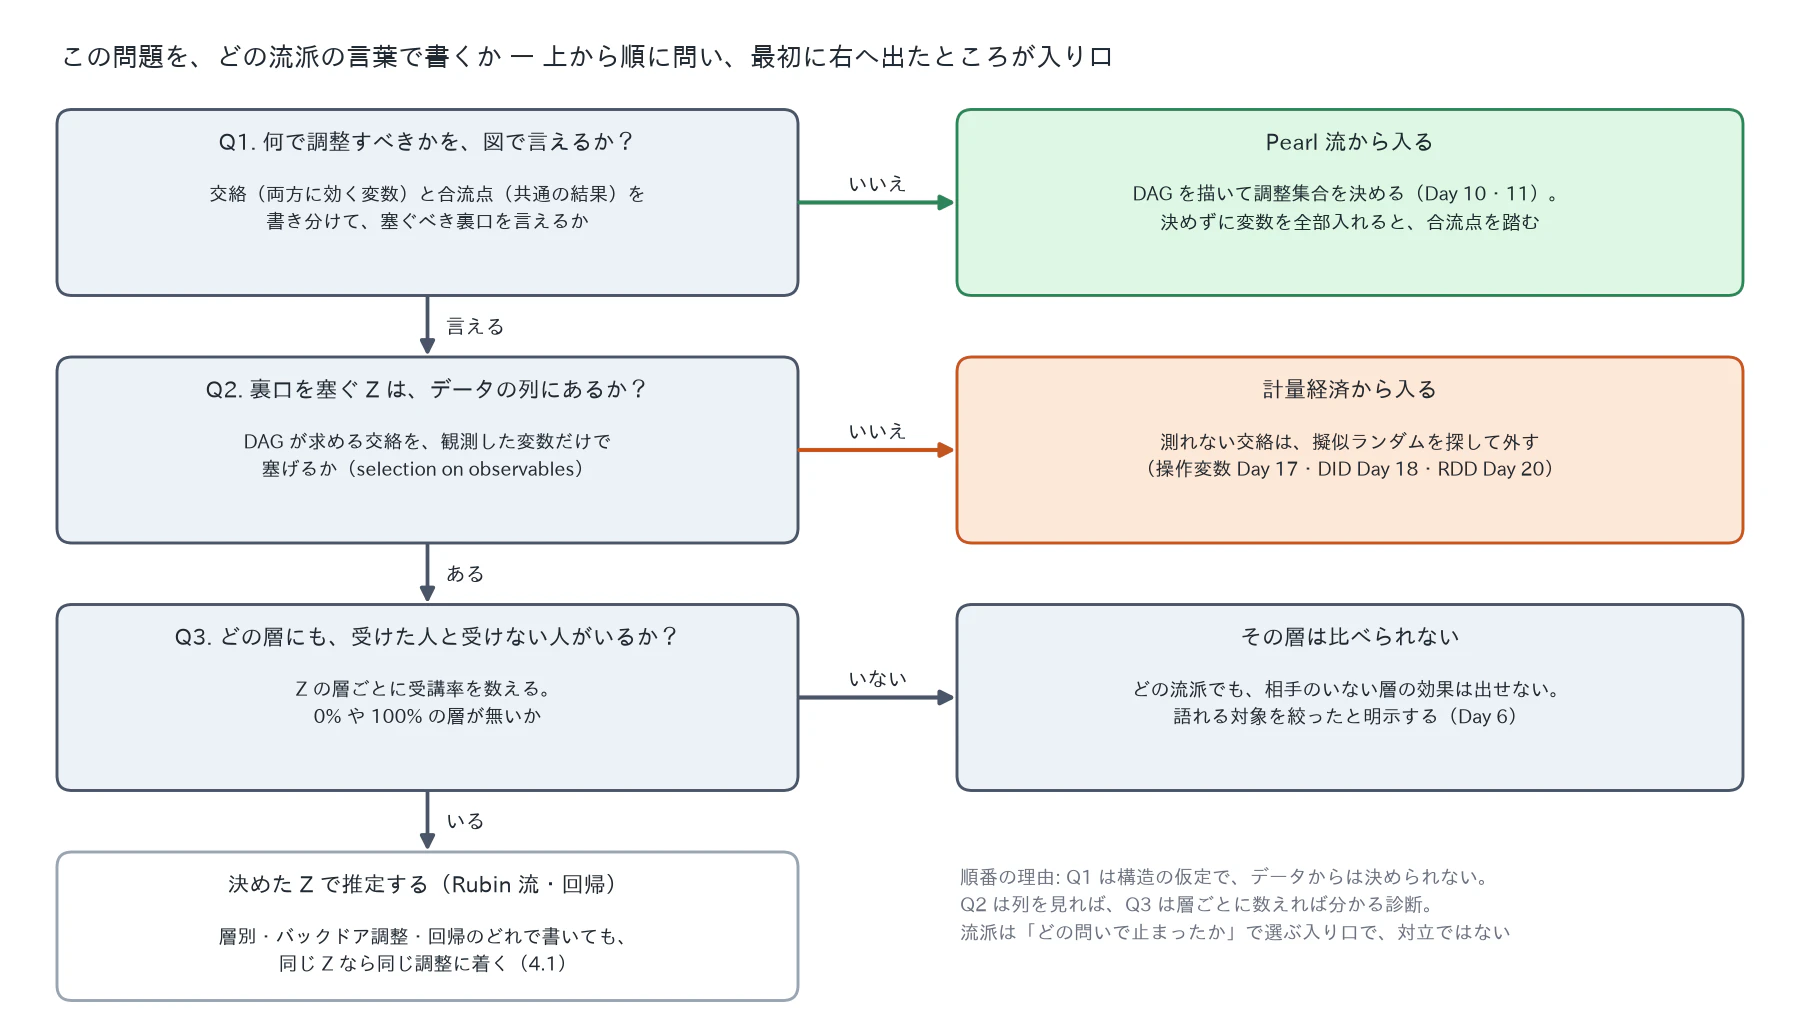
- Q1 は構造の仮定で、データからは決められません。 何が交絡で何が合流点かは、相関の強さではなく因果の構造で決まります。ここで答えられなければ、道具を選ぶ前に Pearl 流の DAG(Day 10・11)を描きます。調整する変数を間違えれば(交絡を見落とす、逆に合流点を入れる=Day 1 の罠 3)、3流派そろって同じように間違えるからです。
- Q2 はデータの列を見れば分かります。 DAG が求める $Z$ が手元にあれば、Rubin 流でも回帰でも推定に進めます。測れない交絡が残るなら、「擬似ランダムはどこにあるか」を探す計量経済の設計(操作変数 Day 17・差分の差分 Day 18・回帰不連続 Day 20)の出番です。
- Q3 は層ごとに数えれば分かる診断です。 今日のデータでは Z=0 の 31%、Z=1 の 69% が受講していて、どちらの層にも受けた人と受けない人がいます。片方しかいない層があると、その層の効果はどの流派の言葉で書いても出せません(Day 6 で扱うオーバーラップ)。
注記 回帰=因果、ではありません。「$Y \sim D + Z$ の係数」が因果効果になるのは、$Z$ が交絡を塞いでいるという仮定があってこそです。回帰は道具であって、正しさを保証する魔法ではありません(Day 16 で深掘りします)。
自分の仕事に当てるなら、次の問いから始められます。いま効果を知りたい施策について、受けた人と受けない人の両方に効きそうな変数を、矢印の図に描いて 3 つ挙げられるでしょうか。
6. 確認問題
問 1(自分の言葉で説明する) 3 つの流派(Rubin流・Pearl流・計量経済)の関係を、本文を見ずに 2 文で説明してください。
答えと解説
模範解答: 3 つの流派は対立する理論ではなく、「正しい $Z$ で条件付けて交絡を消す」という同じ調整を、欠測データ・グラフ・回帰という別の言葉で正当化しています。どの言葉で書いても同じ $Z$ で調整すれば答えはそろい、$Z$ を間違えれば 3 つそろって間違います。
次の 2 点のどちらかが抜けたら不十分です。
- 同じ調整を別の言葉で言っていること(欠測データ・グラフ・回帰)
- 何で調整するかは道具ではなく因果の構造で決まること($Z$ を間違えればそろって間違う)
詰まったら 3.5 と 4.1 に戻ってください。
問 2(別の場面へ移す) ある通販サイトで、会員ランクが高い人ほどクーポンを受け取りやすく、購入額も高い傾向があります。クーポンを受け取った人の平均購入額は、受け取らなかった人より 80 円高くなりました。会員ランクが同じ人どうしで比べると、ランクが低い層では 50 円、高い層では 30 円の差で、2 つの層の人数は同じです。会員ランクが交絡を塞ぐ変数だと信じてよいとき、クーポンの効果の推定値として最も適切なものはどれでしょうか。
- ア 80 円。受け取った人と受け取らなかった人の平均の差をそのまま使う
- イ 50 円。ランクが低い層の差を使う
- ウ 40 円。層ごとの差を、層の大きさで重みづけて足す
- エ 30 円。ランクが高い層の差を使う
答えと解説
ウ。80 円には、ランクが高い人ほどクーポンを受け取りやすく購入額も高いという交絡が混ざっています。ランクが同じ層の中の差(50 円と 30 円)を、層の大きさ(半々)で重みづけて足すと、0.5 × 50 + 0.5 × 30 = 40 円です。今日の 4.1 の「分けて・測って・足す」と同じ手順で、層別化・バックドア調整・回帰のどの言葉で書いても、同じ $Z$ なら同じ調整です。
- ア(交絡を無視する読み違い): 層に分けずに比べると、ランクの影響が効果に混ざります。
- イ(片方の層だけを見る読み違い): ランクが低い層だけでは、全体の効果を表しません。
- エ(もう片方の層だけを見る読み違い): ランクが高い層だけでも、全体の効果を表しません。
問 3(出力を読む) 次の出力で、3つの推定値がそろいました。この一致の読み方として正しいものはどれでしょうか。
① Rubin  層別化     = 50.9
② Pearl  バックドア = 50.9
③ 計量経済 回帰     = 50.9
ア 3つの流派がそれぞれ独立に確かめたので、50.9 が因果効果だと保証された イ 3つとも同じ $Z$ で同じ調整をしたので同じ数字になった。$Z$ の選び方が正しいかどうかは、この一致からは分からない ウ 回帰がいちばん精密なので、③だけを信じればよい エ ①と②が一致したのは、乱数シードの偶然である
答えと解説
イ。①と②はコードの上で pearl = rubin と書いたとおりまったく同じ計算で、③の回帰も同じ $Z$ で同じ調整をしています。もし $Z$ を入れ忘れれば、3つはそろって素朴な比較の 81.3 に並びます。50.9 を因果効果と読めるのは、$Z$ が裏口を塞いでいてほかに交絡が無いことを、今日はデータの作り方から知っているからです。
ア: 一致は正しさの証拠になりません。そろって間違うこともあります。ウ: 精密さの問題ではなく、3つは同じ調整です。エ: 層別化の加重平均とバックドア調整式は式の上で同じもので、シードを変えても①と②は必ず一致します。
7. おわりに

因果推論の主要な3つの流派、Rubin流(潜在的結果)/Pearl流(DAG・do演算子)/計量経済(準実験デザイン) は対立していません。「正しい変数 $Z$ で条件付けて交絡を消す」という同じ調整を、別の言葉で正当化しています。実務では、何で調整するかを Pearl の DAG で決め、測れない交絡が残るなら計量経済の設計を探し、決めた $Z$ で Rubin 流の道具や回帰を使って推定します。最後に確かめます。3 つの流派の関係を、本文を見ずに 2 文で言えますか。詰まったら 3.5 と 4.1 に戻ってください。
8. 参考(本棚)
- Imbens & Rubin『Causal Inference for Statistics, Social, and Biomedical Sciences』第1章。潜在的結果・割付メカニズム(Rubin流の下敷き)
- Pearl, Glymour & Jewell『入門 統計的因果推論』。DAG・do演算子・バックドア基準(Pearl流の下敷き)
- Pearl & Mackenzie『因果推論の科学』(原題 The Book of Why)。「見る」と「する」の違いを数式なしで。Pearl流の考え方の読み物
- Imbens, G. W. (2020) "Potential Outcome and Directed Acyclic Graph Approaches to Causality: Relevance for Empirical Practice in Economics", Journal of Economic Literature 58(4). Rubin流と Pearl流の違いを、計量経済の立場から整理した論文
- 林岳彦『はじめての統計的因果推論』/安井翔太『効果検証入門』。3流派を橋渡しする和書
- 伊藤公一朗『データ分析の力』。準実験デザイン(IV・DID・RDD)を数式なしで
この記事の位置づけ
因果推論を「本を読んだ」で終わらせず、自分の言葉で説明でき、コードで再現できる状態まで落とす 30 日連載の Day 3 です。
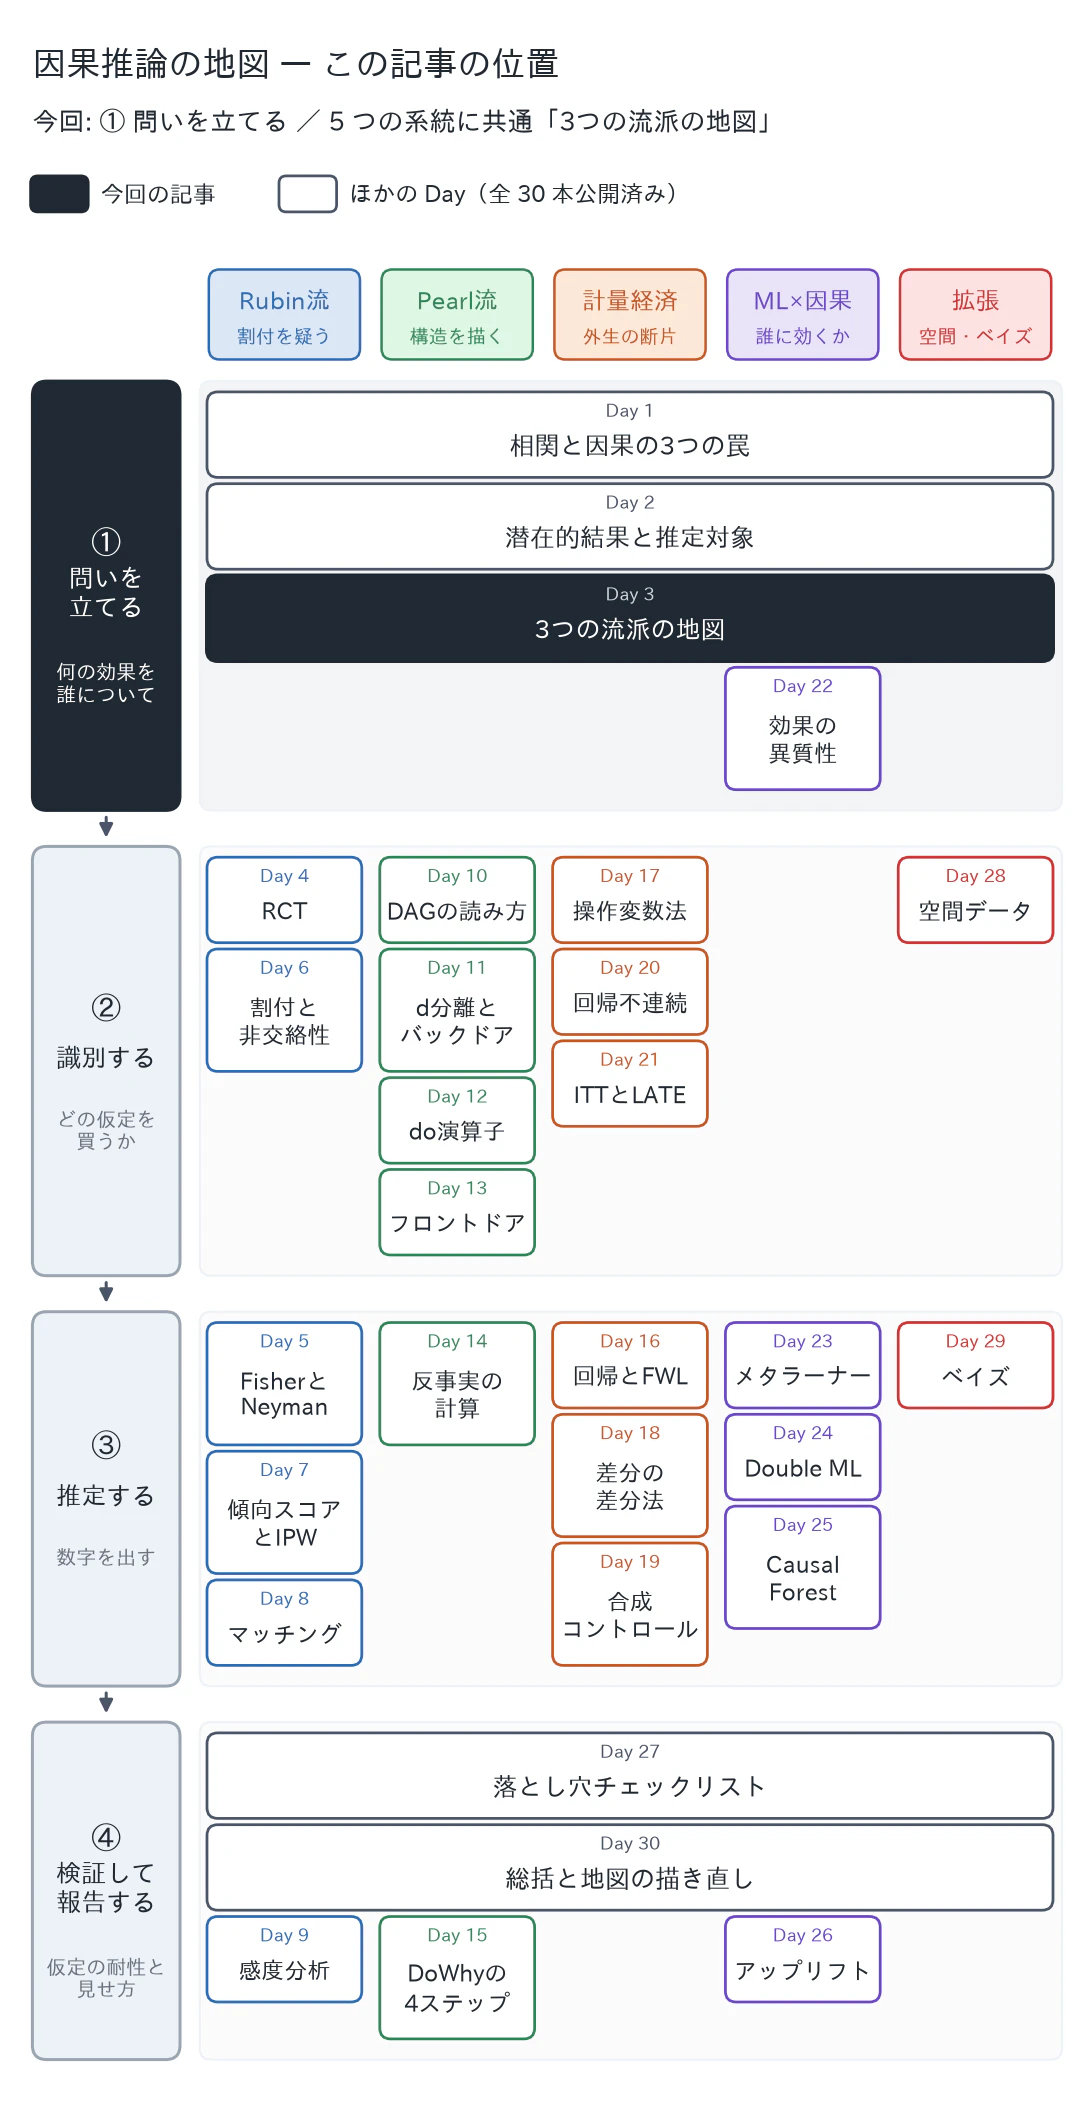
図は縦が分析の工程、横が流派です。この記事は 5 つの系統に共通する土台「3つの流派の地図」で、工程は「① 問いを立てる(何の効果を誰について)」です(図の横長の黒い札)。前提になる回はありません(この記事から読めます)。ここで覚える考え方や道具は Day 15(DoWhyの4ステップ)・Day 30(総括と地図の描き直し) で再登場します。
9. 次回予告(Day 4)
Day 4(RCT)
いよいよRubin流の本丸に入ります。テーマは RCT(無作為化比較試験)はなぜ因果推論の黄金律なのか。Day 3で「正しい $Z$ で調整すれば因果が取れる」と分かりましたが、RCTはそもそも交絡が生まれないように割付を設計します。「調整いらずで因果が測れる」魔法の正体を、A/Bテストのシミュレーションで確かめます。