
この記事は、施策が「誰に、どれだけ効くか」を、手持ちの機械学習で推定する回です。1 人につき見えるのは処置を受けた結果か受けなかった結果の片方だけなので、効果そのものを正解ラベルにした回帰は組めません。予測モデルを組み合わせて効果を作るメタラーナー(S・T・X)を、真の効果を仕込んだ合成データで組み立て、採点します。
登場人物
遠藤顧問: データ分析の社外顧問。答えを言わずに問いで返す/さくら: データアナリスト 1 年目。数字を出すのは速いが、相関を因果と読み違える

1. 1 文で言うと
1 文で言うと
CATE(条件付き平均処置効果)の教師ラベル $\tau_i$ は誰にも観測できないので(因果推論の根本問題の再来)、普通の教師あり回帰は組めません。予測モデルの組み合わせで $\hat\tau(x)$ を作るのがメタラーナーで、S・T・X の 3 つは sklearn だけで手組みできます。
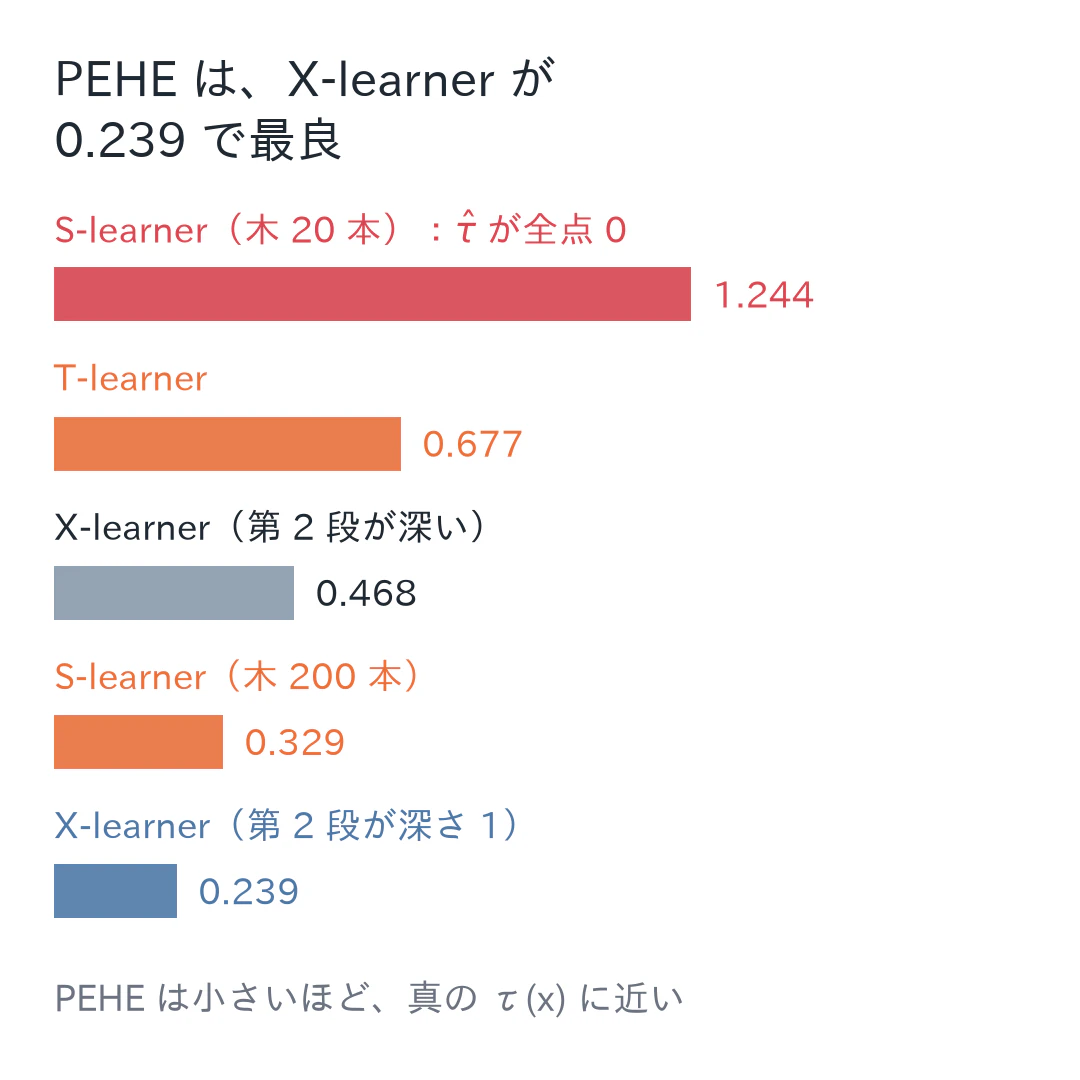
- 今日の数字: 今日の設定では X-learner の PEHE が 0.239 で最良でした(S 0.329、T 0.677)。
2. 今日の問い
今日の問い
「誰に効くか」を予測モデルとして学びたい。でも1人につき観測できるのは $Y(1)$ か $Y(0)$ の片方だけだから、正解ラベル $\tau_i = Y_i(1) - Y_i(0)$ はデータのどの行にも存在しない。
ラベルの無い量を、手持ちの教師あり学習でどう推定するのか。そしてその推定を、正解ラベル無しでどう採点するのか?
読み終えたら、ラベルの無い効果を手持ちの予測モデルで推定する S・T・X の組み方と、その採点に PEHE が要る理由を説明できます。
Day 2 で見た因果推論の根本問題が、機械学習の言葉で戻ってきました。教師あり学習は (特徴量, ラベル) のペアを要求しますが、$\tau_i$ のラベル列は原理的に作れません。今日のゴールは、この壁を「予測問題への分解」で迂回するメタラーナーの設計図を、S/T/X の順に1つずつコードにすることです。3 で S・T・X の考え方と採点の PEHE を言葉にし、4 で合成データを使って手を動かします。前の回から使うのは次の 2 つです。
- Day 6(非交絡性): 割付を決める共変量をすべて観測できている、という検証できない仮定
- Day 7(傾向スコア): 特徴量が $x$ の人が処置を受ける確率で、X-learner の混ぜ方に使う
3. 概念
先に、手元の道具との違いを置きます。A/B テストなら、無作為に分けた 2 群の平均を比べれば効果が出ます。回帰や予測モデルなら、$Y$ を目的変数にして当てにいけます。今日の場面は、処置を受けた人が少数派で割り付けも無作為ではなく、しかも欲しいのは平均ではなく人ごとの効果 $\tau_i$ です。その列は目的変数としてどの行にも無いので、手元の道具をそのまま当てても足りません。メタラーナーは、ラベルのある $Y$ の予測モデルだけを材料に、その組み合わせ方で効果を作ります。
3.1 メタラーナー:ラベルの無い回帰を、予測問題の組み合わせに分解する
出発点は、Day 6 の非交絡性です。割付を決める共変量 $X$ をすべて観測できているなら、CATE は条件付き期待値の差に書き直せます。
$$
\tau(x) = E[Y \mid W=1, X=x] - E[Y \mid W=0, X=x]
$$
読み下すと「特徴量が $x$ の人たちに絞ったとき、処置を受けた人の $Y$ の平均から、受けなかった人の $Y$ の平均を引いたもの」です。$E[\cdot \mid \cdot]$ は「縦棒の右の条件を満たす人だけで取った平均」と読んでください。

左辺はラベルの無い量ですが、右辺に並んだ2つの条件付き期待値は、どちらもただの予測問題です。「処置群での $Y$ の予測」と「対照群での $Y$ の予測」なら、ラベルは観測済みの $Y$ そのもので、勾配ブースティングでもランダムフォレストでも(どちらも決定木をたくさん組み合わせる機械学習の手法です)、好きな学習器で当てにいけます。この分解の仕方には複数の流儀があり、その設計図(レシピ)をメタラーナーと呼びます。中に入れる学習器(base learner)は交換自由で、今日は全部 sklearn の GradientBoostingRegressor に固定します。
以下の記号は、$\hat\mu$(ミューハット)が「$Y$ を予測するモデル」、$\hat\tau$ が「効果の推定値」です。ハット記号は「データから推定した値」の印で、ハットの無い $\mu$ や $\tau$ が真の値を指します。
- S-learner(Single):$W$ をただの特徴量として $X$ に足し、モデル1本 $\hat\mu(x, w)$ を学習。$\hat\tau(x) = \hat\mu(x,1) - \hat\mu(x,0)$。
- T-learner(Two):対照群だけで $\hat\mu_0(x)$、処置群だけで $\hat\mu_1(x)$ の2本を学習。$\hat\tau(x) = \hat\mu_1(x) - \hat\mu_0(x)$。
- X-learner(Cross):T の2本を第1段に使い、第2段で $\tau$ の代理ラベルを作って $\tau$ を直接学習。仕上げに傾向スコアで2つの推定を混ぜます(考え方は 3.3、コードは 4.2 で1ステップずつ)。
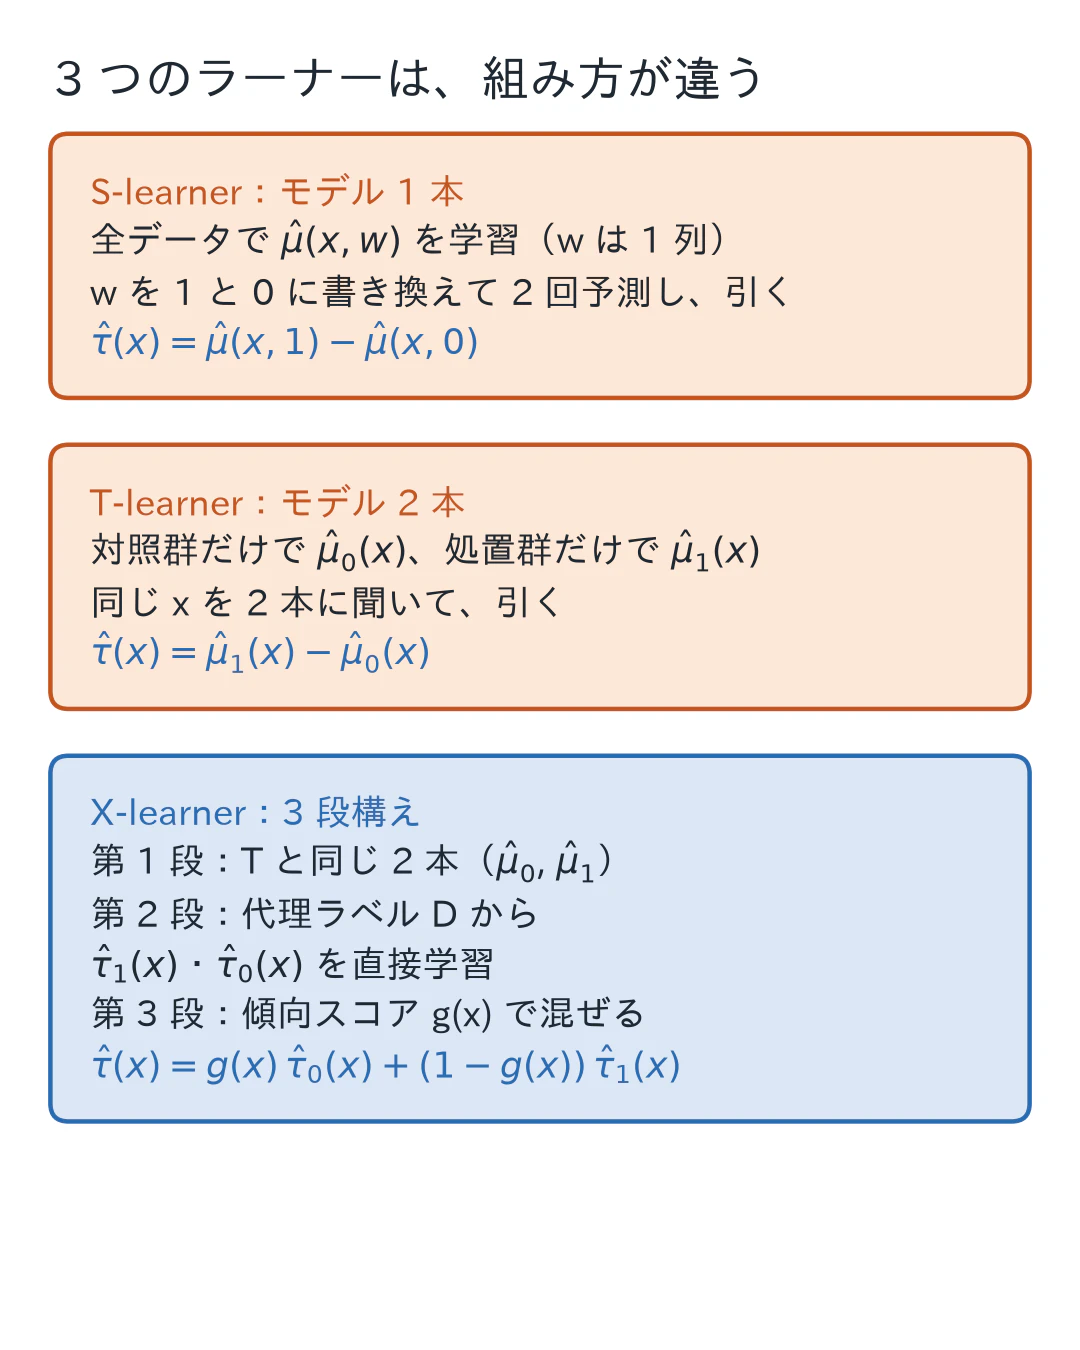
どれも中で使うのは「$Y$ を当てる予測モデル」だけで、違うのは組み合わせ方です。それぞれの考え方を、3.2(S と T)と 3.3(X)で見ていきます。
3.2 S-learner と T-learner の考え方:W を混ぜるか、データを分けるか
まず S-learner です。S は Single の頭文字で、モデルは1 本だけです。処置 $W$ をほかの特徴量と同じ「ただの 1 列」として $X$ の横に足し、全員のデータで $Y$ を予測するモデル $\hat\mu(x, w)$ を学習します。効果を出すときは、同じ人の特徴量 $x$ を 2 回入れます。1 回目は $W$ の列を 1 に、2 回目は 0 に書き換えて予測し、その差 $\hat\mu(x,1) - \hat\mu(x,0)$ を効果とします。「この人が処置を受けていたら」と「受けていなかったら」を、1 本のモデルに 2 回聞く発想です。
S の強みは、全員のデータを 1 本のモデルにまとめて使えることです。弱みは、$W$ がモデルにとって「たくさんある列の 1 つ」にすぎないことです。モデルが $W$ を重要でないと判断すれば、$W$ を 1 から 0 に書き換えても予測はほとんど動かず、推定した効果は 0 に寄ります。どれだけ寄るかは、4.1 で正則化の強さを振って確かめます。

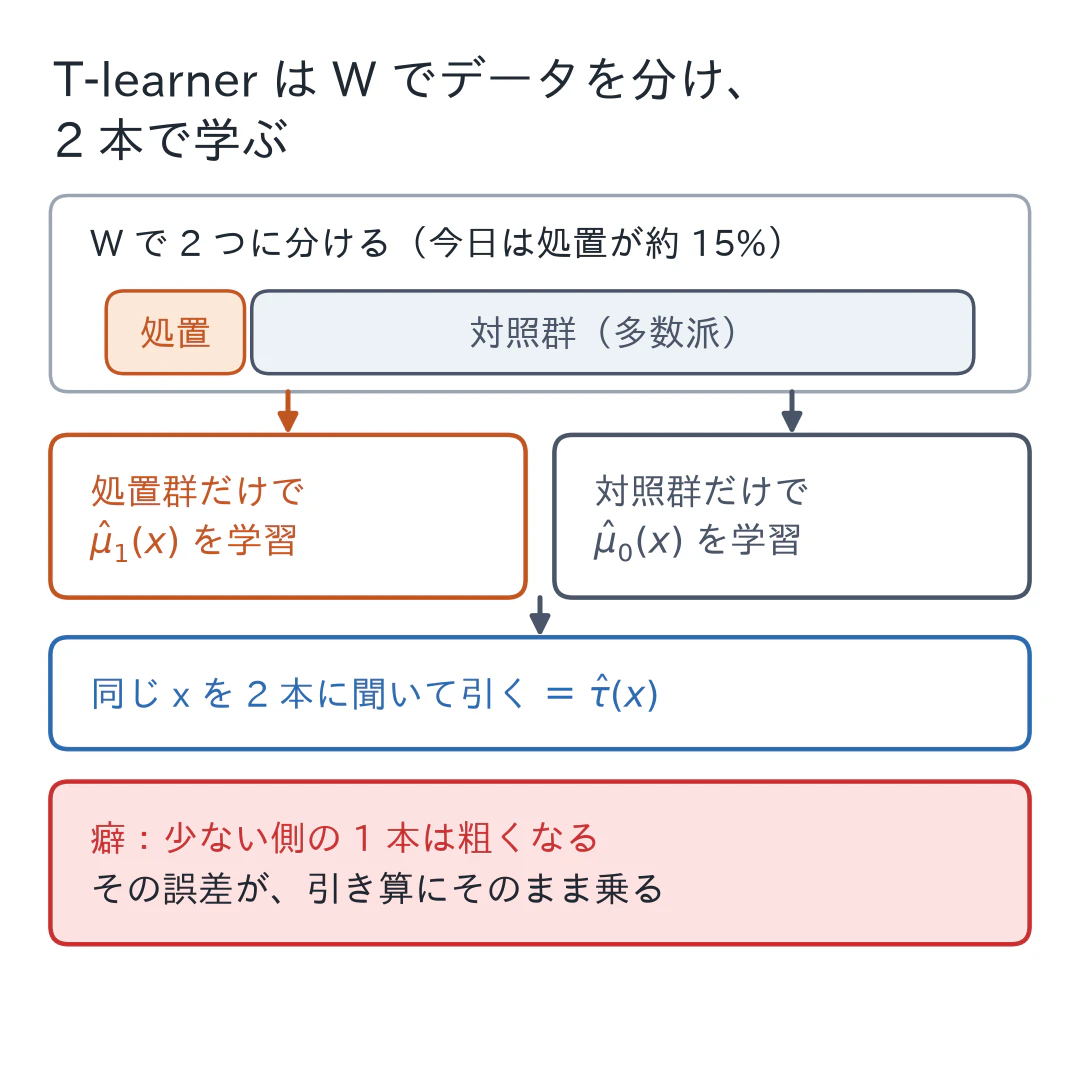
次に T-learner です。T は Two の頭文字で、モデルは2 本です。データを $W$ で 2 つに分け、対照群だけで $\hat\mu_0(x)$、処置群だけで $\hat\mu_1(x)$ を学習します。効果は、同じ $x$ に対する 2 本の予測の差 $\hat\mu_1(x) - \hat\mu_0(x)$ です。$W$ はもう特徴量ではなくデータを分ける鍵なので、S のように見落とされることはありません。
代わりに T は、2 本がそれぞれ別々に $Y$ の背景をまるごと学ぶので、2 本の予測誤差が引き算でそのまま効果に乗ります。とくに片方の群が少ないと、その群の 1 本は少ない人数で背景の構造を学ぶことになり、粗くなります。処置を受けた人が少数派という今日の設定では、この弱点が 4.1 で数字になって出てきます。
3.3 X-learner の考え方:欠けた片方を、対照群の予測で埋める
この小節が今日の主役です。欠けた片方を予測で埋めて代理の効果 $D$ を作り、それを目的変数にして効果を直接学ぶところが、X-learner の中心です。

X-learner は、T-learner の2本を土台に「$\tau$ を直接学習する」段を重ねます。鍵は、観測できないはずの $\tau_i$ の代理ラベルを作ってしまうことです。S は $W$ を見落とし、T は少ない側の誤差を引き算に乗せました。本当に欲しいのは、効果そのものを目的変数にした回帰です。ところがその列には、どの行にも「?」しか入っていません。そこで発想を変えます。1 人分の効果を丸ごと予測で置くのではなく、欠けた片方だけを予測で埋めるのです。
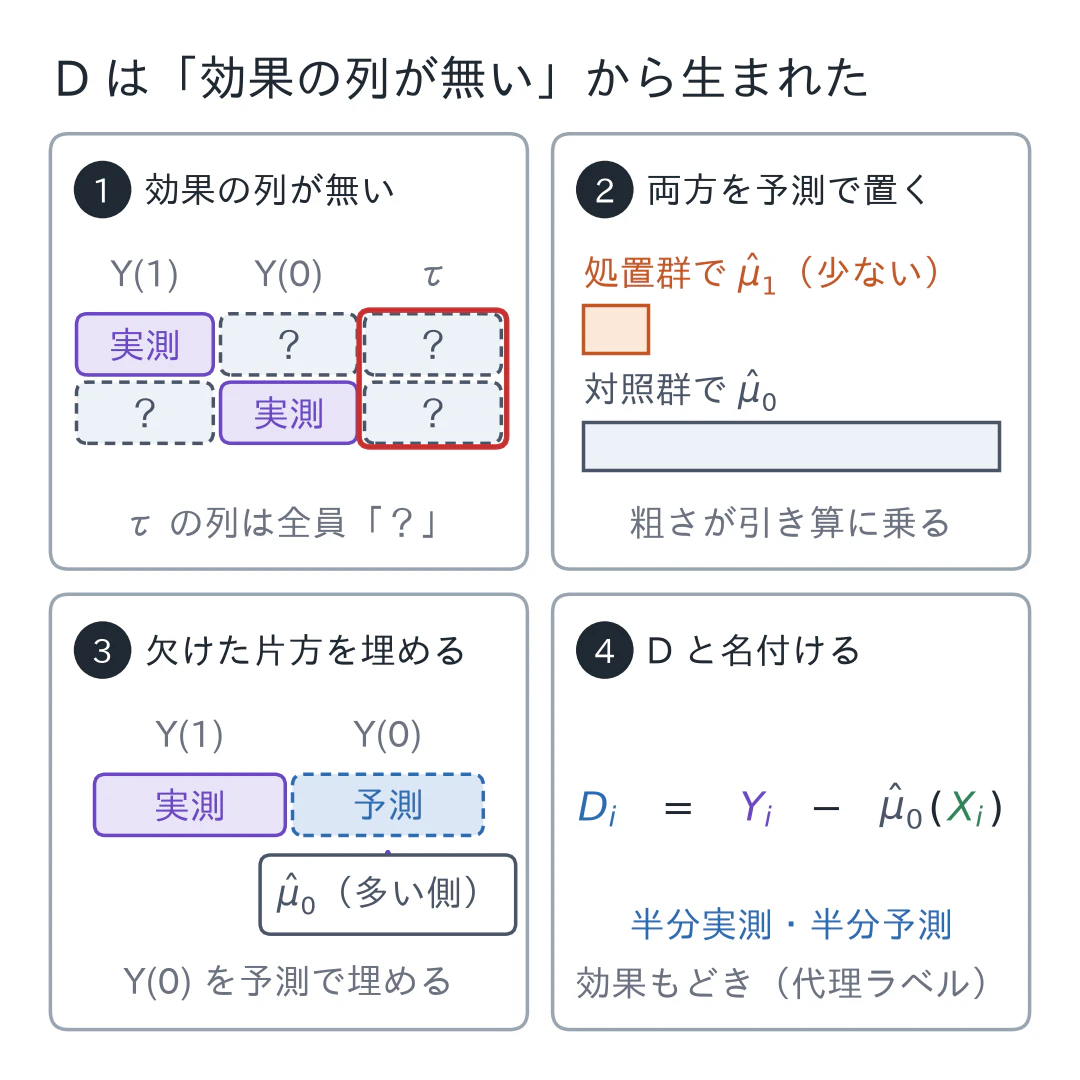
処置群の人 $i$ を考えます。$Y_i(1)$ は実測済みで、欠けているのは $Y_i(0)$ だけです。その欠けた片方を、対照群5,061人で鍛えた $\hat\mu_0$ の予測で埋めると、次の「半分実測・半分予測」の効果もどきが1人1個できます。
$$
D_i = Y_i - \hat\mu_0(X_i)
$$
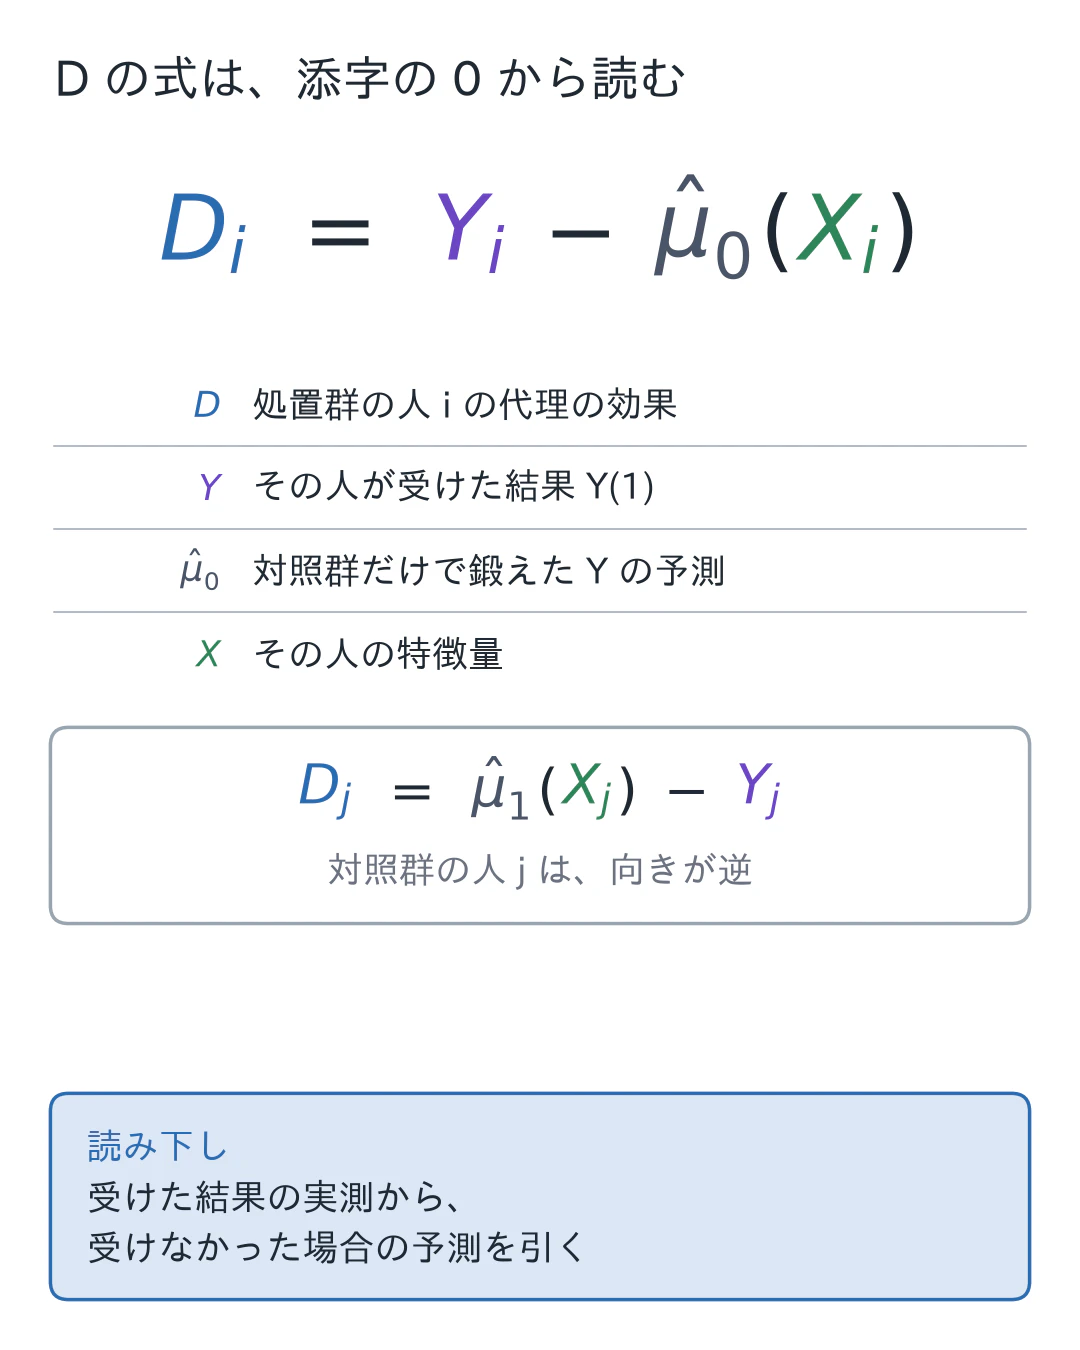
式は左から読むより、$\hat\mu$ の添字の 0 から読みます。この式は 3 つに分けて読みます。
- $\hat\mu_0$ は対照群($W = 0$)のデータだけで鍛えた、$Y$ を予測するモデルです。
- そこへ処置群の人 $i$ の特徴量 $X_i$ を入れた $\hat\mu_0(X_i)$ は、「この人が処置を受けなかったら、$Y$ はいくつだったか」の予測になります。
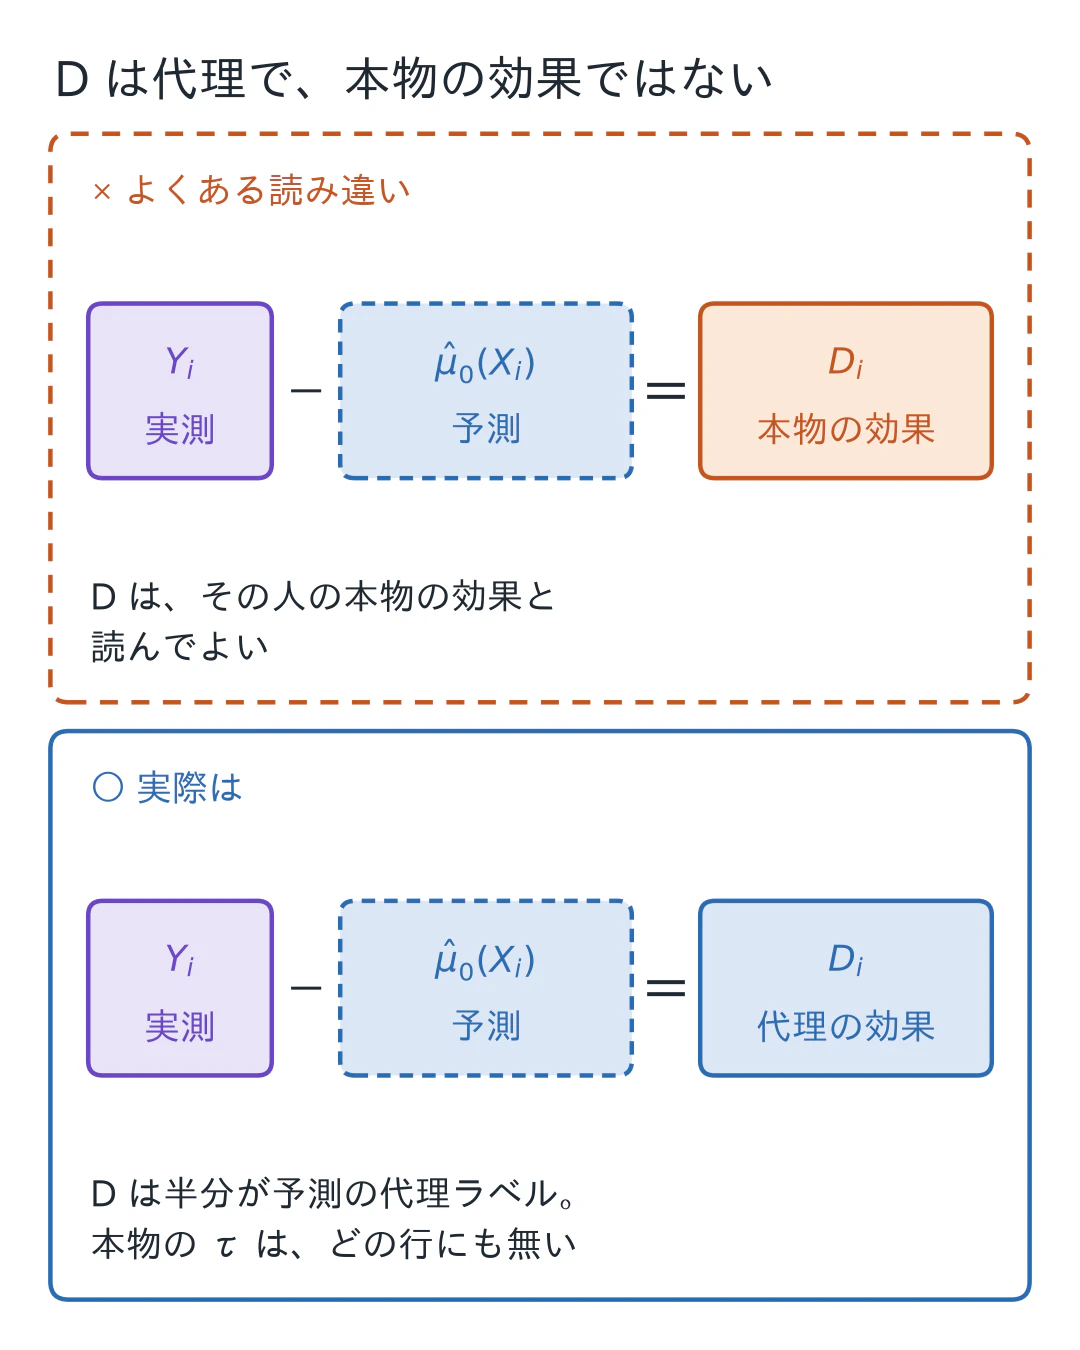
- $Y_i$ は、この人が実際に処置を受けて観測された結果、つまり $Y_i(1)$ そのものです。つなげると「受けた結果の実測から、受けなかった場合の予測を引いたもの」で、それに $D_i$ という名前を付けただけの式です。
対照群には逆向きに $D_j = \hat\mu_1(X_j) - Y_j$ を作ります。これでついに「$\tau$ を目的変数にした回帰」が書けます。ラベルは代理品ですが、処置群側の代理ラベルから $\hat\tau_1(x)$、対照群側から $\hat\tau_0(x)$ を学習します。T-learner との違いは、引き算の片方が実測になったことです。処置群側の代理ラベルに入る予測は、人数の多い対照群で鍛えた $\hat\mu_0$ だけなので、少ない処置群で学んだモデルの粗さを持ち込みません。
代理ラベルの作り方を図にすると、処置群と対照群で「実測」と「予測」の役割が入れ替わっているのが見えます。
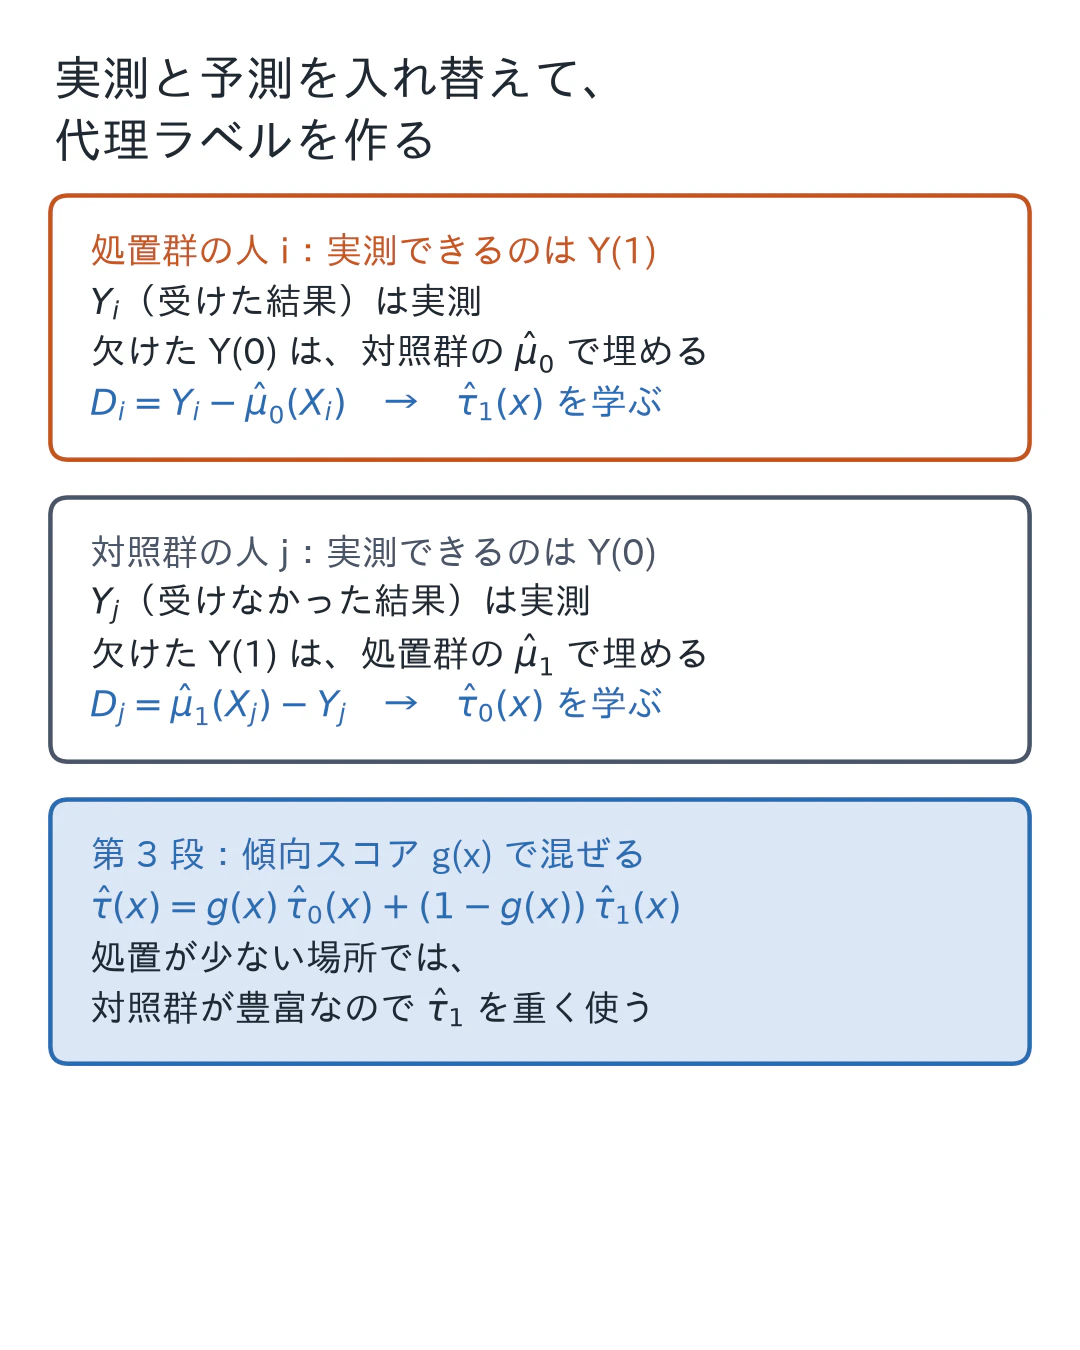
最後に2つをどう混ぜるか。ここで Day 7 の傾向スコアが再登場します。重み $g(x) = \Pr(W=1 \mid X=x)$(特徴量が $x$ の人が処置を受ける確率)を使い、$\hat\tau(x) = g(x)\hat\tau_0(x) + (1-g(x))\hat\tau_1(x)$ と混ぜます。直感はこうです。$\hat\tau_1$ の材料は「処置群の実測」と「対照群で鍛えた $\hat\mu_0$」でした。処置が少ない場所($g(x)$ が小さい場所)では対照群が豊富なので $\hat\mu_0$ が信頼でき、$\hat\tau_1$ を重く使うべきです。$g$ と $1-g$ の取り合わせは、まさにその配分になっています。今日の設定では処置が15%しかないので、ほとんどの場所で $g(x)$ は小さく、$\hat\tau_1$ の側が重く使われます。
3.4 PEHE:効果の予測誤差、ただし現実には計算できない採点表
CATE 推定の標準的な採点は PEHE(precision in estimating heterogeneous effects)です。見た目は RMSE(予測誤差を2乗して平均し、平方根を取った値。機械学習で最もよく使う精度指標の1つ)そのもので、対象が $Y$ ではなく $\tau$ に替わっています(原義は2乗平均で、平方根を取って報告する流儀が多く、本稿でも平方根の値を PEHE と呼びます)。
$$
\mathrm{PEHE} = \sqrt{E\bigl[(\hat\tau(X) - \tau(X))^2\bigr]}
$$
読み下すと「推定した効果 $\hat\tau$ と真の効果 $\tau$ の差を2乗し、全員分の平均を取って平方根に戻した値」です。0 に近いほど効果の予測が真に近く、単位は $Y$ と同じです。

ここで立ち止まる価値があります。なぜ通常の精度指標ではだめなのでしょうか。$Y$ に対する RMSE や決定係数(当てはまりの良さを 0〜1 で表す指標)が測るのは「アウトカムの当てはまり」であって、効果の当てはまりではありません。4.1 で実際に見せますが、$Y$ の予測としてはそこそこのモデルが、効果については「全員ゼロ」という大外れの回答をすることがあります。交差検証(データを分割し、学習に使わなかった部分で精度を測る手順)も同じ理由で頼れません。検証データにあるのは $Y$ のラベルだけなので、交差検証で選ばれるのは「$Y$ をよく当てるモデル」であり、$\tau$ をよく当てるモデルではないのです。
そして本丸の問題があります。$\tau_i$ の正解列が無い以上、実データでは PEHE そのものが計算できません。採点表は定義できるのに、答案と照合する解答用紙が現実には手に入らない。だから今日はデータを合成し、真の $\tau(x)$ を私たちが握ります。この「正解を知っている側が採点する」やり方を、本稿ではオラクル採点と呼びます(オラクルは「正解を知っている神託役」の意味です)。オラクル採点で3つのラーナーの癖を掴みます。実データでの代理評価(順位づけの良さで測る Qini 曲線)は Day 26 に置きます。
4. 手を動かす
4.1 S/T-learner を手組みして、弱点まで見る
データの設計を先に言葉にします。ベースライン $\mu_0(x)$ は $x_2$ から $x_5$ が絡む複雑な関数、効果 $\tau(x)$ は $x_1$ だけで決まる単純なシグモイド(S字カーブ。0 から 2 へなだらかに上がり、ATE は 1.0)、処置確率は $x_2$ に依存させて(交絡)平均15%に絞ります。「背景は複雑、効果は単純、処置は少数派」という、Künzel らが X-learner の得意場面として挙げた構図です。実務でも施策を受けた側が少数派になることは多く、わざとらしい設定ではありません。
コード
import numpy as np
from sklearn.ensemble import GradientBoostingRegressor

rng = np.random.default_rng(23)
N = 6000

# 共変量5個。ベースラインは x2〜x5 の複雑な関数、効果の異質性は x1 だけが決める
X = rng.uniform(-1, 1, size=(N, 5))
x1, x2, x3, x4, x5 = X.T

mu0 = 5 * np.sin(np.pi * x2) + 3 * x3 * x4 + 2 * x5 + 2 * x2   # ベースライン(複雑)
tau = 2 / (1 + np.exp(-4 * x1))          # 真の効果 τ(x):x1 のシグモイド(単純)
e   = 1 / (1 + np.exp(2.0 - 1.5 * x2))   # 傾向スコア:x2 が高いほど処置(交絡)
w   = rng.binomial(1, e)
y   = mu0 + w * tau + rng.normal(0, 1, N)

print("処置群 %d 人 / 対照群 %d 人" % (w.sum(), (1 - w).sum()))
print("真のATE = %.2f(τ(x) は %.2f から %.2f)" % (tau.mean(), tau.min(), tau.max()))
print("素朴な差 = %.2f" % (y[w == 1].mean() - y[w == 0].mean()))
出力
処置群 939 人 / 対照群 5061 人
真のATE = 1.00(τ(x) は 0.04 から 1.96)
素朴な差 = 4.02
出力の読み方は、1行目が群のサイズ、2行目が真の効果の平均と範囲、3行目が何も調整しない単純な平均差です。素朴な引き算は 4.02 で、真の ATE 1.00 の4倍です。$x_2$ が処置確率とベースラインの両方を押し上げているからで、Day 6 で見た交絡そのものです。メタラーナーは共変量 $X$ で条件付けた予測の差を取るので、割付を決める $x_2$ が $X$ に入っている限り、この交絡は調整されます。では S と T を組みます。
コード
def pehe(tau_hat, tau_true):
    return np.sqrt(np.mean((tau_hat - tau_true) ** 2))

# 採点用の新データ。合成だから真の τ(x) を知っていて、答え合わせできる
X_test = rng.uniform(-1, 1, size=(2000, 5))
tau_test = 2 / (1 + np.exp(-4 * X_test[:, 0]))

gbm = dict(n_estimators=200, max_depth=3, learning_rate=0.05,
           min_samples_leaf=30, random_state=0)

# S-learner:W をただの特徴量として1本のモデルに混ぜる
m_s = GradientBoostingRegressor(**gbm).fit(np.column_stack([X, w]), y)
tau_s = (m_s.predict(np.column_stack([X_test, np.ones(2000)]))
         - m_s.predict(np.column_stack([X_test, np.zeros(2000)])))

# T-learner:処置群と対照群で別々のモデル
m0 = GradientBoostingRegressor(**gbm).fit(X[w == 0], y[w == 0])
m1 = GradientBoostingRegressor(**gbm).fit(X[w == 1], y[w == 1])
tau_t = m1.predict(X_test) - m0.predict(X_test)

for name, t in [("S", tau_s), ("T", tau_t)]:
    print("%s-learner: PEHE %.3f, 推定ATE %.2f, τ̂の標準偏差 %.2f"
          % (name, pehe(t, tau_test), t.mean(), t.std()))
print("真のτ(x)の標準偏差 = %.2f" % tau_test.std())
出力
S-learner: PEHE 0.329, 推定ATE 1.02, τ̂の標準偏差 0.62
T-learner: PEHE 0.677, 推定ATE 1.07, τ̂の標準偏差 0.98
真のτ(x)の標準偏差 = 0.71
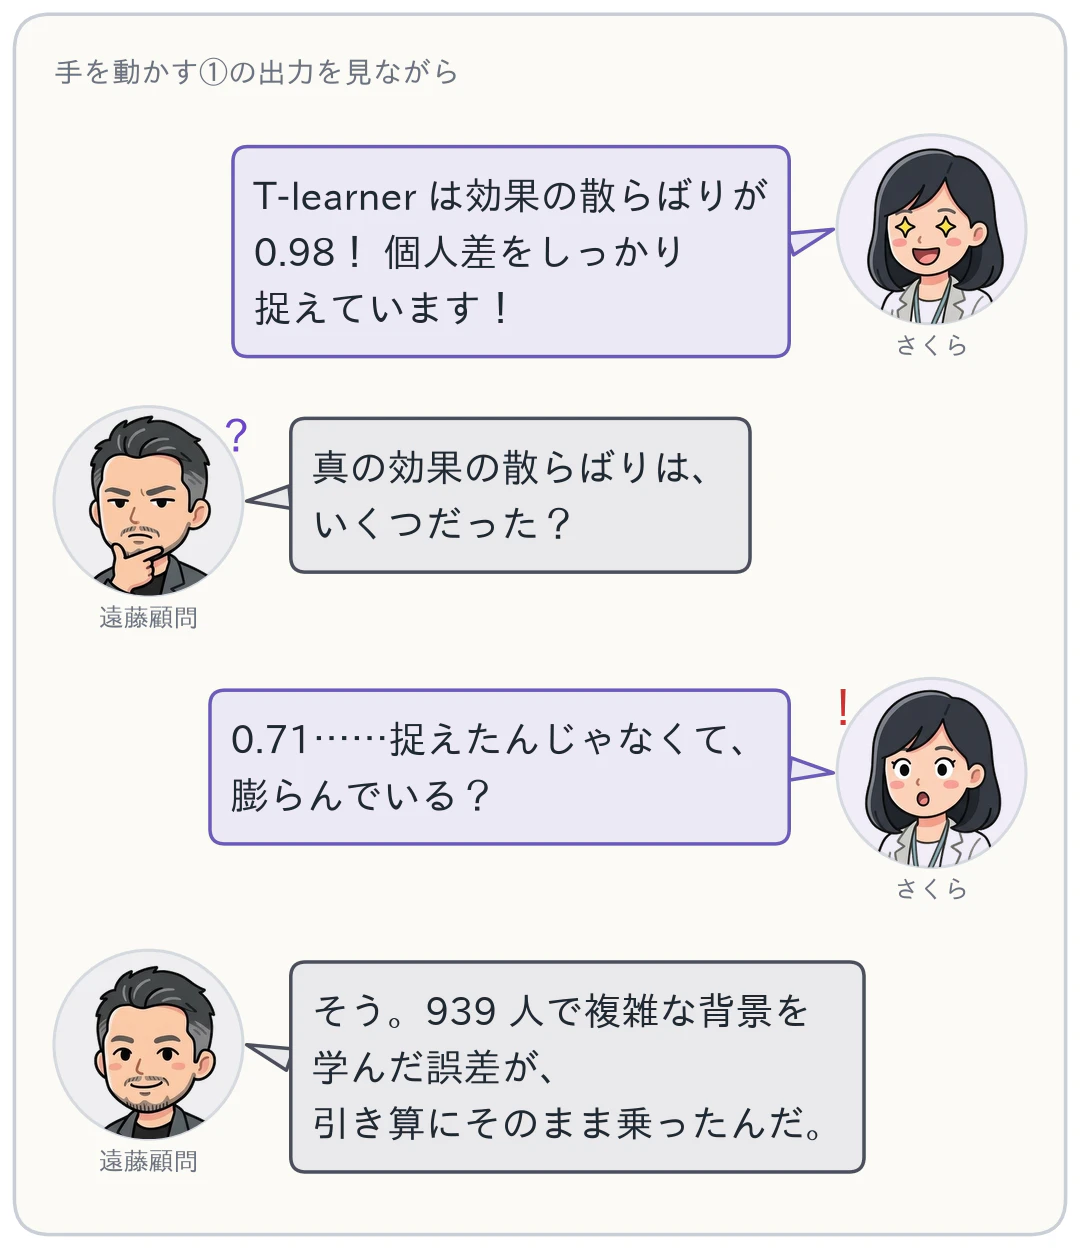
各行の3つの数は、左から「効果の予測誤差(PEHE)」「$\hat\tau$ の平均、つまり推定 ATE」「$\hat\tau$ の散らばり(標準偏差)」です。散らばりは「人によって効果がどれだけ違うと推定したか」の目安で、最終行にある真の散らばり 0.71 と見比べます。両者とも推定 ATE は 1.0 付近に来ました。差が出るのは異質性の質です。T-learner の $\hat\tau$ の散らばり 0.98 は真の 0.71 を大きく超えています。異質性を捉えたのではなく、ノイズを異質性と誤認した膨らみです。原因は群サイズの不均衡で、$\hat\mu_1$ は939人だけで複雑なベースラインをまるごと学ぶ羽目になり、その推定誤差が引き算 $\hat\mu_1 - \hat\mu_0$ にそのまま乗ります。一方 S-learner の散らばり 0.62 は真より小さく、こちらは異質性が1割ほど潰れています。
この「潰れ」は正則化を強めると劇的に進みます。勾配ブースティングで最も素朴な正則化は木の本数を減らすことなので、木の本数を絞ってみます。
コード
for n_est in [200, 50, 20]:
    m = GradientBoostingRegressor(**dict(gbm, n_estimators=n_est)).fit(
        np.column_stack([X, w]), y)
    t = (m.predict(np.column_stack([X_test, np.ones(2000)]))
         - m.predict(np.column_stack([X_test, np.zeros(2000)])))
    print("木 %3d 本: PEHE %.3f, 推定ATE %.2f, τ̂=0 の割合 %3.0f%%"
          % (n_est, pehe(t, tau_test), t.mean(), 100 * np.mean(np.abs(t) < 0.01)))
出力
木 200 本: PEHE 0.329, 推定ATE 1.02, τ̂=0 の割合   0%
木  50 本: PEHE 0.941, 推定ATE 0.35, τ̂=0 の割合   0%
木  20 本: PEHE 1.244, 推定ATE 0.00, τ̂=0 の割合 100%
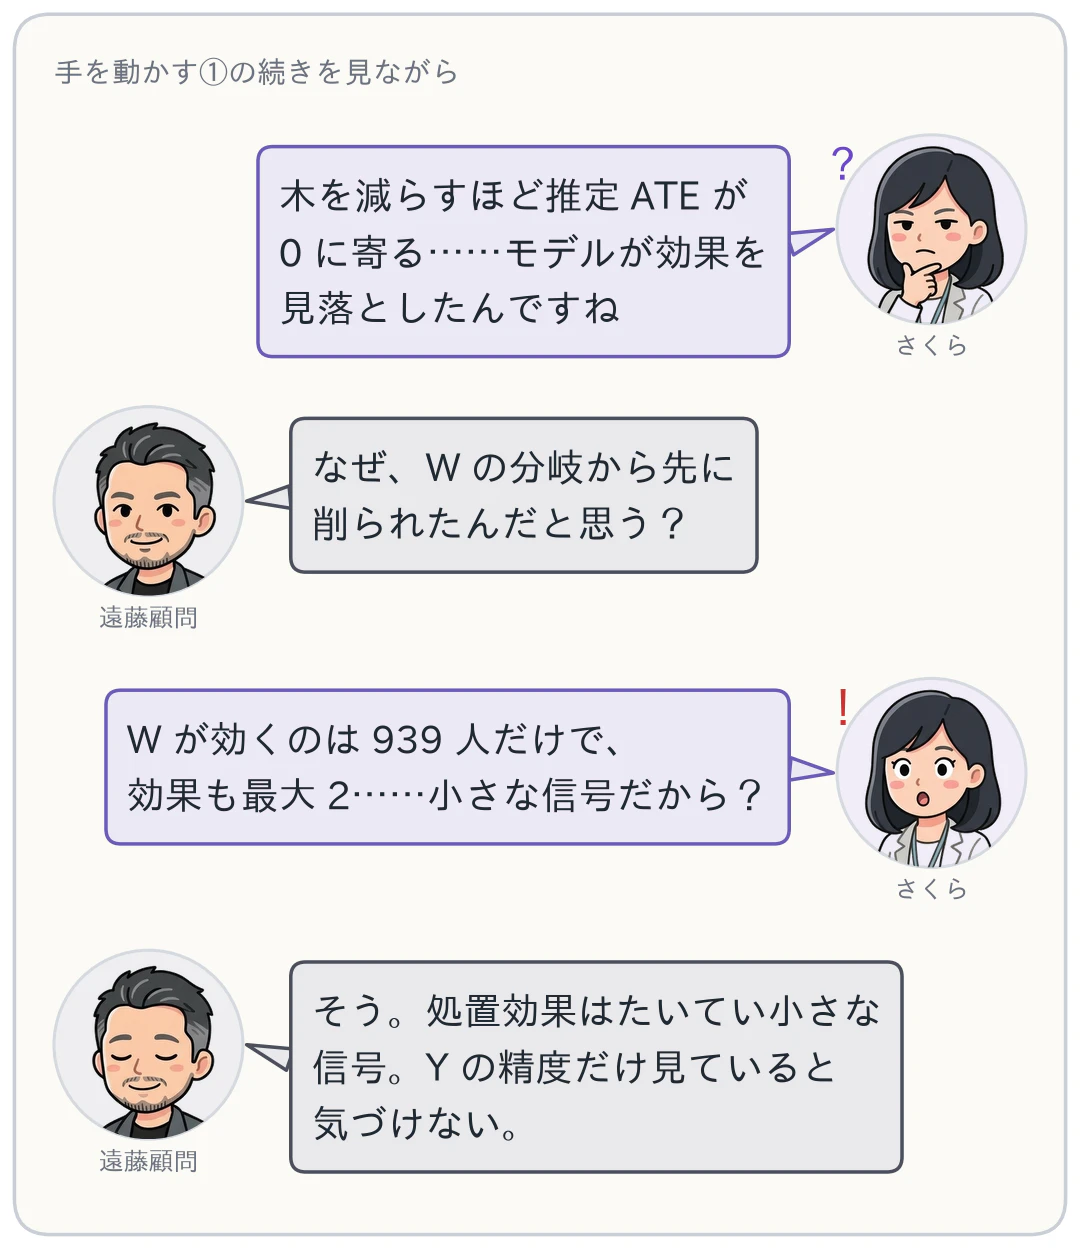
木20本の S-learner は、全2,000点で $\hat\tau = 0$、推定 ATE 0.00 です。「処置効果は存在しない」という回答で、しかもこのモデルは $Y$ の予測器としては壊れていません(訓練データへの決定係数は 0.76 あり、ベースラインの大きな構造は20本でも粗く捉えています)。からくりはこうです。木の分岐は、予測の外れ(損失)を最も減らす特徴量から順に採用されますが、$W$ の分岐が効くのは6,000人中939人だけで、しかも効果の大きさは最大2。振幅10近いベースラインを説明する $x_2$ たちの分岐に比べて、利得が小さいのです。容量を絞られたモデルは小さな信号から切り捨てます。そして処置効果はたいてい小さな信号です。これが「正則化が $\tau$ を潰す」の中身で、$Y$ の精度だけ見ていると気づけません(3.4 の伏線回収です)。
4.2 X-learner を1ステップずつ
3.3 の 3 段を、そのままコードにします。第1段は 4.1 の T-learner の2本(m0 と m1)を再利用し、第2段で代理ラベル d1 と d0 を作って $\tau$ を直接学習し、第3段で傾向スコア $g(x)$ で混ぜます。コードでは $g(x)$ を Day 7 と同じロジスティック回帰で推定し、C=np.inf は「正則化なし」の指定です。
コード
from sklearn.linear_model import LogisticRegression

# 第1段:T-learner の2本 (m0, m1) をそのまま再利用する
# 第2段:観測できない τ_i の代理ラベルを作り、τ を直接学習する
d1 = y[w == 1] - m0.predict(X[w == 1])   # 処置群:実測Y − 予測Y(0)
d0 = m1.predict(X[w == 0]) - y[w == 0]   # 対照群:予測Y(1) − 実測Y
cate = dict(n_estimators=300, max_depth=1, learning_rate=0.05, random_state=0)
tau1 = GradientBoostingRegressor(**cate).fit(X[w == 1], d1)
tau0 = GradientBoostingRegressor(**cate).fit(X[w == 0], d0)

# 第3段:傾向スコア g(x) で2つの推定を混ぜる(Day 7 の再登場)
g = LogisticRegression(C=np.inf).fit(X, w).predict_proba(X_test)[:, 1]
tau_x = g * tau0.predict(X_test) + (1 - g) * tau1.predict(X_test)

print("X-learner: PEHE %.3f, 推定ATE %.2f, τ̂の標準偏差 %.2f"
      % (pehe(tau_x, tau_test), tau_x.mean(), tau_x.std()))
出力
X-learner: PEHE 0.239, 推定ATE 1.12, τ̂の標準偏差 0.70
PEHE 0.239 で、S の 0.329 と T の 0.677 を抜いて最良です。$\hat\tau$ の散らばり 0.70 は真の 0.71 とほぼ一致し、潰しても膨らませてもいません(推定 ATE は 1.12 とやや上振れで、この点は S/T に劣ります。完璧な道具ではありません)。
1つ設計上の判断を仕込みました。第2段のモデルを max_depth=1 に絞ったことです(深さ1の木は分岐が1回だけの「切り株」で、1つの特徴量の単純な形しか表せません)。「CATE は単純」という見込みを、$\tau$ を学ぶモデルに正則化として直接注入しています。ここに X-learner の構造的な強みがあります。S/T では正則化がアウトカムモデルに掛かるため、強めると $\tau$ が巻き添えで歪みました。X は $\tau$ を学ぶ場所が独立にあるので、正則化を正しい場所に掛けられるのです。試しに第2段を第1段と同じ深いモデルにすると、代理ラベルに含まれるノイズまで学んでしまいます。
コード
# 第2段に深いモデル(第1段と同じ設定)を使うと、代理ラベルのノイズまで学ぶ
tau1b = GradientBoostingRegressor(**gbm).fit(X[w == 1], d1)
tau0b = GradientBoostingRegressor(**gbm).fit(X[w == 0], d0)
tau_xb = g * tau0b.predict(X_test) + (1 - g) * tau1b.predict(X_test)
print("X-learner(第2段が深い): PEHE %.3f" % pehe(tau_xb, tau_test))
出力
X-learner(第2段が深い): PEHE 0.468
第2段を深くしただけで PEHE は 0.239 から 0.468 に悪化しました。3つのラーナーの推定を真の $\tau(x)$ に重ねたのが下の 3 枚です。横軸は効果を決める共変量 $x_1$、縦軸は推定した効果 $\hat\tau$ で、赤い曲線が真の $\tau(x)$、点が評価用2,000点それぞれの推定値です。1 枚目の S は形を追えているものの上端がやや潰れ、2 枚目の T は縦に散らばり、3 枚目の X が最も赤い真値曲線に沿っています。


4.3 econml で同じものを1行ずつ対応付ける
手組みの中身が分かったので、実務で使うライブラリ実装と突き合わせます。econml は Microsoft が公開している因果推論の Python ライブラリで、そのメタラーナーは、今日書いた部品がそのまま引数名になっています。 SLearner の overall_model が S の1本、 TLearner の models が T の2本(X の第1段も同じ)、 XLearner の cate_models が第2段の $\tau$ モデル、 propensity_model が混合重み $g(x)$ です。
出力を開く前に予想してください。3 つのラーナーそれぞれで、手組みの $\hat\tau$ と econml の $\hat\tau$ の最大の差は、どのくらいでしょうか。

コード
from econml.metalearners import SLearner, TLearner, XLearner

S = SLearner(overall_model=GradientBoostingRegressor(**gbm))
T = TLearner(models=GradientBoostingRegressor(**gbm))
Xl = XLearner(models=GradientBoostingRegressor(**gbm),
              cate_models=GradientBoostingRegressor(**cate),
              propensity_model=LogisticRegression(C=np.inf))

for name, est, hand in [("S", S, tau_s), ("T", T, tau_t), ("X", Xl, tau_x)]:
    est.fit(y, w, X=X)
    diff = np.abs(est.effect(X_test) - hand).max()
    print("econml %s-learner: PEHE %.3f(手組みとの最大差 %.6f)"
          % (name, pehe(est.effect(X_test), tau_test), diff))
出力
econml S-learner: PEHE 0.329(手組みとの最大差 0.000000)
econml T-learner: PEHE 0.677(手組みとの最大差 0.000000)
econml X-learner: PEHE 0.239(手組みとの最大差 0.000000)
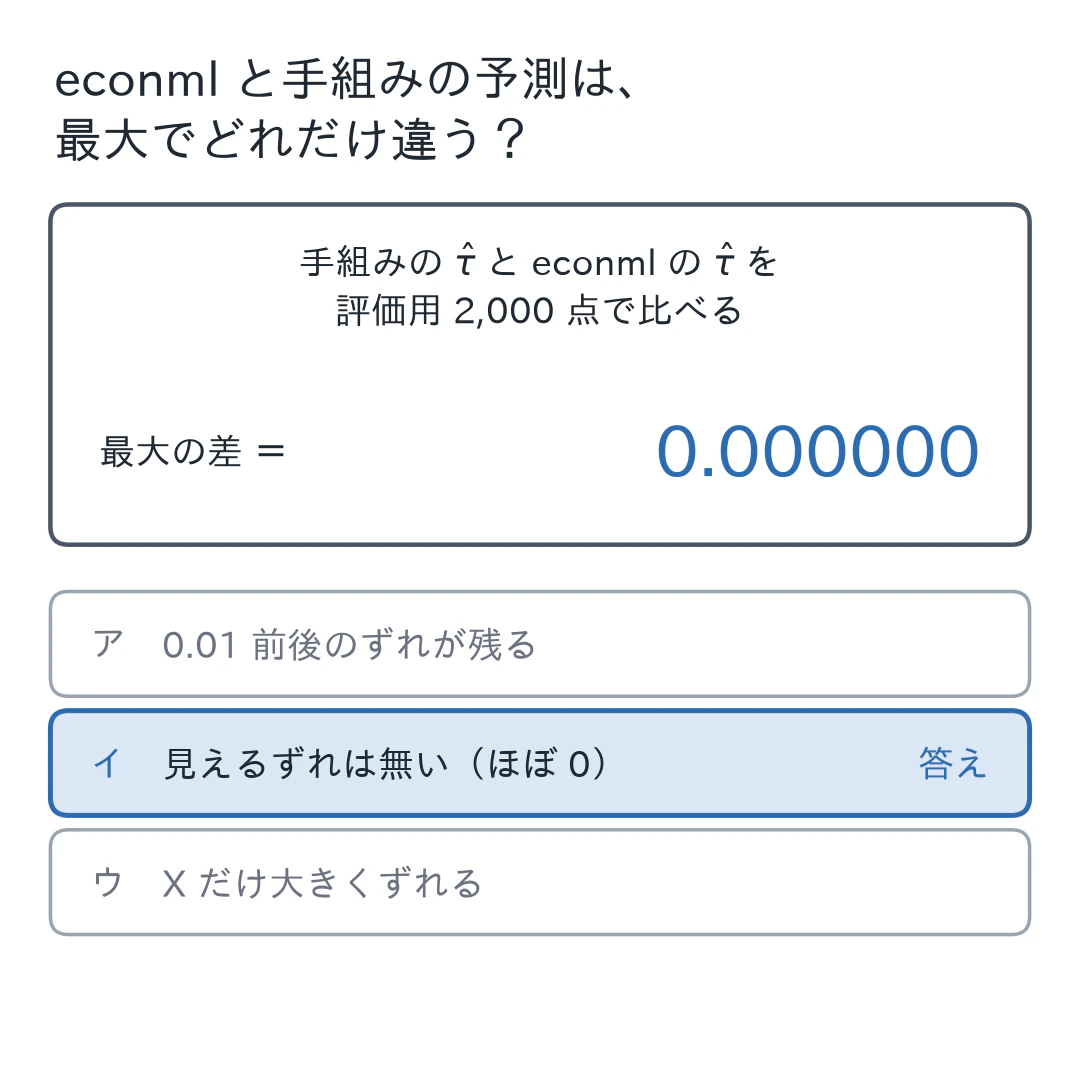
3つとも手組みとの最大差は小数第6位まで 0.000000、つまり econml は今日手組みした計算と同じものを実行しています。ライブラリはブラックボックスではなく、レシピの清書だと確認できました。今日の全結果を PEHE の1つの物差しに並べたのが下の図です。木20本の S-learner($\hat\tau$ が全点0)の 1.244 も同じ物差しに載せると、「正則化をどこに掛けるか」で結果がどれだけ動くかが一望できます。
ライブラリが清書するのは組み方までです。PEHE の採点に渡す真の効果 $\tau$ の列は、答えを握った合成データにしか無く、採点の解答用紙まではライブラリも持ってきてくれません。
成り立つ場合と成り立たない場合
| 割付を決める変数が $X$ に入っているか(非交絡性) | データに出るもの | 今日の数字の読み方 |
|---|---|---|
| 入っている(今日のデータ) | 素朴な差は 4.02 でも、割付を決める $x_2$ を $X$ に入れた予測の差で、交絡が調整される | 推定 ATE は S 1.02、T 1.07、X 1.12 で、真の ATE 1.00 の近くに来た |
| 入っていない(思考実験で、本記事では未実行) | $x_2$ を $X$ から外しても、処置確率とベースラインの両方を押し上げる構造は残る | 3 つともそろってずれるはずで、今日の数字はそのまま効果の推定とは読めない |
5. 判断の基準
メタラーナーで CATE を出してよいか、出すならどの learner を選び、何で採点するか。問いを 3 つに絞りました。上から順にたどり、最初に右へ出たところが、いまやることです。

- Q1 は仮定の話で、データからは検証できません。 メタラーナーは交絡を解決しません。土台は Day 6 の非交絡性のままで、割付を決める変数が $X$ に入っていなければ、S も T も X も同じようにバイアスされます(今日のデータなら、割付を決める $x_2$ を特徴量から外せば三者そろってズレるはずです。本記事ではこの確認は実行していません)。どの $x$ にも処置群と対照群の両方がいること(共通サポート。Day 6 のオーバーラップ)も、2 つの予測の差を取る前提です。機械学習を差し込んだからといって観察データが実験に化けるわけではない、という規律は Day 24 の Double ML でも繰り返します。
- Q2 はデータで確かめられる診断です。 群のサイズを数えるだけです。今日のように処置が少数派(939 人対 5,061 人)なら、T-learner は少ない側の 1 本が粗くなり、$\hat\tau$ の散らばりがノイズで膨らみます(0.98、真は 0.71)。この不均衡では X-learner から試すのが手筋で、$\tau$ を学ぶ第 2 段を浅くして、正則化を正しい場所に掛けます。
- Q3 もデータの側の問いですが、物差しを選び間違えやすい問いです。 PEHE は真の $\tau$ が要るので、実データでは計算できません。$Y$ の交差検証で代用しても $\tau$ を採点したことにはなりません(木20本の S-learner がすり抜けます)。今日のオラクル採点は「自分のパイプラインの癖を、答えを知っている環境で検査する」ための手段です。手元のデータを模した合成データに真の $\tau(x)$ を仕込んで先に検査し、実データでの代理評価は Day 26 の Qini 曲線、信頼区間の話は Day 25 で扱います。
注記 S-learner の「効果ゼロ」は正則化の産物かもしれませんが、裏を返すと、効果が本当に無い(または一様に小さい)場面では、ゼロに寄せる S-learner の癖はむしろ保守的で堅実に働きます。どのラーナーが勝つかは場面次第で、今日の「X が最良」も「背景は複雑、効果は単純、処置は少数派」という設定での結果です。
自分の仕事に当てるなら、次の問いから始められます。いま「誰に効くか」を出したい施策のデータで、割付を決める変数は特徴量に入っているでしょうか。処置群と対照群の人数は、どれくらい違うでしょうか。
6. 確認問題
問 1(自分の言葉で説明する) 効果のラベル $\tau_i$ はどの行にも無いのに、メタラーナーはどうやって効果を作り、その推定をどう採点するのでしょうか。本文を見ずに 2 文で説明してください。
答えと解説
模範解答: 効果は、観測済みの $Y$ を当てる予測モデルを組み合わせて作ります(S は 1 本に $W$ を混ぜ、T は 2 本、X は欠けた片方を予測で埋めた代理ラベルから効果を直接学びます)。採点の PEHE は真の $\tau$ が要るので、真の効果を仕込んだ合成データでしか計算できません。
次の 2 点のどちらかが抜けたら不十分です。
- 効果そのものを当てるのではなく、$Y$ の予測問題に分解して組むこと
- PEHE は真の $\tau$ を知る合成データでしか測れず、実データでは別の物差し(Day 26)が要ること
詰まったら 3.1 と 3.4 に戻ってください。
問 2(別の場面へ移す) あるウェブサービスで、クーポンを受け取った会員が 10,000 人中 500 人でした。割付を決める会員の属性は、特徴量にそろっています。「誰にクーポンが効くか」を人ごとに出すとき、最初に試すものとして最も適切なものはどれでしょうか。
ア クーポンを受けた 500 人だけで 1 本のモデルを学べば、人ごとの効果がそのまま出る イ T-learner が最も安全。群ごとに別のモデルを学ぶので、人数の差は影響しない ウ X-learner から試す。少ない 500 人側のモデルは粗くなるので、多い側の予測で欠けた片方を埋め、効果を直接学ぶ エ 全員の売上を 1 本のモデルで予測し、予測値の大きい人に効くと読む
答えと解説
ウ。処置を受けた人が少数派なので、T-learner では少ない側だけで学ぶ 1 本が粗くなり、その誤差が引き算に乗ります。X-learner は多い側の予測で欠けた片方を埋め、効果を直接学びます。ただし、どのラーナーが勝つかは場面次第で、今日の「X が最良」も設定の結果です。
- ア(予測問題への分解を忘れる読み違い): 受けた人だけでは、受けなかった場合の $Y$ が分からず、効果は出ません。
- イ(群ごとに分ければ安全と読む読み違い): 少ない側の 1 本の粗さが、そのまま効果に乗ります。
- エ($Y$ の予測を効果と読む読み違い): $Y$ が大きい人と、効果が大きい人は別です。
問 3(出力を読む) 4.1 で S-learner の木の本数を絞ったときの出力です。木 20 本の行の読み方として最も適切なものはどれでしょうか。
木 200 本: PEHE 0.329, 推定ATE 1.02, τ̂=0 の割合   0%
木  50 本: PEHE 0.941, 推定ATE 0.35, τ̂=0 の割合   0%
木  20 本: PEHE 1.244, 推定ATE 0.00, τ̂=0 の割合 100%
ア 容量を絞られたモデルが、小さな信号である $W$ の分岐を切り捨てた可能性があり、「効果が無い」とは言えない イ この処置には効果が無いことが分かった ウ $Y$ の予測器として壊れているので、この行は無視してよい エ 木を減らすほど過学習が減るので、20 本の答えがいちばん信頼できる
答えと解説
ア。$\hat\tau$ が 0 に張り付いたのは、$W$ の分岐が容量制限で削られた結果の可能性があります。今日のデータの真の ATE は 1.00 です。正則化の強さを振って $\hat\tau$ の動きを見るのが、このスイープの使い方です。
イ: 真の効果 $\tau(x)$ は 0.04 から 1.96 の範囲にあり、ゼロの人はいません。ウ: 訓練データへの決定係数は 0.76 あり、$Y$ の予測器としては壊れていません。だから $Y$ の精度だけ見ていると気づけないのです。エ: 木を減らすほど PEHE は 0.329、0.941、1.244 と悪化しています。
7. おわりに

CATE(条件付き平均処置効果)の教師ラベル $\tau_i$ は誰にも観測できないので(因果推論の根本問題の再来)、普通の教師あり回帰は組めません。予測モデルの組み合わせで $\hat\tau(x)$ を作るのがメタラーナーで、S・T・X の 3 つは sklearn だけで手組みできます。最後に確かめます。ラベルの無い効果を手持ちの予測モデルで推定する組み方と、その採点に PEHE が要る理由を、本文を見ずに 2 文で言えますか。詰まったら 3.1 と 3.4 に戻ってください。
8. 参考(本棚)
- Matheus Facure『Causal Inference in Python』第7章 Metalearners。S/T/X の構成と、正則化が効果推定を歪める実演。今日の下敷き
- Künzel, Sekhon, Bickel & Yu (2019). Metalearners for estimating heterogeneous treatment effects using machine learning. PNAS 116(10)。X-learner の原論文。「群サイズが不均衡で CATE が単純な場面に強い」という設計意図の出どころ
- Robert Osazuwa Ness『Causal AI』と econml ドキュメント(Metalearners)。メタラーナーの実装視点と API。今日の照合相手
- データ: 合成データ(シード23)。真の $\tau(x)$ を握って PEHE をオラクル採点するための設計で、生成式は本文のコードに全部書いてあります
この記事の位置づけ
因果推論を「本を読んだ」で終わらせず、自分の言葉で説明でき、コードで再現できる状態まで落とす 30 日連載の Day 23 です。
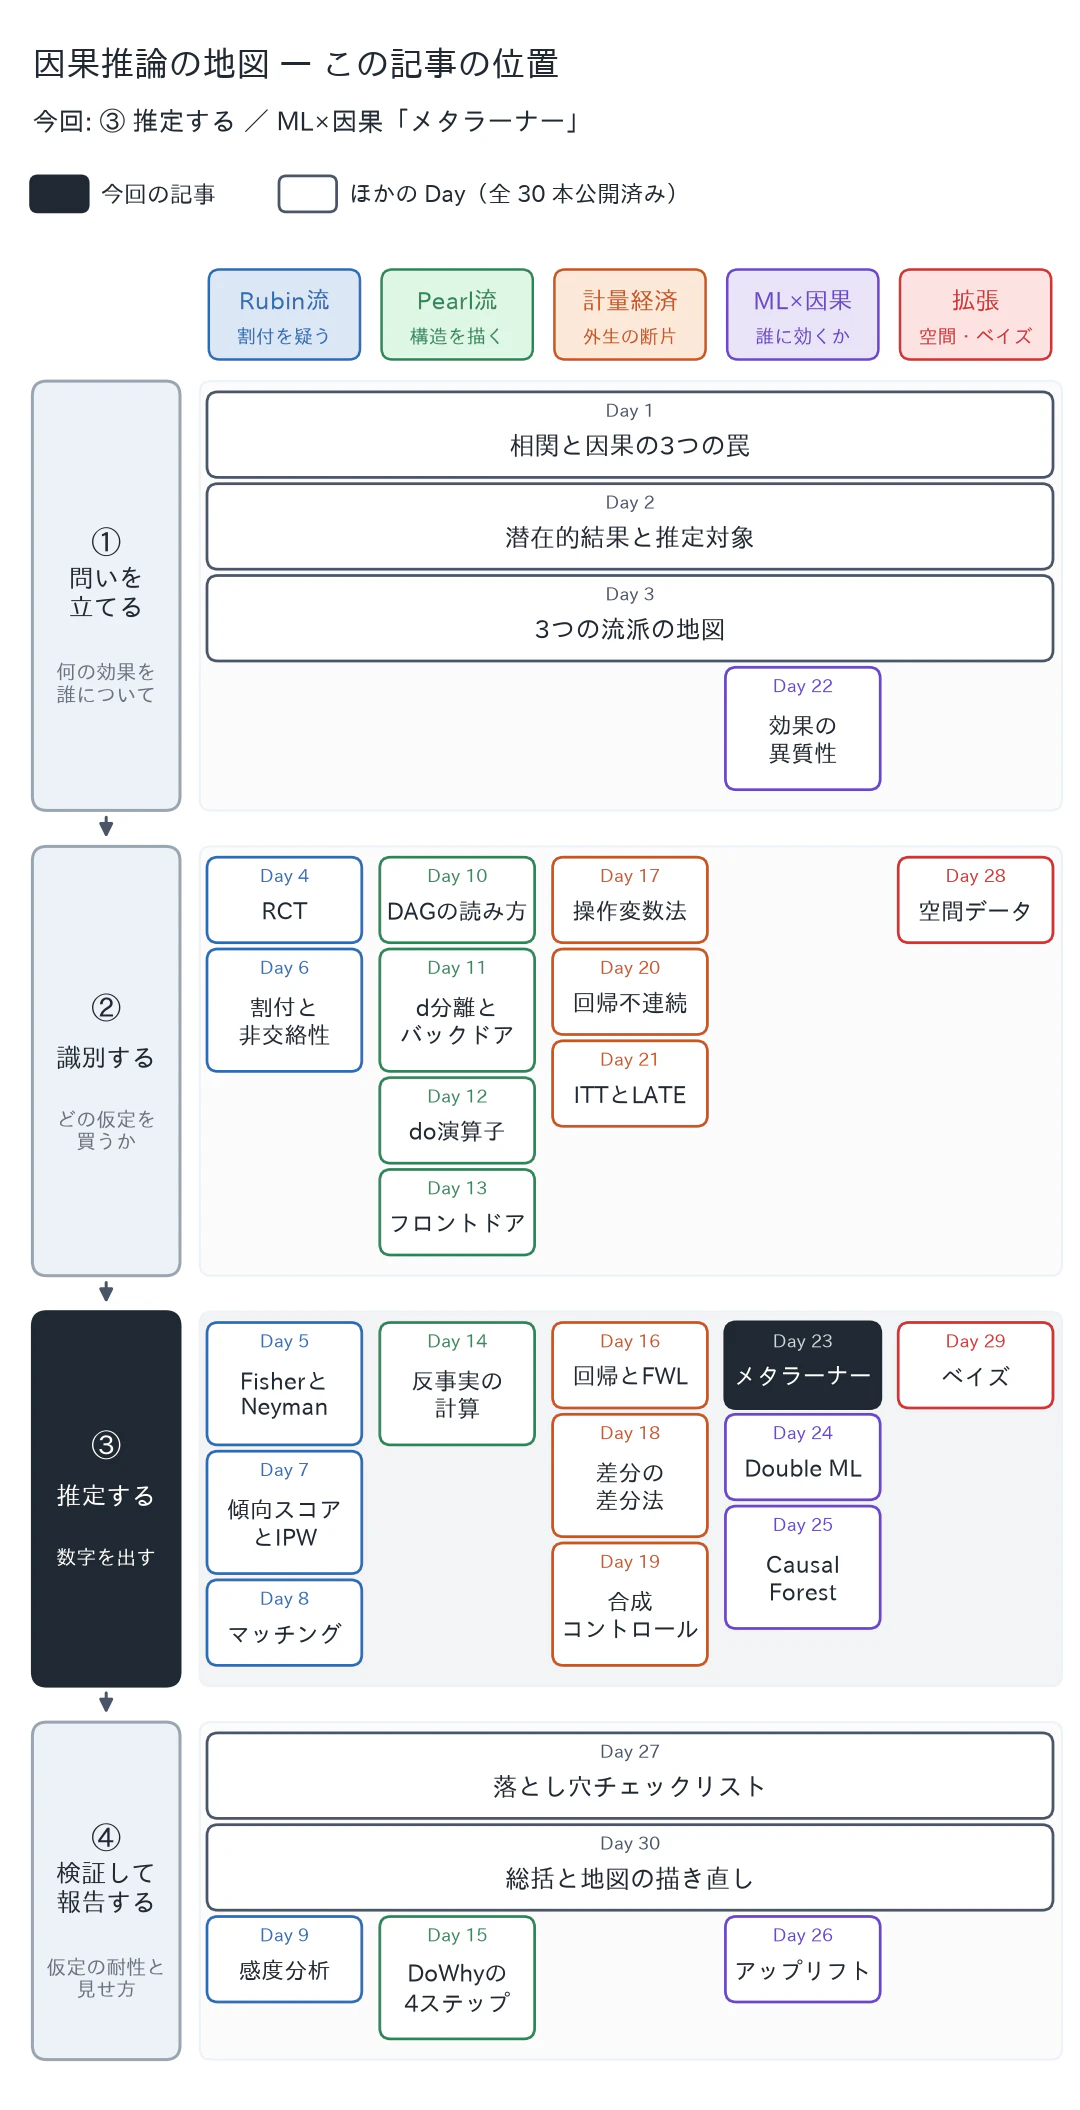
図は縦が分析の工程、横が流派です。この記事は「③ 推定する(数字を出す)」の、ML×因果(誰に効くか)の「メタラーナー」を扱います(図の黒い札)。前提になるのは Day 22(効果の異質性)・Day 16(回帰とFWL)。ここで覚える考え方や道具は Day 25(Causal Forest)・Day 26(アップリフト) で再登場します。
9. 次回予告(Day 24)
Day 24(Double ML)
今日は「誰に効くか」を機械学習で組みました。次回は問いをいったん平均に戻します。共変量が高次元でも、機械学習の当てはめ癖に推定を汚させずに ATE を厳密に出す Double Machine Learning(DML) です。今日 S-learner を潰した正則化バイアスが今度は主役として登場し、Day 16 で頭に焼き付けた FWL の残差化が機械学習版に進化します。残差×残差、交差適合、そして「ニュイサンス(推定の目的ではないが途中で必要になる量)を少し間違えても効かない」Neyman 直交性まで、いつもどおり手組みから積み上げます。聞き慣れない言葉が並びましたが、次回で1つずつほどきます。