
1.はじめに
GoとPythonをgRPCで繋いだGKE上のサイドカー構成のOCR基盤を構築しました。
本記事では、負荷試験ツール k6 を用い、「基本機能試験」、「限界負荷試験」、「スケーラブル機能試験」の検証を行います。
「k6の実行結果」、「Cloud Logging経由でBigQueryに格納したログ」をベースに、以下の4つの視点で解析します。
・スケーラビリティの証明
Pod増減に伴うスループット(TPS)の変化を定量的に測定。
・高負荷環境下での精度評価
テスト画像と期待値を照合し、リソース逼迫時でも演算精度が損なわれないかを検証。
・内部構造の解析
BigQueryに集約した構造化ログを用い、Go(受付) / Python(推論) 各レイヤーの滞在時間をミリ秒単位で分解・可視化。
・分散トレーシングの追跡
Correlation IDをキーに、リクエストから推論完了までの一連の流れを可視化。
本記事は、スケーラブルなOCR基盤を構築・検証した3部作の「検証編」です。
・詳細解説編
Go / Pythonの実装から、Terraform / Helmによるインフラ構築まで、各設定の詳細なソースコード解説。
・ポイント説明編
サイドカー構成、gRPC通信、構造化ログの伝播など、各技術を組み合わせた機能設計の要点解説。
・検証編
k6を用いた「限界負荷試験」、「スケーラブル機能試験」の検証を解説。
| ◆構成 |
|---|
| 1.はじめに |
| 2.技術スタックとシステム構成 |
| 3.検証環境と計測手法 |
| 4.検証結果1:基本性能 |
| 5.検証結果2:限界性能の特定 |
| 6.検証結果3:スケーラビリティの証明 |
| 7.アーキテクチャ検討の試行錯誤 |
| 8.まとめ |
2.技術スタックとシステム構成
本検証で使用した基盤の全体像です。
2-1. 技術スタック
検証の肝となる「負荷計測」と「ログ分析」のツールを中心に構成しています。
| カテゴリ | 技術・ツール | 用途 |
|---|---|---|
| 負荷試験 | k6 | 本物の画像データを用いたシナリオベースの負荷注入 |
| Frontend API | Go (Gin) | OCR結果と正解データの合否判定、構造化ログ出力 |
| Inference Engine | Python (EasyOCR) | CPU集約型処理(OCR推論)の実行 |
| Infrastructure | GKE/HPA | CPU負荷に応じたPod/ノードの動的スケーリング |
| Analytics | BigQuery | 蓄積された全ログに対するSQLを用いた性能・精度分析 |
2-2. 主要ライブラリ
特に注目すべき採用ライブラリは以下の通りです。
| 対象 | ライブラリ | 採用理由 |
|---|---|---|
| Go | Gin | 軽量かつ高速で、構造化ログとの相性が良いため。 |
| Go | gopsutil | Pod内のリソース使用率をログに含め、分析に活用するため。 |
| Python | EasyOCR | PyTorchベースで精度が高く、日本語・英語に標準対応しているため。 |
| Python | psutil | 推論時のCPU負荷を正確に計測し、ログ出力するため。 |
| Common | gRPC | HTTP/1.1よりも低遅延で、双方向通信やストリーミングにも対応可能なため。 |
2-3. ディレクトリ構成
インフラ管理(Terraform)コマンドで、デプロイできる以下の構成となっています。
このデータセットは、GitHubレポジトリ登録しています。
.
├── terraform/          # GKE, VPC, Artifact Registry, Log Sinkの定義
├── chart/              # Kubernetesデプロイ用リソース (Helm Chart形式)
│   └── templates/      # Deployment, Service, HPA, RBACのマニフェスト
├── go-api/             # フロントエンドAPI (Go / Gin)
├── python-api/         # 推論エンジン (Python / EasyOCR / gRPC Server)
├── pb/                 # gRPC定義ファイル (.proto) と自動生成コード
└── k6/                 # 負荷試験スクリプト
    └── test_images/    # 検証用画像および正解データ(mapping.json)
2-3. システム構成
3.検証環境と計測手法
本システムの実効性を証明するため、負荷試験ツール k6 を活用し、「システムパフォーマンス」と「推論精度」の両面から徹底的な検証を行いました。
3-1. テストフェーズと手順
段階的に負荷を引き上げ、リソースの飽和(エルボーポイント)とスケーラビリティを確認します。
・Phase 1:ベースライン測定(VU: 1)
インフラへの負荷が最小の状態で、1枚あたりの「理論上の最大性能」を測定。
・Phase 2:垂直限界の特定(VUs: 3 ~ 5)
1 Pod構成のまま同時接続数を増やし、待ち行列が発生し始める「限界点」を観測。
・Phase 3:水平スケーリング検証(VUs: 5 ~ 30)
Pod数を拡張(3 Pods / 5 Pods)し、インフラ増強によるスループットの線形向上を確認。
・負荷シナリオ:
100枚のテスト画像をループで送信し、各フェーズ10分間の安定負荷を注入。一時的なスパイクではなく、継続的な負荷に対する安定性を評価します。
k6 で実行する`JavaScript`(./k6/script.js)
import http from 'k6/http';
import { check, sleep } from 'k6';
//import { uuidv4 } from 'https://jslib.k6.io/k6-utils/1.4.0/index.js';
import { uuidv4 } from './k6-utils.js';


// 1. Pythonが作った正解リスト(JSON)を読み込む
const mapping = JSON.parse(open('./test_images/mapping.json'));
const imageFiles = [];

// 2. 100枚の画像をメモリに読み込む
for (let i = 1; i <= 100; i++) {
  const filename = `${String(i).padStart(3, '0')}.png`;

  imageFiles.push({
    name: filename,
    expected: mapping[filename], // JSONから正解を取得
    bin: open(`./test_images/${filename}`, 'b')
  });
}


export default function () {
  const url = 'http://35.221.115.130:8080/predict';

  // ★ 4. 順番に1枚選ぶ (0, 1, 2... 99, 0, 1...)
  // execution.instance.iterationInTest を使う方法もありますが、簡易的には __ITER を使用します
  const index = __ITER % imageFiles.length;
  const targetImage = imageFiles[index];

  const data = {
    image: http.file(targetImage.bin, targetImage.name, 'image/png'),
  };

  const k6SendTime = Date.now();

  const params = {
    headers: {
      'X-Correlation-ID': uuidv4(),
      'X-Expected-Text': targetImage.expected,
      'X-K6-Send-Time': k6SendTime.toString(),
      'X-Image-Index': index.toString(), // デバッグ用に何番目か送るのもアリ
    },
  };

  const res = http.post(url, data, params);

  // (以下、check処理はそのまま)
  check(res, {
    'Status is 200': (r) => r.status === 200,
    'OCR Content Match': (r) => {
      try {
        const body = r.json();
        const match = body.result.includes(targetImage.expected);
        // ★ 失敗した時にログを出すと特定が捗ります
        if (!match) {
           console.log(`Failed! Index: ${index}, File: ${targetImage.name}, Expected: ${targetImage.expected}, Got: ${body.result}`);
        }
        return match;
      } catch (e) {
        return false;
      }
    },
  });

  sleep(1); // 待機時間
//  sleep(2); // 待機時間
}
3-2. 精度検証の自動化
単なる疎通確認ではなく、「推論結果が正しいか」をリアルタイムに評価 する仕組みを構築しました。
・正解データの準備: 100枚の画像と対応する正解テキストを mapping.json で定義。
画像を作成したpythonスクリプト(./k6/gen_image.py)
import os
import json
from PIL import Image, ImageDraw, ImageFont

# フォルダ作成
os.makedirs("./test_images", exist_ok=True)

# 100個の重複のない厳選英単語(3〜6文字)
words = [
    "apple", "bird", "cat", "dog", "fish", "frog", "jump", "blue",
    "green", "book", "desk", "milk", "moon", "star", "tree", "rose",
    "lion", "bear", "duck", "king", "queen", "lamp", "fire", "ice",
    "snow", "rain", "wind", "ship", "boat", "car", "bus", "train",
    "gold", "iron", "wood", "road", "path", "city", "town", "home",
    "door", "wall", "room", "roof", "desk", "pen", "cup", "bowl",
    "rice", "corn", "bean", "soup", "meat", "pork", "beef", "salt",
    "leaf", "root", "stem", "seed", "lily", "pink", "red", "dark",
    "sky", "star", "sun", "cloud", "gray", "gold", "bear", "wolf",
    "deer", "fox", "owl", "hawk", "swan", "lake", "river", "sea",
    "sand", "rock", "clay", "dirt", "hill", "farm", "park", "yard",
    "shoe", "hat", "coat", "bag", "ball", "silver", "bell", "coin",
    "hand", "foot", "eye", "ear", "nose", "face", "hair", "skin"
]

# 単語数が足りない場合の保険(ユニークな100個を確実に取得)
words = list(set(words))[:100]

mapping = {}

# Windows標準のArialフォント(特大サイズ40)
try:
    font = ImageFont.truetype("arial.ttf", 40)
except IOError:
    font = ImageFont.load_default()

# 100枚生成
for i, target_text in enumerate(words, start=1):
    filename = f"{i:03d}.png"
    mapping[filename] = target_text

    # 黒背景の画像を作成 (横250px, 縦100px)
    img = Image.new('RGB', (250, 100), color='black')
    draw = ImageDraw.Draw(img)

    # 白文字でハッキリと描画
    draw.text((30, 25), target_text, fill='white', font=font)

    img.save(f"./test_images/{filename}")

# 正解リストをJSONで保存
with open('./test_images/mapping.json', 'w') as f:
    json.dump(mapping, f)

print(f"100枚の重複のない画像生成が完了しました。 (単語数: {len(words)})")
・期待値の注入: k6はリクエスト送信時、カスタムヘッダー X-Expected-Text に正解文字列をセット。
・判定の自動化: Go API側で「推論結果」と「ヘッダー内の正解」を比較し、その合否を構造化ログ として出力。
これにより、k6のレポート上で 「スループットが上がった瞬間に、計算リソース不足で推論が適当(またはエラー)になっていないか」 を即座に判定可能にしました。
| Step | 処理 |
|---|---|
| 1 | Python(EasyOCR)から返ってきた推論結果を受け取る |
| 2 | リクエストヘッダーに含まれる「正解文字列」と比較 |
| 3 | 判定(IsMatch)、処理時間、Correlation IDと共にログ出力 |
3-3. 計測指標 (Metrics) と分析基盤
収集したデータは Cloud Logging 経由で BigQuery へ集約し、以下の多角的な指標でシステムを評価します。
① クライアント指標(k6 Metrics)
k6の check 機能を使い、クライアントサイドから見た健全性を測定します。
| 項目 | 内容 |
|---|---|
| Status is 200 | 通信が正常終了したか(HTTP 200) |
| Has Result Field | レスポンスJSONが定義通りの構造か |
| OCR Content Match | OCR結果が正解データと一致しているか(精度) |
② バックエンド指標(BigQuery分析)
Cloud Logging経由で集約されたデータをSQLで解析し、ボトルのネックを特定します。
| 分析項目 | 目的 |
|---|---|
| Latency (ms) | Go/Pythonそれぞれの滞在時間をミリ秒単位で測定 |
| Accuracy (IsMatch) | OCR正解率のモニタリング |
| Resource Efficiency | 1コア制限下での Python Pod の CPU 使用効率 |
| Traffic Distribution | Pod名ごとの処理数による、GKE負荷分散の偏り確認 |
4.検証結果1:基本性能
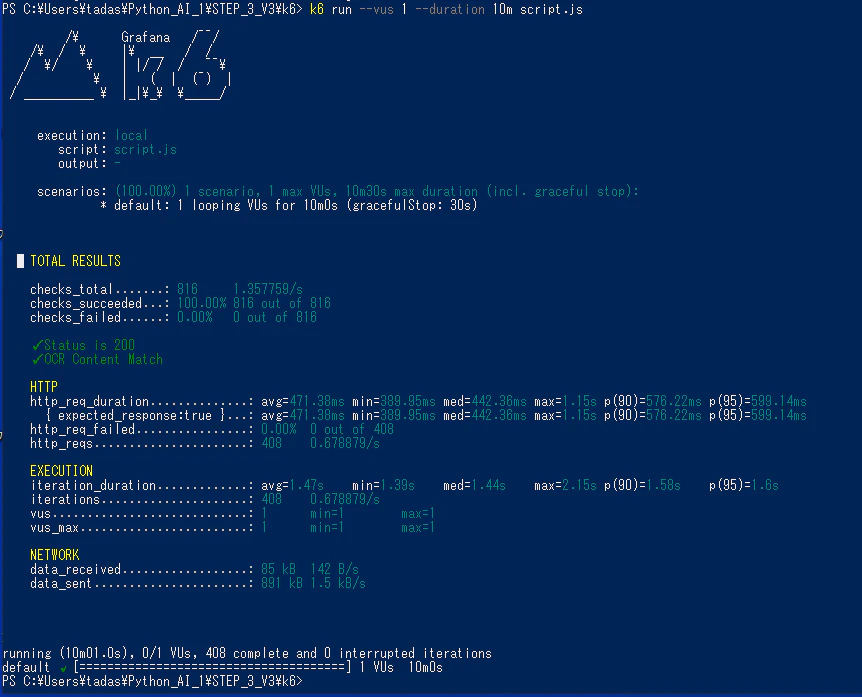
まずは、インフラへの負荷が最小の状態(同時接続数1)で、1 Podあたりの「理論上の最大性能」を測定しました。これが本システムのパフォーマンスの基準値(ベースライン)となります。
4-1.実行内容
1 Pod に対して k6 を使用し、連続的なリクエストによる挙動を観測します。単発のテストではなく10分間継続することで、リソースリークの有無や処理の安定性を確認します。
・実行コマンド: k6 run --vus 1 --duration 10m script.js
| 項目 | 内容 |
|---|---|
| POD数 | 1個 (Go & Python サイドカー構成) |
| 負荷 (VUs) | 1vus(同時接続数1) |
| 実行時間 | 10分間 |
| テストデータ | 100枚のテスト画像をループで送信 |
4-2.実行結果(クライアント側:k6)
テスト実行後の k6 最終メトリクスは以下の通りとなりました。
| 指標 | 測定値 | 考察 |
|---|---|---|
| スループット | 0.68req/s | 1秒間に0.68回、つまり1分間で約41リクエストを完結 |
| 平均応答時間(avg) | 451.86ms | インターネット経由の全工程を含め、0.5秒を切る軽快な応答 |
| 95% 応答時間(p95) | 552.43ms | 文字量の多い「重い画像」でも、1秒未満で処理が完了 |
| 成功率(Checks) | 100% | 413リクエスト全件で、精度・形式ともに正常に応答 |
k6実行結果
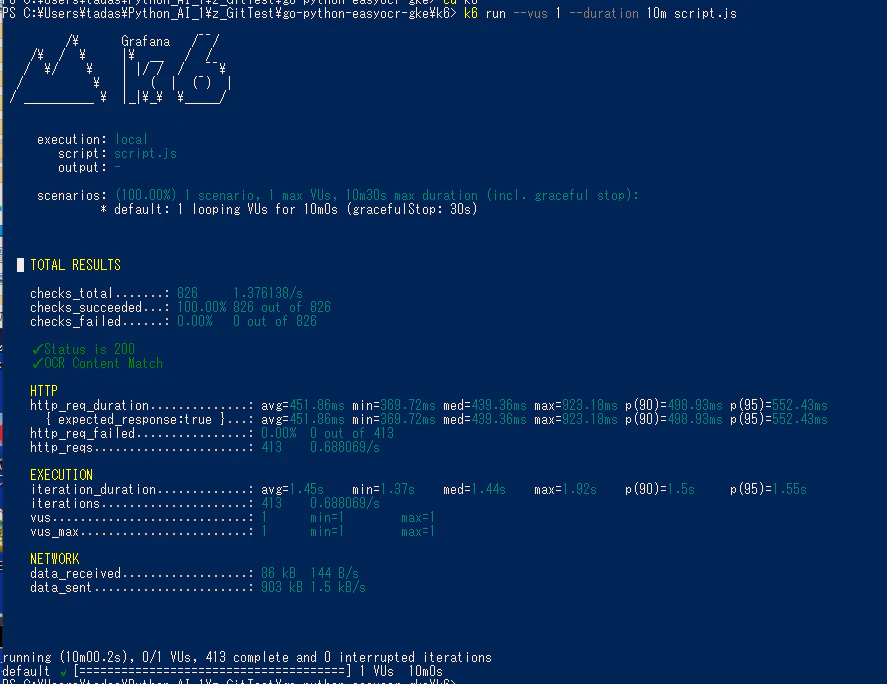
計算の整合性
k6の結果(0.68 req/s)を1分あたりに換算すると 0.68 * 60 = 40.8件 となります。これは、BigQueryのログから算出した request_count(40〜42件/分)と完璧に一致しており、測定データの正当性が裏付けられました。
4-3.実行結果(BigQuery分析)
Cloud Logging経由でBigQueryに蓄積された構造化ログを分析し、GoレイヤーとPythonレイヤーそれぞれの処理時間を可視化しました。
以下で提示するSQLのyour-project-idには、ご自身の環境に沿ったIDを設定して下さい。
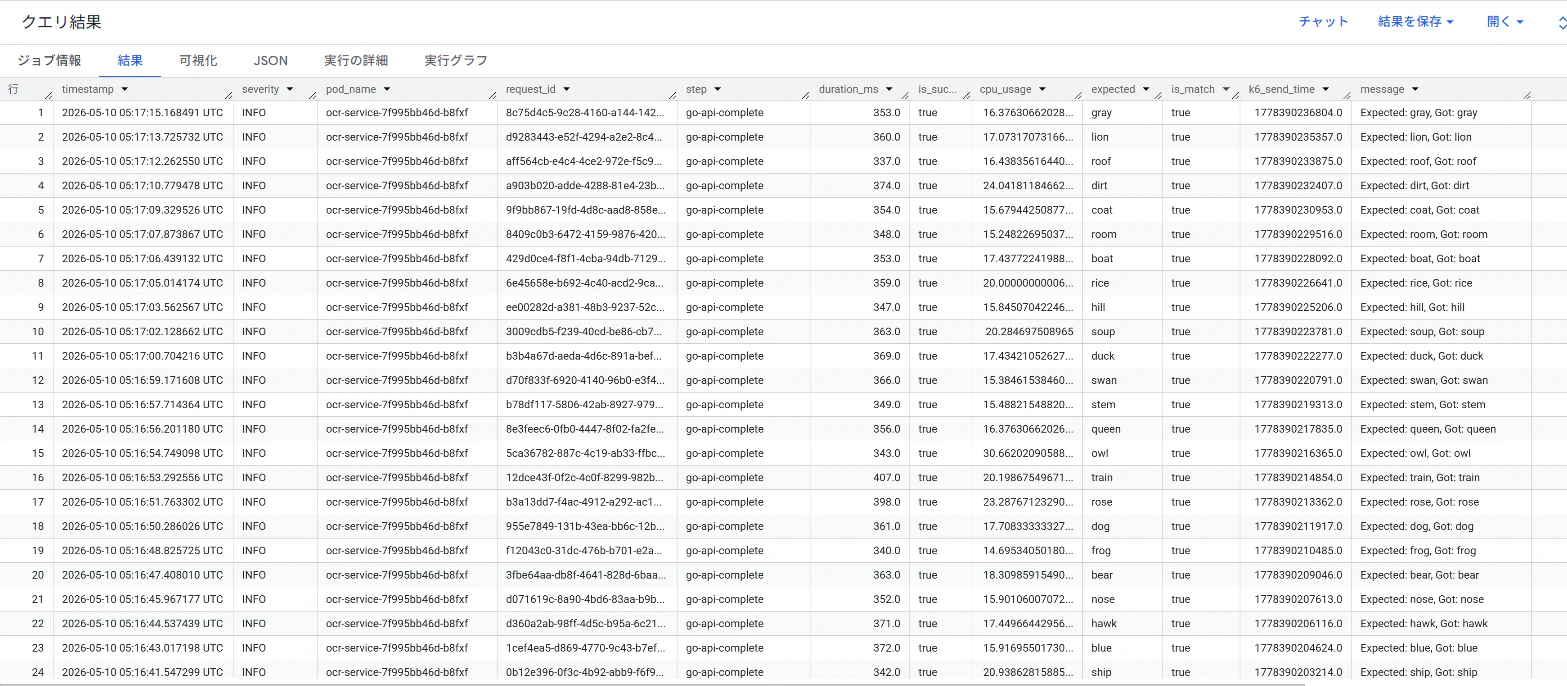
①BigQuery格納データ
BigQuery格納データは、SQLで取得すると以下の様な形式となるので、これを元に解析します。
取得画像とSQL
BigQuery格納データ(抜粋)
SELECT
  timestamp,
  severity,
  jsonPayload.pod_name,
  jsonPayload.request_id,
  jsonPayload.step,
  jsonPayload.duration_ms,
  jsonPayload.is_success,
  jsonPayload.cpu_usage,
  jsonPayload.expected,
  jsonPayload.is_match,
  jsonPayload.k6_send_time,
  jsonPayload.message
FROM
  `<your-project-id>.log_dataset.stdout_*`
WHERE
  jsonPayload.step = 'python-ocr-inference'
ORDER BY
  timestamp DESC
LIMIT 100
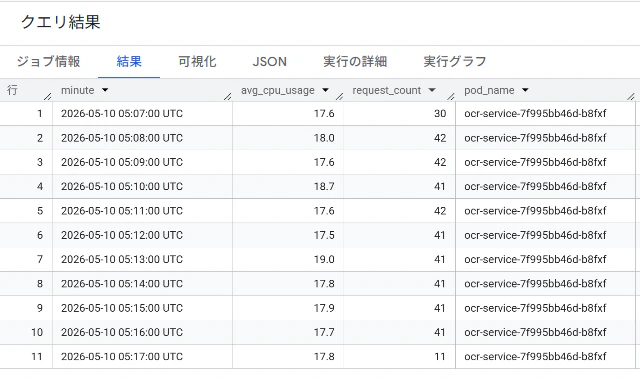
②CPU負荷率の推移(Go,Python)
1分あたりのリクエスト数(約40件)に対し、CPU負荷が一定の範囲で安定して推移しています。
■Go-API : CPU使用率=17%~19%
■Python-API : CPU使用率=54%~56%
取得画像とSQL
■Go-API
■Python-API
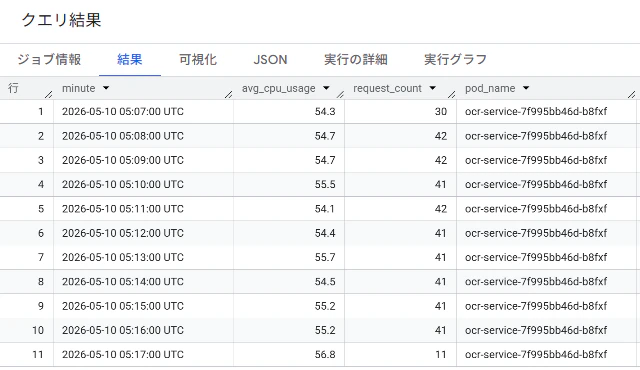
jsonPayload.stepにて、go-api , python-apiを切替え
SELECT
  TIMESTAMP_TRUNC(timestamp, MINUTE) AS minute,
  ROUND(AVG(CAST(jsonPayload.cpu_usage AS FLOAT64)), 1) AS avg_cpu_usage,
  COUNT(*) AS request_count,
  jsonPayload.pod_name
FROM
  `<your-project-id>.log_dataset.stdout_*`
WHERE
  jsonPayload.step = 'go-api-complete'
  AND timestamp >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 1 HOUR)
GROUP BY
  minute,
  jsonPayload.pod_name
ORDER BY
  minute ASC,
  jsonPayload.pod_name
③処理時間の測定(ミリ秒)
| 指標 | Python推論(A) | Go全体(B) | 通信・その他(B-A) |
|---|---|---|---|
| 平均 (avg) | 354.5 ms | 364.9 ms | 10.4 ms |
| 最小 (min) | 325.0 ms | 328.0 ms | 3.0 msv |
| 最大 (max) | 761.0 ms | 779.0 ms | 18.0 ms |
取得画像とSQL
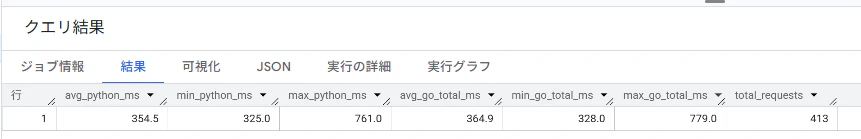
WITH request_metrics AS (
  -- まずリクエストごとにGoとPythonの時間を紐付け
  SELECT
    jsonPayload.request_id,
    MAX(IF(jsonPayload.step = 'python-ocr-inference', jsonPayload.duration_ms, 0)) AS python_ms,
    MAX(IF(jsonPayload.step = 'go-api-complete', jsonPayload.duration_ms, 0)) AS go_total_ms
  FROM
    `<your-project-id>.log_dataset.stdout_*`
  WHERE
    jsonPayload.request_id IS NOT NULL
  GROUP BY
    1
  HAVING
    python_ms > 0 AND go_total_ms > 0
)
SELECT
  -- Python(OCR処理)の統計:ROUNDで小数点第1位までに
  ROUND(AVG(python_ms), 1) AS avg_python_ms,
  MIN(python_ms) AS min_python_ms,
  MAX(python_ms) AS max_python_ms,

  -- Go全体(クライアント体感)の統計:ROUNDで小数点第1位までに
  ROUND(AVG(go_total_ms), 1) AS avg_go_total_ms,
  MIN(go_total_ms) AS min_go_total_ms,
  MAX(go_total_ms) AS max_go_total_ms,

  -- サンプル数(リクエスト総数)
  COUNT(*) AS total_requests
FROM
  request_metrics
4-4.結果分析
1.推論処理が全体の95%以上を占有
全工程(約364ms)のうち、PythonによるOCR推論が約345msを占めています。
Python(EasyOCR)の計算リソースに依存していること が明確になりました。
2.サイドカー構成による低遅延通信の実証:
Go-Python間の差分(平均10.4ms)には、gRPC通信・画像のシリアライズ・ロギング処理が含まれておりlocalhost通信によるマイクロサービス間のオーバーヘッドを抑制しています。
3.ネットワーク・インフラコストの可視化:
k6側の平均(451ms)とGo内部の平均(364ms)の差分、約87ms が「クライアント 〜 GCP Ingress 〜 Pod」間の往復ネットワーク遅延(RTT)であると推測できます。
5.検証結果2:限界性能の特定
垂直負荷を、3VUs,5VUsと段階的に引き上げ、1Pod構成の限界値の見極めます。
5-1.負荷の引き上げ(1 Pod / 3 VUs)
同時接続数(VU)をベースラインの3倍となる「3」に引き上げました。
リソースをどこまで効率的に使い切れるか、その限界を探ります。
①実行結果
平均応答時間は基本性能とほぼ変わらない数値(約465ms)を維持しており、この負荷レベルではまだサーバー内での待ち行列(Queue)が発生していないことがわかります。
▲「k6」出力結果の比較
| 指標 | 1 VU (基準値) | 3 VUs(今回) | 変化 |
|---|---|---|---|
| スループット | 0.68req/s | 2.04 req/s | 3.0倍(理論値通り!) |
| 平均応答時間(avg) | 451.86ms | 465.77ms | ほぼ変化なし(優秀) |
| 95% 応答時間(p95) | 552.43ms | 589.08ms | ほぼ変化なし(優秀) |
| 成功率(Checks) | 100% | 100% | 完璧に維持 |
k6実行結果

CPU負荷率と処理数の推移(Go-API)
■Go-API : CPU使用率=44%~47%(平均)

内部レイテンシ測定

②結果分析
・CPU負荷率(Go-API):
平均 約45% 〜 47% 程度。1 VU時の約20%から、リクエスト数に比例して上昇。
・内部レイテンシ:
Python側の推論時間(avg_python_ms: 376ms)は1 VU時と変わらず、並列処理によるパフォーマンス低下も見られません。
・「限界の足音」
最大応答時間は、1,162ms と、ついに1秒の壁を突破。平均は安定していても、瞬間的にリソースが飽和し、リクエストがわずかに滞留し始めている様です。
5-2.限界点の到達(1 Pod / 5 VUs)
同時接続数を「5」まで引き上げたところ、ついにシステムが飽和状態に陥りました。
①実行結果
BigQueryのログ分析では、リソース枯渇が処理時間に与える大きな影響を与えていました。
▲「BigQuery」格納結果の比較
| 指標 | Python推論(A) | Go全体(B) | 差分(B-A:待ち行列) |
|---|---|---|---|
| 平均(ave) | 815.6 ms | 1,171.6 ms | 356.0 ms |
| 最小(min) | 346.0 ms | 434.0 ms | 88.0 ms |
| 最大(max) | 1,939.0 ms | 3,448.0 ms | 1,509.0 ms |
k6実行結果
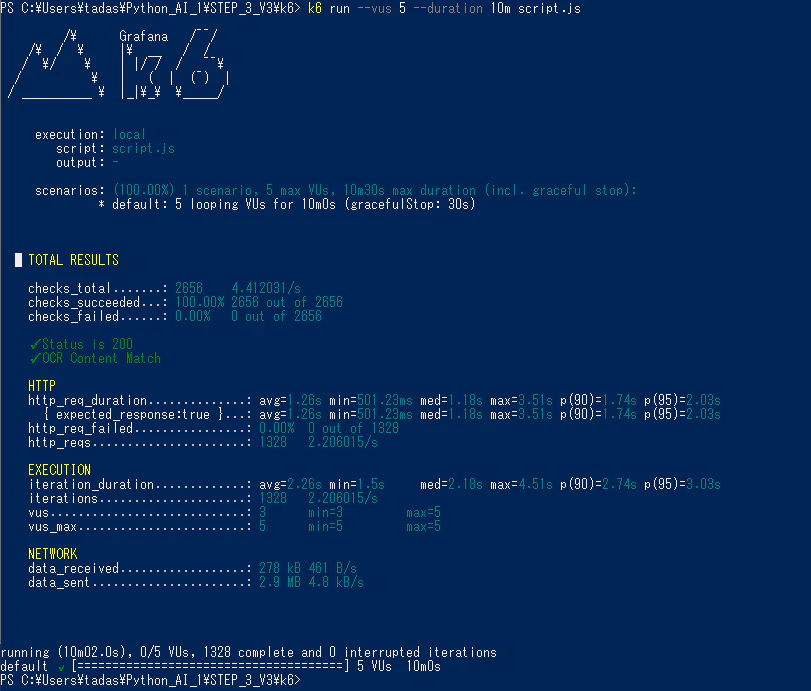
CPU負荷率と処理数の推移(Go-API)
■Go-API : CPU使用率=88%~95%

内部レイテンシ測定

②結果分析
・限界値(最大3.4秒)
Go-API,Python-APIでの処理時間は、基本性から大きく膨らんで、ほぼ限界と思われる数値(MAX=3.4秒)にまで達しました。ここが1つのPodに負荷を集中させる「垂直スケール」の限界と判断で出来そうです。
・水平スケーリングの必要性
1 Pod構成では、システムが機能不全に陥ることが確認されました。
この「渋滞」を解消すべく、水平スケーリング(Podの増設) による機能回復を検証します。
6.検証結果3:スケーラビリティの証明
1 Pod構成での限界を受け、3 Pods, 5 Pods と水平スケーリングさせて、問題現象への対応を実施します。
6-1.リソース拡張(3 Pods / 5 VUs)
Helmチャートの replicaCount を 3 に変更し、インフラを水平スケーリングさせた状態で再度 5 VUs の負荷を投入しました。
①実行結果
1 Pod時には1.2秒を超えていたレスポンスタイムが、ベースライン(1 VU時)と同等の水準まで回復しました。
▲「k6」出力結果の比較
| 指標 | 1Pod(限界時) | 3Pods(今回) | 改善率 |
|---|---|---|---|
| 平均応答時間(avg) | 1,260 ms | 455.94 ms | 約64% 改善 |
| 95% 応答時間(p95) | 2,030 ms | 554.42 ms | 約72% 改善 |
| 成功率(Checks) | 100% | 100% | 維持 |
k6実行結果

各PODに対する測定
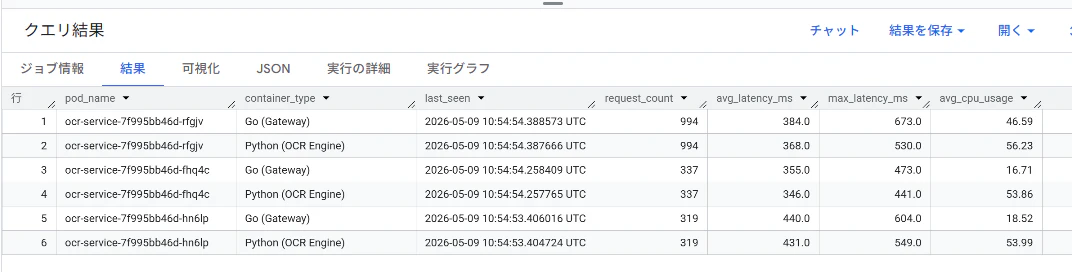
②結果分析
構造化ログを分析したところ、3つのPodが同時に稼働し、リクエストを分散処理している様子が明確に確認できました。
・負荷の均等分散(Load Balancing)
各Podのリクエスト処理数にばらつきはあるが、分散されており「「負荷の均等分散」が機能しています。
・「待ち行列」の解消:
Go全体(Gateway)とPython推論のレイテンシ差分が再び最小化されました。これは、背後の推論エンジンに十分な空きがあるため、API受付け直後に即座に処理が開始されていることを意味します。
6-2.余裕の確保(5 Pods / 5 VUs)
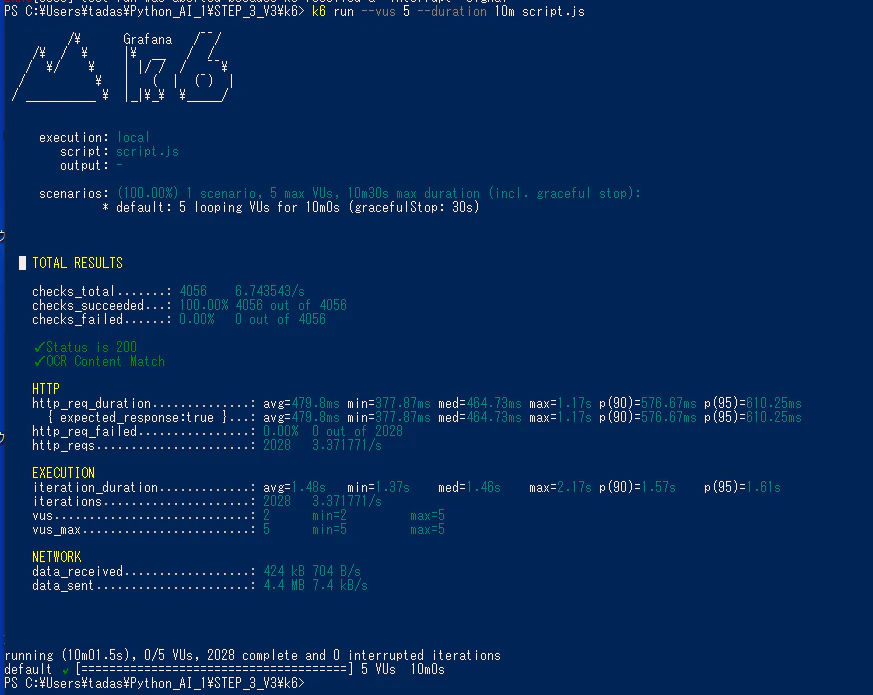
Podを5つに増やした状態で 5 VUs(同時接続数5)の負荷を投入して、スケーラビリティによる余裕度の増加がみられるかを検証します。
①実行結果
結果としては、3Podsとほぼ変わらない上に「5番目のPodにはリクエストが割り振られない」で、4Podsしか稼働しない現象が発生しました。
▲「k6」出力結果の比較
| 指標 | 1Pod(限界時) | 3Pods | 5Pods(今回) |
|---|---|---|---|
| 平均応答時間(avg) | 1,260 ms | 455.94 ms | 479.80 ms |
| 95% 応答時間(p95) | 2,030 ms | 554.42 ms | 610.25 ms |
| 成功率(Checks) | 100% | 100% | 100% |
k6実行結果
各PODに対する測定

②結果分析
これは故障や設計不良ではなく、低負荷時(5 VUs)におけるgRPC(HTTP/2)のロングコネクション特性 の影響と判断しました。
・gRPC(HTTP/2)のロングコネクション特性とは
接続数(VUs)がPod数と同程度の場合、クライアント(k6)と特定のPodとの間でコネクションが維持(スティック)され続け、後から起動した新規Podへリクエストが伝播しにくい現象。
③想定の実証確認
「負荷が低いために5つ目のPodが遊んでいる」という想定の下、同時接続数を一気に 30 VUs まで引き上げれば解消されるという狙いをもって再試験を実施しました。
・実行結果
BigQueryのログにて、5つすべてのPod名に対して request_count が記録され、基盤機能としては、5Pod同時に並列で稼働できる事は確認できました。
k6実行結果

各PODに対する測定

7.アーキテクチャ検討の試行錯誤
今回の検証では、サイドカー構成かつ静的なPod数指定を採用しました。ここでは、その選定に至るまでの試行錯誤を説明します。
7-1.サイドカー構成の選択理由
当初は、リソース効率の観点からGo(API)とPython(推論)を個別のサービスとしてデプロイする 独立サービス(Microservices)構成 も検討しました。
しかし、以下の理由から最終的に同一Pod内のサイドカー構成を選択しました。
・通信の安定を優先
独立構成では、Go-Python間のgRPC通信において稀に発生する大幅な遅延(テールレイテンシ)の原因が「ネットワーク経路」なのか「gRPCの再送制御」なのかの切り分けが困難で解決できませんでした。
7-2.負荷分散の壁:gRPC「接続の持続性」問題
検証過程では、サイドカー構成のままHPAによるオートスケーリングにも挑戦しました。
しかし、ここでgRPC特有の「スティッキネス(接続の持続性)」という課題に直面しました。
・観測された現象
負荷に応じてPodは正常に増殖(Scale-out)するものの、既存のGo-APIが最初に確立したPythonとのコネクションを保持し続けてしまい、後から起動したPodへリクエストが分散されない。
・技術的背景(L4負荷分散の限界)
gRPCはHTTP/2をベースにしており、効率化のためにコネクションを長時間維持します。一般的なL4ロードバランサーでは、一度繋がった「土管」を切り替えることが難しいため、特定のPodに負荷が偏る現象が発生しました。
8.まとめ
スケーラブルなOCR基盤の構築において、「スケーラビリティの証明」 や 「高負荷環境下での精度評価」 を、「構造化ログ(BigQuery)による解析」 を用いて定量的に測定する手法は、非常に学びが多いものでした。
最終的にほぼ想定通りの結果を得られたことは、基盤の実装方法や測定環境の構築が適正であったことの証左となり、非常に有意義な取り組みとなりました。
本記事は、スケーラブルなOCR基盤を構築・検証した3部作の「検証編」です。
・詳細解説編
Go / Pythonの実装から、Terraform / Helmによるインフラ構築まで、各設定の詳細なソースコード解説。
・ポイント説明編
サイドカー構成、gRPC通信、構造化ログの伝播など、各技術を組み合わせた機能設計の要点解説。
・検証編
k6を用いた「限界負荷試験」、「スケーラブル機能試験」の検証を解説。