


Loop Engineering やってますか?
自分は最近は 「GitHub Project 上のタスクを勝手にエージェントが進めてくれる Loop Engineering 環境」を整えていて、これのおかげでプロンプト投げから解放されてきています。
タスクを AI 用の GitHub Project で管理し、特定のカラムで自動で AI が処理してくれるようにしました。

今回のワークフローを実現するツールは OSS として公開していますが、Symphony を利用することで似たような自分だけのツールを作成することが可能です。
どういうことをやっているか
今回自分が作ったものは、OpenAI が開発した、Issue Tracker と連動するオーケストレーションツールである Symphony をベースにしています。
Symphony 自体はシンプルな実装で改造が容易です (というより改造前提のリファレンス実装として公開されています。)
自分はこれを改造し、GitHub Project の各カラム毎に、あらかじめ用意したプロンプトを自動で投げ、エージェントに処理させる仕組みを用意しました。
このツールを使って、以下のワークフローを組んでいます。
タスクの実装 Loop
メインとなるループがこれです。
進めたいタスクを Implement に移動するとエージェントを自動が起動し、「Issue の実装を行う」「PR で修正すべき点を直す」というプロンプトが自動で入力されます。
それが完了したタイミングで Verify に移動し、また自動で「CI のチェックや AI レビューを行う」「結果次第で Implement に戻すか、In Review に進める」という指示を渡します。
この Implement → Verify → Implement → ... というループを通るまで繰り返します。最後に人間がレビューを行い、OK なら merge、 NG ならコメントして Implement に戻します。
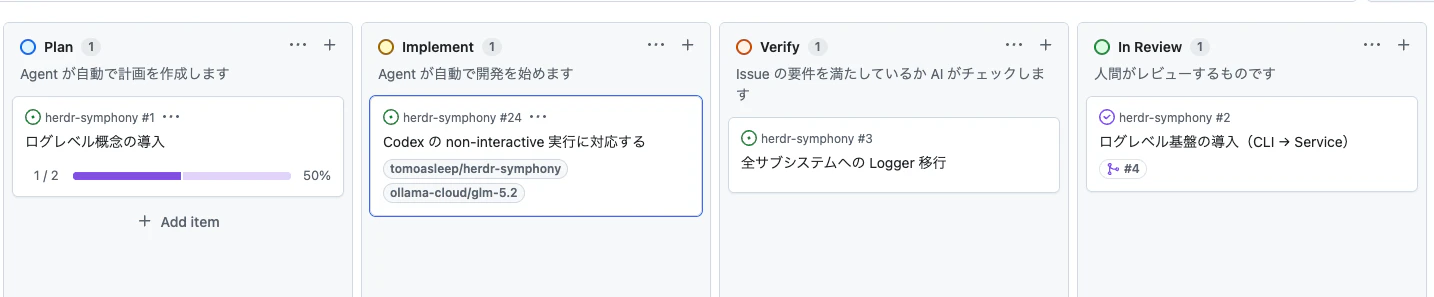
こうした作業を GitHub Project で管理することで、自分がどれを見るべきかわかりやすく、また対応も GitHub 上で完結する (レビューして、コメントし、Issue を移動させる) と、あたかも他のエンジニアに委託しているかのように作業を進めることが出来ます。
また細かいところではこういうこともやっていたりします。
- 曖昧なタスクや複雑なタスクは Plan に移動させるとタスク分解や計画を作るようにする
- 利用する model 等を GitHub Project の field から設定出来るようにする
タスク候補の作成
自動で色々進められるようになると今度は、Issue を作ることがボトルネックになってきます。自分も Loop Engineering のプラクティスを参考に、定期的に AI に、タスクの案を作らせています。
GitHub Project 上では Draft Item がこれに向いてます。(Issue よりもログが残らず、雑に作って雑に消しやすいです。)
AI に Draft Item を作らせ、それの仕分けを自分が行う、というやり方で進めています。
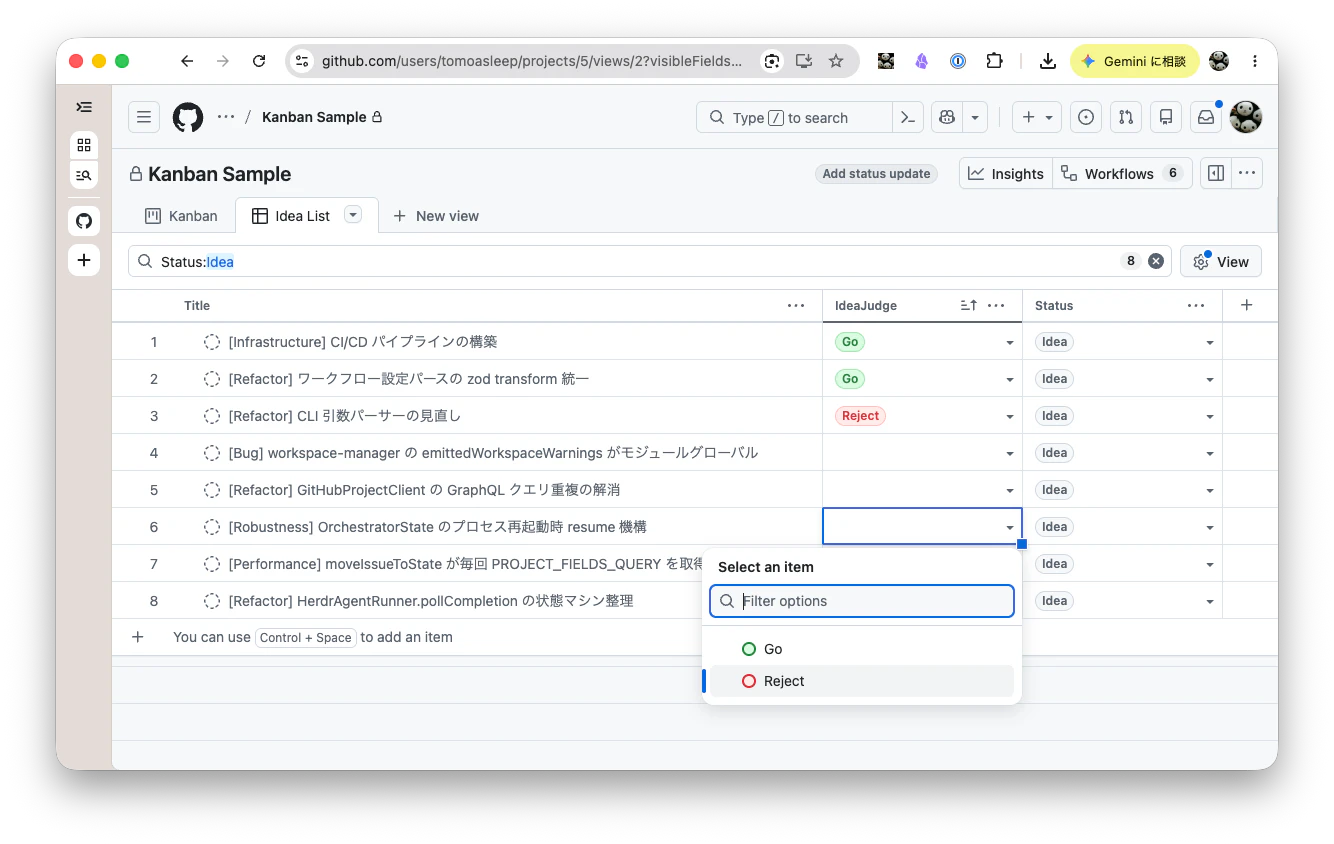
仕分ける際に判断の根拠を書いておくことで、AI がそれを学んで次に活かす、ということもやってます。
GitHub Project のオーケストレーターの作り方
一応参考実装として自分の実装も紹介しているのですが、自分のワークフローに合わせて作ってみるのもとても良いと思います。どういう風に作った/作れるかと、合わせて実際に作ったときの Tips を紹介します。
Symphony の SPEC を用いて初期開発
先ほども軽く紹介したのですが、 Symphony はあくまでリファレンス実装です。これをフォークしても良し、仕様が SPEC.md として文章化されているので、エージェントに「これをベースに実装して」とお願いするも良しです。
(公式でもだいたいそんな感じのスタンスで解説されています)
一応、初期実装では、
- 実装言語は Elixir
- 対象ツールは Linear
- エージェントは Codex
- Web フロントエンドを持つ
- こういう感じの設定ファイル で動作設定とプロンプトを指示する
となっているのですが、それぞれのツールに依存しているわけではないので、例えば
https://github.com/openai/symphony/blob/main/SPEC.md を元に Symphony システムを実装してください。

ただし、

* 実装言語は、 Elixir じゃなくて TypeScript
* 対象ツールは、 Linear じゃなくて GitHub Project
* エージェントは、 Codex だけではなく、Claude Code と OpenCode に対応
* Web フロントエンド及びサーバー機能は持たず、エージェントの起動は herdr (https://herdr.dev/) を介して行う
* workspace は gwq を利用し、 git worktree を用意する
* workflow ファイルは複数用意でき、実行条件や設定、プロンプトを status 毎に変えるなどが出来るようにする
みたいなプロンプトで今回紹介しているような仕組みに近いものが構築できます。
(情報量の差的に SPEC 側に若干引っ張られやすいので、作る際は Plan で手綱を握っておくことをおすすめします)
エージェントの中に作るか?外に作るか?の話
Loop Engineering のようなハーネスは、エージェント内の仕組み (/goal など) を利用するという方法もありますが、今回は主に以下の理由でエージェント外にハーネスを設ける Symphony のアプローチを主に採用しています。
- 特定のエージェント (Claude Code など) に依存したくない
- 特に Claude Code は
claude -pの料金変更とか不安定な挙動など、依存したくない理由が結構ある…
- 特に Claude Code は
- 決定的な動作はエージェントが苦手とする (例えば、ロングコンテキスト化するとサボったりしがち)
- 試作として Agent Skill として作ってみましたが、信頼性に難があったので、自作に踏み切りました
- プロンプトを最初に書くのも面倒 (Agent 管理疲れから完全に解放されたい)
herdr で agent の状態を管理する
Claude Code を自動化させるという点で面倒なのが、 claude -p の利用枠がクレジットを消費するということです (※ 6/15 から適用予定でしたが延期されており、まだ適用されていませんが、撤回されてないのでいつ適用されても問題ないように身構えておく必要はあります)
ということで Claude Code は interactive モードで起動しつつ、上手く自動制御したいわけですが、そこで便利なのが herdr です。
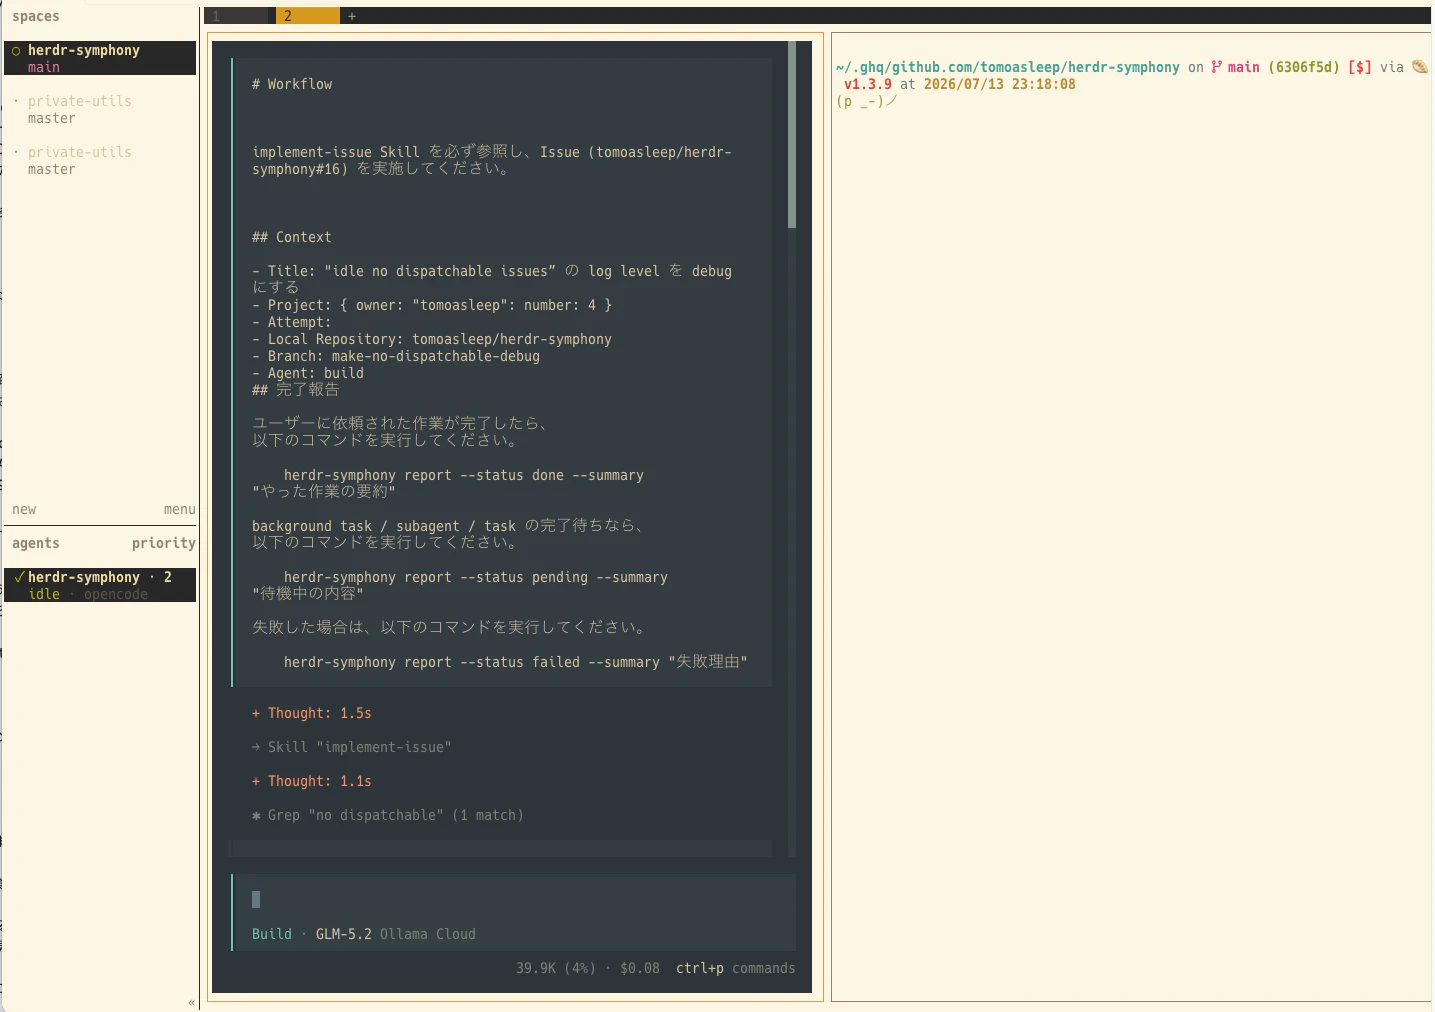
herdr はいわゆる tmux や zellij のようなターミナルマルチプレクサですが、 agent の起動や状態監視を行うことが出来、処理中、入力待ちなどの状態を把握することが出来ます。とても便利。
エージェントの管理を今回はこれに任せることにしました。Symphony 側のフロントエンドも herdr を見れば状態が分かることでほぼ不要になります。

(公式によると、エージェントごとのプラグインや表示画面の内容から把握しているらしいです。)
ただ、これも完璧ではなく、例えば Claude Code がバックグラウンドエージェントの完了を待機しているときにも herdr 上では「完了」と扱われてしまいます。
なので、最終的には以下の組み合わせで完了検出を行うことにしました。
- Claude Code が入力待機状態になっている
- あらかじめ特定のファイルパスを指定し監視し、ファイルが作られている
- ※ 特定のコマンドを使ってもらうことで、レポートとしてファイルが作成されるようになっている
検出後は、一定時間後に自動で agent のプロセスを終了させます。
入力待機中のまま止まっている場合は、以下のリマインダープロンプトを送信します。 (herdr agent send で指定したテキストを送信することが出来ます)
ユーザーに依頼された作業は完了しましたか?
完了した場合は `herdr-symphony report --status done --summary "やった作業の要約"` を実行してください。
まだ background task / subagent / task の完了待ちなら `herdr-symphony report --status pending --summary "待機中の内容"` を実行してください。
失敗した場合は `herdr-symphony report --status failed --summary "失敗理由"` を実行してください。
若干構築が面倒ですが、 agent が interactive に起動していると、変なパターンに嵌っているときにプロンプトを渡して助け舟を出す、みたいなことが出来るので、ワークフローのプロンプトを調整している間とかは便利です。
GitHub Issue を Memory として利用する
Loop Engineering で重要なこととして、エージェント間で引き継ぐ情報の伝搬 (Memory) があります。特に、 Implement → Verify → Implement → … のループは無限ループに陥りやすいために、何かしらの記録は残しておくべきです。
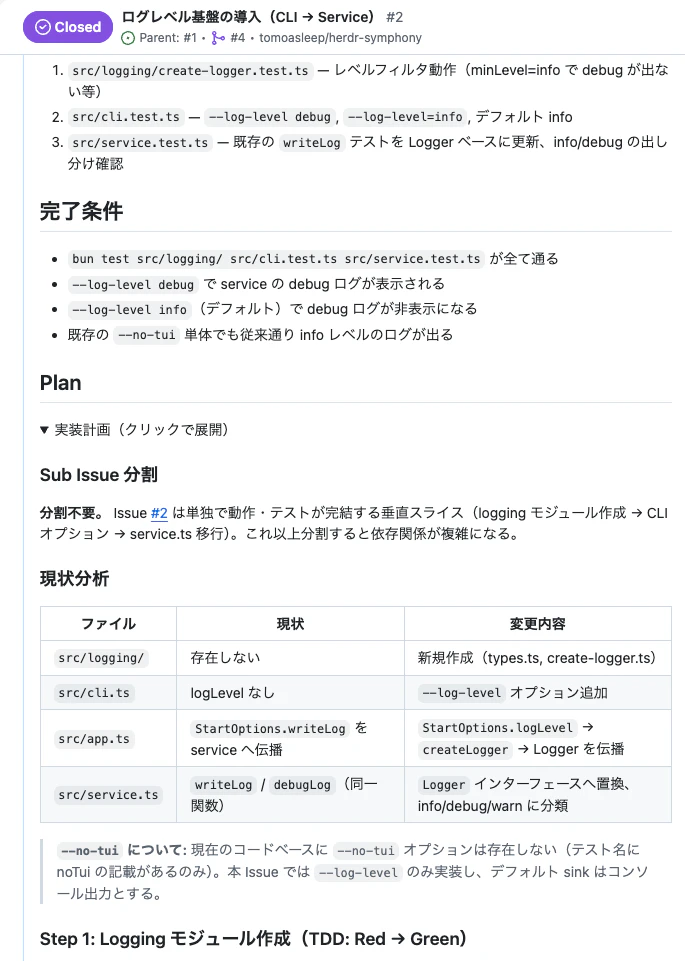
自分は今回 GitHub Issue そのものを Memory として利用しています。
具体的には、エージェントが最後に報告するメッセージを、オーケストレーターがそのまま Issue 本文に自動で追加するようにしています。
(Issue コメントでも良いのですが、通知が鬱陶しくなるので、 <details> tag で囲う形で追記してもらっています。 <details> で囲ってるのは普段あんまり読みたくないからです)

ループ判定もこれを使ってやってもらっていて、数回のログを確認して進展が無いまま繰り返している場合はループと判断して、人間のレビューに回すようにしています。
同様の手法で Plan も Issue に追記してもらっています。Plan の置き場所、git 管理すると古くなったときに面倒、ローカルファイルだとふとした時に消失してしまったりと、置き場所に難儀しがちなのですが、個人的には Issue 本体に <details> tag 付きで追記というスタイルが気に入ってます。
すべての情報が GitHub にあるので、続きをやるときに情報が消えないというのも便利な点です。
Plan は plannotator で表示する
基本的に Symphony のアプローチだと、エージェントと interactive にやる頻度は減るのですが、 Plan mode を使いたいことがあります。
そういう場合は自分は plannotator を使っています。
plannotator は plan のレビューをブラウザ上で (リッチな表示で) 行えるのですが、plan が出来ると自動でブラウザで開いてくれるので気づきやすくて便利なのと、見た目がリッチになることで、得られる情報量が増えて、やりやすくなります。
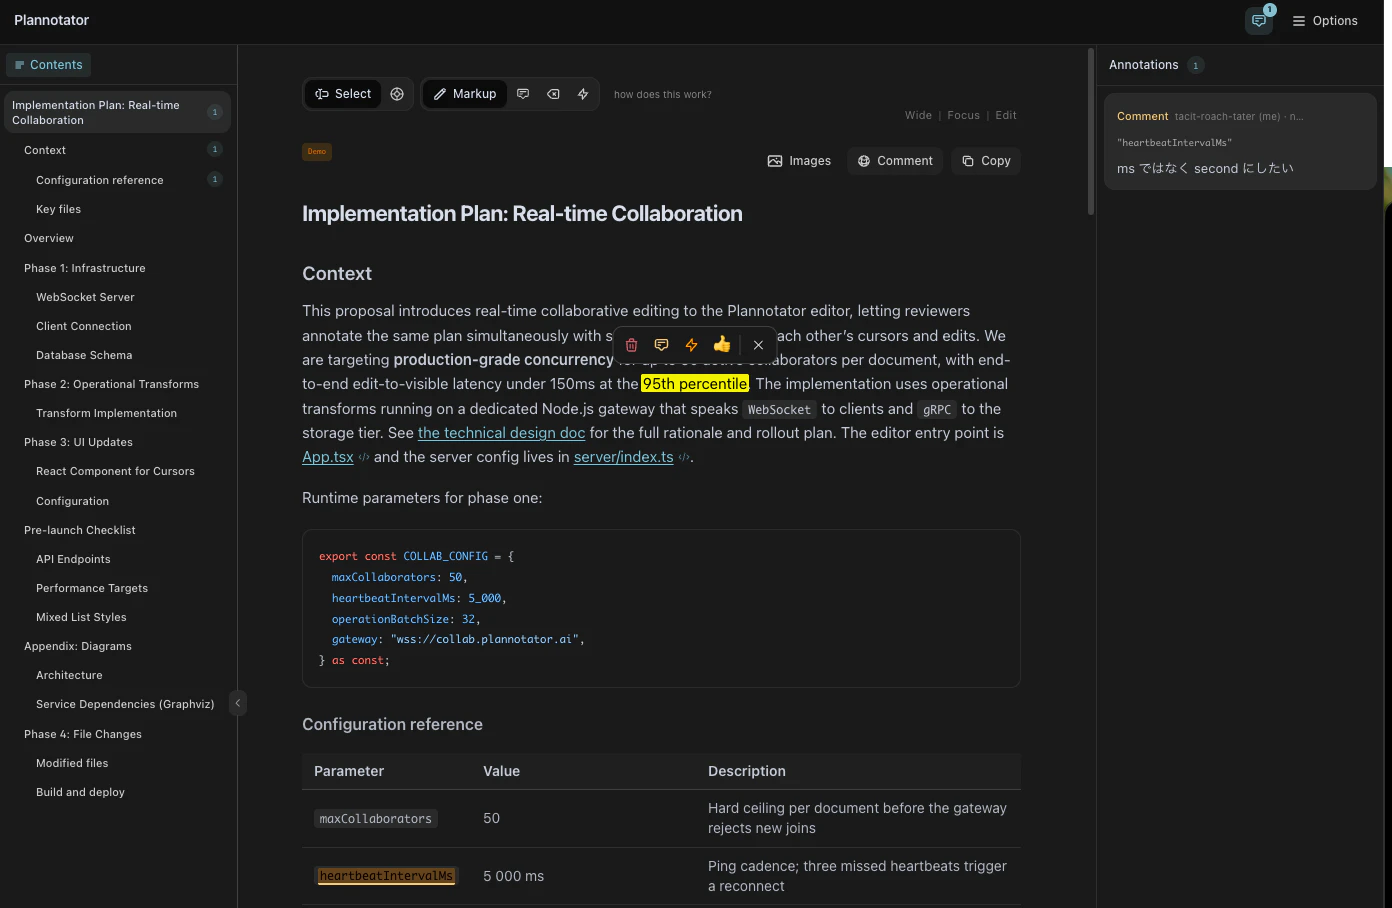
(反面ブラウザが勝手に開いて邪魔、という場合には cmux など、ターミナルとブラウザがくっついたツールを使うと、そっちが吸ってくれます。)
まあ、そもそもこうした Loop Engineering は、繰り返しの多い作業から解放するためのものなので、すべてを Symphony の枠組みの上でやる必要は無いです。
対話的に模索する必要があることは、従来通りチャットでやるでも良いと思います。
自分のコンテキストを元にタスクを提案させる
AI にタスク案を考えさせるのをやらせた感じでは、何を情報源とするかが重要な印象です。特に自分のコンテキストを与えずに、案出しをやらせると重要度が低い改善タスクを無限に提案してきがちです。
そうならないようにするために、自分のコンテキストとなる情報、例えば Meeting の文字起こし、自分の Slack での発言を参照させています。
また、こういった情報を LLM Wiki として整理させて、できるだけ自分がやりたいと思っていることを引っ張り出してもらうように試しています。
GitHub API の Rate Limit に気をつける
GitHub Project の監視は、基本的に polling で行うことになります。
GitHub の Rate Limit はそこまで高くないので (GraphQL API だと 5000pt/1h) 短時間にポーリングを行ったり、GitHub Project のアイテム全スキャンとかをやってるとあっという間に切れがちです。
Rate Limit を表示できるようにする、取得する量や頻度を調整する、などはしておいたほうが良いです。
おわりに
この記事では Symphony ベースで GitHub Project を中心とした Loop Engineering 環境の構築手法 (と個人の所感) について解説しました。
作るのに若干苦労するところもありましたが、Symphony がベースを作ってくれるおかげでかなり楽できたのと、いちいちプロンプトを叩かなくても勝手に Loop で進む体験は圧倒的に楽です。自分だけのワークフローを作ってみるのはおすすめです〜