
過去の登壇資料は、こちらにまとめています:https://github.com/Kenta-Matsuda/presentation-materials
個人で作って運営している AWS 認定の学習サイトについての発表資料を、記事にしました。スライド 1 枚ごとに、発表で話す内容を書いています。

こんにちは、松田です。Qiita では kenken38 という名前で記事を書いています。
今日は、私が個人で作って運営している AWS 認定の学習サイトの話をします。サーバレスでどう作って、公開したあとどう運用しているのか、その裏側をお見せします。
まずは、そのサイトを見てください。

これが、私が個人で運営している「AWS認定合格ナビゲーター」です。AWS 認定資格の勉強を手伝う、無料の Web サイトです。使い方はシンプルで、①で13の資格から試験を選び、②で試験の出題範囲ごとに公式の資料を読んで学び、③で AI が作る模擬問題を解きます。
AWS 認定は全部で13ありますが、そのすべてに対応しています。これまでに、約4,500人の方に使っていただきました。公開したときに書いた Qiita の記事は、週間トレンドで3位に入りました。会員登録も広告もなくて、完全に無料です。
今日は、このサイトについて、5つの章に分けてお話しします。
参考:kenta-matsuda.github.io/Kenta-Matsuda.github.io-aws-study / Qiita

今日の流れです。全部で5つの章があります。
1つめは、なぜこのサイトを作ったのかという、サイト制作の背景。2つめは、学習者から見て何ができるのかという、機能。3つめは、それを裏で支えているアーキテクチャ。4つめは、AI が模擬試験の問題を作る仕組みと、その改善の話。最後の5つめが、サイトを安全に動かし続けて、直し続けるための運用保守です。
サイトの中で資料を探す AI 検索の仕組みは、付録にまとめました。発表では飛ばしますが、あとでゆっくり読んでもらえるようにしています。
TRACK 01 サイト制作の背景

1つめの章は、サイト制作の背景です。問題集を丸暗記して合格しても、すぐに忘れてしまいますよね。このサイトは、読むべき資料を示す航海士、つまりナビゲーターになって、実務で本当に使える AWS の一次情報へ案内したいと思って作りました。なぜこのサイトを作ったのか。そして、学習者の困りごとをどう解決しているのかをお話しします。

AWS 認定を勉強していると、みんなだいたい同じところでつまずきます。よくある困りごとを5つ挙げてみました。
1つめ。何から手を付ければいいのか、学習のロードマップが分からない。
2つめ。資格を取るためだけの勉強ではなく、実務で役立つスキルを身に付けたい。
3つめ。Web で見つかる問題集が、実は本番の試験から流出した問題、つまり規約違反の問題かもしれない。流出問題を使っていたことが分かると、合格を取り消されることもあるんです。
4つめ。そもそも忙しくて、勉強が続かない。
そして5つめ。できればお金を掛けたくない。
この5つを解決したくて、このサイトを作りました。では、それぞれをどう解決しているのかを見ていきます。

さっきの5つの困りごとに、このサイトがどう答えているかです。
ロードマップが分からない、に対しては、AWS 認定の全冠保持者、つまり AWS 認定をすべて持っている私がおすすめする学習ロードマップを載せています。試験ガイドに沿って、読む資料を順番に並べたものです。試験ガイドが何なのかは、次の章で実物を見ながら説明しますね。
実務のスキルを身に付けたい、に対しては、AWS の質の良い一次リソースを3000件以上載せています。問題をたくさん解くよりも、公式の資料を読むことに時間を使ってほしい、というのが私の考えです。
流出問題かもしれない、に対しては、サイトのソースコードを丸ごと OSS として公開しています。AI で問題を作るときの指示文も見られるので、流出問題を使っていないことを、誰でも確かめられます。
勉強が続かない、に対しては、称号のランクアップや、XP という経験値など、ゲームの要素を入れました。実はここが、私がいちばんこだわったところです。
最後の、お金を掛けたくない、に対しては、AI を BYOK という形で呼んでいます。Bring Your Own Key の略で、学習者が自分で取った API キーを使ってもらう方式です。サイト自体は静的な Web サイトで、AWS も無料枠の範囲で動かしています。
では、学習者から見て、このサイトで具体的に何ができるのか。次の章で見ていきます。
参考:GitHub
TRACK 02 機能

2つめの章は、機能です。最初にお見せしたサイトで、学習者が何をできるのかを見ていきます。まずは全体を1枚の図で整理してみます。

画面を1つずつ見る前に、このサイトで何ができるのかを整理しておきます。
まず上の段から。AWS は、試験ごとに「試験ガイド」という公式の文書を出しています。試験に何が出るのかを、分野と、その下のタスクに分けて書いたものです。分野は英語で Domain と呼びます。たとえば SAA-C03 だと、分野1が「セキュアなアーキテクチャの設計」で、その最初のタスクが「AWS リソースへのセキュアなアクセスを設計する」です。このサイトは、このタスクごとに、読むべき資料を並べています。これが、1つめの困りごと、ロードマップが分からない、への答えです。
下の段が、このサイトでできる4つのことです。公式の資料で学ぶ。AI が作った問題を解く。AI に聞く。そして、感想を開発者に伝える。このあとの画面も、この4つの順番で見ていきます。学ぶ画面では、AI が用語を説明してくれたり、資料を探してくれたりもします。この AI 検索の仕組みは、付録にまとめています。
では、学ぶ画面から見ていきましょう。

まずは学ぶ画面です。試験に SAA-C03 を選んで、上のタブで Domain 1、つまり分野1を開いたところです。
①が、さっきお話しした試験ガイドのタスクです。日本語と英語を並べて出しています。②の「模擬問題を作成」を押すと、このタスクの範囲だけから、AI が問題を作ってくれます。
左側には、このタスクで必要な知識が並んでいます。③の「解説」を押すと、そのサービスについて AI が説明してくれます。
右側には、④のように、AWS のブログや、AWS の公式オンラインセミナーの Black Belt、公式ドキュメントといった公式の資料を、種類ごとに並べています。特におすすめのものには印を付けています。⑤の Good と Bad のボタンで、資料の評価も送れます。この評価がどこに届くのかは、あとの AWS の話で出てきます。
学ぶ画面では、もう1つ、AI を使って資料を探すこともできます。

画面の右上にある検索ボタンを押すと、すべての試験の資料をまとめて探せます。ボタンは2つあって、オレンジの枠で囲んだのが、それぞれの例で押したボタンです。
左の青い「検索」は、キーワードが一致するものを探す、普通の検索です。入れた言葉をそのまま含む資料しか見つかりません。たとえば「分析用の AI サービス」と入れると、この言葉そのものを含む資料は無いので、0件になります。サービス名をまだ知らない初学者ほど、ここで困ってしまいます。
そこで、右の紫の「AI 検索」です。同じ言葉のまま押すと、AI が「答えにはこんなサービス名が出てきそうだ」と考えて、その名前で探し直してくれます。この例では135件見つかって、上に AI のおすすめと、その理由が出ています。
中でどうやって探しているのかは、付録で詳しく説明しています。
次は、解くです。まずは、問題の解き方を選ぶ画面から。
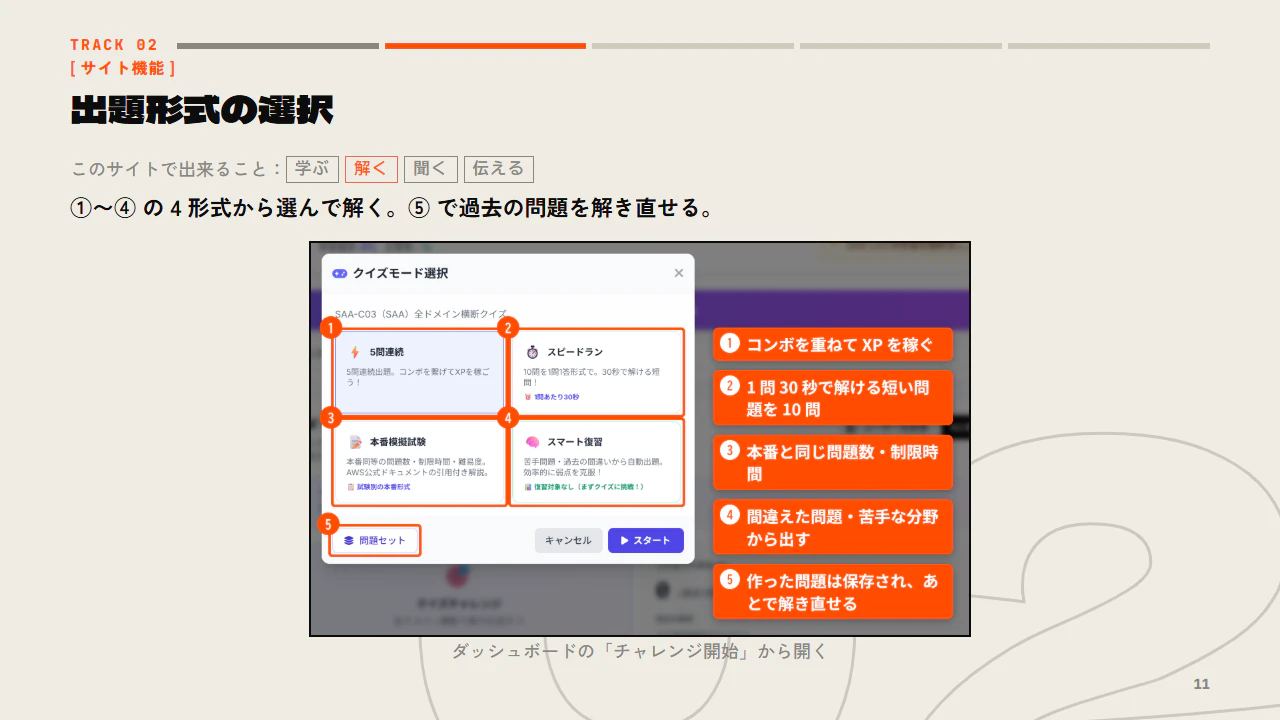
ダッシュボードの「チャレンジ開始」を押すと、この画面が開きます。
①の5問連続は、続けて正解するとボーナスが付いて、経験値の XP がたくさんもらえるモードです。②のスピードランは、1問30秒くらいで解ける短い問題を、10問続けて解きます。本番のような長いシナリオは無くて、サービス名や機能を直接聞く1〜2文の問題なので、ちょっとしたすき間の時間でも解けます。③の本番模擬試験は、本番と同じ問題数と制限時間で解くモードです。④のスマート復習は、間違えた問題や、苦手な分野から出してくれます。
忙しくて続かない、という困りごとに向けて、スピードランのような短い時間で解ける形と、XP のような、つい続けたくなる仕組みを入れています。
⑤の問題セットからは、前に作った問題を開いて、解き直すこともできます。
ちなみに、ここまでの問題は AI がその場で作るので、API キーが必要です。キーを持っていない方のために、あらかじめ用意しておいた問題で、本番と同じ形式の試験を解ける入口も別に用意しています。
では、実際に本番模擬試験の問題を1問、解いてみます。

このサイトでいちばん力を入れているのが、この本番模擬試験です。これは SAA-C03 の本番模擬試験で、AI が実際に作った問題です。AI がその場で作るので、流出問題ではありません。
①を見てください。物流会社が AWS Organizations でたくさんのアカウントを管理していて、決まったリージョン以外ではリソースを作れないようにしたい、という具体的な場面から始まります。本番の試験と同じ、シナリオ形式の問題です。AWS Organizations は、たくさんの AWS アカウントをまとめて管理するサービスで、その中のアカウントに一括で「ここまでしか操作できない」という上限をかける設定を、SCP と呼びます。
選択肢も、どれもそれっぽく書かれています。ここでは、あえて A を選んでみました。
この問題を AI がどんな手順で作っているのかは、04 の「模擬問題生成の仕組み」の章でお話しします。答えると、解説が出ます。

A を選んだので、②に不正解と出て、正解は C だと分かります。間違えても、経験値の XP は少しもらえます。
この解説が、本番模擬試験のいちばんの売りです。③を見てください。まず、正解の C がなぜ正しいのか。SCP では明示的な Deny が Allow より優先されること、IAM のようなグローバルサービスは除外しておく必要があることまで、説明してくれます。次に、A、B、D がそれぞれなぜ違うのかも、1つずつ説明します。さらに、Well-Architected のセキュリティの柱という、AWS のベストプラクティスにも触れています。
そして④のように、根拠になった AWS 公式ドキュメントへのリンクも付きます。間違えた問題から、そのまま公式ドキュメントを読みに行けるわけです。1つめの章でお話しした「AWS の一次リソース」を、ここでも使っています。
この解説の形は、サイトが AI に指示しているものなので、どの問題でも同じ形になります。
下の Good と Bad で、問題の良し悪しも送れます。
次は、聞くです。AI とのチャットですね。

画面の右下のボタンを押すと、AI とのチャットが開きます。
①のように、いま選んでいる試験について答えてくれます。試験ガイドや対象のサービス、試験の改定予定といった公式の情報を踏まえて答えるようにしています。
②の「重要ポイント」「頻出サービス」「勉強方法」は、ボタン1つで聞ける質問です。もちろん、③の欄に自由に質問を書くこともできます。
最後は、伝えるです。感想を送る画面を見てみます。

左側の「フィードバックを送る」を押すと、この画面が開きます。
①で要望か不具合かといった種類を選んで、②に1,000字まで書けます。③で画像も3枚まで付けられます。画像は、送る前にブラウザの中で縮小して、位置情報なども消しています。
④の送信ボタンは、GitHub のアカウントを持っていなくても使えます。送った感想は、公開している GitHub の Issue になります。Issue というのは、やることや不具合を管理するチケットのようなものです。そのうえで、Issue の番号と一緒に、AWS の DynamoDB にも保存されます。
この2つの行き先は、このあとの話につながります。DynamoDB への保存は次の章の AWS の話で、GitHub の Issue は最後の運用保守の章の、開発の自動化の話で出てきます。
ここまでが、学習者から見たサイトです。では、これが裏でどう動いているのかを見ていきましょう。
TRACK 03 アーキテクチャ

3つめの章は、アーキテクチャです。先に答えを言ってしまうと、このサイトは、ここにある3つの組み合わせで動いています。まずは全体の構成図で見てみます。

全体の構成はこんな感じです。左が静的サイト、右上が AI、右下が AWS です。
サイト本体は GitHub Pages に置いていて、HTML と JavaScript と試験のデータを、静的なファイルとして配っているだけです。サーバを持っていないので、配信にお金はかかりません。
画面の処理も、問題を作る処理も、全部、学習者のブラウザの中で動いています。
AI は、ブラウザから Gemini や OpenAI の API を直接呼んでいます。API キーは学習者に自分で取ってもらって、設定画面に入れてもらいます。なので、AI の利用料を運営側が払うことはありません。
XP や解いた履歴、設定、API キーは、学習者のブラウザの中に保存されます。これらは運営側には送りません。ただし、問題を良くするために、あとで説明する解答のログという最小限の記録だけは送ってもらっています。
AWS を使っているのは、右下の小さな部分だけです。ブラウザから送られてくる感想と問題の評価、それから解答のログを、Lambda が受け取って、DynamoDB に保存しています。解答のログというのは、どの問題でどれを選んで、正解だったか、何秒かかったか、という記録です。
AWS の部分を拡大する前に、AI を学習者のキーで呼ぶことで生まれる制約を、1つだけお話しさせてください。

AI は、学習者が自分で取った API キーで呼んでいます。そうすると、AI プロバイダーが決めている年齢の条件が、そのまま学習者にかかってきます。特に気を付けたいのが、未成年の方です。
オレンジの行を見てください。Gemini の API は、18歳以上でないと使えません。OpenAI は13歳から使えますが、18歳未満の方は保護者の同意が必要です。そこで、13歳から17歳の方には、保護者の同意をもらったうえで OpenAI を使ってもらうよう、左の設定画面で案内しています。
ただ、OpenAI には Gemini のような無料枠がなく、使った分だけお金がかかります。それに、次の章でお話しする、ブラウザを閉じても問題を作り続ける機能も、OpenAI では使えません。この機能は、Gemini の Batch API という、まとめて頼んだ処理を Google 側で進めてくれる仕組みを使っているからです。年齢によって学習体験に差が出てしまっていて、ここはまだ解決できていない課題です。
では、右下の AWS の部分を拡大して見てみます。

AWS の部分を拡大すると、こうなっています。
ブラウザからの送信を Lambda が受け取って、DynamoDB に保存します。感想に画像が付いていれば S3 に保存して、GitHub に Issue を作ります。GitHub に投稿するためのトークン、つまりパスワードのような認証情報は、SSM の Parameter Store に保管しています。S3 に保存した画像は、CloudFront という AWS の配信サービスを通して、GitHub の Issue の中に表示します。DynamoDB のデータは、決めた日数が過ぎると自動で消えるようにしています。図の枠の中は全部、あとで説明する SAM のテンプレート1つで定義しています。
この構成の真ん中にいるのが Lambda です。ここからは、Lambda を使ったことがない方にも分かるように、この Lambda が実際にどう動いているのかを、コードを見ながら説明していきます。

Lambda を初めて聞く方のために、まず、Lambda が1回呼ばれたときに何が起きるのかを見てみます。Lambda は、サーバを用意しなくても、リクエストが来たときだけ関数を動かしてくれるサービスです。このサイトでは、Function URL という、Lambda に直接付けられる URL で呼び出しています。API Gateway は使っていません。Function URL 自体には、追加の料金はかかりません。
ブラウザが感想を POST すると、Lambda はその HTTP リクエストを、左の event という JSON に変えて、関数に渡してくれます。中には、どのパスに送られたか、どのページから送られたか、送信元の IP アドレス、そして本文が入っています。オレンジの項目が、このサイトのコードで実際に使っているところです。
関数の入口は handler です。処理が終わったら、右のように statusCode と headers と body を持ったオブジェクトを返します。すると Lambda がこれを HTTP の応答に変えて、ブラウザに返してくれます。つまり、関数を書く側は HTTP サーバを書かなくてよくて、JSON を受け取って JSON を返すだけでいいんです。
では、handler の中で何をしているのかを、順番に見ていきます。
参考:Lambda 関数 URL の呼び出し / infra/feedback/src/index.mjs
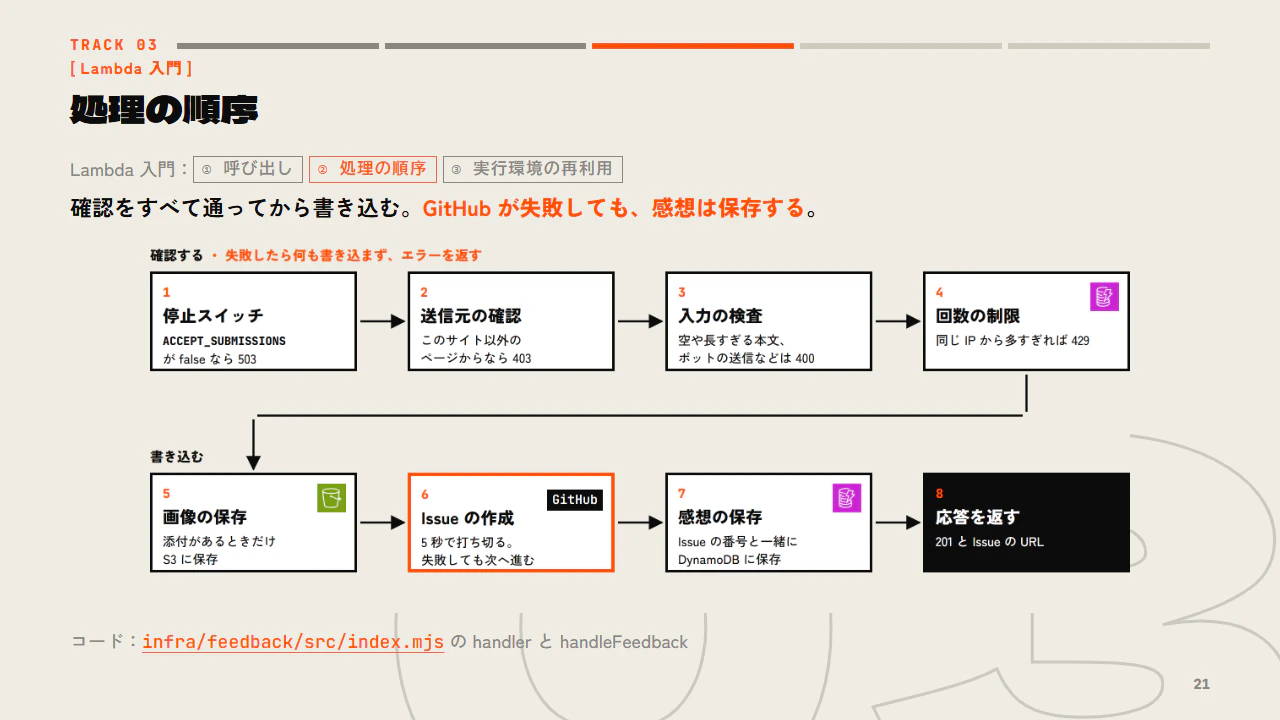
感想が1件届いたときに handler がやっていることを、コードの順番に並べました。
上の段は、チェックです。1の停止スイッチは、05 の運用保守の章でお話しする、受け付けを止めるための設定です。2で、このサイト以外のページから送られてきたものをはじいて、3で本文の長さや、ボットからの送信でないかを確かめ、4で同じ IP アドレスから何回送られているかを数えます。どこかで引っかかったら、その場でエラーを返して、何も書き込みません。書き込む前にチェックを済ませるので、悪用されても費用が膨らみにくくなっています。
下の段が、書き込みです。5で、画像が付いていれば S3 に保存します。S3 は非公開にしていて、CloudFront を通したときだけ読めるようにして、その URL を Issue に埋め込みます。6で GitHub の Issue を作ります。GitHub に投稿するトークンは SSM の Parameter Store に保管していて、このリポジトリの Issue の読み書きしかできないようにしています。この GitHub の呼び出しは5秒で打ち切って、失敗しても先に進みます。7で、Issue の番号と一緒に、感想を DynamoDB に保存します。DynamoDB には TTL という仕組みを設定していて、決めた日数が過ぎたデータは自動で消えます。最後に8で、201 と Issue の URL を返して終わりです。
ちなみに、問題の評価と解答のログが届いたときは、画像の保存と Issue の作成はせずに、確認のあと DynamoDB にまとめて保存するだけです。
Lambda のタイムアウトは10秒にしています。GitHub を5秒で打ち切っているのは、GitHub の応答が遅くても、DynamoDB に保存する時間を残しておくためです。
Lambda の基本はここまでです。最後におまけとして、Lambda を使うなら知っておくと得をする、実行環境の仕組みを1つだけ紹介します。
参考:infra/feedback/src/index.mjs

ここはおまけの話です。Lambda を使うなら知っておくと得をする、実行環境の仕組みです。
左のコードは、このサイトのコードを、説明のために短くしたものです。オレンジの部分が handler の外、下の白い部分が handler の中です。
右の1件目を見てください。最初の呼び出しでは、Lambda がまず実行環境を作って、handler の外を1回だけ実行します。ここで DynamoDB のクライアントを作ります。そのあと handler を実行して、トークンがまだ無いので、SSM から取ってきます。これがコールドスタートです。
処理が終わっても、実行環境はすぐには捨てられません。そのあいだに2件目が来ると、今度は handler だけが実行されます。ddb も token も、前の呼び出しで入れた値がそのまま残っているので、クライアントを作り直す必要も、SSM に取りに行く必要もありません。これがウォームスタートです。しばらく呼ばれないと環境は捨てられるので、3件目は、また handler の外からやり直しになります。
じゃあ、環境はどのくらい残るのか。下に公式ドキュメントの仕様を載せました。残る時間は公開されていなくて、設定もできません。呼ばれ続けていても、数時間ごとに作り直されます。起動済みの環境をいつも用意しておきたいときは、Provisioned Concurrency という有料の設定を使います。このサイトは、多少のコールドスタートなら問題にならないので、使っていません。
なので、handler の外の値は、使い回せたらラッキーなキャッシュくらいに考えて、無くてもちゃんと動くように書いておきます。
ここまでが Lambda の動きです。ここまでに出てきた AWS のリソースは、全部 SAM のテンプレート1つで定義しています。SAM を使ったことがない方のために、SAM とは何かを説明しますね。
参考:Lambda 実行環境のライフサイクル / Provisioned Concurrency / infra/feedback/src/index.mjs
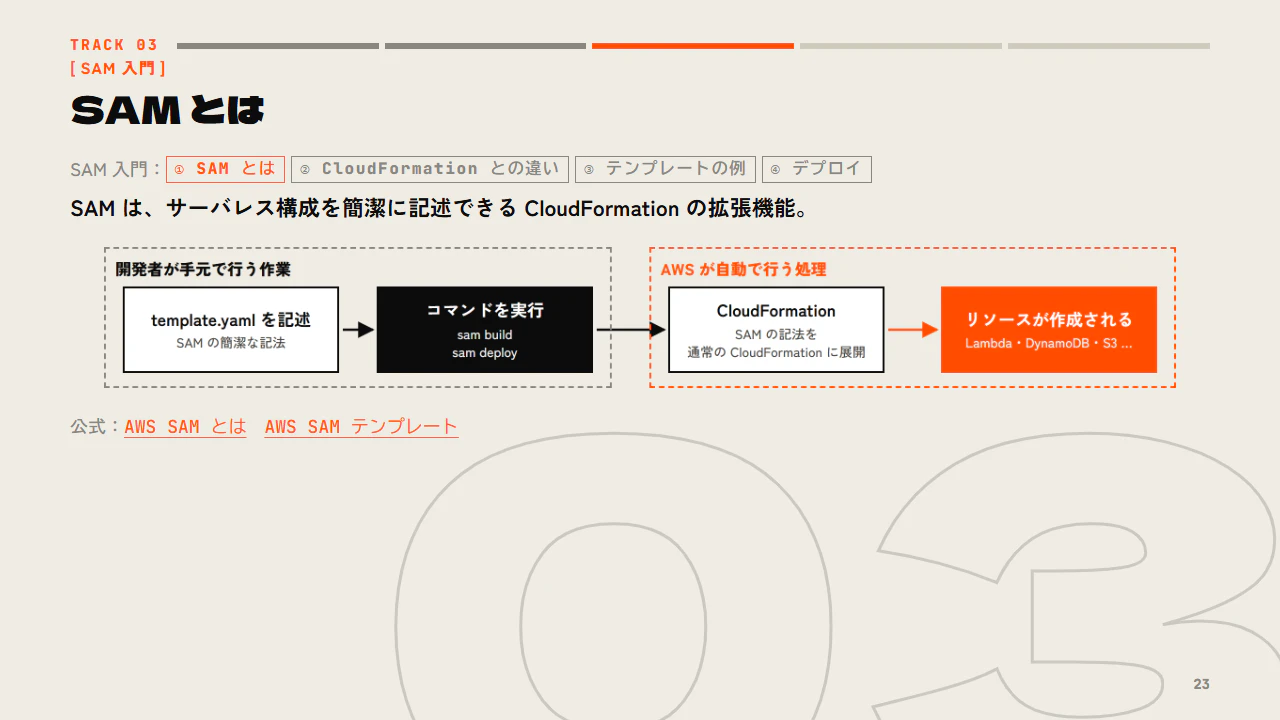
AWS には CloudFormation というサービスがあります。テンプレート、つまり設計図を書いておくと、そのとおりにリソースを作ってくれるサービスです。SAM は、その CloudFormation を拡張したもので、Lambda のようなサーバレスの構成を短く書けるようにしてくれます。
図の左の枠が、開発者が手元でやることです。SAM の書き方でテンプレートを書いて、sam build と sam deploy を実行するだけです。右の枠は、AWS が自動でやってくれます。CloudFormation が、SAM の書き方を普通の書き方に展開して、リソースを作ります。開発者が自分で書き換える必要はありません。SAM と CloudFormation 自体は無料です。
では、SAM で書くと、CloudFormation だけで書く場合と比べて、何が楽になるのか。次のスライドで比べてみます。
参考:AWS SAM とは / AWS SAM テンプレート

このサイトの Lambda のように、誰でも呼べる URL 付きの Lambda を作る場合で比べてみます。
CloudFormation だけで書くと、左のように5つのリソースを全部自分で書くことになります。関数そのもの、関数の権限になる IAM ロール、URL、それから、URL を誰でも呼べるようにする許可と、URL から関数を呼べるようにする許可の2つです。だいたい30行になります。
SAM なら、右のように AWS::Serverless::Function を1つ書くだけです。許可する操作と URL の設定を書いておけば、IAM ロールも URL も2つの許可も、展開するときに自動で作られます。だいたい10行で済みます。
ほかにも違いが2つあります。CloudFormation だけだと、Lambda のコードを自分で zip にして S3 にアップロードして、その場所を書く必要があります。SAM なら、コードのフォルダを書いておくだけで、sam deploy がアップロードまでやってくれます。それから SAM には、sam local invoke という、関数を手元で動かして試せるコマンドもあります。
では、このサイトの実際のテンプレートを見てみましょう。
参考:SAM が作る CloudFormation のリソース
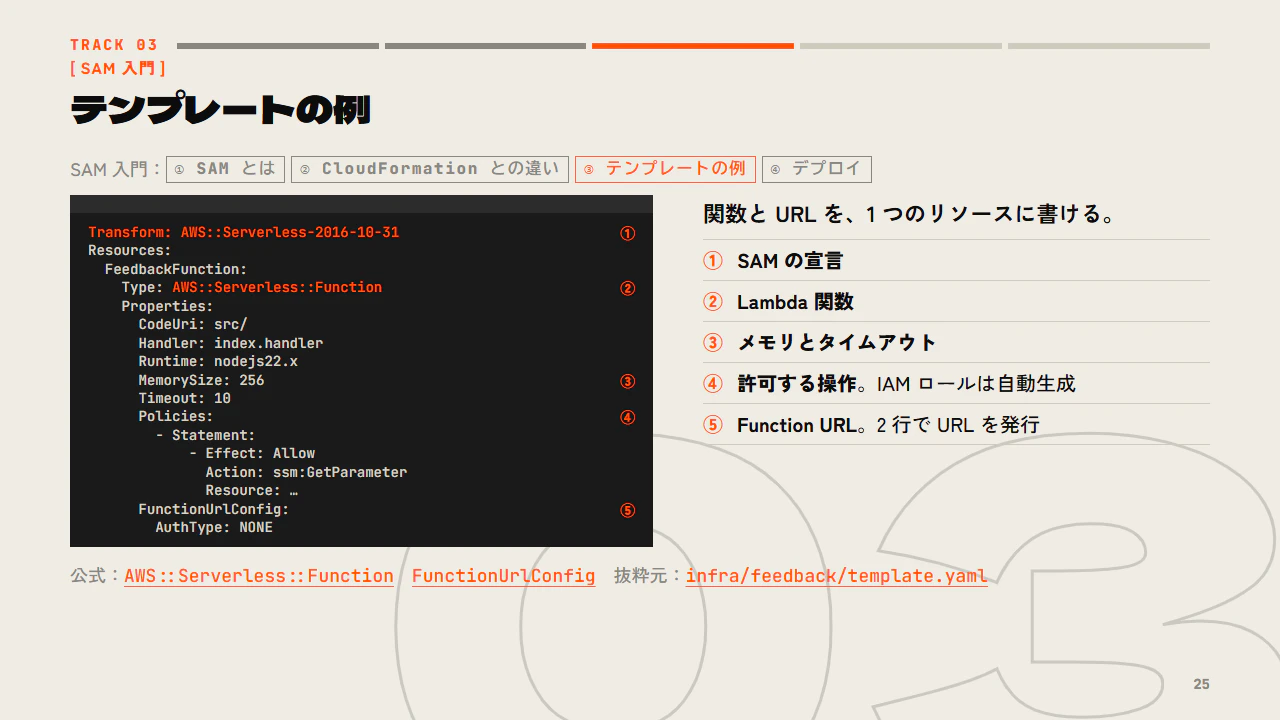
これは、実際のテンプレートから、Lambda の関数の部分だけを抜き出して短くしたものです。
①の Transform の1行が、「これは SAM のテンプレートですよ」という宣言です。この1行があるから、SAM の書き方が使えます。
②が Lambda の関数です。コードが src フォルダにあること、どの関数を動かすか、言語は Node.js であることを書いています。
③は、関数に割り当てるメモリと、タイムアウトです。256メガと10秒にしています。この2つの数字は、あとで料金を計算するときに使います。
④は、この Lambda に許可する操作です。この抜粋では、GitHub のトークンを Parameter Store から読む許可だけを載せていますが、実際には DynamoDB への書き込みと、S3 への画像の保存も許可しています。実行用の IAM ロールは、これをもとに自動で作られます。さっき「自分で書かなくていい」と言った IAM ロールが、これです。
⑤の FunctionUrlConfig の2行を書くだけで、この Lambda を呼べる URL ができます。誰でも呼べる設定なので、05 の運用保守の章でお話しする回数の制限などを、Lambda のコードの中で入れています。
DynamoDB のテーブルや S3 のバケットも、同じテンプレートの中に、普通の CloudFormation の書き方で並べています。
では、このテンプレートを、どうやって AWS に反映するのか。
参考:AWS::Serverless::Function / FunctionUrlConfig / infra/feedback/template.yaml
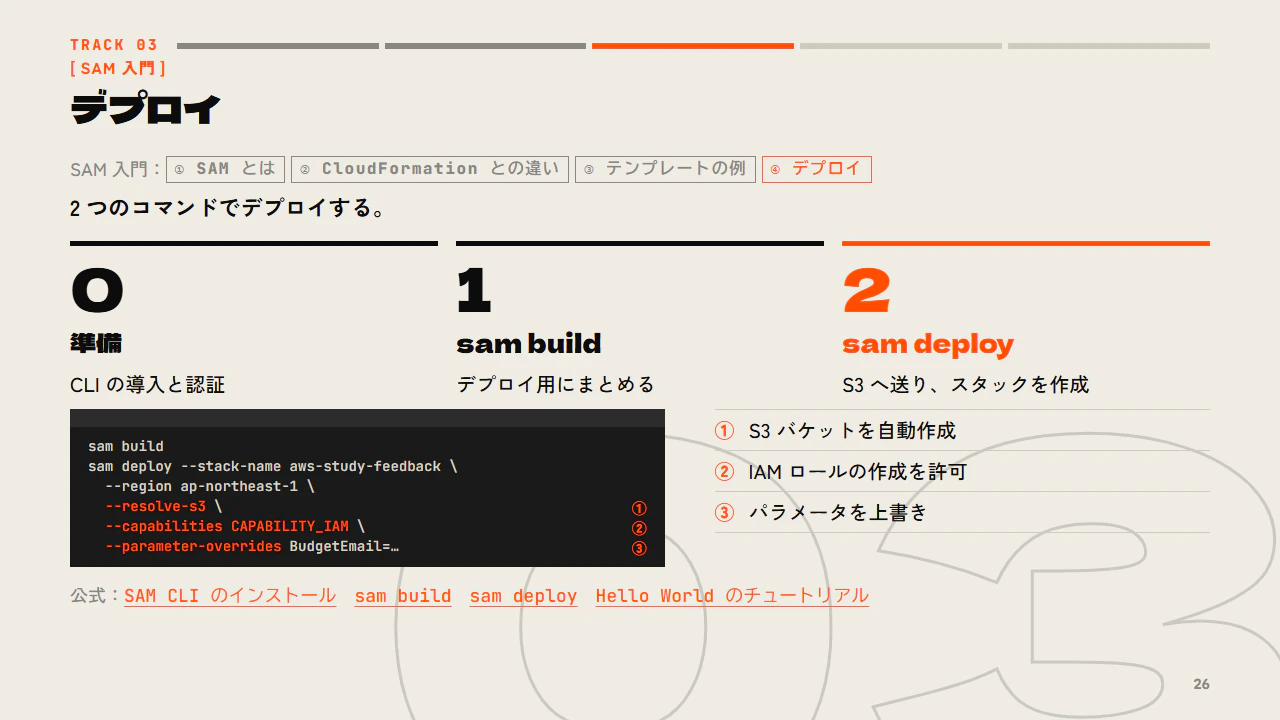
デプロイの手順です。まず準備として、手元のパソコンに AWS CLI と SAM CLI を入れて、AWS にログインしておきます。このとき、root ユーザーは使わずに、IAM ユーザーか IAM Identity Center のユーザーを使ってください。
あとは、コマンド2つだけです。sam build で、Lambda のコードとテンプレートを、デプロイできる形にまとめます。sam deploy で、コードを S3 にアップロードして、CloudFormation がスタック、つまりテンプレートから作ったリソースのひとまとまりを作ります。2回目からは、変えたところだけが更新されます。
下が、このサイトで実際に使っているコマンドです。①は、コードの置き場所になる S3 バケットを自動で作るオプション。②は、IAM ロールを作ってもいいですよ、という許可。③は、テンプレートのパラメータの値を、デプロイのときに上書きするオプションです。05 の運用保守の章でお話しする停止スイッチも、この③で切り替えます。
初めての方には、sam deploy --guided から始めるのがおすすめです。質問に答えていくだけで設定ができて、次からは sam deploy だけで済むようになります。
ちなみに、デプロイは私が手で実行しています。
では、こうして作った AWS の部分には、いったいいくらかかるのか。まずは Lambda の料金の仕組みから見ていきます。
参考:SAM CLI のインストール / sam build / sam deploy / Hello World のチュートリアル

実際の費用を出す前に、Lambda の料金の仕組みを見ておきます。Lambda の料金は、2つの合計です。1つは、リクエストの回数。もう1つは、関数に割り当てたメモリと、動いた時間を掛け算した量で、これを GB 秒と呼びます。無料枠は毎月、100万リクエストと、40万 GB 秒です。
このサイトの関数は、メモリを256メガ、つまり0.25ギガにしています。40万 GB 秒を0.25ギガで割ると、160万秒。つまり、全部の呼び出しの実行時間を足して、月に160万秒までなら、2つめの料金はかかりません。
ただ、1件に何秒かかるかは、処理の中身や、そのときの混み具合で変わるので、前もっては分かりません。そこで、いちばん悪い場合で考えます。タイムアウトを10秒にしているので、1件は長くても10秒で打ち切られます。全部の呼び出しが10秒かかったとしても、月16万件までは無料です。
次のスライドでは、利用者が増えた場合を仮定して、月30万件で計算します。30万件の全件が10秒かかると75万 GB 秒になって、無料枠を35万 GB 秒はみ出します。金額にすると、約4.7ドルです。
無料枠は、2026年10月時点の内容です。では、利用者が増えたら、全体でいくらかかるのかを計算してみます。
参考:AWS Lambda の料金 / infra/feedback/template.yaml

では、利用者が増えたらいくらかかるのか。実績ではなく、仮の数字で計算してみました。
仮定は2つです。1つめ。アクティブユーザーが1,000人いて、1人が月に300問、つまり1日10問ずつ解くとします。解いた問題の記録は、多めに見積もって1問ごとに1回送るとすると、月30万回の送信です。2つめ。感想が月100件届いて、全部に上限いっぱいの画像が3枚ずつ付いているとします。
まず Lambda です。30万回なので、回数は無料枠に収まります。実行時間のほうは、さっきのスライドのとおり、全件がタイムアウトの10秒かかるという最悪の場合で考えて、最大で月4.7ドルくらいです。
残りの2つです。DynamoDB の書き込みは、オンデマンドだと、ずっと無料で使える枠がありません。1回の送信で、送信の回数を数える記録と、問題を作った記録、解いた記録の3件を書くので、月90万件で、約0.64ドル。S3 は、画像を消していないので、1年で5.4ギガたまって、月0.14ドルくらいです。
DynamoDB の保存容量、Lambda の実行ログを置く CloudWatch Logs、CloudFront での画像の配信は、どれも無料枠に収まります。サイトの配信は GitHub Pages なので0円、AI の利用料は学習者のキーなので、運営の負担は0円です。
全部足すと、1年後に最大で月5.5ドルくらいです。05 の章でお話しする月1ドルの予算は超えてしまうので、そこまで使われたら、予算の通知メールが届くことになります。料金は2026年10月時点の東京リージョンのものです。
次の章では、ブラウザの中で動いている AI が、どうやって問題を作っているのかをお話しします。
参考:AWS Lambda の料金 / DynamoDB オンデマンドの料金 / Amazon S3 の料金
TRACK 04 模擬問題生成の仕組み

4つめの章は、模擬問題生成の仕組みです。機能の章で、AI が作った本番模擬試験の問題をお見せしましたよね。あの問題を、AI がどんな手順で作っているのかをお話しします。たとえば SAA-C03 の本番と同じ65問を作ってと頼んだとき、中で何が起きているのか、という話です。

最初の作り方は、とても単純でした。プログラムが出題範囲と問題数を決めて、あとは AI に1問ずつ、自由に問題を書かせていたんです。
すると、問題に2つの偏りが出てきました。
1つめは、正解の記号の偏りです。正解を A から D のどこに置くかを AI に任せていたので、正解が B の問題ばかりになることがありました。左のグラフは、そのときの傾向をイメージで描いたものです。
2つめは、同じ正解の問題が何度も出てきたことです。AI Business Strategist、AIB-C01 という試験の模擬試験で、正解が「CoE を作る」の問題が繰り返し出てきました。CoE は、組織の中で AI の活用を進める専門のチームのことです。AI は1問ずつ、ほかの問題で何を聞いたかを知らないまま書くので、毎回いちばん無難な答えを選んでしまうんですね。
そこで、作り方の流れそのものを作り直しました。

これが、作り直したあとの流れです。白い段はプログラムが、オレンジの段は AI がやります。
1の設計図では、プログラムが、1問ごとに何をどう聞くかと、正解の記号を先に決めてしまいます。2の出題計画では、AI に試験全体を一度に見せて、聞く中身が重ならないように計画を立てさせます。3の作問では、AI がその計画の1行に沿って、1問ずつ書きます。4の検査では、プログラムが問題の形をチェックして、前の問題と似ていたら作り直させます。最後の5の査読と修正では、AI に正解を伏せたまま問題を解かせて採点し、問題を直すか捨てるかを決めます。
Gemini を使っている場合は、2の出題計画のあとの作問を、Gemini の Batch API でまとめて頼みます。なので、ブラウザを閉じても Google 側で作り続けていて、次にサイトを開いたときに、できた問題を受け取れます。03 の章でお話ししたとおり、OpenAI ではこれが使えません。
この流れに入る前に、1の設計図の材料になる「出題のネタ」を見ておきます。

出題のネタというのは、AWS の公式資料から、問題の材料を前もって整理しておいたものです。ポイントは、試験ごとに聞かれる観点が違うので、ネタの形も試験に合わせて変えていることです。形は3つあります。
左のケースカードは、SAA や SAP のような、要件に合う構成を選ばせる10の試験で使います。AWS の構築事例のブログなどから、判断が必要になる場面を抜き出します。たとえば、組織全体の統制を、どの階層に置くか、といった場面です。採用した案だけでなく、採用しなかった案も書いておくと、それがもっともらしい誤答の選択肢になります。
真ん中のフレームワークの表は、AI をビジネスでどう使うかの判断を問う AIB で使います。AWS CAF for AI、つまり AWS がまとめた AI 導入のための枠組みを、観点と段階のマスに分けて、1マスずつ要点と、よくある誤解を書いておきます。この誤解が誤答になります。
右の用語カードは、用語やサービスの理解を問う、CLF、つまりクラウドプラクティショナーや、AIF、つまり AI プラクティショナーのような基礎の試験で使います。公式ドキュメントの定義と、取り違えやすいサービスを書いておきます。たとえば CloudTrail の問題なら、CloudWatch や Config が誤答の候補になる、という具合です。
ネタは AI が公式資料から書き出して、私がレビューしてから使います。書き出している AI については、最後の章でお話しします。
では、このネタを使って、1の設計図を作ります。

1の設計図は、プログラムが作ります。ここではまだ AI は使いません。
左の3つが材料です。まず、試験ガイドに書かれた分野ごとの出題の割合に合わせて、各問題をどのタスクから出すかを決めます。次に、そのタスクの出題のネタを1つずつ割り当てます。同じタスクから何問も出るときは、ネタをひと通り使い切るまで、同じネタは使いません。さらに、聞き方と、問題の中で判断する人の立場と、業界を割り当てて、似た問題が続かないようにばらします。
これで、真ん中のような、1問ごとの枠ができあがります。
そして右です。正解の記号も、ここでプログラムが割り当てます。A から D を順番に配ってから並べ替えるので、65問なら、どの記号もだいたい16回ずつになります。これで、1つめの偏りだった、正解が B ばかりになる問題はなくなります。
次は、2の出題計画です。

2の出題計画では、AI を1回だけ呼びます。左のように、1の設計図で作った枠の一覧を、全部まとめて渡します。ここで渡すのはネタの名前だけで、ネタの中身や正解の記号は渡しません。
AI は、枠ごとに3つのことを返してきます。正解として何を聞くか、問題の状況、そしてどんな誤答を選ばせるかの方針です。このとき、聞く中身が試験全体で重ならないように指示しています。
それでも似た行が出てくることがあるので、右の4行目のように、聞く中身が似ている行はプログラムが消します。消した行の問題は、計画なしで、枠の情報だけをもとに書かせます。
これで、2つめの偏りだった、同じ正解が何度も出る問題の、いちばん大きな原因がなくなります。
次は、この計画の1行に沿って書く、3の作問です。

3の作問では、1問ごとに AI を呼びます。プログラムが、左のブロックをつなぎ合わせて、AI への指示文を組み立てます。
上の2つは、前からあったものです。本番と同じシナリオ形式で書く、といった、どの問題にも入れる共通の指示と、そのタスクの公式資料3件のタイトルと URL です。解説で引用していいのは、この3件だけにしています。
オレンジの4つが、改善で足したものです。2の出題計画の1行。出題のネタの中身で、採用しなかった案や誤解は誤答に使うように指示します。ほかの問題ですでに正解にした中身の一覧で、同じものを正解にしないように伝えます。そして、1の設計図で決めた正解の記号です。
すると AI は、右のような問題を返してきます。これは説明のために私が作った例ですが、ケースカードの採用しなかった案が、選択肢 B の誤答になっています。
書けた問題は、次の4の検査と5の査読に回します。

4の検査は、プログラムがやります。左上のように、選択肢がちゃんと4つあるか、正解だけが目立って長くないか、解説が渡した資料だけを引用しているか、といった形をチェックします。左下は、似た問題のチェックです。前の問題と正解や問題文がよく似ていたら、「この正解と似ているよ」と名指しして、1回だけ作り直させます。
5の査読と修正では、AI に役割を分けて呼びます。解く役には、問題文と選択肢だけを渡して、正解は見せません。なぜ解かせるのかというと、解く役の答えが、1の設計図で決めた正解と一致すれば、問題文から正解が1つに決まると分かるからです。一致しなければ、問題文があいまいだと判断できます。採点する役には、正確さや、正解が1つに決まるかなど、5つの観点で点を付けさせます。
その結果を見て、プログラムが判定します。問題がなければそのまま使い、正確さが低ければ捨てて、それ以外の指摘があれば、直す役に直させます。直すときも、正解の記号は変えさせません。
査読をすると AI の呼び出しが増えるので、今は Gemini で本番模擬試験を作るときだけ、標準で動かしています。
では、最初の2つの課題が、どの段で解決したのかをまとめます。

最初にお見せした2つの課題が、どの段で防がれているかを並べてみました。
1つめの、正解の記号の偏りは、1の設計図で、プログラムが記号を均等に割り当てることで防いでいます。
2つめの、同じ正解が何度も出る問題は、いくつもの段で重ねて防いでいます。出題のネタで聞く材料を広げて、2の出題計画で試験全体の重なりを避け、3の作問ですでに使った正解を伝え、それでも残った似た問題は4の検査で作り直させます。
それに加えて、5の査読で、問題そのものの誤りも減らしています。
ここまでで、サイトの機能と、それを動かす仕組みをお話ししました。最後の章では、このサイトを公開したあと、どうやって安全に動かし続けて、直し続けているのかをお話しします。
TRACK 05 運用保守

最後の章は、運用保守です。前半の運用では、公開しているサイトを安定して動かし続けるために、何をしているか。後半の保守では、届いた不具合や要望を、1人でどうやって直し続けているかをお話しします。保守のところでは、AI に作業を任せる仕組み、エージェントの話をします。

このサイトは、誰でも無料で使えるように公開しています。なので運用では、2つのことに気を付けています。
1つめは、費用が膨らむことです。運営費は私の自腹なので、AWS の費用が想定を超えないように見張って、いざというときは止められるようにしています。
2つめは、公開している URL を悪用されることです。03 の章で見た Lambda の URL は、誰でも呼べてしまいます。図のとおり、ブラウザから AWS に届くところで守っています。
まずは1つめの、費用の話からです。

費用を見張ってから、受け付けを止めるまでの流れです。上の段がサイト運営者、つまり私がやること、下の段が AWS が自動でやることです。
左下から見ていきます。AWS Budgets で、月1ドルの予算を設定しています。実際の費用がその8割、0.8ドルを超えると、私にメールが届きます。
メールが来たら、費用の内訳を見て、想定外の増え方なのかを判断します。想定外のアクセスだったら、03 の章のデプロイのスライドでお見せした③のオプションで、テンプレートの AcceptSubmissions というパラメータを false にして、デプロイし直します。この値が、03 の章の handler の1で見た停止スイッチになります。
すると Lambda は、すべての送信に503を返すようになって、DynamoDB への保存も、GitHub への投稿もしなくなります。これで、費用はほとんど増えなくなります。止めている間も、サイトの配信は GitHub Pages ですし、AI は学習者のブラウザから呼んでいるので、学習の機能はそのまま使えます。止まるのは、感想と学習の記録の送信だけです。
原因に対処したら、true に戻してデプロイし直して、受け付けを再開します。
次は2つめの、悪用の対策です。
参考:infra/feedback/template.yaml

Lambda の URL は誰でも呼べるので、Lambda の中でいくつか対策をしています。
03 の章で見た handler の、2から4の確認を、悪用対策の目で分けると、この4つになります。まず、このサイト以外のページからの送信をはじきます。
次に、自動で投稿してくるボットを見分けます。人には見えない入力欄に何か書き込まれていないか、画面を開いてから送信までの時間が短すぎないか、で判断しています。
送れる文字数やリンクの数、画像の数にも上限を付けています。
最後に、同じ IP アドレスから送られてきた回数を DynamoDB で数えて、短い時間に送りすぎていたら断ります。
それから、悪用の対策とは別に、個人情報もできるだけ受け取らないようにしています。解答のログで受け取るのは、問題と選んだ答えの番号、正解かどうか、かかった時間だけです。問題文や答えの文章は受け取りません。送信元の IP アドレスも、そのままは保存せず、元に戻せない形に変えてから保存しています。
ここまでが運用です。ここからは保守、つまりサイトの不具合や要望に対応し続ける話です。

ここからは保守の話です。このサイトは OSS として GitHub で公開していて、誰でも Issue や PR を出せます。PR、プルリクエストは、コードの変更を提案して、レビューしてから取り込んでもらう仕組みで、取り込むことをマージと言います。取り込む先は main という、公開しているサイトの元になるブランチです。ただ、実際には、2026年の2月から開発してきたのは私1人です。この8か月で、マージした PR は169件、コードは学習データを除いて約2万5千行になりました。
1人でこれだけの量をこなせたのは、開発の大半を AI のエージェントに任せてきたからです。エージェントというのは、役割と手順を渡しておくと、自分でコードを読んで直して、確かめるところまで進めてくれる AI のことです。
公開したあとの保守では、2つの作業がずっと続きます。1つめは、要望と不具合の修正です。02 の章の「伝える」で学習者が送ってくれた感想は、03 の章で見た Lambda が GitHub の Issue にします。こうして Issue が届き続けます。2つめは、学習資料と出題のネタのメンテナンスです。AWS の公式資料は日々更新されるので、リンク切れや古くなった資料を差し替えて、04 の章で見た出題のネタも書き出し続ける必要があります。
どちらも、本業の合間にやっている1人では、とても手が足りません。そこで、この2つを、それぞれ別の AI エージェントに半自動で任せています。
これまでは、AI の開発ツールの定時実行の機能で、毎晩自動で動かしてきました。今はちょうど、使うツールを乗り換えている途中なんですが、このあとお見せするとおり、エージェントの定義はただのファイルなので、乗り換えても同じ仕組みが作れます。
では、2つのエージェントと人の分担を見てみます。
参考:Kenta-Matsuda.github.io-aws-study

人と GitHub とエージェントの分担を、3つの段で描きました。
上の段の左から見ていきます。学習者が感想を送ると、Lambda が GitHub の Issue にします。
いちばん下の段がエージェントです。決まった時刻に、毎晩自動で起動します。仕事は2つの列に分かれています。
上の列は、要望と不具合を直す仕事です。真ん中の段の Issue と、まだマージされていない PR を読んで、仕分けます。すぐには直せない Issue には「見送り」のラベルを付けて、新しい書き込みがあるまでは触りません。直せるものは、実装して検証します。AWS の操作のように、人にしかできない作業が見つかったら、人向けの作業の一覧に書き出して、先に進みます。
下の列は、学習資料を差し替える仕事です。AWS の公式資料を調べて、リンク切れや古い資料を見つけ、新しい公式ドキュメントに差し替えます。04 の章で見た出題のネタを書き出すのも、この仕事です。
どちらも、最後は PR にまとめます。そして最後に、その夜の作業を振り返って、自分の手順書を直す PR を、修正の PR とは別に出します。エージェントが自分で自分を改善していく、自己進化の部分です。ここは、このあとの「エージェントの失敗への対策」で詳しくお話しします。
人がやるのは、上の段の右の2つだけです。エージェントに禁止している AWS の作業と、PR をレビューして main に反映することです。
では、このエージェントに何をやらせて、何をやらせないのか。それを書いたファイルを見てみます。

じゃあ、エージェントは何で動いているのか。実は、Markdown のファイル1つなんです。AI の開発ツールの多くは、リポジトリの決まったフォルダに Markdown のファイルを置くと、それが1つのエージェントになります。左が、Issue を直すエージェントのファイルの抜粋です。これは、これまで使っていたツールの形式ですが、書く中身はどのツールでもほぼ同じです。
ファイルの先頭の①が、権限の設定です。AWS を操作するコマンド、履歴の書き換え、main への直接の反映は、実行しようとしても拒否されます。エージェントが自分の権限をゆるめることも禁止しています。やらせたくないことは、「やらないでね」というお願いの言葉ではなく、この設定で止めています。
その下の②が手順書で、普通の日本語の文章です。「あなたは、Issue を順に解決するエージェントです」から始まって、毎回やることを書いています。判断する前に、Issue と PR のコメントを全部読むこと。まだマージされていない PR への指摘や、main との競合に先に対応すること。直せる Issue を実装して検証し、PR を出すこと。人にしかできない作業は一覧に書き出して、止まらずに先へ進むこと。
つまり、新人さんに渡す業務マニュアルと、システムの権限設定を、1つのファイルにまとめたようなものです。資料をメンテナンスするエージェントも、同じ形のファイルをもう1つ置いているだけです。
こうして毎晩エージェントに任せていると、困ったことも起きました。エージェントも、人と同じように失敗するんです。

これは、エージェントが自分で書いた、失敗の記録からの抜粋です。
確かめもせずに「できない」と決めつけた。一部の PR をチェックし忘れた。テストが本当に不具合を見つけられるのかを確かめていなかった。実行環境を思い込んでいた。人に却下された表現を、言い換えてまた出してきた。どれも、人間の新人さんにもありそうな失敗ですよね。右の対策の列も、エージェント自身が書いたものです。
エージェントは、毎晩まっさらな新しい会話として起動します。何もしなければ前の夜の失敗を覚えていないので、同じ失敗を繰り返してしまいます。
じゃあ、右の列のような対策を、どうやって次の夜のエージェントに引き継いでいるのか。それが次の仕組みです。

同じ失敗を繰り返さないように、エージェント自身に、自分を直させています。私はこれを、自己進化エージェントと呼んでいます。エージェントには、毎回4つの仕事をさせています。1つめは、ここまで見てきた Issue の解決です。
2つめは、振り返りです。なぜ失敗したのかを考えて、さっきのスライドのような失敗と対策を、docs/wiki フォルダの記録のファイルに書きます。3つめは、スクリプト化です。PR のチェックのように、手で確かめると漏れが出る作業は、scripts フォルダのスクリプトにします。4つめは、対策を自分の手順書、つまり2つ前のスライドで見た定義ファイルに書き足すことです。どれもただのファイルの変更なので、PR としてレビューできます。
次の夜のエージェントは、この記録と手順書を最初に読んでから仕事を始めます。こうして、前の夜の失敗と対策が次の夜に引き継がれて、エージェントが夜ごとに賢くなっていきます。これが自己進化です。
ただし、エージェントが自分の手順書を書き換えるときには、決まりを設けています。必ず PR を出して、私のレビューを通すこと。禁止事項を削らないこと。権限をゆるめないこと。狙いとリスクを書き残すこと。
面白かったのは、手順書に書いたのにエージェントが守らなかった決まりへの対処です。手順書の言葉を強くするよりも、手順書の先頭のような、必ず読まれる場所に移すほうが効きました。
では、運用保守の章をまとめます。

運用保守の章をまとめます。何を AI がやっていて、何を人間が判断しているのか、という軸で整理してみました。
修正では、Issue の仕分けから、実装、検証、PR の作成までを AI がやります。私が決めるのは、その PR を main に反映するかどうかだけです。
資料では、リンク切れのチェックと差し替え、出題のネタの書き出しを AI がやって、私はそれが正しいかを確かめます。
改善では、失敗の振り返りと手順書の更新まで AI がやって、私はその変更を認めるかどうかを決めます。
AWS だけは、AI に操作させていません。デプロイや受け付けの停止は、私が判断して実行します。本番の環境やお金に直接響く操作は、それ自体が意思決定なので、あえて人がやっています。
作業は AI に任せて、人間は意思決定をする。1人でこのサイトを回せているのは、この分担のおかげです。これからは、こういう時代になっていくんじゃないかと思っています。

AWS認定合格ナビゲーターは、公式の資料で AWS 認定を学ぶためのサイトです。無料で、アカウントの登録もいらないので、今日からすぐ使えます。API キーが無くても解ける問題もあります。感想を送っていただければ、エージェントと私で直します。
ありがとうございました。
付録 AI 検索の仕組み

ここからは付録です。機能の章で少し触れた、資料を探す AI 検索の仕組みを、実際に検索したときの中身を使って説明します。
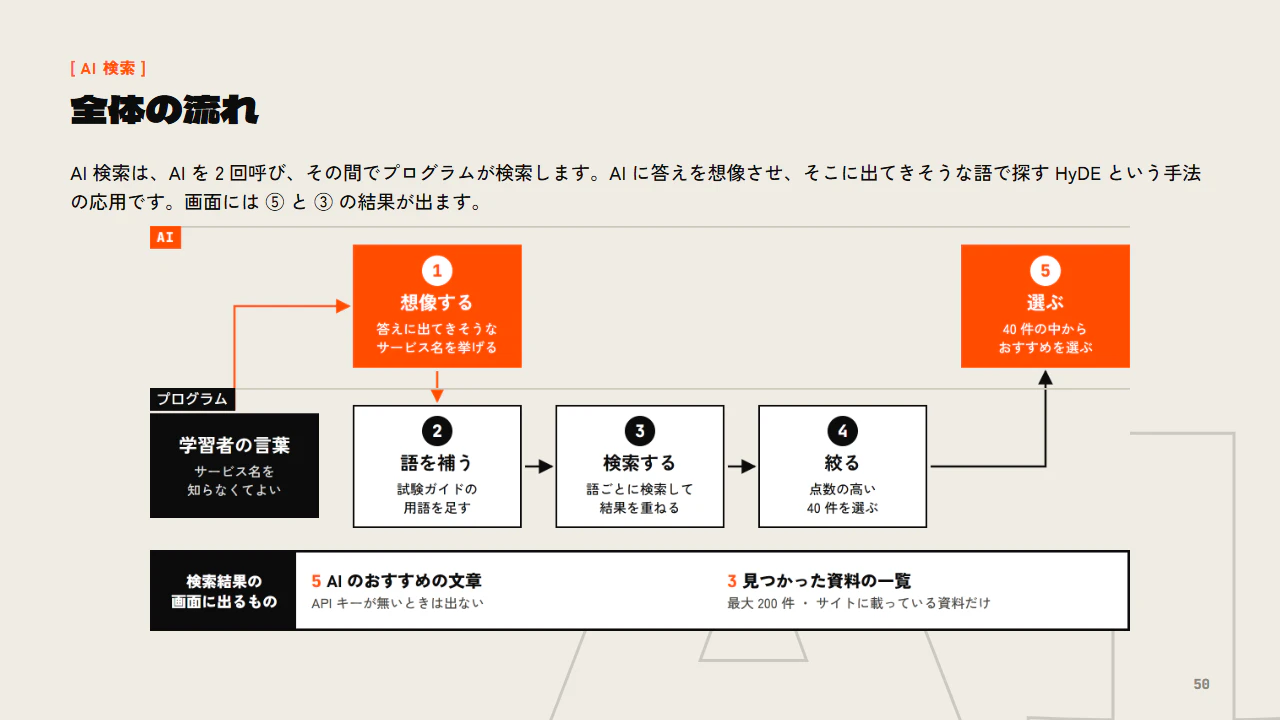
AI 検索の全体の流れです。オレンジの①と⑤が AI で、白い②から④がプログラムです。
この仕組みは、HyDE という手法を応用しています。Hypothetical Document Embeddings の略で、まず「答えはきっとこんな文書だろう」という仮の文書を作って、それを手がかりに探す手法です。本来は、文の意味の近さで探すベクトル検索で使う手法ですが、このサイトではキーワード検索に応用しています。
流れを順に見ます。①で、AI に学習者の質問への答えを想像させて、そこに出てきそうなサービス名を挙げさせます。②で、試験ガイドから作った用語の一覧を使って、検索に使う語を補います。③で、語ごとに検索して結果を重ね、④で点数の高い40件に絞ります。⑤で、AI がその40件の中からおすすめを選んで、理由を説明します。
検索結果の画面には、⑤の AI のおすすめの文章と、③で見つかった資料の一覧が出ます。

①で AI に渡しているのは、毎回同じ指示の文と、学習者が入れた言葉の2つだけです。サイトの資料や検索結果は渡していませんし、Web 検索のような道具も使わせていません。つまり AI は、自分がもともと学習している知識だけで、「この質問に答える資料には、こんなサービスが出てきそうだ」と想像して、サービス名を最大8語挙げます。このときは、SageMaker、Bedrock、Comprehend など8語が返ってきました。
②はプログラムの仕事です。試験ガイドの知識の項目から作った1,338語の用語の一覧から、①の語を含む用語を足します。たとえば Bedrock なら、Amazon Bedrock Guardrails のような用語です。AI が知らない新しいサービスも、試験ガイドに載っていればここで拾えます。元の言葉も必ず残して、全部で24語になったところで打ち切ります。
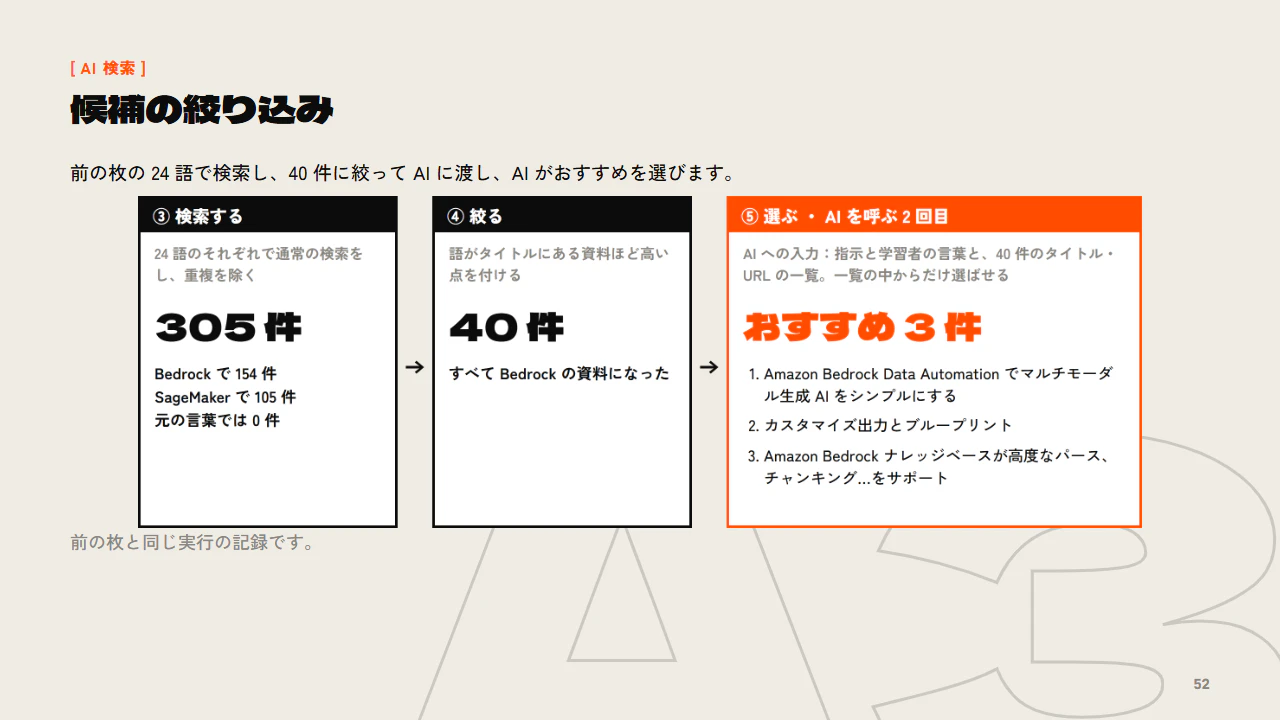
③では、24語のそれぞれで普通の検索をして、結果を重ねます。なお、機能の章の画面とは別の回に実行した記録です。AI が挙げる語は毎回変わるので、件数も変わります。元の言葉では0件でしたが、Bedrock で154件、SageMaker で105件などが見つかって、重複を除くと305件になりました。画面の一覧には、上限の200件までが出ます。
④で、AI に渡す40件に絞ります。24語を単語に分けて、資料のタイトルにあれば3点、URL にあれば2点、その他の欄にあれば1点、という形で点を付けます。このときは Bedrock を含む語が多かったので、上位40件は全部 Bedrock の資料になってしまい、SageMaker の資料は AI に渡りませんでした。
⑤で AI に渡すのは、指示の文と学習者の言葉、それから40件のタイトルと場所と URL の一覧です。この一覧の中からだけ選ぶように指示して、おすすめと理由を書かせます。このときは3件を選びましたが、2件目のタイトルを、一覧の「カスタム出力」から「カスタマイズ出力」に言い換えていました。

安全策は3つです。1つめは、元の言葉でも必ず検索すること。2つめは、一覧に出すのはサイトに載っている資料だけにすること。3つめは、AI が使えないときは普通の検索に戻ること。
限界も3つあります。1つめは、AI に渡す候補が、語の多いサービスに偏ってしまうこと。2つめは、「候補の中からだけ選ぶ」がプロンプトでの指示にすぎず、実際に言い換えも起きたこと。3つめは、待ち時間が長くて、結果が毎回変わることです。

出典の一覧です。この資料で参照した公式ドキュメントや記事を、ここにまとめています。
- AI 検索の設計:docs/issues/ai-search-hyde-201.md / exam-guide-hyde-209.md
- AI 検索のコード:js/resourceSearch.js / js/ui.js
- 問題生成のコード:js/examPipeline.js / js/examGenerator.js
- エージェント:github-issue-resolver.md / exam-content-maintainer.md
- AWS の部分:infra/feedback/template.yaml
- サイト制作の背景:α 版の記事 / β 版の記事 / 正式リリースの記事 / AIB-C01 対応の記事