
【翻訳記事】 本記事は、Alibaba Cloud Blog に掲載された以下の記事を英語原文から日本語に翻訳したものです。
- 原文:The First Data Foundation of the Agent Era: What Exactly Is the PolarDB Full-Stack Data Foundation for Agents?
- 著者:Sun Chuan(Hualuo)/ApsaraDB
- 公開日:2026年9月14日
※本訳文中の画像は、原文記事のものをそのまま使用しています(翻訳・加工はしていません)。
本記事では、プロダクション環境のAIエージェントにおけるメモリ・コンテキスト・実行を支える統合データベースソリューション「PolarDB Agentic Data Foundation」を紹介します。
エージェント時代に必要なのは、エージェントが「接続し、記憶し、検索し、実験し、ロールバックし、トレースし、弾力的に実行できる」データワークスペースです。Alibaba Cloud のクラウドネイティブデータベース「PolarDB for MySQL」は、そのワークスペースを支えるフルスタックのデータ基盤へと進化しつつあります。
チャットボットからエージェントへ:データインフラへの新たな問い
ここ2年間、LLMアプリケーションの主流形態はチャットボットでした。ユーザーが質問し、モデルが回答し、その過程でRAG(検索拡張生成)のレイヤーが追加のコンテキストを供給する——役割の境界は明快でした。しかし2026年に入ると、これに代わって、より本番志向の形態が台頭してきます。それがエージェントです。エージェントの核心は、もはや「会話」ではなく「行動」にあります。ゴールを理解し、タスクに分解し、ツールを呼び出し、ファイルを読み書きし、データベースにクエリを発行し、中間成果物を生成し、プランを検証し、自らのエラーを修正し、複数回の実行をまたいでメモリと経験を蓄積し続ける——これがエージェントに求められる姿です。

この変化は、データインフラに対して、従来のRAGをはるかに超える要求を突きつけます。エンタープライズグレードのエージェントには、本番レベルの一連の能力が必要です。すなわち、データベースへのセキュアなアクセス、タスク状態とビジネス上の事実の確実な保存、セッションをまたいで永続するプリファレンスと組織の経験、構造化・非構造化データを横断する統一的なコンテキスト想起、実データ上での隔離された実験、推論と呼び出しのトレースの完全な記録、短ライフサイクルタスクのオンデマンドで弾力的な実行、そして高頻度推論におけるレイテンシとコストの最適化です。
一言でいえば、エージェント時代のデータベースは、もはや「アプリケーションバックエンドにある1枚のテーブル」ではありません。それは、エージェントが動作するための状態プレーン(state plane)、メモリプレーン(memory plane)、コンテキストプレーン(context plane)、そしてワークスペースプレーン(workspace plane)なのです。
ポイントソリューションでは、本番レベルのエージェントを支えられない
業界でよく見られるやり方は、能力ごとに個別のシステムを導入することです。検索にはベクトルデータベース、メモリにはMemoryサービス、ファイルにはオブジェクトストレージ、Traceにはロギングプラットフォーム、業務データにはリレーショナルデータベース——そして、それらを大量のグルーコードで繋ぎ合わせる。プロトタイプ段階なら、これでも動きます。しかし本番環境では、問題が一斉に表面化します。
- 認証情報がエージェントのコンテキストに混入し、セキュリティ境界が失われる
- データが散在しているため、エージェントが一貫したコンテキストを持てない
- 権限・監査・テナント分離を、システムごとに再構築しなければならない
- バースト性のある短ライフサイクルワークロードでは、インスタンス単位の容量予約型コストモデルが無駄になる
- エージェントに本番データ上で直接実験させるリスクは到底受け入れられない
- コンテキスト・メモリ・ナレッジ・Traceが、いつまでもループを閉じない
PolarDB Agentic Data Foundation:全体アーキテクチャ
PolarDB Agentic Data Foundation は、Alibaba Cloud ApsaraDB がLLMエージェントのために構築した統合データインフラです。PolarDB for MySQL を唯一の基盤とし、Context、Memory、エンタープライズナレッジスペース、Vector、Search、Branch、In-Memory Column Index(IMCI)、Serverless、KVCache といったサブ能力を1つのプロダクト体系の中で提供します。さらに、プロトコル適合とセキュアなアクセスを担う統合Gatewayも備えています。

エージェントの8つのコアニーズを軸に、次の統合能力を提供します。
Access(セキュアなアクセス):エージェントは標準プロトコルである MCP(Model Context Protocol)経由で接続し、データベースのアドレス・アカウント・パスワードには一切触れません。OAuth がアイデンティティ認証を担い、サーバー側が認証情報を保持します。クライアント側が持つのは、スコープとライフサイクルが限定された MCP トークンだけです。Cursor、Claude、QoderWork といった主要クライアントから直接接続できます。

Context & State:Agentic Database が、エージェントの履歴コンテキストと状態を保存します。形態は2つ——Limitless(数百億レコード規模への水平スケール)と Agile Serverless(秒単位の弾力性、Scale to Zero)——で、統一された SQL とトランザクション整合性を提供します。
Memory(長期メモリ):PolarDB Mem0 は、インタラクションからエンティティ・リレーションシップ・プリファレンス・ファクト・経験を抽出し、ユーザー/エージェント/プロジェクト/組織という4つの次元で想起と進化を続けます。コンテキストエンジニアリングの長期メモリレイヤーとして、セッションをまたいで連続し、時間とともに進化します。つまり、新しいエージェントは組織の経験の上に立って仕事を始められるのです。
Knowledge & Research:統合されたエンタープライズナレッジスペース、ナレッジ資産のマルチモーダル解析、ハイブリッドなマルチウェイリコールが一体となり、コンテキストエンジニアリングにおけるエンタープライズナレッジ+リアルタイム検索レイヤーを構成します。Agentic Research は、問いを自律的に分解し、複数ラウンドを反復し、複数のソース間でクロス検証して、出典をトレース可能なリサーチレポートを生成します。

Branch(データベースレベルでの安全な実験):PolarDB Agentic Branch を使えば、エージェントは実データベースから隔離ブランチを素早く作成し、探索的な変更、プランの検証、並列 what-if 実行を行えます。失敗すれば破棄し、成功すれば永続化(コミット)できます。データベースはこうして、「結果を保存するだけの存在」から、エージェントの「実行可能なワークスペース」へと進化します。

Multi-tenancy & リソース分離:Resource Control は USER/DATABASE/CONNECTION/QUERY の4次元で CPU シェアを制限し、安全マージンを確保します。スロー SQL は即座にスロットリング可能です。マルチテナント機能は、同一クラスタ内でデータベース・アカウント・CPU の三重分離を実現します。本番データベースは暴走したエージェントを恐れる必要がなく、開発データベースはエージェント同士の干渉を恐れる必要もありません。

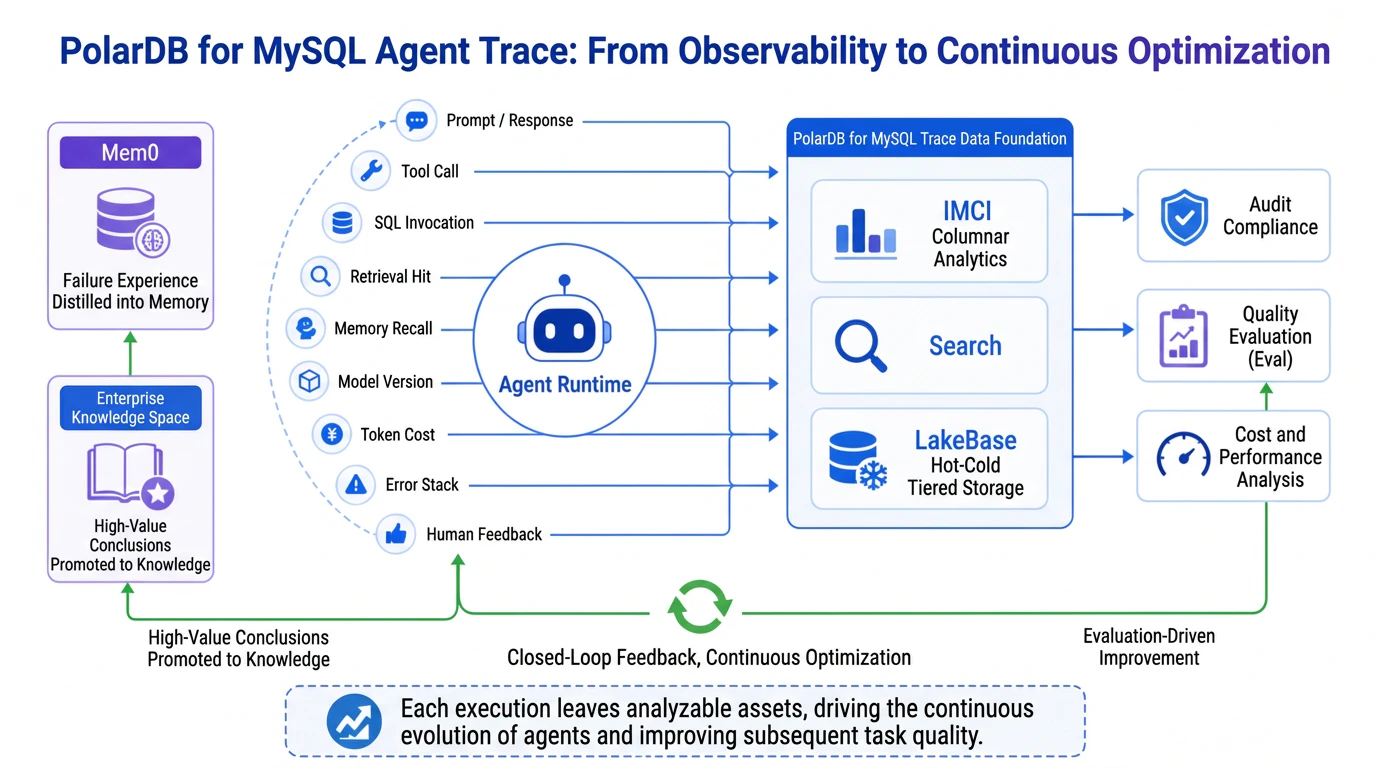
Trace(実行トレース):Prompt、Response、Tool Call、タスク DAG、Token 消費量、検索ヒット、メモリ想起、Eval 結果といった情報を、IMCI カラムナストレージと Search で保持し、ホット/コールド階層化でコストを制御します。これにより「監査→評価→最適化」のループが形成され、失敗ケースは Memory と Knowledge へ還流します。
Runtime(弾力的なランタイム):PolarDB Serverless は、PCU(PolarDB Capacity Unit)による秒単位の弾力性と Scale to Zero を提供します。Agent Workspace はオンデマンドで作成・実行・解放され、アイドル時のコストはほぼゼロです。

Inference(推論高速化):PolarKVCache は、Distributed Memory Pool(DMP)の上で、LLM 推論の KVCache を拡張・高速化します。データベースベンダーが推論インフラに踏み込む理由はこうです。KVCache は本質的に、高スループット・大容量・低レイテンシのキーバリュー型データシステムであり、分散メモリ、ホット/コールド階層化、共有ストレージといった領域で、データベースと同じ工学的ルーツを共有しているのです。

差別化のポジショニング:「積み上げ」から「収斂」へ
エージェントにとって、統一された基盤は「あれば嬉しい(nice-to-have)」ものではありません。「なくてはならない(must-have)」ものです。1つのセッションは、その時点のランタイムコンテキストであると同時に、再利用可能なメモリであり、学習コーパスでもあります。これを相互に独立したシステムへと切り分けてしまえば、データ本来の繋がりが断たれ、「実行し、記録し、振り返り、蓄積する」というループも止まってしまいます。統一されていることの本質は、複数のプロダクトを1つのプロセスに詰め込むことではなく、単一のガバナンス境界の中でデータを自然に流せるようにすることです。
PolarDB が選んだ道は、ポイントコンポーネントを作り直すことではありません。データベースレベルのガバナンス能力——データの主権境界・時間性・リレーションシップ——を、単一の MySQL 互換・クラウドネイティブ・エンタープライズグレードのデータ基盤へと収斂させることです。その基盤の上では、開発者は素早く連携でき、成果は再利用可能なアセットとしてそのままデータベースに着地し、高リスクな操作はまず隔離ブランチ上で検証されます。
まとめ
エージェントは、LLMアプリケーションを「表現」から「実行」へと押し進めています。本番環境に到達するすべてのエージェントには、接続し・記憶し・検索し・実験し・ロールバックし・トレースし・弾力的に実行できるデータワークスペースが必要です。PolarDB MySQL Agentic Data Foundation は、そのワークスペースを支えるフルスタックのデータ基盤です。
本記事は「PolarDB MySQL Agentic Data Foundation」シリーズの序章として、この新しい形の全体像を描きました。Access、State、Memory、Knowledge & Context、Branch とマルチテナント分離、Trace、Runtime、Inference——この8つの方向性について、技術的な詳細と実際のプラクティスを、今後の記事で1つずつ紐解いていきます。