

- Zoom AI Services の3API(Scribe / Summarizer / Translator)で 「AI伝言ゲーム」 をやった。文字起こし→要約→翻訳→また翻訳→…と最大12世代回して、情報がどこでどう死ぬかを実測
- 結果は予想外。無限には劣化しない(数世代で不動点に収束=
f(f(x)) ≒ f(x)のほぼ冪等挙動)、一番情報を落とすのは要約(生存率52%)、そして固有名詞は死ぬ(プロジェクト「大福」→ "O Fuku" → 消滅) - 実用CLI「ojigi」(録音→日英議事録+コストレシート)も公開(GitHub: azaminat/ojigi)。総コストはAPI 174回で ¥139.68、缶コーヒー1本でお釣りが来る
作ったもの:録音を置くだけで日英議事録とコストレシートを出すCLI
今回作ったのは ojigi というCLIです。
- 録音ファイルを渡す
- Scribeで文字起こし
- Summarizerで要約・決定事項・アクションアイテム抽出
- Translatorで英訳
- Slack通知
- usageからコストレシートを表示
つまり、Zoom AI Servicesの3 APIを実務の議事録フローに組み込むツールです。
ただし、ここで気になったのが「AIを多段につないだとき、情報はどこで壊れるのか?」でした。
そこで、このCLIに ojigi telephone という検証モードを追加し、AI伝言ゲームを行いました。
これは単なるAIおもしろ実験ではなく、Zoom AI Services の Scribe / Summarizer / Translator を多段パイプラインに組み込んだとき、品質とコストがどこでどう変化するかを実測した記事です。
はじめに:AIは伝言ゲームに強いのか?
子どもの頃の伝言ゲームを思い出してください。「隣のクラスの田中くんが犬を拾った」が、5人目には「田中先生が化けて出た」になっているアレです。
画像の世界にも似た話があります。「世代劣化(generation loss)」——JPEGを保存し直すたびにブロックノイズが積もり、VHSをダビングするたびに画が溶けていく、あの現象です。
いま会議の音声は文字起こしされ、要約され、翻訳されて海外チームに届きます。つまり現代の議事録は、AIによる伝言ゲームの産物です。では、テキストをAIに通し続けたら、JPEGと同じように溶けていくのでしょうか? 各段階の精度は個別にベンチマークされています。でも「繰り返し通したら何がどこで壊れるのか」を定量的に見た例は、あまりありません。
そこで Zoom AI Services の3つのAPIで実験しました。先に結果を1枚だけ見せます。
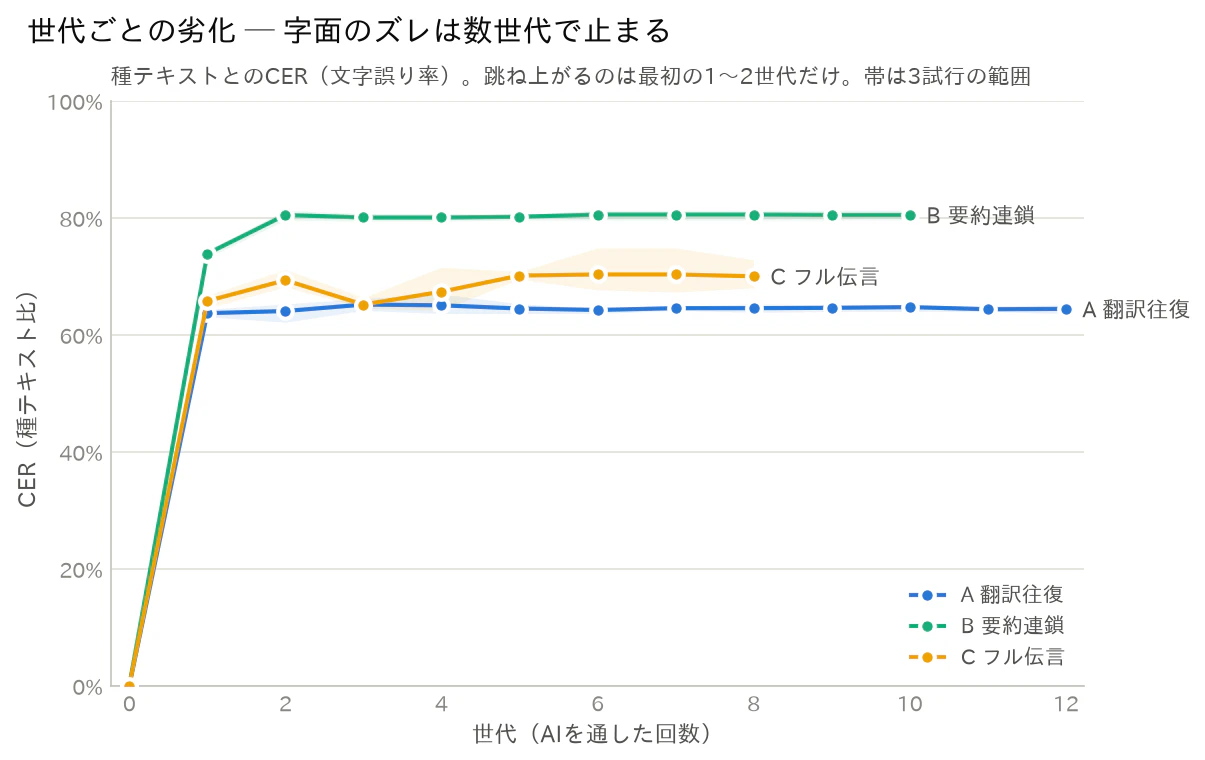
字面のズレ(CER)は最初の1〜2世代で跳ね上がり——その後ピタッと止まります。「回すほど壊れる」を期待していた身としては、これはかなり意外な形です。なぜこうなるのか、何が生き残って何が死ぬのかを、これから順番に見ていきます。
💡 この記事は Zoom AI Services の品質とコストを「伝言ゲーム」という枠組みで検証するものです。ふざけているようで、各APIの劣化特性がかなり真面目に見えてきます。
登場する3つのAPI(30秒で)
| API | 役割 | 課金単位 | 公称単価 |
|---|---|---|---|
| Scribe | 文字起こし(音声→テキスト) | 音声秒数 | $0.0033/分 |
| Summarizer | 要約・アクションアイテム抽出 | 入力文字数 | $0.40/100万字 |
| Translator | 翻訳(英語との双方向) | 入力文字数 | $7.50/100万字 |
Zoom Build プラットフォームのクレジット制で、新規登録で$20の無料クレジットが付きます(アカウント作成の手順は こちらの記事 がStep-by-Stepで丁寧です)。認証はJWT(後述のハマりポイント参照)。
※Summarizer/Translatorは公式製品ページの公称値。Scribeの単価のみ公開情報ベースのため、実際の消費はBuildダッシュボードで確認してください(本記事のコストはこの単価で換算)。
実験設計:劣化源を切り分ける3つの伝言ゲーム
「全部混ぜて回したら壊れた!」では検証になりません。どのAPIが劣化の犯人かを切り分けるため、3つの実験を用意しました。
| 実験 | ループ | 使うAPI | 何が見えるか |
|---|---|---|---|
| A 翻訳往復 | ja→en→ja→en→…(12世代) | Translator単体 | 翻訳の揺り戻し |
| B 要約連鎖 | 要約の要約の要約…(10世代) | Summarizer単体 | 要約の情報の取捨 |
| C フル伝言 | 音声→文字起こし→翻訳往復→再び音声化→…(8世代) | Scribe+Translator+TTS | 音声化を含む複合劣化 |
実験Cの「テキスト→音声」はZoom APIの守備範囲外なので、Amazon Polly(ja-JP, neural)を"伝言役の口"として使っています。A・BはZoom APIだけで完結する純粋な検証です。
なお、Cのループに要約は挟んでいません。挟むと「要約の取捨(実験B)」と「音声化・翻訳の劣化」が混ざって、どれが犯人か切り分けられなくなるからです。要約込みの挙動はBが単体で答えてくれます——つまり後で見るように、要約を含む現実の議事録パイプラインの劣化はB寄りに読むのが正解です。
やっていることは、本質的にこれだけです:
text = seed_text
for gen in range(1, 13):                    # 実験A: 翻訳往復
    en = translate(text, "ja-JP", "en-US")
    text = translate(en, "en-US", "ja-JP")
    measure(gen, text)                      # 字面のズレ / 意味の近さ / 生存ファクト
「このループ、回し続けたらどこに行き着くのか?」——それをひたすら測っただけの記事です。
種テキスト:罠を仕込んだ模擬会議
第0世代として、追跡用のファクト14個を意図的に仕込んだ模擬会議台本(597字)を用意しました。
- 決定事項3件: リリース日7月13日 / 追加サーバー費用 月3万円 / プレス配信 午前10時
- アクションアイテム4件: 山田→リリースノート7/5、田中→負荷テスト7/8、ジョン・キム→プレス原稿7/10、佐藤→顧客デモ
- 劣化しやすそうな罠: プロジェクト名「大福」(和菓子と同名)、恵比寿オフィス、同時接続1,200ユーザー、応答1.5秒以内、第3四半期
各世代で「このファクトはまだ生きているか?」を日英の表記ゆれ込みのキーワード照合で判定します(決定サバイバル率)。
測った指標
- 字面のズレ: 元の文とどれだけ文字が入れ替わったかの割合。0%なら一字一句同じ、100%なら原型なし(音声認識の評価で使う標準指標 CER=文字誤り率。NFKC正規化+jiwerで算出。グラフの縦軸はこれ)
- 意味の近さ: 字面が変わっても「言っていることは同じか」をスコア化したもの。1.0が同義(多言語文埋め込み paraphrase-multilingual-MiniLM のcos類似。日本語⇔英語間でも測れる)
- 決定サバイバル率: 台本に仕込んだ14ファクトのうち、何個がまだ本文に残っているか
- 各実験 ×3試行 して結果のブレも確認(グラフの帯)
結果①:伝言ゲームは無限には劣化しない
まず全実験共通の発見から。「1周でどれだけ字面が変わったか」(前世代とのCER)をプロットすると:
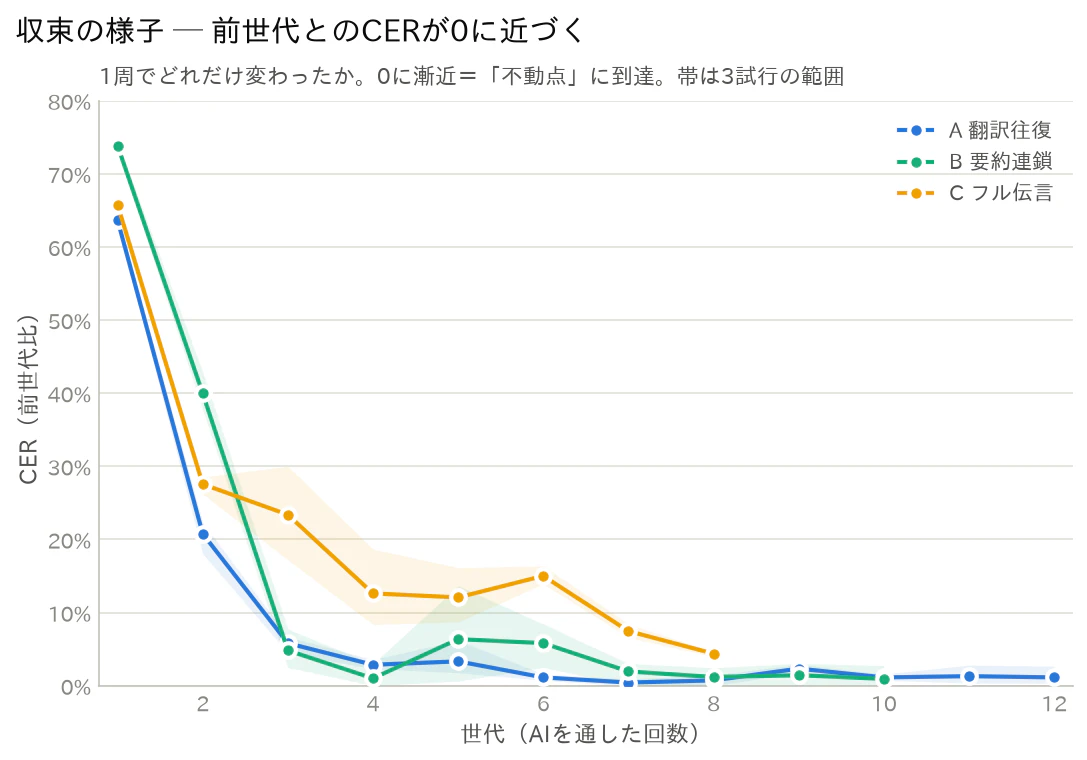
3実験すべて、数世代で0に漸近します。 つまり各APIには「これ以上変換しても変わらない表現」=不動点(fixed point)があります。テキストは数周で、そこに吸い込まれます。関数っぽく書けば、数世代後には f(f(x)) ≒ f(x)——繰り返すとほぼ冪等な振る舞いに落ち着くわけです。JPEGの世代劣化のように無限に溶けていくのではなく、アトラクタに捕まって止まる。
- 翻訳往復(A): 第1世代で63.7%変化 → 第7世代には0.4%。ja↔enの相互翻訳が安定なペアに落ち着く
- 要約連鎖(B): 第3世代以降ほぼ固定。「要約の要約」は2〜3回で最小表現に到達し、以降は同じ文を返し続ける
- フル伝言(C): 音声化のノイズが毎回入るため揺れは残るが、それでも第8世代には4.4%まで低下
「AIを何回も通すとどんどん壊れる」という直感は、少なくともこの3APIについては誤りでした。壊れるのは最初の1〜2世代で、その後は驚くほど安定します。
結果②:情報を一番落とすのは「要約」だった
では、その最初の1〜2世代で何がどれだけ死ぬのか。ファクト14個の生存率がこちら:
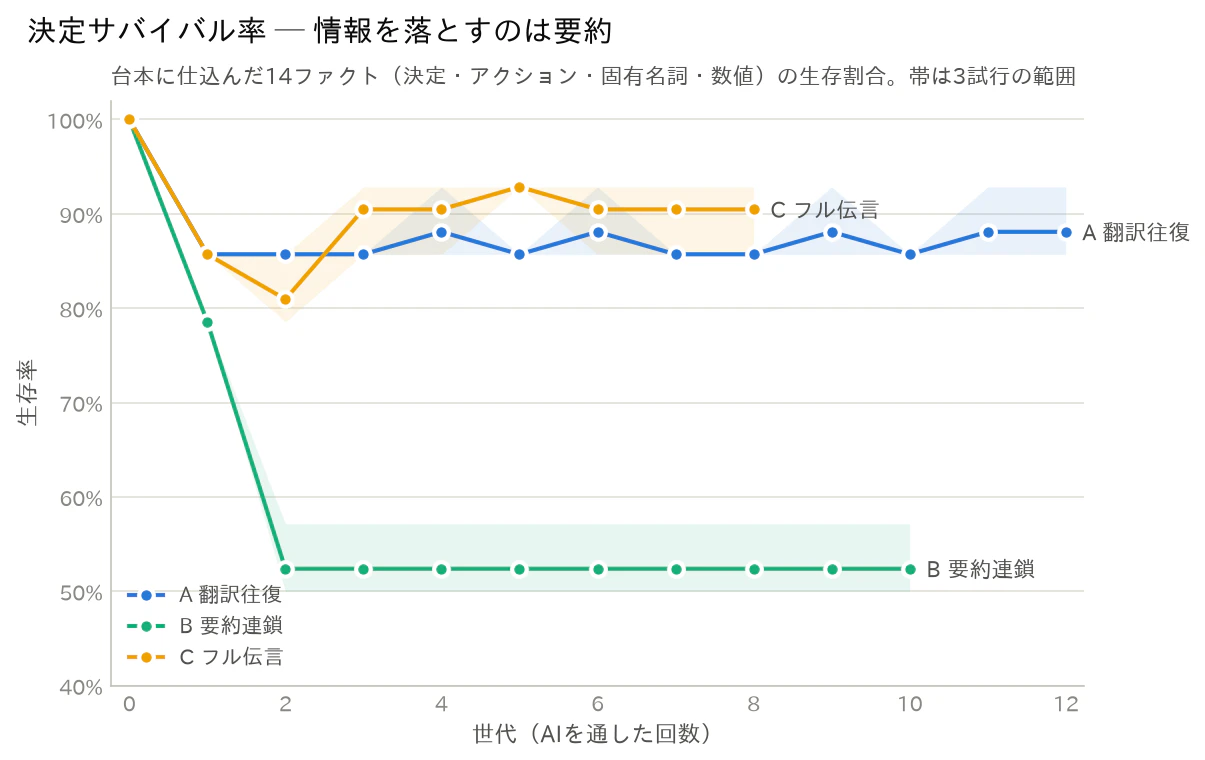
| 実験 | 最終生存率 | 落ちたもの |
|---|---|---|
| A 翻訳往復(12世代) | 85.7〜88.1% | 固有名詞「大福」など |
| B 要約連鎖(10世代) | 52.4% | 固有名詞・細かい数値(1,200ユーザー、1.5秒、第3四半期…) |
| C フル伝言(8世代) | 90.5% | 「大福」(翻訳段階で死亡) |
**最も情報を落とすのは要約(52%)**です。音声化→文字起こし→翻訳往復まで通すC(要約なし)が90%保持しているのと対照的です。逆に言えば、実運用の議事録パイプラインは途中に要約を挟むので、劣化の主戦場は音声でも翻訳でもなく要約の段だと分かります。
ただしこれはSummarizerの欠陥ではありません。ログを見ると、取捨選択には一貫した方針があります。残すのは決定事項・担当者・期限。捨てるのは固有名詞と細部の数値です。リリース日(7月13日)と担当者付きアクション4件は、3試行すべてで10世代後も生存していました。要約とは情報を捨てる技術なので、「何を捨てるか」の方針が測れたと言えます。
面白いのは、要約は2〜3世代で完全な不動点に達すること(597字→241字→180字→以降ほぼ同一文)。つまり summarize(summarize(x)) ≒ summarize(x)——Summarizerは実質的に冪等です。自分の出力を食わせ続けても、それ以上は削らない「最小の要約」で止まる。再帰的に突っ込んでも暴走しないという頑健性の証拠で、パイプライン設計者には地味に嬉しい性質です。
結果③:字面は6割変わるが、意味は保たれる
「字面の64%が入れ替わった」と聞くと壊滅的に見えます(冒頭のグラフで翻訳往復の線が64%あたりで止まっていた、あれです)。でも「意味の近さ」を見ると、別の景色になります:
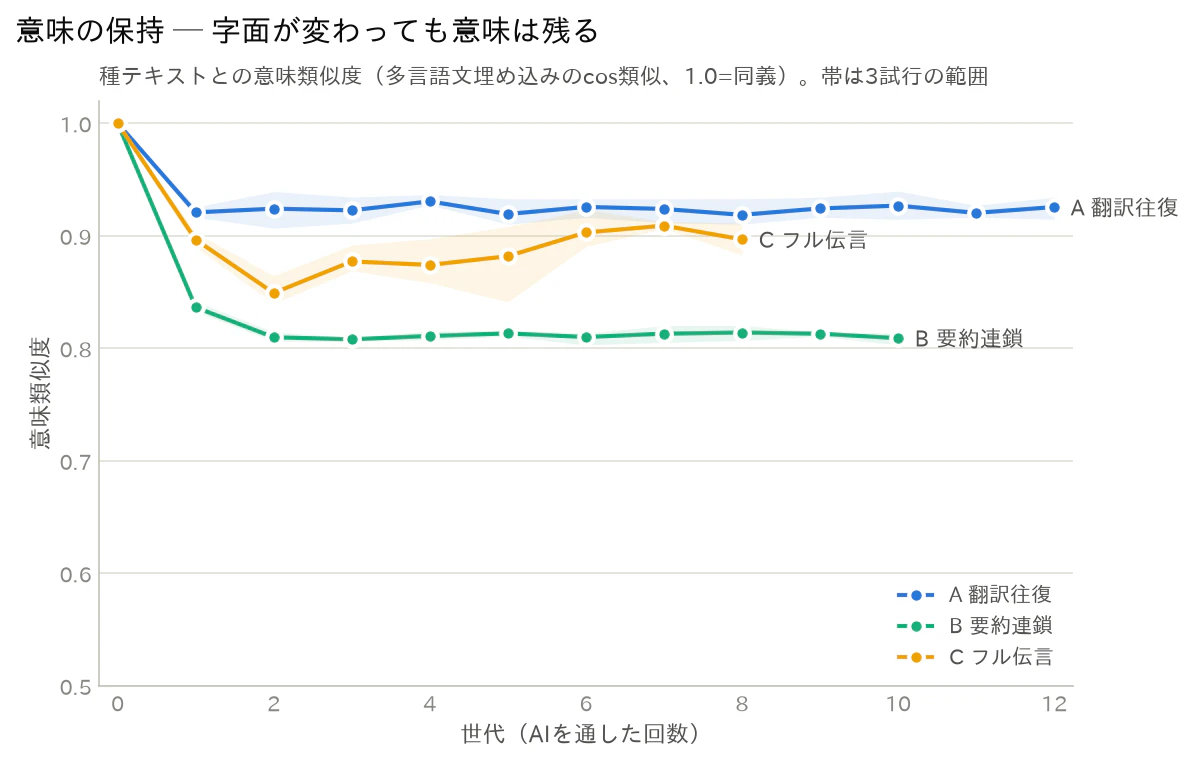
- 翻訳往復(A): 12世代後も意味の近さ 0.92を維持。語順や言い回しは大きく変わる(だから字面のズレは大きい)が、意味はほぼ完全に保存
- フル伝言(C): 0.90前後。音声化を挟んでもほぼ同水準
- 要約連鎖(B): 0.81。情報を捨てている分だけ低いが、これは要約として正しい挙動
つまりZoomの翻訳は「字面の忠実さより意味の等価性を優先する」タイプで、伝言ゲームには意外なほど強いことが分かりました。
誤変換ギャラリー:それでも事故は起きる
数字だけだと面白くないので、実際に起きた変異を見てください。
「大福」の死(全3試行で再現)
プロジェクト名「大福」は、翻訳往復の第1世代で即死します。
| 世代 | テキスト |
|---|---|
| 0 | 第3四半期のプロジェクト**「大福」**定例会議を始めます |
| 1(英訳) | ...quarterly project meeting for "O Fuku." ... |
| 1(往復後) | では、**『O Fuku』**の第3四半期プロジェクト会議を… |
| 2〜12 | O Fuku のまま永遠に固定 |
Translatorは「大福」を製品名と解釈し、和菓子の読み「おおふく…?」風のローマ字 "O Fuku" に変換。一度英語表記になると二度と漢字には戻らず、不動点に「誤訳ごと」焼き込まれます。壊れた値がキャッシュに載って、TTL無限でヒットし続けるようなものです。これは重要な示唆で、収束=正しさではないということ。間違った形で安定することがある。
フル伝言(音声経由)ではさらに残酷です。TTS→文字起こしまでは「大福」が生きているのに(ASRログで確認)、直後の翻訳で死亡。死因は音声ではなく翻訳でした。
恵比寿のゾンビ復活
フル伝言では「恵比寿オフィス」が第2世代で EBIS にローマ字化 → 第3世代で「恵比寿」に復活という珍現象も起きました。英語表記 "Ebisu office" が再翻訳で標準的な地名表記に戻ったためです。固有名詞でも辞書に載っている地名は強い。
会長、突然の出現
フル伝言 trial0 の第3世代では、感謝の挨拶が「ありがとうございます、会長。」に変異しました。会長など誰もいない会議です。聞き取りの揺れに、翻訳が気を利かせて敬称を足した合わせ技だと思われます。議事録に架空の役職者が出席する瞬間です。
生き残り王者たち
一方、翻訳往復とフル伝言では**「午前10時」「7月13日」「月3万円」等の数値+単位、「ジョン・キム」等のカタカナ人名が全世代で生存**しました。アラビア数字と日付は言語間でほぼ無傷に往復できます。
ただし例外が実験B(要約連鎖)。「午前10時」や「月3万円」が要約で消えた試行がありました。翻訳や音声化を生き延びる数値も、要約は「重要でない」と判断すれば容赦なく捨てます。「情報を一番落とすのは要約」——結果②の実例が、まさにこれです。
実務への教訓: 多段AIパイプラインに乗せるなら、漢字の造語・プロジェクト名は最初から英語表記を併記しておくと死なない。数値と日付は翻訳には強いが、要約を挟むなら「金額・時刻は必ず残す」等の指示が要る。
録音を置くだけで日英議事録+コストレシート ─ 検証ツール「ojigi」も公開
この実験を支えたのが、イベントのお題に沿って作った議事録CLI「ojigi」です(検証機能telephoneも同梱)。
# 録音を置くだけで日英バイリンガル議事録 + コストレシート
uv run ojigi minutes meeting.m4a --slack
- Scribe→Summarizer→Translatorをオーケストレーションし、要約・決定事項・アクションアイテムの日英議事録MarkdownとSlack通知を出力
- 全API呼び出しのusageを
usage_ledger.jsonlに記録し、実行のたびにコストレシートを表示:
       💰 コストレシート(公称単価ベース)
┌────────────┬────────────────┬─────────┬────────┐
│ API        │ 使用量         │     USD │ 円換算 │
├────────────┼────────────────┼─────────┼────────┤
│ Scribe     │ 音声 0.8分     │ $0.0026 │  ¥0.39 │
│ Summarizer │ 入力 266文字   │ $0.0001 │  ¥0.02 │
│ Translator │ 入力 387文字   │ $0.0029 │  ¥0.44 │
│ 合計       │                │ $0.0056 │  ¥0.84 │
└────────────┴────────────────┴─────────┴────────┘
(usage_ledger.jsonl の実測値そのまま。要約は本当に安い)
48秒の会議の日英議事録が¥0.84。伝言ゲームは:
uv run ojigi telephone examples/telephone_seed.md --mode roundtrip -g 12 -t 3 --facts examples/telephone_facts.json
で誰でも再現できます(結果JSON+世代別メトリクス表+コストレシートが出ます)。この記事で使った種テキストとファクト定義もリポジトリの examples/ に同梱してあります。
コスト検証:174回叩いて¥139.68
この記事の全実験(3実験×3試行、API呼び出し174回)の実測合計:
| API | 使用量 | USD | 円換算 |
|---|---|---|---|
| Scribe | 音声 38.1分 | $0.1257 | ¥18.85 |
| Summarizer | 入力 6,844文字 | $0.0027 | ¥0.41 |
| Translator | 入力 107,033文字 | $0.8027 | ¥120.41 |
| 合計 | $0.9312 | ¥139.68 |
注目はコスト構造です。Translatorが86%を占めます。単価が Summarizer の19倍($7.50 vs $0.40 /100万字)あるためで、翻訳往復実験はほぼ翻訳代。逆に言うと:
- 要約は事実上タダ同然(10世代連鎖して¥0.41)
- 60分会議(≒15,000字)に外挿すると、議事録1本 = Scribe ¥30 + 要約 ¥1 + 要約英訳 ¥2 ≒ ¥33。全文英訳を足すと+¥17
- 人力の議事録外注(¥5,000〜/時)や翻訳(¥3,000〜/千字)と比べると誤差みたいな金額
「品質検証のためにAPIを174回無駄遣いする」という贅沢が缶コーヒー1本分でできる時代です。
実装のハマりポイント(再現したい人向け)
1. JWT認証のKey/Secretは「Build プラットフォーム」のもの
Marketplace アプリの Client ID/Secret ではない。zoom.us → Plans and Billing → Universal Credit → Build App → API keys で取得する。JWTは HS256、iss=API Key、expは最長1時間。ここで30分溶かした。
2. Scribeは音声を「URL」でしか受け取らない
multipartアップロード不可。ローカルファイルはS3にアップロード→**署名付きURL(短TTL)**を渡し、文字起こし後に即削除する構成にした。拡張子のないURLは415になるのでファイル名は保持すること。
3. 話者分離(diarization)はja-JP非対応
"diarization": true を日本語で送ると 400 INVALID_INPUT("Diarization is not supported for locale 'ja-JP'")。英語では動作を確認済み。日本語対応が来たら議事録の話者ラベルが一気に良くなるはず。
4. Summarizerのresultフィールドはtaskで揺れる
full_summaryは「# Recap / # Summary / # Action Items」のMarkdown文字列1本で返る(構造化JSONではない)。taskごとにsummary_text/text等キーが揺れるためフォールバック参照が必須。
5. Translatorは英語との双方向のみ・4,000字制限
対応は英語⇔他言語の組み合わせのみ。ja→fr のような直接翻訳はできず、やりたければ自前で英語を経由させることになる(=多言語展開は必然的に「伝言ゲーム」になる。今回のja↔en往復実験がそのまま実運用の劣化モデルなのはこのため)。長文は段落単位のチャンク分割が必要。
6. usageオブジェクトは全APIで取れる(コスト実測の要)
{"input_units": N, "output_units": N, "unit_type": "seconds"|"characters"} が返る。Translatorのinput_unitsは入力文字数と完全一致することを確認済み。これをフックで全部JSONLに落とすとコストレシートが作れる。
この検証の限界
公平のために、この実験で言えないことも書いておきます。
- サバイバル判定はキーワード照合(日英の表記ゆれ込み)なので、保守的に出ます。実際、「顧客デモ」が「顧客向けデモンストレーション」に言い換えられて「消失」扱いになった試行がありました(意味は完全に生きている)。生存率の実態は表の数字より少し高いはずです
- 種テキストは1種類(模擬会議597字)、各実験3試行。ジャンルや長さが変われば数字は変わります
- 実験Cの音声はAmazon Pollyのクリーン音声。実会議の雑音・かぶり発話ではScribeの劣化はもっと大きいはずで、Cの結果は「音声経由の下限側」と読むべきです
- 「意味の近さ」スコアは多言語埋め込みモデル(paraphrase-multilingual-MiniLM)に依存した推定値です
まとめ:審査基準どおりに振り返る
品質: Zoom AI Servicesは伝言ゲームに予想外に強い。翻訳は意味の近さ0.92を12世代維持、要約は3世代で安定する不動点を持ち、決定事項を優先保存する。弱点は漢字の造語系固有名詞(大福→O Fuku)で、誤訳ごと不動点に固定されるリスクがある。この検証の一番の持ち帰りはこれです——収束は正しさを意味しない。 安定して見える出力が、間違いごと安定していることがある。ずっとグリーンのまま仕様を間違えているテストと同じで、「落ちない」は「正しい」の証明にならないのです。
コスパ: 議事録1本¥1未満〜60分会議でも¥33程度。検証で174回叩いても¥139.68。要約はほぼ無料、コストの主役は翻訳(単価19倍)。
実験コード・ツールはすべて GitHub(azaminat/ojigi) で公開しています。ojigi telephone であなたの会社のプロジェクト名が何世代生き残るか、ぜひ試してみてください。「大福」はダメでした。
(付録)生データ・全世代テキスト・グラフの元データはリポジトリの article-data/ を参照(3実験×3試行の全世代JSON・集計表・グラフ)。種テキストとファクト定義は examples/ に。