
はじめに
個人で「もくもく問題集」というクラウド資格の問題集アプリを開発しています。
環境づくりから開発・作問に至る全てをClaude Codeにほぼ任せており、サブエージェントは今12体です。10月以降だけで、起動は延べ4,130回です。
リリースまでの仕組みが作られているため、一定の品質を維持した状態で処理を任せきりにできる一方、コスト効率は正直良くないと感じています。(Proだと20問程度で5Hセッションを食い潰す...)
この「コスト」の主な原因が同じ前提を読み込み直すだけの往復のせい?と疑っていたところ、Anthropicが2026年10月22日、サブエージェントをメインのループに畳む(1つのループにまとめる)ためのガイド(以下、畳むガイド)を公開しました。ここでの「畳む」(原文はfold)は、サブエージェントをなくし、プロンプトはスキルに、API呼び出しはツールに移して、メインのループに取り込むことです。
もともと自分には、「1Mトークンのコンテキストが使える今、特別な理由がなければ分けなくてよいのでは」という仮説がありました。分けるとエージェントごとにCLAUDE.mdやツール定義を読み込み直すぶん、トークンを余計に使うからです。
そこで今回は、畳むガイドと経緯を調べ、自分のセッション記録から12体のトークンを数えてみました。先に書いておくと、仮説は半分当たりで半分外れです。
※だいぶ長文となったため記事は2本に分けます。
- 前編(本記事):調査と判断基準、今の12体の集計。手元のセッション記録を読むだけで、追加の実験はしていません
- 後編:同じタスクを「分ける / 一部だけ分ける / 分けない」で回し、コストと出来を比べる
Claude Codeでサブエージェントを何体も作っていて、このまま分けておいてよいのか気になっている人向けの記事です。
なお、畳むガイドは企業がClaude Platformでエージェントを組む場面向けの記事です。12体への当てはめは自分の解釈として読んでください。
本記事の情報は2026年11月時点のものです。Claude Codeは2.1.296〜2.1.318の記録を、2.1.319で集計しています。
記事中の費用は、Claude APIの定価でトークン数から計算した「APIで回したらいくらか」の見積もりで、Maxプランの実際の請求額ではありません。
また、最新情報については公式ドキュメントをご確認ください。
この記事でわかること
- Anthropicの畳むガイドが勧めていることと、それでもサブエージェントを残す場面
- サブエージェントに分けるやり方が広まった経緯と、今の公式の見解
- 自分のサブエージェントを1体ずつ「残す / 畳む」に仕分けるときの目安
- Claude Codeのセッション記録から、サブエージェントごとのトークンとAPI換算の費用を数える方法
先に結論
仕分けの目安です(出典つきの表は3. 分けたほうがいい場面・分けなくていい場面)。
| 判定 | サブエージェントの分け方 |
|---|---|
| 畳む | 役割で分けた役(コーダー / テスター)、手順やルールを持たせただけの役(スキルに移す) |
| 残す | 大量に読んで結論だけ返す調査役、作成役と別の検査役(レビュアーなど)、権限で分けた役、並列に回す役 |
| 後編で測る | 安いモデルに回すために分けた役 |
自分の12体の集計結果(2026年10月以降の20セッション、API換算で合計$1,818.96)はこちらです。
- サブエージェントの費用:29.4%($534.40)
- メインのループの費用:70.6%($1,284.56)
- いちばん高い役:$121.41(question-verifier。Opus 5.5で1,452回起動)
サブエージェントがトークンを食っていると思っていたのですが、費用の7割はメインでした。
一方で、短い検証をOpusの役に2,000回以上投げているところでは、起動分(起動の最初の応答で読み込む入力。1回約1万トークン)が費用の半分近くを占めていました。
分けるか畳むかより先に、どの役をどのモデルで動かし、どれだけ読ませているかを見直すべきだった、というのが前編の結論です。
(※自分の1リポジトリ・20セッションだけの集計なので、あくまで参考値です。)
1. Anthropicの「サブエージェントを畳む」ガイドの中身
畳むガイドの原題は「Building agents: When to fold subagents into your main agent loop」です。日本語版は本記事作成時点ではないため、引用の和訳は自分で訳したものです。
何を勧めているか
畳むガイドが勧めているのは、1つのループに必要なときだけ読み込むスキルとツールを持たせる形です。チームや問題の種類ごとにサブエージェントを作る分け方には否定的で、原文ではこう書かれています(以下引用)。
But too often we see enterprises give each team or problem type its own subagent, with the agent architecture becoming a copy of their org chart (Conway's law at work).
要するに、組織図を写したエージェント構成はうまくいかない、という話です。
自分の12体も作問の工程表をそのままエージェントにした形なので、少し耳が痛かったです...。
理由には、受け渡しのたびに細部が抜け落ちることと、遅延が増えることが挙がっています。「畳むと2倍速くなる」という紹介も見かけますが、畳むガイドにあるのは「ある顧客が単一のループに変えたら実行時間が約2倍速くなった」(翻訳)という匿名の1社の話だけで、品質やコストは書かれていません。
それでも残す3つの場面
サブエージェントを使う条件は以下3つです(翻訳)。
- 単一のループで、コンテキストの肥大による性能の低下が測れる形で出ている
- 複数のタスクを、終わったら捨てられる新しいコンテキストで並列にこなす必要がある
- 適切なツールを選べない、またはシステムプロンプトの指示が衝突している
原文では1つ目にわざわざ「measurable(測れる)」と付いているので、「長くなりそうだから念のため分けておく」は理由にならない、と自分は読みました。12体のトークンを数えたのも、この一語があったからです。
畳み方
先に小さな評価(正解つきの例10個から)を作り、プロンプトはスキルに、API呼び出しはMCPツールに置き換えて1体ずつ畳み、評価を比べる手順です。同じタスクは複数回回すように(2回に1回しか出ない失敗もあったため)、とも書かれていて、後編で各構成を3回ずつ回すのはこれに合わせました。
一度に全部を移さなくてよいそうで、12体を抱えている身としてはありがたいです!
2026年1月のmulti-agent記事
2026年1月23日の「Building multi-agent systems: when and how to use them」(以下、multi-agent記事)も向きは同じで、まず単一のエージェントで始め、複数にして得をするのはコンテキストの保護と並列化と専門化の3つの場面だけ、という整理です。
2. なぜ今までサブエージェントに分けてきたのか
もくもく問題集で作問の工程ごとにサブエージェントを分けたいちばんの理由は、書く役と確かめる役を分けたかったからです。書いた側の思い込みを引き継がない確認役が欲しくて、作成役と検査役、作問なら下書き・検証・判定と、役を分けていきました。
背景にあったのは、「調べものや検査はサブエージェントに任せて、メインのコンテキストを軽く保つ」というアドバイスです。
このアドバイスの出どころを、公開日を一次情報で確認できたものだけで並べました。
| 日付 | 出来事 | 書かれていたこと |
|---|---|---|
| 2025-06-13 | Anthropicの研究システムの記事 | サブエージェントが並列に調べて圧縮して返す。トークンはチャットの約15倍 |
| 2025-07-24 | Claude Code v1.0.60 | カスタムサブエージェントが登場(日付はnpmの公開日時) |
| 2025-09-29 | Anthropicのコンテキストエンジニアリングの記事 | サブエージェントはまっさらなコンテキストで調べ、要約だけを返す |
| 2026-01-23 | multi-agent記事 | まず単一から。トークンは単一でやる場合の3〜10倍 |
| 2026-03-13 | 1Mコンテキストが一般提供 | Opus 4.6とSonnet 4.6から |
| 2026-10-22 | 畳むガイド | スキルとツールを持つ1つのループへ |
2025年は、Anthropic自身が「サブエージェントでメインのコンテキストを守る」を勧めていた時期でした(研究システムの記事自身は、コーディングは研究より並列化できる作業が少ない、と書いています)。
1Mが使えるようになったあと
今のClaude Codeでは、Opus 4.7以降、Sonnet 5以降、Haiku 5.5がデフォルトで1Mのウィンドウで動きます(参考:Model configuration)。ただしHaiku 5.5は、プロンプトが100Kトークンを超えるリクエストだけ単価が上がります(セッション記録と単価の表の下に書きました)。自分のメインも1リクエストあたり平均約39万トークンを読んでいて、200Kにはとても収まりません。
Claude CodeのBest practicesには「What you can stop doing(やめてもよいこと)」という節があり、「サブエージェントでコンテキストを守れ」が昔のアドバイスとして挙がっています(参考:Claude Codeのベストプラクティス)。
コンテキストが足りなくなることは、もはやほとんど問題になりません。サブエージェントは並列作業、ノイズの多い出力の切り離し、独立したレビューには今でも非常に有用ですが、どれも追加のトークンがかかります。
自分の仮説とほぼ同じことが、公式ドキュメントにそのまま書いてあり確信しました笑。
とはいえ、Claude APIのドキュメントでは、トークン数が増えるほど精度が下がる現象を「context rot」と呼んでいます(参考:Context windows)。1Mあるから何でも1つに入れてよい、ではないので、自分のメインで出来が落ちていないかは後編で確かめます。
3. 分けたほうがいい場面・分けなくていい場面
畳むガイドとAnthropicのほかの公式ドキュメントにある判断材料を、分け方のパターンごとに表にしました。「Claude Codeのこの役を畳め」と書いたドキュメントはないので、判定は自分の解釈です。
分け方ごとの判断表
「Best practices」は2. なぜ今までサブエージェントに分けてきたのかで引用したページ、「サブエージェントのドキュメント」はこちらです。
| 分け方 | 畳める条件 | 判定 | 根拠 |
|---|---|---|---|
| 役割で分ける(コーダー / テスター) | フェーズの間で同じ文脈を使う | 畳む | multi-agent記事、サブエージェントのドキュメント |
| 調査で分ける(大量に読んで結論だけ返す) | 読む量が少ない、または読んだ中身をメインでも使う | 残す | multi-agent記事、Best practices |
| 作成役と検査役 | 検査をlintやテストのコマンドに置き換えられる | 残す | 畳むガイド、multi-agent記事、Best practices |
| 権限で分ける(読み取り専用の役) | 権限を絞る必要がない | 残す | 畳むガイド、Best practices |
| モデルを変える(Haikuに回す) | メインと同じモデルで動いている | 後編で測る | サブエージェントのドキュメント |
| 並列に回す | 1件ずつ順番に処理しても困らない | 残す | 畳むガイド、Best practices |
| 手順やルールの切り出し | 手順をスキルにしてメインで読み込める | スキルにして畳む | 畳むガイド、サブエージェントのドキュメント |
役割で分ける行の根拠は、multi-agent記事の次の部分です(翻訳)。
ソフトウェア開発の役割(planner、implementer、tester、reviewer)で専門化したエージェントの実験では、サブエージェントが実際の作業よりも調整に多くのトークンを使いました。
ただしレビュアーは「作成役と検査役」の行に入れました。Best practicesに「新しいレビュアーは役立ちますが、それはユーザーの推論を見ていないからであり、委任とは別の話です」とあるためです。書いた側の推論を見ていない目として働いているなら残し、作業の続きをさせているだけなら畳む、と決めました。
サブエージェントが起動時に持つもの
フォークでない通常のサブエージェントには、親の会話も親が読んだファイルも渡らず、前提は親が書く委任メッセージだけです。そのうえで起動のたびに、CLAUDE.md、git status、ツール定義など(組み込みのExploreとPlanはCLAUDE.mdとgit statusを読みません)と、システムプロンプトとしてエージェント定義の本文を読み込みます。
Claude Code本体のシステムプロンプトを丸ごと流し直していると思い込んでいましたが、そこは違いました。
プロンプトキャッシュも親とは別で、TTLは5分です。同じ役を間をあけて呼ぶと、次の起動はキャッシュの書き込みからやり直しになります。親の会話ごと引き継ぐフォークだけは親のキャッシュを共有し、フォークはv2.1.302以降(対話端末ではv2.1.232以降)はデフォルトでオンです(参考:サブエージェントとキャッシュ)。自分が集計した記録(2.1.296〜2.1.318)はどれも対話セッションで、全期間でフォークがオンだったので、5. 20セッションを集計した結果でフォークが混じっていないかを確かめています。各エージェントの description も常にメインに載っていて、合計が15,000トークンを超えると警告が出ます。
自分の12体のdescriptionは合計で約1,700字なので、この目安には届きません。
4. もくもく問題集の12体を測る方法
測ったのは、もくもく問題集のリポジトリで2026年10月1日以降にサブエージェントを1回以上起動した20セッションです。どれもMaxプランの対話セッションで、メインは19セッションがOpus 5.5でした。
12体の一覧
| エージェント | 役 |
|---|---|
| commit-writer | コミットメッセージ案を書く |
| draft-writer | PR・Issueの本文を下書きする |
| inspector | 差分の機密情報を検査する |
| inspector-deep | inspectorと同じ検査をSonnetで行う |
| guide-extractor | 試験ガイドから出題範囲を抜き出す |
| source-scout | 出典にする公式文書の候補を挙げる |
| fact-extractor | 公式文書から参考情報を抜き出す |
| question-drafter | 問題を下書きする |
| question-verifier | 出典を読み、下書きの正誤を確かめる |
| question-judge | 公開中の問題を判定する |
| question-reviser | 保留になった問題を直す |
| notebook-reviser | 体系ノートの文体を直す |
モデル(すべて5.5世代)は5. 20セッションを集計した結果の表に載せています。guide-extractorからquestion-reviserまでが作問パイプラインの役です。記録には組み込みの general-purpose と Explore(メインと同じOpus)、以前の実装役 impl-app と impl-infra も残っていたので、集計に含めました。
セッション記録と単価
公式の /usage は直近7日までの割合しか出ないので(参考:Claude Codeのコスト管理)、役ごとの金額と起動分の読み込み量を出すスクリプトをPythonで書きました。
サブスクで回していても、~/.claude/projects/ の下のjsonlに応答ごとのusageが残ります。サブエージェントは subagents/agent-*.jsonl に分かれていて、隣の .meta.json の agentType に役の名前が入っていました(公式の仕様はなく、実物を見た限りです)。
jsonlは内部形式なのでバージョンによって変わる、と公式ドキュメントにあり、記録も30日で消えます。スクリプトは2.1.319で動かしたもので、集計値はJSONに残しました。
単価はClaude APIの公式料金です(100万トークンあたりのUSD、2026年11月8日時点)。
| 種類 | Opus 5.5 | Sonnet 5.5 | Haiku 5.5 |
|---|---|---|---|
| 入力 | 4 | 2 | 0.10 |
| キャッシュ書き込み(5分) | 5 | 2.50 | 0.125 |
| キャッシュ書き込み(1時間) | 8 | 4 | 0.20 |
| キャッシュ読み込み | 0.20 | 0.10 | 0.01 |
| 出力 | 20 | 10 | 0.50 |
(参考:Claude APIの料金)
Haiku 5.5は、プロンプト(キャッシュ込み)が100Kトークンを超えるリクエストだけ、入力$0.50 / 出力$2.50 / キャッシュ読み込み$0.05などの単価で計算されます。
キャッシュの書き込み(5分)と読み込みでは、単価がOpus・Sonnetでは25倍(Haikuは12.5倍)違うので、トークンの割合と費用の割合はずれます。キャッシュ書き込みは記録どおり、メインは1時間、サブエージェントは5分で数えました。全部5分で数え直しても(合計$1,747.82)、メインの割合は69.4%で結論は変わりません。
重複除去でハマったところ
jsonlは1つの応答をcontentブロックごとに別の行で記録し、どの行にもusageを付けます。ただし、値が同じとは限りません(手元の記録では、同じ応答の行どうしで output_tokens が違う組が4,561ありました)。自分は最初、message.id ごとに最初の行を残していて、出力トークンを少なく数えていました。Agent SDKのドキュメントにあるとおり、最初の行の output_tokens は応答を生成する前の仮の値のことがあるからです(jsonlについての記述ではありませんが、同じ組み立て方だと考えました)。手元の記録でも、最初の行では16だった応答が、最大の行では217です。
output_tokens が最大の行を残すように直して対象の20セッションを数え直すと、出力トークンは2,528万から2,898万になりました。1度目の計測では12.8%少なく数えていたことになります。
# message.id ごとに output_tokens が最大の行を残す(最初の行は仮の値のことがある)
key = msg.get("id") or d.get("requestId") or d.get("uuid")
u = parse_usage(usage)
if key not in best or u.output > best[key][1].output:
    best[key] = (model, u)
念のため、claude -p --output-format json を1回だけ回して照らし合わせました。claude -p が返した output_tokens は173、total_cost_usd は0.0868で、同じセッションの記録をこのスクリプトで数えた値(173、$0.0868)と一致しました。短い応答だったので記録の2行は同じ値でしたが、単価の計算がClaude Code自身の見積もりと合うことは確かめられています。
実行したコマンドです。
# 役ごとのトークンと費用(サブエージェントを起動したセッションだけ)
$ python3 session_usage.py --since 2026-10-01 --with-subagents-only --json ~/.claude/projects/<プロジェクトのフォルダ>* > usage.json
# 起動分(最初の応答の入力)
$ python3 startup_overhead.py --since 2026-10-01 ~/.claude/projects/<プロジェクトのフォルダ>* > startup.txt
フォルダは複数渡せます。ワークツリーで起動したセッションは別のフォルダに記録されるので、自分は本体とワークツリーの2つを * でまとめて渡しました(起動4,102回 + 28回 = 4,130回)。
スクリプトの全文です。3つのファイルを同じフォルダに置けば動きます。
session_usage.py(全文)
#!/usr/bin/env python3
"""Claude Code のセッション記録 (jsonl) から、トークン数と API 換算の費用を集計する。

サブスクリプション (Pro / Max) で対話的に回したセッションでも、
~/.claude/projects/<プロジェクト>/<セッションID>.jsonl に応答ごとの usage が残る。
サブエージェントの分は <セッションID>/subagents/agent-*.jsonl に別ファイルで残り、
同じ名前の .meta.json に agentType (どのエージェント定義か) が入っている。

使い方:
  # プロジェクトのフォルダ (複数可) を渡すと、セッションごとに1行出す
  python3 session_usage.py ~/.claude/projects/<プロジェクト>*

  # セッションを指定する (実験で回したセッションだけ見る)
  python3 session_usage.py --session <セッションID> ~/.claude/projects/<プロジェクト>

  # エージェント定義ごと・モデルごとの内訳も出す
  python3 session_usage.py --by-agent --by-model ~/.claude/projects/<プロジェクト>

  # JSON で出す (記事の表を作るとき)
  python3 session_usage.py --json ~/.claude/projects/<プロジェクト> > usage.json

API 換算の単価は prices.json (同じフォルダ) から読む。単価は 100 万トークンあたりの USD。
サブスクリプションで回した場合、実際の請求額ではなく「API で回したらいくらか」の参考値になる。
"""

from __future__ import annotations

import argparse
import json
import sys
from collections import defaultdict
from dataclasses import dataclass, field
from datetime import datetime
from pathlib import Path

HERE = Path(__file__).resolve().parent
TOKEN_KEYS = ("input", "cache_write_5m", "cache_write_1h", "cache_read", "output")


@dataclass
class Usage:
    input: int = 0
    cache_write_5m: int = 0
    cache_write_1h: int = 0
    cache_read: int = 0
    output: int = 0
    requests: int = 0

    def add(self, other: "Usage") -> None:
        for k in (*TOKEN_KEYS, "requests"):
            setattr(self, k, getattr(self, k) + getattr(other, k))

    @property
    def total_input(self) -> int:
        """モデルに読ませた入力の総量 (キャッシュ読み込みも含む)"""
        return self.input + self.cache_write_5m + self.cache_write_1h + self.cache_read

    def cost(self, price: dict | None) -> float | None:
        if not price:
            return None
        m = 1_000_000
        return (
            self.input * price["input"]
            + self.cache_write_5m * price["cache_write_5m"]
            + self.cache_write_1h * price["cache_write_1h"]
            + self.cache_read * price["cache_read"]
            + self.output * price["output"]
        ) / m

    def as_dict(self) -> dict:
        d = {k: getattr(self, k) for k in (*TOKEN_KEYS, "requests")}
        d["total_input"] = self.total_input
        return d


@dataclass
class Transcript:
    path: Path
    agent_type: str  # "main" か、サブエージェントの agentType
    by_model: dict[str, Usage] = field(default_factory=lambda: defaultdict(Usage))
    first: datetime | None = None
    last: datetime | None = None
    cost: float = 0.0
    unpriced: bool = False


def parse_usage(u: dict) -> Usage:
    cc = u.get("cache_creation") or {}
    w5 = cc.get("ephemeral_5m_input_tokens")
    w1 = cc.get("ephemeral_1h_input_tokens")
    total_write = u.get("cache_creation_input_tokens", 0) or 0
    if w5 is None and w1 is None:
        # 内訳がない古い記録は 5 分キャッシュとみなす
        w5, w1 = total_write, 0
    return Usage(
        input=u.get("input_tokens", 0) or 0,
        cache_write_5m=w5 or 0,
        cache_write_1h=w1 or 0,
        cache_read=u.get("cache_read_input_tokens", 0) or 0,
        output=u.get("output_tokens", 0) or 0,
        requests=1,
    )


def read_transcript(path: Path, agent_type: str, prices: dict | None = None) -> Transcript:
    t = Transcript(path=path, agent_type=agent_type)
    # 1つの応答が content ブロックごとに複数行で記録される。最初の行の output_tokens は
    # 途中の仮の値のことがあるので、message.id ごとに output_tokens が最大の行を残す
    best: dict[str, tuple[str, Usage]] = {}
    with path.open(encoding="utf-8") as f:
        for line in f:
            try:
                d = json.loads(line)
            except json.JSONDecodeError:
                continue
            ts = d.get("timestamp")
            if ts:
                dt = datetime.fromisoformat(ts.replace("Z", "+00:00"))
                t.first = dt if t.first is None or dt < t.first else t.first
                t.last = dt if t.last is None or dt > t.last else t.last
            if d.get("type") != "assistant":
                continue
            msg = d.get("message") or {}
            usage = msg.get("usage")
            if not usage:
                continue
            model = msg.get("model") or "unknown"
            if model == "<synthetic>":
                continue
            key = msg.get("id") or d.get("requestId") or d.get("uuid")
            u = parse_usage(usage)
            if key not in best or u.output > best[key][1].output:
                best[key] = (model, u)
    for model, u in best.values():
        t.by_model[model].add(u)
        c = request_cost(u, price_for(prices or {}, model))
        if c is None:
            t.unpriced = True
        else:
            t.cost += c
    return t


def request_cost(u: Usage, price: dict | None) -> float | None:
    """1リクエストの費用。プロンプトが閾値を超えると単価が上がるモデル (Haiku 5.5) は long の単価を使う"""
    if not price:
        return None
    long = price.get("long")
    if long and u.total_input > long["threshold"]:
        price = price | long
    return u.cost(price)


def agent_type_of(jsonl: Path) -> str:
    meta = jsonl.with_suffix(".meta.json")
    if meta.exists():
        try:
            return json.loads(meta.read_text(encoding="utf-8")).get("agentType") or "subagent"
        except json.JSONDecodeError:
            pass
    return "subagent"


def load_session(main_jsonl: Path, prices: dict | None = None) -> list[Transcript]:
    out = [read_transcript(main_jsonl, "main", prices)]
    sub_dir = main_jsonl.with_suffix("") / "subagents"
    if sub_dir.is_dir():
        for p in sorted(sub_dir.glob("agent-*.jsonl")):
            out.append(read_transcript(p, agent_type_of(p), prices))
    return out


def price_for(prices: dict, model: str) -> dict | None:
    if model in prices:
        return prices[model]
    # "claude-opus-5-5-20261001" のような日付つきの ID も拾う
    for k, v in prices.items():
        if model.startswith(k):
            return v
    return None


def summarize(transcripts: list[Transcript], prices: dict) -> dict:
    total = Usage()
    main = Usage()
    sub = Usage()
    by_agent: dict[str, Usage] = defaultdict(Usage)
    by_model: dict[str, Usage] = defaultdict(Usage)
    cost_total = 0.0
    cost_known = True
    cost_by_agent: dict[str, float] = defaultdict(float)
    first = min((t.first for t in transcripts if t.first), default=None)
    last = max((t.last for t in transcripts if t.last), default=None)
    for t in transcripts:
        for model, u in t.by_model.items():
            total.add(u)
            (main if t.agent_type == "main" else sub).add(u)
            by_agent[t.agent_type].add(u)
            by_model[model].add(u)
        cost_total += t.cost
        cost_by_agent[t.agent_type] += t.cost
        if t.unpriced:
            cost_known = False
    return {
        "subagent_runs": sum(1 for t in transcripts if t.agent_type != "main"),
        "wall_seconds": (last - first).total_seconds() if first and last else None,
        "started": first.isoformat() if first else None,
        "total": total.as_dict(),
        "main": main.as_dict(),
        "subagents": sub.as_dict(),
        "by_agent": {k: v.as_dict() | {"cost_usd": round(cost_by_agent.get(k, 0.0), 4)} for k, v in by_agent.items()},
        "by_model": {k: v.as_dict() for k, v in by_model.items()},
        "cost_main_usd": round(cost_by_agent.get("main", 0.0), 4),
        "cost_usd": round(cost_total, 4) if cost_known else None,
        "cost_usd_partial": round(cost_total, 4),
    }


def load_prices(path: Path = HERE / "prices.json") -> dict:
    return {k: v for k, v in json.loads(path.read_text(encoding="utf-8")).items() if not k.startswith("_")}


def main() -> int:
    ap = argparse.ArgumentParser(description=__doc__, formatter_class=argparse.RawDescriptionHelpFormatter)
    ap.add_argument("project_dirs", nargs="+", type=Path, help="~/.claude/projects/<プロジェクト> のフォルダ")
    ap.add_argument("--session", action="append", default=[], help="対象のセッションID (複数指定可)")
    ap.add_argument("--since", help="この日時以降に始まったセッションだけ (例: 2026-10-01)")
    ap.add_argument("--with-subagents-only", action="store_true", help="サブエージェントを1回以上起動したセッションだけ")
    ap.add_argument("--by-agent", action="store_true")
    ap.add_argument("--by-model", action="store_true")
    ap.add_argument("--json", action="store_true")
    ap.add_argument("--prices", type=Path, default=HERE / "prices.json")
    args = ap.parse_args()

    prices = {}
    if args.prices.exists():
        prices = load_prices(args.prices)

    sessions: list[Path] = []
    for d in args.project_dirs:
        sessions.extend(sorted(d.glob("*.jsonl")))
    if args.session:
        sessions = [s for s in sessions if s.stem in set(args.session)]

    rows = []
    for s in sessions:
        summary = summarize(load_session(s, prices), prices)
        if summary["total"]["requests"] == 0:
            continue
        if args.since and (summary["started"] or "") < args.since:
            continue
        if args.with_subagents_only and summary["subagent_runs"] == 0:
            continue
        rows.append({"session": s.stem, "project": s.parent.name} | summary)

    if args.json:
        json.dump(rows, sys.stdout, ensure_ascii=False, indent=2)
        print()
        return 0

    def fmt(n: int) -> str:
        return f"{n:,}"

    print(f"{'session':<10} {'start':<16} {'min':>6} {'sub':>4} {'input(all)':>12} {'cache_read':>12} {'output':>9} {'sub_share':>9} {'usd':>8}")
    for r in rows:
        tot = r["total"]
        share = r["subagents"]["total_input"] / tot["total_input"] if tot["total_input"] else 0
        usd = r["cost_usd"] if r["cost_usd"] is not None else f"~{r['cost_usd_partial']}"
        mins = f"{r['wall_seconds'] / 60:.1f}" if r["wall_seconds"] is not None else "-"
        print(
            f"{r['session'][:8]:<10} {(r['started'] or '')[:16]:<16} {mins:>6} {r['subagent_runs']:>4} "
            f"{fmt(tot['total_input']):>12} {fmt(tot['cache_read']):>12} {fmt(tot['output']):>9} {share:>8.0%} {usd:>8}"
        )
        if args.by_agent:
            for name, u in sorted(r["by_agent"].items(), key=lambda kv: -kv[1]["total_input"]):
                print(f"    agent {name:<22} req={u['requests']:>4} input(all)={fmt(u['total_input']):>12} output={fmt(u['output']):>9} usd={u['cost_usd']}")
        if args.by_model:
            for name, u in r["by_model"].items():
                print(f"    model {name:<28} req={u['requests']:>4} input(all)={fmt(u['total_input']):>12} output={fmt(u['output']):>9}")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
startup_overhead.py(全文)
#!/usr/bin/env python3
"""サブエージェント1回の起動で、最初の応答の時点で読み込んでいた入力 (= 起動分) を数える。

最初の応答の入力 = システムプロンプト + ツール定義 + CLAUDE.md + エージェント定義 + 依頼文。
親の会話は引き継がれないので、ここが「エージェントごとに流し直す前提」の大きさになる。

使い方: python3 startup_overhead.py [--since 2026-10-01] ~/.claude/projects/<プロジェクト> ...
"""
import argparse, json, statistics
from collections import defaultdict
from pathlib import Path
from session_usage import agent_type_of, parse_usage, price_for, request_cost, load_prices

ap = argparse.ArgumentParser()
ap.add_argument("project_dirs", nargs="+", type=Path)
ap.add_argument("--since", default="")
args = ap.parse_args()
prices = load_prices()

rows = defaultdict(list)  # agentType -> [(first_input, first_cache_write, first_cache_read, total_input, model, first_cost, total_cost)]
for d in args.project_dirs:
    for p in d.glob("*/subagents/agent-*.jsonl"):
        best = {}; started = None
        for line in p.open(encoding="utf-8"):
            try: e = json.loads(line)
            except json.JSONDecodeError: continue
            started = started or e.get("timestamp")
            if e.get("type") != "assistant": continue
            m = e.get("message") or {}
            if not m.get("usage") or m.get("model") == "<synthetic>": continue
            u = parse_usage(m["usage"]); k = m.get("id")
            # 最初の行の output_tokens は仮の値のことがあるので、最大の行を残す (dict は最初に出た順を保つ)
            if k not in best or u.output > best[k][0].output: best[k] = (u, m.get("model"))
        first = None; total = 0; total_cost = 0.0
        for u, model in best.values():
            c = request_cost(u, price_for(prices, model or "")) or 0.0
            total += u.total_input; total_cost += c
            if first is None: first = (u, model, c)
        if first is None or (started or "") < args.since: continue
        u, model, c = first
        rows[agent_type_of(p)].append((u.total_input, u.cache_write_5m + u.cache_write_1h, u.cache_read, total, model, c, total_cost))

print(f"{'agent':<20} {'runs':>5} {'model':<18} {'起動時の入力(中央値)':>14} {'うちキャッシュ読込':>12} {'1回の入力合計(中央値)':>16} {'起動分の比率':>8} {'起動分$':>8} {'全体$':>8}")
g_first = g_total = g_fc = g_tc = 0
for a, rs in sorted(rows.items(), key=lambda kv: -len(kv[1])):
    fi = [r[0] for r in rs]; tot = [r[3] for r in rs]
    fc = sum(r[5] for r in rs); tc = sum(r[6] for r in rs)
    g_first += sum(fi); g_total += sum(tot); g_fc += fc; g_tc += tc
    models = sorted({r[4] for r in rs})
    print(f"{a:<20} {len(rs):>5} {models[0][:18]:<18} {int(statistics.median(fi)):>14,} {int(statistics.median([r[2] for r in rs])):>12,} {int(statistics.median(tot)):>16,} {sum(fi)/sum(tot):>8.0%} {fc:>8.2f} {tc:>8.2f}")
print(f"ALL first-request input share: {g_first/g_total:.1%}  cost share: {g_fc/g_tc:.1%} (${g_fc:.2f} / ${g_tc:.2f})")
prices.json(全文)
{
  "_note": "100万トークンあたりの USD (Claude API の標準単価、2026-11-08 に公式の料金ページで照合)。キャッシュ書き込みは入力の 1.25 倍 (5分) / 2 倍 (1時間)。Haiku 5.5 はプロンプト (キャッシュ込み) が 100K トークンを超えるリクエストだけ long の単価になる。",
  "claude-opus-5-5": {
    "input": 4.0,
    "output": 20.0,
    "cache_write_5m": 5.0,
    "cache_write_1h": 8.0,
    "cache_read": 0.2
  },
  "claude-sonnet-5-5": {
    "input": 2.0,
    "output": 10.0,
    "cache_write_5m": 2.5,
    "cache_write_1h": 4.0,
    "cache_read": 0.1
  },
  "claude-haiku-5-5": {
    "input": 0.1,
    "output": 0.5,
    "cache_write_5m": 0.125,
    "cache_write_1h": 0.2,
    "cache_read": 0.01,
    "long": {
      "threshold": 100000,
      "input": 0.5,
      "output": 2.5,
      "cache_write_5m": 0.625,
      "cache_write_1h": 1.0,
      "cache_read": 0.05
    }
  },
  "claude-fable-5-1": {
    "input": 10.0,
    "output": 50.0,
    "cache_write_5m": 12.5,
    "cache_write_1h": 20.0,
    "cache_read": 0.25
  },
  "claude-opus-5": {
    "input": 5.0,
    "output": 25.0,
    "cache_write_5m": 6.25,
    "cache_write_1h": 10.0,
    "cache_read": 0.5
  },
  "claude-sonnet-5": {
    "input": 2.0,
    "output": 10.0,
    "cache_write_5m": 2.5,
    "cache_write_1h": 4.0,
    "cache_read": 0.2
  },
  "claude-opus-4-8": {
    "input": 5.0,
    "output": 25.0,
    "cache_write_5m": 6.25,
    "cache_write_1h": 10.0,
    "cache_read": 0.5
  },
  "claude-sonnet-4-6": {
    "input": 3.0,
    "output": 15.0,
    "cache_write_5m": 3.75,
    "cache_write_1h": 6.0,
    "cache_read": 0.3
  },
  "claude-haiku-4-5": {
    "input": 1.0,
    "output": 5.0,
    "cache_write_5m": 1.25,
    "cache_write_1h": 2.0,
    "cache_read": 0.1
  }
}
5. 20セッションを集計した結果
仮説どおりなら、起動のたびに前提を読み直すサブエージェントの側に、費用のかなりの部分が出るはずです。ただ12体のうち10体はSonnetかHaikuなので、そのぶん安く済んでいるだろう、とも思っていました。
(※作問パイプラインを大量に回した3セッションだけで費用の55%を占めているので、使い方が違えば割合も変わります。)
メインとサブエージェントの割合
| メイン | サブエージェント | 合計 | |
|---|---|---|---|
| リクエスト数 | 11,449 | 25,429 | 36,878 |
| 入力トークン(キャッシュの読み書きを含む) | 約45.1億(77.7%) | 約12.9億(22.3%) | 約58.0億 |
| 入力のうちキャッシュ読み込み | 99.1% | 89.1% | 96.9% |
| 出力トークン | 約598万 | 約2,300万 | 約2,898万 |
| API換算の費用 | $1,284.56(70.6%) | $534.40(29.4%) | $1,818.96 |
リクエスト数はサブエージェントがメインの2倍以上なのに、費用の7割はメインでした。
正直、ここは予想と逆です...。
メインの費用の69.5%($892.92)はキャッシュ読み込みです。単価は入力の5%しかありませんが、メインは1リクエストあたり平均約39万トークンを毎回読み込んでいて、リクエストが1セッションで2,000回を超えることもありました。
役ごとの費用と、起動1回あたりの読み込み
| エージェント | モデル | 起動回数 | 費用 | 割合 | 起動分の入力 | 起動分の費用比 |
|---|---|---|---|---|---|---|
| question-verifier | Opus | 1,452 | $121.41 | 22.7% | 10,703 | 44% |
| ※general-purpose | Opus | 56 | $94.75 | 17.7% | 33,207 | 8% |
| question-drafter | Sonnet | 272 | $64.59 | 12.1% | 11,016 | 9% |
| draft-writer | Sonnet | 94 | $60.83 | 11.4% | 10,276 | 4% |
| question-judge | Opus | 695 | $58.45 | 10.9% | 11,407 | 48% |
| inspector-deep | Sonnet | 145 | $47.69 | 8.9% | 9,782 | 7% |
| inspector | Haiku | 509 | $24.48 | 4.6% | 9,897 | 2% |
| question-reviser | Sonnet | 81 | $20.73 | 3.9% | 12,694 | 10% |
| notebook-reviser | Sonnet | 64 | $15.33 | 2.9% | 11,291 | 10% |
| fact-extractor | Haiku | 538 | $8.09 | 1.5% | 9,543 | 6% |
| commit-writer | Haiku | 210 | $1.95 | 0.4% | 10,297 | 14% |
| source-scout | Sonnet | 1 | $0.42 | 0.1% | 10,220 | 7% |
| guide-extractor | Haiku | 9 | $0.10 | 0.0% | 10,107 | (10%) |
| ※impl-app、Explore、impl-infra | Opus | 4 | $15.58 | 2.9% | - | - |
(※は12体以外。「起動分の入力」は最初の応答の入力トークンの中央値、「起動分の費用比」は最初のリクエストの費用 ÷ その役の費用です。)
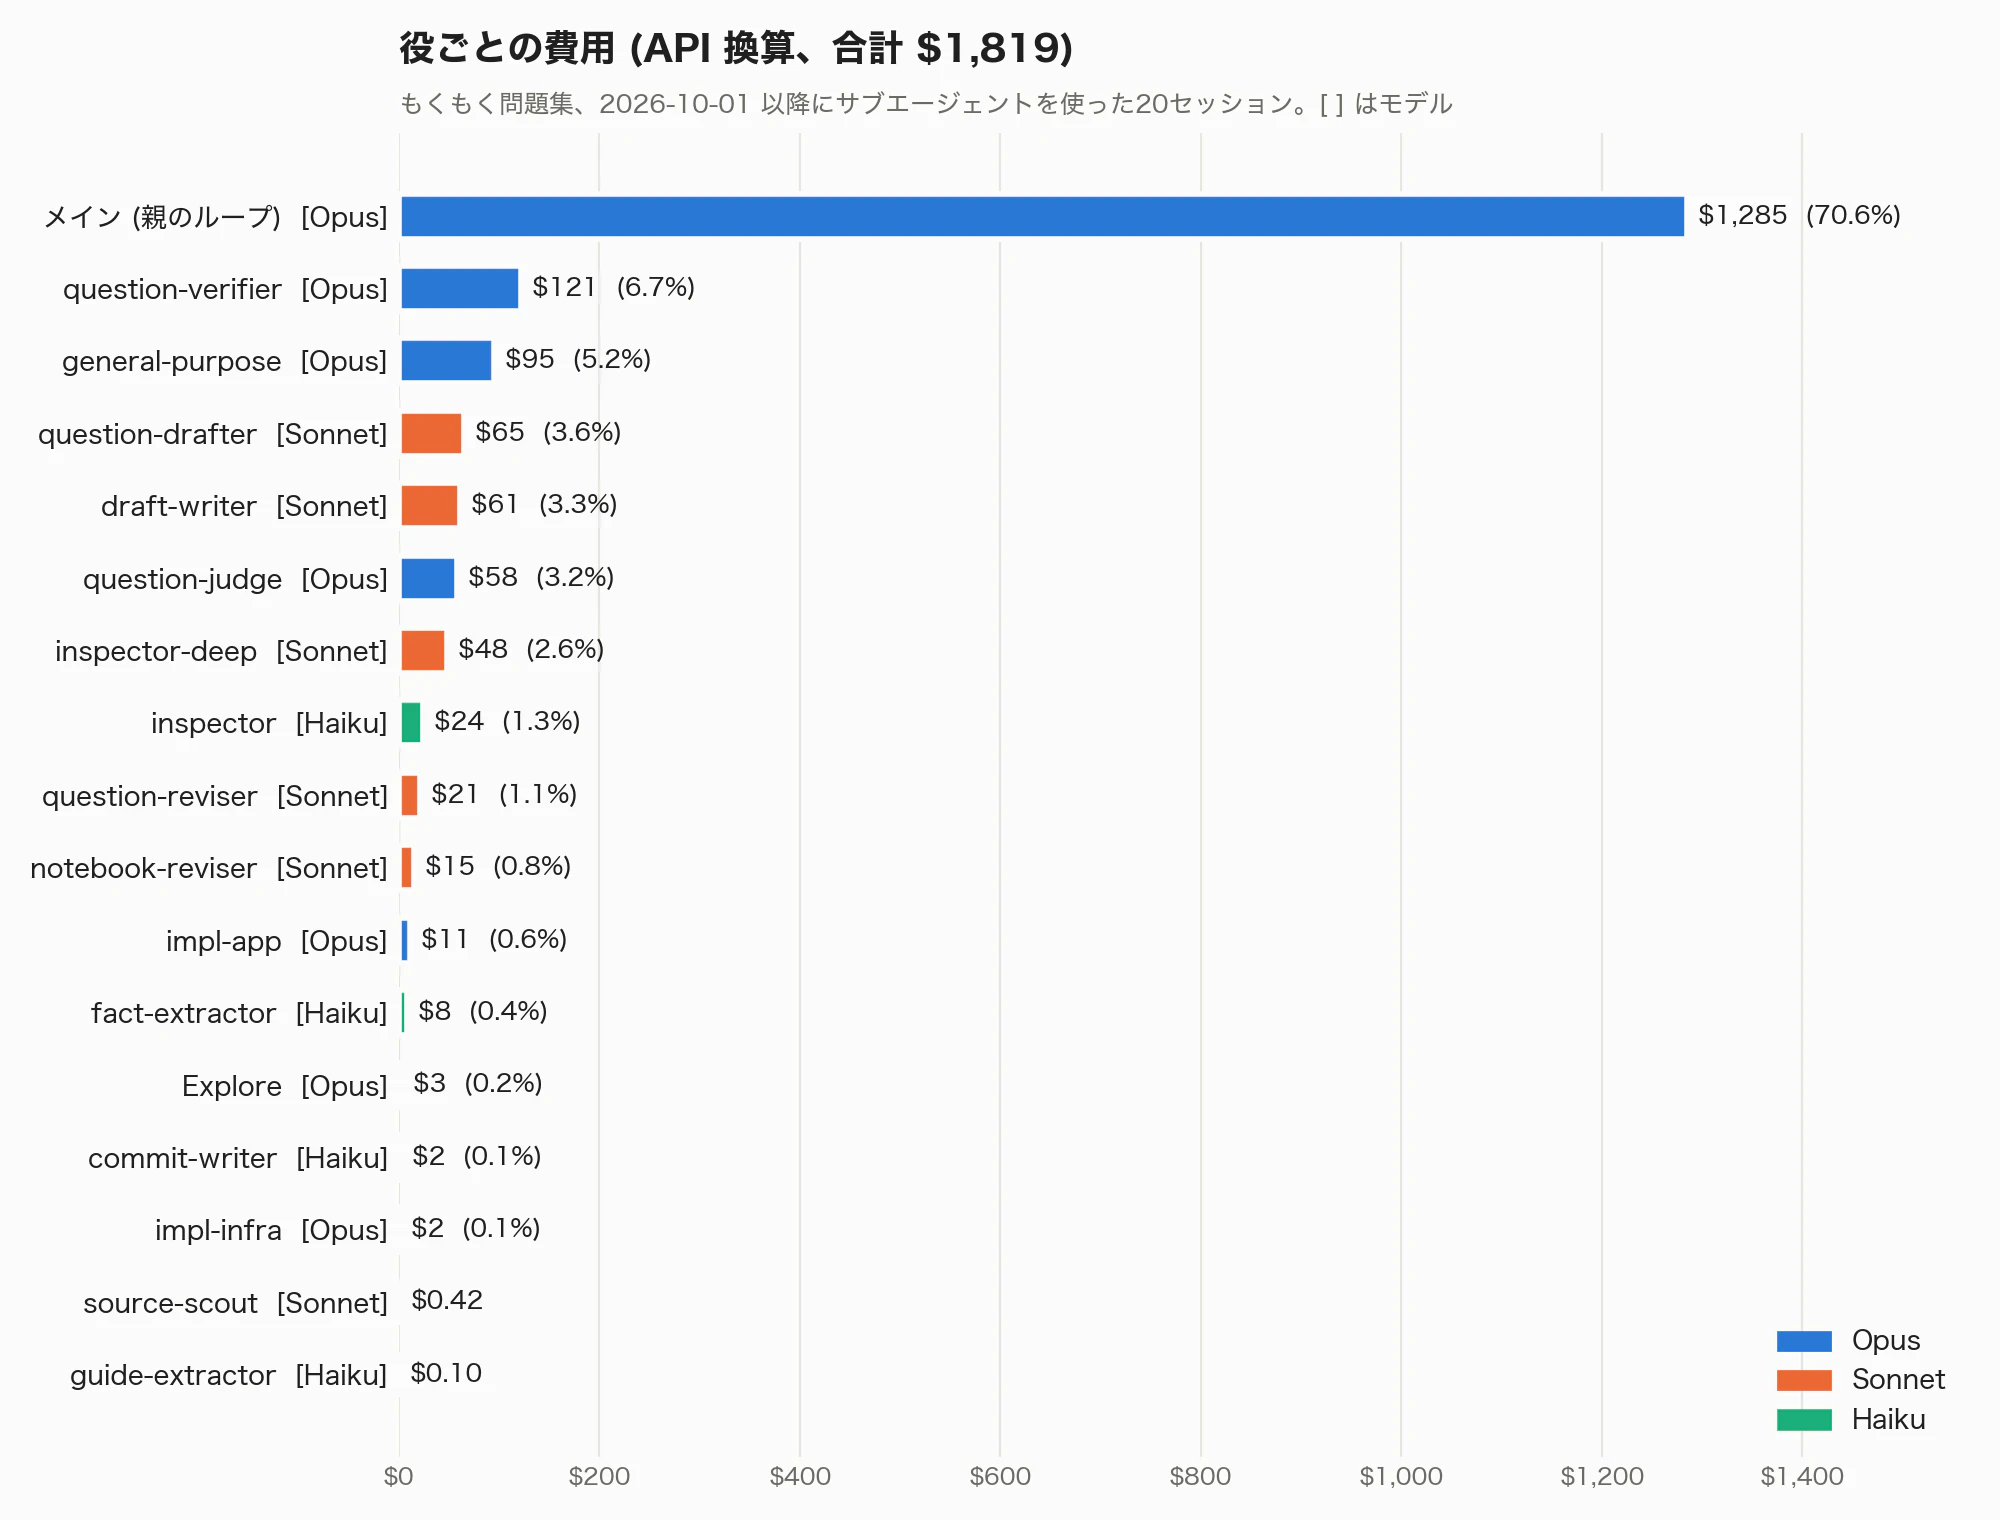
役のモデルでまとめると、Opusの役が54.3%、Haikuの役は6.5%でした。起動回数の多いfact-extractorとinspectorはHaikuにしていて、合わせて1,000回以上動いても\$32.57です!
逆に上位5役のうち3つはOpusで、question-verifierは1回\$0.084でも1,452回呼んでいました。安いモデルに回した役は確かに安く、Opusのまま残した役が上位に並んでいた、ということです。
起動分の入力は、12体とも中央値で9,543〜12,694トークンでした。役が違ってもほぼ1万トークンを読んでから仕事を始めていて、ここは仮説どおりです。
サブエージェント全体では、起動分は入力トークンの3.5%、費用の19.9%($106.45)でした。最初の応答は単価の高いキャッシュ書き込みが中心だからです。特にquestion-verifierとquestion-judgeは1回の起動が約3リクエストの短い仕事なので、起動分が費用の44%と48%になっていました。
ただ、全体の$1,818.96から見ると、起動分は5.9%です。
なお、親の会話ごと引き継ぐフォークが混じっていれば最初の応答でキャッシュ読み込みが極端に大きくなりますが、4,130回の起動で10万トークンを超えるものは0件でした。
6. 自分の12体を仕分ける
3. 分けたほうがいい場面・分けなくていい場面の判断表を、12体と組み込みのgeneral-purposeに当てはめました。数字は5. 20セッションを集計した結果の表のとおりです。
| エージェント | 当てはめたパターン | 仕分け |
|---|---|---|
| inspector | 作成役と検査役、権限で分ける | 残す |
| inspector-deep | 作成役と検査役、権限で分ける | 畳む候補(inspectorに一本化) |
| guide-extractor | 調査で分ける | 残す |
| source-scout | 調査で分ける | 畳む候補(10月以降1回だけ) |
| fact-extractor | 並列に回す、モデルを変える | 残す |
| commit-writer | 手順やルールの切り出し | 畳む候補 |
| draft-writer | 手順やルールの切り出し | 畳む候補 |
| notebook-reviser | 手順やルールの切り出し | 畳む候補 |
| question-reviser | 役割で分ける | 畳む候補 |
| question-drafter | 並列に回す、モデルを変える | 後編で測る |
| question-verifier | 作成役と検査役、並列に回す | 後編で測る |
| question-judge | 作成役と検査役、並列に回す | 後編で測る |
| ※general-purpose | モデルを変える(メインと同じOpusで動いている) | 畳む候補 |
方針は「畳めるものは畳む」にしました。12体では、残すが3体、畳む候補が6体、後編で測るが3体です。
ただし、これはまだ案です。もくもく問題集の本体のエージェント定義は変えていません。畳む候補もすぐには消さず、後編で実験用のワークツリーを切り、畳むガイドの手順どおり比べる材料を作ってから1体ずつ畳むつもりです。
仕分けた理由
残す側は、検査役(inspectorは使えるツールを Read と Grep と Glob に絞っています)と、公式の本文を1件ずつ読んでJSONを書いて終わる抽出役です。抽出役は同時に8体まで回していて、何百件もの本文をメインで読めばコンテキストが埋まるので、ここは迷わず残しました。
検査役でも、inspector-deepは畳む候補にしました。inspectorと同じ検査をSonnetで行うだけの役なので、検査はHaikuのinspector 1体に一本化します。source-scoutは調査役ですが、10月以降1回しか起動していないので、わざわざ分けておく理由がありません。question-reviserは保留になった問題を直す役で、工程で分けただけなので、これも畳む候補です。
畳む候補のcommit-writerとdraft-writerは、決まった書き方で下書きするだけの役で、決まりはもうスキルにまとめてあります。draft-writerは1回の起動で読む入力の合計が中央値で約14.6万トークンあり、メインがすでに知っている変更を読み直しているぶんだと見ています。notebook-reviserは、書いた本人に自分の文の癖を直させてうまくいくのか、正直わかりません(この記事も、AI臭を消す工程だけは別のエージェントに分けています笑)。
組み込みのgeneral-purposeは、メインと同じOpusで動くので、分けても安くはなりません。56回($94.75)の内訳はこうでした。
| 用途 | 回数 |
|---|---|
| バージョンごとの実装・リベース・衝突の解消 | 19 |
| タグ付け・解説の書き直し・図の下書き(バッチで生成) | 13 |
| 保留した問題の再判定・再審査(バッチで並列) | 12 |
| 生成物の検証 | 7 |
| コードや作業履歴のレビュー | 5 |
実装やリベースはメインでやっても同じ仕事なので、畳む候補にしました。バッチで並列に回した分は、畳むとしても並列のまま回せるかを確かめてからになります。
question-drafterは、fact-extractorと同じく並列に回し、モデルも変えている役です。ただ、fact-extractorは本文を読んでJSONを返すだけでHaikuのまま\$8.09に収まっているのに対し、question-drafterはSonnetで\$64.59かかり、書いた問題はすぐ後ろのquestion-verifierが読み直します。下書きと検証をメインで続けて回したほうがよいのかは、次の2体と一緒に後編で測ります。
いちばん迷ったのはquestion-verifierとquestion-judgeです。「書いた側の思い込みを引き継がない」ことを定義に書いた役なので、パターンでは残す側です。ただ、独立した目を残したまま起動分だけを減らせるかは、当てはめでは決まりません。ここは後編で、作問パイプラインと小さな開発タスクを題材に、今の分割と1つのループを claude -p で各3回回し、費用と所要時間、テストの通過、レビューの指摘を比べて決めます。
比べ方は畳むガイドの勧めに合わせます。まず正解がわかっている例を10件ほど用意し、どの構成も同じ例で採点します。1回だけだと崩れを見落とすので、各タスクは2回以上回します(ガイドでも、崩れが2回に1回しか出なかった例が挙げられています)。畳むのも1体ずつにして、そのたびに出来と費用を比べます。
比べる構成の1つには、question-verifierとquestion-judgeに複数の問題をまとめて渡す案も入れます。この2体はまとめて渡せば起動の回数が減るので、そのぶん起動分も減ると見ています。
まとめ
畳むガイドと公式ドキュメントから判断表を作り、12体をセッション記録で数えて仕分けの案を作りました。
数える前は「分けるとトークンを余計に使うので、畳めば安くなる」と思っていたのですが、数えてみると印象が変わりました。仕分けだけで費用が大きく下がるわけではなさそうです。
数字で振り返ると、サブエージェントの費用のうちOpusの役が54.3%で、Haikuの役は6.5%でした。起動分もトークンでは3.5%なのに費用では19.9%で、同じ読み直しでもモデルと回数しだいで重さが変わります。サブエージェントに分けるかどうかも大事ですが、根本の「どの役をどのモデルで動かし、どれだけ読ませるか」もコスト効率化において考えないとですね。
セッション記録はサブスクでも30日は残る(既定)ので、消える前に一度数えてみると、どこがネックになっているかという見直しができるかと思います。
後編では、作問パイプラインの3体を1つのループにまとめても出来が落ちないのかを確かめたいと思います!
この記事が参考になれば幸いです。
参考
- Building agents: When to fold subagents into your main agent loop
- Building multi-agent systems: when and how to use them
- How we built our multi-agent research system
- Effective context engineering for AI agents
- 1M context is now generally available
- Claude Codeのベストプラクティス
- Claude Codeのサブエージェント
- Claude Codeのプロンプトキャッシュ
- Claude Codeのコスト管理
- Model configuration(Claude Code)
- Claude Codeのセッション
- Track cost and usage(Agent SDK)
- Context windows(Claude API)
- Claude APIの料金