
はじめに:前回のあらすじと今回のテーマ
前回の記事(【ローカルLLM】【ollama】 外付け GeForce RTX 2080Ti 2台で40tok/s(Qwen 27B Q4_K_M))では、M.2 OCuLink(PCIe Gen3 x4)という極細のホストバス接続でありながら、2枚の改造RTX 2080 Ti(22GB×2=計44GB VRAM)間をNVLinkブリッジで直結し、Turing世代(sm_75)向けにソースビルドしたカスタムNCCLによって27B Denseモデルで40 tok/sを達成したことを報告しました。
今回は今流行りのStrataについて、検証&最適化と言う名の魔改造を行った結果について報告します。
Strata(ストラータ)とは、一般的な家庭用PCやゲーミングPCで、通常はサーバー級の大型GPUが必要な超大規模なAIモデルを動かすためのオープンソースのAI推論エンジンです。
実はこのStrataはゲーミングPCに特化しているエンジンであり、マルチGPUはやや相性が悪い曲者です。
1. 一般的なマザーボードのPCIe16レーンは1つしかない
いきなりマザーボードの話というのも変ではありますが、GPUはPCIeのスロットに入れると思います。実はこのPCIeのスロットのレーン数はCPUによって決まっております。
一般的なコンシューマ向けCPUの場合20レーン前後であり、その合計値を分散してM.2やPCIスロットに分けています。更にチップセットで中継していますので、実質はもっとレーン数が増えます。
それがなんだ?という話ではありますが、マルチGPUを組む場合は、必然的にこのスロットをGPUで取り合う形になります。
Strataの特性はエキスパートと呼ばれるパラメータが移動します。VRAM⇔RAM⇔SSDという形で行ったり来たりするので、伝送路が広く太くないと渋滞が発生します。マルチGPUの場合、GPUが伝送路を取り合う形になるのでどうしても不利になります。ただし、不利とはいっても、マルチGPUによるVRAM増加によりVRAMからのエキスパート読み込み可能性が上がるので、高速にはなります。
2. Strataは複数のGPUをほぼ同時には使っていない
Strataの特性はゲーミングPCがターゲットです。今どきのゲーミングPCは高性能なRTX5090のようなGPUが1台あればよいです。2台以上のGPUを使っているゲーミングPCは最近ないです。(並列処理する必要がないくらいGPUの性能が上がっている。)
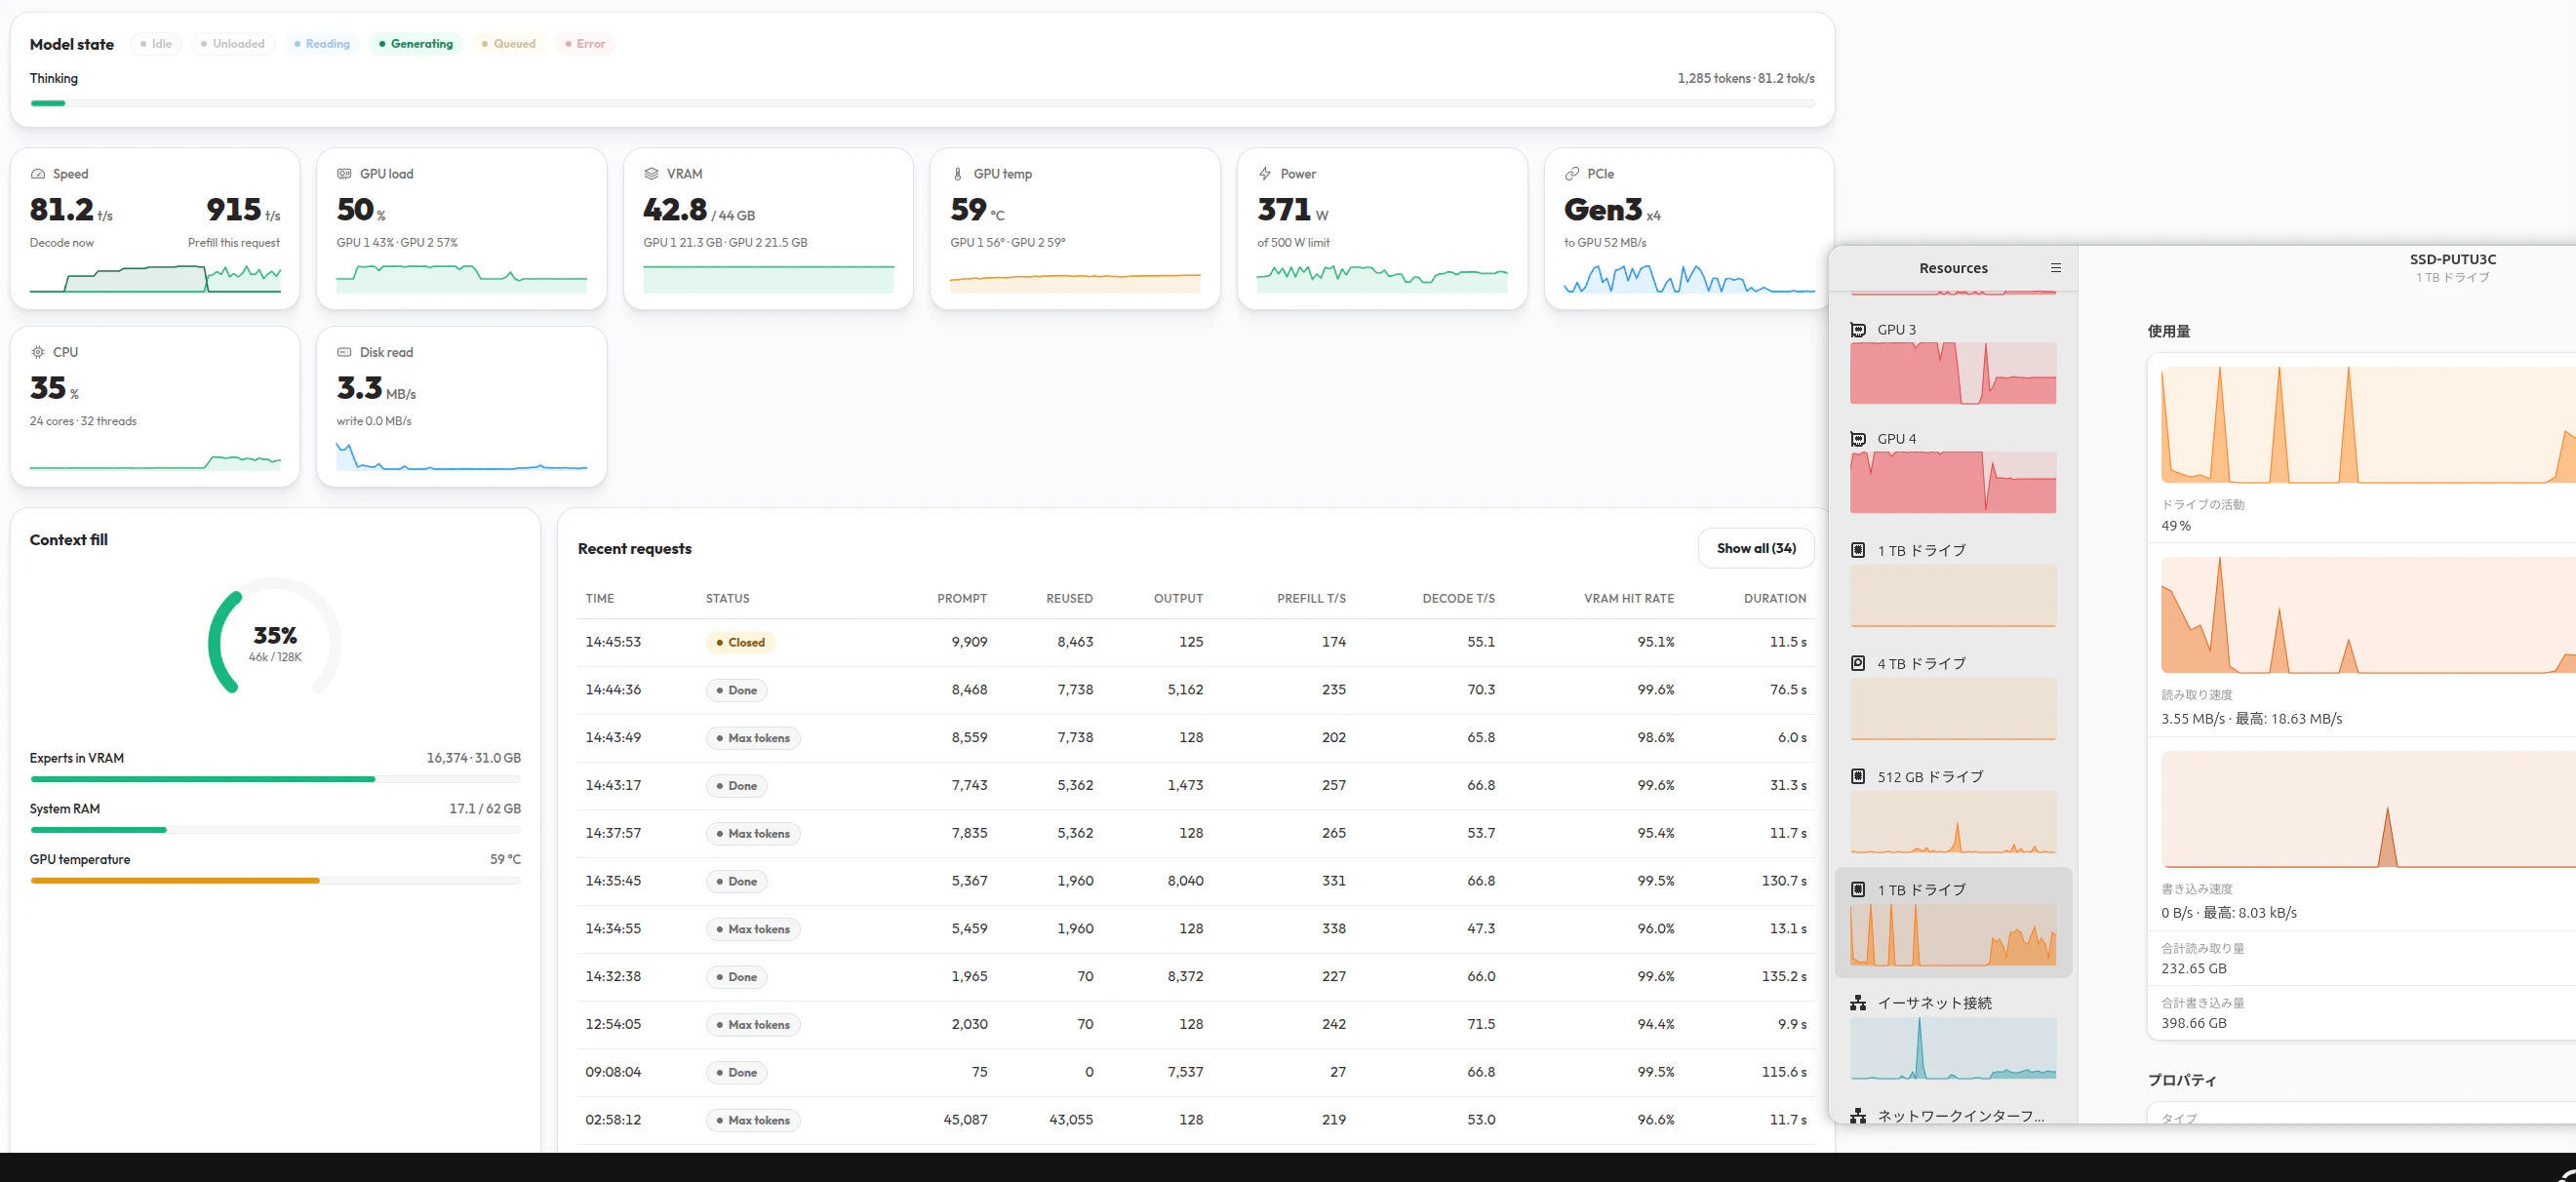
ではStrataは基本的どんな形で2枚以上のGPUを使用しているかと言うと、2枚目を動かすときは1枚目のGPUは休んでいます。(倉庫番のような感じです。このことをバブルと言います。)
この方式はPP(パイプラインパラレル)といい、Strataの制御は基本PPとなります。
例えばGPUの枚数を2枚にし、48層あるモデルを使用するとパラメータのうち1〜23層をGPU1が24~48層をGPU2が担当するような感じです。1~24層の計算を行っている間GPU2は暇になります。
マルチGPUでStrataを起動して使用すると、GPU使用率は100%にはなりません。(=GPU性能を使い切っていないと言えます。)
3. TP(テンソルパラレル)とStrata
複数GPUに対して100%の能力を使うにはどうするか、層ごとに分けるのではなく、各層で並列計算させれば良いのです。この方式をTP(テンソルパラレル)と言います。
しかし、これには罠があり、互いの計算結果を各層で検算する必要が出てきます。PPのときは層をまたぐときだけで良かった検算が各層ごとに必要となります。48層の例だと単純に計算しても24倍の通信量が発生します。
ただえさえエキスパートが移動して、VRAM、RAM間の移動があるStrataと、マルチGPUにしたことによる実質レーンの減少による速度低下が重なり、通信路は大渋滞となり、並列計算のメリットが全く活かせません。
そういった理由なのかどうかはわかりませんが、StrataにはTPが最初から使えません。
ソースコードのビルドオプションでONにできますが、PCIe3x4というOculink構成でStrataをソースからビルドを行ったら、散々な結果でした。
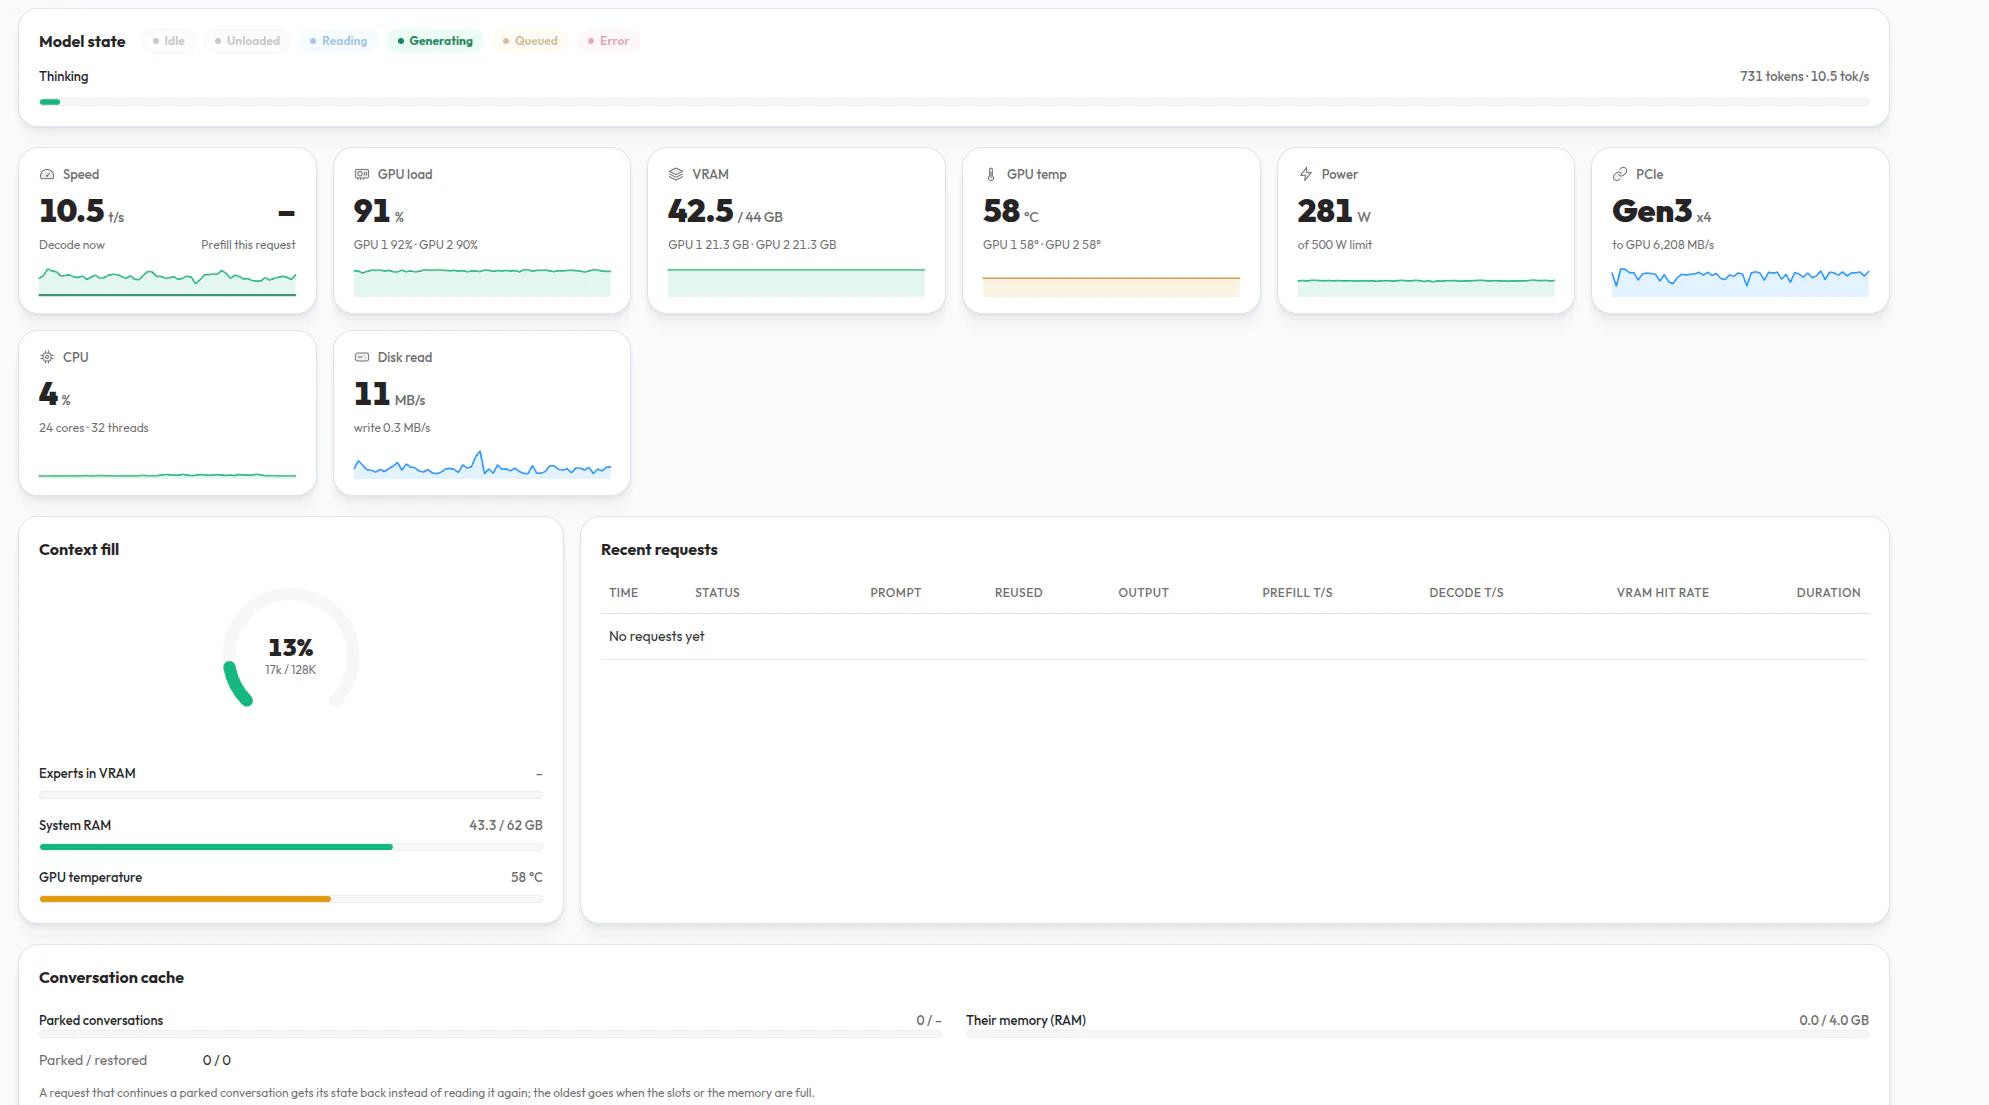
(使用モデルはQwen3.8-Flash-Next-GSQ-RCO-abliterated-GGUFのIQ3_S 約78GByte)
4. TPの可能性とStrataの魔改造
TPは使えない。わけではないと思っています。ロマンがあります。伸びしろがあります。
GeForce RTX2080Ti x 2 Oculink(PCIe3x4)という3.8Gbyte/sしかない伝送路を最低限しか使わなければよいのです。RTX2080TiにはNVLinkという100GByte/sの極太の伝送路があります。この伝送路をなるべく使用し、PCIeの伝送路は最低限使用する。という形にすれば、この10tok/sという不名誉が挽回できるのではないかと思います。
Gitで2026/11/13時点のコードを入手してGeminiを使用し、コードを変更していきました。
(記載しているのは一例です。全部やってもビルドは通らないのでご注意ください。)
コード上には、TP用のコードも記述されており、TPでの運用も想定はされています。
1. 通信路の変更
通信部分はAMD製のGPUのみGPU間の通信をするような部分がありました。nvidia製のGPUは強制的にPCIeになるようです。この部分を徹底的に前回ビルドしたNCCLライブラリを呼び出すようにバッサリ置き換えます。
src/split/src/engine.cu等
// 【変更前】AMD環境のみで有効だったRCCLやP2P処理のガード
-#if FNX_HIP
     if (p.rccl) {
         const RcclApi& api = *(const RcclApi*) p.rc_api;

// 【変更後】無条件でコンパイル対象にする
+#if 1
     if (p.rccl) {
         const RcclApi& api = *(const RcclApi*) p.rc_api;
// 【変更前】ホスト(マザーボードのRAM)にリングバッファを確保
- b->ring.in = hxalloc<unsigned long long>(ring_in_words(MAXT));
- b->ring.ag = hxalloc<unsigned long long>(ring_ag_words(MAXT));

// 【変更後】NVLinkが有効(peer_on)な場合は、GPUのVRAM(pxalloc)に直接確保
+ b->ring.in = peer_on ? (unsigned long long*) pxalloc(ring_in_words(MAXT) * sizeof(unsigned long long)) : hxalloc<unsigned long long>(ring_in_words(MAXT));
+ b->ring.ag = peer_on ? (unsigned long long*) pxalloc(ring_ag_words(MAXT) * sizeof(unsigned long long)) : hxalloc<unsigned long long>(ring_ag_words(MAXT));
// 【変更前】AMDならデバイスメモリ、それ以外(NVIDIA)ならホストメモリ
-#if FNX_HIP
         if (peer_on && (peer_parts & 1)) b->ring.pk = pxalloc((size_t) 2 * NCARD * MAXT * (N / 2) * sizeof(unsigned long long));
         b->att_ring.in = peer_on && (peer_parts & 2) ? (unsigned long long*) pxalloc(att_ring_words() * sizeof(unsigned long long))
                                                      : hxalloc<unsigned long long>(att_ring_words());
-#else
-        b->att_ring.in = hxalloc<unsigned long long>(att_ring_words());
-#endif

// 【変更後】#if FNX_HIP を削除し、NVIDIAでも peer_on なら pxalloc を使用
         if (peer_on && (peer_parts & 1)) b->ring.pk = pxalloc((size_t) 2 * NCARD * MAXT * (N / 2) * sizeof(unsigned long long));
         b->att_ring.in = peer_on && (peer_parts & 2) ? (unsigned long long*) pxalloc(att_ring_words() * sizeof(unsigned long long))
                                                      : hxalloc<unsigned long long>(att_ring_words());
const long long t0 = clock64();
                 while ((int) (*(volatile const unsigned*) (flag + threadIdx.x) - seq) < 0) {
+            #if FNX_HIP
                     __builtin_amdgcn_s_sleep(1); // AMD用の待機命令
+#else
+                    __nanosleep(64);             // NVIDIA(CUDA)用の待機命令
+#endif
2. 溢れた処理のCPU処理
GPUで処理ができなかった(エキスパートがRAM側にあった場合の)処理についてCPUですぐに処理できるように常に待機します。
src/split/src/engine.cu等
// 【追加】CPU MoE用のホスト-デバイス共有メモリ(CpuMoeBox)を割り当て
+ ck(cudaHostAlloc((void**) &hbox, sizeof(CpuMoeBox), cudaHostAllocMapped), "cpu_box alloc");

// 【追加】ワーカースレッドの待機ループ(抜粋)
+ if (b_id == my_batch) {
+     if (++idle_spins > 5000000) {
+         std::this_thread::sleep_for(std::chrono::milliseconds(1));
+     } else {
+         #if defined(__x86_64__)
+         __builtin_ia32_pause(); // ロックフリーでCPU負荷を抑えつつ超低遅延待機
+         #endif
+     }
+     continue;
+ }
3. 1軍,2軍管理によるVRAM-RAM 完全独立プリフェッチ
StrataのオリジナルのTPの処理ではPPのような入れ替えはないので、独自に作りました。
VRAMを1軍、RAMを2軍としてそれぞれ推論中にエキスパートがヒットするとその周辺のエキスパートに1/4,1/8の影響を出しながら得点を加算します(重力波計算)。
逆に加算されなかったエキスパートは得点が下がります。
VRAMとRAMそれぞれのエキスパートで独立して得点をカウントし、RAMのエキスパートが一定以上になるとVRAMの得点の低いエキスパートと入れ替えをします。
(今回はVRAM+RAMに78GB乗りましたので、SSDは考慮していません。)
src/split/src/moe.cuh
// 【追加】2軍(RAM)の非ヒットペナルティと、隣接エキスパートへの重力波及計算
+ if (swap_mode == 1) {
+     int h = 0;
+     if (lane == 0) {
+         // 2軍メンバーのみを対象に重力加算(本人 +base_grav+1、両隣 +(base_grav>>1)+1)
+         for (int d = -2; d <= 2; ++d) {
+             const int nw = w + d;
+             if (nw >= 0 && nw < NEXP) {
+                 const int ng = base + nw;
+                 if (ec.slot_of[ng] < 0) { // VRAMに無い(2軍の)場合
+                     const int ad = d < 0 ? -d : d;
+                     // 距離(ad)に応じたビットシフト減衰(ad=0: 1/1, ad=1: 1/4, ad=2: 1/8)
+                     const int shift = (ad == 0) ? 0 : (ad + 1);
+                     const int add_g = (base_grav >> shift) + 1;
+                     const int nv = min(255, freq[ng] + add_g);
+                     freq[ng] = nv;
+                 }
+             }
+         }
+     }
+ }
他細かいところのチューニングを実施。
5.結果
入力プロンプト
「Pythonの標準ライブラリのみを使って、マルチスレッド対応の簡易HTTPサーバーと、その負荷テストを行うクライアントスクリプトを実装してください。コードの解説とエラーハンドリングの設計思想も詳しく書いてください。」
設定
MAXコンテキスト:128K
投機的デコード:6
KVキャッシュ:FP16
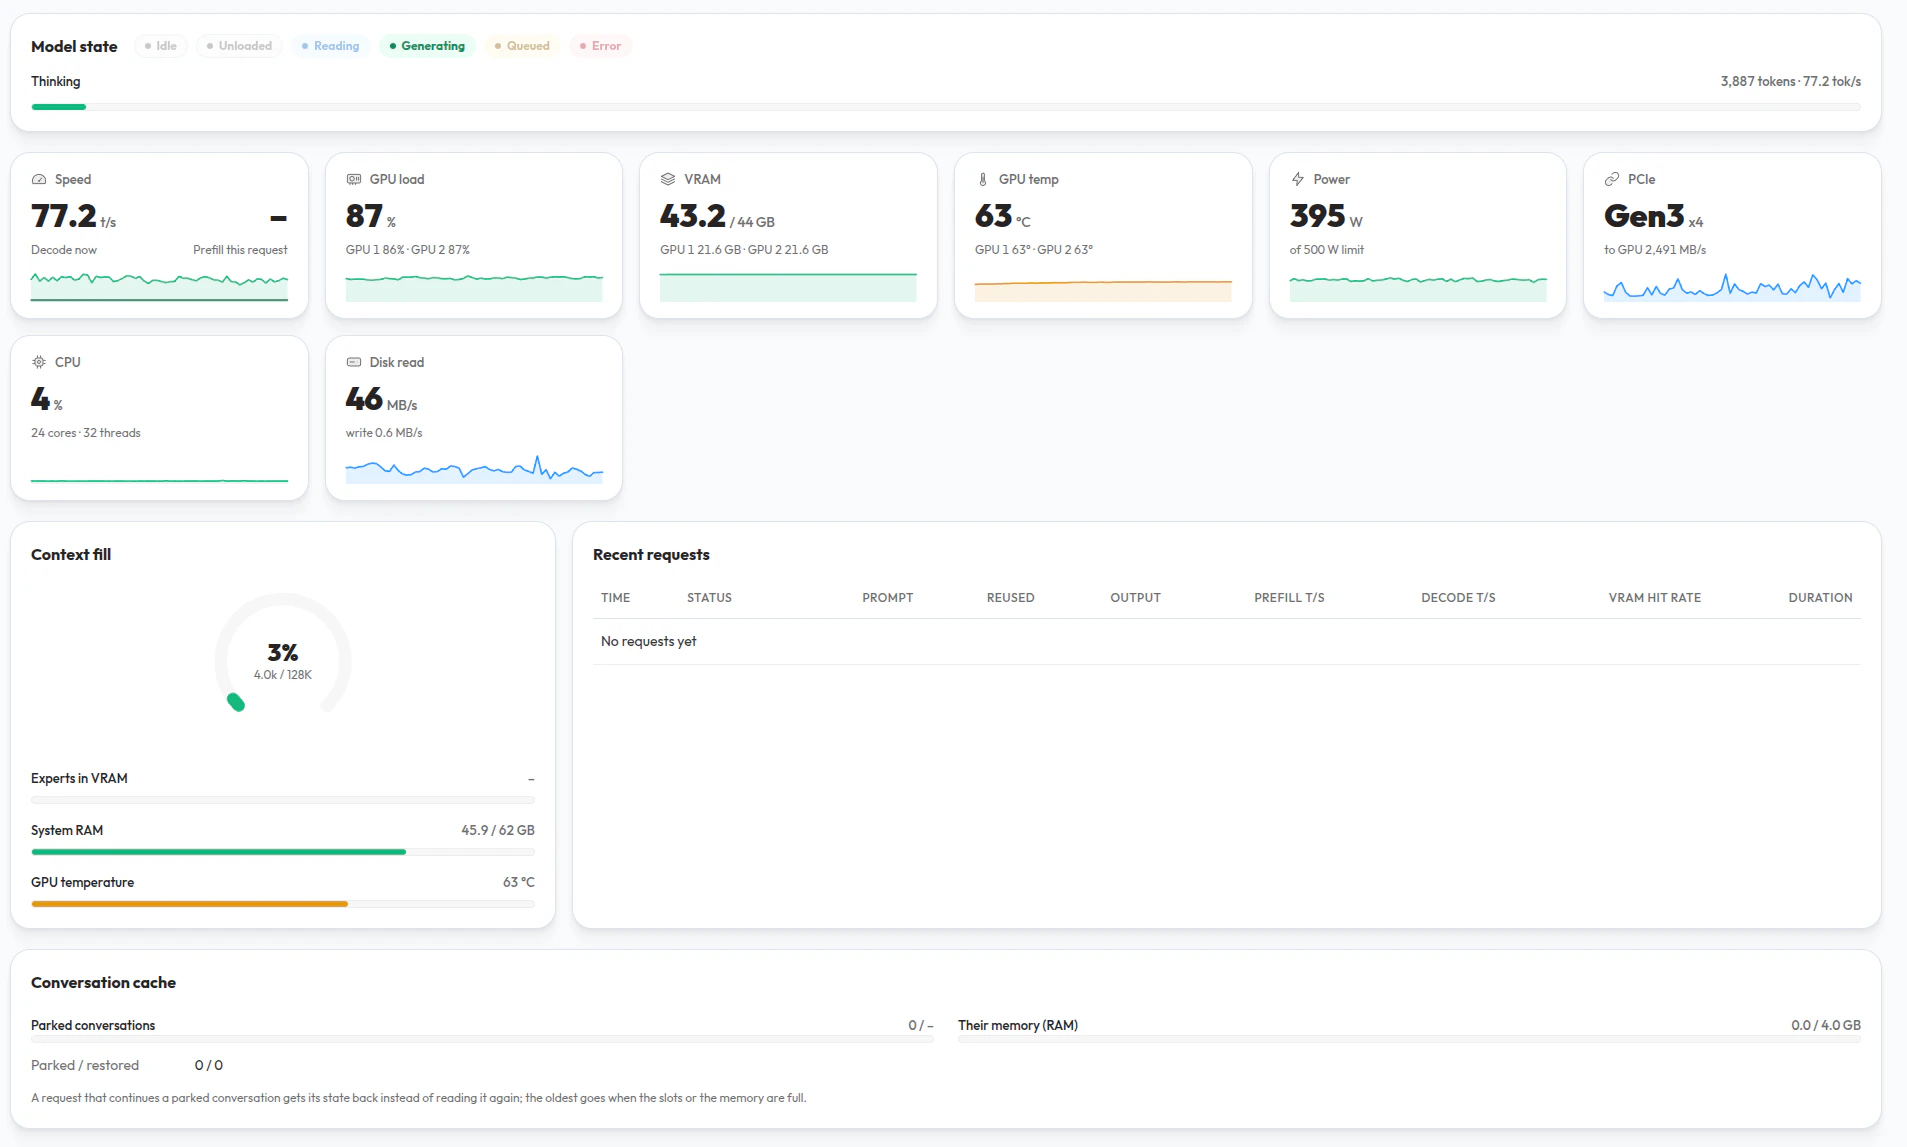
StrataTPの平均で43.1tok/s 瞬間最大で77.2tok/sを記録しました。
ただ、PPは60tok/sまで行くので、まだまだ改善が必要です。
おわりに
PPモード(パイプライン)の60 tok/sにはまだ及びませんが、元々「10 tok/s」しか出なかったOCuLink環境でのTP(テンソルパラレル)を、コードの魔改造によって平均43.1 tok/s(瞬間最大77.2 tok/s)まで引き上げることができました。
PCIe 3.0 x4という細い土管の制約を、NVLinkへの直接ルーティングと独自の1軍・2軍重力場キャッシングでどうにかした結果としては良い結果になったと思います。
次回は、AR900iのPCIスロットにPEX88096 PCIeスイッチボードを導入して帯域自体を拡張したり、Tesla V100の4Way NVLink(300Gbyte/s)でTPを組んで見ようかと思います。
おまけ:今回作成したTP化パッチ
この記事で使用したStrata魔改造パッチ(C++差分)は、以下のリンクからダウンロードできます。
strata_hybrid_tp_complete.patch のダウンロードはこちら (Google Drive)
2026/11/18 追伸
不具合修正 & CPU使用率の改善により、とうとうPPを超えることができました。
一度のみ測定となりますが測定結果は下記になります。
入力プロンプト
「Pythonの標準ライブラリのみを使って、マルチスレッド対応の簡易HTTPサーバーと、その負荷テストを行うクライアントスクリプトを実装してください。コードの解説とエラーハンドリングの設計思想も詳しく書いてください。」
設定
MAXコンテキスト:128K
投機的デコード:6
KVキャッシュ:FP16
PP:55.6tok/s 出力:49,813tok
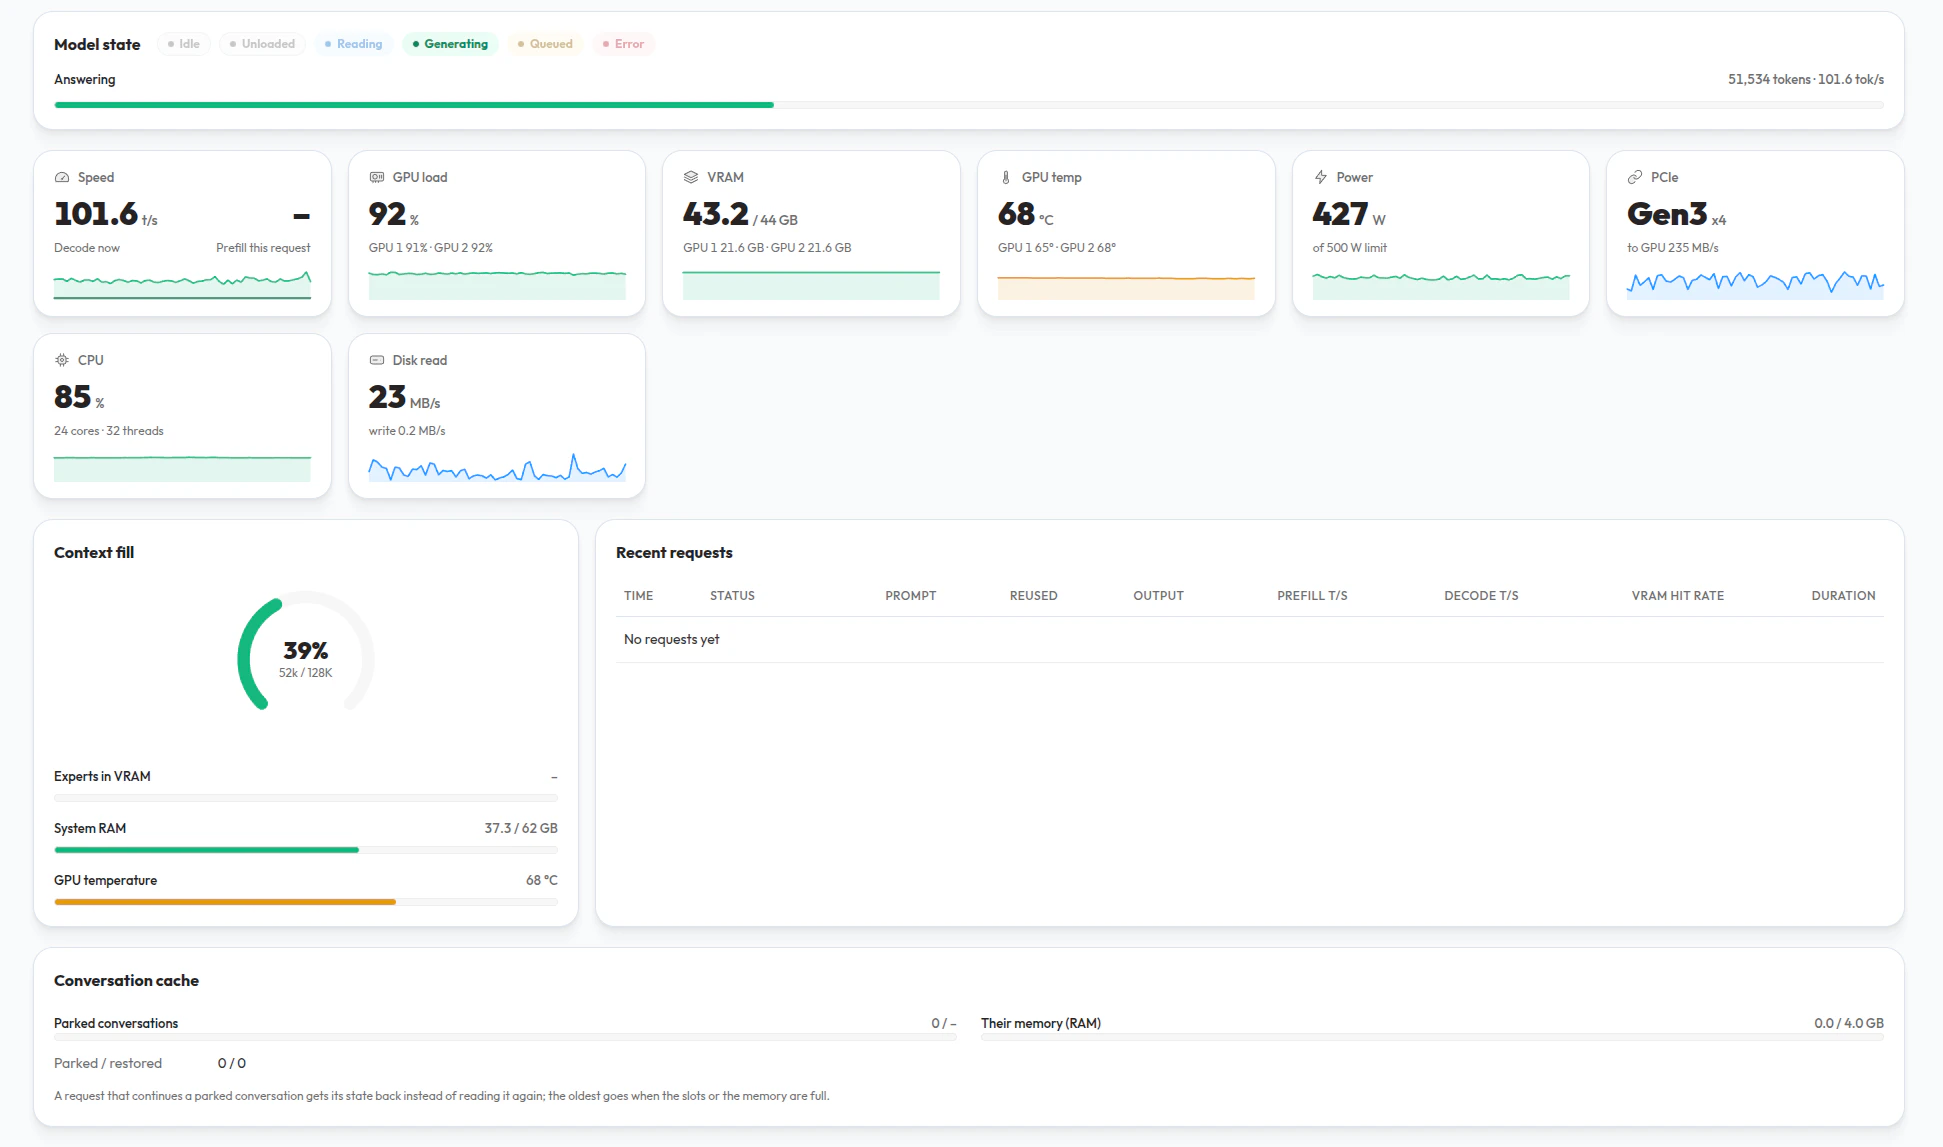
TP:66.5tok/s 出力:63,718tok
下記がPP時のキャプチャになります。(画像にはありませんが瞬間最大が103tok/sくらい?)
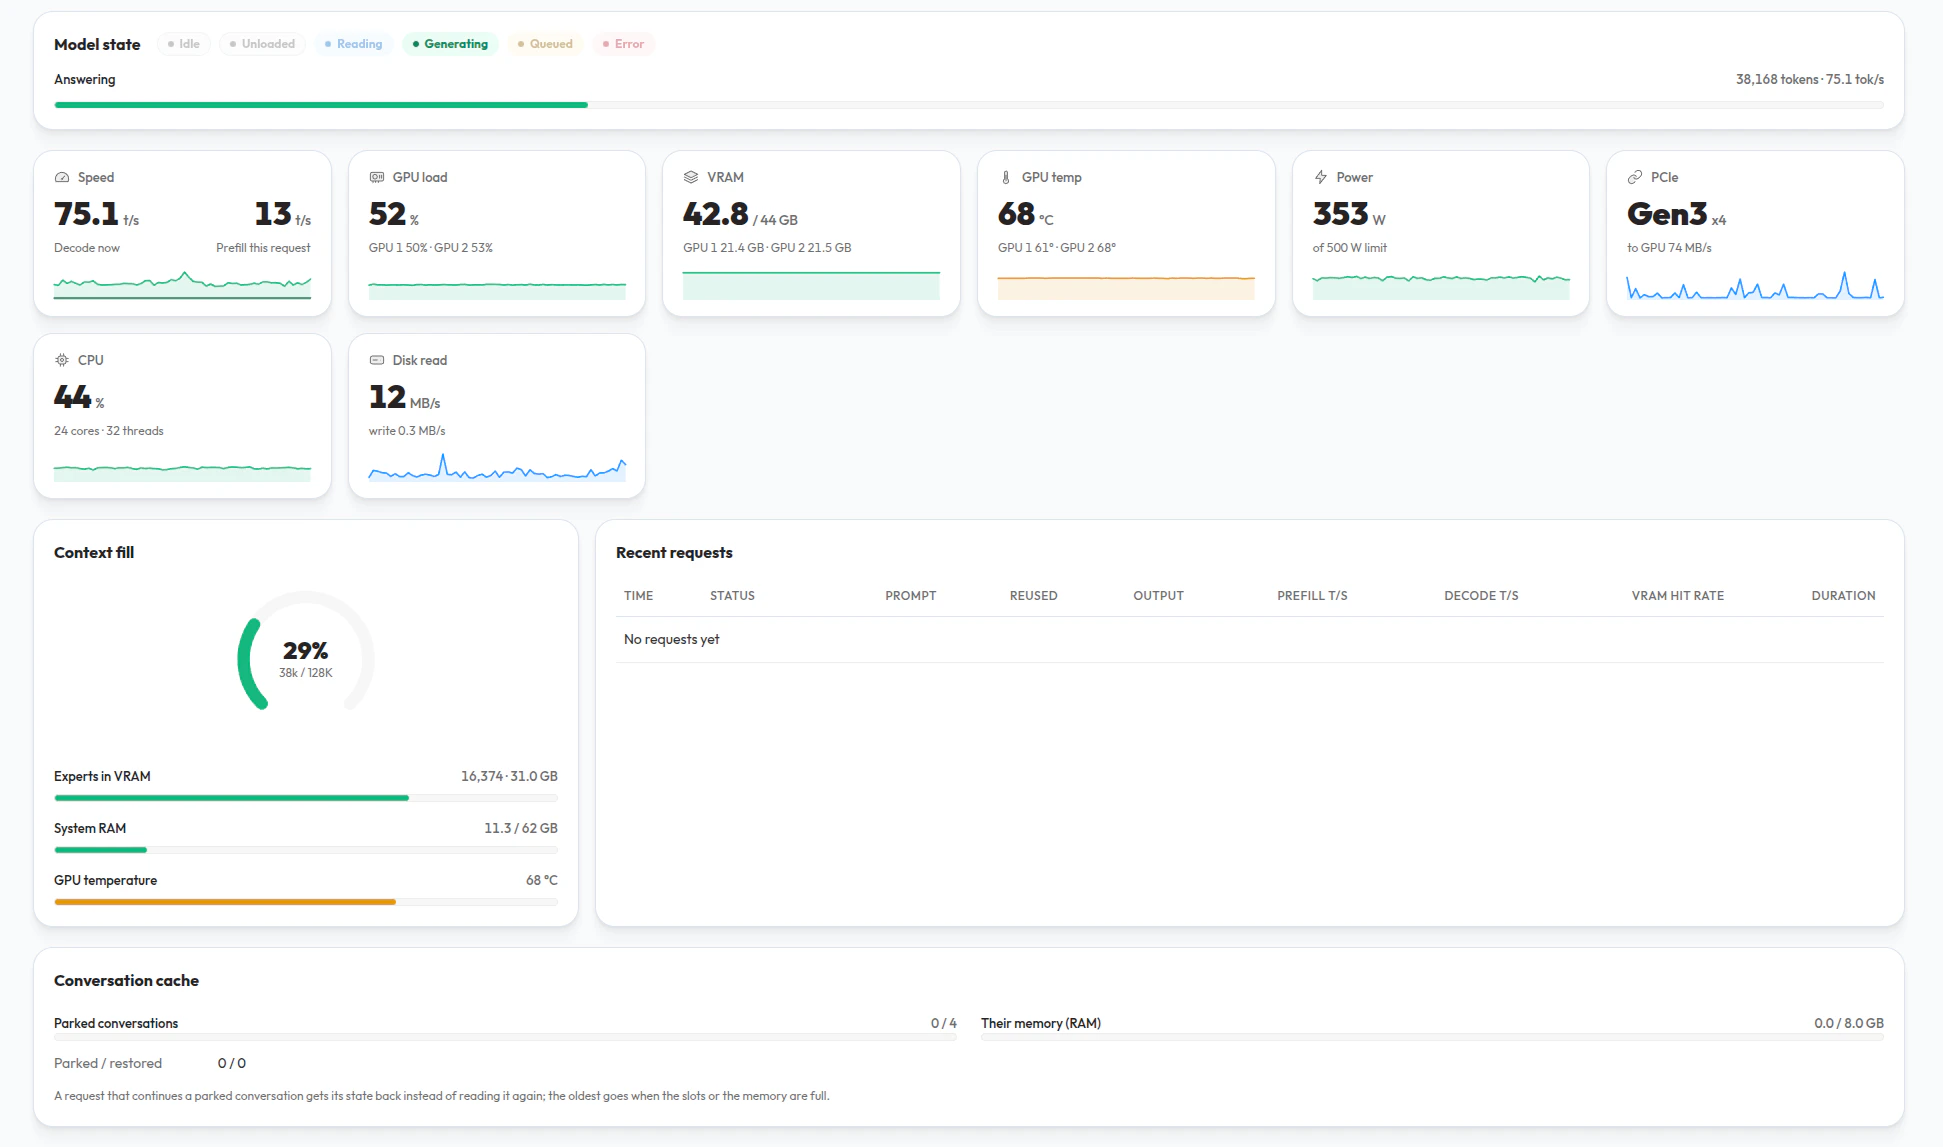
下記がTP時のキャプチャになります。(画像にはありませんが瞬間最大が121tok/sくらい?)
NCCL含めた今回の検証に使用したgit差分のコード一式をgeminiに作ってもらいました。
readmeをみてもらいディレクトリパスを合わせれば再現できると思います。
Strata改造パッチ
※1軍2軍の入れ替えは止めています。(それで66.5tok/sです。)
なお、まだ改善の余地はありますので、改善していくつもりです。
(メモリ使用量、1軍2軍の入れ替え、先出しDMA転送等)
2026/11/19 追伸
メモリ使用量、1軍2軍の入れ替え3軍追加と空間重力波、
ペアリング設定、先出しDMA転送等の処理を加えて
70tok/sを超えました。
入力プロンプト
「Pythonの標準ライブラリのみを使って、マルチスレッド対応の簡易HTTPサーバーと、その負荷テストを行うクライアントスクリプトを実装してください。コードの解説とエラーハンドリングの設計思想も詳しく書いてください。」
設定
MAXコンテキスト:128K
投機的デコード:6
KVキャッシュ:FP16
61568 tokens in 873 s (70.9 tok/s)
うーん、PPが55.6tok/sなのでもう少し行けそうではあるが、ここが限界?
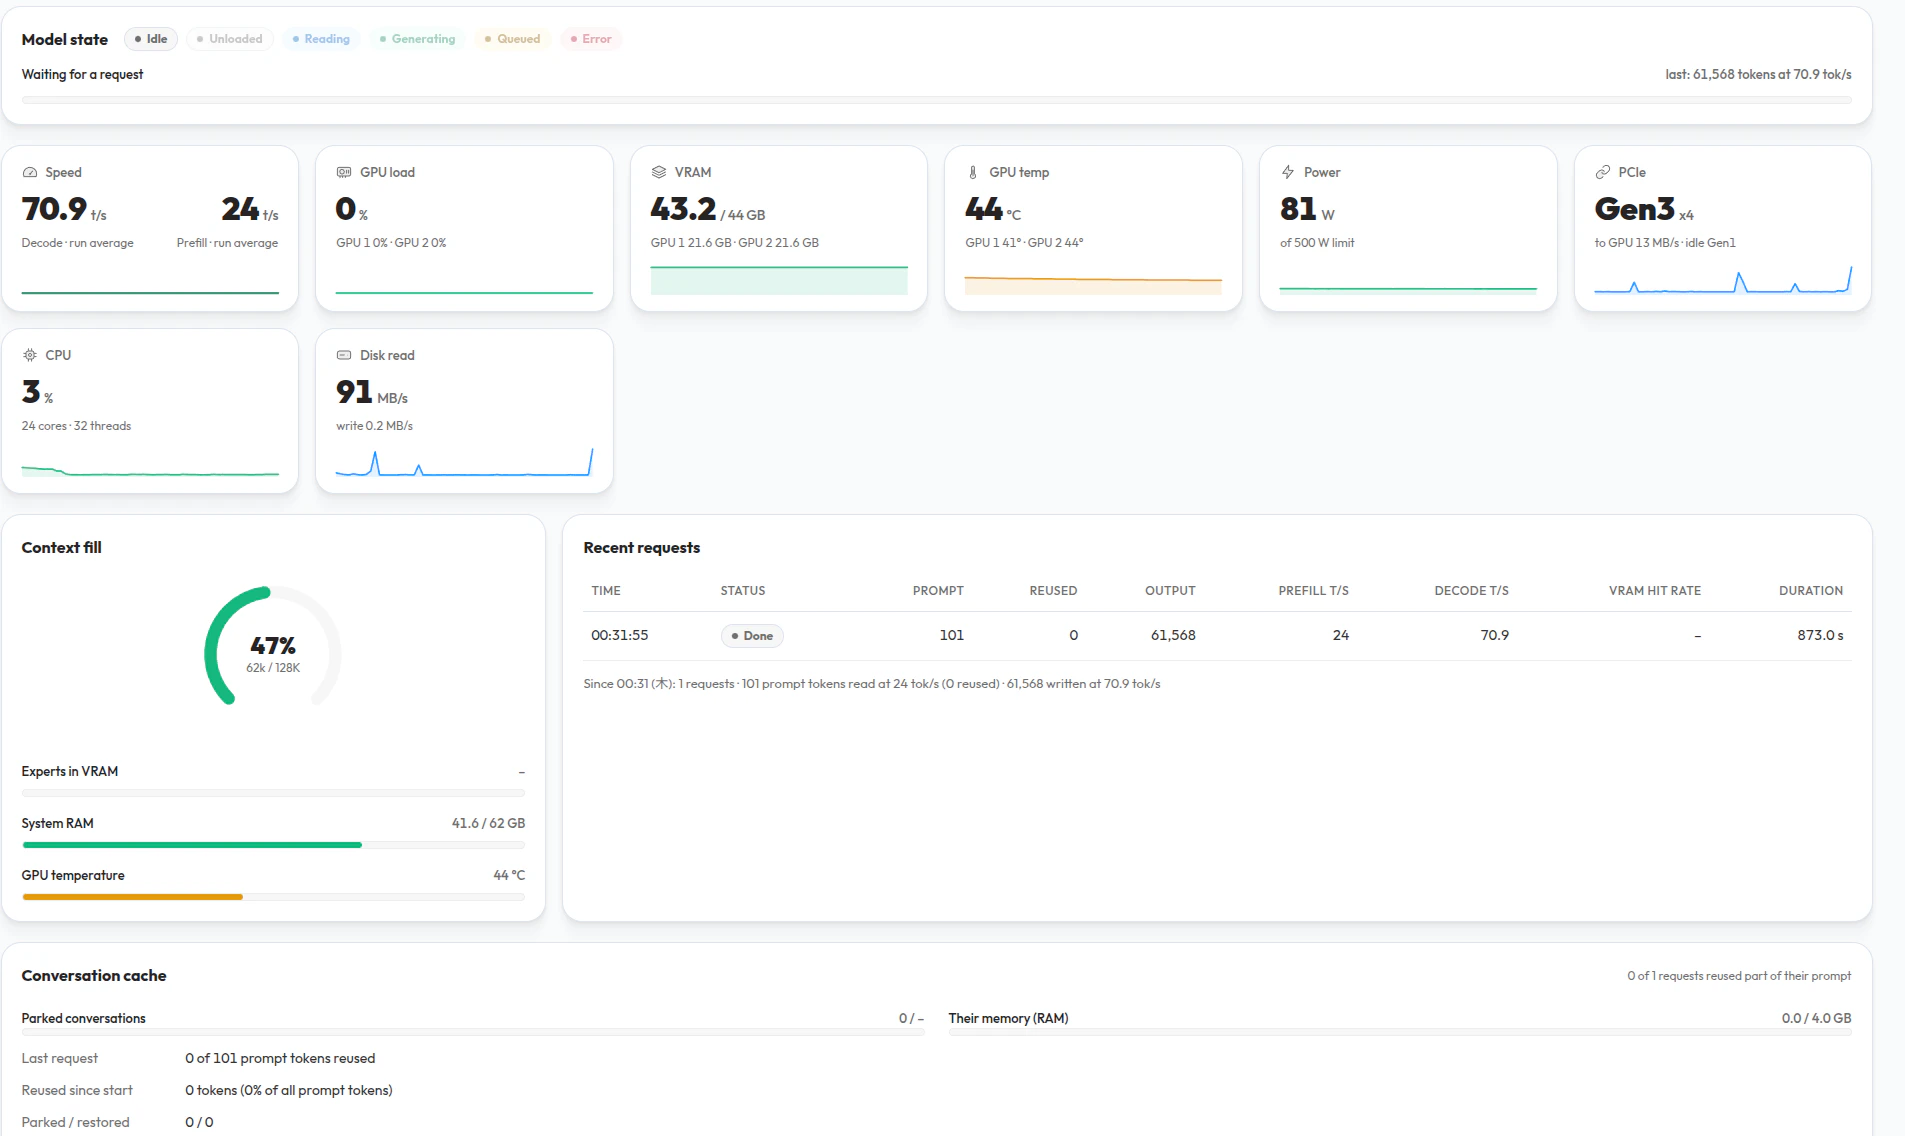
ただし設計上CPU使用率がとんでもない状態になります。
これはCPUをスピンロックで待たせているので、常時85%という状態になりました。
"FNX_CPU_THREADS": "12"というパラメータ設定により常時12スレッドが使用される状態になるからです。(Corei9 24Coreのうち12Coreがこれに使用され、CPUにも推論処理させるので更に使用率を上げます。)
// 【追加】ワーカースレッドの待機ループ(抜粋)
+ if (b_id == my_batch) {
+     if (++idle_spins > 5000000) {
+         std::this_thread::sleep_for(std::chrono::milliseconds(1));
+     } else {
+         #if defined(__x86_64__)
+         __builtin_ia32_pause(); // ロックフリーでCPU負荷を抑えつつ超低遅延待機
+         #endif
+     }
+     continue;
+ }
ここのループがCPU使用率の正体
速度に犠牲はつきものです。
なお、TPによる電力消費はGPUの待機時間がなくなるためPPに比べておよそn倍です。(同時推論時は除きます。)
70.9tok/sを出したパッチセットはこちらからダウンロードできます。
ぜひ、ハーネス付きのAI(Codex等)に読み込ませて各自の環境に合わせてみてください。