
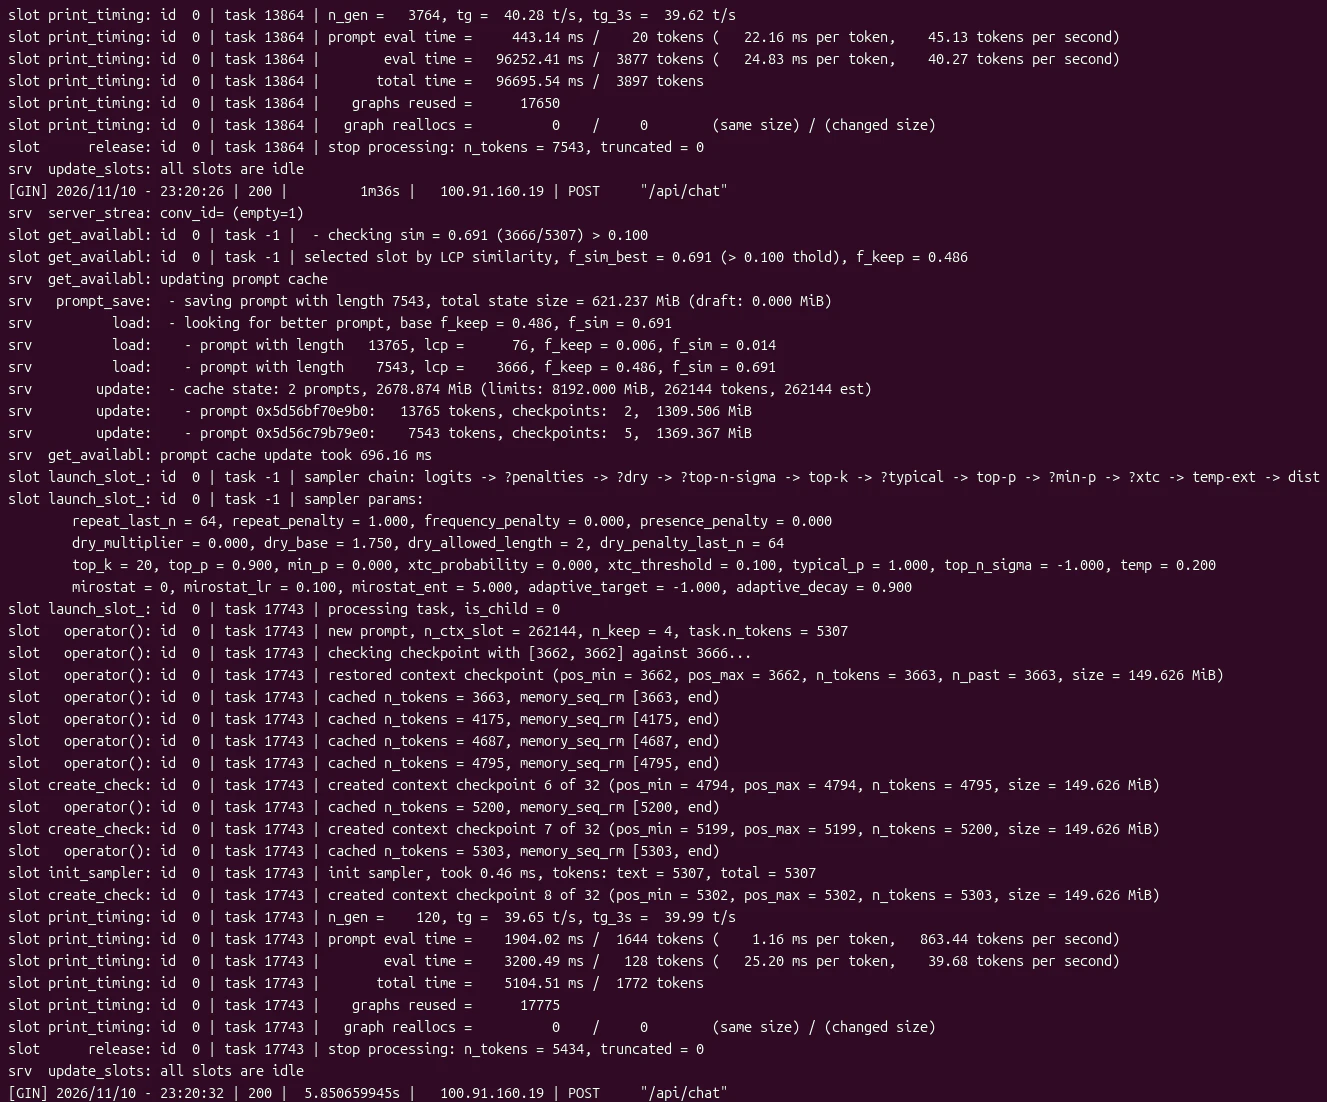
ollamaにて40tok/sを記録したので記念に記述
達成したこと
Tailscale
- 外のスマホからLocalMindを使用してチャットで推論
- スマホをからSSHで状態確認


ローカルLLMとして
旧世代の外付けGPU(RTX 2080Ti 2台)だけで、ollama Qwen3.8 27B 約40tok/sを達成
ちなみに2080Ti 1台だと26tok/sくらいでした。モデルはGPU1台に全て乗ります。
(使用したモデル:Qwen3.8-27B-Uncensored-bughunter-v7 Q4_K_M 16.8GB)
環境
一般的なMini-ITX構成で、特殊な構成なのは外付け化しているRTX2080Tiくらいです。
- マザーボード/CPU:AR900i Core i9-13900HX 24C/32T
- メモリ:DDR5 SODIMM 5600M/T 32GB x 2 = 64GB (内部では5200M/Tで認識)
- GPU0:GeForce RTX5070
- SSD1:SAMSUNG MZVL2512HCJQ-00BH1 512GB (Ubuntu 26.04用)
- SSD2:KIOXIA-EXCERIA PRO SSD 1TB(Windows 11用)
- GPU1:GeForce RTX2080Ti (改造版 VRAM22GB)
- GPU2:GeForce RTX2080Ti (改造版 VRAM22GB)
- USB1:IO-DATA SSD 1TB
- USB2:外付けHDD 3TB
- 電源1:マザボ、RTX5070用 玄人志向の750W
- 電源2:RTX2080Ti用 玄人志向の850W
- ケース:Core V1(Mini-ITXのケース)
お金がありませんのでRTX3090すらも買えません。(笑)
GPU1とGPU2はM.2経由のOculink -> Pci Express Gen3 x 4レーンで動作
RTX2080Tiなので2台のGPU同士をnvlinkで繋いでいます。
(AR900iというマザーボードはオンボードCPUのMini-ITXでM.2スロットが4個ついています。
今回、全て使用していますが、発売時にはM.2スロット4つもいらんだろ!とか言われておりました。)

白色のケーブルは左側からの電源配線です。手前にある四角い物体がnvlinkです。
無負荷時のnvidia-smiの結果はこんな感じとなります。(しっかりと22GB認識しています。)
CUDA Version 13.2(後で出てきます…)
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 595.99.02              Driver Version: 595.99.02      CUDA Version: 13.2     |
+-----------------------------------------+------------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id          Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |           Memory-Usage | GPU-Util  Compute M. |
|                                         |                        |               MIG M. |
|=========================================+========================+======================|
|   0  NVIDIA GeForce RTX 5070        Off |   00000000:01:00.0 Off |                  N/A |
|  0%   41C    P8              8W /  250W |     750MiB /  12227MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
|   1  NVIDIA GeForce RTX 2080 Ti     Off |   00000000:02:00.0 Off |                  N/A |
| 27%   30C    P8             34W /  250W |       5MiB /  22528MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
|   2  NVIDIA GeForce RTX 2080 Ti     Off |   00000000:03:00.0 Off |                  N/A |
| 24%   33C    P8             24W /  250W |       5MiB /  22528MiB |      0%      Default |
|                                         |                        |                  N/A |
+-----------------------------------------+------------------------+----------------------+
テンソル並列非対応のollamaに無理やりテンソル並列を実装しました。
-
なぜollama?
ComfyUIからの呼び出しや、LocalMindから簡単に呼び出せるという感じで、結構使い慣れている感じだったからです。 -
GPUの使用状況は?
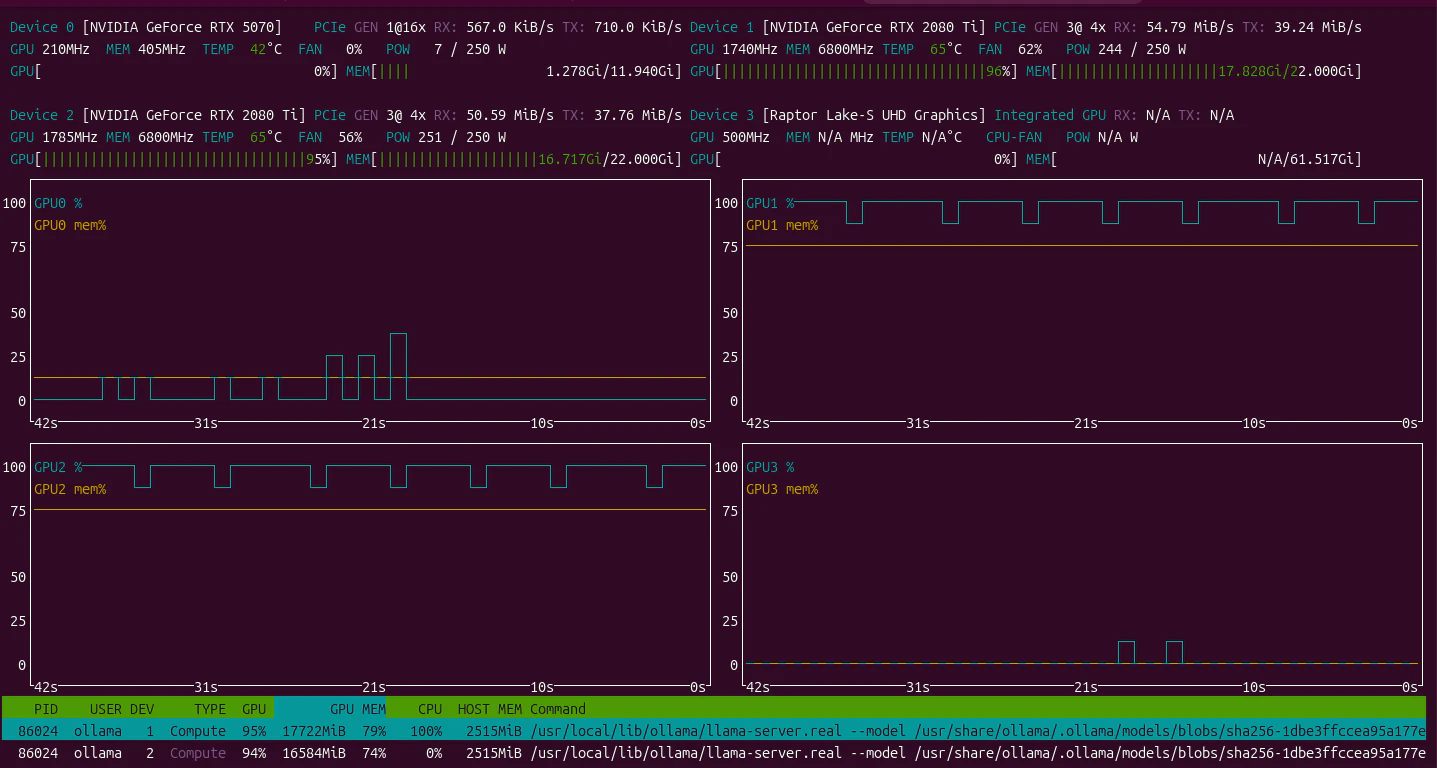
ollamaで推論させたときのnvtopの結果はこんな感じです。
今回はMAXコンテキストを64Kに設定しているため、KVキャッシュによるVRAM使用量が凄まじいことになっています。
Qwen 27Bクラスでもコンテキストをここまで伸ばすとRTX 3090(24GB)1枚ではVRAMから溢れて推論速度が激減しますが、22GB×2台(計44GB)の恩恵で全てVRAMに収まり、速度を維持できています。またRTX5070は未使用です。
テンソル並列の特徴、ローカルLLMの場合
- 通常のパイプラインに比べて1.5倍くらいのパフォーマンスが出ます
- GPU使用率がTP=2(2台テンソル)の場合、2台とも同じスペックのGPUであればおおよそ2台とも100%に張り付きます
(nvlinkなどの広帯域使用時にGPU使用率が50%の場合、PP=パイプラインで動いています。) - GPUが常に高負荷になるので、電気代がすごいことになります
- NVLINKがない場合、PCIeでの通信になるため遅くなります
(RTX5070を参加させてTP=3にすると、36tok/sまで落ちました。)
ここからは長くなります。
方法
ハードウェア/OS
- nvlinkを使用し2080Tiの2台を接続
RTX2080Tiの改造版22GBは中国で需要がある?らしく、2026年11月も値上がりしています。
2026年7月の時点で約7万円くらいだったのが、11月時点で12万円前後まで高騰…
- OSはUbuntu 26.04を使用
WSLを含むWindowsだとnvlinkがドライバレベルで使用できない
これは、GeminiによるとWindowsではnvlinkはPCIeの8レーンからしか認識できないんだそうな。
今回は外付けGPUなのでPCIe3x4となり4レーンなのでWindowsは論外だったようです。
(WSLでコマンド打ってみましたが、nvidia-smi系のコマンドでは認識していますが、pythonのテストコマンドでnvlinkを使用したGPU通信はできませんでした。どなたかやり方知っていたら教えてください。)
nvlinkコマンドの結果
$ nvidia-smi topo -m
	GPU0	GPU1	GPU2	CPU Affinity	NUMA Affinity	GPU NUMA ID
GPU0	 X 	PHB	PHB	0-31	0		N/A
GPU1	PHB	 X 	NV2	0-31	0		N/A
GPU2	PHB	NV2	 X 	0-31	0		N/A

Legend:

  X    = Self
  SYS  = Connection traversing PCIe as well as the SMP interconnect between NUMA nodes (e.g., QPI/UPI)
  NODE = Connection traversing PCIe as well as the interconnect between PCIe Host Bridges within a NUMA node
  PHB  = Connection traversing PCIe as well as a PCIe Host Bridge (typically the CPU)
  PXB  = Connection traversing multiple PCIe bridges (without traversing the PCIe Host Bridge)
  PIX  = Connection traversing at most a single PCIe bridge
  NV#  = Connection traversing a bonded set of # NVLinks
NV2との表示でしっかりとNVLINKとして認識されています。
アプリ側
-
ollamaでテンソル並列を使用
ollama公式ではテンソル並列の使用はサポートしていない
というよりパラメータがない…ではどうするか?ollamaが呼び出す/usr/local/lib/ollama/llama-serverに細工をすれば良いのでは!
まずは/usr/local/lib/ollama/llama-serverをバックアップ
$ sudo mv /usr/local/lib/ollama/llama-server /usr/local/lib/ollama/llama-server.bakつぎにnanoあたりでシェルを作成する
$ sudo nano /usr/local/lib/ollama/llama-server
ということで、以下のようなシェルを用意する(Geminiに作らせた)
#!/bin/sh
export NCCL_DEBUG=INFO
export LimitMEMLOCK=infinity
export NCCL_P2P_DISABLE=0
export NCCL_P2P_LEVEL=SYS
export NCCL_IGNORE_CPU_AFFINITY=1

# 1. Ollamaが渡してきた引数の中からモデルファイルのパスを抽出
MODEL_PATH=""
PREV=""
for i in "$@"; do
    if [ "$PREV" = "--model" ]; then
        MODEL_PATH="$i"
        break
    fi
    PREV="$i"
done

# デフォルト: 巨大モデル(70B等)向けに3枚すべてを使用
GPUS="0,1,2"
SPLIT="11,22,22"

# 2. モデルサイズが 35GB(約 35000000000 バイト)未満なら、5070(GPU 0)を除外
if [ -n "$MODEL_PATH" ] && [ -f "$MODEL_PATH" ]; then
    MODEL_SIZE=$(stat -c%s "$MODEL_PATH")
    if [ "$MODEL_SIZE" -lt 35000000000 ]; then
        # 2080 Ti(GPU 1,2)のみを使用
        GPUS="1,2"
        SPLIT="1,1"
    fi
fi

export CUDA_VISIBLE_DEVICES="$GPUS"
REAL="/usr/local/lib/ollama/llama-server.real"

set -- "$@" \
  --split-mode tensor \
  --tensor-split "$SPLIT" \
  --spec-draft-n-max 8 \
 --flash-attn on

exec "$REAL" "$@"
llama-serverのバイパス先をバックアップからコピー
$ sudo cp /usr/local/lib/ollama/llama-server.bak /usr/local/lib/ollama/llama-server.real下記コマンドで確認
sudo journalctl -u ollama -fうまく動いていそうに見える…

だが、注目したいのがllama_context: n_outputs_max_per_seq = 1 NCCL not compiled in; falling back to internal AllReduce. Recompile with -DGGML_CUDA_NCCL=ON for best multi-GPU performance. ↑ この部分NCCL(NVIDIA Collective Communications Library)がコンパイルされていないのでフォールバックしてinternal AllReduceを使用したとのメッセージ。
つまり、nvidiaの公式のGPU通信のライブラリが使用できていないということのようです。
ここに書いてあるが、【「DGGML_CUDA_NCCL=ON」にして再度コンパイルせよ】とのこと
ということで、llama-serverのビルドから実施します。
-
llama-serverのビルド
Git clonecd ~ git clone https://github.com/ggml-org/llama.cpp.git cd llama.cpp初回はクリーン不要だけど載せておきます。(Geminiに作らせました。)
# 1. 既存のビルドディレクトリをクリーン
cd ~/llama.cpp
rm -rf build
mkdir build
cd build

# 2. CMakeで両方のアーキテクチャとカスタムNCCLを指定してビルド
# 下記は仮に sm_100 としていますが、エラーが出る場合は sm_89(Ada) やネイティブサポートに合わせてください。
cmake .. \
  -DGGML_CUDA=ON \
  -DGGML_CUDA_NCCL=ON \
  -DCMAKE_CUDA_ARCHITECTURES="75;120" \
  -DGGML_CUDA_PEER_MAX_BATCH_SIZE=128

cmake --build . --config Release -j $(nproc)
このあたり、実はGeminiなどのAIに聞いても、AIは40xxまでの情報しか出してくれないことが多く、DCMAKE_CUDA_ARCHITECTURESを100に指定しようとする。50xxシリーズは120らしい。
で、ビルド通る。が、テスト(コマンドはGemini用意)で
~/llama.cpp$ CUDA_VISIBLE_DEVICES=1,2 ./build/bin/llama-server \
  -m ../Qwen3.8-27B-ABLITERATED-Q8_0.gguf \
  -ngl 999 --jinja \
  --host 0.0.0.0 --port 8080 -c 32768 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --split-mode row
 :
 :
 :

<user>-Uranus-Series:20961:20961 [1] NCCL INFO cudaDriverVersion 13020
<user>-Uranus-Series:20961:20961 [1] misc/cudawrap.cc:134 NCCL WARN Retrieve cuGetErrorString failed with 34 status 0
<user>-Uranus-Series:20961:20961 [1] misc/cudawrap.cc:203 NCCL WARN CUDA some PFN functions not found in the library
<user>-Uranus-Series:20961:20961 [1] NCCL INFO Bootstrap : Using enp4s0:192.168.0.220<0>
<user>-Uranus-Series:20961:20961 [1] NCCL INFO NCCL version 2.22.3+cuda12.1
<user>-Uranus-Series:20961:21013 [0] NCCL INFO NET/Plugin: Could not find: libnccl-net.so. Using internal network plugin.

 :
 :
 :

0.10.654.680 E CUDA error: unhandled cuda error (run with NCCL_DEBUG=INFO for details)
0.10.654.684 E   current device: 1, in function ggml_backend_cuda_comm_allreduce_nccl at /home/<user>/llama.cpp/ggml/src/ggml-cuda/ggml-cuda.cu:1186
0.10.654.684 E   ncclAllReduce(tensors[i]->data, tensors[i]->data, ne, ncclFloat, ncclSum, comm_ctx->comms[i], cuda_ctx->stream())
[New LWP 21020]
[New LWP 21019]
[New LWP 21018]
[New LWP 21017]
[New LWP 21016]
[New LWP 21015]
[New LWP 21011]
[New LWP 21010]
[New LWP 21009]
[New LWP 21008]
[New LWP 21007]
[New LWP 21006]
[New LWP 21005]
[New LWP 21004]
[New LWP 21003]
[New LWP 21002]
[New LWP 21001]
[New LWP 21000]
[New LWP 20999]
[New LWP 20998]
[New LWP 20997]
[New LWP 20996]
[New LWP 20995]
[New LWP 20994]
[New LWP 20993]
[New LWP 20992]
[New LWP 20991]
[New LWP 20990]
[New LWP 20989]
[New LWP 20988]
[New LWP 20987]
[New LWP 20986]
[New LWP 20985]
[New LWP 20984]
[New LWP 20983]
[New LWP 20982]
[New LWP 20981]
[New LWP 20980]
[New LWP 20979]
[New LWP 20978]
[New LWP 20977]
[New LWP 20976]
[New LWP 20975]
[New LWP 20968]
[New LWP 20967]
[New LWP 20966]

This GDB supports auto-downloading debuginfo from the following URLs:
<https://debuginfod.ubuntu.com>
Enable debuginfod for this session? (y or [n]) [answered N; input not from terminal]
Debuginfod has been disabled.
To make this setting permanent, add 'set debuginfod enabled off' to .gdbinit.
[Thread debugging using libthread_db enabled]
Using host libthread_db library "/usr/lib/x86_64-linux-gnu/libthread_db.so.1".
__syscall_cancel_arch () at ../sysdeps/unix/sysv/linux/x86_64/syscall_cancel.S:56
⚠️ warning: 56 ../sysdeps/unix/sysv/linux/x86_64/syscall_cancel.S: そのようなファイルやディレクトリはありません
#0  __syscall_cancel_arch () at ../sysdeps/unix/sysv/linux/x86_64/syscall_cancel.S:56
56 in ../sysdeps/unix/sysv/linux/x86_64/syscall_cancel.S
#1  0x0000738427ca039c in __internal_syscall_cancel (a1=<optimized out>, a2=<optimized out>, a3=<optimized out>, a4=<optimized out>, a5=0, a6=0, nr=61) at ./nptl/cancellation.c:49
⚠️ warning: 49 ./nptl/cancellation.c: そのようなファイルやディレクトリはありません
#2  __syscall_cancel (a1=<optimized out>, a2=<optimized out>, a3=<optimized out>, a4=<optimized out>, a5=a5@entry=0, a6=a6@entry=0, nr=61) at ./nptl/cancellation.c:75
75 in ./nptl/cancellation.c
#3  0x0000738427d1cacf in __GI___wait4 (pid=<optimized out>, stat_loc=<optimized out>, options=<optimized out>, usage=<optimized out>) at ../sysdeps/unix/sysv/linux/wait4.c:30
⚠️ warning: 30 ../sysdeps/unix/sysv/linux/wait4.c: そのようなファイルやディレクトリはありません
:
:
:
#18 0x0000738427c2a601 in __libc_start_call_main (main=main@entry=0x636f87f5a2f0 <main>, argc=argc@entry=19, argv=argv@entry=0x7ffc09d15ca8) at ../sysdeps/nptl/libc_start_call_main.h:59
⚠️ warning: 59 ../sysdeps/nptl/libc_start_call_main.h: そのようなファイルやディレクトリはありません
#19 0x0000738427c2a718 in __libc_start_main_impl (main=0x636f87f5a2f0 <main>, argc=19, argv=0x7ffc09d15ca8, init=<optimized out>, fini=<optimized out>, rtld_fini=<optimized out>, stack_end=0x7ffc09d15c98) at ../csu/libc-start.c:360
⚠️ warning: 360 ../csu/libc-start.c: そのようなファイルやディレクトリはありません
#20 0x0000636f87f5a325 in _start ()
[Inferior 1 (process 20961) detached]
 中止                     (コアダンプ) ./build/bin/llama-server -m ../Qwen3.8-27B-ABLITERATED-Q8_0.gguf -ngl 999 --host 0.0.0.0 --port 8080 -c 32768 --flash-attn on -ctk q8_0 -ctv q8_0 --split-mode tensor
といった感じでエラー…
cuda 13.2(冒頭のnvtop)に対して、llamaの参照先のcuda【NCCL version 2.22.3+cuda12.1】
これが元になってエラー
このあたりもGeminiなどのAIが難しいところで、AIは40xxシリーズが最新だと思っている模様で、cuda12をあてがおうとllamaのビルドを勧めてくる…
結局ncclのリビルドが必要とのことで、ncclのビルドも実施
-
ncclのビルド
Git clonerm -rf ~/nccl-src ~/nccl-install git clone https://github.com/NVIDIA/nccl.git ~/nccl-src cd ~/nccl-src git checkout v2.31.2-1 #(ここは最新を持ってくれば良い、たしかこのときはこのVerだった気がする)ビルド(Geminiにコマンドを作成してもらった)
make -j src.build NVCC_GENCODE="-gencode=arch=compute_75,code=sm_75 -gencode=arch=compute_120,code=sm_120"
make src.install CUDA_HOME=$CUDA_HOME NVCC_GENCODE="-gencode=arch=compute_75,code=sm_75 -gencode=arch=compute_120,code=sm_120" PREFIX=$HOME/nccl-install
で、ここでもGeminiはsm_100と勧めてくる。(sm_75がRTX20xx, sm_120がRTX50xx)
-
ncclをリンクした上で、再度llama-serverを実行
cd ~/llama.cpp
unset NCCL_P2P_DISABLE NCCL_P2P_LEVEL NCCL_TOPO_DISABLE NCCL_IGNORE_CPU_AFFINITY

export CUDA_VISIBLE_DEVICES=1,2
export LD_LIBRARY_PATH=$HOME/nccl-install/lib:$LD_LIBRARY_PATH #これが重要
export NCCL_DEBUG=INFO

./build/bin/llama-server \
  -m ../Qwen3.8-27B-ABLITERATED-Q8_0.gguf \
  -ngl 999 \
  --host 0.0.0.0 --port 8080 -c 32768 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --flash-attn on \
  -ctk q8_0 -ctv q8_0 \
  --split-mode tensor
llama-serverがテンソルで起動に成功しました
-
ollamaのライブラリをごっそり更新
/usr/local/lib/ollama/の各ライブラリのバックアップを取った上でsudo systemctl stop ollama # 1. OllamaのCUDA v13用ディレクトリが存在するか確認し、存在する場合はそこにNCCLをコピー sudo mkdir -p /usr/local/lib/ollama/cuda_v13 sudo cp $HOME/nccl-install/lib/libnccl.so* /usr/local/lib/ollama/cuda_v13/ # 2. ついでに一般的なOllamaのlibディレクトリにもコピー sudo cp $HOME/nccl-install/lib/libnccl.so* /usr/local/lib/ollama/ sudo ldconfig sudo systemctl start ollama適当な使い方をして
sudo journalctl -u ollama -fで監視する
最後に
- ログ上でNCCLが出現しきれいにnvlinkを使用してくれていることを確認

最後まで見てくださり、ありがとうございます。
GeForceRTX 2080Ti(改)は2026年11月の相場で12万円/台くらいです。
電源やM.2変換ドックなどを合わせても、2台で3090や4090の24GBより安価で大きいモデルが扱えます。
nvlinkテンソル並列を行うことでトークンデコードやプリフィルが大幅に上昇しました。
(デコードは26tok/s -> 40tok/s)
次はpex88096(PCIeスイッチ PCIe4x16を5ポートに増やす)ボードからTesla V100のバックポートに配線し、nvlinkで4台のV100をnvlinkでテンソル並列を実施予定です。
V100の32GBは高すぎて買えませんので16GBx4で実施予定です。
ちなみに今回の話とはあまり関係ないので書いていませんが、最近の20xx~40xxまでのアンロックは2080Tiにも適応済みです。最初はRTX5070巻き込んでカーネルパニック起きました…
あとnvlink関連でiommuの設定もしたと思いますが、あまり覚えていないので、もしうまくいかなかったりしたら必要かもしれません。