

はじめに
本記事は、Databricks AI/BI Genieスペースの運用・改善に関するベストプラクティスをまとめた後編です。前編と同様に、Databricks公式ドキュメント・公式ブログ・フィールドエンジニアリングでの実導入経験をもとに構成しています。
権限管理、日本語対応テクニック、アンチパターン、本番運用チェックリストを解説します。
前編(データソース設計・指示設定・精度向上PDCAサイクル)はこちら
1. 運用・権限管理
1.1 スペースの権限管理
権限レベル:
| 権限 | できること |
|---|---|
| CAN VIEW | スペースの閲覧のみ |
| CAN RUN | 質問の実行、フィードバック提供 |
| CAN EDIT | 指示の編集、データソース管理 |
| CAN MANAGE | 権限管理、モニタリング、すべての操作 |
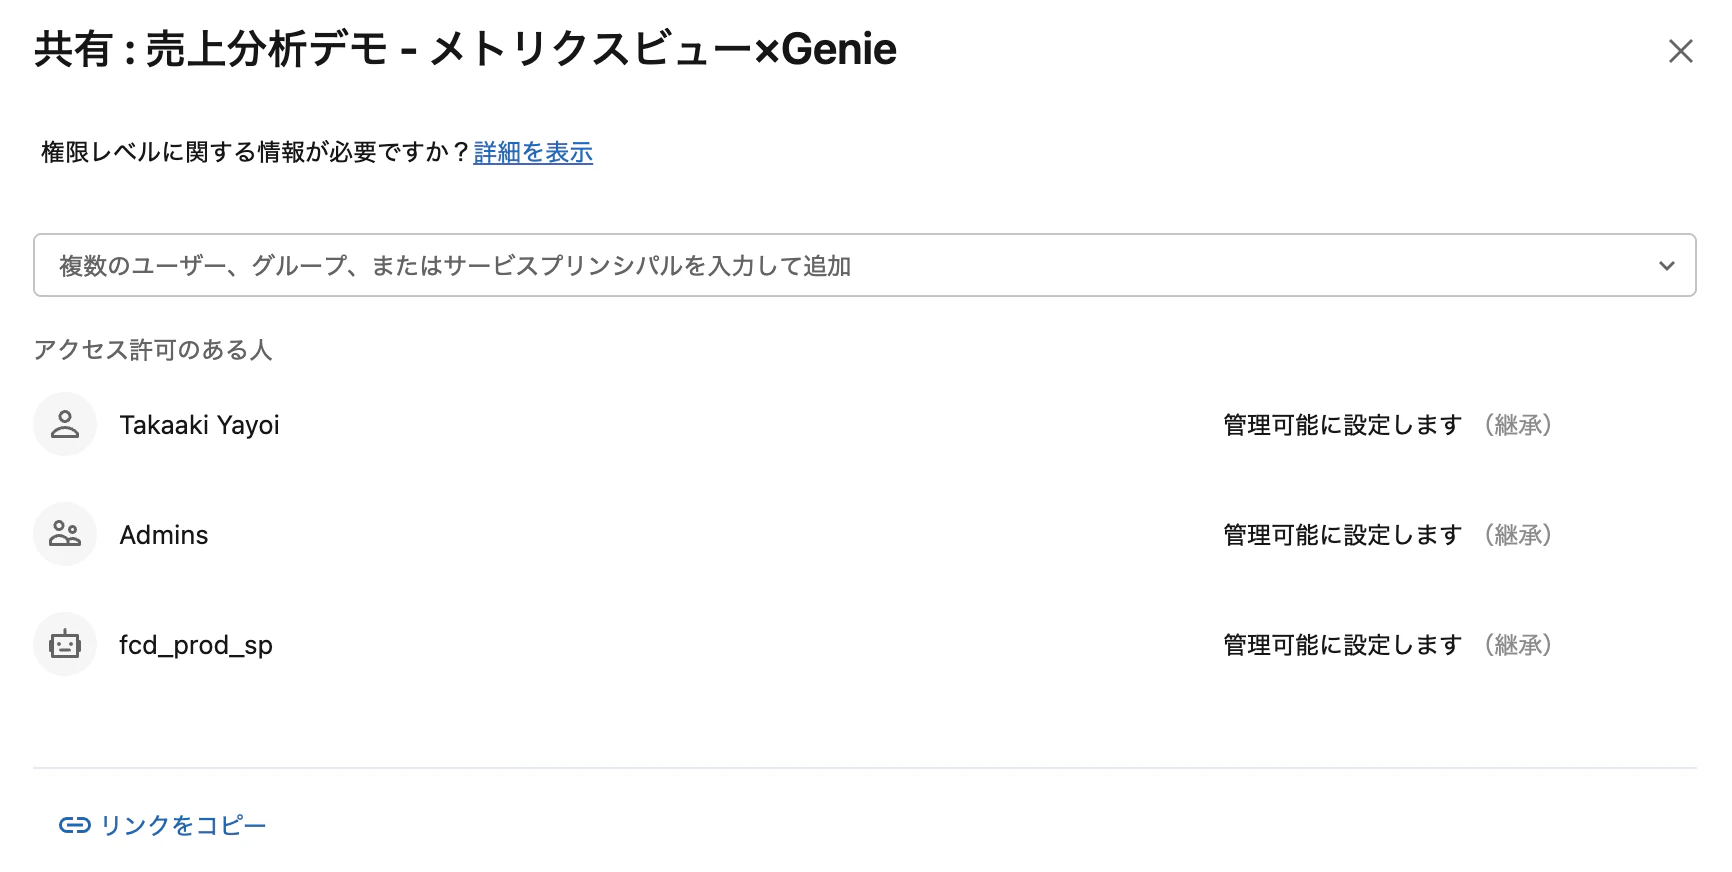
前提条件:
- Databricks SQL エンタイトルメント
- Pro/サーバレスSQLウェアハウスへのCAN USEアクセス
- 対象テーブルへのSELECT権限
スペース作成の権限: SQLエンタイトルメントを持つユーザーは誰でもGenieスペースを作成可能です。「Create Space」という個別の権限は提供されません(Databricksプラットフォームポリシーに準拠)。
モニタリング権限の課題: 現時点ではCAN MANAGE権限がないとモニタリングタブにアクセスできません。モニタリングだけを許可する中間権限は現時点では提供されていません。
セキュリティ:
- データアクセスはUnity Catalogの権限(行フィルター、カラムマスク)に準拠
- クエリはSQLウェアハウスで読み取り専用で実行
- 注意: 「Genieはスペースに明示的に追加されたテーブル以外のテーブルにもクエリを実行できる」(UCの権限で制御)
1.2 複数スペースの管理方法
設計パターン:
- ドメイン別分割: 営業、人事、製造など機能別にスペースを分離
- マルチエージェントスーパーバイザー(MAS): 複数のGenieスペースを統合し、質問を適切なスペースにルーティング
- Databricks Appsでの統合: 複数のGenieスペースをアプリに組み込み、統一インターフェースを提供
MAS利用時の注意点: ルーティングの精度向上には、MASの一般指示にGenieスペースの役割分担を明記することが効果的です。
1.3 Databricks Asset Bundle(DAB)でのGenie管理
現状(2026年3月時点): DABからGenieスペースの詳細設定(テーブル紐づけ、指示等)を宣言的に管理する機能は未提供です。ライフサイクル管理(作成・削除)は可能ですが、詳細設定はREST APIで管理します。
REST APIによるCI/CD:
# 設定のエクスポート
GET /api/2.0/genie/spaces/{id}?include_serialized_space=true

# 設定のインポート/更新
POST /api/2.0/genie/spaces
PUT  /api/2.0/genie/spaces/{id}
- Gitでバージョン管理し、CI/CDパイプラインで環境間へ展開
DABネイティブサポートの最新状況は公式ドキュメントで確認してください。
1.4 フィードバック機能の活用方法
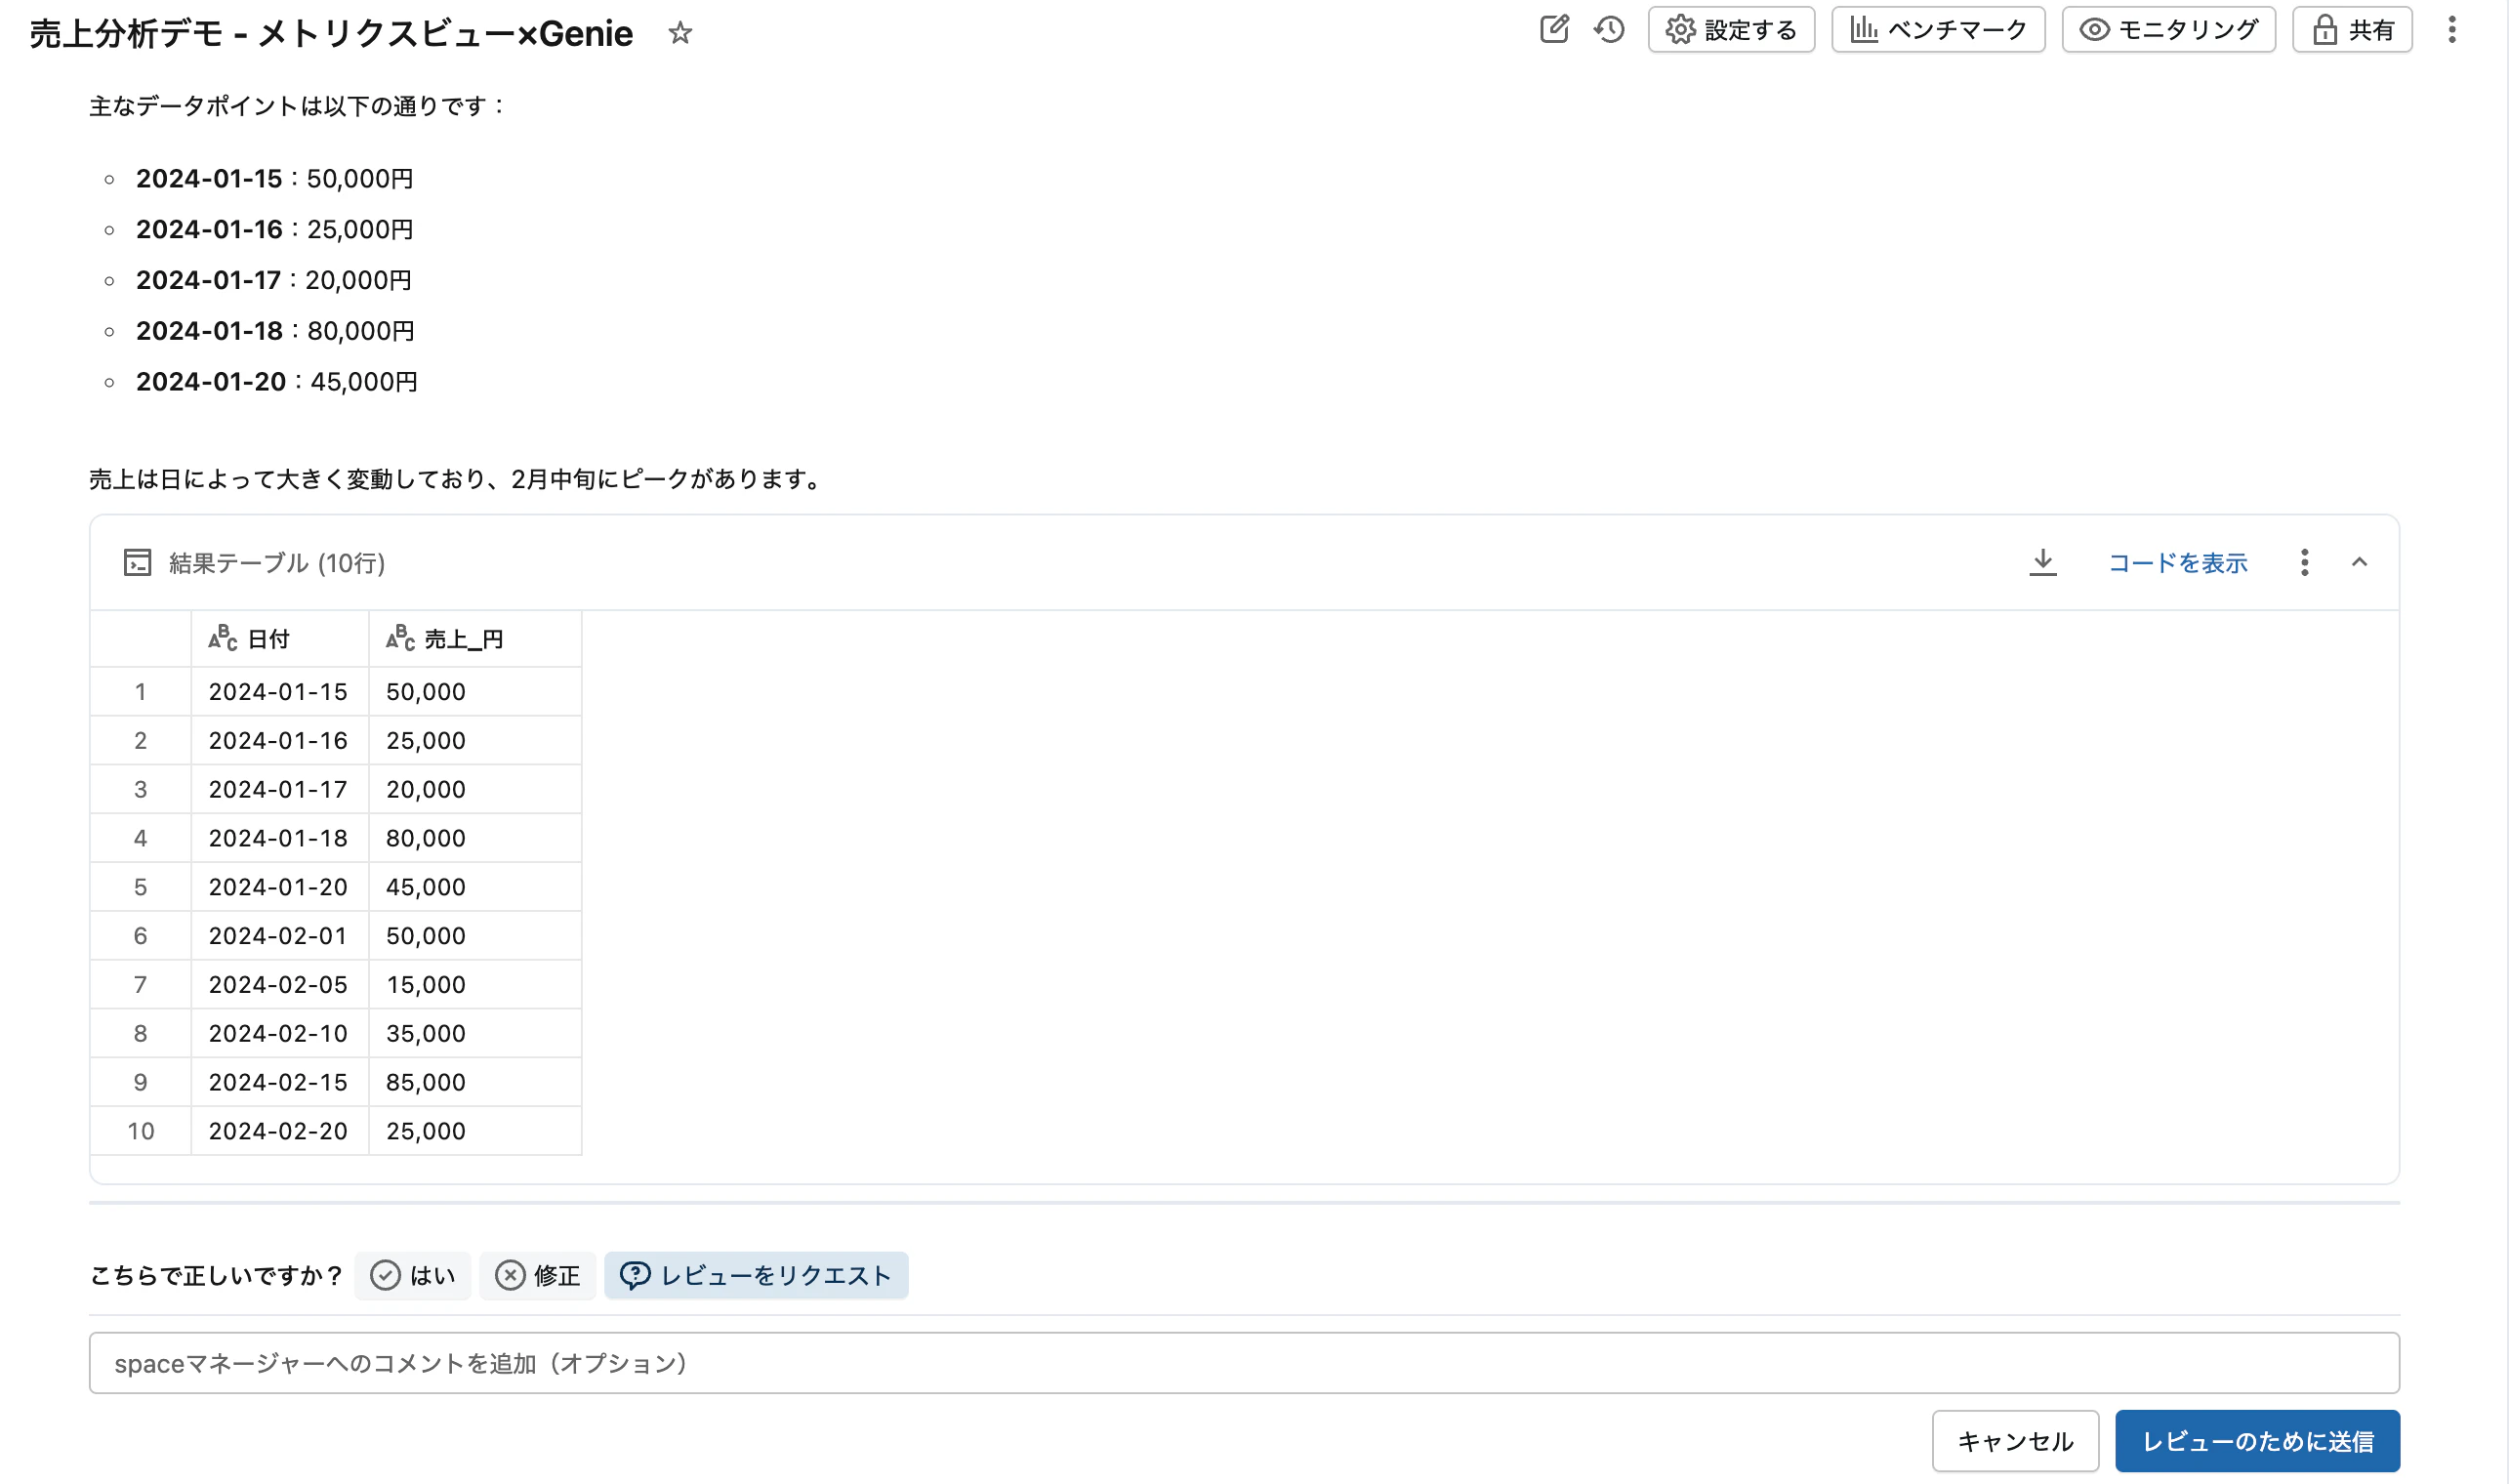
ユーザーフィードバックの種類:
- Yes(正しい): 正確な回答を確認
- 修正(Fix It): 修正付きでの再生成を要求
- レビュー依頼(Request Review): 著者へのレビュー依頼(コメント付き)
フィードバックは直接モデルに影響しない: フィードバックはキュレーターが改善すべき領域を特定するためのシグナルです。著者がフィードバックに基づいて指示やメタデータを手動で更新して初めて改善が反映されます。
1.5 モニタリング・ログの確認方法
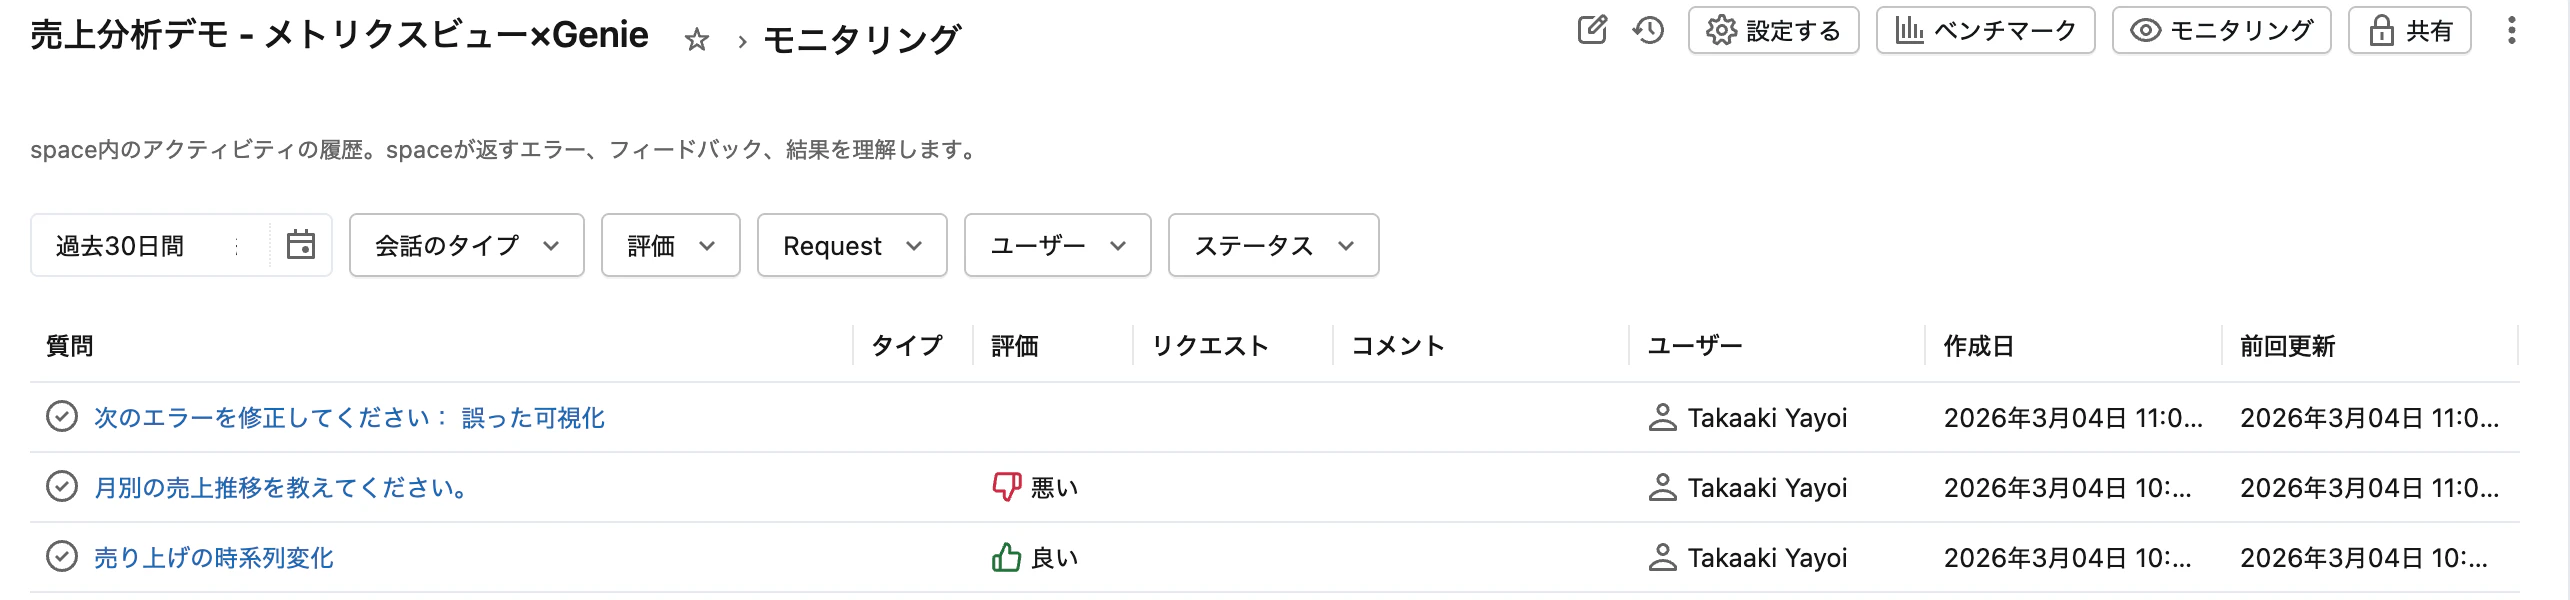
モニタリングタブ: CAN MANAGE権限でアクセス可能です。
- 個別の質問と回答の確認
- ユーザーフィードバックの閲覧
- レビュー依頼の確認
- 時間・評価・ユーザー・ステータスでフィルタリング
監査ログ(Audit Log): system.access.audit テーブルで以下のイベントを追跡:
genieCreateConversationMessage
genieStartConversationMessage
createConversation
createConversationMessage
2. 日本語対応テクニック
2.1 日本語での質問精度を上げるテクニック
公式ドキュメントでは「Databricksは、スペース作成者が選択した言語でできるだけ多くのメタデータを追加することを推奨している。基盤となるシステムプロンプトの影響で、Genieの回答が英語で表示される場合がある」と記載されています。
実践的なテクニック:
| テクニック | 説明 |
|---|---|
| メタデータを日本語で記述 | テーブル/カラムコメントを日本語で書くことで、日本語の質問との照合精度が向上 |
| 指示は日本語でOK | LLMは多言語処理が得意であり、言語間の指示の重複は不要 |
| 「回答は日本語で行うこと」と明記 | 基盤プロンプトが英語のため、テキスト指示での明示が有効 |
| SQL式のシノニムに日本語を含める | 例: measure名 "revenue" にシノニム "売上" を追加 |
| エンティティマッチングでの日本語値対応 | カテゴリカルデータの値が日本語の場合、エンティティマッチングを有効化して正確なマッチングを確保 |
2.2 バイリンガル/多言語Genieスペースの運用
Databricksの公式見解: 「言語間で指示を重複させる必要はない。LLMは通常、言語間でかなりうまく動作する」
推奨事項:
- 1つのスペースで複数言語をサポート可能(言語別に分割する必要なし)
- 指示は主要言語1つで記述すれば十分
- 問題が発生した場合のみ、言語別スペースの分割を検討
2.3 AgentBricks経由での日本語処理の注意点
課題: AgentBricks(Multi-Agent Supervisor)経由の場合、Supervisor Agentが質問を英語に翻訳してGenieに渡すことがあります。これにより、日本語テキスト検索(LIKE句)が英語で処理され、不正確な結果になる場合があります。
対処法: AgentBricksの説明文(Description)に「各種ツールに指示を出す際は日本語で出しなさい」と記述することで対応可能です。
2.4 文字コード・エンコーディングの注意点
- GenieのLLMはUTF-8を処理可能であり、日本語の文字化けは基本的に発生しない
- Delta Lake/Unity CatalogもUTF-8をネイティブサポート
- ただし、CSVファイルアップロード時のエンコーディング(Shift_JIS等)には注意が必要
- カラム名に日本語を使う場合、バックティック(
`)でエスケープが必要な場合がある
3. よくあるミス・アンチパターン
3.1 設計のアンチパターン
| アンチパターン | 正しいアプローチ |
|---|---|
| すべてのテーブルをそのまま追加 | 必要なテーブルのみ、ビューで事前にジョイン |
| テキスト指示にテーブル構造を記述 | UCメタデータとナレッジストアで管理 |
| 指示が多すぎる・冗長 | SQL式 > サンプルSQLクエリ > テキスト指示の優先順位 |
| すべてのドメインを1スペースに | ドメインごとに分割、MASで統合 |
| メタデータなしでスペース作成 | まずUCメタデータを充実させてから |
| AIが生成したメタデータをそのまま使用 | 必ず人間がレビューし修正 |
3.2 運用のアンチパターン
| アンチパターン | 正しいアプローチ |
|---|---|
| テストなしで本番デプロイ | ベンチマーク駆動で段階的にデプロイ |
| 全ユーザーに一斉公開 | 少数のテストユーザーから段階的に展開 |
| フィードバックを無視 | モニタリングタブで定期的に確認・改善 |
| UIからのみ管理 | REST APIでCI/CD・Gitでバージョン管理 |
| 1回作って放置 | 継続的なPDCAサイクルで改善 |
3.3 精度に関するアンチパターン
| アンチパターン | 正しいアプローチ |
|---|---|
| ベンチマークの結果をそのまま信頼 | 非決定性があるため手動レビューも併用 |
| 一般的なダッシュボードの代替としてGenieを使用 | 上位10%の定型KPIはダッシュボード、探索的な質問にGenieを活用 |
| カラムマスク付きテーブルでエンティティマッチング | エンティティマッチングは行フィルター/カラムマスク付きテーブルでは無効 |
4. チェックリスト
4.1 スペース作成前チェックリスト
- 対象トピックとターゲットユーザーを明確に定義した
- 必要なテーブルを5テーブル以下に絞った(最大30)
- 関連テーブルをビューで事前ジョインした
- Unity Catalogにテーブル/カラムコメントを記述した
- PKとFKの関係を定義した
- 不要列を特定し、非表示にする準備をした
- Pro/サーバレスSQLウェアハウスを確認した
- ユーザーのSELECT権限を確認した
4.2 ナレッジストア設定チェックリスト
- スペース固有のテーブル/カラム説明を追加した
- カラムシノニム(同義語)を設定した(日本語含む)
- エンティティマッチングを有効化した
- フォーマット支援(Format Assistance)を有効化した
- JOIN関係を正しく定義した
- SQL式でフィルター・メジャー・ディメンションを定義した
4.3 指示設定チェックリスト
- SQL式による指標・フィルター定義を優先した
- 複雑なパターンにはサンプルSQLクエリを追加した
- テキスト指示は最後の手段として最小限にした
- 矛盾する指示がないことを確認した
- 日付の解釈ルールを明記した
- 文字列比較のルール(ILIKE等)を指定した
- 結果のフォーマット指示を追加した
- 日本語で回答するよう指示した
- 明確化質問の方法を定義した
4.4 精度検証チェックリスト
- ベンチマーク質問を作成した(最低10-20問推奨)
- ベンチマークを実行し、結果を確認した
- 不合格のパターンを分析し、対策を実施した
- 重要な質問には信頼できる資産(パラメータ化SQLクエリ/ユーザー定義関数)を用意した
- テストユーザーによる評価を実施した
- フィードバックに基づいて改善した
- 改善後のベンチマーク結果を記録した
4.5 本番運用チェックリスト
- 権限設定を確認した(CAN RUN: エンドユーザー、CAN MANAGE: 管理者)
- モニタリングタブのアクセスを確認した
- 監査ログの設定を確認した
- CI/CDパイプラインを構築した(APIベース)
- 少数のテストユーザーで先行リリースした
- フィードバック対応プロセスを定義した
- 定期的なPDCAサイクルのスケジュールを設定した
- スペースの利用状況モニタリングを開始した
まとめ
前後編を通じて、Genieスペースの設計から本番運用までのベストプラクティスを網羅しました。
全体を通じた重要原則の振り返り:
- データモデルが基盤: テーブルを絞り、メタデータを充実させることが最優先
- 指示はピラミッド型: SQL式 → サンプルSQLクエリ → テキスト指示の順で設定
- ベンチマーク駆動のPDCA: 測定なき改善はない。80%合格率を目標に反復改善
- 信頼できる資産で信頼性を確保: 重要なKPIには必ずパラメータ化SQLクエリかユーザー定義関数を用意
- 日本語対応はメタデータから: コメントを日本語で書き、テキスト指示に「日本語で回答」を明記
- 継続的な運用が前提: 1回作って終わりではなく、フィードバックを活かして改善し続ける
Genieは活発に開発が続けられており、機能や仕様は随時更新されます。最新情報は公式ドキュメントを参照してください。
参考資料
公式ドキュメント(日本語版)
- 効果的なGenieスペースをキュレーションする - ベストプラクティスの公式ガイド
- AI/BI Genieスペースの設定と管理 - セットアップと管理
- より信頼性の高いGenie spacesのためのナレッジストアを構築する - ナレッジストアの構築
- AI/BI Genieスペースで信頼できる資産を使用する - 信頼できる資産の活用
- Genie APIを使用してGenieをアプリケーションに統合する - API統合とCI/CD
- AI/BI Genieスペースとは - 日本語公式ドキュメント
ブログ記事
- How to Build Production-Ready Genie Spaces - 本番運用ガイド
- From Data to Dialogue: Best Practices Guide - 高性能スペース構築ガイド
- Building Confidence with Benchmarks - ベンチマーク活用ガイド
- Best Practices for AI/BI Genie Spaces (Medium) - SME Engineeringブログ