
はじめに
生成AIの使い方を聞くと、「分からないことを質問して、答えを受け取る」という使い方が一番多いように感じます。調べ物の代わりとして使う、いわゆるQ&Aです。これはこれで便利ですが、私が普段AIに任せている仕事の大半は、この形には収まっていません。
業務では、Claude Codeをベースにしたツールを使っています。プロトタイプの開発から、仕様の確認や性能の最適化といった技術調査、そして結果をまとめたレポートの作成まで、ひと続きでAIと進めています。体感として、以前とは比べものにならない速さで回るようになりました。
速くなった理由を振り返ると、AIの答えが賢くなったからだけではありません。使い方が次の形になっていることが大きいと考えています。
- やりたいことの方向性をAIに渡す
- AIと一緒に、方向性を具体的な作業に落とし込む
- 作業した結果をAIに返し、次の作業を決める
この記事では、この「サイクルとしての使い方」を、自分の実例で紹介します。Q&Aとの違いは、何を聞けばいいか分かっていない段階から始められることです。後半では、同じやり方が仕事以外の取り組みでも効くことにも触れます。
以前、AIとの付き合い方について書いた記事があります。あちらは考え方の話が中心だったので、今回は実際のやり取りで具体的に書いていきます。
Q&Aとサイクルの違い
Q&Aとサイクルの違いを表にまとめます。
| Q&A | サイクル | |
|---|---|---|
| 始められる段階 | 何を聞けばいいか分かっている | 方向性しか決まっていない |
| 人間が渡すもの | 質問 | 方向性、作業の結果、気づいたずれ |
| AIの出力の位置づけ | 答え | 次に自分が判断するための材料 |
| 1回のやり取りで終わるか | 終わる | 結果を返して次の作業につなげる |
| 次の会話への影響 | 引き継がれない | 直した内容がルールとして残る |
図にすると次のようになります。
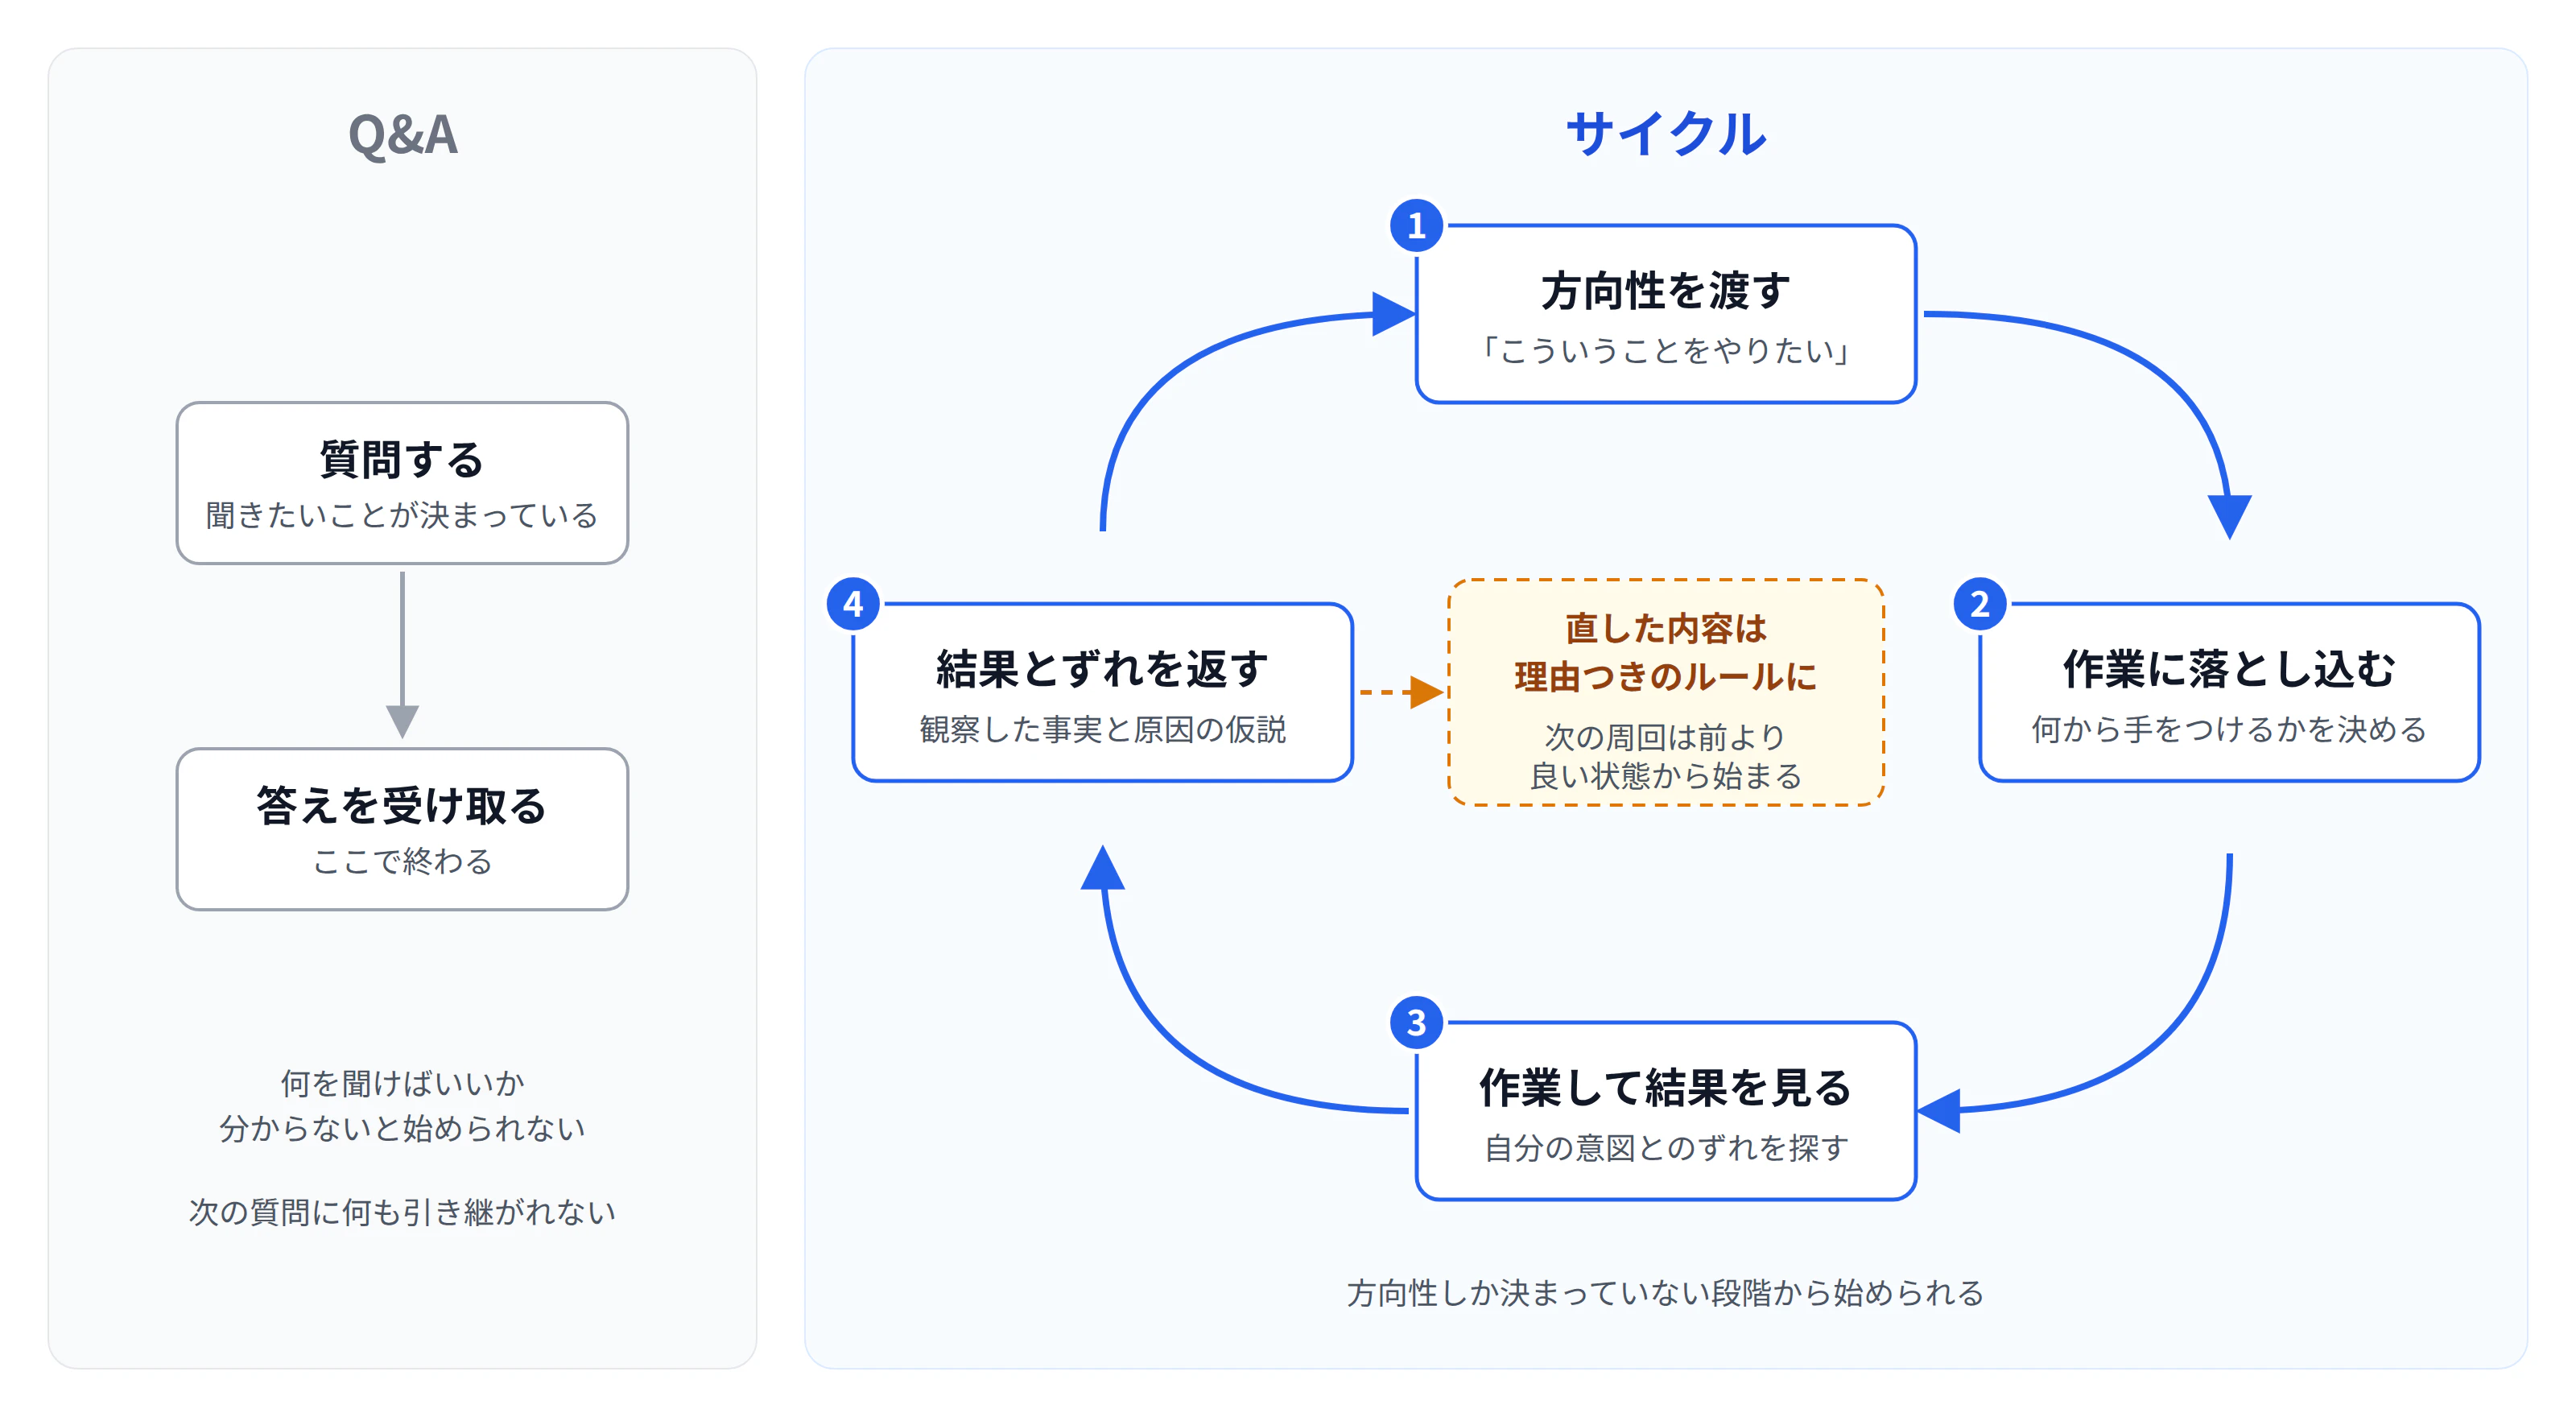
一番大きな違いは、始められる段階です。Q&Aは、質問を言葉にできて初めて使えます。サイクルとして使うと、「こういうことをやりたい」という方向性だけの段階から始められます。方向性を具体的な作業に変える部分は、多くの人が取り組みを始められずに止まる部分でもあります。ここをAIと一緒に進められることが、新しいことを気軽に始められる理由だと考えています。
もう一つの違いは、AIの出力の扱い方です。サイクルでは、AIの出力をそのまま答えとして受け取りません。出力を見て、自分の意図とのずれを見つけ、そのずれを次の指示として返します。結果の質を決めているのは、この「ずれを見つけて返す」部分です。
業務での例
私の業務の中心は、Databricksの新しい機能を検証して、その結果を社内外に伝えることです。検証用のノートブックを作り、実行し、結果を確かめて、レポートや記事にまとめる。この一連の流れを、ほぼすべてAIと進めています。以下は、その中からサイクルがよく見える例です。
評価の設計を3回作り直した
MLflowでAgent Skillを評価する検証をしたときの例です。スキルを書く前の版 (v1) と書いた後の版 (v2) を比べて、スキルの効果を測るのが目的でした。
1回目は、v1とv2のスコアがどちらも100%になり、差が出ませんでした。結果を見て原因を考えたところ、v1から抜いたルール (返金の前に本人確認をする) は、モデルがもともと常識として知っている内容でした。書いても書かなくても同じ動きになるので、差が出ないのは当然です。そこで、抜くルールを組織固有のものに作り直すよう指示しました。
- 返金期限は配送日から数える
- 未配送の注文は期限の対象外にする
- 20,000円以上の返金はエスカレーションする
- 返金履歴が3回以上ある顧客はエスカレーションする
2回目は、トレースを確認して別の問題に気づきました。スキルに何も書いていないv1でも、返金履歴を照会するツールが呼ばれていたのです。モデルは使えるツールを一通り呼ぶので、「ツールを呼んだか」で測るスコアラーでは差がつきません。そこで、「返金履歴の照会が注文の照会より前か」という順序で判定するように変えました。
3回目で、ようやく差が出ました。
| 評価項目 | v1 | v2 |
|---|---|---|
| decision_correctness | 62.5% | 100% |
| ledger_before_orders | 12.5% | 100% |
| policy_compliance | 75% | 100% |
| verify_before_orders | 100% | 100% |
振り返ると、AIに渡していたのは「うまくいかない」という感想ではありませんでした。「スコアが全部100%だった」「v1でもツールが呼ばれていた」という観察した事実と、「ルールがモデルの常識側にあるのではないか」という原因の仮説です。事実と仮説をセットで返すと、AIは設計の直し方を具体的に出せます。感想だけを返すと、AIは何を直せばいいか分からず、的外れな修正が返ってきがちです。
前提が崩れたら、方針を切り替える
同じ検証では、スキルの置き場所として最初はUnity CatalogのSkillsを使うつもりでした。ところが調べていくうちに、UC Skillsはローカルのコーディングエージェント向けのレジストリだと分かりました。今回の用途とは合わないので、その時点で使うのをやめ、Unity Catalogのボリュームに SKILL.md を置く形に切り替えています。
別の検証では、Databricks Free Editionのサーバーレスノートブックで import psycopg を実行した時点でカーネルが落ちました。回避策を探し続けることもできましたが、検証の目的はそこではありません。検証環境を別のワークスペースに移して先に進めました。
AIは、頼めば回避策をいくらでも出してきます。そのまま付き合うと、本来の目的から離れたところで時間が過ぎていきます。前提が崩れたと分かった時点で方針を切り替えるのは、人間の側の判断です。
一度の失敗を確認手順として残した
AIが間違えたときの直し方にも、Q&Aとの違いが出ます。
Omnigentの最新版をAIに確認したとき、AIは古いリリース一覧のページを根拠に「最新版はv0.13.0」と答えました。実際にはv0.15.0が出ていました。
このとき、間違いを指摘して終わりにはしませんでした。次からの確認手順として、次の内容をClaudeのメモリに残しています。
- GitHubのリリースは、一覧ページだけで判断せず、releases/latestやAPIなど別の経路でも確かめる
- リリース間隔から外れるなど違和感があれば、追加で確認する
- 確かめきれないときは、確認した情報源と範囲を添えて答える
ポイントは、ルールに理由を添えていることです。理由があると、AIは似た別の場面にもルールを当てはめられます。ルールだけだと、書かれた場面以外では外しやすくなります。
記事の書き方も同じように積み上げています。たとえば、Markdownで太字にするとき、日本語の句読点の直後に閉じの ** があると強調にならず、記号がそのまま表示されることがあります。これを一度指摘したときに、Markdownの仕様上の理由も添えて残しました。こうした指摘は、メモリのほか、記事執筆用のスキルとしてもまとめています。Q&Aではやり取りが1回で終わりますが、サイクルでは直した内容が次の会話に引き継がれ、回すほど最初の出力が良くなっていきます。
弱点から逆算して、試験対策の教材を作った
Databricks Certified Context Engineer Associateの受験準備も、サイクルで進めました。
- 公式のExam Guideのセクション構成に沿って、模擬試験アプリをAIと作った
- 模擬試験を解いた結果、45問中40問正解で、弱点はセクション4 (Memory Architecture with Lakebase and MLflow) だと分かった
- 結果をAIに渡し、セクション4の内容を実際に手を動かして学ぶノートブックを作った
- ノートブックを検証して記事にし、本番の試験に合格した
最初にあったのは「合格したい」という方向性だけです。模擬試験の結果をAIに返したことで、次にやるべき作業が「セクション4のハンズオン」と具体的に決まりました。
こちらが模擬試験アプリです。

仕事以外でも同じやり方が効く
ここまでは業務の例でしたが、同じやり方は仕事以外の取り組みでも効きます。
アプリ開発
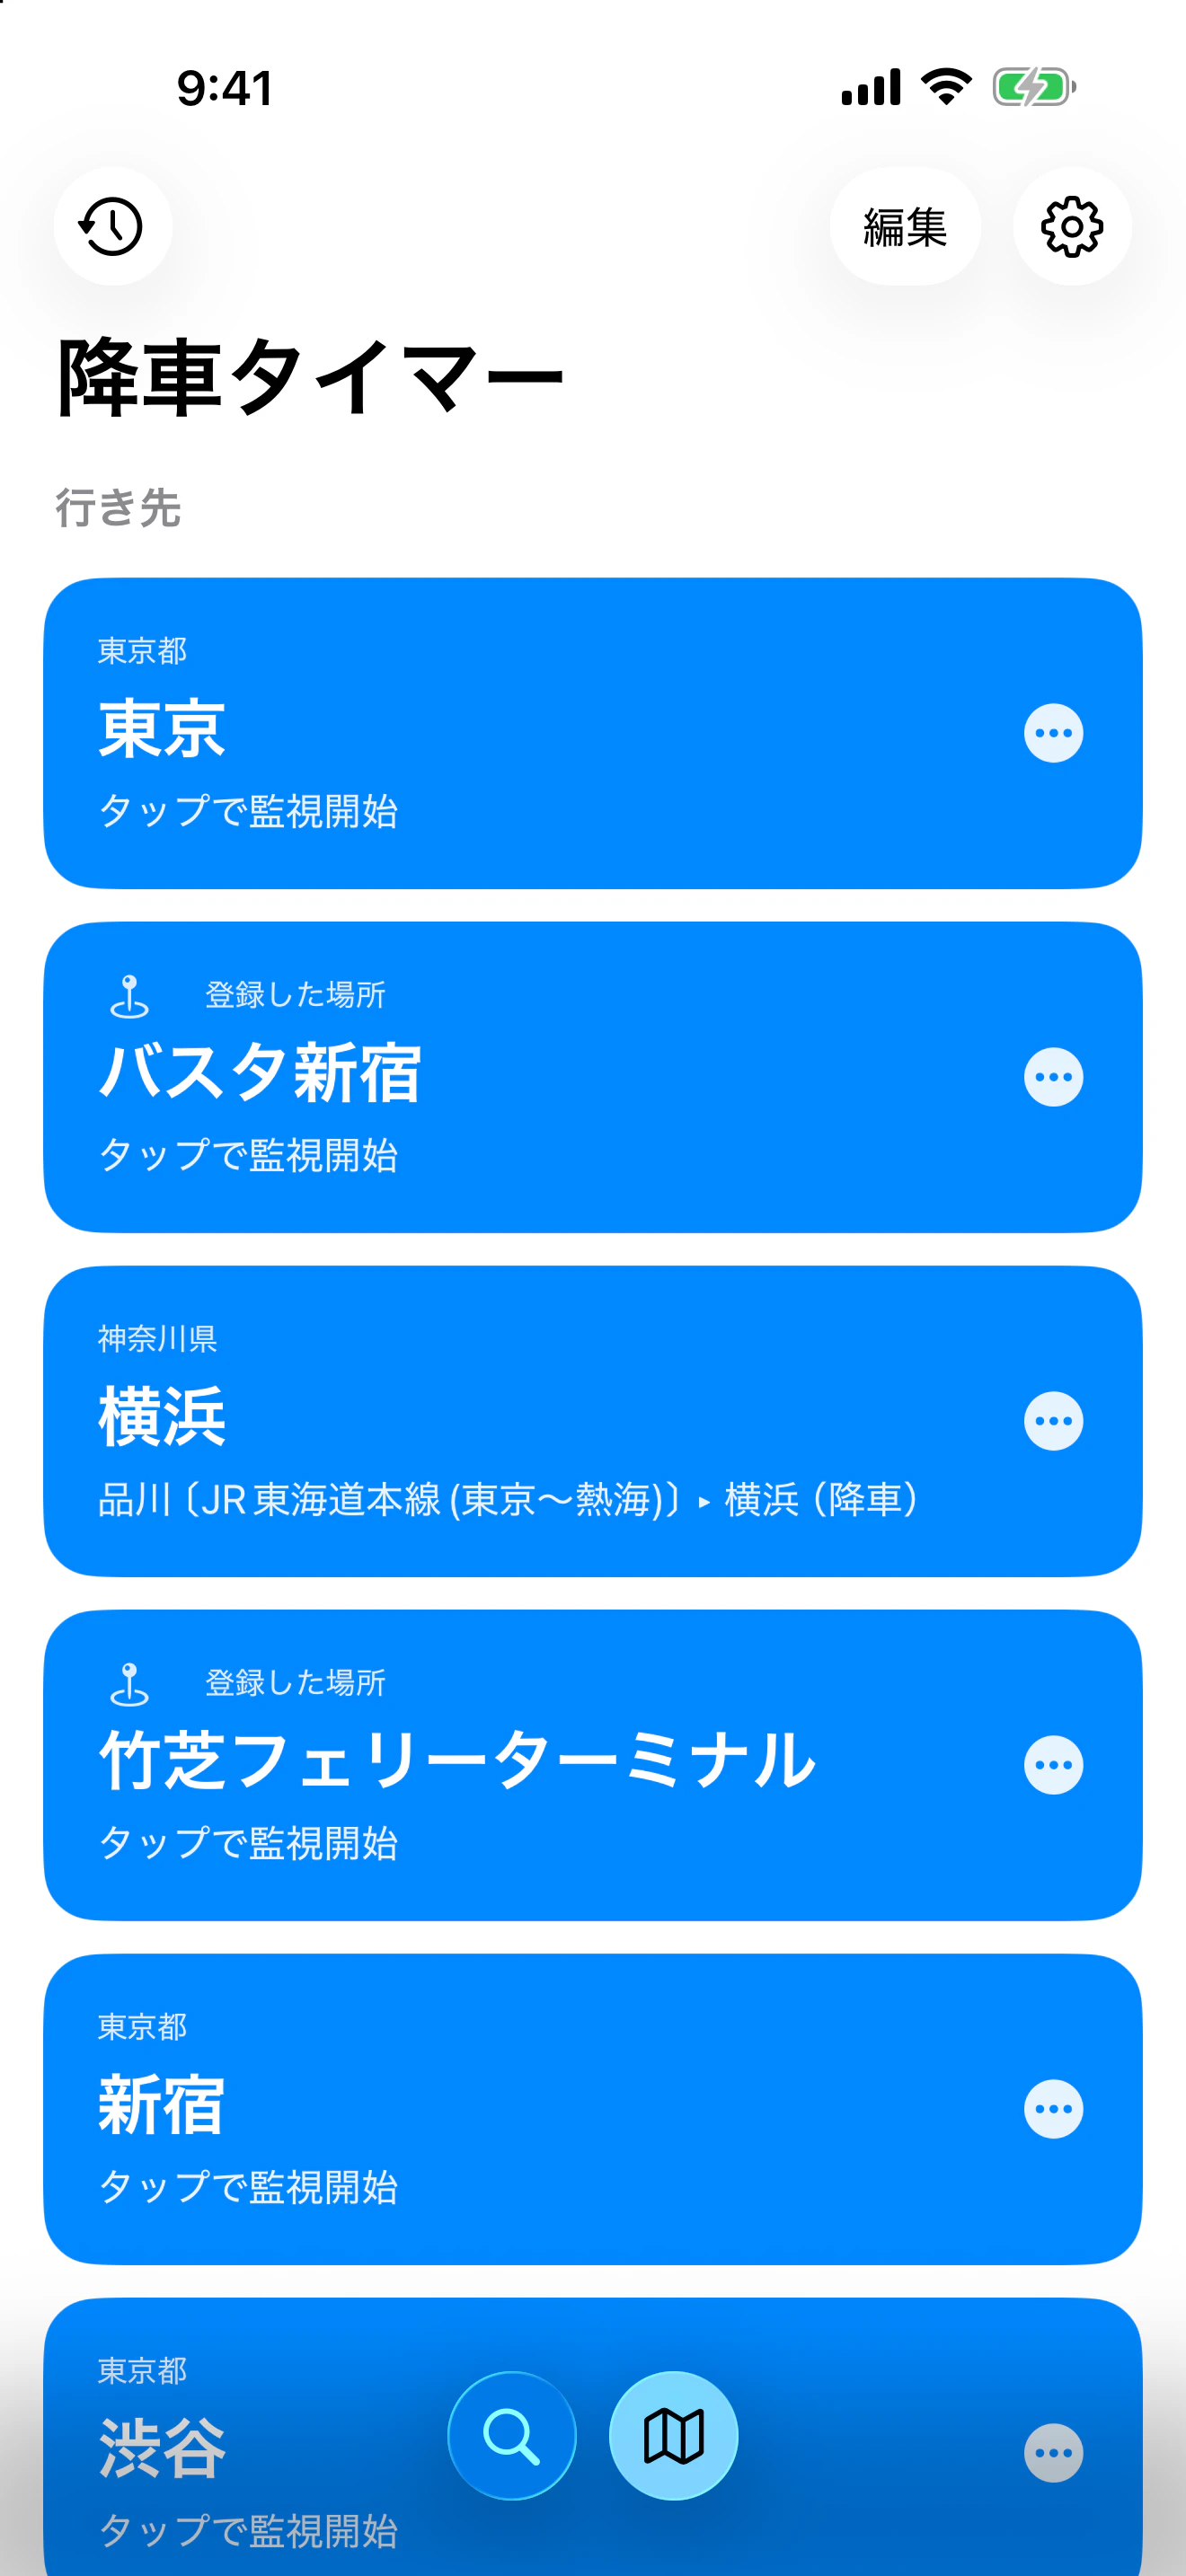
個人でiOSアプリ (CloudWatcher、TeijiTimer) を開発しています。アプリ開発は本業の領域ではありません。それでも、作りたいものの方向性を渡し、作業に落とし込み、動かした結果を返す、という進め方は業務と変わりません。本業ではない領域に手を出すときこそ、何から手をつければいいか分からない状態から始められることが効いてきます。
実際に作ったアプリの画面です。
書籍の執筆
共著で技術書を書いています。本の執筆は期間が長く、関わる人も多いので、サイクルを回し続けることになります。
たとえば、ゲラを読んだレビュアーから指摘が届いたときの作業です。指摘を原稿と照らして1件ずつ確かめ、通読メモに記録し、GitHubのissueとして起票します。最初は1件ずつAIとやり取りしていましたが、繰り返すうちに手順が固まったので、今はスキルにしています。ここでも、回すほど次の出発点が良くなる、という積み上げが起きています。
この記事もサイクルで書いた
実は、この記事自体がサイクルの例です。
記事を書く前のAIとのやり取りは、「内向型と外向型ってありますよね?」という、ただの質問から始まりました。そこから、AIの出した整理に対して、何度も方向を修正しています。
- 「AIとの相性はどうでもいい」
- 「単なるQ&Aじゃないと伝えたい」
- 「ハンドラーの比喩にはこだわらない」
AIの出した整理のうち、使える部分を残し、外れている部分を捨てていきました。その結果、最初は言葉にできていなかった「Q&Aではなくサイクルとして使う」という主張が、一文で言える状態になりました。
業務やアプリ開発の例は、作業を進めるためのサイクルです。この記事のやり取りは、考えをまとめるためのサイクルです。自分が何を言いたいのかはっきりしていない段階でも、サイクルは回せます。
サイクルを回すときに意識していること
ここまでの例から、サイクルを回すときに意識していることをまとめます。
- 感想ではなく、観察した事実と原因の仮説を返す。 「うまくいかない」ではなく「スコアが全部100%だった。ルールがモデルの常識側にあるのではないか」と返す
- 直した内容は、理由を添えてルールにする。 次の会話が前回より良い状態から始まる
- 前提が崩れたら、早めに方針を切り替える。 回避策をAIに粘らせると時間がかかる
- AIの出力は答えではなく、次の判断の材料として扱う。 何を採用し、何を捨てるかは自分で決める
まとめ
- Q&Aは、何を聞けばいいか分かっている段階でしか使えない
- サイクルとして使うと、方向性しか決まっていない段階から始められる
- 結果の質を決めるのは、AIの出力と自分の意図のずれを見つけて返す部分
- 返すときは、感想ではなく観察した事実と原因の仮説をセットにする
- 直した内容を理由つきのルールとして残すと、回すほど最初の出力が良くなる
- 業務でも、アプリ開発や書籍の執筆でも、同じやり方が効く
一番伝えたいのは、AIを使うと新しいことを始めるハードルが下がる、ということです。何から手をつければいいか分からない段階こそ、方向性をそのままAIに渡してみてください。出てきた結果を見て、ずれを返す。それを繰り返すうちに、最初は見えていなかった作業が見えてきます。