

はじめに
2026年9月1日のリリースノートで、自動チェンジデータフィード (Auto CDF) が一般提供になりました。
チェンジデータフィード (CDF) は、テーブルのバージョン間で行がどう変わったかを読み出す機能です。これまでは使いたいテーブルごとに delta.enableChangeDataFeed を有効にする必要がありましたが、自動CDFではその設定が要りません。行追跡 (row tracking) が有効なテーブルであれば、そのまま table_changes() で変更を読めます。
設定が一つ減っただけの話に見えるかもしれませんが、実際に効いてくるのはそこではありません。何が嬉しいのかを、実際に動かしながら書いていきます。
これまでのCDFで面倒だったところ
レガシーCDFは、書き込みのたびに変更行を実体化します。UPDATE や MERGE を実行すると、更新後のデータファイルとは別に、変更内容を記録したファイルがテーブル配下の _change_data に書かれます。読み取り側はそれを読むだけなので速いのですが、代償が3つあります。
一つ目は、書き込みのコストです。CDFを有効にしたテーブルでは、すべての更新操作が余分な書き込みを伴います。CDFを読むのが1日1回のバッチだとしても、書き込みは毎回発生します。
二つ目は、ストレージです。変更ファイルはテーブルに溜まっていきます。
三つ目が一番痛いところで、有効にし忘れると、それ以前の変更は取り返せません。下流に連携したくなった時点でCDFを有効にしても、読めるのはそこから先の変更だけです。過去の差分が必要なら、全量を読み直して自前で突き合わせることになります。
自動CDFとの違いを先に並べておきます。
| レガシーCDF | 自動CDF | |
|---|---|---|
| 変更の計算 | 書き込み時に実体化 | 読み取り時に計算 |
| テーブルごとの設定 |
delta.enableChangeDataFeed が必要 |
不要 (行追跡は必要) |
| 対応形式 | Delta Lake | Delta Lake、Iceberg v3 |
| 読み取りAPI |
table_changes()、readChangeFeed
|
同じ |
| 要件 | なし | DBR 19 LTS 以降、Unity Catalog |
自動CDFで何が変わるか
書き込みが軽くなる
自動CDFは、書き込み時に変更を実体化しません。読み取り時に、行追跡が持っている行リネージのメタデータから変更を計算します。
そのため変更ファイルの書き込みが消えます。リリースノートでは、変更を読み出す対象になっているテーブルで MERGE と UPDATE が約15%高速になる、という数字が挙げられています。ストリーミングの取り込み先など、更新が絶えず走るテーブルほど効いてくる性質のものです。
書き込みを軽くした代わりにコストは読み取り側に寄ります。頻繁に大きな範囲を読むワークロードでは、そのぶんを読み取り時に払うことになる、という理解でよいと思います。
テーブルごとの設定が要らない
「このテーブルもCDFを有効にしておけばよかった」が起きにくくなります。行追跡さえ有効になっていれば、後からCDFを読みたくなったときにそのまま読めます。
ただし、ここは正確に書いておきたいところです。完全に設定ゼロというわけではありません。Delta Lakeテーブルでは行追跡を明示的に有効にする必要があります。Iceberg v3テーブルは行追跡を仕様として含んでいるので、こちらは本当に何もしなくて済みます。
そして、行追跡を有効にする前の変更まで遡れるわけでもありません。CDFはテーブルの全変更を永続的に記録するものではない、という位置づけ自体は変わっていないので、そこは期待しすぎないほうがよいです。
Icebergテーブルでも読める
レガシーCDFはDelta Lakeテーブルだけの機能でした。自動CDFはApache Iceberg v3テーブルにも対応しています。Unity Catalogのマネージドテーブルとして持っているIcebergテーブルから、Deltaと同じAPIで変更を読めます。
Iceberg側の事情としては、外部のIcebergクライアントからは自動CDFをクエリできません。Databricks側から読む前提の機能です。
マテリアライズドビューのCDFも読める
自動CDFが土台になって使えるようになった機能もあります。2026年8月7日から、Lakeflowパイプラインや Databricks SQL で作成したマテリアライズドビューからCDFを読めるようになりました。
マテリアライズドビューは更新のたびに中身が入れ替わるので、これまでは「前回から何が変わったか」を下流に伝える手段がありませんでした。行追跡が有効なマテリアライズドビューであれば、個別の設定なしでCDFが読めます。集計結果の差分だけを外部に連携する、といった構成が組めるようになります。
実際に試す
サーバレスノートブックで動かしました。ポイントは、delta.enableChangeDataFeed をどこにも書かないことです。
行追跡だけを有効にしたテーブルを作る
CREATE TABLE takaakiyayoi_catalog.auto_cdf_demo.orders (
  order_id   INT,
  customer   STRING,
  amount     DECIMAL(10,2),
  status     STRING
)
TBLPROPERTIES (delta.enableRowTracking = true)
SHOW TBLPROPERTIES で確認すると、CDF関連のプロパティは入っていません。行追跡だけが有効な、普通のテーブルです。
変更を積む
INSERT、UPDATE、DELETE、MERGE をそれぞれ別のコミットとして流します。
INSERT INTO orders VALUES
  (1, 'Alice',  1200.00, 'placed'),
  (2, 'Bob',     450.50, 'placed'),
  (3, 'Carol',  3300.00, 'placed');

UPDATE orders SET status = 'shipped' WHERE order_id IN (1, 2);

DELETE FROM orders WHERE order_id = 3;

MERGE INTO orders AS t
USING (
  SELECT * FROM VALUES
    (2, 'Bob',   500.00, 'delivered'),
    (4, 'Dave',  780.25, 'placed')
  AS s(order_id, customer, amount, status)
) AS s
ON t.order_id = s.order_id
WHEN MATCHED THEN UPDATE SET *
WHEN NOT MATCHED THEN INSERT *;
table_changes() で読む
CDFを一度も有効にしていないテーブルに、そのまま table_changes() を投げます。
SELECT order_id, customer, amount, status,
       _change_type, _commit_version, _commit_timestamp
FROM table_changes('takaakiyayoi_catalog.auto_cdf_demo.orders', 0)
ORDER BY _commit_version, _change_type, order_id
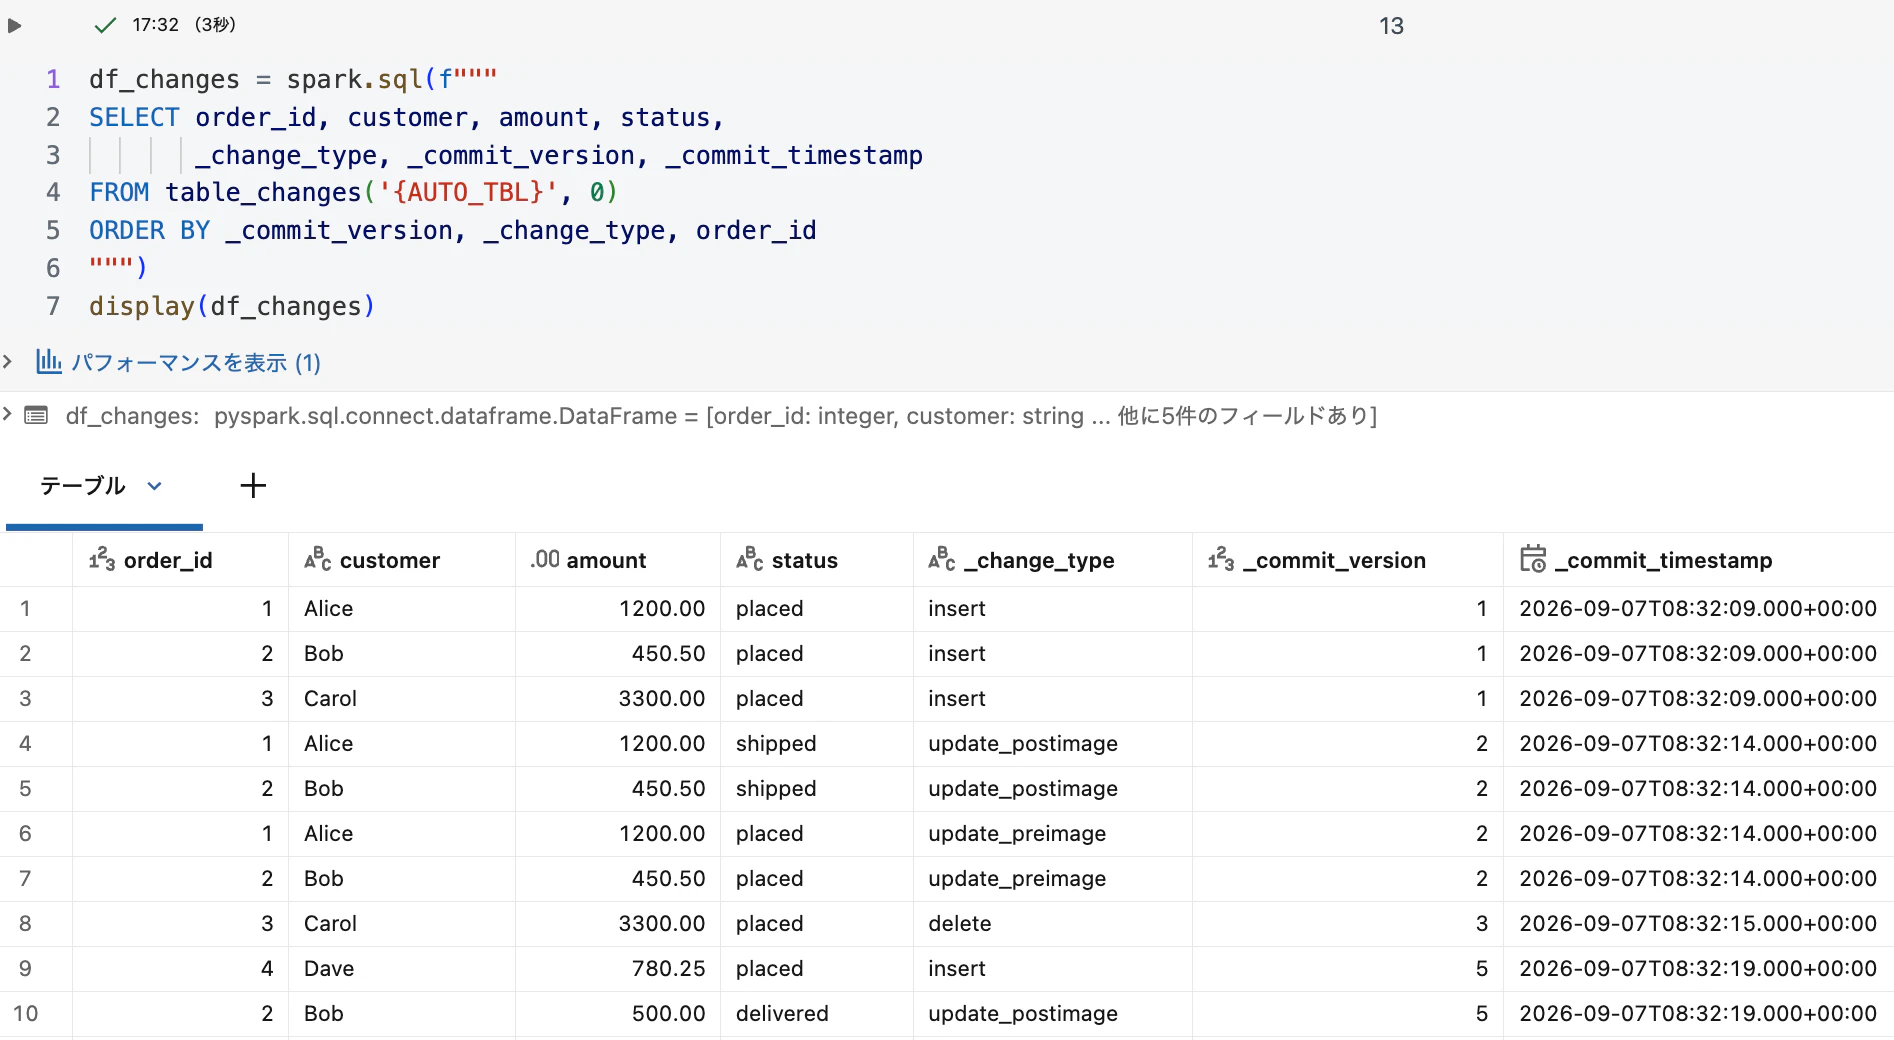
読めます。_change_type には insert、update_preimage、update_postimage、delete が入り、UPDATE は更新前と更新後がペアで返ります。MERGE は行ごとに更新のペアと挿入が混ざります。返ってくる列も意味もレガシーCDFと同じなので、既存の下流処理をそのまま当てられます。
書き込み側に変更ファイルが増えていないことは、DESCRIBE HISTORY の operationMetrics でも確認できました。レガシーCDFを有効にした同じ構成のテーブルでは UPDATE のときに変更ファイルが1つ書かれているのに対し、自動CDF側はどの操作でもゼロのままです。
Python APIとストリーミング
読み取りAPIも変わりません。
df = (spark.read
      .option("readChangeFeed", "true")
      .option("startingVersion", 1)
      .table("takaakiyayoi_catalog.auto_cdf_demo.orders"))
display(df)
Structured Streaming から読む場合も同じオプションです。
stream_df = (spark.readStream
             .option("readChangeFeed", "true")
             .table("takaakiyayoi_catalog.auto_cdf_demo.orders"))
バッチ、ストリーミングに加えて、Delta Sharing 経由でも自動CDFが使えます。
ハマりどころ: バージョン番号を決め打ちしない
table_changes() にバージョン範囲を渡すとき、自分が実行した操作の順番で番号を数えると合いません。先ほどの実行結果をよく見ると、_commit_version が 1、2、3 と来て次が 5 になっています。飛んでいる 4 は自分が実行した操作ではなく、サーバレスの予測的最適化による OPTIMIZE です。手元の履歴では、4回の更新操作のあいだに OPTIMIZE が2回入っていました。
OPTIMIZE 自体は行の変更を伴わないのでCDFには何も現れませんが、バージョン番号は確実にずれます。
範囲を指定するときは DESCRIBE HISTORY で実際のバージョン番号を確認してからにするのが安全です。
要件と制限
要件は3つです。
- Databricks Runtime 19 LTS 以降
- Unity Catalog に登録されたテーブル
- 行追跡が有効な Delta Lake 形式、または Iceberg v3 形式
制限として押さえておきたいのは以下です。
- 行フィルターまたは列マスクが適用されたテーブルでは使えません。更新前の行を返す仕組みである以上、フィルターで隠しているはずの行が変更フィードから漏れる可能性があるので、対象外になっているのだと思われます
- 列の削除・リネーム・型変更といった非加法的なスキーマ変更をまたぐ範囲は読めません。変更前後でファイルのスキーマが揃わないため、突き合わせができないということだと思います
- マルチステートメントトランザクションの途中でソーステーブルが変更された場合は非対応です
- 外部のIcebergクライアントからはクエリできません
レガシーCDFからの移行
レガシーCDFを有効にしているテーブルは、プロパティを外して行追跡を有効にすれば自動CDFに寄せられます。
ALTER TABLE <table_name> UNSET TBLPROPERTIES ('delta.enableChangeDataFeed');
ALTER TABLE <table_name> SET TBLPROPERTIES (delta.enableRowTracking = true);
既存テーブルで行追跡を有効にすると、既存のすべての行に行IDと行コミットバージョンが割り当てられます。この処理は複数のバージョンを作り、テーブルの規模によっては時間がかかります。ストリーミングなどの継続的な書き込みがある場合は、事前に止めてから実行してください。
読み取り側のコードは変えなくて済みます。table_changes() も readChangeFeed もそのままです。
まとめ
自動CDFを触ってみて分かったことをまとめます。
-
delta.enableChangeDataFeedを設定していないテーブルでもtable_changes()が通る。必要なのは行追跡 - 返ってくる列も
_change_typeの値もレガシーCDFと同じ。読み取り側のコードは書き換え不要 -
書き込み時に変更ファイルを作らない。リリースノートでは
MERGEとUPDATEが約15%高速になるとされている - Iceberg v3テーブルとマテリアライズドビューでも読める。ここはレガシーCDFにはなかった範囲
- 完全な設定ゼロではない。Delta Lakeテーブルでは行追跡の有効化が要る
- 行追跡を有効にする前の変更まで遡れるわけではない
- 行フィルター・列マスク付きのテーブルは対象外
- サーバレスでは予測的最適化のOPTIMIZEが履歴に挟まるので、バージョン番号は決め打ちしない
一番の収穫は、CDFが「使うと決めたテーブルだけに付ける特別な設定」ではなくなった、という感覚が持てたことでした。これまでは下流連携の要件が固まってからCDFを有効にする、という順番になりがちで、要件が後から来ると詰みます。行追跡を有効にしておけば後から読める、という形になったことで、テーブル設計の段階で判断を先送りできるようになりました。地味ですが、実務ではこの差が効いてくると思います。
参考リンク
- Databricksプラットフォームのリリースノート: 2026年9月
- Databricksでチェンジデータフィードを使用する
- 行追跡を使用する
- マテリアライズドビューからチェンジデータフィードを読み取る