


OCI Autonomous AI Databaseの新機能 Data Science Agent が先日リリースされました。
Data Science Agent はOracle Autonomous AI Databaseに含まれる Oracle Machine Learning の機能を、対話しながら使えるようにしてくれるAIエージェントです。
ユーザーはデータ探索、データ準備、特徴量作成、モデル学習、評価、推論SQL生成といった一連のデータサイエンスに関する作業を自然言語で実行できます。
Data Science Agentは以下のような課題を背景として開発されています。
- 通常データ探索、SQL作成、特徴量準備、モデル学習などは複数ツールに跨って対応する
- Data Science Agentとの対話を通して一気通貫で実行
- データをノートブック、外部ML基盤などへ移動する必要がある
- データベース内で処理し、データ移動を減らす
- 異種DBLinkを使えばNon-Oracle DB上のデータもETLなしで活用可能
- SQL、統計、ML、DB、モデル評価の専門知識が必要、かつ手作業が多い
- 自然言語で容易&効率的に一連のワークフローを実行
上記を実現するために、内部では SELECT AI や Oracle Machine Learning が利用されています。
以降では Data Science Agent の具体的な利用手順をまとめたいと思います。
目次
事前準備
以下を参考にADBを作成します。
ADBを作成するリージョンは Ashburn を選びました。理由は後述します。
訓練、予測用のデータとしてKaggleに公開されている以下データを利用させて頂きました。
こちらは道路の状況から事故発生率を予測するためのデータとなっています。
検証用DBユーザ作成
今回の検証で使うDBユーザを作成し、必要な権限を付与します。
GRANT DB_DEVELOPER_ROLE TO dsauser identified by <your password>;
ALTER USER dsauser QUOTA UNLIMITED ON DATA;
GRANT EXECUTE ON DBMS_CLOUD TO dsauser;
GRANT EXECUTE ON DBMS_CLOUD_AI TO dsauser;
GRANT EXECUTE on DBMS_CLOUD_PIPELINE to dsauser;
GRANT OML_DEVELOPER to dsauser;
Database ActionsのDBユーザ管理から、作成したユーザのREST、OMLを有効化します。


検証用DBユーザで資格証明、AIプロファイルを作成します。
-- OCI資格証明を作成
BEGIN
    DBMS_CLOUD.CREATE_CREDENTIAL(
        credential_name => 'OCI_CRED',
        user_ocid       => 'your user ocid',
        tenancy_ocid    => 'your tenancy ocid',
        private_key     => 'your user private key',
        fingerprint     => 'your fingerprint related to your user private key'
    );
END;
/

-- AIプロファイルを作成
BEGIN
    DBMS_CLOUD_AI.CREATE_PROFILE(
        'GENAI',
        '{
            "provider": "oci",
            "credential_name": "OCI_CRED",
            "model":"xai.grok-4.3",
            "region": "us-ashburn-1",
            "oci_compartment_id": "your compartment ocid"
        }'
    );
END;
/
ちなみに利用するLLMの選択が非常に重要でして、以下に推奨モデルの一覧があります。
推論にかなり強いモデルを利用する必要があるみたいです。
残念ながら本記事を執筆した時点では、OCI大阪リージョンで使えるモデルに推奨モデルは含まれていません。。
そのため今回は推奨モデルが使える Ashburn リージョンを選びました。
具体的なモデルとしては xai.grok-4.3 を利用しました。
もちろんOpenAIなどのモデルが使える環境であればOCI東京/大阪リージョンで問題ありません。
データ準備
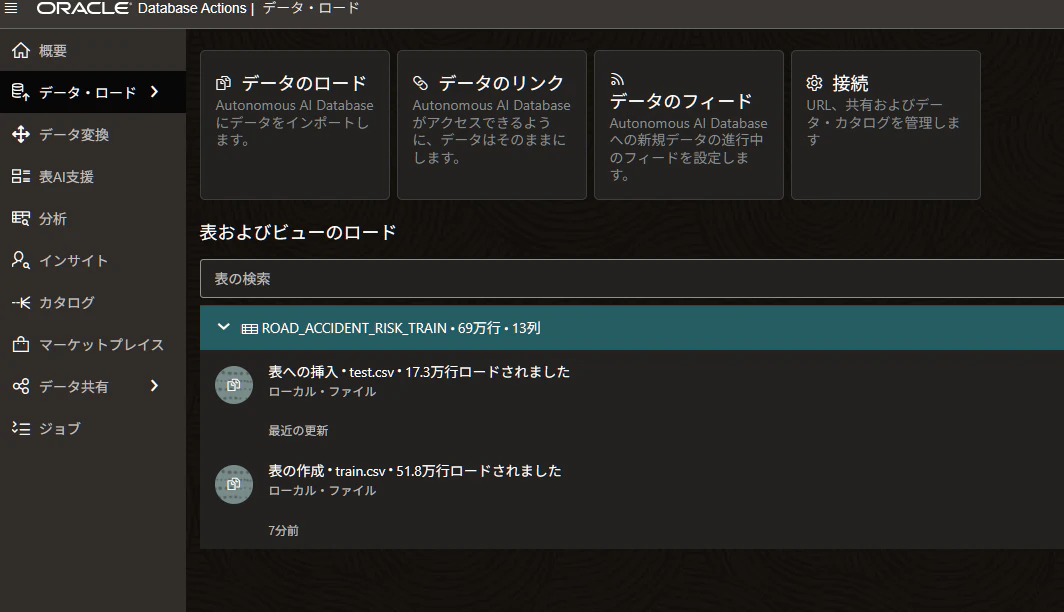
Database Actionsのデータ・ロードを使い、Kaggleからダウンロードしたデータを投入しました。
今回は ROAD_ACCIDENT_RISK_TRAIN テーブルに train.csv と test.csv の両方を登録しました。
Data Science Agentの会話を開始
たったこれだけの作業で Data Science Agent を使う準備が整いました。
ここから対話形式で特徴量エンジニアリング、モデル作成をやっていきます。
まずは Database Actions の機械学習へアクセスし、検証用DBユーザでログインします。
トップページから Data Science Agent を選択します。

作成ボタンを押下し、新しい会話を始めます。
事前に作成したAIプロファイルをプルダウンメニューから選択します。
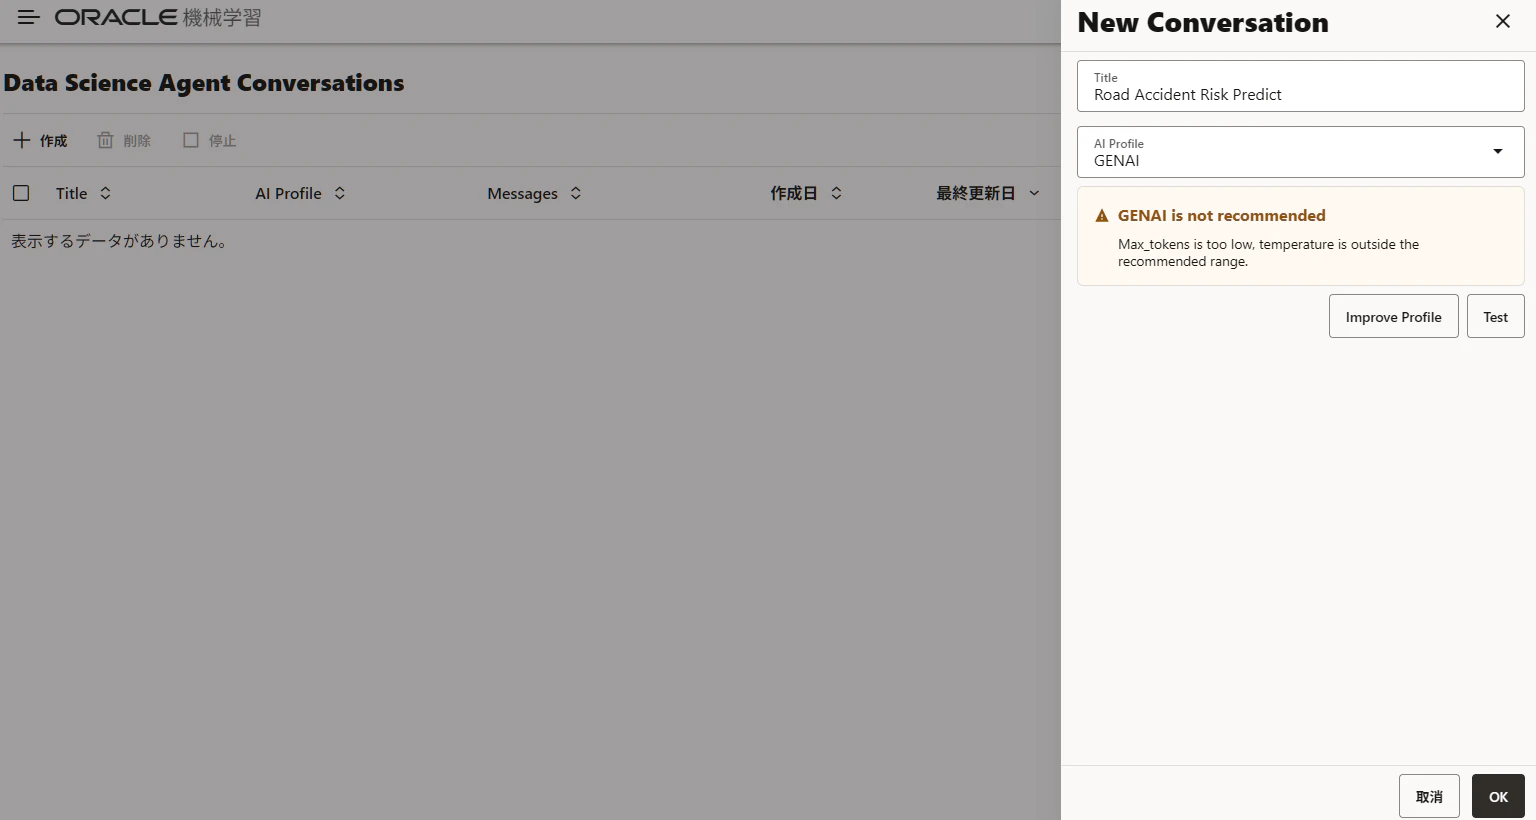
すると今回作成したAIプロファイルは推奨されない旨のメッセージが表示されてしまいました。
そのため Improve Profile ボタンを押下してみます。

AI Profileをどう変えれば良いかが提示されました。
本検証では推奨として提示されたパラメータでAI Profileを作ってもらうことにしました。
そのため右下の Create Profile ボタンを押下します。

推奨とされる変更が適用された GENAI_IMPROVED というAIプロファイルが作成されましたので、こちらを選択して OK を押下します。
するとチャットが開始され、以下のような画面に遷移します。

今回は道路状況のデータをもとに事故発生率を予測するモデルを作りたいので、以下プロンプトを入力して利用できるデータがどれかを聞いてみました。
道路の状況に応じた事故発生率を予測できるモデルを作りたいです。どのデータを利用すべきですか?
ちなみに本環境にはKaggleの当該データの他に、Oracle DBの有名なサンプルデータ SH も格納していました。
ちゃんと有効なデータを見つけられるか試したくてそのようにしていたのですが、以下の通り期待したデータを提示してくれました。

コメントやアノテーションは付けていなかったのですが、Step履歴を見る限り、格納データを分析するサブエージェントによって正しい結果を導出しているようにみえます。
続いて目的変数が ACCIDENT_RISK である点を伝えつつ、どのカラムを使うと良いモデルを作れるか聞いてみました。
ROAD_ACCIDENT_RISK_TRAINテーブルを使ってACCIDENT_RISKを予測するモデルを作りたいです。ACCIDENT_RISKの値に関係のある特徴量はどれですか?
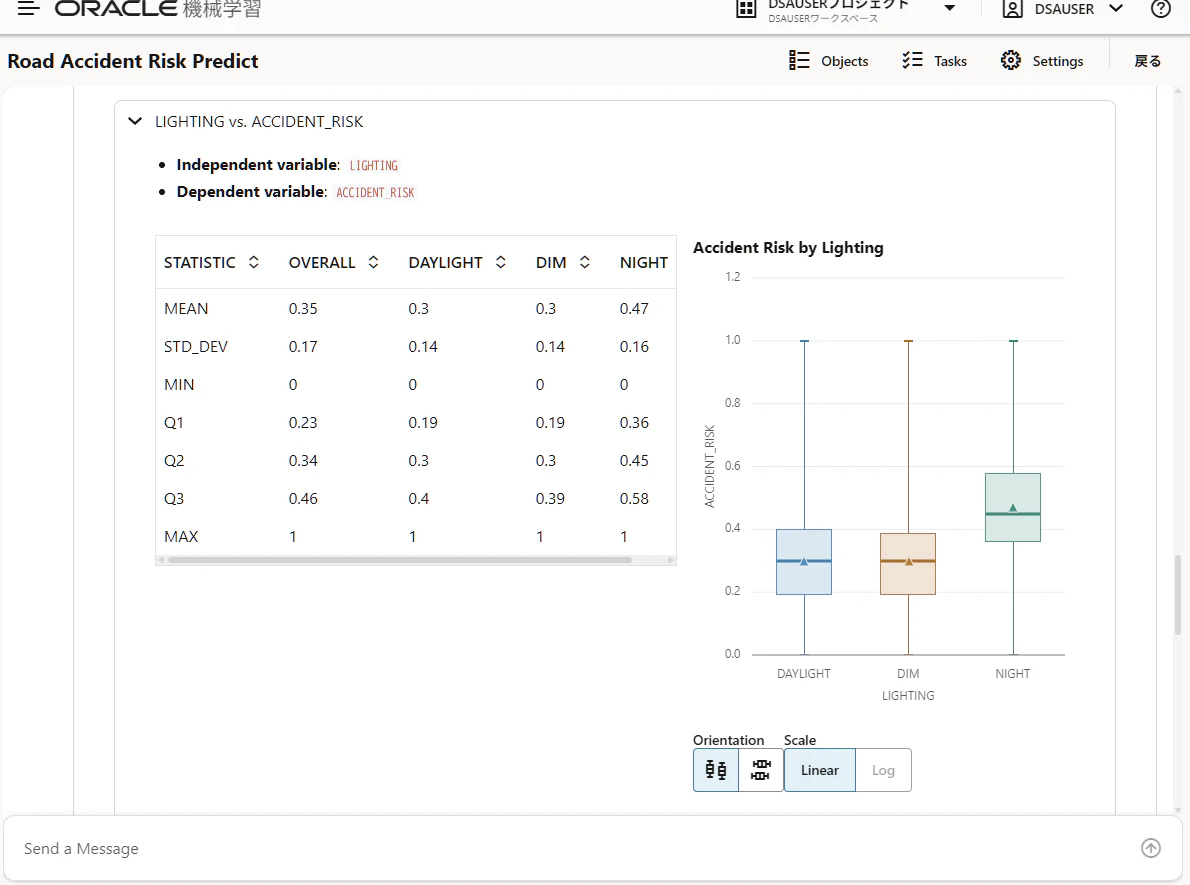
内部で主成分分析を実行しているのか、4つのカラムを重要データとして挙げてくれました。

各カラムの分析結果を開くと、例えば LIGHTING では箱ひげ図が提示されており、ACCIDENT_RISK との関係性が見て取れます。
予測モデルを作る上で重要なデータが分かったところで、これらデータを加工すると予測精度が向上するか、特徴量エンジニアリングの余地について聞いてみました。
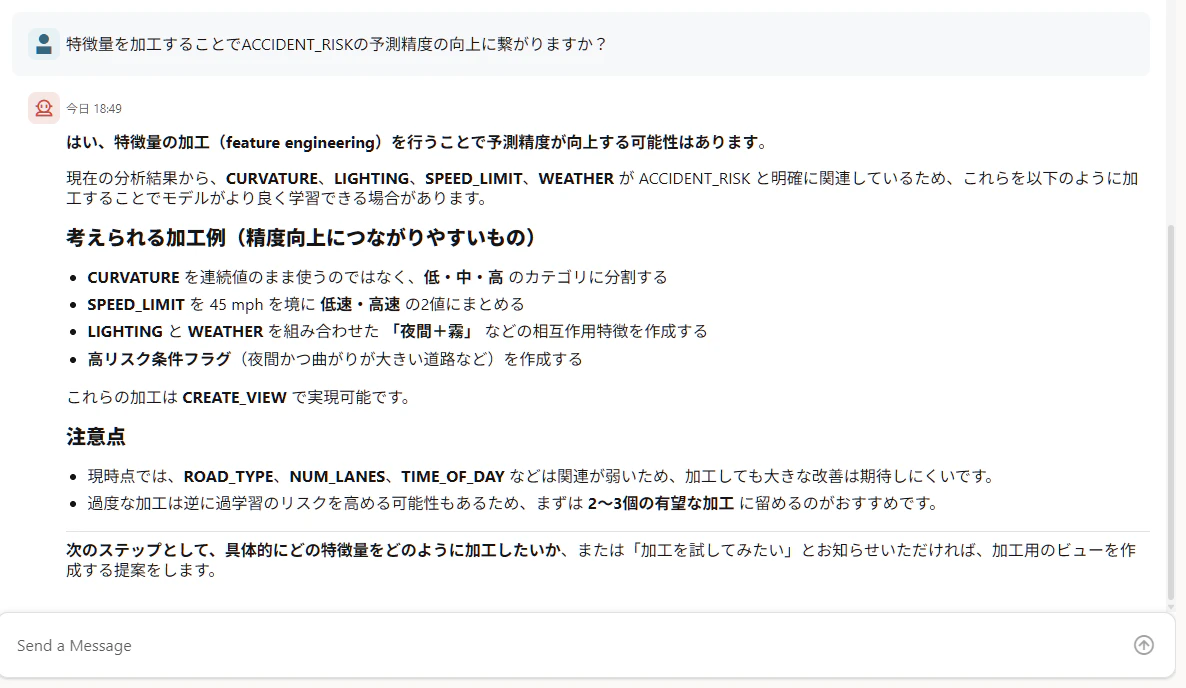
特徴量を加工することでACCIDENT_RISKの予測精度の向上に繋がりますか?
すると以下の通り、有効と考えられるデータ加工案を提示してくれました。
お願いすると対応するデータをViewとして作ってくれるみたいです。
ここでは提案されたViewを作成するようお願いしてみます。
精度向上につながりやすいものを使ってACCIDENT_RISKの予測モデルを作るためのビューを作成してください。
すると作成に進んでよいか承認依頼が来ました。
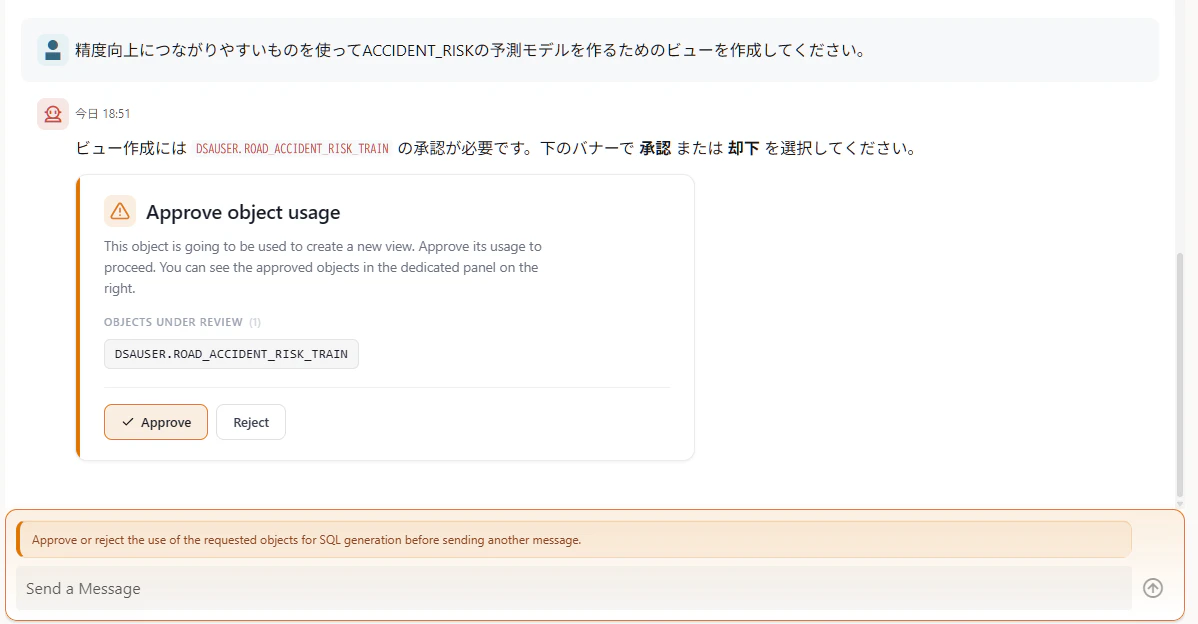
Data Science Agentでは、このようなDBに変更を加える作業では承認依頼が通知されるようになっています。
承認すると無事にViewを作成してくれました。

詳細欄を開くとViewのDDLやデータリネージのような図を確認できました。

このまま予測モデルの構築をお願いしてみます。
予測モデル構築を進めてください。

無事に予測モデルが出来たようです。
Step履歴を見て分かる通り、複数のモデルを構築して一番精度の良いものを選択する AutoML がサブエージェントによって内部実行されているようです。
学習過程で算出された各統計情報も確認できます。
特徴量ごとの重要度

Train、Validaton、Testそれぞれのデータの準備状況と対応するView作成のDDL


テストデータでの評価もお願いしてみます。
テストデータでの最終評価を行ってください。

MSE、RMSEなど予測結果に関する各統計情報を確認できます。

最後に正解ラベルの付いていないデータの予測もお願いしてみました。
作成した予測モデルを使って、ACCIDENT_RISKがNULLとなっているデータのACCIDENT_RISKの値を予測してください。
すると 100 行までしか予測結果を出せないので、提示したSQLを手動で実行して欲しいと返ってきました。

Data Science Agentは対話形式での予測モデル構築を目的に開発されており、構築したモデルを使って新規データを予測する作業は意図されていないようです。
そのため今回はSQLを提示するようお願いしました。
2でお願いします。
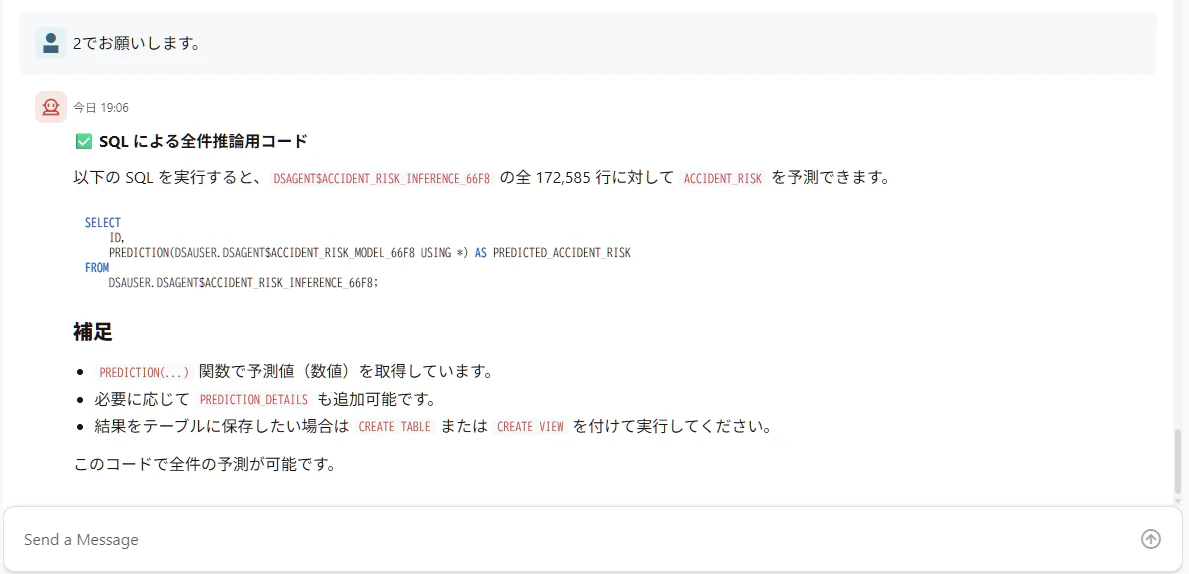
ちなみに提示されたSQLを Database Actions のSQLで実行した様子が以下になります。

正解ラベルの付いていない各データについて、ちゃんと ACCIDENT_RISK の予測結果が出力されました。
検証内容としては以上になります。
その他Tips
私は今回見よう見まねで試しましたが、マニュアルにはベスプラや制約、会話例が掲載されています。
ちゃんと使いたい場合は以下を一通り確認頂くのが良いかと思います。
- Best Practices for using Data Science Agent
- Limitations of Data Science Agent
- Example of a Conversation with Data Science Agent
機械学習を使った仕組みづくりに挑戦したいけど、複雑なコードを書くのはちょっと...というケースでしたら、Data Science Agent は有効なソリューションになるはずです。
ADBにAutoMLは以前よりありましたが、Data Science Agent を使えば特徴量エンジニアリングまで踏み込んで、より精度の良い予測モデルを構築できます。
機械学習にご興味ありましたら是非お試しください!