
ハーネスエンジニアリングとループエンジニアリングを整理する ── AIエージェントが働ける環境と改善サイクルの設計
はじめに
AIにプログラムの修正を頼むと、短いコードならそのまま使えることも増えてきました。一方で、少し規模の大きな開発では、コードを生成できることと、そのコードを安心して使えることの間に、まだ大きな差があります。
例えば、AIが「修正しました」と答えても、実際にはテストが通っていなかったり、別の機能が動かなくなっていたりします。修正のたびに人間がエラーをコピーして伝え直すのでは、作業量はなかなか減りません。
こうした問題を考えるうえで参考になるのが、ハーネスエンジニアリング (Harness Engineering) と ループエンジニアリング(Loop Engineering)です。
前者は、AIが作業しやすく、結果を確かめやすい環境を整える考え方です。後者は、AIの作業と検証を繰り返し、決められた条件を満たすところまで進める仕組みを設計します。
この記事では、両者の違いと関係を整理したうえで、Docker、GitHub Actions、Python、Fortranなどを使う開発環境への取り入れ方を考えます。図はMermaidで記載しているため、Qiita上でそのまま表示できます。あとで作成した画像へ差し替えられるよう、各図に番号と差し替え位置も付けています。
1. プロンプトを書くことから、作業の仕組みを設計することへ
これまでAIを使って開発する場合は、人間が指示を出し、AIの回答を確認して、次の指示を出す方法が一般的でした。
人間が指示する
    ↓
AIがコードを作成する
    ↓
人間が実行・確認する
    ↓
問題があれば、もう一度指示する
もちろん、この方法でも十分に役立ちます。ただし、開発が長期化したり、複数のファイルやテストが関係したりすると、何を確認すれば完了なのかを毎回伝える必要があります。
そこで、AIに与える指示だけでなく、AIが参照する資料、利用できるツール、テストの方法、作業を繰り返す条件まで含めて設計する考え方が広がってきました。
関連する用語を整理すると、次のようになります。
| 考え方 | 主に設計するもの | 何を解決するか |
|---|---|---|
| Prompt Engineering | 一回の指示や質問 | AIに意図を伝える |
| Context Engineering | 仕様書、関連コード、履歴などの情報 | AIに必要な判断材料を渡す |
| Harness Engineering | 実行環境、ツール、規約、検証方法 | AIが作業し、結果を確認できるようにする |
| Loop Engineering | 実行、評価、修正、停止の手順 | 人間が毎回指示しなくても作業を進められるようにする |
これらは、厳密に分かれた4つの技術というわけではありません。ハーネスの中にコンテキスト管理やフィードバックループが含まれることもありますし、ループを作る際にはハーネスの機能を利用します。
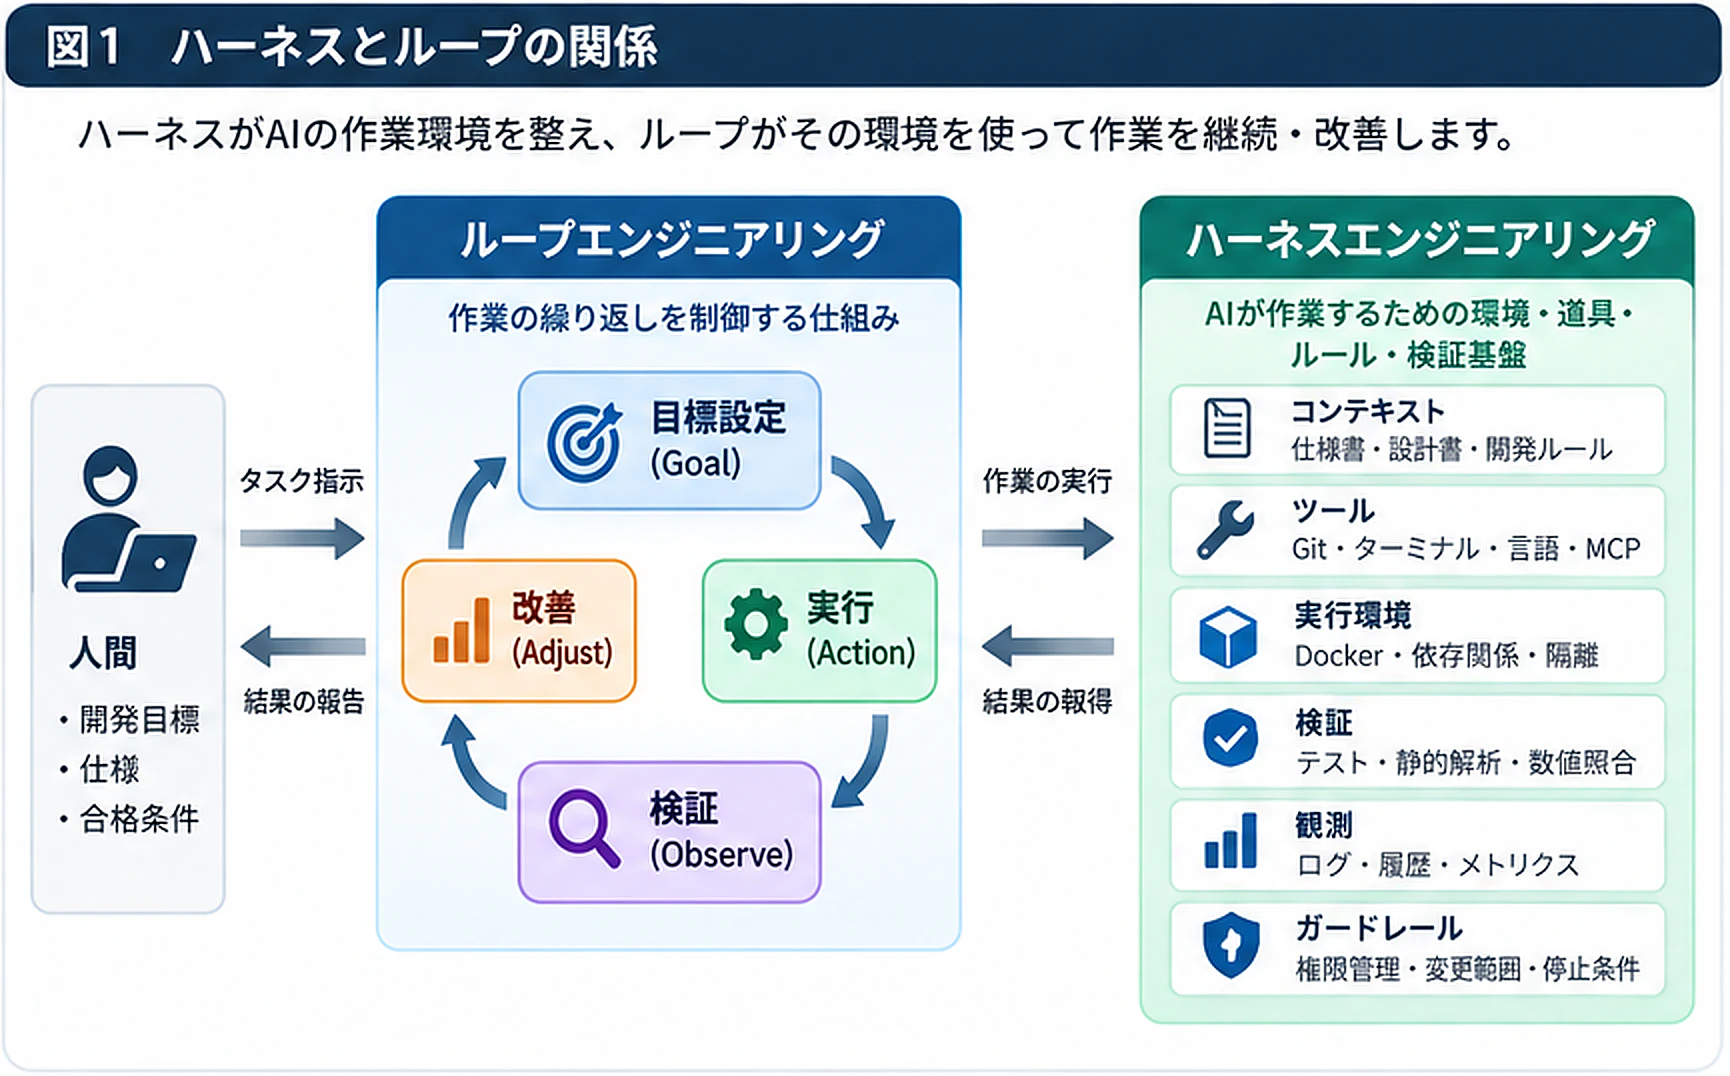
**ハーネスは「AIが働くための環境」、ループは「その環境を使って作業を進める制御方法」**と考えると、関係がつかみやすくなります。
2. ハーネスエンジニアリングとは
ハーネス(Harness)という言葉は、もともと装置や機器を接続したり、動作を支えたりする仕組みに使われます。ソフトウェア開発でも、テストの実行に必要な仕組みを「テストハーネス」と呼んできました。
AI開発では、その考え方を広げ、AIエージェントが作業を行うための周辺環境全体を設計することをハーネスエンジニアリングと呼んでいます。
単にAIがソースコードを読めるようにするだけではありません。必要な設計情報を見つけられること、決められたコマンドで実行できること、結果が合格か不合格かを判定できることまで含みます。
2.1 ハーネスに必要なもの
実装を考えると、少なくとも次の要素を整理しておくと扱いやすくなります。これは記事内での整理であり、標準化された6項目という意味ではありません。
| 要素 | 具体例 | 役割 |
|---|---|---|
| コンテキスト |
AGENTS.md、仕様書、設計書 |
作業の前提を明確にする |
| ツール | Git、ターミナル、コンパイラ、MCP | AIが実際に操作できる手段を用意する |
| 実行環境 | Docker、依存ライブラリ、設定ファイル | 同じ条件で実行しやすくする |
| 検証 | Ruff、mypy、pytest、回帰テスト | 変更結果を機械的に確認する |
| 観測 | ログ、メトリクス、変更差分 | 失敗した理由を調べられるようにする |
| 制約 | 権限、変更禁止ファイル、承認手順 | 危険な変更を防ぐ |
ここで重要なのは、AIが自分で検証結果を見られることです。
例えば、テストが失敗した場合に「失敗しました」だけを返す仕組みでは、次の修正に必要な情報が不足します。失敗したテスト名、エラーメッセージ、直前の変更差分などを確認できれば、次に何を直すかを判断しやすくなります。
2.2 OpenAIの実践例
OpenAIは2026年2月11日に、Codexを使った開発実験を紹介しています。
この実験では、アプリケーション本体だけでなく、テスト、CI設定、ドキュメント、監視機能、開発ツールなどもCodexに作成させています。記事によると、約5か月で約1500件のPull Request、約100万行規模のコードを扱いました。所要時間が手作業で書いた場合の約10分の1だったという数値も示されていますが、これは当該チームによる推定であり、一般的な開発案件にそのまま当てはまるものではありません。
この事例で参考になるのは、AIに難しい指示を繰り返すのではなく、AIが作業できなかった原因を、環境や情報の不足として調べたことです。
例えば、AIが画面上の不具合を確認できないなら、画面を操作・観測する手段を整えます。ログを読めないなら、実行時のログやメトリクスを参照できるようにします。コードが決められた構造から外れてしまうなら、説明文だけでなく静的な検査ルールで制約します。
また、AGENTS.mdを巨大な説明書にするのではなく、必要な資料への案内役にする方法も紹介されています。
出典:OpenAI - Harness engineering: leveraging Codex in an agent-first world
2.3 AGENTS.mdは「説明書」より「案内図」にする
AGENTS.mdには、すべての仕様を書く必要はありません。最初に確認する資料と、絶対に守るべきルールが分かれば十分な場合もあります。
例えば、次のような内容です。
# 開発時の基本ルール

## 最初に確認する資料
- 要件: docs/requirements.md
- 構成: docs/architecture.md
- 完了条件: docs/acceptance_criteria.md

## 変更時のルール
- 変更前に既存テストを確認すること
- 基準データと受入条件を無断で変更しないこと
- 修正後は bash scripts/verify.sh を実行すること
- 未実施の検証を「合格」と報告しないこと

## 完了時の報告
- 変更したファイル
- 実行した検証コマンド
- 検証結果と残っている問題
要件の詳細はdocs/以下に整理し、AIには必要になった段階で読ませます。資料を増やすだけでなく、古くなった記述を更新し、矛盾をなくす運用も必要です。
3. ループエンジニアリングとは
ループエンジニアリングは、AIに毎回「次はこれをしてください」と伝える代わりに、作業の実行、検証、修正、停止を繰り返す仕組みを設計する考え方です。
Addy Osmani氏は2026年6月8日の記事で、人間がその都度プロンプトを入力する役割を、エージェントを動かす仕組みの設計へ置き換える考え方として紹介しています。
出典:Addy Osmani - Loop Engineering
3.1 基本となる4段階
IBMはエージェントによるループを、Goal、Action、Observation、Adjustmentの4段階で説明しています。
- Goal(目標):達成すべきことと、完了の判定条件を決めます。
- Action(実行):AIが調査や実装、修正などを行います。
- Observation(観測・評価):テストや実行結果を確認します。
- Adjustment(調整):失敗の原因を調べ、必要なら次の修正に反映します。
出典:IBM - What is loop engineering?
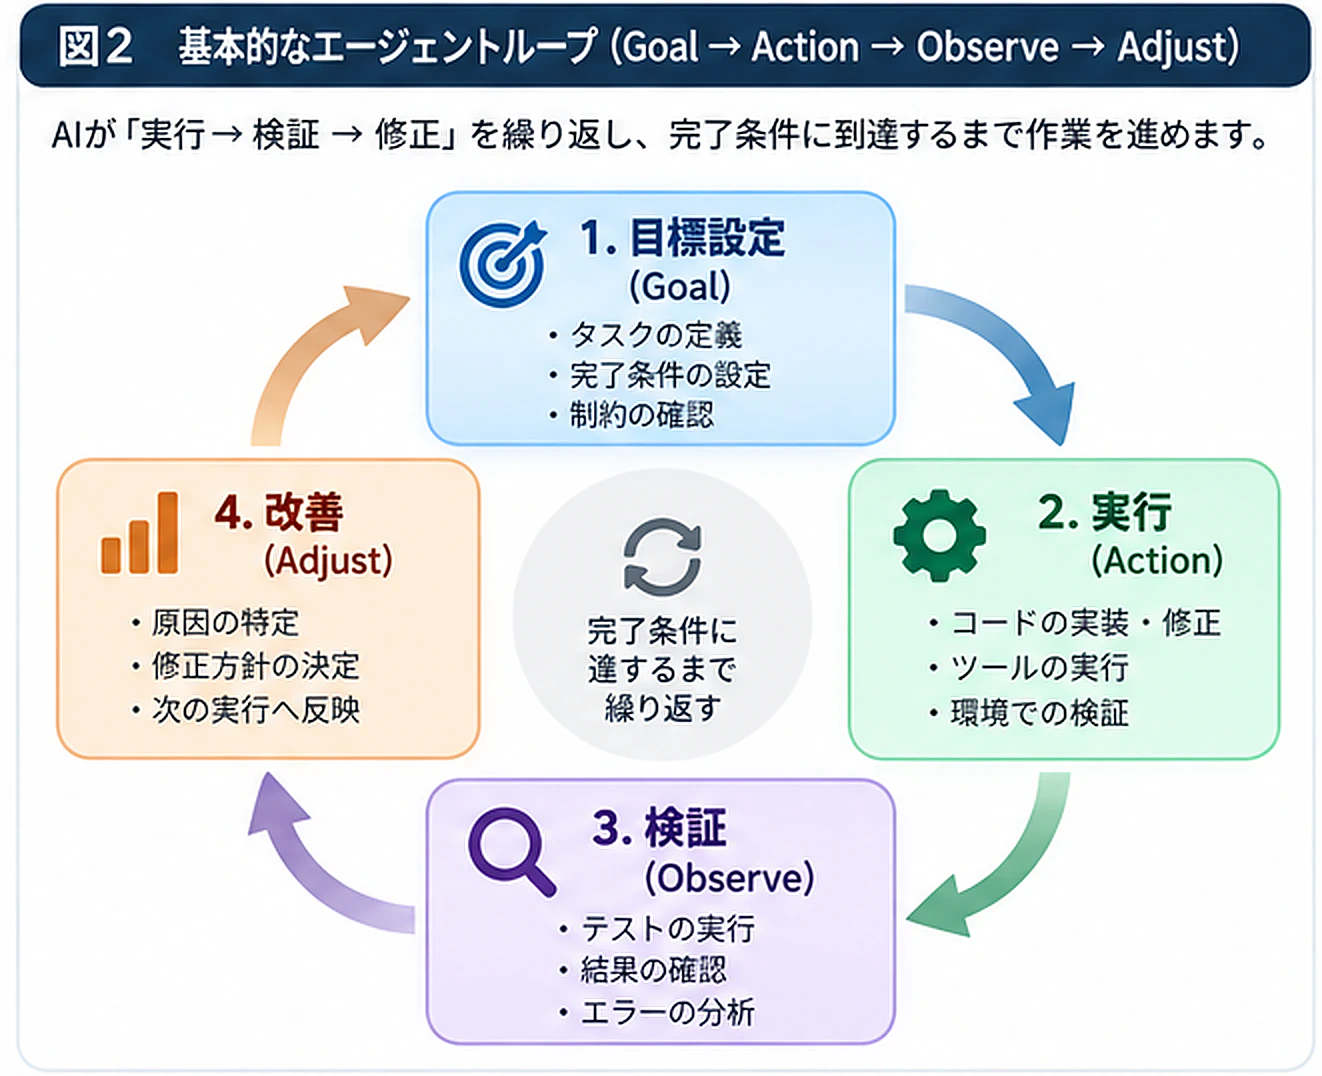
これを見ると、プログラムのwhileやforによる繰り返し処理と似ています。ただし、AIの判断を挟むため、同じ入力でも毎回まったく同じ修正になるとは限りません。
そのため、ループそのものには必ず上限を設けます。試行回数、時間、費用、変更可能な範囲などを決めておき、解決できない場合は人間に戻します。
3.2 4種類のループ
Anthropicは2026年6月30日の解説で、ループを起動条件や停止条件から次のように整理しています。
| 種類 | 特徴 | 向いている作業 |
|---|---|---|
| Turn-based | 人間の指示から始める | 単発の修正や調査 |
| Goal-based | 明確な合格条件まで繰り返す | テスト合格、不具合修正 |
| Time-based | 時間や周期を指定して実行する | 定期点検、レポート作成 |
| Proactive | 定めた条件や状況に応じて作業する | Issue整理、継続的な保守 |
すべてを自動化する必要はありません。最初は、例えば「単体テストが通るまで最大3回修正する」というGoal-basedの小さなループから試すと、動作と費用を管理しやすくなります。
出典:Anthropic - Loop engineering: Getting started with loops
3.3 ループを長期間動かすための要素
ループを複数回、あるいは複数日にわたって動かす場合は、試行結果を保存する仕組みが必要です。
| 要素 | 利用例 |
|---|---|
| 自動起動 | 定期実行、CIの失敗をきっかけに起動 |
| Git Worktree | エージェントごとに作業ディレクトリを分離 |
| Skills | よく使う手順や確認方法を定型化 |
| コネクター | GitHubなどの外部サービスと連携 |
| サブエージェント | 実装と検証を別の担当に分ける |
| 永続的な状態保存 | 実行履歴、進捗、未解決事項を保存 |
最後の状態保存は特に大切です。会話の履歴だけに頼ると、セッションが変わった際に前回の試行内容を十分に引き継げない場合があります。
何を試し、何が失敗し、どの条件がまだ満たされていないのかを、MarkdownやJSON、データベースなどに記録しておくと、同じ失敗を繰り返しにくくなります。
4. ハーネスとループは、どこでつながるのか
ここまでを整理すると、ハーネスとループは次のように役割を分けられます。
| 項目 | ハーネスエンジニアリング | ループエンジニアリング |
|---|---|---|
| 主な問い | AIは何を使って、どの条件で作業するか | AIはいつ作業し、いつ繰り返し、いつ止めるか |
| 中心となるもの | 仕様、ツール、実行環境、検証 | 目標、実行、評価、再試行、停止 |
| 失敗したとき | 情報や実行環境、検査方法を改善する | 結果を受けて次の処理を決める |
| 記録するもの | 変更内容、ログ、テスト結果 | 試行履歴、進捗、停止理由 |
| 人間の役割 | 条件や権限、検証基準を決める | 自動化の範囲と終了条件を決める |
例えば、AIが修正したPythonプログラムに対してpytestを実行できるようにするのは、ハーネス側の設計です。そのテストが失敗したとき、結果を次の修正へ渡すか、人間に確認を依頼するかを決めるのがループ側の設計です。
ただし、この区分は設計を理解しやすくするためのものです。実際には「検証結果を使って修正を繰り返す仕組み」もハーネスの一部として語られます。片方がもう片方に取って代わるわけではありません。
5. DockerとGitHub Actionsを使った構成例
ここからは、Ubuntu 24.04、Docker Compose、Python、Fortranで構成した開発プロジェクトを例にします。
AIエージェントとしてCodexやClaude Codeなどを想定しますが、使用する製品を固定する必要はありません。まずは検証の仕組みを、AIから独立したコマンドとして用意します。

この構成では、AIによる修正の途中にもローカルでテストを実行しますが、それだけで作業を完了とはしません。変更をPull Requestにまとめた後、別のCIジョブでもう一度検証します。
AIが自分で修正したテストだけを通して「合格」としてしまわないように、受入条件や基準データは保護しておくことが重要です。
5.1 ディレクトリ構成
必要最小限の構成として、例えば次のように整理できます。
project/
├── AGENTS.md
├── docs/
│   ├── requirements.md
│   ├── architecture.md
│   └── acceptance_criteria.md
├── app/
│   ├── __init__.py
│   └── core.py
├── fortran/
│   ├── fpm.toml
│   ├── src/
│   └── test/
├── tests/
│   └── test_core.py
├── scripts/
│   └── verify.sh
├── loops/
│   ├── controller.py
│   └── state/
├── .github/
│   └── workflows/
│       └── ci.yml
├── Dockerfile
└── compose.yaml
AGENTS.mdはAIが作業を始める入口、docs/は仕様と合格条件、scripts/verify.shは共通の検証コマンド、loops/controller.pyは再試行を管理する場所です。
loops/state/には試行ごとのログを記録します。機密情報を含むログはそのままGitにコミットしないよう、保存先と公開範囲を分けます。
5.2 検証コマンドを一本化する
scripts/verify.shの例を示します。
#!/usr/bin/env bash
set -euo pipefail

# Pythonコードの書式・静的解析を確認します。
python -m ruff check app tests

# Pythonコードの型の整合性を調べます。
python -m mypy app

# Pythonの単体テストを実行します。
python -m pytest -q tests

# Fortran側のテストはfpmプロジェクト内で実行します。
(
    cd fortran
    fpm test
)

echo "All verification checks passed."
set -euo pipefailにより、途中のコマンドが失敗した場合は後続の処理を続けず、失敗を終了ステータスとして返せます。ループ側では、この終了ステータスとログを使って合否を判定します。
なお、このスクリプトを使うには、Python側にRuff、mypy、pytestを、Fortran側にfpmとコンパイラを用意し、各テストを実装しておく必要があります。プロジェクトによっては、検証コマンドを追加・変更してください。
5.3 ループ制御の考え方
次は、AIによる修正と検証を繰り返す制御プログラムの最小例です。AIエージェントの呼び出し部分は、製品によってコマンドやAPIが異なるため、引数として受け取る形にしています。
"""AIによる修正と独立した検証を繰り返すための制御例。"""

from collections.abc import Callable
from pathlib import Path
import subprocess


# 引数は「作業内容」と「直前の検証結果」です。
AgentAction = Callable[[str, str], None]


def verify(project_dir: Path) -> subprocess.CompletedProcess[str]:
    """共通検証スクリプトを実行し、終了コードとログを取得します。"""
    return subprocess.run(
        ["bash", "scripts/verify.sh"],
        cwd=project_dir,
        text=True,
        capture_output=True,
        check=False,
        timeout=1800,
    )


def run_loop(
    project_dir: Path,
    task: str,
    agent_action: AgentAction,
    max_attempts: int = 3,
) -> bool:
    """指定回数内で検証に合格した場合だけTrueを返します。"""
    if max_attempts < 1:
        raise ValueError("max_attempts must be at least 1")

    log_dir = project_dir / "loops" / "state"
    log_dir.mkdir(parents=True, exist_ok=True)
    feedback = "初回実行です。仕様と合格条件を確認してください。"

    for attempt in range(1, max_attempts + 1):
        # この処理は実際のCodex/Claude Code等の呼び出しと差し替えます。
        # 変更できるファイルや実行権限はエージェント側でも制限します。
        agent_action(task, feedback)

        # 合否はエージェントの自己申告ではなく、検証プロセスで決めます。
        result = verify(project_dir)
        feedback = result.stdout + "\n" + result.stderr

        # エラーが発生した場合もログを保存して調査できるようにします。
        (log_dir / f"attempt_{attempt:02d}.log").write_text(
            feedback,
            encoding="utf-8",
        )

        if result.returncode == 0:
            # これは自動検証の合格です。人間による承認とは分けます。
            return True

    # 試行回数の上限に達した場合は、人間に判断を戻します。
    return False
上のコードはループ制御部分を説明するサンプルです。agent_actionに実際のAI呼び出しを渡す処理、呼び出し自体の失敗やタイムアウトへの対応、トークン利用量・費用の管理、変更内容の検査、Pull Requestの作成などは含めていません。また、verify()の30分タイムアウトが発生したときの例外処理も、実運用では追加する必要があります。
重要なのは、AIが「完了した」と回答した時点ではなく、検証コマンドが実際に成功し、必要な受入条件を満たした時点で、次のレビュー段階へ進むという点です。
6. 数値シミュレーションの開発では、何を検証するか
この考え方は、Webアプリケーションだけでなく、気象予測や水理解析などの数値シミュレーションにも利用できます。
ただし、数値計算ではpytestが成功しただけで計算の正しさを保証できません。プログラムが最後まで動いても、境界条件や保存則の扱いが間違っている場合があるためです。
例えば、数値計算ソルバーを修正する場合は、次のような検証を分けて考えます。
| 検証対象 | 確認内容 |
|---|---|
| ビルド | Fortranコードをコンパイルできるか |
| ソフトウェアとしての健全性 | 単体テスト、型検査、回帰テストが通るか |
| 数値の健全性 | NaNやInf、想定外の負値がないか |
| 保存則 | 水量・質量などの収支が許容範囲内か |
| 物理的な妥当性 | 境界条件、流れの向き、時間発展が適切か |
| 既知解との比較 | 解析解、基準解、別実装と整合するか |
| 再現性 | 同じ入力条件で再実行し、比較できるか |
| 性能 | 計算時間やメモリ使用量が想定内か |
保存則の許容誤差をいくつにするかは、モデルや計算条件に応じて事前に定義します。テストに通すために、AIが許容誤差や基準結果を勝手に書き換えてはいけません。
また、ソースコードの変更と、境界条件や物理モデルの変更は別に扱う必要があります。後者は計算結果の意味そのものに影響するため、専門的な確認が欠かせません。
「テストに合格したこと」と「物理モデルが妥当であること」は同じではありません。 この区別を受入条件に書き残すことが、数値計算向けハーネスを作るうえで大切になります。
7. 自動化で気を付けたいこと
ハーネスとループを組み合わせれば、多くの作業を自動化できるようになります。ただし、ループを長く動かせば品質が上がるとは限りません。
| 起こりやすい問題 | 事前に決めておきたい対策 |
|---|---|
| 同じ失敗を繰り返す | 試行履歴を保存し、再試行上限を設ける |
| テストを書き換えて合格させる | 受入条件や基準データを保護する |
| 予想外のファイルを変更する | 変更できる場所と操作権限を制限する |
| 費用や実行時間が増える | 回数、時間、トークン、予算の上限を設ける |
| 別の機能を壊す | 回帰テストと独立したCI確認を行う |
| エージェント間で変更が衝突する | Git Worktreeや作業ブランチを分ける |
| 不確かな修正が続く | 途中で停止し、人間に判断を戻す |
特にGitHub ActionsのSelf-hosted Runnerでは注意が必要です。GitHubの公式ドキュメントでも、信頼できないPull RequestのコードをSelf-hosted Runnerで動かすことには重大なリスクがあると説明されています。
ローカルの開発PCや社内ネットワークへ接続できるRunnerでは、AIの実行権限を最小限にし、未確認の外部コードがそのまま動かない構成にします。本番環境へのデプロイや重要データの更新は、ソースの修正とは別の承認手順に分けておいた方が安全です。
参考:GitHub Docs - Secure use reference
8. 導入するなら、まずは小さなループから
いきなり自律的な開発システム全体を構築する必要はありません。既存の開発環境に少しずつ取り入れる方が、改善の効果を確かめやすくなります。

Step 1では、ハーネスを整えます。
まず、Dockerで再現できる実行環境と、同じコマンドで実行できるテストを用意します。仕様や受入条件の置き場所も決めます。この段階では、人間がAIに一回ずつ指示する方法でも構いません。
Step 2では、小さなGoal-basedループを試します。
例えば、既存の単体テストに失敗している不具合を対象にし、最大3回まで修正を試みます。各試行の結果を保存し、解決できなければ停止します。
Step 3では、CIとの連携を考えます。
変更をPull Requestにまとめ、GitHub Actionsで独立した検証を実行します。CIに失敗した場合はAIへ結果を返し、再修正を行うか、人間に判断を戻すかを決めます。
Step 4では、必要に応じて作業を分担します。
実装と検証の担当を分けたり、Git Worktreeで複数の変更を並行して進めたりできます。ただし、複数エージェントを使えば必ず効率が上がるわけではありません。検証の負荷や利用費用も含めて判断します。
9. まとめ
ハーネスエンジニアリングとループエンジニアリングは、AIをより多く働かせるためだけの技術ではありません。AIが行った作業を人間が確認でき、問題が起きたときに原因を追えるようにするための考え方です。
ハーネスを整えると、AIは必要な資料や道具を使い、決められた方法で結果を検証できるようになります。そこへループを加えると、失敗内容を次の修正へ渡し、あらかじめ定めた条件まで処理を繰り返せます。
とはいえ、最初から長時間の完全自律運用を目指す必要はありません。まずは一回の変更を確実に検証できる環境を作り、そのうえで再試行を自動化するところから始めるのがよいと思います。
特に数値計算やシミュレーションでは、AIの回答をそのまま信用するのではなく、独立した検証、再現性の確認、物理的な妥当性の確認を残しておくことが大切です。
AIへの指示の仕方だけでなく、AIが間違えたときに発見できる仕組みまで設計することが、これからの開発では一段と重要になると考えています。