
未経験降雨指数(TP)をリアルタイムに計算する ― 1300万点の過去比較を2µsに縮めた話
この記事でつくるもの
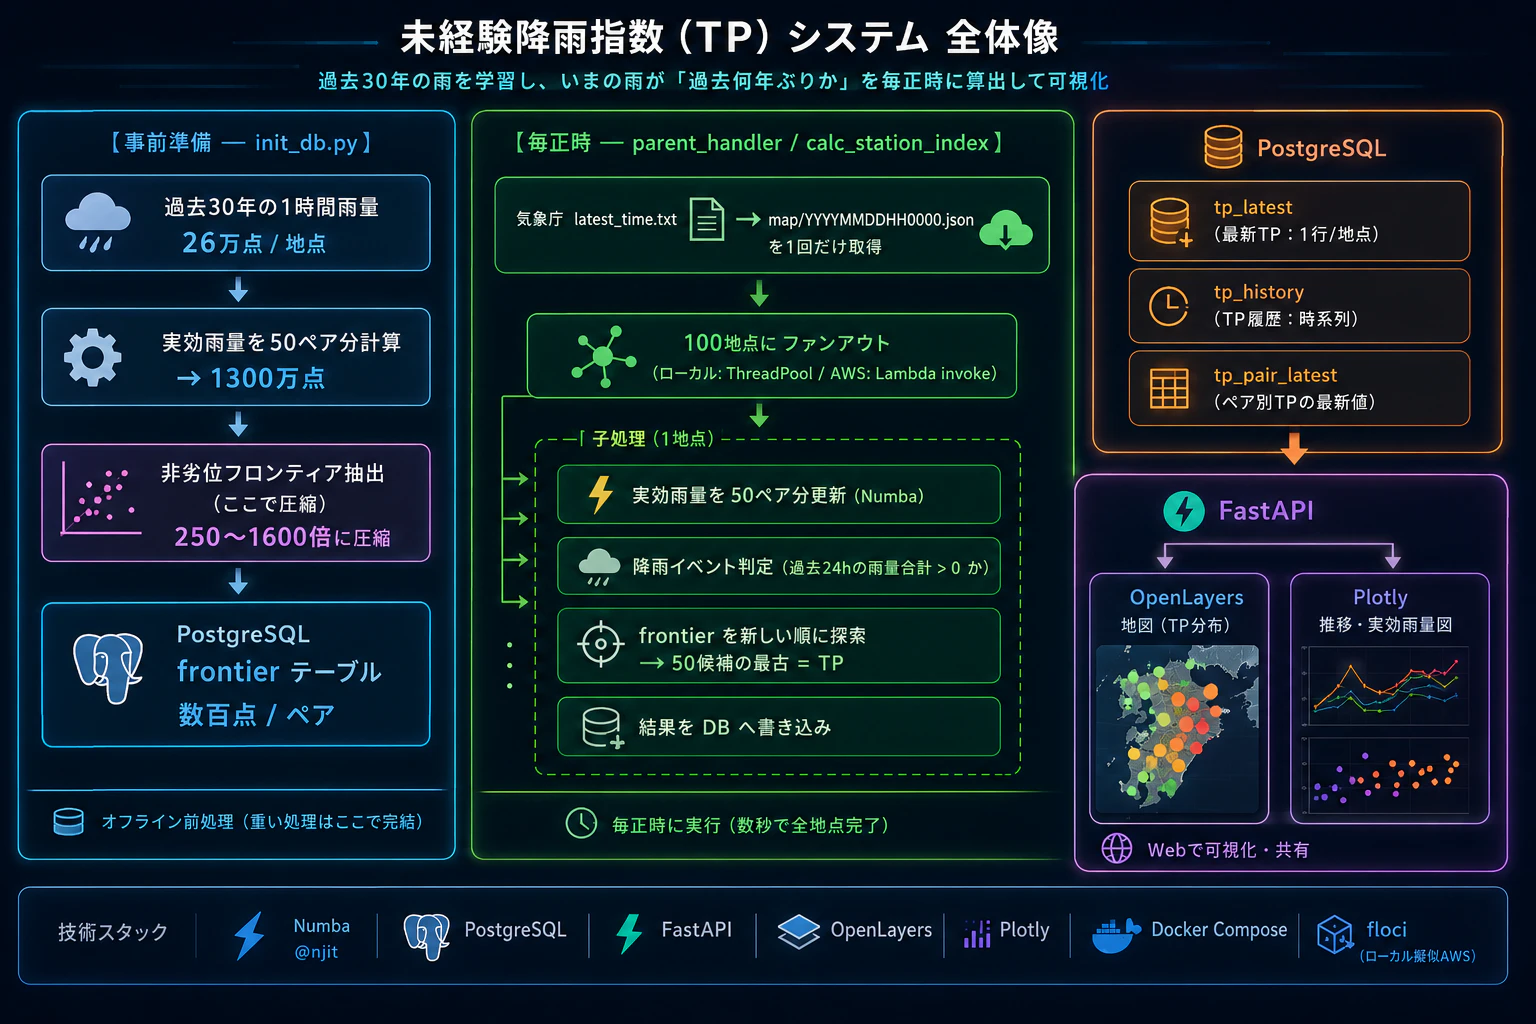
九州のアメダス約100地点について、気象庁のリアルタイム雨量と過去30年の降雨履歴を突き合わせ、「いま降っている雨は、過去のいつまで遡れば経験済みか」を表す未経験降雨指数 TP (Time of Past rainfall event) を毎正時に算出してWebに公開するシステムの検討を行いました。
京都大学・小杉賢一朗教授が提案されている手法がベースで、実装にあたっては以前投稿したQiita記事を参考にしています。
構成はこんな感じです。
-
計算エンジン: Numba (
@njit) で JIT コンパイル - DB: PostgreSQL(探索用に「非劣位フロンティア」を事前計算)
- API/UI: FastAPI + OpenLayers + Plotly
- 実行基盤: Docker Compose + floci(ローカル擬似AWS)、将来の Lambda ファンアウトを見据えた親子関数構成
この記事で扱うのはローカル運用までです 。
記事の主眼は探索をどう軽くしたかです。未経験降雨指数算出の考え方は難しくはありませんが、データの組み合わせと検索が大量にあります。素直に実装すると1地点あたり1300万点の総当たりになるところを、データ構造の工夫で数百点まで落とし、探索時間を 約2µs にできました。
全体の流れ
TP とは何か
ざっくり言うと「現在の雨が、過去何年ぶりの規模か」を時刻で表した指標です。
土砂災害の危険度は「短時間の激しさ」と「長時間の積算」の両方で決まります。そこで、
減衰の速さが異なる2つの実効雨量を組にして、雨を2次元平面上の点として扱います。
実効雨量は指数減衰型の漸化式で計算します。半減期 $M$ に対して
X_M(t) = rain(t) + \alpha \cdot X_M(t-1), \quad \alpha = 0.5^{\Delta t / M}
長期半減期 $M_1$ と短期半減期 $M_2$($M_1 \ge M_2$)を組にすると、ある時刻の雨は
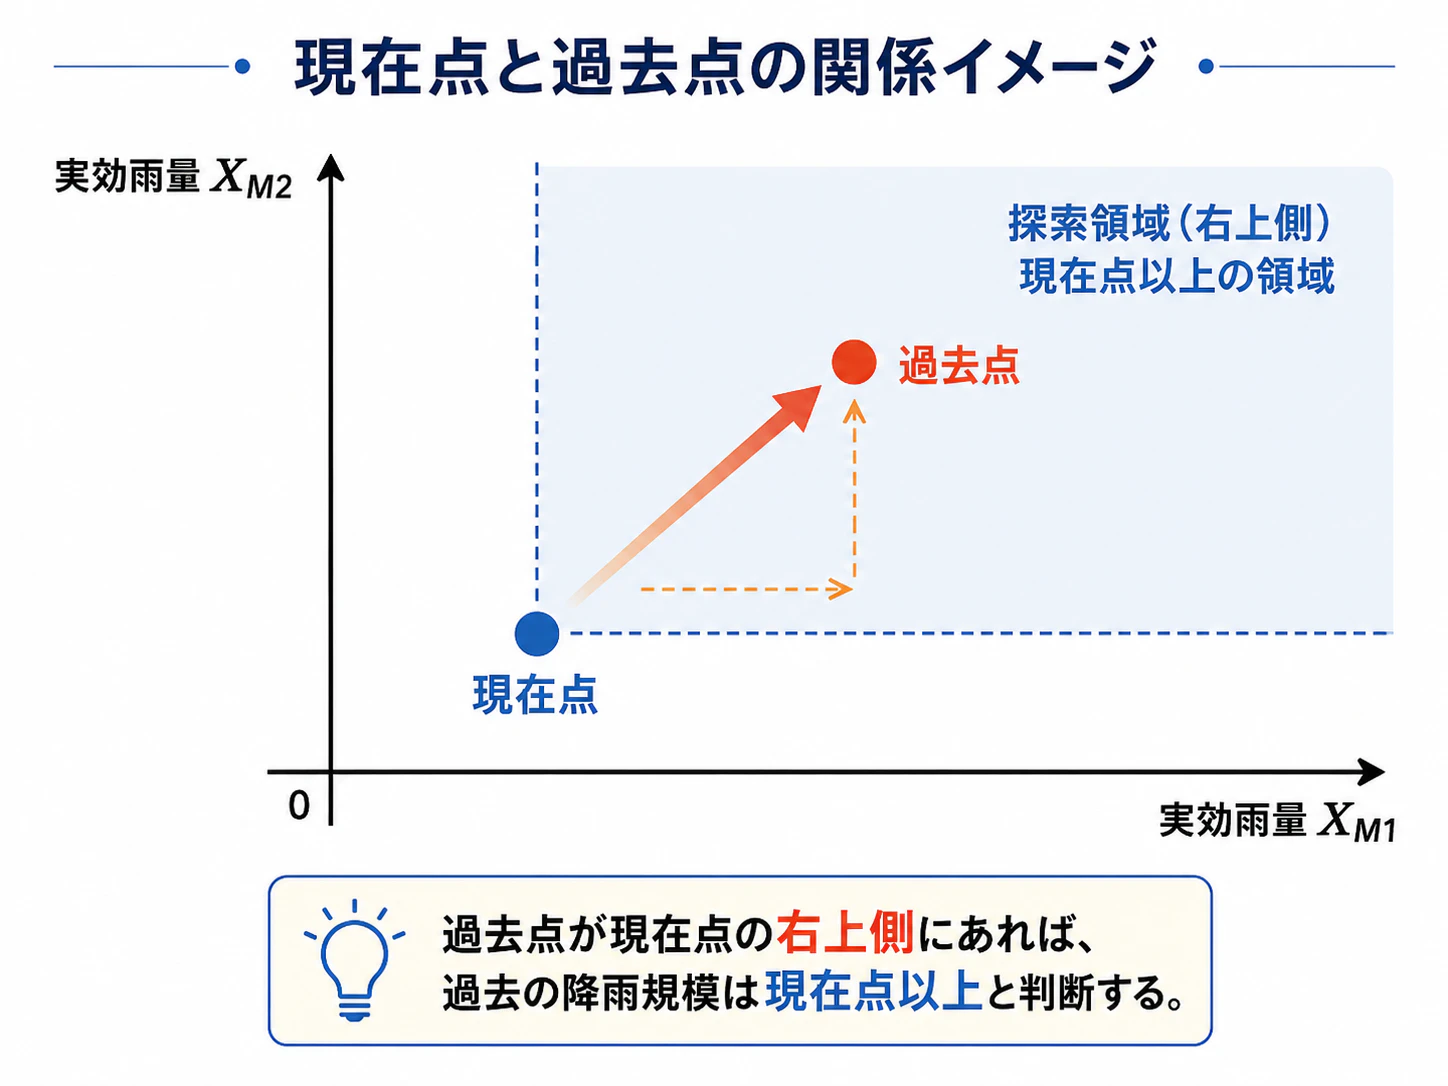
$(X_{M_1}, X_{M_2})$ という平面上の1点になります。この平面を半減期ペア実効雨量図と呼びます。
ここで TP の定義です。
現在の点 $(x, y)$ に対して、過去の点で $x' \ge x$ かつ $y' \ge y$ を満たすもの(=図の右上にある点)を
新しい時刻から順に遡って探し、最初に見つかった時刻をそのペアの TP 候補とする。
図の右上に過去の点があれば「その時刻には今より強い雨を経験している」ということです。逆に右上に何もなければ、「観測史上未経験」になります。
そして半減期ペアは1組では足りません。短時間強雨に効くペア、長雨に効くペアと性質が違うので、
1326通りのペアで並行に評価し、最も古い候補(=最も長く遡らないと同等の雨が見つからないペア)を TP として採用します。
「どのペアで見ても経験済み」ではなく「一つでも未経験に近いペアがあれば危険」という安全側の判断です。
危険度は TP の古さから機械的に決めています。
| 危険度 | 意味 |
|---|---|
| 0 | 降雨なし(イベント外) |
| 1 | 1年未満 |
| 2 | 1〜5年 |
| 3 | 5〜15年 |
| 4 | 15〜30年 |
| 5 | 観測史上未経験 |
素直に実装すると死ぬ
計算量を見積もってみます。
- 過去30年 × 1時間値 = 約26万点/地点
- 半減期ペア 1326通り
- → 1地点あたり 約1300万点
- 100地点で 13億点
毎正時、100地点それぞれで「新しい順に遡って条件を満たす最初の点を探す」わけですが、
最悪ケース(=観測史上未経験のとき)は全点を走査します。しかも未経験のときこそ
一番急いで結果を出したい場面なので、最悪ケースが遅いのは致命的です。
SQL で書くとこうなります。
SELECT max(ts) FROM effective_rainfall
WHERE station_id = %s AND param_id = %s AND x >= %s AND y >= %s;
2次元の範囲条件は B-Tree インデックスが効きにくく、2600万行(100地点分)に対してこれを
毎正時 5000回(100地点 × 50ペア)投げるのは現実的ではありません。
解法: 時刻を考慮した非劣位フロンティア
ここで利用するのは、探索が「過去へ向かって新しい順に調べ、条件を満たした最初の点を返す」という性質です。
過去の点Aより新しい時刻に、Aより右上に位置する点Bがあるとします。
すなわち、
t_B > t_A,\qquad
x_B \ge x_A,\qquad
y_B \ge y_A
です。
このときAはTP候補になることがありません。
現在点を ((x,y)) とすると、Aが探索条件
x_A \ge x,\qquad y_A \ge y
を満たす場合、
x_B \ge x_A \ge x,\qquad
y_B \ge y_A \ge y
なので、Bも必ず探索条件を満たします。
しかもBの方がAより新しいため、新しい時刻から遡って探索すると、Aへ到達する前にBが見つかります。したがってAは事前に探索対象から除外できます。
一方、古い点Aが新しい点Bより右上にある場合は事情が異なります。Bでは条件を満たさず、Aで初めて条件を満たす現在点が存在するため、Aは捨てられません。
つまり、除外できるのは、
「空間的に右上にある、より新しい点に支配されている過去点」
だけです。
抽出アルゴリズム
新しい時刻から遡りながら、既に見た点の集合を「$x$ 昇順・$y$ 降順の階段(staircase)」として保持します。
新しい点 $(x, y)$ が来たら、$x' \ge x$ となる最小の $x'$ を二分探索し、その点の $y'$ が $y$ 以上なら支配されている=捨てる。
支配されていなければ採用し、逆にその点に支配される既存点(階段の一部)を削除します。
@njit(cache=True)
def build_frontier_mask(x, y):
    """x, y は時刻昇順。残す点を True にしたマスクを返す。"""
    n = x.shape[0]
    keep = np.zeros(n, dtype=np.bool_)
    cap = 1024
    sx = np.empty(cap)   # 階段: x 昇順
    sy = np.empty(cap)   # 階段: y 降順
    k = 0
    for i in range(n - 1, -1, -1):     # 新しい順に遡る
        px, py = x[i], y[i]
        # j = 最初の sx >= px
        lo, hi = 0, k
        while lo < hi:
            mid = (lo + hi) >> 1
            if sx[mid] < px:
                lo = mid + 1
            else:
                hi = mid
        j = lo
        if j < k and sy[j] >= py:
            continue                    # より新しい点に支配される → 捨てる
        keep[i] = True
        # (以下、この点に支配される既存点を階段から除去)
        ...
    return keep
$O(n \log k)$ で回ります。
効果
実測です(擬似30年データ、九州100地点)。
82182 福岡   rows= 262,800  frontier= 27,094 (542/param, 圧縮率 485x)
84076 美津島  rows= 262,800  frontier=  8,080 (162/param, 圧縮率 1,626x)
88166 溝辺   rows= 262,800  frontier= 51,970 (1039/param, 圧縮率 253x)
1300万点(26万×50ペア)が、1地点あたり2〜5万点、1ペアあたり数百点まで落ちました。圧縮率は250〜1600倍です。
ここまで小さければ、DB から全部メモリに読んで線形走査しても一瞬で終わります。
Numba で殴る
フロンティアは (地点, ペア) ごとに長さが違う可変長配列の集まりです。これを Numba に渡すために
CSR 形式(区間オフセット + 連結した1次元配列)にしました。型を固定することでコンパイルキャッシュが効きます。
offs : int64[51]   # param p の区間は [offs[p], offs[p+1])
fts  : int64[N]    # 区間内は ts 降順(新しい → 古い)
fx   : float64[N]
fy   : float64[N]
fev  : int64[N]    # event_id
探索本体はこれだけです。
@njit(cache=True)
def search_tp_all(cx, cy, offs, fts, fx, fy, fev, current_event_id, obs_start_ts, cands, found):
    P = cx.shape[0]
    for p in range(P):
        cands[p] = obs_start_ts
        found[p] = False
        for j in range(offs[p], offs[p + 1]):      # 新しい順
            if current_event_id != NO_EVENT and fev[j] == current_event_id:
                continue                            # 現在イベントは候補から除外
            if fx[j] >= cx[p] and fy[j] >= cy[p]:
                cands[p] = fts[j]
                found[p] = True
                break                               # 最初のヒットで確定
50ペアの候補が出たら、**最小値(最も古い時刻)**を TP として採用します。
実測で 1回あたり約2µs。DB 書き込み込みでも1地点1時刻の処理が 約5ms なので、
100地点を ThreadPoolExecutor で流しても 1〜2秒で1サイクルが終わります(目標は5分以内だったので大幅に余裕)。
実際に動かしてみる
ここまでの実装を実際に起動する手順です。必要なのは Docker と Docker Compose だけです。
ディレクトリ構成
tp_system/
├── docker-compose.yml         db / backend / lambda / floci
├── backend/                   FastAPI + Web UI (static/)
├── lambda/
│   ├── Dockerfile.lambda      Ubuntu 24.04 + awslambdaric (AWS/floci とローカル兼用)
│   ├── handler.py             parent_handler / child_handler / calc_station_index
│   ├── kosugi_logic.py        Numba 計算エンジン
│   ├── db.py                  PostgreSQL アクセス (psycopg3, COPY, CSR 変換)
│   ├── init_db.py             30年履歴 → フロンティア抽出・初期状態構築
│   ├── scheduler.py           定期実行ループ
│   ├── schema.sql             DDL
│   └── params_50.csv          50通りの半減期ペア
├── scripts/
│   ├── fetch_stations.py      観測所マスター生成
│   ├── convert_jma_csv.py     気象庁CSV → 履歴CSV 変換
│   └── deploy_floci.sh        floci へのデプロイ
└── data/                      PostgreSQL 永続化 / 履歴CSV置き場
1. 観測所マスターを作る
気象庁の観測所テーブルから、九州7県(ID先頭2桁が82〜88)の降水量観測所を抽出します。
pip install requests
python3 scripts/fetch_stations.py --limit 100
# → 100 stations -> lambda/kyushu_stations.json
2. DB を起動して初期化する
まず PostgreSQL だけ起動し、過去30年データからフロンティアを構築します。
実データが手元にない段階では --mock で九州の降雨っぽい擬似データ(梅雨・台風期のピーク、
数十年に一度の記録的豪雨を含む)を生成できます。
docker compose up -d db
docker compose run --rm --entrypoint python3 lambda init_db.py --mock
初回はイメージのビルド(Numba の JIT キャッシュのウォームアップを含む)で数分かかります。
初期化が始まると地点ごとに進捗が出ます。
params: 50 通り  (M1 3.0–480.0h, M2 1.5–480.0h)
stations: 100  history_end: 2026-08-31T09:00:00+09:00
  82136 飯塚   rows= 262,800  frontier= 20,152 (403/param, 圧縮率 652x)  calc 0.5s  db 0.1s
  82182 福岡   rows= 262,800  frontier= 27,094 (542/param, 圧縮率 485x)  calc 0.5s  db 0.1s
  ...
done in 87.8s
100地点で約90秒。1地点あたり0.9秒(30年分の実効雨量計算+50ペア分のフロンティア抽出+DB投入)です。
3. API と定期実行を起動する
docker compose up -d backend lambda
docker compose logs -f lambda
lambda コンテナは latest_time.txt を60秒ごとにポーリングし、新しい正時データが出たら
100地点を一斉に処理します。
tp-lambda-runner | INFO scheduler start (poll=60s, mode=thread)
tp-lambda-runner | INFO JMA latest=2026-08-31T10:30:00+09:00 stations=100 fetched in 0.0s
tp-lambda-runner | INFO parent done: {'timestamp': '2026-08-31T10:30:00+09:00', 'stations': 100,
                                      'errors': 0, 'mode': 'thread', 'elapsed_sec': 1.72, 'max_risk': 3}
100地点で1.72秒。errors: 0 なら成功です。あとは http://localhost:8000/ を開けば地図が出ます。
4. API を叩いてみる
# 危険度2以上の観測所だけ
curl localhost:8000/api/tp/latest?min_risk=2

# 福岡の最新TP
curl localhost:8000/api/tp/82182

# TP判定の根拠(50ペアそれぞれの候補時刻)
curl localhost:8000/api/tp/82182/pairs
/pairs を叩くと、どのペアがどれだけ遡ったかが全部見えます。採用されたペア(adopted: true)が
最も古い候補を持っているはずです。
5. 停止・やり直し
docker compose down                          # 停止
docker compose down && sudo rm -rf data/postgres/*   # DBごと作り直す
観測所リストを変更した場合(fetch_stations.py を再実行した場合)は、再初期化が必要です。
ハマったポイント
1. 「現在のイベント」を厳密に除外する
これが一番の落とし穴でした。TP は「過去のイベントとの比較」なので、いま降っている雨そのもの(現在イベント)を
比較対象に入れてはいけません。入れてしまうと「1時間前の自分」がヒットして TP が常に直近になり、指標が無意味になります。
イベントの区切りは「過去24時間の雨量合計が0ならイベント外」で判定します。実装では、
- 進行中イベントの点は
effective_liveテーブルに置き、frontierには入れない - 探索側でも
event_idで二重に除外 -
イベント終了時に
merge_frontier()でフロンティアへ畳み込む
という二段構えにしました。
雨量  ▁▁▃█▇▅▂▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▃▇█▅▂▁▁▁ ← いま
      └── イベントA ──┘          └─ イベントB(現在)─┘
           ↑ 24時間 無降雨で区切る    ↑
           │                          │
      frontier に畳み込み済み      effective_live に隔離
      (=探索対象)                (=探索対象から除外)
畳み込み結果が「最初から全データでフロンティアを作った場合」と完全一致することは
テストで担保しています。
def test_merge_frontier_equals_rebuild():
    merged = k.merge_frontier(old, pts)
    ref = k.build_frontier_for_station(ts[:iend], X1[:iend], X2[:iend], ev[:iend])
    assert all(np.array_equal(a, b) for a, b in zip(merged, ref))
なお最初の実装では、イベント外の時刻(event_id = -1)で探索したときに fev[j] == current_event_id が
-1 == -1 で成立してしまい、過去のイベント外の点まで軒並み除外されるバグを踏みました。
ブルートフォースとの突き合わせテストを書いていたおかげで発見できたやつです。
# NG: イベント外 (-1) 同士で一致してしまう
if fev[j] == current_event_id:
    continue
# OK
if current_event_id != NO_EVENT and fev[j] == current_event_id:
    continue
2. 気象庁の最新時刻は10分値
latest_time.txt が返すのは10分間隔の最新時刻(例 12:10)です。使いたいのは正時の
precipitation1h(前1時間雨量)なので、正時に切り捨てて map/YYYYMMDDHH0000.json を取りに行きます。
これを忘れると対象区間がずれます。
将来的には、10分間隔の雨量と3時間先の雨量を使って、未経験降雨指数tpを求める予定です。
def floor_hour(dt):
    return dt.astimezone(JST).replace(minute=0, second=0, microsecond=0)
ついでに観測所マスターの URL は amedastable.json(アンダースコア無し)です。
amedas_table.json だと 404 の HTML が返ってきて JSONDecodeError になります。
3. Docker Compose の entrypoint
Lambda 互換イメージにするため ENTRYPOINT ["python3", "-m", "awslambdaric"] を書いていたのですが、
compose 側で entrypoint: ["python3", "scheduler.py"] としていたせいで
docker compose run --rm lambda python3 init_db.py --mock
が scheduler.py python3 init_db.py --mock に連結されて初期化コマンドが黙って無視されていました。
結果、初期化されていない DB に対して常駐スケジューラが10分おきに100地点分のエラーを吐き続けるという地獄に。
修正は entrypoint: [] + command: への分離ですが、念のため scheduler.py の冒頭にガードも入れました。
if len(sys.argv) > 1:
    os.execvp(sys.argv[1], sys.argv[1:])   # 引数付きならそのコマンドを実行
さらに親ハンドラ側で「station_state が空なら100個のトレースバックではなく1行のエラーで中断し、
初期化コマンドを案内する」ようにしました。エラーメッセージは丁寧に出すより次にやるべきことを書く方が有用です。
4. スレッドプールの作り直しで接続リーク
parent_handler() を呼ぶたびに ThreadPoolExecutor を with で作り直していたところ、
スレッドローカルに持たせた DB 接続が毎回リークして、数サイクルで
FATAL: sorry, too many clients already になりました。Executor をモジュールレベルで常駐させて解決しています。
Web UI: OpenLayers + Plotly
指標だけ出しても「なぜその値なのか」が伝わらないので、判断根拠が見えることを重視しました。
-
地図 (OpenLayers): 地理院タイル上に観測所を危険度で色分け。マーカーのサイズも危険度に連動。
右上の危険度別カウンタでフィルタできます。 -
推移 (Plotly, 3段): 雨量 / TP年 / 危険度を縦に並べて x 軸連動。イベント外の区間は TP 線を意図的に途切れさせ、
「評価対象外」であることを明示しています。 -
実効雨量図 (Plotly): 横軸 $X_{M_1}$、縦軸 $X_{M_2}$。灰点が過去フロンティア、緑線が現在イベントの軌跡、
◆が現在点、★がそのペアの TP 候補。現在点の右上を「経験済み領域」として塗ることで、
TP の定義そのものが図から読み取れるようにしました。 - ペア別候補表: 50ペアそれぞれの候補時刻と何年前か。採用されたペアを強調し、行クリックでその図に切り替わります。
APIは以下の構成です。
GET /api/tp/latest.geojson              地図用(危険度つき)
GET /api/tp/{station_id}                最新TP
GET /api/tp/{station_id}/history?hours= 時系列
GET /api/tp/{station_id}/pairs          50ペアの候補一覧(根拠)
GET /api/tp/{station_id}/diagram        実効雨量図データ
サーバーレスを見据えた親子構成
将来 AWS へ移すことを前提に、処理を親子に分けています。
-
親
parent_handler(): 気象庁から最新 JSON を1回だけ取得し、100地点にファンアウト -
子
calc_station_index(station_id, latest_data): 1地点分の実効雨量更新とTP探索、DB書き込み
ファンアウト部分は環境変数で切り替えるだけにしました。
def _invoke_children(payloads):
    if config.INVOKE_MODE == "lambda":
        client = boto3.client("lambda", endpoint_url=config.AWS_ENDPOINT_URL)
        for pl in payloads:
            client.invoke(FunctionName=config.CHILD_FUNCTION_NAME,
                          InvocationType="Event", Payload=json.dumps(pl).encode())
    else:
        # ローカル: ThreadPoolExecutor で疑似並列
        ...
INVOKE_MODE=thread でローカル実行、INVOKE_MODE=lambda で本番の100多重ファンアウト。
イメージも Ubuntu 24.04 + awslambdaric で共通化してあるので、ECR に push すればそのまま動きます。
floci でローカルに擬似 AWS 環境を作る
とはいえ「環境変数を変えるだけで動くはず」を信じてそのまま本番に投げるのは怖いので、
floci でローカルに擬似 AWS 環境を立てて検証できるようにしました。
floci は LocalStack 互換の AWS エミュレータで、http://localhost:4566 にエンドポイントを立て、
AWS CLI や boto3 をそのまま向けられます。Lambda は Docker ソケット経由で実際のコンテナとして起動されるため、
「ハンドラの引数の受け取り方」「コールドスタート」「非同期invokeの挙動」といった、
ThreadPoolExecutor 版では絶対に検出できない差分をローカルで潰せます。
compose には profile 付きで定義してあるので、必要なときだけ起動します。
  floci:
    image: floci/floci:latest
    ports:
      - "4566:4566"
    environment:
      FLOCI_STORAGE_MODE: hybrid
      # floci が起動する Lambda コンテナを compose のネットワークに参加させる
      LAMBDA_DOCKER_NETWORK: tp_system_default
    volumes:
      - /var/run/docker.sock:/var/run/docker.sock
    profiles: ["floci"]
ポイントは LAMBDA_DOCKER_NETWORK です。floci が起動する Lambda コンテナを compose のネットワークに
参加させないと、Lambda 側から db というホスト名を解決できず DB に繋がりません。
デプロイはスクリプト一本にまとめました。やっていることは
「イメージをビルドして擬似ECRにpush → 子Lambda作成 → 親Lambda作成 → EventBridge Schedulerで10分毎起動」です。
docker compose --profile floci up -d
export AWS_ENDPOINT_URL=http://localhost:4566
export AWS_ACCESS_KEY_ID=test AWS_SECRET_ACCESS_KEY=test AWS_DEFAULT_REGION=ap-northeast-1
./scripts/deploy_floci.sh
スクリプトの中身はこんな感じです。同じイメージをCommandだけ変えて親子2つの関数として登録しているのがミソで、
これは本番AWSでもそのまま通用する構成です。
# 子 Lambda(100多重で起動される側)
aws lambda create-function --function-name tp-calc-station --package-type Image \
  --code ImageUri="$REPO:latest" --role $ROLE --timeout 120 --memory-size 1024 \
  --image-config '{"Command":["handler.child_handler"]}' \
  --environment "Variables={DATABASE_URL=$DB_URL}"

# 親 Lambda(INVOKE_MODE=lambda で子を非同期invoke)
aws lambda create-function --function-name tp-parent --package-type Image \
  --code ImageUri="$REPO:latest" --role $ROLE --timeout 300 --memory-size 512 \
  --image-config '{"Command":["handler.parent_handler"]}' \
  --environment "Variables={DATABASE_URL=$DB_URL,INVOKE_MODE=lambda,\
                            CHILD_FUNCTION_NAME=tp-calc-station,AWS_ENDPOINT_URL=http://floci:4566}"

# 10分毎に親を叩く
aws scheduler create-schedule --name tp-every-10min --schedule-expression "rate(10 minutes)" \
  --flexible-time-window '{"Mode":"OFF"}' \
  --target "{\"Arn\":\"...:function:tp-parent\",\"RoleArn\":\"$ROLE\"}"
動作確認は AWS CLI をそのまま使えます。
# 親を手動起動(→ 子が100多重で走る)
aws lambda invoke --function-name tp-parent --payload '{}' out.json && cat out.json

# 子を単体でテスト
aws lambda invoke --function-name tp-calc-station --cli-binary-format raw-in-base64-out \
  --payload '{"station_id":"82182","ts":1756530000,"rain":20.5}' out.json

# ログを追う
aws logs tail /aws/lambda/tp-calc-station --follow
Lambda 実行環境に寄せるため、イメージは awslambdaric(AWS Lambda Runtime Interface Client)を
ENTRYPOINT にしてあります。ローカルの常駐ランナーとして使うときは compose 側で entrypoint を上書きする、
という二役構成です。
FROM ubuntu:24.04
...
RUN pip install --no-cache-dir -r requirements.txt awslambdaric
COPY . .
# Numba の JIT キャッシュをビルド時に温めておく(コールドスタート短縮)
RUN python3 -c "import kosugi_logic as k; k.warmup()"
ENTRYPOINT ["python3", "-m", "awslambdaric"]
CMD ["handler.parent_handler"]
最後の warmup() は地味に重要で、Numba の JIT コンパイルは初回に数秒かかります。
Lambda のコールドスタートで毎回これを払うのは論外なので、ビルド時にキャッシュを生成しておきます
(@njit(cache=True) と NUMBA_CACHE_DIR の指定がセット)。
なお、この二役構成が原因で「compose の entrypoint 指定と衝突して初期化コマンドが無視される」という
事故を起こしました(「ハマったポイント」参照)。
本番 AWS への移行(RDS Proxy による接続集約、VPC からの外部アクセス、非同期invokeのリトライ対策など)は
それ自体でボリュームがあるので、次回の記事にまわします。この記事はローカル運用までとしました。
テストの話
数値計算はバグっても「それっぽい値」が出てしまうので、ブルートフォースとの突き合わせを必ず書きました。
def _brute(q, ts, X1, X2, ev):
    """定義通りの総当たり実装"""
    P = X1.shape[1]; best = None
    for p in range(P):
        cand = 0
        for j in range(q, -1, -1):
            if ev[q] != -1 and ev[j] == ev[q]:
                continue
            if X1[j, p] >= X1[q, p] and X2[j, p] >= X2[q, p]:
                cand = ts[j]; break
        best = cand if best is None else min(best, cand)
    return best


def test_search_matches_brute_force():
    ts, X1, X2, ev = _series()
    for q in (n - 1, n - 77, n - 1234, n - 5000):
        fr = k.build_frontier_for_station(ts[:q+1], X1[:q+1], X2[:q+1], ev[:q+1], exclude_event_id=ev[q])
        tp, _, _ = k.search_tp(X1[q], X2[q], *fr, np.int64(ev[q]), np.int64(0))
        assert tp == _brute(q, ts, X1, X2, ev)
重要なのは、フロンティアをクエリ時刻までのデータだけで構築している点です([:q+1])。
未来のデータが混入しないことも同時に検証できます。前述の -1 == -1 バグはこのテストで捕まえました。
実データの投入
気象庁の過去の気象データ・ダウンロードから取得したCSVを変換するスクリプトも用意しました。
CP932エンコーディング、「24:00」表記、品質情報による欠測判定、複数ファイルの結合に対応しています。
python3 scripts/convert_jma_csv.py raw/fukuoka_1996-2005.csv raw/fukuoka_2006-2026.csv \
    -o data/history/82182.csv
docker compose run --rm --entrypoint python3 lambda init_db.py --history-dir /data/history
なお100地点×30年を集めるのはダウンロード作業としてそれなりの分量なので、
まずは擬似データ(--mock)で動かしてから主要地点だけ実データに差し替える運用が現実的だと思います。
まとめ
| 項目 | 結果 |
|---|---|
| フロンティア圧縮率 | 250〜1600倍(26万点/ペア → 数百点) |
| TP探索 | 約2µs/回 |
| 1地点1時刻の処理 | 約5ms(DB書き込み込み) |
| 100地点1サイクル | 1〜2秒(目標5分に対して大幅に余裕) |
| 初期構築 | 約0.9秒/地点(30年分の実効雨量計算+フロンティア抽出) |
検証はローカル(Docker Compose)と floci での擬似AWS環境まで。
本番AWSへのデプロイは次回の記事で書く予定です。
**「答えになり得ない点を事前に捨てる」**というたった一つの観察で、13億点の総当たりが数百点の線形走査になりました。
2次元の範囲検索をSQLで頑張るより、問題の性質を利用してデータそのものを小さくする方が効く、という好例だったと思います。
土砂災害の警戒判断は最終的に人が行うものですし、この実装はあくまでプロトタイプです。
ただ「いまの雨が過去何年ぶりか」が地図上で一目で分かることには、それなりの価値があるのではないかと考えています。