
未経験降雨指数 TP の計算フローと Python 実装メモ
はじめに
土砂災害の危険度を考えるとき、時間雨量や累積雨量だけでは、現在の雨が「どのくらい珍しいのか」を直感的に把握しにくいことがあります。そこで参考になるのが、小杉賢一朗先生が提案している 未経験降雨指数 TP です。
まず未経験降雨指数を算出するための参考資料として、以下の論文を使いました。
以下にリンクを挙げておきます。
TP は、現在の降雨状態が過去のどの時刻まで遡れば「経験済み」と言えるかを示す指標です。言い換えると、現在の雨が過去の雨量履歴の中でどの程度珍しいのかを、時刻として表す考え方です。
この記事では、未経験降雨指数 TP の考え方をもとに、計算フローと Python 実装の考え方を整理します。ここで紹介する実装は検証用プロトタイプであり、実際の警戒避難判断にそのまま使うものではありません。
未経験降雨指数 TP の基本的な考え方
TP の考え方は、現在の降雨を複数の雨量指標で表し、過去イベントの中から現在以上の降雨状態を探す、というものです。
処理を簡単に書くと、以下のようになります。
未経験降雨指数 TP の基本的な考え方
- 現在の雨量状態を計算する
↓ - 過去の降雨イベントと比較する
↓ - 現在以上の規模を示す過去時刻を探す
↓ - 複数の雨量指標ペアで TP 候補を求める
↓ - 最も古い TP 候補を TP として採用する
現在以上の過去降雨がかなり昔まで見つからない場合は、現在の雨が過去履歴の中でも珍しい状態であると解釈できます。
全体フローチャート

このフローで特に大切なのは、現在イベント自身を過去候補に含めないことです。現在の雨を現在自身と比較してしまうと、TP の意味が崩れてしまいます。
入力データ
プロトタイプでは、時間雨量 CSV を入力にします。
station_id,MY_STATION_001
station_name,テスト観測地点名
timestamp,rain_mm
2015-01-01T00:00:00,0.000
2015-01-01T01:00:00,1.200
2015-01-01T02:00:00,0.000
先頭 2 行は地点情報です。
station_id   : 地点ID
station_name : 地点名
その後に、時刻と雨量を並べます。
timestamp : 観測時刻
rain_mm   : 時間雨量 [mm/hour]
Step 1. 雨量時系列を整える
まず、CSV から読み込んだ雨量を時刻順に並べます。負の雨量が入っている場合は、プロトタイプでは 0 に補正します。
@dataclass(frozen=True)
class RainPoint:
    """1時刻分の雨量データを表す入れ物。

    timestamp:
        観測時刻。CSV の timestamp 列から作成する。
    rain_mm:
        その時刻の時間雨量 [mm/hour]。
    """

    timestamp: datetime
    rain_mm: float


def sort_rainfall(points: Iterable[RainPoint]) -> list[RainPoint]:
    """雨量データを時刻順に並べ、計算前の最低限の補正を行う。

    ここではプロトタイプとして、負の雨量を 0 mm に補正している。
    実務では、欠測値・重複時刻・異常値を別途フラグ管理する方が安全。
    """

    cleaned = [
        # 観測値に負値が入った場合は、簡易的に 0 として扱う。
        RainPoint(p.timestamp, max(0.0, float(p.rain_mm)))
        for p in points
    ]

    # TP 計算では時刻順が前提になるため、必ず昇順に整列する。
    cleaned.sort(key=lambda p: p.timestamp)

    if len(cleaned) < 2:
        raise ValueError("雨量データは2レコード以上必要です。")

    return cleaned
ここで、時刻が重複している場合や欠測がある場合は、本来は別途チェックが必要です。実運用に近づけるなら、欠測フラグを持たせる方が安全です。
Step 2. 実効雨量を計算する
TP の計算では、現在の雨を 1 つの雨量指標だけで見るのではなく、複数の半減期を持つ実効雨量で表します。
実効雨量は、次のような指数減衰型の式で計算します。
X_M(t) = rain(t) + α × X_M(t-1)

α = 0.5 ^ (Δt / M)
ここで、
X_M(t) : 半減期 M の実効雨量
rain(t): 現在時刻の雨量
Δt     : 前回観測からの時間差
M      : 半減期
です。
Python では以下のように書けます。
def compute_effective_rainfall(
    points: list[RainPoint],
    half_lives: list[float],
) -> dict[float, list[float]]:
    """複数半減期の実効雨量をまとめて計算する。

    戻り値は `{半減期: 実効雨量時系列}` の辞書にしておく。
    こうしておくと、後段で M1, M2 の半減期ペアを作るときに扱いやすい。
    """

    # 0 以下の半減期は計算に使えないので除外し、重複も取り除く。
    values = sorted({float(v) for v in half_lives if float(v) > 0})

    # 半減期ごとに、雨量データと同じ長さの配列を準備する。
    eff = {m: [0.0] * len(points) for m in values}

    for m in values:
        series = eff[m]
        series[0] = points[0].rain_mm

        for i in range(1, len(points)):
            # 観測間隔が1時間とは限らないため、実際の時刻差から Δt を求める。
            dt_hours = (
                points[i].timestamp - points[i - 1].timestamp
            ).total_seconds() / 3600.0

            # 時刻重複などで Δt が不正な場合は、プロトタイプでは1時間として扱う。
            if dt_hours <= 0:
                dt_hours = 1.0

            # 半減期 M に応じて、前時刻の実効雨量を減衰させる。
            alpha = 0.5 ** (dt_hours / m)

            # 現在雨量を加えて、現在時刻の実効雨量にする。
            series[i] = points[i].rain_mm + alpha * series[i - 1]

    return eff
短い半減期は短時間強雨に敏感で、長い半減期は長雨や累積的な雨に敏感です。
プロトタイプでは、以下の半減期を既定値にしています。
1.5, 3, 6, 12, 24, 48, 72 時間
Step 3. 半減期ペアを作る
次に、半減期の組み合わせを作ります。
M1 >= M2
となるように、長い半減期を M1、短い半減期を M2 として扱います。
def make_half_life_pairs(half_lives: list[float]) -> list[tuple[float, float]]:
    """実効雨量図で使う半減期ペアを作成する。

    M1 は横軸、M2 は縦軸として扱う。
    ここでは M1 >= M2 だけを採用し、同じ組み合わせを二重に評価しない。
    """

    values = sorted({float(v) for v in half_lives if float(v) > 0})
    pairs: list[tuple[float, float]] = []

    for m1 in values:
        for m2 in values:
            if m1 >= m2:
                pairs.append((m1, m2))

    return pairs
半減期ペアは、2次元の実効雨量図として考えると分かりやすいです。
横軸:X_M1
縦軸:X_M2
この図の中で、現在点より右上にある過去点を探します。
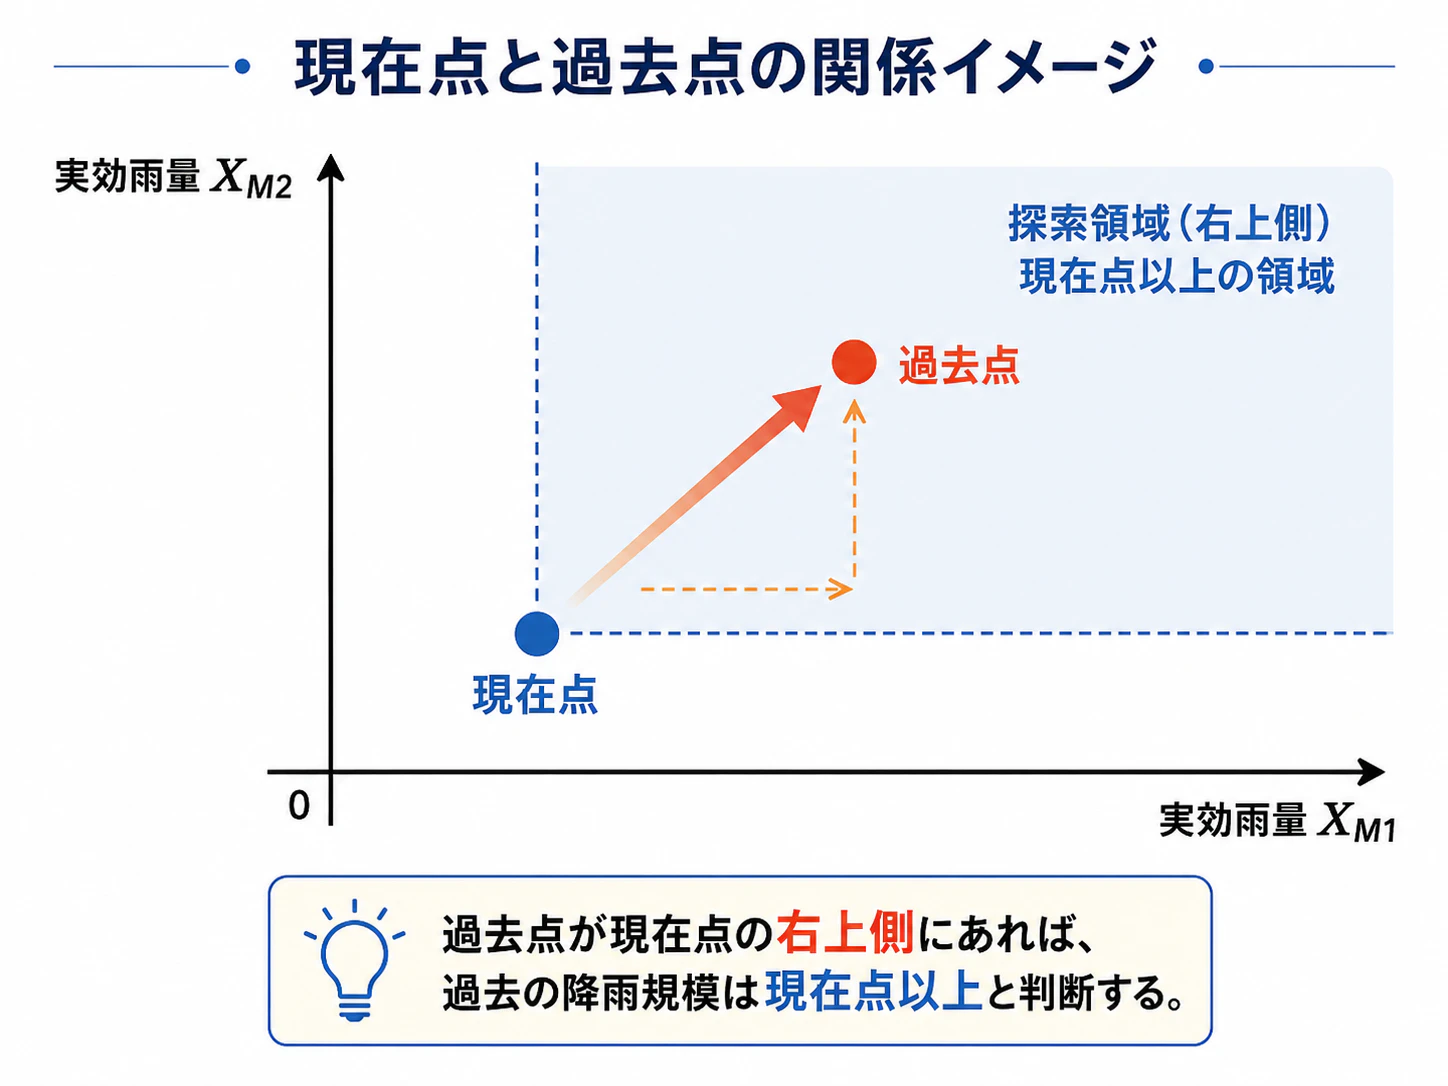
過去点が現在点の右上にあるということは、M1 と M2 のどちらの見方でも、過去の方が現在以上だったことを意味します。
Step 4. 無降雨イベント区切りを判定する
降雨イベントをどう区切るかも重要です。
プロトタイプでは、過去 event_gap_hours 時間の雨量合計を見て、降雨イベント中かどうかを判定しています。
過去 event_gap_hours 時間の雨量合計 > 0
  → 降雨イベント中

過去 event_gap_hours 時間の雨量合計 = 0
  → 降雨イベント外
既定値は 24 時間です。
def compute_event_state(
    points: list[RainPoint],
    event_gap_hours: float = 24.0,
) -> tuple[list[bool], list[int | None]]:
    """各時刻が降雨イベント中かどうかを判定する。

    プロトタイプでは、過去 `event_gap_hours` 時間の雨量合計が 0 より大きければ
    降雨イベント中とみなす。既定では 24 時間を使う。

    Returns:
        active:
            各時刻が降雨イベント中かどうか。
        start_indices:
            イベント中の時刻について、そのイベントの開始インデックスを返す。
            イベント外の場合は None。
    """

    n = len(points)
    active = [False] * n
    start_indices: list[int | None] = [None] * n

    # rolling_sum は、現在時刻から event_gap_hours だけ遡った範囲の雨量合計。
    left = 0
    rolling_sum = 0.0

    for i in range(n):
        rolling_sum += points[i].rain_mm
        limit = points[i].timestamp.timestamp() - event_gap_hours * 3600.0

        # 判定窓から外れた古い雨量を合計から引く。
        while left <= i and points[left].timestamp.timestamp() <= limit:
            rolling_sum -= points[left].rain_mm
            left += 1

        # 浮動小数点の微小な誤差を 0 とみなす。
        if abs(rolling_sum) < 1e-9:
            rolling_sum = 0.0

        active[i] = rolling_sum > 1e-9

    # active の True 区間をたどり、イベント開始位置を記録する。
    current_start: int | None = None
    for i, is_active in enumerate(active):
        if is_active and (i == 0 or not active[i - 1]):
            current_start = i

        if is_active:
            start_indices[i] = current_start
        else:
            current_start = None

    return active, start_indices
実際の運用では、0.0 mm だけを無降雨とするのか、0.5 mm 未満のような微小雨量を無降雨扱いにするのかも検討が必要です。
Step 5. 現在イベントと過去イベントを分ける
TP を計算するときは、現在イベント自身を過去候補に含めません。
処理の流れは以下です。
イベントAを処理する
  ↓
イベントAの中では、イベントA自身を候補に入れない
  ↓
イベントAの処理が終わったら、過去候補として登録する
  ↓
次のイベントBでは、イベントAを過去候補として使う
実装イメージは以下です。
for start_i, end_i in event_ranges:
    """1つの降雨イベントを処理する。

    start_i から end_i までが同じ降雨イベントに属する。
    このイベントを処理している間は、まだ過去候補 archive に登録しない。
    """

    for current_i in range(start_i, end_i + 1):
        # この時点では、現在イベントは archive に入っていない。
        # そのため、探索対象は「すでに終了した過去イベント」だけになる。
        # ここで current_i の TP 候補を計算する。
        pass

    # イベント終了後に、初めて過去候補へ登録する。
    # 次のイベントからは、このイベントが比較対象として使われる。
    archive.extend(event_points)
この順番を間違えると、現在の降雨を現在自身と比較してしまいます。
Step 6. 半減期ペアごとに TP 候補を探す
ある時刻 t について、半減期ペアごとの現在点を作ります。
current_x = X_M1(t)
current_y = X_M2(t)
過去イベント点の中から、以下を満たす点を探します。
past_x >= current_x
past_y >= current_y
単純に書けば、以下のような処理になります。
for m1, m2 in pairs:
    """1つの半減期ペアについて、現在点以上の過去点を探す。"""

    # 現在時刻を半減期ペア実効雨量図の点として表す。
    current_x = eff[m1][current_i]
    current_y = eff[m2][current_i]

    candidate_i = None

    # 過去点を新しい時刻から順に調べる。
    # 最初に見つかった点が、この半減期ペアにおける TP 候補になる。
    for past_i in reversed(past_indices):
        past_x = eff[m1][past_i]
        past_y = eff[m2][past_i]

        # 過去点が現在点の右上側にあるかどうかを判定する。
        if past_x >= current_x and past_y >= current_y:
            candidate_i = past_i
            break

    # 候補が無い場合は、プロトタイプでは観測開始時刻を候補にする。
    if candidate_i is None:
        candidate_i = 0
候補が見つからない場合は、プロトタイプでは観測開始時刻を TP 候補として扱います。
過去候補なし
  → 観測開始以来級
Step 7. 最も古い TP 候補を採用する
半減期ペアが複数あるため、TP 候補も複数できます。
M1=72h, M2=1.5h → TP候補 2020-07-10
M1=48h, M2=3h   → TP候補 2021-08-12
M1=24h, M2=6h   → TP候補 2019-09-03
この中で、最も古い時刻を TP とします。
# 半減期ペアごとに得られた TP 候補のうち、最も古い時刻を採用する。
# index が小さいほど古い時刻なので、min() で取り出せる。
tp_i = min(candidate_indices)
tp_ts = rainfall[tp_i].timestamp
TP が古いほど、現在の降雨状態が過去の記録の中で珍しいことを示します。
実装全体の流れ
Python 実装としては、以下のような流れになります。

データ構造
計算本体では、以下のようなデータ構造を使っています。
@dataclass(frozen=True)
class TpResult:
    """1時刻分の TP 計算結果。

    Plotly の時系列表示や、Parquet への保存に使う。
    `tp_ts` が未経験降雨指数 TP として求めた過去時刻で、
    画面ではこの年を取り出して TP年として表示する。
    """

    timestamp: datetime                 # 評価対象時刻
    rain_mm: float                       # その時刻の雨量 [mm/hour]
    event_active: bool                   # 降雨イベント中かどうか
    event_start_ts: datetime | None      # イベント開始時刻
    tp_ts: datetime | None               # 採用された TP 時刻
    tp_age_hours: float | None           # 現在時刻から TP 時刻までの時間差
    severity_level: int                  # 画面表示用の簡易危険度レベル
    severity_label: str                  # 簡易危険度ラベル
    n_pairs: int                         # 評価した半減期ペア数
    min_tp_pair: str | None              # TP 採用に効いた半減期ペア


@dataclass(frozen=True)
class PairCandidate:
    """半減期ペアごとの TP 候補。

    画面の「TP判定に使われた半減期ペア」カードに表示するためのデータ。
    どの半減期ペアが、どの過去時刻を TP 候補としたかを確認できる。
    """

    timestamp: datetime                  # 評価対象時刻
    m1_hours: float                      # 横軸側の半減期 M1 [hour]
    m2_hours: float                      # 縦軸側の半減期 M2 [hour]
    tp_candidate_ts: datetime            # このペアで得られた TP 候補時刻
TpResult は時系列表示に使う結果です。PairCandidate は、画面で「TP判定に使われた半減期ペア」を表示するために使います。
高速化の考え方
単純に過去全体を後ろ向きに探すと、データ数が増えたときに重くなります。
時刻数 N
半減期ペア数 P

単純探索:
O(N × P × N)
10年分の時間雨量では約 87,000 行になるため、毎回単純探索するとかなり重くなります。
そこで、プロトタイプでは半減期ペアごとに PairArchive を持たせています。
PairArchive
  - 過去イベント点
  - 非劣位フロンティア
  - ブロック化インデックス
考え方はシンプルです。
ある古い点 A よりも新しい点 B があり、
B の X と Y が両方とも A 以上なら、
A は今後の探索で選ばれにくい
このような点を整理して、探索対象を減らします。
保存方式
結果は DuckDB と Parquet を使い分けています。
DuckDB
  - 計算ジョブ
  - 地点情報
  - 計算履歴
  - 半減期ペア候補
  - 最新結果メタ情報

Parquet
  - 全時刻の TP 結果
全時刻データは行数が多いため、Parquet に保存します。DuckDB には、履歴や検索に必要な軽い情報を保存します。
data/
├─ urei.duckdb
└─ results/
   └─ cache/
      └─ <result_cache_key>/
         └─ tp_results.parquet
Plotly での可視化
画面では、時系列グラフを 3 つに分けて表示しています。
1. 雨量図
2. TP年
3. 簡易危険度
1つの図に複数軸を重ねると読み取りにくくなるため、分けて表示しています。
雨量図:
  timestamp - rain_mm

TP年:
  timestamp - tp_year

簡易危険度:
  timestamp - severity_level
また、半減期ペア別 TP 候補は、TP の根拠を確認するために重要なので、最新結果の近くに表示しています。
実装時に気をつけたいこと
実装で特に気をつける点は以下です。
1. 現在イベントを過去候補に含めない
2. 無降雨イベント区切りを明確にする
3. 半減期ごとの実効雨量を正しく更新する
4. 半減期ペアごとに TP 候補を求める
5. 複数候補のうち最も古い時刻を TP とする
6. 過去候補が無い場合の扱いを決めておく
7. 欠測、微小雨量、観測間隔の扱いを決めておく
特にリアルタイム化する場合は、次の状態管理が必要になります。
現在イベント中か
最後に雨があった時刻
無降雨継続時間
半減期ごとの現在実効雨量
過去イベント探索用フロンティア
欠測フラグ
まとめ
未経験降雨指数 TP は、現在の雨を過去イベントと比較し、「どの時刻まで遡れば現在以上の雨があったか」を表す指標です。
プロトタイプでは、以下の流れで実装しました。
未経験降雨指数 TP の算出
- 雨量CSV
↓ - 複数半減期の実効雨量
↓ - 半減期ペア実効雨量図
↓ - 過去イベント点の探索
↓ - 半減期ペア別 TP 候補
↓ - 最も古い候補を TP として採用
↓ - TP年・簡易危険度・採用ペアを可視化
この形にしておくと、次の段階でリアルタイム雨量入力や AMeDAS、解析雨量、レーダー雨量との接続にも拡張しやすくなります。
高速化前の未経験降雨指数の基本的な算出については、ZIPファイルをダウンロードして、解凍後、readme.mdを読んでから実行して試してください。
python 3.12以上で環境を作成してください。
参考リンク
- 土砂災害に対する警戒・避難のための未経験降雨指数の提案
- 土砂災害に対する警戒・避難における未経験降雨指数の有用性について
- 雨量指標データ記録方法の改良による未経験降雨指数算定の効率化に関する検討
- FastAPI 公式ドキュメント
- Docker Compose 公式ドキュメント
- DuckDB 公式ドキュメント
- Apache Arrow / PyArrow Parquet
- Plotly.js 公式ドキュメント