
はじめに
Stable Diffusionを使って、ショートストーリーから複数枚のイラストを自動生成する仕組みを作ってみたくなりました。
最終的には、こんなものを考えています。
日本語でストーリーを入力
        ↓
LLMで12シーンに分割
        ↓
Stable Diffusion用の英語プロンプトを生成
        ↓
12枚のイラストを生成
        ↓
日本語テロップ・吹き出しを合成
        ↓
1080×1920へ変換
        ↓
ショート動画用素材として保存
ただし、手元のマシンにはNVIDIA GPUがありません。
環境はProxmox上のUbuntu VMです。
そこで今回は、
「GPUなしのCPU環境だけでAUTOMATIC1111版Stable Diffusion Web UIはどこまで動くのか?」
を試してみました。
結論から言うと、
- GPUなしでもAUTOMATIC1111は起動できた
- Stable Diffusion 1.5で画像生成もできた
- メモリ不足はかなり深刻
- 256×256では品質が厳しかった
- 512×512なら画像として成立するようになった
- DreamShaperに変更するとさらに改善した
- ただしCPU生成はかなり遅い
という結果になりました。
環境
ホストはProxmox VEをインストールしたノートPCです。
CPUは以下です。
Intel Core i7-8565U
4コア / 8スレッド
物理メモリは8GB。
Stable Diffusion用Ubuntu VMには、当初4GB程度のメモリを割り当てていました。
GPUはありません。
Stable Diffusionのcheckpointには、まずSD 1.5を使用しました。
v1-5-pruned-emaonly.safetensors
AUTOMATIC1111をインストールする
最初はStable Diffusion Web UIの派生版であるreForgeを試していました。
しかしCPUモードで起動しようとしても内部で、
torch.cuda.current_device()
が呼ばれ、
RuntimeError: Found no NVIDIA driver on your system.
となってしまいました。
そこで今回はAUTOMATIC1111本家へ変更しました。
cd ~

git clone https://github.com/AUTOMATIC1111/stable-diffusion-webui.git

cd stable-diffusion-webui
CPUのみで動かすため、以下のオプションを使用します。
./webui.sh \
  --use-cpu all \
  --precision full \
  --no-half \
  --skip-torch-cuda-test
CLIPのインストールで失敗
途中でCLIPのインストールに失敗しました。
ModuleNotFoundError: No module named 'pkg_resources'
venvを有効にして、setuptoolsを入れ直します。
cd ~/stable-diffusion-webui

source venv/bin/activate

python -m pip install --upgrade "setuptools<81" wheel
確認します。
python -c "import pkg_resources; print(pkg_resources.__file__)"
その後、CLIPを手動でインストールしました。
python -m pip install \
  "https://github.com/openai/CLIP/archive/d50d76daa670286dd6cacf3bcd80b5e4823fc8e1.zip" \
  --no-build-isolation
Stable DiffusionリポジトリのcloneでGitHub認証を要求された
次に、
Cloning Stable Diffusion into ...
Username for 'https://github.com':
となりました。
AUTOMATIC1111側を確認すると、Stable Diffusionのリポジトリが環境変数 STABLE_DIFFUSION_REPO で指定できるようになっていました。
今回は webui-user.sh に以下を設定しました。
export STABLE_DIFFUSION_REPO="https://github.com/w-e-w/stablediffusion.git"
CPU起動用オプションもまとめます。
export COMMANDLINE_ARGS="--use-cpu all --precision full --no-half --skip-torch-cuda-test"
export STABLE_DIFFUSION_REPO="https://github.com/w-e-w/stablediffusion.git"
失敗したclone先を削除します。
rm -rf repositories/stable-diffusion-stability-ai
再度起動します。
./webui.sh
今度はメモリ不足
AUTOMATIC1111自体は起動しました。
しかしSD 1.5のcheckpointを読み込むところで、
RuntimeError: unable to mmap 4265146304 bytes
Cannot allocate memory
となりました。
モデルだけで約4GBあります。
VMのメモリだけでは足りなかったため、swapも利用しました。
例えば8GBのswapファイルを作成する場合は以下です。
sudo fallocate -l 8G /swapfile
sudo chmod 600 /swapfile
sudo mkswap /swapfile
sudo swapon /swapfile
確認します。
free -h
ただし、後述するように、swapを増やせば高速になるわけではありません。
swapを増やしたらディスクが100%になった
今度は、
sqlite3.OperationalError: disk I/O error
が発生しました。
ディスクを確認してみます。
df -h
すると、
Filesystem                         Size  Used Avail Use%
/dev/mapper/ubuntu--vg-ubuntu--lv   47G   45G     0 100% /
見事に100%。
AUTOMATIC1111、Pythonのvenv、SD 1.5のモデル、swapなどが重なり、47GBのルートディスクを使い切っていました。
不要になったreForgeなどを削除して空き容量を確保しました。
このあたりから、
Stable DiffusionではGPUだけでなくRAMとストレージも重要
ということを実感します。
Web UIをLAN内から開く
AUTOMATIC1111が起動すると、
Running on local URL: http://127.0.0.1:7862
と表示されました。
しかし 127.0.0.1 ではVM自身からしかアクセスできません。
LAN内の別PCからアクセスするため、--listen を付けます。
さらに将来APIから画像生成したいので、--api も追加します。
./webui.sh \
  --listen \
  --api \
  --port 7862 \
  --use-cpu all \
  --precision full \
  --no-half \
  --skip-torch-cuda-test
Gradioのbindで問題があったため、最終的には環境変数でも明示しました。
export GRADIO_SERVER_NAME=0.0.0.0
export GRADIO_SERVER_PORT=7863
起動すると、
Running on local URL: http://0.0.0.0:7863
となりました。
これでLAN内のPCから、
http://<VMのIPアドレス>:7863
でアクセスできます。
いよいよCPUだけで画像生成
まずは負荷を下げるため、
Width:  256
Height: 256
Steps:  10
Batch size: 1
で生成しました。
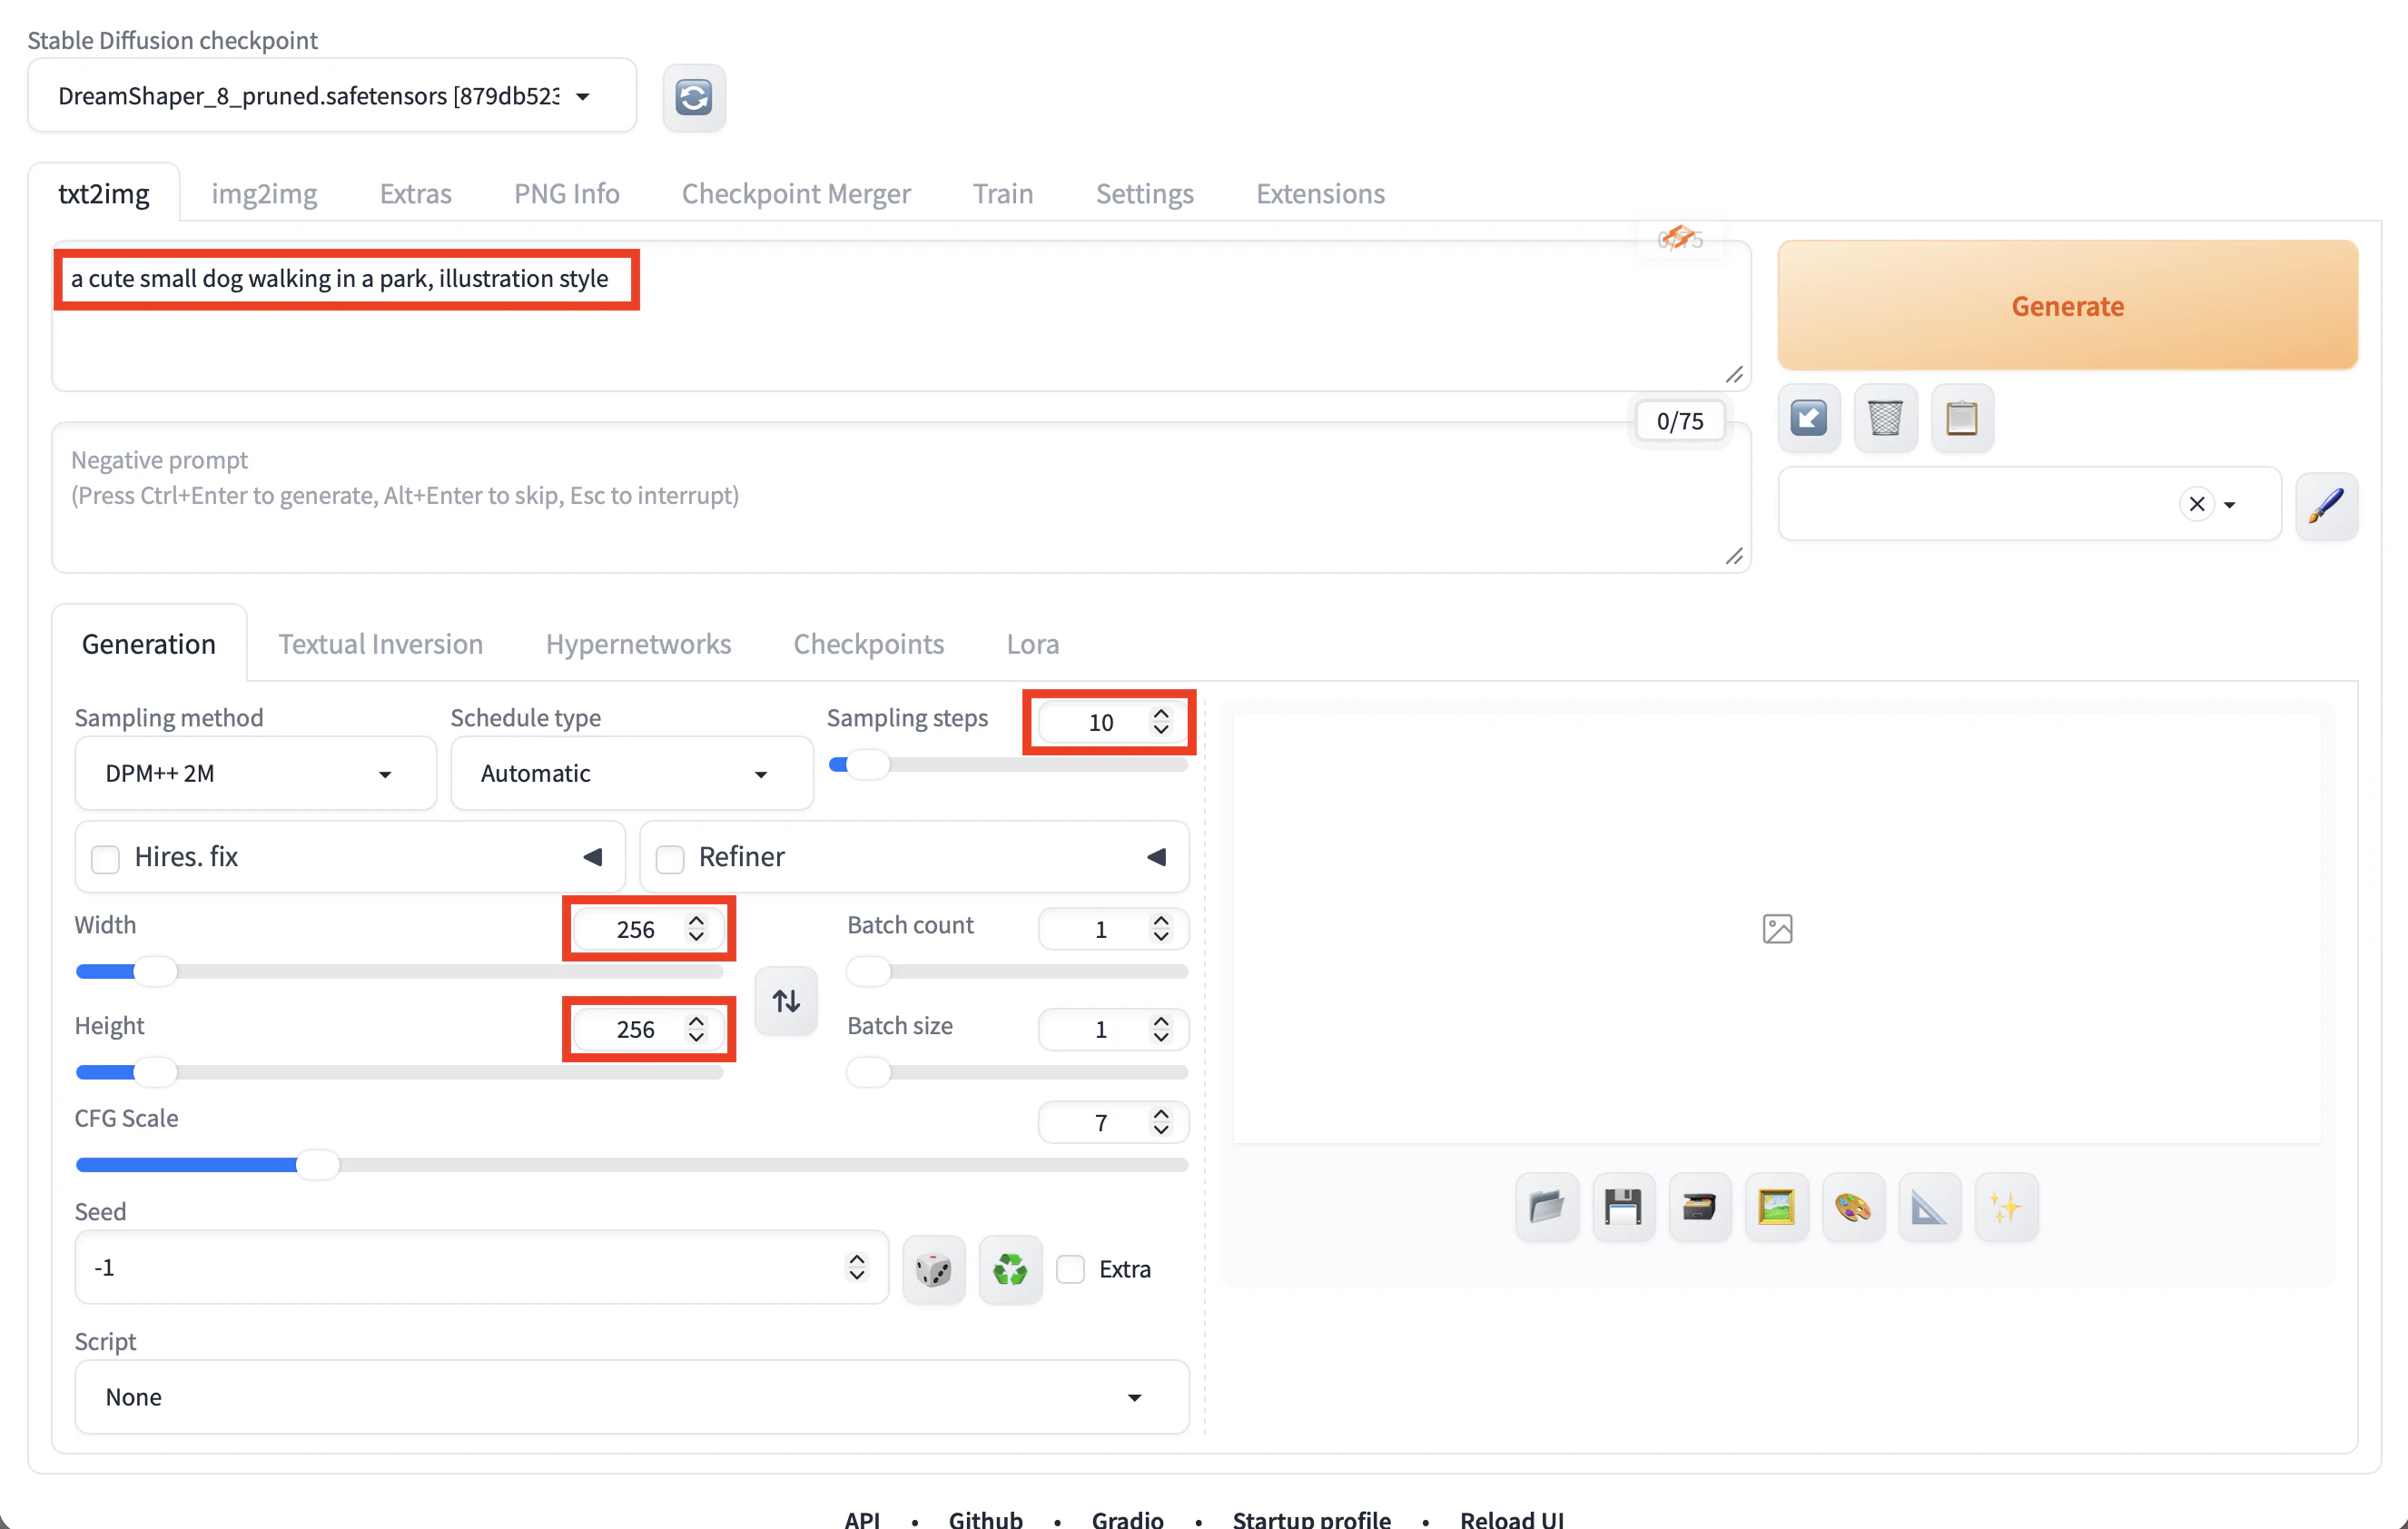
プロンプトは簡単に、
a cute small dog walking in a park, illustration style
としました。
ところが……
10%|██████ | 1/10 [16:35<2:29:14, 995.00s/it]
1 stepに約16分。
10 stepsなので、1枚生成するだけで数時間コースです。
これはさすがに実用になりません。
VMのメモリを増やしたら大幅改善
メモリ不足によるswapが原因ではないかと考え、VMへ割り当てるメモリを6GBに増やしました。
すると、
2/10 [07:17<24:11, 181.39s/it]
まで改善しました。
約995秒/stepから約181秒/step。
単純比較では5倍以上高速化しています。
CPUそのものよりも、メモリ不足によるswapが相当なボトルネックになっていたようです。
AUTOMATIC1111の起動時間も、ある時点では、
Startup time: 673.3s
だったものが、
Startup time: 56.3s
まで短縮しました。
キャッシュなど他の要因もあるため単純比較はできませんが、メモリに余裕を持たせる重要性はかなり感じました。
256×256では画像品質が厳しい
速度を優先して256×256で生成してみたものの、出てきた画像はかなり崩れていました。

Stepsを10から20に増やしてみましたが、品質は改善しませんでした。
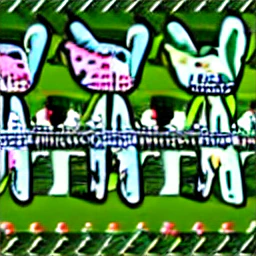
ここで気づいたの解像度です。
SD 1.5は512×512を基準としたモデルなので、256×256では条件が厳しすぎるようです。
そこで、
Width:  512
Height: 512
Steps:  10
CFG Scale: 7
へ変更しました。
すると、少なくとも、
「公園にいる犬のイラスト」
と認識できる画像が生成されるようになりました。
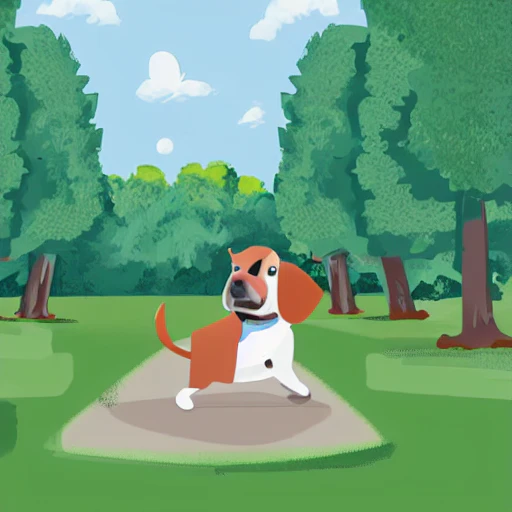
生成時間は約6分。
CPUのみとしては遅いですが、かなり現実的になりました。
12枚生成すると単純計算で、
約6分 × 12枚 = 約72分
です。
自分用のMVPなら、
生成ボタンを押して1時間程度放置する
という使い方はできそうです。
checkpointをDreamShaperへ変更
標準SD 1.5では人物や犬の表現に限界を感じたため、DreamShaper 8も試しました。
AUTOMATIC1111ではcheckpointファイルを、
stable-diffusion-webui/
└── models/
    └── Stable-diffusion/
へ配置します。
例えば、
DreamShaper_8_pruned.safetensors
を置きます。
その後Web UIの Stable Diffusion checkpoint からDreamShaperを選択します。
DreamShaperに変更すると、標準SD 1.5よりも犬らしい形やイラストらしい雰囲気が出るようになりました。
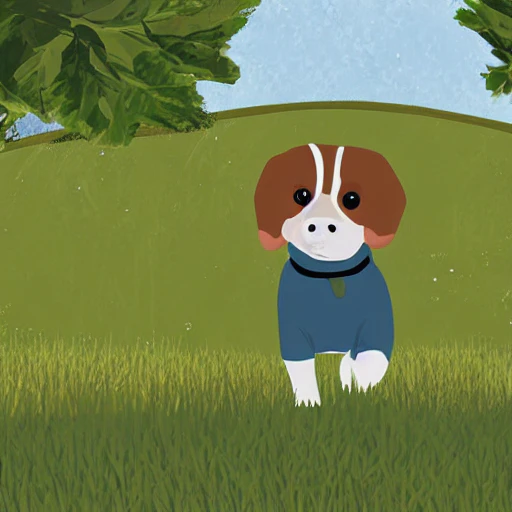

一方で、
- 人物の顔が崩れる
- 複数シーンで同じ人物・犬を維持できるか
- 手や細かいパーツが不自然
など、まだ課題があります。
モデルを変えるだけでかなり出力が変わることも分かりました。
日本語のセリフはStable Diffusionに描かせない
今回作りたいものでは、最終画像に日本語のテロップや吹き出しを入れたいと思っています。
しかし、それをStable Diffusion自身に生成させるのは避けることにしました。
構成を分離します。
Stable Diffusion
        ↓
文字なしのイラスト
        ↓
アプリケーション側
        ↓
日本語テロップ・吹き出しを描画
        ↓
1080×1920
例えば各シーンを、
{
  "scene": 3,
  "image_prompt": "a small dog stopping and looking toward another street",
  "caption": "すると、犬が立ち止まった。",
  "speech": "こっちに行きたいの?"
}
のようなデータとして扱います。
image_prompt だけをStable Diffusionへ渡します。
caption と speech は生成画像へ後から合成します。
この方法なら、
「今日はこっちに行こう」
        ↓
「今日はこっち?」
のような文章変更だけで画像を再生成する必要がありません。
最終的に作りたいもの
今回のStable Diffusion環境構築自体が目的ではありません。
最終的には以下のようなツールを作ろうとしています。
ユーザー
「犬との散歩で新しい道を見つけた話」
        ↓
ローカルLLM
        ↓
12シーンへ分割
        ↓
各シーンの英語プロンプトを生成
        ↓
AUTOMATIC1111 API
        ↓
12枚のイラストを生成
        ↓
日本語テロップを合成
        ↓
1080×1920へ変換
        ↓
プロジェクトとして保存
ユーザーは日本語でストーリーを書くだけ。
画像生成用の英語プロンプトを意識する必要はありません。
今回分かったこと
GPUなしでもStable Diffusionは動きました。
ただし、実際に試してみるとGPU以外にもかなり重要な要素があります。
| 項目 | 分かったこと |
|---|---|
| GPU | なくても動く。ただし遅い |
| RAM | かなり重要。不足するとswapで極端に遅くなる |
| Swap | 起動には役立つが、速度の代わりにはならない |
| SSD | モデル・venv・swapで意外と容量を使う |
| 256×256 | SD 1.5では品質がかなり厳しかった |
| 512×512 | 一気に画像らしくなった |
| Steps | 増やせば必ず良くなるわけではなかった |
| checkpoint | 出力品質への影響がかなり大きい |
| 日本語文字 | AIに描かせず後処理した方が扱いやすい |
| CPU生成 | 512×512・10 stepsで約6分/枚 |
次にやること
Stable Diffusionそのものを延々調整するより、次はアプリケーション側を作ってみます。
まずは、
日本語ストーリー
       ↓
ローカルLLM
       ↓
12シーンのJSON
       ↓
AUTOMATIC1111 API
       ↓
12枚自動生成
までつなげる予定です。
画像生成に1時間程度かかっても、手作業ではなく放置できるなら、自分用のMVPとしては十分です。
実際に自分でショート動画を何本か作ってみて、
「これは自分が継続して使いたい」
と思えるかを確認してから、GPUマシンへの投資を考えようと思います。
おわりに
最初は、
GPUがないからStable Diffusionは無理だろう
と思っていました。
実際にやってみると、無理ではありませんでした。
ただし、
動くことと、実用になることは別
でした。
特に今回面白かったのは、GPU以前にメモリ不足でswapしまくるだけで生成速度が大きく変わったことです。
低スペック環境だからこそ、Stable DiffusionがどこでCPU・RAM・ストレージを使っているのかを体感できました。
次はこの環境をAPIとして使い、ストーリーから12枚の画像を自動生成するところまで作ってみます。