
はじめに
個人情報や機密情報は、クラウドの Claude Code や Codex には投入できません。そのため、ハーネスと LLM をローカルで動かしたいという需要が増えてきています。加えて、クラウドの AI はトークン課金が膨らみがちです。当ラボでは、ローカル AI でどこまでできるのかを検証しています。ハーネスには OpenCode を使っています。組み合わせるローカル LLM は、前に書いた「ハーネス(OpenCode)+ローカル LLM 7 モデル比較で Qwen3.8-Flash-Next が満点!」の比較で、現時点では Qwen3.8-Flash-Next が最強だと分かっています。この記事では、OpenCode と LLM を組み合わせて動く仕組み全体を「エージェントAI」と呼びます。
前回、DGX Spark で Flash-Next を安定して動かせたので、今回は GMKtec の EVO-X2(Ryzen AI Max+ 395(Strix Halo)、メモリ 128GB)で、AMD の GPU と Vulkan で動かしてみました。
結果は、動きました。ただし、エージェントAIとして本格的に使おうとコンテクスト長を大きくすると、不安定でした。
この記事の前半では、AMD の Vulkan で Flash-Next を動かすコツをまとめます。
- VRAM 96GB・システム RAM 30GB の配分でも、モデルの一部(PLE)を SSD 側に置けば動きます。ただし llama.cpp の既定の設定のままでは RAM が足りずに落ちるので、読み込み方式の指定が欠かせません
- バックエンドは Vulkan、量子化は日本語の品質で選びました。日本語の品質は DGX Spark と見劣りしません
- 1 件ずつ処理するときの出力速度は約 20 tok/s で、DGX Spark(約 27 tok/s)の約 4 分の 3 です。短い〜中程度のコンテクストで 1 人で会話する用途なら、十分な速さです
後半では、エージェントAIとして使うためにコンテクスト長を広げたところ、10 万トークン前後で EVO-X2 のシステムごとリセットされた経緯を書きます。現時点では「Ryzen AI Max+ 395 の環境では、Flash-Next の長いコンテクストは不安定」と判断し、Flash-Next のメインは DGX Spark に移しました。
構成
| 項目 | 内容 |
|---|---|
| 本体 | GMKtec EVO-X2(Ryzen AI Max+ 395、メモリ 128GB) |
| GPU | Radeon 8060S Graphics(Ryzen AI Max+ 395 の内蔵 GPU) |
| メモリの配分 | 128GB のうち、BIOS で VRAM に 96GB を割り当て。残りの 32GB がシステム RAM(OS から使えるのは約 30GB) |
| OS/カーネル | Ubuntu 26.04 LTS / Linux 7.0.0-38-generic x86_64 |
| 推論エンジン | llama.cpp 本家(build 11200)。フォークは使っていません |
| バックエンド | Vulkan |
| Vulkan ドライバ | Mesa 26.0.3 の RADV |
| シェーダコンパイラ(ビルド時) | glslc(shaderc 2026.1) |
| モデル | Qwen3.8-Flash-Next(unsloth の GGUF、UD-IQ4_XS) |
| 測定時期 | 2026 年 9 月 26〜28 日 |
llama.cpp(b11200)の Vulkan バックエンドは、GPU を次のように認識していました(llama-bench の起動ログより)。
ggml_vulkan: 0 = Radeon 8060S Graphics (RADV STRIX_HALO) (radv) | uma: 1 | fp16: 1 | bf16: 0 | fp4: 0 | warp size: 64 | shared memory: 65536 | int dot: 1 | matrix cores: KHR_coopmat
uma: 1 は CPU と GPU がメモリを共有していること、matrix cores: KHR_coopmat は行列演算の拡張機能が使えることを示しています。
Flash-Next は、総パラメータ 125B・1 トークンあたり 6B だけを使う MoE(エキスパートの混合)モデルです。これに加えて、PLE(Per-Layer Embedding)と呼ばれる 51B 規模の n-gram 埋め込み表を持っています。PLE は、入力トークンの並びに応じて表から数行を引いて使う仕組みで、1 トークンあたりに読む量はごくわずかです。そのため、GPU のメモリに載せなくても、SSD に置いて必要な行だけ読めば動きます。
UD-IQ4_XS の GGUF は約 94GB あり、その内訳は本体が約 66GB、PLE が約 29GB です。VRAM 96GB には本体だけを載せ、PLE は SSD 側に置く、というのが今回の構成の要です。
AMD の Vulkan で Flash-Next を動かすコツ
コツ 1:PLE を SSD 側に置く(--load-mode mmap)
既定の読み込み方式では、PLE が RAM に丸ごと載る
最初は、PLE を CPU 側に置く指定(-ot per_layer_token_embd=CPU)を付ければ、SSD からの読み出しになると考えていました。ところが実際には、PLE の約 23GB がシステム RAM に丸ごと確保され、30GB しかない RAM が尽きて、llama-server が強制終了されました。サーバのログには何も残らず、痕跡は dmesg の OOM の記録だけでした。
原因は、llama.cpp の読み込み方式の既定値です。--load-mode の既定値 auto は、Vulkan のデバイスがあると mmap(ファイルをメモリに対応づけて、必要な部分だけ読む仕組み)を使わず、テンソルの中身をメモリにコピーします。PLE も、SSD から必要な行を読むのではなく、全体が RAM にコピーされていました。-ot の指定の有無は関係ありませんでした。
直し方
mmap を明示的に指定します。-ot per_layer_token_embd=CPU は不要なので外しました(mmap と組み合わせると読み込みが極端に遅くなったという報告が llama.cpp 本家の GitHub にあります)。
--load-mode mmap --no-host --no-repack --fit off
正しく mmap されているかは、プロセスの /proc/<pid>/status で見分けられます。RssAnon はプロセスが確保したメモリ、RssFile はファイルに対応づけて実際に読み込んだ分です。
| 状態 | RssAnon | RssFile |
|---|---|---|
既定(auto) |
約 23GB | 約 80MB |
--load-mode mmap、読み込み直後 |
約 50MB | 約 30MB |
--load-mode mmap、リクエスト 5 件の後 |
約 410MB | 約 120MB |
mmap にすると、PLE は使った行の分だけ少しずつ SSD から読まれるようになり、RAM を丸ごと占有しなくなりました。読んだ分はページキャッシュに残りますが、メモリが足りなくなればカーネルが捨てて、あとで SSD から読み直せます。これで OOM は起きなくなりました。
残る制約:ディスクの読み出しが多い
mmap にしても、速度の測定 1 回(約 36 分)で SSD から 64〜80GB を読んでいました。PLE が 30GB の RAM のページキャッシュに収まりきらないうえ、llama.cpp がファイル全体に「順番に読む」という指定を掛けているため、必要以上に先読みしているとみられます。PLE だけをランダムアクセス向けに扱う仕組み(--lazy-mode)もありますが、試したところ読み込みが終わらず、逆効果でした。今の llama.cpp 本家では避けられない制約と考えています。読み出しなので SSD の寿命への影響は小さいです。
コツ 2:バックエンドは Vulkan を使う
ROCm(HIP)のビルドも試しましたが、--load-mode mmap を指定すると、ディスクから 114GB を読んでもモデルの読み込みが終わりませんでした。llama.cpp 本家の GitHub にも、Flash-Next が HIP では読み込み中に固まり、Vulkan では読み込めるという報告(#29149)があり、同じ現象とみられます。Vulkan では問題なく動いたので、Vulkan に一本化しました。
コツ 3:量子化は日本語の品質で選ぶ
unsloth の GGUF のうち、VRAM に本体が収まる UD-IQ4_XS(本体約 66GB)と UD-Q3_K_XL(本体約 61GB)を、日本語の知識を問うベンチマーク JamC-QA(300 問のサブセット)で比べました。
| 量子化 | 本体のサイズ | JamC-QA(300 問) |
|---|---|---|
| UD-IQ4_XS | 約 66GB | 66.67% |
| UD-Q3_K_XL | 約 61GB | 62.67% |
Q3_K_XL の利点は本体が約 4GB 小さいことだけなので、IQ4_XS を採用しました。PLE の大きさは両者で同じ(約 29GB)です。
参考までに、DGX Spark(SGLang、NVFP4)で全 2,309 問を測ったときは 64.57% でした。問題数も量子化も違うので単純には比べられませんが、EVO-X2 の構成でも日本語の品質は見劣りしないと見ています。
コツ 4:プロンプトキャッシュを有効にする
ベンチマークでは公平に比べるためにプロンプトキャッシュを切りますが、普段使う設定にそのまま持ち込むと、会話のたびに全文を読み直すことになります。EVO-X2 は prefill が遅いので、キャッシュの有無の影響が特に大きく出ます。普段使う起動設定には --no-cache-prompt などを入れないようにしました。
コツ 5:-c は並列数で割られる
llama.cpp の -c(コンテクスト長)は全スロットの合計で、-np(並列数)で割った値が 1 スロットの上限になります。当初 -c 32768 -np 4 としていたため、1 スロットあたり 8K しかありませんでした。起動ログの n_ctx_slot で確かめられます。
Flash-Next は KV キャッシュを持つ層が 48 層中 12 層だけなので、コンテクストを長くしてもメモリの増え方は小さいです。-c 131072 -np 4(1 スロット 32K)にしても、VRAM の増加は約 3GB でした。
起動の引数(主なもの)
短い〜中程度のコンテクストで使っていたときの構成です。
llama-server -m Qwen3.8-Flash-Next-UD-IQ4_XS.gguf \
  -ngl 99 -fa on -c 131072 -np 4 --jinja \
  --load-mode mmap --no-host --no-repack --fit off
これで VRAM の使用量は約 70GB です。
DGX Spark との速度の比較
比べる DGX Spark 側は、SGLang と NVFP4 の構成です。どちらも投機デコード(MTP)は使っていません。ランタイムも量子化も違うので、「同じモデルを、それぞれの機械で動かしやすい構成で動かしたときの差」として見てください。
同時リクエスト数ごとの出力速度
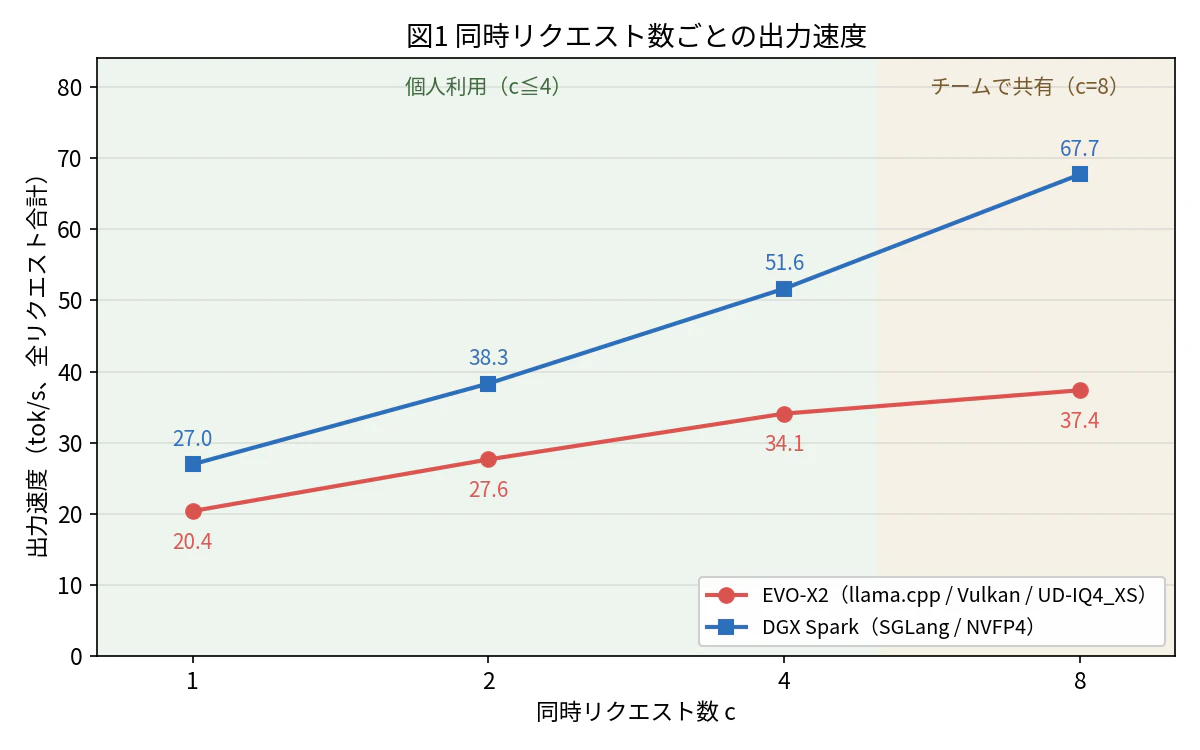
同時リクエスト数 c は、同時に何件の会話を処理しているかです。c≦4 は個人や少人数での利用、c=8 はチームでの共有を想定しています。
| c | EVO-X2 | DGX Spark | EVO-X2 / DGX Spark | 応答開始までの時間の中央値(EVO-X2 / DGX Spark) |
|---|---|---|---|---|
| 1 | 20.4 tok/s | 27.0 tok/s | 76% | 1.8 秒 / 0.22 秒 |
| 2 | 27.6 tok/s | 38.3 tok/s | 72% | 2.0 秒 / 0.40 秒 |
| 4 | 34.1 tok/s | 51.6 tok/s | 66% | 2.2 秒 / 0.45 秒 |
| 8 | 37.4 tok/s | 67.7 tok/s | 55% | 2.6 秒 / 0.53 秒 |
ShareGPT の 200 プロンプトを使い、プロンプトキャッシュは無効にして測っています。c=1 は両機種とも 3 回の中央値(EVO-X2 の 3 回の振れ幅は 0.8%)、それ以外は 1 回の測定です。
1 件ずつ処理するときの出力速度は、EVO-X2 が DGX Spark の約 4 分の 3 です。20 tok/s は、日本語ならおおよそ 1 秒に 20〜30 文字が出てくる速さで、人が読む速さよりは速く、1 人で会話する分には不満のない速さです。一方、同時に処理する件数が増えると DGX Spark のほうが大きく伸び、c=8 では EVO-X2 の約 1.8 倍になります。応答が出始めるまでの時間も、DGX Spark が一貫して短くなっています。
また、EVO-X2 ではコンテクストが長くなっても出力速度はあまり落ちませんでした(コンテクスト 0 で 25.2 tok/s、32K で 21.4 tok/s)。
長いプロンプトでの応答開始までの時間
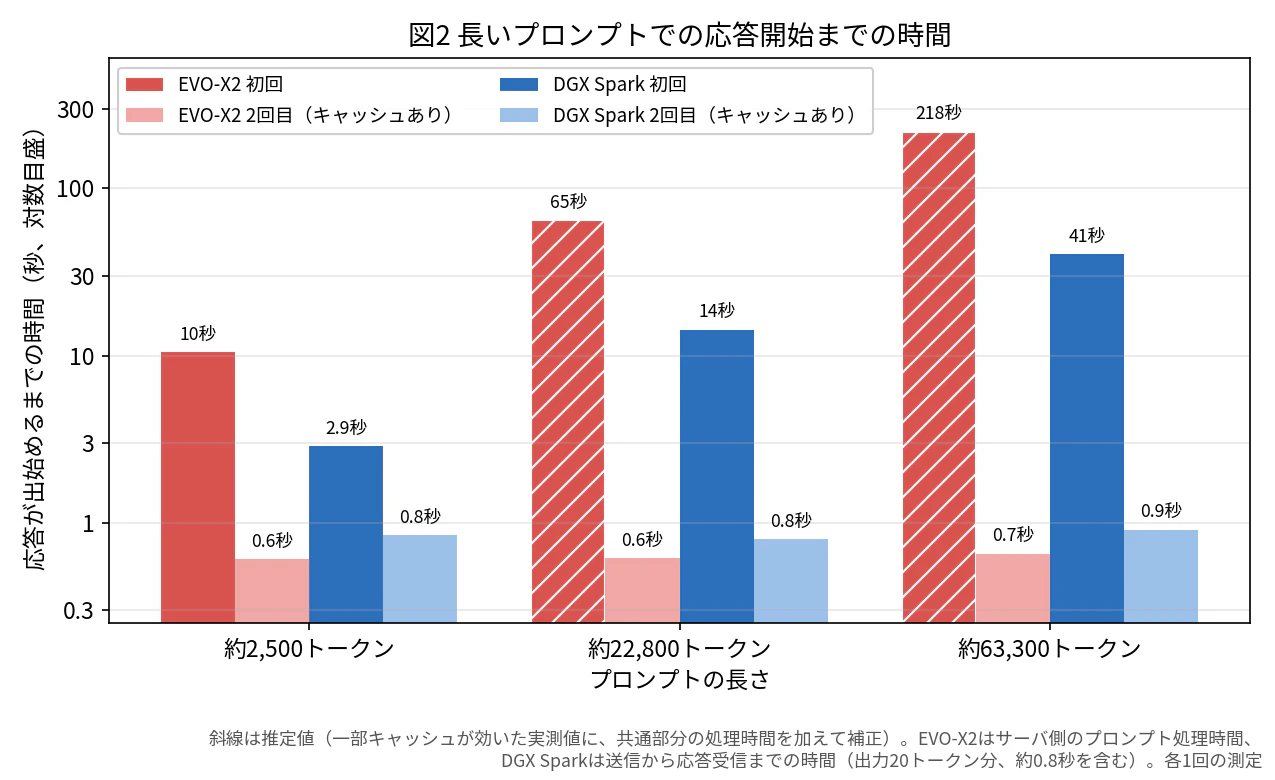
長い文書を貼り付けて質問する場面を想定し、約 2,500・22,800・63,300 トークンのプロンプトで、初回と、同じプロンプトを 2 回目に送ったとき(プロンプトキャッシュが効く)の時間を測りました。両機種で同じプロンプトを使っています。
| プロンプトの長さ | EVO-X2 初回 | DGX Spark 初回 | EVO-X2 2 回目 | DGX Spark 2 回目 |
|---|---|---|---|---|
| 約 2,500 トークン | 10 秒 | 2.9 秒 | 0.6 秒 | 0.8 秒 |
| 約 22,800 トークン | 約 65 秒(推定) | 14 秒 | 0.6 秒 | 0.8 秒 |
| 約 63,300 トークン | 約 218 秒(推定) | 41 秒 | 0.7 秒 | 0.9 秒 |
測り方には次の違いがあります。
- EVO-X2 は llama.cpp が返すサーバ側のプロンプト処理時間、DGX Spark は SGLang に同じ値がないため、リクエストを送ってから応答を受け取るまでの時間です。DGX Spark の値には、20 トークン分の出力時間(約 0.8 秒)が含まれています。初回、特に長いプロンプトではこの差はほとんど影響しませんが、2 回目の値は細かくは比べられません
- EVO-X2 の 22,800 と 63,300 トークンの初回は、直前の測定と先頭が共通だったため、一部にキャッシュが効いていました。実測値に共通部分の処理時間を加えた推定値を載せています
- どちらも各規模 1 回の測定です
プロンプトを読み込む速さ(prefill)は、DGX Spark が約 900〜1,600 tok/s、EVO-X2 が約 240〜370 tok/s で、DGX Spark が 4〜5 倍速いです。EVO-X2 で数万トークンの文書を初めて貼ると、応答が始まるまで数分待ちます。ただし、同じ文書で会話を続ければ、2 回目以降はどちらの機種も 1 秒前後で応答が始まります。
エージェントAIでは、ハーネスが会話の履歴やファイルの中身を毎回プロンプトに詰めて送るので、この prefill の速さが体感に直結します。
エージェントAIとして本格的に使おうとすると不安定
ここまでのコツで、Flash-Next は EVO-X2 で動くようになりました。ところが、OpenCode と組み合わせてエージェントAIとして使おうとすると、1 スロット 32K のコンテクスト長では、ちょっとしたタスクでもすぐに使い切ってしまいました。会話の自動要約(compaction)が頻繁に走り、いつまで経ってもタスクが終わらないのです。普段使っている Claude Code や Codex ではめったに出くわさない状況で、コンテクスト長の大切さが身に沁みました。
そこで、コンテクスト長を 128K、256K と広げていきました。最終的には -kvu(KV キャッシュを全スロットで共有する指定)を付け、1 スロットで最大 262,144 トークン(256K)まで使える設定にしました。KV キャッシュが小さいモデルなので、VRAM は約 76GB に収まりました。
しかし、この構成で 10 万トークン前後のコンテクストで生成させていたところ、EVO-X2 のシステムがリセットされる現象が 2 回起きました。
| 回 | 状況 | 結果 |
|---|---|---|
| 1 回目 | 約 104K トークンのコンテクストで生成中 | 応答がなくなり、電源の入れ直しが必要だった |
| 2 回目 | 約 88K トークンのコンテクストで生成中 | 自動で再起動した |
どちらも GPU の使用率が 95% 前後の状態でした。2 回目の記録は「internal CPU shutdown event」だけで、llama.cpp やカーネルのログには何も残っていませんでした。直前の VRAM の使用率は 72% で一定で、VRAM が尽きたわけではありません。温度・電力・メモリにも、記録の範囲では異常は見当たりませんでした。
原因はまだ特定できていません。長いコンテクストでの GPU の処理(ソフトウェア側)と、電源やファームウェア(ハードウェア側)の両方の可能性を考えています。現在は、1 秒おきに GPU の状態を記録する仕組みなどを入れて、次に起きたときに原因を絞り込めるようにしています。
一方、DGX Spark では SGLang で最大 384K トークンのコンテクストで動かし、OpenCode からは 256K で使っていますが、安定して動いています。指示を投入したときの反応も、DGX Spark のほうが軽快です。
そこで、現時点では、Ryzen AI Max+ 395 の環境では Flash-Next の長いコンテクストは不安定と判断し、Flash-Next のメインは DGX Spark に移しました。
まとめ
動かすコツ
- PLE を SSD 側に置けば、VRAM 96GB・システム RAM 30GB の EVO-X2 でも Qwen3.8-Flash-Next は動きます。llama.cpp の既定の読み込み方式のままだと PLE が RAM に載って落ちるので、
--load-mode mmapの指定が欠かせません - バックエンドは Vulkan、量子化は日本語の品質で UD-IQ4_XS を選びました
- 普段使う設定ではプロンプトキャッシュを有効にし、
-cが並列数で割られることに注意します
速度
- 1 件ずつ処理するときの出力速度は DGX Spark の約 4 分の 3(約 20 tok/s)で、短い〜中程度のコンテクストで 1 人で会話する用途には十分です
- 複数のリクエストを同時に処理する場面と、長い文書を初めて読み込ませる場面では、DGX Spark が大きく上回ります
エージェントAIとしての本格的な利用
- OpenCode と組み合わせるエージェントAIの用途では、長いコンテクストが欠かせません。しかし EVO-X2 では、10 万トークン前後でシステムがリセットされる現象が起き、原因を調査中です。現時点では、Flash-Next のメインは DGX Spark に移しています
短い〜中程度のコンテクストの会話なら EVO-X2 でも実用になります。長いコンテクストが必要なエージェントAIの用途は DGX Spark、という使い分けが、今のところ現実的だと考えています。
おわりに — 当ラボについて
筆者は NPO法人 IoTメディアラボラトリーで、IoT 研究とあわせて AI 分野の検証を担当しています。東京大学・本郷キャンパス 大学院工学系研究科のラボで行っていた IoT 研究が独立し、研究機関として活動を続けている組織です。
やっていることは、本記事のようなローカル LLM の実機検証が中心です。新しいモデルが出るたびに手元のハードで動かし、速度・日本語知識・コーディング・マルチモーダルの 4 軸で測り、動かなければ原因を突き止めるところまでやります。ベンダーの公称値ではなく、実際に自分の機械で何が起きるかを知りたいからです。
そのぶん、計算資源はいくらあっても足りません。もっと GPU が欲しい(笑)。機材の提供、検証のご依頼、共同研究など、お声がけいただけると喜びます。