
次世代Qwen4のアーキテクチャの先行公開版といわれる Qwen3.8-Flash-Next を DGX Spark で試してみました。128GBに載る量子化モデルとレシピが公開されているのに、そのままでは動かず少し苦労したので、当ラボで検証した中で最速の構成をレシピとして公開します!
1. 128GB のメモリに載らないはずのモデルが動く
Qwen3.8-Flash-Next の総パラメータは 125B、さらに PLE と呼ばれる埋め込みテーブルが 51B 分付いて 合計 176B 相当である。DGX Spark のメモリは 128GB(実際に使えるのは 121.63GiB)で、当ラボがこれまで単機で動かしてきたモデルは 120B 級が上限だった。量子化して無理やり詰め込んだ、という話ではなく、一部をSSDに置くことで大きなモデルを動かす、という設計がされている。
当ラボがこのモデルに注目した理由は 2 つある。
- 載らないはずのサイズが載る。 当ラボの従来の検証構成では、128GB 単機で動かせるのは 120B 級までだった。その枠を超える
- KV キャッシュの増加を抑えられる。 48 層のうち 36 層が線形アテンションで、KV を持つのは残る 12 層だけ。128K トークンのコンテクストでも 3.04GB に収まった
この 2 つは別々の工夫から来ている。順に説明する。
KV キャッシュは、読ませた文章の内容をモデルが保持しておくための作業領域。コンテクストが長くなるほど比例して膨らみ、メモリを圧迫する。
1-1. 「Flash-Next」とは何か
正式名称は Qwen3.8-Flash-Next 125B-A6B 、Qwen3.8 シリーズの一員という顔をしているが、実態は次の世代(Qwen4)のアーキテクチャの先行公開である。Qwen 公式のモデルカードにもそう明記されており、NVIDIA の Jetson AI Lab も「Qwen4 アーキテクチャの早期プレビュー」と紹介している。以下、本記事では Flash-Next と呼ぶ。
| 要素 | 内容 |
|---|---|
| 公式の呼称 | Qwen3.8-Flash-Next 125B-A6B(総パラメータ 125B、毎トークン使うのは 6B) |
| PLE(n-gram 埋め込みテーブル) | 別途 51B |
| MTP ヘッド | 別途 4B(投機デコード用。本記事の本番構成では使わない) |
| 層数 | 48層。うち 36層が Gated DeltaNet(線形アテンション)、12層が Qwen Sparse Attention |
| コンテクスト長 | 262,144(YaRN で 1M まで拡張可) |
| 入力 | テキスト・画像・動画 |
公式が使っているのは「125B-A6B」という呼び方で、PLE を足した 176B という表記は使っていない。公式カードの記載は「125B(うち 6B が稼働)、加えて 51B の n-gram 埋め込みと 4B の MTP」で、チェックポイント全体では 180B になる。本記事でも規模を言うときは 「125B-A6B + PLE 51B」 と書く。ただし「128GB に載るか」を論じるときは合計サイズが問題になるので、そこでは 176B 相当という言い方をする。MTP は本記事の本番構成(§5-4)では読み込まないため、この合計に含めていない。
1-2. 利点その1 — 巨大なモデルの一部を SSD に置ける
PLE は、辞書に似ている
PLE(n-gram embedding)は 16 個の参照表からなる。それぞれが約 2,000 万行 × 160 次元で、トークンの並びに応じて、各表から 1 行ずつ、計 16 行を引いてくる(各表の行数は 2,000 万強の素数に設定されており、ハッシュの衝突を減らす工夫と見られる)。
サイズは圧倒的だ。16 表 × 約 2,000 万行 × 160 次元で、合計 51B パラメータ。BF16 なら 102.4GB、FP8 に落としても 47.7GiB。モデル全体の半分近くを占める。ところが 1 トークンが読むのは 16 行だけ。FP8 なら 1 行 160 バイトなので、160 バイト × 16 = 2.5KB である。
辞書を思い浮かべてほしい。分厚い国語辞典でも、1 つの言葉を調べるときに開くのは 1 ページだけで、残りの数千ページには触れない。PLE はこれと同じ使われ方をする。一方、モデルの通常の重み — アテンションの射影行列やエキスパートの行列 — はそうではない。こちらは辞書の全ページに目を通してから答えを出すような使い方をする。入力と重みの全体を掛け合わせることが計算そのものだからだ。だから重みのサイズがそのまま生成速度を決める。GB10 のメモリ帯域 273GB/s が天井になる、というのは当ラボの記事で繰り返し書いてきたとおりである。同じ「パラメータ」でも、読まれ方がまったく違う。 ここが出発点になる。
だから SSD に置ける
あとは素直な帰結になる。めったに読まれず、読むときも一部しか読まないなら、メモリに常駐させる必要はない。 Flash-Next はこの PLE テーブルを NVMe 上のファイルに置き、必要な 16 行だけをそのつど読む。メモリに置くのは本体の 81GB だけで済み、121.63GiB の枠に収まる。
しかもこれは有志が見つけた裏技ではない。Qwen 自身の技術報告に、この使い方が書かれている。 埋め込みテーブルはアクセスが疎で、しかも読む場所が事前に決まっているので、アクセラレータの外のストレージに置ける、と。
さらに PLE を使うのは 48 層のうち 2 層目の 1 か所だけで、1 層目の計算をしている間に先読みが重なるよう設計されている。ディスクからの読み出し待ちが、計算時間の陰に隠れる。
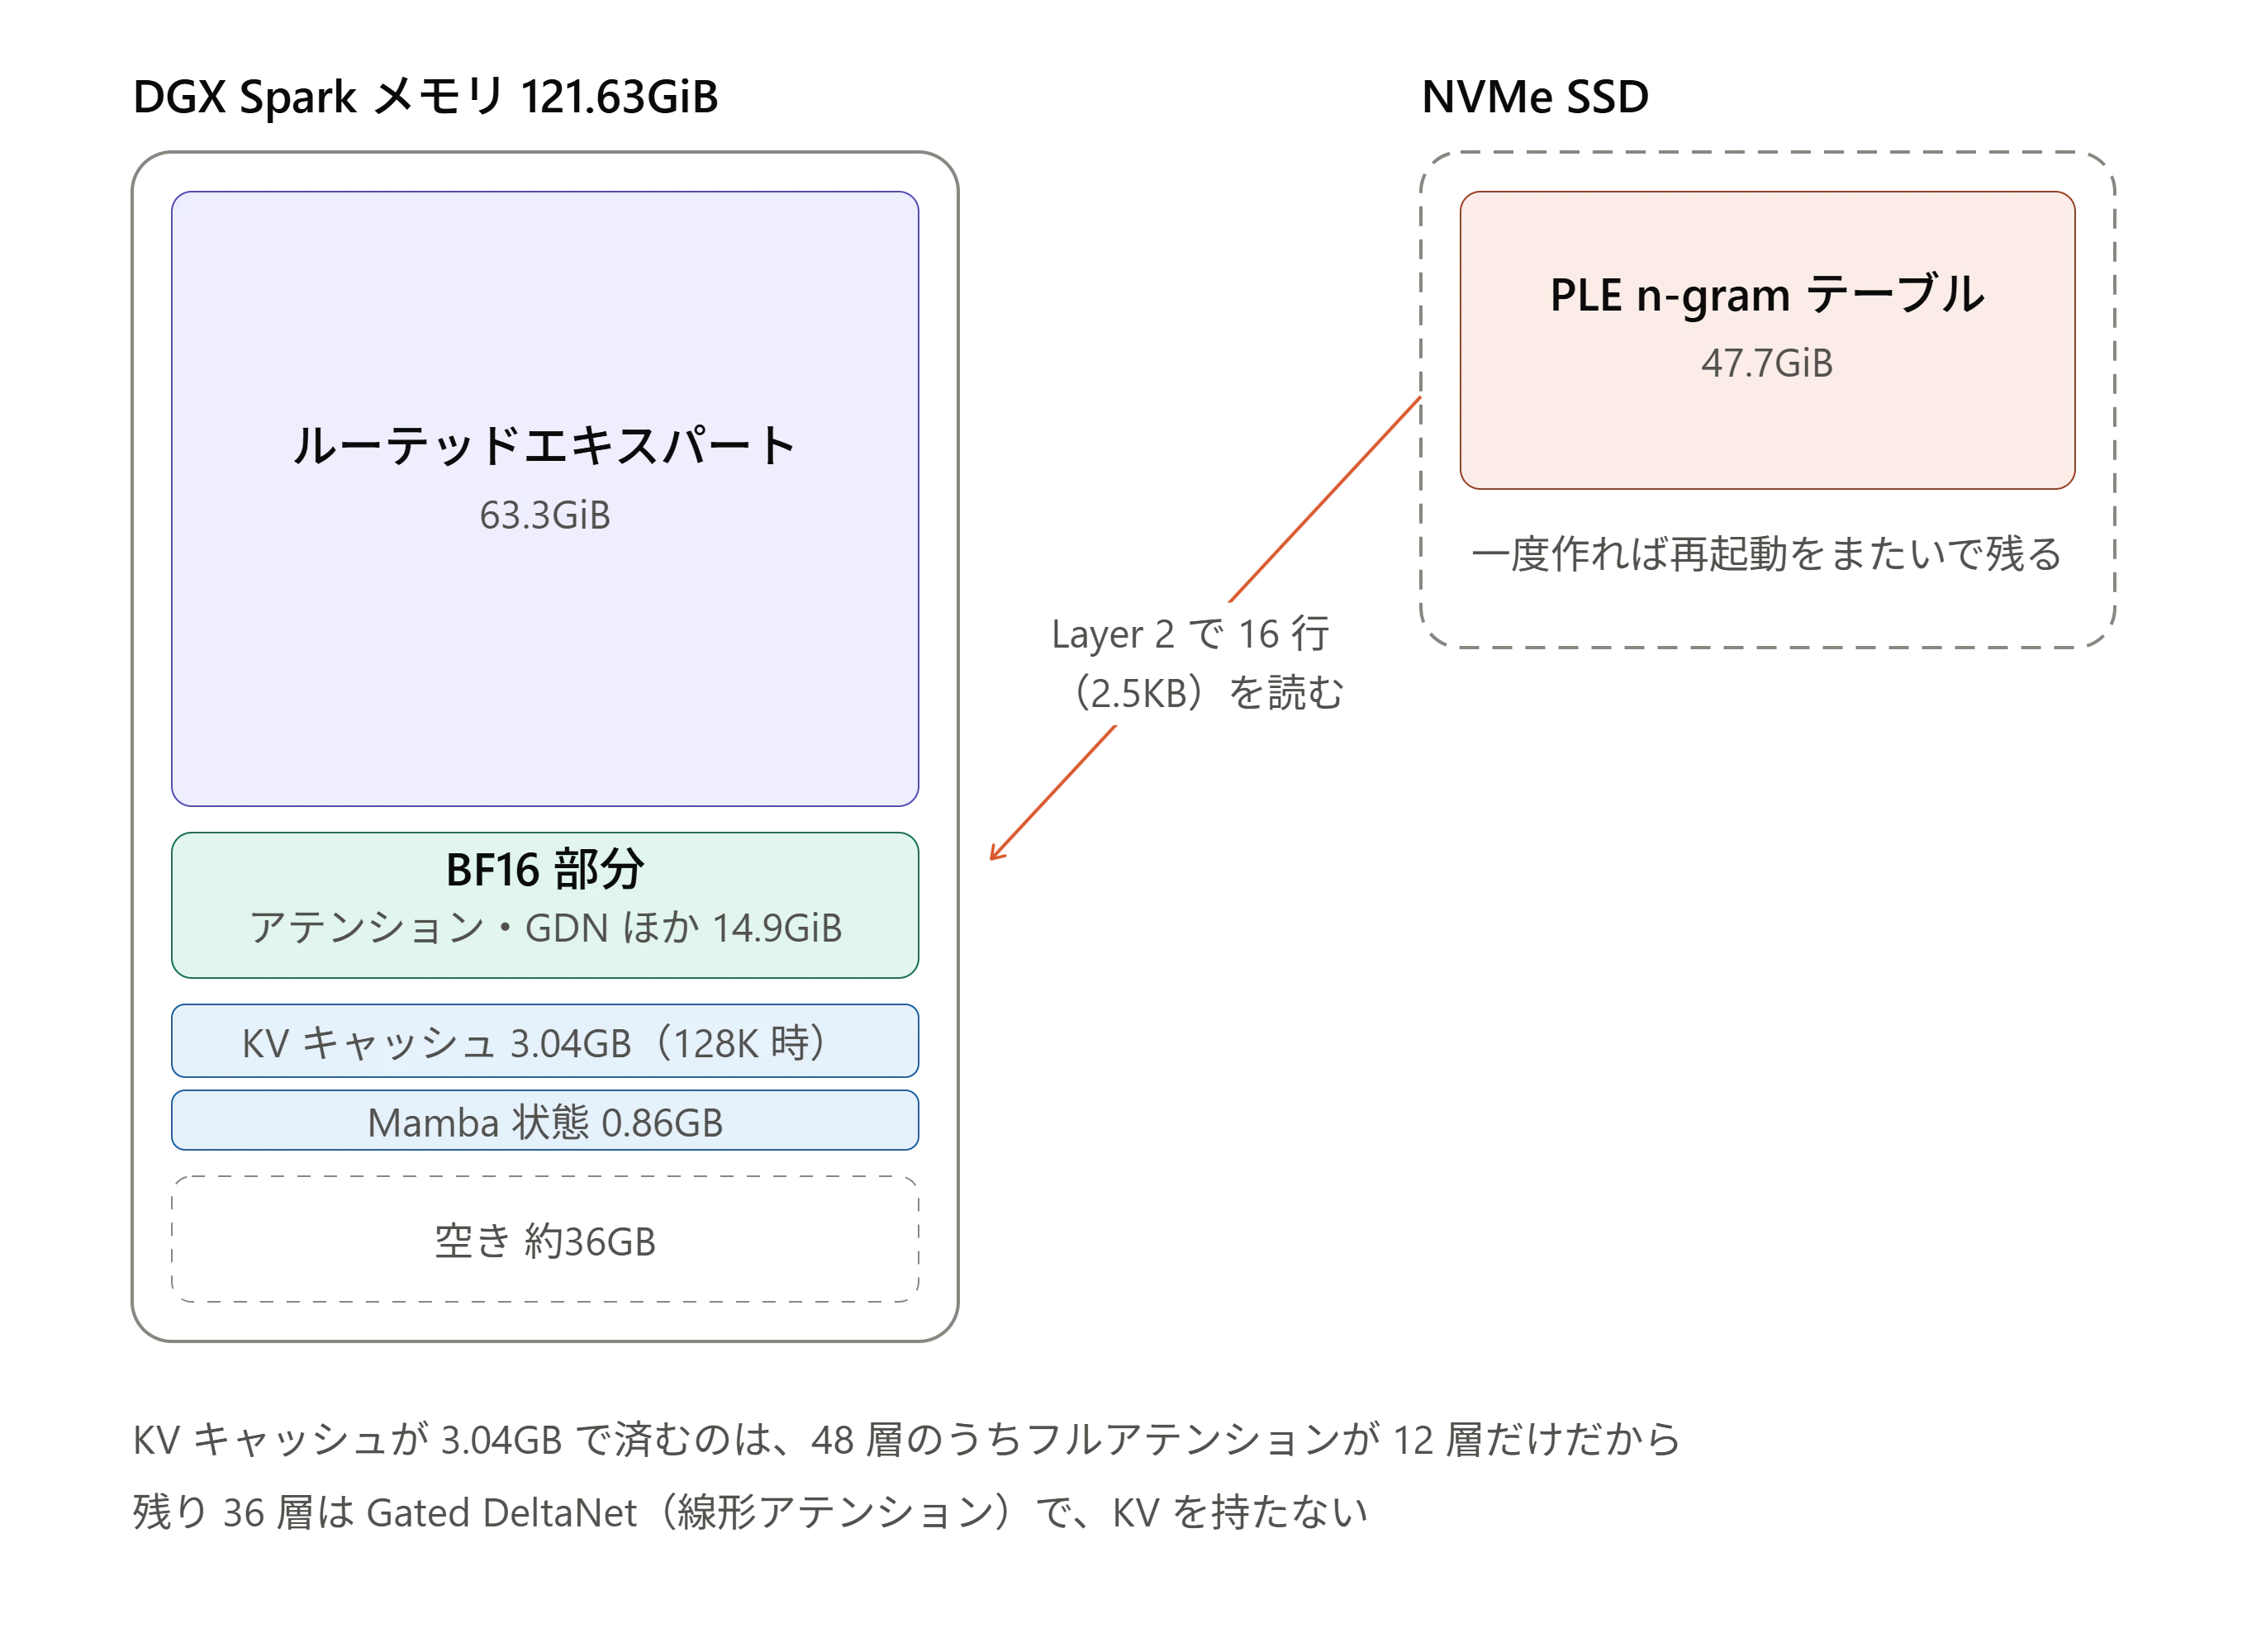
この SSD 上のファイル(バッキングファイル)は一度作れば再起動をまたいで残り、起動は毎回 7 分程度で済む。ただし何もしないと 2 回目以降が 53 分に化ける落とし穴がある。詳細は §2-8 と §6-4 で述べる。
では、何でも SSD に追い出せるのか
答えは「ノー」。仮にエキスパートの重みを SSD に置いたらどうなるか。エキスパートは毎トークン使う部分なので、生成のたびにギガバイト単位の読み出しが発生する。NVMe が 1〜5GB/s 出るとしても、1 トークンごとに数百ミリ秒の待ちが入る計算になり、実用にならない。
SSD へ追い出せるのは、「巨大だが、読む量がごく少ない部品」だけである。Flash-Next の場合、設計の段階でそういう部品(PLE)が切り出してあった。
これまでのローカル LLM は、できあがったモデルをどう手元の機械に詰め込むかという工夫だった。量子化がその代表である。Flash-Next は逆で、最初から一部をメモリの外に置く前提で作られている。 mmap でファイルを読む技術自体は昔からあるもので、新しいのはモデルの設計のほうだ。
これまでのモデルとの容量比較
当ラボで測ってきたモデルと並べる。
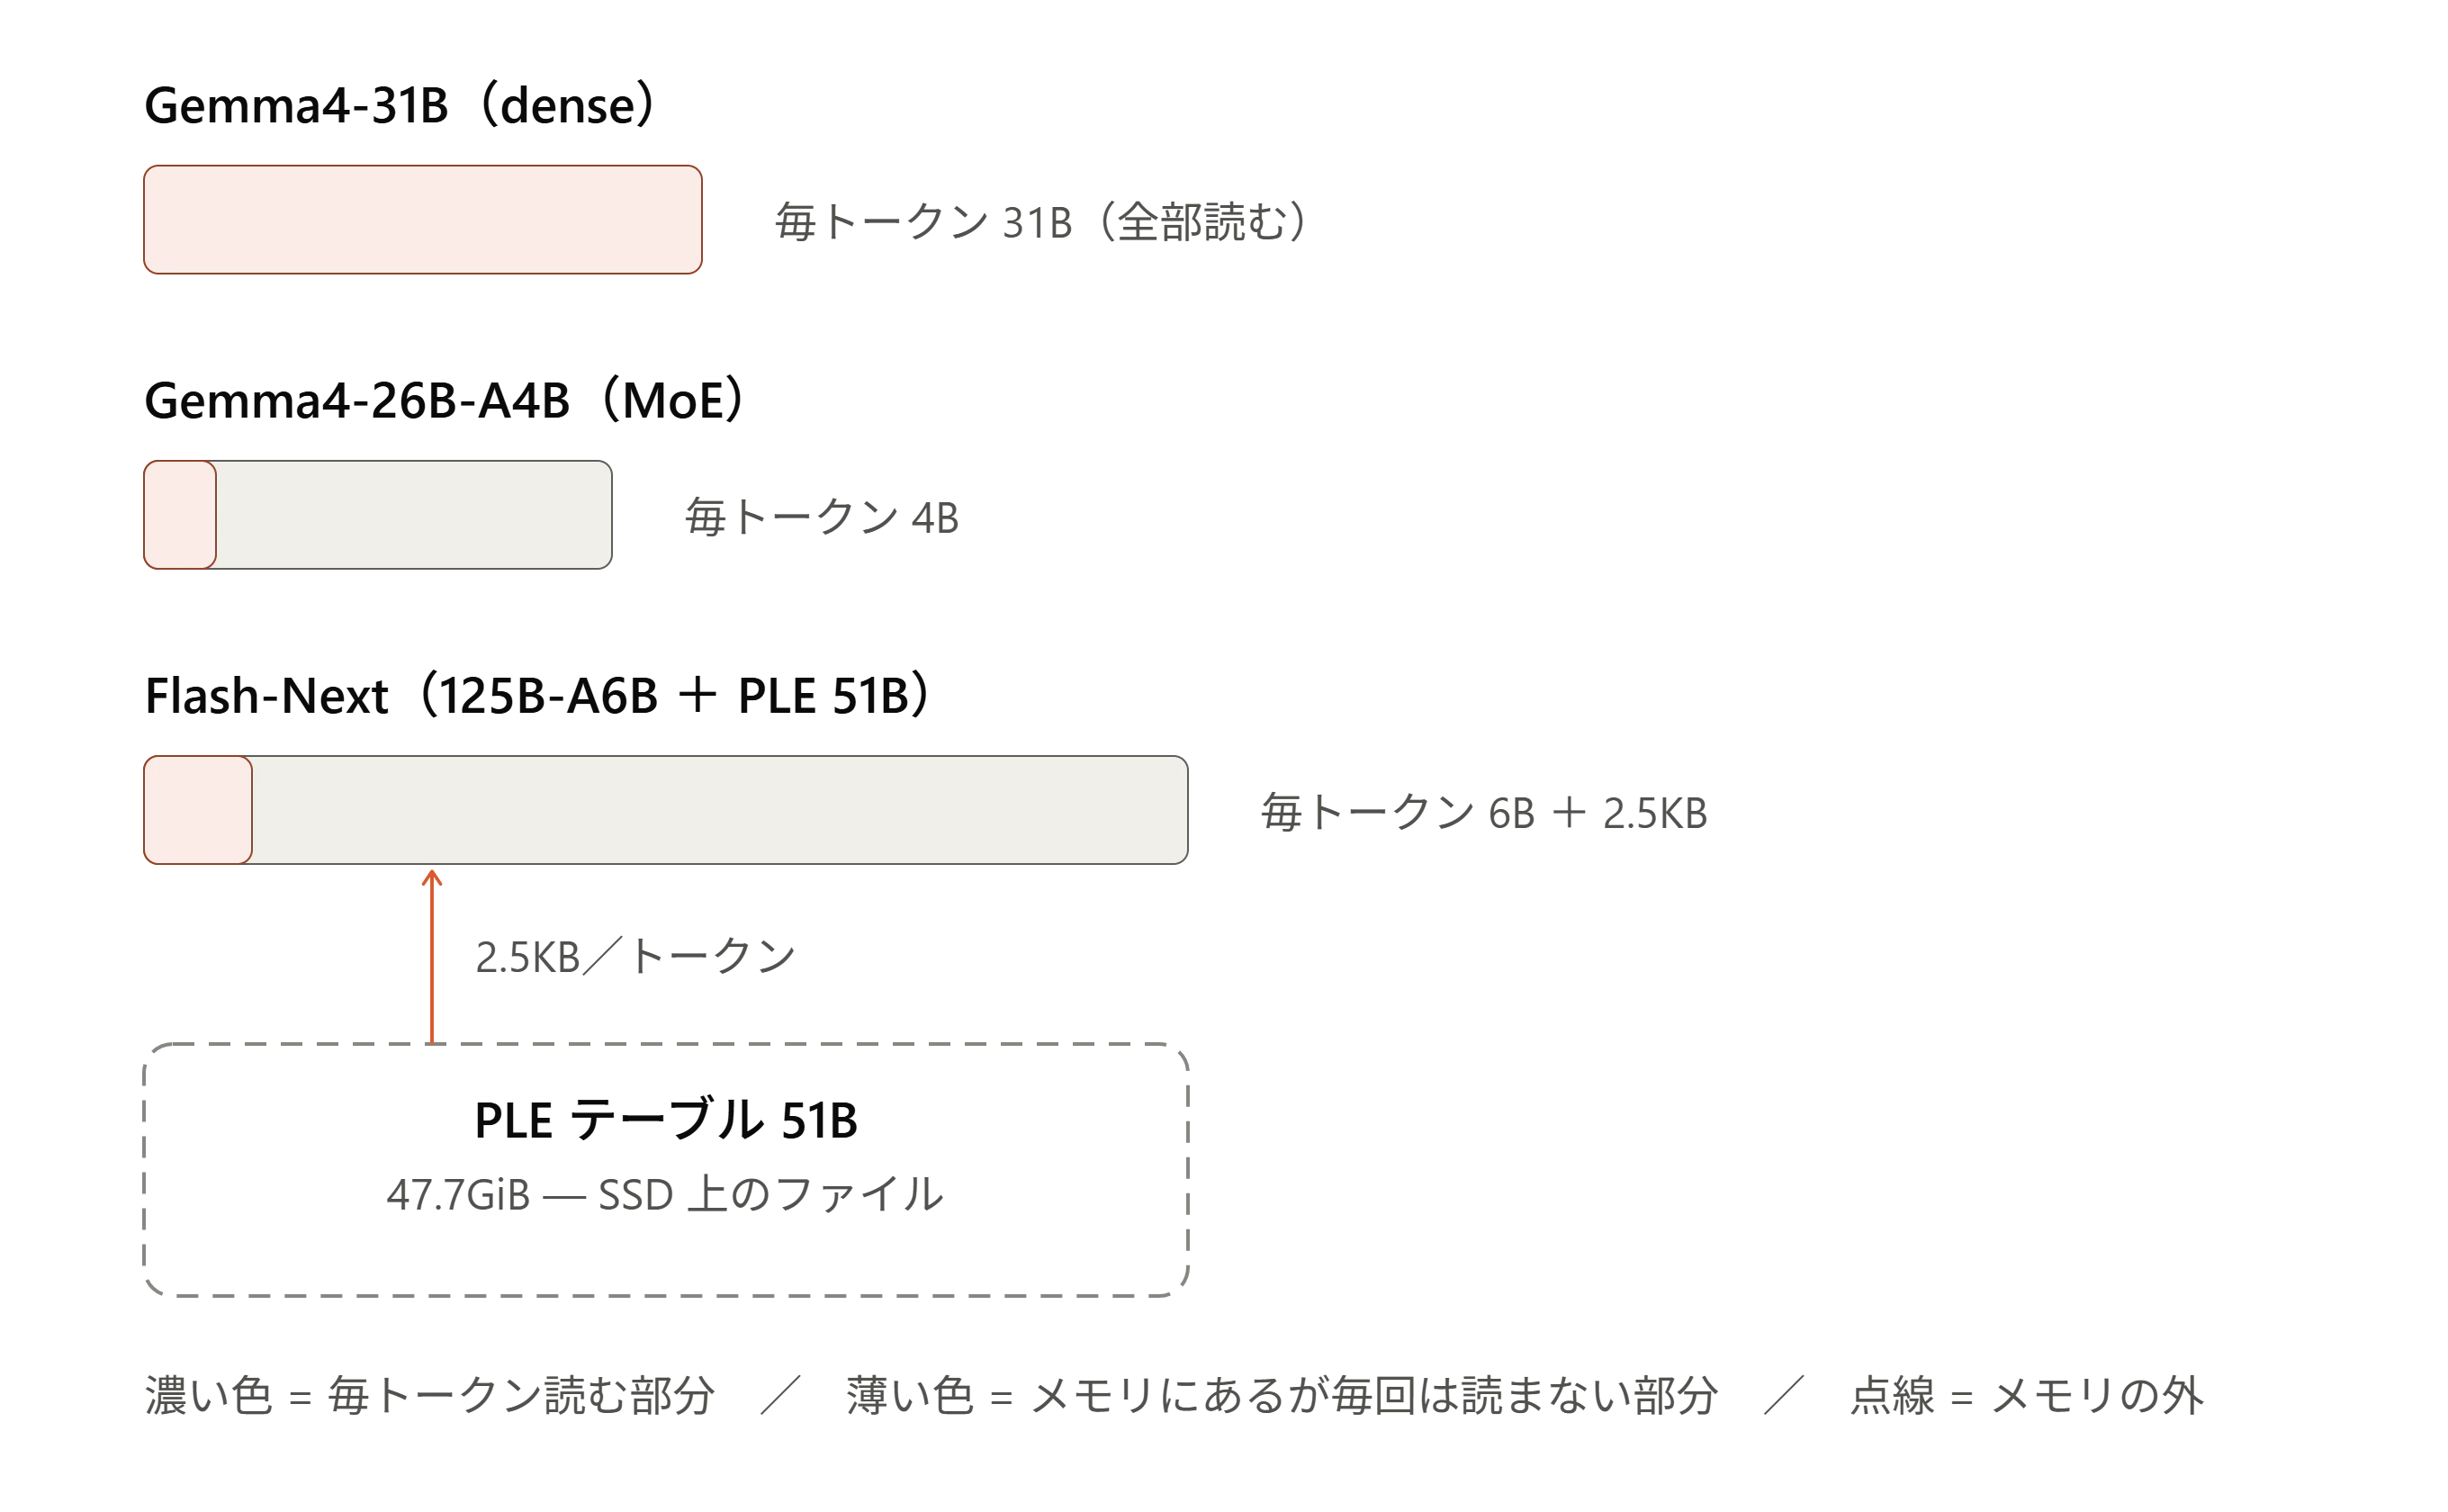
| モデル | 総パラメータ | 毎トークン使う量 | メモリに載る量 | SSD |
|---|---|---|---|---|
| Gemma4-31B | 30.70B | 30.70B(dense) | 17.39 GiB | — |
| Qwen3.8-27B | 28B | 28B(dense hybrid) | 17.67 GB | — |
| Gemma4-26B-A4B | 26B | 4B(MoE) | 15.78 GiB | — |
| Qwen3.6-35B-A3B | 34.66B | 3B(MoE) | 20.21 GiB ※ | — |
| Flash-Next | 125B-A6B + PLE 51B | 6B + 2.5KB | 81GB | 47.7GiB |
※ 量子化形式は Flash-Next 以外の 4 モデルについての記載。Qwen3.6-35B-A3B のみ MXFP4_MOE、他の 3 モデルは Q4_K_M。Flash-Next は §2 の senfu 版(NVFP4 を中心とした混合構成)。
最下段の 2 列に注目してほしい。176B 相当という規模に対して、毎トークン実際に使うのは 6B しかない。 しかも本体 81GB はメモリに載り、残る 47.7GiB は SSD にいる。
1-3. 利点その2 — KV キャッシュの増加を抑えられる
128GB 機にとって効くもうひとつの性質が、コンテクストの扱いである。48 層のうち KV キャッシュを保持するのは Qwen Sparse Attention(QSA)の 12 層だけで、残り 36 層は Gated DeltaNet(線形アテンション)が担当し KV キャッシュを持たない。そのため、コンテクストを伸ばしてもキャッシュの増え方が緩やかである。実測では、128K トークンのコンテクストで KV キャッシュは 3.04GB に収まった。
これが効いてくるのはエージェント用途である。ログや資料をまとめて読ませる場面では数万トークンのコンテクストが当たり前になるが、通常の dense モデルだとここで KV キャッシュがメモリを大きく圧迫する。Flash-Next は本体 81GB を載せた残りで、128K のコンテクストを確保できた。
2. DGX Spark で Qwen3.8-Flash-Next を動かすレシピ
手順から知りたい人のために、当ラボが最終的に到達した構成をここにまとめる。詰まったときの対処は §6 にまとめた。
この構成で、起動は約 7 分、c=1 で 27 tok/s、128K のコンテクストが使える。
パッチの差分と適用手順は、英文の GitHub リポジトリで公開している。
https://github.com/nabe2030/flashnext-dgx-spark
2-1. 必要なもの
| 内容 | |
|---|---|
| ハード | DGX Spark(GB10、128GB unified、273GB/s) |
| ドライバ |
open カーネルモジュール(nvidia-driver-580-open 系)。proprietary では動かない(§6-1) |
| ディスク | チェックポイント 128.9GB + PLE のバッキングファイル 47.7GiB。200GB 程度の空きを見ておきたい |
| ランタイム | SGLang(本家 main からソースビルド) |
ドライバの種別が最初の関門になる。 modinfo nvidia | grep -i license で確認できる。Dual MIT/GPL なら open、NVIDIA なら proprietary である。後者だと、この先の手順は途中で illegal memory access に当たる。
2-2. チェックポイント
senfu/Qwen3.8-Flash-Next-NVFP4
revision: 5d37b3b3711d8406174b96ff950c0aa16324b266
128.9GB(実ファイルの合計。モデルカード記載の 131.4GB とは約 2% の差がある)、421 ファイル。RadixArk 版(SGLang 開発元が出しているもの)を土台に、dense 経路と LM head をさらに量子化した派生である。低並列で 63.5% 速い。選び方の詳細は §5 に書いた。
2-3. SGLang のビルド
commit: 4fb9b5b5bad41ac7de5586ec812c421fe3aa2b8b
公式の Docker イメージは使えなかった。Flash-Next に必要な修正が本家にマージされたのが 2026-09-05 で、当時の公開イメージは 09-04 ビルド。1 日足りなかった。
ソースからビルドする。venv 内に入れること。当ラボの環境では torch==2.13.0、flashinfer_python==0.6.18 である。
ビルド時の注意:
pip installがcargoを要求して失敗する場合がある。今回の用途では Rust 拡張は不要なので、SGLANG_BUILD_RUST_EXTS=noneで回避。
2-4. パッチ 1 本 — PLE バッキングファイルの再利用
現時点では、本家のコードに 1 か所手を入れている。
PLE テーブル(47.7GiB)は起動のたびに SSD 上のファイルへ書き出される。すでに中身が入ったファイルに上書きすると極端に遅くなり、2 回目以降の起動が 53 分になる。ファイルの内容を照合して、既に正しい内容が入っていれば書き込みをスキップするようにした(4KB 窓 × 32 サンプルで確認)。これで 2 回目以降も約 7 分を維持できる。
本家も「起動前に古いファイルを消すこと」と案内しているので、消して回る運用でも同じ効果が得られる。消し忘れが怖い人はパッチを当てるほうが安全だと思う。
当ラボは当初、PLE の行を取り出す処理を CPU 側に回すパッチも当てていた。GPU がファイル上のメモリを読めずに落ちていたためだが、これは proprietary ドライバが原因の問題への回避策で、open ドライバに戻したあとは不要だった(§6-1)。最初の起動成功の時点で、このパッチは既に外していた。
2-5. 環境変数
export SGLANG_QWEN4_PLE_FILE_SKIP_DEVICE_CHECK=1   # ATS の属性チェックを飛ばす(GB10 で必須)
export MAX_JOBS=2                                  # JIT の並列コンパイル数を抑える
export SGLANG_WARMUP_TIMEOUT=3600                  # 内蔵ウォームアップの 600 秒タイムアウトを延長
3 つとも、無いと起動しない。 それぞれ理由がある。
- 1 番目: SGLang は起動時に
cudaDevAttrPageableMemoryAccessUsesHostPageTablesという属性を見て、PLE を SSD に置けるかを判定する。GB10 ではこの属性が open ドライバでも false を返すため、判定で弾かれる。GB10 は ATS という別の経路で同じ機能を提供しており、実際には問題なく動くので、判定を飛ばす - 2 番目: 既定のままだと JIT コンパイラが何十本も並列で走り、ホストメモリを使い切ってサーバが無言で消える(§6-2)
- 3 番目: SGLang が起動の最後に自分自身へ投げるウォームアップのリクエストが、600 秒のハードコードでタイムアウトして自壊する(§6-3)
なお PLE の再利用に関する環境変数(SGLANG_QWEN4_PLE_REUSE など)は既定で有効なので、明示的な指定は要らない。
2-6. 起動コマンド
c=1(個人が対話で使う想定)の例。
python3 -m sglang.launch_server \
  --model-path ~/models/qwen38-flash-next-senfu \
  --host 0.0.0.0 --port 30000 \
  --quantization modelopt_fp4 \
  --ple-offload-embedding --ple-offload-backend file \
  --mem-fraction-static 0.85 \
  --context-length 32768 --max-total-tokens 32768 \
  --chunked-prefill-size 1024 \
  --max-running-requests 1 --max-mamba-cache-size 1 \
  --disable-radix-cache \
  --watchdog-timeout 3600 \
  --prefill-attention-backend triton --decode-attention-backend trtllm_mha \
  --reasoning-parser qwen3 --tool-call-parser qwen3_coder
要点を挙げる。
--quantization modelopt_fp4 — senfu のモデルカードでは modelopt_mixed が案内されているが、当ラボはこの指定で起動し、本記事の全測定をこの指定で行った。
--ple-offload-backend file — PLE を SSD に置く指定。ここが §1 で説明した仕組みである。pinned という選択肢もあるが、DGX Spark では使ってはいけない。ホストメモリに 47.7GiB を常駐させようとして枯渇し、OS ごと固まる(当ラボは 1 度やった)。GB10 はホストメモリと GPU メモリが同じ池なので、「ホストに逃がす」という発想が成立しない。
--max-mamba-cache-size — 並列数に合わせる。1 スロットあたり約 110MB。既定のままだと 99 スロット(約 10.5GB)確保しようとして、メモリを圧迫する。
--prefill-attention-backend と --decode-attention-backend を分けて指定 — --attention-backend でまとめて指定すると、prefill 側の判定で拒否される。
--reasoning-parser qwen3 と --tool-call-parser qwen3_coder — エージェント用途では必須である。起動ログは自動検出したと表示するが、明示しないと実際には適用されず、思考テキストが本文に混ざる。tools 付きの curl を投げて、reasoning_content と tool_calls が別フィールドで返ることを必ず確認してほしい。
MTP(投機デコード)は使わない — --speculative-algorithm 系のフラグは付けない。このチェックポイントでは MTP を有効にするとかえって 25.6% 遅くなる(§5-3)。
--disable-radix-cache — これは速度測定のための指定である。実際に使うときは外すこと。プレフィックスキャッシュが有効になり、エージェント用途では効果が見込める(§4)。
2-7. 用途に応じて変えるところ
上のコマンドは c=1 用である。並列数を上げるとき、長いコンテクストを使うときは以下を変える。--max-total-tokens はサーバ全体で確保する KV の総量なので、コンテクスト長 × 並列数を目安にする。
| 用途 | 主な変更 |
|---|---|
| 並列処理(c=8 など) | --max-running-requests 8 --max-mamba-cache-size 8 |
| 長文を 8 並列で(当ラボの Aider 測定の構成) | --context-length 49152 --max-total-tokens 393216 --max-running-requests 8 --max-mamba-cache-size 8 |
| 128K のコンテクスト(c=1) | --context-length 131072 --max-total-tokens 131072 |
当ラボの実測では、128K でも安定して動いた。KV キャッシュが 3.04GB で済むので、本体 81GB を載せた残りに十分収まる。
2-8. 起動にかかる時間
| ケース | 所要 |
|---|---|
| 初回(PLE ファイルが無い状態) | 7.8 分 |
| 2 回目以降(パッチ適用済み) | 7.1 分 |
| 2 回目以降(パッチなし、古いファイルを消さない場合) | 約 53 分 |
初回と 2 回目の差は 44 秒しかない。時間の大半は、モデル全体(128.9GB)の読み込みそのものである。PLE の書き出しは思ったほど重くない。
公開されているレシピの多くは「初回は約 1 時間」と書いているが、それは 3 行目のケース(同じファイルに書き直し続けている状態)を初回だと誤認しているのではないかと思う。当ラボも最初の 2 日間、そう思い込んでいた。
3. ベンチマーク計測
当ラボはモデルを評価するとき、4 つの軸で測ることにしている。①速度、②日本語知識、③コーディング、④マルチモーダルである。
①②④を先に公開し、③コーディング(Aider Polyglot 225 題)は測定に数十時間かかったため、完走後に追記した(3-5)。
以下、特記のない限り senfu 版・MTP なしの値である(§3-3 の RadixArk 版との比較、§3-4 の MTP の比較は例外。チェックポイントの選び方は §5)。
3-1. ①速度 — 対話では圧勝、高並列では逆転される
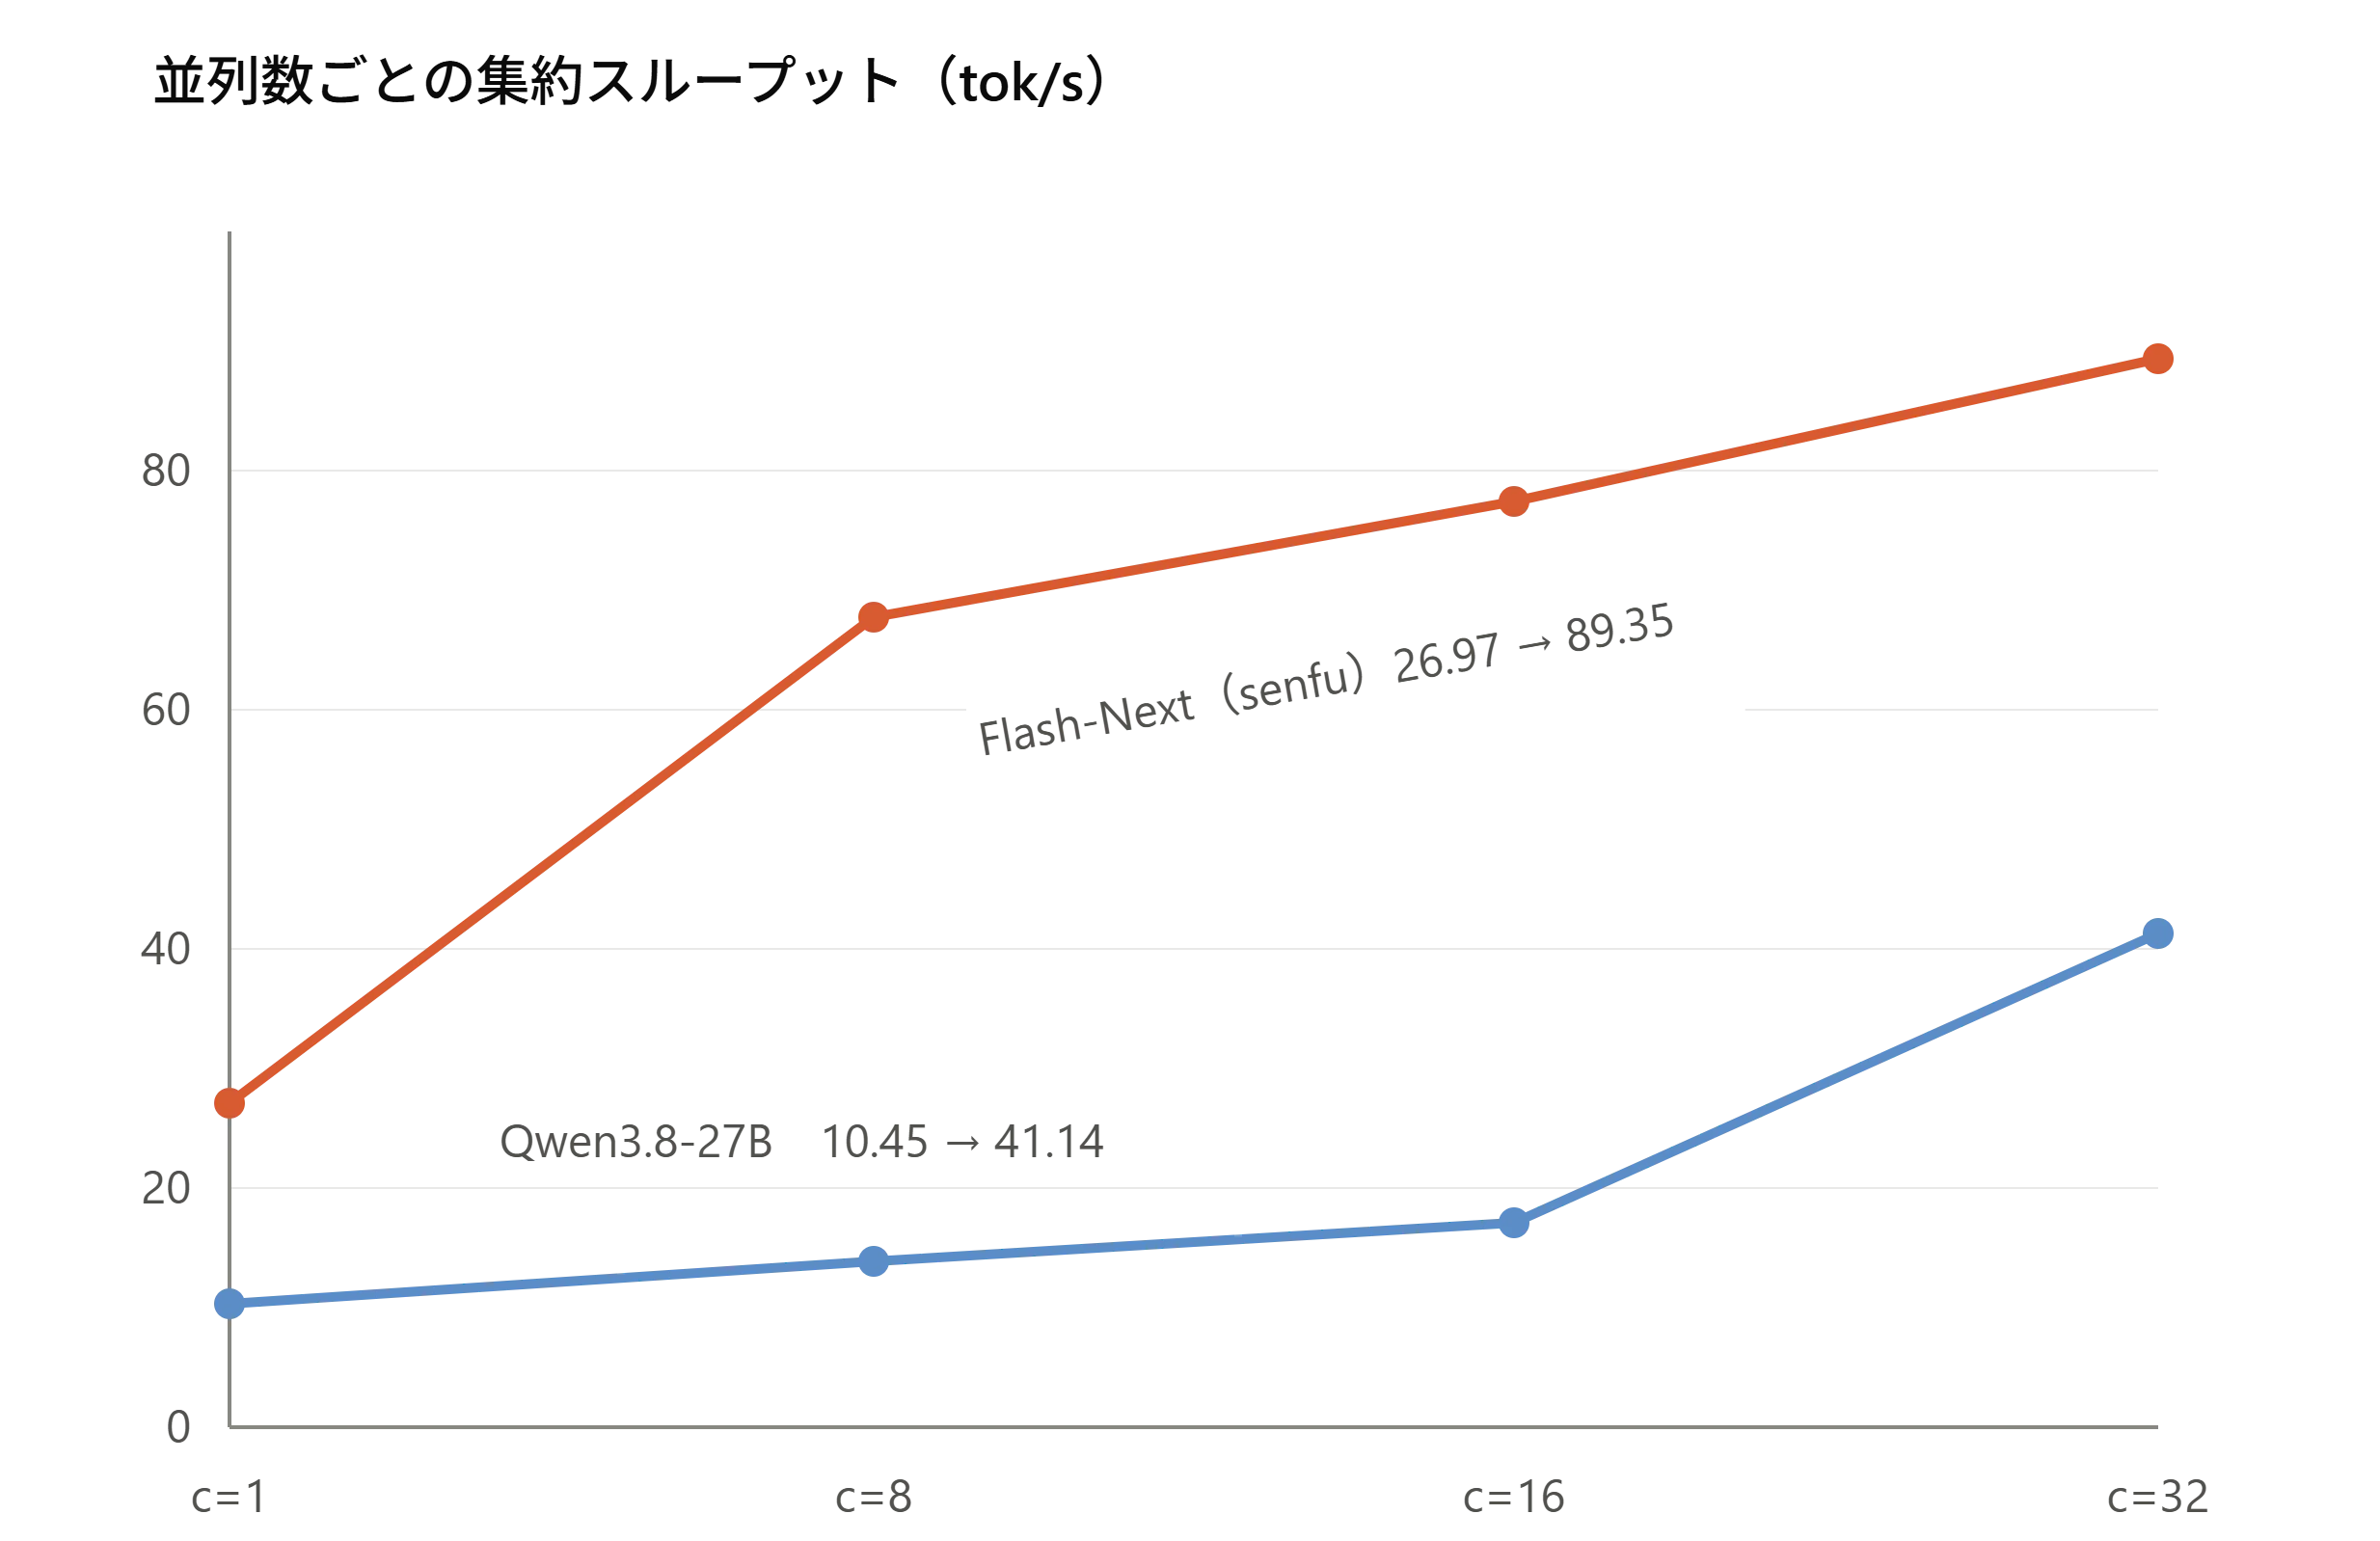
比較相手は Qwen3.8-27B(dense 28B)である。27B は llama.cpp と vLLM の両方で動かせるが、vLLM + NVFP4 + MTP が最速構成だった。記事の公平のため、今回この構成も同じ条件(キャッシュ無効化、最新イメージ)で 4 点測り直した。
| c | Flash-Next(senfu) SGLang + NVFP4 |
Qwen3.8-27B llama.cpp + Q4_K_M |
Qwen3.8-27B vLLM + NVFP4 + MTP |
|---|---|---|---|
| 1 | 26.97 | 10.45 | 16.60 |
| 8 | 67.68 | 13.85 | 104.99 |
| 16 | 77.48 | 17.19 | 168.49 |
| 32 | 89.35 | 41.14 | 235.74 |
c の読み方を添えておく。c=1 は個人が対話で使うときの速さ、c=8〜16 は社内で数人がエージェントを動かす部門サーバ、c=32 は本格的なサーバ運用にあたる。
読みどころは 2 つある。
c=1 では Flash-Next が最も速い。 26.97 tok/s は、27B の最速構成(vLLM、16.60)の 1.6 倍、llama.cpp 構成(10.45)の 2.6 倍である。176B 相当のモデルが、28B の dense モデルより速く対話に応える。 メモリに載りきらないサイズのモデルが小さいモデルより速く動くというのは、これまでの相場観にはなかった。
一方、高並列では 27B の vLLM 構成が上回る。 c=32 で 235.74 対 89.35、2.6 倍の差がつく。Flash-Next は今のところ SGLang 上でしか動かないので、この土俵では勝てない。「巨大なモデルが載る」ことと「サーバとして一番速い」ことは別である。
用途で言えば、個人が対話やエージェントで使うなら Flash-Next、多人数がぶら下がるサーバとして回すなら 27B の vLLM 構成、という選び分けになる。ただしエージェント用途では、この数字がそのまま体感にならない可能性がある。その理由は §4 で述べる。
TTFT と TPOT も挙げておく(Flash-Next)。
| c | TTFT 中央値 | TPOT 中央値 |
|---|---|---|
| 1 | 221 ms | 36.1 ms |
| 8 | 527 ms | 113.5 ms |
| 16 | 686 ms | 198.0 ms |
| 32 | 1,018 ms | 343.6 ms |
c=1 で TPOT 36ms は、体感としてはかなり快適な部類である。
TTFT(Time To First Token)は最初のトークンが返るまでの待ち時間で、プロンプトを読む処理がここに含まれる。TPOT(Time Per Output Token)は 2 個目以降のトークン間隔で、生成が流れる速さにあたる。対話では TTFT の短さが「反応の良さ」、TPOT の短さが「読みやすい流れ」として体感される。上の集約 tok/s がサーバ全体の処理量を表すのに対し、この 2 つは 1 人のユーザーから見た体感を表す。
3-2. ②日本語知識 — 上位 2 つを Flash-Next が占めた
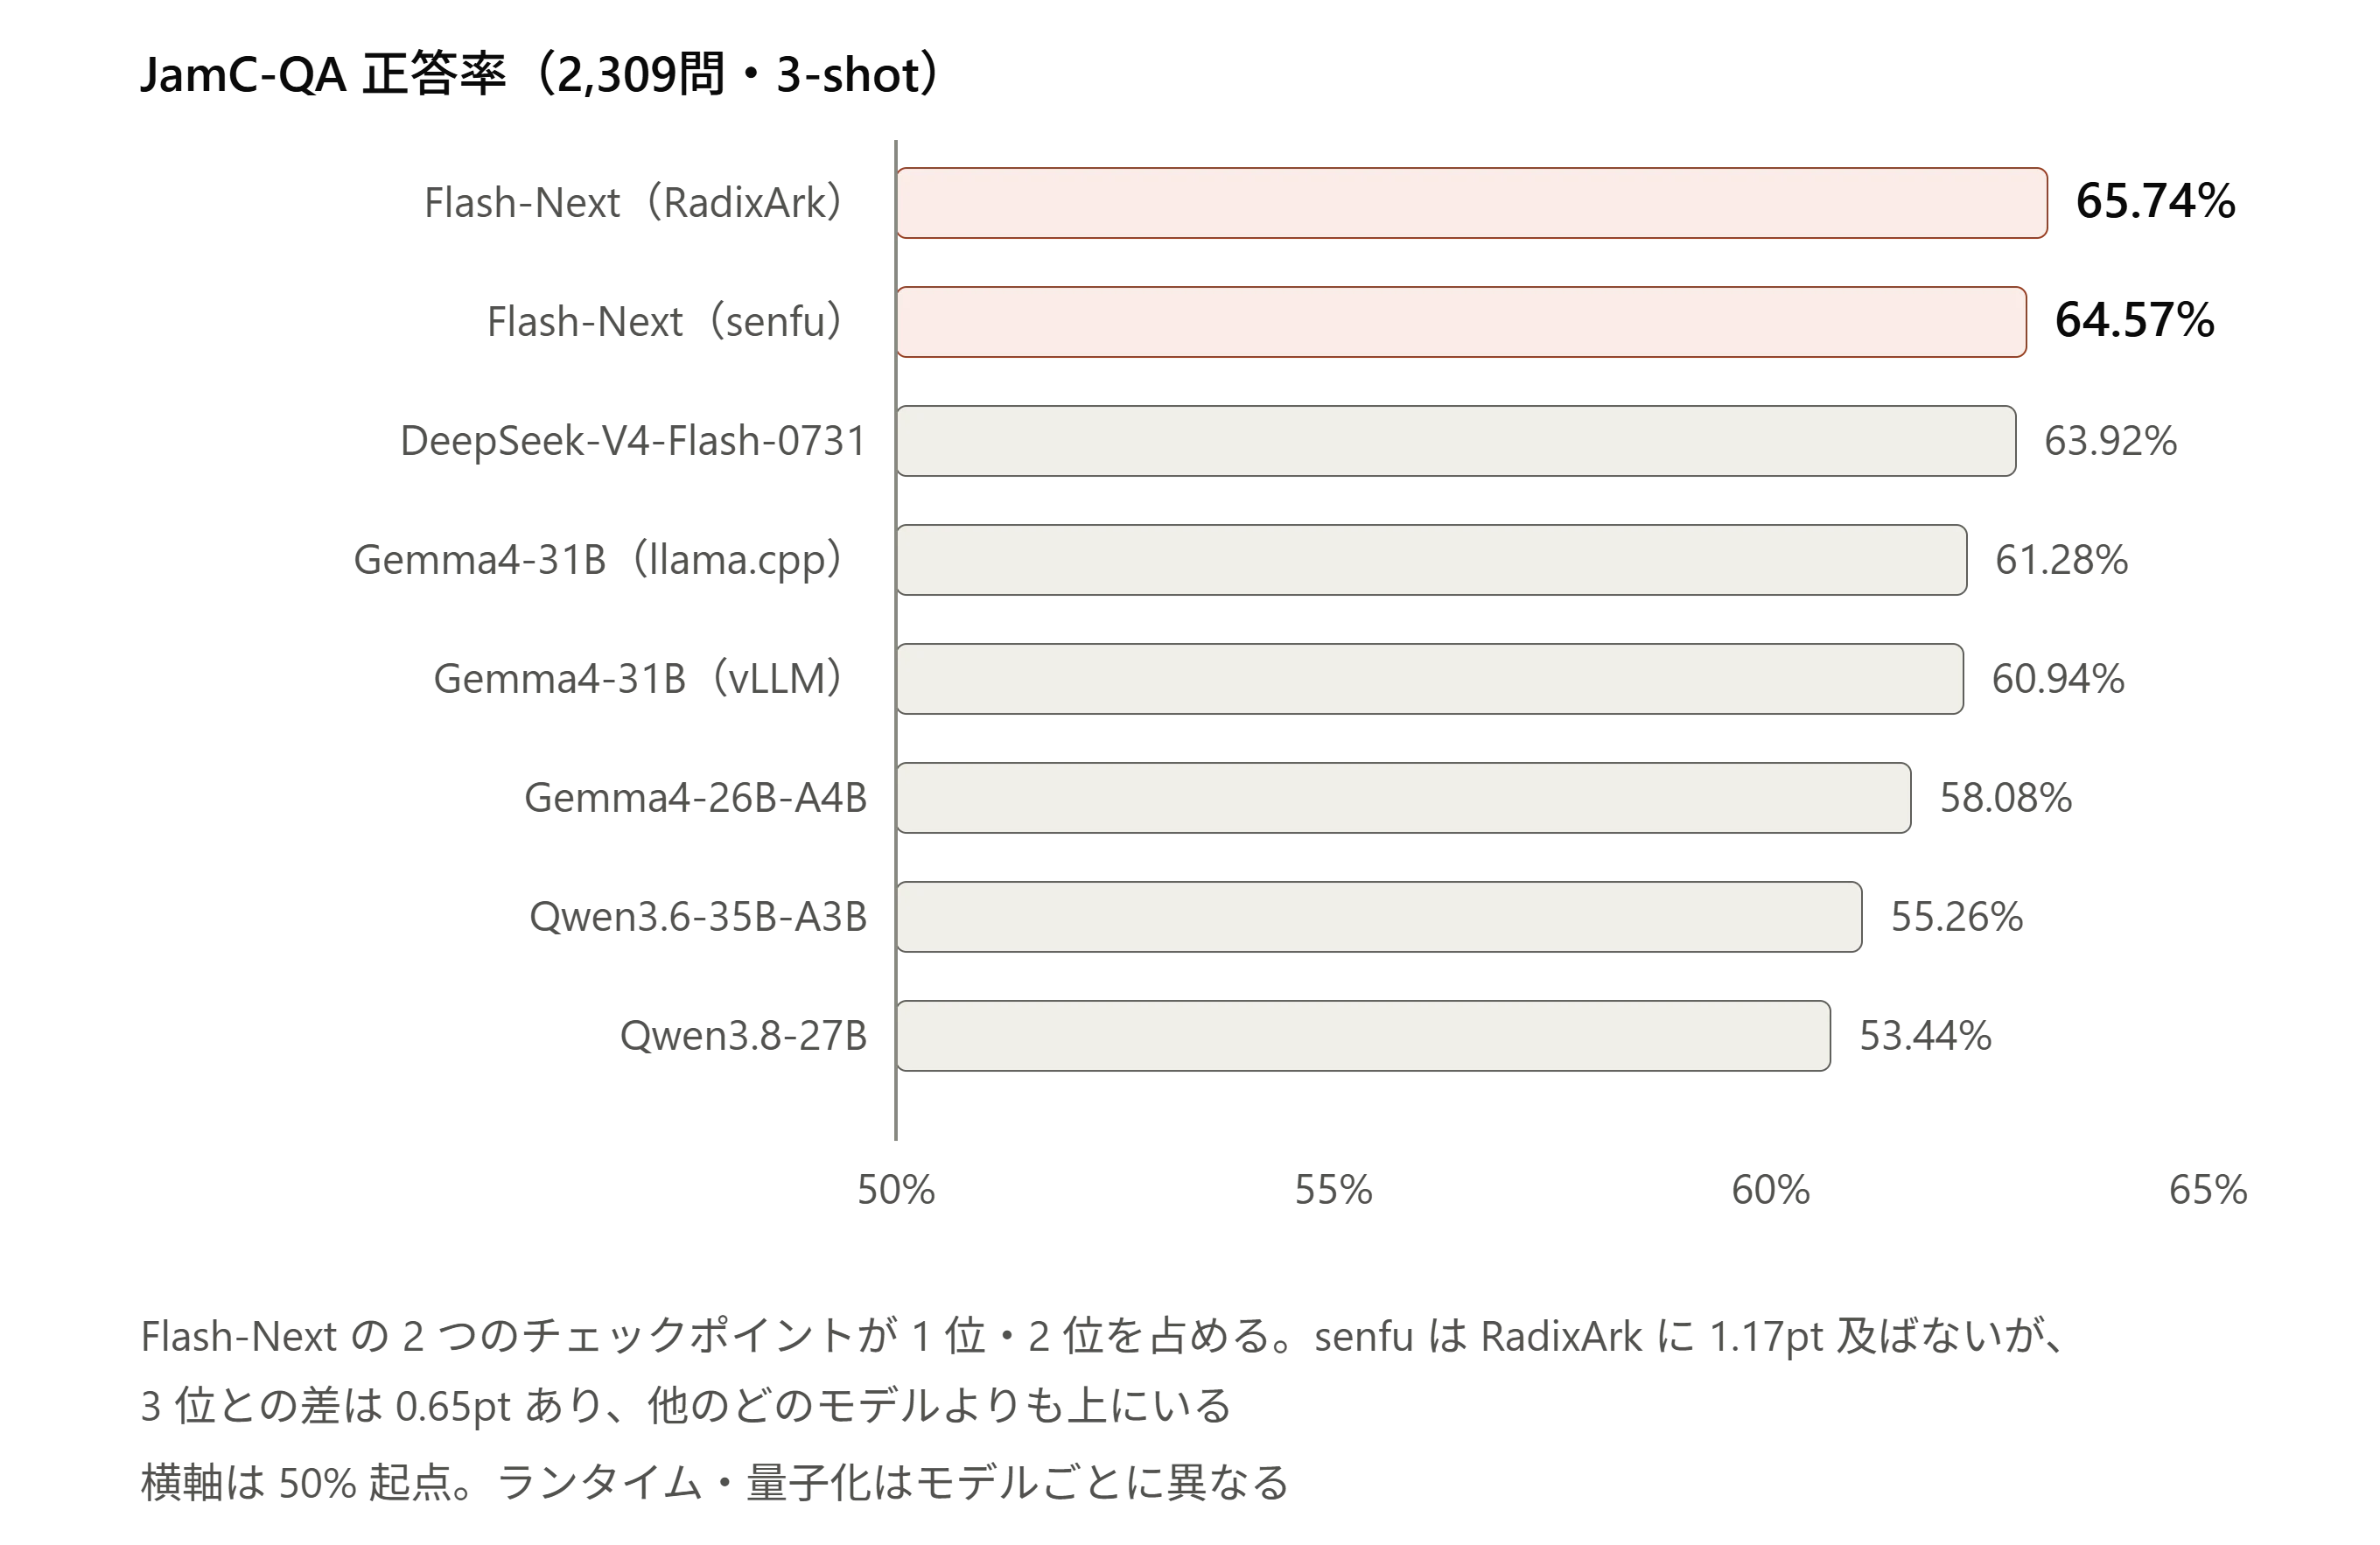
JamC-QA(SB Intuitions 構築、日本固有の知識を問う 4 択、全 2,309 問)で測った。条件は nothink / dev スプリット 3-shot / 4 択一致判定。parse 失敗は 0%。
64.57%(1,491/2,309)。当ラボが同条件で測った 8 モデル中 2 位である。
1 位も同じ Flash-Next の別チェックポイント(RadixArk 版、65.74%)で、上位 2 つを Flash-Next が占めた。
3 位は DeepSeek-V4-Flash-0731(63.92%)で、差は 0.65pt。大きな性能差と言える幅ではない。注目したいのは載せ方の違いである。8 モデルはすべて DGX Spark 1 台で測っているが、DeepSeek-V4-Flash-0731(総 284B)は 3bit(約 104GB)まで落として詰め込んでいる。 一方 Flash-Next は NVFP4 のまま、PLE を SSD に置いて載せた。同じ 1 台でも、詰め込み方がまったく違う。
日本語知識のように「暗記の厚み」を問う軸では、パラメータ数の多いモデルが有利になりやすい。だから従来は、良いスコアが欲しければ、量子化を深めて詰め込むか、機械を増やして連結するかしかなかった。前者は品質を削り、後者は導入の敷居も運用の手間も倍になる。§1 で述べた「本来なら載らないサイズが 1 台に載る」ことの恩恵は、こういう形で現れる。 大きなモデルを削りすぎずに 1 台で扱えるようになれば、これまで機材で稼いでいたスコアに単機で手が届く。
3-3. ④マルチモーダル — 形式を守り切る
当ラボの VLM ベンチは、実写画像 8 枚に対する 3 タスクである。Caption 生成、JSON 構造化抽出、PPE(安全装備)検出。測るのは画像理解の賢さというより、視覚情報を機械可読な形式で返し続けられるかである。
| タスク | 平均所要 | parse rate |
|---|---|---|
| Caption 生成 | 50.46 秒/枚 | —(自由記述) |
| JSON 構造化抽出 | 18.23 秒/枚 | 100% |
| PPE 検出 | 18.27 秒/枚 | 100% |
両タスクとも parse rate 100%。 過去に測ったモデルでは、単純な JSON 抽出は満点でも複合的な PPE 検出で出力形式が崩れるケースがあった(Gemma4-31B は 33.3%)。Flash-Next はどちらも守り切っている。
RadixArk 版と比べると、senfu 版は全タスクで 20〜42% 速い(Caption 63.4→50.5 秒、JSON 28.9→18.2 秒、PPE 31.8→18.3 秒)。速くなって、形式は守ったままである。
3-4. 投機デコード(MTP)— 効きが内容で大きく違う
Flash-Next は MTP(multi-token prediction)ヘッドを持っている。投機デコード用のドラフタが本体と一緒に学習されたものだ。ここで面白い結果が出た。MTP の効きは、生成する内容によって大きく変わる。
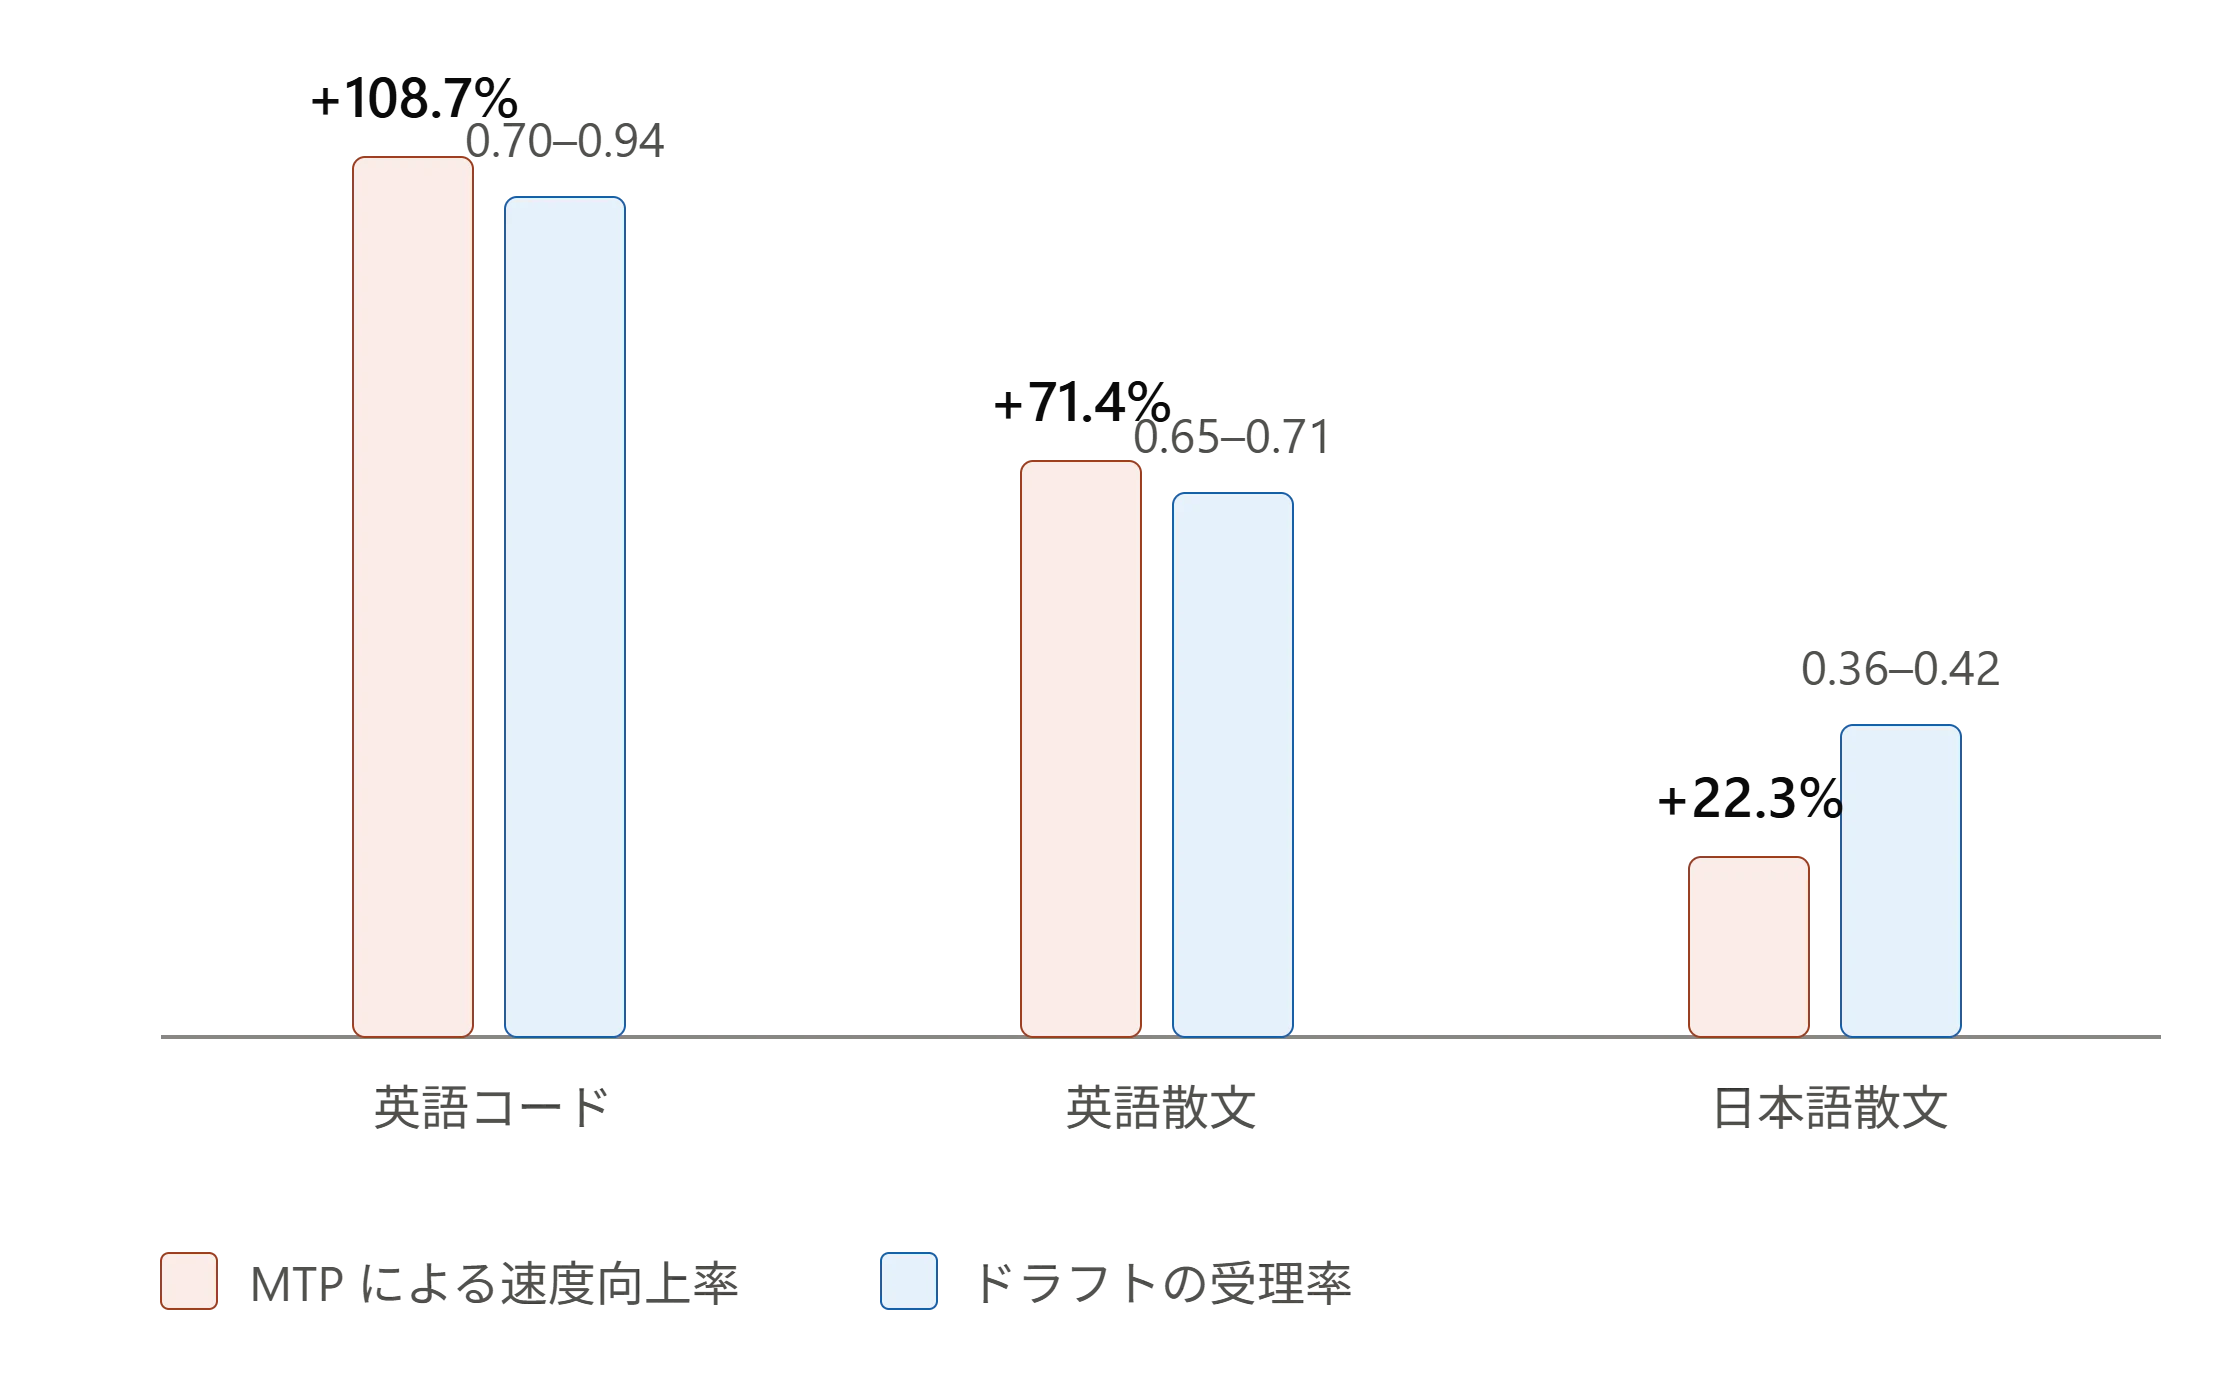
(RadixArk 版、c=1、3 試行の中央値)
| 種別 | MTP なし | MTP あり | 向上率 | 受理率 |
|---|---|---|---|---|
| 英語コード | 18.02 | 37.61 | +108.7% | 0.70〜0.94 |
| 英語散文 | 17.08 | 29.28 | +71.4% | 0.65〜0.71 |
| 日本語散文 | 16.88 | 20.65 | +22.3% | 0.36〜0.42 |
受理率の順位と、速度向上の順位が完全に一致している。ドラフタの先読みが当たるほど速くなる、という投機デコードの理屈がそのまま出た形である。
注目してほしいのは、MTP を切った状態では 3 種の速度差がほとんど無い(16.88〜18.02)ことだ。つまりモデル本体は日本語もコードも同じ速さで生成している。差は投機デコードを有効にしたときにだけ現れる。
海外の記事では「Flash-Next はコード生成で速い」と書かれていることがあるが、それは MTP を有効にした場合の話である。今回のプロンプト群では、日本語での速度向上率はコードの約 5 分の 1 だった。 日本語で使う読者にとっては、知っておく価値のある差だと思う。(なお本記事の本番構成である senfu 版では、MTP は使わない。理由は §5-3 に書いた)
3-5. ③コーディング — Aider Polyglot
最後に、コーディングを測る。
Aider Polyglot は何を測るか
Exercism 由来の 225 題を C++ / Go / Java / JavaScript / Python / Rust の 6 言語で解かせる。ただの「コードを書かせるテスト」ではない。
- 既存のファイルを渡して直させる。 白紙からの生成ではなく、渡されたコードに手を入れる
- テストのフィードバックで 2 回まで試せる。 1 回目が落ちたら、テストのエラー出力を渡して直させる
- 6 言語。 Python の暗記量だけでは通用しない
つまり、エージェントとしてコードを直せるかの実技試験である。
結果 — 比較群で 2 位、同条件では最上位
pass_rate_1 = 32.4%(73/225)、pass_rate_2 = 56.9%(128/225)。 225 題すべて完走、出力形式の破綻は 0 件(well-formed 100%)。
当ラボが測ってきたモデルと並べる。編集形式と並列数が揃っていないので、その列を付けた。
| モデル | 編集形式・並列 | pass_rate_1 | pass_rate_2 |
|---|---|---|---|
| Qwen3-Coder-480B | diff・1 | 30.7% | 57.3% |
| Flash-Next(senfu) | whole・8 | 32.4% | 56.9% |
| Qwen3.6-35B-A3B | diff・1 | 24.0% | 49.8% |
| Muse Glimmer 30B | ATEM・8 | 20.4% | 48.0% |
| Qwen3.8-27B | whole・8 | 15.6% | 47.6% |
| GLM-5.2 | diff・1 | 11.6% | 43.1% |
| Gemma4-31B-IT | diff・1 | 9.3% | 43.1% |
| MiniMax-M3 | diff・1 | 17.3% | 40.0% |
| DeepSeek-V4-Flash | diff・1 | 20.7% | 39.7% ※ |
| Granite 4.2-30B | whole・8 | 1.8% | 11.1% |
※ DeepSeek-V4-Flash は 174/225(77%)の部分結果。
編集形式について。 Aider はモデルにコードを直させるとき、2 つの頼み方を持っている。whole は「ファイル全体を書き直して返して」、diff は「変える前の行と変えた後の行だけを、決まった書式で返して」。diff は引用した行が既存のファイルと 1 文字でも違えば失敗するので、一般に whole より難しい。当ラボの測定では、どちらもコマンドラインで明示的に指定していた(モデルによる自動選択ではない)。
読み方を 2 つ。
同じ whole 系では最上位である。 Flash-Next 56.9%、Muse Glimmer 48.0%、Qwen3.8-27B 47.6%、Granite 4.2 11.1%。同系統で最も近い条件の Qwen3.8-27B を 9.3pt 上回った。
表全体では 2 位だが、1 位の Coder-480B とは編集形式が違う。 0.4pt 差という数字に意味を持たせるのは避けたい。難しい形式(diff)で 57.3% を出した 480B と、易しい形式(whole)で 56.9% を出した Flash-Next は、同じ土俵にいない。
もうひとつ、pass_rate_1 の 32.4% に触れておきたい。Qwen3.8-27B は 15.6% で、当ラボは当時「一発目は当たらないが、エラーを読んで直す力がある」と書いた。Flash-Next は一発目の的中率がその倍ある。直す力に頼らず、最初から当ててくる。
max_tokens の罠 — シリーズ 4 例目
この測定でいちばん時間を取られたのが、生成トークン数の上限だった。
当ラボの過去記事で 3 回書いている(Qwen3.8-27B、Muse Glimmer、Granite 4.2)。思考を長く出すモデルは、上限が足りないと思考だけでトークンを使い切り、答えにたどり着かない。 Flash-Next でも同じことが起きた。しかも過去のどれより深刻だった。
| max_tokens | 結果 |
|---|---|
| 8192(Muse Glimmer での採用値) | 1 問目からコンテクスト超過。ある問題は可視の出力が 1 文字も出ずに終了 |
| 16384 | 2 回ともコンテクスト超過する問題が出る |
| 24576 | 通るが、使用量が上限の 99.6% |
| 32768 | 採用 |
32768 でも延べ 450 試行のうち 198 回(44.0%)がコンテクスト超過している。比較群の中で最も高い。上限を目一杯与えてなお足りない場面が残る、というのがこのモデルの性格である。
所要時間も相応で、1 問あたり平均 59 分、225 題で数十時間かかった。このモデルでコーディングのベンチを回すなら、生成トークン数の上限と測定時間を最初から大きく見積もっておくことをすすめる。
3-6. ベンチマーク計測のまとめ
| 軸 | 結果 |
|---|---|
| ①速度 | c=1 で 26.97 tok/s、c=32 で 89.35 tok/s。対話では 27B を上回り、高並列では 27B の vLLM 構成に譲る |
| ②日本語知識 | JamC-QA 64.57%、比較群 8 モデル中 2 位(1 位も Flash-Next) |
| ④マルチモーダル | JSON / PPE とも parse rate 100%、RadixArk 比で 20〜42% 高速 |
| ③コーディング | Aider Polyglot pass_rate_2 56.9%、同条件の比較群で最上位 |
速く、日本語に強く、形式を守り、コードも直せる。 128GB のメモリに載るモデルとしては、現時点で相当に強い部類だと考えている。
4. なぜ SGLang なのか
当ラボの測定は、これまで llama.cpp と vLLM の2本立てだった。SGLang を本格的に使うのは今回が初めてである。Flash-Next の提供元が対応ランタイムに SGLang しか挙げておらず、選択の余地がなかった。ところが測ってみると、SGLang の設計がエージェント用途とよく噛み合うことが見えてきた。
4-1. 2つのランタイムは、解いた問題が違う
| vLLM | SGLang | |
|---|---|---|
| 出発点の発明 | PagedAttention | RadixAttention |
| 解こうとした問題 | KV キャッシュの断片化 | プロンプトの使い回し |
| 想定利用者 | サービング一般 | 同じプロンプトを何度も投げる用途 |
vLLM の中核は PagedAttention だった。KV キャッシュを OS の仮想メモリのようにページ単位で管理することで、同時実行数を上げてもメモリが無駄にならなくなった。連続バッチングと組み合わさって、サービング基盤として最も広く使われている。
SGLang の中核は RadixAttention である。KV キャッシュを基数木(radix tree)で持ち、プロンプトの共通部分を自動的に共有・再利用する。名前の SGLang は Structured Generation Language の略で、もともと「同じプロンプトから何度も分岐して生成する」プログラムを書くための言語処理系として出発した。だからキャッシュの使い回しが設計の中心に来ている。
vLLM にも自動プレフィックスキャッシュはある。違いは管理の仕方で、SGLang は木構造で持つぶん、分岐が多く履歴が伸びていく使い方で差が出やすい、とされる。
(なお今回 llama.cpp は対象外とした。Flash-Next の GGUF 版は極端な量子化を伴い、ツール呼び出しの精度が読めないためである)
4-2. エージェントは、同じプロンプトを投げ直し続ける
ここが今回いちばん重要な点である。当ラボの過去の速度測定(方式4)は、ShareGPT の 200 問を並列で流す。200 問は互いに無関係な独立したプロンプトなので、共通部分はほぼ無い。この土俵では RadixAttention の利点は現れない。
ところがエージェントの動き方は違う。ハーネス(当ラボでは OpenCode や Aider)がモデルを呼ぶとき、毎ターンこういう中身を送っている。
- システムプロンプト+指示書(毎回同じ)
- + これまでのツール呼び出しとその結果(ターンごとに伸びる)
- + 今回の一手
つまり毎ターン、前回送ったものの全体に少し足して投げ直している。プロンプトの大半が前回と同一である。長いコンテクストを扱うほど、この構造が効く。ログを数万トークン読ませたら、それ以降のターンは毎回その数万トークンを再送することになる。素直に処理すれば、毎ターン数万トークン分のプリフィルが発生する。
4-3. 実測 — 63,000 トークンのプロンプトで 85 倍
当ラボの実測値を挙げる。同じ長文を 2 回続けて投げて、2 回目のプリフィル時間を測った。
| プロンプトの長さ | 1 回目 | 2 回目 | 短縮 |
|---|---|---|---|
| 2,512 トークン | 3.010 秒 | 0.748 秒 | 4.0 倍 |
| 22,813 トークン | 19.744 秒 | 3.010 秒 | 6.6 倍 |
| 63,262 トークン | 35.53 秒 | 0.417 秒 | 85.2 倍 |
プロンプトが長いほど、効きが跳ね上がる。 2,500 トークンなら 4 倍だが、63,000 トークンでは 85 倍になる。35 秒かかっていたプリフィルが 0.4 秒で済む。これが意味するのは、長いコンテクストの代金をセッション中に 1 回しか払わずに済む可能性があるということだ。最初のターンで数万トークンのログを読ませたら、そのあとのターンではその分のプリフィルがほぼ発生しない。エージェントがまさにそういう使い方をする。
なおこれは SGLang のプレフィックスキャッシュが効くことを示す実験であって、vLLM のキャッシュと直接比べたものではない。
4-4. 実運用では、速度測定より速く回っていた
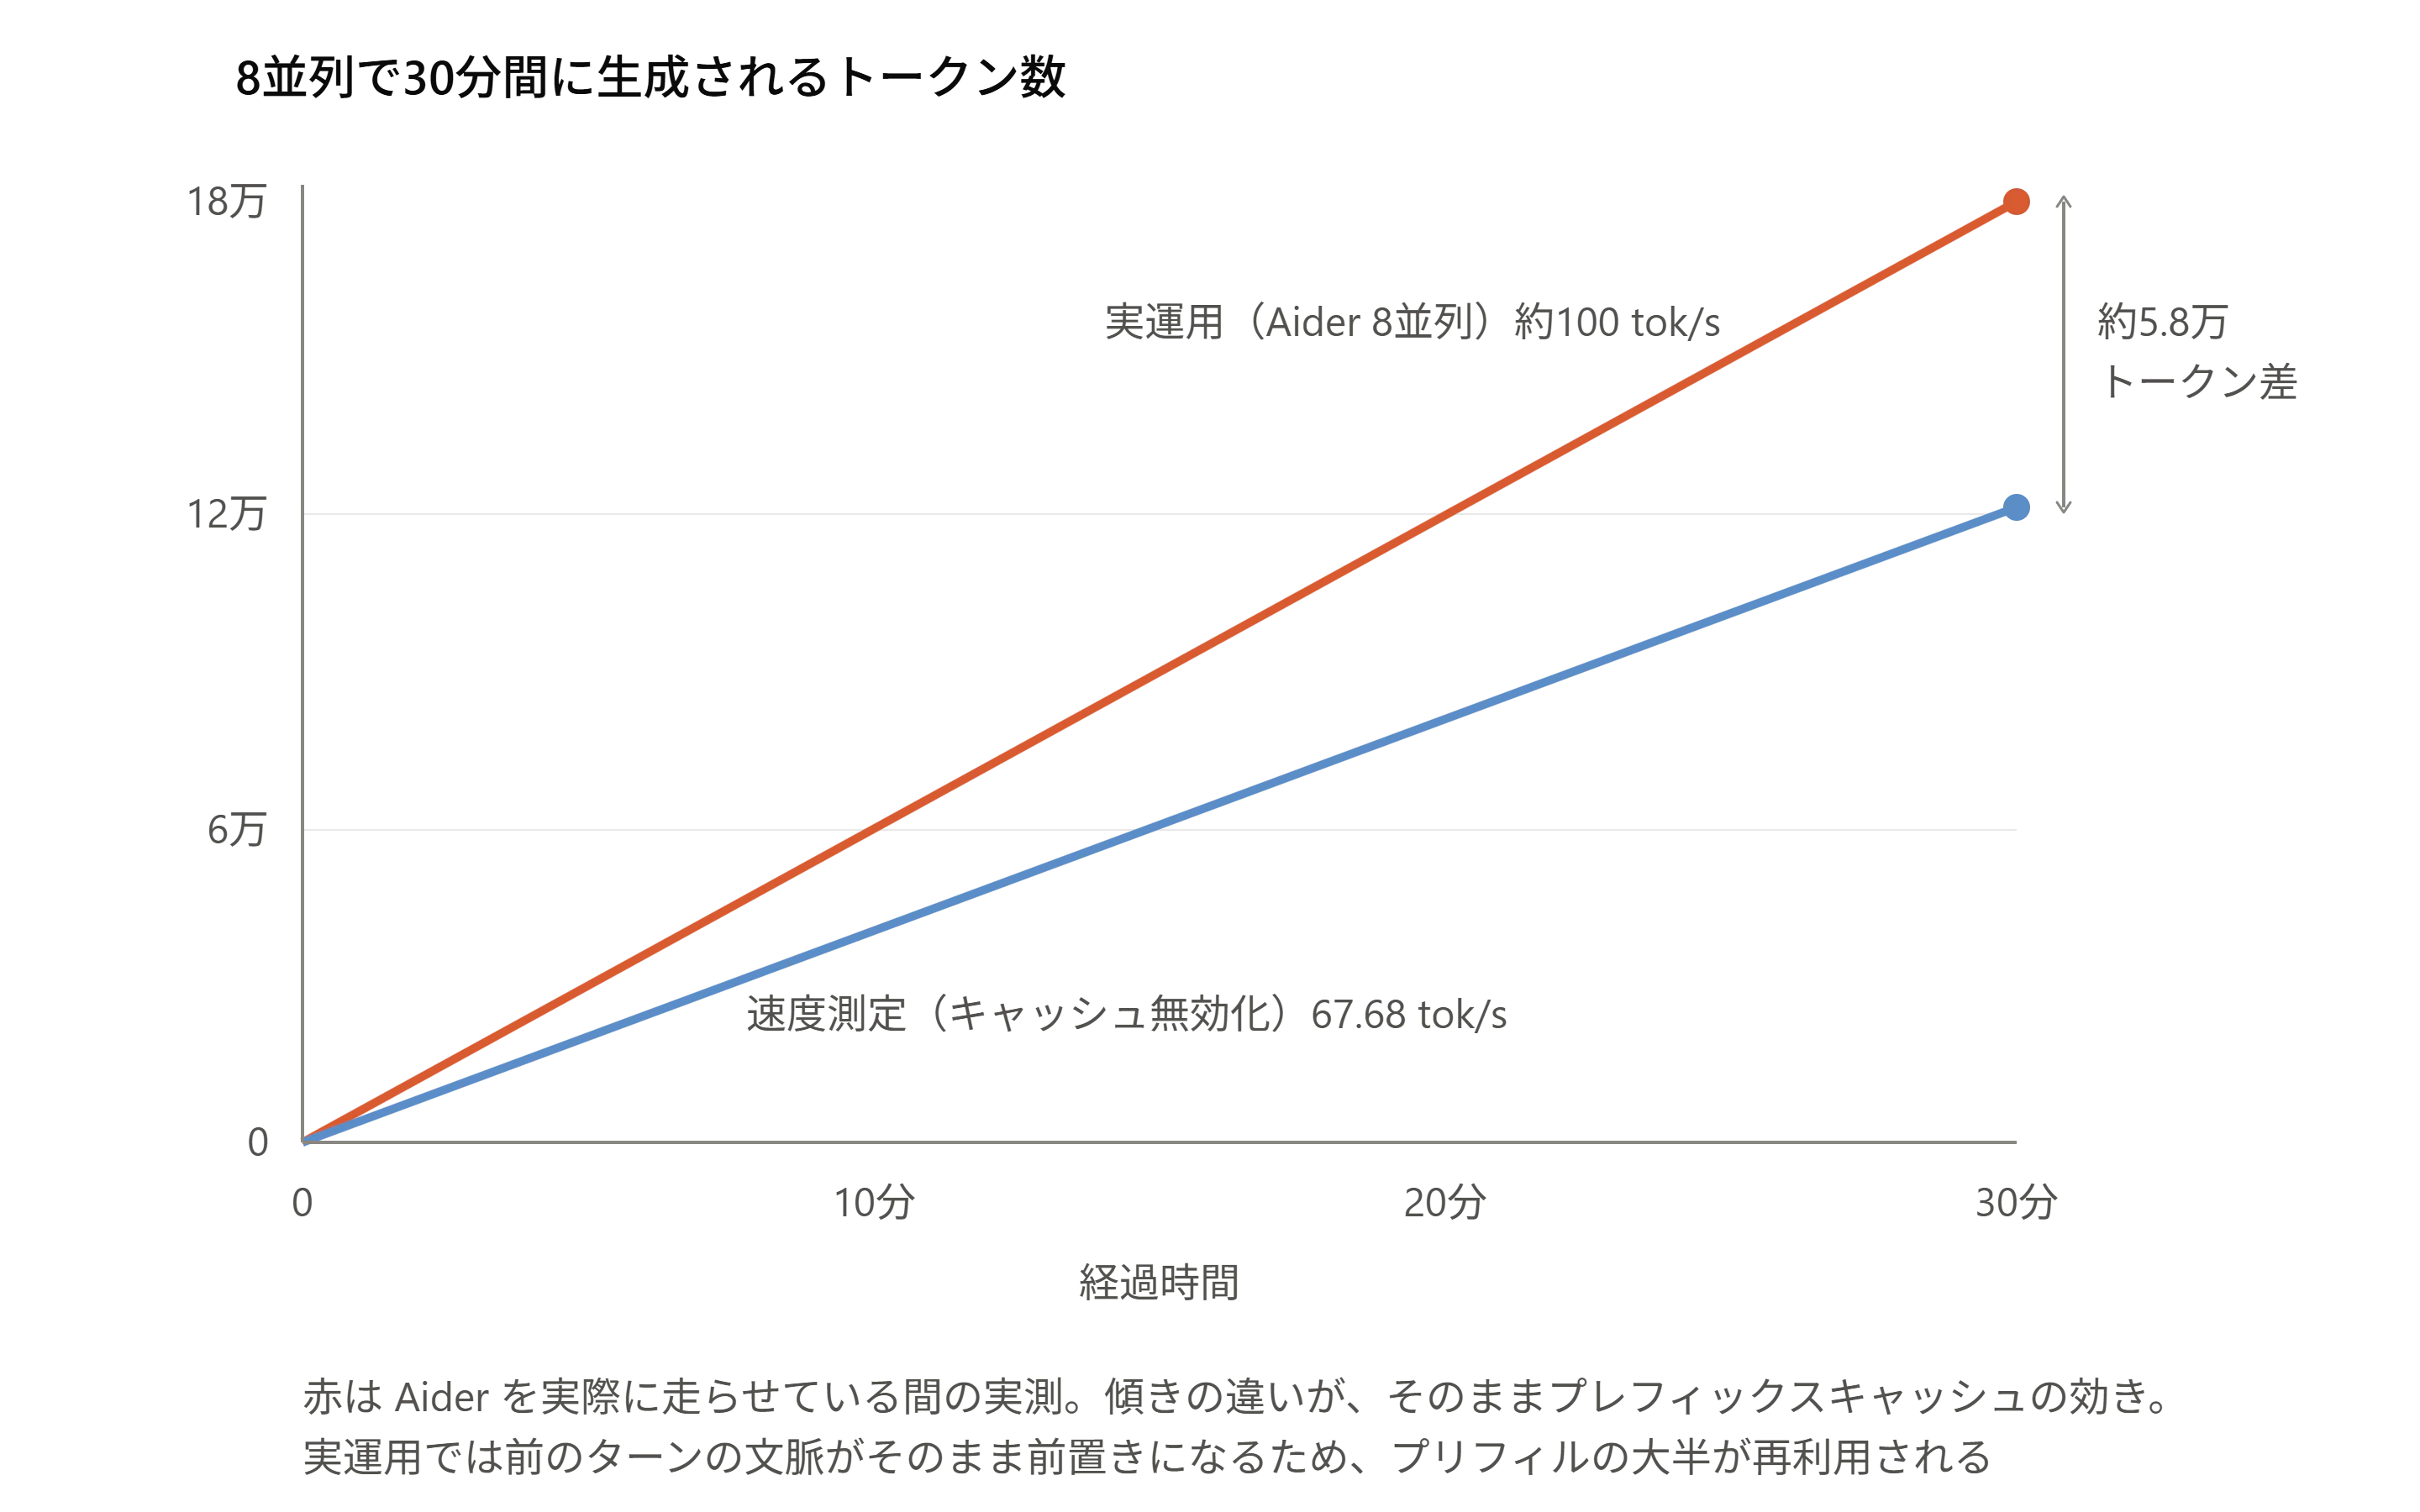
ここまでは実験室の数字である。実際の運用に近い状況も観測できた。コーディングのベンチマーク(Aider Polyglot、8 並列)を回している最中のサーバのスループットを観測したところ、集約 97〜102 tok/s で安定していた。ところが同じ 8 並列で測った速度測定の値は 67.68 tok/s である。
| 集約 tok/s | 1 スロットあたり | |
|---|---|---|
| 速度測定(c=8、キャッシュ無効化) | 67.68 | 8.46 |
| 実運用に近い状況(Aider 8 並列、キャッシュ有効) | 約 100 | 約 12.3 |
約 1.5 倍の差が出た。 ただし、この比較は条件が揃っていない。速度測定の ShareGPT と Aider では、プロンプトの長さも出力の長さもリクエストの到着間隔も違う。差のすべてをキャッシュによるものとは言えない。
それでも、Aider はテストの往復を繰り返すハーネスで、2 回目の試行では 1 回目のやり取りがそのまま先頭に来る。4-2 で述べた構造が効いている以上、キャッシュの寄与は大きいと考えている。同じワークロードでキャッシュの有無を切り替えた比較は、今後の宿題とする。
つまり、記事に載せている速度の数字はキャッシュを切った条件での値であり、エージェント用途ではキャッシュが効くぶん上振れする可能性がある。
4-5. だから「単発の tok/s」だけで判断すると読み違える
§3-1 で見たとおり、Flash-Next は c=1 では 27B を上回るが、高並列では 27B の vLLM 構成に届かない。数字だけ見れば「サーバ用途では負け」で話が終わる。
しかしエージェント用途では、1 ターンの所要時間はプリフィルとデコードの合計になる。長いコンテクストを持ったまま何十ターンも往復する使い方では、プリフィル側の効きが全体を大きく左右する。
言い換えると、こうなる。
- 単発の質問(c=1、短いプロンプト): デコード速度がすべて。tok/s で判断してよい
- エージェント(長いコンテクスト、多ターン): 2 ターン目以降のプリフィルがほぼゼロになるかどうかが効く
当ラボがこれまで tok/s を主指標にしてきたのは、前者の使い方が中心だったからだ。エージェント用途を本気で測るなら、プレフィックスキャッシュの効きを指標に加えるべきというのが、今回の測定で得た反省である。
4-6. 運用上の注意 — 速度測定ではキャッシュを切る
裏返しの注意点もある。これだけ効くということは、速度測定でキャッシュを切り忘れると、モデルの実力ではなくキャッシュとの相性を測ってしまうおそれがあるということでもある。
今回あらためて確認したところ、llama.cpp も vLLM も、プレフィックスキャッシュは既定で有効だった。vLLM はフラグ未指定だと enable_prefix_caching=True に解決される。当ラボの速度測定(方式4)では ShareGPT の 200 問がすべて異なるプロンプトなのでキャッシュはヒットしないが、それでも管理のコストが各リクエストに乗りうる。
ところがその影響はランタイムによって大きく違った。
| ランタイム | キャッシュ無効化による変化 |
|---|---|
| llama.cpp | TTFT が 9.7 倍改善(2,953.7ms → 305.4ms)、tok/s も +11.4% |
| vLLM | 1.5〜2.7% 程度(c=8/16/32、バージョン更新分を含む) |
llama.cpp では管理コストが TTFT に集中的に乗っていたのに対し、vLLM ではほとんど影響がない。同じ「既定で有効」でも、実装によってここまで違う。llama.cpp 側は過去記事の数値を訂正することになった(別途報告する)。
速度測定ではキャッシュを明示的に無効化し、その事実を条件に明記する。 今回の測定はすべてこの条件で行っている。
4-7. 追記 — その後、実運用に移した
本記事の測定のあと、当ラボでは Flash-Next を実際の作業に使い始めた。DGX Spark 上で 384K のコンテクストを確保して常駐させ、コーディングのエージェントの接続先として日常的に使っている。それまで使っていた AMD Ryzen AI Max+ 395(Strix Halo)搭載機が、長いコンテクストでは安定しなかったための置き換えである。使ってみると、指示を投げてから動き出すまでの流れが明らかになめらかで速い。§4-3 で測ったプレフィックスキャッシュの効きが、ベンチの数字としてではなく日々の待ち時間の短さとして返ってきている、というのが今の実感である。
5. 同じモデルでも、どの派生を選ぶかで 6 割変わる
ここまで「Flash-Next は速い」と書いてきたが、正確ではない。どのチェックポイントを選んだかで速度が 6 割変わる。 そして、その選択には副作用もある。当ラボは今回 2 つのチェックポイントを同じ条件で測った。結論から言うと、低並列では後から見つけたほうが 63.5% 速く、しかも投機デコードの速度上の利点がなくなった。
5-1. 派生モデルが大量にある
注目度の高いモデルには、派生チェックポイントが大量に出る。Flash-Next も例外ではなく、公開直後から十数本が Hugging Face に並んだ。名前はどれも「NVFP4」だが、中身は違う。違うのは「どこを量子化したか」である。モデルは一枚岩ではなく、部位ごとに役割が違う。
| 部位 | 役割 | 量子化の影響 |
|---|---|---|
| ルーテッドエキスパート | MoE の本体。毎トークン一部だけ使う | サイズへの寄与が最大 |
| PLE n-gram テーブル | 表引き。51B ある | サイズは大きいが速度への影響は小さい(§1-2) |
| dense 経路(アテンション、GDN、共有エキスパート) | 毎トークン全部読む | 低並列の速度を直接左右する |
| LM head | 出力層 | 精度に効きやすい |
| MTP ヘッド | 投機デコードのドラフタ | 本体とずれると受理率が落ちる |
当ラボが最初に選んだ RadixArk 版は、SGLang の開発組織が出しているもので、ルーテッドエキスパートだけを NVFP4 にし、それ以外は BF16 のまま残している。公式サポートのランタイムも SGLang なので、素性としては申し分ない。
あとから見つけた senfu 版は、その RadixArk を土台に、さらに dense 経路を FP8、LM head を NVFP4 まで落としたものだった。ルーテッドエキスパートと PLE はバイト単位で同一である。
5-2. dense 経路を削ると、低並列が速くなる
senfu のモデルカードには、狙いがはっきり書かれている。デコード 1 ステップあたりの読み出しが 9.95GB → 6.13GB(38% 減)。
§1-2 で書いたとおり、生成速度を決めるのは「毎トークン読むバイト数」である。MoE なのでエキスパートは一部しか読まないが、dense 経路は毎トークン全部読む。低並列ではここがメモリ帯域を食っている。実測はこうなった。
| c | RadixArk | senfu | 差 |
|---|---|---|---|
| 1(個人が対話する速さ) | 16.50 | 26.97 | +63.5% |
| 8(チームで数人が使う) | 58.21 | 67.68 | +16.3% |
| 16 | 71.80 | 77.48 | +7.9% |
| 32(本格的なサーバ運用) | 85.22 | 89.35 | +4.8% |
優位が c とともに縮む。 +63.5% → +4.8% と、きれいに減衰している。これは設計から予想される挙動である。低並列ではメモリ帯域が律速なので、読み出しを減らした効果がそのまま出る。並列数を上げると計算のほうが律速になり、読み出しを減らしても効かなくなる。
用途で言えば、個人で対話に使うなら senfu が圧倒的、チームで並列に叩くなら差はほとんどないということになる。
5-3. 予想しなかったこと — 投機デコードが効かなくなる
Flash-Next は MTP(multi-token prediction)ヘッドを持っている。投機デコードのためのドラフタが本体と一緒に学習されており、RadixArk 版ではよく効いた。
| c | RadixArk OFF | RadixArk ON | 差 |
|---|---|---|---|
| 1 | 16.50 | 23.78 | +44.1% |
| 8 | 58.21 | 59.40 | +2.0% |
| 16 | 71.80 | 65.95 | −8.1%(逆転) |
c=8〜16 のあいだで優位が消える、というのは投機デコードでよく見られる形で、当ラボの過去の測定でも同じ傾向が出ている(ドラフトの生成と検証が、高並列では本体の計算と取り合いになるため)。
ところが senfu版では、c=1 の時点で既に逆効果だった。
| c=1 | OFF | ON | 差 |
|---|---|---|---|
| RadixArk | 16.50 | 23.78 | +44.1% |
| senfu | 26.18 | 19.49 | −25.6% |
受理率を見ると理由が分かる。RadixArk では 0.48〜0.53 だった受理率が、senfu では約 0.19 まで落ちていた。 半分以下である。
投機デコードは、ドラフタが提案したトークンを本体が検証して、当たっていれば採用する仕組みである。当たる前提は、ドラフタと本体が同じ答えを出しやすいことだ。ところが senfu は dense 経路と LM head の精度を落としている。本体の出力分布が変われば、ドラフタの提案は当たりにくくなる。
さらに調べると、senfu は MTP ヘッド自体も一部量子化していた。MTP のうち重い部分であるエキスパートが、NVIDIA 公式チェックポイント由来の FP8 に置き換えられている(attention や正規化などの残り 29 テンソルは RadixArk と同じ BF16)。RadixArk が MTP の 31 テンソルすべてを BF16 で保っているのと対照的である。senfu のモデルカードには「MTP は変更なし」とあるが、両者の safetensors を直接比べたところ、これはエキスパート以外の部分についての記述だった。なお、ドラフト側の量子化指定を明示して測り直しても結果はほぼ同じだった(19.49 → 19.21 tok/s、受理率 0.19 → 0.17)。設定の問題ではない。 他の検証者の報告では、MTP のエキスパートだけを FP8 にした版は速度が誤差の範囲だったとあるので、受理率の低下は主に本体側(dense 経路と LM head)によるものと見ている。
「量子化を深めると投機デコードが効かなくなる」 — これは当ラボが他所で読んだことのない知見だった。両方のチェックポイントを同じ条件で測ったから見えたことである。
5-4. それでも senfu版 を選ぶ
一見すると痛手だが、数字を並べれば結論は明快だった。
| 最良の構成 | c=1 の速度 | |
|---|---|---|
| RadixArk | MTP ON | 23.78 |
| senfu | MTP OFF | 26.97 |
senfu は MTP を使わずに、RadixArk の MTP 入りより速い。 各チェックポイントのベストで比べれば senfu が勝っている。しかも MTP を切れること自体に利点がある。
- ドラフタの重み 3.46GB が空く
- SGLang の公式ドキュメントに「単一 DGX Spark で MTP を使う場合、並列数の上限は 8」という制約があるが、これが無関係になる。MTP なしなら c=32 まで素直に測れる
- 起動フラグが減り、運用が単純になる
当ラボは senfu・MTP OFF を本番構成として採用した。
5-5. 選ばなかったもの
参考までに、検討して見送ったチェックポイントも挙げておく。
local-inference-lab 版は、単なる量子化ではなく量子化を意識した蒸留で作られていた。BF16 の教師モデルに対して追加学習を行い、PLE テーブルまで NVFP4 で訓練している。NVIDIA の Jetson AI Lab がこのチェックポイントをリンクしているのも、おそらくこの品質が理由だろう。品質では RadixArk を上回る可能性がある。ただし PLE テーブルが NVFP4 で、現在の SGLang は FP8 と BF16 しか読めない。使うにはランタイム側の実装が要るため、今回は見送った。
PLE を 4bit にして常駐させる構成も検討した。SSD を使わずメモリに全部載せる案である。しかし先行事例では、コンパイル時にテーブルの複製が作られてメモリが枯渇し、複数台が再起動に追い込まれている。速度も mmap 構成より遅かったという報告があり、こちらも見送った。常駐させて速くなるかは当ラボでは検証していないが、§1-2 で書いたとおり PLE は 1 トークンあたり 2.5KB しか読まないので、大きな改善は期待しにくいと考えている。
6. 試行錯誤の履歴
ここまで「この手順で動く」と書いてきたが、そこに至るまでに当ラボは 20 回以上起動をやり直している。同じ壁に当たる人のために、症状から逆に引ける形でまとめておく。時系列の苦労話ではなく、「こう見えたらここを疑う」という並べ方にした。
6-1. ロードが途中から異様に遅くなる/PyTorch の素の演算で illegal memory access が出る
こう見えたらこれを疑う
nvidia-smi -q の Addressing Mode を見てほしい。None と出ていたら、これである。
何が起きているか
Flash-Next は PLE テーブルを SSD 上のファイルに置き、GPU がそのメモリを直接読む。この経路(ATS / HMM)は、NVIDIA の open カーネルモジュールでしか動かない。proprietary ドライバが入っていると経路が閉じ、GPU がファイル裏付けのメモリを触った瞬間に落ちる。
やっかいなのは、CUDA のエラー報告が非同期なことだ。実際の破損とはまったく別の場所 — JIT とは無関係な、PyTorch の素の pow() や mean() — でエラーが表面化する。当ラボは最初、JIT カーネルのバグだと思ってそちらにパッチを当ててしまった。当然直らない。PLE の行を CPU 側で取り出すパッチも試したが、これも本当の原因ではなかった。
対処
open ドライバ(nvidia-driver-580-open 系)に戻す。DGX Spark の標準はこちらである。戻したところ、上記の回避策はいずれも不要になった。
なぜ proprietary が入るのか
当ラボの場合、以前に CUDA が動かなくなったときの復旧作業で、一般的な手順(apt install nvidia-driver-XXX)を踏んだ結果、意図せず入れ替わっていた。そのまま 8 か月動いていて、今回まで気づかなかった。復旧作業のあとは、ドライバの種別を確認するという教訓になった。modinfo nvidia | grep -i license で分かる(open なら Dual MIT/GPL、proprietary なら NVIDIA)。
補足: 興味深いことに、open ドライバに戻しても SGLang が判定に使う属性(
pageableMemoryAccessUsesHostPageTables)は 0 のままだった。GB10 の ATS は、この属性が指す経路とは別の形で同じ機能を提供しているらしい。SGLang 側の判定は GB10 を誤って弾くので、環境変数でバイパスする必要がある(§2-5)。
6-2. 最初のリクエストを投げた瞬間、サーバが消える
こう見えたらこれを疑う
/model_info は 200 を返すのに、最初の chat completions を投げた直後にプロセスが消滅する。Python のトレースバックが一切出ない。 journalctl -k を見て、同時刻に nvcc / cicc / cudafe++ が大量に並列実行されていないか確認してほしい。当ラボの事例では 44 個走っていた。
何が起きているか
ホストメモリを使い切っての強制終了である。犯人は CUDA の JIT コンパイラだった。SGLang には --disable-flashinfer-autotune があるが、これが止められるのはモデルロード直後の明示的な autotune だけである。実際のリクエストが来て初めて必要になるカーネル(入力の形や型に依存する)のコンパイルは、これでは防げない。当ラボの観測では、コンパイラ 1 本が 1.6〜9.9GB を使い、それが同時に何本も走る。
対処
MAX_JOBS=2 を設定して、JIT の並列コンパイル数を抑える。
6-3. 起動が Initialization failed. warmup error: で自壊する
こう見えたらこれを疑う
エラーの末尾に read timeout=600 と出ていないか。そして、--watchdog-timeout を伸ばしても直らないなら、これである。
何が起きているか
SGLang は起動の最後に、自分自身に対してウォームアップのリクエストを 1 本送る。このリクエストのタイムアウトが requests.post(..., timeout=600) とハードコードされている。Flash-Next のように起動時の JIT コンパイルが長引くモデルでは、この 600 秒に間に合わない。サーバは正常に動こうとしているのに、自分自身への待ちに耐えきれず自壊する。
--watchdog-timeout はまったく別のもの(forward batch の無進捗を検知する仕組み)なので、いくら伸ばしても効かない。当ラボはここで 1 回分の起動時間を無駄にした。
対処
SGLANG_WARMUP_TIMEOUT=3600 を設定する。
6-4. 2 回目以降の起動だけ、やたら遅い
こう見えたらこれを疑う
初回は数分で起動したのに、2 回目から 30 分〜1 時間かかるようになった。サーバログの PLE table: X/Y shards already on disk を見て、copied が 0 でないなら、これである。
何が起きているか
PLE のバッキングファイルへの再書き込みが走っている。空のスパースファイルに初めて書くのは速い(実測 7.8 分)が、すでに中身が入ったファイルに上書きすると極端に遅くなる(最悪 53 分)。SGLang 本家もこの挙動を既知の注意点として記載しており、「起動前に古いファイルを消すこと」と案内している。
当ラボは最初、この 53 分を「Flash-Next はロードに 1 時間かかるモデル」だと思い込んでいた。実際には、同じファイルに書き直し続けていただけだった。
対処
2 つある。
-
本家の案内どおり、起動前に
ple_table_*.binを消す。 毎回まっさらから書くので 7.8 分で済む。ただし消し忘れると 53 分に戻る - 書き直し自体を省く。 ファイルの中身を照合して、既に正しい内容が入っていれば書き込みをスキップする。当ラボはこの方式を採り、2 回目以降も 7.1 分を維持している(§2-4 のパッチ)
なお 1 と 2 の差はわずか 44 秒である。**このパッチが効いているのは「初回を速くすること」ではなく、「53 分という最悪ケースを踏まないこと」**だという点は、正確に書いておきたい。
6-5. まとめ — 3 つの壁
振り返ると、当ラボがぶつかった本質的な壁は 3 つだった。どれも当ラボが参照した公開レシピには書かれていなかった。
| 壁 | 症状 | 対処 |
|---|---|---|
| ドライバの種別 |
illegal memory access が無関係な場所で出る |
open ドライバへ |
| JIT の並列コンパイル | 最初のリクエストでサーバが無言で消える | MAX_JOBS=2 |
| ウォームアップの 600 秒 | 起動が warmup error で自壊 |
SGLANG_WARMUP_TIMEOUT=3600 |
そして 4 つ目として、PLE ファイルの書き直し(53 分の正体)がある。これは本家が注意書きとして公開しているので、厳密には「書かれていない壁」ではない。ただし起動ログを読まないと気づけないので、実質的には同じ難しさがあった。
おわりに — 当ラボについて
筆者は NPO法人 IoTメディアラボラトリーで、IoT 研究とあわせて AI 分野の検証を担当しています。東京大学・本郷キャンパス 大学院工学系研究科のラボで行っていた IoT 研究が独立し、研究機関として活動を続けている組織です。
やっていることは、本記事のようなローカル LLM の実機検証が中心です。新しいモデルが出るたびに手元のハードで動かし、速度・日本語知識・コーディング・マルチモーダルの 4 軸で測り、動かなければ原因を突き止めるところまでやります。ベンダーの公称値ではなく、実際に自分の機械で何が起きるかを知りたいからです。
そのぶん、計算資源はいくらあっても足りません。もっと GPU が欲しい(笑)。機材の提供、検証のご依頼、共同研究など、お声がけいただけると喜びます。