
「あなたはもう試した?判断特化AI『Jev』で遊ぼう!」への参加記事です。テーマのうち「Jev と生成AI(LLM)を組み合わせた活用法」と「判断特化AIを触ってみた事例」に当たります。
やった事をまとめると、こうです。自分が実際に下した「この課題は続けるか閉じるか」の裁定21件を正解にし、Jev に同じ判断をさせ、渡し方を4回変えた。最後に Claude Haiku 5.5 にも同じ問いを渡した。
本記事の実測は 2026-10-12 に東京の Windows マシン1台から、21件を各1回ずつ 試したものです(モデルは jev-1.13.0)。正解の「閉じる」は4件しかありません。「この題材ではこう出た」以上の主張はしません。
登場人物を先に決めておきます。 「私」は人間の側です。AI 側は役割が違うので、モデル名で書き分けます——Jev(TypeSafe AI の判断モデル)、Claude Opus 5.5(Claude Code の本体。実験の実行・ログの集計・この記事の下書きを担当)、Claude Haiku 5.5(Claude Code のサブエージェントとして、「探す役」と「判断する役」を担当)。
Jev には、判断の材料(State)と型の決まった問いを渡します。問いの型は、キャンペーンのページにあるとおり Choice(分類)・Score(採点)・Noul(真偽)で、答えは確信度つきで返ります。
先に結論
| # | 分かった事 |
|---|---|
| 1 | 東京から 130〜300ms。 接続を使い回すと約 130〜250ms、新しく接続すると約 300ms。公式の「70〜500ms」の範囲に入り、techarm さんの大阪からの中央値 238ms(p50) とも近い |
| 2 | 課題の本文をそのまま渡すと、「閉じる」を 0/4 しか当てられなかった。 閉じる根拠が、渡した本文の外にあったから |
| 3 | 「探す役」と「判断する役」に分け、問いを作り直すと 4/4 になった。 問いは主張の向きに触れない形にし、「全部書かれているか」と「一部が書かれているか」に分けた(どの変更が効いたかは切り分けていない) |
| 4 | 試した3つの版の中では、問いを英語にし、データを日本語のままにした時が一番良かった(18/21)。techarm さんの記事と同じ傾向 |
| 5 |
同じ材料と問いを Claude Haiku 5.5 に渡すと 19/21。 正しさは Jev と同じ位で、外し方が違った。確度ラベル [Fact] を付けた答えは9件全て当たった |
| 6 | 「探す役」に判断しないよう頼んでも、探す途中で判断が済んでしまっていた |
速いのは判断の部分で、当たり外れを決めたのは、State と問いを作る側(人間か、その手前の仕組み)でした。
構成
題材: 自分の「課題一覧の棚卸し」
題材は、私が運用している AI駆動開発(AIDD)の実践ガイド の課題一覧(BACKLOG.md)です。2026-10-08 に、私は項目を1件ずつ開いて「続ける」か「閉じる」かを裁定しました。今回はそのうち21件を使います。
| 私の裁定 | 件数 |
|---|---|
| 続ける | 17 |
| 閉じる | 4 |
閉じた4件のうち3件は、項目に「本ガイドにはまだ無い」と書いてあったのに、実際には本文にもう入っていた、という理由です。残る1件も、提案していた追記がもう済んでいました。つまり、閉じる根拠は項目の本文の外(ガイド本体)にありました。 これが後で効いてきます。
開発の過程の判断に Jev を挟んだ例として、watany さんの grill-jev(要件定義の一問一答の一次評価を Jev にさせる)が先にあります。そこでも、残す記録に「Jev の高確率回答で人間の承認を代替しない」と書かせています。本記事は向きが逆で、既に私が下した裁定を正解にして、Jev の判断と突き合わせるものです。
正解が「続ける」に偏っているので、全部「続ける」と答えても 17/21 になります。見るべきは閉じる4件を当てられるかです。
実測1: 速さ
Python の標準ライブラリで API を叩き、time.perf_counter() で1回ごとの往復を測りました。
| 条件 | 時間 |
|---|---|
| 接続を使い回して5回×2(英語の例文) | 155〜247ms(中央値 188〜195ms) |
| 接続を使い回して5回(同じ例文の日本語訳) | 183〜199ms(中央値 188ms) |
新しい接続で1回(curl の -w) |
DNS 26ms・TCP 35ms・TLS 107ms・最初の1バイト 302ms |
| 課題21件・4問ずつ(後述) | 152〜254ms(中央値 178ms) |
| 主張と抜粋・1〜2問ずつ(後述・147回) | 130〜225ms(中央値 156〜163ms) |
日本語にしても、問いを4つにしても、時間は殆ど動きませんでした。
応答は Cloudflare の東京の拠点(CF-RAY …-NRT)を通っていて、サーバー側の処理時間を示すヘッダーはありません。測れるのは「このマシンから見た往復の時間」までで、推論の時間だけは切り分けられません。
他の方の数字と並べるとこうなります。測った日も場所も違うので、違いの理由は分かりません。
| 出どころ | 場所・日付 | 時間 |
|---|---|---|
| 公式ブログ | (評価は主に西海岸のノート PC から、と別の段落に注記) | 70〜500ms |
| techarm さん | 大阪・2026-09-19 | 中央値 238ms(p50) |
| mizchi さん | 日本・記事は 2026-09-18(測った日の記載なし) | 500〜600ms |
| 本記事 | 東京・2026-10-12 | 130〜300ms |
単位で一度つまずきました。 下書きの段階で、AI がこちらの「0.16〜0.3 秒」と他記事の「238ms」を並べて「大きく違う」と書いていたのを、私が「単位が違う」と指摘して直しています。
もう1つ。同じ入力を5回送ると、答えは小数第2位で揺れました。 英語では担当部署の Choice の確率が 0.79〜0.85 で揺れ、苛立ちの Score(1.0)と急ぎの Noul(0.99)は揺れませんでした。日本語では逆に、Choice(0.99)は揺れず、Score(0.99〜1.01)と Noul(0.98〜0.99)が揺れました。1か0に張り付いていない答えのほうが揺れると読んでいます(5回ずつの観察です)。taka_yayoi さんも「同じ入力でも判定が変わることがある」と書いています。
実測2: 課題の本文をそのまま渡したら、0/4
最初は素直に、項目の本文をそのまま State にして、4つの問いを同時に投げました。
- 「この項目が提案している作業は、本文の中で『済んだ』と述べられているか」(Noul)
- 「本文に、まだ済んでいない作業が書かれているか」(Noul)
- 「本文は、中身を別の項目へ移したと述べているか」(Noul)
- 「進み具合」(Score)
判定の規則は送る前に決めました(「まだ済んでいない作業」が 0.5 未満で、「済んだ」か「移した」が 0.5 以上なら閉じる)。
結果は 17/21 で、閉じる4件は 0/4。 全部「続ける」と答えたのと同じです。「まだ済んでいない作業が書かれているか」が、21件全てで 0.88〜0.98 と高く出ました。
理由は単純で、閉じる根拠が本文の外にあったからです。Jev は渡された State の中だけで判断します。公式の Jev 1.13 jaggedness(.md)にも、「決定に関係のない内容が多い State」は苦手で、先に絞って問いに必要な部分だけを送るようにと書いてあります。306〜3,758字の項目を丸ごと渡したのは、まさにそれでした。
TypeSafe のドキュメントは、URL の末尾に .md を付けると Markdown で取れます(AI に読ませる時に便利です)。本記事では、人間向けのページと .md を並べて載せています。Anthropic の公式ドキュメント(platform.claude.com)も同じです。
実測3: 「探す役」と「判断する役」に分けたら、4/4
公式の Cookbook に、丁度良い手本がありました。引用の検証(.md)は、引用が原文にあるかをコードの文字列照合で探し、残ったものだけを Choice で判断させます。これに倣って、役を2つに分けました。
- 探す役(Claude Haiku 5.5): 項目ごとに、「本ガイドにはまだ無い」と述べている主張を1文にし、ガイド本体(commit を固定)から関係する箇所を原文のまま抜き出す。判断はさせない
-
判断する役(Jev):
{claim, section}を State にして答えさせる
そこから問いを3回作り直しました。
| 版 | 問い | 一致 | 閉じるを当てた | 誤って閉じた |
|---|---|---|---|---|
| 本文だけ | 上の4問 | 17/21 | 0/4 | 0 |
| A | Choice「抜粋は主張を支持する/否定する/触れていない」(日本語) | 14/21 | 2/4 | 5 |
| B | Noul「主張の中身がすべて書かれているか」「一部が書かれているか」(日本語) | 17/21 | 3/4 | 3 |
| C | B と同じ問いを英語で、データは日本語のまま | 18/21 | 4/4 | 3 |
A で外れた理由の1つは、主張の向きでした。 探す役が書いた主張は、大半が「〜がまだ無い」の向きでしたが、1件だけ「〜を追記する」の向きで、Choice の「支持する」の意味が逆になっていました。B では問いを主張の向きに触れない形(「主張が話題にしている中身が書かれているか」)にして、これを避けました。
A から B では、問いを3つ同時に変えています(Choice を Noul に/主張の向きに触れない形に/「全部」と「一部」に分けた)。どれが効いたかは切り分けていません。観察として言えるのは、私が「続ける」にした項目の中には、本文に一部は入っているけれど残りがあるから続けたというものが多く、A ではそれが「既にある」に寄って誤って閉じていたのが、B では「一部はあるが、全部ではない」として「続ける」に戻ったという事です。
入力の形が結果を決めるという話は outcast_zari さんの記事が題名にそのまま書いています。本記事は、人間の実際の裁定を正解として、0/4 から 4/4 という数で確かめた事例という位置づけです。
実測4: 問いの言語
B と C の差は、問いの言語だけです。試した3つの版の中では、問いを英語にし、データを日本語のままにした時(C)が一番良くなりました。 これは techarm さんの記事の「落ちるのはデータではなく質問文の言語」「質問文と選択肢は英語、データは日本語のまま」と同じ傾向です。本記事の実験は21件・1回ずつなので、「同じ傾向が出た」以上の事は言えません。
問いもデータも英語に訳した版(探す役が訳したもの)も試しましたが、13/21 でした。訳文の質が混在するので、言語の比較には使っていません。
実測5: 同じ問いを Claude Haiku 5.5 に渡す
最後に、「Jev のような判断」を Claude Haiku 5.5 にさせてみました。
ここで1つ決めた事があります。Jev 互換の応答(確率の JSON)は真似しない。 TypeSafe 公式にも、普通の LLM の API で Jev の呼び出しを置き換え、Jev と LLM を比べる為の互換層(System One Adapter)がありますし、suwa_nobu さんの比較では Haiku 5.5 に確率を JSON で答えさせています。私の目的は「速い一次判断を、文脈を知らない目でさせる事」で、互換の形はその為の手段(HOW)に寄り過ぎると考えました。そこで返答は Markdown にし、「はい/いいえ」に確度ラベルを添える形にしました。
-
[Fact]: 抜粋に書いてある事を、そのまま確かめて答えた -
[Judgment]: 抜粋を読んで判断した(書き方が違う、範囲の解釈が要る、など) -
[Assumption]: 抜粋だけでは確かめられず、推測で答えた
呼び方はこうです。Claude Code のサブエージェントを1項目に1本、21本並べて立て、依頼文の中に主張と抜粋だけを入れ、ツールを使わせず、セッションの文脈を渡さずに答えさせました。 1本にまとめると項目同士が影響しうるので、Jev の「問いは互いに独立」に合わせています。
| Claude Haiku 5.5(日本語の問い) | Jev(B・日本語の問い) | Jev(C・英語の問い) | |
|---|---|---|---|
| 一致 | 19/21 | 17/21 | 18/21 |
| 閉じるを当てた | 3/4 | 3/4 | 4/4 |
| 誤って閉じた | 1件 | 3件 | 3件 |
| 1件あたりの時間 | 中央値 5.5 秒(サブエージェントの起動を含む) | 約 160ms(API の往復) | 約 160ms(API の往復) |
Haiku に渡した問いは B と同じ日本語です。
正しさは同じ位で、外し方が違いました。 C で Jev だけが誤って閉じた2件は、抜粋に「他のレビュー系の Skill がある」「別の文書を指す行がある」と書いてあったものでした。公式の jaggedness が最初に挙げる「字義通りに読む」に当たると私は見ています。Haiku はこの2件を外しませんでした。逆に、Haiku だけが外した1件(閉じるべき項目)を、Jev(C)は当てています。もう1件は両方とも外しました。
この21件では、確度ラベルが外れの目印になりました。 Haiku が [Fact] を付けた9件は全て当たり、外れた2件はどちらも [Judgment] でした。[Judgment] が付いた答えだけを人が見直せば、外れを拾えた事になります。kikuziro さんの記事は、Haiku 5.5 に番号だけを返させる使い方の注意として「確信度が付かないので、迷った判断だけ人に回すことはできない」と書いています。確度ラベルを添えさせる形は、その穴の埋め方の1つになりそうです(21件・1回ずつの観察です)。
費用(単価は 100万 tokens あたり。Haiku は Anthropic の料金ページ(.md)の、2026-10-13 時点の値)
| Jev | Claude Haiku 5.5 | |
|---|---|---|
| 入力 | $0.042 | \$0.10(プロンプトが10万 tokens を超えると $0.50) |
| 出力 | 無料 | \$0.50(同 $2.50) |
| キャッシュの読み込み | — | \$0.01 |
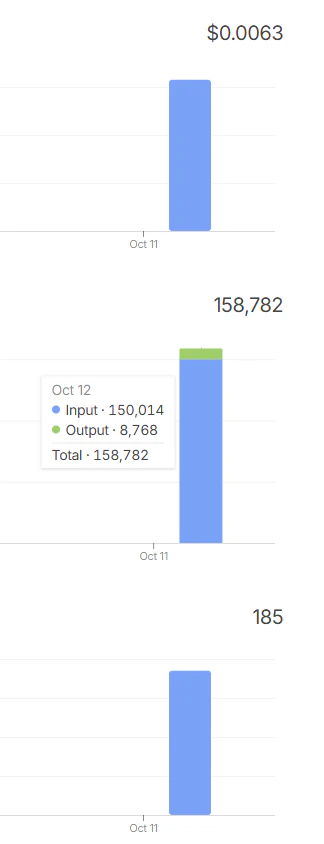
| この記事で実際に払った額 | $0.0063(185回。コンソールの表示) | 0円(Claude Pro のサブスクリプションの枠の中で走らせた) |
| API の料金に換算すると | — | 約 \$0.09〜0.10(21回。1回あたり約 $0.0045) |
時間も費用も、同じ物差しでは比べていません。 Haiku の時間はサブエージェントの起動を含み、Jev は API の往復だけです。Haiku の費用は API の料金としては払っておらず、上の換算は、Claude Code の実行ログ(transcript)に残った tokens の数に公式の単価を当てた値です。1回あたり約4万 tokens の入力の大半は、サブエージェントを立てる度に渡される Claude Code の指示で、判断の材料(主張と抜粋)の分は一部です。API を直接呼べば、この分はかかりません。
おまけ: 探す役は、頼んでいないのに判断していた
探す役の Haiku には「判断しない。探して抜き出すだけ」と頼みました。返ってきた抜粋に判断の言葉は入っていませんでしたが、報告の「迷ったこと」に、こう書いていました。
項目の前提と版が合っていない可能性があります。
f0d209b には
01行 133〜135(AZ)と行 115〜116(B)に同じ内容があります。
閉じる4件のうち3件は、この報告を読むだけで当てられました。 役割を分けても、「関係する箇所を探す」という作業の中で、判断は殆ど済んでしまう。Jev が速く正しく答えられたのは、探す役が正しい抜粋を選んだ結果でもあります。
⇒ 速い判断の手前には、遅い仕事(何を State に入れるかを決める・主張の向きをそろえる・全部か一部かを分ける)があり、当たり外れはそこで決まっていました。 Jev はその遅い仕事を代わりにはしてくれません(公式の jaggedness(.md)も、間接の多い「System Two のタスク」は避けるようにと書いています)。代わりに、遅い仕事さえ済んでいれば、1件 200ms 弱・ほぼタダで答えてくれます。
計測方法(再現用)
-
Jev:
POST https://api.typesafe.ai/v1/systemone(API reference(.md))。Python のhttp.clientで接続を使い回し、1回ごとにtime.perf_counter()で測りました -
料金: 応答の
usage.input_tokensを足し上げて単価をかけると、Jev のコンソールの表示(185 requests・入力 150,014 tokens・$0.0063)と一致しました。本記事の Jev の呼び出しは全部でこの $0.0063 です
-
Claude Haiku 5.5: Claude Code の Agent ツールで
model: haikuを指定(transcript のmessage.modelはclaude-haiku-5-5)。判断する役は21本とも、ツールを1回も呼んでいません -
正解: 2026-10-08 に私が下した裁定。ガイド本体は commit
f0d209bの時点の版を使いました
まとめ
- Jev は東京から 130〜300ms で答え、公式の範囲通り速かった。 日本語でも、問いを増やしても、時間は殆ど変わらない
- ただ、課題の本文をそのまま渡すと「閉じる」を 0/4 しか当てられなかった。 根拠が State の外にあったから
- 探す役と判断する役に分け、問いを「全部/一部」に分け、問いを英語にすると 4/4 になった(どの変更が効いたかは切り分けていない)
-
同じ材料なら Claude Haiku 5.5 も同じ位正しく、外し方が違った。 この21件では、確度ラベル
[Fact]は全部当たり、外れは[Judgment]に集まった - 当たり外れを決めたのは、速い判断の手前の遅い仕事だった
この記事の作り方について。 実験の実行と本文の下書きは Claude Opus 5.5 に任せています。但し数値は全て API の応答とセッションのログから機械的に集計したもので、何を載せ何を落とすか、どの問いを試すかは私が決めました。下書きの単位の取り違え(秒と ms)に気づいたのも私です。
参考
- あなたはもう試した?判断特化AI「Jev」で遊ぼう!(キャンペーン)
- Introducing System One Models & Jev(TypeSafe 公式ブログ)
- System One Adapter(TypeSafe 公式・GitHub)
- Pricing(Anthropic 公式)(.md)
- TypeSafe のドキュメント: Primitives(.md)・Jev 1.13 jaggedness(.md)・Double-checking citations(.md)・Parallel questions(.md)・Models(.md)
- Jevは日本語で使えるのか。落ちるのは「データ」ではなく「質問文」だった(techarm)
- Jevを「読む前に捨てる門番」と「人が書く if 文」として…(outcast_zari)
- Jev 互換の判断AI「Clef」と Haiku 5.5 に同じ分類を306問(suwa_nobu)
- Claude Haiku 5.5 は判断特化モデルの代わりになるのか?(kikuziro)
- Jev は LLM ジャッジに使えるか、紛らわしい誤答72件で確かめた(taka_yayoi)
- Jevでハーネスエンジニアリング(watany)
- 既存の LLM が CPU なら、Jev はその GPU 版みたいなやつ(mizchi)
- 高速判断AI Jevのユースケースとオープン実装を雑にまとめる(karaage0703)
- LLMの193倍速い"判断だけのAI" Jev —— 「型安全」は判断の正しさを保証するのか(BugiAK)
出典