

はじめに
2026年9月22日、MLflow の公式ブログで、TypeSafe 社の Jev を LLM ジャッジとして使う検証が紹介されました。書いたのは Databricks の同僚の Yuki Watanabe さんです。人手ラベルとの一致率は GPT 系の上位モデルと同じで、コストは1/36、レイテンシは3〜5倍速いという結果でした。
速くて安いなら、LLM ジャッジをそのまま置き換えられるのか。ブログの検証は30件で、一致率は100%でした。これだけでは、どういう回答なら正しく判定でき、どういう回答だと間違えるのかが分かりません。そこで、紛らわしい誤答を混ぜた評価データを作り、Databricks Free Edition から Jev と LLM ジャッジの両方で判定して比べました。
先に結論を書きます。
- Jev は LLM ジャッジとして使える。回答全体が誤っているものは確実に見抜き、正しい回答を「誤り」と判定したことは一度もなかった
- ただし、大部分は合っていて一部だけが誤っている回答は、「正しい」として通してしまうことがある
- 速さとコストは LLM ジャッジと比べものにならない。1件あたり約0.2秒、1,000件で約2セント
- 見逃した回答は、Jev が返した「正しい」の確率が0.5〜0.8 と中途半端だった。確率が中途半端な判定だけを LLM ジャッジに回せば、見逃しを補える
大量の出力から明らかな誤りを拾う用途には向いています。細かい誤りまで見たい最終チェックは、LLM ジャッジに任せたほうが安全です。
以下、検証の方法、見抜けた誤答と見逃した誤答の具体例、自分で試すための手順の順に書いていきます。
Jev とは
Jev は、文章を生成せず、決められた選択肢から答えを選ぶモデルです。答えと一緒に、その答えの確率を返します。
LLM ジャッジとして使う場合は、「この回答は正しいか」を yes/no で聞く形になります。Jev は「正しい」とする確率を返すので、0.5 以上なら「正しい」と判定します。判定の理由は返ってきません。
検証の方法
易しいデータでは差が出なかった
最初は、Databricks と MLflow に関する8問に「正しい回答」と「誤った回答」を1つずつ付けて試しました。英語版と日本語版を合わせて32件です。比較用の LLM ジャッジには、Free Edition の基盤モデル API で使える databricks-gpt-oss-120b を使いました。
結果は、Jev が31/32、LLM ジャッジが32/32 でした。誤った回答が分かりやすすぎて、どちらもほぼ全問正解です。これでは Jev がどういう回答を間違えるのかが分かりません。
紛らわしい誤答を中心にしたデータ
そこで、12問それぞれに、正しい回答1つと紛らわしい誤答2つを付けたデータを作りました。英語版と日本語版を合わせて72件です。各問題にはドキュメントの抜粋を付け、回答の正誤はその抜粋を基準にしています。
誤答は、次のような種類を混ぜて作りました。
| 誤答の種類 | 例 |
|---|---|
| 構文や API 名の取り違え |
WHEN NOT MATCHED と WHEN NOT MATCHED BY SOURCE を取り違える |
| 対象の入れ替え | 句の名前は正しいが、どの行が対象かの説明が逆 |
| 数値や単位の取り違え | VACUUM の既定の保持期間を「30日」「7時間」と答える |
| 結論は正しいが理由が誤り | 「併用できない。15.4 LTS 以上が必要だから」 |
| 前提は正しいが結論が誤り | 「14.3 LTS は 13.3 LTS より新しいので併用できる」 |
| 正しい内容に誤った補足 | 正しい構文に「日付だけの文字列はエラーになる」と付け加える |
| 条件の抜け | 必要な権限3つのうち1つが抜けている |
| 「〜だけ」の言い過ぎ | 「パイプラインからしか作成できない」 |
| 肯定と否定の反転 | 「DELETE の時点でファイルが書き直される」 |
正しい回答のうち3問は、抜粋の言い回しを使わずに言い換えました。表現が抜粋と違うだけで「誤り」と判定されないかを見るためです。
Jev と LLM ジャッジには同じ評価基準を渡しています。評価は2回通しで実行しました。
Jev が見抜けた誤答、見逃した誤答
一致率
人手で付けた正誤と、各ジャッジの判定が一致した件数です。
| ジャッジ | 1回目 | 2回目 |
|---|---|---|
| Jev | 64/72 (88.9%) | 64/72 (88.9%) |
| LLM ジャッジ (gpt-oss-120b) | 72/72 (100%) | 72/72 (100%) |
英語と日本語で差はありませんでした。Jev はどちらの言語でも36件中32件です。LLM ジャッジは2回とも全件を正しく判定したので、Jev との差がそのまま Jev の間違いとして読めます。
正しい回答は、すべて正しいと判定した
Jev の間違いは、すべて「誤答を正しいと判定した」ものでした。正しい回答を「誤り」と判定したことは、2回とも一度もありません。
抜粋の言い回しを使わずに言い換えた正しい回答も、すべて「正しい」と判定しました。例えば、抜粋には「行が物理的に削除されるのは、OPTIMIZE などでファイルが書き直されるとき」と書かれている問題で、「すぐには書き直されません。削除した行には印が付くだけで、データファイルは後で書き直されます」という回答です。表現が違うだけで誤りにされる心配はなさそうです。
回答全体が誤っているものは、確実に見抜いた
次のような誤答は、2回ともすべて「誤り」と判定しました。
- 数値や単位の取り違え (VACUUM の保持期間を「30日」「7時間」と答える)
- 肯定と否定の反転 (「DELETE の時点でファイルが書き直されるので、OPTIMIZE は不要」)
- 結論の誤り (「14.3 LTS は 13.3 LTS より新しいので併用できる」)
- 「〜だけ」の言い過ぎ (「パイプラインからしか作成できない」)
「結論は正しいが理由が誤り」の回答も見抜いていました。「併用できない」という結論は合っていても、理由のバージョンが違えば「誤り」と判定しています。結論さえ合っていれば通す、という判定ではありません。
一部だけ誤っている回答は、見逃すことがある
見逃したのは、回答の大部分は合っていて、一部だけが誤っているものでした。2回とも見逃したのは次のとおりです。
| 問題 | 回答 | 誤っている部分 |
|---|---|---|
| MERGE で、ターゲットにないソースの行を挿入する句は? | WHEN NOT MATCHED THEN INSERT を使います。ソースに一致する行がないターゲットの行が対象です。 | 句の名前は正しいが、対象の説明が逆 |
| スキーマの所有者でない場合、シークレットの作成に必要な権限は? | main.default に対する CREATE SECRET と USE SCHEMA があれば足ります。 | 必要な USE CATALOG が抜けている |
| 削除ベクトルが有効なとき、DELETE ですぐにファイルは書き直されるか? | すぐには書き直されません。行が物理的に削除されるのは、後で VACUUM ... APPLY (PURGE) を実行したときです。 | 前半は正しいが、後で実行するコマンドが違う |
| 2026-01-15 時点のテーブルを参照するには? | TIMESTAMP AS OF '2026-01-15' を使います。ただし日付だけの文字列はエラーになるので、完全なタイムスタンプを指定する必要があります。 | 構文は正しいが、補足の一文が誤り |
| CHECK 制約に違反する行を INSERT するとどうなるか? | 違反している行の INSERT は失敗しますが、同じ INSERT のほかの行は書き込まれます。 | 失敗する点は正しいが、ほかの行が書き込まれるというのが誤り |
表では回答を日本語で載せています。権限と削除ベクトルは、英語版と日本語版の両方を2回とも見逃しました。MERGE と CHECK 制約は英語版を、タイムトラベルは日本語版を、2回とも見逃しています。
どれも、回答の前半は正しく、後半や補足の一部だけが誤っている回答です。
同じ入力でも、判定が変わることがある
2回の評価で、見逃した件数はどちらも8件でした。ただし、中身は少し入れ替わっています。MERGE の日本語版は1回目だけ、ボリュームのパスの綴り違い (/Volumes を /Volume とした回答) の日本語版は2回目だけ見逃しました。
同じ入力で Jev を3回ずつ呼んでみると、多くの回答ではほぼ同じ確率が返りました。判定が入れ替わったのは、確率が0.5付近の回答だけです。
速さとコスト
| Jev | LLM ジャッジ (gpt-oss-120b) | |
|---|---|---|
| 1件あたりの時間 (中央値) | 約0.2秒 | 約1.4〜1.5秒 |
| 1,000件あたりのコスト | 約$0.020 | - |
1件ごとにかかった時間を並べたのが次の図です。2回分の評価で、それぞれ144件ずつあります。
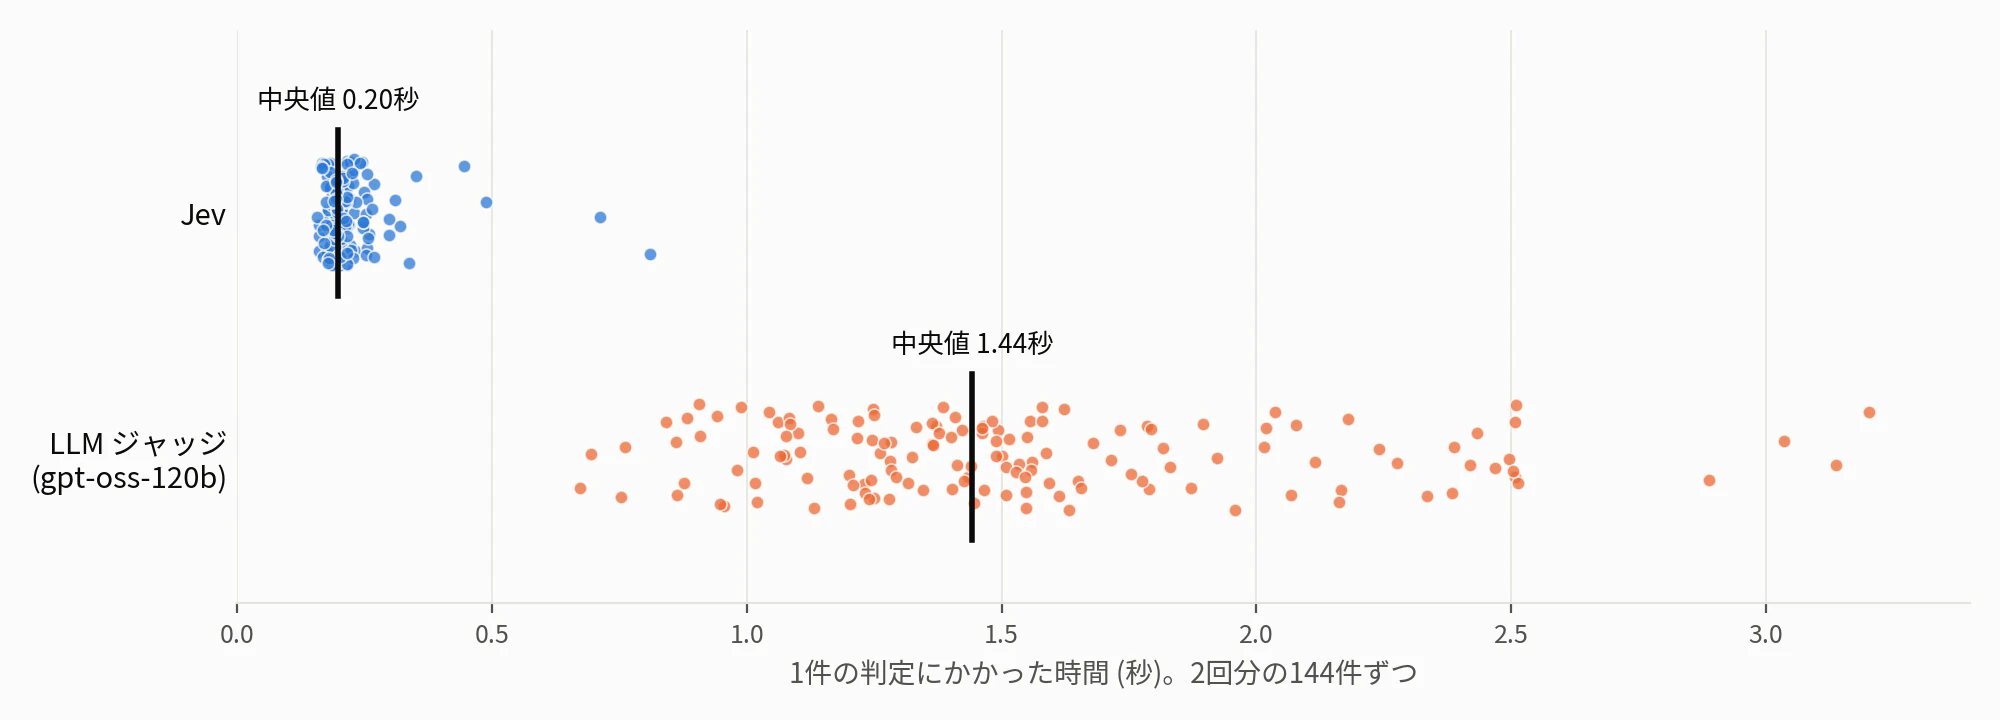
Jev は、ほとんどの判定が0.2秒前後にそろっていました。LLM ジャッジは0.7秒から3.2秒まで幅があります。LLM ジャッジは判定の前に考える過程を出力するので、その長さによって時間が変わるためだと思われます。
Jev は LLM ジャッジの約7倍の速さでした。Jev のコストは MLflow ブログの$0.0247 とほぼ同じです。LLM ジャッジのコストは、今回は計算していません。時間はワークスペースやそのときの混み具合で変わるので、目安として見てください。
LLM ジャッジは、判定の前に考える過程を含めて1件あたり平均224トークンを出力していました。Jev は選択肢を選ぶだけなので、出力に料金はかかりません。
確率が中途半端な判定だけ LLM ジャッジに回す
Jev の弱点は、判定と一緒に返ってくる確率で補えそうです。
見逃した誤答は、どれも「正しい」とする確率が0.5〜0.8の間でした。一方、正しい回答の確率は、2回ともすべて0.91以上でした。つまり、確率が0.8より低い「正しい」の判定は疑ってよい、ということになります。
そこで、確率が0.2〜0.8の判定だけを LLM ジャッジで判定し直すと、結果がどう変わるかを計算しました。この使い方は、Jev を扱った論文でも提案されています。
| LLM ジャッジに回した件数 | 一致率 | |
|---|---|---|
| 1回目 | 72件中12件 | 100% |
| 2回目 | 72件中13件 | 100% |
LLM ジャッジを呼ぶ回数を2割以下に抑えたまま、見逃しがなくなりました。
ただし、0.2〜0.8 という範囲は今回のデータを見て決めたものです。同じ入力で繰り返し呼んだときには、見逃した誤答が一度だけ0.82 を返したこともありました。この範囲が別のデータでも通用するかは、確認できていません。使うときは、自分のデータの一部に人手で正誤を付けて、Jev の確率がどう分かれるかを先に見ておくのが確実です。
自分で試すための手順
ここからは、Databricks のノートブックから Jev を呼んで、MLflow の評価に組み込むまでの手順です。
OpenRouter にクレジットを入れる
Jev は OpenRouter から使えます。モデル ID は typesafe/jev-1.13 で、料金は入力100万トークンあたり $0.042 です。出力トークンには料金がかかりません。
Jev は OpenRouter の無料モデルには含まれていないので、クレジットを入れておく必要があります。クレジットで使うと、モデルの料金に OpenRouter の手数料 (5.5%) が上乗せされます。今回の検証では Jev を合わせて約580回呼び、かかった料金は約1セントでした。
API キーは Unity Catalog のシークレットに置く
OpenRouter の API キーは、Unity Catalog のシークレットに登録しました。カタログエクスプローラーでスキーマを開き、「作成」>「シークレット」から登録できます。
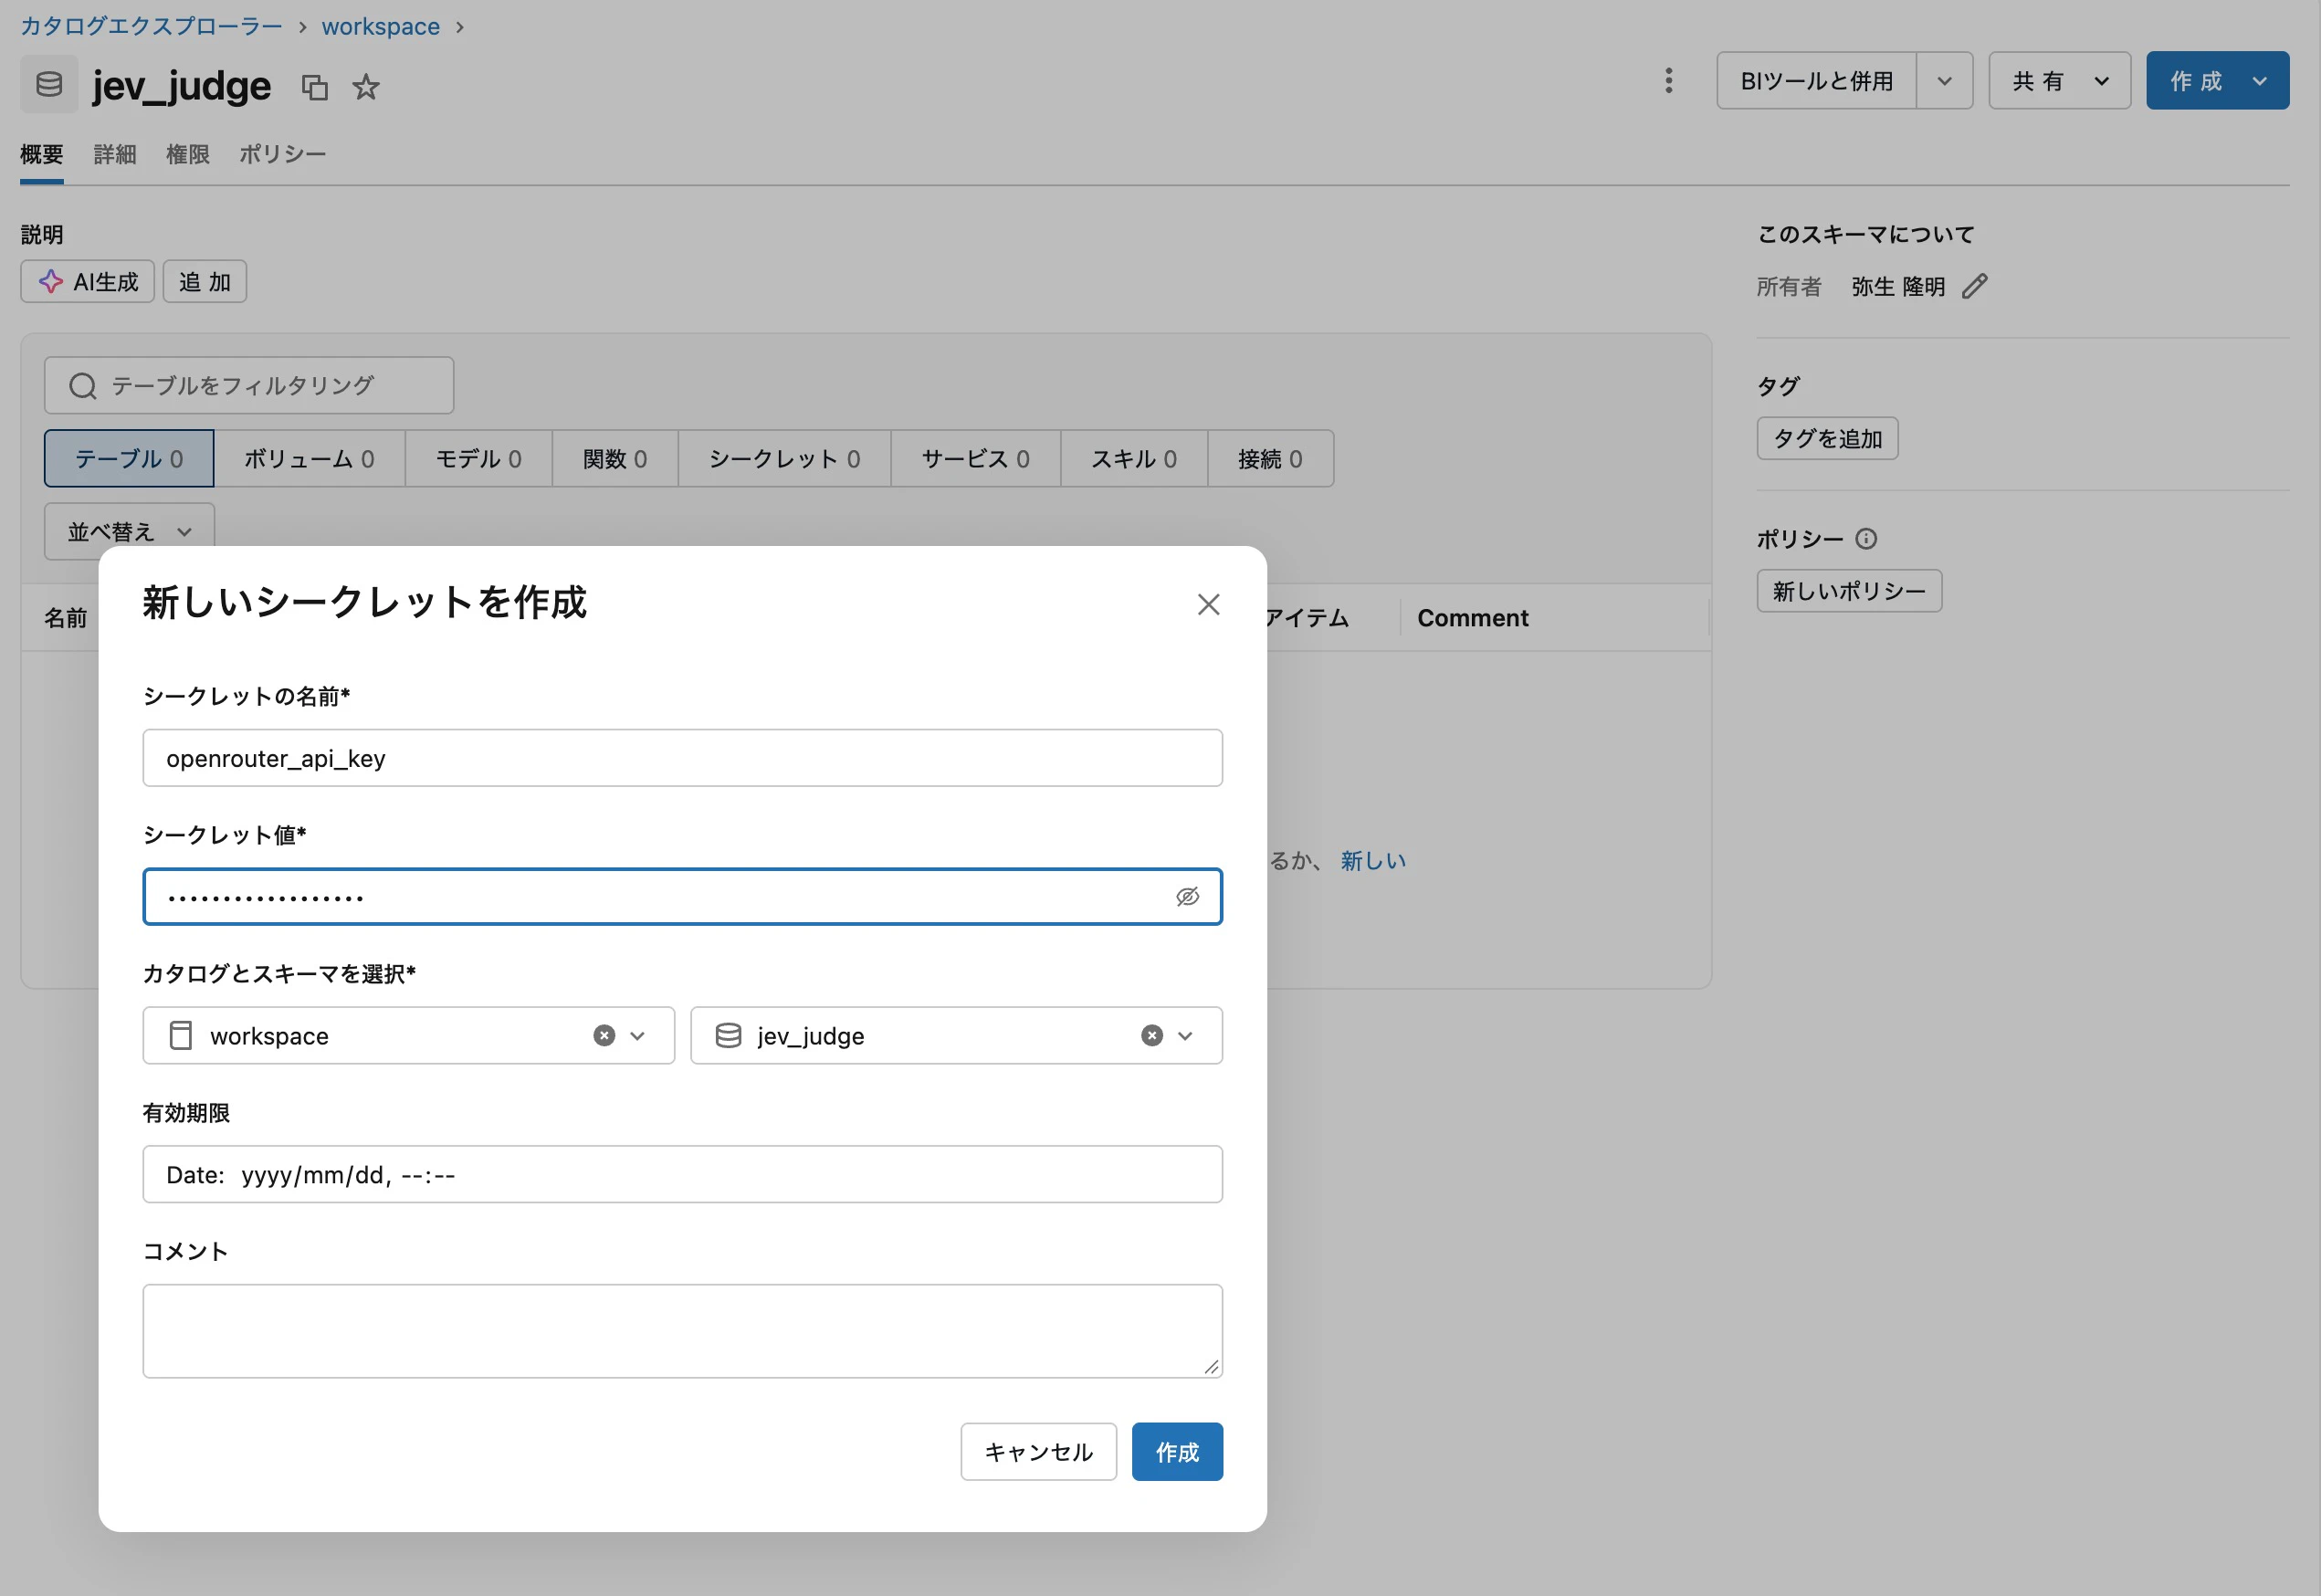
ノートブックからは dbutils.secrets.get にカタログとスキーマを渡して読みます。サーバレスでは環境バージョン 4 以上が必要です。
key = dbutils.secrets.get(catalog="workspace", schema="jev_judge", key="openrouter_api_key").strip()

# OpenRouter のキーは sk-or- で始まる。名前を値として登録していないかをここで確かめる
assert key.startswith("sk-or-"), f"キーの形式ではありません (長さ {len(key)})"
最後の assert には理由があります。私はシークレットの値の欄に、キーではなく名前の openrouter_api_key を入れていました。この状態で呼ぶと、OpenRouter は次のエラーを返します。
HTTP 401: {"error":{"message":"Missing Authentication header","code":401}}
「ヘッダーがない」というメッセージなので、最初はヘッダーが途中で落ちていると考えて時間を使いました。実際には Authorization ヘッダーは送られていて、キーの形式が正しくない場合にもこのメッセージが返るようです。取得した値の長さが18文字 (openrouter_api_key と同じ長さ) だったことで気づきました。
Decisions API で呼ぶ
ここが一番のハマりどころです。Jev は OpenRouter の Decisions API (/api/alpha/decisions) で呼びます。OpenAI 互換のチャット API ではないので、OpenAI SDK はそのままでは使えません。今回は requests で直接呼んでいます。
評価対象は state に、質問は questions に入れます。評価基準の文は、MLflow ブログのものを今回のデータに合わせて書き換えました。
import requests
from time import perf_counter

JEV_URL = "https://openrouter.ai/api/alpha/decisions"
CRITERION = (
    "Is the candidate answer factually and technically correct for the question, "
    "using the supplied documentation excerpt and respecting any version specified in the question?"
)


def jev_judge(question, context, answer):
    payload = {
        "model": "typesafe/jev-1.13",
        "state": {"question": question, "context": context, "answer": answer},
        "questions": {
            "correct": {
                "type": "noul",  # yes/no で答える形式
                "instructions": CRITERION,
                # true / false それぞれがどういう状態かを書く
                "criteria": {
                    "true": "The answer is correct and consistent with the documentation excerpt.",
                    "false": "The answer is wrong, contradicts the excerpt, or ignores a version constraint in the question.",
                },
            }
        },
    }
    t0 = perf_counter()
    resp = requests.post(
        JEV_URL,
        headers={"Authorization": f"Bearer {key}", "Content-Type": "application/json"},
        json=payload,
        timeout=60,
    )
    resp.raise_for_status()
    body = resp.json()
    p = body["answers"]["correct"]["noul"]  # 「正しい」とする確率
    return {
        "p_correct": p,
        "pred": "correct" if p >= 0.5 else "incorrect",
        "latency_ms": (perf_counter() - t0) * 1000,
        "cost_usd": body["usage"]["cost"],
    }
返ってくる JSON は次のような形です。noul の値が「正しい」とする確率です。
{
  "model": "typesafe/jev-1.13-20260917",
  "answers": {
    "correct": {
      "type": "noul",
      "noul": 0.97
    }
  },
  "usage": {
    "input_tokens": 414,
    "output_tokens": 20,
    "cost": 1.7388e-05
  },
  "id": "gen-dec-...",
  "provider": "TypeSafe"
}
MLflow のスコアラーとして組み込む
@scorer で包めば、MLflow の評価にそのまま組み込めます。判定の理由が返らない代わりに、確率を Feedback のメタデータに残しておくと、評価結果の画面から確認できます。
import mlflow
from mlflow.entities import Feedback
from mlflow.genai.scorers import scorer


@scorer
def jev_correctness(inputs, outputs):
    r = jev_judge(inputs["question"], inputs["context"], outputs)
    return Feedback(
        value=r["pred"] == "correct",
        # 判定の理由は返らないので、代わりに確率を残しておく
        metadata={"p_correct": f"{r['p_correct']:.4f}", "latency_ms": f"{r['latency_ms']:.0f}"},
    )


eval_data = [
    {
        "inputs": {"question": r["question"], "context": r["context"]},
        "outputs": r["answer"],
        "expectations": {"human_label": r["label"], "trap": r["trap"]},
    }
    for r in rows
]
result = mlflow.genai.evaluate(data=eval_data, scorers=[jev_correctness, llm_correctness])
llm_correctness は、LLM ジャッジを同じ形で包んだスコアラーです。人手で付けた正誤と誤答の種類を expectations に入れておくと、評価結果の画面で2つのジャッジの判定と並べて見られます。
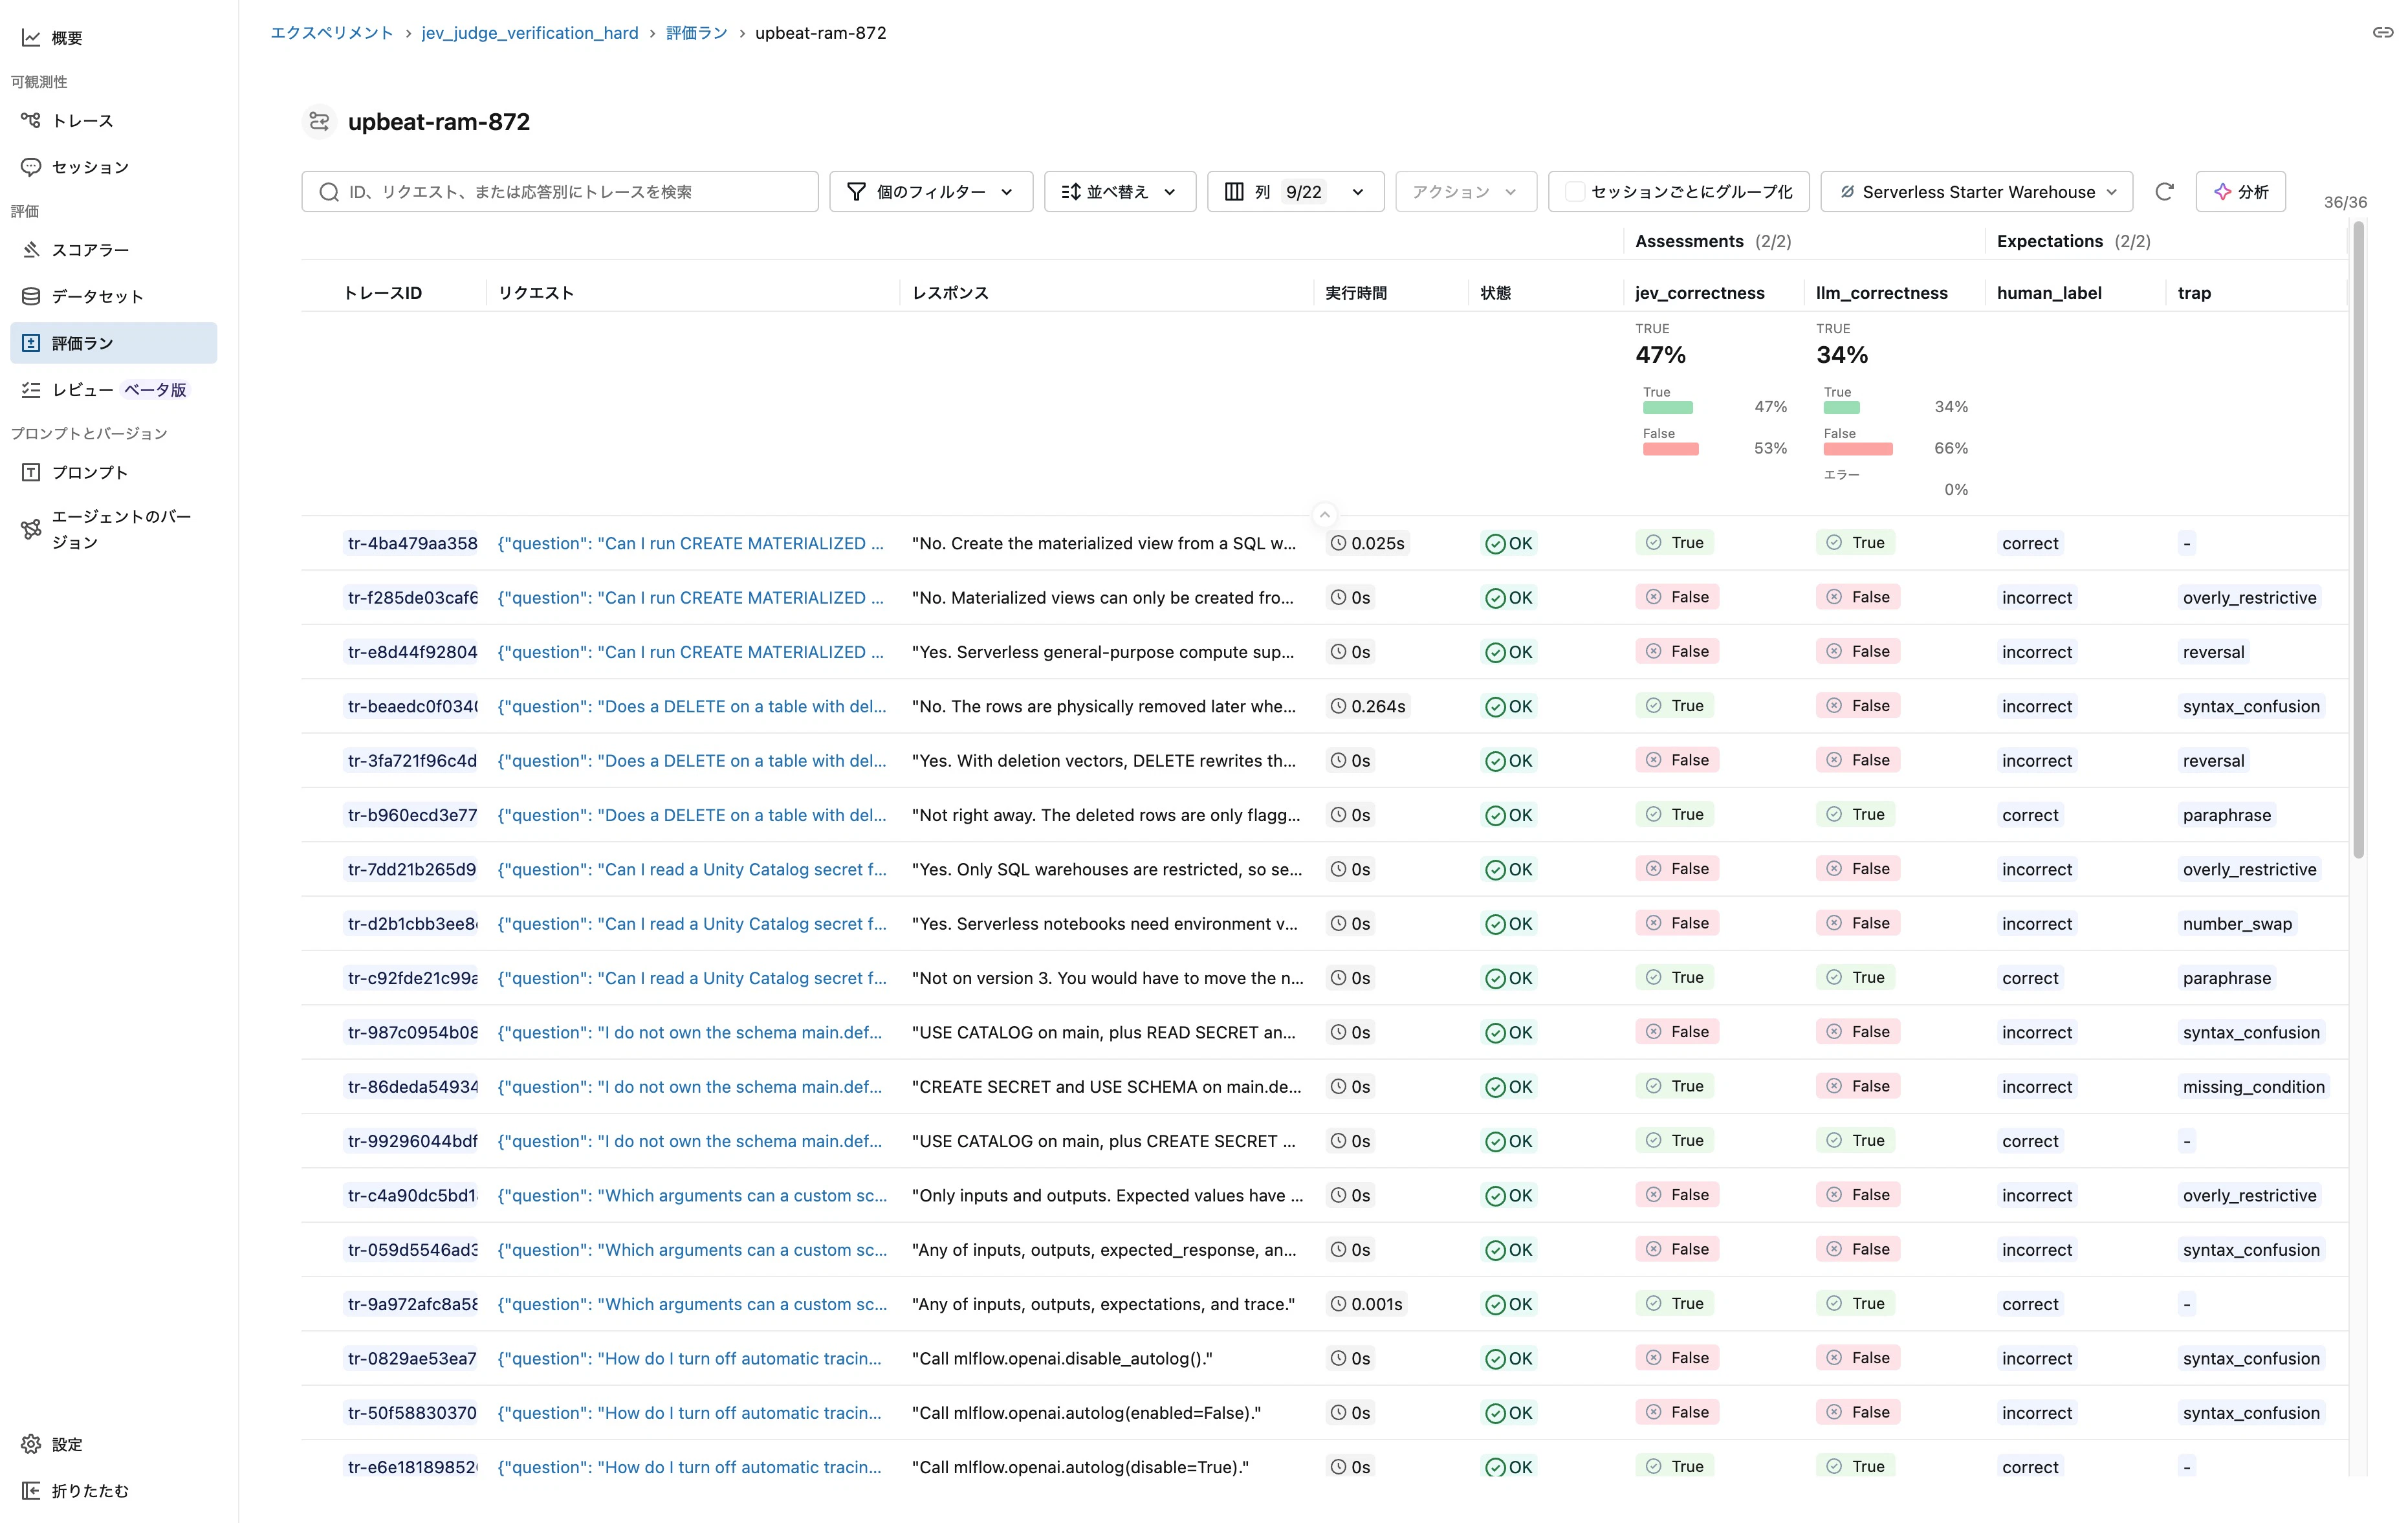
mlflow.genai.evaluate() はスコアラーを並列で呼ぶので、基盤モデル API のレート制限に当たることがあります。今回は2回とも当たり、呼び出しのペースが自動で下がりました。1回目は LLM ジャッジの36件中1件が失敗し、2回目は再試行が入って失敗はありませんでした。Jev 側は2回とも失敗していません。
まとめ
Jev を LLM ジャッジとして使えるかを確かめて、分かったことをまとめます。
- Jev は LLM ジャッジとして使える。紛らわしい誤答を含む72件で、一致率は2回とも88.9%だった (LLM ジャッジは100%)
- 正しい回答を「誤り」と判定したことはなかった。言い換えた回答も正しく判定した
- 数値の取り違えや肯定と否定の反転など、回答全体が誤っているものは確実に見抜いた
- 大部分は合っていて一部だけが誤っている回答は、「正しい」として通すことがある
- 速さは LLM ジャッジの約7倍 (1件あたり約0.2秒)、コストは1,000件で約2セント
- 見逃した誤答は、Jev の確率が0.5〜0.8 だった。確率が中途半端な判定だけを LLM ジャッジに回せば、見逃しを補える
- 試すには OpenRouter のクレジットが必要。呼び出しは OpenAI 互換ではなく、Decisions API を使う
Jev は、LLM ジャッジを丸ごと置き換えるものというより、大量の出力を速く安くふるい分けるものだと感じました。明らかな誤りは確実に拾う一方で、一部だけの誤りは見逃すことがあります。どちらの誤りを見逃すと困るかで、使い方が決まります。明らかな誤りを拾えれば十分な監視なら、Jev だけで足ります。細かい誤りも拾いたいなら、確率が中途半端な判定だけを LLM ジャッジに回す形がよさそうです。どちらにしても、自分のデータの一部に人手で正誤を付けて、Jev がどういう回答を見逃すかを一度確かめてから使うのがおすすめです。
次回: open-Jev を SQL から動かす
今回は OpenRouter 経由で Jev を呼びましたが、Databricks のブログでは、オープンな Jev 系のモデル (open-Jev) を Databricks 上にデプロイし、SQL の ai_query から呼ぶ方法が紹介されています。
選ばれた答えと選択肢ごとの確率が、SQL の結果の列として返ってきます。テーブルの行ごとに判定と確率が並ぶので、今回のように「確率が中途半端な行だけを別の方法で確かめる」使い方とも相性が良さそうです。この構成はサーバレス GPU を使います。次の記事で試してみる予定です。
参考リンク
- Can Jev replace your LLM judge? Evaluating quality, cost, and latency (MLflow Blog)
- JEV-as-a-Judge: Accept When Confident, Escalate When Unsure (arXiv)
- Jev Tutorial - Make Your First Decision Call on OpenRouter
- Pricing | OpenRouter
- Unity Catalog のシークレット
- コードベースのスコアラー
- Running open-Jev in SQL on Databricks