

この記事は「Zoom AI Services を触り倒すシリーズ」の 2本目 です。
1本目で描いた地図のうち、新 API の Speech Summarization と Decisions を、実際にコードで叩いてパイプラインにします。
はじめに:読者の方からの、素敵な問いから始めます
1本目を公開したあと、こんな趣旨のコメントをいただきました。
商談の途中で条件が変わるケース——たとえば一度決めた日程や条件を、後から「やっぱりこうして」と訂正するような会話で、要約や判定は "訂正後" をちゃんと拾えるのか。そして 引用(根拠)も訂正後の発言 を指すのか。あとで会話を参照する用途を考えると、そこが気になる。
これは、AI で会議・商談を処理するときの 核心を突いた問い だと思いました。議事録や要約が「最初に言ったこと」に引きずられて、途中の訂正を取りこぼすと、下流の意思決定が丸ごと狂います。
そこで本記事では、次のパイプラインを実装し、実データで検証 します。
- やること:商談音声を Speech Summarization で要約し、その結果を Decisions に渡して「受注見込み(スコア)」「次のアクション(選択)」などを 型付きで構造化判定 する
-
検証する問い:
- 会話の途中で条件が変わっても、判定は 訂正後の値 を選べるか
- 引用 は訂正後の発言(=その時刻)を指すか
- 日本語の商談音声で、一連の処理が通るか(1本目で予告した事前検証)
素材は 架空の商談音声を2本 用意しました。1本は「値の訂正(日程・契約条件が後から変わる)」、もう1本は毛色を変えて「前提の訂正(判断の前提が途中でひっくり返る)」です。
録音内容はすべて架空です。Claude で架空の商談スクリプトを作り、VoiceStudio で T2S を行ったものをffmpeg でそれぞれ Customer/SalesRep のみの音声に分割し、さらに Zoom Meeting で実際に会議に流し込んで録音したものをベースにしています。
事前検証タスクの結果報告(1本目の宿題)
1本目で「日本語音声で通るか先に確認する」と予告していたので、先に結果だけ。
-
日本語対応:合格 ✅ — 文字起こし・要約・Decisions のすべてを
ja-JPで通して、問題なく動きました。要約は日本語の Markdown で、引用マーカー[^1]付きで返ってきます。 -
モデル:
zoom-decisions(標準)を使用 — Decisions にはzoom-decisionsとzoom-decisions-proがありますが、zoom-decisions-proは執筆時点では準備中 だったため、本記事は標準モデルで通しています。結論から言うと、商談の判定用途では 標準モデルで十分な精度 が出ました。
パイプライン全体像
今回のキモは、Decisions を2経路で流して比較する ところです。
なぜ2経路かというと、冒頭のコメントにあった 「要約すると情報が落ちるのでは?」 を直接検証したいからです。
- 経路A(要約 → Decisions):構造化された要約を入力にする。情報は圧縮されるが、ノイズも減る。
- 経路B(文字起こし → Decisions):生の全文を入力にする。情報は最大だが、ノイズも最大。
同じ質問を両方にぶつけて、答えが一致するか・どこで割れるか を見ます。これが後半の考察で効いてきます。
実装① Speech Summarization(音声 → 文字起こし → 要約)
エンドポイントは POST /v2/aiservices/speech-summarization/summarize。multipart/form-data で config(JSON)と file(音声)を送り、レスポンスは SSE(Server-Sent Events) で返ります。
依存ゼロ(Node 20+ の fetch / FormData / Blob だけ)で書けます。
// config は file より前に append するのがポイント
const config = {
  transcribe: { language: 'ja-JP', diarization: true, profanity_filter: false },
  summary: {
    language: 'ja-JP',
    citations: true,            // 引用(根拠)を付ける
    template_id: 'customer_success', // 商談向けテンプレート
  },
};

const form = new FormData();
form.append('config', JSON.stringify(config));                 // ← 先に config
form.append('file', new Blob([buf], { type }), 'demo-call.m4a'); // ← 次に file

const res = await fetch(
  'https://api.zoom.us/v2/aiservices/speech-summarization/summarize',
  {
    method: 'POST',
    headers: { Authorization: `Bearer ${token}`, Accept: 'text/event-stream' },
    body: form,
  },
);
レスポンスは SSE なので、ストリームを逐次パースします。主なイベントは transcribe_complete(文字起こし確定)、summary_updated(要約の更新。summary_result は累積で届く)、done です。
for await (const { event, data } of parseSSE(res.body)) {
  if (event === 'transcribe_complete') {
    transcript = data.transcript.result.text_display;
  } else if (event === 'summary_updated') {
    summary = data.summary_result;   // 最新で上書き
    citations = data.citations;      // [{ marker, start_time, end_time, ... }]
  }
}
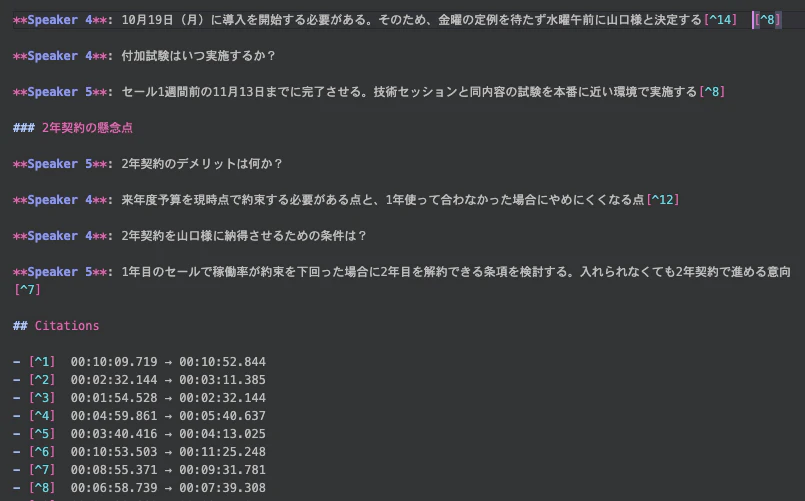
ここで返ってくる要約は、見出し・表・箇条書きで構造化された Markdown です。そして各所に [^1] のような 引用マーカー が付き、citations[] にはそれぞれの 開始・終了時刻 が入っています。この「引用に時刻が付く」のが、今回の検証の裏取りに効きます。
実装② Decisions(テキスト → 型付きの構造化判定)
エンドポイントは POST /v2/aiservices/decisions/decide(同期)。input に判定したいテキスト、questions[] に 型付きの質問 を並べます。型は3種類です。
-
predicate:Yes/No を 確率(0〜1) で返す -
choice:選択肢から1つ選び、各選択肢の確率分布 も返す -
score:レベルに対する 加重スコア+分布 を返す
商談用の質問セット(抜粋)はこんな形です。
{
  "questions": [
    {
      "type": "choice",
      "name": "sale_start_date",
      "instructions": "商談で最終的に合意された『セール初日』はいつか。会話の途中で訂正があった場合は、訂正後(最後に合意された)日付を選ぶこと。",
      "choices": [
        { "value": "nov_27", "description": "11月27日" },
        { "value": "nov_20", "description": "11月20日" },
        { "value": "other_or_undecided", "description": "それ以外、または未定" }
      ]
    },
    {
      "type": "predicate",
      "name": "start_date_was_revised",
      "instructions": "会話の途中で、セール初日の日付が一度述べられた後に、別の日付へ変更・訂正されたか。"
    }
  ]
}
ポイントは instructions で 「訂正があったら訂正後を選べ」と明示 していること。ここの書き方が精度を大きく左右します(後述)。
呼び出し側はシンプルです。
const res = await fetch('https://api.zoom.us/v2/aiservices/decisions/decide', {
  method: 'POST',
  headers: { Authorization: `Bearer ${token}`, 'Content-Type': 'application/json' },
  body: JSON.stringify({ input, questions, model: 'zoom-decisions' }),
});
const { answers } = await res.json();
レスポンスの answers[] に、質問ごとの判定が型に応じて入ります。
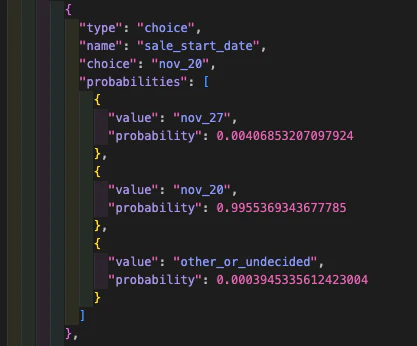
{
  "answers": [
    { "type": "choice", "name": "sale_start_date", "choice": "nov_20",
      "probabilities": [
        { "value": "nov_27", "probability": 0.0004 },
        { "value": "nov_20", "probability": 0.9994 }
      ] },
    { "type": "predicate", "name": "start_date_was_revised", "probability": 0.997 }
  ]
}
検証A:「値の訂正」は拾えるか(商談①)
1本目の音声は、途中で条件が2つ訂正される商談です。
- セール初日:「11月27日」と言った後 → 「誤りで、正しくは1週間前倒しの 11月20日」に訂正
- 契約:「1年契約・年額1,300万円」案 → 最終的に「2年契約・年額1,200万円」で合意(1年案は取り消し)
これを要約し、Decisions にかけた結果がこちらです(要約経由/文字起こし経由)。
| 質問 | 経路A(要約) | 経路B(文字起こし) | 正解 |
|---|---|---|---|
sale_start_date |
nov_20 | nov_20 | ✅ 訂正後 |
contract_term |
two_year_1200 | two_year_1200 | ✅ 訂正後 |
start_date_was_revised |
0.997 | 0.998 | ✅ 訂正を検知 |
next_action |
send_quote | send_quote | ✅ |
訂正後の値(11/20・2年契約)を、要約経由でも文字起こし経由でも、両方とも正しく拾えました。 「訂正があったか?」も 0.99 超で検知しています。
引用の裏取り
要約の「11月20日に前倒し」の記述には引用マーカー [^14] が付いていて、その citations を見ると——
[^14] 00:06:16 → 00:06:58
会話で 実際に日付を訂正したまさにその区間 を指していました。つまり「訂正後の結論」だけでなく「どこでそう決まったか」まで時刻で辿れます。冒頭のコメントの懸念(引用が訂正後を指すか)への答えは Yes です。
検証B:「前提の訂正」は拾えるか(商談②)
2本目は、毛色を変えて 「値」ではなく「前提」がひっくり返る 商談にしました。
- 当初は「暫定構成(月払い・月額58万円)なら担当者決裁で通る」と見ていた
- ところが会話の途中で、経理の 決済基準が「支払総額」ではなく「年額換算」だと訂正 される → 年換算696万円で社長決裁対象に
- 結果、暫定構成は見送り、4月の本契約(年額1,700万円)に一本化する方針へ転換
- あわせて、見積の有効期限は 3月末まで延長 で合意
商談①用とは別に、この会話に合わせた質問セット(provisional_setup_decision ほか)を用意して判定しました。
| 質問 | 経路A(要約) | 経路B(文字起こし) | 正解 |
|---|---|---|---|
provisional_setup_decision |
skip(見送り) | skip(見送り) | ✅ 方針転換後 |
provisional_decision_was_reversed |
0.979 | 0.997 | ✅ 撤回を検知 |
approval_basis_was_corrected |
0.999 | 0.9996 | ✅ 前提の訂正を検知 |
estimate_valid_until |
end_of_march | end_of_march | ✅ 延長後 |
「値の訂正」だけでなく、「前提が訂正されて方針ごと覆る」ケースまで、両経路で正しく拾えました。 特に approval_basis_was_corrected(決済基準の訂正)を 0.999 で検知できたのは、議事録用途として心強い結果です。
おまけ:無い情報は「無い」と答えるか(ハルシネーション耐性)
試しに、商談①用の質問(sale_start_date など)を、まったく別内容の商談②にそのままぶつけてみました。結果は——
| 質問 | 商談②に当てた結果 |
|---|---|
sale_start_date |
other_or_undecided(該当なし) |
contract_term |
undecided(該当なし) |
start_date_was_revised |
0.03(低い) |
質問が内容と噛み合わないときは、無理に答えをでっち上げず「該当なし/低確率」と返してくれました。 型付き質問を使い回す運用でも、誤検知で暴走しにくいということです。
検証C:ヒント(priming)を外しても拾えるか
ここまでの検証A・Bには、実は弱点があります。質問文に 「訂正があれば訂正後を選べ」と書いていた こと。これだと「訂正を拾えた」のか「訂正を探せと指示したから探しただけ」なのか区別がつきません。
そこで、ヒントを一切外した中立版 を用意しました。
-
instructionsから訂正に関する文言を全削除し、ただ 「合意された金額は?」「開始日は?(未定なら未定)」 と素朴に聞くだけにする - 両商談で 共通の中立スキーマ(金額/契約期間/主要日付/プロビジョニング判断/提供Tier/確度/次アクション)に統一する
- 選択肢に 訂正前の値(11月27日・年額1,300万円)もあえて混在 させ、ヒントなしで後者=訂正後を選べるかを見る
結果:ヒントなしでも、訂正後を選んだ
商談①(値の訂正)・中立版
| 質問 | 経路A(要約) | 経路B(文字起こし) | 評価 |
|---|---|---|---|
contract_amount |
y1200 | y1200 | ✅ 1,300万に釣られず訂正後 |
contract_term |
two_year | two_year | ✅ 訂正後 |
key_scheduled_date |
nov_20 | nov_20 | ✅ 11/27が選択肢にあっても訂正後 |
next_action |
send_quote | send_quote | ✅ |
商談②(前提の訂正)・中立版
| 質問 | 経路A(要約) | 経路B(文字起こし) | 評価 |
|---|---|---|---|
contract_amount |
y1700 | y1700 | ✅ |
key_scheduled_date |
apr_1 | apr_1 | ✅ |
provisioning_decided |
0.999 | 0.997 | ✅ |
provisioning_tier |
vpc_dedicated | vpc_dedicated | ✅ 暫定見送り後 |
ヒントを一切与えず、しかも訂正前の値を選択肢に混ぜても、両経路とも訂正後の値(11/20・2年契約・1,200万円)を選びました。 つまり priming は精度の "底上げ" ではあっても "種明かし" ではなく、Decisions は会話の最新状態を地力で追えている と言えます。
ただし中立版では、新しい割れも見えました。これは次の考察でまとめて扱います。
考察:要約 vs 文字起こし、どっちに通すべきか
2経路を比較して、はっきりした傾向が出ました。
事実の抽出は、どちらでも頑健(むしろ要約が有利な場面も)
日付・契約・方針・「訂正されたか」といった 事実ベースの質問は、要約経由でも文字起こし経由でも答えが一致 しました。
それどころか、初期検証で質問が曖昧だったとき、文字起こし経由だけが会話に紛れた無関係な語(例:別件の「来週月曜」)に引っ張られて誤答 し、要約経由は構造化のおかげで正しく弾いた という場面もありました。要約は「情報を落とす」だけでなく、ノイズ除去としても効く わけです。
明示的に言い切られた事実は、instructions に「訂正があれば訂正後を」と書かなくても両経路で拾えました(検証C)。ヒントの明示は精度の "底上げ" にはなりますが、必須ではありません。とはいえ、質問文と選択肢の設計 が精度を左右するのは変わらないので、ここは丁寧に書く価値があります。
もう一つの割れ:言い切られていない事実は、要約が落とすことがある
中立版(検証C)で、新しいタイプの割れが見えました。会話の中で1文で言い切られず、複数の発言に分散している事実 です。
| 質問 | 経路A(要約) | 経路B(文字起こし) | 実態 |
|---|---|---|---|
商談① provisioning_tier
|
undecided | shared | 「共有環境で行く」は確定だが、会話に分散 |
商談② contract_term
|
undecided | one_year | 契約期間は明言されていない |
- 商談①では、「共有環境を採用する」という結論が会話のあちこちに散らばっていて、1文で言い切られていません。要約はこれを圧縮の過程で落とし、"未定" と答えました。一方で文字起こしは
shared(正解)を拾えました。 - 商談②では逆に、契約期間そのものが会話で明言されていません。ここでは 要約の "未定" の方が正直 で、文字起こしは「1年目の金額」という表現から
one_yearと 過剰に推論 しています。
➡️ 整理すると、事実抽出の傾向は次の非対称性で捉えられます。
- 明示・訂正済みの事実(金額・日付など、はっきり言い切られる)→ 両経路で頑健。要約はノイズ除去としても効く。
- 分散・暗黙の事実(Tier・契約期間など、言い切られない)→ 要約は落として "未定" になりやすい(安全側だが取りこぼし)、文字起こしは拾えるが過剰推論のリスク。
分散・暗黙の項目に、どう向き合うか(個人的意見)
「取りこぼし(recall)」と「誤検知(precision)」のトレードオフ 、正解は用途次第だと思います。
-
安全側に倒す(precision 重視) — 要約経由を使い、言い切られていない項目は "未定" のまま受け取る。判定をそのまま自動処理に流すなど、間違った断定を避けたい 用途向き。取りこぼしは後工程の人手レビューで拾う前提にします。
-
ワイルドに攻める(recall 重視) — 文字起こし経由を使い、多少の過剰推論を許容してでも 拾いにいく。ドラフトの下書き・候補出しなど、人が最後に必ず確認する 用途向き。
-
(推奨)項目を分解して、具体的な instructions を書く — 「Tierはどれか」と一発で聞くのではなく、判断に効く 関連項目を複数に分けて 抽出します。たとえば
provisioning_tier(choice)に加えて、dedicated_env_required(predicate:専用環境が必須か)、shared_env_agreed(predicate:共有環境で合意したか)のように分解し、選択肢のdescriptionとinstructionsに 「どんな発言があればどれを選ぶか」の基準 まで書き込みます。こうすると要約・文字起こしのどちらでも精度が上がり、"未定" の取りこぼしも過剰推論も同時に減らせる=トレードオフ自体を小さくできます。手間は増えますが、本番運用で効かせたい項目にはこれが一番効きます。
スコア(主観判断)は割れることがある。そして、その"差"が情報になる
一方で、deal_likelihood(受注見込みスコア、0〜2)だけは挙動が分かれました。しかも、ヒントあり版(A/B)とヒントなし版(C)の 両方で同じ傾向が再現 しています。
| 経路A(要約) | 経路B(文字起こし) | 差 | |
|---|---|---|---|
| 商談①(ヒントあり) | 1.99 | 1.05 | 0.94(大きく割れた) |
| 商談①(ヒントなし) | 1.98 | 1.06 | 0.92(大きく割れた) |
| 商談②(ヒントあり) | 1.99 | 1.99 | ≒0(一致) |
| 商談②(ヒントなし) | 1.98 | 1.99 | ≒0(一致) |
最初は「スコアは入力依存で割れるもの」と考えましたが、2商談 × 2条件で比べて解釈が変わりました。
- 商談① は、解約条項が保留・決裁者の承認待ちなど、未解決の含みが会話に残って いました。文字起こしはその空気まで読んで慎重(1.05)に、要約はそれを均して楽観的(1.99)に振れた。
- 商談② は、基準の訂正も方針も有効期限も その場で決着 していた。だから両方とも高スコアで一致した。
つまり、「要約スコア」と「文字起こしスコア」の差分そのものが、"要約が覆い隠した未解決リスクの量" を示すシグナル になり得ます。
ハマりどころメモ
-
要約テーブル内の改行が HTML エスケープされて返る — 表のセル内改行が
<br>の形で返ってきます。そのまま Markdown 表示すると文字列として見えてしまうので、表示前にアンエスケープ するか、レンダラ側で処理してください。 -
言語は明示指定が安心 —
transcribe.languageとsummary.languageをそれぞれja-JPで指定しました。文字起こしと要約で別言語にもできます。 -
SSE は逐次パース、要約は累積 —
summary_updatedのsummary_resultは差分ではなく累積で届くので、最新で上書きすればOKです。 - (必要なら)一時エラーに備えてリトライを — 今回レート制限(429)等には遭遇しませんでしたが、SSE+同期呼び出しを本番運用するなら、一時的な失敗に備えて軽いリトライを入れておくと安心です。
まとめ
- Speech Summarization(SSE・引用付き)と Decisions(型付き判定)を繋ぐと、商談音声 → 構造化された判定 までを少ないコードでパイプライン化可能
- 会話の途中で条件が変わっても、「値の訂正」「前提の訂正」のどちらも、要約経由・文字起こし経由の両方で訂正後を正しく拾えた
- しかも ヒント(priming)を外した中立版でも訂正後を拾えた(検証C)ので、これは指示頼みではなく Decisions の地力
- 明示された事実は要約経由で頑健(ノイズ除去にもなる)
- ただし 分散・暗黙のカテゴリ値は要約が "未定" に落とすことがある
- 主観スコアは入力で割れることがある
- 精度は「入力の選び方」と 「質問・選択肢の書き方」 の両輪
検証環境(執筆時点)
- 日付:2026-11 時点のドキュメント/API 挙動
- 実行:Node.js 20+(依存ゼロ、
fetch/FormData/ SSE 手動パース) - モデル:Speech Summarization(
ja-JP)/ Decisionszoom-decisions - 素材:自作の架空商談音声2本
参考リンク
- AI Services - Zoom Developer Docs
https://developers.zoom.us/docs/ai-services/ - Speech Summarization / Streaming mode
https://developers.zoom.us/docs/ai-services/speech-summarization/ - Decisions
https://developers.zoom.us/docs/ai-services/decisions/