
0. はじめに: llama.cpp 1.0.0の発表
ローカルで LLM を動かすときの悩みは、モデルが VRAM に載り切らないことです。私の手元の GPU は VRAM が 16GB で、普段使っている Nemotron 3.5 の Lightning(総 30B・アクティブ 3B)や Bolt(総 74B・アクティブ 9B、IQ2)1も、重みの一部を CPU 側のメモリに置いて動かしています。
そこに 2026-11-13、llama.cpp が 1.0.0 になりました2。GPU に載り切らない MoE モデルを速く動かすための MoE キャッシュ(--moe-cache-mib など)が入ったのが、手元の GPU の VRAM が 16GB の環境にとって、一番気になる変化です。普段使っている Ollama と比べて、どれだけ変わるかを測りました。
先に結論です(測定日 2026-11-14、いずれも約 3,300〜3,600 トークンのプロンプトに対する生成速度の中央値)。
- MoE キャッシュを効かせると、llama.cpp 自身の自動配置(
--fit)に対して M1(Qwen3-30B-A3B)が +46〜56%、M2(Nemotron 3.5 Lightning 30B-A3B)が +50%、M3(Nemotron 3.5 Bolt 74B-A9B IQ2)が +24〜26% 速くなりました。ただし M2 は、-lmが既定(mmap)のままだとキャッシュを付けても 50.3 tok/s で、--fit(60.0)より遅く、-lm noneとの併用が必要でした。 - Ollama との同じコンテキスト長での比較では、M1 が 32k で +29〜37%、64k で +22〜35%、M2 が 32k で +32%、64k で +39%、M3 が 32k で +13〜14%、64k で +9% でした。Ollama は、M1 と M2 でコンテキストを広げると遅くなりました。Ollama 既定の 4096 と比べると、M1 は 98.2 tok/s と llama-server の 32k(約 103)にほぼ並び、M3 も近い値でしたが、M2 は 72.3 に対して 89.7 と差が残りました(llama-server を短いコンテキストで測ってはいません)。
- 落とし穴もあります。VRAM がほぼいっぱいになる設定では、M3 は 7.3 tok/s まで落ちました(同じ mmap 条件で、キャッシュ 8000 の 53.4 の約 7 分の 1)。M1 でも、64k の KV を f16 にすると 9.4 tok/s に落ちました。
- Windows では Smart App Control に未署名バイナリを止められたため、WSL2 上の Linux 版で測っています。
検証時点で、GitHub の v1.0.0 リリースには実行ファイルが付いていませんでした。本記事の「1.0.0」は、対応する nightly ビルド b123593(llama-server --version は 1.0.0-dev (build 12359, commit b1b770d90))です。
検証したモデルは次の3つです。
| ID | モデル | 総 / アクティブ | 量子化 | ファイルサイズ |
|---|---|---|---|---|
| M1 | Qwen3-30B-A3B | 30B / 3B | Q4_K_M | 約 17.3 GiB |
| M2 | Nemotron 3.5 Lightning 30B-A3B | 30B / 3B | Q4_K_M | 約 23.7 GiB |
| M3 | Nemotron 3.5 Bolt 74B-A9B | 74B / 9B | IQ2 | 約 20.5 GiB |
「A3B」は、1 トークンで使うパラメータ(アクティブ)が約 3B であることを表します。
1. llama.cpp 1.0.0の概要
1.1 今回使ったフラグ
今回の検証で使ったフラグは次のとおりです。いずれも llama-server --help で実在を確認しました。1.0.0 の新機能は MoE キャッシュ(--moe-cache-*)で、ほかには 1.0.0 より前からあるフラグも含まれると思われます(どれが新しいかは確認していません)。
| フラグ | 役割 |
|---|---|
--moe-cache-mib N |
MoE のエキスパート重みを VRAM に常駐させるキャッシュの容量(既定 0) |
--moe-cache-cpu-share F |
キャッシュが満杯になったあと、ミス(キャッシュにないエキスパート)のうち CPU 側の重みで計算させる割合。0〜1 の小数で、オン/オフのフラグではない(既定 0 = ミスはすべて VRAM へ転送) |
-cmoe / -ncmoe N
|
MoE のエキスパートを CPU 側に置く(全層 / N 層) |
--fit [on|off] |
VRAM に収まるよう自動で配置を決める |
-ctk / -ctv
|
KV キャッシュの型。f8_e4m3(FP8)が選べる |
-lm {auto|none|mmap|mlock|mmap+mlock} |
モデルの読み込み方式 |
1.2 MoE キャッシュの考え方
MoE モデルは、トークンごとに一部のエキスパートしか使いません。そこで、全エキスパートを CPU 側のメモリに置いたうえで、よく使うものを VRAM のキャッシュに常駐させます。キャッシュにあれば GPU がそのまま計算でき、なければ CPU 側の重みを転送するか、CPU で計算します。
図 1: MoE キャッシュの流れ
速度は ヒット率 に強く左右されるようです。同じ --moe-cache-mib 11000 でも、M1 は 98.7%、M2 は 85.3% でした。M1 は VRAM のキャッシュだけでほとんど足りるため速く、M2 はミスが多い分、ミスの扱いが速度に効きやすいと考えられます。そのミスの扱いを変えるのが --moe-cache-cpu-share で、この結果は 3.6 のコラムで詳しく書きます(-lm が既定の mmap のときの話で、-lm none では事情が変わります)。
1.3 ヒット率の見方
ヒット率が出るのは、-lv 4 を付けてサーバーを止めたときだけです。次のように起動し、いくつかリクエストを送ってから、Ctrl+C(SIGINT)で止めます。
# 1. -lv 4 を付けて起動(ログをファイルへ)
llama-server -m model.gguf -c 32768 -fa on --jinja -t 8 \
  -ngl 99 --fit off -cmoe -lm none --moe-cache-mib 11000 \
  -lv 4 > server.log 2>&1 &

# 2. /completion などでリクエストを送る(省略)

# 3. SIGINT で止める(終了時に累計のヒット率が出る)
pkill -INT -x llama-server

# 4. ヒット率を取り出す
grep "hit rate" server.log
llama_moe_cache: ubatch <= 8: ... hit rate = 98.69%
ここで ubatch <= 8 はデコード(1トークンずつの生成)側の値です。私が確認できた範囲では、ヒット率の行は -lv 4 を付けたときにだけ出ました。
コラム:LLAMA_MOE_CACHE_TRACE はヒット率のスイッチではない
名前から、ヒット率のログを出す環境変数だと思って試しましたが、違いました。この変数は、チューニング用スクリプト scripts/moe-cache-tune.py に渡すバイナリトレースの出力先のパスです。ヒット率を見たいときは、上のとおり -lv 4 を付けます。
2. 導入手順
2.1 検証環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 5070 Ti 16GB(ドライバ 610.88) |
| CPU | Intel Core Ultra 7 270K Plus(24コア) |
| RAM | DDR5-5600 64GB |
| OS | Windows 11 Pro + WSL2 Ubuntu 26.04 |
| llama.cpp |
1.0.0-dev (build 12359)、Linux CUDA 13.5 ビルド |
| 比較対象 | Ollama 0.40.16 |
構成は次のとおりです。Ollama は Windows 上、llama.cpp は WSL2 の中で動かし、どちらも同じ GPU と同じメモリを使います(同時には動かしません)。モデルは、GPU の VRAM(16GB)と、DRAM(64GB)に分かれて置かれます。
図 2: 検証環境の構成。Ollama は Windows 上、llama.cpp は WSL2 内で動き、LLM は GPU の VRAM と DRAM に分かれる
測定中の PCIe は、負荷時に Gen5 まで上がっていました(アイドル時の Gen1 は省電力によるものです。リンク幅の最大は x16 です)。
2.2 進め方と、環境に加えた変更
進め方は、公式の --help とドキュメントのとおりに動かす → フラグを変えて測る → 失敗や想定外も記録する、の順です。設定が反映されていなかった測定は、結果から除いて測り直しました。
測定のために、環境へ次の変更を加えました。
- Smart App Control は無効にしていません(2.3)。
-
WSL の割り当てを変更しました。
%USERPROFILE%\.wslconfigを、メモリ 12GB・6 プロセッサから、48GB・24 プロセッサにしました。元の設定は.wslconfig.bakに退避してあり、戻す手順も用意してあります(2.4)。 -
モデルのコピーを作りました。 WSL の ext4 側に、3 モデルで約 65GB です。M2(
nemotron-3.5-lightning:30b-a3b)と M3(nemotron-3.5-bolt:74b-a9b-iq2)は Ollama の blob のコピー、M1 は Hugging Face のQwen/Qwen3-30B-A3B-GGUF4 から取得した Q4_K_M の GGUF です。 -
Ollama の設定は変えていません。 環境変数も未設定のままで、コンテキスト長はリクエストごとに指定しました。M1 だけは、Ollama 側の比較用に、同じ GGUF を
ollama createで取り込みました(約 18GB)。
2.3 Windows ネイティブ版が起動しなかった
最初は Windows 用の CUDA 13.5 ビルドを展開して動かそうとしましたが、起動しませんでした。Smart App Control が未署名のバイナリを拒否し、イベントログに Code Integrity の 3077/3033、終了コードは 0xC0E90002 が残っていました。
Smart App Control は、一度オフにすると再びオンにするには Windows の再インストールが必要とされているため、無効化はせず WSL2 で進めました。WSL2 でも GPU は使えます。ただし、測定は WSL 内の llama.cpp と Windows 側の Ollama の比較になり、条件が完全には揃いません。
2.4 WSL2 側の準備
.wslconfig は次のようにしました(swap と networkingMode は元のままです)。
[wsl2]
memory=48GB
processors=24
swap=4GB
networkingMode=Mirrored
反映には wsl --shutdown が必要です(全ディストリビューションが止まります)。元に戻すときは、バックアップした .wslconfig.bak を戻します。
モデルは WSL の ext4 側(~/llm-bench/models/)にコピーしました。/mnt/c 経由のファイル読み込みは、一般に遅くなりやすいためです。M2・M3 は Ollama の blob を、そのまま GGUF として使えます(M2 は SHA256 が blob 名と一致しました)。
2.5 ビルドの取得
nightly の b12359 から、Linux CUDA 13.5 版と cudart を取得して展開します。
cd ~/llm-bench/llama.cpp
mkdir -p _dl v1.0.0
B=https://github.com/ggml-org/llama.cpp/releases/download/b12359
for n in llama-b12359-bin-ubuntu-cuda-13.5-x64.tar.gz \
         cudart-llama-b12359-bin-ubuntu-cuda-13.5-x64.tar.gz; do
  curl -sL --fail -o "_dl/$n" "$B/$n"
  tar -xzf "_dl/$n" -C v1.0.0
done
チェックサムの検証はしていません。
ライブラリパスを通して、バージョンと GPU の認識を確認します。
LLB=~/llm-bench/llama.cpp/v1.0.0/llama-b12359
LLRT=~/llm-bench/llama.cpp/v1.0.0/cudart-llama-b12359-bin-ubuntu-cuda-13.5-x64
export LD_LIBRARY_PATH="$LLB:$LLRT:/usr/lib/wsl/lib:$LD_LIBRARY_PATH"
$LLB/llama-server --version        # 1.0.0-dev (build 12359, commit b1b770d90)
$LLB/llama-server --list-devices   # CUDA0: NVIDIA GeForce RTX 5070 Ti (16302 MiB, ...)
ビルドは CUDA 13.5 ですが、WSL のドライバ側は CUDA 13.3 でした。それでも GPU は問題なく認識されました。
2.6 起動スクリプト
最終的に、次の形で起動しています(M2 の例)。
llama-server --host 127.0.0.1 --port 8080 \
  -m ~/llm-bench/models/M2-lightning-Q4_K_M.gguf \
  --alias nemotron-3.5-lightning:30b-a3b \
  -c 32768 -fa on --jinja -t 8 \
  -ngl 99 --fit off -cmoe -lm none \
  --moe-cache-mib 11000
ポイントは次の4つです。
-
-ngl 99 --fit off -cmoeで配置を固定し、キャッシュの容量だけを調整変数にしています。 -
--aliasに Ollama と同じモデル名を付けると、クライアント側は接続先 URL を変えるだけで切り替えられます。 -
-lm mlockは WSL のRLIMIT_MEMLOCKのせいで3モデルとも失敗しました(failed to mlock ... Cannot allocate memory)。起動は続き、速度は mmap をやめた-lm noneと同等でした。mmap を使わず、ホスト側のエキスパートがピン留めメモリに置かれる効果だと考えていますが、mlock が失敗した状態でどうなっているかは確認していません。警告が出ない-lm noneを採用しました。mmap は、モデルのファイルを OS のメモリ空間に対応づけて読む既定の方式です。ピン留めは、物理メモリに固定して、GPU への転送を速くする方式です。 -
--moe-cache-cpu-shareは付けていません。ピン留めすると転送が速くなり、CPU 分担は効かなくなるためです(3.6)。
WSL 周りで時間を取られた点: Git Bash は /tmp/... を Windows のパスに変換するため、WSL へ渡すスクリプトは PowerShell から呼ぶ必要がありました。スクリプトは LF で保存し、/mnt/c/... 経由で実行するのが確実でした。
3. パフォーマンスの比較
3.1 測定方法
- 入力は3種類です。P1 は短文、P2 は約 3,300〜3,600 トークンの議事録、P3 はコード生成。主に P2 の生成速度(tok/s)で比べます。
- llama-server は
/completion、Ollama は/api/generateに、n_predict(Ollama はnum_predict)512、temperature=0、seed=42を指定しました。llama-server はcache_prompt=falseです。llama-server には生のプロンプトを渡しています。Ollama はrawを指定しておらず、チャットテンプレートが適用されます(プロンプトのトークン数が 16 トークン前後多くなりました)。また、Ollama の M2・M3 では、生成された 512 トークンがresponseに出ず(空でした)、思考(thinking)に使われたとみられます。M1 のresponseは<think>で始まっていました。thinking の中身は記録していません。速度はeval_count / eval_durationから求めたので、トークンあたりの生成速度としては比べられますが、出力の内容は Ollama と llama-server で揃っていません。 - ウォームアップ 1 回のあと 5 回測って中央値を取りました。
- コンテキストは 32768、
-fa on --jinja -t 8。VRAM、PCIe 世代、RAM、スワップ(/proc/vmstat)を測定中に記録しています。 - Ollama は環境変数を変えず、リクエストごとの
options.num_ctxで 4096(既定)、32768、65536 を指定しました。
誤差の目安。 同じフラグを別のサーバープロセスで測り直すと、約 5〜6% ばらつきました(-lm mlock の構成を 2 回ずつ測った値で、M1 が 101.5 と 96.5、M2 が 85.0 と 81.0、M3 が 59.4 と 62.9)。1 つの設定の 5 回の中でも、最小〜最大の幅は、3.2 の表の最良構成では 2〜5% ほどですが、構成によっては 10% を超えました(M1 の 96.5 の測定は 94.8〜105.8)。数 % の差は、優劣を言えません。
構成の主なものは次のとおりです。
| 構成 | 内容 |
|---|---|
| C1 |
--fit on(llama.cpp の自動配置。基準) |
| C2 |
-cmoe(エキスパートを全部 CPU に置く) |
| C3 |
-cmoe + --moe-cache-mib(4000 / 8000 / 11000) |
| C4 | C3 + --moe-cache-cpu-share(0.5 / 0.9) |
| C5 | 64k コンテキスト + KV の型違い(f16 / q8_0 / f8_e4m3) |
| C7 | 最良のキャッシュ設定 + -lm(mlock / none) |
| Cbest | C7(-lm mlock)を別プロセスで測り直したもの |
(C6 は、--fit にキャッシュを足す構成で、C1 と同等か遅かったため、記事では扱いません。)「旧設定」と書いた M2 の設定は、cpu-share 0.9 を付けた最初の測定のことです。
3.2 モデル別の結果
P2 の生成速度(tok/s、中央値)です。最良構成は、-lm none の C7 です(いずれも cpu-share は付けていません)。
| モデル | C1(--fit) |
C2(-cmoe) |
最良構成(5 回の最小〜最大) | 最良構成の設定 | C1 比 |
|---|---|---|---|---|---|
| M1 Qwen3-30B-A3B | 65.9 | 32.6 | 102.9(99.6〜104.0) | キャッシュ 11000 | +56% |
| M2 Nemotron 3.5 Lightning 30B-A3B | 60.0 | 33.9 | 89.7(88.9〜91.1) | キャッシュ 11000 | +50% |
| M3 Nemotron 3.5 Bolt 74B-A9B IQ2 | 50.0 | 35.4 | 62.0(61.1〜62.2) | キャッシュ 8000 | +24% |
(図 3 に棒グラフを示します。)
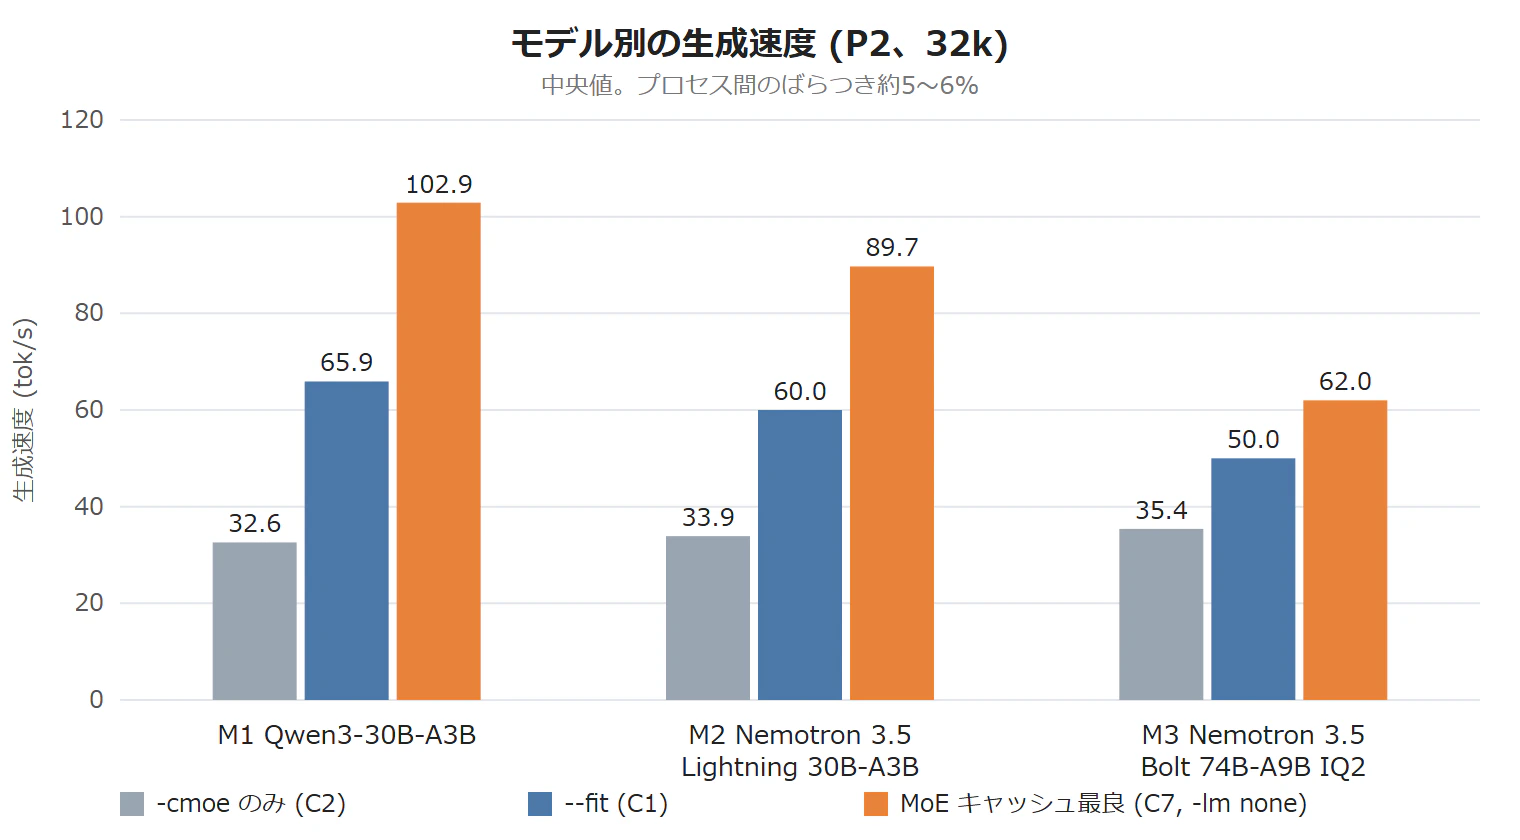
図 3: モデル別の生成速度(P2、32k、中央値)
読み取り
- 素の
-cmoe(C2)から見ると、キャッシュで 1.8〜3.2 倍になっています。ただし C2 は比較用の下限で、実際の基準は C1 です。 - 別プロセスで測り直した値(Cbest、
-lm mlock)は、M1 96.5(C1 比 +46%)、M3 62.9(+26%)でした。冒頭の「+46〜56%」「+24〜26%」は、-lm noneの測定とこの測り直しにまたがる幅です。M2 の Cbest(81.0)は cpu-share 0.9 を付けた旧設定のため、比べていません。 - M2 の +50% は、1 回のサーバー起動(5 回測った中央値)にもとづく値で、M1・M3 のような測り直しはありません(C1 の測定からも約 10 時間あいています)。
キャッシュ容量を変えたときの変化です(P2、tok/s)。
| キャッシュ容量 | M1 | M2 | M3 |
|---|---|---|---|
| 4000 MiB | 33.5 | 23.6 | 40.7 |
| 8000 MiB | 81.6 | 36.8 | 53.4 |
| 11000 MiB | 94.7 | 50.3 | 7.3 |
| (参考)C2 キャッシュなし | 32.6 | 33.9 | 35.4 |
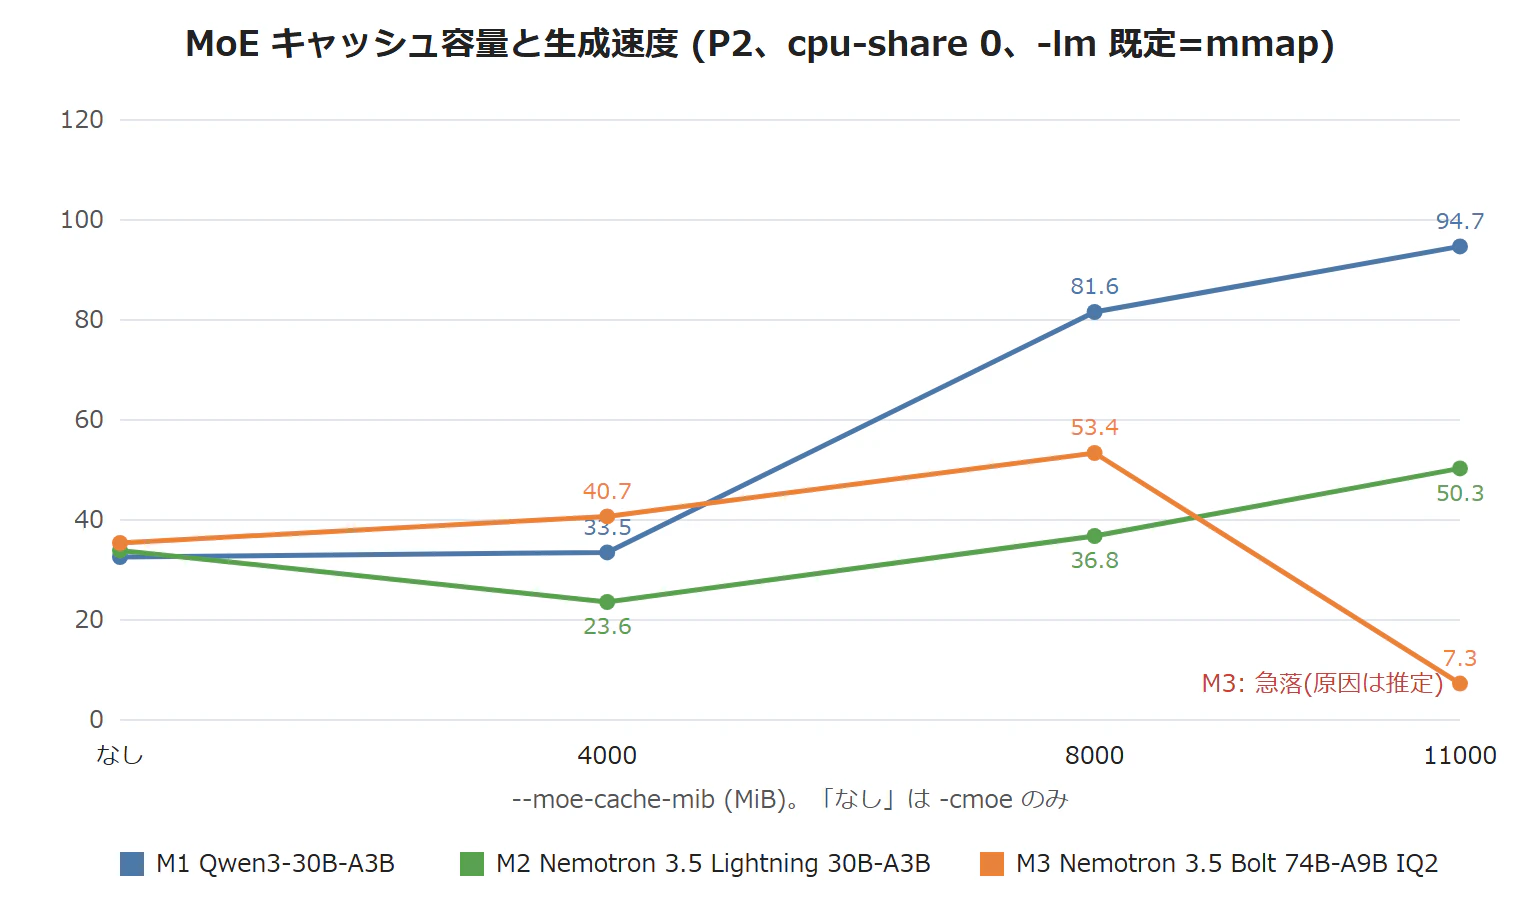
図 4: キャッシュ容量と生成速度(P2、cpu-share 0、-lm 既定=mmap。左端はキャッシュなしの -cmoe)
読み取り
- 容量を増やすほど速くなるのは M1・M2 で、M3 は 8000 MiB が最良でした。
- M2 の 4000 MiB(23.6)は、キャッシュなし(33.9)より遅いです。キャッシュが小さいと、入れ替えの転送が増えてかえって損をする場合があります。
- ヒット率は、11000 MiB で M1 98.7%、M2 85.3%、8000 MiB の M3 で 88.8% でした。
- ここまでの表と図 4 は、
-lmが既定(mmap)の測定です。ホスト側のエキスパートをピン留めメモリに置く-lm noneを足すと、同じキャッシュ容量で M1 は 94.7 → 102.9、M2 は 50.3 → 89.7、M3 は 53.4 → 62.0 になりました。特に M2 は、キャッシュ容量を決めたあとの-lm noneが一番大きく効きました。逆に言うと、M2 は mmap のままだと、キャッシュ 11000 でも 50.3 tok/s で、--fit(60.0)より遅いままです。
3.3 失敗構成から学ぶ
起動に失敗した構成はありませんでしたが、完走したのに異常に遅いものが2つありました。
| 構成 | 生成 tok/s | VRAM ピーク |
|---|---|---|
| M1:64k、KV f16、キャッシュ 11000 | 9.4 | 15,915 MiB |
| M3:32k、キャッシュ 11000 | 7.3 | 15,808 MiB |
どちらも VRAM のピークが、搭載量(16,302 MiB)の約 97〜98% に達していました。同じモデルで、M1 は KV を FP8 や q8_0 にすると、M3 はキャッシュを 8000 にすると、正常な速度に戻りました。VRAM が足りなくなって、GPU のデータが CPU 側のメモリへ追い出された(Windows の GPU ドライバの仕組み、WDDM による動き。下のコラム)ためと推定していますが、共有 GPU メモリの使用量までは直接確認していません。
M3 のキャッシュ 11000 は、別のサーバープロセスで測り直しても 7.1 tok/s(6.9〜7.3)で、再現しました。ところが、ヒット率を取るために -lv 4 を付けて同じ構成を再実行したときは 52〜55 tok/s で、遅くなりませんでした(VRAM のピークは 15,890 MiB と、むしろ大きい値でした)。M1 の 11000 も、15.8GB 台で正常に動いています。VRAM のピークの大きさだけでは説明できず、遅くなる条件は特定できていません。
コラム:WDDM と VRAM あふれ
WDDM(Windows Display Driver Model)は、Windows の GPU ドライバのモデルです。Windows では、VRAM が足りなくなっても、アプリはすぐには失敗しません。GPU 上のデータを、CPU 側の「共有 GPU メモリ」へ追い出して動き続けます。ただし、追い出されたデータは PCIe 越しに読むことになるので、極端に遅くなります。今回の 9.4 と 7.3 tok/s は、これに当たる可能性があります(WSL2 も、GPU は Windows のドライバを通して使いますが、WSL2 の CUDA で同じ退避が働くかどうかは確認していません)。
読み取り
- 避ける目安として、
moe-cache-tune.pyが各モデルのキャッシュ上限を M1 10390、M2 11608、M3 8854 MiB と出しました。M3 の 11000 はこれを超えており、方向としては合います。ただし M1 の 11000 も上限を超えていて正常だったので、境界ではなく目安として見てください。 - 推奨値も実測と同じ向きでした。ただしこのスクリプトは mmap で測るため、
-lm noneにすると M2 の最良は share 0 に変わりました(3.6)。
| モデル | スクリプトの推奨 | 実測の最良 |
|---|---|---|
| M1 Qwen3-30B-A3B | 10368 MiB、share 0 | 11000 MiB、share 0 |
| M2 Nemotron 3.5 Lightning 30B-A3B | 11584 MiB、share 0.9 | 11000 MiB、share 0.9(mmap のとき) |
| M3 Nemotron 3.5 Bolt 74B-A9B IQ2 | 8832 MiB、share 0 | 8000 MiB、share 0 |
- KV を FP8(
-ctk f8_e4m3 -ctv f8_e4m3)にすると、M1 の 64k で VRAM に収まり、9.4 → 95.1 tok/s になりました。
3.4 Ollama との比較(同じコンテキスト長)
ここが一番知りたいところです。P2 の生成速度(tok/s)を、同じコンテキスト長で比べます。llama-server の値は、特記がなければ -lm none です。M1 の 32k の下限(96.5)は -lm mlock の別プロセスの測定で、M1 の 64k は -lm の違いで 85.9 と 95.1 に分かれました(VRAM のピークが 15,862 MiB と、ほぼいっぱいの設定です)。M2 は 1 回のサーバー起動の測定です。
| Ollama | llama-server(最良) | 差 | |
|---|---|---|---|
| M1 既定(4096) | 98.2 | – | – |
| M1 32k | 74.9 | 96.5〜102.9 | +29〜37% |
| M1 64k | 70.7(実際は 40960) | 85.9(-lm none)〜95.1(mmap)、FP8 KV |
+22〜35% |
| M2 既定(4096) | 72.3 | – | – |
| M2 32k | 67.8 | 89.7(-lm none) |
+32% |
| M2 64k | 66.8 | 92.9(FP8 KV、-lm none) |
+39% |
| M3 既定(4096) | 59.4 | – | – |
| M3 32k | 55.0 | 62.0〜62.9 | +13〜14% |
| M3 64k | 56.5 | 61.8(FP8 KV) | +9% |
(図 5 に、表の値をグラフで示します。)
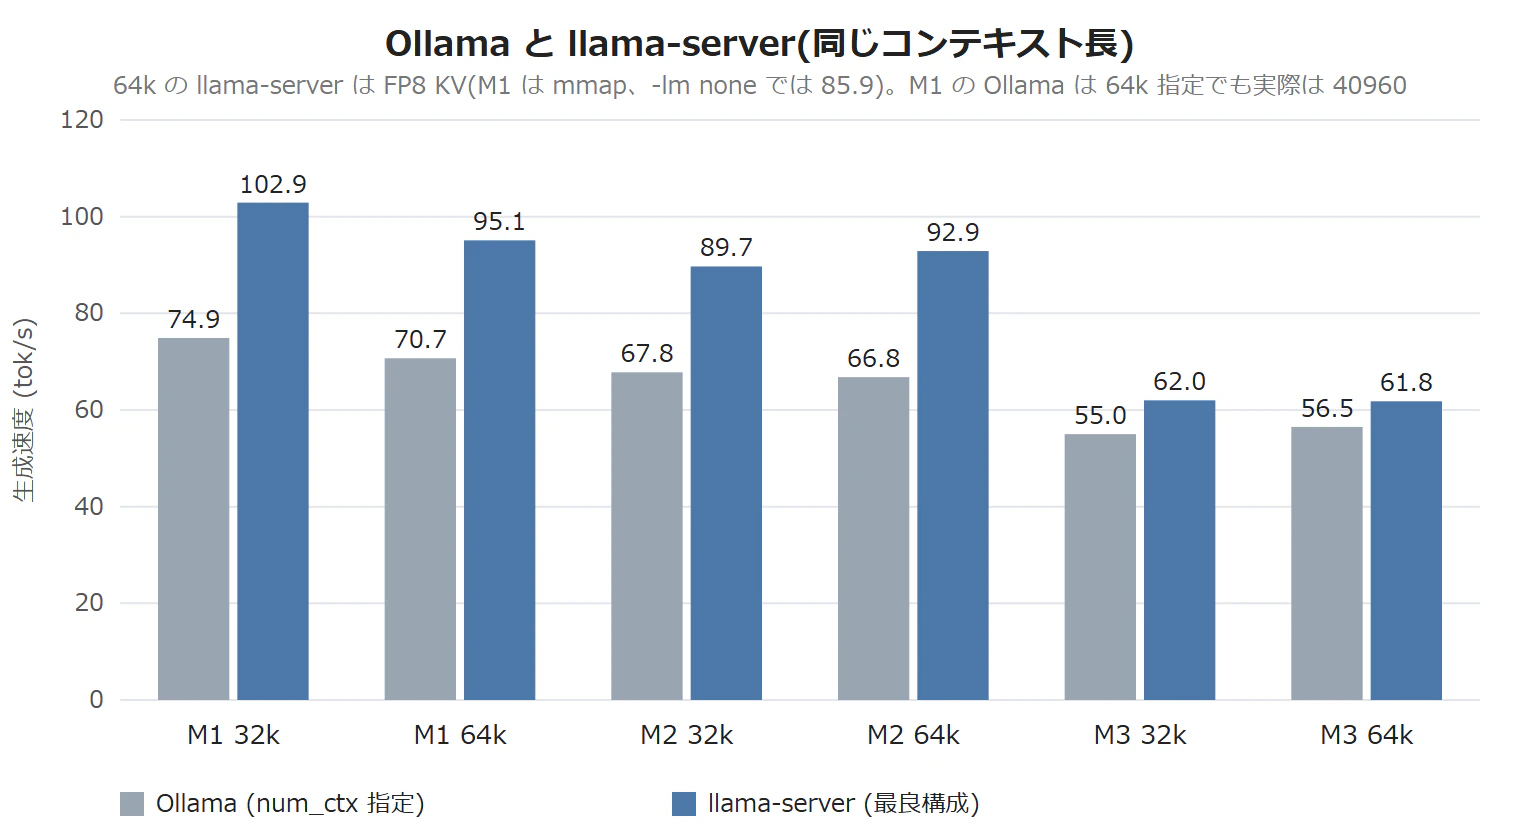
図 5: 同じコンテキスト長での比較(P2)。64k の llama-server は FP8 KV(M1 の 64k は mmap の値。M3 の 32k は -lm none の値)
読み取り
- M1 は、Ollama でコンテキストを広げるほど遅くなりました(4096 で 98.2 → 32k で 74.9 → 64k 指定で 70.7)。このとき Ollama の GPU 搭載率も、76% → 66% → 64% と下がっています。M2 も 72.3 → 67.8 → 66.8 と下がりましたが、32k から 64k の差(約 1.5%)はばらつきの範囲です。M3 は 59.4 → 55.0 → 56.5 で、4096 から 32k で下がり、64k ではほぼ横ばいでした。llama-server は 64k でも、32k から大きくは落ちませんでした。
- Ollama 既定の 4096 と、llama-server の 32k を比べると、M1 は 98.2 対 96.5〜102.9 でほぼ同等、M3 は 59.4 対 62.0〜62.9 で +4〜6%、M2 は 72.3 対 89.7 で +24% でした。llama-server を短いコンテキストで測っていないため、短い対話での優劣は未確認です。
- 短いプロンプト(P1)と、コード生成(P3)では、M2 の旧設定(cpu-share 0.9)の 32k 測定で、Ollama に対して P1 が約 +10%、P3 が約 −4% でした(M2 の Ollama と llama-server の比較。新しい設定では P1・P3 を測り直していません)。
注意点
-
以前の記事の値とは比べられません。 以前の記事では、Ollama で Bolt が約 36〜46 tok/s(投機的デコードを切ると約 60)、Lightning が約 74〜81 tok/s と書きました56。今回の Ollama の値(M3 の 59.4、M2 の 72.3)は、今回新たに測り直した数値です。環境も変わっています。Ollama は 0.40.5 から 0.40.16 になり、コンテキストは 8,192 から既定の 4096 に、プロンプトは約 3,300〜3,600 トークンの議事録で、思考なしの
/api/generateです。どの違いが効いたかの切り分けはしていません。 - Ollama と llama-server で、入力と出力の内容が揃っていません。 3.1 に書いたとおり、Ollama はチャットテンプレートが適用され、M2・M3 では出力が thinking に使われたとみられます。速度はトークンあたりの値なので比べられますが、出力の内容や品質を比べたものではありません。
- Ollama の 4096 の測定では、M2・M3 のプロンプトが 3,627 トークンで、出力の 512 トークンと合わせると約 4,139 になり、4096 をわずかに超えます(M1 は約 3,800 で収まります)。Ollama 側で何が起きたかは確認していません。
- M3 は、Ollama 側で内蔵のドラフター(投機的デコード)が働いていたかを確認していません。llama-server では、ドラフターを使っていません。
- M1 は Ollama に導入していなかったため、llama-server と同じ GGUF ファイルを
ollama createで取り込んで測りました(重みは同一です)。そのうえで、num_ctxの指定以外の調整(GPU への載せ方など)はしていません。 - Ollama で GPU に載った重みの割合(
/api/psのsize_vram / size)は、M1 が 4096 で 76%・32k で 66%、M2 は約 51〜54%、M3 は約 20% でした。 - M1 の 64k 指定は、Ollama 側でモデルの上限である 40960 に切り詰められました(Qwen3 のコンテキスト長の上限)。
3.5 出力の品質と挙動
速さだけでなく、壊れていないかも確認しました。
出力の同一性: 同じ入力(temperature=0、seed 固定)でも、C1 とキャッシュ構成では文字単位では一致しませんでした。差は言い換え程度で、内容が破綻する分岐ではありませんでした(ただし、通しで確認したのは M2 のみで、M1・M3 は差分の冒頭だけです)。原因は特定していません(CPU 計算の有無や配置の違いによる、数値のわずかな差の可能性があります。cpu-share 0 のキャッシュ構成でも、M2 では出力が途中で分岐していました)。
KV の型(64k): M1・M2 は f16、q8_0、f8_e4m3 のいずれも、自動指標(他言語の混入、重複文など)では破綻しませんでした。ところが M3 の q8_0 は明らかに崩れました。指示文を繰り返し、「影響度(高/高/低)」のような出力になりました。f16 と f8_e4m3 では出ていません(1 つのプロンプトの、温度 0 の 1 回の生成での結果です)。IQ2 は重みを 1 つあたり 2 ビット前後まで削る強い量子化で、もともと精度の余裕が小さいモデルです。そこへ KV の 8 ビット量子化(q8_0)の誤差が重なって、出力が崩れた可能性がありますが、なぜ q8_0 だけ崩れたのかは切り分けていません。M3 の 64k では f16 か FP8 を使うようにします。
| KV の型(64k、P2 tok/s) | M1 | M2 | M3 |
|---|---|---|---|
| f16 | 9.4 | 78.0 | 51.2 |
| q8_0 | 86.5 | 78.5 | 53.9(出力が破綻) |
| f8_e4m3 | 95.1 | 78.2 | 52.7 |
この表は -lm が既定(mmap)での比較で、M2 は旧設定の cpu-share 0.9 を付けています。型どうしの差を見るためのもので、3.4 の llama-server の値(-lm none)とは条件が違います。
ツール呼び出し: get_meeting_info(meeting_id) を渡して 5 回試し、llama-server の 3 モデルと Ollama の M2・M3 で 5/5 でした。1 関数の簡単なテストなので、複雑な構成での優劣を示すものではありません。
30 分連続稼働(M2、旧設定の cpu-share 0.9): 199 回連続で、生成速度の中央値は 83.5 tok/s、最初の 5 回から最後の 5 回で −2.2% でした。VRAM は 14,762〜14,815 MiB で安定し、WSL 内の RAM も 23.86 → 23.95GB で、スワップはほぼ発生しませんでした。
3.6 モデルごとの推奨設定
| モデル | キャッシュ | cpu-share | 備考 |
|---|---|---|---|
| M1 Qwen3-30B-A3B | 11000 | 0 | 64k では、f16 の KV は VRAM 不足(9.4)。FP8 か q8_0 を使う。64k だけは -lm 既定(mmap)の 95.1 が、-lm none の 85.9 より速かった |
| M2 Nemotron 3.5 Lightning 30B-A3B | 11000 | 0 |
-lm none を強く推奨(mmap のままだと 50.3) |
| M3 Nemotron 3.5 Bolt 74B-A9B IQ2 | 8000 | 0 | キャッシュ 11000 は避ける(7.3)。64k の KV は f16 か FP8 で、q8_0 は避ける |
M1 の 64k を除いて、-lm none を付けた設定です。
コラム:なぜ M2 で cpu-share が効かなくなったのか
--moe-cache-cpu-share は、キャッシュに載っていないエキスパート(ミス)の扱いを変えるフラグです。付属のドキュメント(docs/moe-cache.md)7には、次のように書かれています。
- 0 のときは、ミスしたエキスパートを VRAM へ転送してから GPU で計算します。
-
Fを指定すると、ミスのうち割合Fを、CPU が CPU 側の重みを読んで直接計算します。残りは転送します。 - 効くのは、CPU が重みを読む速さが、GPU への転送より速い場合です(速い RAM、PCIe 4 の接続、ピン留めされていないメモリなど)。
-lm noneなどでホスト側の重みをピン留めすると、転送がリンクの最大速度で行われるため、効かないことが多いそうです。 - キャッシュが満杯になるまでは、すべて転送されます。
私は最初、この結果から「M2 だけ cpu-share が効く」と見ていました。mmap(既定)で測ると、M2 は cpu-share で大きく伸びたためです(なし 50.3、0.5 で 60.7、0.9 で 75.8)。一方、M1 と M3 は、mmap で cpu-share を付けると遅くなりました(M1:94.7 → 約 70)。ヒット率が低い M2 は、ミスが多い分、CPU に肩代わりさせる意味があるのだろう、と考えていました。
もう一つ訂正があります。記事を書く途中で、M2 を -lm none で、cpu-share を付けずに測ってみると、share 0 が 89.7、0.9 が 82.7 で、逆に share 0 のほうが速くなりました(64k・FP8 KV でも 0 が 92.9、0.9 が 82.1)。最初の結果は、-lm の条件が絡んでいたのです。ドキュメントの説明のとおり、mmap のままではホスト側の重みがピン留めされず、GPU への転送が遅いので、CPU に肩代わりさせる意味があります。-lm none でピン留めすると、転送が速くなり(PCIe Gen5)、CPU 分担は不要になるのだろうと考えています。
ただし、この比較は 1 設定につき 1 回のサーバー起動(各 5 回測った中央値)で、差は 32k で約 8%、64k で約 13% と、プロセス間のばらつき(5〜6%)と同程度か、やや大きい程度です。「share 0 のほうが速い」と断定はせず、「少なくとも share 0.9 の利点は見えなかった」と受け止めています。
4. まとめ
4.1 分かったこと
1.0.0 の MoE キャッシュが、VRAM が 16GB の環境で何をもたらすかを、3 点にまとめます。
-
MoE キャッシュが効きます。 自動配置(
--fit)に対して +24〜56%、Ollama に対して同じコンテキスト長で +9〜39% でした。 -
効き方はモデルで違い、設定を外すと遅くなります。 ヒット率の高い M1 はキャッシュだけで伸び、M2 は
-lm none(ピン留め)が特に効きました(50.3 → 89.7)。VRAM がほぼいっぱいになる設定では、M3 が 7.3 tok/s、M1 が 9.4 tok/s まで落ちました。 - FP8 の KV で、64k が現実的になります。 ただし M3 の q8_0 は出力が崩れたので、型は確認してから選んでください。
4.2 使い分けの目安
-
num_ctxを 32k 以上に設定して使う → llama-server を試す価値があります。Ollama との差は +9〜39% でした。ただし、今回実際に入れたプロンプトは約 3,300〜3,600 トークンまでで、長い入力でのプロンプト処理時間は測っていません。 - 短い対話が中心 → Ollama のままでも、実用になると思われます(M1 は 4096 で 98.2 tok/s)。ただし M2 では、4096 でも llama-server が +24% でした。llama-server を短いコンテキストで測っていないため、短い対話での優劣は未確認です。今回は WSL に 48GB を割り当てて測り(測定中の使用は最大約 25GB、最小値は未確認)、VRAM をほぼ使い切るため、Ollama とは同時に動かしていません。
制約のある VRAM 環境での奮闘は続きます。
4.3 この検証で言えないこと
- 測定は nightly の b12359 で、WSL 内の llama.cpp と Windows 側の Ollama を比べています。条件は完全には揃っていません。Windows ネイティブ版は Smart App Control のため測れていません。
- 1 台の PC(RTX 5070 Ti)での結果です。プロセスごとに約 5〜6% ばらつくため、数 % の差は誤差の範囲です。M2 の +50% と、cpu-share の比較は、1 設定につき 1 回のサーバー起動(各 5 回測った中央値)です。
- Ollama 側は
num_ctxの指定以外、細かな調整をしていません。また、Ollama と llama-server で、入力(チャットテンプレートの有無)と出力(thinking の有無)が揃っておらず、速度(トークンあたり)の比較にとどまります。 - プロンプト処理(prefill)の速度や、最初のトークンまでの時間は載せていません。M1 の 64k は、モデルの学習時のコンテキスト長(40960)を超える設定で、速度の比較だけで、品質は評価していません。
- 出力の品質は、自動指標と目視で破綻を見ただけで、良し悪しの評価はしていません。ヒット率の差の原因(M1 が高い理由)も確かめていません。
- 30 分連続稼働は、cpu-share 0.9 の旧設定での結果で、現在の推奨設定では測っていません。ツール呼び出しも、Ollama の M1 は未実施です。
- VRAM がほぼいっぱいになる設定で遅くなる原因は、推定です。
参考リンク
- llama.cpp v1.0.0 のリリースページ(公開日、MoE キャッシュの記載)
- llama.cpp の nightly ビルド b12359(検証に使ったビルド)
-
llama.cpp の MoE キャッシュのドキュメント(docs/moe-cache.md)(
--moe-cache-cpu-shareの説明) - NVIDIA の発表ブログ(Nemotron 3.5 Super VL と Bolt)(Lightning・Bolt の位置づけ)
- Qwen/Qwen3-30B-A3B-GGUF(Hugging Face)(M1 の GGUF)
- 24GB推奨のモデルを16GBで:Nemotron 3.5 Bolt の速度・日本語品質・エージェント実験(以前の記事。Ollama での Bolt の速度)
- Nemotron 3.5 Lightning を VRAM 16GB で動かした記事(以前の記事。Ollama での Lightning の速度)
-
llama.cpp v1.0.0 のリリースページ(2026-11-13) ↩