
本記事は個人環境での検証に基づく個人的な備忘録です。設定値やパスは一般化して記載しているため、実際の環境に読み替えてください。技術的な確認は Sonnet 5 と、記事の執筆は Opus 5 と共に進めています。
1. はじめに
2026年8月11日、NVIDIA から Nemotron 3.5 Lightning が公開されました。総パラメータ 30B・アクティブパラメータ 3B の MoE(Mixture of Experts)モデルです。
公式ブログでは、このモデルの位置づけが示されています。ひとことで言えば 「賢く考える役」ではなく「エージェントの実務を高速に回す実行役」 です。
もう少し詳しく見ると、フロンティア級の推論モデルがオーケストレーションと複雑な計画を担当し、より小さく効率的なモデルが「高ボリューム実行層」— ツール呼び出し、結果検証、フォーマット処理といった反復タスク — を担当する、という2層構成の設計思想が示されています1。毎ステップでフロンティアモデルを呼ぶとコストとレイテンシが嵩む、という現実的な課題への回答という位置づけです。
公式ブログが挙げる特徴
- 30B total / 3B active の MoE 設計 — ルータが各トークンを少数のエキスパートに振り分けるため、モデルパラメータのごく一部だけが実際に計算される1
- PinchBench で 86% の精度、10,000タスク完了までの時間が Qwen3.6 35B 比で 30% 高速1
- 類似サイズのモデル比で最大4倍の出力速度1
- MTP(マルチトークン予測)を事前学習段階で実装、speculative decoding 用のドラフトモデル(DSpark / DFlash)も公式提供1
- OpenMDW-1.1 ライセンスで重みとデータを公開、公式チェックポイントは NVFP4 と BF161
なお、この公式ブログ自体は MoE であることは明記していますが、Mamba-2 やアテンション層の構成には触れていません。 本記事の 2章では、Nemotron-H 系の技術レポート2を参照しつつ、実際に配布されている GGUF の中身で構造を確認します。
この「アクティブ 3B」という点が今回の関心事です。総パラメータが大きくても、1トークンあたりに実際に使う計算量が小さいなら、リソース制約のある環境でも実用速度が出るのではないか。 これを手元の 16GB VRAM 機で検証しました。
なお本記事に出てくる数値は、断りのない限りすべて自分の環境での実測値です。GGUF のメタデータとテンソル構成も、配布ファイルを直接読んで確認しています。
検証環境
| 項目 | スペック |
|---|---|
| GPU | NVIDIA GeForce RTX 5070 Ti(VRAM 16GB / 実効 16,303 MiB) |
| CPU | Intel Core Ultra 7 270K Plus(24論理コア) |
| システムRAM | 64GB |
| OS | Windows 11 Pro |
| 推論ランタイム | Ollama 0.32.9(Windows ネイティブ) |
前提となる制約
Ollama ライブラリで配布されている GGUF(Q4_K_M)は 25.4GB です。
ここで出てくる2つの用語を簡単に整理しておきます。
- GGUF — llama.cpp 系のランタイムが読み込むモデルファイル形式です。重みそのものに加えて、アーキテクチャ情報・トークナイザ・各種ハイパーパラメータといったメタデータを1ファイルにまとめて格納します。Ollama、llama.cpp、LM Studio などが共通して扱えます。このメタデータは後述するようにファイルの先頭側に置かれているため、モデル全体をダウンロードしなくても中身を調べられます。
-
Q4_K_M — 量子化(quantization)方式のひとつです。元の重みは BF16(1パラメータあたり16bit)ですが、これを4bit前後まで圧縮してファイルサイズを大幅に削減します。末尾の
_K_Mは「K-quant 系の中程度の設定」を意味し、精度への影響が大きいテンソルだけは高めのビット数を残す、といった配分がなされています。精度はわずかに落ちますが、ローカル実行では実用範囲として広く使われています。
VRAM 16.3GB < モデル重み 25.4GB
単純計算で VRAM には乗りません。フル GPU ロードは最初から不可能です。それでも動くのか、動くとしてどれくらいの速度が出るのか、というのが本記事の主題です。
補足: NVIDIA 公式チェックポイントは NVFP4 / BF16 で公開されており1、今回使う GGUF Q4_K_M は Ollama ライブラリ経由で配布されているものです。公式ブログでも Ollama、llama.cpp、LM Studio、Unsloth といった標準ツールへの対応が明記されています。
2. なぜGPUにフルロードせずに動くのか
結論から言うと、このモデルには 「重みは大きいが、1トークンごとに必要なものは小さい」 という性質が二重にあります。そのため Ollama(llama.cpp)の GPU/CPU 自動分割と非常に相性が良いです。
まず、モデルの実体を確認しました。GGUF ファイルのヘッダーには全メタデータが入っているので、25GB をダウンロードせずに HTTP Range リクエストで先頭だけ取得してパースできます。
# モデル本体の blob を先頭 40MB だけ取得(全体は 25.4GB)
curl -sL -o gguf_head.bin --range 0-40000000 \
  https://registry.ollama.ai/v2/library/nemotron-3.5-lightning/blobs/sha256:5c19f6282f4f...
得られたメタデータの要点は次のとおりです。
nemotron_h_moe.block_count           = 53
nemotron_h_moe.context_length        = 1048576      # 1M(公称どおり)
nemotron_h_moe.attention.head_count  = 32
nemotron_h_moe.attention.head_count_kv = [0,0,0,0,0,2,0,0,...]  # 2 が入るのは 7 層だけ
nemotron_h_moe.expert_count          = 128
nemotron_h_moe.expert_used_count     = 6
nemotron_h_moe.expert_shared_count   = 1
nemotron_h_moe.ssm.state_size        = 128
nemotron_h_moe.ssm.inner_size        = 4096
性質①:128エキスパート中、1トークンで使うのは7個だけ
expert_count = 128 に対して expert_used_count = 6、加えて expert_shared_count = 1 となっています。つまり 1トークンあたり 6個のrouted expert + 常時稼働の共有expert 1個 = 7個 しか活性化しません。残り 122 個の重みは、そのトークンの計算には一切関与しません。
この 128個という数は MoE 層1層あたりの値です(後述するとおり、このモデルには MoE 層が24層あります)。層ごとに毎回 128個から6個が選び直される、というのがルータの仕事です。
これが「total 30B / active 3B」の実体です。
性質②:53層中、KVキャッシュを持つのは7層だけ
block_count = 53 のうち、head_count_kv に値が入っている(= Attention 層である)のは 7層のみです。
では残りの46層は何なのか。メタデータだけでは判別できないので、GGUF のテンソル名を直接読んで各層を分類しました(テンソル情報もヘッダー領域にあるので、同じく先頭数MBで読めます)。
blk.0  → ssm_in / ssm_conv1d / ssm_a / ssm_d / ssm_norm ...   → Mamba-2 層
blk.1  → ffn_gate_inp / ffn_up_exps / ffn_down_exps ...       → MoE(FFN)層
blk.5  → attn_q / attn_k / attn_v / attn_output               → Attention 層
53層すべてを分類した結果は次のとおりです。
| 層の種類 | 層数 | KVキャッシュ |
|---|---|---|
| Mamba-2 SSM | 23 | なし |
| MoE(FFN) | 23 | なし |
| Attention(GQA) | 6 | あり |
| Attention + MoE(最終層) | 1 | あり |
| 合計 | 53 | あり = 7層 |
並び順は Mamba-2 → MoE → Mamba-2 → MoE → Mamba-2 → Attention → MoE → … と、Mamba-2 と MoE を交互に重ねつつ、7層に1回ほど Attention を挟む構造でした。
つまり KVキャッシュを持つのは 7層だけで、残り 46層(Mamba-2 23層 + MoE 23層)は一切持ちません。 ここが通常の Transformer との決定的な違いです。
余談: 最終層(
blk.52)だけは Attention と MoE の両方に加えてnextn.*というテンソルを持っていました。メタデータのnextn_predict_layers = 1と合わせると、これが公式ブログの言う MTP(マルチトークン予測)用の層と考えられます。Ollama 側のパラメータにもdraft_num_predict: 2が設定されています。
- Attention 層は過去の全トークンの K/V ベクトルを保持し続けるため、KVキャッシュがトークン数に比例して増加します
- Mamba-2 SSM 層は過去の情報を固定サイズの状態ベクトルに圧縮して持ち回るため、context 長が伸びてもメモリが増えません34
- MoE(FFN)層はそもそも過去のトークンを参照しないため、context 長とは無関係です
さらに、残った 7層の Attention も head_count = 32 に対し head_count_kv = 2 という強めの GQA(Grouped Query Attention) 構成です。GQA は複数のクエリ head で 1組の KV head を共有することで、MHA 相当の精度を保ちつつ KVキャッシュを削減する手法です5。32 の query head が 2組の KV head を共有しているので、ここでもさらに 16分の1 に圧縮されています。
実測での裏付け:context を8倍にしてもVRAMが増えない
この性質②は、実測ではっきり確認できました。num_ctx を 8,192 と 65,536 に変えてロードし直し、/api/ps の size_vram(重みの GPU 搭載量)を比較します。各2回ずつ実行しました。
| num_ctx | size_vram | モデル全体サイズ |
|---|---|---|
| 8,192 | 13.283 GB | 25.537 GB |
| 65,536 | 12.973 GB | 25.713 GB |
context を 8倍(+57,344トークン)にしても、モデル全体サイズの増分はわずか 176MB です。 1トークンあたりに換算すると約 3KB になります(これは KVキャッシュ単体ではなく、compute バッファ込みの総増分です)。通常の Transformer なら 64k context の KVキャッシュだけで数GB〜10GB規模(概算)になるところなので、一桁以上小さいことになります。
「Mamba-2 ハイブリッドは長 context に強い」という設計上の主張が、そのまま VRAM 収支に効いていることが確認できました。
なお
size_vramが微減している点について: 2回とも同じ値が出たのでノイズではなく決定的な挙動です。Ollama/llama.cpp はロード時に「指定 context 長で必要なバッファ量」を見積もり、それを踏まえて GPU に載せるテンソル(重みを格納したデータの集合。モデルの読み込みや GPU/CPU への配置は、このテンソル単位で行われます)を決めます。バッファ用の余白を確保するために、テンソル単位で数百MB分を CPU 側へ退避させた結果、バッファは増えたのに重みの GPU 搭載量は減る、という逆転が起きたと考えられます。これは公式に文書化された仕様ではなく、実測パターンからの推測です。 「context を上げると VRAM が減る」という一般法則ではない点に注意してください。
Ollamaによる自動配置
以上の2つの性質を踏まえると、この種のモデルに有効な分割方針は次のようになります。
- 毎トークン必ず使うもの(Attention / GQA、Router、共有 Expert、KVキャッシュ)→ GPU VRAM へ
- 滅多に同時には要らないもの(残りの routed expert の重み)→ システム RAM へ
routed expert は 128個中 6個しか使われないので、CPU 側から都度読み出しても致命的なボトルネックになりにくいです。これが「25.4GB のモデルが 16GB VRAM で実用速度で動く」仕組みです。
補足: この考え方は llama.cpp の
--n-cpu-moeオプション(ルーティングされる expert の重みだけを CPU 側へ移し、Attention・KVキャッシュ・Router・共有 Expert は GPU に残す)が明示的に実装しているものです。今回は Ollama の自動分割に任せており、テンソル単位でどこに配置されたかまでは確認していません。 後述する「重みの約50%が GPU に載る」という実測値は、上記の方針と整合的である、という範囲の裏付けです。
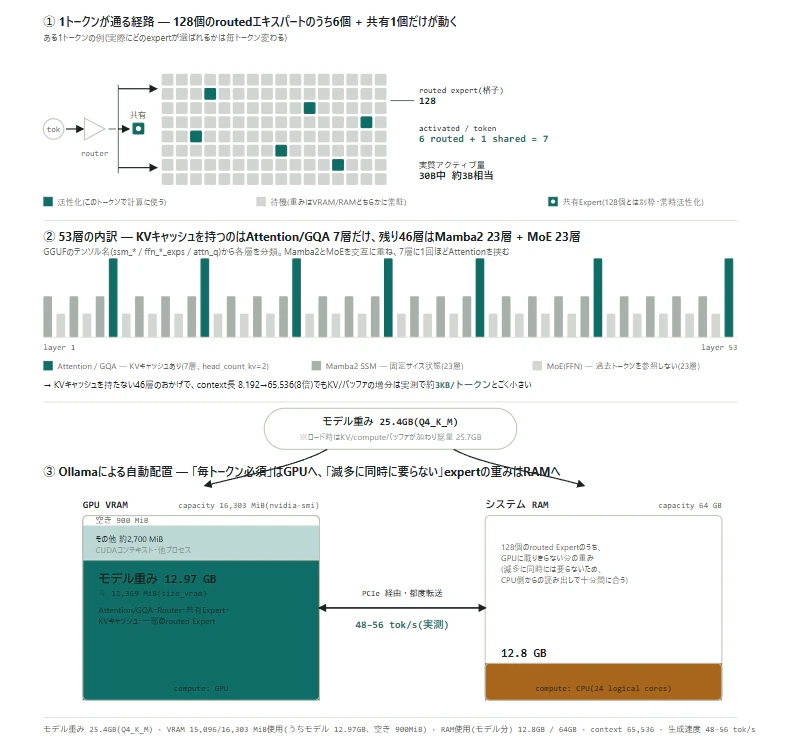
3. 実際の検証の流れ
3-1. 【要注意】Ollama のバージョン要件
前提の確認をしましょう。
ollama pull する前に、レジストリの manifest を確認します。25GB をダウンロードする前に中身がわかるためです。
curl -s https://registry.ollama.ai/v2/library/nemotron-3.5-lightning/manifests/30b-a3b \
  -H "Accept: application/vnd.docker.distribution.manifest.v2+json"
返ってくる manifest の config blob をさらに取得します。この blob は R2 ストレージへ 307 リダイレクトするので -L が必須です(付け忘れると空レスポンスに見えてハマります)。
curl -sL https://registry.ollama.ai/v2/library/nemotron-3.5-lightning/blobs/sha256:7101a4a1d9e3...
中身:
{
  "model_format": "gguf",
  "model_family": "nemotron_h_moe",
  "model_type": "32.9B",
  "file_type": "Q4_K_M",
  "renderer": "nemotron-3.5-nano",
  "parser": "nemotron-3.5-nano",
  "requires": "0.32.9",
  "architecture": "amd64",
  "os": "linux"
}
"requires": "0.32.9" — 当時インストールされていたのは 0.32.8 でした。この要件は Ollama のモデルページにもドキュメントにも書かれていません。manifest を見て初めてわかります。
新アーキテクチャのモデルは推論エンジン側の対応が必須なので、リリース直後のモデルを試すときは Ollama のバージョンを疑うのが定石のようです。公式インストーラで 0.32.9 に更新してから進めました。
ollama --version
# ollama version is 0.32.9
3-2. pull
ollama pull nemotron-3.5-lightning:30b-a3b
25GB のダウンロードです。筆者の環境では 10MB/s 程度で、40分ほどかかりました。
3-3. capabilities の確認
エージェント用途で使うなら、まず tools 対応の確認です。
curl -s http://localhost:11434/api/tags
{
  "name": "nemotron-3.5-lightning:30b-a3b",
  "details": {
    "family": "nemotron_h_moe",
    "parameter_size": "32.9B",
    "quantization_level": "Q4_K_M",
    "context_length": 1048576
  },
  "capabilities": ["completion", "tools", "thinking"]
}
tools と thinking の両方がついています。ちなみに Ollama では、tools 非対応のモデルにツール定義を渡すと、黙って無視されるのではなく HTTP 400 で明示的に拒否されます(筆者が別のモデルで確認済み)。事前確認の価値は高い項目です。
3-4. 生成テストとツール呼び出しテスト
まず素の生成を試します。
curl -s http://localhost:11434/api/generate -d '{
  "model": "nemotron-3.5-lightning:30b-a3b",
  "prompt": "1+1は?一言で。",
  "stream": false,
  "options": {"num_ctx": 8192}
}'
問題なく応答しました。次に num_ctx: 65536 でツール定義を渡します。
{
  "message": {
    "role": "assistant",
    "content": "",
    "thinking": "Here we need to get the current weather in Tokyo. Use get_weather function with city \"Tokyo\"...",
    "tool_calls": [{
      "id": "call_kusixoft",
      "function": {"name": "get_weather", "arguments": {"city": "Tokyo"}}
    }]
  }
}
日本語のプロンプト(「東京の今の天気を調べて教えて」)から都市名を正しく抽出し、tool_calls を返しました。thinking フィールドに推論過程も出ています。
💡 ハマりどころ: Windows のシェルから
curl -d '{"content":"日本語..."}'を直接叩くと文字化けすることがあります。モデル側のthinkingに "garbled characters" と出て一瞬モデルを疑いましたが、原因はシェルの文字コードでした。JSON を UTF-8 ファイルに書き出して--data-binary @file.jsonで渡すと確実です。
4. リソースの使用結果
すべて num_ctx: 65536 でロードした状態の実測値です。
VRAM
nvidia-smi --query-gpu=memory.used,memory.free --format=csv
# 15096 MiB, 900 MiB
| 項目 | 実測値 | 再現性 |
|---|---|---|
| モデル重み(GGUF) | 25.4 GB | 固定 |
うち GPU 搭載分(size_vram) |
12.97 GB | 4回ロードして毎回同一 |
| GPU 搭載率 | 約 50% | 同上 |
| GPU 全体使用量(nvidia-smi) | 15,096〜15,488 MiB / 16,303 MiB | 環境依存 |
| 空き VRAM | 約 500〜900 MiB | 環境依存 |
ギリギリですが収まります。 ただし読み方に注意が必要です。
再現性があるのは モデル自身の GPU 搭載量 size_vram = 12.97GB のほうです。何度ロードし直しても 1バイトも変わりませんでした。
一方 「空き VRAM」はモデルの性質ではなく、実行環境に依存する値です。 nvidia-smi --query-compute-apps で確認すると、ブラウザ・デスクトップアプリ・シェル UI など多数のプロセスが GPU を使っており、それだけで 2.5GB 前後を消費していました。実際、時間帯を変えて測り直すと空きは 500〜900MiB の間で動きます。
モデル 12.97GB + デスクトップ環境 約2.5GB ≒ 15.1〜15.5GB / 16.3GB
つまり GPU を使う常駐アプリが多い環境ほど余裕がなくなります。 逆に言えば、他アプリを閉じれば 2GB 以上の余裕を作れます。
なお /api/ps が返す総量は 25.71GB で、GGUF ファイルサイズ(25.4GB)より少し大きくなります。差分は KV/compute バッファです。本記事ではモデルのサイズを表す数値は GGUF の 25.4GB に統一し、バッファを含む値が必要な場面だけ明示します。
システムRAM
モデルを保持しているのは ollama.exe 本体ではなく、子プロセスの llama-server です。
Get-Process llama-server | Select-Object @{N='WorkingSetGB';E={[math]::Round($_.WorkingSet64/1GB,2)}}
# 例: 12.87
測定タイミングによって 12.5〜13.1GB の範囲で常駐します。これは VRAM に載らなかった分(バッファ込みの総量 25.71GB から GPU 搭載分 12.97GB を引いた約 12.7GB)とほぼ一致しており、CPU オフロードされた expert 重みがそのまま RAM に置かれている形です。
64GB 環境では余裕ですが、32GB 環境だと OS やその他アプリと合わせてかなり厳しいと思われます。公式・非公式問わず「システムRAM 32GB以上、できれば64GB」と言われるのはこのためかと思われます。
CPU
生成中のみバースト的に上昇し、終わるとアイドルに戻ります。負荷を担っているのは llama-server プロセスです。
瞬間的な使用率カウンタは値がぶれるので、プロセスの累積 CPU 時間の増分をストップウォッチの実測時間で割る方法で測りました。
| 測定区間 | 平均使用コア数 | 24コア換算 |
|---|---|---|
トークン生成中(eval_duration 基準) |
約 12.0 コア | 約 50% |
| リクエスト全体(HTTP往復含む) | 約 8.9 コア | 約 37% |
2回測定していずれも 12.0〜12.1 コアで一致しました。重みの半分が RAM 側にある以上、CPU は本当に計算しています。生成が走っている間は 24論理コアの半分が埋まるので、他の重い CPU タスク(ビルド等)との同時実行は速度低下を招きます。
生成速度
4種類のプロンプトで測定しました。tok/s は Ollama が返す eval_count(生成トークン数)を eval_duration(生成時間)で割った値で、モデルのロード時間やプロンプト解釈時間は含みません。
| # | プロンプト | 生成トークン数 | 生成時間 | tok/s |
|---|---|---|---|---|
| ① | 「1+1は?一言で。」 | 348 | 7.27s | 47.9 |
| ② | 「東京の今の天気を調べて教えて」(ツール定義あり) | 73 | 1.29s | 56.6 |
| ③ | 「日本の歴史を平安時代から明治維新まで、できるだけ詳しく解説してください。」 | 322 | 6.22s | 51.8 |
| ④ | 「日本の歴史を古代から現代まで、できるだけ詳しく、各時代ごとに段落を分けて解説してください。」 | 934 | 18.43s | 50.7 |
各試行の補足です。
-
① — 回答本文自体は「1 + 1 = 2」と一行ですが、このモデルは
thinking(推論過程)を出力するため、その分を含めて 348 トークンとなっています -
② — 渡したツール定義は
get_weather(パラメータはcityの1つのみ)の 1種類だけです。モデルはこれを 1回 呼び出しました({"city": "Tokyo"})。実際の天気 API には接続しておらず、tool_callsが正しい形式で返るところまでの確認です -
③④ — 長文生成時の速度を見るためのテストです。
num_predict(生成トークン数の上限)にそれぞれ 800 / 1500 を指定しましたが、モデルが上限に達する前に自然に応答を終えたため、実際の生成数は表の値になっています
おおむね 48〜56 tok/s でした。 生成トークン数が増えても速度が落ちていない点(④の 934トークンでも 50.7 tok/s)から、この範囲では安定して出ると見てよさそうです。
念のため日を改めて測り直しても 51.9〜55.3 tok/s と同じ範囲に収まりました。半分を CPU オフロードしている構成としては、体感でもストレスのない速度です。
参考:同じ Nemotron 系の 4B モデルとの比較
比較対象として、同じ PC 上で動かしている nemotron-3-nano:4b ベースのモデル(num_ctx 65536 を焼き込んだもの)を同条件で測定しました。
| 項目 | Lightning 30B-A3B | 参考: Nemotron 3 Nano 4B |
|---|---|---|
| 総 / アクティブ パラメータ | 30B / 3B | 4B / 4B |
| GGUF サイズ(Q4_K_M) | 25.4 GB | 2.8 GB |
VRAM 搭載量(size_vram) |
12.97 GB | 4.42 GB |
| GPU 搭載率 | 約 50%(CPUオフロードあり) | 100%(オフロードなし) |
| 生成速度 | 48〜56 tok/s | 約 200 tok/s |
| コールドロード時間 | 約 10〜28 秒 | 約 3 秒 |
| capabilities | completion, tools, thinking | completion, tools, thinking |
速度差は約4倍です。フル GPU 常駐の 4B モデルはやはり圧倒的に速く、GPU に 10GB 前後の空きを残せるので他アプリとの併用も気になりません。
一方で Lightning は総パラメータで7倍以上の規模を持つモデルです。**「速度を4分の1払って、より大きなモデルを 16GB VRAM 機に載せる」**という選択になります。
ただし 本記事は動作検証が目的であり、出力品質のベンチマークは行っていません。 実際にどちらが有利かは、タスクの性質次第です。
5. Hermes Agent での使用
公式ブログでは、OpenClaw や Hermes といった標準的なエージェントハーネス向けに最適化した学習(harness-optimized training)を行ったと述べられています1。実際にエージェントから使えるか試しました。
Hermes Agent は、モデルを一時的に差し替えて実行できる -m フラグを持っています。設定ファイルを変更せずワンショットで試せるので、検証にはこれが便利です。
hermes -m nemotron-3.5-lightning:30b-a3b \
  -z "シェルツールを使って現在のディレクトリのファイル一覧を取得して、結果を教えて"
結果、モデルは自発的にシェルツールを呼び出して ls -la を実行し、その出力を Markdown の表に整形したうえで、「ドットファイルが大半を占める」「大きなメディアファイルや実行ファイルは見当たらない」といった観察を日本語で付け加えて返してきました。
ツール定義の解釈 → ツール呼び出し → 結果の受け取り → 要約 という一連のループが、追加設定なしで成立しています。
なお今回の環境では Ollama の OLLAMA_NUM_PARALLEL が 1 でした(サーバー起動時のログで確認)。このためエージェントが複数のツールを並列実行しても、モデルへのリクエスト自体は逐次処理されます。KV/compute バッファはロード時に num_ctx 分を先に確保する方式なので、会話が伸びて context が埋まってきても VRAM 使用量は増えません。前掲の「空き 900MiB」は単発 QA でもエージェントの長い会話でもほぼ同じ値になります。
6. まとめ
- 総重み 25.4GB(Q4_K_M)のモデルが、VRAM 16GB 機で 48〜56 tok/s で動作しました。 MoE の疎な活性化(1層あたり128エキスパート中6個 + 共有1個)と、53層中46層が KVキャッシュを持たない構成(Mamba-2 が23層、MoE が23層)という2つの性質が、CPU オフロードと噛み合った結果です
- context を 8,192 → 65,536(8倍)にしても VRAM はほぼ増えません(総増分 176MB)。長い context を扱うエージェント用途で、この特性は効きます
- リソース収支: VRAM 搭載量 12.97GB / システムRAM 約12.8GB / 生成中の CPU 約12コア(24論理コア中)。RAM は最低 32GB、実用上は 64GB を推奨します。VRAM の空きは他アプリの使用状況次第で数百MiB まで詰まります
-
躓きポイント: モデル manifest に
"requires": "0.32.9"というランタイムバージョン要件が埋まっていました。ドキュメント化されていないので、リリース直後のモデルを試すときは manifest を先に見るか、Ollama を最新にしてから臨むのが安全です - 使い分けの示唆: 反応速度と VRAM 余裕を優先するなら小型モデルのフル GPU 常駐、より大きなモデルの表現力と長 context を優先するなら Lightning、という棲み分けになりそうです
「30B のモデルが 16GB VRAM で動く」という結果そのものより、アクティブパラメータとアーキテクチャを見れば動くかどうかは事前に見積もれるという点はありがたいです。GGUF はメタデータもテンソル構成も先頭数MBに入っているので、HTTP Range で部分取得するだけで「何層がどの種類か」まで判別できます。25GB をダウンロードする前に判断できます。
本日も大変勉強になりました。
7. 追記:これはDGX Sparkでの「織り込み済み」の話なのか
「DGX Sparkで動くという触れ込みなので、今回のようなリソース制約下での動作は最初から想定されていたのでは」と思い公式情報も整理してみました。
設計思想としては明確に織り込まれている
NVIDIA公式ブログは、このモデルが DGX Spark からデータセンターまで幅広いハードウェアへの配置を意図した設計だと述べています。
"at a size that deploys anywhere from an NVIDIA DGX Spark to a data center"
"makes capable agentic AI accessible on local systems including NVIDIA Jetson, GeForce RTX 5090"1
そして「なぜ30B total / 3B activeなのか」という設計理由について、DGX Sparkの帯域制約(273GB/s)を引き合いに、第三者の技術記事が次のように解説しています。
"On a bandwidth-bound box like the Spark (273 GB/s), the active parameter count is what decides your decode speed. That is the reason this model exists at this size."6
「リソースが制約された環境では、アクティブパラメータ数が実効速度を決める」という設計原理そのものは、まさに今回検証した内容の理論的裏付けです。この点は織り込み済みと言えそうです。
具体的なシナリオとしては想定の外側
一方、NVIDIA自身が Hugging Face で公開しているモデルカードには、より控えめなガイダンスがあります。
"You can use
/set parameter num_ctx DESIRED_CONTEXT_LENGTHwhich may result in CPU offloading for higher context limits."
"Ollama will dynamically set context based on available VRAM (under 24GB → 4K, 24–48GB → 32K, 48GB+ → 256K)"7
16GB VRAM(24GB未満)のカードに対する公式のデフォルトは 4Kコンテキストです。本記事で検証した num_ctx=65536 は、その16倍にあたります。
- NVIDIA の記述は「context を伸ばすと CPU オフロードが起きうる」という補助的な言及にとどまり、「重み自体(Q4_K_M で25.4GB)が VRAM(16GB)に収まらないためオフロードが必須になる」という今回のケースを正面から想定した書き方ではありません
- 2章で示した「Mamba2 ハイブリッドのおかげで context を伸ばしても VRAM がほぼ増えない」という実測は、公式のデフォルト推奨(24GB未満→4K)よりずっと踏み込んだ運用ができることを示しています
- NVIDIA公式が配布するチェックポイントは NVFP4(約21.6GB)と BF16 で、本記事で使った Q4_K_M(Ollama経由のGGUF)は NVIDIA自身の公式配布物ではなく、コミュニティ/エコシステム側の量子化です
まとめると
「アクティブパラメータを絞ってリソース制約環境で速度を出す」という設計思想は、DGX Sparkの帯域制約を念頭に明確に織り込まれています。ただし「16GB VRAMの単体GPU + Ollama + Q4_K_M + 65536コンテキスト」という具体的な組み合わせは、NVIDIA自身の公式ガイダンス(24GB未満→4K推奨)よりも制約を持ってしまった内容で、公式が明示的に検証・想定されているシナリオそのものとは言えなさそうですが動くことは救いです。
-
NVIDIA Nemotron 3.5 Lightning Delivers Fast, Accurate, Specialized Task Execution for Long-Running Agents | NVIDIA Technical Blog ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9
-
NVIDIA Nemotron Nano 2: An Accurate and Efficient Hybrid Mamba-Transformer Reasoning Model (arXiv:2508.14444) および NVIDIA Nemotron 3 Nano Technical Report ↩
-
Mamba: Linear-Time Sequence Modeling with Selective State Spaces (Gu & Dao, arXiv:2312.00752) ↩
-
Transformers are SSMs: Generalized Models and Efficient Algorithms Through Structured State Space Duality (Dao & Gu, arXiv:2405.21060) ↩
-
GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints (Ainslie et al., EMNLP 2023, arXiv:2305.13245) ↩
-
Running Nemotron 3.5 Lightning on DGX Spark | Kubesimplify ↩
-
nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 · Hugging Face ↩