
📺 この記事は YouTube チャンネル きなこもっちーのテック深掘り の動画解説記事です。
▶️ 動画はこちら → なぜ32Bより小さい27Bが1位なのか|whichllmのRTX 4090例 92.8点と83.0点
🐹🦜 この記事に登場する2匹
- 🐹 もっちー (ハムスター)… AI はまだ勉強中。「それどういうこと?」と素朴に質問する生徒役
- 🦜 きなこ (セキセイインコ)… AI で調べものをこなす解説役。やさしく深掘りして教える先生役
この記事は2匹の掛け合いを書き起こした形式です。発言の先頭にいる絵文字+名前が話者です。
はじめに
🐹 もっちー「ねえきなこ、ローカルでAIを動かすなら、VRAMに収まる一番大きいモデルを選べばいいんでしょ?」
🦜 きなこ「そう思うよね。でも、whichllmっていうツールの作者は、そこをはっきり否定してるの」
🐹 もっちー「否定?大きいほうが賢いに決まってるやん!」
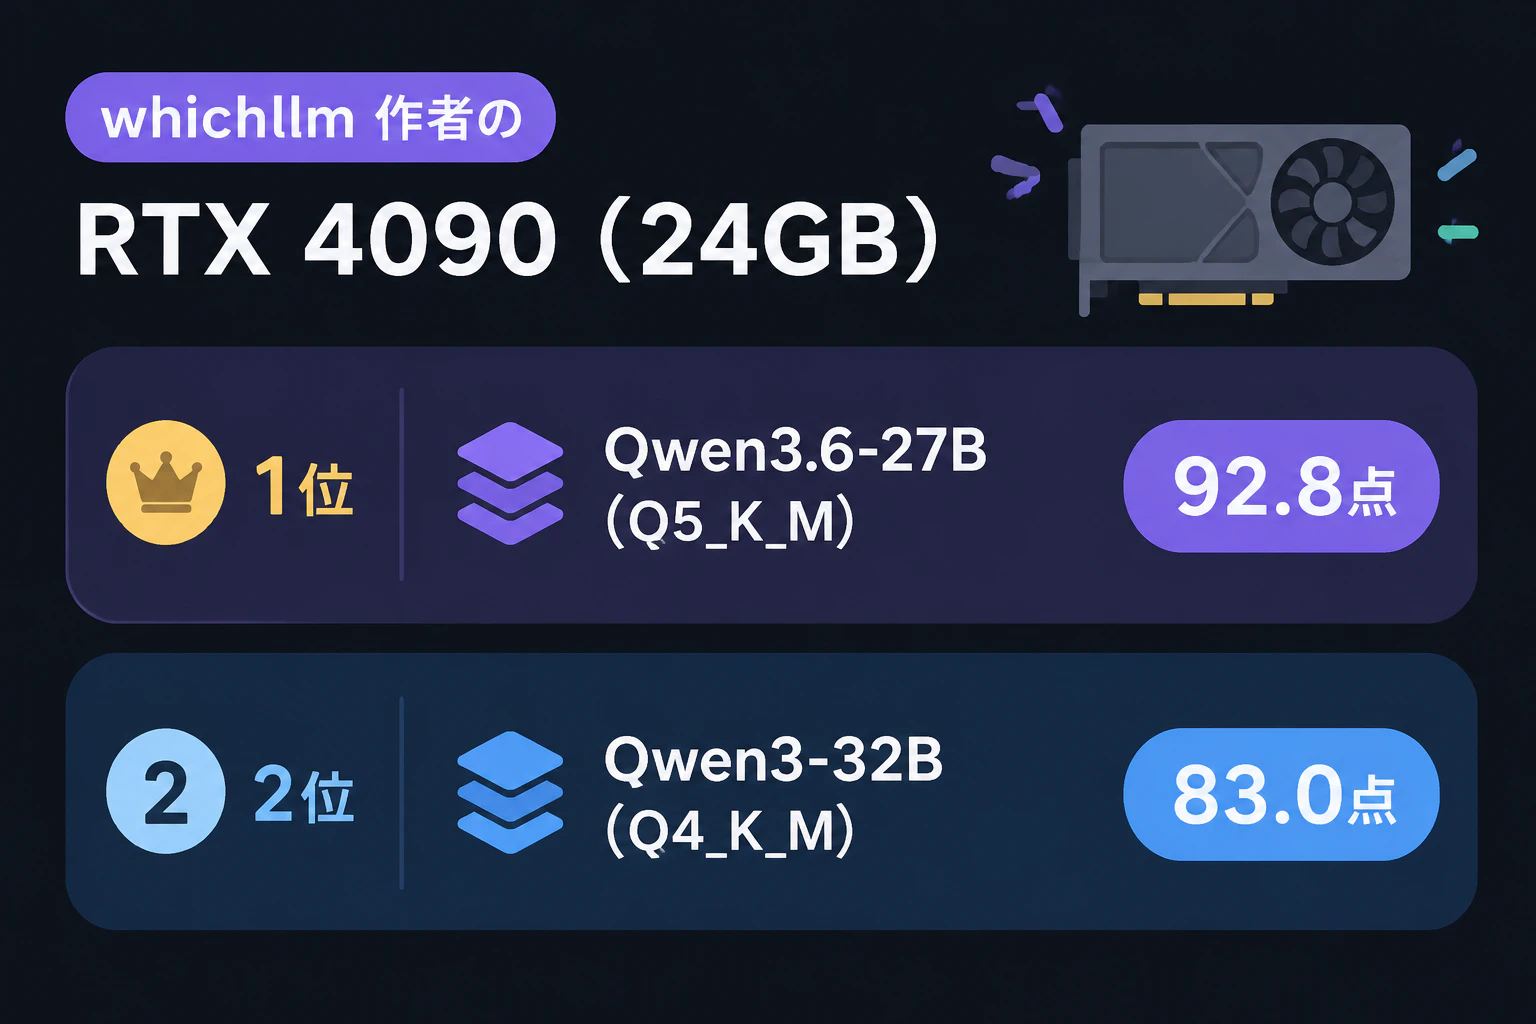
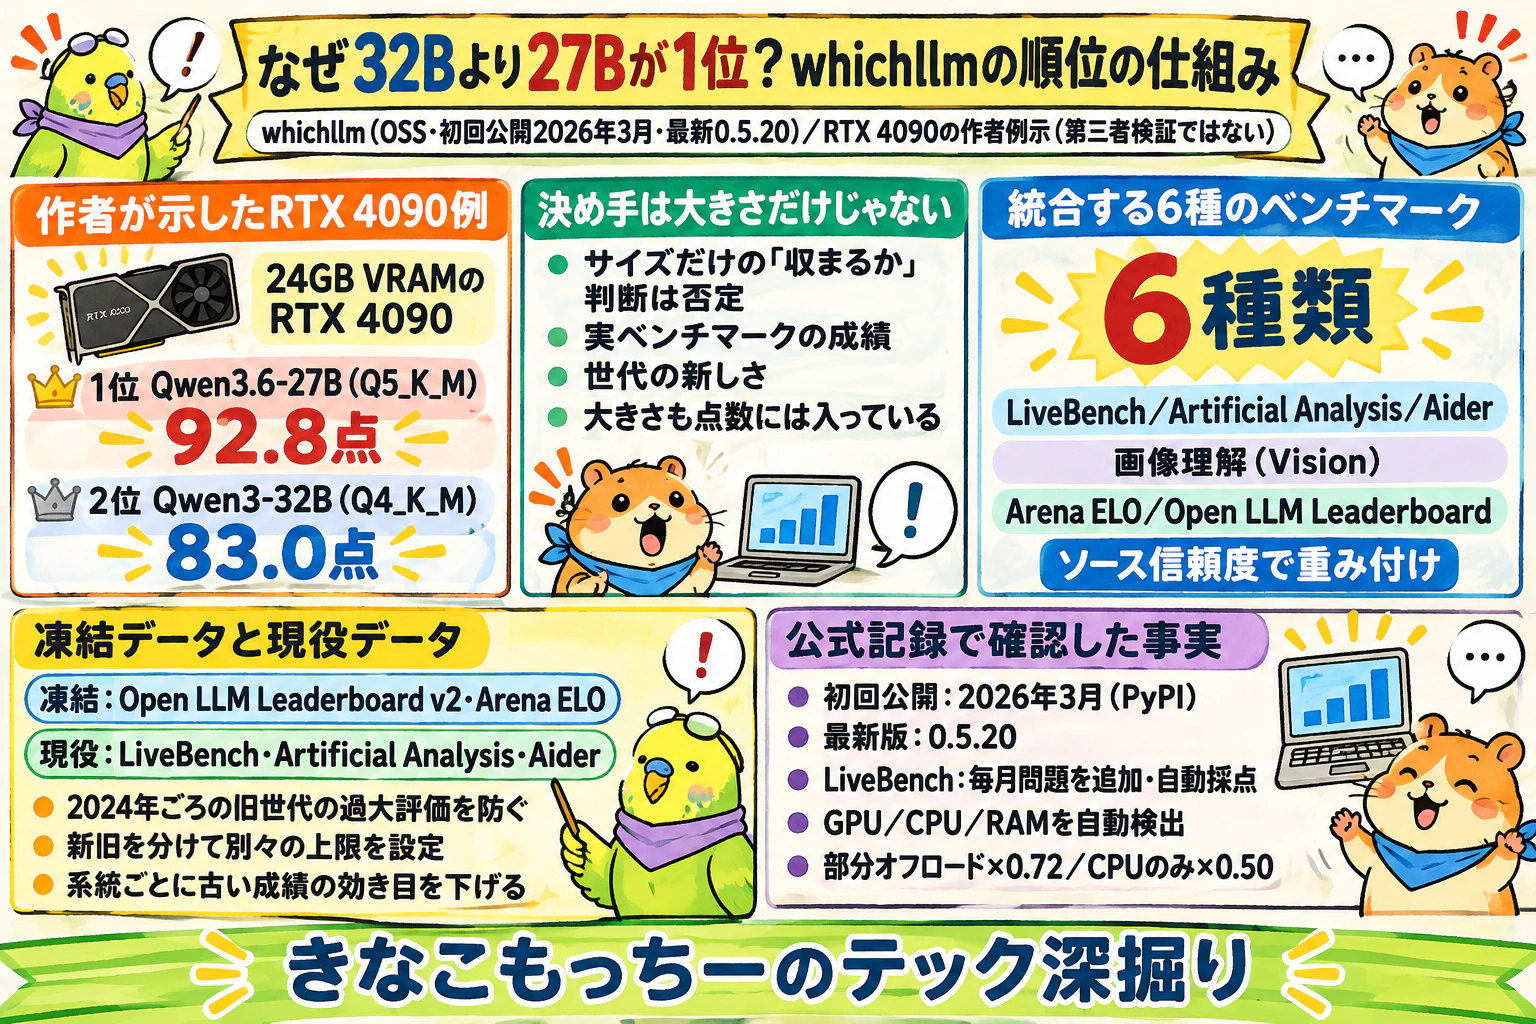
🦜 きなこ「作者の例だと、24GBのRTX 4090で1位はQwen3.6-27Bで92.8点。カードに収まる32Bは83.0点で2位なの」
🐹 もっちー「えっ、小さいほうが勝ってるの?」
🦜 きなこ「作者によると、決め手は大きさじゃなくて、実際のベンチマーク成績と世代の新しさなんだよ」
🐹 もっちー「じゃあ、大きさって全然関係ないの?」
🦜 きなこ「ううん、点数には入ってる。どれだけ効くのか、順位をどこまで信じていいのか見ていくね」
whichllmは何を見て順位をつける?
🦜 きなこ「白状するとね、私、最初はこのツールを、2026年6月に出たばかりで、ベンチマークを4種類まとめたものだと読んでたの」
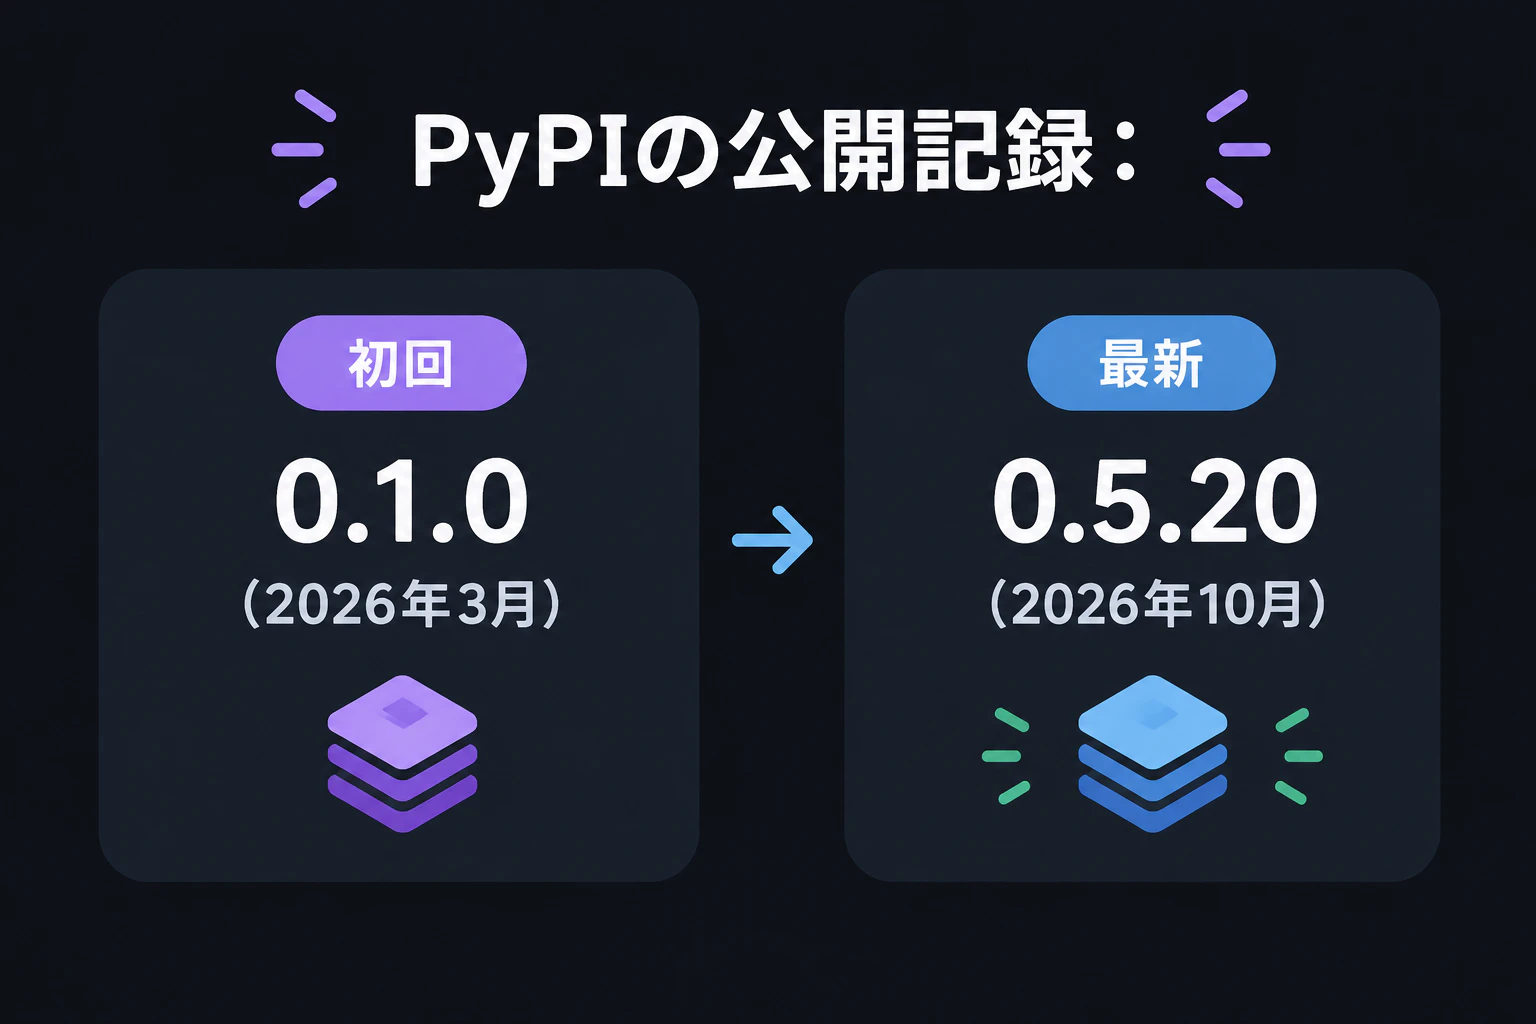
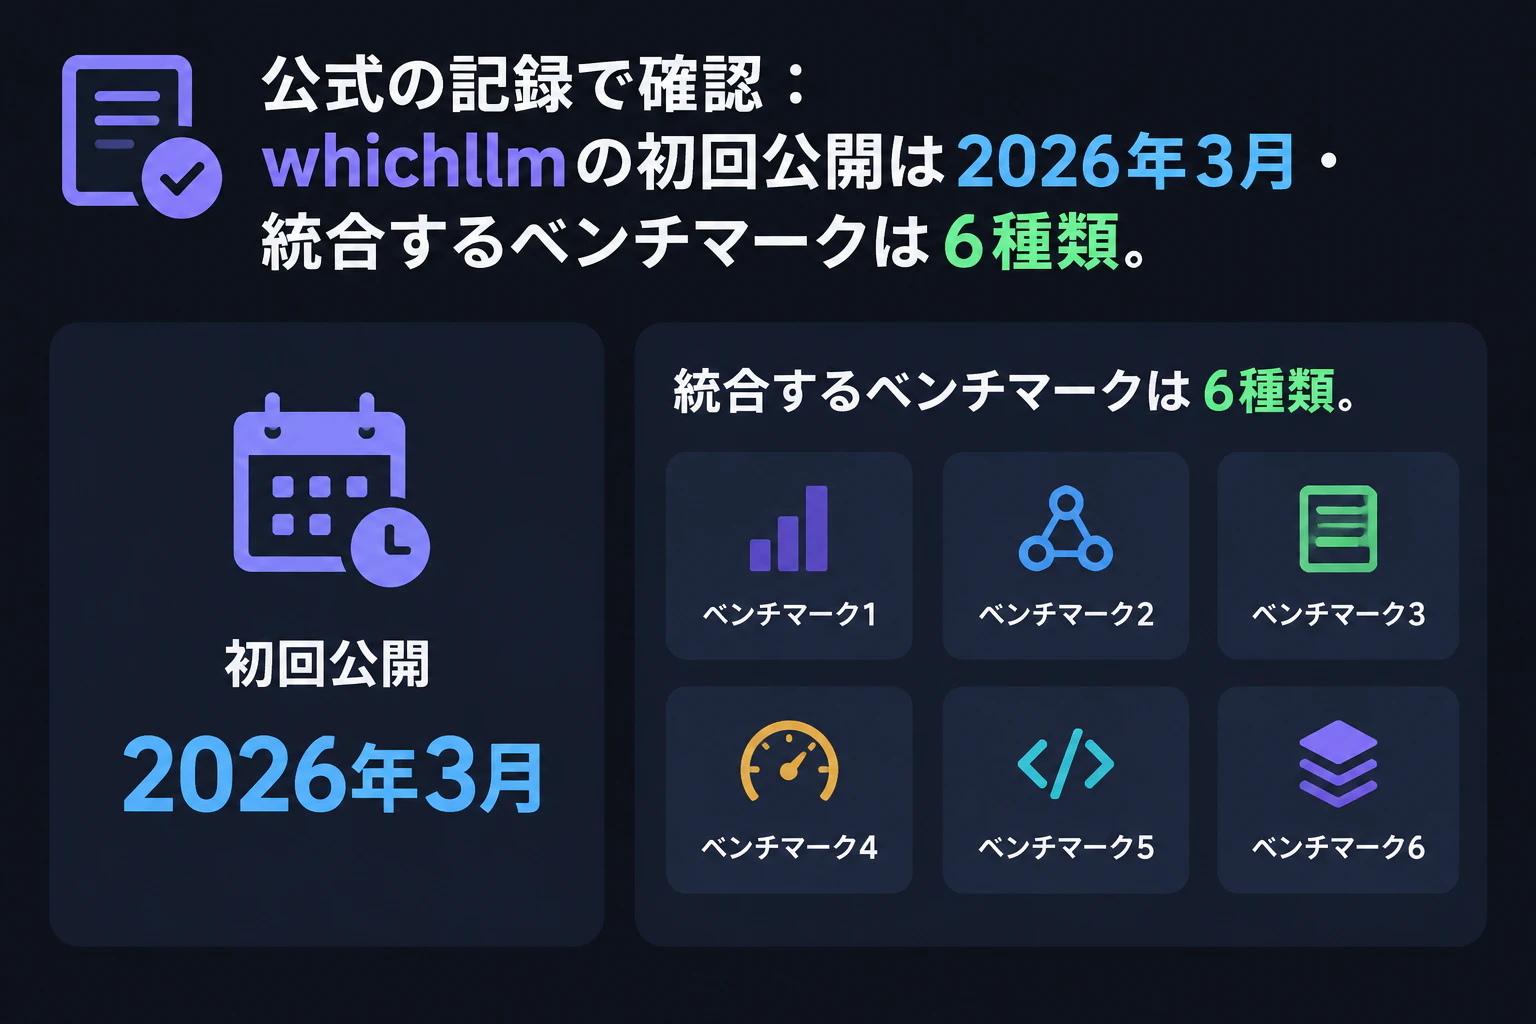
🦜 きなこ「でも公式の記録を見たら、見立て違いだった。Pythonの道具の公式の棚、PyPIだと最初の公開は2026年3月で、最新版は0.5.20なの」
🐹 もっちー「じゃあ、ベンチマークは本当は何種類なの?」
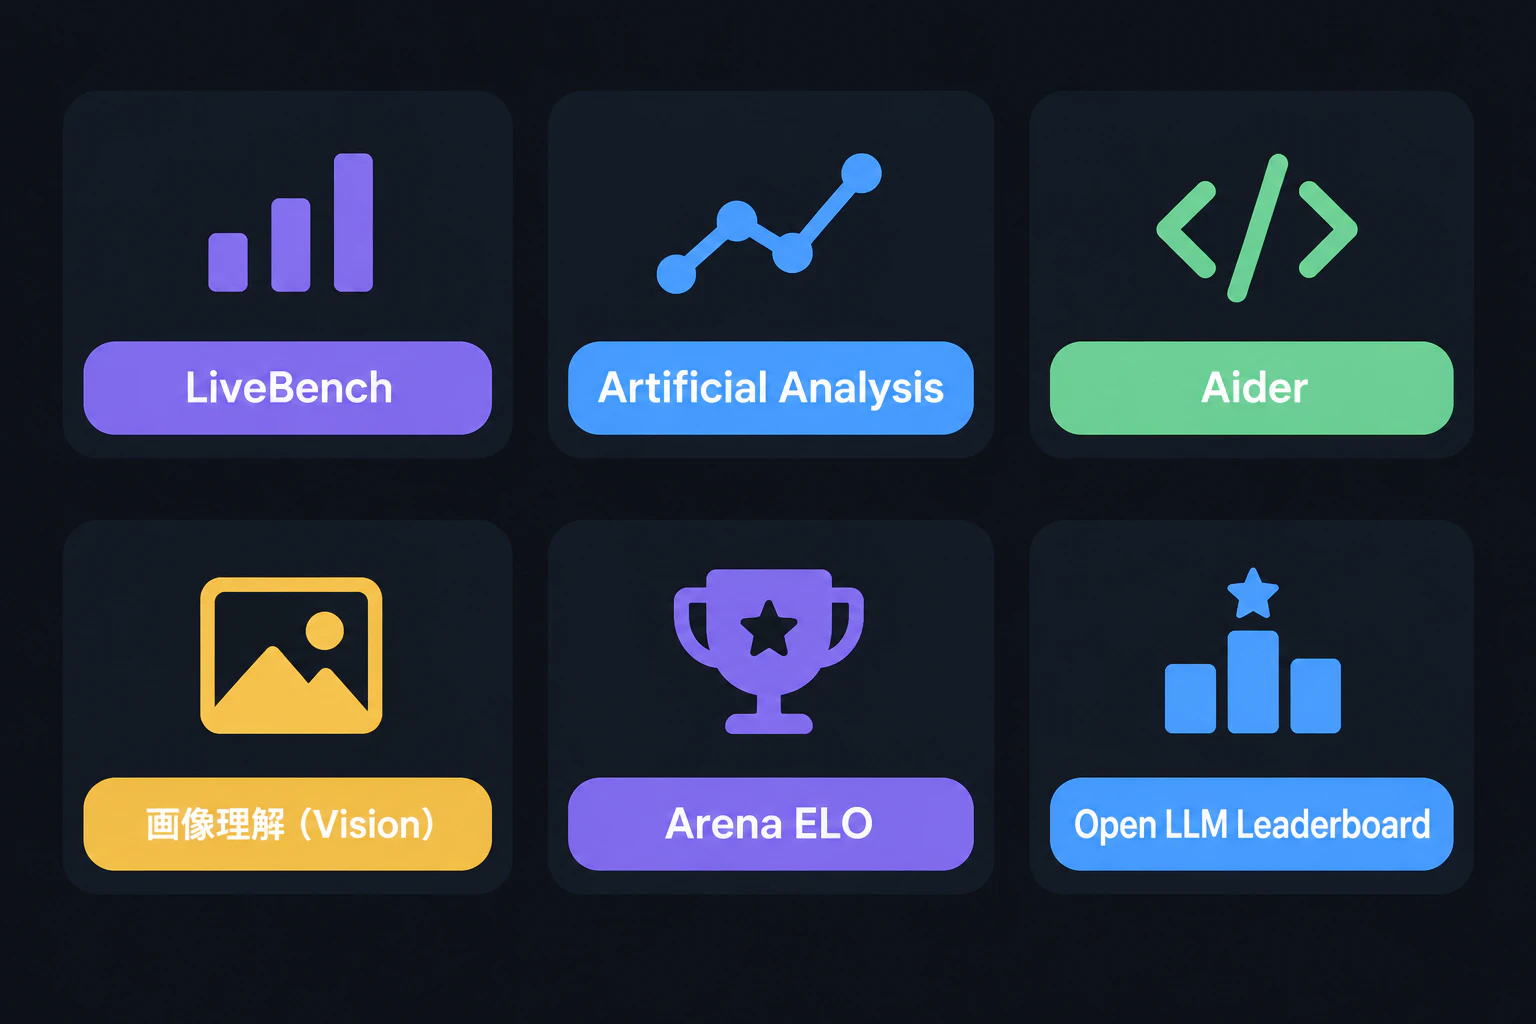
🦜 きなこ「6種類。LiveBench、Artificial Analysis、Aider、画像の理解の指標、Arena ELO、Open LLM Leaderboardだよ」
🐹 もっちー「多っ!それ全部、今のモデルの成績なん?」
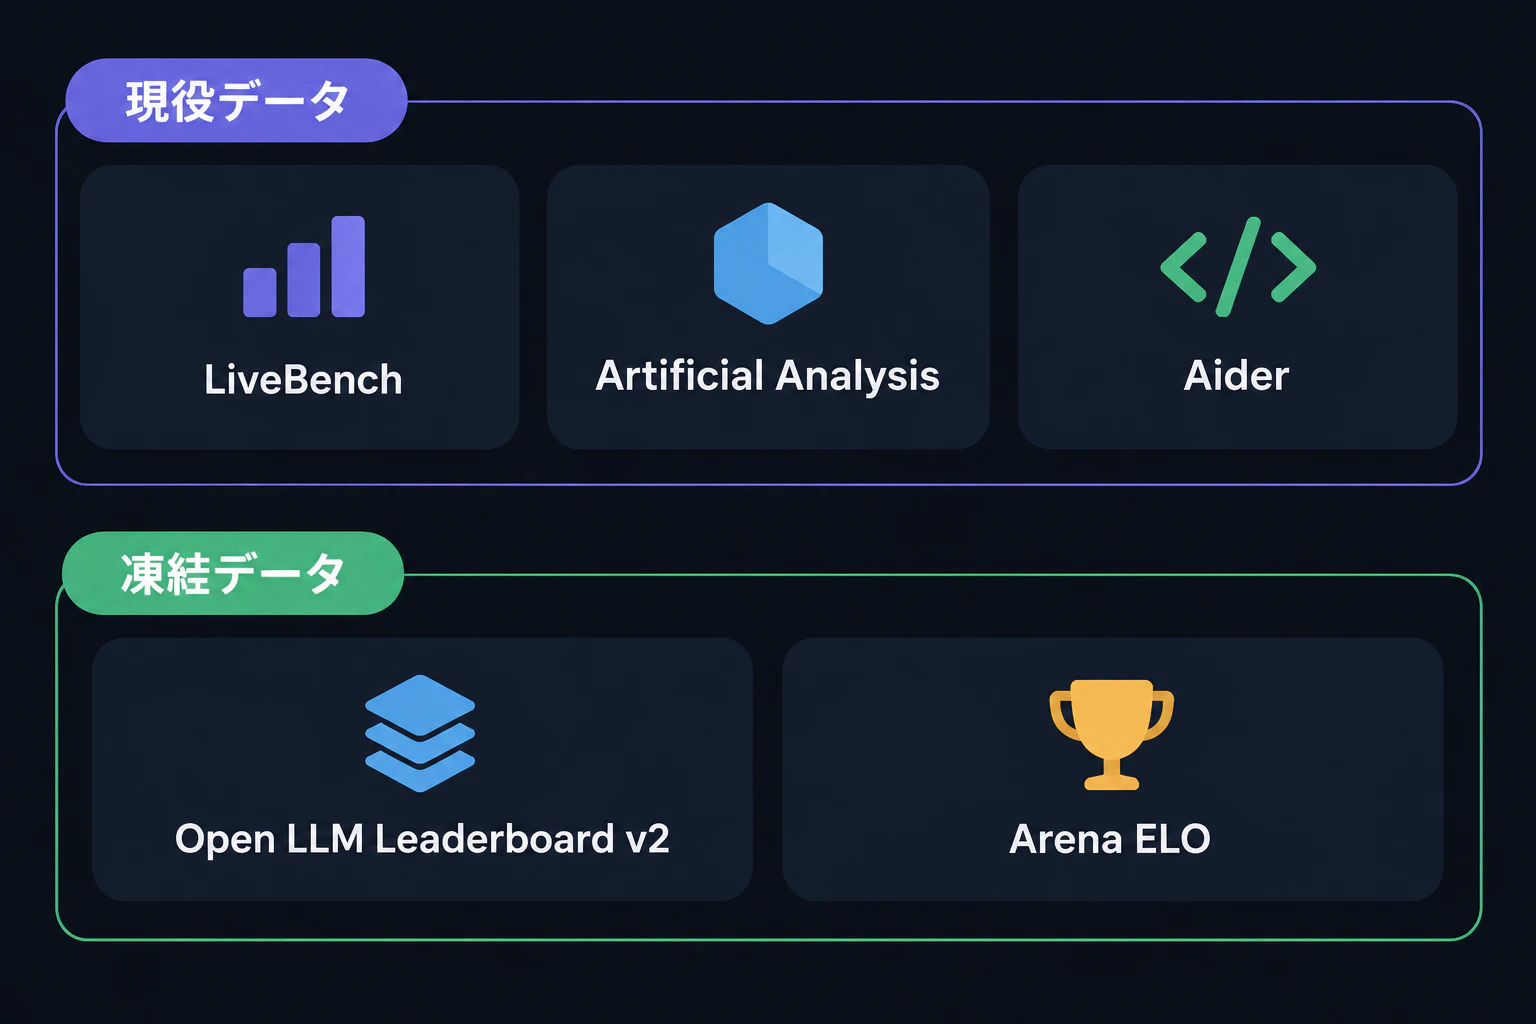
🦜 きなこ「そこがポイント。Arena ELOとOpen LLM Leaderboard v2は、昔の記録を固めた凍結データとして扱われてるの」
🐹 もっちー「なんでわざわざ固めちゃうの?古い成績なら、捨てちゃえばいいのに」
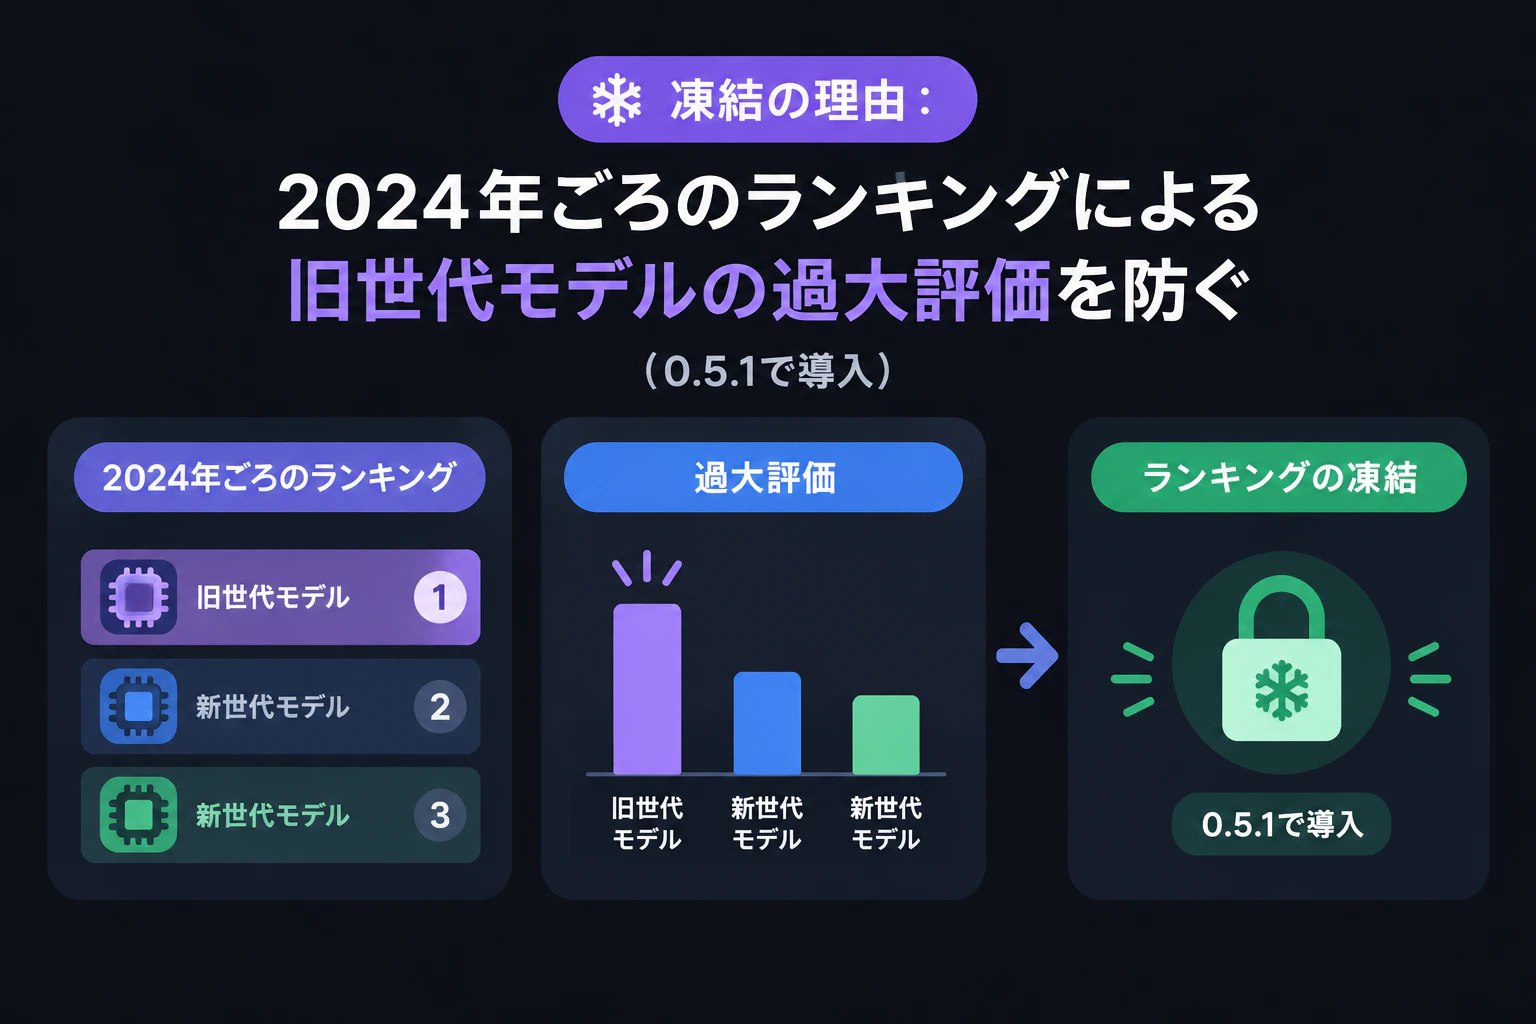
🦜 きなこ「公式の説明だと、2024年ごろのランキングが、古い世代のモデルを高く見すぎるのを防ぐためなの」
🦜 きなこ「新しい成績と古い成績を分けて、それぞれに別々の上限を付けてるんだよ」
🐹 もっちー「ってことは、古いテストの点で、昔のモデルが上に来すぎないようにしてるってこと?」
🦜 きなこ「そういうこと。モデルの系統ごとに、古い成績の効き目を下げる仕組みもあるんだよ」
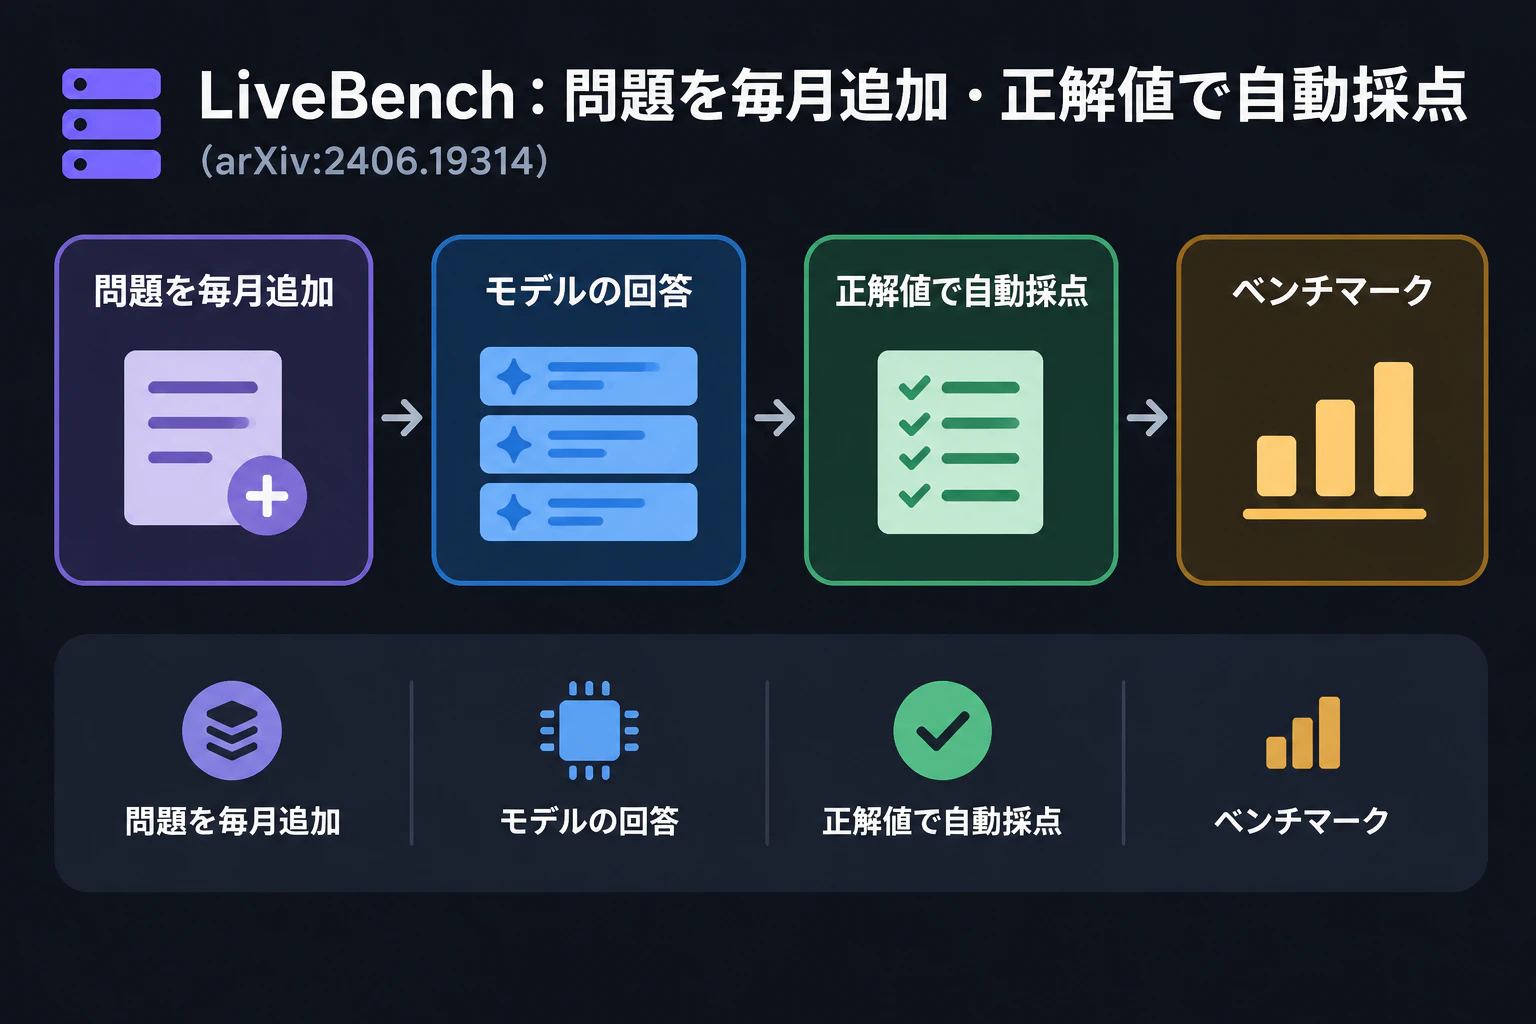
🦜 きなこ「ちなみにLiveBenchは、問題を毎月足していく設計で、答えを機械的に採点するテストなの」
🐹 もっちー「答えを丸暗記されにくいテストってことか!」
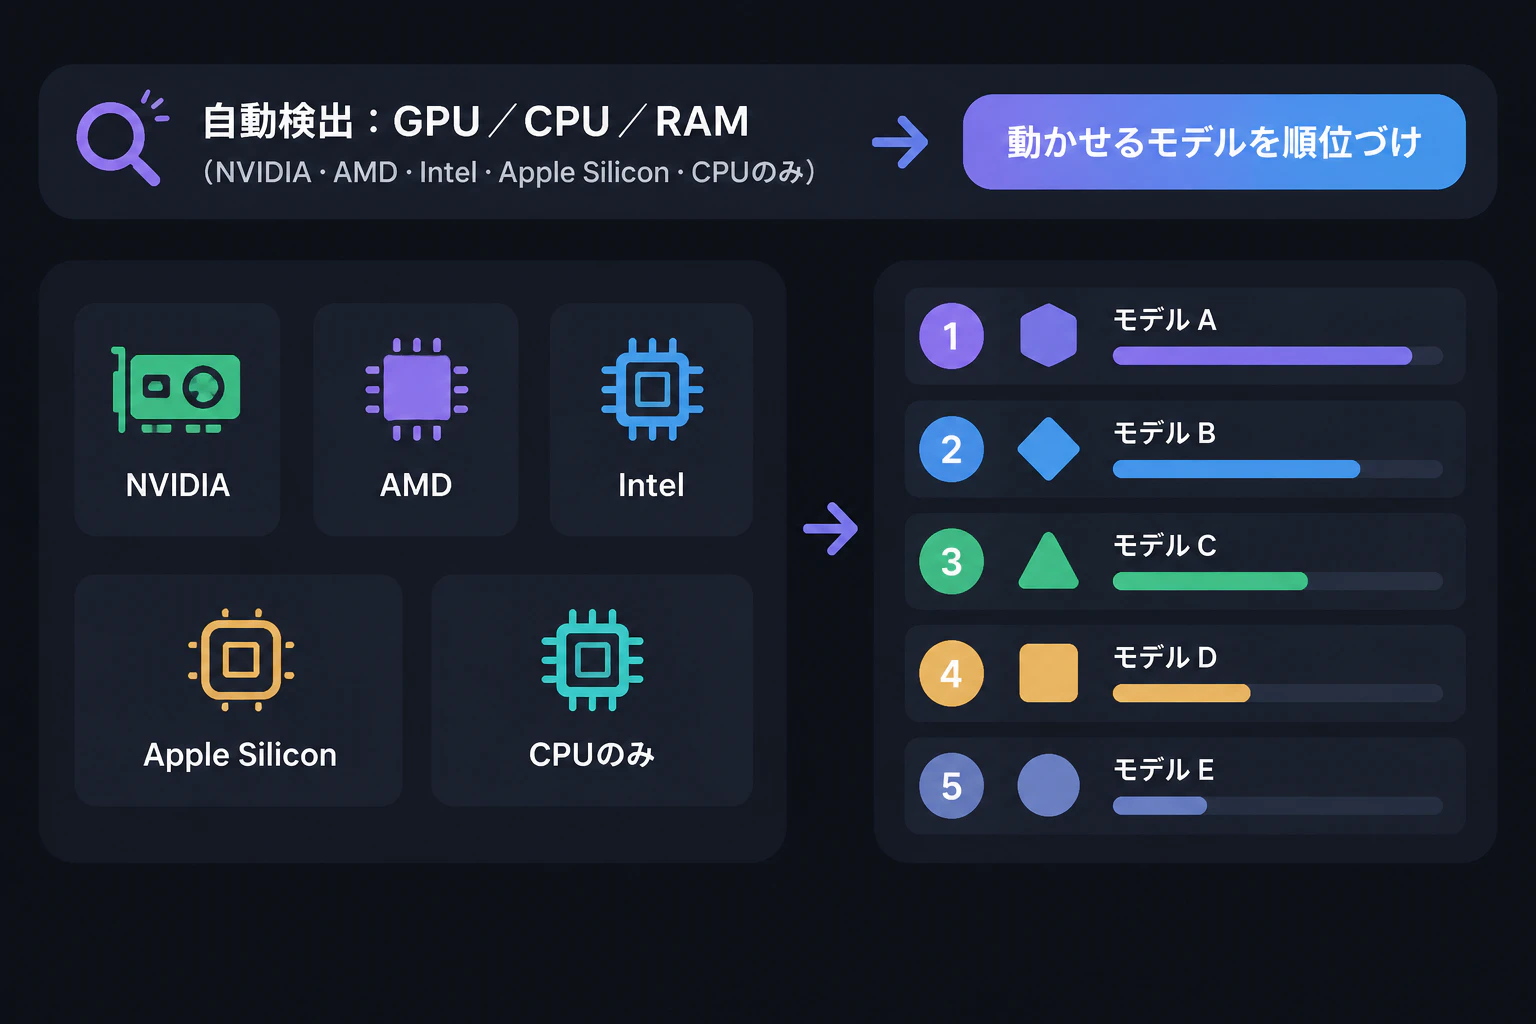
🦜 きなこ「うん。それに、PCのGPUやメモリを自動で調べて、そのマシンで動かせるモデルを、動かし方まで考えて並べてくれるんだよ」
🐹 もっちー「なるほどね。成績表をいっぱい集めて、一番点がいいモデルを選んでくれる仕組みなんだ」
大きさは何点ぶん?
🐹 もっちー「でもさ、結局モデルが大きいほど、点数もどんどん上がるんでしょ?」
🦜 きなこ「そう思うよね。whichllmも、大きさを物知り度の目安として、ちゃんと点数に入れてるの」
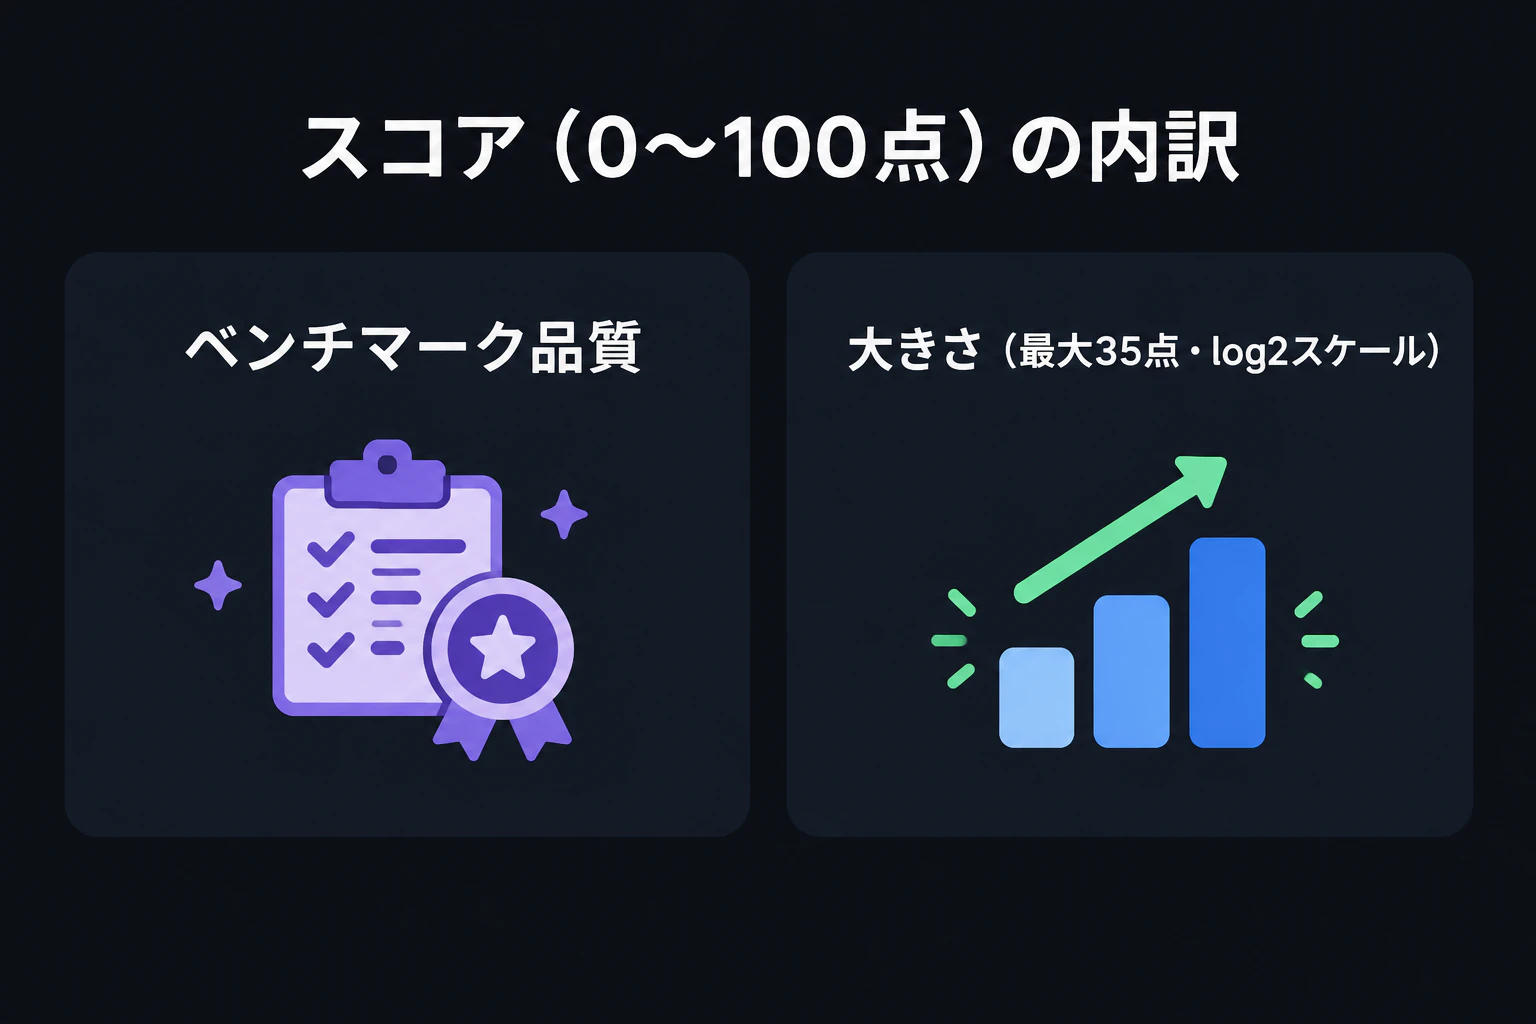
🦜 きなこ「でも、大きさの点は最大35点まで。しかも大きくなるほど、点の増え方がゆるやかになる計算なんだよ」
🐹 もっちー「100点満点のうち35点か。じゃあ、残りはどこから来るの?」
🦜 きなこ「土台はベンチマークの成績。そこに、掛け算の割引がかかるの」
🐹 もっちー「割引?セールみたいに?」
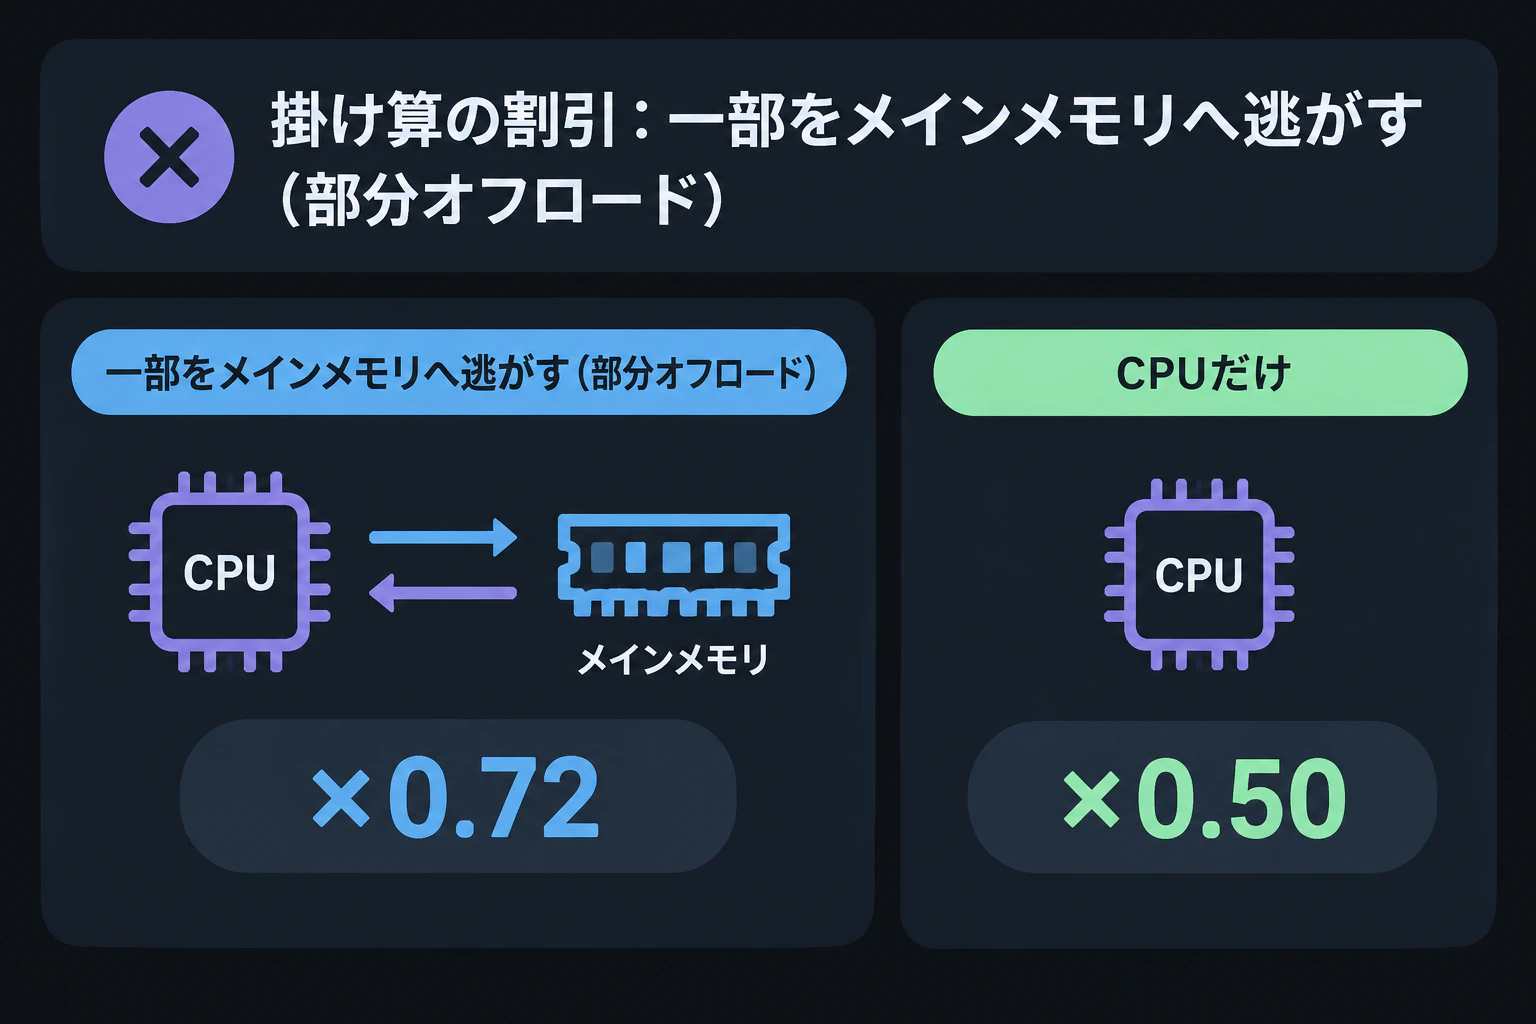
🦜 きなこ「逆セールかな。READMEの表だと、VRAMに乗りきらず一部をメインメモリに逃がすと0.72を掛ける。CPUだけなら0.5なの」
🐹 もっちー「CPUだけやと半分!?はみ出したら損するやん!」
🦜 きなこ「そうなの。ただ、ちょっとはみ出すだけなら割引をゆるめる調整が、0.5.10で入ってるんだよ」
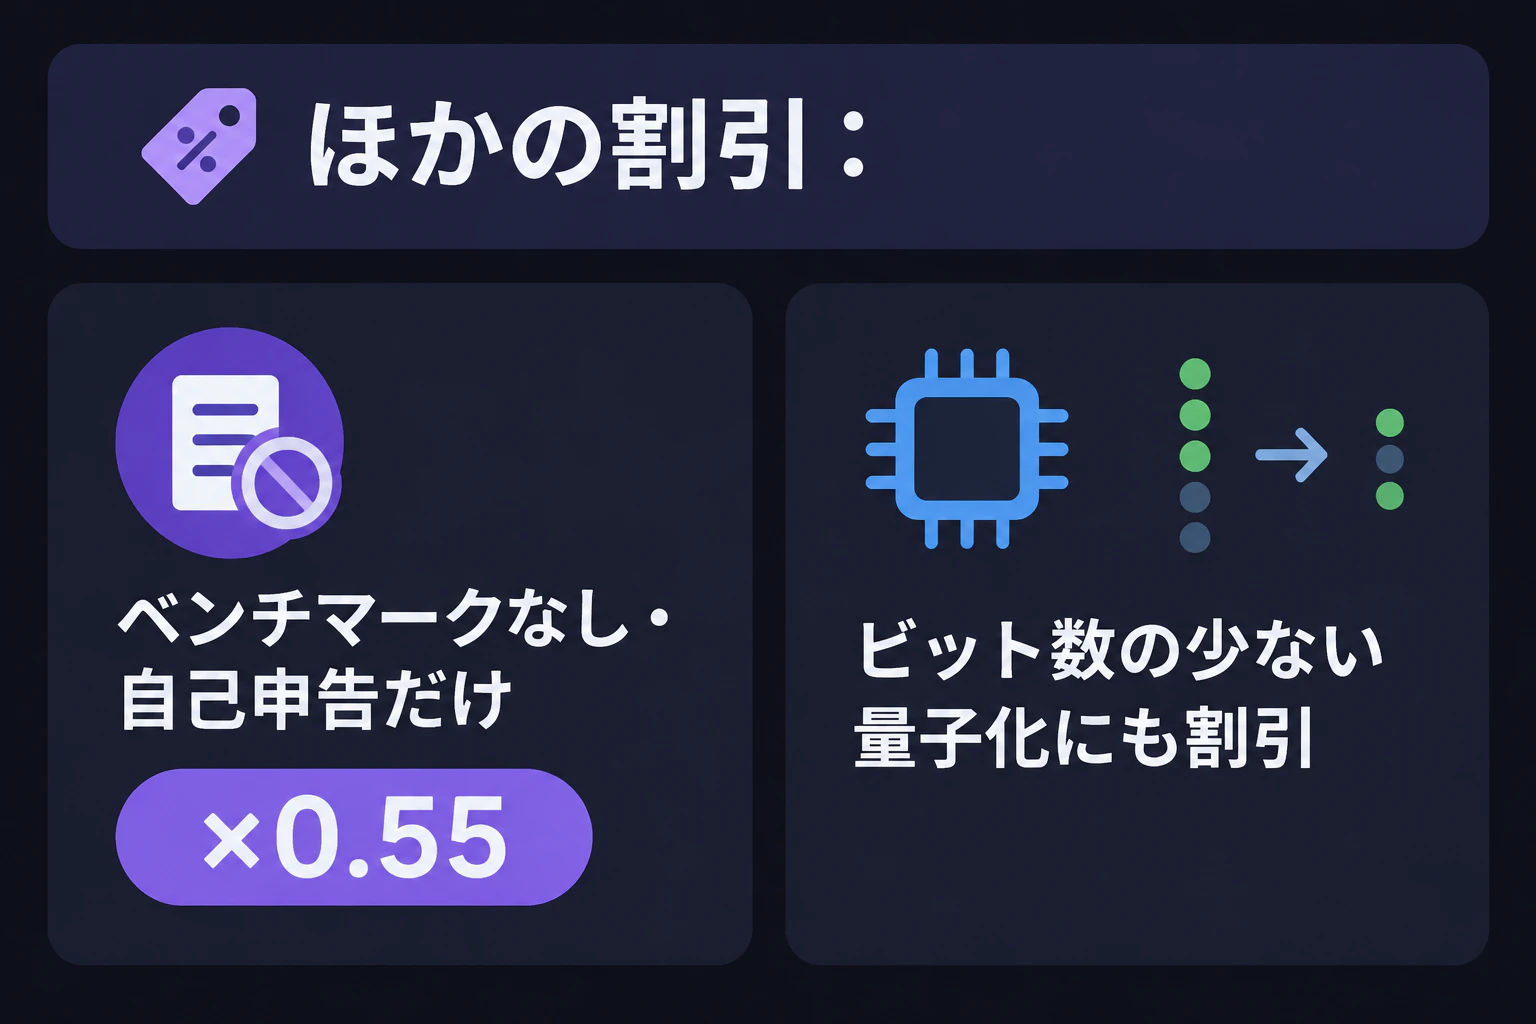
🦜 きなこ「それから、成績の証拠が自己申告だけのモデルも0.55倍。ビット数を減らした量子化にも、割引がかかるの」
🐹 もっちー「量子化ってなに?」
🦜 きなこ「モデルの中の数字を、細かさを落として小さく保存することだよ」
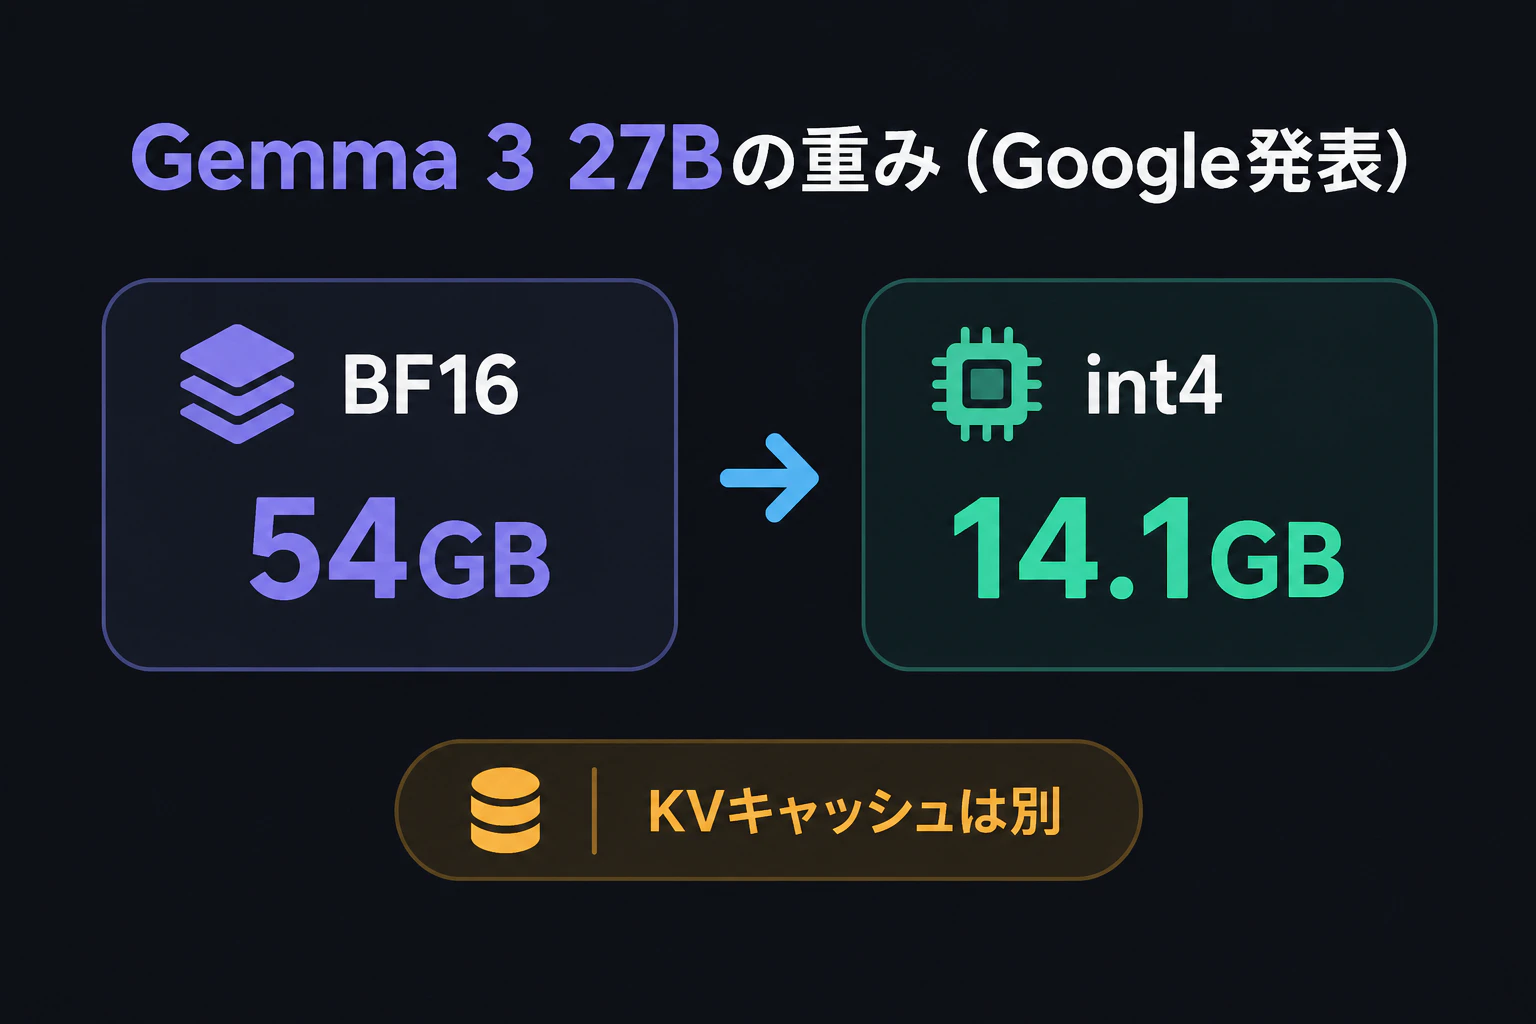
🦜 きなこ「Googleの発表だと、Gemma 3の27Bは、重みだけでBF16なら54GB。4bitにすると14.1GBになるの」
🐹 もっちー「4分の1くらいやん!写真の画質を落として、容量を減らすようなもんやな!」
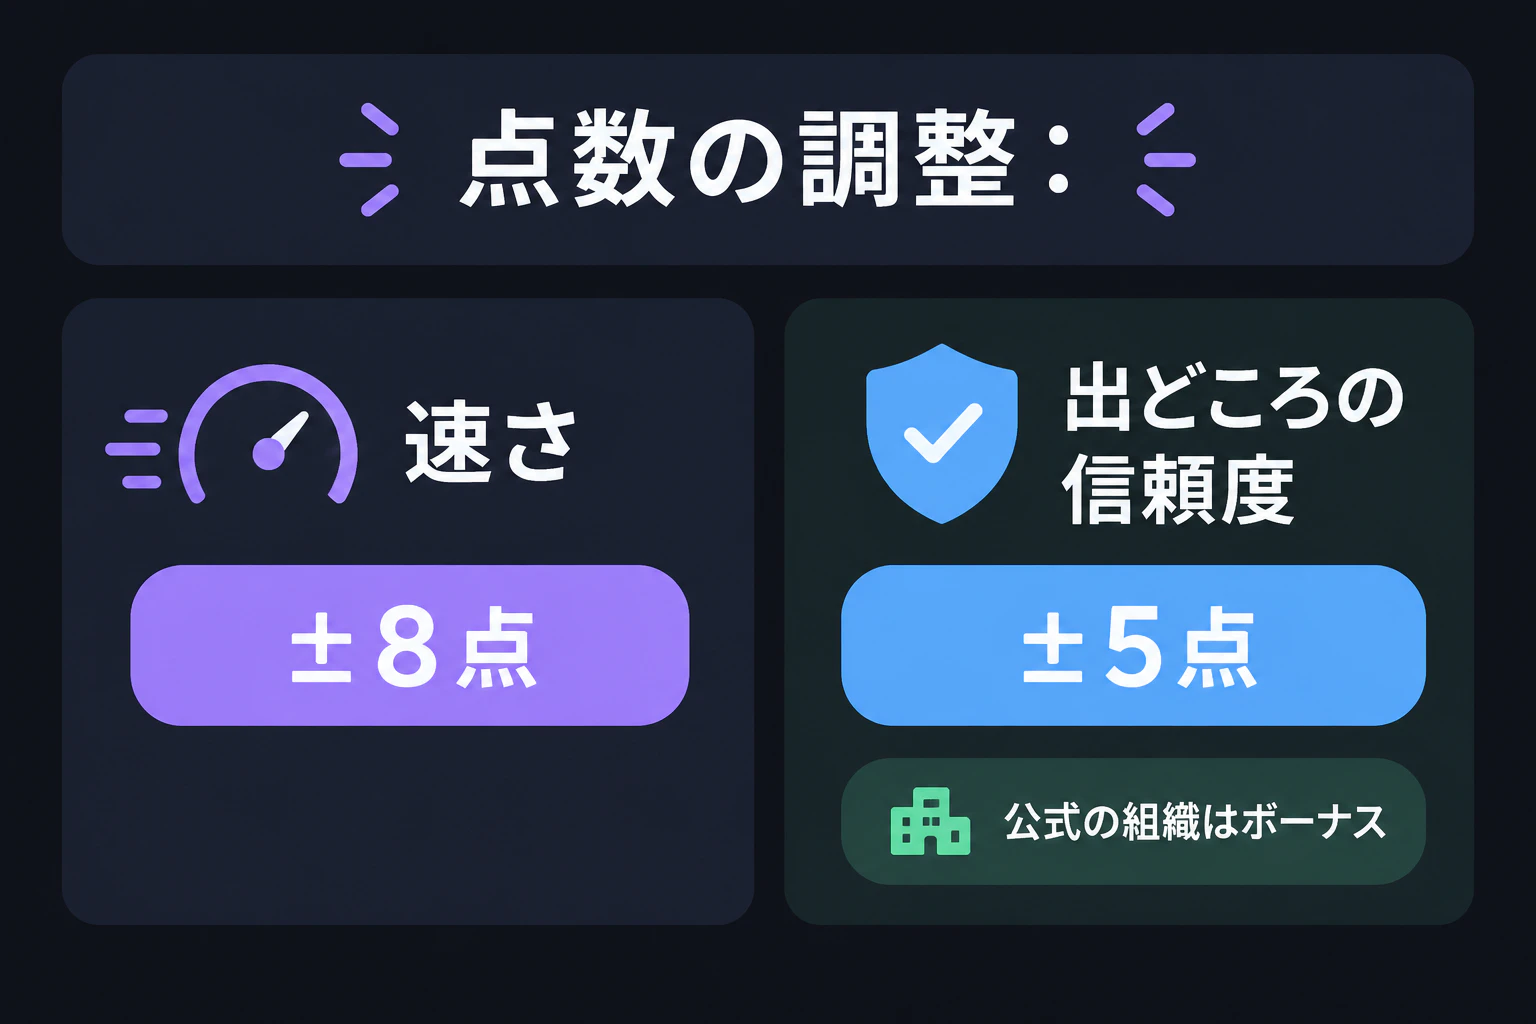
🦜 きなこ「いいたとえ。あと、速さでプラスマイナス8点、出どころの信頼度でプラスマイナス5点の調整もあるの」
🐹 もっちー「ってことは、大きさは35点までの加点で、削ったり詰め込みすぎたりすると、掛け算で減っちゃうのか」
なぜ27Bが32Bに勝った?
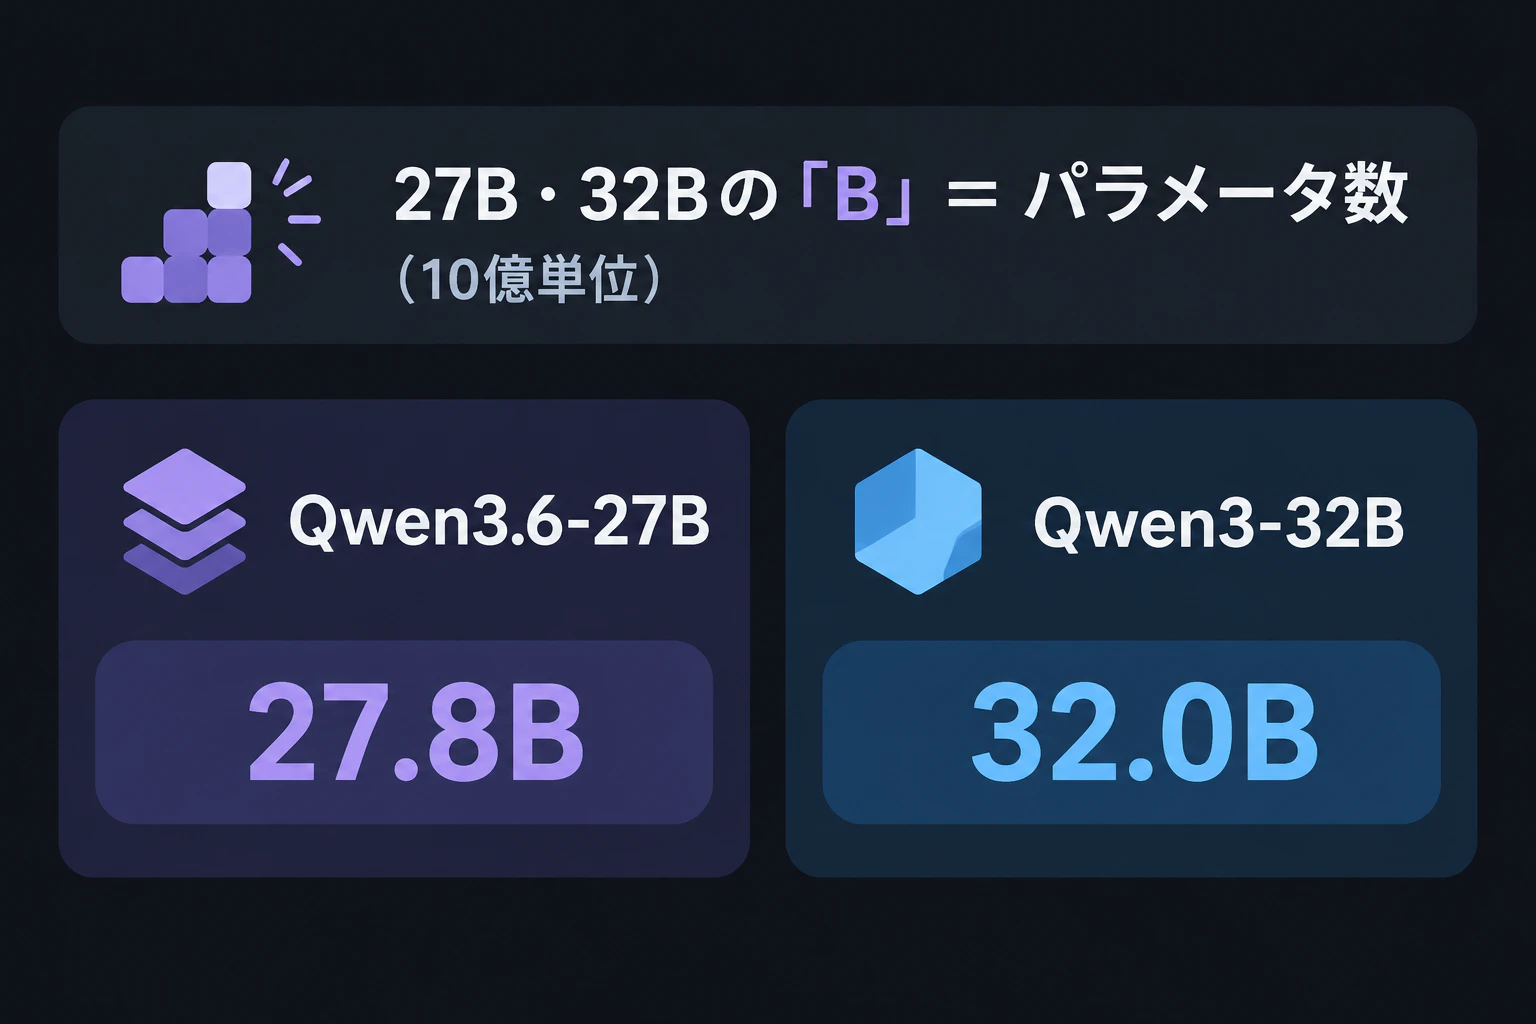
🐹 もっちー「そもそも、27Bとか32Bの数字って何なの?」
🦜 きなこ「パラメータっていう、モデルの中の数字の数。Bは10億で、名前の27Bは約270億個ってことなの。大きさだけなら32Bが上なんだよ」
🐹 もっちー「なのに、なんで小さい27Bが勝てるの?」
🦜 きなこ「作者の説明だと、27Bのほうが実際のベンチマークの点が高くて、世代も新しいからなの」
🐹 もっちー「世代ってどういうこと?」
🦜 きなこ「Qwen3.6-27Bは、Qwen3-32Bより新しい世代のモデルなの。同じQwenの名前でも、出た時期が違うんだよ」
🐹 もっちー「回し車も、大きくて古いのより、新しいののほうがスイスイ回ったりするもんね!」
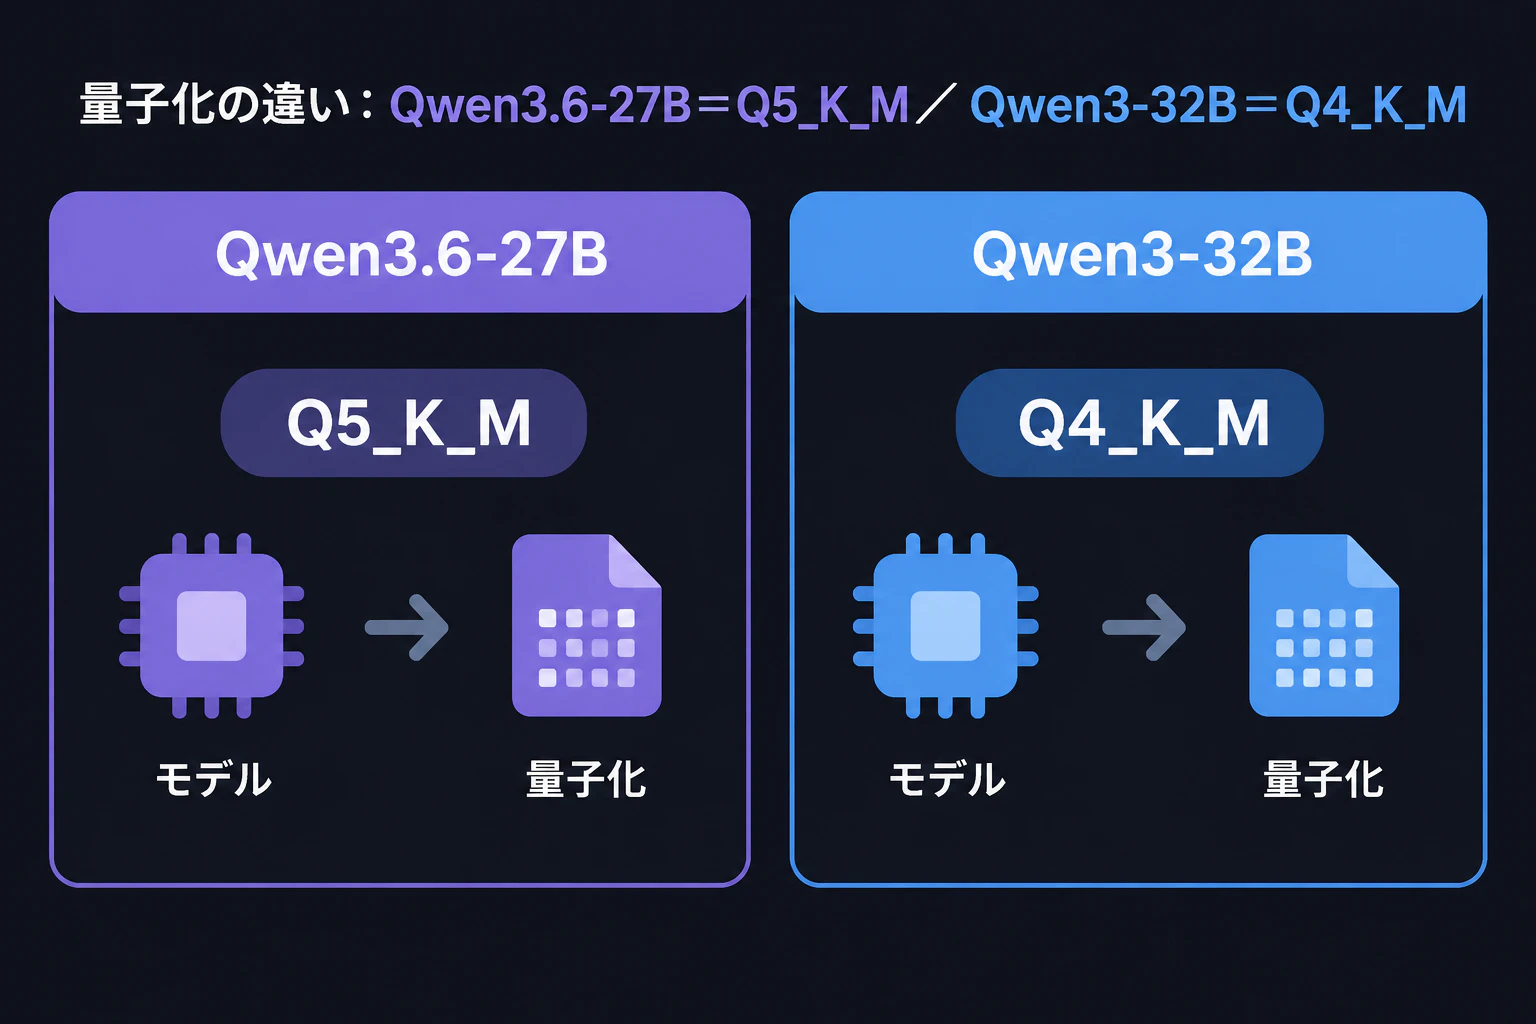
🦜 きなこ「近いね。それと、並んでる量子化の形式も違うの。27BはQ5_K_M、32BはQ4_K_Mなんだよ」
🐹 もっちー「Q5とQ4って、何が違うの?」
🦜 きなこ「ざっくり言うと、数字が大きいほど細かさを多く残してる目安。さっきの割引の話につながるの」
🐹 もっちー「じゃあ、32Bは削りすぎたから負けたってこと?」
🦜 きなこ「そこは言い切れないの。READMEが挙げてる理由は、成績と世代の2つ。量子化がどれだけ効いたかまでは書いてないんだよ」
🐹 もっちー「じゃあ、量子化の違いは、おまけくらいに見ておけばいいの?」
🦜 きなこ「おまけとまでは言えないの。効き方が分からないだけで、割引自体はちゃんとかかってるからね」
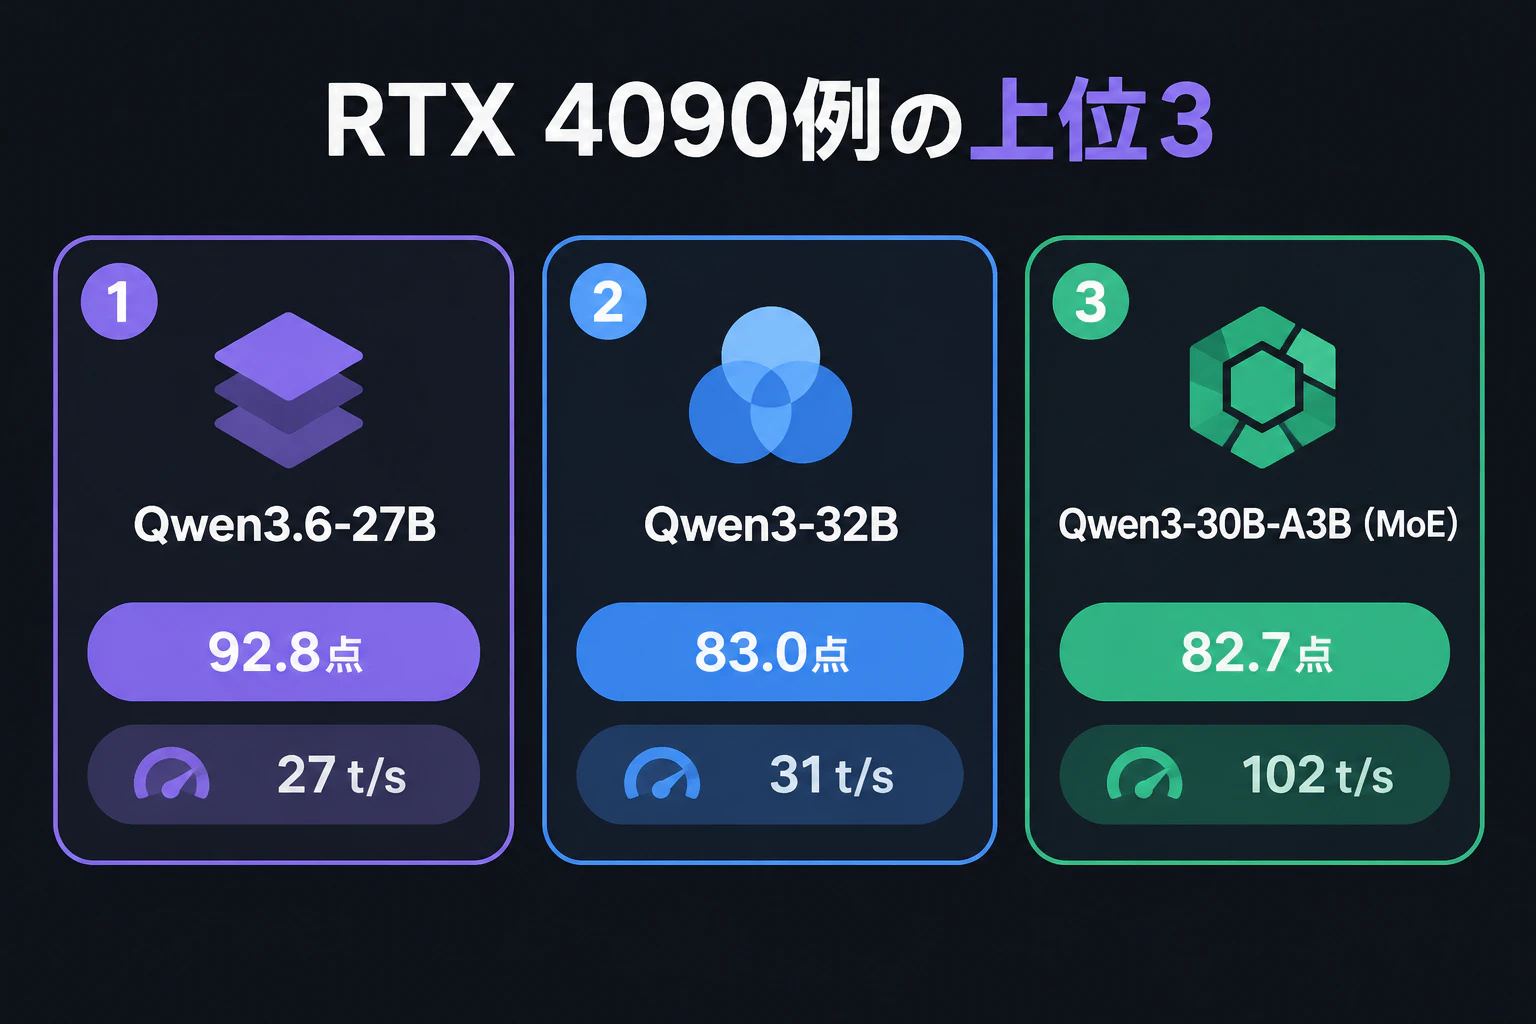
🦜 きなこ「ちなみに3位はQwen3-30B-A3Bで82.7点。こっちは文字のかたまりを1秒に102個も出せるの」
🐹 もっちー「102!?ワイなら速いほうがええな、待つの苦手やし!」
🦜 きなこ「そこは使い方次第だね。点数は1位より10点くらい低くても、速さは4倍近いから、速さを取るのもアリなの」
大きいのを削って詰めるのは損?
🐹 もっちー「でもさ、量子化で割引されるなら、大きいモデルを削って詰め込むのはやめたほうがいいの?頭も悪くなりそうだし」
🦜 きなこ「そう思うのも自然だよ。画質を落とした写真みたいに、賢さも荒くなりそうだもんね」
🦜 きなこ「でも研究を見ると、話はそう単純じゃないの」
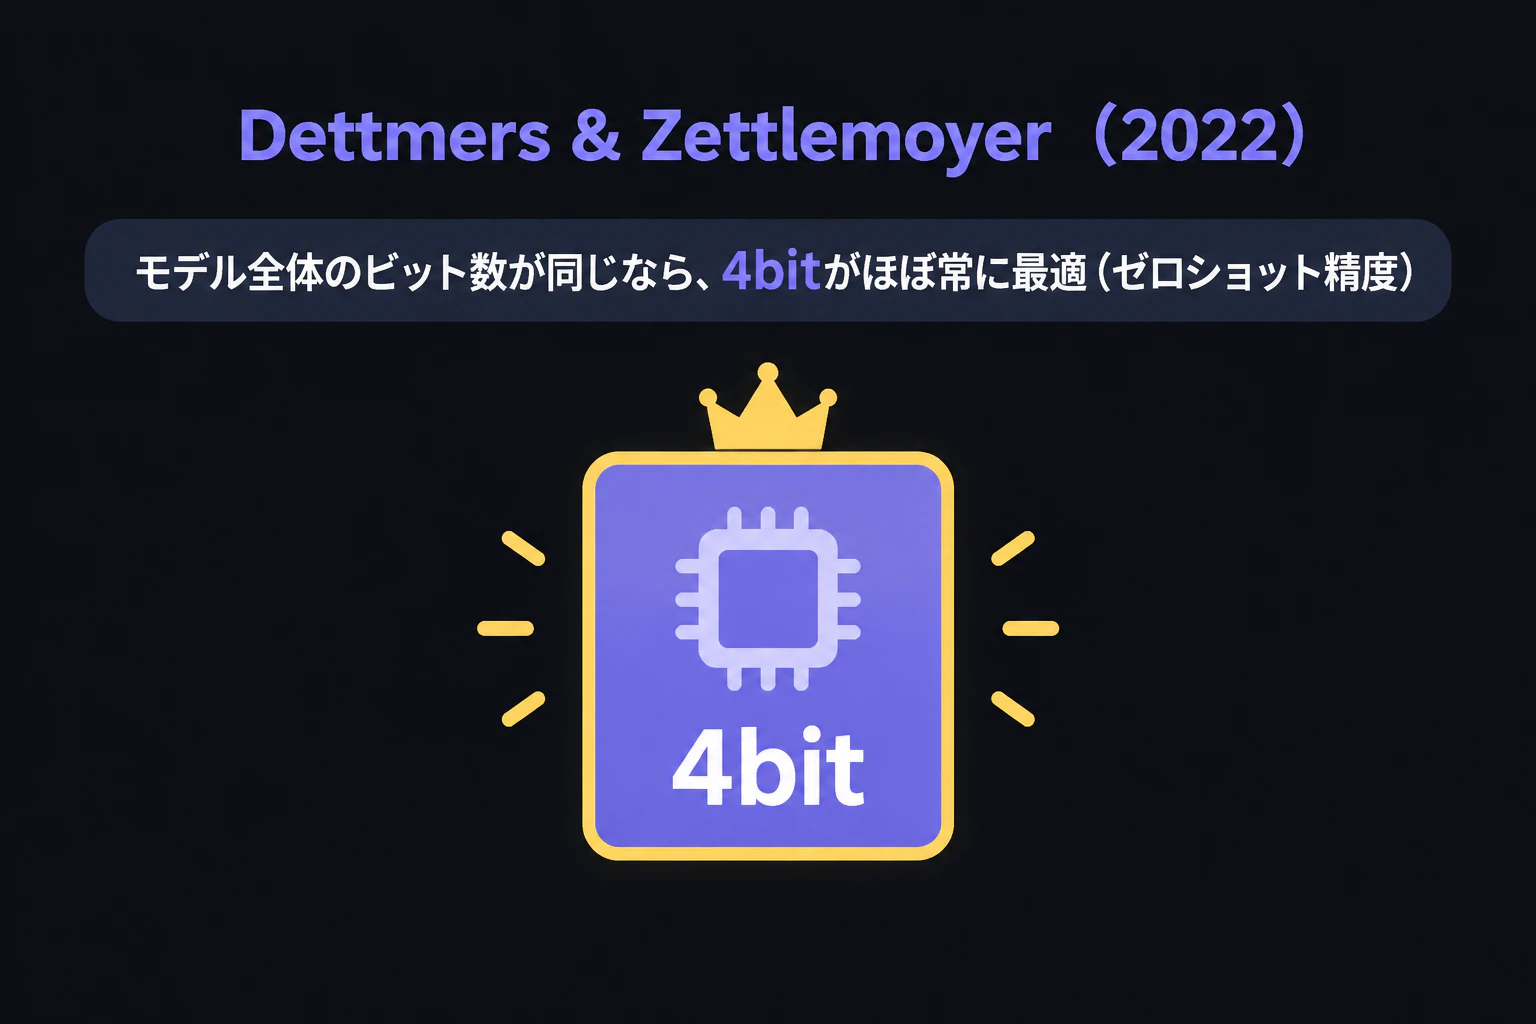
🦜 きなこ「2022年の論文では、使うメモリの量が同じなら、4bitにした大きいモデルのほうが、正解率でほぼ常に有利だったんだよ」
🐹 もっちー「えっ、じゃあ『収まる一番大きいのを選ぶ』って、合ってるやん!」
🦜 きなこ「半分はね。ただ、その論文が調べたのは、BLOOMやOPTみたいな、少し前の世代のモデルなの」
🐹 もっちー「最近のモデルだと、どうなの?」
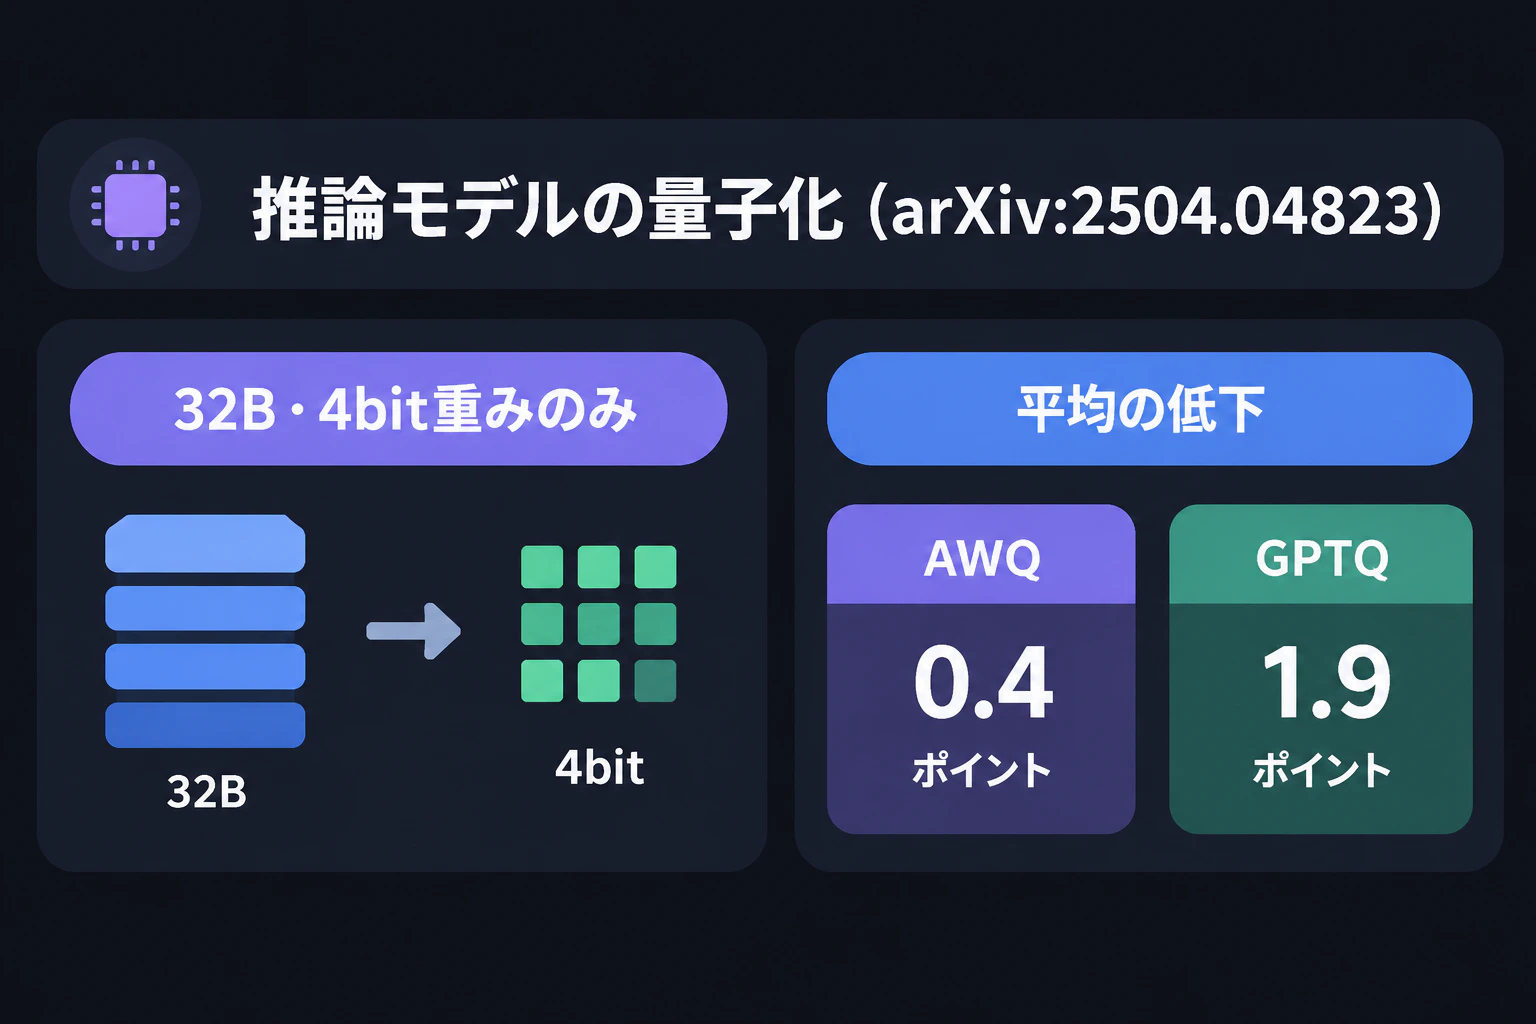
🦜 きなこ「2025年の別の研究だと、32Bの推論モデルは、4bitの重みだけの量子化なら、平均の落ち幅が2ポイント未満だったの」
🐹 もっちー「2ポイントなら、ほとんど変わらないね」
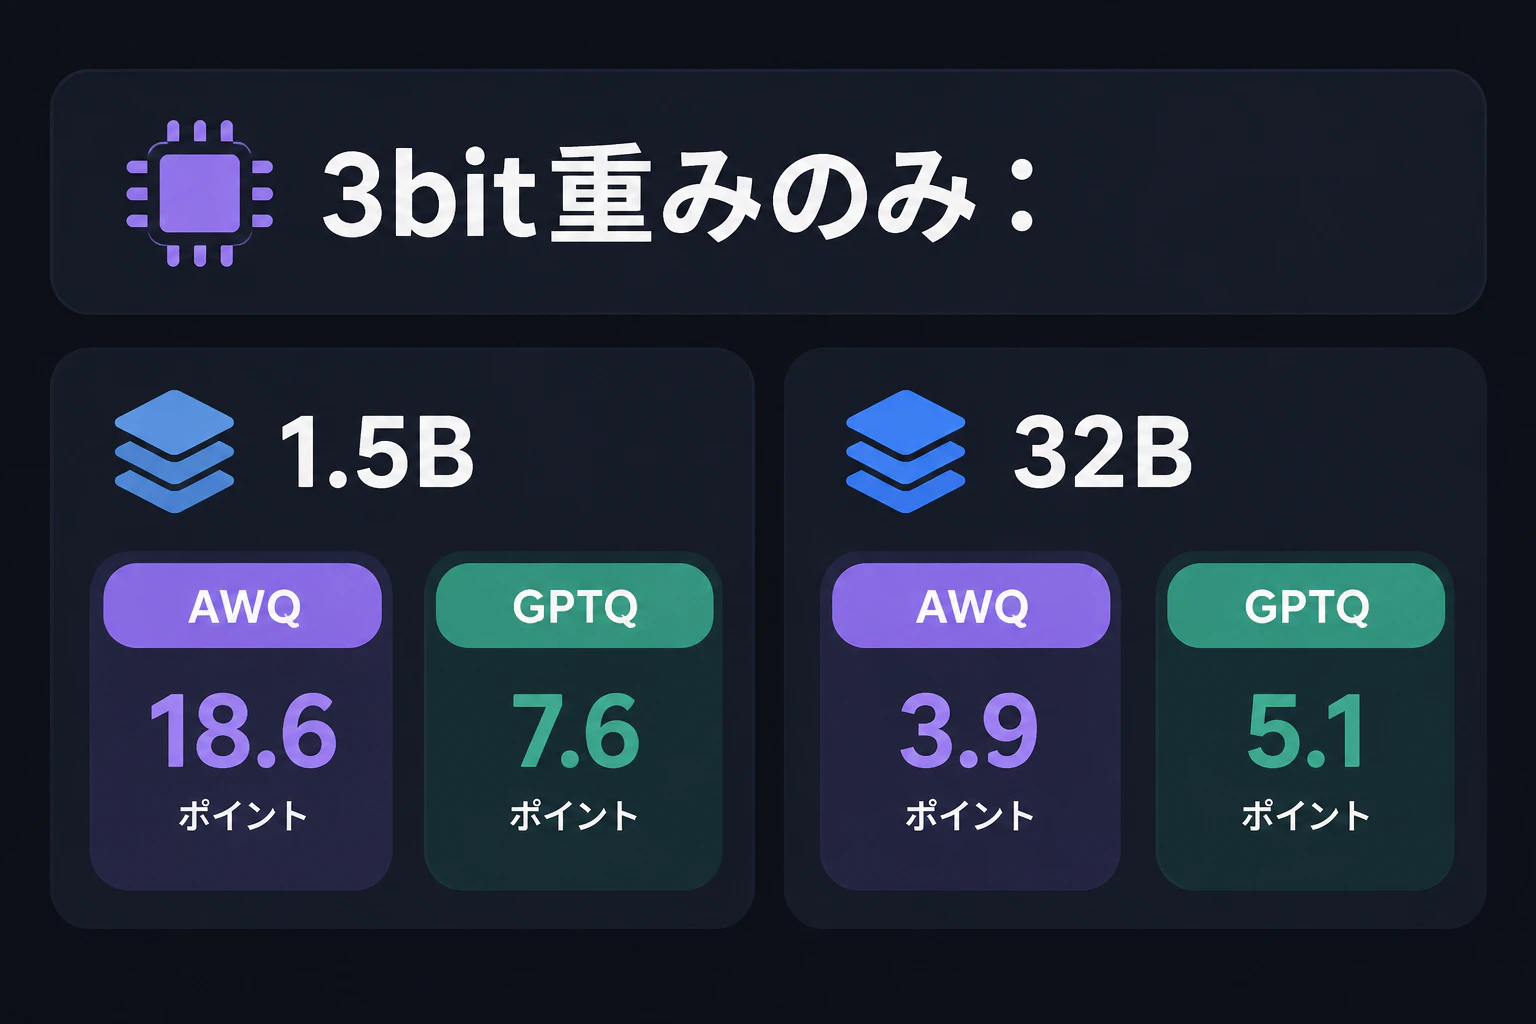
🦜 きなこ「でも3bitまで削ると話が変わるの。1.5Bの小さいモデルだと、方式によっては18ポイント以上も落ちたんだよ」
🐹 もっちー「18ポイント!?小さいモデルを削りすぎると、そんなに落ちるんだ…」
🦜 きなこ「小さいモデルほど、量子化の影響を受けやすいって結果なの」
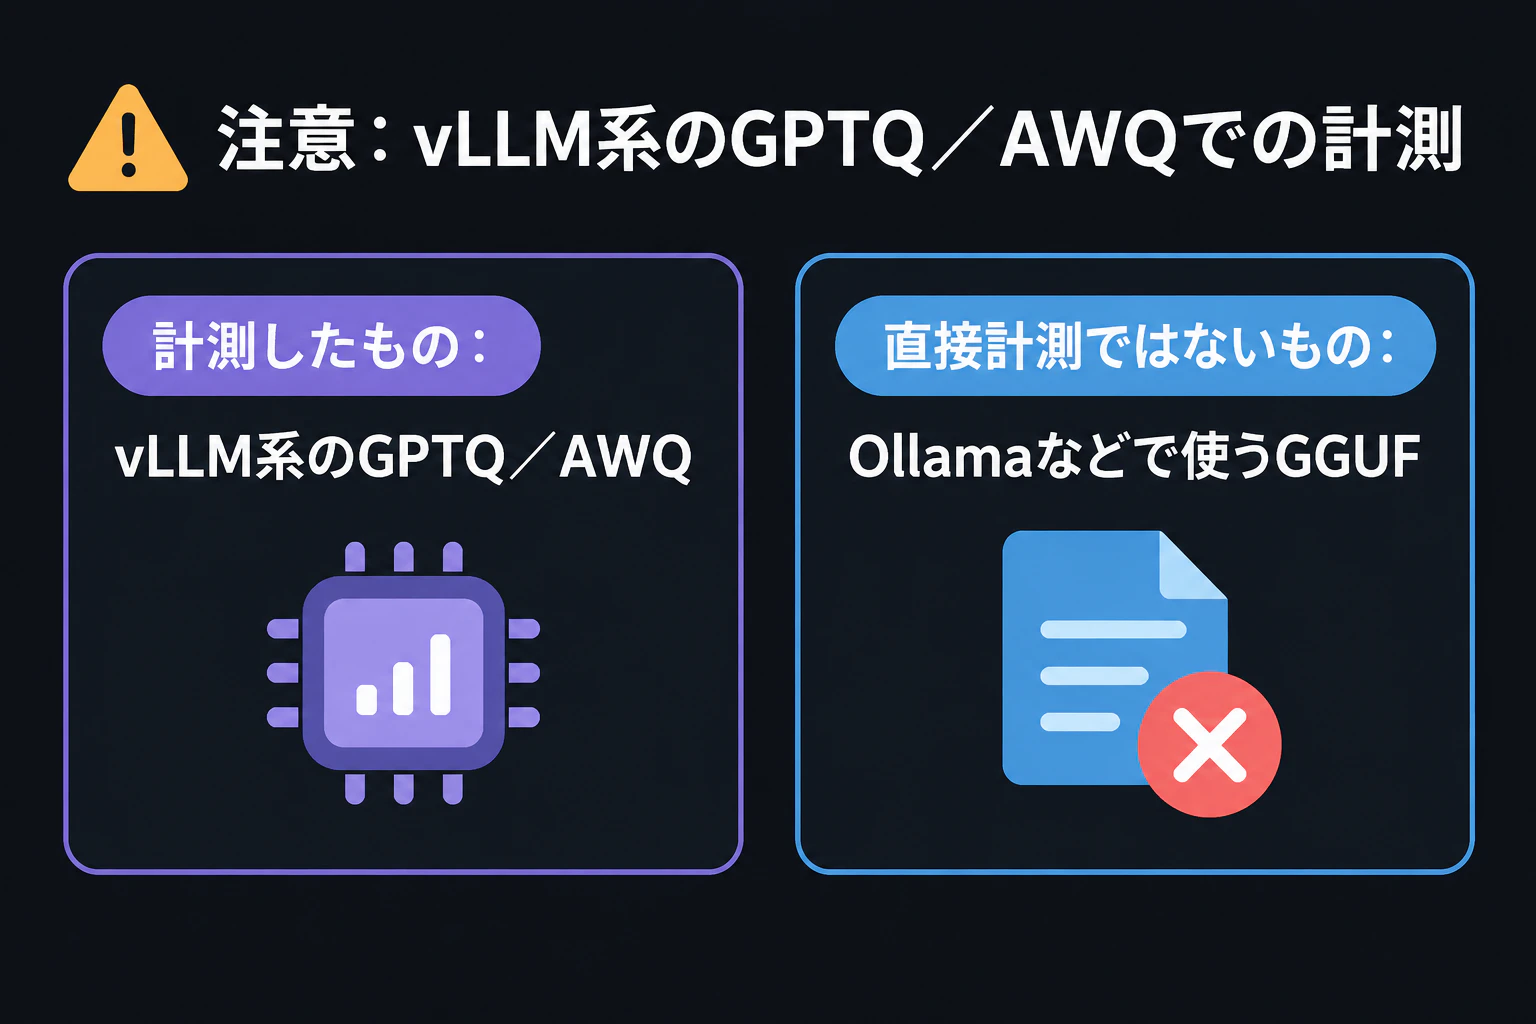
🦜 きなこ「ただ、Ollamaでよく使うGGUFとは別の方式で測った数字だから、そのまま当てはめないでね」
🐹 もっちー「ってことは、4bitくらいまでなら、大きいのを削って入れるのもアリってこと?」
🦜 きなこ「32Bくらいの大きいモデルなら、そう読める結果なの。でも大きさだけで決めると、さっきの27Bみたいに世代で順位が入れ替わるのを見落とすの」
この順位、どこまで信じる?
🐹 もっちー「よし、whichllmが1位って言ったモデルを入れれば、間違いなしだね!」
🦜 きなこ「そこはちょっと待って。27Bが32Bに勝つ例は、作者自身がREADMEに載せてる、2026年5月時点の例なの」
🦜 きなこ「別の人が実際に試して、順位どおりだったか確かめた報告は、私が調べた範囲では見つからなかったんだよ」
🐹 もっちー「作者さんのおすすめ例、ってことか」
🦜 きなこ「それに、12GBや16GBのGPUで何が1位になるかも、今回は確認できてないの」
🐹 もっちー「えー、そこが一番知りたいのに…」
🦜 きなこ「もう一つ、点数の材料そのものも動くの」
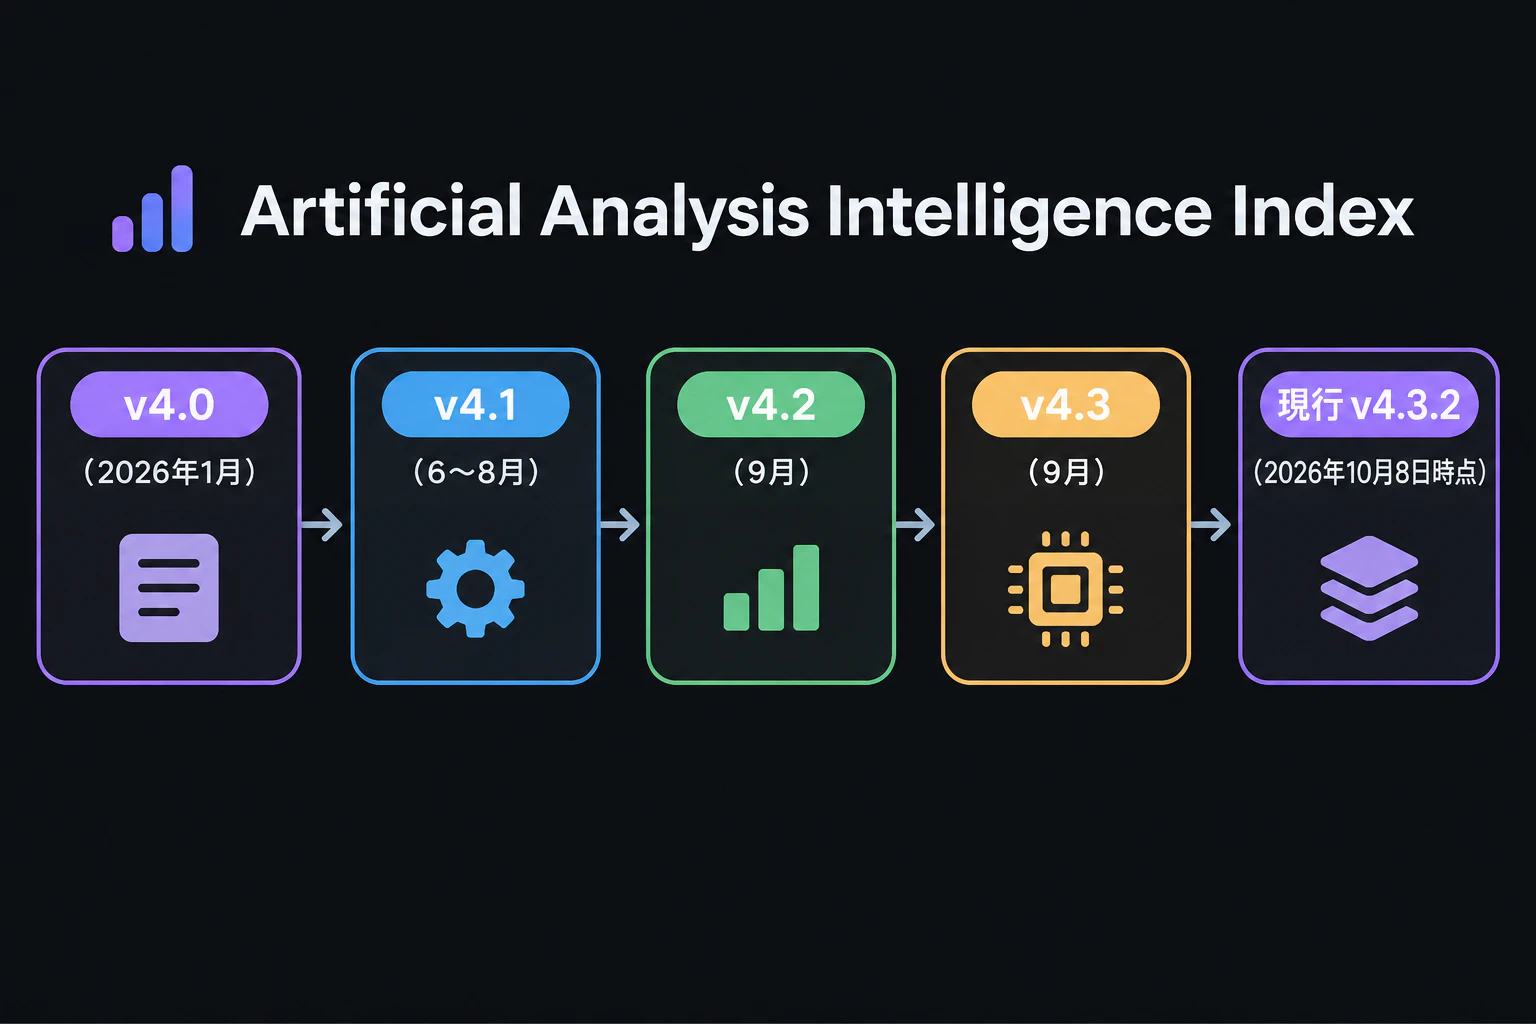
🦜 きなこ「たとえばArtificial Analysisの指標は、2026年10月8日時点でv4.3.2。9月だけでも、版が何度か変わってるんだよ」
🐹 もっちー「whichllmは、そのどの版を使ってるの?」
🦜 きなこ「そこは今回、確認できてないの」
🦜 きなこ「ただ、whichllmは0.5.20から、ネットで取れたArtificial Analysisの最新の点を、前の点より優先するようになったの」
🐹 もっちー「ってことは、日が変わったら、順位も入れ替わるかもしれないんだ」
🦜 きなこ「うん、その可能性はあるの。同じPCでも、データが更新されれば点数が変わるからね」
🐹 もっちー「エサ皿みたいに、毎日中身を確かめるものなんだね」
🦜 きなこ「そういうこと。順位は答えじゃなくて、候補をしぼるための地図くらいに思っておくのがちょうどいいの」
まとめ
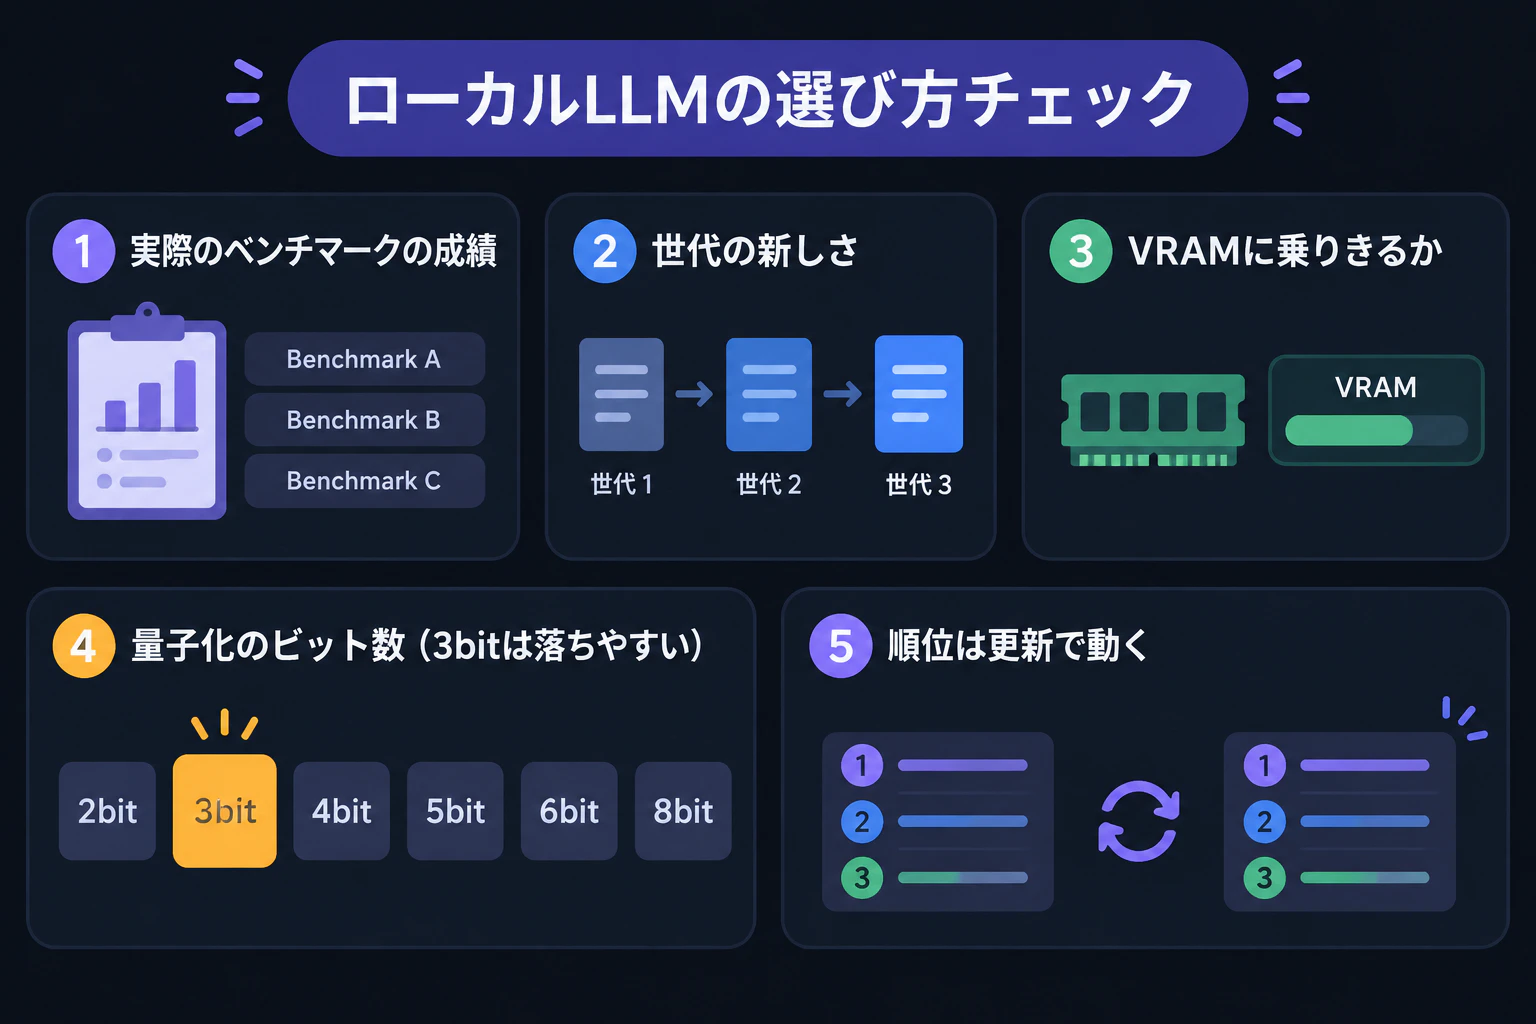
🦜 きなこ「まとめるね。whichllmが見てるのは大きさだけじゃなくて、ベンチマークの成績、世代、動かし方、量子化の細かさなの」
🦜 きなこ「大きさは、最大35点ぶんの材料の一つ。削るなら、3bitまで下げると落ちやすいことも覚えておいてね」
🐹 もっちー「これ保存しとこ!順位はそのまま信じこまない、っと」
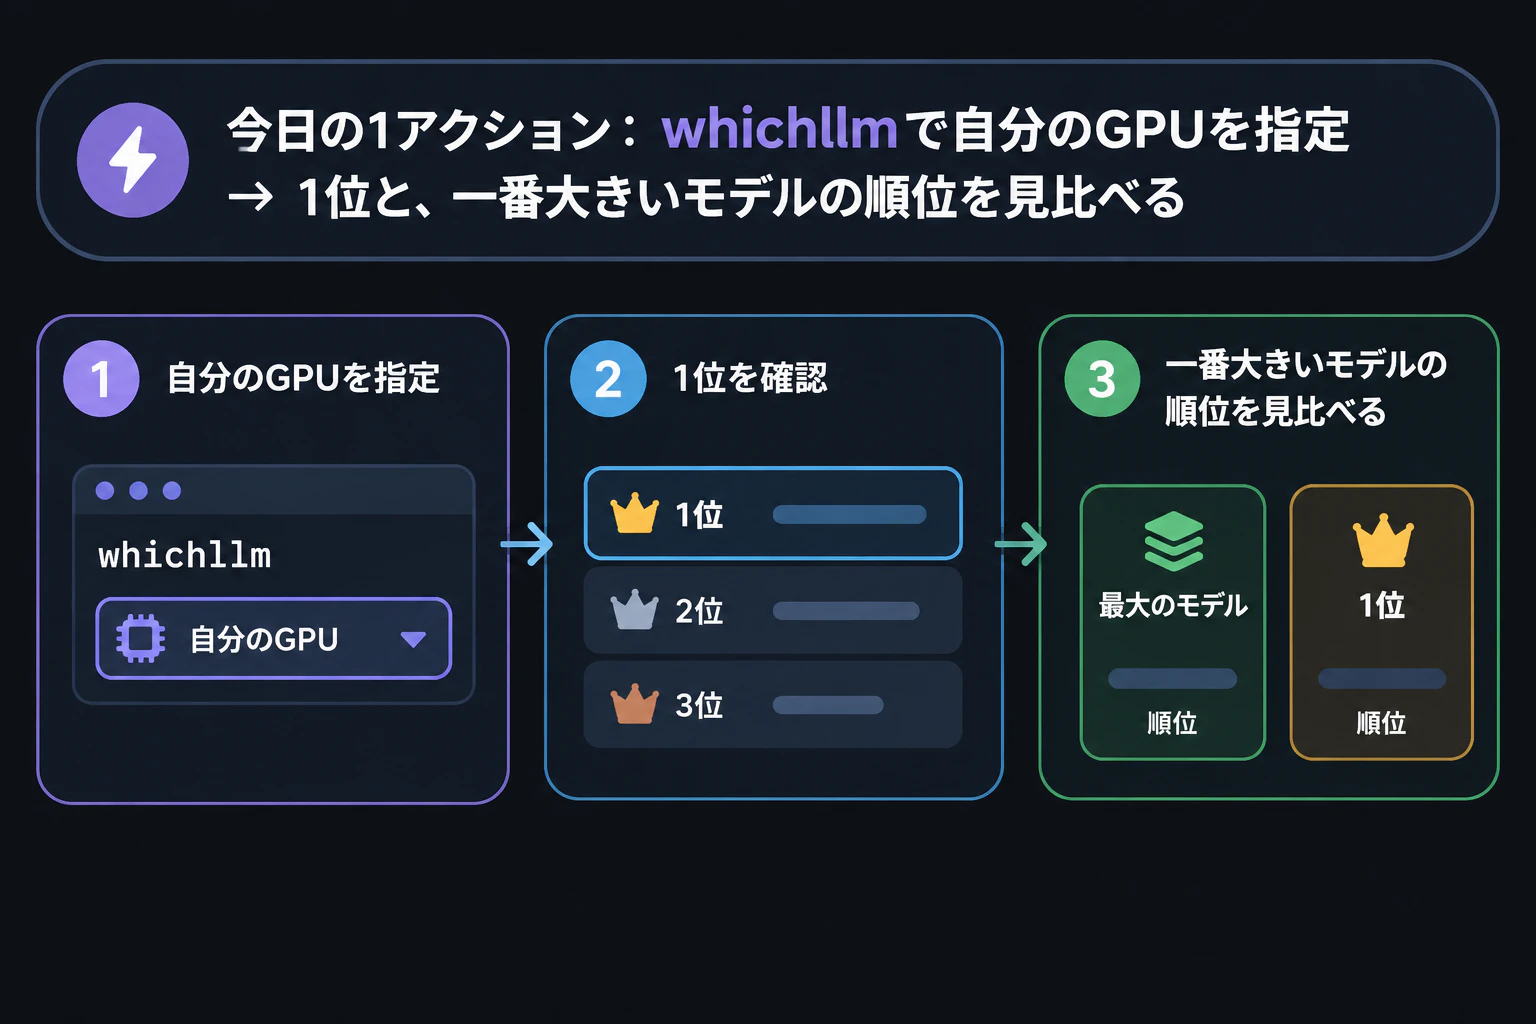
🦜 きなこ「完璧。今日から1個だけ試すなら、whichllmで自分のGPUを指定して、1位と一番大きいモデルの順位を見比べてみて」
🐹 もっちー「見比べるだけか。それならぼくでもできそう!」
🦜 きなこ「みんなのPCでは、1位と一番大きいモデルは同じだった?違ったら、理由が世代なのか量子化なのか、コメントで教えてね」
🐹 もっちー「飼い主、また新しいグラボ買おうとしてへん?回し車の予算はどこ行ったん」
🦜 きなこ「その前に、今のPCで十分かどうか、確かめてほしいよね」
🐹 もっちー「ほんで、ワイのひまわりの種の予算も、ちゃんと残しといてな!」
🦜 きなこ「ちなみに、同じモデルでもQ4_K_MとQ5_K_Mで、速さや賢さがどう変わるのかは、いつか別の動画で深掘りしたいな」
🐹 もっちー「それも気になる!」
きなこもっちーのテック深掘り では、AI/LLM を中心としたテック全般をハムスター(🐹 もっちー)とセキセイインコ(🦜 きなこ)の掛け合いで楽しく解説しています。
▶️ 動画で観る → なぜ32Bより小さい27Bが1位なのか|whichllmのRTX 4090例 92.8点と83.0点
👍 この記事が役に立ったら LGTM・ストックしてもらえると励みになります!
📺 チャンネル登録はこちら → きなこもっちーのテック深掘り
🔗 他の解説動画も見る → きなこもっちーのテック深掘り の動画一覧