
📺 この記事は YouTube チャンネル きなこもっちーのテック深掘り の動画解説記事です。
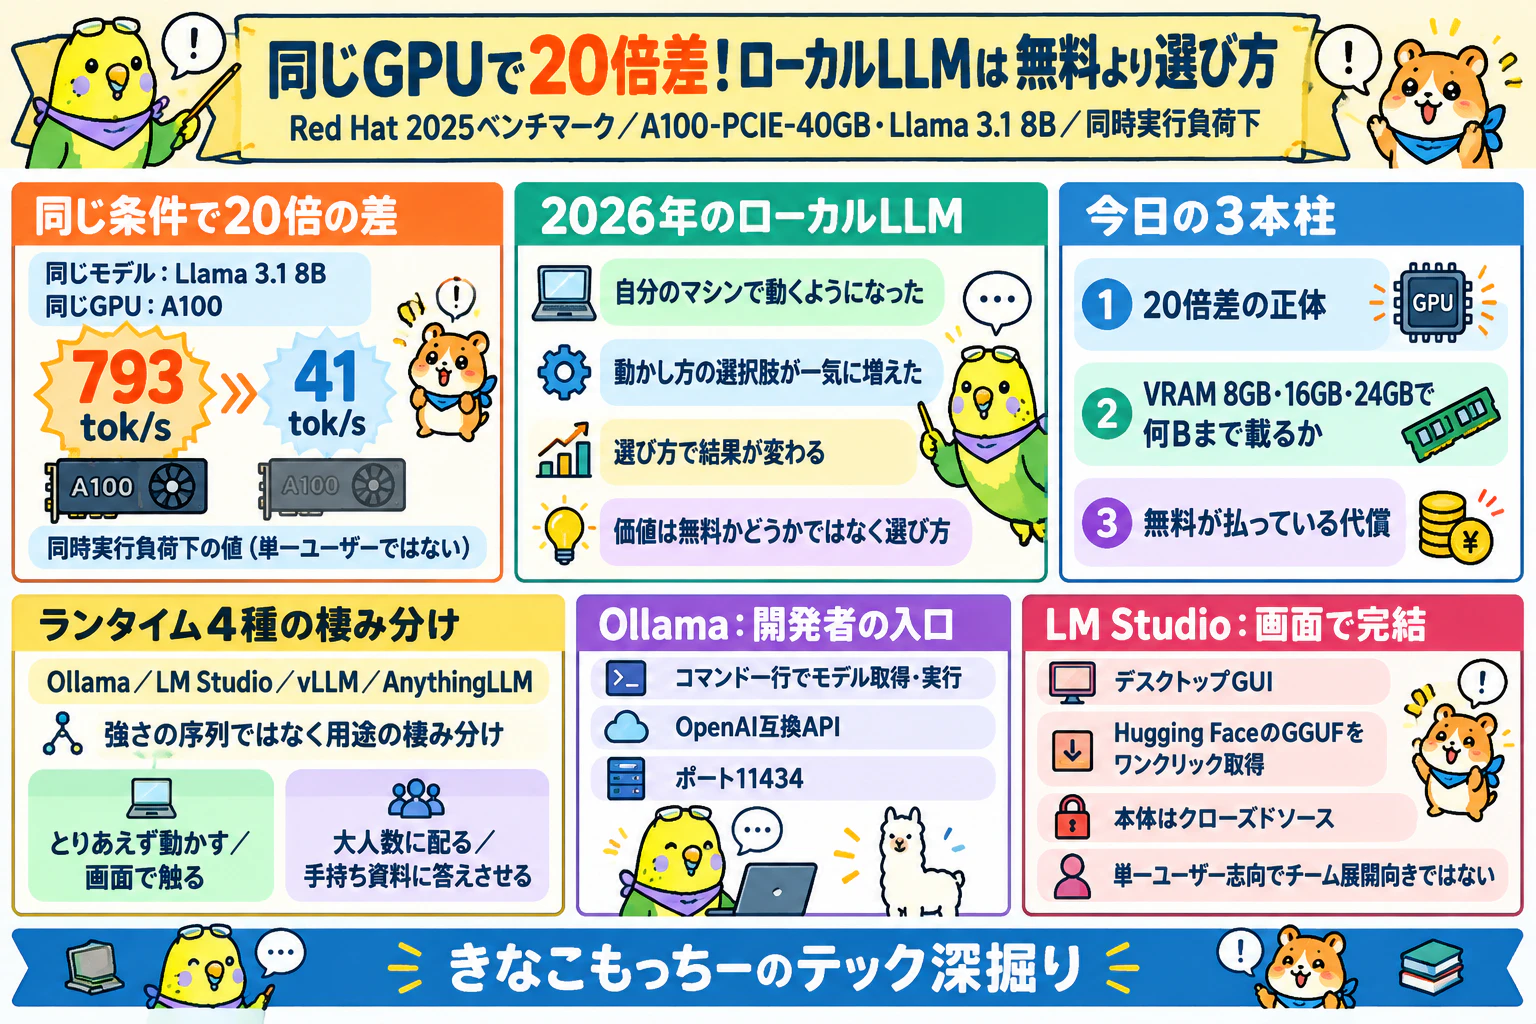
▶️ 動画はこちら → 同じGPUで20倍差!ローカルLLMは「無料」より「選び方」だった
🐹🦜 この記事に登場する2匹
- 🐹 もっちー (ハムスター)… AI はまだ勉強中。「それどういうこと?」と素朴に質問する生徒役
- 🦜 きなこ (セキセイインコ)… AI で調べものをこなす解説役。やさしく深掘りして教える先生役
この記事は2匹の掛け合いを書き起こした形式です。発言の先頭にいる絵文字+名前が話者です。
はじめに
🐹 もっちー「ねえきなこ、最近よく聞く「ローカルAI」ってさ、要するに無料でChatGPTみたいなの動くってことでしょ?」
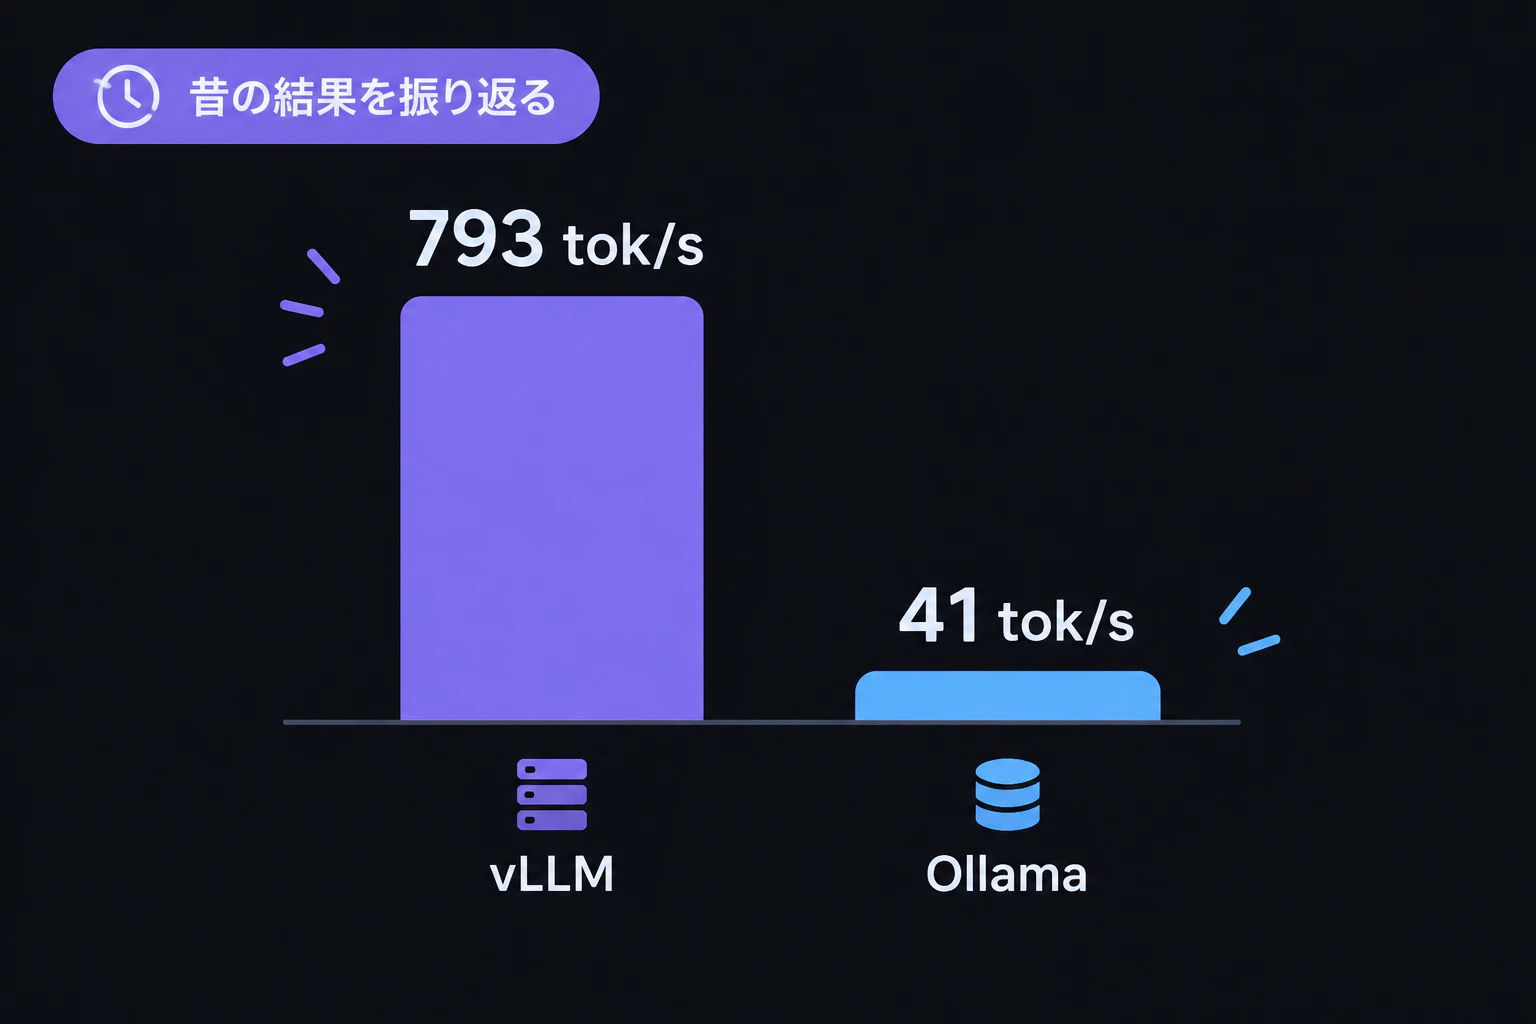
🦜 きなこ「その前にひとつ、数字だけ見てほしいの。同じモデル、同じGPU、なのに片方は毎秒793トークン。」
🦜 きなこ「もう片方は毎秒41トークンなの。」
🐹 もっちー「え、待って。793と41って……ほぼ20倍だよね。同じモデルで?」
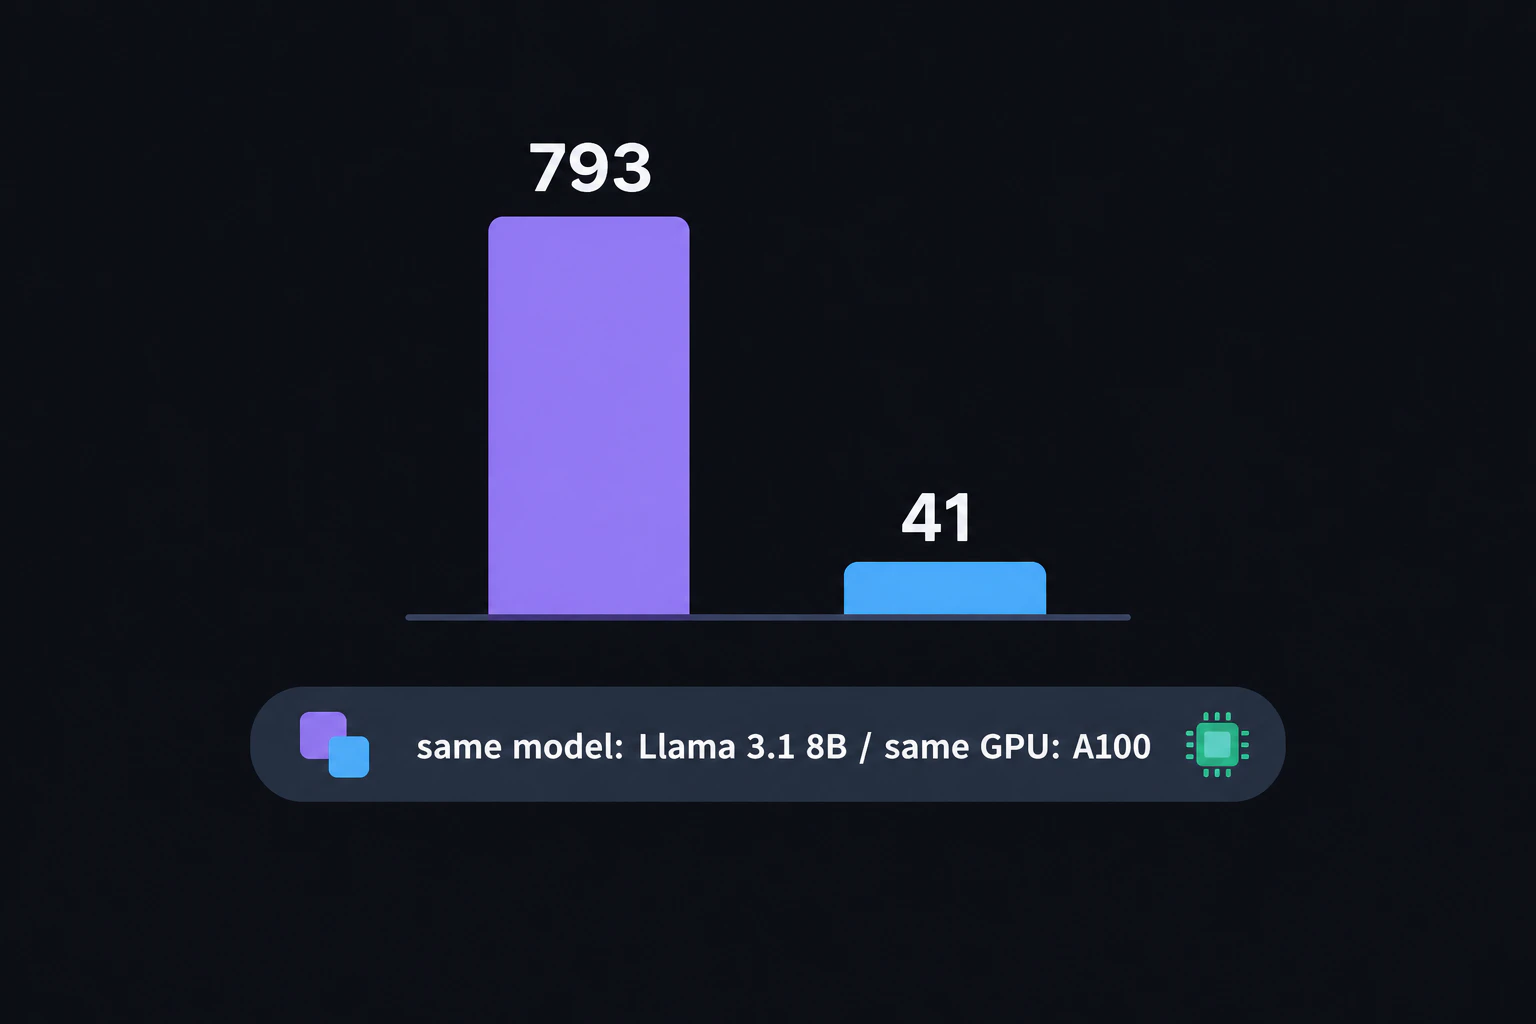
🦜 きなこ「同じLlama 3.1の8B。GPUも同じA100。差を作ったのはモデルでもGPUでもないの。」
🐹 もっちー「じゃあ何が違うの。裏で誰かがひまわりの種でも運んでるの?」
🐹 もっちー「というかさ、そもそもの話。ぼくのパソコン、ゲームですらカクカクするのに、AIなんて動くの?」
🦜 きなこ「それがね、2026年は動くようになったの。ただ動かし方の選択肢が一気に増えて、選び方で結果が変わるようになったんだよ」
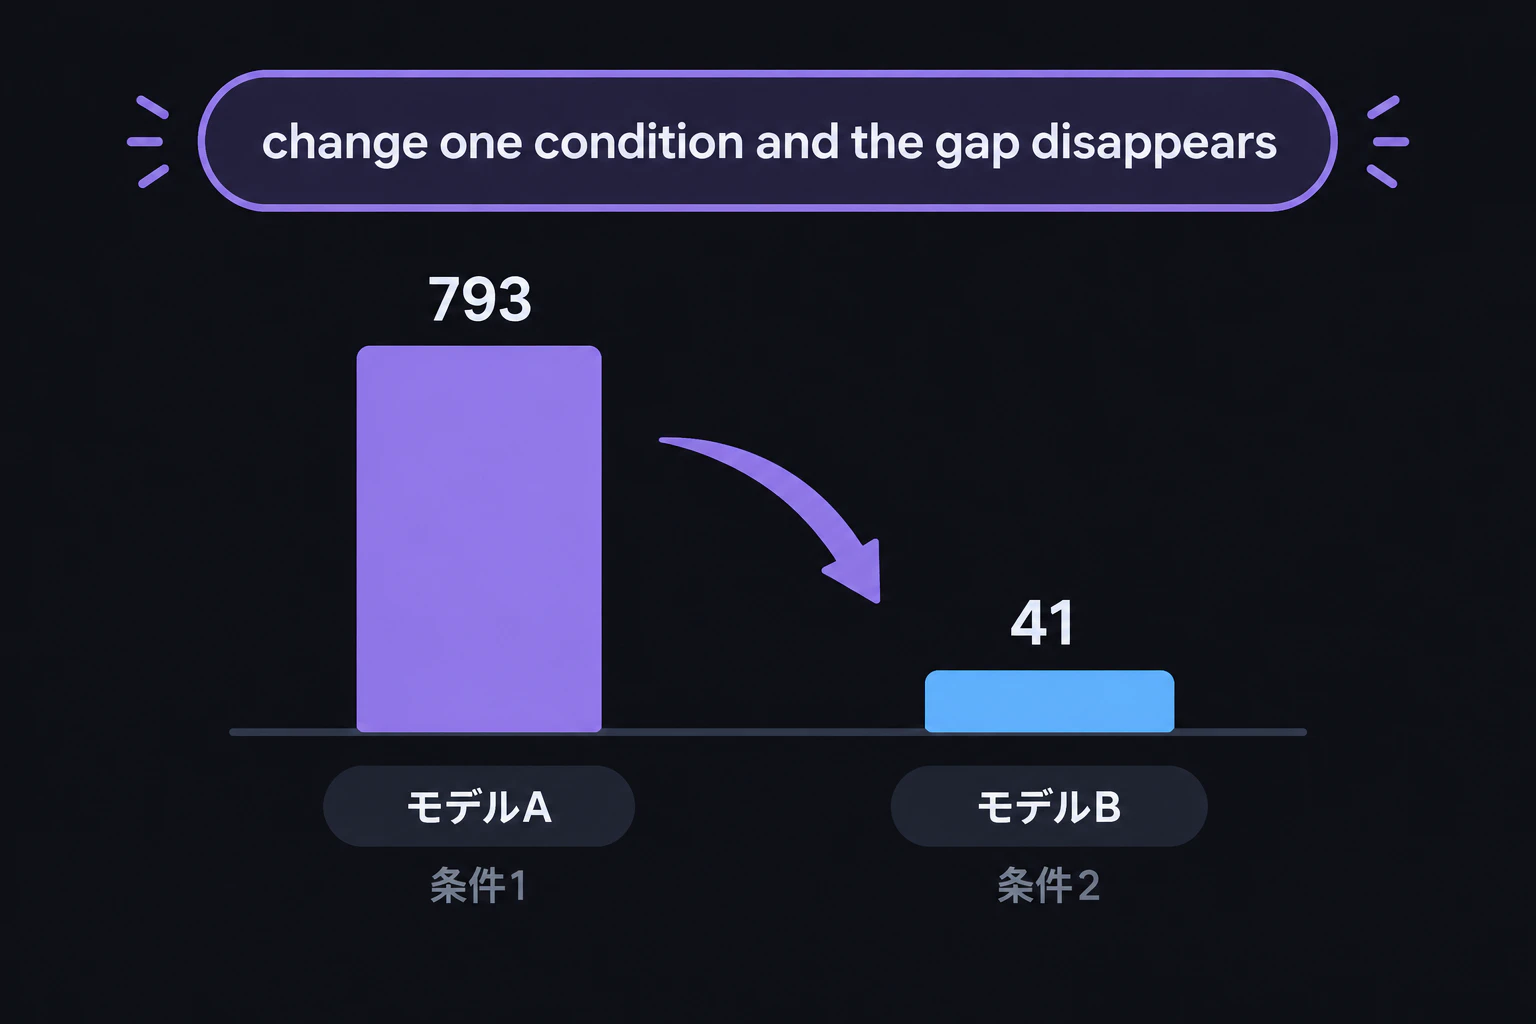
🦜 きなこ「近いよ。運び方の設計が違うの。ただね、この20倍、条件をひとつ変えると跡形もなく消えるんだよ。」
🐹 もっちー「消えるの!?せっかく20倍で感動したのに。」
🦜 きなこ「そこが今日の本題なの。ローカルAIの価値って、無料かどうかじゃなくて選び方の話なんだよ。」
🦜 きなこ「20倍差の正体と、VRAM 8GB・16GB・24GBで何Bまで載るのか。そして無料が払ってる代償まで見せるね。」
🐹 もっちー「代償!?やっぱりタダより高いもんはないんか。気になるやん。」
🦜 きなこ「最後まで見れば、自分のGPUで何が動くか自分で判断できるようになるよ。今日はそこまで一気に解説するね。」
ランタイム4種の棲み分け——入口はOllama、本番はvLLM
🐹 もっちー「ちょっと待って。さっきから知らない名前がいっぱい出てくるんだけど、正直どれか一個だけでよくない?」
🐹 もっちー「種類多すぎるよ。全部覚えるのしんどい。ぼくに一番強いやつを一個だけ教えてほしいんだけど」
🦜 きなこ「うん、その気持ち分かるよ。私も最初は一番強いのを探してた。でもこの4つ、強さの序列じゃなくて用途の棲み分けなの」
🐹 もっちー「棲み分け?なんか急に野生動物の縄張りみたいな話になってきたな。ぼくにも分かる言い方にしてほしいんだけど」
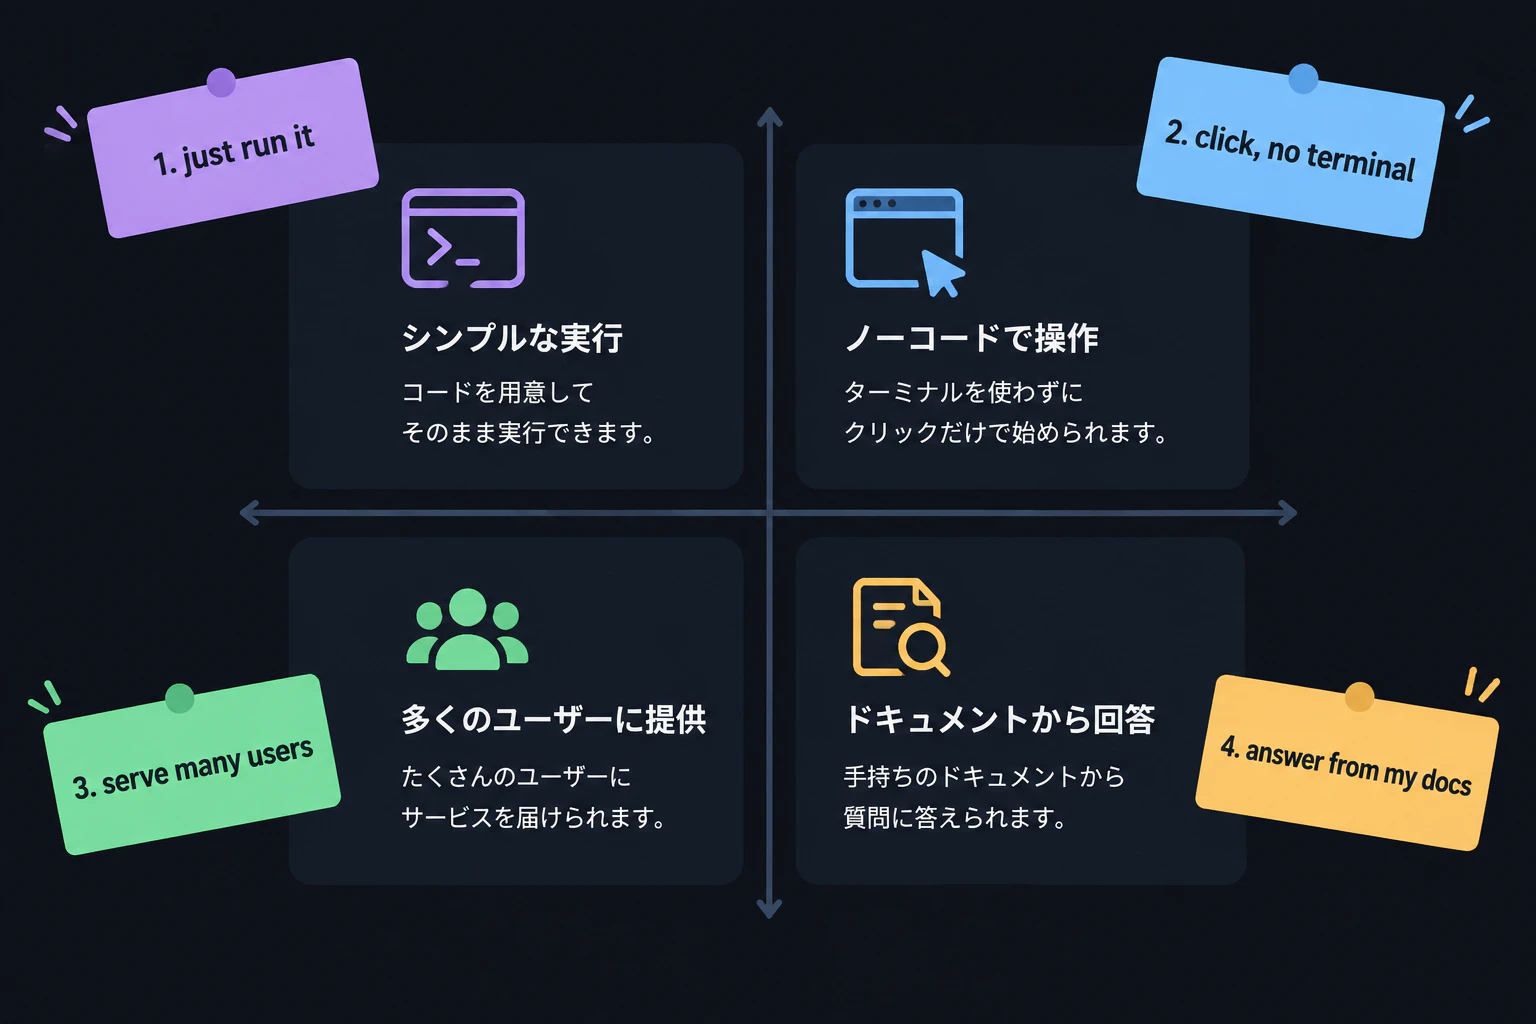
🦜 きなこ「名前は後回しにするね。やりたいことは、とりあえず動かす、画面で気軽に触る、大人数に同時に配る、手持ちの資料に答えさせる。この4つ」
🐹 もっちー「あー、先にやりたいことから言われると分かりやすいね。で、その4つに名前を当てはめてくってこと?」
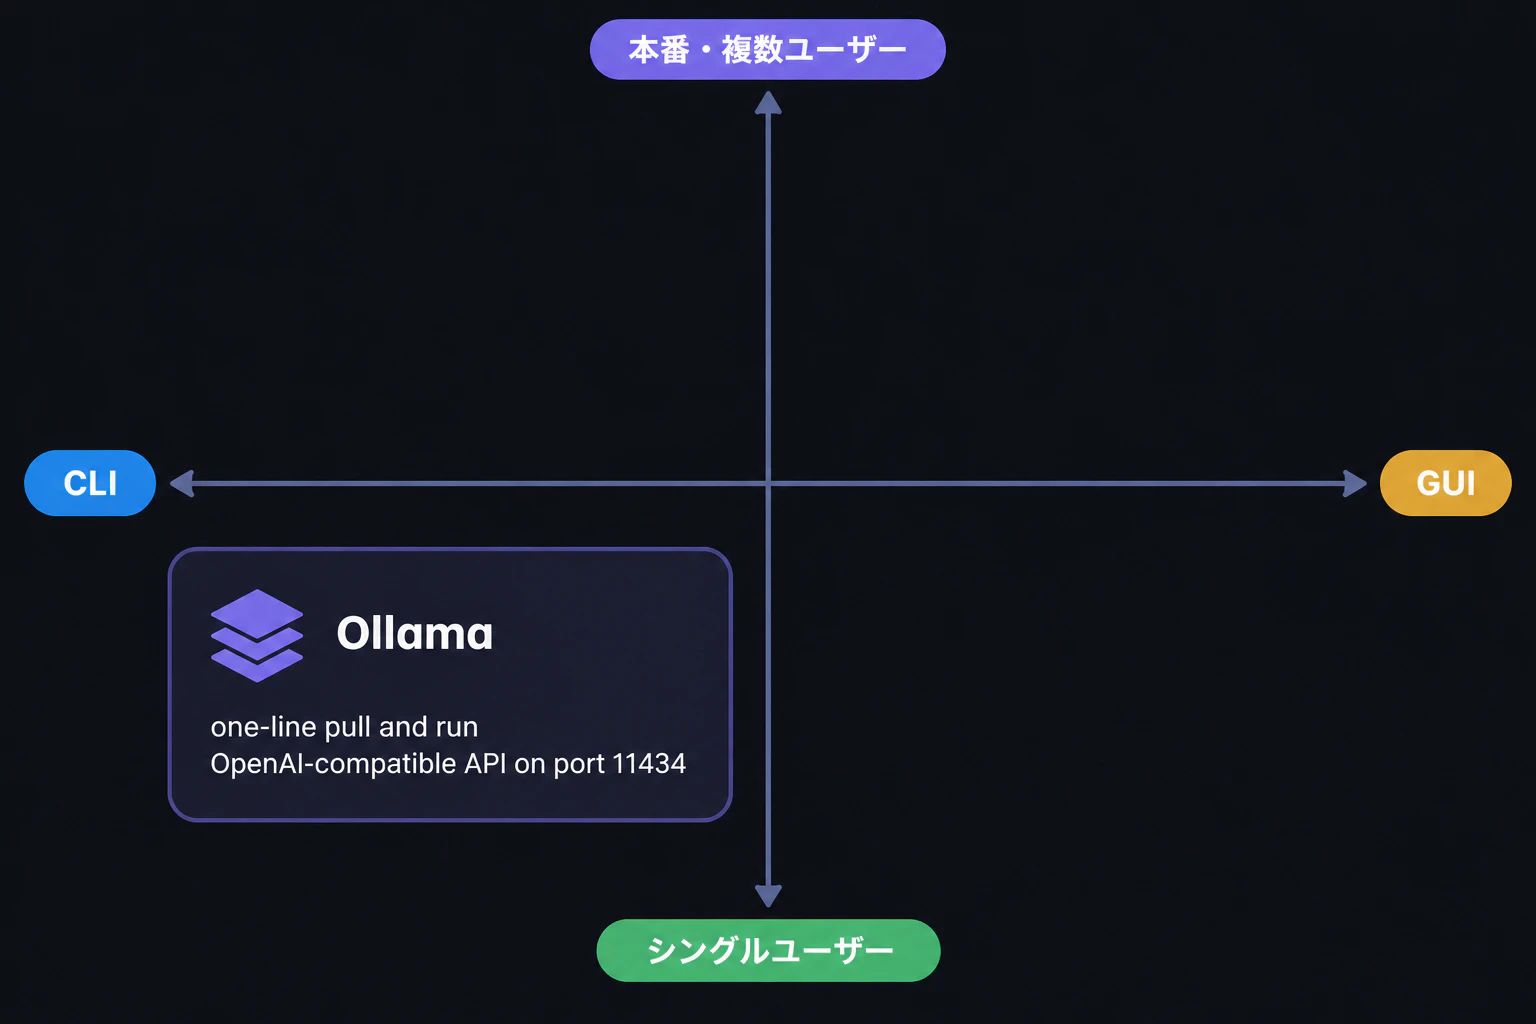
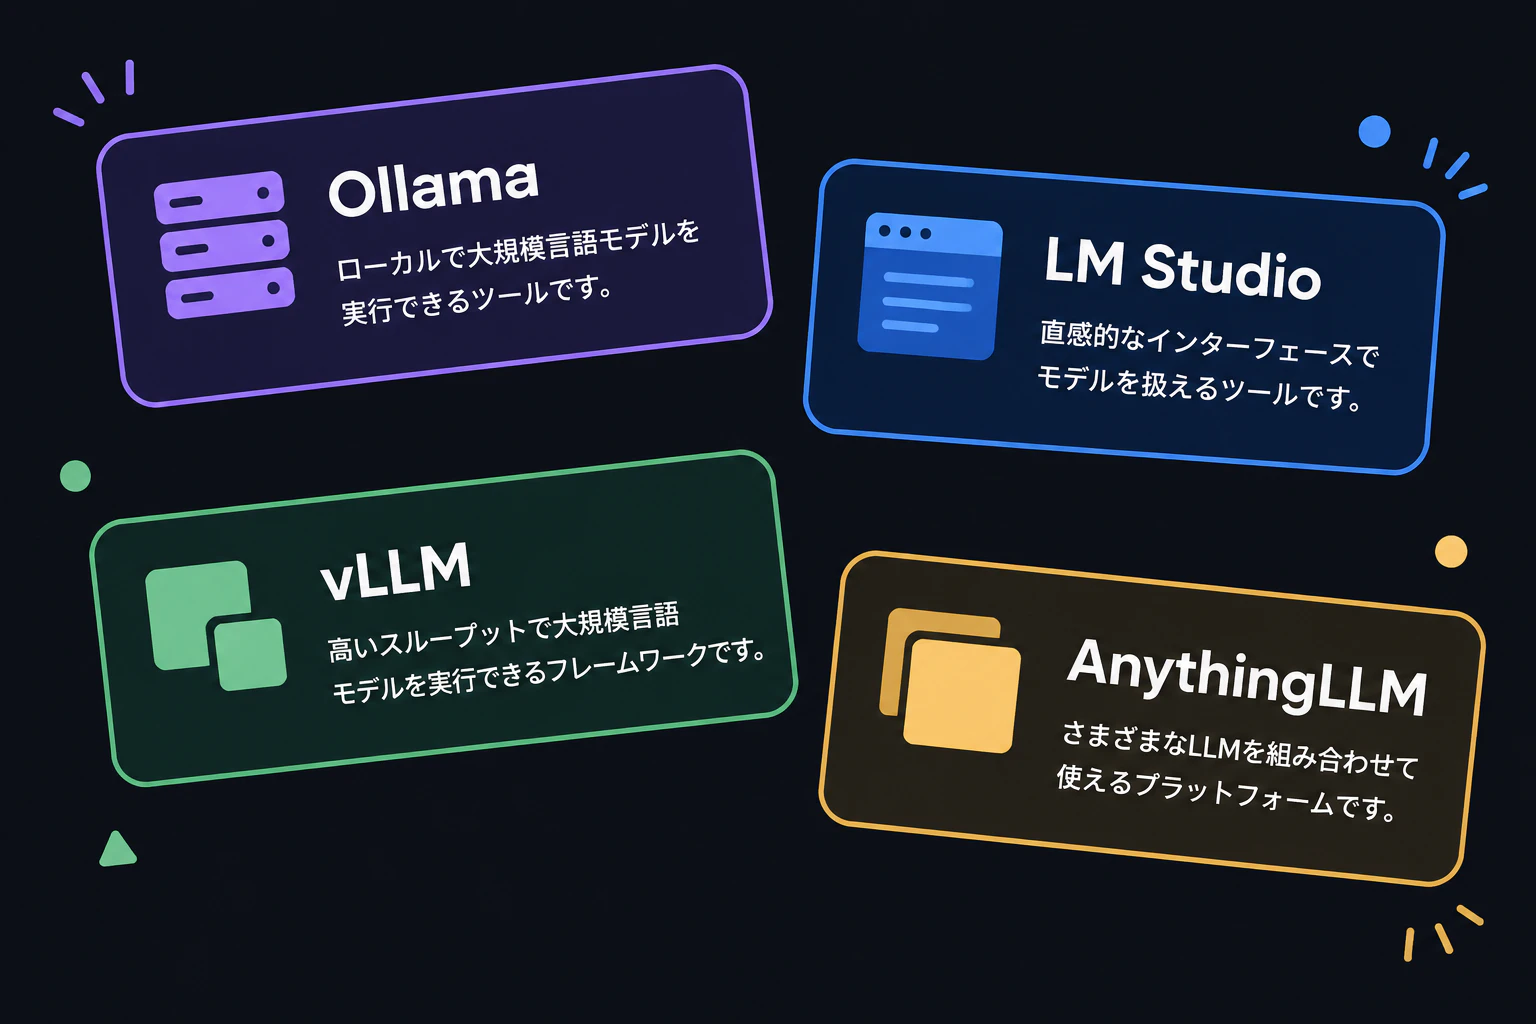
🦜 きなこ「一つ目がOllama。モデルを動かす土台、いわゆるランタイムだね。コマンド一行で動かせて、OpenAI互換のAPIがポート11434で立つの」
🐹 もっちー「OpenAI互換のAPI…つまり、他のアプリから同じ言葉で話しかけられる受付窓口が最初から付いてるってこと?」
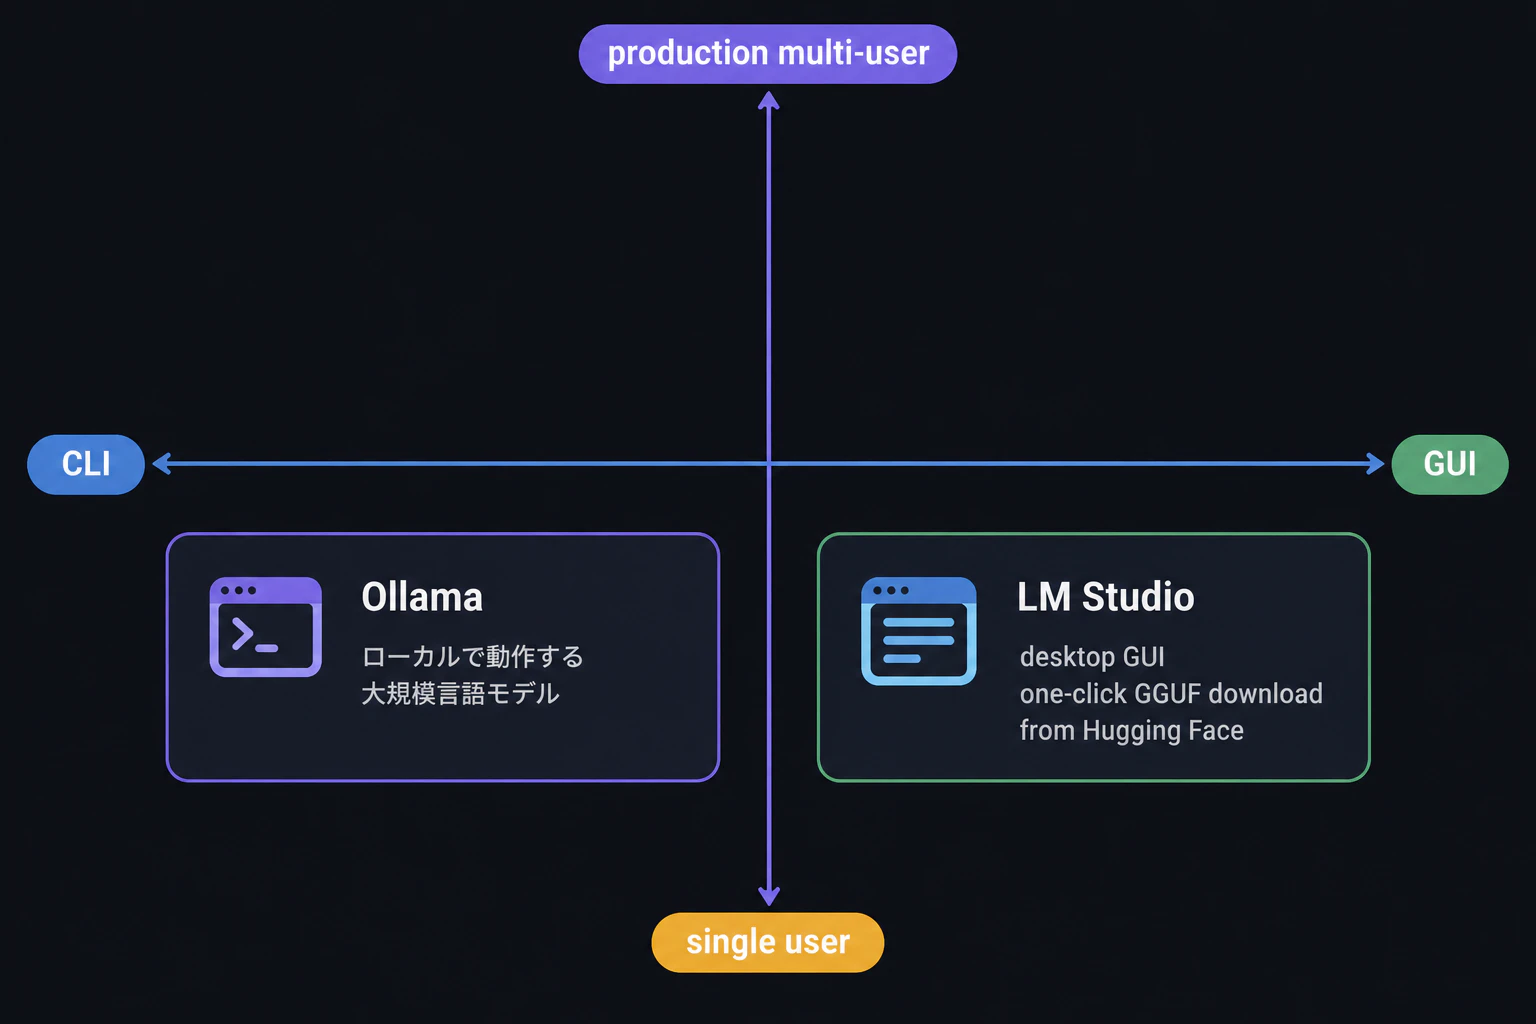
🦜 きなこ「そう、その理解で合ってるよ。だからOllamaは開発者の入口なの。二つ目がLM Studio、こっちは画面で完結するの」
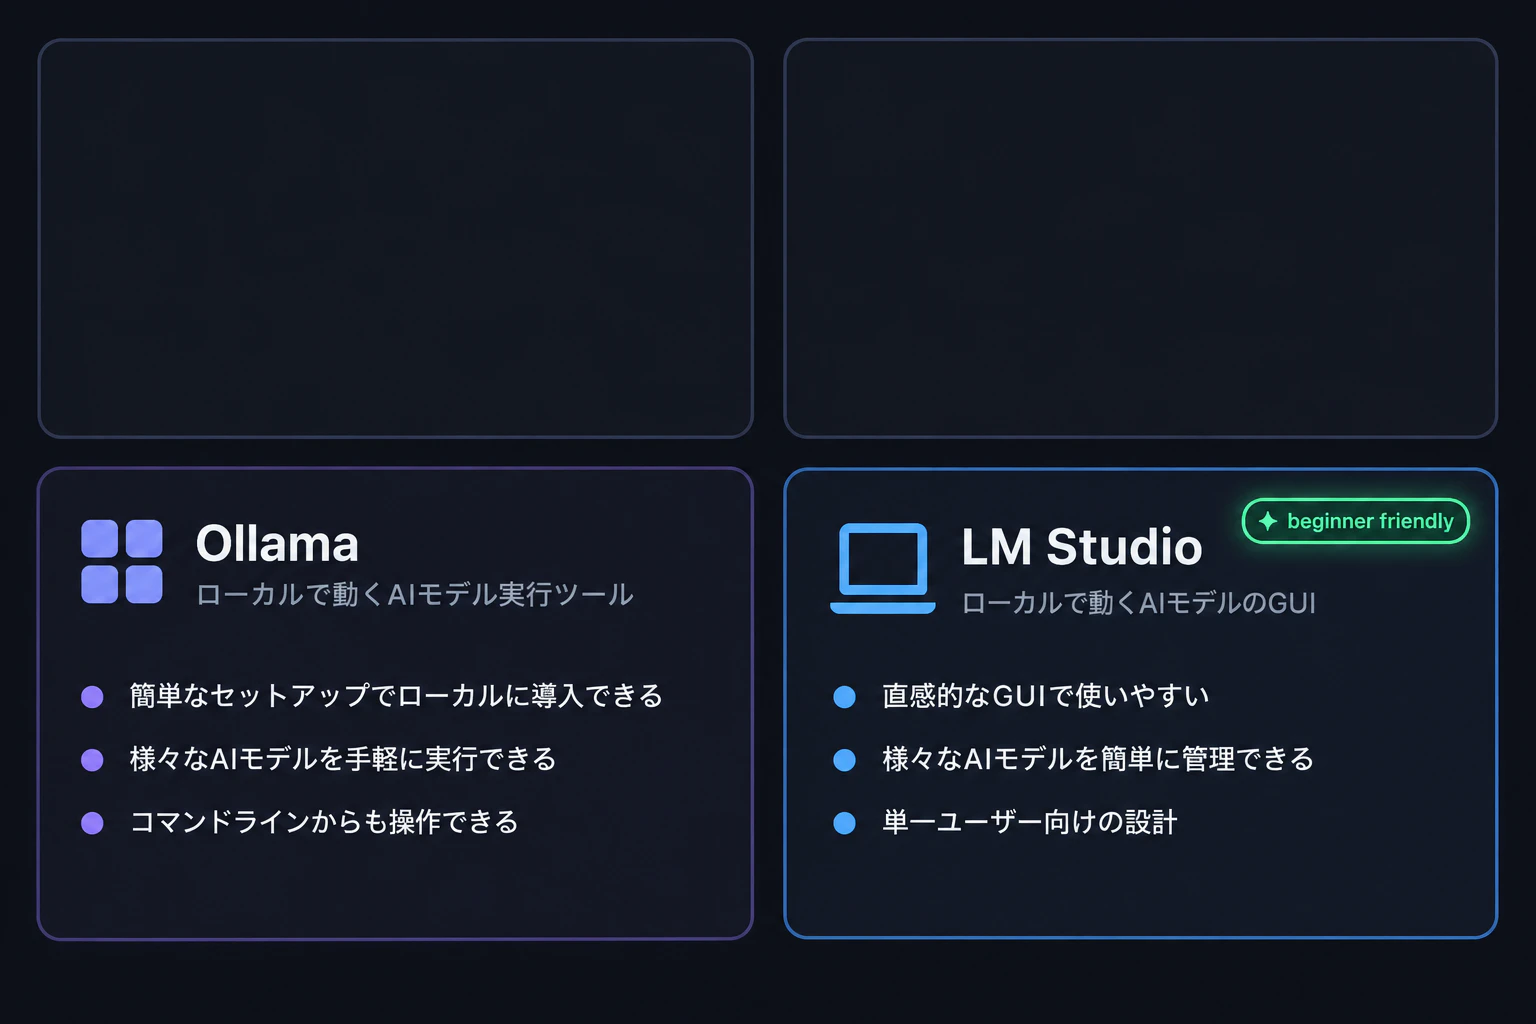
🐹 もっちー「ほなITオンチのワイはそれ一択やん!画面ポチポチするだけでええんやったら今日からいけるで」
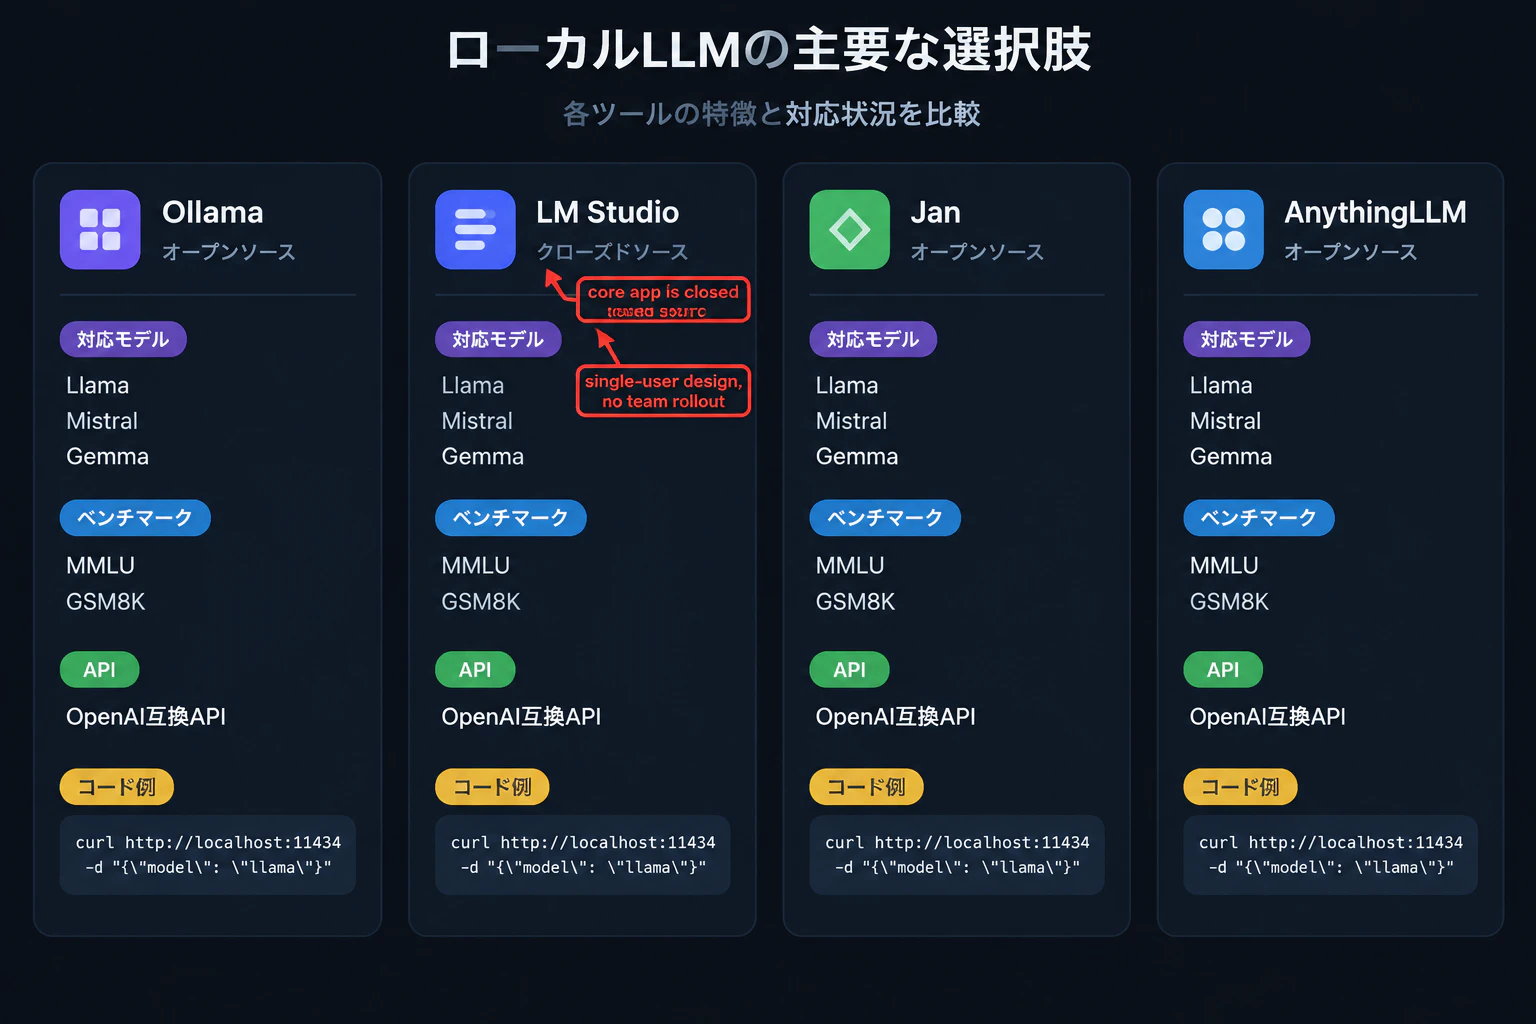
🦜 きなこ「入口としてはね。ただ本体は中身が非公開で、一人で使う前提の作りなの。チームに配る設計にはなってないんだよ」
🐹 もっちー「なるほどな。じゃあ残りの二つ、大人数に同時に配るのは誰が担当なん?」
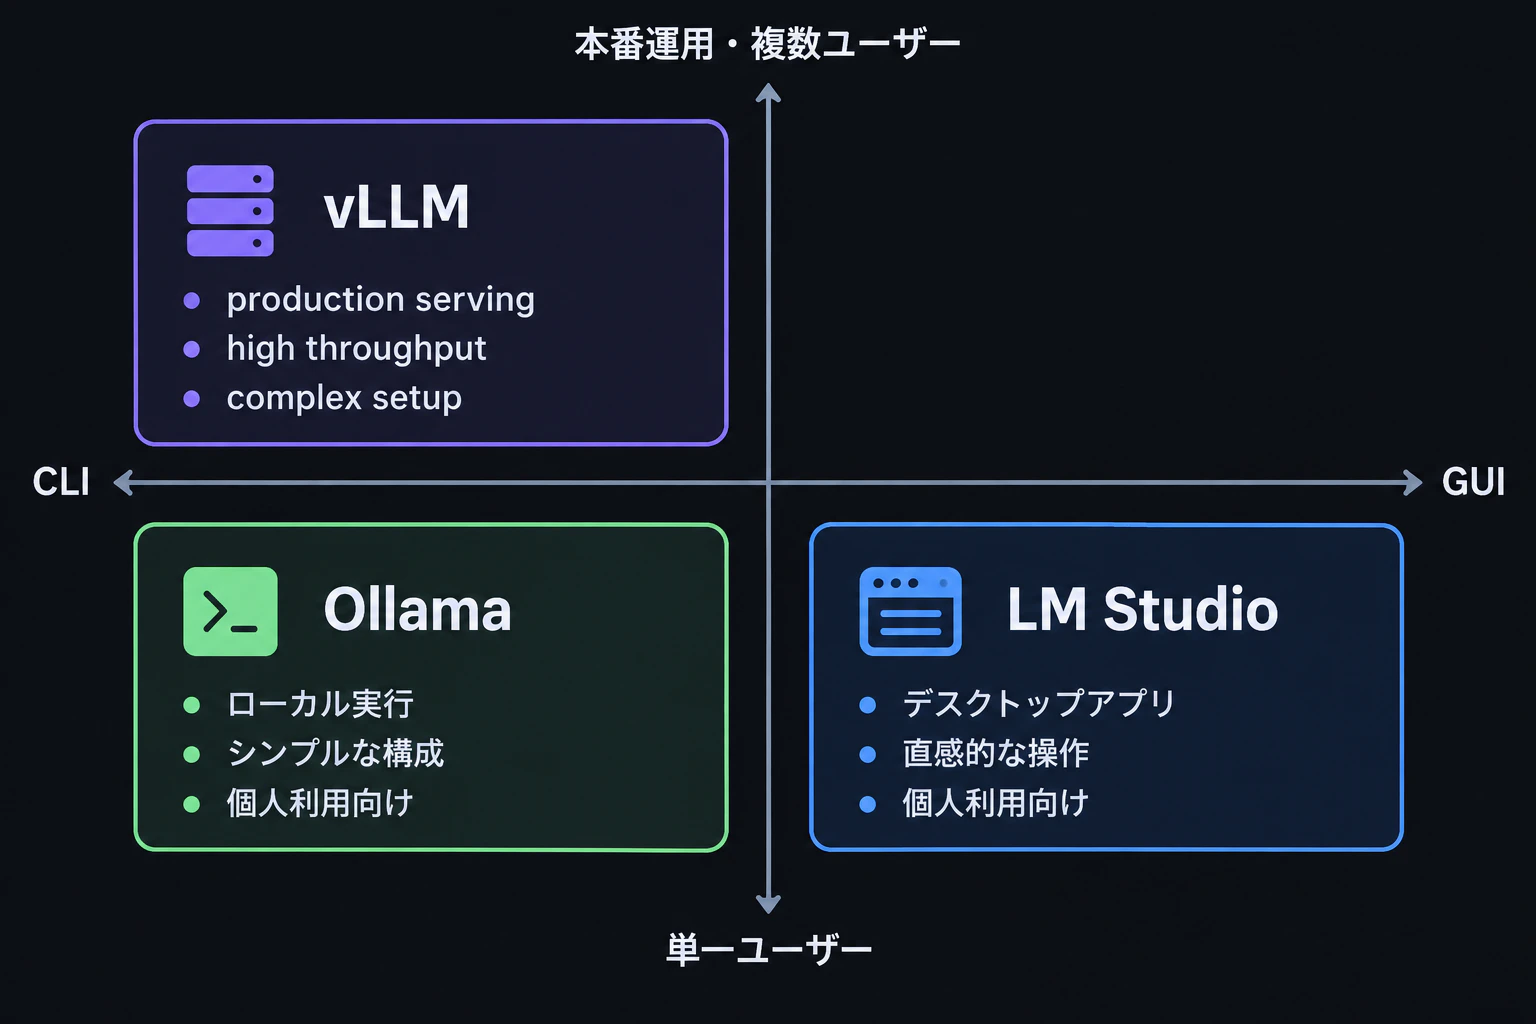
🦜 きなこ「三つ目のvLLM。本番のサービスで大人数にまとめて配るための高性能エンジンで、設定の手間は一番重いの」
🐹 もっちー「じゃあ最後の、手持ちの資料を読ませて答えさせるやつは?ぼくのメモにも答えてほしいんだけど」
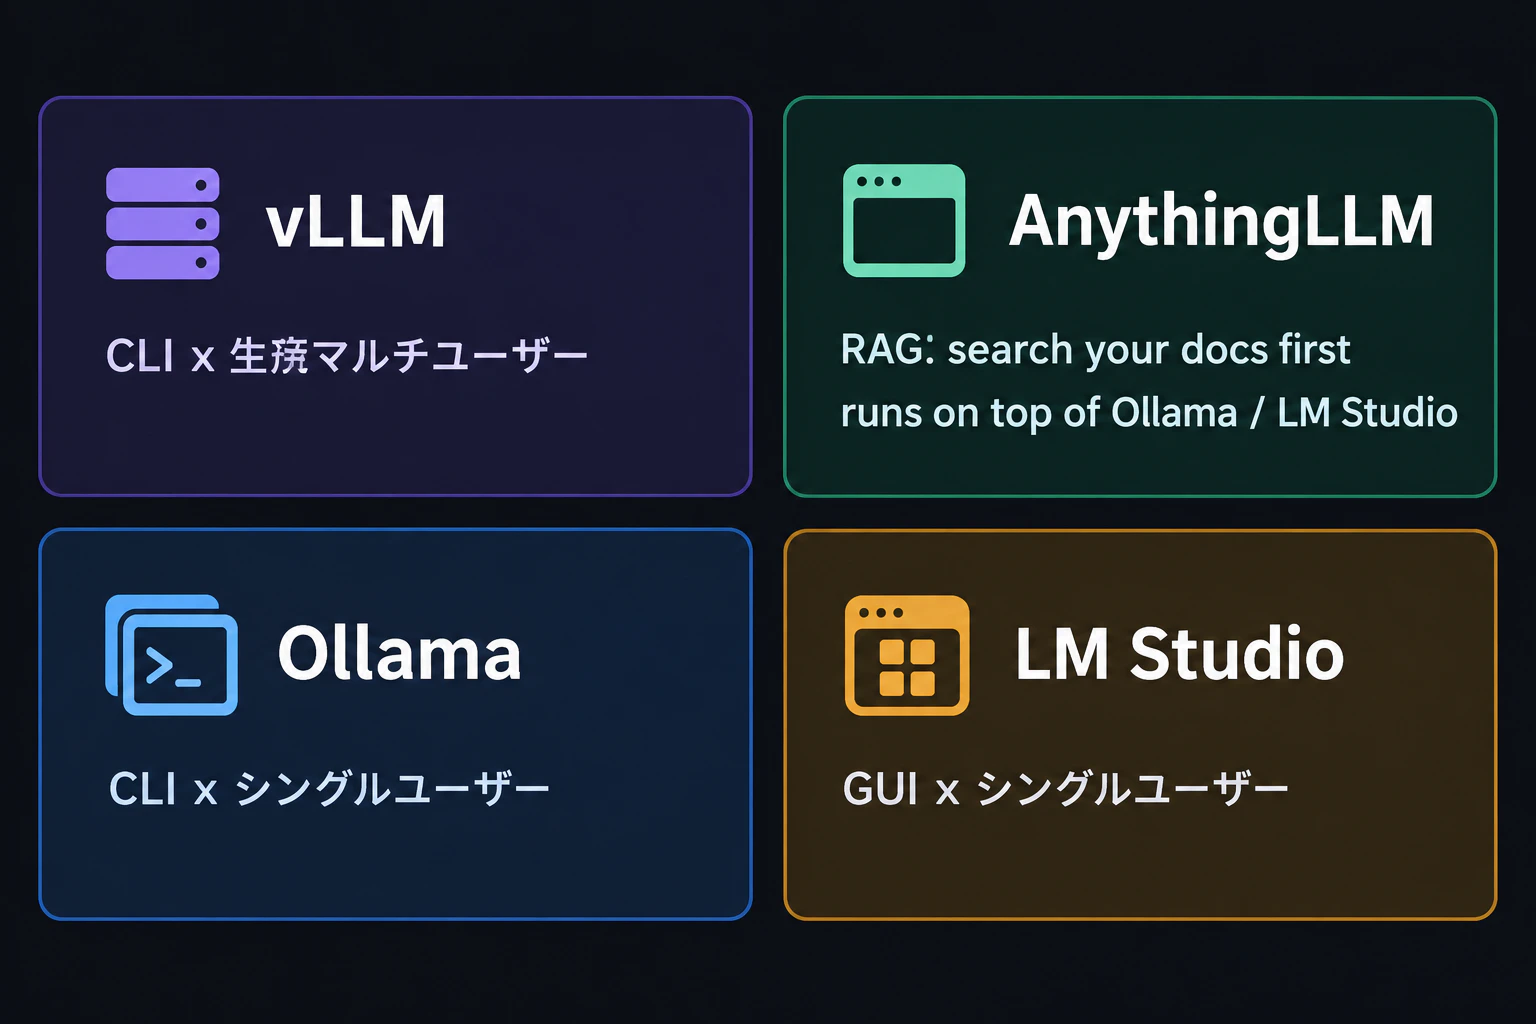
🦜 きなこ「四つ目がAnythingLLM。資料を先に探してから答えるRAGの層で、下にOllamaやLM Studioを敷いて使うの」
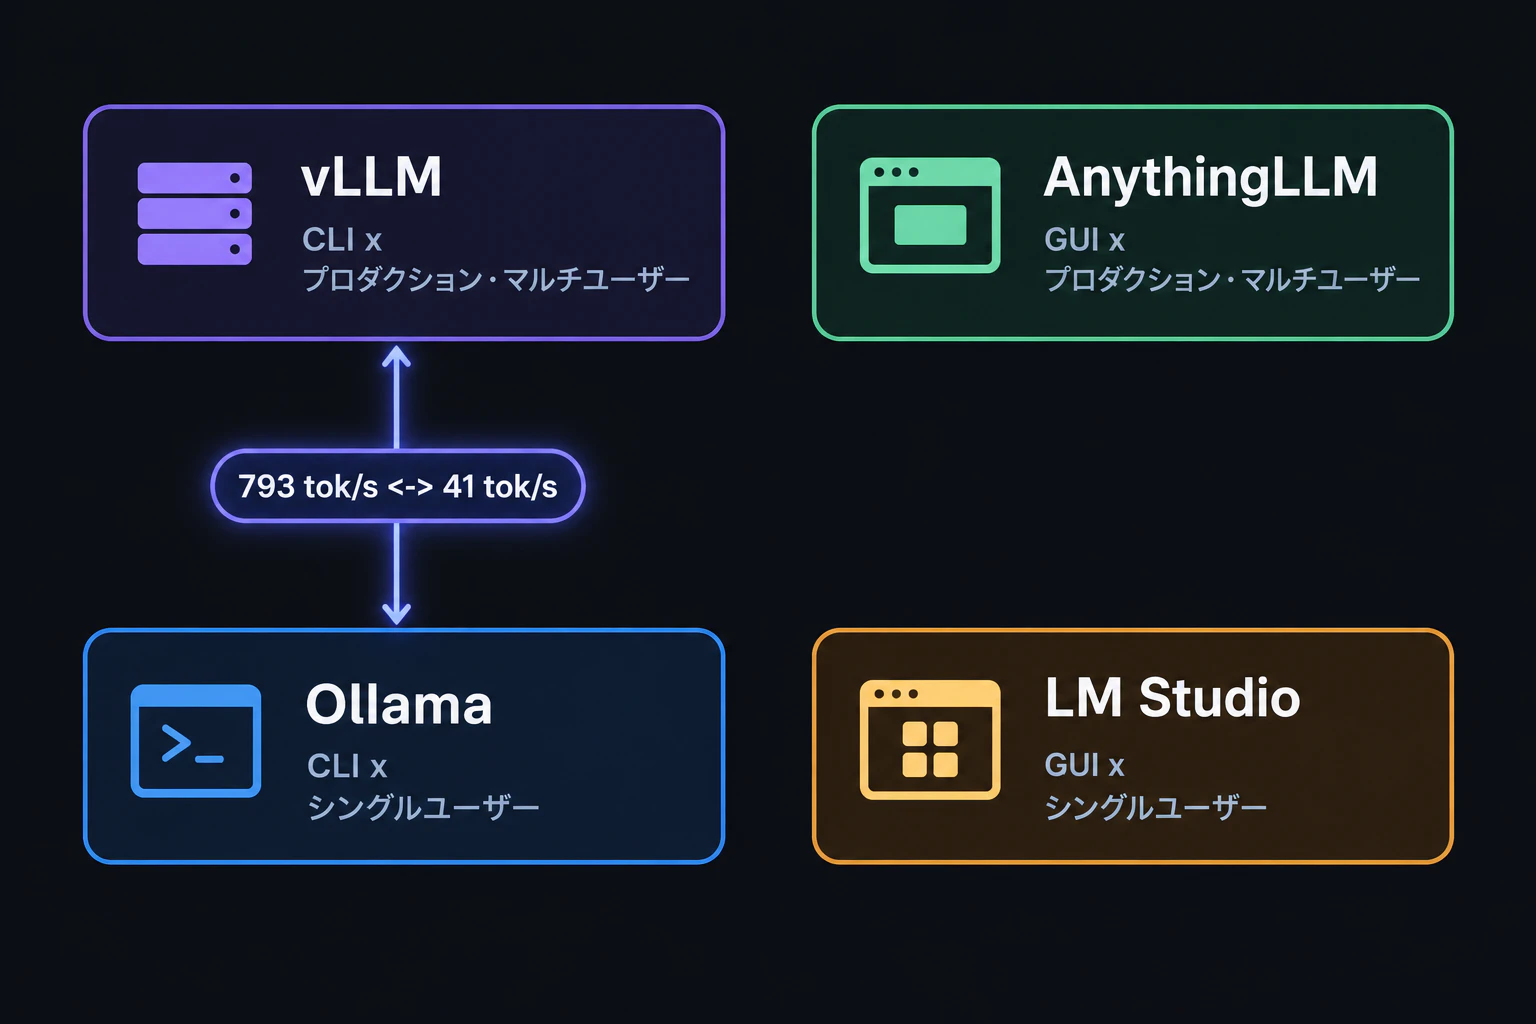
🦜 きなこ「でね、この棲み分けの根っこにあるのが、さっきの20倍差を生んだ設計思想の違いなんだよね」
20倍差の正体——PagedAttentionと「同時実行」という前提
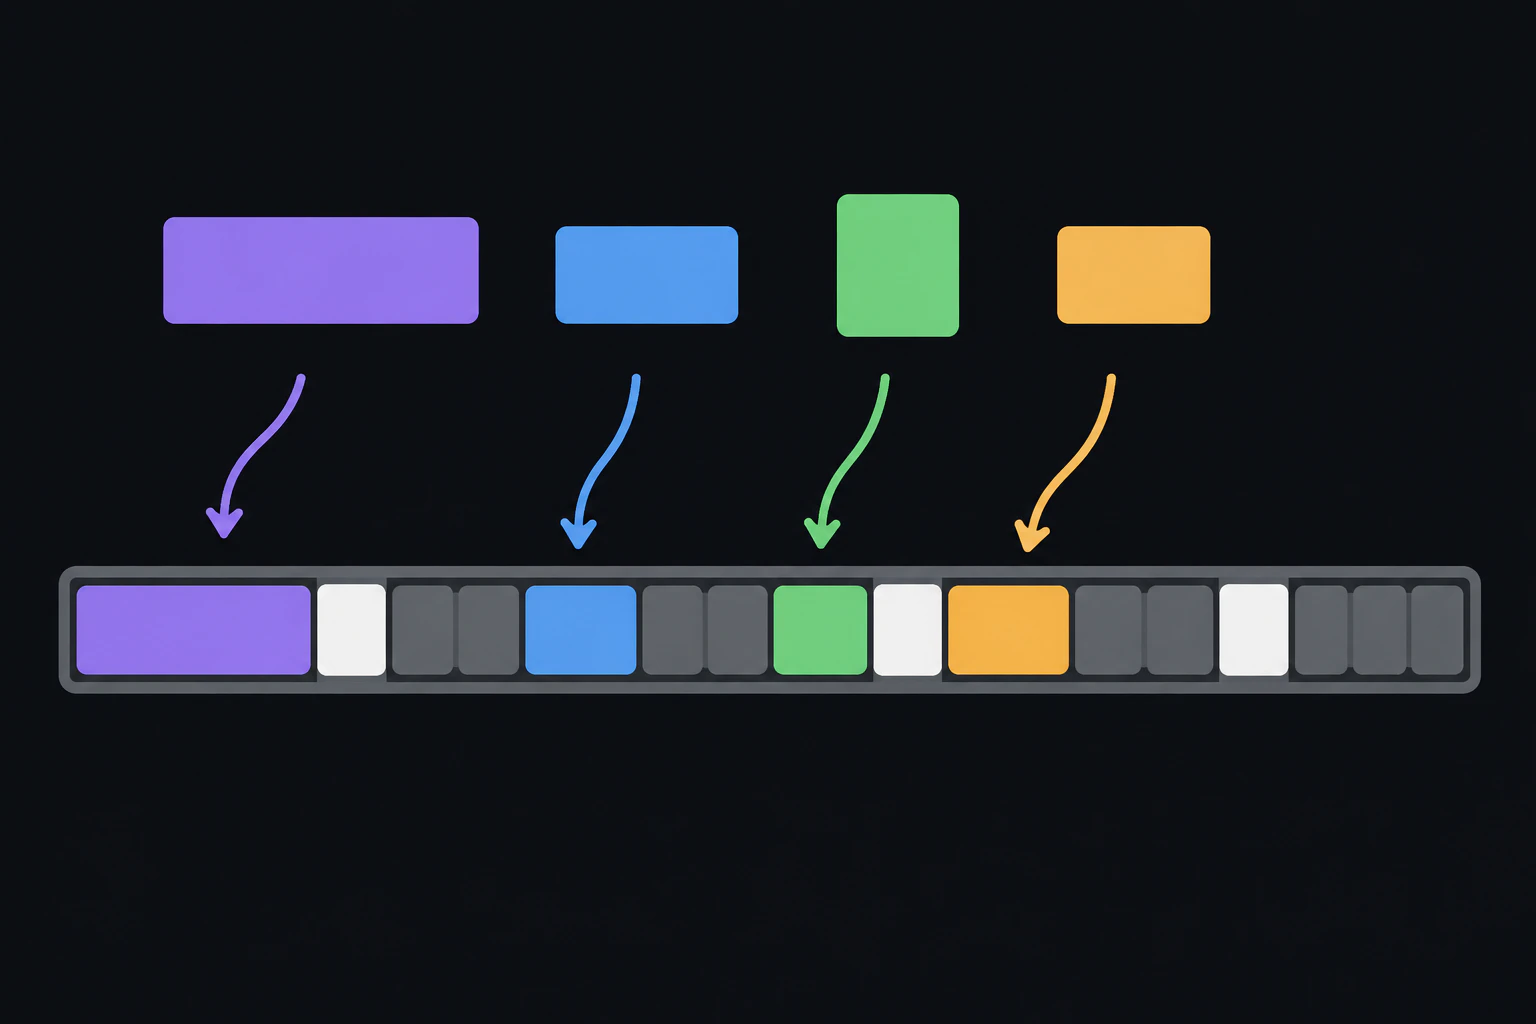
🦜 きなこ「もっちー、巣箱にひまわりの種をしまうときね。大きい粒と小さい粒が混ざったまま詰めると、あちこちに隙間できない?」
🐹 もっちー「あるある。あとひと粒くらい入りそうなのに、どこも中途半端に空いてるだけで、結局どこにも入らないんだよね」
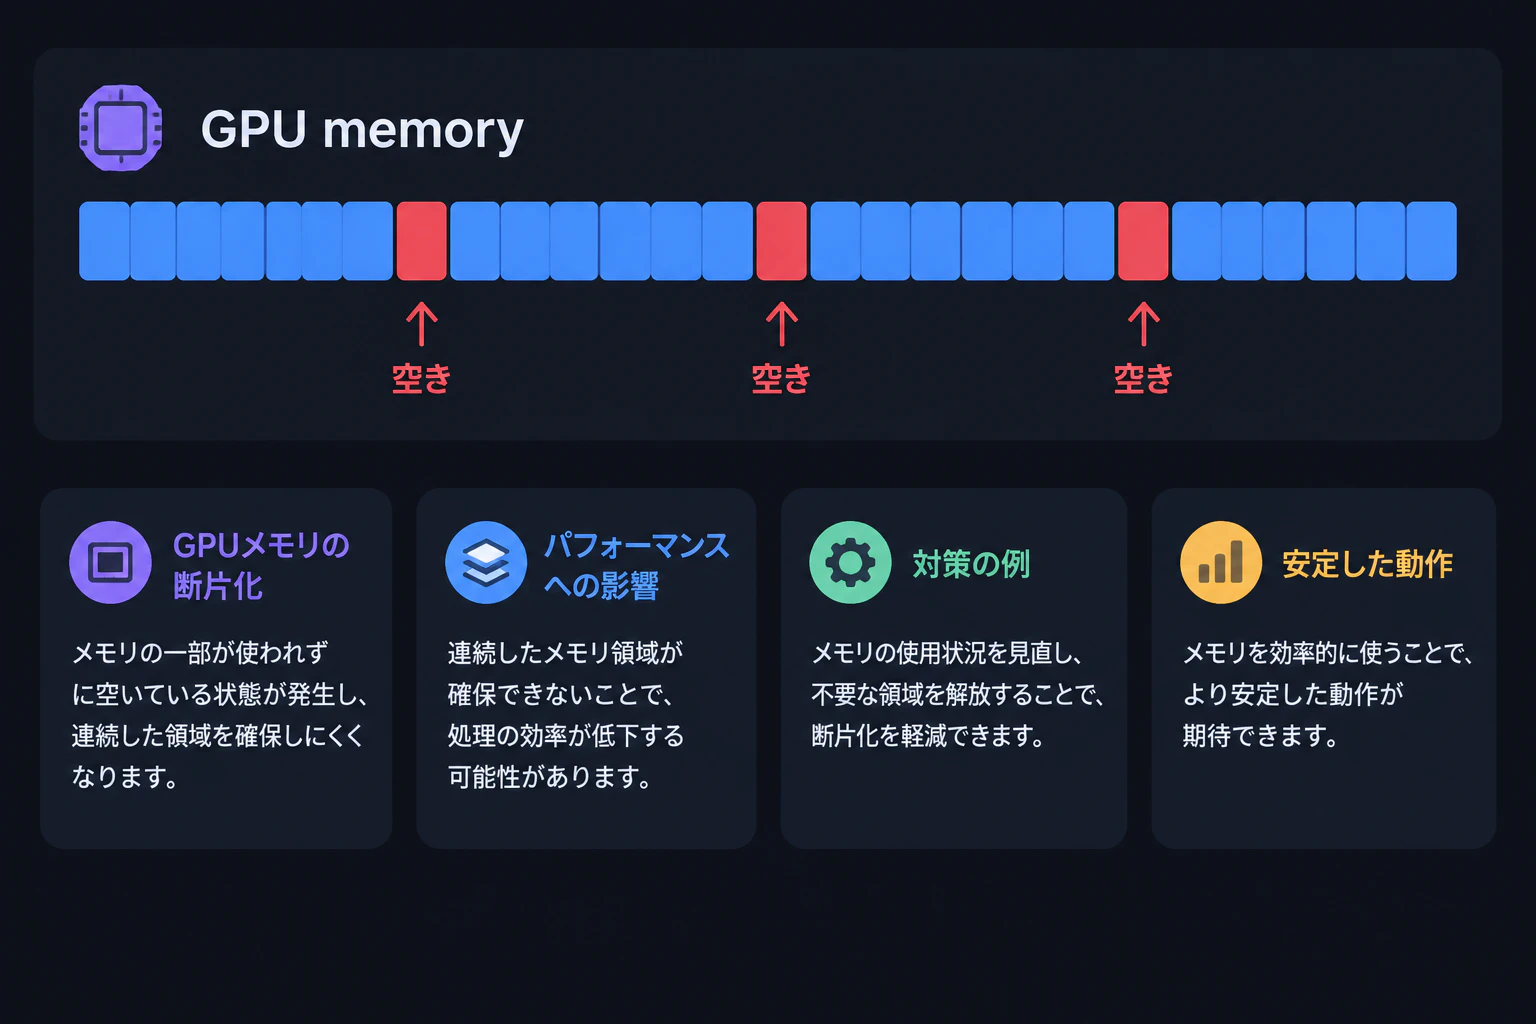
🦜 きなこ「実はGPUのメモリでも、まったく同じことが起きてるの。会話の途中経過を置いておく場所が、その虫食い状態になる」

🦜 きなこ「その途中経過はKVキャッシュって呼ばれてて、会話が長くなるほど太っていくの。読んだ内容を書き足すメモの束だと思って」
🐹 もっちー「太り続けるメモの束が、あの虫食いの隙間に散らばるってこと?想像しただけで巣箱がぐちゃぐちゃになってきた」
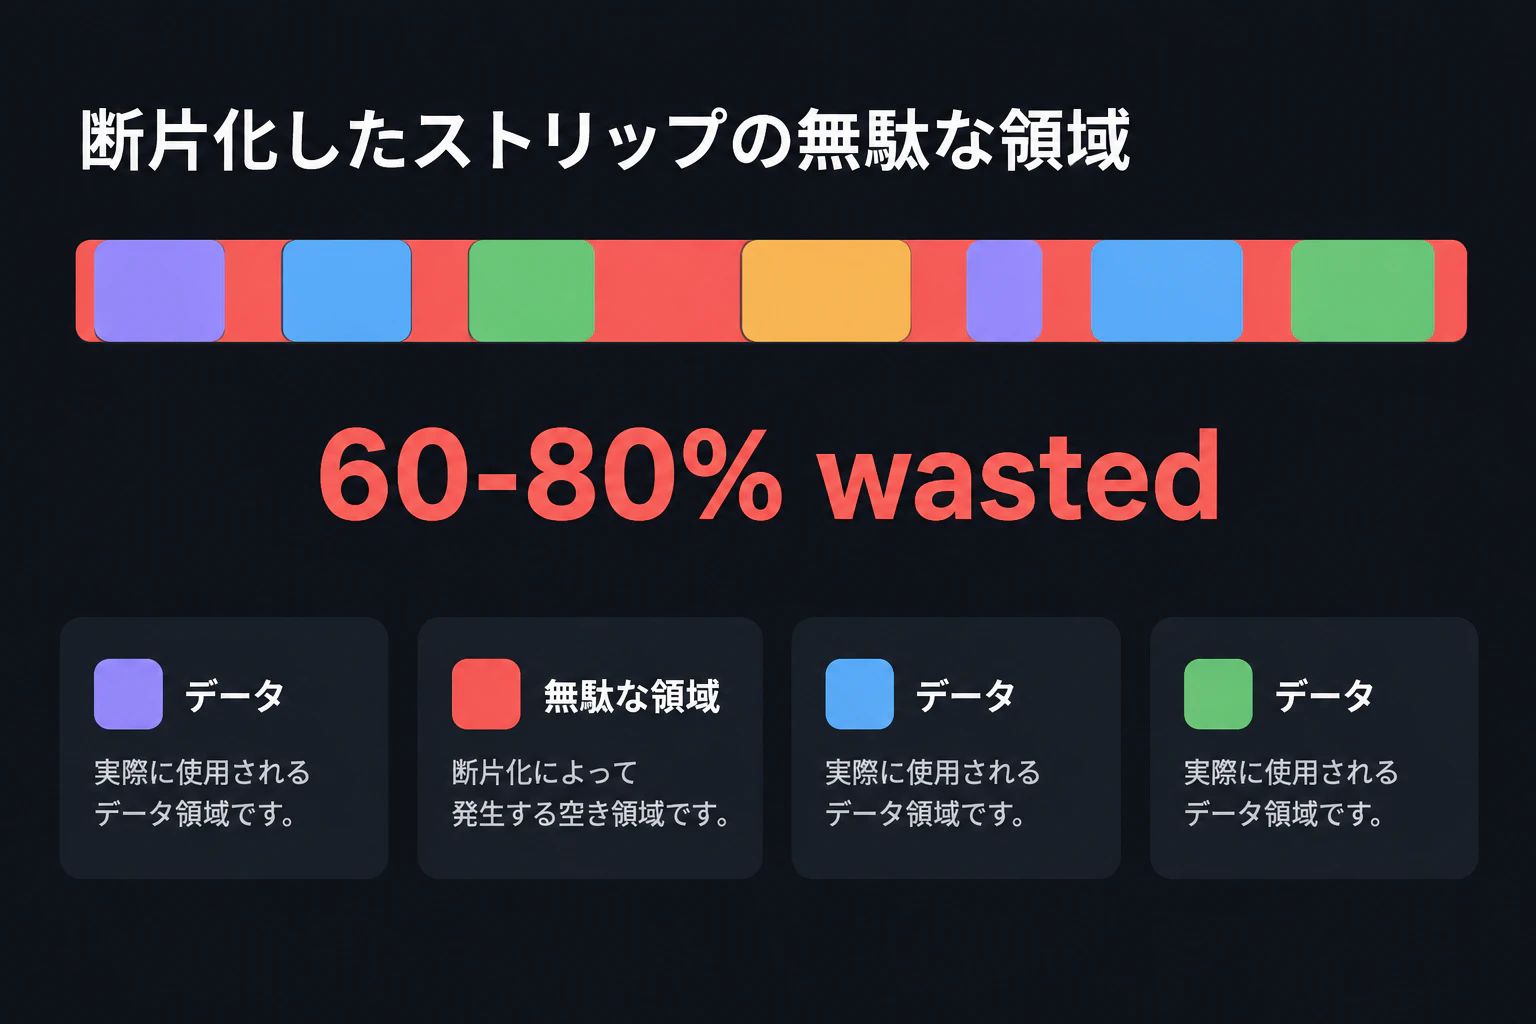
🦜 きなこ「そう。しかも昔のやり方だと、そのメモ用に先に押さえた場所の60から80パーセントが、使われないまま無駄になってたの」
🐹 もっちー「8割て!ワイの巣箱がそんな空きだらけやったら、種あと何粒入ると思ってんねん。もったいなさすぎるわ」
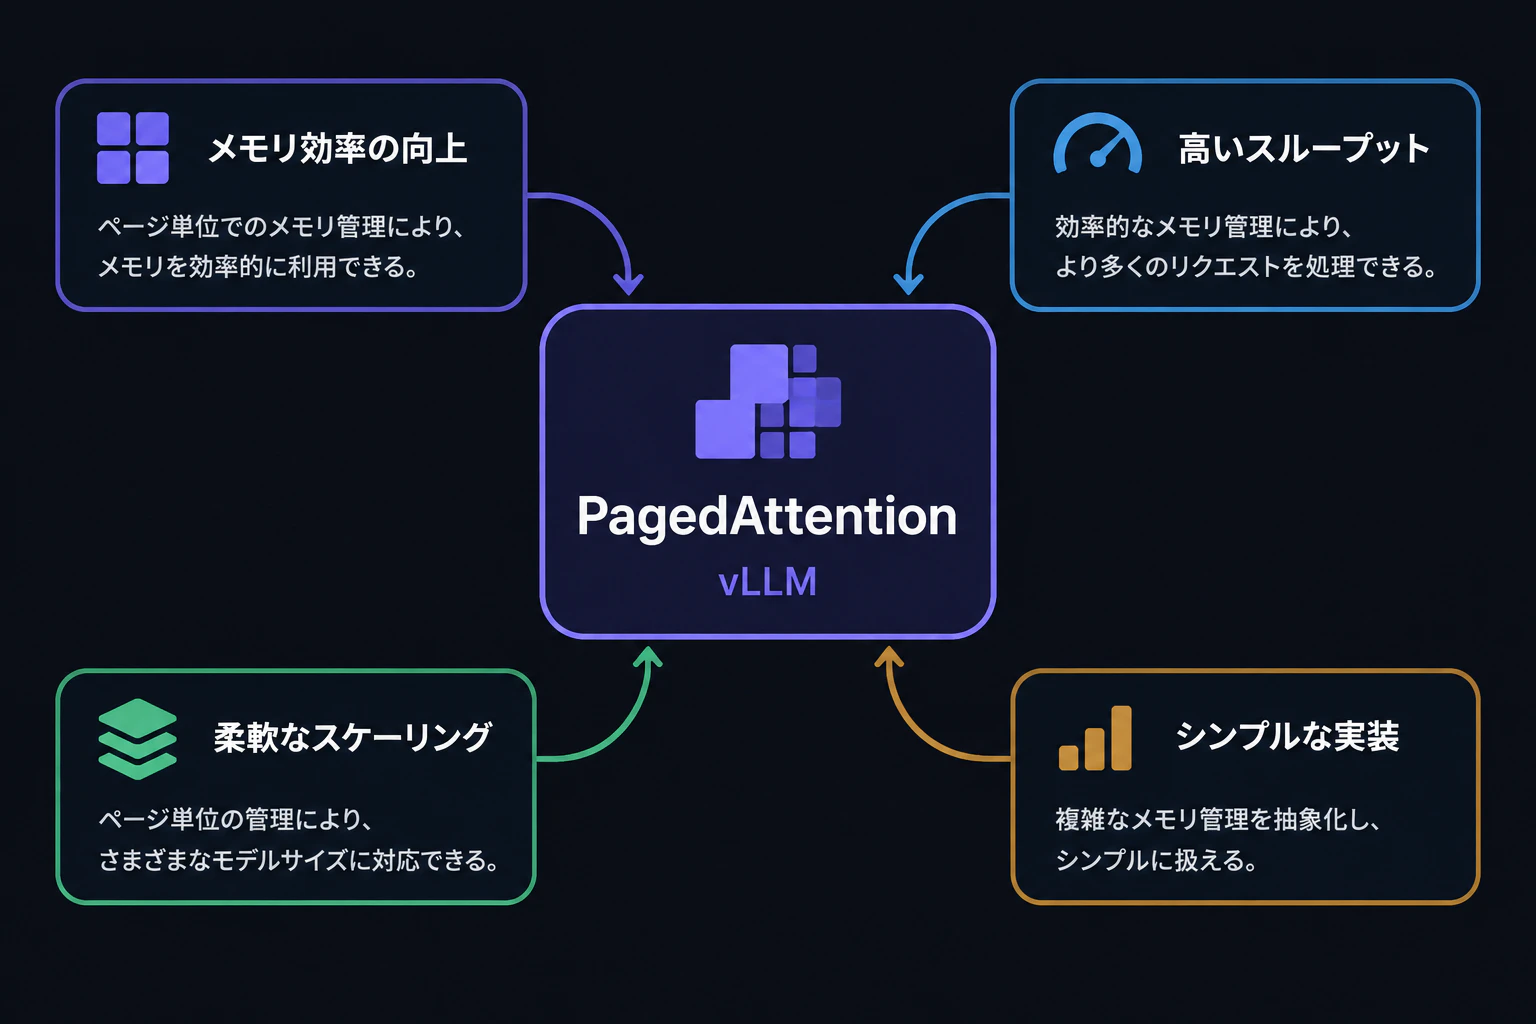
🦜 きなこ「でしょ。この名前のなかった無駄を潰すために生まれた仕組みに、ちゃんと名前がついてるの。PagedAttentionっていうんだよ」
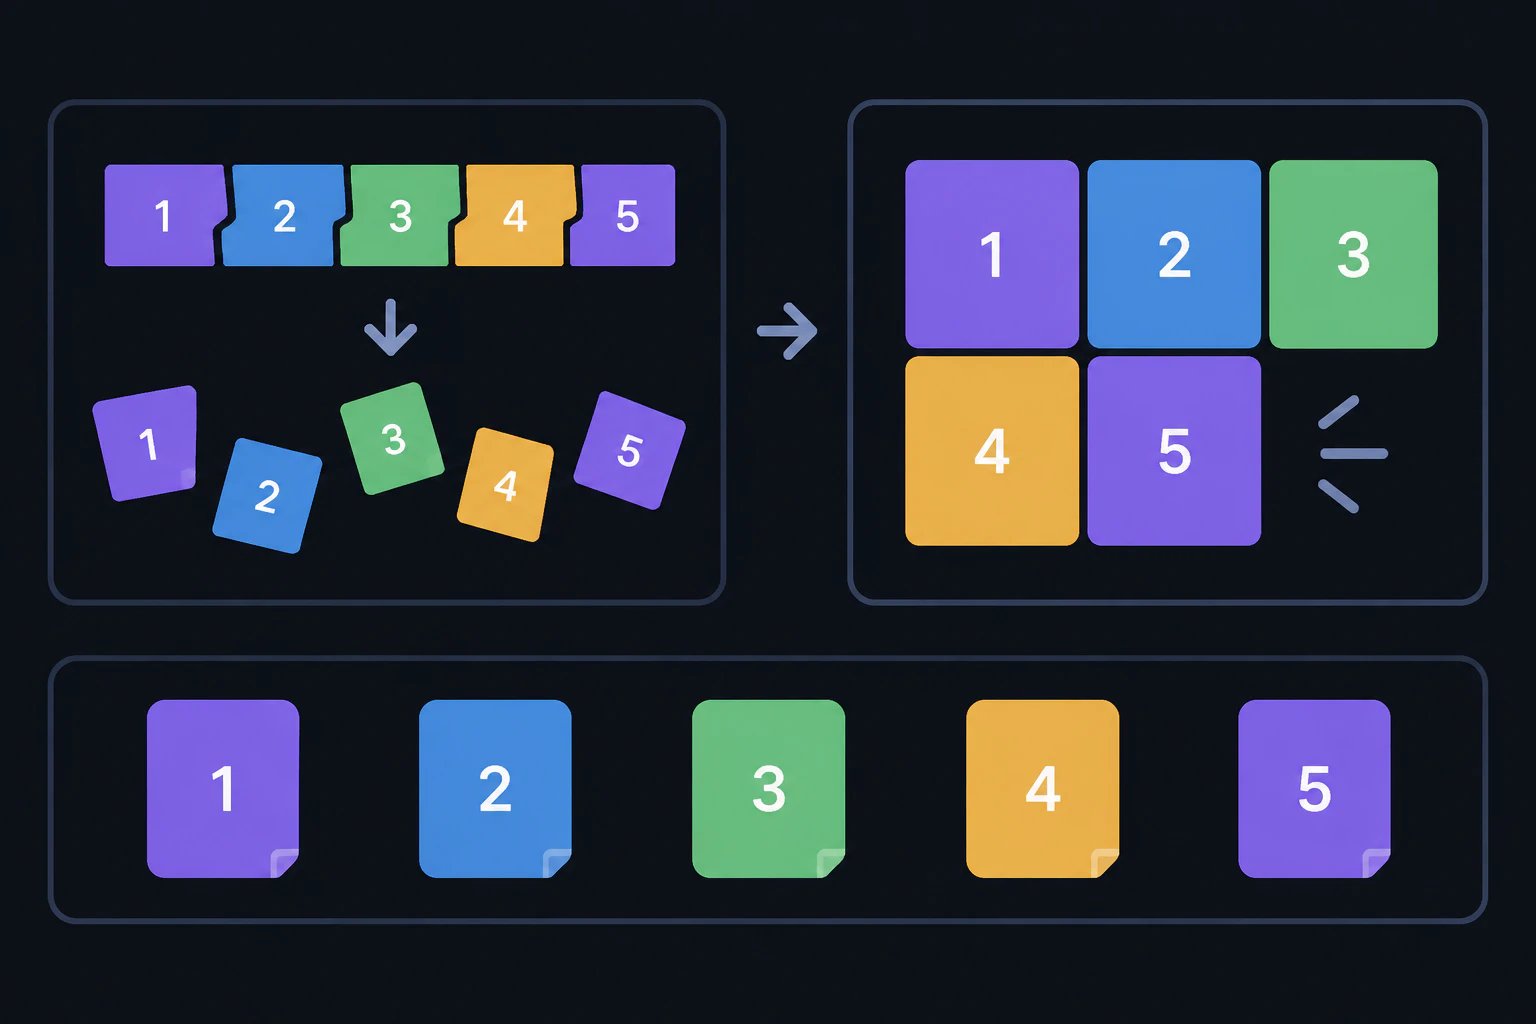
🦜 きなこ「やることは単純で、種を全部おなじ大きさの小袋に分けて、空いてる棚へばらばらに置くの。連続した空きを探さなくていい」
🐹 もっちー「あっ、小分けにすれば細い隙間まで全部使えるんだ。中身は変えずに、巣箱の詰め方だけを変えたってことだよね」
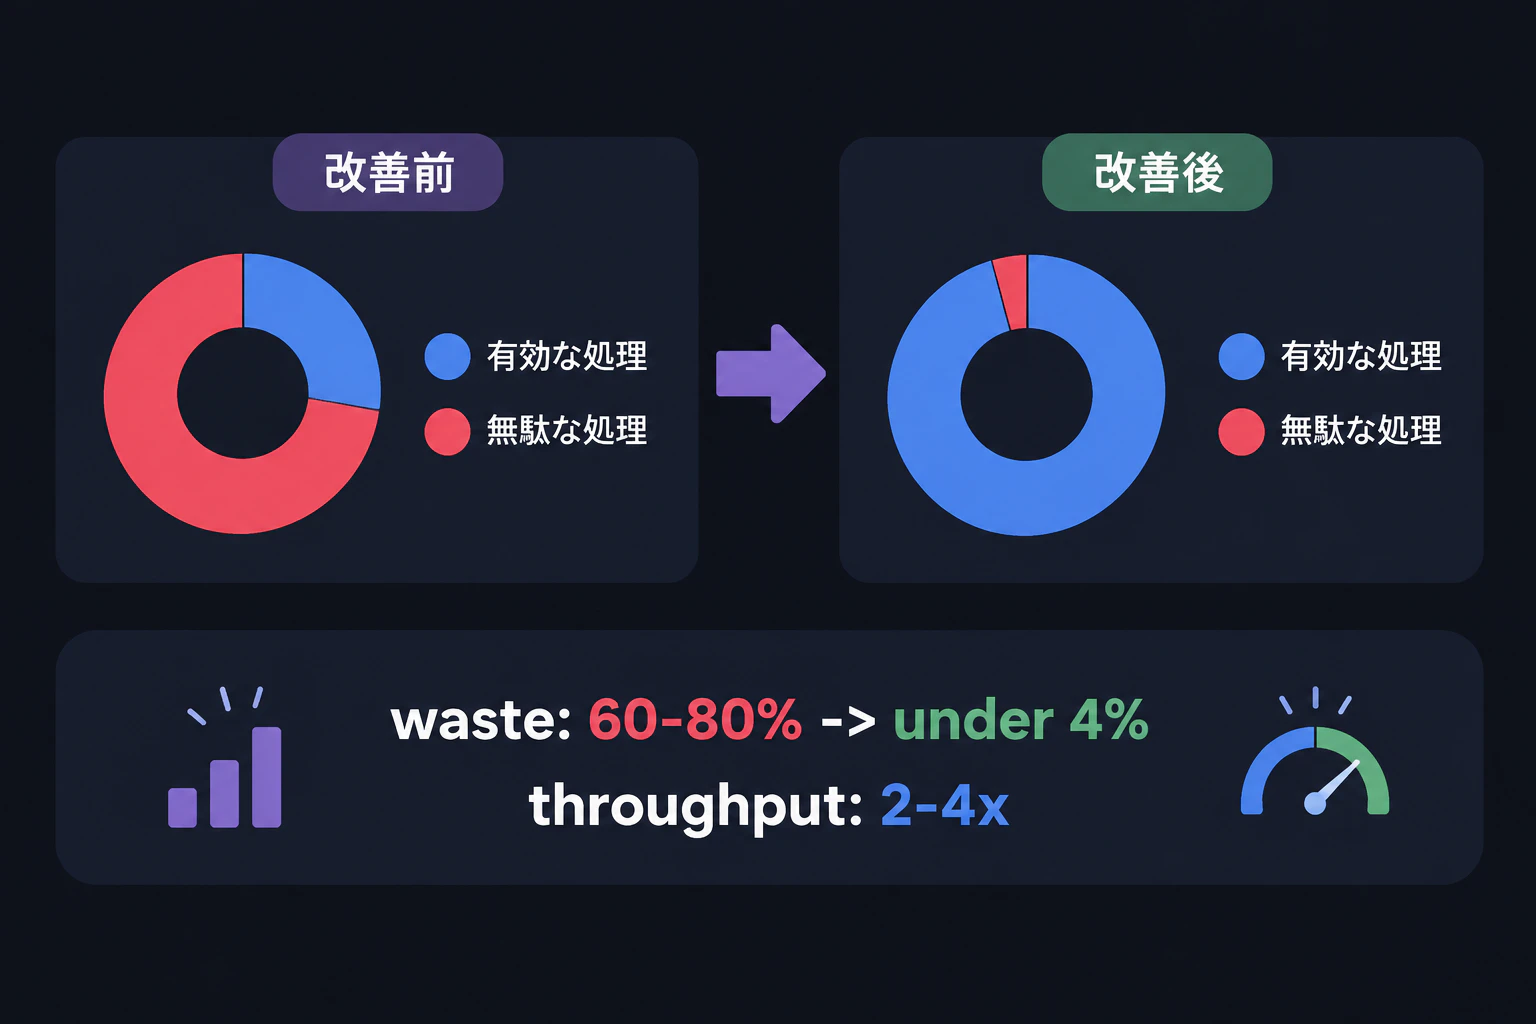
🦜 きなこ「そういうこと。無駄は4パーセント未満まで落ちて、一度にさばける量は2倍から4倍。この量をスループットって呼ぶの」
🐹 もっちー「なんやそれ最強やん!ほな全員vLLM使ったらええやん。同じGPUのまま4倍やろ、迷う理由あらへんわ」
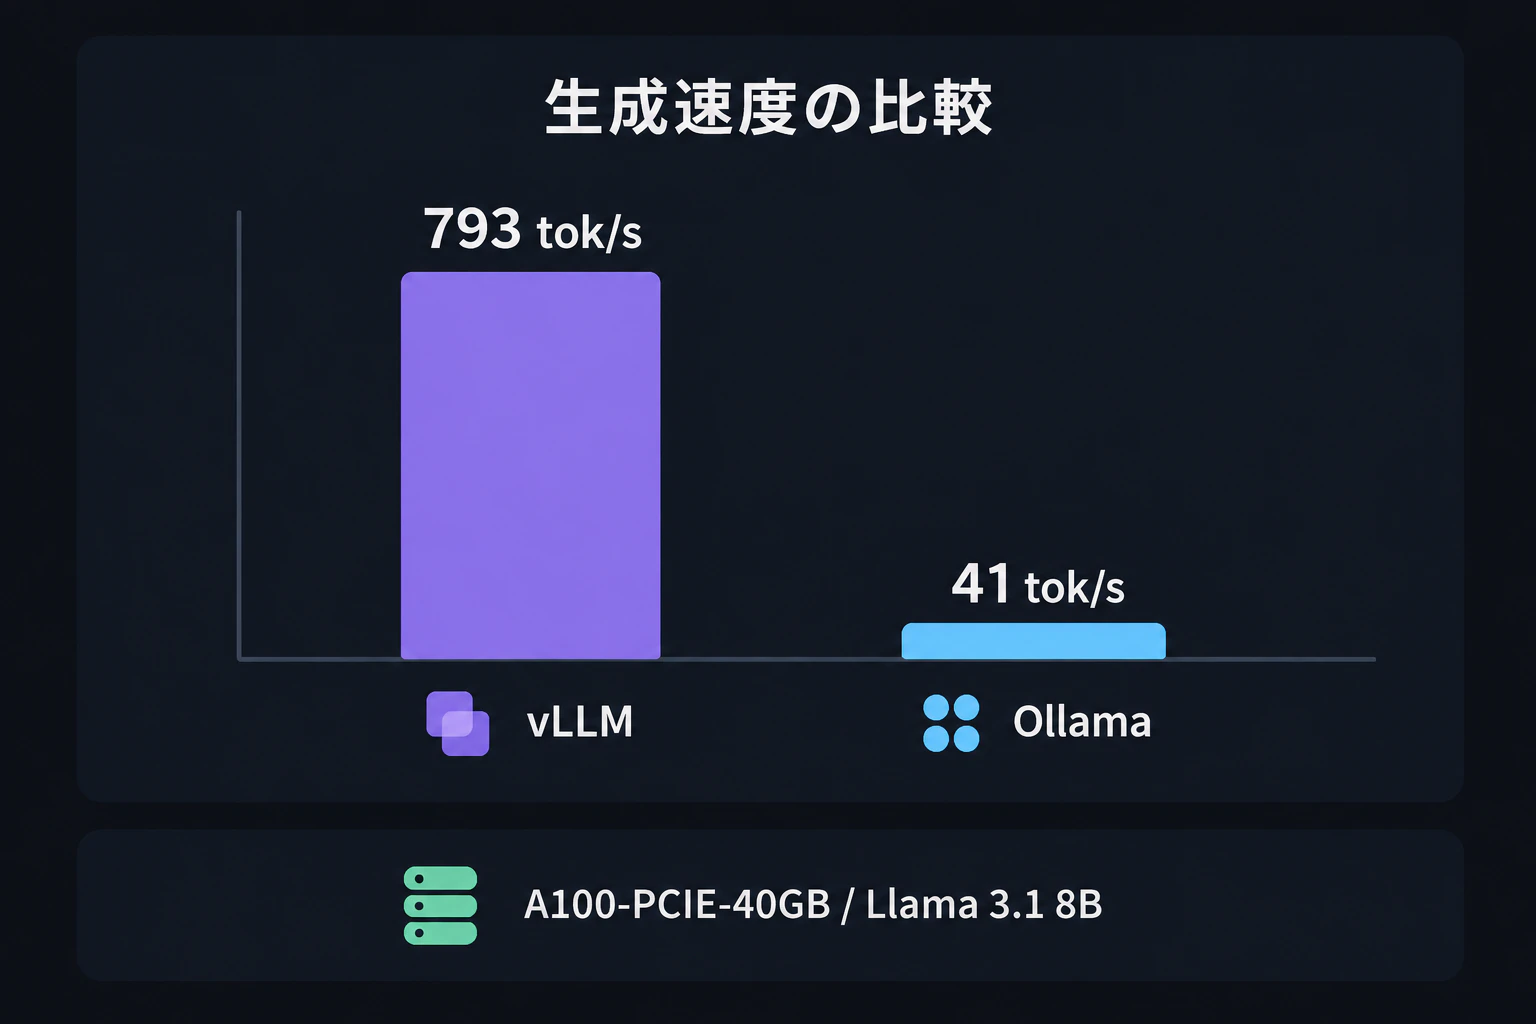
🦜 きなこ「実際その差は大きくて、A100ってGPUでLlama3.1の8Bを動かすと、毎秒793トークン対41トークン。トークンは言葉のかけらね」
🐹 もっちー「793対41って、ざっと20倍やん!もう完全に勝負ついてるわ。ワイ明日からvLLM一本で行くで、決まりや」
🦜 きなこ「ちょっと待って、そこが大事なところなの。その793はね、たくさんの人が同時にお願いを投げてる状態で出た数字なんだよ」
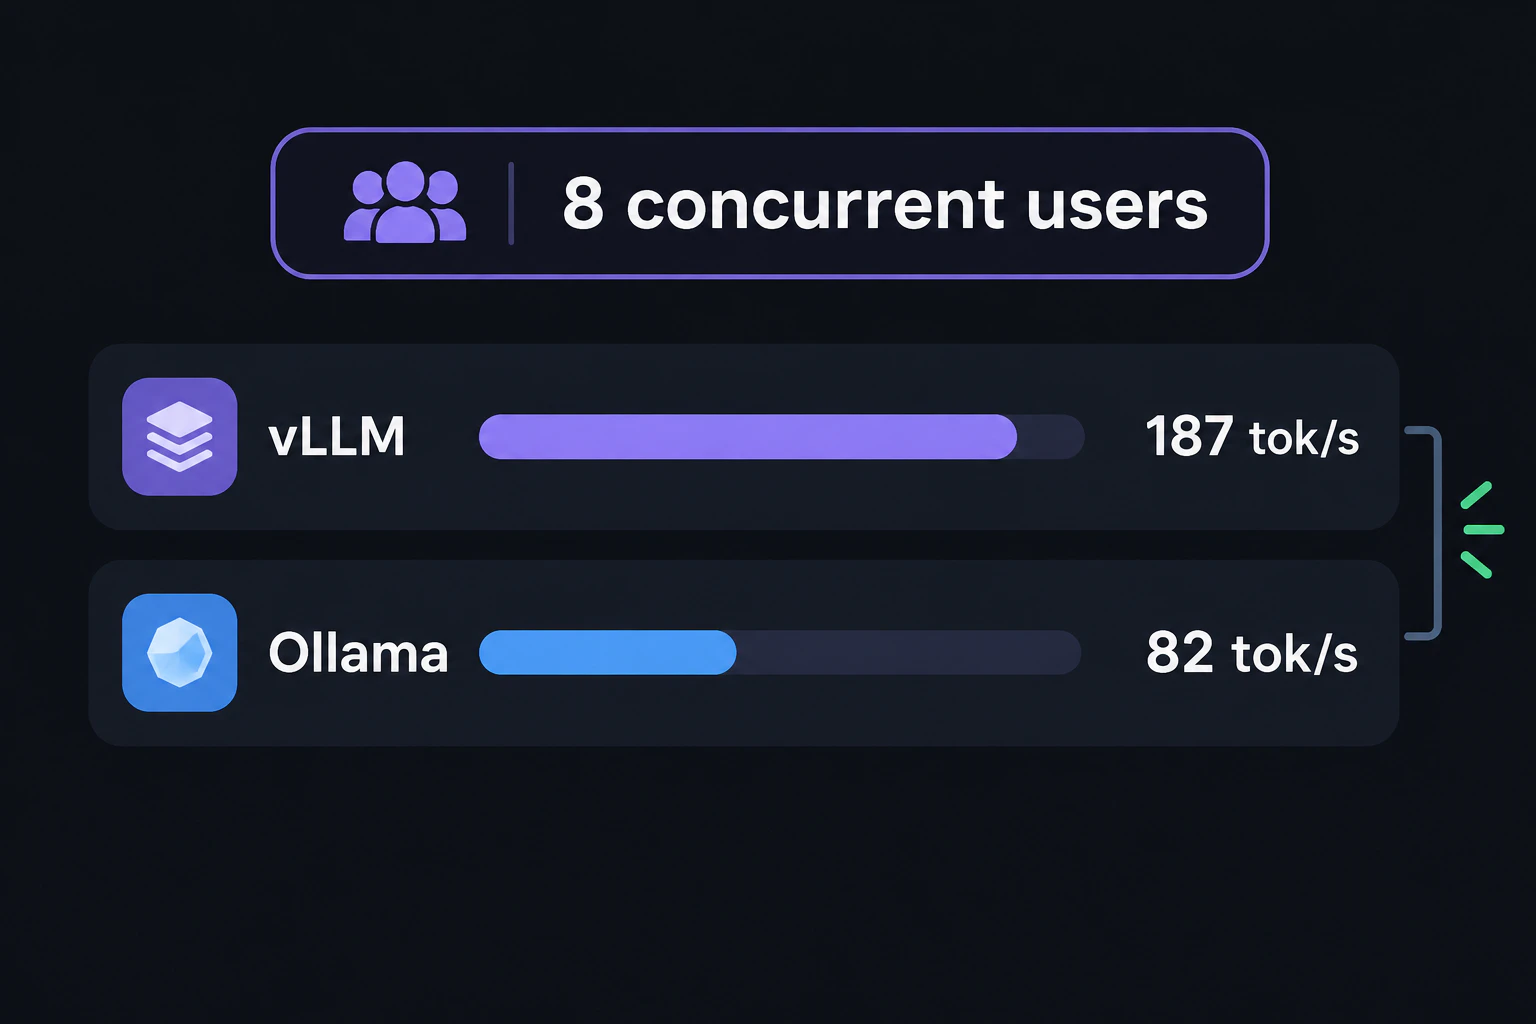
🦜 きなこ「同時に使う人数を8人まで下げると187対82で、およそ2.3倍。同じベンチマークでも人数を変えるだけで数字は動くの」
🐹 もっちー「えっ、20倍が2.3倍まで縮むの?使う人数が減っただけで、そんなに変わっちゃうんだ。話が全然違うじゃん」
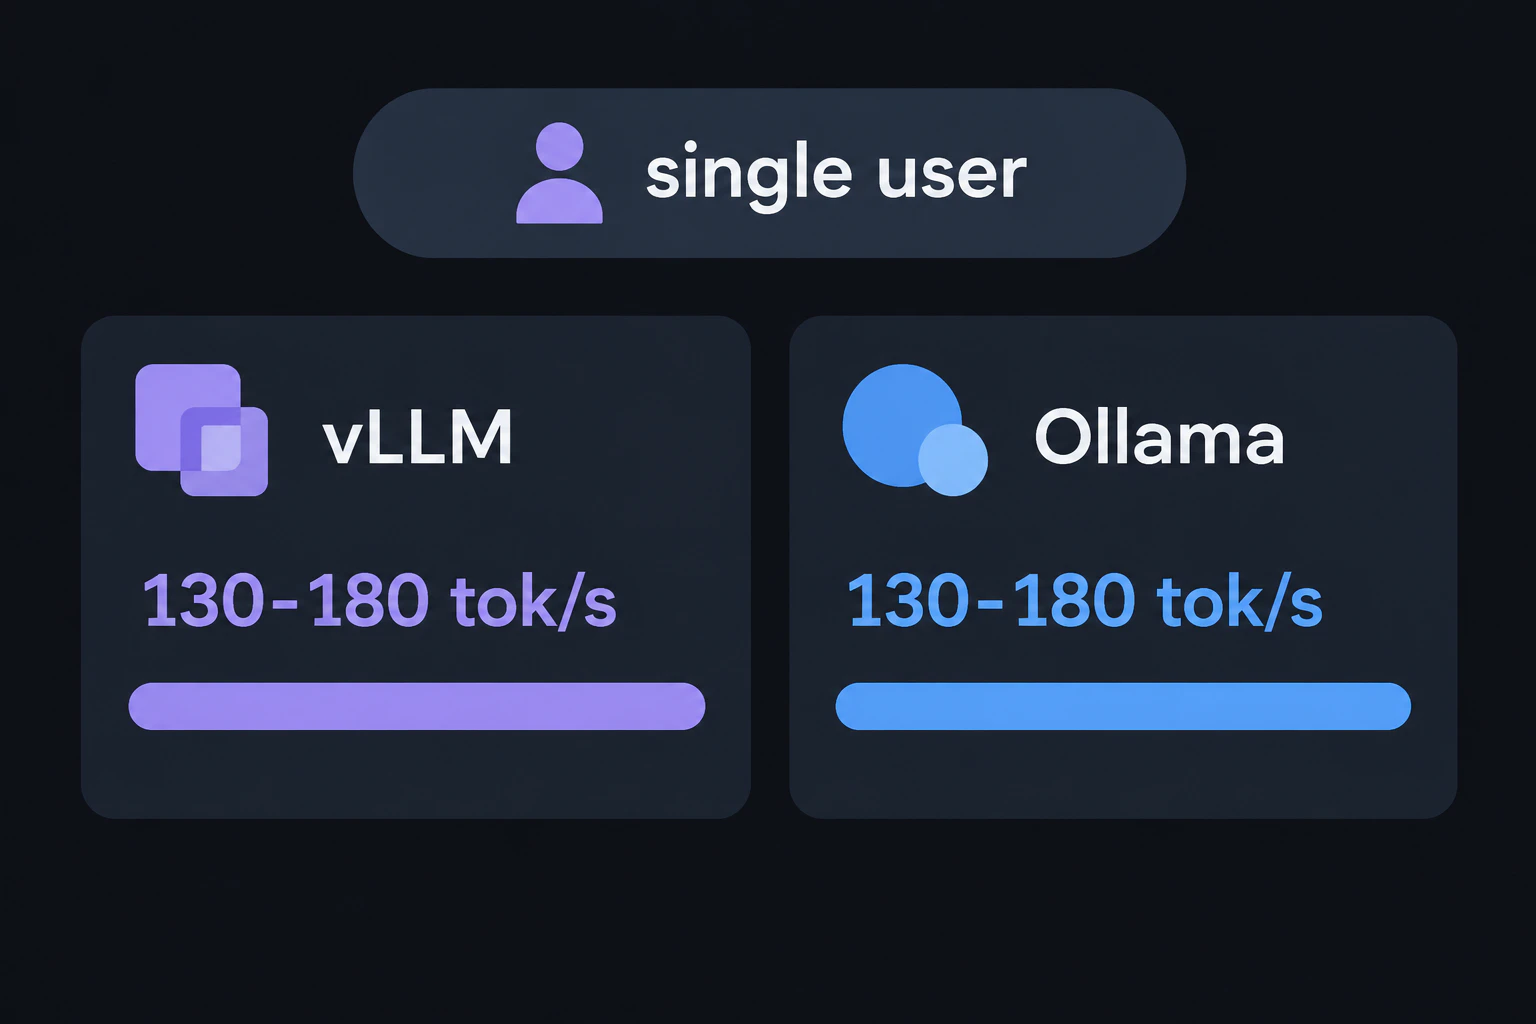
🦜 きなこ「そう。使ってるのがもっちー一人だけなら、vLLMもOllamaも毎秒130から180くらい。もう差はほとんど残らないの」
🐹 もっちー「なるほど…数字だけ見て飛びつくところだった。何人で同時に使ったのか、そこまで込みで見なきゃダメなんだね」
🦜 きなこ「ここまでは速さの話。でも多くの人が本当に詰まるのは、そもそも自分のPCに載るかどうかなんだよね」
VRAM別・実際に何が載るのか——Q4_K_Mという現実解
🐹 もっちー「速い遅いの話は分かったよ。でもぼく、さっきからもっと手前のところで、ずーっと引っかかってるんだ」
🐹 もっちー「そもそもさ、そのモデルってぼくのパソコンに載るの? 速いか遅いかの前に、そこが分かってないんだけど」
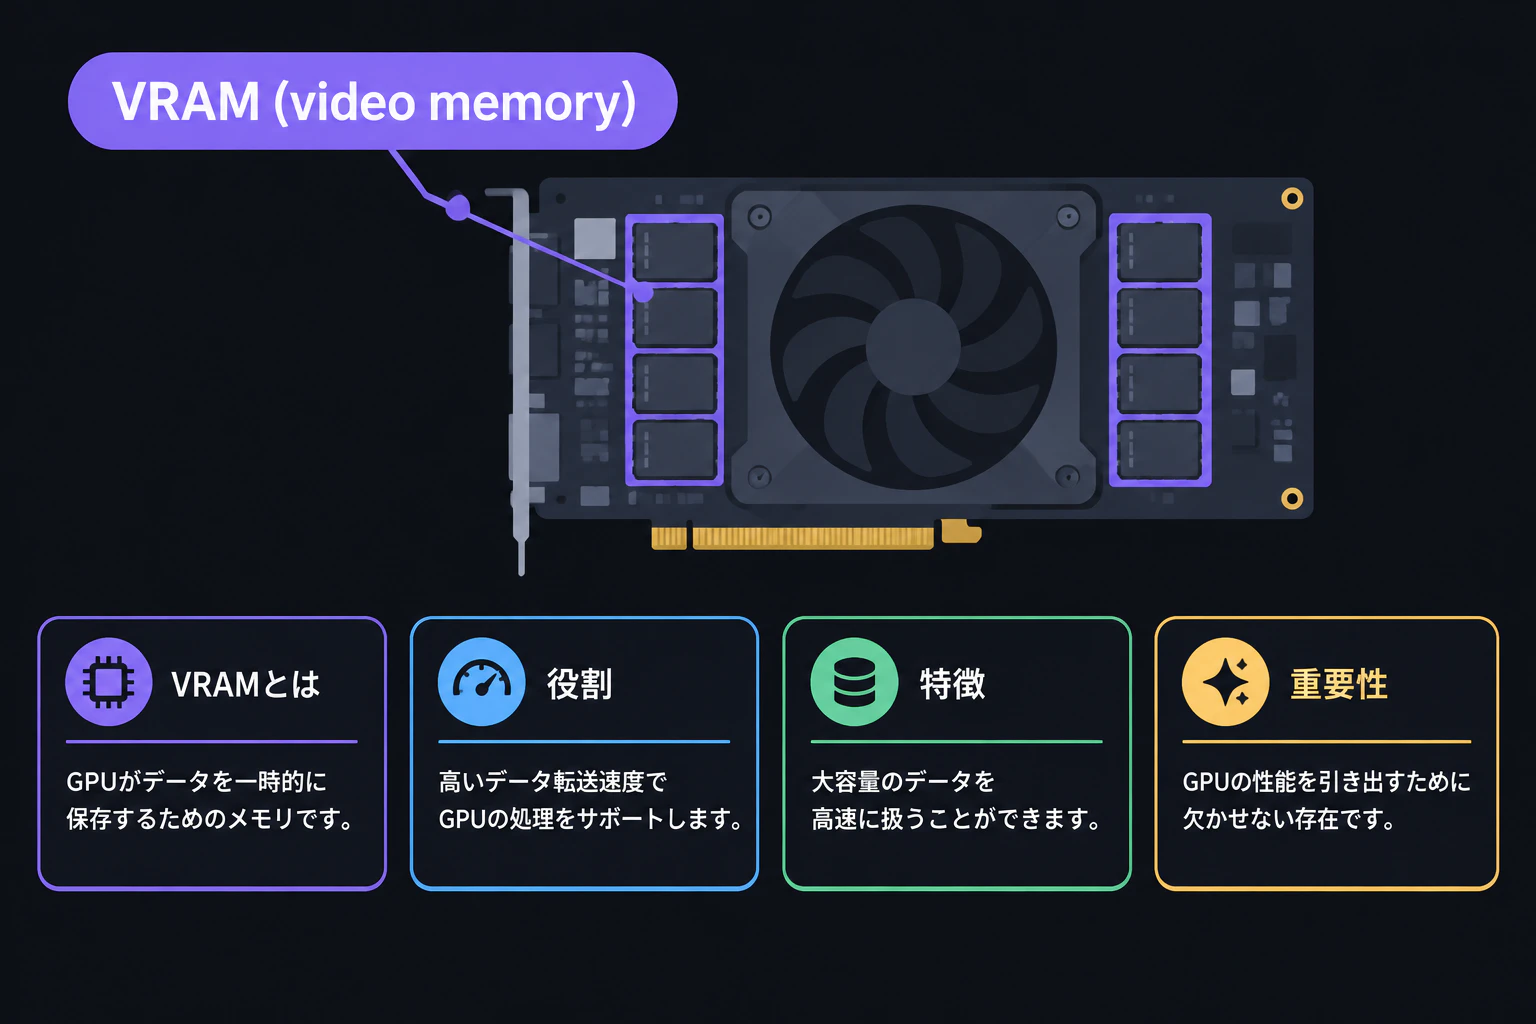
🦜 きなこ「むしろそこが本題なの。載るか載らないかを決めてるのは、グラボの中のVRAMっていうメモリなんだよ」
🐹 もっちー「ブイラム? ゲームのグラボの話でしか聞いたことないんだけど、それがモデルの大きさとどう関係するの?」
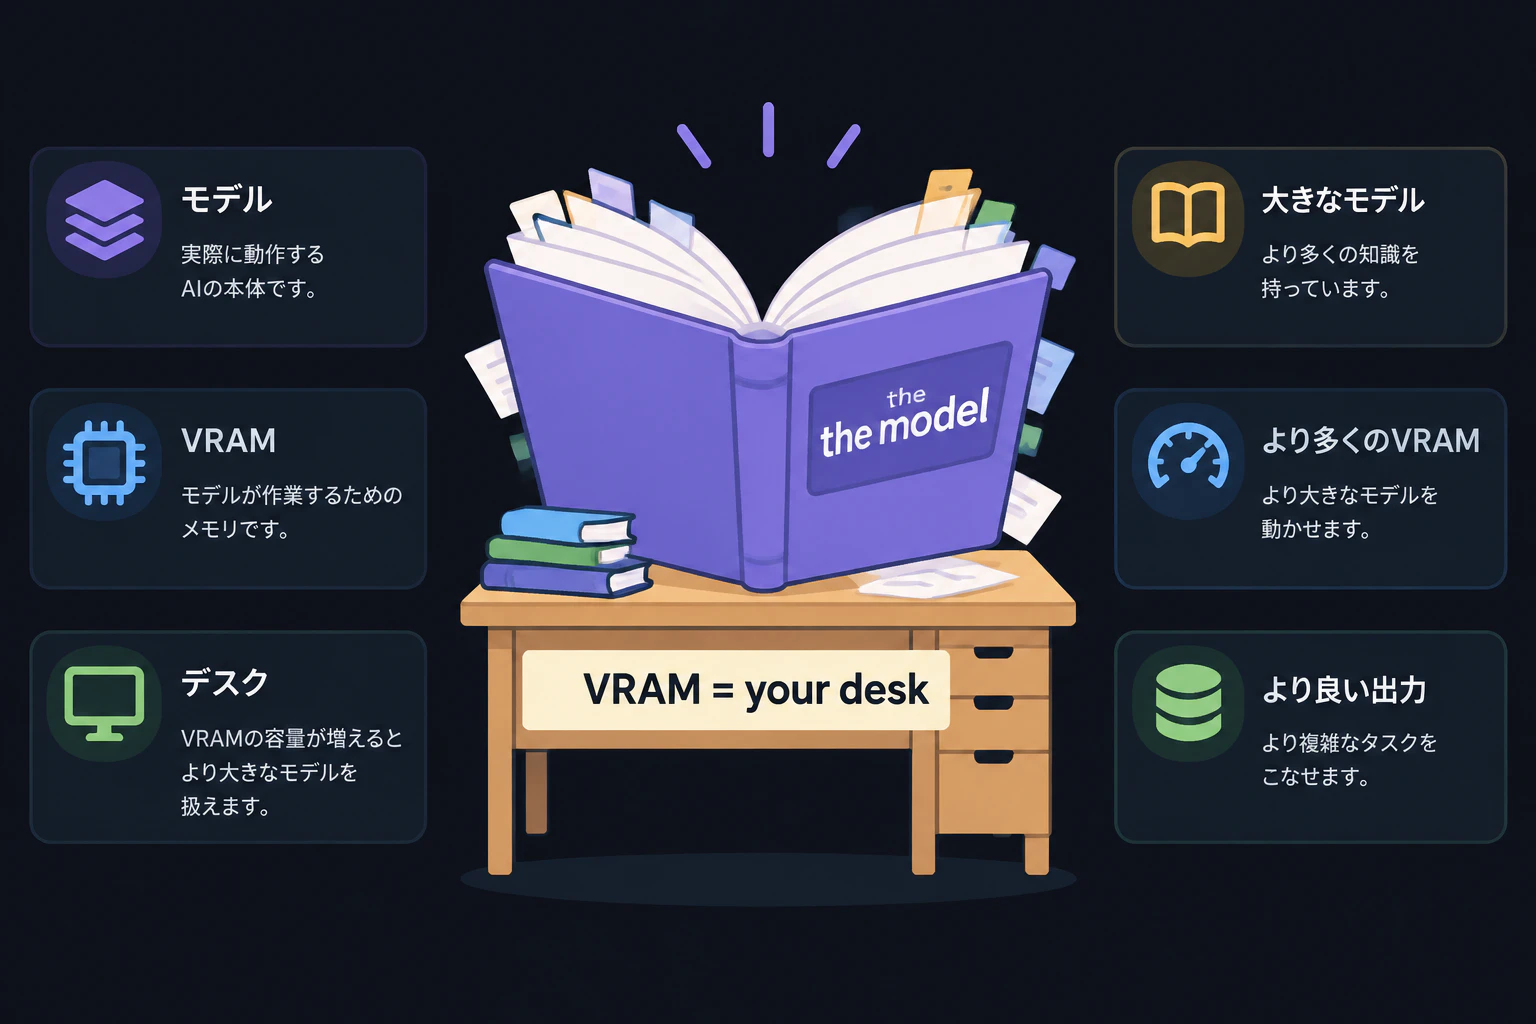
🦜 きなこ「グラボ専用の作業机だと思って。モデル全体をその机に広げられないと、そもそも動かせないの」
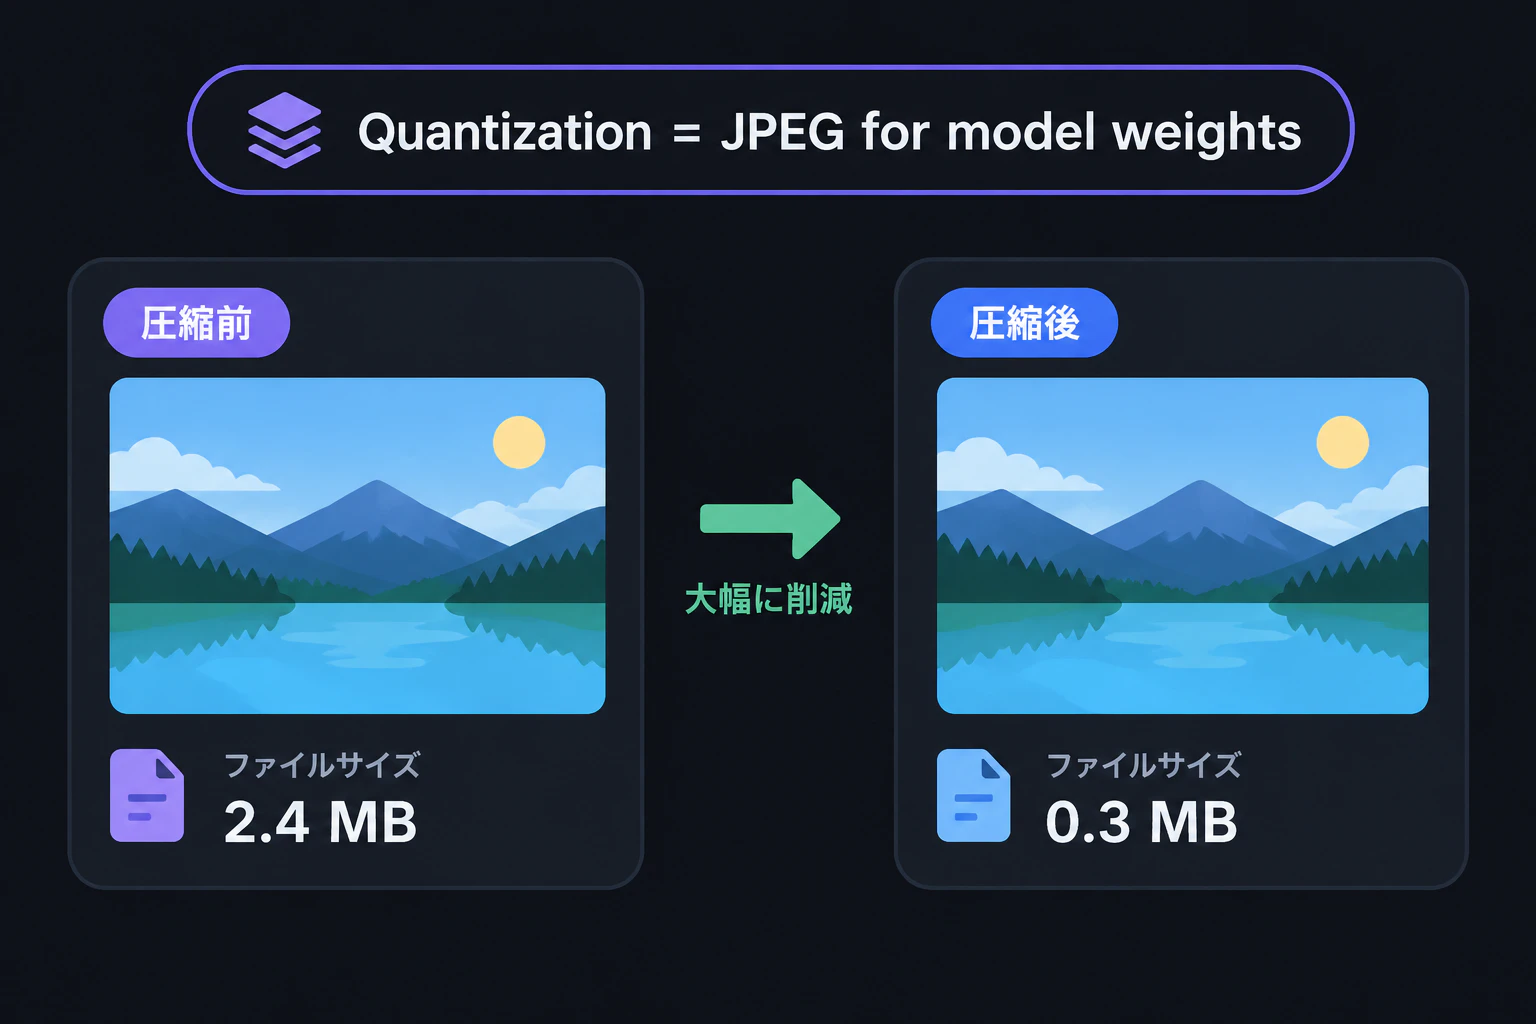
🦜 きなこ「でも今のモデルは机に乗りきらないの。そこで使うのが量子化。写真をジェイペグで軽くするみたいに、数字を粗くする技なんだよ」
🐹 もっちー「えっ、ちょっと待って。数字を粗くするってことは、圧縮したらアホになるんちゃう? 頭悪なったら意味ないやん」
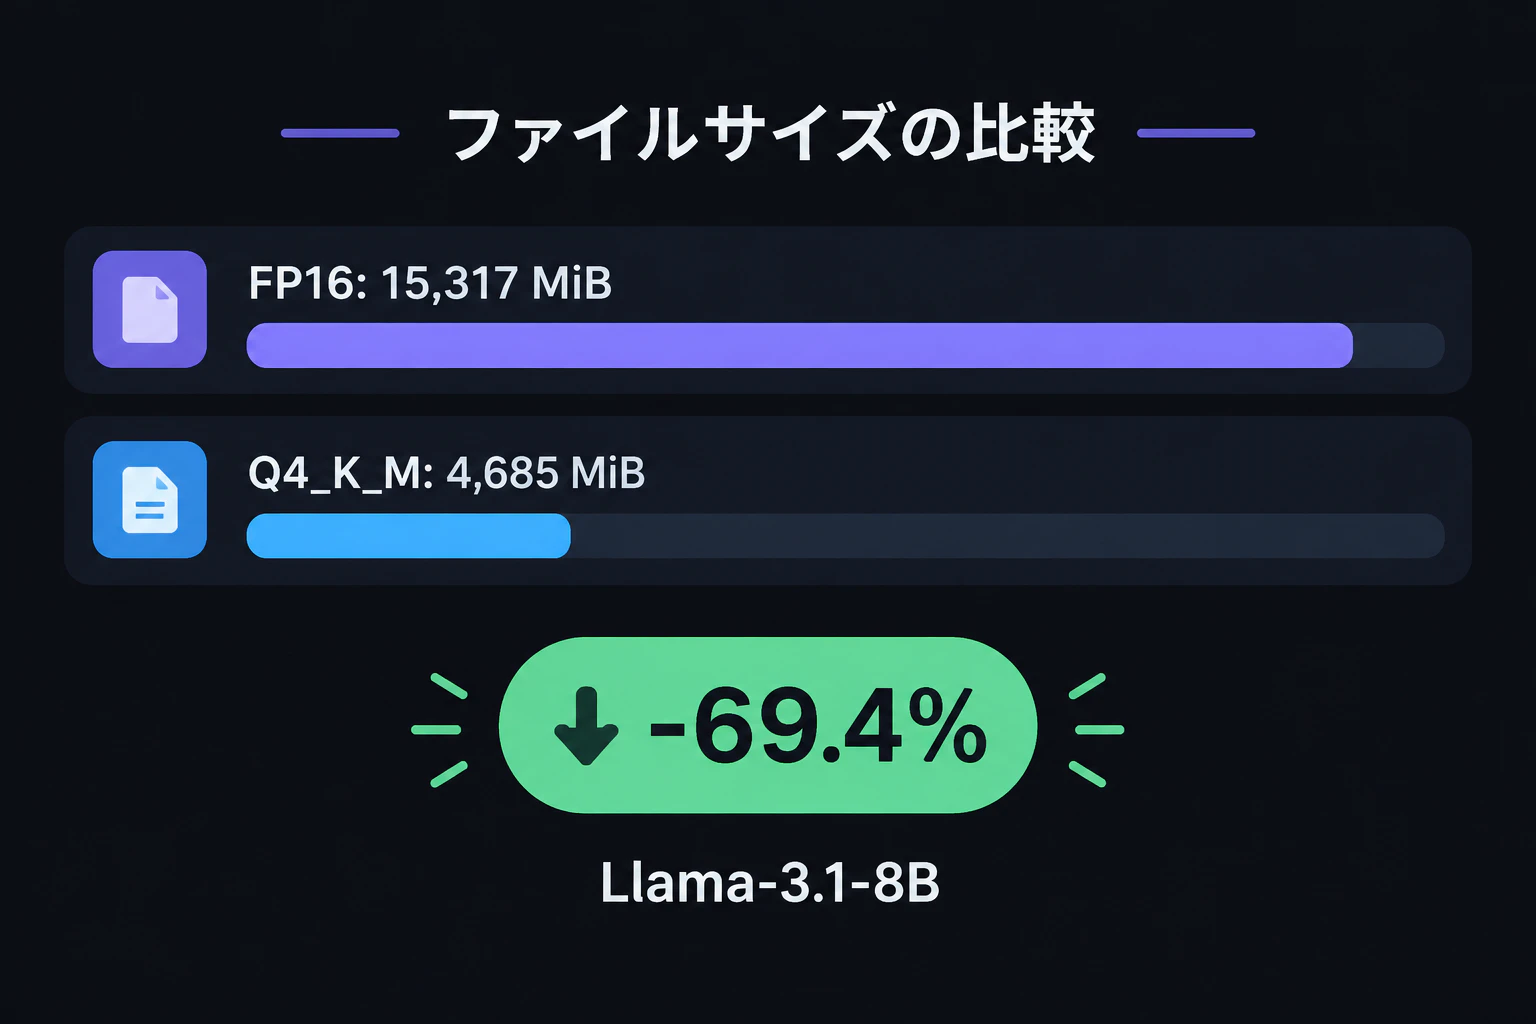
🦜 きなこ「そこが面白いの。Q4_K_Mっていう定番設定だと、モデルのファイルは約69.4%も小さくなるんだよ」
🐹 もっちー「7割減? 三分の一以下じゃん。そんだけ数字を削っといて、ほんとに頭のほうは無事なの?」
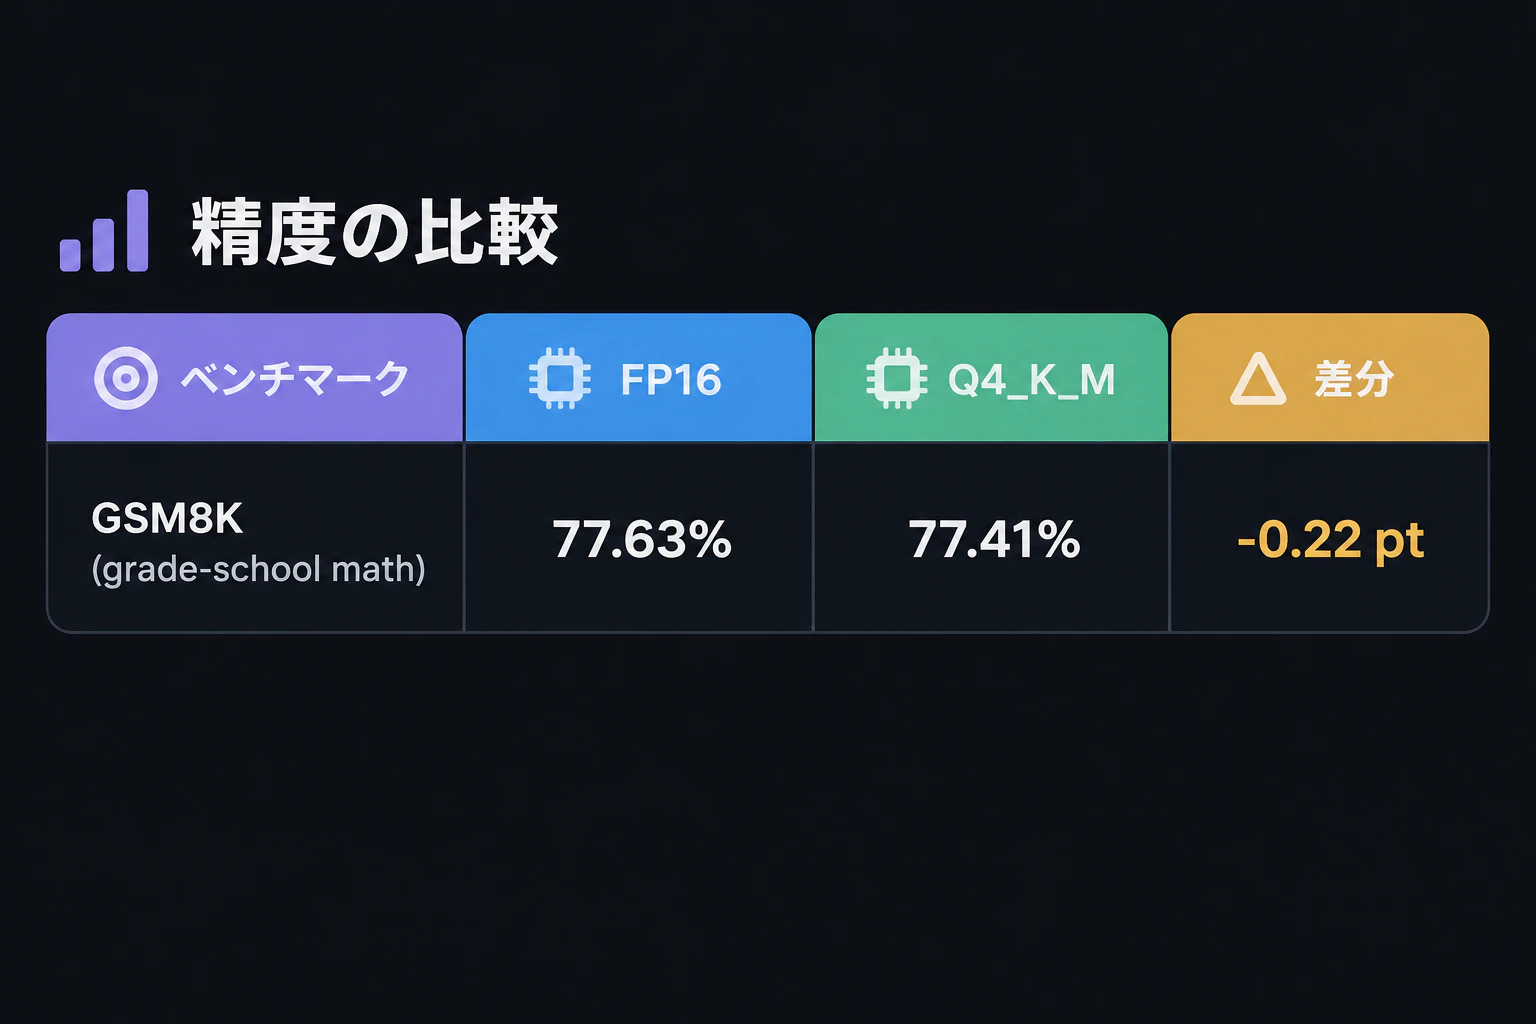
🦜 きなこ「小学生レベルの算数テストGSM8Kだと、圧縮前が77.63%で圧縮後が77.41%。差は0.22ポイントなの」
🐹 もっちー「0.2ポイント? ほぼ変わってへんやん! ジェイペグで縮めた写真、パッと見分からんのと一緒か」
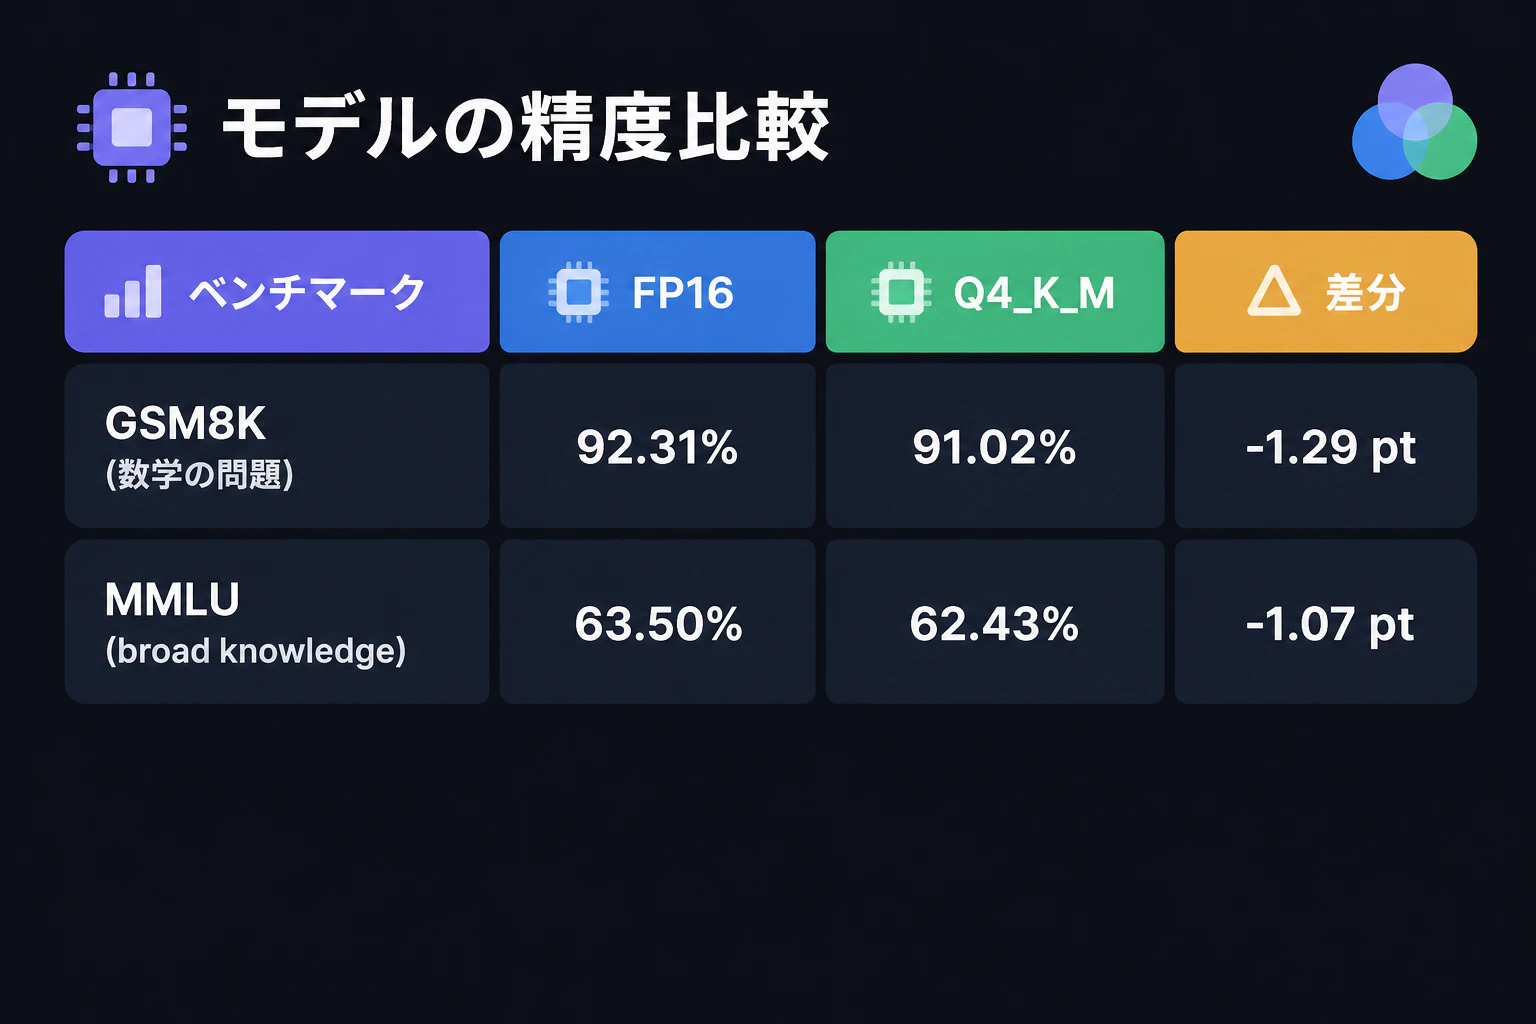
🦜 きなこ「そういうこと。幅広い知識を測るMMLUでも、63.50%が62.43%。1ポイントちょっとの差で収まってるの」

🦜 きなこ「ただし大事な留保があるの。今の数字はモデルの重み、つまり保存されたファイル本体の大きさの話なんだよ」
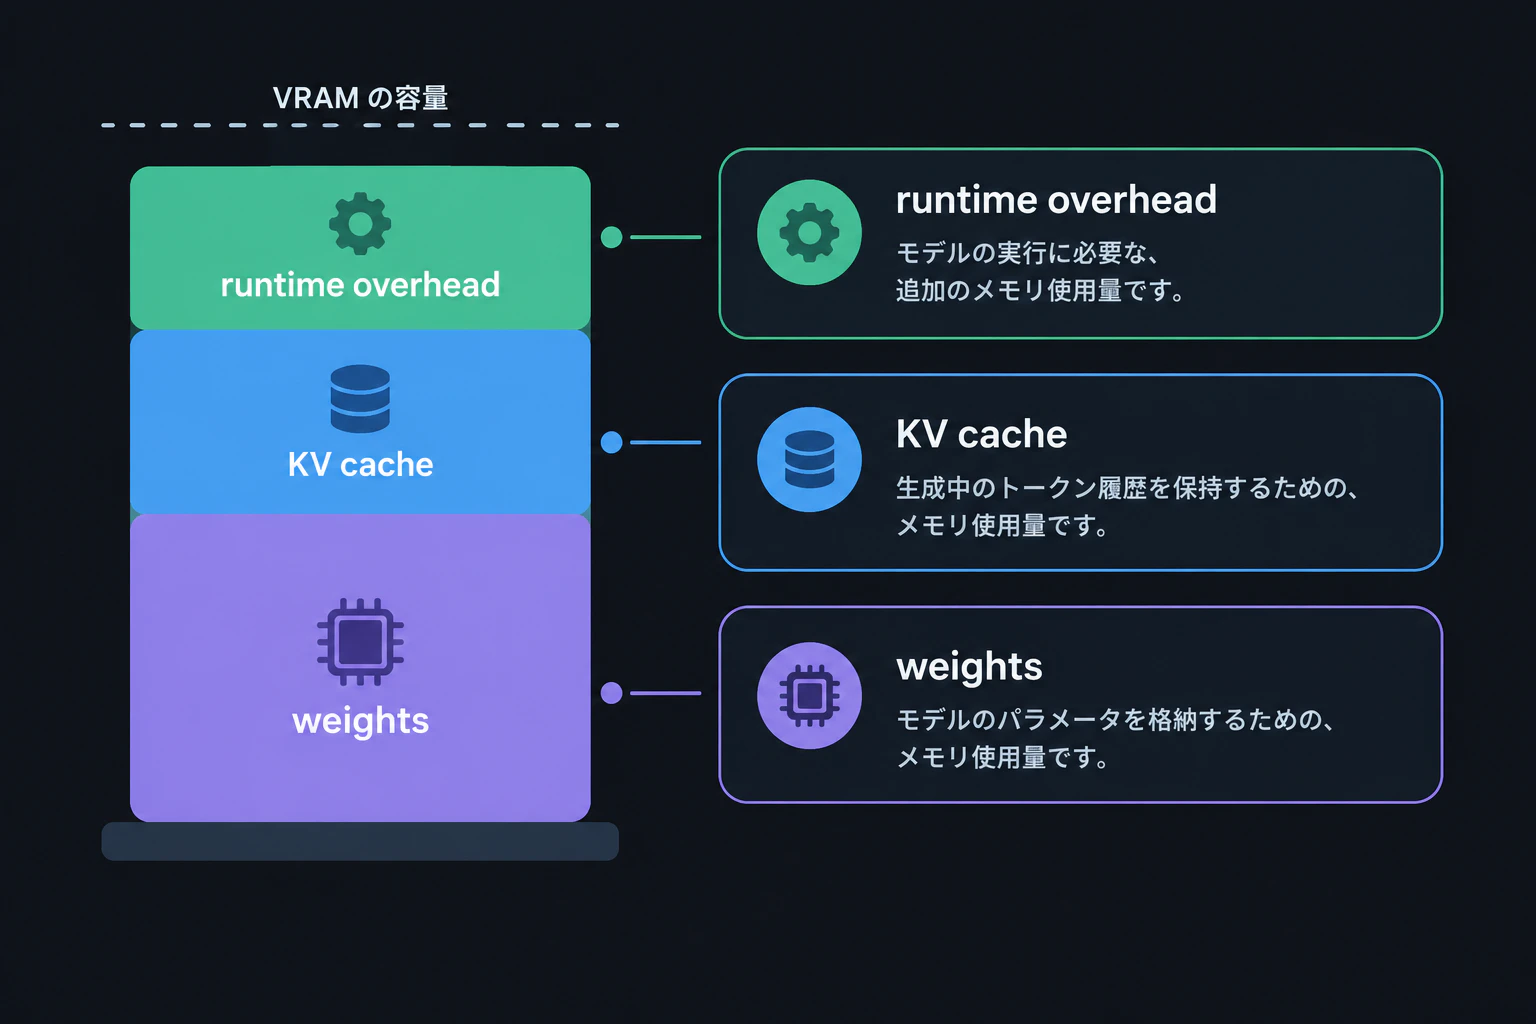
🦜 きなこ「実際に動かすと、会話の履歴を保つKVキャッシュの分が別に乗るの。だから数字ぴったりじゃなく、余裕を見ておくんだよ」
🐹 もっちー「なるほどね。で、いちばん知りたいのはそこなんだよ。結局ぼくのパソコンだと、何がどこまで動くの?」
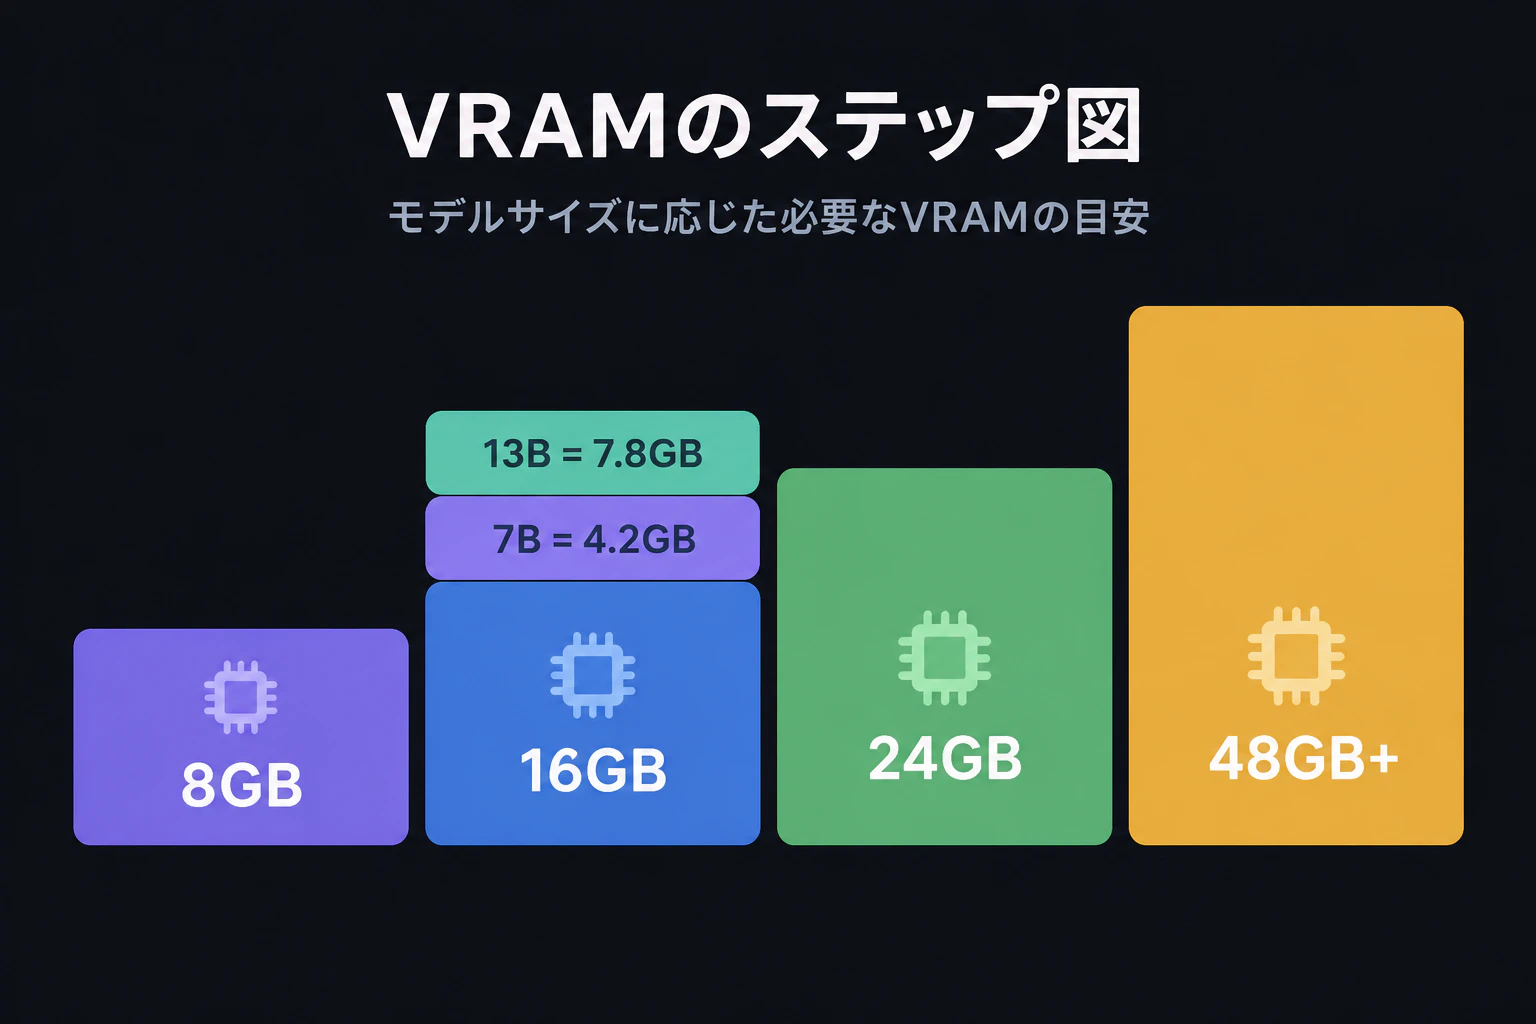
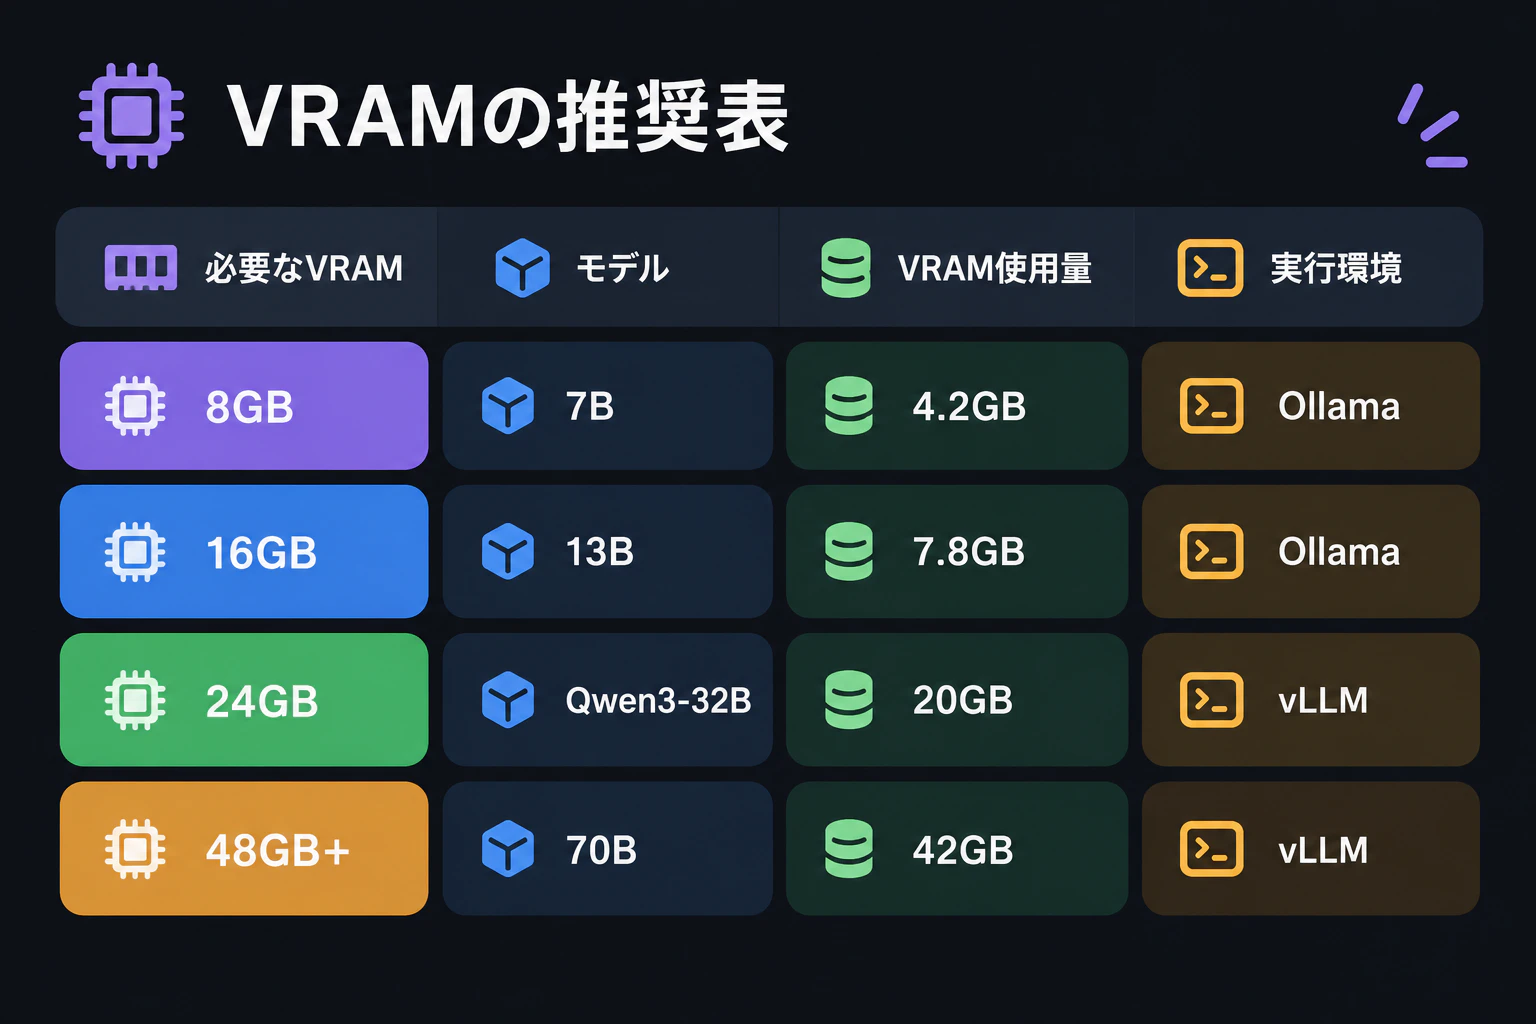
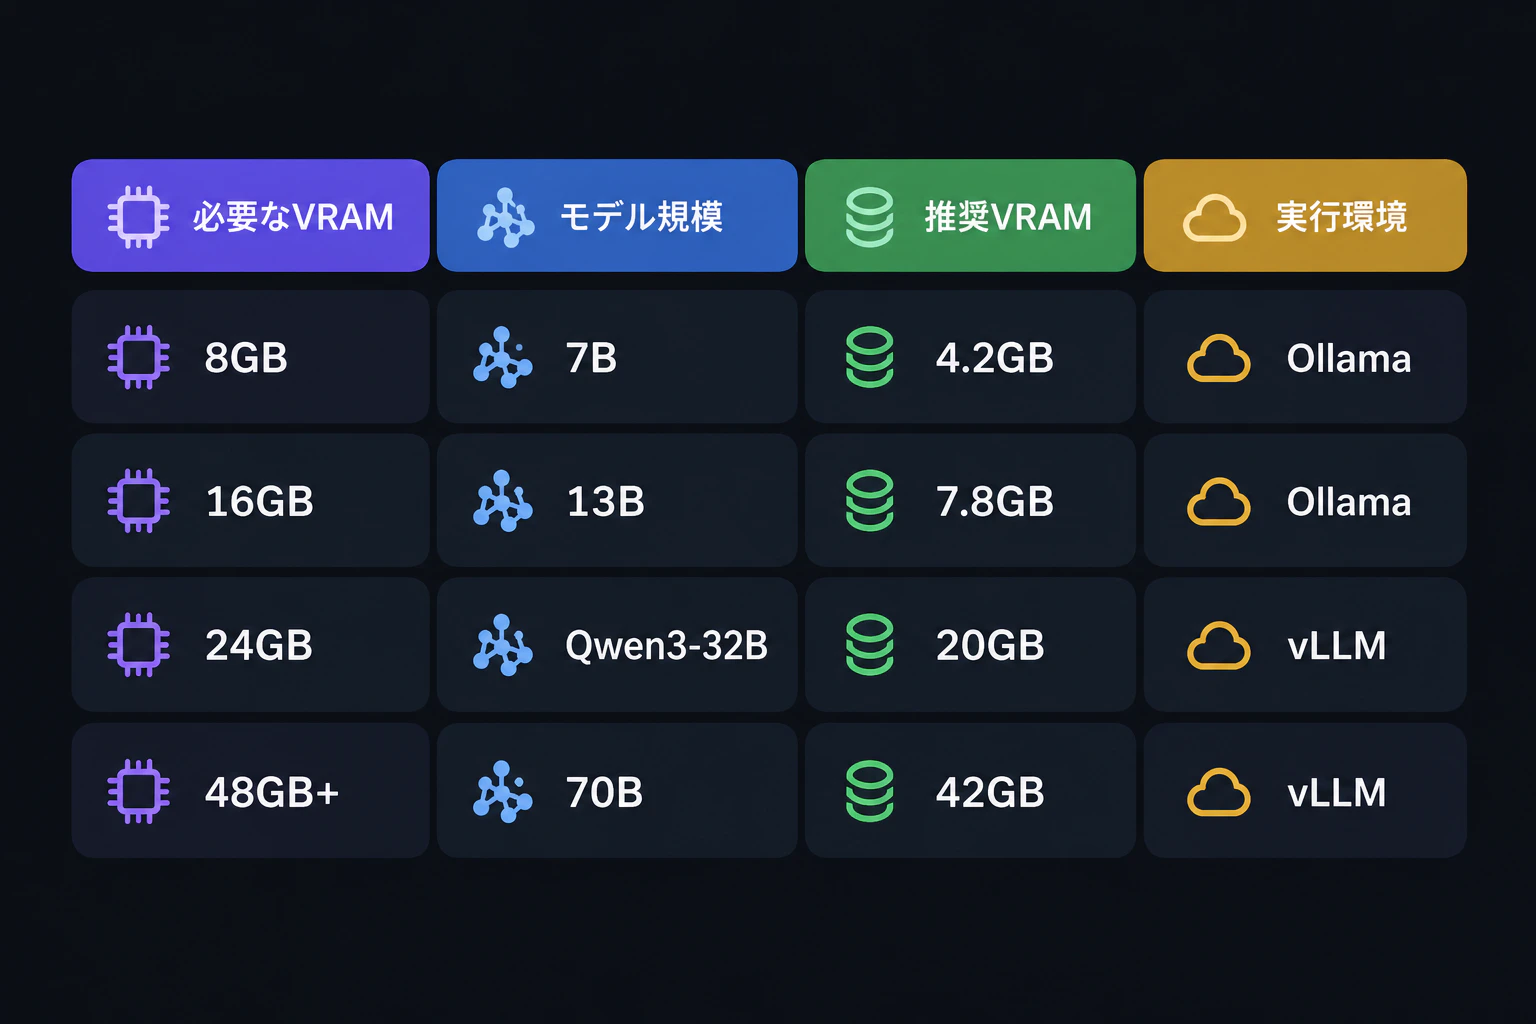
🦜 きなこ「VRAM8GBなら7Bクラスが約4.2GB、16GBなら13Bクラスが約7.8GB。ここまでは普通のゲーミングPCの範囲なの」
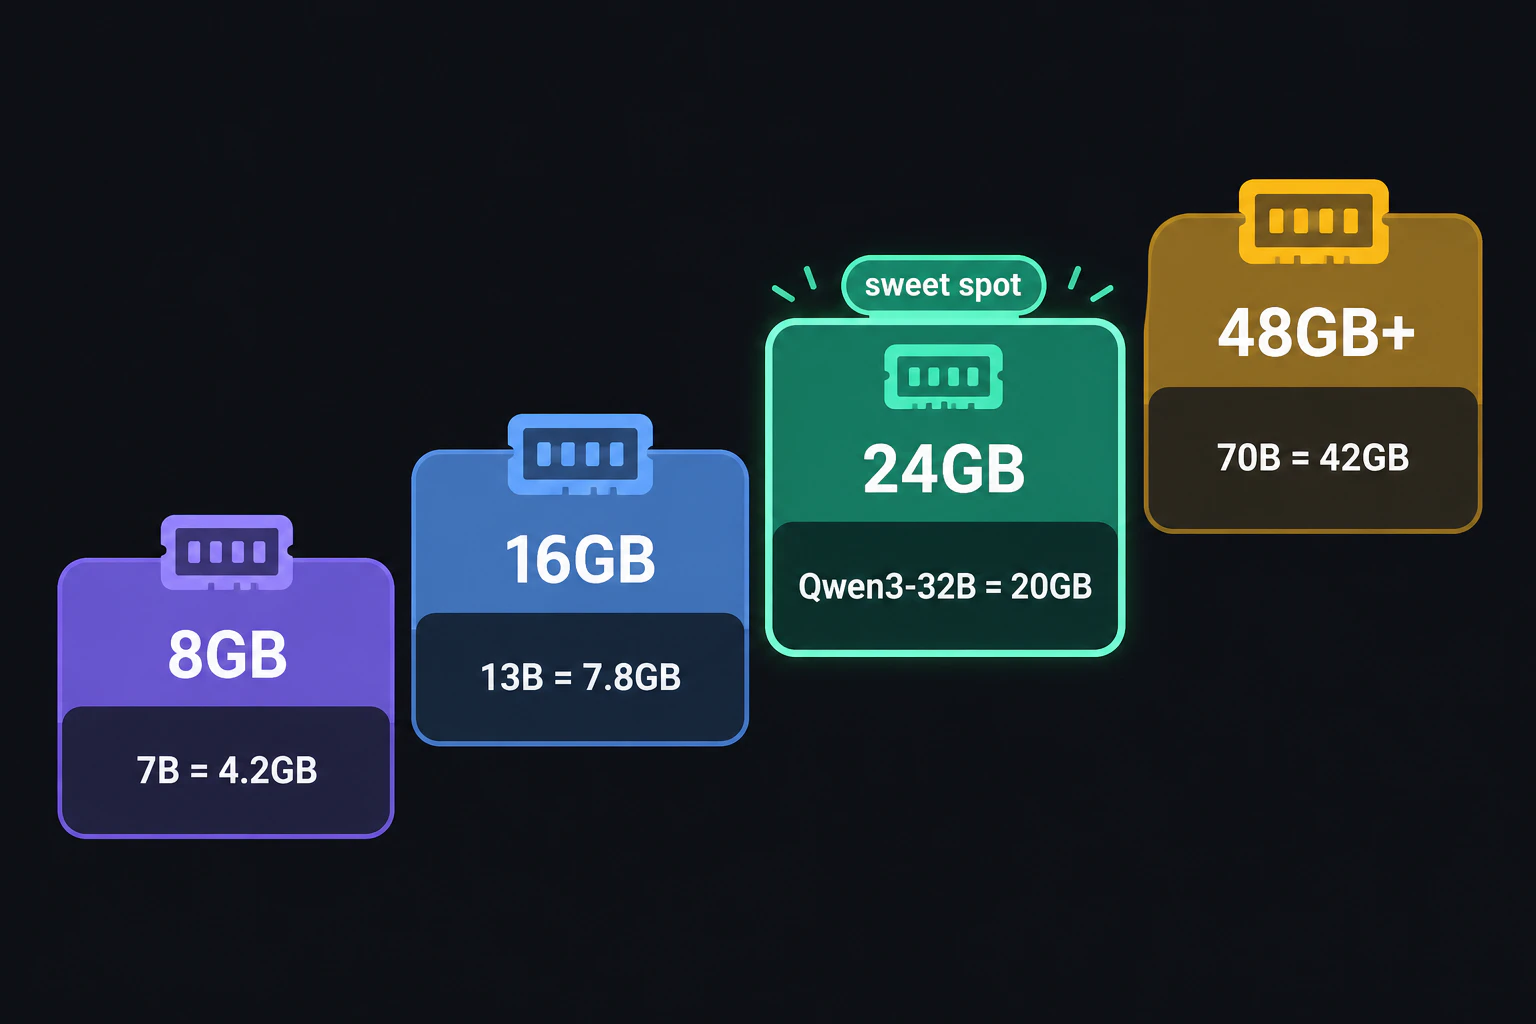
🦜 きなこ「24GBならQwen3-32Bが約20GBでちょうど収まるの。70Bクラスは約42GB、48GB以上ないと厳しいんだよ」
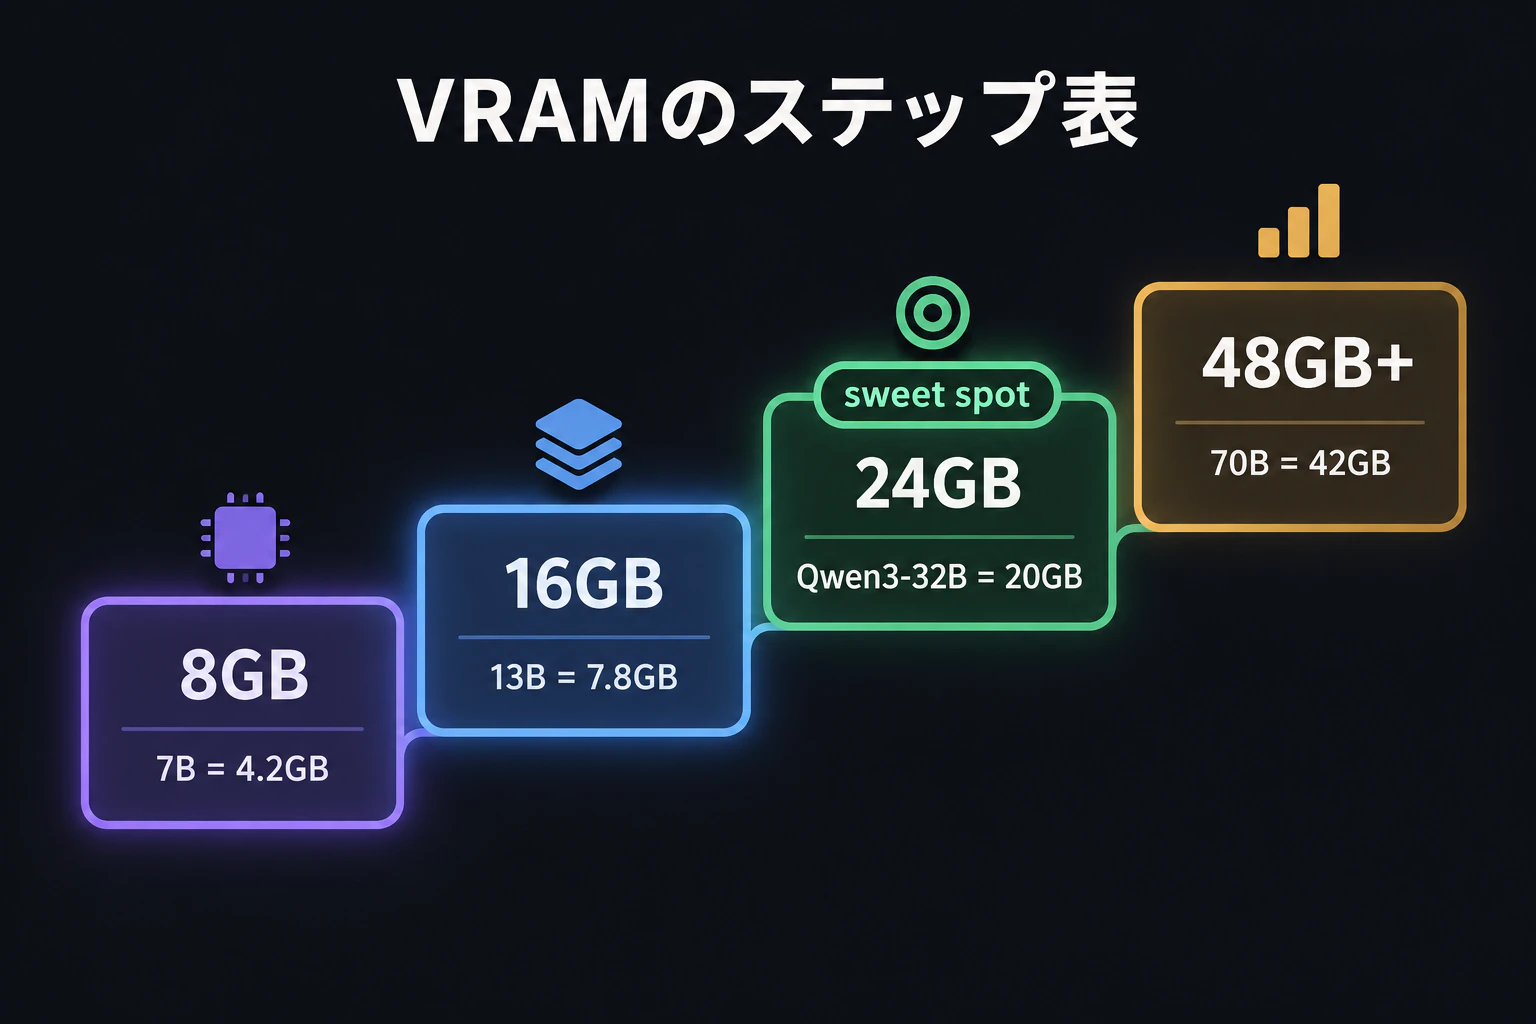
🐹 もっちー「つまりぼくの手元だと、8GBなら7B、16GBなら13B。数字で言えるようになったら、急に自分の話に聞こえてきた」
何を動かす?——Qwen3系とライセンスの落とし穴
🦜 きなこ「白状すると、私、最初はQwen3って名前が付いてるものを全部いっしょくたにして覚えてたんだよ」
🦜 きなこ「数字が違うだけでしょ、って雑にまとめて、あとでもっちーの前で思いっきり恥をかいたことがあるの」
🐹 もっちー「きなこでも間違えるんだ。ちょっと安心したかも。で、いっしょくたにすると何がまずいの?」
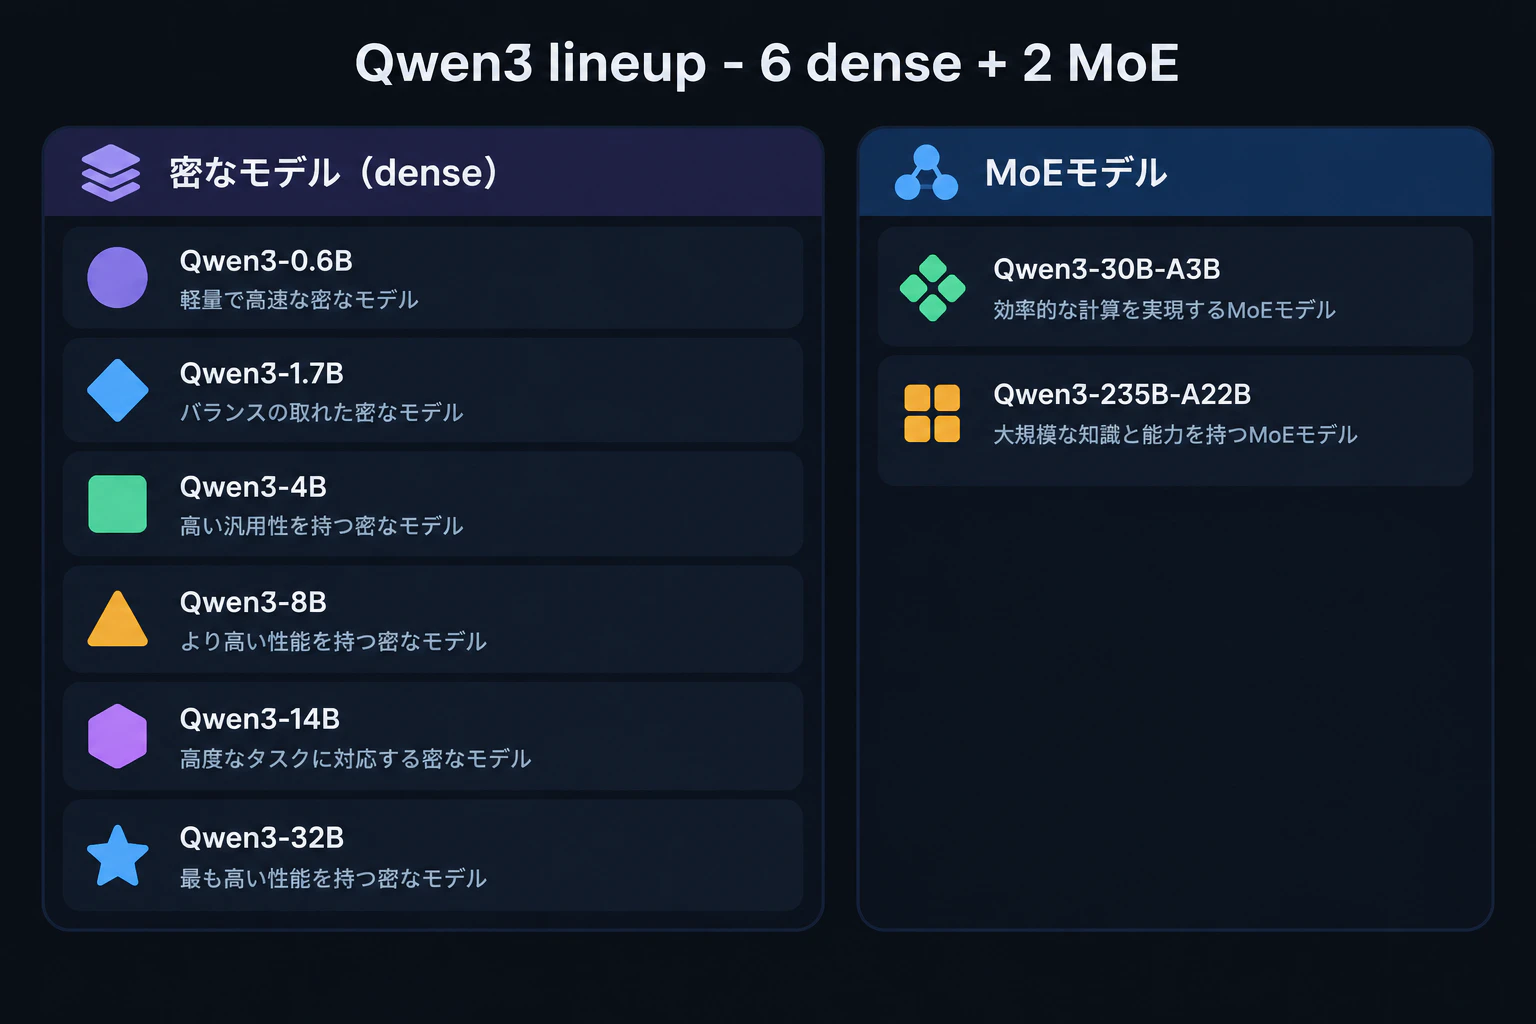
🦜 きなこ「まず数から整理するね。Qwen3の密なモデルは0.6B・1.7B・4B・8B・14B・32Bの6種類なんだよ」
🦜 きなこ「そこにMoEっていう別型が2種類。30B-A3Bと、2025年4月29日公開の旗艦235B-A22Bだよ」
🐹 もっちー「合わせて8種類もあるんだ…ぼく、名前と数字が多すぎて、もう頭がぐるぐるしてきたんだけど」
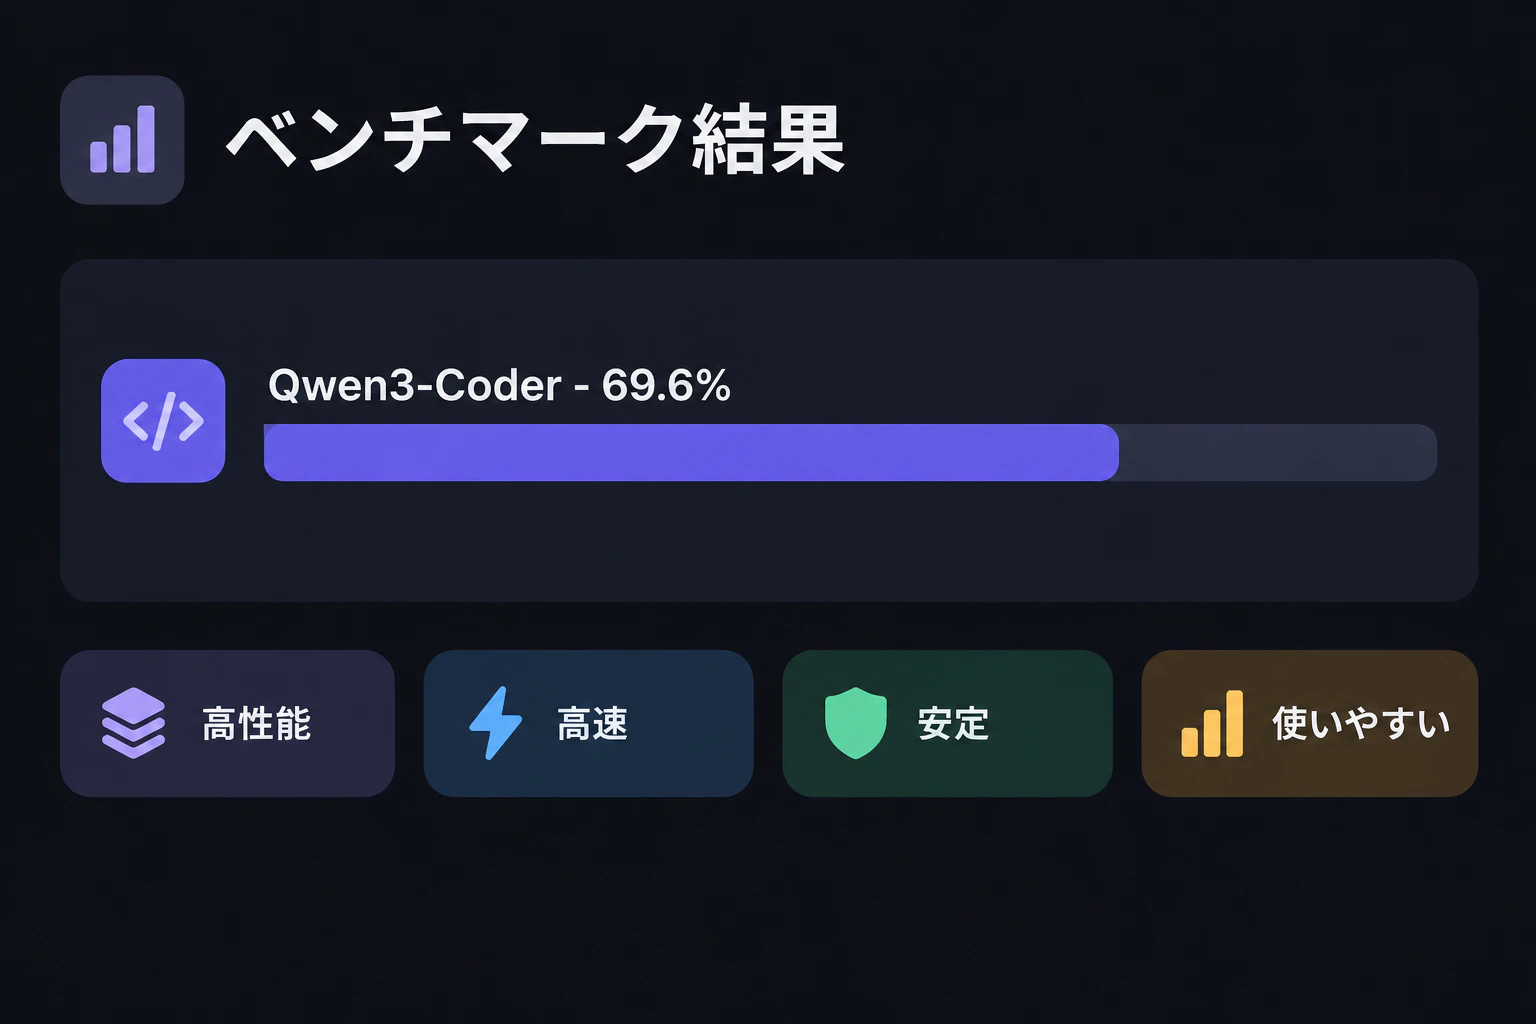
🦜 きなこ「覚えなくて大丈夫。大事なのは性能のほう。Qwen3-CoderはSWE-Bench Verifiedで69.6%なの」
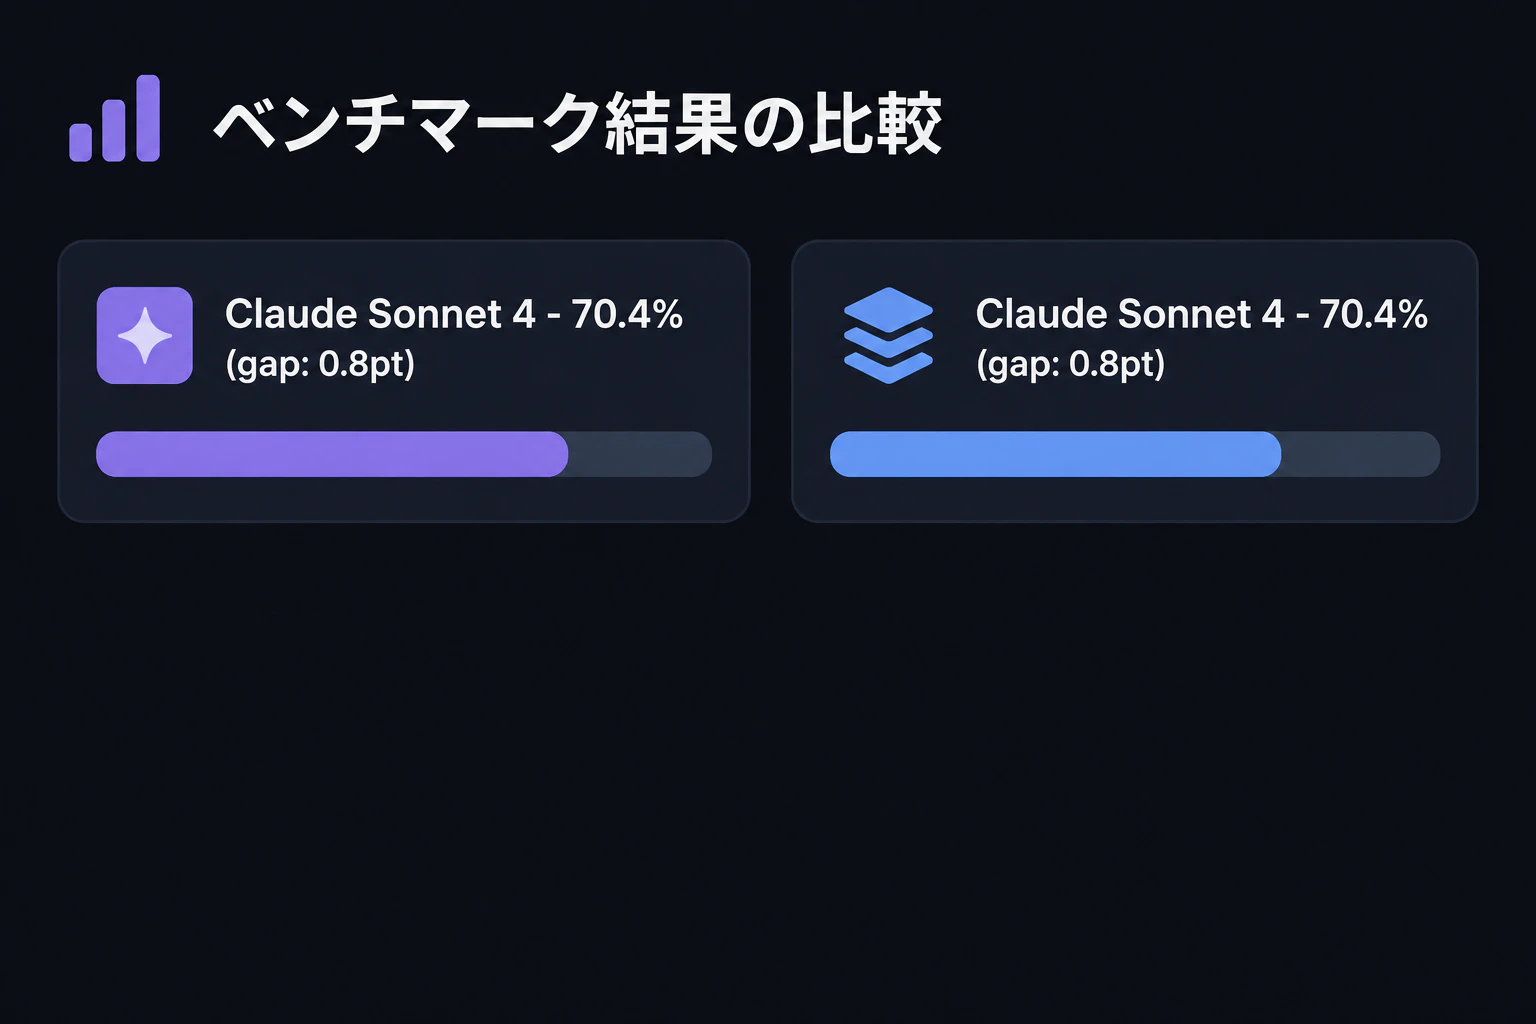
🦜 きなこ「比較対象のClaude Sonnet 4が70.4%だから、差は0.8ポイント。オープンモデルでは首位なんだよ」
🐹 もっちー「69.6ってなんの点数なの? よく分からないけど、タダのやつが有料のやつに肉薄してるってこと?」
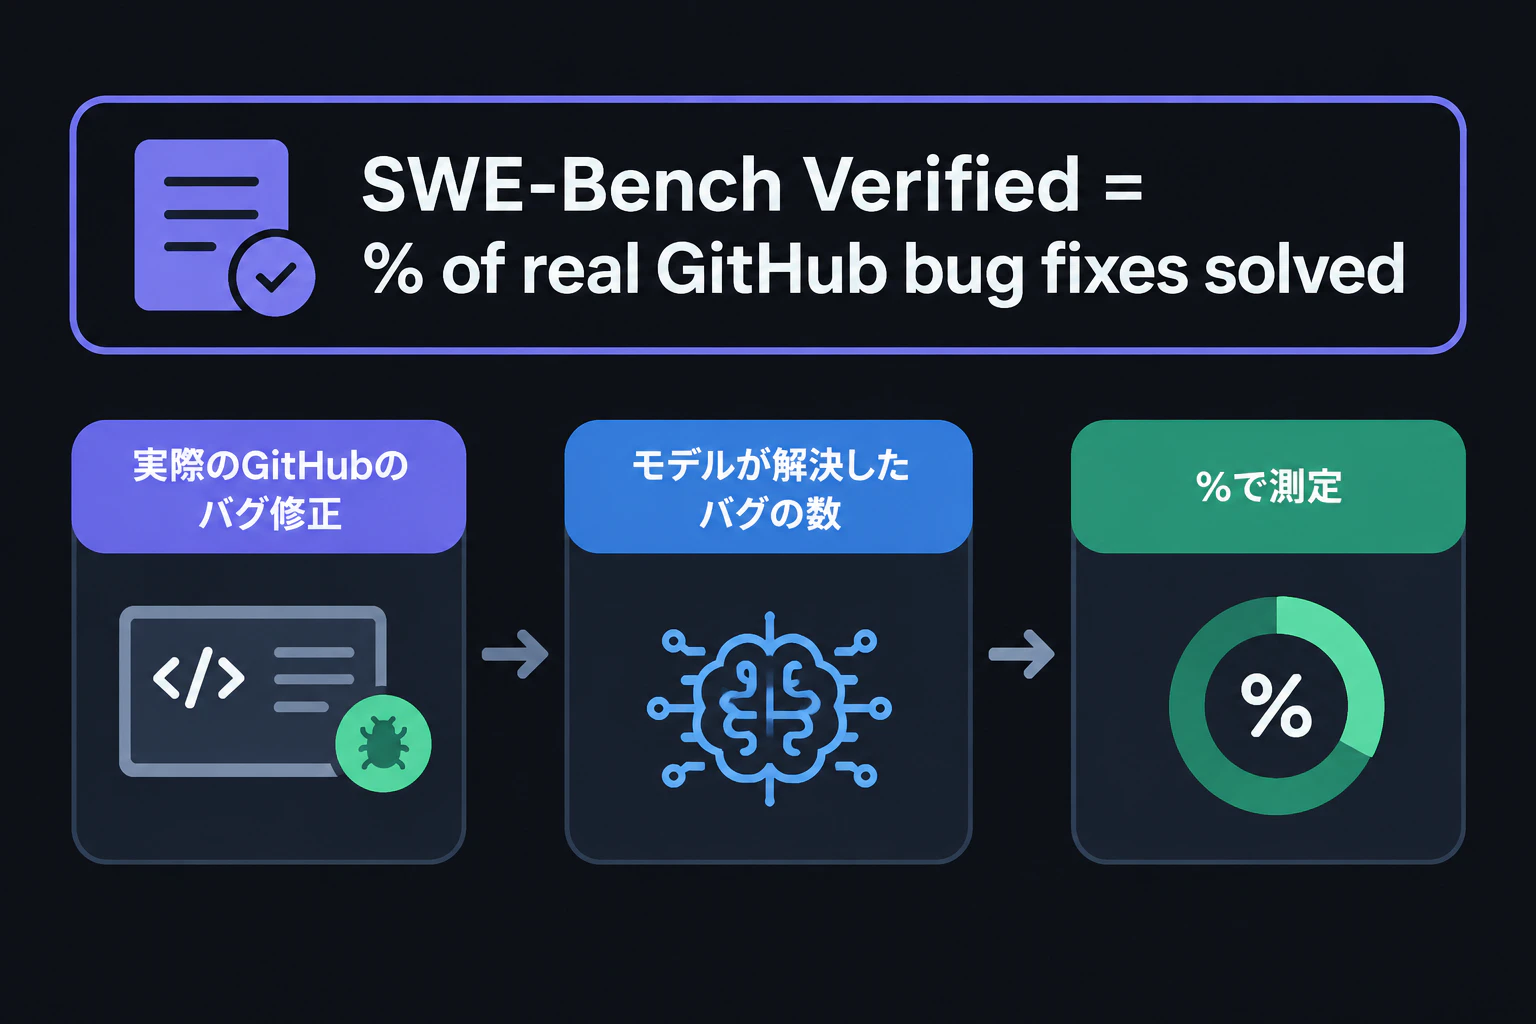
🦜 きなこ「SWE-Benchは実際に報告されたバグ修正課題を何割直せたかを測るテスト。実務の力にかなり近いんだよ」
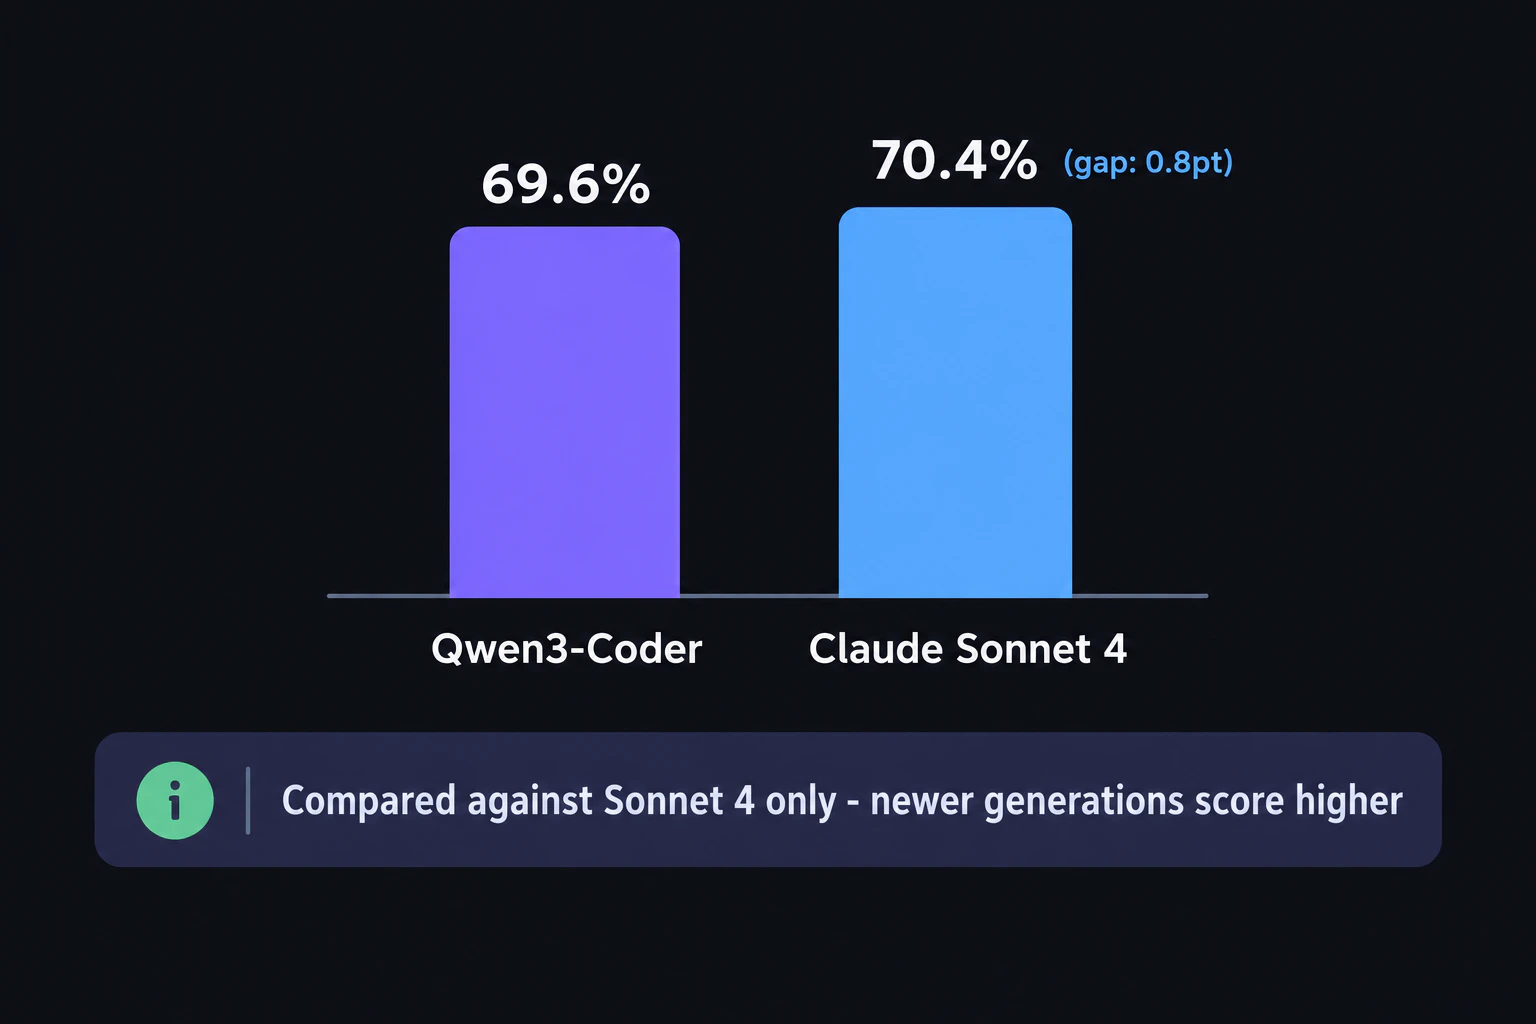
🦜 きなこ「ただし比べた相手は旧Sonnet 4限定ね。もっと新しい世代とはまだはっきり差があるの」
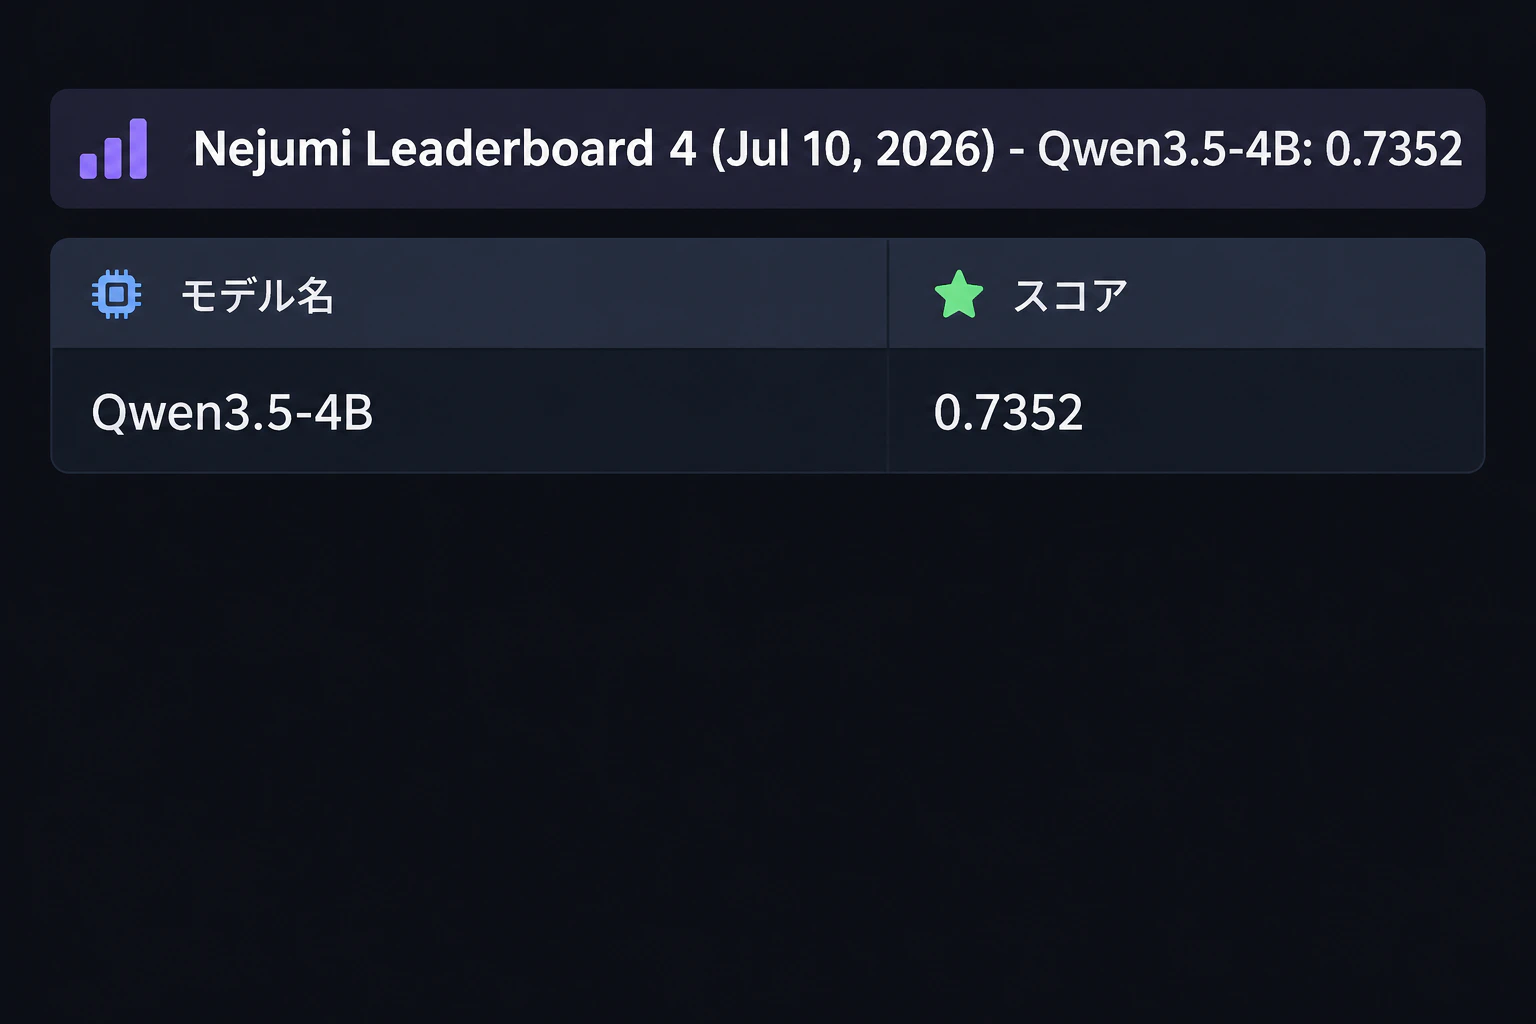
🦜 きなこ「日本語のほうはNejumi Leaderboard 4の2026年7月10日版で、Qwen3.5-4Bが0.7352」
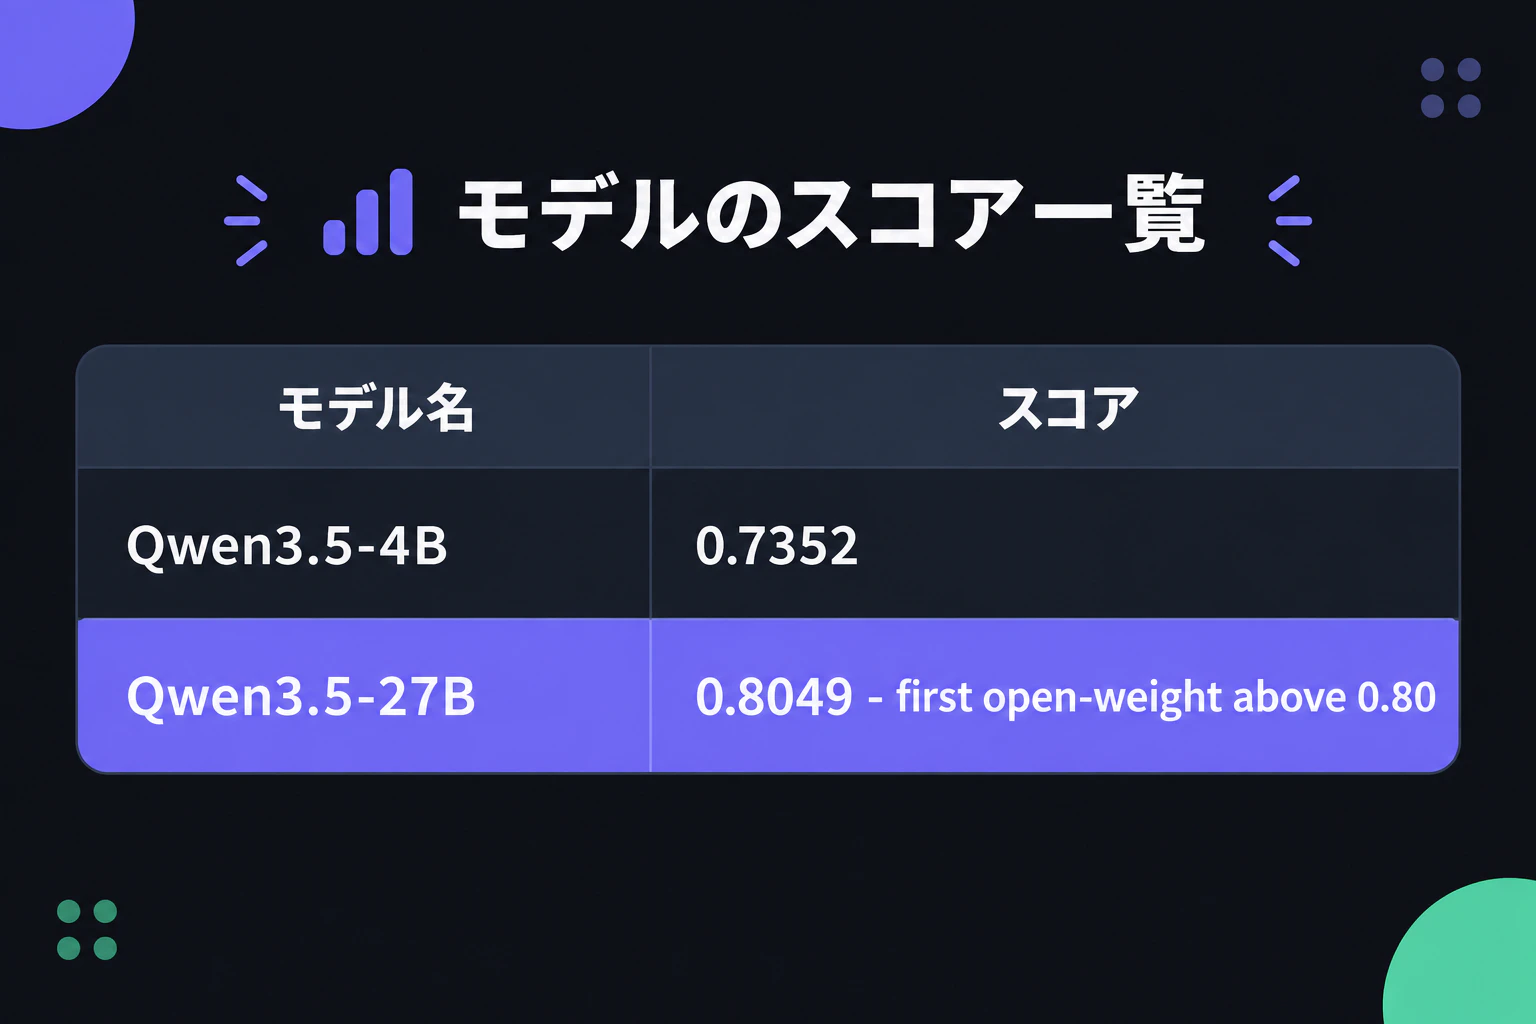
🦜 きなこ「スコアは高いほど良い指標なの。Qwen3.5-27Bは0.8049で、オープンウェイト初の0.80超えだよ」
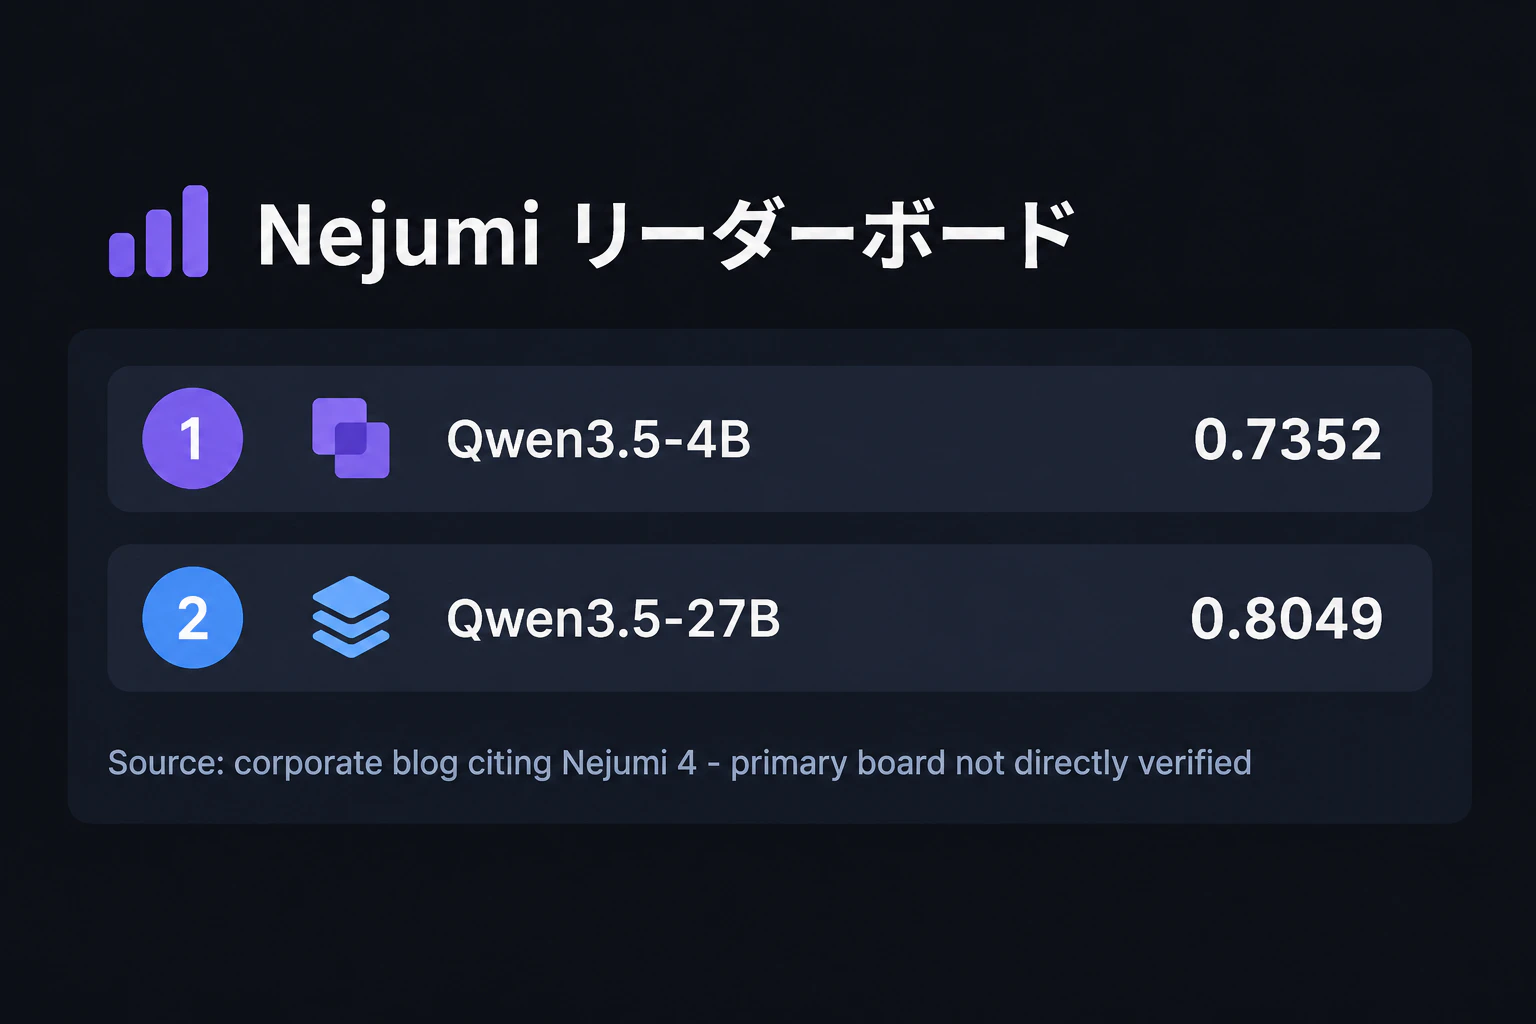
🦜 きなこ「ただね、私も一次のリーダーボード本体は直接見られてなくて、企業ブログ経由で拾った数字なの」
🐹 もっちー「なあきなこ、Qwenって全部Apache 2.0でタダなんやろ?商売にどう使っても文句言われへんやん!」

🦜 きなこ「惜しい、半分正解。中身のデータが配られてるオープンウェイトの8Bや32Bなら、確かにApache 2.0だよ」
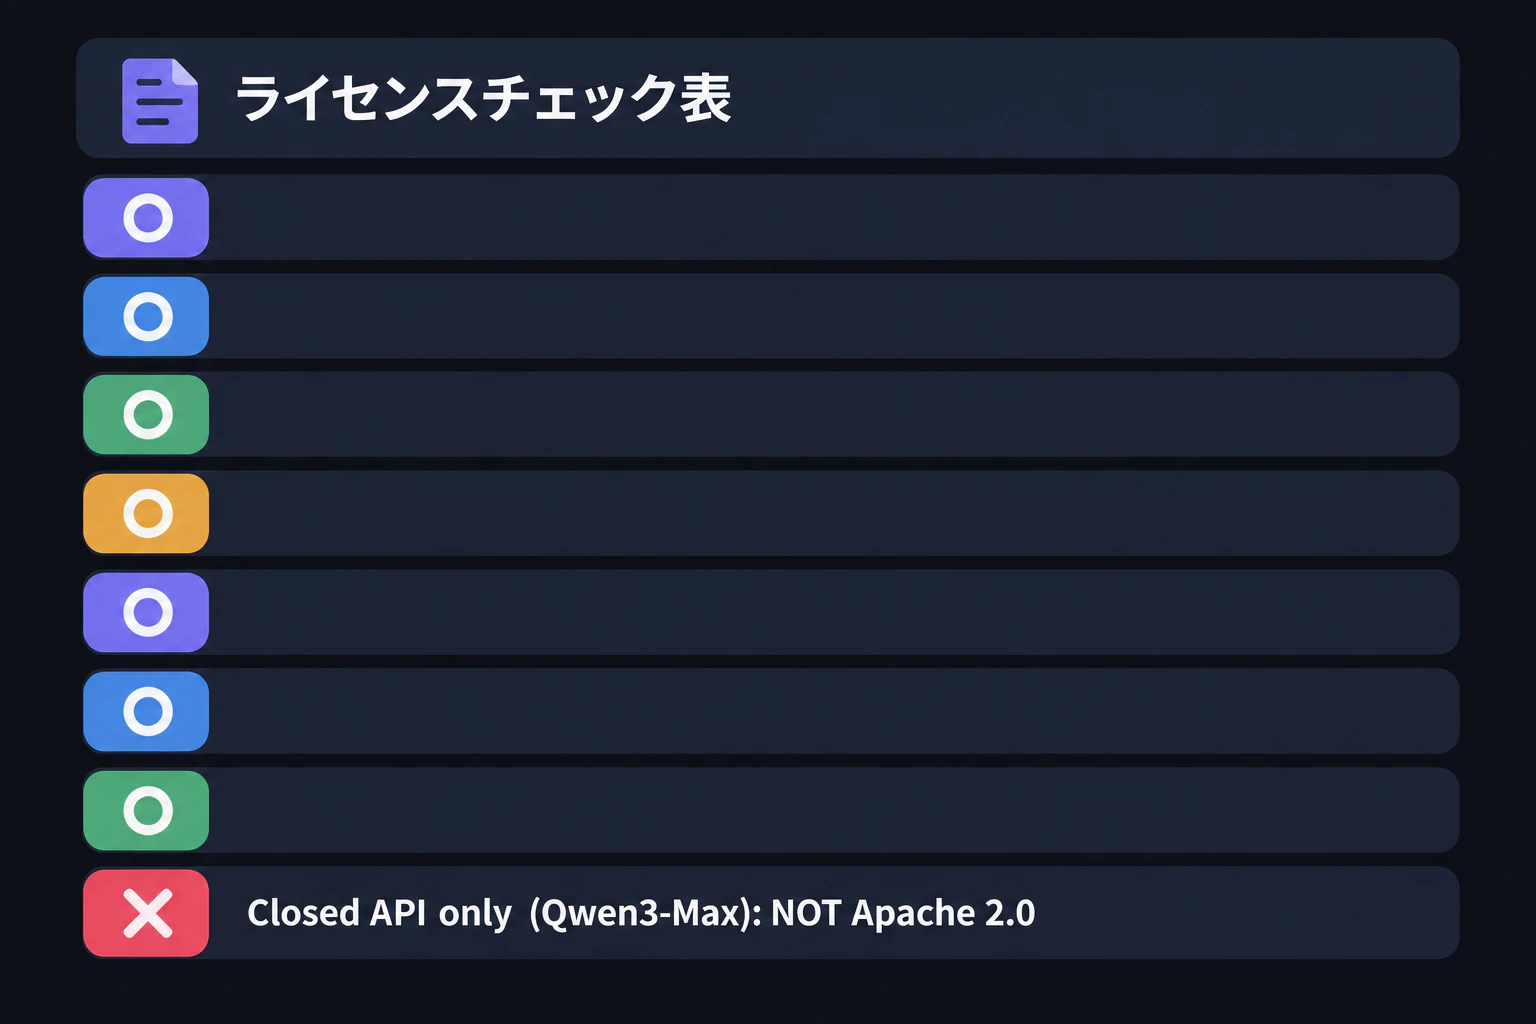
🦜 きなこ「Apache 2.0は商用も改造もどうぞっていう許可証。でもクローズドAPI専用のQwen3-Maxは、そもそも対象外なの」
🐹 もっちー「うわあ、ぼく完全に「Qwenは全部タダ」で覚えてた。名前が同じでも、札がもらえる子とそうじゃない子がいるんだ」
無料の代償——コンシューマーGPUは半年から1年遅れる
🐹 もっちー「ここまで聞いてきてさ、ぼく一個ずっと引っかかってることがあるんだよね。言ってもいい?」
🐹 もっちー「タダで賢いのが自分のPCで動くんやったら、毎月課金してる人って何にお金払ってるん?」
🦜 きなこ「いい引っかかり方だね。まさにそこなの。その答えが、ローカルLLMがこっそり払ってる代償なんだよ」
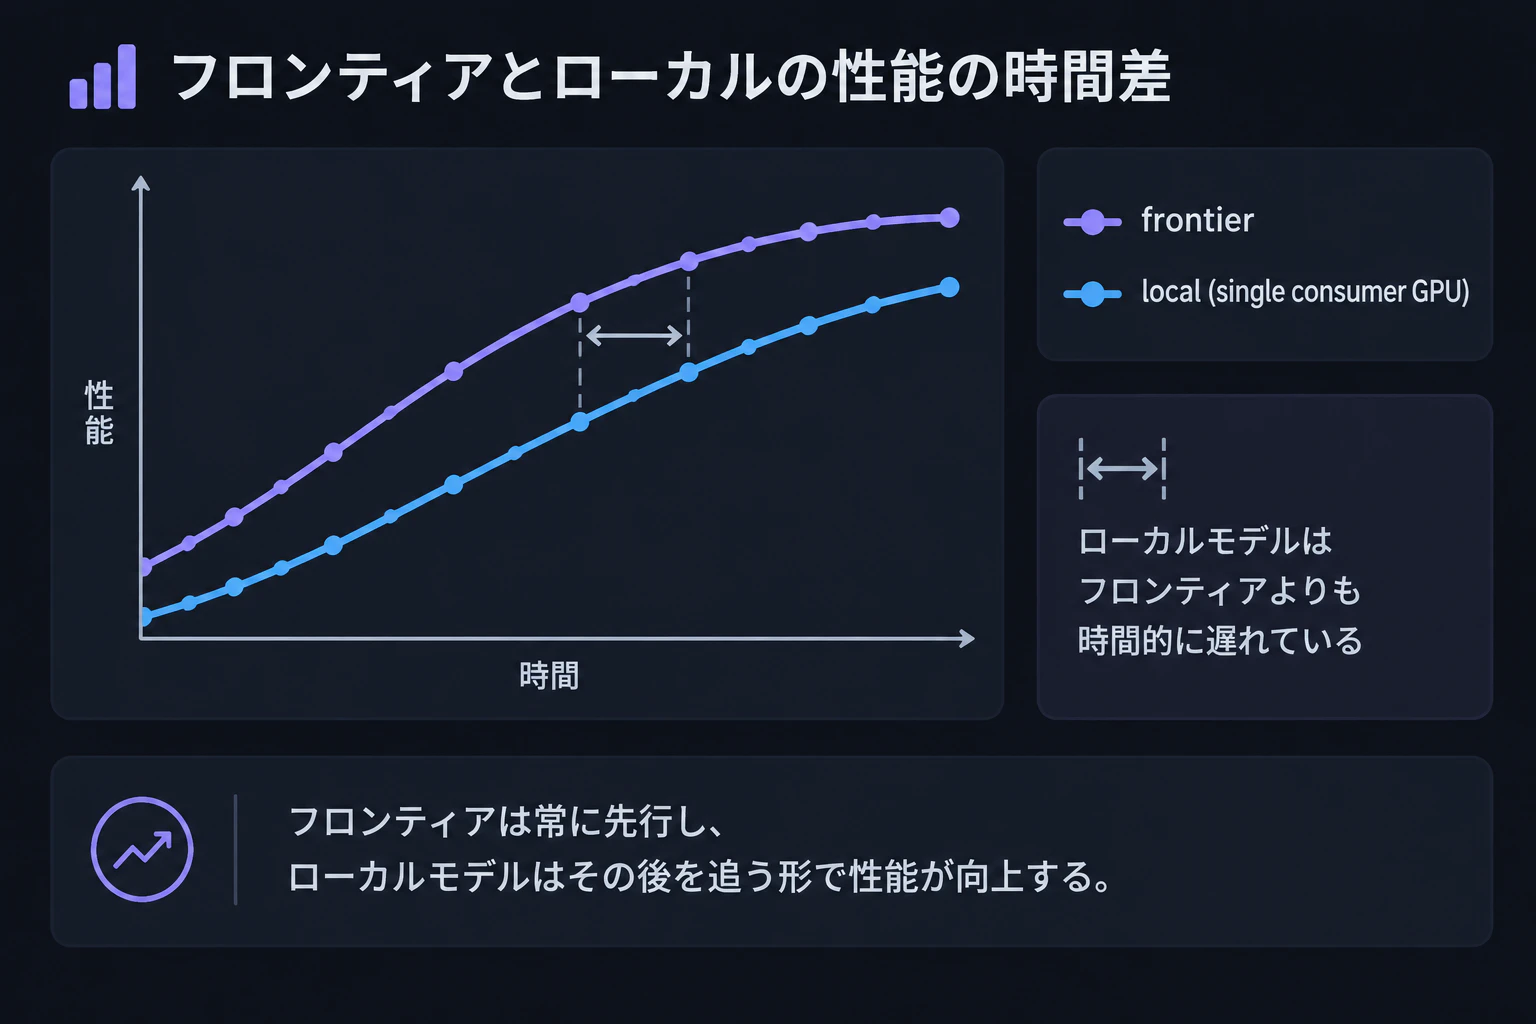
🦜 きなこ「単一のコンシューマーGPU一枚で動くオープンモデルはね、いちばん先を走ってるAIに、平均で6〜12か月遅れてるの」
🐹 もっちー「半年から1年遅れ…?え、ちょっと待って。それ、思ってたよりだいぶ開いてるんだね」
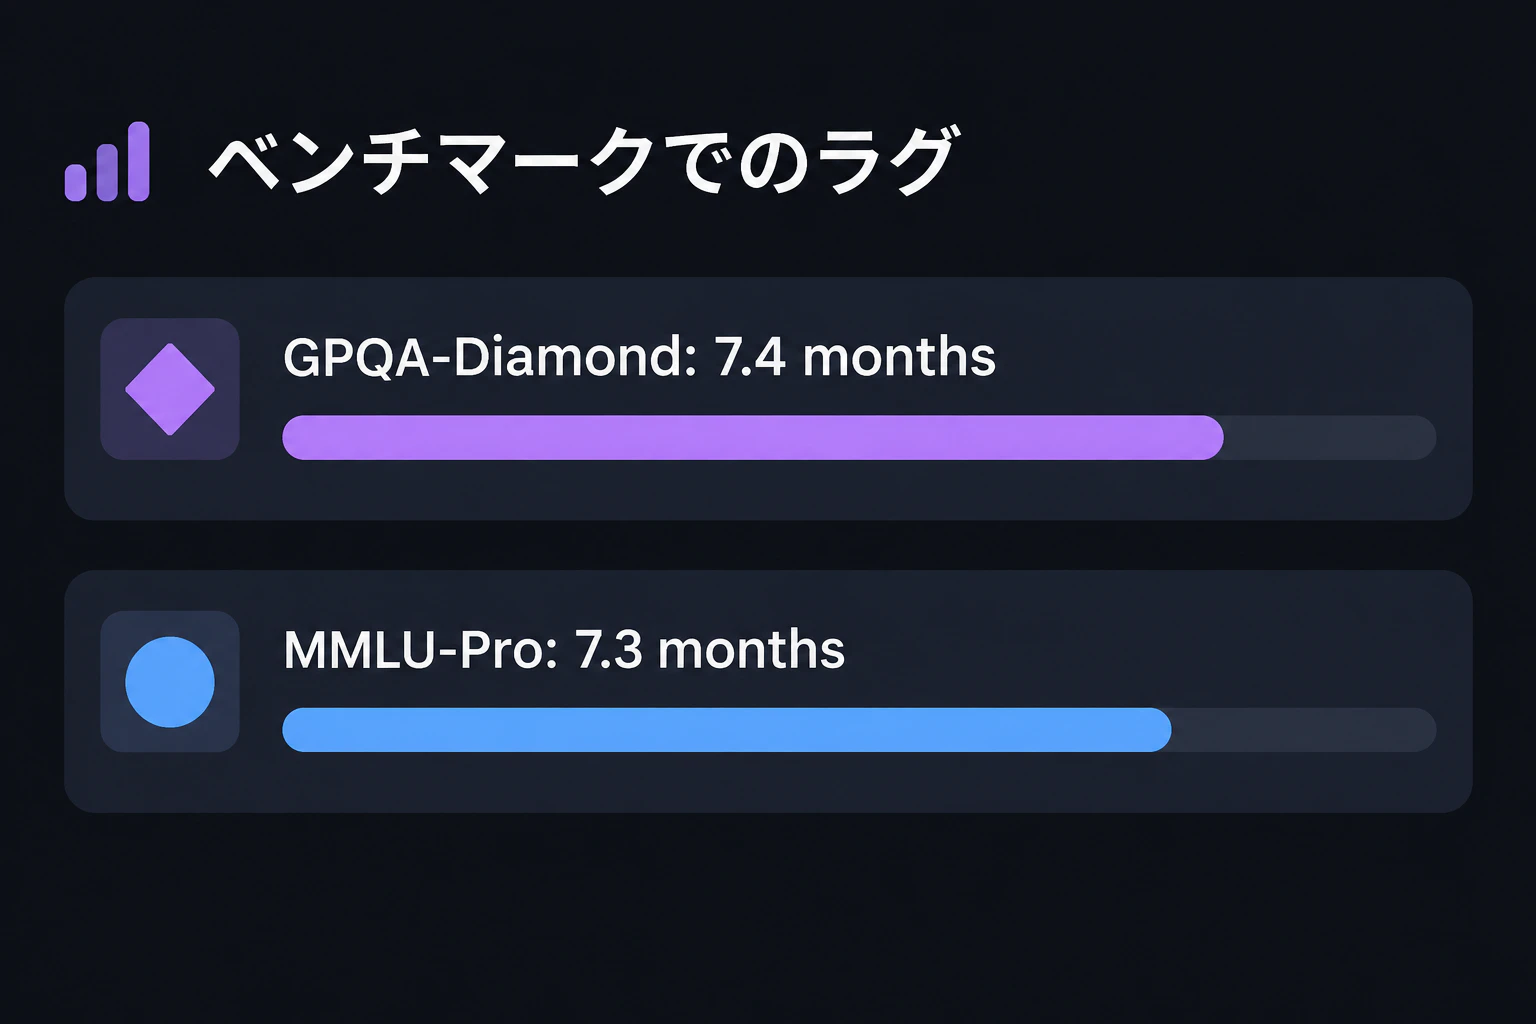
🦜 きなこ「測り方で幅が出てね。博士級の難問を解かせるGPQA-Diamondで7.4か月、大学レベルの総合学力テストMMLU-Proで7.3か月」
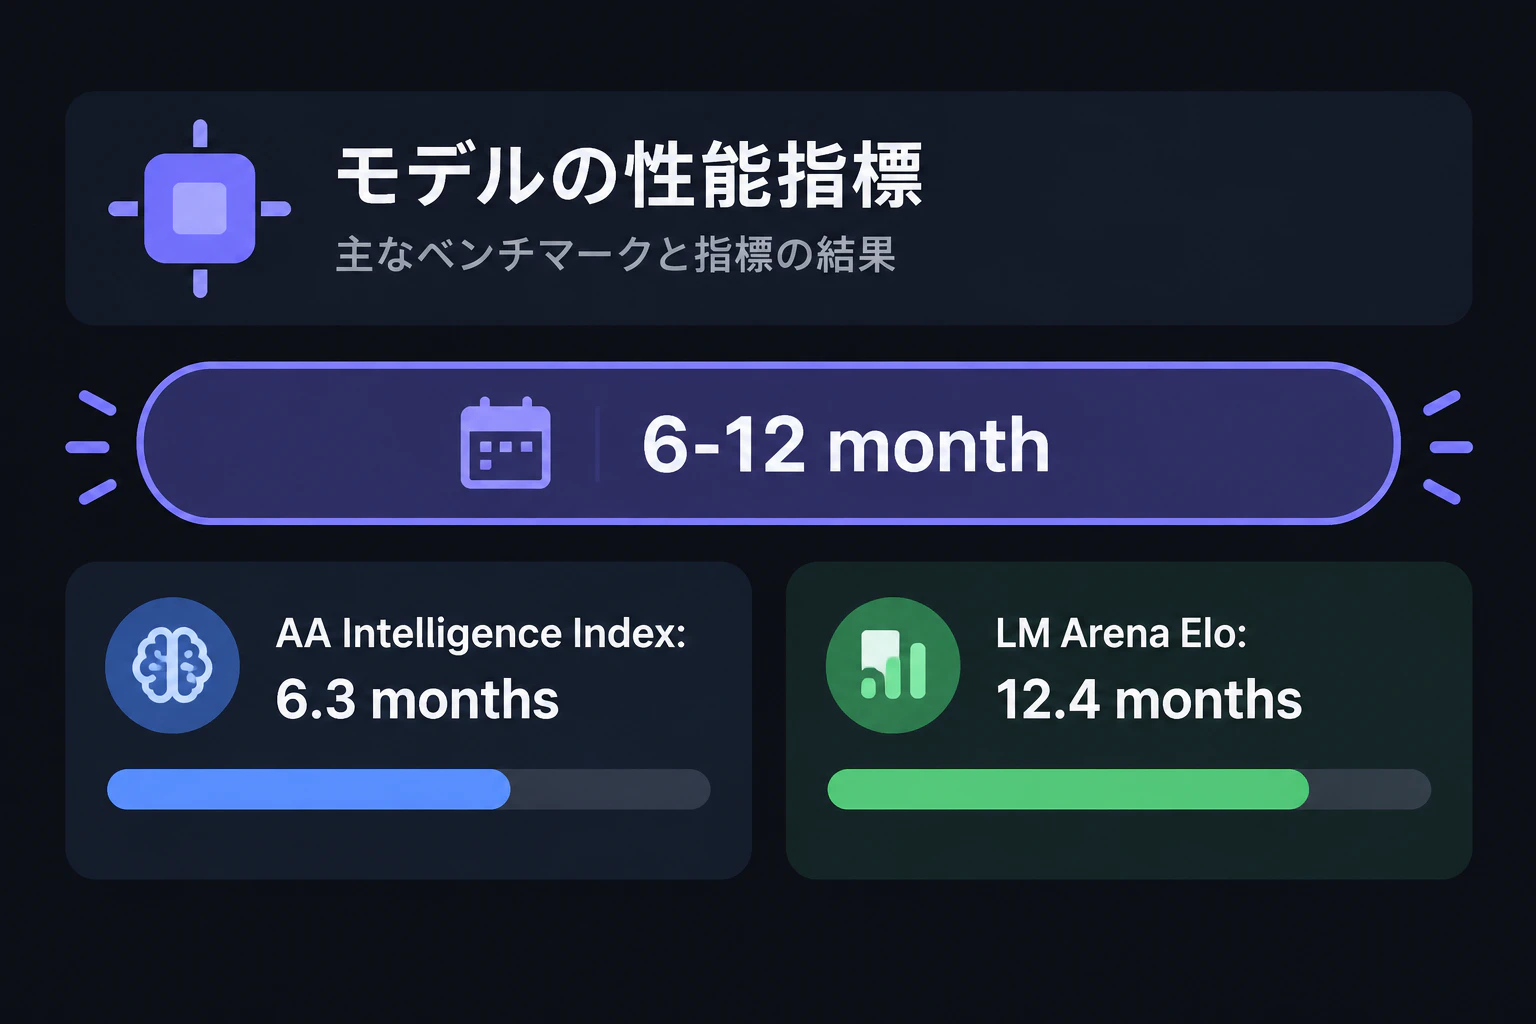
🦜 きなこ「総合指数のIntelligence Indexだと6.3か月。人間の投票で強さを決めるLM Arenaのスコアは、いちばん長くて12.4か月なの」
🐹 もっちー「つまり去年のモデルを今ごろ使ってるってことか…なんか、ちょっと損した気分になっちゃうな」
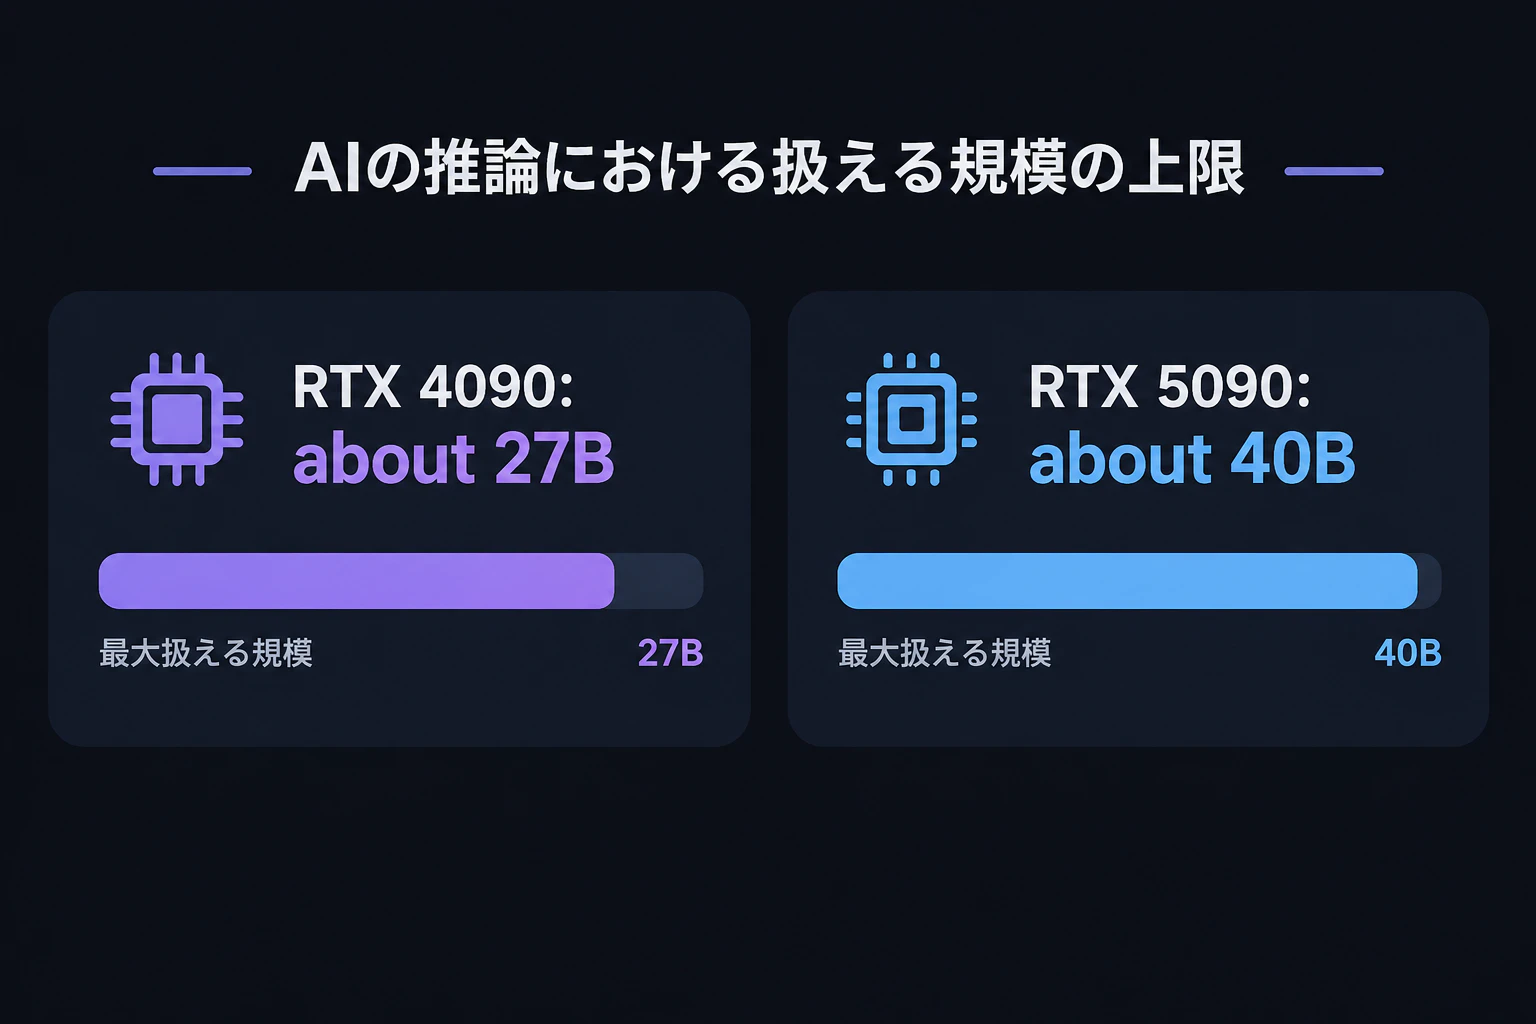
🦜 きなこ「しかもね、載せられるサイズのほうにも天井があるの。理論上はRTX 4090で約27B、RTX 5090で約40Bまで」
🐹 もっちー「遅れてるうえに天井まであんのかい!無料や無料や言うても、これけっこう払わされてるやん」
🦜 きなこ「まあまあ。そこで切り捨てないでほしいな。その差ね、遅れっぱなしじゃなくて今まさに詰まってきてるの」
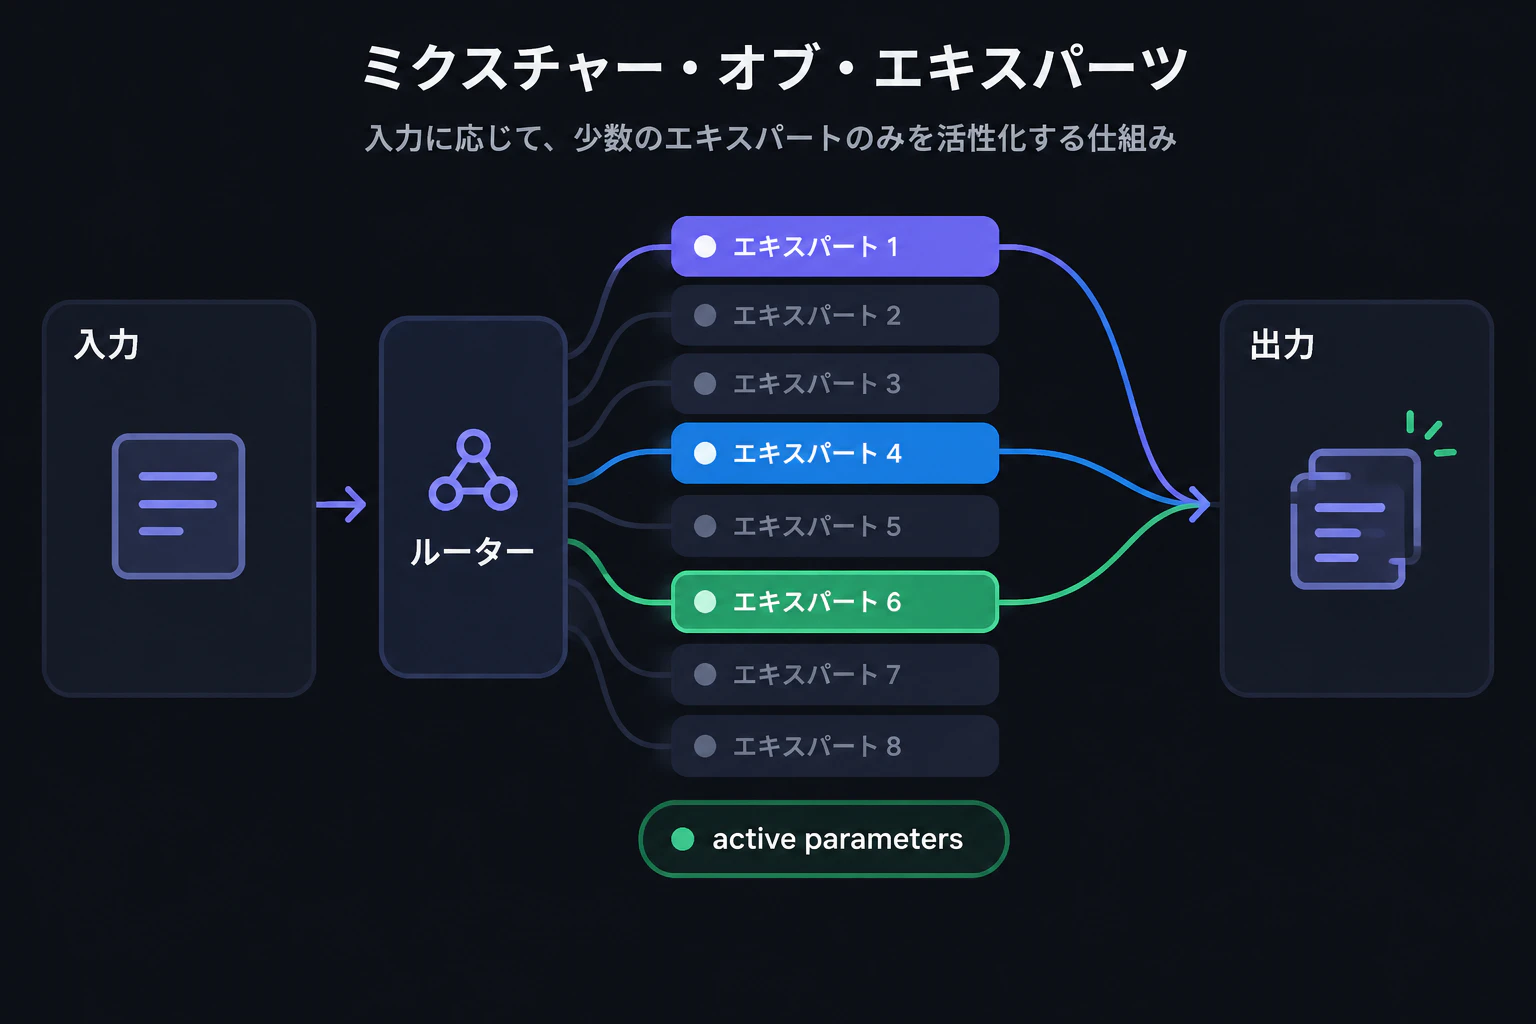
🦜 きなこ「MoEっていう、毎回ぜんぶ使わずに担当だけ起こす方式ね。その実際に動く分をアクティブパラメータって呼ぶんだよ」
🐹 もっちー「担当だけ起こすって、巣箱の全員をたたき起こさずに、種を運ぶ係だけ声かける感じ?」
🦜 きなこ「うん、その理解でいいよ。全員分の知識は持ったまま、動かす人数だけ絞る。だから小さいGPUでも回せるの」

🦜 きなこ「Gemma 4は26Bのうち約4B、Qwen 3.6は35Bのうち3Bしか動かさない。だから4090や5090でちゃんと回るの」
🦜 きなこ「ここだけの話、飼い主の課金明細ちらっと見ちゃったんだけど…AIのサブスク、毎月けっこうな数が並んでたよ」
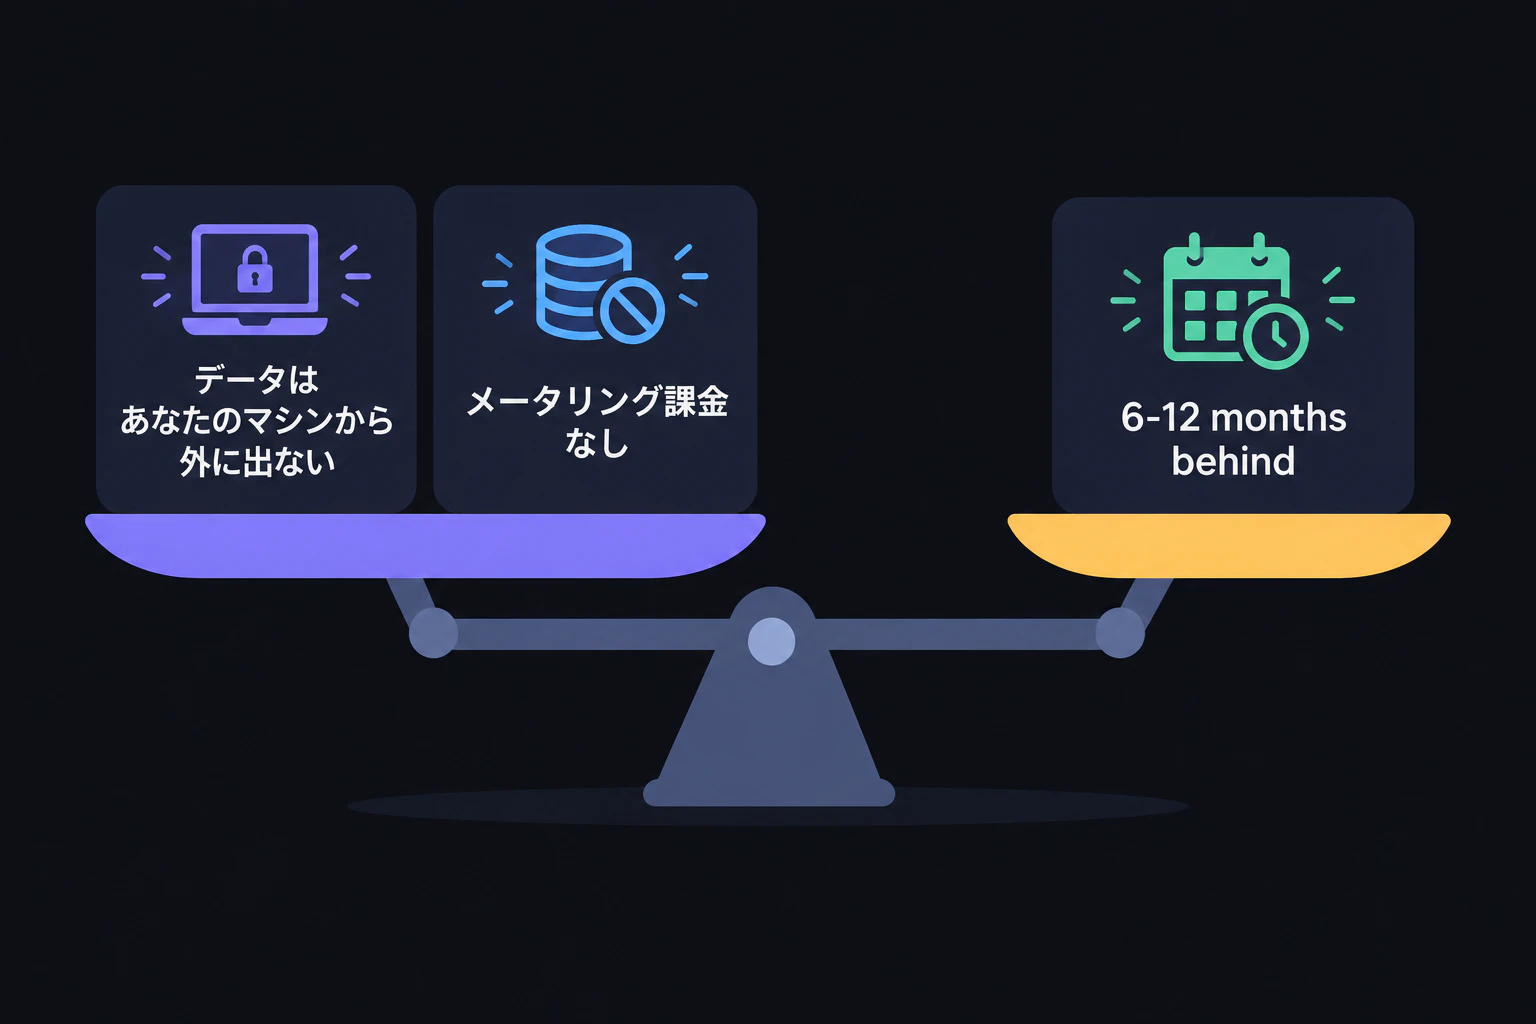
🐹 もっちー「待って、それやったら手元で動くほうがええやん!外に一切出えへんし、何回使うても追加で取られへん!」
🐹 もっちー「で、冒頭の20倍——あれ結局どっちを使えばいいの?ってところに、結局戻ってくるんだけど」
まとめ
🦜 きなこ「よし、最後に3ステップでまとめるね。今日話したこと、全部この順番に畳めるんだよ」
🐹 もっちー「3ステップ?待って、並べるだけはやめて。ぼく、リストにされると全部こぼれるんだよ」
🦜 きなこ「ステップ1は、自分のGPUのVRAMを見ること。冒頭の793対41って数字、あれ同時実行したときの差なの」
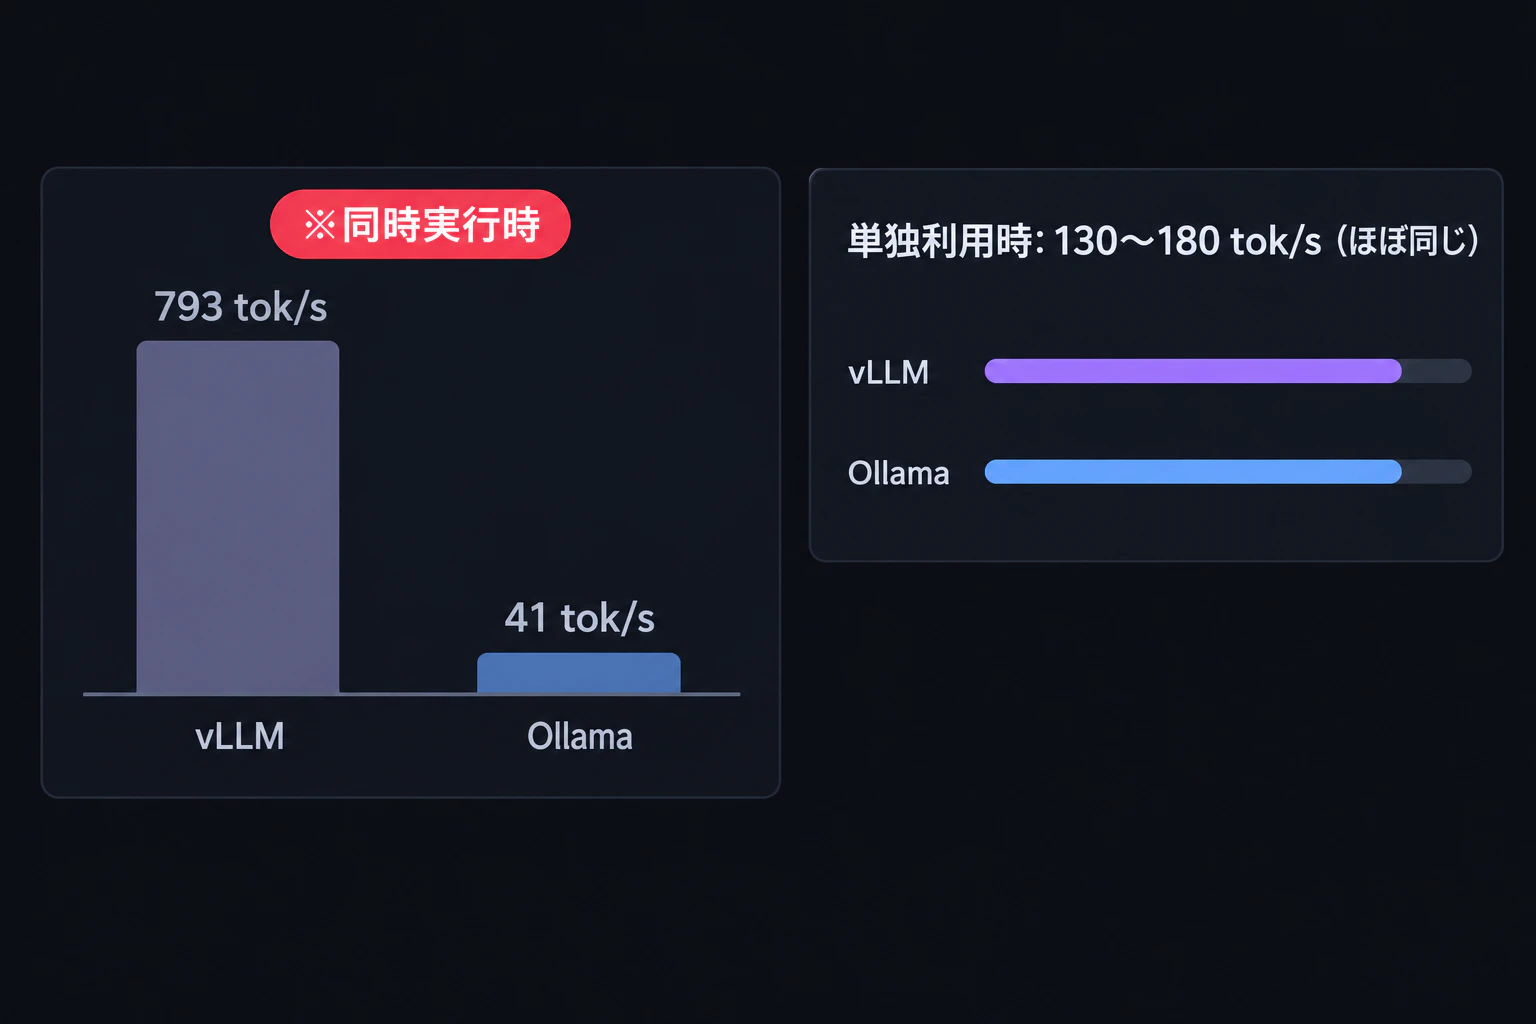
🐹 もっちー「あ、そうか!ワイみたいに一人で使うだけなら、あの20倍差は最初から関係ないんやな!」
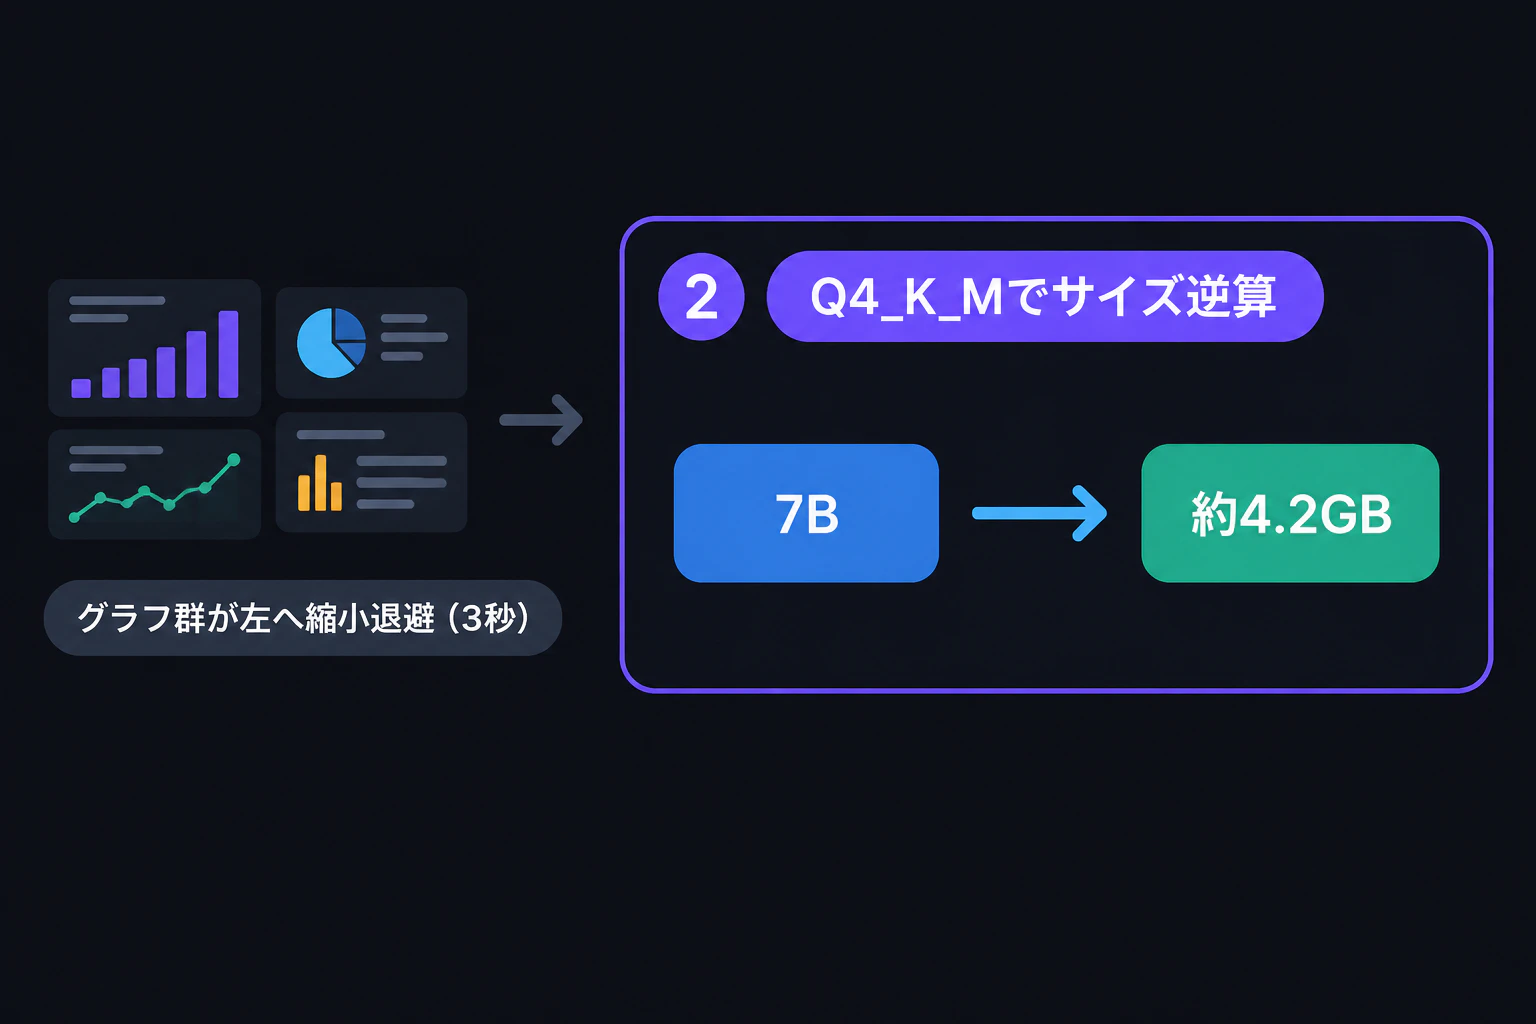
🦜 きなこ「そう。単独なら両方130〜180 tok/s で横並び。じゃあステップ2、Q4_K_Mでサイズを逆算する。7Bなら約4.2GBなんだよ」
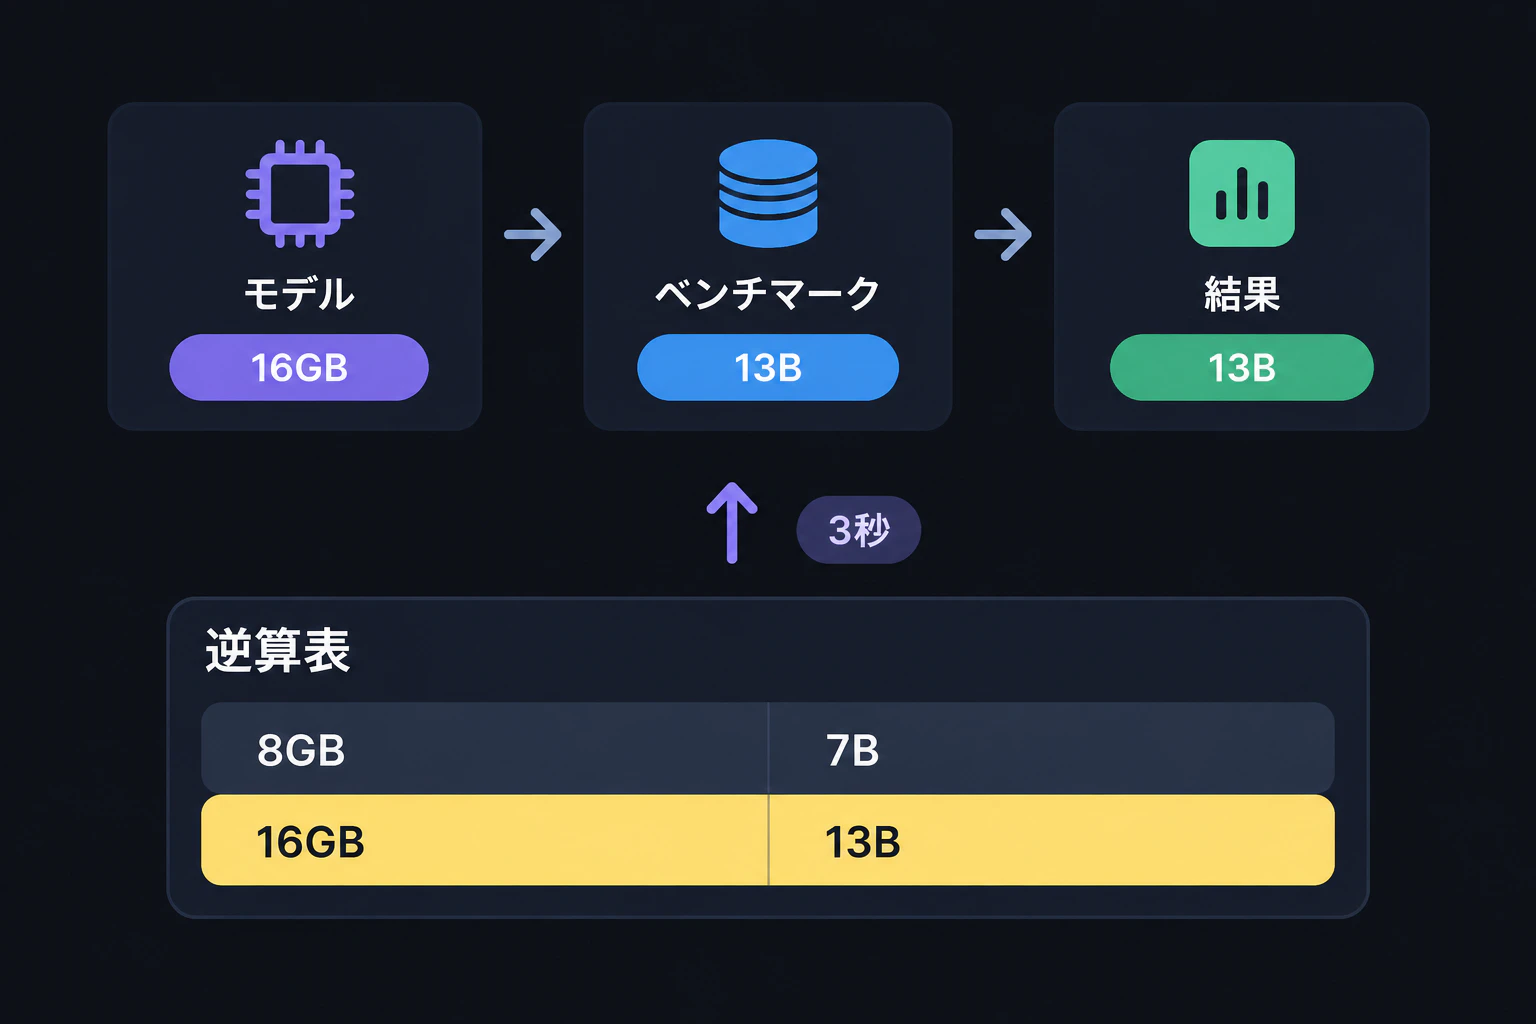
🐹 もっちー「ほんなら逆算やん!ワイのPCは16GBやから…13Bが約7.8GBやろ?ワイでも13Bいけるやんか!」

🦜 きなこ「そう、それがステップ2。ステップ3は用途でランタイムを選ぶこと。一人ならOllama、社内で同時に叩くならvLLMなの」
🐹 もっちー「つまり冒頭の20倍は、速さの勝ち負けやなくて「何人で使うか」の話やったってことか!」

🦜 きなこ「そういうこと。だから一人で試すだけなら、まずOllamaで一個動かしてみるのが一番はやいんだよ」
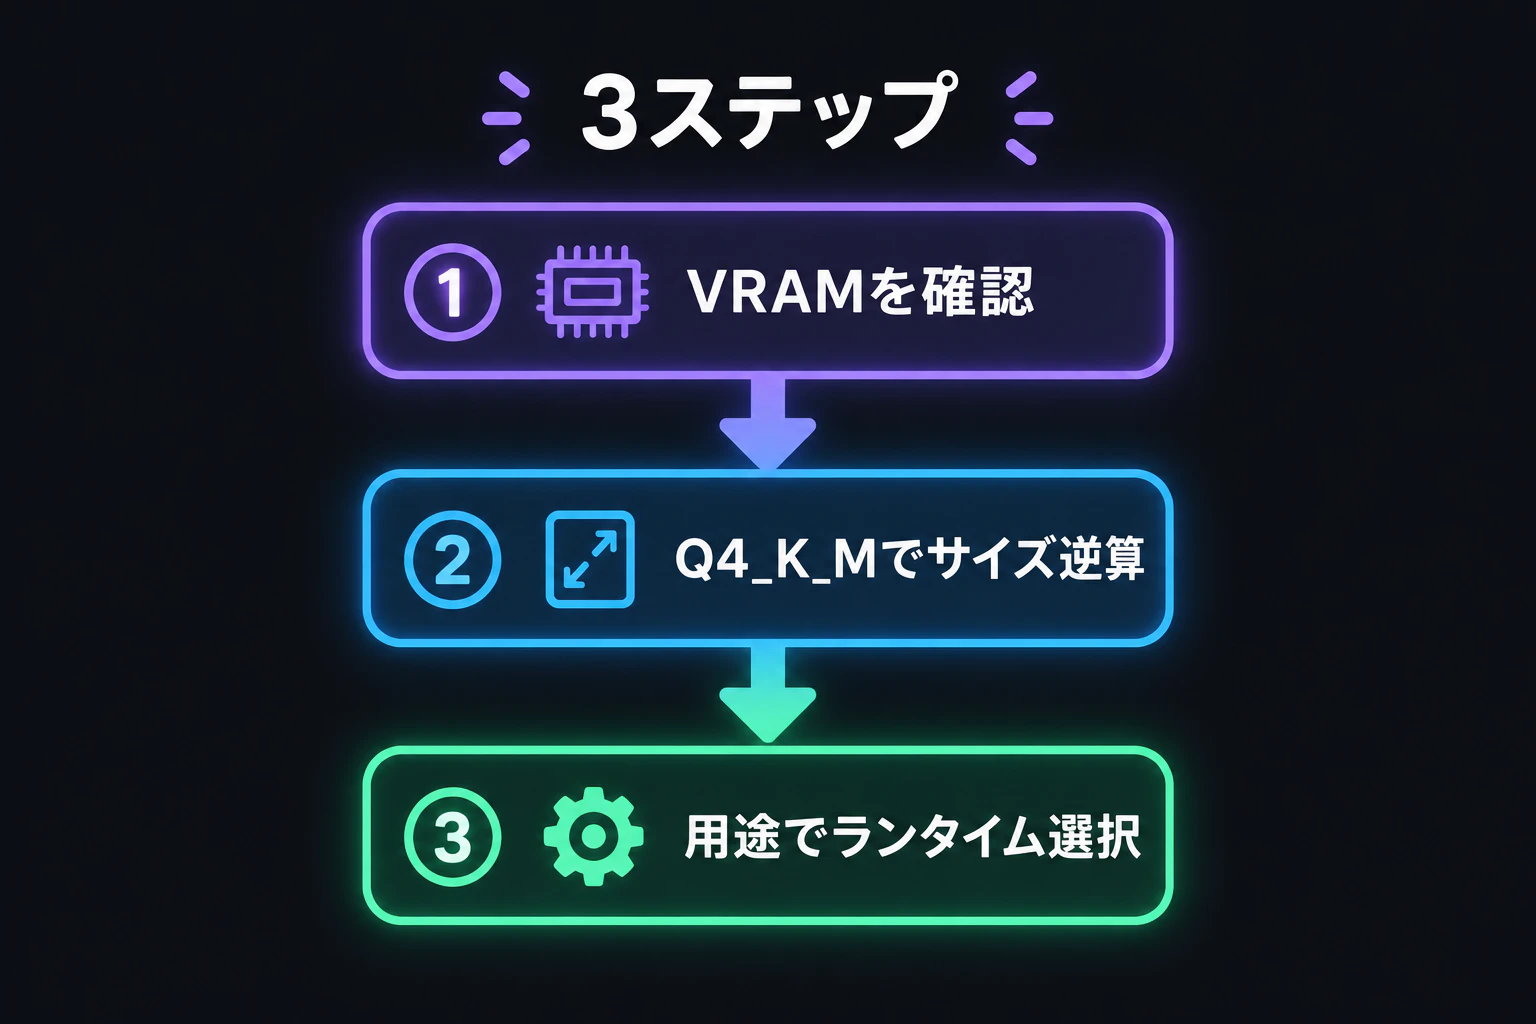
🐹 もっちー「ええと…VRAM見て、Q4_K_Mでサイズ逆算して、一人か大勢かでランタイム決める。これだけ?」
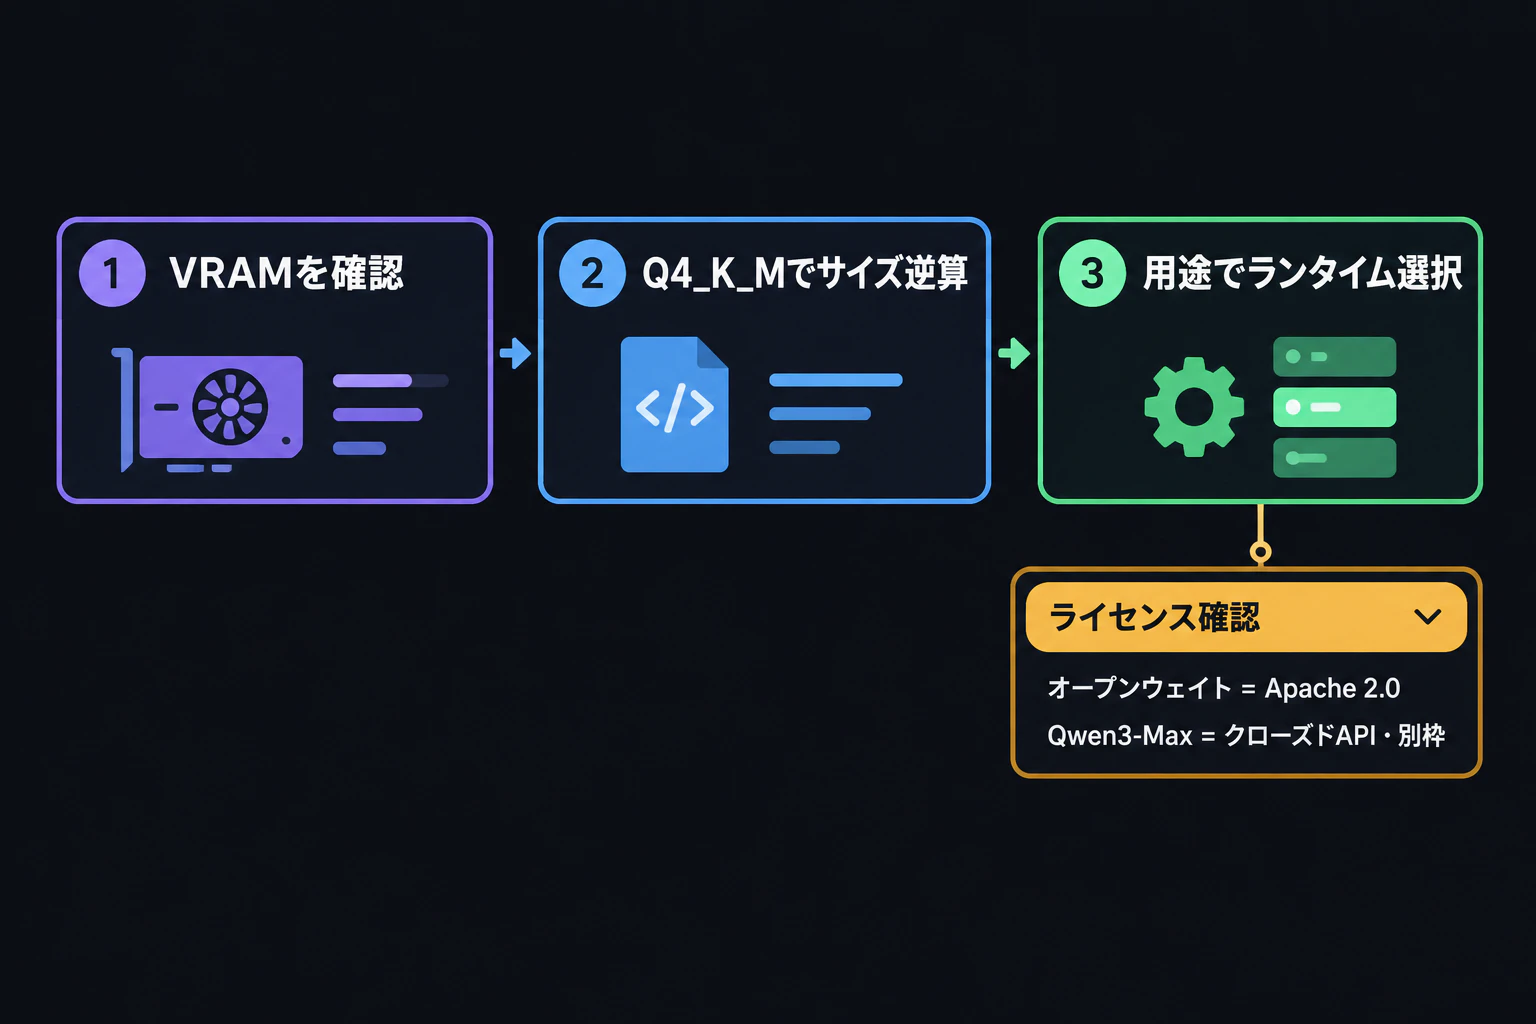
🦜 きなこ「これだけ。あとライセンスだけ確認してね。Qwen3のオープンウェイトはApache 2.0、Qwen3-Maxは別枠なの」
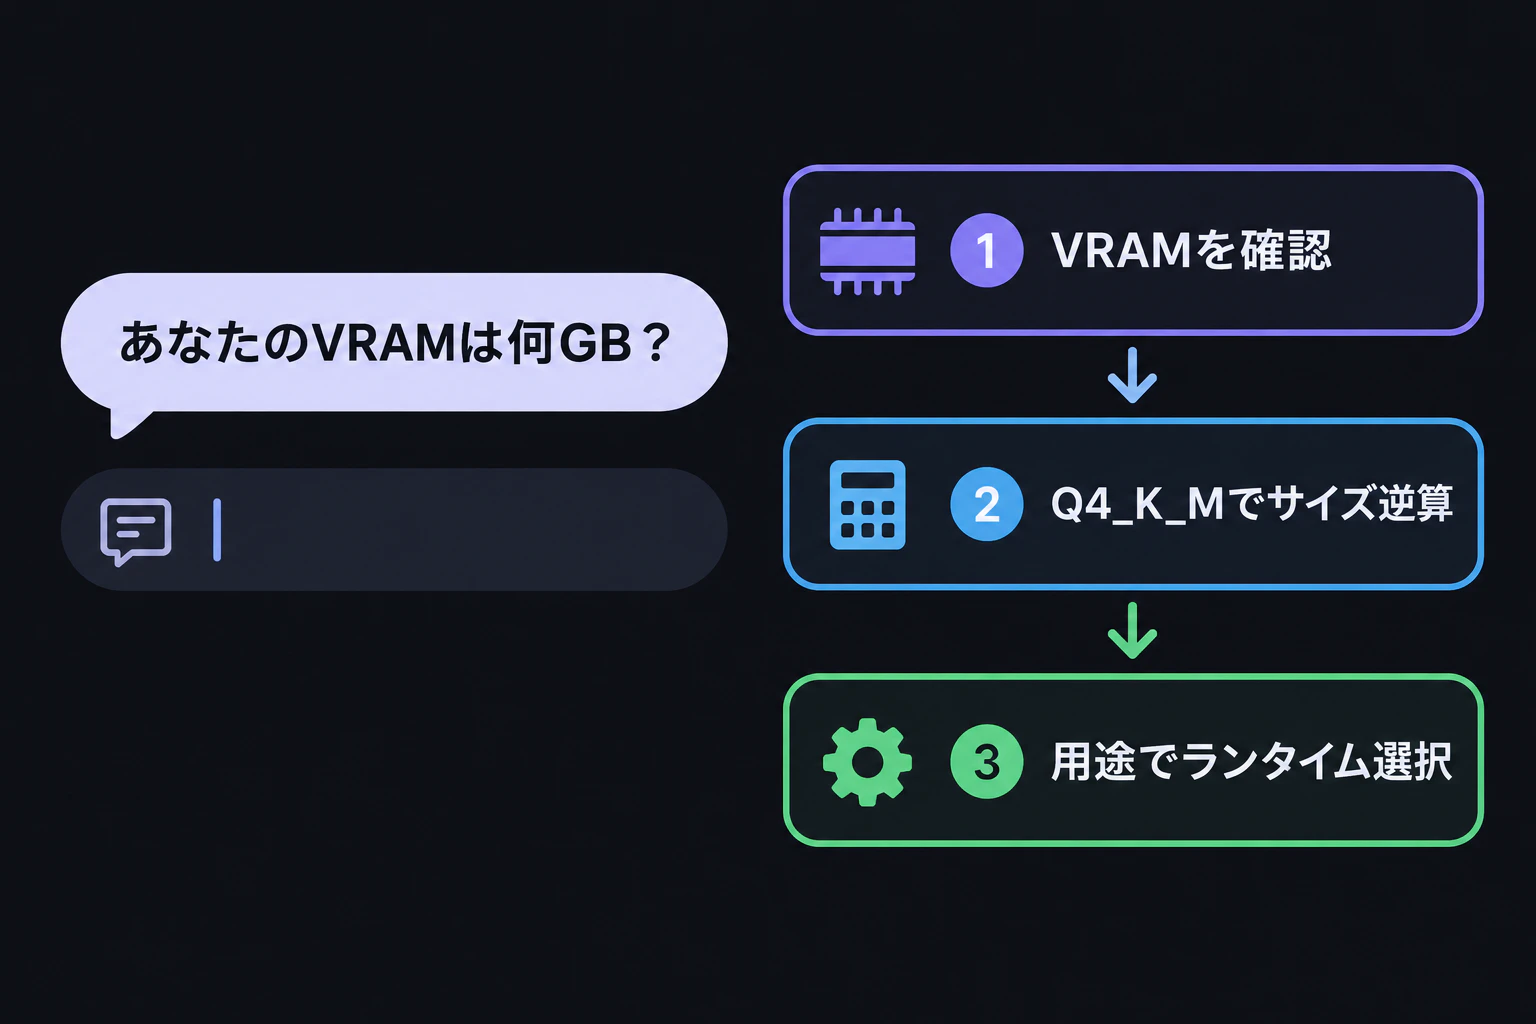
🐹 もっちー「なるほどね。…そこの君!自分のGPUのVRAM、何GBか教えてくれない?コメント欄で待ってるよ」
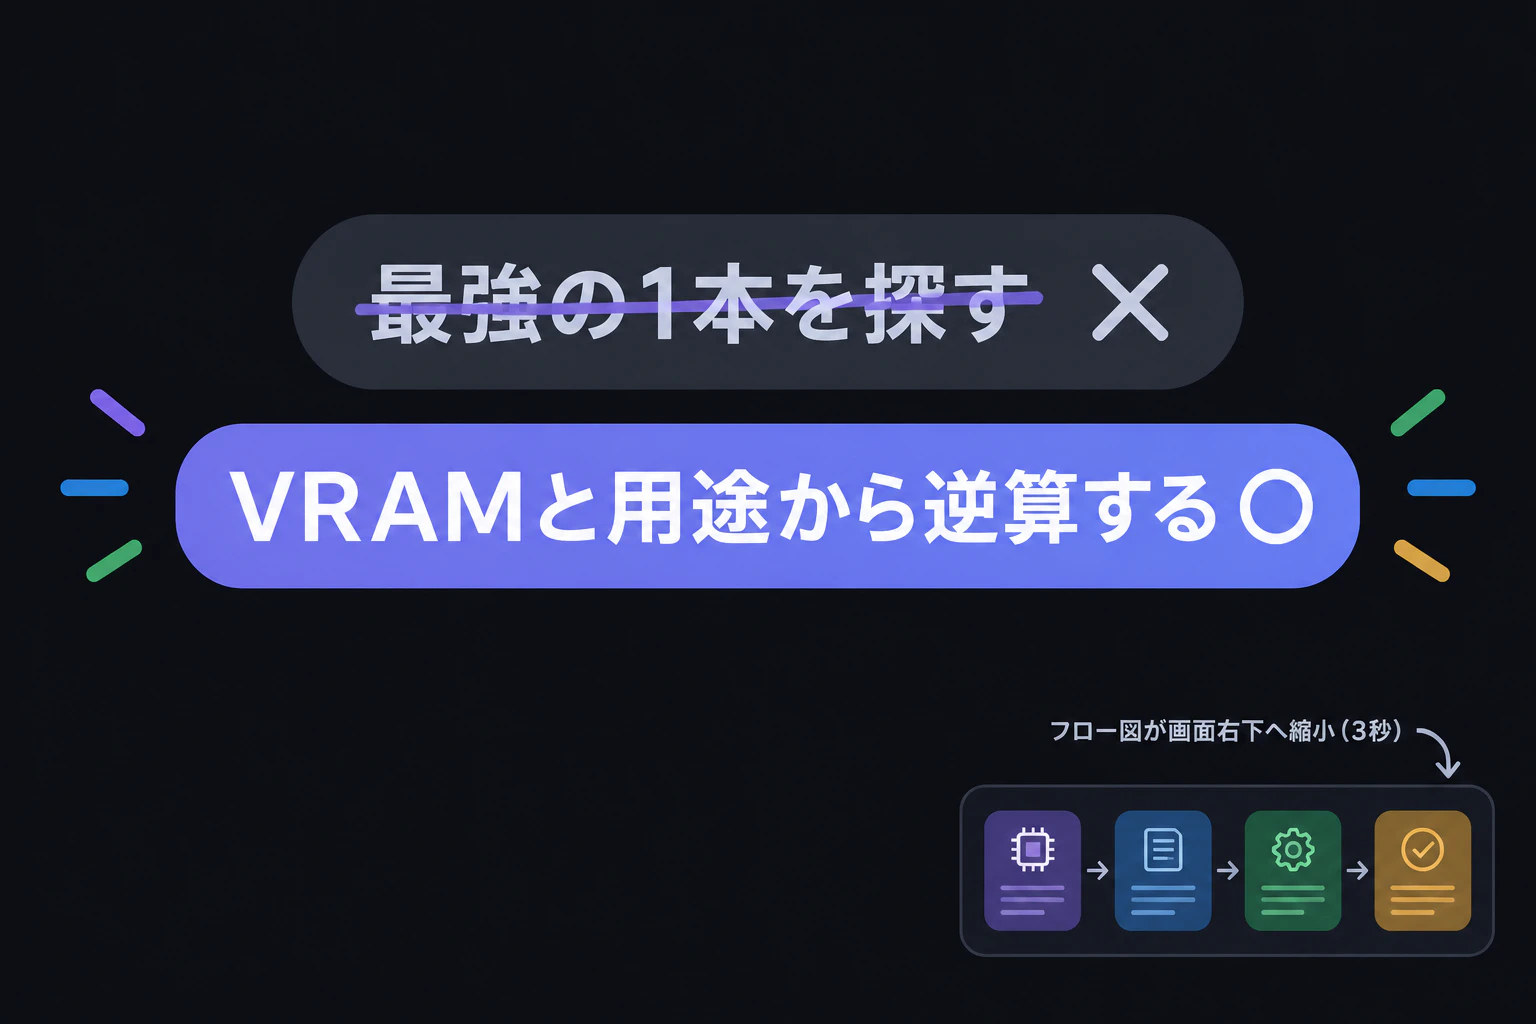
🦜 きなこ「私も気になる。最強の1本を探すんじゃなくて、自分のVRAMと用途から逆算する。それが今日の答えなんだよ」
🐹 もっちー「4.2GBなら今夜のうちに落とせるよね。ぼく、まず7Bを1個だけ動かしてみる」
🦜 きなこ「…実はこの「量子化しても精度が落ちない」って話、クラウドAPIの値下げ競争とも地続きなんだけど……それはまた別の動画で」
🐹 もっちー「えっ、なんでそこで止めるん!一番おいしいとこやんか!…きなこ、ほんまええ性格してるわ」
きなこもっちーのテック深掘り では、AI/LLM を中心としたテック全般をハムスター(🐹 もっちー)とセキセイインコ(🦜 きなこ)の掛け合いで楽しく解説しています。
▶️ 動画で観る → 同じGPUで20倍差!ローカルLLMは「無料」より「選び方」だった
👍 この記事が役に立ったら LGTM・ストックしてもらえると励みになります!
📺 チャンネル登録はこちら → きなこもっちーのテック深掘り
🔗 他の解説動画も見る → きなこもっちーのテック深掘り の動画一覧