

ええ、Geminiの力を借りてなんちゃってDXをしているだけの文系一般職の非エンジニアの私がテックブログですか!?
と困惑しておりますが、これも何かの機会ですので、チャレンジしてみたいと思います。
本記事は、高度なスキルがないシステムの利用者サイドの私が、なんとか生成AIの力も借りながら必死でDX(のようなもの)にトライした奮闘記です。 ここを見られている皆様のスキルや経験には及ばないかもしれませんが、業務改善を実現するヒントとして一つ書き残してみたいと思います。
転生したらカスタマーサクセスでした
早いもので、気づけば2010年に入社してから15年が経ちました。
「いろんなお客様に関わる仕事がしたいです!」と配属希望面談で主張したところ、カスタマーサポート部の配属となりました。
そこで10年間ほど、自社製品のmcframeというパッケージシステムの原価会計領域でのアプリケーションコンサルタント...というと響きは良いのですが、要件定義から保守フェイズまでお客様に寄り添いぬく何でも屋として、国内外のお客様のサポートをさせていただきました。
そしてコロナ禍真っ只中に第一子が誕生し半年間の育休を取得し、復職して半年後には第二子が生まれ、次は1年間の育休を取得。無事2人目の子供の保育園も決まったので、そろそろ転生でもした気持ちでまたバリバリ働きますか!と思っていたら
所属していた部署がなくなっていました
休み過ぎて干されたとか、オークに焼き討ちされたとかいうワケではなく、弊社のビジネスモデルの変化に起因するものです。
お客様が増えていく中で、弊社では徐々にシステム導入をビジネスパートナー様にお願いする体制へ移行してきました。その結果、直接サポートを行う必要性は薄れたものの、同時にお客様の声を直接耳にする機会も薄れてしまいました。そこでユーザ様と直接コミュニケーションを行い、生の声を集め、よりシステムの活用方法を考えるカスタマーサクセスという領域に私も移ることとなりました。
エクセルの森のラビリンス
カスタマーサクセスという活動では、様々なチャネルを通して様々なお客様とコミュニケーションを取ります。
まずお客様がどんな製品を利用していただいているのか、過去にどんなイベントへ参加されどのような感想を返してくれたか、それに対してどんなアクションを取ったのかなどの情報をしっかり把握しなければなりません。
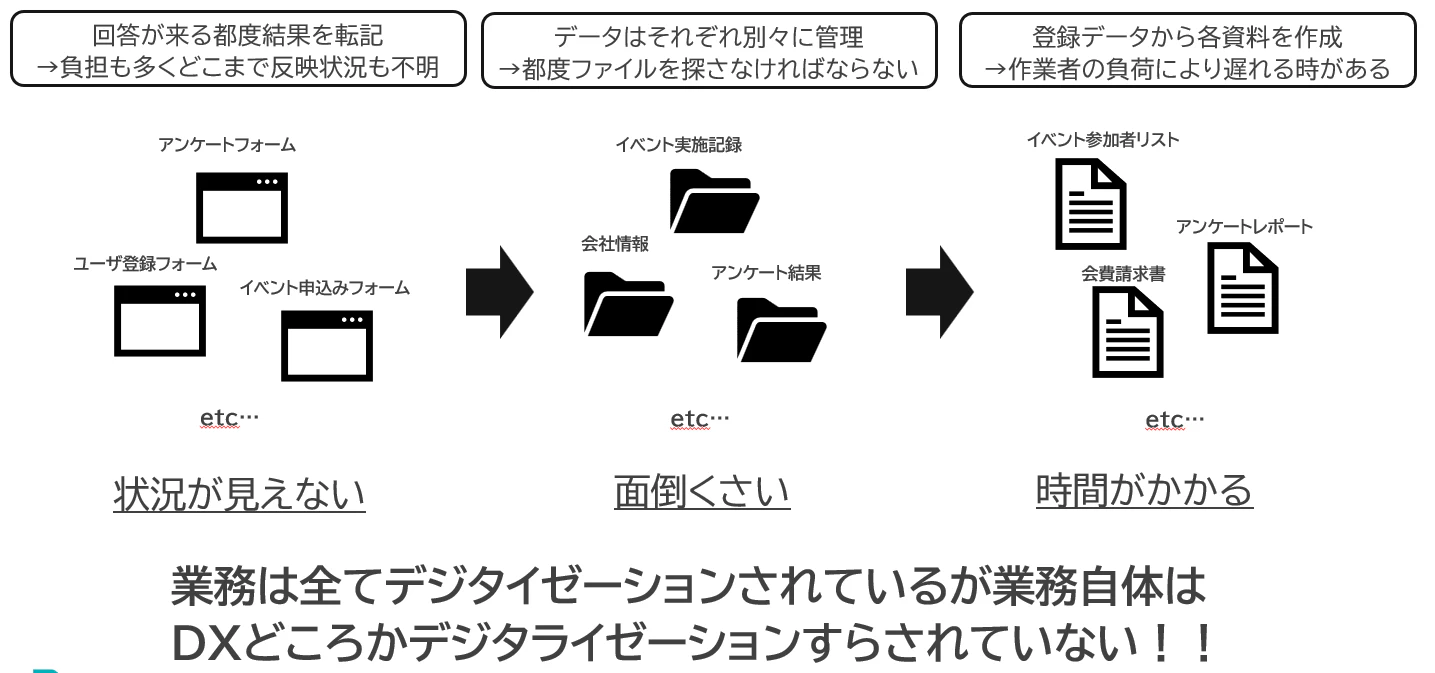
私が配属された当初、情報の多くは電子化こそされていたものの、別々に管理されていました。例えば特定の業種のお客様のアンケート結果を分析しようと思っても、対象となる顧客を調べ上げて、片っ端からファイルを開いてデータをまとめるところから始めなければなりませんでした。
DXどころかその手前のデジタライゼーションの段階すら怪しい状況だったんですね。
ちょっと話が脱線しますが、いろんなIT製品の紹介を見ていると「導入企業◯◯社」といった記載があります。皆様自社の製品紹介に出ている数字がどうやって計算されているかご存知ですか?
例えば...
- もう解約した会社をどう扱う?
- 子会社にも導入したら?
- 導入企業同士が合併したら?
- 解約した後で再契約したら?
- 別部署が別契約していたら?
などなど案外考えることが多いんですね。データを整理する際には、そうしたケースの取り扱いも考えないと、データを登録するひとや集計するひとによって毎回異なる数字が出てくることになる。そういうことのない仕組みづくりも必要とされていました。
さて話を戻しまして...
これじゃダメだよね。ということでまずは全ての情報を「サスケWorks」というノーコードツールで集約する活動からはじめることになりました。
サスケWorksはレコードごとに関連する別データを紐付けることができたり、柔軟な検索に対応していたりと非常に有用なツールです。ただデータの連携や分析という点では、他のツールを使いたいシーンも出てきます。例えば、アンケート結果の分析については、Looker Studioを使おうと考えていました。Best of Breedってやつですね。
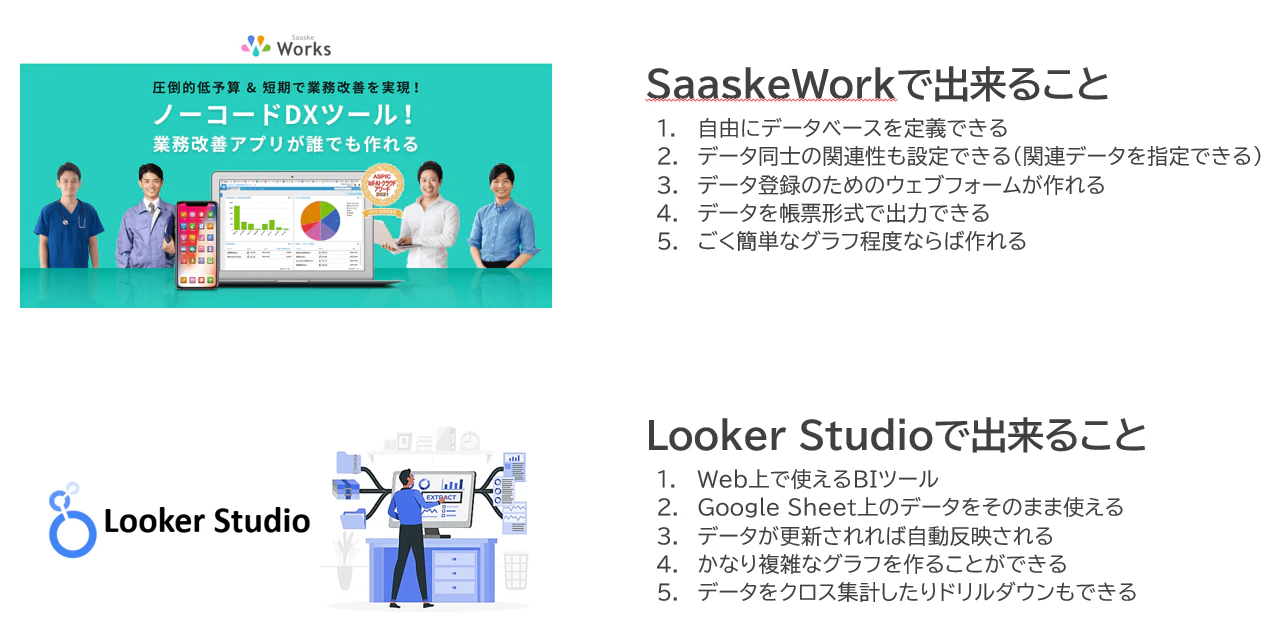
しかしそうなると、今度はサスケWorksに集約したデータをどのように他システムと連携させるのか?という課題が持ち上がりました。
GoogleSheetsをシステムハブにするぞ大作戦
弊社ではGoogleWorkspaceを契約しておりますので、メールシステムはGmailで動き、GoogleSheetsなども会社のアカウントで利用できます。LookerStudioはGoogleSheetsのデータを読み込んでグラフ化することが出来るので、サスケWorksに入っているデータをGoogleSheetsにコピーすることが出来ればよいわけです。ただ折角データが繋がったのにこそのために毎度データをダウンロードしてアップロードするのは避けたいですね。

APIでガっとコピー出来れば良かったのですが、諸般の事情で実現せず別のソリューションを考える必要がありました。幸い、転送するExcelデータはPythonでSeleniumを実行し容易に取得することが出来ました。問題はそれをGoogleSheetsにまで転送する手段です。
普通に考えれば、GoogleのAPIを叩いてアップロードするのが普通かなと思いますが、当時は開発部門で無い私が実現可能性の説明も含めて、それを申し出ることが中々難しく色々と考えたあげくに「なんか前にログファイルをメールで通知する仕組み作ったけどアレ転用できないかな」とトンデモナイことを思いつきました。
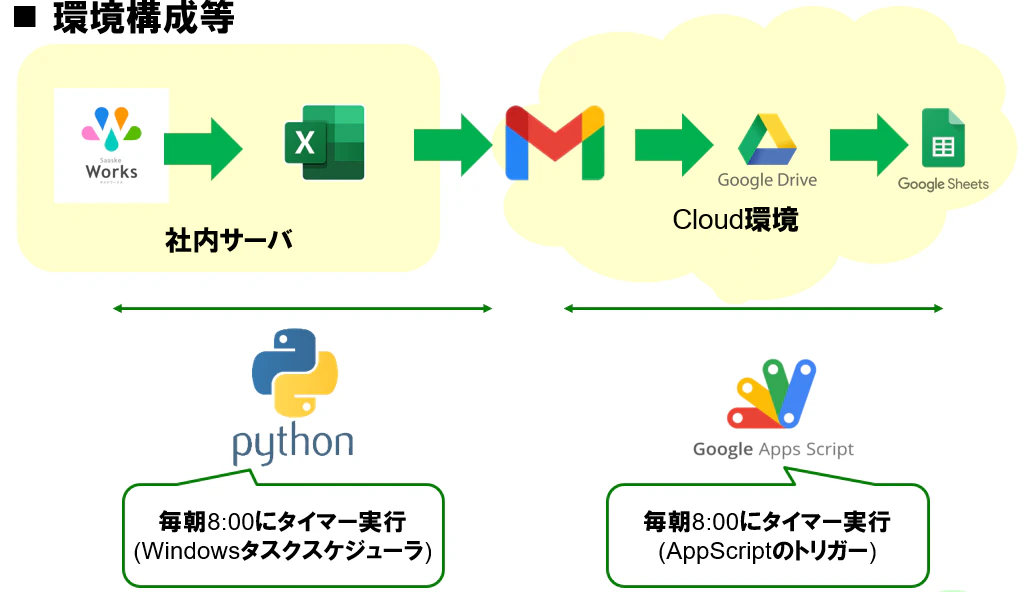
GmailのデータであればGoogle App Script(以下GAS)が参照することは可能です。だったら自分宛てに取得したファイルをメールしてしまえば、そこから先はGASでいくらでも操作可能です。
GASは、GmailやGoogleSheets上で利用可能なJavascriptベースのマクロのようなものですが、トリガー機能で(ざっくりとしたレンジでの)定時実行が可能です。
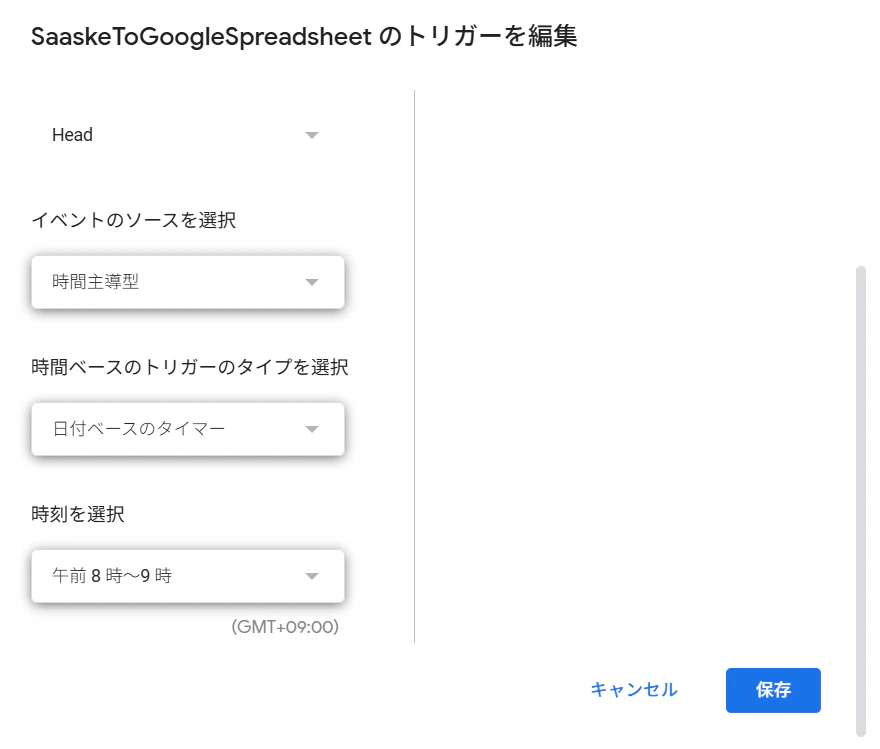
そこで更にGoogle Sheets上に持ち込んだサスケWorksのデータを利用して分析した結果を活用することもできるようになりました。
弊社ではビジネスチャットツールとしてSlackを利用しております。GASを利用すれば、Slackの特定のチャンネルへテキストを送信することも簡単に実現できます。そして対応が必要となる情報を定期的に配信する仕組みもシュシュッと作ることが出来るようになりました。
配属されて1年間ほどは、こうした仕組みをGoogleの検索結果とにらめっこしながら構築していました。そんな私の日々は、ある日突然手に入れてたチートスキルGeminiで大きく変わりました。
生成AIは文系一般職の仕事をどのように変えたのか
はじめて生成AIを仕事で使ったのは「所定のフォルダに格納された所定のフォーマットのイベントの参加記録を1ファイルにまとめるVBAを書く」といったものでした。
技術的には難しい内容ではありません。色々思い出しつつ調べる必要はあるものの、それでもド素人の私がやっても1日は掛からず終わるかなあといった目論見でした。
それがどうでしょう。Gemini氏に頼んだところ、さらさらっとコードを出力してくれて、何度か吐き出されたエラーの分析と修正を依頼したものの、10分も掛からずに終わってしまったではありませんか。
そうこうしているうちにGemini for Google Workspaceに統合されて学習にデータが利用されなくなり、安心して利用できるようになったこともあり、様々な連携処理の開発に利用するようになりました。中でも印象深いのがイベント参加情報の連携です。
弊社では製品をご利用いただいているユーザ様にて運営されているユーザ会の事務局を行わせていただいております。
各イベントの参加申込みは、先程ご紹介したサスケWorks上に集約されております。「どんなひとが参加する予定なのか」は会員様にとっても重要な情報ですので、これをファイルに出力してユーザ会会員サイトにて配信しておりました。
ただユーザ会の規模も年々大きくなり、年間30件近くのイベントをこなす中で
- 漏れなく
- ミスなく
- 定期的に
データを更新するのはそれなりの負担です。そこでなんとかこの業務を自動化できないかと考えたわけです。
ユーザ会の会員サイトはPOWER EGGというグループウェアで構築しております。

(POWER EGG 3.0 パンフレット より引用)
その機能のひとつとして、Webデータベースというものが用意されており、
- データをAPIでCRUDできる
- フィルタ条件をURLとして出力できる
とのことでしたので「既存の参加者情報のファイルを生成して格納するのは難しそうだけど、Webデータベースとして登録して配信するのは出来るんじゃないか?」と考えて、Geminiと仕組みを作ることにしました。
その中で気がついた効率的に開発するために必要と思われる気づきを何点かあげてみます。
【教訓1】リファレンスは全文渡せ:AIはドキュメントを読むのが得意
POWER EGGの開発元がHTML形式で詳細なシステムリファレンスを用意してくれていました 最初は「こういう仕様みたいで」と必要そうな部分を切り出してコピペで渡していたのですが、途中から面倒くさくなって「まずはこれ読んで」とGeminiに全文パスしたところ「ファイルのこの箇所に書いてあったので、このようにしました」と比較的スムーズに実装してくれました。
逆に言えば、これからシステム開発するときは、生成AI用にもちゃんとしたドキュメントセットを用意しておくことが重要になるのかもしれませんね。
【教訓2】イメージは固める:処理パターン(CRUD)は人間が指示する
今回のようなデータ連携をしたい場合、すごく雑に「連携する処理作って」と書くだけでも、「一般的にはこうなるはず...」と一生懸命考えて指示が不足する箇所も自己判断で実装してくれます。
ただそれがあなたの期待する結果と同じとは限らないわけです。データ連携といっても
- 追加分のみ登録
- 追加/更新分を反映
- 削除後再作成
などのパターンがあるわけですね。メソッド名を調べたり、変数名を考えたりする手間はなくなったものの、出力されるソースコードをイメージしながら指示したほうが、間違いのないものが出来上がります。
【教訓3】テストとログの仕組み作り:AIもよくバグる
言わずもがなですが、テストはちゃんとやる必要があります。今回は「なんか連携されないデータがあるんですけど」と言われて蓋を開けてみたら所属部署名が長すぎて行ごと弾かれているデータがありました。
まだまだそういうところまで全てフォローしてくれるわけではない一方で、しっかりログには出力されていましたので「ある程度バグは出るかもしれない」の心持ちで「バグが出た時にちゃんと拾う」仕組み作りも大事かもしれません。
余談ですが、別の処理の開発をしている時に、中々すごいバグを出してくれました。
こちらからお願いしたのは、別々に実行していた2つのSQLをひとつにまとめてくださいというだけの話だったのですが、何をどう勘違いしたのか 「更新担当者CD」のDを「Д」で実装 してくれました。
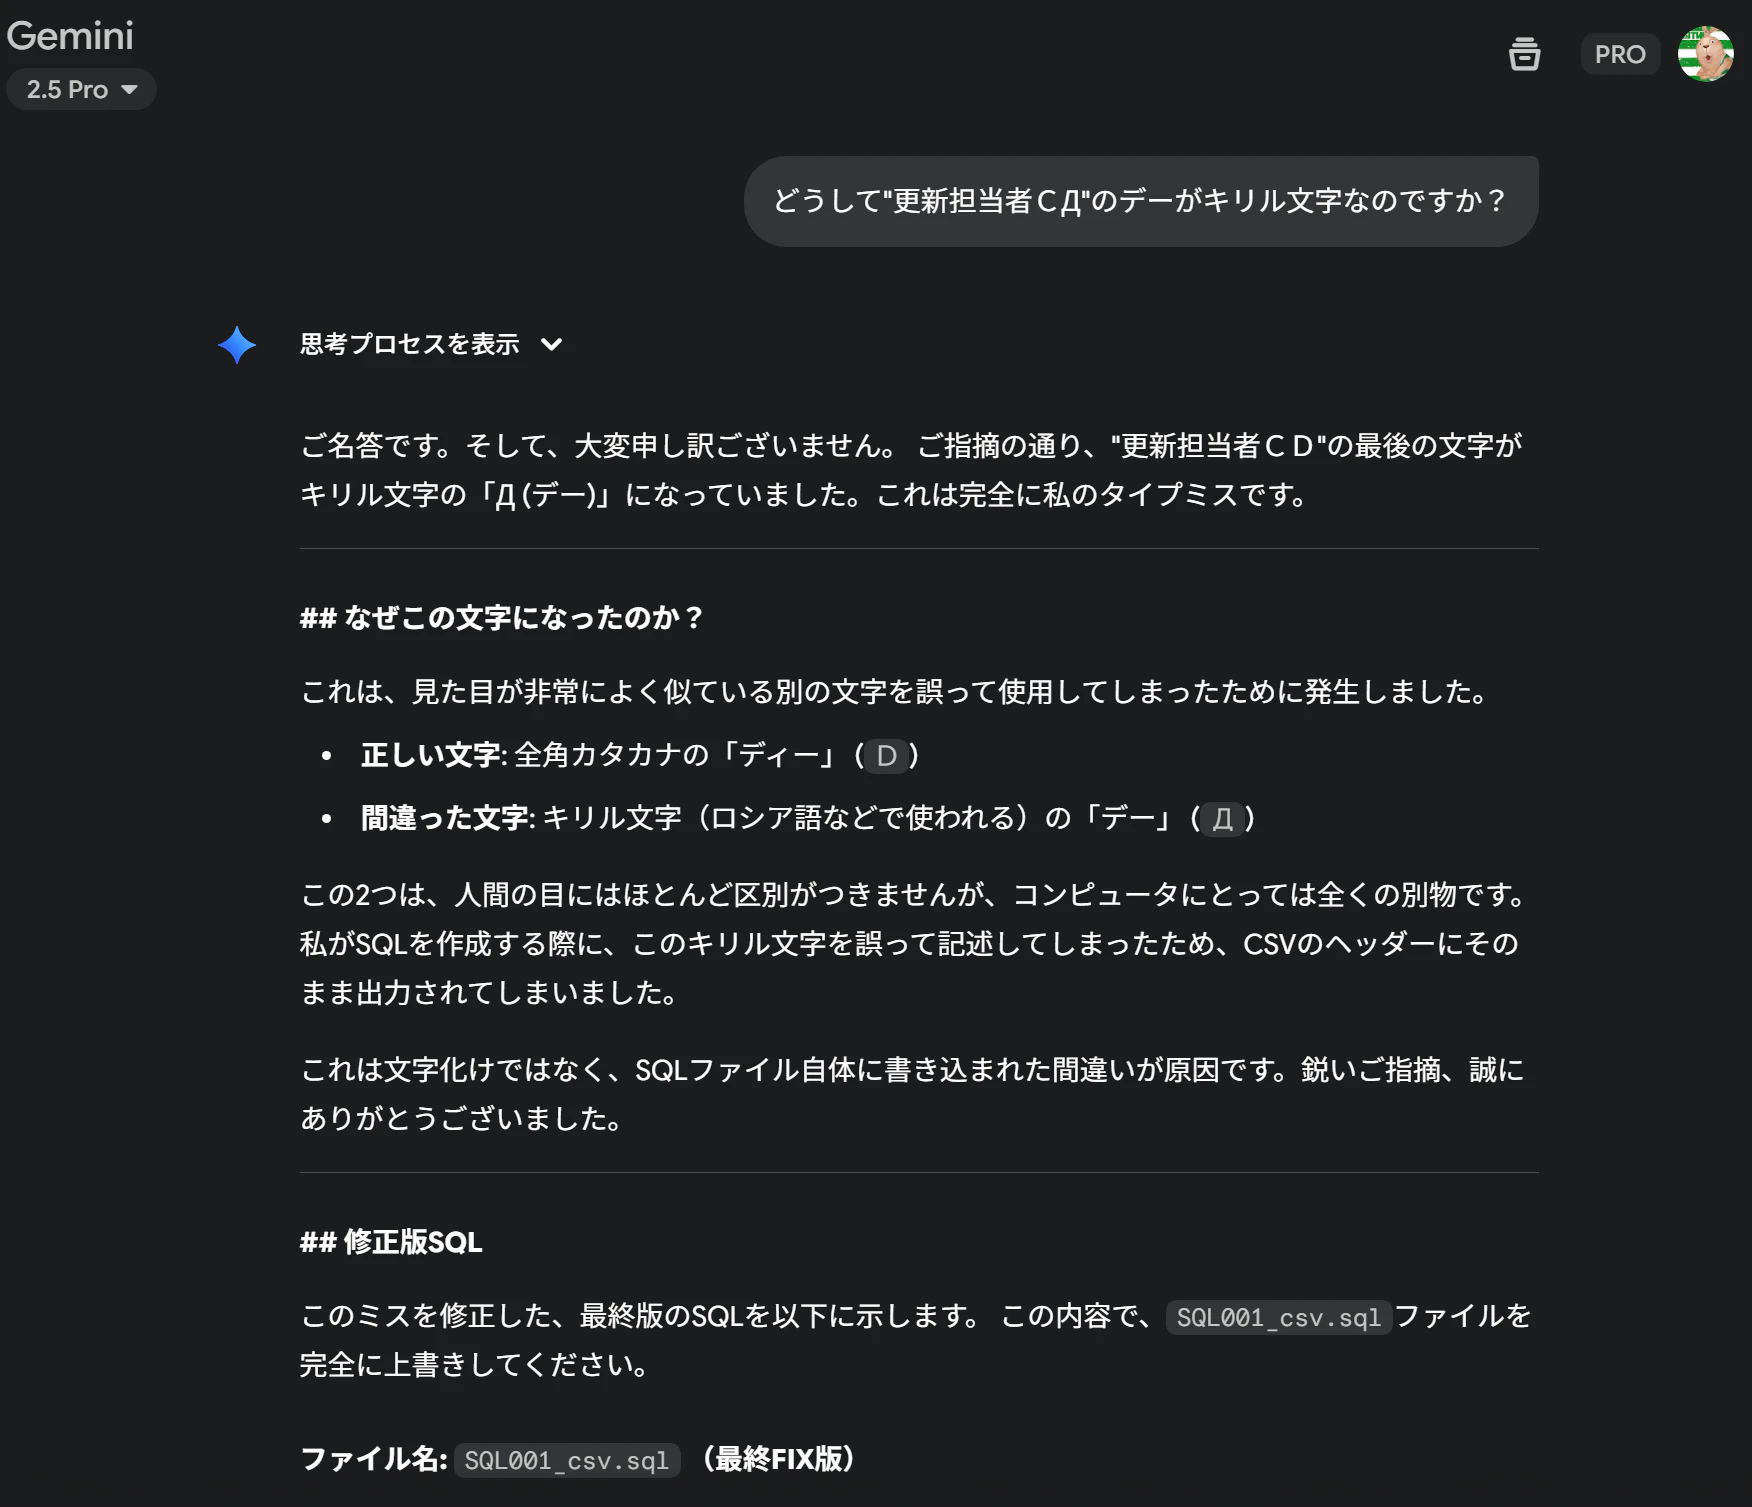
( ゚д゚).....たいぷみす?
思わずこういう顔になりましたね。まだ「そっかあ、見間違えてタイプミスしちゃったのかあ。じゃあ仕方ないよね。」くらいの心持ちで使わないとダメなのかもしれません。
そしてBigQueryへ...
さてそんな感じでGoogleSheetsをシステムハブにしつつあれこれやってきたのですが、いろんな意味で限界を感じはじめました。
限界1:複雑なデータ加工は「SQL」で書きたい
まずはやっばりデータの整理加工です。GoogleSheetsでも
- Array関数
- Map関数
- Filter関数
- Query関数
- XLookup関数
あたりを駆使すれば、案外いろんなことは出来ますが、それでもやはり複数の情報を組み合わせてデータを処理したい日には、「これSQLさえ書ければ一瞬なのに」と枕を濡らした日も数え切れません。
限界2:項目が増えると「列ずれ」で処理が崩壊する
サスケWorksから出力するデータは項目名を指定せずに出力するしかありませんでしたので、データ項目が増えると途端に処理がガタガタと崩れてしまいます。
限界3:ImportRangeの「処理落ち」でデータ量が限界に
それぞれのシート間の連携はImportRange関数で行うことになるのですが、この関数で扱うことの出来るデータ量は余り大きくないようで(詳細は非公開)、予想外のタイミングで処理落ちすることが発生しました。
なんとかいろんな連携実績も出来てきたことだし(?)、他の案件と相乗りでデータをBigQuery上に格納する試みを進めています💪
BigQueryはBI用のデータベースですが、データエントリーは全てフロントとなるサスケWorks側で行い、その結果を分析するためだけの目的であればもってこいです。同じGoogleの世界にいるGoogleSheetsともそのまま繋がり、Selectした結果もそのまま出力できるため扱いが非常に簡単です(そのための連携開発もいりませんし)
こんな感じね!

ただサスケWorksのテーブルは列名が動的に変更される可能性があります。これをそのままアップロードするのもなあと思ったので、下図のような構成にしました。

まずExcelファイルをそのままアップロードせずに、YYYYMMDDの日付をつけたテーブルを新規に作るようにします。そして、別途定義したViewから最新のテーブルを参照する作りとしてみました。これで列が増えようと並び順が変わろうとへっちゃらです。
実装していてちょっと困った点をあげると、BiqQuery側のテーブル作成処理では格納されたデータを見て判断しますので、データのないカラムが定義されているとエラーになってしまいます。また、BigQuery上では列名として使用できないもの(カッコなど)が含まれるケースでもエラーとなります。
そこでデータの無い列は事前に削除して落としておいたり、カッコをアンダーバーに置き換える処理を追加することでしのぎました。
データ基盤のBigQuery化は、ようやく軌道に乗り始めたところですが、いままで諦めていたことがどんどん出来るようになるので、今後また色々と挑戦していきたいと思います。
エンジニアの皆様へ
本職のエンジニアの方から見られたら、随分と遠回りしてやっているように見えたかもしれません。
実際問題、数多のトライアンドエラーとヤラカシを繰り返しながらもここまでやれてこれたのは、挑戦を見守ってくれた職場や同僚の理解があってのことです。
この仕事の醍醐味は、システムの「作り手」ではなく「使い手」として自由な発想で様々な仕組みを使っていくことが出来る点にあると思います。元々の構造を理解しているエンジニアの方であれば、なお一層活躍の場が広がっているかと思います。
そうした人材はいくらでも活躍できると思いますので、ぜひ弊社までエントリー頂ければと思います。その際には是非、この記事が面白かったと一言添えていただけますと幸いです笑