

学習済みLLMは高性能ですが、動かすには高価なGPUが必要になります。かといって、小さなLLMをゼロから作ろうとすると、学習に膨大なデータが必要になります。
学習済みLLMの汎用的な性能を引き継ぎつつ、必要な部分だけを切り出して小さなモデルを作れたら、GPUの負担と性能を両立できて嬉しいと思いませんか?
例えば、脳は学習の初期に多くの神経細胞を使って多様な試行を行い、解を見つけた後に無駄な活動を排除して効率化します。これは神経ダーウィニズムと呼ばれています。
LLM でも同じ発想で、モデル全体で学習したあとに不要な層を削ぎ落とす枝刈り(Pruning)を行えば、モデルを軽量化できるのではないでしょうか。
そこで本記事では、40層からなる IBM Granite 4.2 3B を使い、何層まで削っても精度を保てるか、そして何をすれば枝刈りをしても壊れにくくなるかを試してみます。
前提: どの層から削るかを決める
削る層を決めるために、各層を1つずつ飛ばしてモデルを動かし、最終出力がどれだけズレるかを測りました。このズレの大きさを0〜1に正規化したものを「影響度スコア」と呼びます。
スコアが高い層は、飛ばすと出力が大きく狂うので、モデルにとって重要な層です。スコアが低い層は、飛ばしても出力がほとんど変わらないので、削っても影響の小さい冗長な層です。

結果として、最初の Layer 0 と最後の Layer 39 だけが突出して高いスコアを示しました。中間層の大半はスコアが極めて低く、冗長だとわかります。
実験1: 追加学習なしでどこまで削れるか
Base モデルから、影響度スコアが低い層から順に最大24層まで削り、削るたびに精度と Perplexity を測りました。
精度は、計100問の4択問題に正解した割合です。ランダムに選んでも25%は当たるので、25%が下限の目安になります。
Perplexity は、次の単語をどれだけ当てにくいかを表す指標です。値が小さいほど、モデルが次の単語を自信を持って予測できています。

2層を削っても精度は73.0%を保ちました。4層(全体の約1割)を削ると精度は60.0%まで下がりますが、まだ実用の範囲です。6層以上を削ると精度は37%以下まで急落し、モデルが崩壊し始めています。
つまり、追加学習なしで安全に削れるのは、全体の約1割にあたる4層までのようです。
実験2: Fine-tuning すると削られても壊れにくくなるか
タスクに特化させると、そのタスクに必要な処理が一部の層に集まり、それ以外の冗長な層を削っても壊れにくくなるのではないでしょうか?
この仮説を確かめるため、SST-2 の感情分類データ1,000件で LoRA を学習しました。評価には SST-2 の validation 100件を使いました。
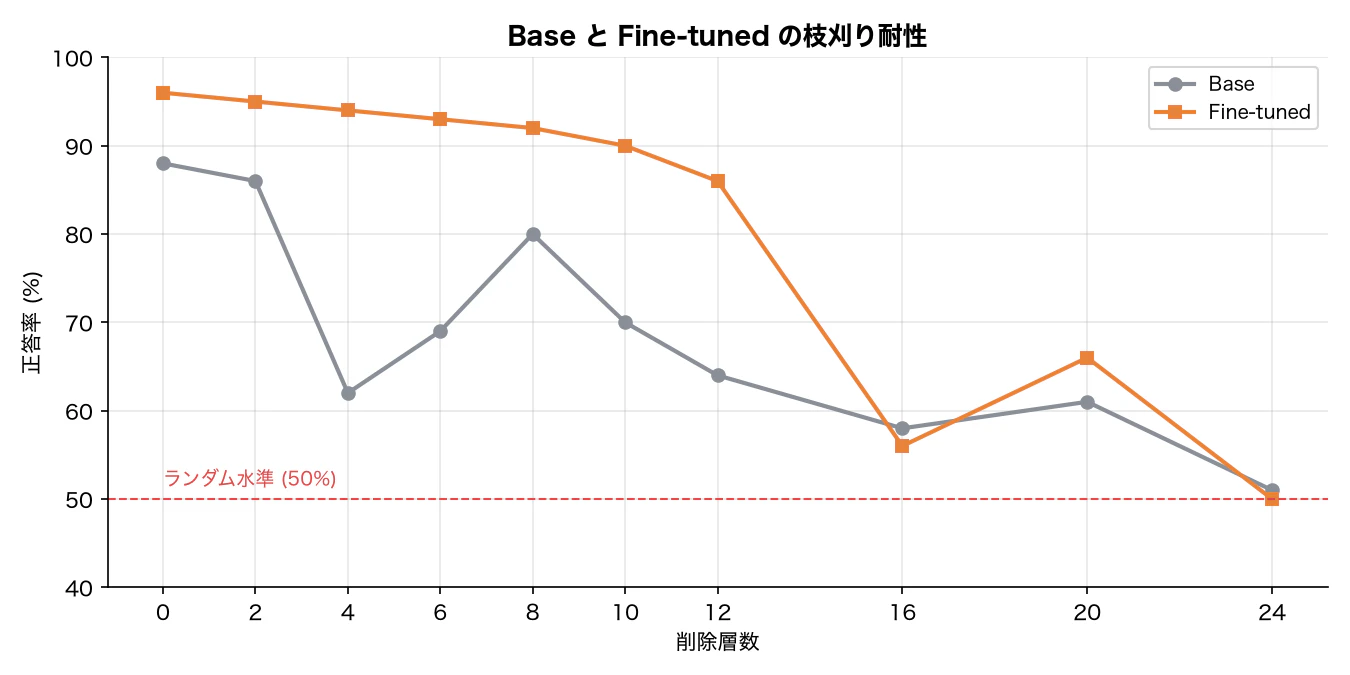
Base モデルは6層以上削ると大きく性能が低下しますが、Fine-tuned モデルは10層(25%)を削っても90%前後の正答率を保ちました。枝刈りへの耐性は、Fine-tuning で大きく向上しています。
ただし、24層(約6割)を削ると、Base も Fine-tuned も正答率がランダム水準まで落ちました。
重みの可視化: LoRA は何を変えたのか
耐性が上がった理由を探るため、LoRA が重みをどれだけ変えたかを $|ΔW|$ として可視化しました。


更新は特定の層に集中せず、40層すべてに薄く広がっていました。最も大きく変わった層と最も変化が小さかった層の差は約3倍で、重みの変化量はどの層でも1〜2%程度です。
学習の成果が全層に分散していたため、一部の層を削っても、残った層が欠けた役割を補えたのだと考えられます。
実験3: LoRA を「残す層」だけに絞るとどうなるか
全層に LoRA を適用すると、枝刈りで削られた層に入っていた更新も一緒に捨てられてしまいます。そこで、最後まで残る影響度上位の層だけに LoRA を適用すれば、追加学習した層が削られずに済むので、枝刈りへの耐性がさらに上がるのではないでしょうか?
そこで、影響度上位8層だけに LoRA を適用して学習し、全層に適用した場合と比べました。
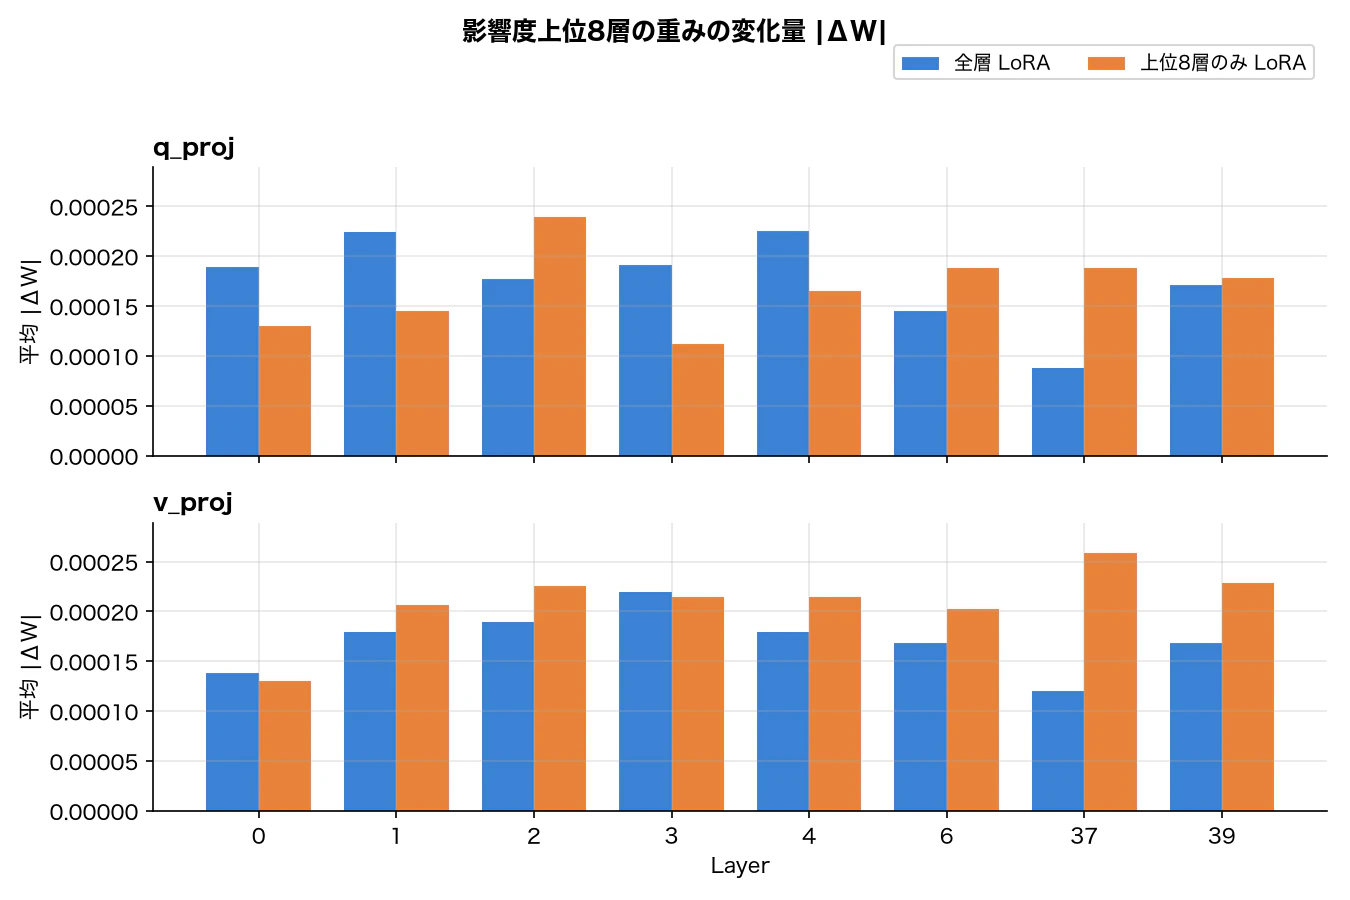
学習後も影響度上位8層の顔ぶれは変わりませんでした。また、この8層にしか LoRA を適用していないにもかかわらず、各層の更新の大きさは全層 LoRA で受けた更新とほとんど変わりませんでした。学習する層を減らしても、残った層の更新が大きくなって補うことはないようです。
枝刈り結果の比較

8層まで削る範囲では、学習パラメータを全層 LoRA の1/5に減らしても、同等の耐性を保てました。しかし10層以上を削ると、全層 LoRA に明確に負けました。正答率は、10層削除で全層 LoRA の90%に対して81%、12層削除で86%に対して59%でした。
残す層だけを学習する方法は、8層(全体の2割)までの浅い枝刈りなら十分に使えます。それより深く削るには、更新を全層に分散させた学習が必要です。
まとめ
Fine-tuning した LLM は、層を削っても性能の低下が緩やかでした。LoRA の更新が全層に薄く分散していたので、一部の層を削っても残った層が役割を補い、枝刈りに強くなったのではないでしょうか。
ところが、最後まで残る影響度上位の層だけに LoRA を適用すると、深く削ったときに全層に適用した場合に負けました。削られるのは LoRA を付けていない層だけなので、学習した更新が失われたわけではありません。それでも崩れたことから、「残る層だけを学習すればよい」という発想はうまくいかないようです。
枝刈りをしない状態や浅い枝刈りでは、上位8層だけに適用したモデルと全層に適用したモデルは、ほぼ同じ性能でした。層を削っていない状態の正答率は、前者が95%、後者が96%です。差が表に出たのは層を深く削ったときで、結果として全層に適用したほうが枝刈りへの耐性が高くなりました。LLM の言語能力は全層の連携で成り立っているため、特定の層だけを Fine-tuning すると、普段は問題なく動いても、層を削られたときに崩れやすくなるということなのでしょうか。
次は、層を削ったあとに追加学習を行う方法も試してみようと思います。