
はじめに
CREATE TABLE 文を貼り付けるだけで、その場でER図ができるWebツール「SketchDB」を作りました。
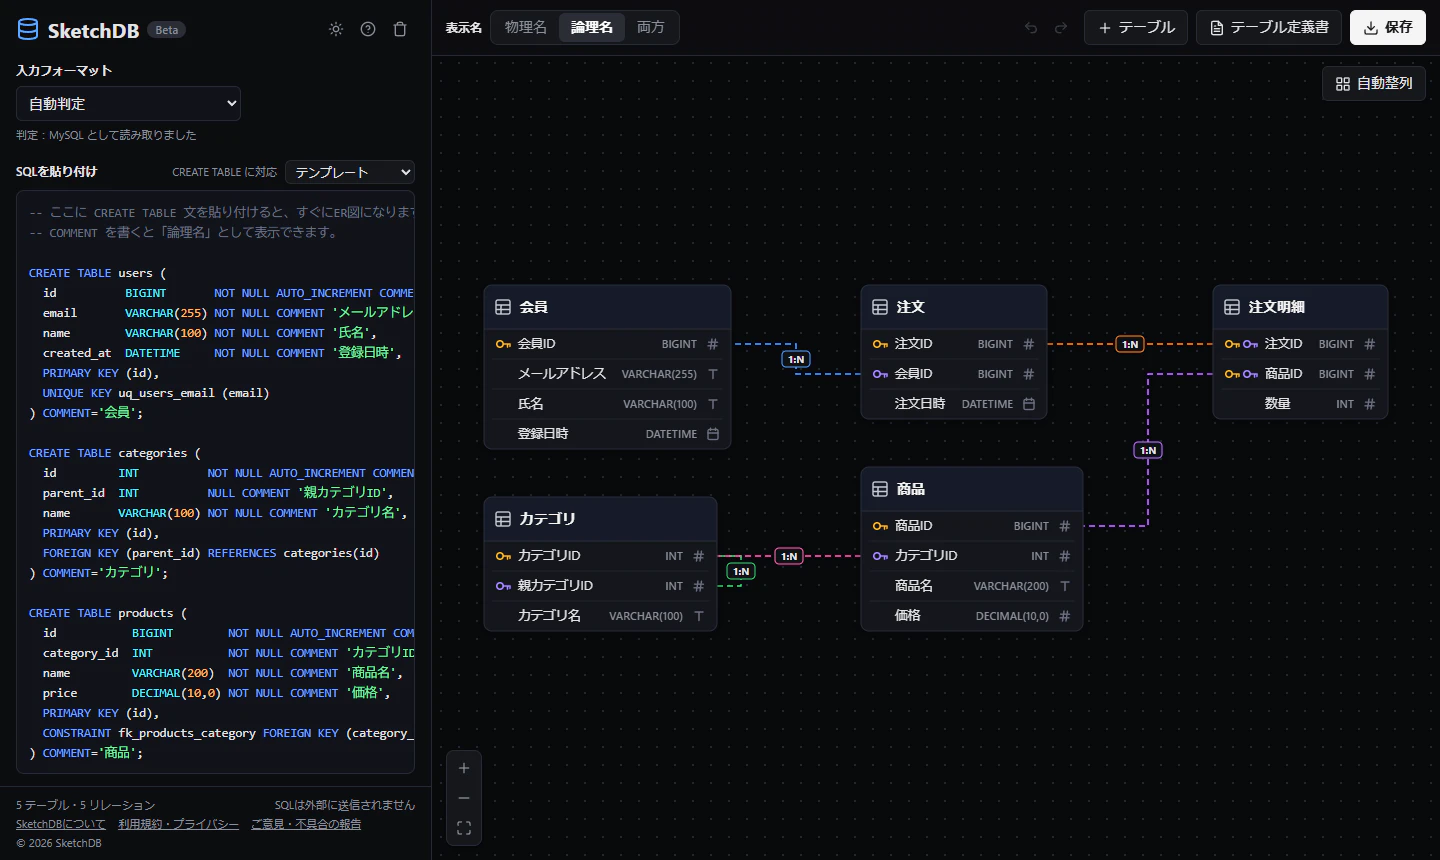
SketchDB は、次の3つを目標に作りました。
- SQLを外部のサーバーに送らず、ブラウザの中だけで処理する
-
COMMENTに書いた日本語名(論理名)を、図にそのまま出す - mysqldump や pg_dump の出力を、CREATE TABLE だけ抜き出さなくてもそのまま貼れる
できること
- MySQL・PostgreSQL・MariaDB・SQL Server・SQLite の CREATE TABLE からER図を作る(自動判定)
- mysqldump・pg_dump の出力、Rails の structure.sql などを、余計な部分を消さずにそのまま貼れる
-
COMMENT(SQL Server はMS_Description)を論理名として表示(物理名/論理名/両方を切り替え) - テーブル定義書(カラム一覧)を表示して、Markdown・CSV・PDF で保存
- ECサイトや SaaS 基盤などのテンプレートで、すぐに試せる
- 入力フォーマットを選んだまま別の方言のSQLを貼っても、自動判定に切り替えて読む
- 画面でテーブルを追加・編集・削除(左のSQLは、編集したテーブルの部分だけが書き換わる)
- テーブルの右端の ○ から別のテーブルへ線を引くと、外部キーができる。元に戻す・やり直し(Ctrl+Z / Ctrl+Y)もできる
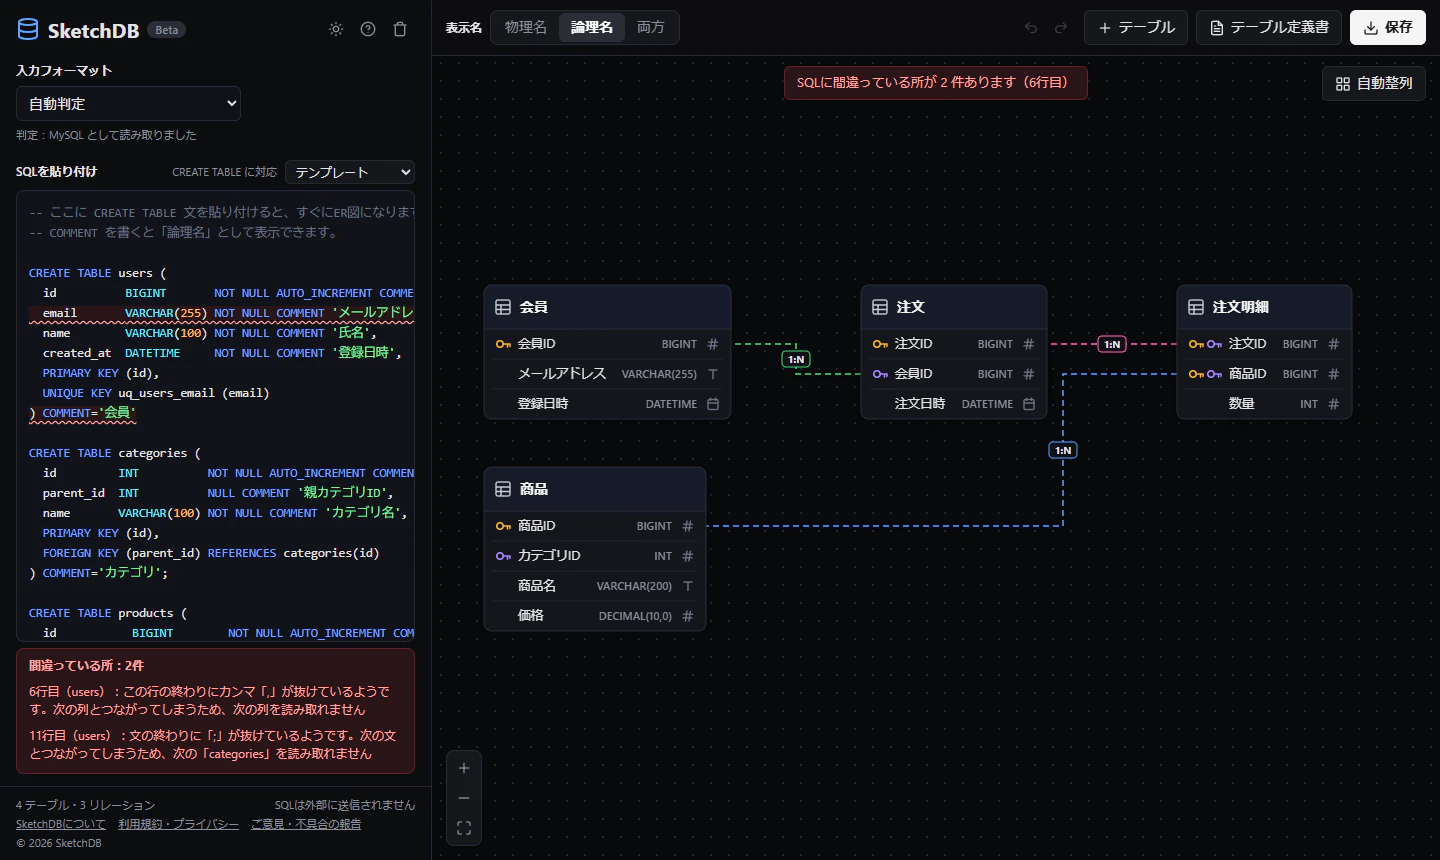
- SQLが間違っていたら、何行目のどこが悪いかを教える(
;やカンマの書き忘れも言い当てる) - テーブルはドラッグで移動、PNG / SVG で保存
- Mermaid でコピー(GitHub の README や Qiita に、そのまま図として貼れる)
- SQLはブラウザの外に送らない(後で書くように、ブラウザの仕組みで外部との通信を禁止しています)
構成
- Vite + TypeScript(フレームワークなし)
- SQLの解析:node-sql-parser
- 図:SVGを自前で描画
- 置き場所:GitHub Pages(サーバーなし)
node-sql-parser は全方言入りのビルドが 2.4MB と大きいので、使う方言のビルドだけを読み込んでいます。
import { Parser as MySqlParser } from 'node-sql-parser/build/mysql'
import { Parser as PostgreSqlParser } from 'node-sql-parser/build/postgresql'
図の色は CSS ではなく SVG の属性で指定しています。画面と、書き出した SVG / PNG の見た目を同じにするためです。
ここからは、作っていてハマったことを書きます。
ハマったこと1:ダンプをそのまま貼ると読めない
ダンプには CREATE TABLE 以外の文がたくさん入っています。
/*!40101 SET @OLD_CHARACTER_SET_CLIENT=@@CHARACTER_SET_CLIENT */;
DROP TABLE IF EXISTS `users`;
CREATE TABLE `users` ( ... ) ENGINE=InnoDB;
LOCK TABLES `users` WRITE;
INSERT INTO `users` VALUES (...);
これをまとめてパーサーに渡すと、どこか1か所でも読めない書き方があれば全体がエラーになります。そこで、自前で文ごとに区切り、ER図に関係する文だけをパーサーに渡すようにしました。
/** ER図に関係する文だけを解析する。INSERT や SET などは無視する */
const RELEVANT = /^(create\s+(temporary\s+|temp\s+|unlogged\s+)?table|alter\s+table|comment\s+on)\b/i
文の区切りでは、文字列・コメント・PostgreSQL の $$ の中にある ; で区切らないようにしています。1文ずつ解析するので、書きかけの文があっても、ほかのテーブルは表示され続けます。
pg_dump では、主キーや外部キーが CREATE TABLE の中ではなく、後ろの ALTER TABLE ONLY ... ADD CONSTRAINT で付きます。これも読んで、あとからテーブルに反映しています。
ハマったこと2:pg_dump のデータに ' があると、後ろが全部消える
pg_dump の出力には、COPY ... FROM stdin; のあとにデータがそのまま続く部分があります。
COPY public.customers (id, email, full_name) FROM stdin;
1	taro@example.com	山田 太郎
2	obrien@example.com	Pat O'Brien
\.
O'Brien の ' を文字列の始まりと読んでしまい、そこから後ろの文がすべて1つの文字列として飲み込まれていました。その結果、後ろにある ALTER TABLE ... ADD CONSTRAINT が全部消え、主キーも外部キーも無い図になっていました。
COPY ... FROM stdin; のあとは、\. の行までをまとめて読み飛ばすようにして解決しました。
ハマったこと3:PostgreSQL の独自の型が読めない
node-sql-parser は、自分で定義した型(CREATE TYPE ... AS ENUM)や、citext・hstore・PostGIS の geography などを含む CREATE TABLE を、丸ごと読めませんでした(5.4.0 で確認)。pg_dump の出力ではよく出てくる形です。
CREATE TABLE public.orders (
    id bigint NOT NULL,
    status public.order_status DEFAULT 'pending'::public.order_status NOT NULL
);
そこで、読めなかったときだけ、パーサーが知らない型を一時的に text に置き換えて読み直し、図には元の型名を表示するようにしました。
let ast = astify(stmt.text)
// パーサーが知らない型の列があれば、型を置き換えて読み直す。表示には元の型を使う
const relaxed = ast ? undefined : relaxTypes(stmt.text)
if (relaxed) ast = astify(relaxed.text)
'pending'::public.order_status のような型の変換も、同時に外しています。
ハマったこと4:SQL Server の外部キーが1本も読めない
SQL Server(SQL Server Management Studio が出力するスクリプト)に対応しようとしたところ、使ったバージョン(node-sql-parser 5.4.0)の SQL Server 用の部品では、FOREIGN KEY / REFERENCES が読めませんでした。列の横に書いても、テーブルの末尾に書いても、SSMS が出力する次の形でもエラーになりました。
ALTER TABLE [dbo].[Orders]  WITH CHECK ADD  CONSTRAINT [FK_Orders_Customers] FOREIGN KEY([CustomerId])
REFERENCES [dbo].[Customers] ([CustomerId])
GO
そこで、読めなかった文から外部キーの部分だけを自前で取り出し、残りをパーサーに渡すようにしました。あわせて、次のことにも対応しています。
-
;ではなくGOの行で文を区切る - 論理名を
EXEC sp_addextendedproperty @name=N'MS_Description', ...から読む(SQL Server には COMMENT が無いため)
ハマったこと5:「読めたかどうか」では方言を見分けられない
入力フォーマットは「自動判定」のほかに、方言を自分で選ぶこともできます。試していて、「PostgreSQL を選んだまま MariaDB のSQLを貼っても、表示が PostgreSQL のまま」なことに気づきました。図は出ているのですが、選んだ方言と中身が違うことに気づけません。
そこで「選んだ方言と明らかに違うSQLが貼られたら、自動判定に切り替える」ことにしました。最初は「選んだ方言の部品で読めなかったら違う方言」と考えたのですが、これがうまくいきません。
- PostgreSQL 用の部品は、MySQL の書き方もほぼ読めてしまう
- 逆に MariaDB 用の部品は、MariaDB 独自の書き方(
inet6型など)を読めないことがある
部品が読めたかどうかは、「どの方言か」の手がかりにならなかったのです。
結局、人が見分けるときと同じ方法にしました。その方言にしか出てこない書き方を数えるだけです。
/** その方言らしい書き方。1つにつき1点(何回出てきても1点) */
const MARKERS = {
  // MySQL と MariaDB に共通
  mysqlFamily: [/`[^`\n]+`/, /\bauto_increment\b/i, /\bengine\s*=/i, /\bunsigned\b/i /* ... */],
  postgresql: [/::\s*[a-z_]/i, /\b(?:big|small)?serial\b/i, /\bjsonb\b/i, /\$\$/ /* ... */],
  sqlserver: [/\[[A-Za-z_][^\]\n]*\]/, /^\s*go\s*$/im, /\bidentity\s*\(/i, /\bnvarchar\b/i /* ... */],
  sqlite: [/\bautoincrement\b/i, /\bwithout\s+rowid\b/i, /^\s*pragma\b/im /* ... */],
}
ただし、自動で切り替えるのは勝手に設定を変えることなので、間違えると迷惑になります。そこで、次の条件を付けました。
- 2つ以上の書き方が当てはまり、ほかの方言より点が多いときだけ切り替える(
CREATE TABLE a (id int)のような、どの方言とも言えないSQLでは何もしない) - MySQL と MariaDB の間では切り替えない(ほぼ同じ書き方なので、わざわざ選んだほうを優先する)
- SQLを貼ったとき・入力したときだけ切り替える。自分で方言を選び直したときは、その選択のまま読む
最後の条件は、実際にブラウザで操作して見つけました。最初は、方言を選び直した瞬間に「違う方言です」と判断され、自動判定に戻ってしまっていました。
切り替えたときは「判定:MariaDB として読み取りました(PostgreSQL とは違う書き方だったため、自動判定に切り替えました)」と理由を表示します。
ハマったこと6:長い名前を貼ると、画面が75秒固まる
公開前に「わざと変な入力をする人がいたら?」と考え、いろいろ試しました。すると、100万文字の名前を貼ると、画面が75秒固まることが分かりました。しかもSQLはブラウザに保存しているので、開き直すたびにまた固まります。
最初は「解析ライブラリが長い名前に弱いのだろう」と考えました。ところが、区切り処理だけを測ってみると、こうなりました。
| 文の長さ | 区切りにかかった時間 |
|---|---|
| 10万文字 | 0.1秒 |
| 20万文字 | 2.6秒 |
| 40万文字 | 12秒 |
長さが2倍になると、時間が4倍以上になっています。犯人は自分で書いた区切り処理でした。
while (i < sql.length) {
  // 文の先頭の空白・改行は開始行に含めない
  if (!current.trim()) startLine = line
  // ...
  current += ch
}
1文字進むたびに current.trim() を呼んでいます。trim() 自体は先頭の空白を見て終わるはずですが、+= で1文字ずつつなげた文字列は、trim() のたびに作り直しが起きているようで、文の長さに比例した時間がかかっていました。それを1文字ごとに行うので、全体では文の長さの2乗に比例します。
「空白以外の文字がもう出てきたか」を変数で覚えておくように直しました。
let started = false
// ...
if (!started) startLine = line
// ...
else if (!started && ch.trim()) started = true
これで、40万文字で12秒かかっていたのが11ミリ秒になりました。ライブラリを疑う前に、まず測るべきでした。
念のため、次の対策も入れています。
- 解析を Web Worker(画面とは別の処理)で行い、5秒を超えたら打ち切る。画面は固まらない
- 読み取れたSQLだけを保存する(開き直すたびに固まるのを防ぐ)
- 入力の上限(全体500万文字・1文10万文字)
ハマったこと7:「SQLを送信しない」をどう保証するか
「SQLは外部に送信されません」と書くだけなら簡単です。でも、それを信じてもらうには根拠がほしいと考えました。
そこで、公開用のページに Content-Security-Policy(CSP)を入れました。
default-src 'self'; script-src 'self'; connect-src 'none'; ...
connect-src 'none' により、このページから外部への通信(fetch など)をブラウザ自体が禁止します。万一、悪いスクリプトが紛れ込んでも、fetch や画像の読み込みを使ってSQLを送ることはできません(リンクで別のページへ移動することまでは止めないので、完全な保証ではありません)。実際に、ページの中から fetch('https://example.com/') を呼ぶとエラーになること、画像の読み込みを使った送信も止められることを確認しました。
script-src 'self' にしたので、ページの中に直接書いていたスクリプト(ダークモードのちらつきを防ぐもの)は動かなくなります。これは別のファイルに分けました。CSP は開発サーバーの自動更新とぶつかるので、ビルドのときだけ入れる小さな Vite プラグインにしています。
const csp = (): Plugin => ({
  name: 'content-security-policy',
  apply: 'build',
  transformIndexHtml: (html) =>
    html.replace('<head>', `<head>\n    <meta http-equiv="Content-Security-Policy" content="${CSP}" />`),
})
ハマったこと8:; を忘れると、テーブルが黙って消える
SQLが間違っているときは「○行目が読めません」と出していたのですが、試していて、次のように ; を1つ忘れると、エラーにすらならず、後ろのテーブルが黙って消えることに気づきました。
CREATE TABLE users (
  id BIGINT PRIMARY KEY
)            -- ← ; を忘れた

CREATE TABLE posts (
  id BIGINT PRIMARY KEY
);
原因は、ハマったこと3や4で入れた「読めなかったら書き直して読み直す」仕組みでした。読み直しのどこかで無理に読めてしまい、2つの文が1つのテーブルとして扱われていたのです。カンマを忘れたときも同じで、次の列が前の列の型の一部として飲み込まれ、列が1つ消えていました。
そこで、この2つは解析部品に任せず、自前で見つけるようにしました。
-
;忘れ:かっこの外で、行の先頭にCREATEやALTERが来たら、前の文の終わりに;が抜けていると見なす -
カンマ忘れ:列の定義の途中の行が「名前 型」(
name VARCHAR(100)など)で始まっていたら、前の行の終わりにカンマが抜けていると見なす。NOT NULLやREFERENCESのように、何行かに分けて書く続きの行は除く
もう1つ、エラーの行番号も直しました。今までは「その文が始まる行」を出していたので、20行ある CREATE TABLE の15行目が間違っていても「1行目」と出ていました。解析部品のエラーには、止まった位置(location)が入っているので、そこから実際の行を出すようにしています。間違った行には、SQL欄で赤い波線を付けています。
画面での編集:貼ったSQLを壊さずに書き戻す
図のテーブルをダブルクリックすると、列の追加や名前の変更ができ、左のSQLも書き換わるようにしました。
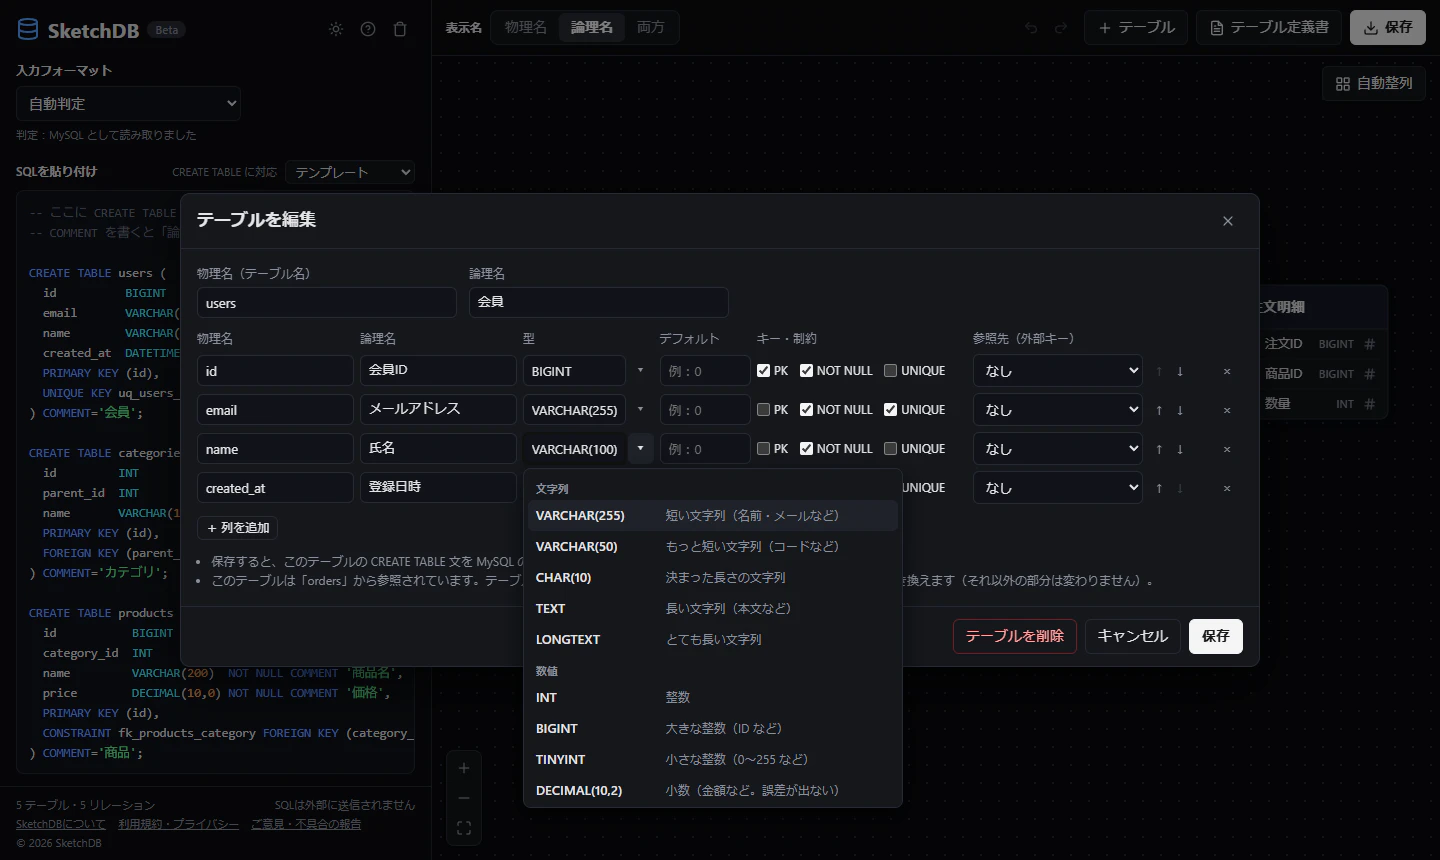
難しかったのは「SQLへの書き戻し」です。編集した内容からSQL全体を作り直すのは簡単ですが、それをすると、貼ったダンプの書き方やコメント、INSERT などが全部消えてしまいます。
そこで、編集したテーブルに関係する文だけを置き換え、ほかの文には触らないようにしました。文の区切り(ハマったこと1)で、それぞれの文が元のSQLのどこからどこまでかを覚えておき、次の文だけを書き換えます。
- そのテーブルの
CREATE TABLE(新しい内容に置き換える) - そのテーブルへの
COMMENT ON(PostgreSQL)、主キー・外部キーを足すALTER TABLE(pg_dump の形)、MS_DescriptionのEXEC(SQL Server)は、新しいCREATE TABLEに含めるので消す
書き直すときは、元のSQLの方言に合わせます。論理名なら、MySQL は COMMENT '…'、PostgreSQL は COMMENT ON、SQL Server は MS_Description です。SQLite には論理名を書く場所が無いので、-- のコメントとして残すだけにしています。
実際のダンプ5種類(mysqldump、MariaDB、pg_dump、SSMS、SQLite)で1つのテーブルを書き直し、次の2点をテストで確かめています。
- 図の中身が変わらないこと
- ほかのテーブルの文や
INSERTが1文字も変わらないこと
ハマったこと9:何も変えずに保存したのに、AUTO_INCREMENT が消えた
編集画面の「列の並べ替え」を試していたとき、保存したSQLを見て気づきました。
-- 元のSQL
id BIGINT NOT NULL AUTO_INCREMENT COMMENT '会員ID',
-- 保存したあと
id BIGINT NOT NULL COMMENT '会員ID',
編集画面で扱っているのは、名前・論理名・型・デフォルト値・主キー・NOT NULL・UNIQUE・参照先だけです。書き直すときにそれしか書かないので、画面に出していない部分が全部消えていました。AUTO_INCREMENT のほかにも、ON UPDATE CURRENT_TIMESTAMP、索引(KEY idx_name (name))、ON DELETE CASCADE、ENGINE=InnoDB などです。
そこで、元の CREATE TABLE から「画面では扱わない部分」を取り出しておき、書き直すときに付け直すようにしました。列の名前を変えたときは索引の中の列名も直し、列を消したときはその列を使う索引も消します。
これを確かめるために、手元の実例・試験用SQL 14本のすべてのテーブルを「何も変えずに保存」して、図も書き方も変わらないことをテストにしました。このテストで、ほかにも消えていたものが見つかりました。
- スキーマ名(
public.customersがcustomersになる)。図は同じでも、データベースで実行すると別の場所にテーブルができてしまう - 制約の名前(
customers_pkey、fk_orders_userなど) - 型に付いたスキーマ名(
public.order_status)
pg_dump は主キーや外部キーを後ろの ALTER TABLE で付けるので、そこからも名前を読み、書き直すときは CREATE TABLE の中にまとめています。
-- pg_dump の orders を、何も変えずに保存したあと
CREATE TABLE public.orders (
  id bigint NOT NULL,
  customer_id bigint NOT NULL,
  status public.order_status DEFAULT 'pending'::public.order_status NOT NULL,
  ...
  CONSTRAINT orders_pkey PRIMARY KEY (id),
  CONSTRAINT orders_customer_id_fkey FOREIGN KEY (customer_id) REFERENCES public.customers (id)
)
「図が同じなら大丈夫」ではなく、「書き戻したSQLをそのまま使えるか」まで確かめないといけないと分かりました。
図の上で線を引いて、外部キーを作る
テーブルにマウスを乗せると、右端に ○ が出ます。○ から別のテーブルへドラッグすると、外部キーができます。
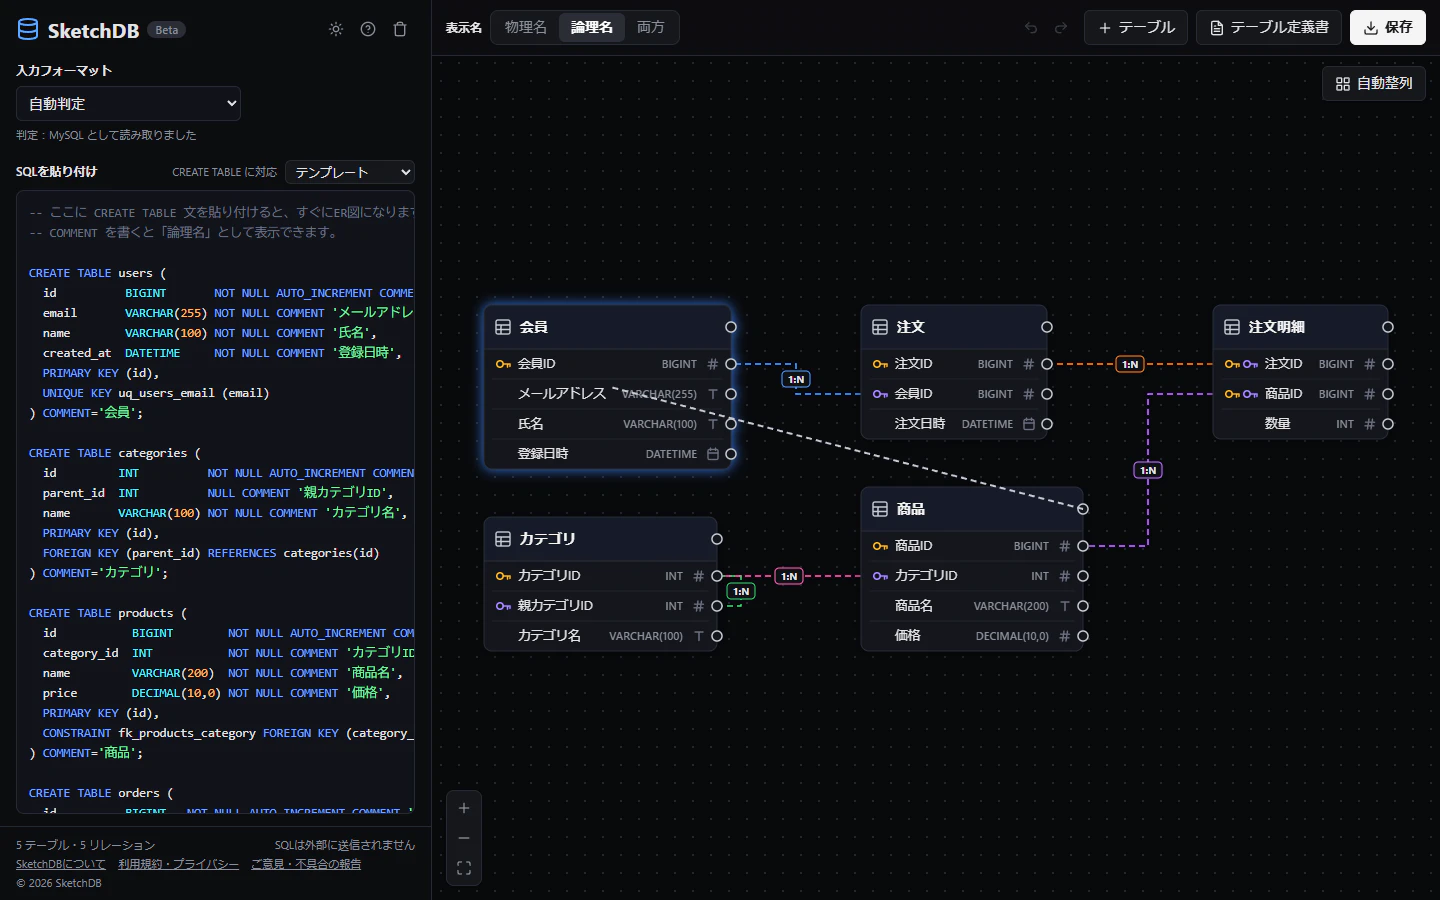
- 列の ○ から引くと、その列が相手のテーブルの主キーを参照する
- テーブル名の ○ から引くと、
相手_idという列を足して、相手の主キーを参照する(型は相手の主キーにそろえ、SERIALならINTEGERにする) - 自分自身に引くと
parent_id(カテゴリの親子など)
テーブルの移動もドラッグなので、○ の上で押したときだけ線を引くようにしています。○ は画面にだけ出し、書き出す画像には入れません。
あわせて、次のものも作りました。
- 元に戻す・やり直し:画面での編集の履歴を持ち、SQLとテーブルの位置をいっしょに戻す。SQL欄に手で文字を打ったら履歴は消す(古い状態に戻して、打った分を消してしまわないため)
-
名前を変えたら、参照しているテーブルも直す:ほかのテーブルの文は作り直さず、
REFERENCES 表 (列)の名前の部分だけを書き換える(クォートや空白は元のまま)
図の工夫:線の重なりを減らす
テーブルが増えると、線がテーブルの裏を通ったり、何本も同じ場所に重なったりして読みにくくなります。次の3つで減らしています。
- 線は「横→縦→横」に曲げる。同じ縦の位置を通る線が重なるときは、少しずつずらす
- 線がほかのテーブルの裏を通るときは、曲がる位置をずらすか、テーブルの無い高さを通る道に変える
- 自動整列では、テーブルを「つながっている相手の位置の平均」の順に並べ替える。これを左右に4往復くり返して、線の交差を減らす
ドラッグ中も毎回計算し直していますが、100テーブルでも1回25ミリ秒ほどで終わります。
テスト:実際によくあるSQLを集める
自分で書いたきれいなSQLだけで試していると、ハマったこと2や3には気づけません。そこで、よく見かける形のSQLを集めて、テストにしました。
- mysqldump の出力(
/*!40101 */、LOCK TABLES、INSERT) - pg_dump の出力(
COPY、ALTER TABLE ONLY、COMMENT ON、独自の型) - Rails の structure.sql、Laravel のスキーマダンプ、WordPress のテーブル
- 手書きでよくある形(小文字、クォートの混在、列の横の
REFERENCES) - 40テーブル・100テーブルの大きなスキーマ
それぞれ「テーブル数・リレーション数・エラー0件」を確かめています。
ただ、これらは読めるように直してきたSQLなので、「その例に合わせただけ」かもしれません。そこで、調整に一度も使っていない新しいSQLを、方言ごとに1つずつ書きました。それぞれの方言らしい書き方をわざと多めに入れています。5つのSQLを、入力フォーマット6通り(自動判定と5方言)で読ませる、計30通りの実験をしました。
その結果、PRIMRY KEY のような書き間違いを「知らない型」として受け入れてしまう不具合が見つかりました。今は30通りすべてで、自動判定と同じテーブル・リレーションになることを、テストで確かめています。あわせて、意地の悪い入力(深い括弧、閉じない文字列、; の大量入力、ランダムな文字列500通りなど)でも、例外を投げずにすぐ終わることを確かめています。
おわりに
まだ Beta です。今後は、URLで図を共有する機能、Prisma Schema への対応、テーブル定義書の Excel 出力などを考えています。
「このSQLが読めなかった」「こういう機能がほしい」などがあれば、ツールの中の「ご意見・不具合の報告」から教えてもらえると、とても助かります。
更新履歴
- 2026-10-29:画面でのテーブル編集、間違っている所の表示、Mermaid 書き出しを追加し、「ハマったこと8」と「画面での編集」の節を書き足しました
- 2026-10-30:線を引いて外部キーを作る機能、元に戻す・やり直しを追加し、「ハマったこと9」と「図の上で線を引いて、外部キーを作る」の節を書き足しました