
本稿は、Qiitaの連載「Geometric Intelligence論への招待」の第4回目の記事です。
第4回となる今回 は、時計の針を少し戻します。
そもそも、本物の社会経済データから、どうやって地図を作るのか?
データを選び、データの乱れを手当てし、3つの条件に合格させるまでの道のりを紹介します。
この記事の想定読者

- 企業や官庁で働く、Python機械学習エンジニア
- 経営コンサルタント
- 政策コンサルタント
- 機械学習(AI)とAIエージェントに明るい、国会議員の政策スタッフ・秘書
上記の方々に加えて、数学の位相幾何学や微分幾何学など、高度な数学の知見を、
- 企業や政府機関の経営(政策)環境分析
- 経営施策(政策)の予測効果測定
- 経営戦略(政策)立案
に使える道具として応用することにご関心をお持ちの研究者・Research Scientistの方々なども想定しています。
この記事を読んで得られるもの
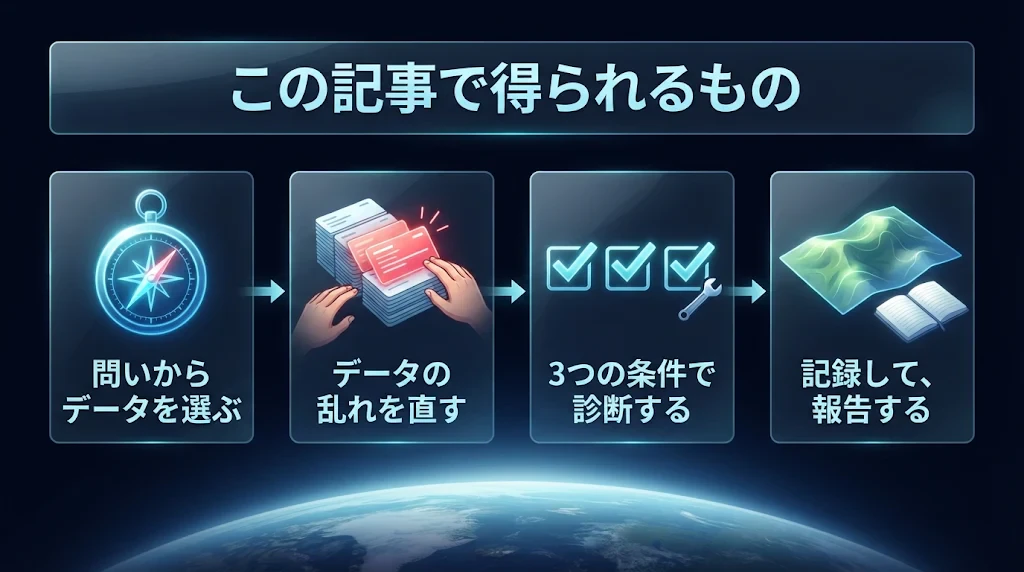
- 地図に入れるデータを、分析の問いから逆算して選ぶ考え方
- 実データでよく起きる問題(名寄せ、粒度の違い、単位の違い、欠測、外れ値、更新の遅れと改定、構造の変化、外に出せないデータ)と、それぞれの手当て
- 3つの条件のどれに落ちたかで、原因の見当をつけ、直す方法
- KL情報量の重みを変えたときの引き換え(第2回・第3回の結果のまとめ)
- 業界や政策領域ごとのデータの制約と、試行錯誤の型(架空のケーススタディ)
- 金融、製造、エネルギーの業界で、地図に何を入れ、何を「高さ」に選ぶかの設計の案
- 試行錯誤の記録の残し方
- 乱れたデータで、前処理の違いが3つの条件をどう変えるかを確かめるPythonのコード(JAX)
- よくある誤解と、地図の作り方を報告するときに必ず書くこと
① 第3回までの振り返り ── 地図があることを前提にしてきた
第1回から第3回までは、3つの条件に合格した地図があることを前提に 話を進めてきました。
-
第1回:地図に定規(リーマン計量)を当ててよいかを、3つの条件で確かめる
-
第2回:地図の上で、いま立っている場所のかたちを読む
- 第3回:地図の上で、どう動くかを決める
第2回と第3回のPythonの実験では、球の表面や馬の鞍の形のように、答えが分かっている、きれいなデータを使いました。
本物の社会経済データ は、そうはいきません。
- 値が欠けています。
- 単位も桁もばらばらです。
- 入力の誤りによる、とんでもない値が混ざっています。
- 月ごとのデータと、四半期ごとのデータが混ざっています。

そうしたデータをそのままVAEに入れても、3つの条件には合格しません。
今回(第4回)ご紹介する のは、乱れたデータから、条件に合格する地図を作るまでの道のりです。

図:乱れたデータから、条件に合格する地図を作るまでの道のり
② 何を地図に入れるか ── 問いから逆算する
データは、問いから選ぶ
地図に入れるデータは、「手に入るデータ」から選ぶのではありません。
「地図で何を問いたいか」から、逆算して選びます。
- 問いが「どの事業が、崖に近づいているか」なら、事業ごとの売上や利益だけでなく、その事業を取り巻く外の環境のデータも必要です。
- 問いが「どの施策を、どの順番で行うか」(第3回)なら、過去に施策を打った時点の前後のデータが必要です。
3種類のデータ
本稿執筆者は、地図に入れるデータを、次の3種類に分けて考えています。
| 種類 | 中身 | 例 |
|---|---|---|
| 内部の構造のデータ | 自分の組織の中のデータ | 事業ごとの売上・費用・在庫、人員、設備の稼働、顧客の数 |
| 外部の環境のデータ | 組織の外のデータ | 市場の価格、為替、取引先の状況、規制の動き、競合の動き |
| 過去の大きな出来事のデータ | 地形を大きく変えた出来事の記録 | 感染症の流行、戦争、大きな災害、制度の変更の時期と大きさ |
3種類目の「過去の大きな出来事のデータ」は、見落とされがちです。
けれど、第2回の「転換点」や、第3回の「施策の流れ」を読むには、地形が大きく変わった時点の記録が欠かせません。
次元と時点の数のつり合い
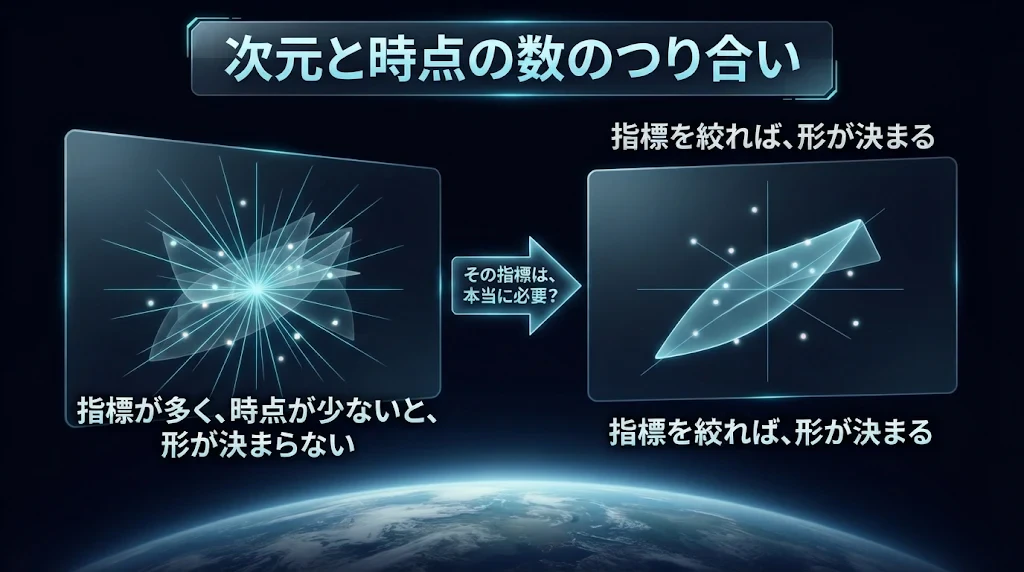
指標を増やすほど、地図の次元は増えます。
けれど、時点の数(月次なら月の数)が少ないままだと、地図の形を決めきれません。
社会経済データでは、時点の数が少ないことが多いので、指標を増やしすぎないことが大切です。
指標を増やす前に、「その指標は、問いに答えるのに本当に必要か」を確かめます。
③ 実データの問題と、手当て
本物の社会経済データでよく起きる問題と、手当ての方法を、1つの表にまとめます。
| 問題 | 中身 | 手当て | 影響しやすい条件 |
|---|---|---|---|
| 名寄せ | 同じ取引先や同じ製品が、部署やシステムによって別の名前で記録されている | 名寄せの規則を決め、対応表を作る。自動の照合の結果は、人が確かめる | 条件1・2 |
| 時系列の粒度の違い | 日次、月次、四半期、年次のデータが混ざっている | 共通の粒度にそろえる。細かいデータは集計し、粗いデータは補間する場合、補間した印を残す | 条件1・2 |
| 分類の粒度の違い | 部署ごとに、製品や地域の分け方が違う | 共通の分類の表(データ辞書)を作り、分類を対応づける | 条件1 |
| 単位と桁の違い | 円、千円、百万円、比率、件数が混ざっている | 単位をそろえる。金額のように右に長く裾を引く指標は、対数をとる。そのうえで、指標ごとに標準化する | 条件1・2 |
| 欠測 | 値が欠けている | 欠け方を調べる(偶然に欠けたのか、理由があって欠けたのか)。欠けた値を0や平均で埋めて、何も印を残さない、ということは避ける | 条件1・2 |
| 外れ値 | 入力の誤りや、一度きりの出来事で、とんでもない値が混ざる | まず原因を調べる。入力の誤りなら、欠けた値として扱う。本当に起きた出来事なら、残して印を付ける | 条件1・2 |
| 更新の遅れと改定 | 統計や決算の数字が、遅れて公表され、あとから改定される | いつの時点で、どの版の数字が手に入っていたかを記録する。過去の分析を、あとから改定された数字で検証しない | 条件の外側(分析の正しさ) |
| 構造の変化 | 制度の変更、定義の変更、大きな出来事で、データの意味が変わる | 変化の時点の記録を残す。変化の前後で、指標の定義がそろっているかを確かめる | 条件2・3 |
| 外に出せないデータ | 機密、個人の情報、国の外に出せないデータ | 集計した値や、差の値だけを持ち出す。データを出さずに計算する仕組みを使う | 学習の前提 |
| 時系列の学習と検証の分け方 | 時系列を無作為に分けると、未来の情報が学習に混ざる | 学習には過去、検証には未来の時点を使う。時間の順番で分ける | 条件の外側(検証の正しさ) |
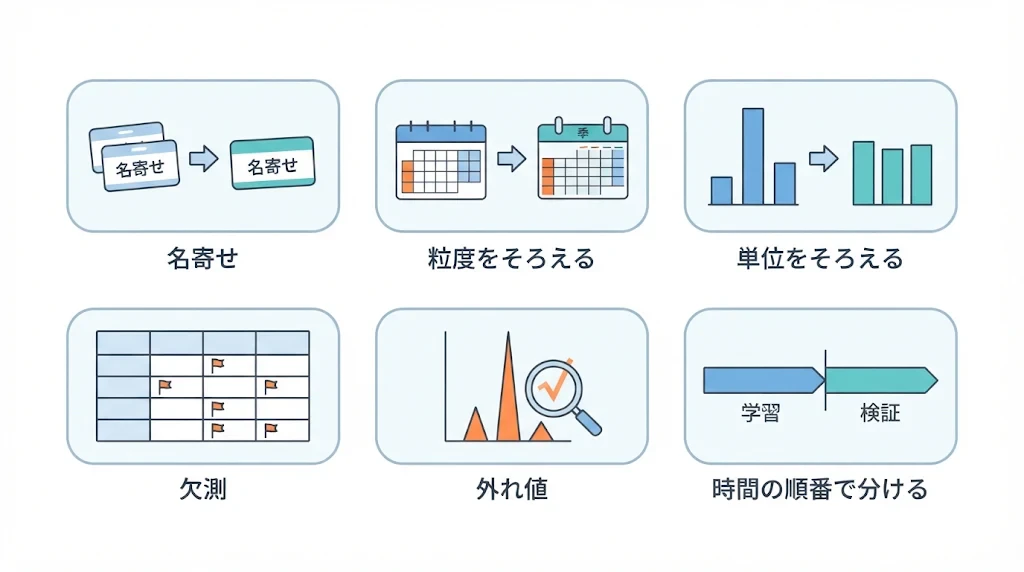
図:実データでよく起きる問題と対応策(手当て)
欠測は、欠け方を調べる
欠測の手当ては、欠け方によって変わります。
統計学では、欠け方を、次の3つに分けて考えます(Rubin, 1976)。
-
完全に偶然に欠ける:欠けるかどうかが、どの値とも関係しない。
-
観測された値によって欠ける:欠けるかどうかが、ほかの観測された値で説明できる(たとえば、小さな事業部ほど報告が遅れる)。
- 欠けた値そのものによって欠ける:欠けるかどうかが、欠けた値そのものと関係する(たとえば、業績の悪い月ほど報告されない)。
3つ目の場合、欠けた値を埋める方法をどれだけ工夫しても、偏りは消えません。
欠け方の理由を、現場の担当者に聞いて確かめることが、統計の操作より先に必要です。
VAEには、欠けた値を損失の計算から外して学習する方法があります(Mattei と Frellsen, 2019。Nazábal ほか, 2020)。
値を補ったうえで、「どの値が欠けていたか」を示す0と1の列を別に作り、入力のデータに加える方法もあります。
「この値は欠けていた(1)/欠けていなかった(0)」という印の列です。
欠け方そのものに意味がある場合、その情報も地図に反映できます。
たとえば、景気の悪い地域ほど統計の報告が遅れて値が欠けやすいなら、欠けていたという事実そのものが、地域の状態を表す情報になります。
この印を加えておけば、その情報を捨てずに、地図に反映できます。

外れ値は、切り詰める前に原因を調べる
外れ値を、上限と下限で切り詰める(ウィンソライズする)方法は、よく使われます。
けれど、入力の誤りによる外れ値は、切り詰めても誤った値のままです。
入力の誤りだと分かった値は、切り詰めるより、欠けた値として扱うほうが正直です。
本当に起きた出来事による外れ値(感染症の流行の月の売上の急減など)は、地形の大事な情報なので、消してはいけません。
⑧のPythonの実験で、この違いを数字で確かめます。
④ 3つの条件に落ちたときの直し方
第1回で紹介した3つの条件は、合格か不合格かを判定するだけの道具ではありません。
どの条件に落ちたかで、原因の見当がつく道具でもあります。
| 落ちた条件 | よくある原因 | 直し方 |
|---|---|---|
| 条件1:再構成の誤差が大きい | 単位や桁がばらばら。外れ値に引きずられている。欠けた値を0で埋めて学習している。デコーダの表現力が足りない | 単位をそろえ、標準化する。外れ値の原因を調べる。欠けた値を損失の計算から外す。デコーダを大きくする、学習を長くする |
| 条件2:近いものが近くに写らない(KNN保存率が低い) | 欠けた値の埋め方が、近さをゆがめている。データが「島」に分かれている。KL情報量の重みが小さすぎる | 欠けた値の印を残して学習する。粒度や定義をそろえる。KL情報量の重みを大きくする(ただし再構成の誤差とのつり合いを見る) |
| 条件3:縮尺が潰れる方向がある(最小特異値が小さい) | 潜在空間の次元が多すぎて、使われない方向がある。指標の実質的な情報が足りない。動きを失った指標がある | 潜在空間の次元を減らす。独立に動く指標を加える。動きのない指標を外す |
KL情報量の重みとの引き換え
第2回と第3回の実験で、KL情報量の重み $\beta$ を変えたときの引き換えを見てきました。
| 記事 | 実験 | $\beta$ が小さいとき | $\beta$ を大きくしたとき |
|---|---|---|---|
| 第2回 | 球の表面 | $\beta = 0.001$:再構成の誤差 0.00001、KNN保存率 0.895(不合格) | $\beta = 0.05$:再構成の誤差 0.00039、KNN保存率 0.961(合格) |
| 第3回 | 丘のある地形 | $\beta = 0.01$:測地線の長さの誤差は小さいが、KNN保存率 0.844(不合格) | $\beta = 0.05$:KNN保存率 0.917(合格)。地図がわずかになめらかになり、丘が少し低く写る |
- $\beta$ を大きくすると、潜在空間の並び方が整い、条件2に合格しやすくなります。
その代わり、細部の正確さ(再構成の誤差、丘の高さ)が少し落ちます。
- $\beta$ を大きくしすぎると、潜在空間の一部の方向が使われなくなり(事後分布の崩壊)、条件3に落ちることもあります(Bowman ほか, 2016)。
条件に合格させるために、何を少し犠牲にしたかを、必ず記録に残します(⑦)。
⑤ 業界や政策領域ごとのデータの制約と、試行錯誤の型
繰り返しますが、以下は、本稿執筆者が書いたフィクションのストーリーの設定です。
実在する企業や政府機関の実データを使って得られた知見ではありません。登場する企業、組織、人物、数値は、すべて架空のものです。
それぞれのケーススタディの掲載先(本稿執筆者の GitHub リポジトリ)の URL は、本稿の末尾の「本稿で触れた GI理論とケーススタディ」に、一覧表として載せています。
本稿執筆者は、業界別・政策領域別の架空のケーススタディで、データの制約と、条件に合格するまでの試行錯誤を描いてきました。
制約の型 と、克服の型 をまとめると、次のようになります。
| データの制約の型 | 影響した条件 | 克服の型(架空のケーススタディ) |
|---|---|---|
| 一度きりの体制の断絶(感染症の流行、英国のEU離脱など) | 条件2・3 | 移り変わりの期間の細かいデータと、制約つきの Neural ODE(繊維メーカー)。変化の度合いを連続の変数にして補間する(英国の国家レジリエンス) |
| 周期的な構造の変化(半導体の景気の波など) | 条件2・3 | 周期の位相を cos と sin の2つの指標にして加える(半導体製造装置メーカー、日本の経済安全保障) |
| データの単位の離散性、システムの分断(案件ごとの別管理など) | 条件2・3 | 企業全体の月次の指標に変換し、主成分分析で共変動を保つ(ゼネコン) |
| 粒度の極端な違い(秒単位の装置のデータと、月次の経営のデータ) | 条件1・2 | 2層の構成(ゼネコン、半導体製造装置メーカー)。共通の粒度(四半期)にそろえる(8か国の情報機関の協力) |
| 人が決めた設定値の断絶 | 条件2 | 自然法則が決める物理量で記述し直す(半導体製造装置メーカー) |
| 尺度と定義の不統一 | 条件1 | データ辞書による統一(日本の経済安全保障)。名寄せと、分野ごとの標準化(8か国の情報機関の協力) |
| 顧客ごと、機密区分ごとの壁 | 学習の前提 | 隔離した区画での処理と、情報源を明かさない特徴量への変換(繊維メーカー、半導体製造装置メーカー) |
| 国境を越えて共有できない | 学習の前提 | 共有する指標の範囲を分け、連合学習を使う(8か国の情報機関の協力) |
| 時点の数の不足 | 条件1〜3 | 週次・日次の指標を軸にして時点を増やし、補間した印を付ける(日本の経済安全保障、英国の国家レジリエンス) |
| データの極端な不足(事故の記録が数件しかない) | 条件3 | シミュレーションで補い、正則化をかける(北極海の海上保険) |
| 不都合なデータの削除(検閲) | 条件3 | 正直なデータでなければ解決しない。次元を下げて「合格」させることは、現実を見ないことの選択になる |
最後の行は、特に大切です。
条件に合格させること自体が目的になると、都合の悪いデータを外して「合格」させる、という誘惑が生まれます。
合格の数値は、データが正直であって初めて意味を持ちます。

図:データの制約は、業界や組織の構造そのものを映している
⑥ 業界別の地図の設計の案 ── 金融、製造、エネルギー
ここまでの考え方を、3つの業界に当てはめると、地図の設計 は次のようになります。
以下は、本稿執筆者が考えた設計の案です。
実在の企業で使われていることを示すものではありません。
| 業界 | 地図に入れるデータ(例) | 第2回の「高さ」の候補 | 第3回の道筋で問うこと | データの手当てで特に注意すること |
|---|---|---|---|---|
| 金融 | 銘柄や債券の価格と相関、市場の流動性の指標 | 市場の変動の大きさ、市場全体が混乱する危険の度合い | 市場が大きく崩れる前ぶれ(回復の遅れ、第2回)が出たとき、どの資産に、どの順番で組み替えるか | 銘柄の新規上場や上場廃止による名寄せ。取引のない日の欠測。暴落の日の値は、入力の誤りではないので消さない |
| 製造 | 部品の供給網、物流の経路、工場の稼働の能力、在庫 | 製品の供給が止まったときの損失、在庫が切れる確率 | 拠点が被災したとき、代わりの経路と生産の手順を、どの順番で組み立てるか | 秒単位の装置のデータと、月次の経営のデータの粒度の違い。取引先の名前の名寄せ |
| エネルギー | 化石燃料の需要、再生可能エネルギーの費用、炭素の価格、技術の進展の度合い | 資産の価値が損なわれる危険(座礁資産)、将来の収益性 | 技術の転換が進むなかで、どの時点で投資の向きを切り替えるか | 制度の変更(炭素の価格の導入など)による構造の変化。年次の公開データしかない指標の時点の少なさ |
どの業界でも、次の2つを守ります。
-
小さく始める:最初から、すべての指標を地図に入れようとしないこと。たとえば「為替」と「在庫」のように、問いに直結する少ない指標から始め、3つの条件に合格することを確かめてから、指標を少しずつ加えます。②の「次元と時点の数のつり合い」のためです。
- 結果を、自分の言葉で説明できるまで確かめる:地図が示した道筋(第3回)が、なぜその道を通るのかを、意思決定する人が自分の言葉で説明できるまで、条件を変えて計算を繰り返します。説明できない結果は、そのまま判断の材料にしません。

図:業界ごとに、地図に入れるデータと「高さ」の選び方は変わる(本稿執筆者の設計の案)
⑦ 試行錯誤の記録の残し方
地図を作る作業は、一度で終わりません。
条件に落ち、原因を調べ、直し、また確かめる、という試行錯誤を繰り返します。
その記録を残すことが、地図の信頼を支えます。
記録には、次の項目を残します。
| 項目 | 中身 |
|---|---|
| データの版 | どのデータを、いつの時点の版で使ったか(改定の前か後か) |
| 前処理 | 名寄せ、粒度、単位、標準化、欠測、外れ値の手当てを、どの規則で行ったか |
| 補ったもの | 補間した値、シミュレーションで補った値。補った印を付けた場所 |
| 捨てたもの | 外した指標、外した期間、外した値。外した理由 |
| モデルの設定 | 潜在空間の次元、KL情報量の重み、学習の長さ、乱数の種 |
| 条件の結果 | 3つの条件の値と、合格・不合格 |
| 次に試すこと | 不合格の原因の見当と、次の手 |
補ったもの(補間、シミュレーション)は、本物のデータが手に入りしだい照らし合わせ続けます。
捨てたもの(指標、期間、値)は、地図から見えなくなった現実として、報告書に明記します。
⑧ Pythonで確かめる ── 乱れたデータで、前処理の違いを比べる
本物の社会経済データでは、正解が分かりません。
そこで、第2回と同じく、答えが分かっている形を使います。
ただし今回は、その形を、わざと乱れたデータに変えます。
実験の設定
- 第2回と同じ馬の鞍の形の点(3,000点)を、距離を保ったまま10個の指標に写します(乱れのないデータ)。
- 実データでよく起きる乱れを、次のように加えます。
- 3つの指標は、金額のように右に長く裾を引く形にする
- 10個の指標の単位と桁を、100分の1から100万倍まで、ばらばらにする
- 全体の1%の値を、入力の誤りのように、20倍や−20倍にする
- 全体の10%の値を、ばらばらに欠けさせる
- 3つの指標は、四半期にしか観測されないことにする(3回に2回は欠ける)
- 次の前処理を比べます(KL情報量の重みはすべて $\beta = 0.05$)。
| 前処理 | 中身 |
|---|---|
| 参考:乱れのないデータ | 乱れを加える前のデータ(実務では手に入らない。比べるための目安) |
| (A) 0で埋めるだけ | 欠けた値を0で埋め、ほかは何もしない |
| (B) 標準化だけ | 指標ごとに平均0・標準偏差1にそろえ、欠けた値を0(平均)で埋める |
| (C) 手当て一式 | 裾の長い指標の対数をとる。中央値と四分位範囲で標準化する。標準化した値が±5を超えるものは外れ値として欠けた値に回す。欠けた値は損失の計算から外す |
| (D) (C)+欠測の印 | (C) に加えて、「どの値が欠けているか」の印もエンコーダに渡す |
| (E) (D)+粒度をそろえる | (D) に加えて、四半期の指標が観測された時点だけを使う(1,000点) |
条件2のKNN保存率は、前処理したデータの近さと、潜在空間の近さを比べます。
欠けた値は、距離の計算から除きます。
さらに、答えが分かっているので、本当の位置の近さとの一致も「参考」として測ります。
結果
以下の数値は、後で紹介するコードを、本稿執筆者の環境で実行して得たものです。
| 前処理 | 条件1(再構成の誤差) | 条件2(KNN保存率) | 参考:本当の位置とのKNN保存率 | 条件3(最小特異値) |
|---|---|---|---|---|
| 参考:乱れのないデータ | 0.0004 | 0.908(合格) | 0.908 | 0.161 |
| (A) 0で埋めるだけ | 約 1.0×10¹² | 0.036(不合格) | 0.012 | 0.000 |
| (B) 標準化だけ | 0.0161 | 0.429(不合格) | 0.222 | 0.557 |
| (C) 手当て一式 | 0.0085 | 0.645(不合格) | 0.664 | 0.334 |
| (D) (C)+欠測の印 | 0.0103 | 0.720(不合格) | 0.756 | 0.226 |
| (E) (D)+粒度をそろえる | 0.0042 | 0.760(不合格) | 0.771 | 0.370 |
条件1の値は、前処理によってデータの尺度が違うので、前処理どうしで大小を比べられません。
同じ前処理の中で、学習がうまくいっているかを見る値として読みます。
乱数の種を変えても、結論は変わらないか
最もよかった (E) と、参考の「乱れのないデータ」を、学習の乱数の種だけを5通りに変えて学習し直しました(データは同じ)。
| 乱数の種 | (E) 条件2(KNN保存率) | (E) 参考:本当の位置との一致 | 乱れのないデータ 条件2 |
|---|---|---|---|
| 1 | 0.760 | 0.771 | 0.908 |
| 2 | 0.780 | 0.797 | 0.908 |
| 3 | 0.793 | 0.808 | 0.905 |
| 4 | 0.754 | 0.762 | 0.907 |
| 5 | 0.766 | 0.776 | 0.908 |
(E) は5回とも0.75〜0.79で、目安の0.90に届きませんでした。
乱れのないデータは、5回とも0.905〜0.908で合格しました。
「手当てを重ねても、データの乱れが残した限界は越えられない」という結論は、乱数の種によって変わりませんでした。
結果から分かること
1. 何もしないと、地図はまったく作れない
(A) では、単位と桁の違いと外れ値に引きずられて、再構成の誤差が約1兆になりました。
最小特異値も0で、縮尺が完全に潰れています。
2. 条件3だけでは、地図のよしあしは分からない
(B) は、最小特異値が0.557で、6つの中でいちばん大きい値でした。
けれど、条件2は0.429で、本当の位置との一致は0.222しかありません。
縮尺が潰れていなくても、近いものが近くに写っていない地図です。
3つの条件を、すべて確かめる必要がある理由が、ここに表れています。
3. 前処理したデータとの比較は、実際よりよく見えることがある
(B) では、前処理したデータとのKNN保存率(0.429)が、本当の位置との一致(0.222)より高く出ました。
欠けた値を0で埋めたデータの「近さ」が、そもそもゆがんでいるためです。
条件2は、「前処理したデータに対して」近さが保たれているかを測る値です。
前処理がデータの近さをゆがめていれば、条件2の値も、その分だけ当てにならなくなります。
4. 手当てを重ねるほど、本当の形に近づく
本当の位置とのKNN保存率は、(B) 0.222 → (C) 0.664 → (D) 0.756 → (E) 0.771 と上がりました。
- 対数をとる
- 外れ値に強い標準化をする
- 入力の誤りを欠けた値に回す
- 欠けた値を学習から外す
- 欠測の印を渡す
- 粒度をそろえる。
どの手当ても、地図を本当の形に近づけています。
5. それでも、合格には届かなかった
(E) でも、条件2は0.760で、目安の0.90に届きませんでした(乱数の種を変えた5回でも、0.75〜0.79)。
乱れのないデータなら0.908で合格するので、足りない分は、データの乱れ(特に、どの指標にも散らばる10%の欠測)が残した限界です。
ここが、実務の分かれ目です。
合格させるために、欠けた値の多い時点や指標を外す方法があります。
けれど、外したものは、地図から見えなくなった現実です(⑤の最後の行、⑦の「捨てたもの」)。
欠けた値を減らすために、データの集め方そのものを見直すほうが、正直な道であることも少なくありません。
本稿執筆者の考え:
この実験は、「前処理を工夫すれば、どんなデータでも合格する」わけではないことを示しています。
3つの条件は、データの質を映す鏡でもあります。

図:前処理を重ねるほど、本当の形に近づく。それでも、データの乱れが残した限界がある
コードの中心部分
コードの全文は、GitHubで公開しています。
上の結果は、このコードを本稿執筆者の環境で実行して得たものです。
gi_real_data_preprocessing_jax.py
実行には、pip install jax optax scikit-learn で必要なライブラリを入れてください。
1つ目の引数で前処理(clean、naive、zscore、careful、careful_mask、careful_quarterly)を、2つ目の引数でKL情報量の重みを、3つ目の引数で学習の乱数の種を選びます(例:python gi_real_data_preprocessing_jax.py careful_quarterly 0.05 3)。
1. 手当て一式の前処理
for j in range(D):
    if j in skewed:                                   # 裾の長い指標は、対数をとる
        Xp[:, j] = np.log(np.clip(Xp[:, j], 1e-12, None))
    v = Xp[obs[:, j], j]
    med = np.median(v); iqr = np.subtract(*np.percentile(v, [75, 25]))
    Xp[:, j] = (Xp[:, j] - med) / (iqr / 1.349)      # 中央値と四分位範囲で、外れ値に引きずられずに標準化する
obs2 = obs & (np.abs(Xp) < 5.0)                       # ±5を超える値は、外れ値として「欠けた値」に回す
Xp[~obs2] = 0.0
2. 欠けた値を、損失の計算から外す
XIN = jnp.concatenate([X, M], 1)                      # 「どの値が欠けているか」の印 M も、エンコーダに渡す
def loss(p, k):
    h = mlp(p["enc"], XIN); mu, lv = h[:, :2], h[:, 2:]
    z = mu + jnp.exp(0.5*lv) * jax.random.normal(k, mu.shape)
    rec = jnp.mean(jnp.sum(M * (mlp(p["dec"], z) - X)**2, 1))   # 観測された値だけで誤差を測る
    kl = jnp.mean(-0.5*jnp.sum(1 + lv - mu**2 - jnp.exp(lv), 1))
    return rec + BETA*kl
3. 欠けた値を除いて、近さを比べる(条件2)
from sklearn.metrics.pairwise import nan_euclidean_distances
def neighbors(A, k=10):                               # 欠けた値を除いて距離を測り、近い順に k 点を選ぶ
    Dm = nan_euclidean_distances(A); np.fill_diagonal(Dm, np.inf)
    return np.argsort(Dm, 1)[:, :k]
Xnan = np.where(M_np > 0, X_np, np.nan)
knn_data = knn_rate(neighbors(Xnan), neighbors(np.array(mu)))
道具箱 ── この記事の手当てを、手元で試すためのライブラリ
| 手当て | ライブラリ(pip でのインストール名) |
|---|---|
| 欠測のある表の扱い、標準化、外れ値に強い標準化 | pandas(pandas)、scikit-learn(scikit-learn。RobustScaler、SimpleImputer、IterativeImputer) |
| 名寄せ(レコードの照合) | recordlinkage(recordlinkage)、Splink(splink) |
| 時系列を時間の順番で分けて検証する | scikit-learn(TimeSeriesSplit) |
| VAE と3つの条件(本稿のコード) | JAX、Optax(jax、optax) |
⑨ 社会経済データで地図を作るときの注意
よくある誤解
-
「前処理を工夫すれば、どんなデータでも条件に合格する」
なぜ誤解か:
⑧の実験のとおり、手当てを重ねても、データの乱れが残した限界は越えられないことがあります。3つの条件は、前処理の腕前ではなく、データの質も映しています。
-
「欠けた値は、平均や0で埋めればよい」
なぜ誤解か:
埋めた値は、本当の値ではありません。
埋めたことを示す印がなければ、モデルは埋めた値を本物として学びます。
欠けた値の近さもゆがみます(⑧の (B))。
-
「外れ値は、切り詰めれば片づく」
なぜ誤解か:
入力の誤りによる外れ値は、切り詰めても誤った値のままです。
本当に起きた出来事による外れ値は、切り詰めると地形の大事な情報を消してしまいます。
まず原因を調べます。
-
「条件3に合格していれば、よい地図だ」
なぜ誤解か:
⑧の (B) のように、縮尺が潰れていなくても、近いものが近くに写っていない地図があります。
3つの条件は、すべて確かめます。
-
「時系列も、学習と検証を無作為に分ければよい」
なぜ誤解か:時系列を無作為に分けると、未来の情報が学習に混ざり、検証の結果が実際よりよく見えます。時間の順番で分けます(Bergmeir と Benítez, 2012)。
地図の作り方を報告するときに、必ず書くこと
-
問いと、選んだデータ(内部の構造、外部の環境、過去の大きな出来事のどれを、なぜ選んだか)
-
データの版(いつの時点の、どの版の数字を使ったか)
-
前処理の規則(名寄せ、粒度、単位、標準化、欠測、外れ値)
-
補ったものと、捨てたもの(補間した値、外した指標・期間・値と、その理由)
-
3つの条件の値と、合格・不合格
-
KL情報量の重みなどの設定と、その引き換え(何を少し犠牲にしたか)
- この地図では言えないこと(データの範囲の外、欠けたデータの多い領域、外したデータ)

図:地図の作り方を報告するときに、必ず書く7つのこと
⑩ 第4回のまとめ
- 地図に入れるデータは、手に入るデータからではなく、問いから逆算して選びます。
内部の構造、外部の環境、過去の大きな出来事の3種類 を考えます。
- 本物の社会経済データには、名寄せ、粒度、単位、欠測、外れ値、更新の遅れと改定、構造の変化、外に出せないデータ、という問題があります。
それぞれに手当ての方法 があります。
- 3つの条件は、どれに落ちたかで、原因の見当がつく道具でもあります。
- 手当てを重ねるほど、地図は本当の形に近づきます。
それでも、データの質が残した限界は、前処理だけでは越えられないことがあります。
- 合格の数値だけでなく、何を補い、何を捨てたかを記録し、報告します。
本稿で触れた GI理論とケーススタディ
GI理論の本と、本稿で紹介した架空のケーススタディは、すべて GitHub で公開しています。
GI理論
架空のケーススタディ
繰り返しますが、以下は、本稿執筆者が書いたフィクションのストーリーです。
登場する企業、組織、人物、数値は、すべて架空のものです。
参考文献
- Diederik P. Kingma, Max Welling. "Auto-Encoding Variational Bayes." arXiv:1312.6114, 2013. https://arxiv.org/abs/1312.6114
- Irina Higgins, Loic Matthey, Arka Pal, Christopher Burgess, Xavier Glorot, Matthew Botvinick, Shakir Mohamed, Alexander Lerchner. "β-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework." International Conference on Learning Representations (ICLR), 2017.
- Samuel R. Bowman, Luke Vilnis, Oriol Vinyals, Andrew M. Dai, Rafal Jozefowicz, Samy Bengio. "Generating Sentences from a Continuous Space." Proceedings of the 20th SIGNLL Conference on Computational Natural Language Learning (CoNLL), 10–21, 2016. https://doi.org/10.18653/v1/K16-1002
- Donald B. Rubin. "Inference and Missing Data." Biometrika, 63(3), 581–592, 1976.
- Roderick J. A. Little, Donald B. Rubin. "Statistical Analysis with Missing Data." 3rd ed., Wiley, 2019.
- Pierre-Alexandre Mattei, Jes Frellsen. "MIWAE: Deep Generative Modelling and Imputation of Incomplete Data Sets." Proceedings of the 36th International Conference on Machine Learning (ICML), PMLR 97, 4413–4423, 2019. https://proceedings.mlr.press/v97/mattei19a.html
- Alfredo Nazábal, Pablo M. Olmos, Zoubin Ghahramani, Isabel Valera. "Handling incomplete heterogeneous data using VAEs." Pattern Recognition, 107, 107501, 2020. https://doi.org/10.1016/j.patcog.2020.107501
- Ivan P. Fellegi, Alan B. Sunter. "A Theory for Record Linkage." Journal of the American Statistical Association, 64(328), 1183–1210, 1969.
- Dean Croushore, Tom Stark. "A real-time data set for macroeconomists." Journal of Econometrics, 105(1), 111–130, 2001.
- Christoph Bergmeir, José M. Benítez. "On the use of cross-validation for time series predictor evaluation." Information Sciences, 191, 192–213, 2012.
- Shachar Kaufman, Saharon Rosset, Claudia Perlich, Ori Stitelman. "Leakage in data mining: Formulation, detection, and avoidance." ACM Transactions on Knowledge Discovery from Data, 6(4), 15, 2012.
- Jonathan de Bruin. "Python Record Linkage Toolkit: A toolkit for record linkage and duplicate detection in Python." Zenodo, 2019. https://doi.org/10.5281/zenodo.3559042
- Robin Linacre, Sam Lindsay, Theodore Manassis, Zoe Slade, Tom Hepworth, Ross Kennedy, Andrew Bond. "Splink: Free software for probabilistic record linkage at scale." International Journal of Population Data Science, 7(3), 2022. https://doi.org/10.23889/ijpds.v7i3.1794