

Executive Summary
忙しくて本文をお読みになれない方のために、本稿の内容をここにまとめます。
本文だけをお読みになる方は、この節を読み飛ばしても差し支えございません。本文は、この節を読んでいなくても理解できるように書いてあります。
本稿の問い
この記事は、連載記事シリーズ の 第3回目の記事 です。
初回記事では、Haskell の コンパイラ GHC が、圏論の法則を書き換え規則として使い、プログラムの実行時間を短縮していること を見ました。
第2回目の記事では、同じ最適化の手法 が Haskell以外の関数型言語 でも使えるかどうかを、11個の関数型言語 で実際に測って調べました。
本稿(第3回目) では、定理証明言語を取り上げます。
Agda、Idris 2、Lean 4、Rocq(旧 Coq)、Isabelle/HOL、Arend の 6つの定理証明言語 を取り上げます。
この6つを選んだ理由 は、次のとおりです。
| 言語 | 選んだ理由 |
|---|---|
| Agda | 依存型を持つ言語の代表。研究と教育で広く使われている |
| Idris 2 | 依存型を持ちながら、実行できるプログラムを書くことを主な目的としている |
| Lean 4 | 数学の形式化で近年もっとも使われている。自身の言語で書かれた処理系を持つ |
| Rocq(旧 Coq) | 産業での検証実績が多い。CompCert、seL4 などで使われた |
| Isabelle/HOL | 依存型を持たない。 6つの中で唯一、古典論理を土台とする |
| Arend | ホモトピー型理論にもとづく。型の等しさの扱いが、ほかの5つと異なる |
Agda の「選んだ理由」欄に「代表」と記載したのは、各言語のユーザ数の人数の昇順ランキングによって Agda を選択したという意味ではありません。
Agda を選んだのは、Agda は以下の3つの特徴を持つ言語であるため、他の5つと対比させるための基準として、もっとも適しているからです。
( Agdaの特徴 )
- 依存型を持つ
- 直観主義論理を土台とする
- 証明を書くことを主な目的とする
この3つの性質 を基準に置くと、他の5つの定理証明言語 との相違点が、はっきり浮かび上がってきます。
| 言語 | Agda と比較したときの相違点 |
|---|---|
| Idris 2 | 依存型と論理体系は同じ。実行できるプログラムを書くことを、主な目的とする |
| Lean 4 | 依存型と論理体系は同じ。数学の形式化に力を入れ、処理系を自身の言語で書いている |
| Rocq | 依存型と論理体系は同じ。産業での検証に使われてきた |
| Isabelle/HOL | 依存型を持たず、古典論理を土台とする。 2つの軸が同時に変わる |
| Arend | 依存型と論理体系は同じ。型の等しさの扱いが異なる(ホモトピー型理論) |
このように、Agdaを基準に置く ことで、次に示す 3つの観点から6つの定理証明言語を対比する構図が、自然と浮かび上がってくる のです。
( 6言語比較:3つの観点 )
- 依存型を持つものと、持たないもの
- 直観主義論理を土台とするものと、古典論理を土台とするもの
- 実行できるプログラムを書くことを主な目的とするものと、証明を書くことを主な目的とするもの

この3つは、本連載の4つの分類軸のうち、どれかで差を生みます。
本連載では、言語を次の4つの軸で見ています。
| 軸 | 何を見るか |
|---|---|
| 型理論 | 静的型付けか動的型付けか。多相型か依存型か |
| 評価戦略 | 正格評価か非正格評価か |
| 論理体系 | 古典論理か直観主義論理か |
| 言語機能 | 型クラスかモジュールか。証明をどう扱うか |
3つの対比と、4つの軸の対応関係は、次のとおりです。
| 対比 | 対応する軸 | 本稿のどこで扱うか |
|---|---|---|
| 依存型を持つか、持たないか | 型理論 | 第6章。型による実行時の検査の削減 |
| 直観主義論理か、古典論理か | 論理体系 | 第5章。排中律を公理として付け加えたときに何が起きるか |
| 実行できるプログラムを書くことが主な目的か、証明を書くことが主な目的か | 言語機能 | 第4章。証明をどう取り除くか |
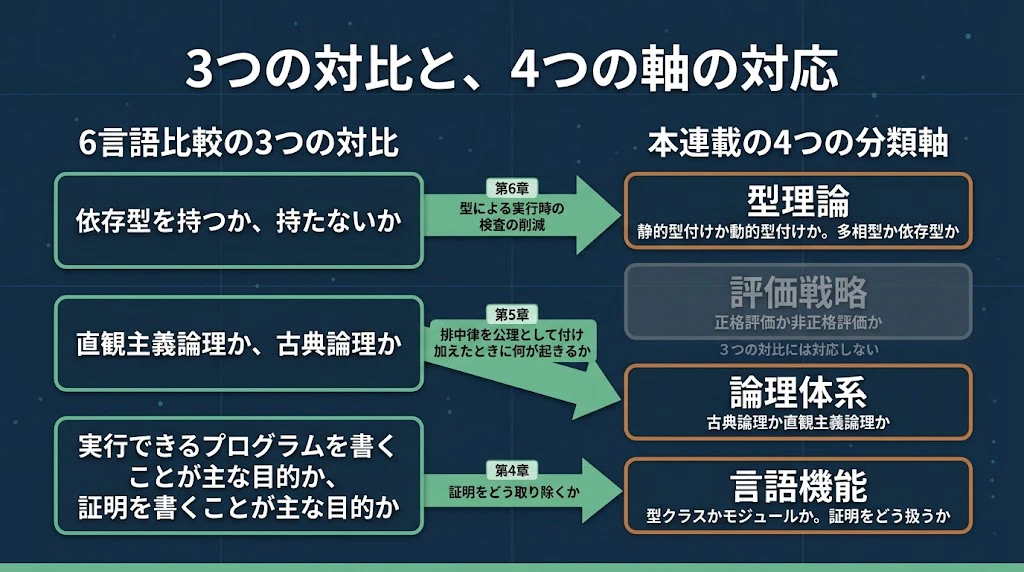
4つの軸については、第1章であらためて説明します。
残る1つの軸である評価戦略については、本稿で扱う6つの言語に大きな違いがありません。
いずれも、証明を検査する過程では必要な部分だけを計算します。
連載第2回の記事(関数型言語比較)では論理体系の軸で差が出ず、
本稿(定理証明言語比較)では評価戦略の軸で差が出ない。
扱う言語が変われば、どの軸が働くかも変わります。
連載第2回の記事(関数型言語比較)で差が大きく出たのは、評価戦略、型理論、言語機能 の3つの軸でした。
-
評価戦略:
map の融合の効き方は、評価戦略で決まりました。
正格評価の言語では 1.56 倍から 4.09 倍速くなったのに対し、非正格評価の Miranda では 1.05 倍にとどまりました。
また、seqによる恒等律の破れは、Haskell だけでなく Miranda でも起き、原因は「非正格評価とseqの組み合わせ」でした。
-
型理論:
静的型付けの言語では、圏論の法則を破る関数を、コンパイルの段階で拒否できました。
動的型付けの言語では、そうした関数が書けてしまい、書き換えの前後で結果が変わりました。
rank-2 type や higher-kinded type を書けるかどうかも、手法を使えるかどうかを左右しました。
-
言語機能:
型クラスかモジュールか、Clean の一意型、Clojure の transducers、Common Lisp のマクロなど、言語ごとの機能によって、誰がどの手段で最適化を担うかが変わりました。
一方、論理体系の軸 では、11 の言語のあいだに差が出ませんでした。
どの言語も、証明を書くことを目的とした言語ではないからです。
本稿(定理証明言語比較)で差が大きく出たのは、型理論、論理体系、言語機能 の3つの軸です。
-
型理論:
依存型を持つかどうかで、型によって実行時の検査を減らせるかが変わります(第6章)。
依存型を持たない Isabelle/HOL は、この点で他の5つの言語と分かれます。
-
論理体系:
排中律を公理として付け加えたとき、何が起きるかが言語によって違いました(第5章)。
ただし、第5章で見るとおり、違いを直接生んでいるのは論理体系そのものではなく、「実行できるかどうかを、いつ検査するか」という処理系の設計です。
-
言語機能:
証明を実行時にどう取り除くかが、言語によって違いました(第4章)。
Rocq、Idris 2、Agda では証明を受け取る箇所そのものがなくなり、Lean 4 では受け取る箇所が残ったまま、その中身を使わない形になっていました。
一方、評価戦略の軸 では、6つの言語のあいだに大きな差が出ません。
| 軸 | 第2回(関数型言語比較) | 本稿(定理証明言語比較) |
|---|---|---|
| 型理論 | 差が出た(静的型付けか動的型付けか、rank-2 type を書けるか) | 差が出た(依存型を持つか) |
| 評価戦略 | 差が出た(正格評価か非正格評価か) | 差が出ない |
| 論理体系 | 差が出ない | 差が出た(排中律の扱い) |
| 言語機能 | 差が出た(型クラスかモジュールか、一意型、マクロなど) | 差が出た(証明の取り除き方) |
本稿では論理体系の違いを扱いますので、6つの言語がどの論理を土台としているかを先に示します。
| 論理体系 | 言語 |
|---|---|
| 直観主義論理 | Agda、Idris 2、Lean 4、Rocq、Arend |
| 古典論理 | Isabelle/HOL |
両者の違いは、第2章で説明します。
本稿の問いは、次の2つです。
- 本連載の4つの分類軸のうち、第2回では差が出なかった論理体系の軸が、定理証明言語では何を分けるのか
- 定理証明言語における「最適化」とは、そもそも何を指すのか
本稿が得た答えは、次のとおりです。
定理証明言語において、論理体系の違いは何をもたらすのか。
直観主義論理と古典論理を分ける規則が、 排中律 です。
「どんな命題も、成り立つか成り立たないかのどちらかである」という規則で、古典論理では公理として認められます。
直観主義論理では公理として置かれません(ただし、排中律を否定するわけでもありません)。
直観主義論理の言語でも、排中律を公理として付け加えることはできます。
ただし、排中律が保証するのは「どちらかが成り立つ」ということだけで、そのどちらであるかは示しません。
プログラムを実行するには、実際にどちらであるかを計算しなければなりませんから、排中律に頼って書いた関数は、実行できるコードになりません。
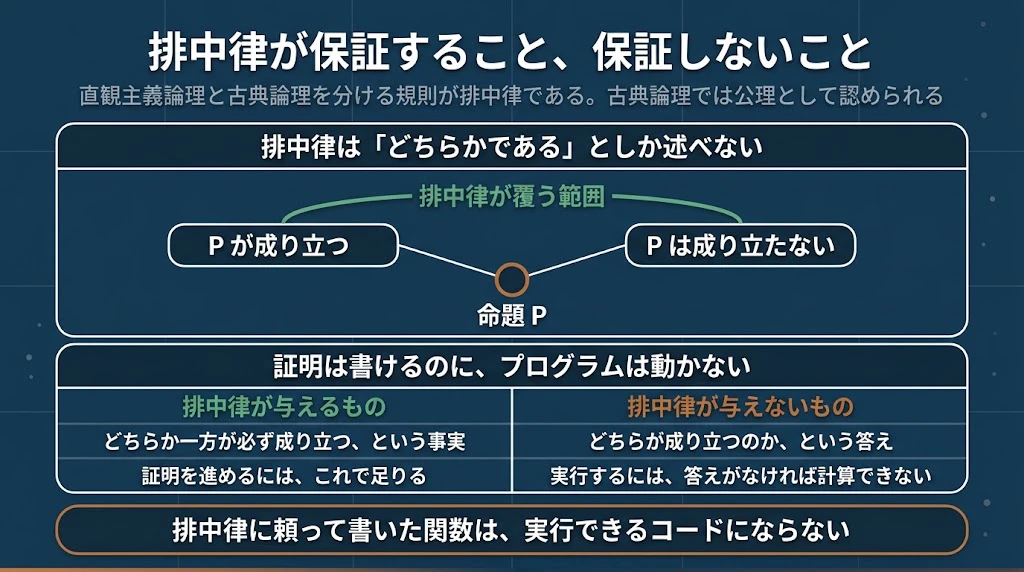
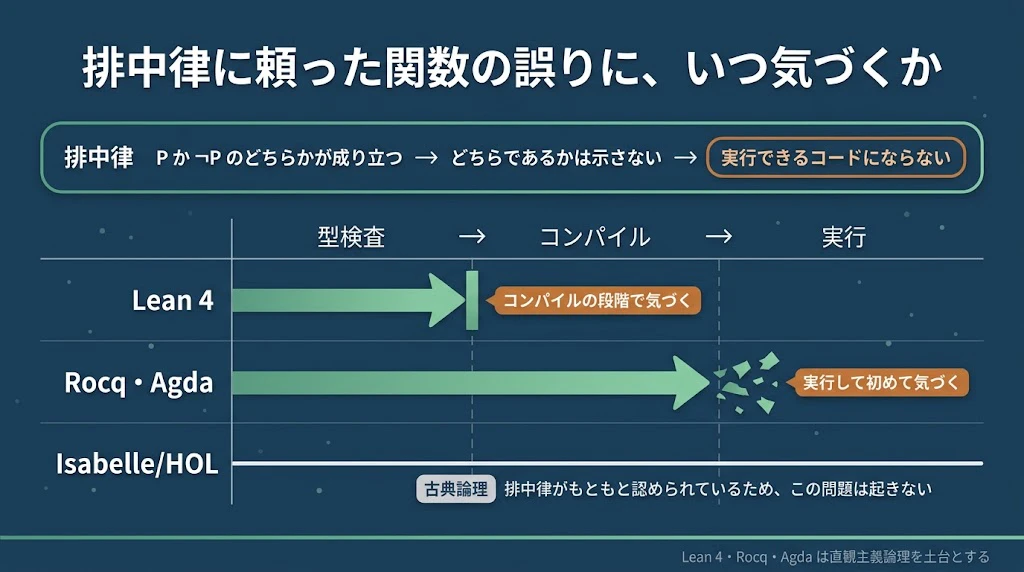
定理証明言語によって違いが出てくるのは、排中律に頼った関数が実行できないと、
いつ分かるか という点です。
直観主義論理を土台とする定理証明言語のうち、Lean 4 は、コンパイルの段階で
その関数を拒否します。 書いたその場で、計算不能(実行不能)だと分かるのです。
ところが、同じ直観主義論理に基づく Rocq と Agda では、型検査を通ってしまいます。
計算不能(実行不能)だったと分かるのは、実行してからなのです。
古典論理を土台とする Isabelle/HOL の場合、排中律がもともと認められていますから、
この問題は起きません。
この話は、本連載の主題である最適化と、直接つながっています。
初回記事と第2回で見たとおり、最適化とは「ある書き方を、別の書き方に置き換えること」 でした。
置き換えてよいかどうかを保証するのが、圏論の法則です。
定理証明言語では、その保証がさらに強められます。
「この書き換えは正しい」ということを、証明として書けるからです。
証明できた書き換えは、必ず正しいものとして使えます。

ただし、その証明が直観主義論理の範囲を超えていると、事情が変わります。
排中律に頼った証明は、どちらが成り立つのかを示しませんから、それにもとづく書き換えも、実行できるコードにはなりません。
つまり、どの論理を土台とするかが、どこまでの最適化を実際のコードとして取り出せるかを決めているのです。
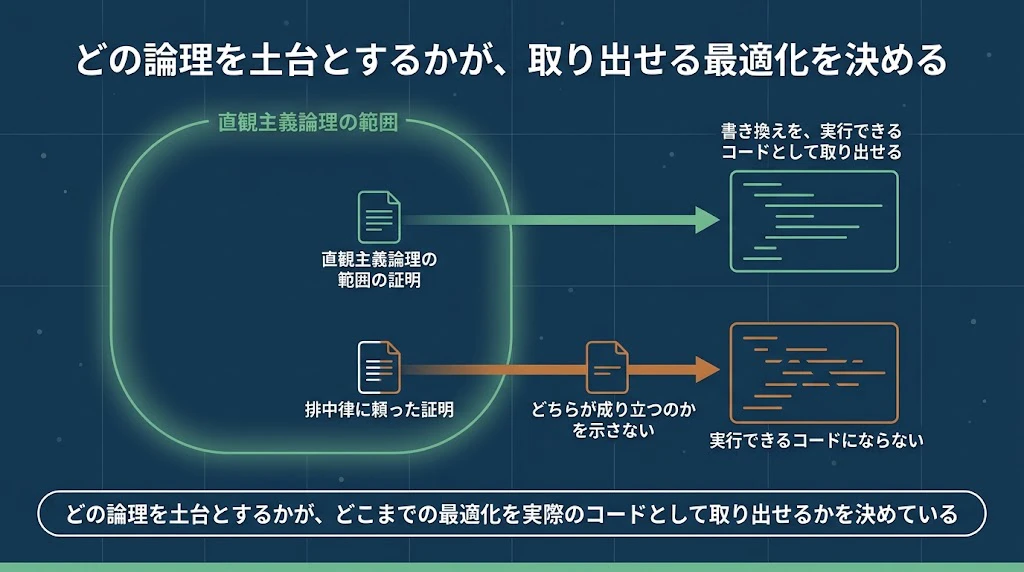
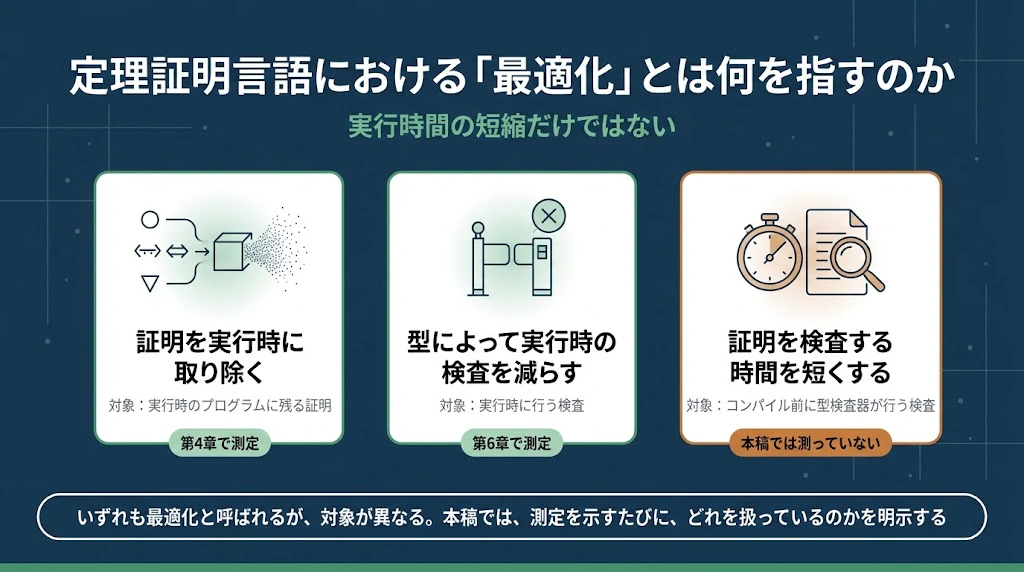
定理証明言語における「最適化」とは何を指すのか。
実行時間の短縮 だけではありませんでした。
- 証明を実行時に取り除くこと
- 型によって実行時の検査を減らすこと
- 証明を検査する時間を短くすること。
いずれも最適化と呼ばれますが、対象が異なります。
本稿では、測定を示すたびに、どれを扱っているのかを明示します。
定理証明言語とは何か
定理証明言語とは、数学の定理や、プログラムが満たすべき性質を、機械が検査できる形で書くための言語です。定理証明支援系とも呼びます。
書いた証明が正しいかどうかを、処理系が機械的に確かめます。
人が読んで納得するのではなく、規則に従っているかを計算機が検査します。
本稿で扱う6つの言語は、いずれも定理証明言語です。
同時に、プログラミング言語でもあります。
証明を書けるだけでなく、実行できるプログラムも書けます。

第2回目に記事との最大の違い
証明に使える計算の範囲では、底を持つ計算を許さないよう設計されています。
初回記事と第2回で、底(bottom) を扱いました。
評価しても値を返さない式のこと です。
例外を投げる undefined や、無限ループがこれにあたります。
Haskell では、この底があるために、恒等律が破れました。
圏の公理のひとつである「どの射 f についても f . id = f かつ id . f = f が成り立つ」という要請が、満たされなくなります。
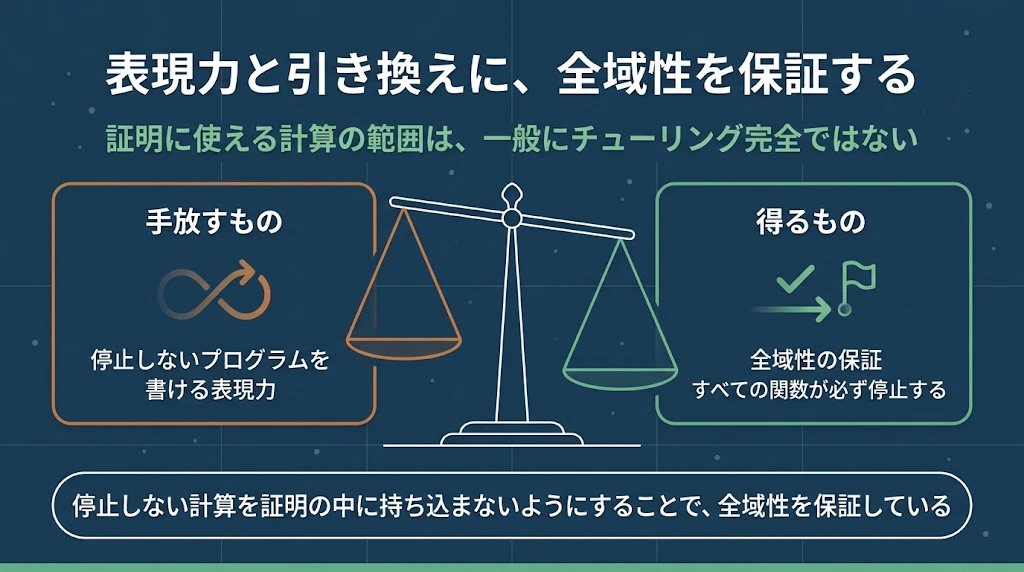
定理証明言語では、証明に使える計算の範囲では全域性(totality)が要求されます。
全域性とは、すべての関数が必ず停止することが保証されている性質のことです。
定理証明言語は、証明に使える計算の範囲では無限ループを書くことができません。
したがって、*底が存在しません。
初回記事で見た問題が、そもそも起きません。

言い換えれば、証明に使える計算の範囲は、一般にチューリング完全ではありません。
停止しないプログラムを書ける表現力を手放すこと を受け入れいれて、
停止しない計算を証明の中に持ち込まないようにすることで、全域性を保証 しています。
ここに、ひとつの皮肉があります。
圏論をもっとも熱心に語るのは Haskell の界隈です。
しかし、圏論の議論がそのまま通るのは、定理証明言語のほうなのです。

本稿で実機検証したこと
本稿では、6つの言語のうち5つについて、処理系を導入して実際に動かしました。
本稿の地図(6言語)
| 言語 | 位置づけの説明 |
|---|---|
| Agda | 依存型を持つ言語の代表 |
| Rocq(旧 Coq) | 産業での検証実績を持つ代表例 |
| Lean 4 | 数学の形式化で広く使われている代表例 |
| Idris 2 | 実行できるプログラムを書くことを主な目的とする代表例 |
| Arend | ホモトピー型理論にもとづく位置づけのための例 |
| Isabelle/HOL | 依存型を持たず、古典論理を土台とする代表例 |
本稿の実験表(実施内容別)
| 言語 | 処理系 | 版 | proof erasure の生成物確認 | 古典公理を用いた定義の確認 | 依存型の実行時間測定 | 文献調査のみ |
|---|---|---|---|---|---|---|
| Agda | agda | 2.6.3 | 実施した | 実施した | ── | ── |
| Rocq(旧 Coq) | coqc | 8.18.0 | 実施した | 実施した | 実施した | ── |
| Lean 4 | lean | 4.15.0 | 実施した | 実施した | 実施した | ── |
| Idris 2 | idris2 | 0.7.0 | 実施した | 実施した | 実施した | ── |
| Arend | Arend.jar | 1.10 | ── | ── | ── | ── |
| Isabelle/HOL | ── | ── | ── | ── | ── | 該当する |
Isabelle/HOL については、本稿では実機検証を実施していません。
本稿が実機検証を行うのは、依存型と proof erasure の働きです。
Isabelle/HOL は依存型を持たないため、同じ条件での比較になりません。

Isabelle/HOL は、第8章で「同じ処理系の中で論理体系を選べる」という主題のもとに扱います。
そこでは文献にもとづいて述べ、実機で確かめていないことを明記します。
なお、Isabelle/HOL そのものについては、依存型を使わない Isabelle/HOL とは何か ── AWS のクラウド基盤を検証した定理証明系は、なぜ証明を自動で探せるのか で、単独の主題として扱っています。
本稿で物足りない方は、上記の記事も併せてご参照ください。
本稿の結論:実機検証によって発見したこと
ここから、本稿で実際に処理系を動かして分かったことを述べます。
発見は2つ あります。
- 発見1 proof erasure
定理証明言語では、プログラムに証明を付けることができます。
その証明は、コンパイルの段階で検査を終えているため、実行するときには不要 です。
実行時にこの証明を取り除く ことを、proof erasure と呼びます。
取り除かれること自体は4つの言語すべてに共通しますが、 その取り除き方が言語によって違いました。
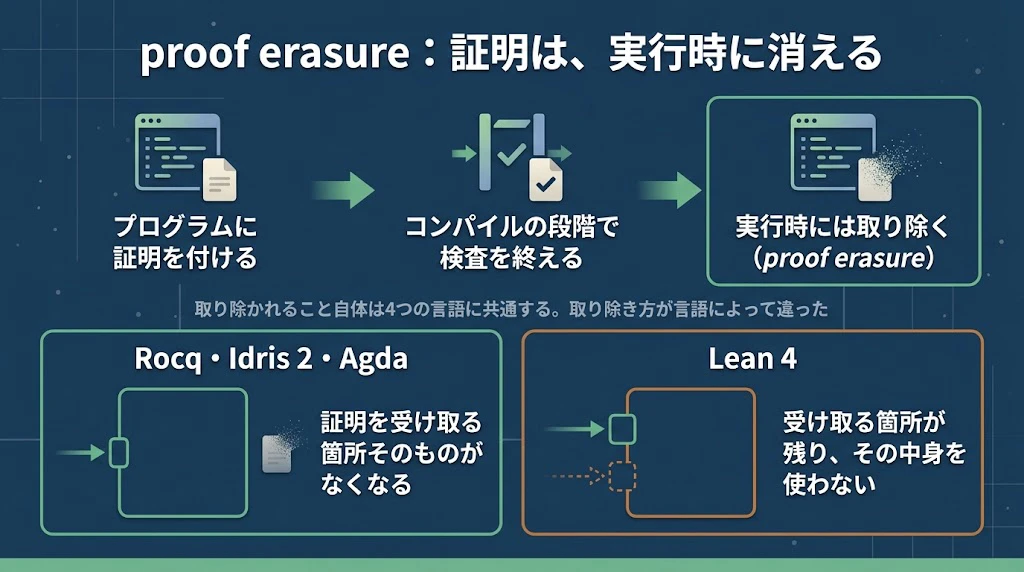
証明を受け取る関数が、生成されたコードでどうなっているかを見ると、Rocq、Idris 2、Agda では証明を受け取る箇所そのものがなくなり、Lean 4 では受け取る箇所が残ったまま、その中身を使わない形になっていました。
ここから、Lean 4 のほうが実行時の負担が大きいと予想 できます。
ところが、この関数を何度も呼び出して測ってみると、両者に差は現れません でした。
言語を比べるとき、生成されたコードを読んで見当をつけるだけでは足りず、実際に測らなければ分からない。

第2回で Erlang を測ったときと、同じことが起きたのです。
なお、発見1 は説明が長くなり executive summary が冗長になるため、executive summary の最後にコラム欄を設けました。
- 発見2 排中律を導入すると、言語によって起きることが違う
これが、本稿でもっとも重要な発見 です。
定理証明言語の多くは、直観主義論理にもとづいています。
この論理では、排中律を一般には証明できません。
排中律とは、「どんな命題 $P$ についても、$P$ が成り立つか、$P$ の否定が成り立つかのどちらかである」という規則です。
古典論理では当然とされますが、直観主義論理では公理として置かれず、一般には証明できません。
ただし、排中律を公理として付け加えることはできます。
ここで問題が起きます。
排中律そのものには、どちらが成り立つかを計算して返す手続きは含まれていません。分かりやすく言うと、排中律は、どちらが成り立つかを教えてくれないのです。
「どちらかである」と述べるだけです。
したがって、排中律を使って書いた定義は、実行できるコードになりません。
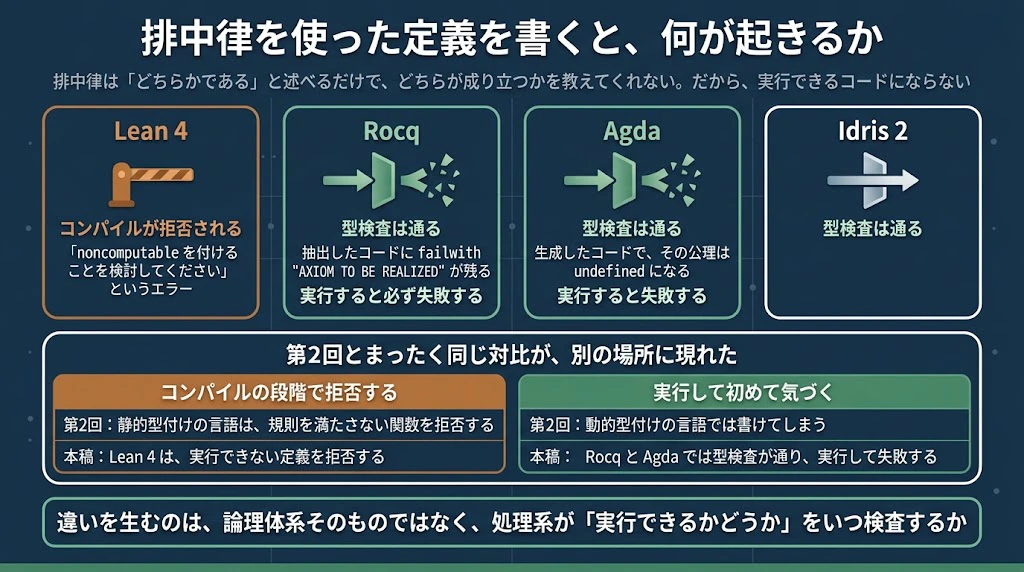
このとき何が起きるか を、4つの言語 で確かめました。
| 言語 | 排中律を使った定義を書くと |
|---|---|
| Lean 4 |
コンパイルが拒否される。 「実行できるコードを持たないため、noncomputable を付けることを検討してください」というエラーになる |
| Rocq | 型検査は通る。抽出したコードに failwith "AXIOM TO BE REALIZED" が残り、実行すると必ず失敗する
|
| Agda | 型検査は通る。生成したコードで、その公理は undefined になる。実行すると失敗する
|
| Idris 2 | 型検査は通る |
第2回とまったく同じ対比が、別の場所に現れました。
| 第2回で見たこと | 本稿で見たこと |
|---|---|
| 静的型付けの言語は、規則を満たさない関数をコンパイルの段階で拒否する | Lean 4 は、実行できない定義をコンパイルの段階で拒否する |
| 動的型付けの言語では書けてしまい、実行するまで誤りに気づけない | Rocq と Agda では型検査が通り、実行して初めて失敗する |
同じ直観主義論理を採用する定理証明言語であっても、公理を導入したときの振る舞いが異なる のです。
この違いを生むのは、論理体系そのものではなく、処理系が「実行できるかどうか」をいつ検査するか です。
本稿で使う分類
本連載は、言語を 4つの軸 で見ています。
本稿では、定理証明言語を次の 3つの世代 に分けて扱います。
本連載では便宜上、第1世代/第2世代/第3世代と呼びます。
なお、この「世代」という言い方は、一般的に確立された分類名ではありません。
| 世代 | 言語 | 何を圏論で見るか |
|---|---|---|
| 第1世代 | Haskell、OCaml、Standard ML、F#、Scala |
関数を圏論で見る。 デカルト閉圏、関手、モナド |
| 第2世代 | Agda、Idris 2、Lean 4、Rocq |
依存型を含む型理論を圏論的に意味づける。 依存型理論、局所デカルト閉圏 |
| 第3世代 | Arend、Cubical Agda |
型の等しさを幾何学として見る。 ホモトピー型理論 |
第1世代は、第2回で扱った言語です。
本稿では第2世代と第3世代を扱います。
「最適化」の意味は言語によって異なる
第2回では、最適化とは実行時の速さのことでした。
本稿では、その意味が広がります。
| 言語 | 「最適化」が指すもの |
|---|---|
| Haskell(第1世代) | 実行速度、メモリの使用量 |
| Agda | 型による実行時の検査の削減 |
| Rocq | 正しさを証明したうえで、効率的な実装を選ぶこと |
| Isabelle/HOL | 仕様から検証済みのコードを生成すること |
| Arend | 正規化、構造の変換、安全な抽象化 |
Arend については、現時点では「高速化」よりも、正規化・構造の変換・安全な抽象化という意味での最適化を扱うほうが適切です。
本稿では、測定のたびに、何を測っているのかを明示します。
本稿の構成
本稿の議論の流れを、図に示します。
(上記のmermaid図について)
第1章から第3章までを土台の説明、第4章から第6章を実機検証、第7章と第8章を理論と別の設計、と3つの塊に分けました。
あいだに 「ここから実機で測る」をオレンジで置き、記事の性格が変わる箇所を示しています。
縦一本道で、各節点から出る矢印は1本です。
各章のテーマと結論 を表にまとめます。
| 章 | テーマ | 結論 |
|---|---|---|
| 第1章 | 第2回の振り返りと、本稿の問い | 第2回では論理体系の軸だけ差が出なかった。定理証明言語では、この軸が働く |
| 第2章 | 定理証明言語とは何か | 証明に使える範囲では底を許さない設計であるため、初回記事で見た恒等律の破れが起きない |
| 第3章 | 3つの世代:何を圏論で見るか | 第1世代は関数を、第2世代は依存型を含む型理論を、第3世代は型の等しさを圏論で扱う |
| 第4章 | 証明は、実行時に消える | 4言語すべてで証明は取り除かれる。ただし Lean 4 だけ引数の位置が残る。実測では差が出なかった |
| 第5章 | 排中律を導入すると、何が起きるか | 実行できない定義になる。Lean 4 はコンパイル時に、Rocq と Agda は実行時に気づく |
| 第6章 | 型で保証すると、実行時の検査は減るのか | Lean 4 と Idris 2 では検査が消える。Rocq では残る。実測は1.02倍、差し引くと1.09倍 |
| 第7章 | 圏論的論理学 | 論理の規則が、圏の普遍性として書き直せる。圏論一般の形式化と、対応定理の形式化は別である |
| 第8章 | Isabelle は、論理体系を選べる | 土台の上に HOL、ZF、FOL を載せられる。古典論理を選ぶと排中律の問題は起きないが、コード生成という別の仕組みが要る |
| 第9章 | 本稿の限界と、第4回への橋渡し | 測っていないこと(型検査の時間など)を明示。連載を通じて「コードを読むことと測ること」「早く気づくか遅れて気づくか」の2つの論点が繰り返し現れた |
想定読者
本稿は、次のような方を想定しています。
- 初回記事または第2回をお読みになり、定理証明言語でも同じ話ができるのかに関心をお持ちの方
- 定理証明支援系の名前は知っているが、言語ごとの違いを整理したい方
- 型システムや論理体系に関心をお持ちの方
前提とする知識
- コーディング経験
- 型があることの意味(コンパイル時に型が検査される、など)
前提としない知識
- 圏論の知識。必要な範囲は本文で説明します
- 定理証明支援系を使った経験
- 初回記事と第2回を読んでいること。必要な箇所は本稿で改めて説明します
コラム 「チューリング完全ではない」とは、どういうことか(折りたたみ)
Executive Summary で、証明に使える範囲はチューリング完全ではない、と述べました。この点を補足します。
チューリング完全とは何か
ある言語がチューリング完全であるとは、計算できることがらを、すべてその言語で書き表せる、という意味です。C、Java、Python、Haskell など、実務で使われる言語のほとんどがこれにあたります。
チューリング完全な言語では、停止するかどうかを判定できないプログラムを書けます。これは避けられない性質です。プログラムが停止するかどうかを、あらゆる場合について機械的に判定する方法は存在しないことが、証明されています(停止性問題)。
定理証明言語が手放したもの
Agda、Rocq、Lean 4 などで、証明に使える範囲は、この表現力をあえて手放しています。
すべての関数が必ず停止することを検査するため、停止しないプログラムを書けません。したがって、チューリング完全ではありません。
なぜ手放すのか
本文で述べたとおり、無限ループを書けると、偽の命題すら証明できてしまうためです。証明として意味をなすために、表現力を制限する必要があります。
ただし、例外があります
「言語がチューリング完全でない」と言い切ると、正確ではありません。次の点にご注意ください。
| 事項 | 内容 |
|---|---|
| 全域性の検査を外す手段がある | Agda には {-# TERMINATING #-} という指定が、Idris 2 には partial という指定があります。これらを使えば、停止しない関数も書けます。ただし、その関数は証明には使えません |
| 停止しない関数を扱う仕組みがある | Isabelle/HOL や Lean 4 には、停止しない可能性のある関数を、別の枠組みで扱う仕組みがあります |
| 実行できるプログラムとしては使える | 証明に使えないだけで、プログラムとしては動きます |
したがって、正確には次のように述べるべきです。
定理証明言語の、証明に使える範囲は、チューリング完全ではありません。
本稿では、この意味で「チューリング完全ではない」と書いています。
コラム 発見1 証明は実行時に取り除かれる。その方法が言語によって違う(折りたたみ)
定理証明言語では関数に引数として証明を渡せる
定理証明言語では、プログラムに証明を付けることができます。その仕組みを、割り算を例に説明します。
a を b で割る関数を考えてください。0で割ることはできませんから、b が0でないことを、どこかで確かめなければなりません。
ふつうのプログラミング言語であれば、この確認は関数の中で行います。呼び出されるたびに、b が0でないかを検査するわけです。
これに対して定理証明言語では、関数を呼ぶ前に確認を済ませ、その結果を証明として関数に渡すことができます。つまり、確認の責任が、呼ばれる側から呼ぶ側へ移るのです。
副次的な効果もあります。この関数は、a と b に加えて「b は0ではない」という証明も受け取ります。その証明を用意できない相手からは、そもそも呼び出すことができません。誤った呼び出しが、コンパイルの段階で防がれるのです。
証明は、どう用意するのか
b が具体的な数、たとえば 2 であれば、「2 は 0 ではない」ことは計算で確かめられます。定理証明言語には、こうした自明な事実を自動で証明する仕組みがあり、rfl や by decide と書けば、処理系が証明を作ります。
b が変数で、中身が分からない場合は、そうはいきません。呼ぶ側が、b が0でないことを自分で示す必要があります。示せなければ、この関数は呼べません。
呼び出しは、どう書くのか
safeDiv 10 2 (2 は 0 ではないことの証明)
第3の引数に、証明を書きます。ふつうの引数と同じように、括弧の中に並べます。特別な構文ではありません。
証明は、実行時には不要である
この証明は、コンパイルの段階で検査されます。実行するときには、もう役目を終えています。計算する必要がありません。
この「証明を実行時に取り除くこと」を、proof erasure と呼びます。
日本語の定訳が確認できなかったため、本稿では英語のまま記します。
4つの言語で確かめた
証明を引数に取る関数を書き、実行時のコードがどうなるかを確かめました。
| 言語 | 取り出した形式 | 証明の引数はどうなったか |
|---|---|---|
| Rocq | OCaml | 引数そのものが消えた |
| Idris 2 | Chez Scheme | 引数そのものが消えた |
| Agda | JavaScript | 引数そのものが消えた |
| Lean 4 | C | 引数の位置は残った。ただし、本体では一度も使われない |
Lean 4 だけ、扱いが異なります。生成された C 言語の関数は3つの引数を取りますが、本体は割り算を行うだけで、証明の引数を参照しません。
引数が残ることに、コスト負担はあるのか
300万回の繰り返しの中で、証明を引数に取る関数と、取らない関数を呼び、10回測定しました。
| 書き方 | 中央値 |
|---|---|
| 証明を引数に取る | 1,022 ms |
| 証明を引数に取らない | 1,020 ms |
差は1.00倍で、測定の揺れの範囲に収まりました。
コードを読むと分かる違いが、実測では現れませんでした。
詳しくは第4章でご説明します。
本稿の用語について
日本語の定訳が確認できた用語は、日本語で記します。
確認できなかった用語は、英語のまま記します。
用語が初めて現れる箇所で、その意味を説明します。
対話篇の形式で、用語の意味を確かめていきます。
第1章 第2回の振り返りと本稿の問い
1-1 本連載の4つの分類軸
本連載は、言語を 4つの軸 で見ています。
| 軸 | 何を見るか |
|---|---|
| 型理論 | 静的型付けか動的型付けか。多相型か依存型か |
| 評価戦略 | 正格評価か非正格評価か |
| 論理体系 | 古典論理か直観主義論理か |
| 言語機能 | 型クラスかモジュールか。rank-2 type を書けるか |
この4つの軸は、いずれも研究者のあいだで標準的に使われているものです。
しかし、この4つの比較軸を同時に並べて1つの表にまとめる方法は、本稿のオリジナルです。
型理論、評価戦略、論理体系、言語機能は、それぞれ独立に重要な研究上の観点です。
本連載では、最適化や書き換えの可否を比べるために、この4つを共通の比較表に置いています。
この表そのものが標準分類として定着している、という意味ではありません。
タロウくん:
先生、この4つの軸は、第2回でも使いましたよね?
専任講師:
はい。第2回では、11個の関数型言語を、この4つの軸で整理しました。
そのとき、ひとつ気づいたことがあります。
論理体系の軸だけ、どの言語でも「特に制約はない」という結果になりました。
タロウくん:
論理体系の軸は、比較基準として役に立っていない、ということですか?
専任講師:
第2回の範囲では、そう言えます。
関数型言語は、証明を書くための言語ではありません。
論理体系の違いが現れるのは、証明を書く場面です。
直観主義論理と古典論理を分けるのは、排中律を認めるかどうかでした。排中律を認めれば、
「どちらかである」とだけ述べて証明を進められます。認めなければ、どちらであるかを
示さなければなりません。
この違いは、証明を書いて初めて表に出ます。
第2回で測った11の言語には、そもそも証明を書く仕組みがありません。
書けるのは、関数の定義と、その呼び出しだけです。
証明を書かないのですから、排中律を使う場面もありません。 排中律を使えるかどうかで
書けるものが変わる、ということが起こらないのです。
そして、第2回で扱った8つの最適化手法は、どれも関数の書き換えでした。
map f (map g xs) を map (f . g) xs に置き換える、といった操作です。
この書き換えが正しいかどうかを決めるのは、関手の法則であって、排中律ではありません。
したがって、どの論理体系にもとづいているかは、最適化手法を使えるかどうかを
左右しなかったのです。

本稿で扱う定理証明言語は、証明を書くための言語です。
ここで、論理体系の比較軸が初めて意味を帯びてきます。
タロウくん:
証明を書けるようになると、何が変わるのですか?
専任講師:
最適化の正しさを、証明として書けるようになります。
第2回で扱った map f (map g xs) を map (f . g) xs に置き換える書き換えを思い出してください。
あの書き換えが正しいことは、関手の法則が保証 していました。
ただし、保証していたのは圏論の側であって、言語の側ではありませんでした。
定理証明言語では、この等式そのものを、証明として書くことができるのです。
map-fusion : (f : B → C) (g : A → B) (xs : List A)
           → map f (map g xs) ≡ map (f ∘ g) xs
この証明を通せば、その書き換えは必ず正しいものとして使えます。

タロウくん:
では、どこで論理体系が関わってくるのですか?
専任講師:
その証明の中で、排中律を使ってしまった場合です。
上の map-fusion は、リストの構造についての帰納法で証明できますから、排中律は要りません。
しかし、扱う対象が変わると、そうはいきません。
たとえば、入力の条件によって計算を切り替える最適化を考えてください。
「条件を満たすなら、こちらの計算に置き換えてよい」という形です。
この「条件を満たすかどうか」を、排中律に頼って片づけたとします。
すると、その証明からは、実行できるコードを取り出すことができません。
排中律は、どちらが成り立つかを示さないから です。
タロウくん:
証明としては通るのに、コードにならない のですね。
専任講師:
そのとおりです。
第2回目で取り上げた関数型言語と、今回取り上げる定理証明言語との違いは、ここにあります。
関数型言語では、最適化の正しさを証明として書きませんでした。
書けないのですから、排中律を使うこともありません。
定理証明言語では、最適化の正しさを証明として書くことができるがゆえに、どの論理体系の上で書いたかが、その証明を実行できるコードに変えられるかどうかを決めるのです。

タロウくん:
つまり、どこまでの最適化を実際のコードとして取り出せるかが、論理体系によって変わる、ということですか。
専任講師:
よい整理です。そのとおりです。

論理体系は、2つだけなのか
タロウくん:
先生、1つ気になっていることがあります。
論理体系というと、古典論理と直観主義論理の2つしか出てきません。
ほかにはないのですか。
専任講師:
たくさんあります。
本稿で2つしか出てこないのは、本稿で扱う6つの言語が、この2つのどちらかを土台にしているから です。
代表的なものを挙げます。
| 論理体系 | 特徴 | どこで使われるか |
|---|---|---|
| 古典論理 | 排中律を認める | Isabelle/HOL、通常の数学 |
| 直観主義論理 | 排中律を公理として置かない | Agda、Idris 2、Lean 4、Rocq、Arend |
| 線形論理 | 前提を1度しか使えない | 資源の管理、量子計算 |
| 様相論理 | 「必ず」「おそらく」を扱う | 並行システムの検証 |
| 時相論理 | 「いつか」「つねに」を扱う | ハードウェアの検証、モデル検査 |
| 多値論理 | 真と偽のほかに値を持つ | 不確かな情報の扱い |
| 量子論理 | 分配法則が成り立たない | 量子力学の形式化 |
タロウくん:
こんなにあるのですか。
専任講師:
これでも一部です。
筆者は、別の記事で21の論理体系を扱いました。
出典:if 文も SQL も、実は別々の「論理」だった ── 古典論理から量子論理まで、21の論理体系を5人で議論【対話篇】
タロウくん:
では、なぜ定理証明言語は、古典論理か直観主義論理のどちらかなのですか?
専任講師:
証明とプログラムを対応させたいからです。
第2章で扱う Curry-Howard対応 が、その理由にあたります。
証明がそのままプログラムになる、という対応です。
この対応がもっともよく整備されているのが、直観主義論理です。
古典論理についても、制御構造との対応が知られています。
ほかの論理体系については、研究は進んでいますが、実用の定理証明言語の土台としては、まだ広く使われていません。

タロウくん:
では、線形論理の定理証明言語は、ないのですか?
専任講師:
研究用のものはあります。
また、Rust の所有権の仕組みは、線形論理の考え方を取り入れたものと説明されることがあります。
ただし、本稿で扱う6つの言語は、いずれも古典論理か直観主義論理のどちらかです。
だから、本稿ではこの2つだけを扱います。
なお、線形論理と圏論の対応については、第7章で触れます。
本連載シリーズが、どの回の記事でどのようなテーマを扱ってきたかを、図で振り返ります。
1-2 初回記事で見たこと
初回記事では、Haskell のコンパイラ GHC が、圏論の法則を書き換え規則として使っていることを見ました。
たとえば、次の書き換えです。
map f (map g xs) = map (f . g) xs
リストに g を適用してから f を適用するのと、f と g を合成してから一度だけ適用するのとは、同じ結果になります。
後者のほうが、途中のリストを作らずに済みます。
この書き換えが正しいことを保証するのが、圏論の法則です。
具体的には、関手の法則(Functor 則) です。
あわせて、初回記事では、もうひとつのことを見ました。
Haskell の圏、すなわち Hask は、厳密には圏ではない。
理由は、底(bottom)の存在です。
次の2つの式が、異なる結果を返します。
| 式 | 結果 |
|---|---|
seq bottomfn 1 |
例外が発生する |
seq (bottomfn . id) 1 |
1 を返す |
恒等律によれば、bottomfn と bottomfn . id は等しいはずです。
しかし、seq はこの2つを区別します。
タロウくん:
先生、そこで出てきた底という言葉ですが、値が返ってこない式のことでしたね。
専任講師:
はい、そのとおりです。
計算が終わらないか、例外で止まるか、どちらにしても値が得られません。
その「値がない」という状態を、ひとつの式として扱うための言葉です。
Haskell では、次のような式が底になります。
undefined            -- 評価すると例外を投げる
error "何か"          -- 同上
loop where loop = loop  -- 無限ループ
タロウくん:
無限ループも、底なのですね。
専任講師:
はい。計算が終わらないので、値が得られません。
この「無限ループを書ける」ということが、本稿の鍵になります。
1-3 第2回で見たこと
第2回では、初回記事の手法が Haskell 以外でも使えるかを、11の関数型言語で測りました。
結論を2つ、挙げます。
(1つ目)
手法によって、依存する軸が違いました。
| 手法 | 何を削るか | 何に依存するか |
|---|---|---|
| map の融合 | 途中のリストを作るコスト負担 | 評価戦略に強く依存する。1.05倍から4.09倍 |
| Difference List | 計算量そのもの(O(n²) を O(n) に) | 依存しない。10言語すべてで桁違いの差 |
(2つ目)
静的型付けと動的型付けで、規則の扱いが違いました。
静的型付けの言語では、規則を満たさない関数を書こうとすると、コンパイルが拒否します。
動的型付けの言語では書けてしまい、実行するまで誤りに気づけません。
この対比が、本稿でも別の形で現れます。
第5章で扱います。
1-4 本稿の問い
以上を踏まえて、本稿の問いを述べます。
問い1:論理体系の軸は、定理証明言語で何を分けるのか。
第2回では差が出なかった軸です。
定理証明言語では、Agda、Idris 2、Lean 4、Rocq が直観主義論理を採用し、
Isabelle/HOL が古典論理を採用しています。
この違いが、何をもたらすのかを見ます。
問い2:定理証明言語における「最適化」とは何を指すのか。
第2回では、実行時の速さを測りました。
定理証明言語では、それだけではありません。
- 証明を検査する速さ
- 証明の書きやすさ
- 実行時の検査の削減
など、複数の意味があります。
どれを扱っているのかを、その都度明示します。

第2章 定理証明言語とは何か
2-1 定理証明言語で、何ができるのか
タロウくん:
先生、定理証明言語という言葉を初めて聞きました。
何をする言語なのですか?
専任講師:
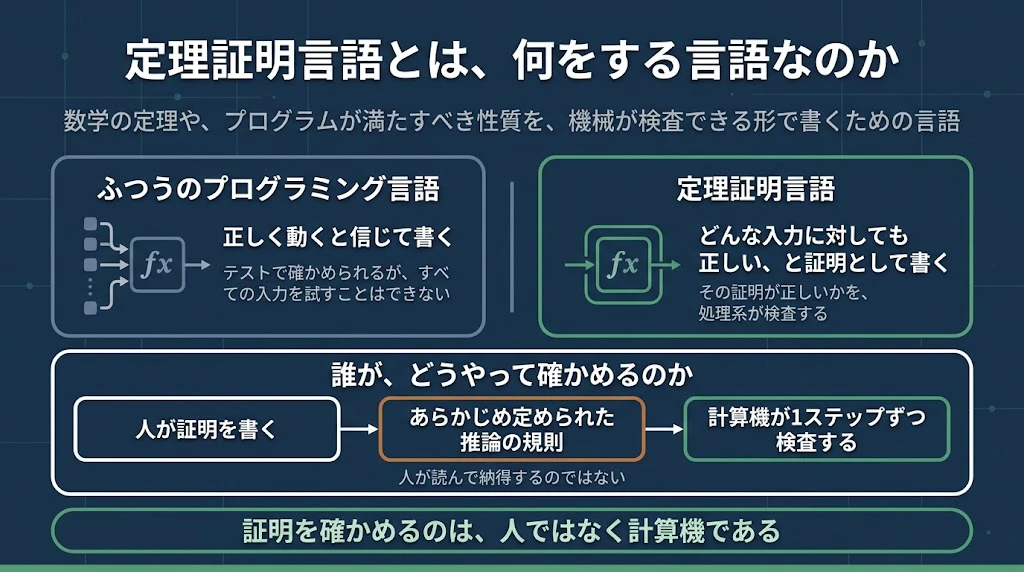
数学の定理や、プログラムが満たすべき性質を、機械が検査できる形で書くための言語です。
ふつうのプログラミング言語では、「この関数は正しく動く」と信じてコードを書きます。
テストを書いて確かめることはできますが、すべての入力を試すことはできません。
定理証明言語では、「この関数は、どんな入力に対しても正しい」ということを、証明として書きます。
その証明が正しいかどうかを、処理系に機械的に検査してもらうのです。
タロウくん:
証明を、人ではなく計算機が確かめるのですね?
専任講師:
その通りです。
人が読んで納得するのではありません。
あらかじめ定められた推論の規則に従っているかどうかを、計算機が1ステップずつ検査します。
規則に従っていなければ、証明として受け付けられません。
タロウくん:
それは、プログラムを書くのとは違うことなのですか。
専任講師:
違うようでいて、同じです。
本稿で扱う6つの言語は、いずれも定理証明言語であり、同時にプログラミング言語でもあります。
証明を書けるだけでなく、実行できるプログラムも書けます。
なぜ同じなのかは、次の節で説明します。
2-2 証明とプログラムは、同じものである
Curry-Howard 対応という考え方があります。
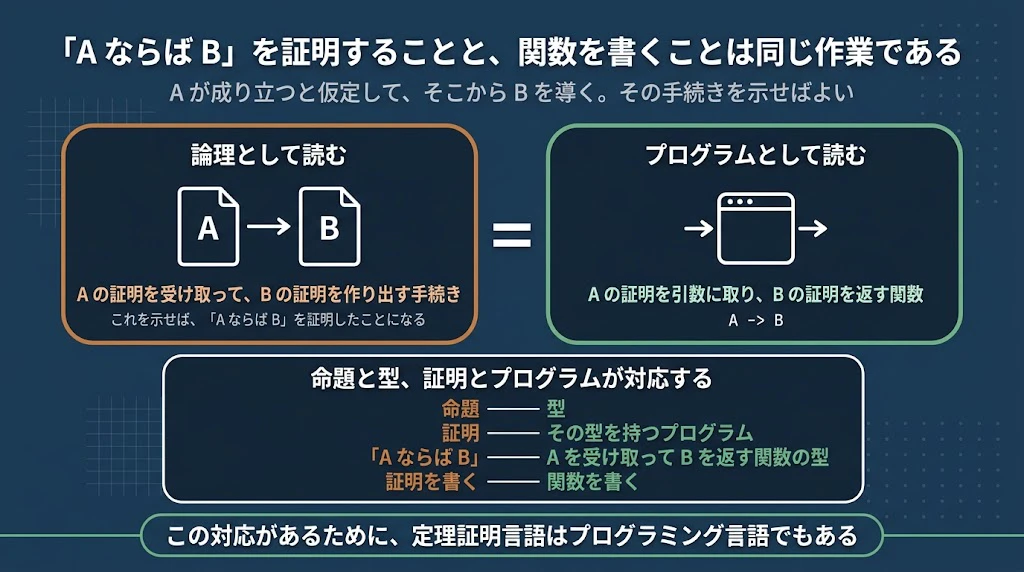
命題を型とみなし、証明をプログラムとみなす、という対応です。
| 論理の側 | プログラムの側 |
|---|---|
| 命題 | 型 |
| 証明 | その型を持つプログラム |
| 「$A$ ならば $B$」 | $A$ を受け取って $B$ を返す関数の型 |
| 「$A$ かつ $B$」 | $A$ と $B$ の組の型 |
| 「$A$ または $B$」 | $A$ か $B$ のどちらかを持つ型 |
タロウくん:
先生、「$A$ ならば $B$」が関数の型になる、というのがよく分かりません。
専任講師:
具体的に考えてみましょう。
「$A$ が成り立つならば、$B$ が成り立つ」ということを証明したいとします。
証明するには、何をすればよいでしょうか。
タロウくん:
$A$ が成り立つと仮定して、そこから $B$ を導きます。
専任講師:
そのとおりです。
「$A$ の証明を受け取って、$B$ の証明を作り出す手続き」 を示せばよいのです。
これは、$A$ の証明を引数に取り、$B$ の証明を返す関数にほかなりません。
タロウくん:
たしかに、同じ形をしています。
専任講師:
だから、証明を書くことと、関数を書くことが、同じ作業になります。
この対応があるために、定理証明言語はプログラミング言語でもあるのです。
なお、Curry-Howard 対応 については、体系的に扱った文献があります。
出典:
M. H. Sørensen, P. Urzyczyn, Lectures on the Curry-Howard Isomorphism, Studies in Logic and the Foundations of Mathematics, Volume 149, Elsevier, 2006
https://www.sciencedirect.com/bookseries/studies-in-logic-and-the-foundations-of-mathematics/vol/149
【上級者向けコラム】三位一体の美しさ ── カリー=ハワード=ランベック対応
第2章で、命題と型、証明とプログラムが対応するという「Curry-Howard 対応」を紹介しました。
そして第7章で、証明と圏の射を対応させたLambekの仕事が登場します。
実は、これらは別々の話ではありません。
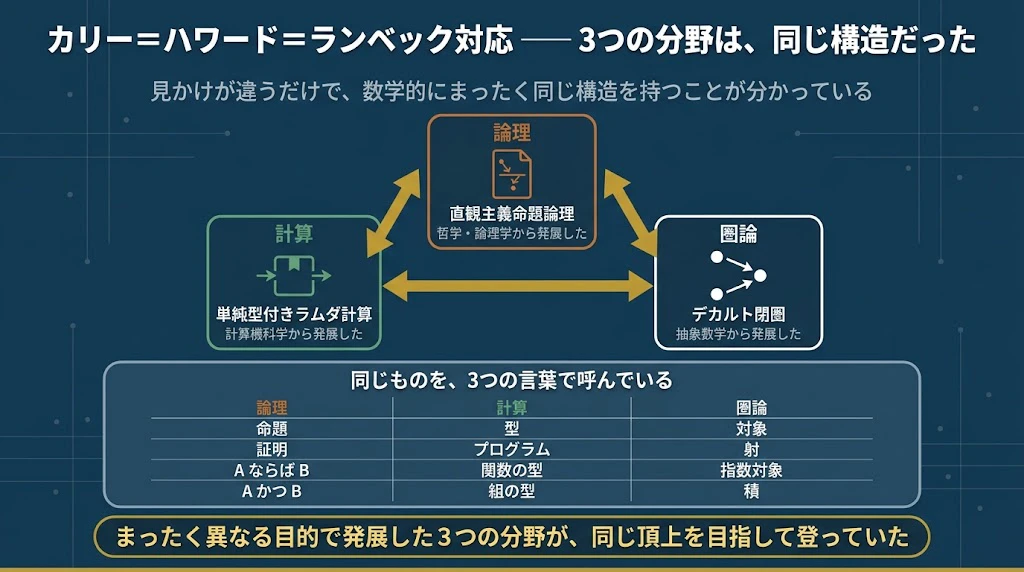
- 「論理(直観主義命題論理)」
- 「計算(単純型付きラムダ計算)」
- 「圏論(デカルト閉圏)」
の3者は、見かけが違うだけで数学的に全く同じ構造を持っていることが分かっています。
これを 「カリー=ハワード=ランベック(Curry-Howard-Lambek)対応」 と呼びます。
哲学・論理学、計算機科学、そして抽象数学という、全く異なる目的で発展した3つの分野が、実は同じ頂上を目指して登っていたという、学問の歴史においても極めて美しく感動的な「三位一体」の発見なのです。
2-3 依存型とは何か
本稿で扱う言語の多くは、依存型を持っています。
タロウくん:
先生、依存型という言葉も、第2回で少しだけ出てきましたね。
値に依存する型、という説明でした。
専任講師:
はい。もう少し詳しく説明します。
ふつうの型は、値とは別のところにあります。
Int という型は、3 という値とは独立に存在します。
依存型では、型の中に値が現れます。
タロウくん:
型の中に、数字が入るということですか?
専任講師:
そのとおりです。
たとえば「長さが3であるリスト」という型を書けます。
3という値が、型の一部になっています。
Vec Int 3    -- 長さ3の、整数のリスト
Vec Int 5    -- 長さ5の、整数のリスト
この2つは、別の型 です。
タロウくん:
それができると、何がうれしいのですか?
専任講師:
間違ったプログラムを、書けなくなります。
たとえば、リストの先頭を取り出す関数を考えてください。
空のリストには先頭がないので、ふつうは実行時に検査します。
依存型があれば、「長さが1以上のリスト」だけを受け取る関数をコードとして記述することができます。
head : Vec a (n + 1) -> a
この関数に空のリストを渡そうとすると、コンパイルの段階で拒否されます。
実行時の検査が要らなくなります。
タロウくん:
検査が減るから、速くなるということですか?
専任講師:
そうなる場合があります。
第6章で、実際に測ります。
ただし、注意すべき点があります。
型が複雑になるほど、型検査に時間がかかってしまうという点です。
実行が速くなる代わりに、コンパイルが遅くなることがあるのです。
この対比は、第2回で見た「何を測っているのか」という問題と同じです。
速さと一口に言っても、何の速さかを区別する必要があります。
2-4 定理証明言語には、底が存在しない
ここが、第2回で扱った関数型言語と、今回取り扱う定理証明言語とのもっとも大きな違いです。
タロウくん:
先生、第1章で「無限ループを書ける」ことが鍵になる、と言われました。
専任講師:
はい。定理証明言語では、無限ループを書くことはできません。
すべての関数が、必ず有限のステップで停止することが保証されています。
この性質を全域性(totality)と呼びます。
タロウくん:
なぜ、そんな制限があるのですか。
専任講師:
証明として正しくあるために、必要だから です。

考えてみてください。もし無限ループを書けるなら、次のような「証明」が書けてしまいます。
何でも証明する関数 : (どんな命題 P) -> P の証明
何でも証明する関数 = 何でも証明する関数
自分自身を呼び出すだけの関数です。
この関数を呼び出すと、処理系は定義を読みにいきます。ところが定義に書かれているのは
同じ関数の名前だけですから、処理系はもう一度その関数を呼び出し、また同じ定義を
読みにいきます。値を返す箇所が、どこにもありません。
従って、無限ループに陥ってしまうのです。
それでも型検査は通ります。
宣言した型と定義の型は一致しているからです。
型検査器が確かめるのはそこまでであって、値を返すかどうかまでは問わないから です。
タロウくん:
実行すると止まりませんが、型は合っているのですね。
専任講師:
そうです。
さらに困ったことに、この関数を使えば、偽の命題すら証明できてしまいます。
たとえば「1 = 2」という、明らかに偽の命題を考えてください。
この命題の証明を求められたとき、先ほどの関数に 1 = 2 を渡せば済みます。
何でも証明する関数 (1 = 2)
宣言は「どんな命題 P を渡しても、P の証明を返す」という形でした。
P のところに 1 = 2 を入れれば、返ってくるのは「1 = 2 の証明」です。
型検査器は、これを正しい証明として受け取ってしまいます。
実行すれば無限ループに陥り、証明が返ってくることはありません。
しかし型検査の段階では、その区別がつかないのです。
タロウくん:
それでは、証明の意味がありません。
専任講師:
そうですよね。
こうした事情があって、定理証明言語は、再帰が必ず終わるかどうかを検査します。
終わることを示せない関数は、受け付けられません。
タロウくん:
どうやって、終わることを確かめるのですか。
専任講師:
もっとも基本的な方法は、引数が必ず小さくなっていることを確かめることです。
add : Nat -> Nat -> Nat
add zero    m = m
add (suc n) m = suc (add n m)
add (suc n) m の中で add n m を呼んでいます。
第1引数が suc n から n へ、ひとつ小さくなっています。
自然数は0より小さくなれないので、この再帰は必ず終わります。

タロウくん:
では、どうしても終わらない処理を書きたいときは、どうするのですか?
専任講師:
そうした処理は記述することができません。
書くとすれば、「この関数は全域ではない」と明示して、証明には使えない形で書きます。
言語ごとに、書き方が決まっています。
| 言語 | 書き方 | 意味 |
|---|---|---|
| Agda | {-# TERMINATING #-} |
停止性の検査を、この関数については行わない |
| Idris 2 | partial |
この関数は全域ではない |
| Rocq |
Program Fixpoint ほか |
停止性を別に示すか、公理として認める |
Agda であれば、関数の手前に次のように書きます。
{-# TERMINATING #-}
loop : Nat → Nat
loop n = loop n
この指定を付ければ、停止性の検査を通らない関数でも、処理系が受け付けます。
ただし、この関数は証明には使うことができません。
先ほど見たとおり、停止しない関数を証明に使えば、偽の命題まで証明できてしまいます。
そこで処理系は、こうした指定の付いた関数を、証明の中から切り離して扱います。
タロウくん:
すると、2つの世界に分かれるのですね?
専任講師:
そういうことです。
証明に使える範囲    すべての関数が停止する。底が存在しない
その外側            停止しない関数も書ける。ただし証明には使えない
本稿で「定理証明言語には底が存在しない」と述べるとき、指しているのは前者の範囲です。処理系の全体から、停止しない関数が一掃されているという意味ではありません。
この制限があるために、定理証明言語には底が存在しません。
なぜ全域性が必要なのかを、図に示します。
【上級者向けコラム】全域性・partial・noncomputableをどう区別するか
本文では「証明に使える範囲では全域性が必要」と説明しました。ここでいう全域性は、処理系全体に「停止しない関数が一切存在しない」という意味ではありません。実際には、言語・処理系によって、partialな関数、noncomputableな定義、外部コードなどを扱う仕組みがあります。重要なのは、「証明の整合性を保証する計算の核」と「実行用プログラムとして許される拡張」を区別することです。
【上級者向けコラム】止まらないプログラムをどう証明するか ── 共帰納法(Coinduction)
定理証明言語では無限ループが書けないと述べましたが、ではOSのプロセスや、無限に続くデータ(ストリームなど)はどう扱うのでしょうか。
定理証明言語には、終わることを保証する「帰納法(Induction)」とは別に、無限に続く状態を安全に扱うための「共帰納法(Coinduction)」という仕組みが用意されています。
これは「必ず終わる」ことを要求する代わりに、「要求されるたびに、次の結果を必ず返す(productiveである)」ことを要求する仕組みです。これを使えば、底(bottom)を避けつつ、無限に続く処理も定理証明言語の中で安全に証明し、実行することができます。
【上級者向けコラム】全域性は、どの層で保証されるか
「定理証明言語は全域的である」という説明は、証明の信頼性を理解する入口として重要です。ただし実際の処理系には、全域性を保証する論理的な核と、現実のプログラムを動かすための拡張が併存しています。
たとえば、停止性検査を回避する注釈、partialな定義、外部関数呼び出し、コード生成先の言語が持つ例外や非停止性などは、処理系ごとに異なる形で存在します。重要なのは、それらを無制限に証明へ流し込ませない境界です。
また「底がない」ことは、関数合成の等式を扱ううえで大きな違いを生みますが、あらゆるプログラム等式が自動的に観測不能な差まで含めて同一になることを意味しません。関数外延性、証明の非関連性、quotientや効果をどう扱うかは別の論点です。
本文では、証明に使える全域的な計算の範囲で、関数合成などの書き換えを考えています。
2-5 底がないと、何が変わるのか
定理証明言語には「底がない」と述べるとき、それは処理系の全体を指すのではなく、証明の整合性を支える、全域的な計算の範囲 に限った話です。
底がないおかげで、本稿で扱う関数合成などの、圏論的な書き換えが正しいことが保証 されます。

タロウくん:
先生、底がないと、初回記事で扱った問題は起きないということですか。
ここでいう問題とは、Haskell で恒等律が破れた という話でしたね。
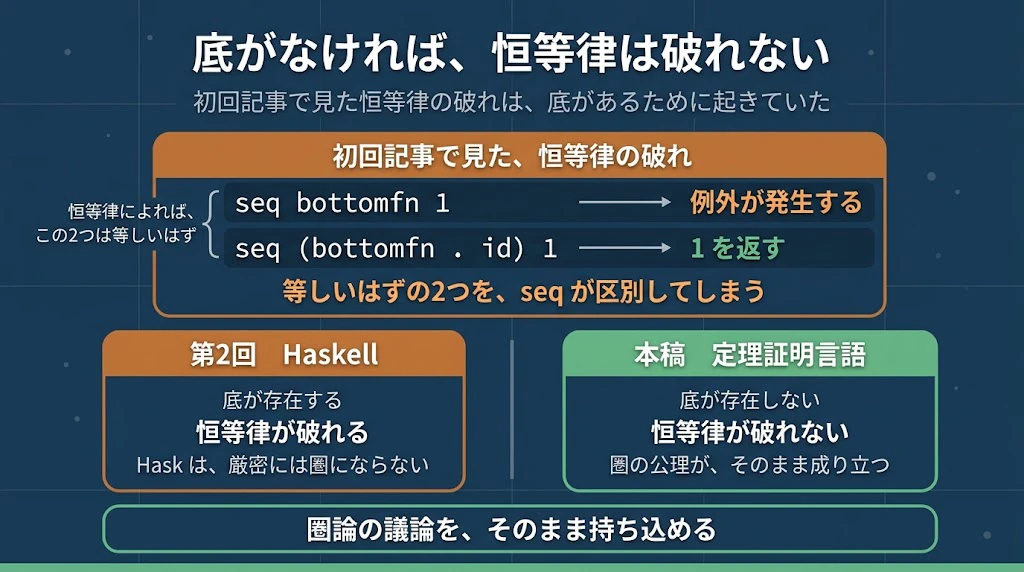
bottomfn と bottomfn . id は、恒等律によれば等しいはずなのに、seq に渡すと片方は例外を投げ、もう片方は値を返してしまう。
この食い違いが、Hask が厳密には圏にならない理由でした。
専任講師:
そのとおりです。
初回記事で見た恒等律の破れは、底があるために起きました。
bottomfn と bottomfn . id を seq が区別する、という現象です。
定理証明言語には底がないので、この問題が起きません。
圏の公理が、そのまま成り立ちます。
タロウくん:
すると、圏論の議論を、より安心して使える ということですか?
専任講師:
そうです。
ここに、ひとつの皮肉があります。
圏論をもっとも熱心に語るのは Haskell の界隈です。
Functor、Monad、Applicative といった言葉は、Haskell のコミュニティで日常的に使われています。初回記事で見たとおり、GHC は圏論の法則を書き換え規則として使っています。
しかし、圏論の議論がそのまま通るのは、定理証明言語のほうなのです。
Haskell   底があるため、Hask は厳密には圏にならない
Lean 4    全域性が保証されるため、圏論的な議論がそのまま通る
ただし、誤解しないでください。Haskell で圏論を語ることが無意味だという話ではありません。
初回記事で扱ったとおり、GHC の書き換え規則は実際に動いており、プログラムの実行時間を短縮しています。
厳密には圏でなくても、実務では機能しています。
初回記事の第9章で扱った論文が、その正当性を保証しています。
部分的な言語における推論を、全域的な言語での推論として正当化する、という内容でした。
定理証明言語では、その正当化が要りません。
最初から全域だからです。
【上級者向けコラム】Haskは「圏ではない」をどう理解するか
bottomとseqを理由にHaskを厳密な圏として扱えない、という説明は本連載の導入として有用です。ただし、Haskellの非停止性や部分性を扱う意味論には領域理論など別の圏論的枠組みがあります。したがって「Haskellでは圏論が使えない」という意味ではなく、本連載では通常のHask上で射の等式を数学的な等式と同じように扱えるかを問題にしています。
第3章 3つの世代:何を圏論で見るか
3-1 なぜ世代で分けるのか
本稿では、言語を3つの世代に分けて扱います。
本連載では便宜上、第1世代/第2世代/第3世代と呼びます。
この「世代」という言い方は、一般的に確立された分類名ではありません。本稿独自の造語です。
| 世代 | 言語 | 何を圏論で見るか |
|---|---|---|
| 第1世代 | Haskell、OCaml、Standard ML、F#、Scala | 関数を圏論で見る |
| 第2世代 | Agda、Idris 2、Lean 4、Rocq | 依存型を含む型理論を圏論的に意味づける |
| 第3世代 | Arend、Cubical Agda | 型の等しさを幾何学として見る |
タロウくん:
先生、この分け方は、本連載の 4つの比較軸 とは別のものですか?
専任講師:
別のものです。ただし、無関係ではありません。
4つの軸 は、言語の性質を見るためのものです。
型付けはどうか、評価戦略はどうか、という具合です。
3つの世代 は、圏論が何を対象にしているか という観点から分類を試みるものです。
同じ「圏論を使う」と言っても、何を圏の対象とみなすかが違います。
タロウくん:
何を対象とみなすか、ですか。
専任講師:
はい。順に見ていきましょう。
3-2 第1世代:関数を圏論で見る
第1世代では、型を対象、関数を射とみなします。
タロウくん:
先生、圏の対象と射という言葉が出てきました。これは何ですか。
専任講師:
圏を作るのに必要な、2つの要素です。
対象は、点だと思ってください。
射は、対象から対象への矢印です。
A ──f──▶ B ──g──▶ C
ここで A、B、C が対象、f と g が射です。
圏であるためには、2つのことが成り立つ必要があります。
| 条件 | 内容 |
|---|---|
| 合成できる |
f : A → B と g : B → C があれば、g . f : A → C が作れる |
| 恒等射がある | どの対象 A にも、id : A → A という「何もしない射」がある |
さらに、合成が結合律を満たし、恒等射が恒等律を満たす必要があります。
タロウくん:
初回記事で出てきた恒等律は、この条件のことですね。
専任講師:
そのとおりです。
f . id = f と id . f = f が成り立つこと。
これが恒等律です。Haskell では、底があるためにこれが破れました。
タロウくん:
第1世代では、型が対象で、関数が射なのですね。
専任講師:
はい。Int や String が対象、Int -> String のような関数が射です。
関数の合成が射の合成にあたり、id が恒等射にあたります。
第2回で扱った Functor 則やモナドの結合律は、すべてこの枠組みの中の話 でした。
3-3 第2世代:型そのものを圏論で見る
第2世代では、依存型 が入ります。
ここで、圏論の見方が変わります。
タロウくん:
どう変わるのですか?
専任講師:
第1世代では、型は「対象」という点でした。中身を考えません。
第2世代では、型の中に値が現れます。
第2章で見た Vec Int 3 のような型です。
すると、「型が値に依存する」という関係そのものを、圏論で表す必要が出てきます。
タロウくん:
それは、どう表すのですか?
専任講師:
局所デカルト閉圏(locally Cartesian closed category)という構造を使います。
名前が長いので、ひとつずつ分けて説明します。
| 語 | 意味 |
|---|---|
| デカルト閉圏 | 積(組)と、関数の型を持つ圏。第1世代の型システムに対応する |
| 局所 | 「各対象の上で」 という意味。対象 $A$ ごとに、$A$ に依存する 型の世界を考える |
タロウくん:
「$A$ に依存する型の世界」というのが、依存型に対応する のですね?
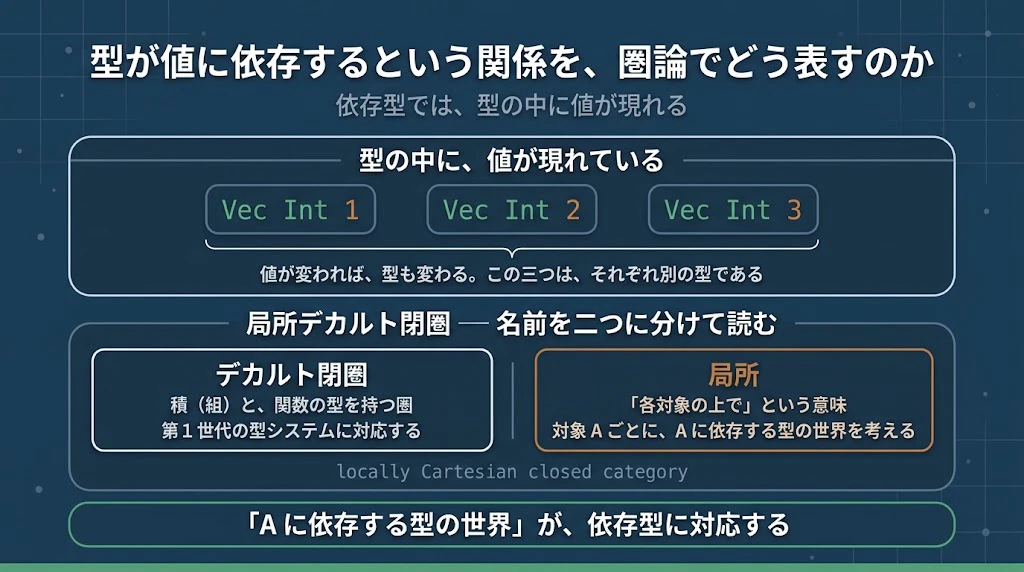
専任講師:
そのとおりです。よい整理です。
Vec Int n は、n という値に依存する型です。
n が動けば、型も変わります。
この「動く 型の族 」を、圏論では A の上の slice category として扱います。
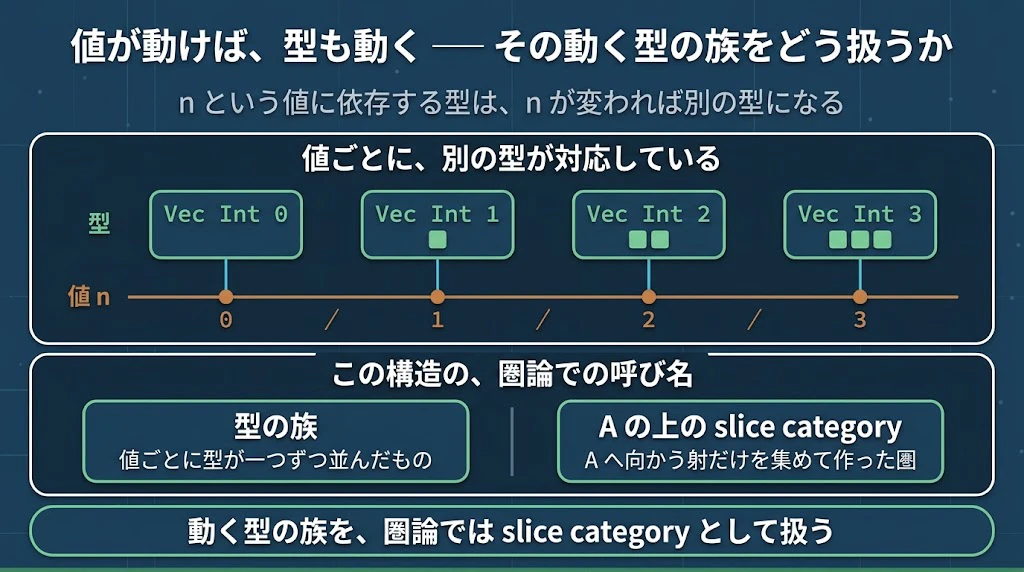
なお、ここで出てきた $A$ は、型が依存している先の値を集めた対象 です。
いまの例では、Vec Int n の n が自然数ですから、$A$ にあたるのは自然数の対象です。
n が 0 のときは Vec Int 0、1 のときは Vec Int 1 というように、$A$ の各点に型が1つずつ対応しています。
型が何に依存しているかによって、$A$ が何になるかも変わります。
- リストの長さに依存するなら $A$ は自然数
- 文字列に依存するなら $A$ は文字列の対象
です。
なお、この $A$ という文字は、本稿の筆者が決めたものではありません。
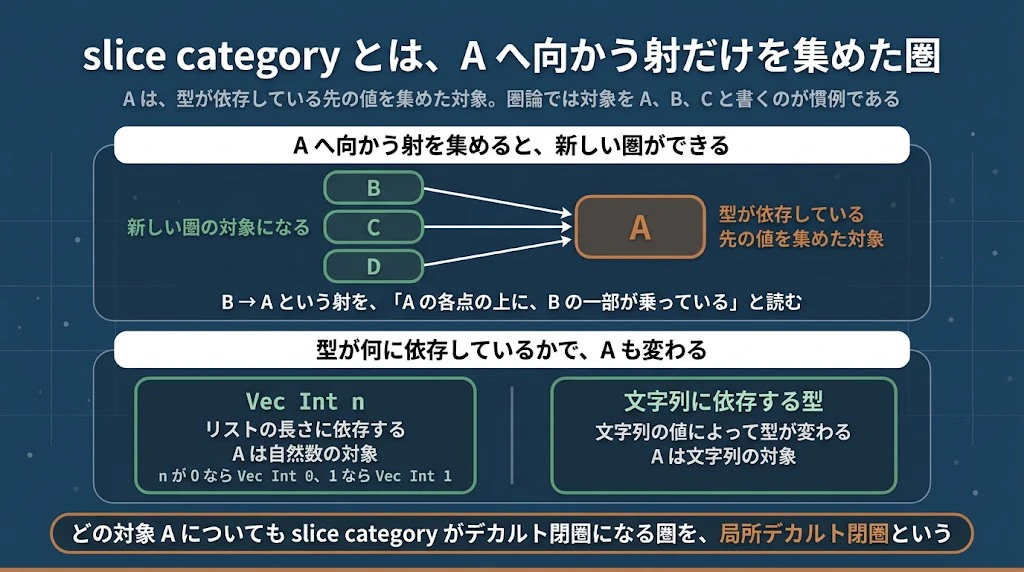
圏論では、対象を表すのに $A$、$B$、$C$ といった文字を使うのが慣例です。
数学で変数に $x$ を使うのと同じで、文字そのものに意味はありません。
決まっているのは、記法のほうです。
圏 $\mathcal{C}$ と、その対象 $A$ があるとき、$A$ の上の slice category を $\mathcal{C}/A$ と書きます。
この書き方は、Lawvere や Lambek の論文をはじめ、圏論の文献で広く使われています。
タロウくん:
先生、いまの説明は少し難しかったです。
専任講師:
少し駆け足で説明しすぎてしまいました。
ある対象 $A$ を固定して、「$A$ へ向かう射」だけを集めた新しい圏を作ります。
これが slice category です。
B ──▶ A
C ──▶ A
D ──▶ A
この B、C、D が、新しい圏の対象になります。
なぜこれが依存型に対応するのか。
B → A という射を、「$A$ の各点の上に、$B$ の一部が乗っている」と読むからです。
$A$ の点 n に対して、Vec Int n が乗っている、という具合です。
タロウくん:
$A$ の点ごとに、別の型が対応しているのですね?
専任講師:
そうです。これが依存型の圏論的な姿 です。
局所デカルト閉圏とは、どの対象 $A$ についても、その slice category がデカルト閉圏になっているような圏のことです。
3-4 内部言語という考え方
ここで、本稿の主題に関わる重要な概念が出てきます。
タロウくん:
先生、圏論で型を表せることは分かりました。
でも、このことは一体、何の役に立つのですか?
専任講師:
逆向きに使えることが役に立ちます。
いま説明したのは、「型理論を圏論で表す」という方向 でした。
逆に、「ある圏が与えられたとき、その圏を記述する型理論を取り出す」こともできます。
この取り出された型理論 を、その圏の内部言語(internal language)と呼びます。
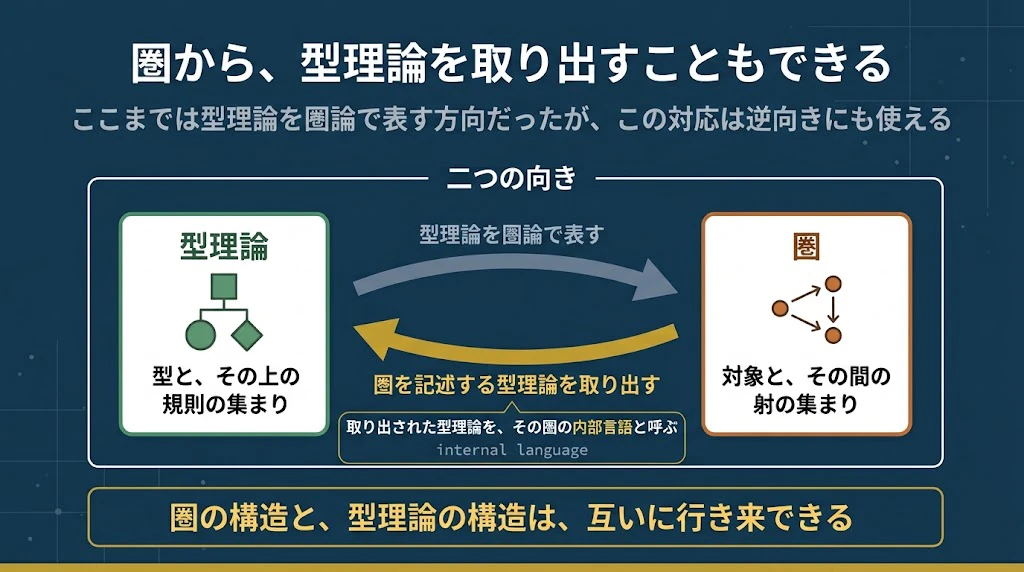
タロウくん:
圏から、言語を取り出す のですか?
専任講師:
はい。
そして、次の 定理 が知られています。
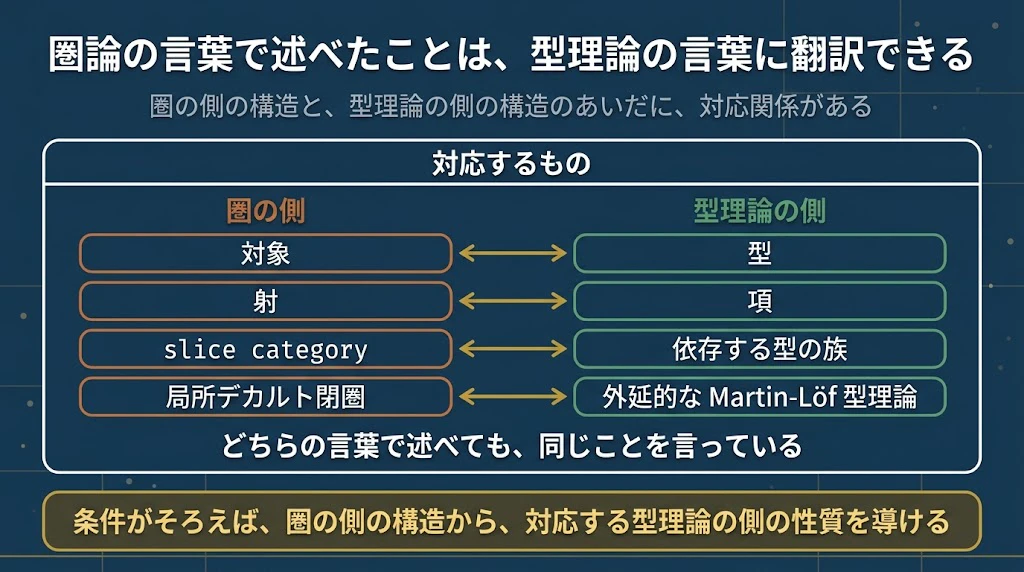
おおざっぱにいうと、局所デカルト閉圏の内部言語は、依存和と依存積を持つ外延的な Martin-Löf 型理論である。
より正確を期して言いかえると、適切な意味論上の条件のもとで、局所デカルト閉圏と、依存和・依存積を持つ外延的な Martin-Löf 型理論との対応が得られる、ということになります。
この定理には、Seely の定理 という名前がついています。
1984年に Seely が発表したものですが、その証明には不備があり、2014年に Clairambault と Dybjer が修正した形で証明し直しました。
本稿で引用する論文は、その修正版を、さらに別の土台の上で証明したものです。

タロウくん:
それは、何を言っているのですか?
専任講師:
圏の側の構造と、型理論の側の構造の間に、対応関係がある ということです。
圏論の言葉で述べたことは、型理論の言葉に翻訳できます。逆も同じです。
タロウくん:
条件がそろえば、圏論側の構造から、対応する型理論側の性質を導けるのですね。
専任講師:
そのとおりです。
ここが実務にも関わります。
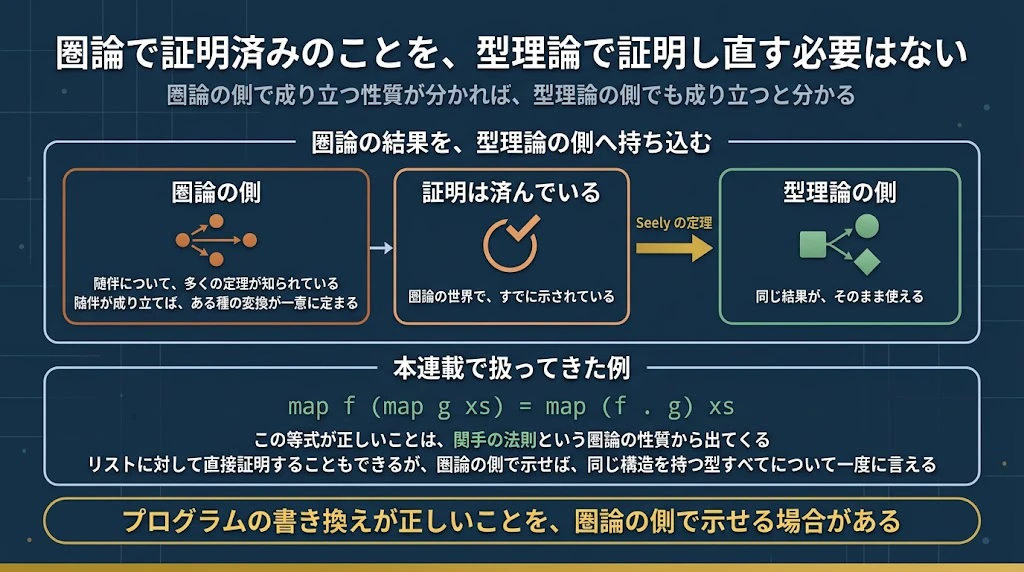
圏論の側で成り立つ性質が分かれば、型理論の側でも成り立つと分かります。
たとえば、圏論には 随伴 という概念があり、それについて多くの定理が知られています。
随伴が成り立てば、ある種の変換が一意に定まる、といった結果です。
Seely の定理があれば、こうした結果を型理論の側へ持ち込むことができます。
圏論の世界ですでに証明済みのことを、型理論の世界で証明し直す必要はないのです。
つまり、プログラムの書き換えが正しいことを、圏論の側で示せる場合があるということです。
本連載で扱ってきた map f (map g xs) の書き換えが、その例です。
この等式が正しいことは、関手の法則 という圏論の性質から出てきます。
リストに対して直接証明することもできますが、圏論の側で示せば、リストに限らず、同じ構造を持つ型すべてについて一度に言えます。
そして、この Seely の定理そのものが、定理証明支援系で形式化されています。
ただし形式化されたのは、Seely の原論文の版ではなく、Clairambault と Dybjer による修正版です。
2025年に発表された論文が、この定理を Rocq で形式化しました。
局所デカルト閉圏だけでなく、pretopos、基本トポス、宇宙を持つ基本トポスへも拡張しています。
論文中のすべての構成と証明が形式化されており、その コード は UniMath というライブラリに取り込まれています。

出典:
N. van der Weide, "The internal languages of univalent categories", 40th Annual ACM/IEEE Symposium on Logic in Computer Science (LICS 2025), pp. 112–126
doi: 10.1109/LICS65433.2025.00016
arXiv: https://arxiv.org/abs/2411.06636
【上級者向けコラム】局所デカルト閉圏と依存型の対応は、単純な「1対1」ではない
依存型理論の意味論には、文脈・型族・置換・依存積・依存和などを組織的に扱う構造が必要です。局所デカルト閉圏はその重要なモデルの一つですが、「依存型=LCCC」と一語で置き換えれば終わるわけではありません。外延的/内包的な型理論、宇宙、恒等型、univalenceなどを加えると、必要な意味論上の構造も変わります。
【上級者向けコラム】LCCCと依存型理論:対応に必要な構造
局所デカルト閉圏と依存型理論の対応を説明するときは、「依存型理論がある」ことと「LCCCだけで望む型理論のすべてを表せる」ことを区別する必要があります。
文脈、型族、置換、依存和、依存積をどのように意味づけるかに加え、内包的恒等型、外延性、宇宙、帰納型、univalence、higher inductive typesなどを扱うには、さらに構造が必要になります。CwF、comprehension category、display map categoryといった枠組みは、こうした文脈依存の構造を明示的に扱うために用いられます。
したがって「依存型 = LCCC」は有用な入口ですが、完全な同一視ではありません。本文が紹介する内部言語の定理も、どの型理論の断片を、どの意味論上の条件のもとで扱うかを明確にして読む必要があります。
タロウくん:
先生、これは「圏論を形式化した」のとは、違うのですか?
専任講師:
違います。ここは区別してください。
| 何を形式化したか | 例 |
|---|---|
| 圏論そのもの | 圏、関手、自然変換の定義と、その性質。agda-categories などのライブラリ |
| 圏論と型理論の対応 | 上の論文。「この圏の内部言語は、この型理論である」という主張そのもの |
前者は、圏論の教科書に書いてあることを機械可読にしたものです。
後者は、圏論的論理学の主張そのものを、機械が検査できる形にしたものです。
タロウくん:
後者のほうが、本稿の主題に近いのですね。
専任講師:
はい。第7章で、圏論的論理学を正面から扱います。

3-5 第3世代:型の等しさを幾何学として見る
第3世代では、さらに見方が変わります。
タロウくん:
今度は、何が変わるのですか?
専任講師:
「等しい」ということの扱いです。
第2世代までは、2つのものが等しいかどうかは、成り立つか成り立たないかのどちらかでした。
第3世代では、等しさそのものを、対象として扱います。
タロウくん:
等しさを、対象として、ですか。
専任講師:
たとえば、$a$ と $b$ が等しいという事実を考えてください。
第3世代では、これを「$a$ から $b$ への道がある」と読みます。
a ●────────● b
      道
タロウくん:
道、ですか?
専任講師:
はい。そして、道は1本とは限りません。
$a$ から $b$ への道が、複数あることがありえます。
さらに、道と道のあいだにも、等しさを考えられます。
「2本の道が等しい」とは、「道のあいだの道がある」ということです。
      道1
a ●━━━━━━━● b
  ┃         ┃    ← 道1 と 道2 のあいだの道
a ●━━━━━━━● b
      道2
タロウくん:
どこまでも続くのですか?
専任講師:
はい。道の道の道、と際限なく続きます。
この構造を扱うのが、ホモトピー型理論(homotopy type theory*)です。
タロウくん:
「ホモトピー」というのは、何ですか。
専任講師:
もともとは幾何学の言葉です。
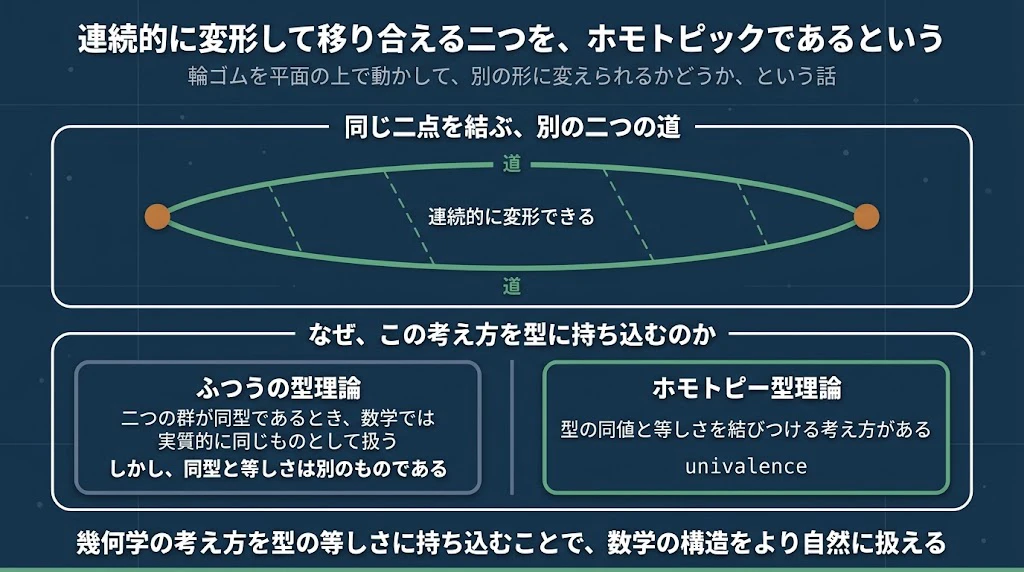
2つの道が、連続的に変形して互いに移り合えるとき、その2つはホモトピックである、と言います。
輪ゴムを平面の上で動かして、別の形に変えられるかどうか、という話だと思ってください。
この幾何学の考え方を、型の等しさに持ち込んだのがホモトピー型理論です。
タロウくん:
なぜ、そんなことをするのですか。
専任講師:
数学の構造を、より自然に扱えるからです。
たとえば、2つの群が同型であるとき、数学では実質的に同じものとして扱います。
しかし、ふつうの型理論では、同型と等しさは別のもの です。
ホモトピー型理論では、この隔たりを埋めます。
ただし、使う言葉が 同型 から 同値(equivalence)に変わります。
同値は、同型を型の世界へ持ち込んだものです。
集合については両者は一致しますが、型を空間として扱う場では、道のレベルまで含めた行き来を指します。
そのうえで、型の同値と等しさを結びつけます。
この性質を univalence と呼びます。
タロウくん:
それが、Arend や Cubical Agda の特徴なのですね?
専任講師:
そのとおりです。
本稿では、Arend を第3世代の例として扱います。ただし、深入りはしません。
ホモトピー型理論そのものが大きな主題であり、本稿の範囲を超えるためです。
タロウくん:
先生、同型と同値は、同じ概念ですか?
専任講師:
近い概念ですが、同じではありません。
同型(isomorphism)は、2つのものを互いに行き来でき、往復すると元に戻る、という関係です。
群や集合について使われる、数学でおなじみの言葉です。
同値(equivalence)は、同型より広い概念 です。
集合であれば、往復したものは元と同じ要素になりますから、両者は一致します。
しかし型を空間として扱う場では、往復したものが元と 厳密に同じ とは限らず、元へ戻る道がある という形になります。
この「道のレベルまで含めた行き来」を扱うのが、同値です。
タロウくん:
すると、univalence が結びつけているのは、どちらですか。
専任講師:
同値のほうです。
(A = B) ≃ (A ≃ B)
記号 ≃ は「同値である」を表します。
左辺は「$A$ と $B$ が等しい」、右辺は「$A$ と $B$ が同値である」という意味で、この2つが同値である というのが univalence の主張 です。
ただし、「同値なものはすべて厳密に同じである」と述べているのではありません。
等しさという概念のほうを、同値まで届く形に 広げている のです。
【上級者向けコラム】「等しい」とは何か ── 内包的等価性と拡張的等価性のジレンマ
第3章で、ArendやCubical Agdaといった第3世代の言語が登場しました。
背景には、定理証明における「等しさ」の扱いの難しさがあります。
たとえば、常に同じ結果を返す2つの関数は「等しい」とみなすべきでしょうか。
これを等しいとする立場を「拡張的等価性(extensional equality)」と呼びます。
直観的ですが、これを採用すると型検査を機械的に終わらせることができない(決定不能になる)というジレンマを抱えます。
そのため、AgdaやRocqなどは、定義の形が同じかを重視する「内包的等価性(intensional equality)」を基本としています。
この堅苦しい等しさを、幾何学的な「道」という概念を使ってスマートに、かつ計算可能な形で解決しようとするのが、ホモトピー型理論やCubical Type Theoryの大きなモチベーションの一つなのです。
【上級者向けコラム】HoTTの「道」は、単なる比喩ではない
本文ではaからbへの「道」という直観的説明を使いました。
HoTTでは、これは単なる図解上の比喩ではなく、恒等型の要素を幾何学的な対象として読む考え方に対応します。
さらに、道の間の道、その間の道……という階層構造が現れます。
Cubical Type Theoryでは、これを計算規則と結びつけて扱えることが重要です。
3-6 3つの世代の関係
タロウくん:
先生、ここまで教えていただいた3つの世代は、新しいものが古いものを置き換えるという関係ですか?
専任講師:
違います。ここは誤解しやすいところです。
3つの世代は、見る対象が違うだけです。
新しい世代が優れているという話ではありません。
| 世代 | 何に向いているか |
|---|---|
| 第1世代 | 実行できるプログラムを書くこと。実行速度を求めること |
| 第2世代 | プログラムの性質を証明すること。型で正しさを保証すること |
| 第3世代 | 数学の構造そのものを扱うこと |
タロウくん:
用途が違うのですね。
専任講師:
そうです。
Web アプリケーションを書くのに Agda を使う人は、あまりいません。
逆に、数学の定理を証明するのに Haskell を使う人も、あまりいません。
それぞれの世代が、それぞれの目的に合っています。
タロウくん:
先生、第3世代がなぜ、数学の構造そのものを扱えることにつながるのですか?
専任講師:
数学者が実際にやっていることと、型理論のできることが、ここで一致するからです。
数学では、同型な2つの群を、同じものとして扱います。
片方について証明したことは、もう片方でもそのまま成り立つ、として話を進めます。
ところが第2世代までの型理論では、同型と等しさが別のものでした。
同型であることを示しても、片方の証明を、もう片方へそのまま持っていくことができません。
タロウくん:
いちいち証明し直すのですか。
専任講師:
そうなります。同型を使って運ぶ作業を、手で書かなければなりません。
第3世代では、univalence によって、この運搬が要らなくなります。
同値であることを示せば、等しいものとして扱えるからです。
タロウくん:
数学の習慣が、そのまま使えるようになるのですね。
専任講師:
そういうことです。
数学の構造そのものを扱う、というのは、この意味です。
数学者が当たり前にしている同一視を、型理論の側が受け入れられるようになった、ということ です。
3つの世代の関係を、図に示します。
本稿で扱うのは、第2世代と第3世代です。 第1世代は、初回記事と第2回で扱いました。
【上級者向けコラム】HoTT・Cubical Type Theoryと「第3世代」という呼び方
本文の「第1世代/第2世代/第3世代」は、圏論が何を照らすかを初学者向けに見取り図として示すための連載内の呼び方です。研究史上の標準的な世代区分ではありません。
HoTTやCubical Type Theoryは、単に「型の等しさを幾何学として見る」だけではなく、恒等型を高次元の構造として扱い、univalenceや(系によっては)higher inductive typesを含む豊かな研究領域です。Cubical Type Theoryの重要な特徴の一つは、道・合成・univalenceの計算的側面を、通常の恒等型理論より直接的に扱える点にあります。
ArendやCubical Agdaをこの見取り図に置く目的は、他の言語より新しい・優れていると順位付けすることではありません。等しさをどのようなデータとして扱うかが、従来の依存型理論と異なることを示すためです。
第4章 証明は、実行時に消える
4-1 証明は、実行するときには不要である
タロウくん:
先生、定理証明言語では、プログラムに証明を付けられるのですよね。
専任講師:
はい。たとえば、割り算を考えてください。
0で割ることはできません。ふつうのプログラミング言語では、実行時に検査します。
if b == 0 then エラー else a / b
定理証明言語では、「b は0ではない」という証明を、引数として受け取ることができます。
safeDiv : (a b : Nat) -> (b ≠ 0 の証明) -> Nat
この関数を呼ぶには、「b は0ではない」ことを証明しなければなりません。
証明できなければ、そもそも呼び出せないのです。
タロウくん:
実行時の検査が、要らなくなる のですね?
専任講師:
そのとおりです。

そして、ここで疑問が出てきます。
その証明は、実行するときに必要でしょうか。
タロウくん:
必要ない気がします。すでに正しさが確かめられているので。
専任講師:
よい直観です。そのとおりです。
証明は、コンパイルの段階で検査されます。
実行するときには、もう役目を終えています。
計算する必要がありません。
この「証明を実行時に取り除くこと」を、proof erasure と呼びます。

日本語の定訳が確認できなかったため、本稿では英語のまま記します。
4-2 4つの言語で確かめた
証明を引数に取る関数を書き、実行時のコードがどうなるかを確かめました。
Rocq では、次の定義を書きました。
Definition safe_div (a b : nat) (H : b <> 0) : nat := Nat.div a b.
H が証明の引数です。
「b は0ではない」という命題の証明を受け取ります。
これを OCaml のコードとして取り出しました。
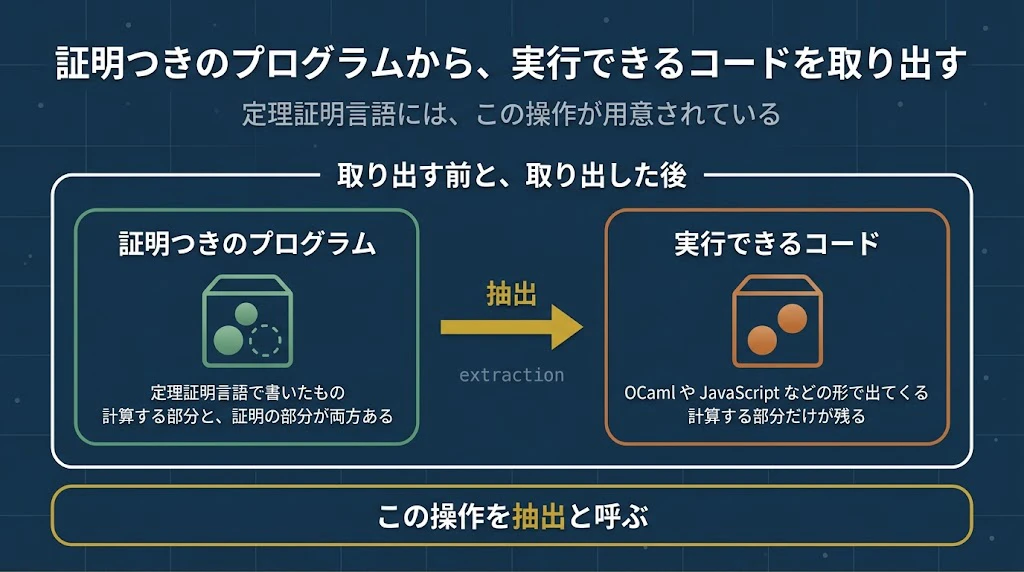
定理証明言語 では、証明つきのプログラムから実行できるコードを取り出すことができます。
この操作を抽出(extraction)と呼びます。
取り出されたコードは、次のとおりです。
(** val safe_div : nat -> nat -> nat **)

let safe_div =
  div
タロウくん:
先生、引数が2つしかありません。
専任講師:
そこが要点です。
証明の引数 H が、完全に消えています。
型も nat -> nat -> nat となっており、証明を受け取る箇所がありません。
中身も div を呼ぶだけです。
検査は1つもありません。
タロウくん:
証明した分だけ、実行時の仕事が減った のですね。
専任講師:
そのとおりです。
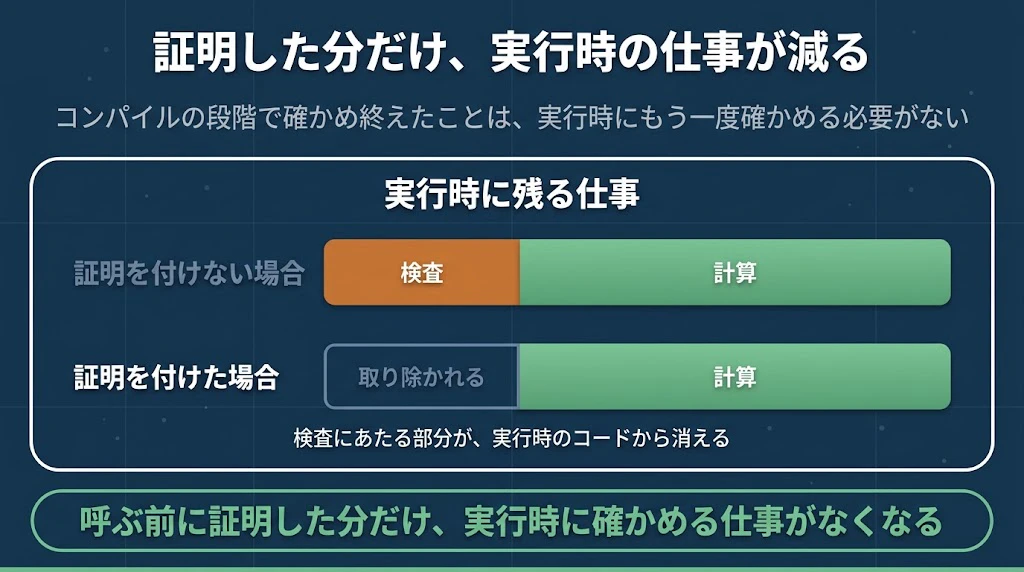
同じことを、ほかの言語でも確かめました。
4-3 4つの言語の結果
| 言語 | 取り出した形式 | 証明の引数はどうなったか |
|---|---|---|
| Rocq | OCaml | 引数そのものが消えた |
| Idris 2 | Chez Scheme | 引数そのものが消えた |
| Agda | JavaScript | 引数そのものが消えた |
| Lean 4 | C | 引数の位置は残った。ただし、本体では一度も使われない |
ここで並べるのは、各処理系が選んだ出力先で観察できた消去の形です。
OCaml、Chez Scheme、JavaScript、Cは別の実行系であり、表の引数数だけから言語全体の速さを順位付けすることはできません。
性能については、同じ Lean 4 の中で第4-5節のように別途測ります。
Idris 2 と Agda について、生成されたコードを示します。
いずれも「引数を2倍する関数」に、使わない証明の引数を付けたものです。
Idris 2(Chez Scheme のコード)
(define Er-double (lambda (arg-0) (+ arg-0 arg-0)))
Agda(JavaScript のコード)
exports["double"] = a => agdaRTS.uprimIntegerPlus(a, a);
どちらも、引数が1つだけです。証明の引数は、生成されたコードに現れません。
4-4 Lean 4 だけ、扱いが違う
Lean 4 では、同じ関数から C 言語のコードが生成されます。
LEAN_EXPORT lean_object* l_safeDiv(lean_object* x_1, lean_object* x_2, lean_object* x_3) {
_start:
{
lean_object* x_4;
x_4 = lean_nat_div(x_1, x_2);
return x_4;
}
}
タロウくん:
先生、引数が3つあります。
専任講師:
そこが、ほかの3つとの違いです。
x_1 と x_2 が、割られる数と割る数です。x_3 が証明の引数です。
引数の位置は残っています。しかし、本体を見てください。
タロウくん:
lean_nat_div(x_1, x_2) だけです。x_3 が使われていません。
専任講師:
そのとおりです。
証明の中身を計算することはありません。
ただ、引数として渡される場所だけが残っています。
タロウくん:
それは、遅くなるということですか。
専任講師:
測ってみましょう。
4-5 実測:引数が残ることに、コスト負担はあるか
証明を引数に取る関数と、取らない関数を、それぞれ300万回呼び出しました。
10回測定した結果です。
| 書き方 | 各回の値 | 中央値 |
|---|---|---|
| 証明を引数に取る | 1010、1011、1018、1019、1020、1023、1025、1025、1028、1041 ms | 1,022 ms |
| 証明を引数に取らない | 1015、1017、1017、1018、1018、1021、1024、1031、1032、1041 ms | 1,020 ms |
差は1.00倍でした。測定の揺れの範囲に収まります。
この測定は、処理系の一般的な優劣を決めるものではありません。
ここに示すプログラム、処理系の版、コンパイル設定、計算機環境における観測です。
再現手順と全測定値は、本文末の『実験環境と再現手順』に掲載します。
タロウくん:
差が出なかったのですね。
専任講師:
はい。
生成されたコードを読むと、引数が1つ多いことが分かります。
しかし、そのコスト負担は、測っても現れませんでした。
タロウくん:
なぜでしょうか。
専任講師:
引数を渡すコスト負担そのものが、非常に小さいためと考えられます。
ただし、この理由は確かめていません。
ここで、第2回の測定を思い出してください。
第2回の第6章で、Erlang の JIT を扱いました。
公式の文書に「加算の命令が14から5に減る」と書かれており、それを確かめました。
命令数は、たしかに減っていました。しかし、最初の測定では、実行時間がむしろ長くなりました。
タロウくん:
条件をそろえ直したら、記述どおりになったのでしたね。
専任講師:
そのとおりです。
コードを読んで分かる違いと、実測で現れる違いは、別のものです。
今回の Lean 4 の測定も、同じ構図です。
引数が1つ多いことはコードから分かりますが、実測では差が出ませんでした。
タロウくん:
すると、Lean 4 の方式でも問題ないということですか。
専任講師:
この測定の範囲では、そう言えます。
ただし、測ったのは1つの関数を300万回呼ぶ、という単純な場合です。
証明の引数が多数ある場合や、引数の構造が複雑な場合については、測っていません。
4-6 なぜ、言語によって扱いが違うのか
タロウくん:
先生、なぜ Lean 4 だけ、引数を残すのですか?
専任講師:
消し方の仕組みが違うためです。
4つの言語を、2つに分けられます。
| 分け方 | 言語 | 仕組み |
|---|---|---|
| 型で自動的に決まる | Rocq、Lean 4 |
Prop という種類に属する型は、実行時に不要とみなされる |
| プログラマが明示する | Idris 2、Agda | 消してよい引数に、印を付ける |
タロウくん:
Prop とは何ですか?
専任講師:
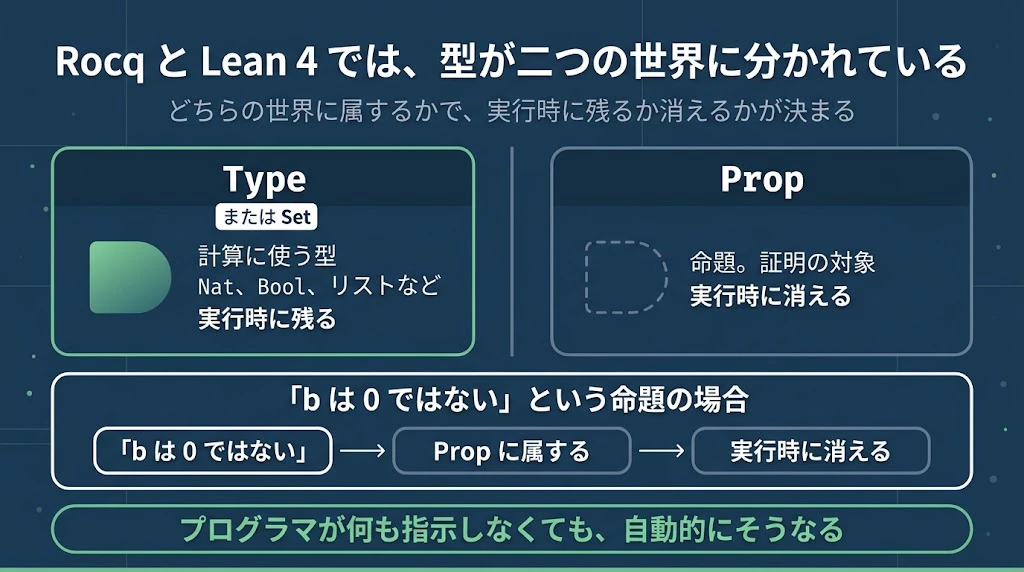
Rocq と Lean 4 では、型が2つの世界に分かれています。
| 世界 | 何が属するか | 実行時 |
|---|---|---|
Type(または Set) |
計算に使う型。Nat、Bool、リストなど |
残る |
Prop |
命題。証明の対象 | 消える |
「b は0ではない」という命題は Prop に属します。だから、実行時に消えます。
プログラマが何も指示しなくても、自動的に そうなります。
タロウくん:
Idris 2 と Agda では、どう書くのですか?
専任講師:
印を付けます。
Idris 2 では、引数の前に 0 と書きます。
double : (n : Nat) -> (0 _ : n = n) -> Nat
この 0 は、multiplicity と呼ばれる 印 です。
「この引数は、実行時に0回使われる」という意味 です。
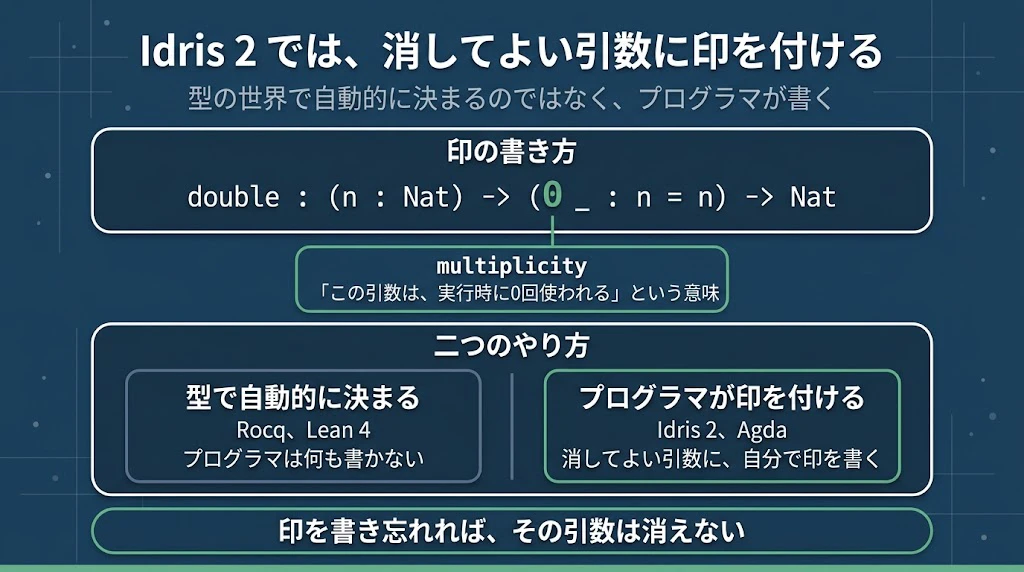
日本語の定訳を確認できなかったため、本稿では英語のまま記します。
なお、論理学で「すべての」「ある」(∀、∃)を指す量化子(quantifier)とは、別のものです。
Agda では、@0 と書きます。
double : (n : Nat) → @0 (n ≡ n) → Nat
タロウくん:
どちらがよいのでしょうか。
専任講師:
一長一短です。
| 方式 | 利点 | 欠点 |
|---|---|---|
| 型で自動的に決まる(Rocq、Lean 4) | プログラマが意識しなくてよい | どの型を Prop にするかを、設計の段階で決める必要がある |
| プログラマが明示する(Idris 2、Agda) | 消すかどうかを、使う場面ごとに選べる | 書き忘れると、消えない |
本連載の4軸でいえば、この違いは「型理論」と「言語機能」の両方にまたがります。
Prop と Type を分けるのは型理論の設計です。
Idris 2 の multiplicity や Agda の @0 の記法は、言語機能です。
【上級者向けコラム】証明の無関連性(Proof Irrelevance)
Lean 4 や Rocq が Prop に属する証明を実行時に消去できるのは、「証明の無関連性(Proof Irrelevance)」という性質があるためです。
これは、「同じ命題に対する証明は、どれも等しいとみなす」という規則です。たとえば、「2は偶数である」ことの証明の仕方が複数あったとしても、命題が真であるという事実さえあればよく、どの証明を使ったかによってその後の計算結果が変わってはいけません。
計算結果に影響を与えない(関連しない)ことが型理論によって保証されているからこそ、コンパイラは安心して証明を丸ごと消去(proof erasure)できるのです。
【上級者向けコラム】proof erasure とコンパイル後の呼出規約
生成されたコードに証明引数の「位置」が残るかどうかは、erasureの意味をそのまま測っているとは限りません。ソース言語での消去、IR上の最適化、C関数の呼出規約、バックエンド最適化、インライン化後の形は別の段階だからです。
Lean 4のC出力で x_3 が参照されないことは、証明内容を評価しないという重要な観察です。しかし、Cの関数シグネチャに引数スロットがあることだけから、最終バイナリにおける呼出コストを直ちに結論することはできません。最適化レベル、インライン化、ABI、コンパイラのdead-argument eliminationなどが関わります。
このため本文が実測へ進む構成は適切です。ただし実測も、特定のバックエンド・ビルド設定・ベンチマークのもとでの結果です。「証明が計算されない」という意味論的な観察と、「速い」という性能上の観察は、分けて読む必要があります。
4-7 本章のまとめ
| 観測したこと | 結果 |
|---|---|
| 証明は実行時に消えるか | 4つの言語すべてで消える。中身が計算されることはない |
| 消え方 | Rocq、Idris 2、Agda は引数そのものが消える。Lean 4 は引数の位置が残る |
| 引数が残ることのコスト負担 | 実測では現れなかった(1.00倍、測定の揺れの範囲) |
| 消す仕組み | Rocq と Lean 4 は Prop で自動的に。Idris 2 と Agda はプログラマが明示する |
本章で見たことを、図に示します。
この章で扱ったのは、「実行時に不要なデータを、処理系がどう扱うか」という問題です。
第2回で扱った「途中のリストを作らずに計算する」という話と、同じ種類の問題です。証明という、実行時には不要なデータをどう扱うか、という話でした。
【上級者向けコラム】proof erasure は「4言語で同じ意味」ではない
proof erasure は、証明・型情報など実行時に不要な情報を実行コードから除く考え方です。ただし、何が消えるか、いつ消えるか、明示的注釈が必要か、型の性質から自動的に消えるかは処理系ごとに異なります。LeanではPropの証明がコンパイルコードから消去され、Agdaにはruntime irrelevance等の消去機構があります。したがって「取り除き方が言語によって違う」という観察は、型理論・消去規則・コンパイラ設計の組合せの違いとして理解できます。
次の第5章では、本稿でもっとも重要な発見を扱います。論理体系の軸が、初めて明確な差を生む場面です。
第5章 排中律を導入すると、何が起きるか
本章が、本稿の中心です。
第2回では差が出なかった 論理体系の軸 が、ここで初めて 明確な違いを生みます 。
5-1 直観主義論理と古典論理
タロウくん:
先生、Executive Summary で 排中律 という言葉が出てきました。
もう一度、説明していただけますか。
専任講師:
はい。排中律 とは、次の規則です。
どんな命題 $P$ についても、「$P$ が成り立つ」か「$P$ の否定が成り立つ」かのどちらかである。
タロウくん:
当たり前のことを言っているように聞こえます。
専任講師:
日常の感覚では、そうです。
しかし、この規則を無条件には認めない論理があります。
| 論理体系 | 排中律 |
|---|---|
| 古典論理 | 認める |
| 直観主義論理 | 公理としては置かない。一般には証明できない(ただし、排中律を否定するわけでもない) |
タロウくん:
なぜ、無条件には認めない立場があるのですか。
専任講師:
「どちらかである」と述べるだけでは、どちらなのかが分からないからです。
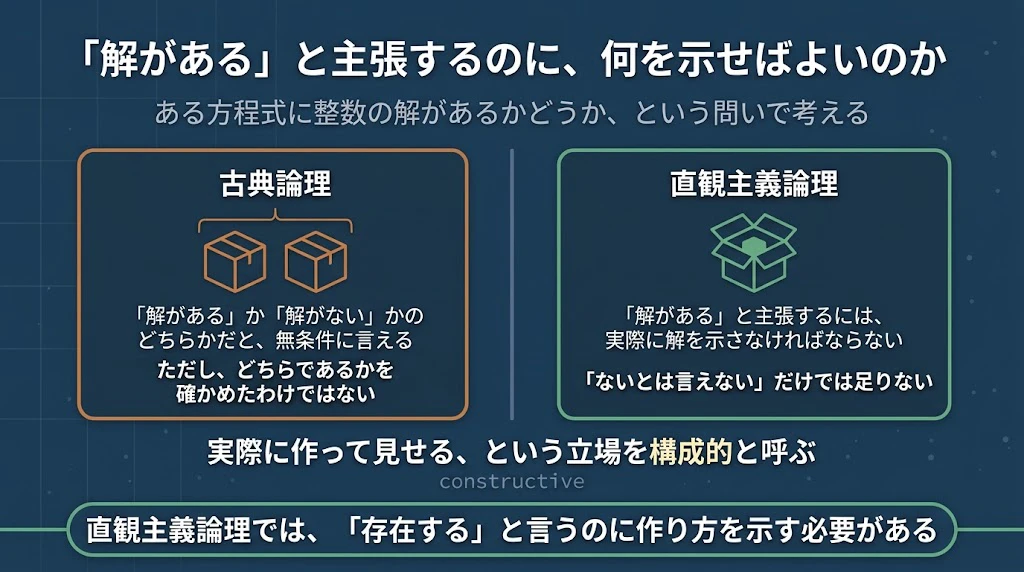
例を挙げます。次の命題を考えてください。
ある方程式には、整数の解がある。
古典論理であれば、「解がある」か「解がない」かのどちらかだと、無条件に言えます。
しかし、どちらであるかを確かめたわけではありません。
直観主義論理では、「解がある」と主張するには、実際に解を示さなければなりません。
「ないとは言えない」だけでは足りません。
タロウくん:
実際に作って見せろ、ということですか。
専任講師:
そのとおりです。この立場を 構成的 (constructive)と呼びます。
直観主義論理は、構成的な数学の論理 です。
「存在する」と言うには、作り方を示す必要があります。
5-2 なぜ、定理証明言語は直観主義論理を選ぶのか
タロウくん:
先生、なぜ多くの定理証明言語が、直観主義論理を選ぶのですか。
不便に思えます。
専任講師:
証明がそのままプログラムになるからです。
第2章で、Curry-Howard 対応を扱いました。証明とプログラムが同じものである、という対応です。
この対応が成り立つのは、構成的な証明 についてです。
タロウくん:
どういうことですか。
専任講師:
「解がある」という証明が、実際に解を作る手続きを含んでいれば、その証明はそのまま「解を計算するプログラム」になります。
逆に、「ないとは言えない」だけの証明からは、何も計算できません。
タロウくん:
だから、構成的な証明にこだわるのですね。
専任講師:
そのとおりです。よい整理です。
本稿で扱う6つのうち、5つが直観主義論理を土台としています。
| 論理体系 | 言語 |
|---|---|
| 直観主義論理 | Agda、Idris 2、Lean 4、Rocq、Arend |
| 古典論理 | Isabelle/HOL |
5-3 排中律を、公理として付け加える
タロウくん:
先生、直観主義論理の言語では、古典論理の証明は書けないのですか。
専任講師:
書けます。排中律を公理として付け加えればよい のです。
公理 とは、証明なしに 正しいと認める前提のことです。
処理系に「この規則は、証明せずに 使ってよい」と宣言します。
Lean 4、Rocq、Agdaは、いずれも直観主義論理を土台にしています。
この土台だけでは、どんな命題についても排中律が成り立つと証明することはできません。
しかし、必要に応じて古典的な原理を使うことはできます。
Lean 4 では標準ライブラリが用意した Classical.em を使えます。
Rocq では古典論理のライブラリを読み込めます。
Agda では postulate を使って、公理として仮定できます。
ここでは、まずそれぞれの書き方を見てみましょう。
Lean 4:標準ライブラリから使う
theorem em_from_library (P : Prop) : P ∨ ¬ P :=
  Classical.em P

#check Classical.em
Classical.em は標準ライブラリで利用できる排中律です。
ここでは「自分で新たな公理を宣言」しているわけではありません。
#check は式の型を表示します。
open Classical を書けば、名前空間を省略して em P と書くこともできます。
Lean 4:公理を自分で宣言する
axiom myExcludedMiddle (P : Prop) : P ∨ ¬ P

theorem em_from_own_axiom (P : Prop) : P ∨ ¬ P :=
  myExcludedMiddle P

#print axioms em_from_own_axiom
こちらは axiom で、証明を与えずに原理を仮定する 例です。
標準ライブラリのClassical.em を使う先ほどの例とは、意味が違います。
#print axioms では、この定理が依存する公理を確認できます。
Rocq:ライブラリを読み込む
Require Import Classical.

Check classic.

Theorem em_from_library : forall P : Prop, P \/ ~ P.
Proof.
  intro P.
  apply classic.
Qed.
Require Import Classical. により、古典論理のライブラリを読み込みます。
classic が排中律を表します。読み込みは、基礎となる論理体系そのものを変更する操作ではありません。
Rocq:公理を自分で宣言する
Axiom my_excluded_middle : forall P : Prop, P \/ ~ P.

Theorem em_from_own_axiom : forall P : Prop, P \/ ~ P.
Proof.
  intro P.
  apply my_excluded_middle.
Qed.
Axiom は証明なしで新しい前提を置く命令です。
Agda:postulateで仮定する
module ExcludedMiddleExample where

open import Relation.Nullary using (¬_)
open import Data.Sum using (_⊎_)

postulate
  em : (P : Set) → P ⊎ ¬ P

use-em : (P : Set) → P ⊎ ¬ P
use-em P = em P
postulate は、証明を与えずに em を仮定する書き方です。P ⊎ ¬ P は「Pか、Pではないか」のどちらかを表します。これはAgda標準ライブラリの Data.Sum と Relation.Nullary を使う例です。
4つの言語での書き方を、表にまとめます。
| 言語 | 標準ライブラリから使う | 自分で公理として宣言する | 依存する公理を確かめる |
|---|---|---|---|
| Lean 4 | Classical.em |
axiom |
#print axioms |
| Rocq |
Require Import Classical. の classic
|
Axiom |
Print Assumptions |
| Agda |
Axiom.ExcludedMiddle の型 |
postulate |
── |
| Idris 2 | ── | 公理を仮定する仕組み | ── |
Rocq の Print Assumptions と Agda の確認手段については、本稿では実機で確かめていません。Lean 4 の #print axioms は、5-7 で実際に使います。
ここまでのコードは、排中律を「使えるようにする」方法を示しただけです。
どの例も、任意の命題について真偽を計算する手順までは与えていません。
次に、こうした原理を使って場合分けをする関数を書き、実行用のコードを作ろうとすると何が起きるかを比べます。
【上級者向けコラム】命題としての排中律と、計算できる判定は同じではない
本文では、排中律を使って分岐を書くと実行できるコードにならない場合を見ました。ここで区別したいのは、命題としての「P または ¬P」と、実行時に分岐できるデータとしての Decidable P(あるいはそれに相当する値)です。
構成的な型理論では、P ⊎ ¬P の値を持つことは、左か右かを実際に示すことを意味します。したがって、その値は場合分けに使えます。一方で、古典的な原理を公理として置き、どちら側かを計算する実装を与えないなら、実行時の分岐に必要な情報は得られません。
Rocqの例で計算に現れるのは、単に Prop 内の排中律ではなく、情報を持つ決定を得るための古典的な選択・記述の原理です。Lean 4が noncomputable を要求する例も、「この定義は計算用のコードを持たない」と明示させる仕組みとして読むと分かりやすくなります。
したがって、本章の結論は「古典論理はプログラムにできない」ではありません。古典的な原理への依存を、計算に必要なデータ選択へ持ち込むとき、処理系ごとにその依存を露呈させる段階が異なる、ということです。
注意:排中律を使った証明が、いつでも実行時の分岐に必要な値を計算できないになるわけではありません。本章で問題にしているのは、命題についての結論を、if の分岐のように実行時のデータ選択へ使う場合です。証明だけを Prop の中で使う場合と、計算に必要な情報を取り出そうとする場合では、事情が異なります。
なお、この Require Import Classical. については、過去記事【思考実験】法律は本当に二値論理なのか? ── 多値論理・量子論理・様相論理から眺める法的判断でも取り上げました。そちらでは、二重否定除去が素の Rocq では証明できず、この1行を書いて初めて証明できることを、実際のコードで示しています。
タロウくん:
それなら、困らないのではないですか。
専任講師:
証明を書くだけなら、困りません。
しかし、その証明からプログラムを取り出そうとすると、問題が起きます。
タロウくん:
なぜですか。
専任講師:
5-1 で述べたとおり、排中律は「どちらかである」と述べるだけで、どちらであるかを示しません。
プログラムを実行するには、実際にどちらであるかを計算しなければなりません。
排中律には、その計算の手続きが含まれていないのです。
タロウくん:
中身のない約束のようなものですね。
専任講師:
よい比喩です。
「どちらかであることは保証する。ただし、どちらかは教えない」という約束です。
証明としては使えますが、計算としては使えません。
5-4 4つの言語で確かめた
排中律を使って、計算内容を持つ定義を書くとどうなるでしょうか。
4つの言語で確かめました。
| 言語 | 結果 |
|---|---|
| Lean 4 | コンパイルが拒否される |
| Rocq | 型検査は通る。抽出したコードに公理が残り、実行すると必ず失敗する |
| Agda | 型検査は通る。生成したコードで公理が undefined になり、実行すると失敗する
|
| Idris 2 | 型検査は通る |
順に見ていきます。
5-5 Rocq:実行すると必ず失敗するコードができる
Rocq で、次の定義を書きました。
Require Import Classical.
Require Import ClassicalDescription.

Definition decide_classical (P : Prop) : {P} + {~P} := excluded_middle_informative P.

Definition f (n : nat) : nat :=
  if decide_classical (n = 0) then 1 else n.
decide_classical は、「どんな命題 P についても、P が成り立つか、成り立たないかを判定する」という定義です。排中律を使っています。
f は、その判定を使って、n が 0 なら 1 を、そうでなければ n を返します。
型検査は、問題なく通りました。
次に、この定義から OCaml のコードを取り出しました。そのとき、警告が出ました。
Warning: The following axiom must be realized in the extracted code: constructive_definite_description.
筆者による日本語訳:
警告:次の公理は、抽出されたコードの中で実装されなければならない:constructive_definite_description
取り出されたコードは、次のとおりです。
let constructive_definite_description =
  failwith "AXIOM TO BE REALIZED"

let f n =
  match decide_classical with
  | Left -> S O
  | Right -> n
タロウくん:
先生、failwith "AXIOM TO BE REALIZED" というのは。
専任講師:
「実装されるべき公理」という意味で、必ず失敗する関数です。
f 自体は、正しく取り出されています。しかし、その中で decide_classical を呼んだ時点で、この failwith に到達します。
タロウくん:
実行すると、そこで止まるのですね。
専任講師:
はい。例外が発生します。
証明としては正しく、型検査も通り、コードとして取り出すこともできる。
しかし、実行すると必ず失敗します。
タロウくん:
それは、気づきにくいですね。
専任講師:
警告は出ます。しかし、警告を見落とせば、実行するまで分かりません。
【上級者向けコラム】Rocqの抽出で「警告」と「実行時失敗」は別物
Rocqの抽出では、論理公理について警告が出る場合と、計算内容を持つ未実装の公理が抽出コードに例外として残る場合を区別する必要があります。
したがって本稿の実験結果は、「Rocqは公理を許すので即座に実行不能」という話ではありません。
今回の例では、古典的な決定手続きを計算に組み込んだ結果、抽出時に未実装の公理への依存が露呈し、完成した実行コードにはならない、という観測です。
5-6 Lean 4:コンパイルの段階で拒否される
同じことを Lean 4 で書くと、結果が違います。
open Classical

def f (n : Nat) : Nat :=
  if Classical.propDecidable (n = 0) matches isTrue _ then 1 else n
この定義は、コンパイルが通りません。 次のエラーになります。
error: failed to compile definition, consider marking it as 'noncomputable' because it depends on 'Classical.propDecidable', and it does not have executable code
筆者による日本語訳:
エラー:定義のコンパイルに失敗しました。'Classical.propDecidable' に依存しており、実行できるコードを持たないため、'noncomputable' を付けることを検討してください
タロウくん:
先生、noncomputable とは何ですか。
専任講師:
「この定義は計算できない」と、プログラマが明示する印 です。
これを付ければ、定義できます。ただし、実行することはできません。
noncomputable def f (n : Nat) : Nat := ...
タロウくん:
実行できないことを、最初から分かって書くのですね。
専任講師:
そのとおりです。
Lean 4 は、実行できない定義を、実行できるもののふりをさせません。 印を付けることを求めます。
タロウくん:
Rocq との違いが、はっきりしていますね。
専任講師:
はい。整理しましょう。
| 言語 | 実行できない定義を書いたとき |
|---|---|
| Rocq | 型検査は通る。抽出時に警告。実行して初めて失敗する |
| Lean 4 | コンパイルの段階で拒否される。noncomputable を付ければ定義できるが、実行はできない |
5-7 依存する公理を、確かめる手段
Lean 4 には、もうひとつの仕組みがあります。
ある定義が、どの公理に依存しているかを表示できます。
#print axioms f
先ほどの f について実行すると、次のように表示されました。
'f' depends on axioms: [propext, Classical.choice, Quot.sound]
タロウくん:
3つの公理に依存している、ということですか?
専任講師:
はい。それぞれ、次のものです。
| 公理 | 内容 |
|---|---|
propext |
同値な命題は等しい、という規則 |
Classical.choice |
選択公理。Lean 4 の排中律 Classical.em は、この選択公理に、propext と関数の外延性(Quot.sound から導かれる)を組み合わせて導かれる(Diaconescu の定理として知られる議論) |
Quot.sound |
商型に関する規則 |
タロウくん:
自分が書いた証明が、何に頼っているかを確かめられるのですね。
専任講師:
そこが要点です。
数学の形式化では、どの公理を使ったかが重要になる場合があります。 選択公理を使わずに証明したい、という場面があるからです。
この仕組みがあれば、使った公理を後から確かめられます。
5-8 Agda:公理は undefined になる
Agda では、postulate という構文で公理を宣言します。
postulate em : (A : Set) → A ⊎ (¬ A)

f : Nat → Nat
f n with em (n ≡ 0)
... | inl _ = 1
... | inr _ = n
型検査は、問題なく通りました。
この定義から JavaScript のコードを生成すると、次のようになりました。
exports["em"] = undefined
タロウくん:
undefined ですか。
専任講師:
はい。中身のない値 です。
これを呼び出すと、実行時に失敗します。Rocq の failwith と、同じ構図です。
タロウくん:
Agda も、実行するまで分からないのですね。
専任講師:
そのとおりです。
5-9 第2回と、まったく同じ対比が現れた
ここが、本章でもっとも重要な点です。
タロウくん:
先生、この4つの言語の違いは、どう整理すればよいのでしょうか。
専任講師:
第2回で見た対比を、思い出してください。
第2回では、静的型付けの言語と動的型付けの言語を比べました。
| 第2回で見たこと |
|---|
| 静的型付けの言語は、規則を満たさない関数をコンパイルの段階で拒否する |
| 動的型付けの言語では書けてしまい、実行するまで誤りに気づけない |
本章で見たことは、これと同じ形をしています。
| 本章で見たこと |
|---|
| Lean 4 は、実行できない定義をコンパイルの段階で拒否する |
| Rocq と Agda では型検査が通り、実行して初めて失敗する |
今回の実機検証では、Lean 4 はコンパイル段階で拒否され、Rocq と Agda は型検査を通った後、抽出・生成されたコードの実行時に失敗しました。つまり、今回の実機検証の限りでは、RocqとAgdaは、実行して初めて失敗する結果となりました
タロウくん:
たしかに、同じ形です。
専任講師:
並べてみましょう。
| 第2回 | 本章 | |
|---|---|---|
| 何を書いてしまったか | 規則を満たさない関数 | 実行できない定義 |
| 早く気づく側 | 静的型付けの言語(Haskell、OCaml、PureScript) | Lean 4 |
| 遅れて気づく側 | 動的型付けの言語(Clojure、Erlang、Common Lisp) | Rocq、Agda |
| いつ気づくか | コンパイル時 か 実行時 | コンパイル時 か 実行時 |
タロウくん:
第2回では型付けの違いが分けていましたが、ここでは何が分けているのですか。
専任講師:
論理体系そのものではありません。
Lean 4 も Rocq も Agda も、いずれも直観主義論理を土台としています。論理体系は同じです。
分けているのは、処理系が「実行できるかどうか」をいつ検査するか です。
タロウくん:
論理体系が同じでも、処理系の設計が違うのですね。
専任講師:
そのとおりです。よい整理です。
論理体系は、何を証明できるかを決めます。 しかし、実行できない定義をいつ見つけるかは、処理系の設計が決めます。
この2つは、別のものです。
5-10 古典論理を土台とする Isabelle/HOL では
タロウくん:
先生、Isabelle/HOL ではどうなるのですか。
専任講師:
Isabelle/HOL は、古典論理を土台としています。排中律が、最初から認められています。
したがって、公理として付け加える必要がありません。本章で見た問題は、そもそも起きません。
タロウくん:
すると、Isabelle/HOL のほうが便利なのですか。
専任講師:
証明を書くだけなら、そう言えます。 古典論理の証明を、何の準備もなく書けます。
しかし、代わりに手放しているものがあります。
証明がそのままプログラムになる、という性質です。
Isabelle/HOL では、証明からコードを生成する仕組みが別に用意されています。証明をそのまま実行するのではなく、実行できる形に改めて書き直す、という手順になります。
タロウくん:
第2回でも、こういう話がありました。片方の問題がなくなる代わりに、別の問題が出てくる、という。
専任講師:
よく覚えていました。第2回の第4章で、正格評価と非正格評価を比べたときの話です。
ここでも同じです。 古典論理を選ぶと、排中律などを前提として証明を書けやすくなります。他方で、直観主義論理を選べば、構成的な型理論では、証明の計算的内容をそのままプログラムとして利用しやすくなります。これは、論理体系全体の優劣を示すものではありません。
Isabelle/HOL では排中律は論理体系に含まれます。そのため『外から追加した未実装公理』という今回の失敗の形は生じません。ただし、古典的な証明をそのまま計算として読むことと、仕様から実行コードを生成することは別の仕組みです。後者は第8章で扱います。
なお、本稿では Isabelle/HOL の実機検証を実施していません。この節の内容は、文献にもとづくものです。Isabelle/HOL については、第8章で改めて扱います。
【上級者向けコラム】古典論理の証明もプログラムになる? ── 制御オペレータとの対応
本文では「直観主義論理の証明がプログラムになる」と説明しました。では、古典論理の証明(排中律や二重否定の除去)は、プログラムの世界では何にも対応しないのでしょうか。
実は1990年、Timothy Griffinによって、古典論理の規則が「継続(continuation)」を操作する制御オペレータ(Schemeの call/cc など)にちょうど対応することが発見されました。
排中律を使えば「未来の計算を途中で打ち切って別の計算にジャンプする」ようなプログラムとして解釈できるのです。本文の「古典論理は実行できない」という説明は、純粋で副作用のない計算(値の計算)に限った場合の話です。計算の概念を「制御のジャンプ」まで広げると、古典論理にもCurry-Howard対応が成り立ちます。
【上級者向けコラム】古典論理だから計算できない、とは限らない
本稿では、排中律を公理として加えたとき、その証明から直接計算内容を取り出せない例を扱いました。これは「古典論理には計算がない」という意味ではありません。どの論理原理を、どの型・意味論・抽出方式と組み合わせるかが重要です。Isabelle/HOLのように、仕様と証明を構築したうえで、コード生成という別の仕組みによって実行可能なコードを得る方式もあります。
5-11 本章のまとめ
| 観測したこと | 結果 |
|---|---|
| 排中律を公理として付け加えられるか | 4つの言語すべてで、付け加えられる |
| その定義を実行できるか | できない。排中律は、どちらが成り立つかを示さないため |
| 実行できないことに、いつ気づくか | Lean 4 はコンパイル時。Rocq と Agda は実行時 |
| 何がこの違いを生むか | 論理体系ではない。処理系が「実行できるかどうか」をいつ検査するか |
本章で見た対比を、図に示します。
次の第6章では、依存型に話を移します。型で正しさを保証すると、実行時の検査をどれだけ減らせるのかを扱います。
第6章 型で保証すると、実行時の検査は減るのか
6-1 この章で確かめること
第2章で、依存型を扱いました。型の中に値が現れる仕組みです。
長さつきのリストを例に挙げました。
Vec Int 3 -- 長さ3の、整数のリスト
この型があれば、「長さが1以上のリスト」だけを受け取る関数を書けます。空のリストを渡そうとすると、コンパイルの段階で拒否されます。
タロウくん:
先生、第2章では「実行時の検査が要らなくなる」と言われました。
専任講師:
はい。そのとおりです。
通常のリストから先頭を取り出す関数は、空かどうかを実行時に検査しなければなりません。長さつきリストであれば、型がすでに保証しているので、検査が要りません。
本章では、その検査が本当に消えるのか、消えたとして実行時間が短くなるのかを確かめます。
6-2 3つの言語で、生成されたコードを比べた
Lean 4、Idris 2、Rocq で、同じ2つの関数を書きました。
| 書き方 | 内容 |
|---|---|
| 通常のリスト | 空かどうかを検査してから、先頭を取り出す |
| 長さつきリスト | 型が長さ1以上を保証しているので、そのまま取り出す |
生成されたコードを比べます。
6-3 Lean 4:検査が完全に消える
通常のリストの場合
生成された C のコードは、次のとおりです。
LEAN_EXPORT lean_object* l_headOption(lean_object* x_1) {
if (lean_obj_tag(x_1) == 0)
{
lean_object* x_2;
x_2 = lean_unsigned_to_nat(0u);
return x_2;
}
...
タロウくん:
lean_obj_tag(x_1) == 0 というのが、検査ですか。
専任講師:
そのとおりです。
Lean 4 では、データの種類を タグ という番号で区別しています。空のリストのタグが 0 です。
この行は、「渡されたリストのタグが 0 か、つまり空かどうか」を確かめています。空であれば、0 を返して終わります。
長さつきリストの場合
LEAN_EXPORT lean_object* l_vhead___rarg(lean_object* x_1) {
lean_object* x_2;
x_2 = lean_ctor_get(x_1, 1);
lean_inc(x_2);
return x_2;
}
タロウくん:
検査がありません。
専任講師:
はい。lean_ctor_get で、直接中身を取り出しています。
型が「空ではない」と保証しているので、確かめる必要がないのです。
6-4 Idris 2:同じく検査が消える
Idris 2 でも、同じ結果になりました。生成された Chez Scheme のコードです。
| 書き方 | 生成されたコード |
|---|---|
| 通常のリスト | (lambda (arg-0) (if (null? arg-0) ... |
| 長さつきリスト | (lambda (arg-1) (let ((e-2 (car arg-1))) e-2)) |
通常のリストには (if (null? arg-0) ...) という検査があります。長さつきリストには検査がなく、car で直接取り出しています。
6-5 Rocq:検査が残る
Rocq では、結果が違いました。抽出された OCaml のコードです。
通常のリスト
let head_option = function
| Nil -> O
| Cons (x, _) -> x
長さつきリスト
let vhead _ = function
| Vnil -> Obj.magic __
| Vcons (_, x, _) -> x
タロウくん:
先生、長さつきリストのほうにも Vnil の場合が書かれています。
専任講師:
よく気づきました。そこが要点です。
Vnil は空のリストです。この関数は「長さ1以上」しか受け取らないので、この場合は起こりえません。
それでも、抽出されたコードには残っています。
タロウくん:
Obj.magic __ というのは何ですか。
専任講師:
到達しない場所を埋めるための値 です。
型の上では起こりえないと分かっているので、中身のない値を置いてあります。もし実行が到達すれば、何が起きるか分かりません。
タロウくん:
でも、到達しないのですよね。
専任講師:
はい。型が保証しています。
ただし、コードの上では場合分けが残るため、実行時にはタグの検査が行われます。
タロウくん:
消えていないのですね。
専任講師:
そのとおりです。
Rocq の抽出は、型が排除した場合を、コードから取り除きません。
3つの言語の結果を、表にまとめます。
| 言語 | 出力した形式 | 通常のリスト | 長さつきリスト | 検査は消えるか |
|---|---|---|---|---|
| Lean 4 | C |
lean_obj_tag で検査する |
lean_ctor_get で直接取り出す |
消える |
| Idris 2 | Chez Scheme |
(if (null? arg-0) ...) で検査する |
(car arg-1) で直接取り出す |
消える |
| Rocq | OCaml | | Nil -> O | Cons (x, _) -> x |
| Vnil -> Obj.magic __ | Vcons (_, x, _) -> x |
残る |
6-6 第4章の結果と、対照的である
タロウくん:
先生、第4章では Rocq が証明の引数を完全に消していました。ここでは残しています。
専任講師:
そこが、本章のもうひとつの発見です。
並べてみましょう。
| 何を取り除くか | Rocq | Lean 4 |
|---|---|---|
| 証明の引数 | 取り除く | 引数の位置は残る |
| 型が排除した場合 | 残る | 取り除く |
タロウくん:
逆になっています。
専任講師:
はい。同じ言語でも、何を取り除き、何を残すかが違います。
「Rocq は取り除く」「Lean 4 は残す」といった、単純な言い方はできません。何を取り除くかによって、答えが変わります。
タロウくん:
言語を比べるときは、何について比べているのかを明確にする必要がありますね。
専任講師:
よい整理です。第2回から繰り返し出てくる論点です。
6-7 実測:検査が消えると、速くなるのか
検査が消えることは、コードから確かめられました。では、実行時間に現れるでしょうか。
Lean 4 で測りました。1000万回の繰り返しで、5回測定した中央値です。
| 書き方 | 中央値 |
|---|---|
| 通常のリスト | 3,769 ms |
| 長さつきリスト | 3,682 ms |
差は1.02倍でした。
タロウくん:
あまり変わりませんね。
専任講師:
この数字だけを見れば、そうです。
しかし、この測定には、取り出す処理以外のコスト負担が含まれています。
タロウくん:
1000万回の繰り返しそのもののコスト負担、ということですか。
専任講師:
そのとおりです。よい着眼です。
繰り返しを1000万回行うだけでも、それなりの時間がかかります。そのコスト負担が、取り出す処理の差を覆い隠している可能性があります。
測ってみましょう。
6-8 繰り返しのコスト負担を差し引く
取り出す処理を行わず、繰り返しだけを行う場合を測りました。
| 測定 | 中央値 |
|---|---|
| 繰り返しだけ(取り出しなし) | 2,696 ms |
| 通常のリスト | 3,769 ms |
| 長さつきリスト | 3,682 ms |
繰り返しだけで、2,696 ms かかっています。
このコスト負担を差し引くと、取り出す処理そのもののコスト負担が得られます。
| 書き方 | 取り出す処理のコスト負担 |
|---|---|
| 通常のリスト | 3,769 − 2,696 = 1,073 ms |
| 長さつきリスト | 3,682 − 2,696 = 986 ms |
差は1.09倍になりました。
1.09倍は、共通だとみなした繰り返しのコスト負担を差し引いて、取り出し部分だけを見積もった値です。この分解がどこまで成り立つかは、コンパイラ最適化や計測環境に依存します。したがって、実際のプログラム全体への効果としては、まず1.02倍を読むべきです。
【上級者向けコラム】ベンチマークの差分は何を仮定するか
第6章では、繰り返しだけの時間を差し引いて、先頭を取り出す操作のコスト負担を見積もりました。この方法は、共通部分のコスト負担を取り除いて関心のある操作を見えやすくするための有用な近似です。
ただし、最適化コンパイラは、プログラム全体を見てインライン化、分岐予測、定数伝播、ループ変形などを行います。そのため「全体時間 = ループの時間 + 操作の時間」が常に厳密に成り立つわけではありません。差分は、同じ設定で測った比較対象どうしの説明用の推定値として扱うのが安全です。
実務で知りたいのがアプリケーション全体の待ち時間や処理量なら、差分値よりも全体時間を優先します。一方で、依存型により検査が消えた機構そのものを観察したいなら、差分値は有益です。本文の1.02倍と1.09倍は、競合する答えではなく、異なる問いへの答えです。
タロウくん:
先ほどは1.02倍だったのに、1.09倍になりました。
専任講師:
どちらも、正しい測定です。
しかし、答えている問いが違います。
| 測り方 | 答えている問い | 結果 |
|---|---|---|
| 繰り返し全体を測る | この繰り返し処理全体が、どれだけ速くなるか | 1.02倍 |
| 繰り返しのコスト負担を差し引く | 取り出す処理そのものが、どれだけ速くなるか | 1.09倍 |
タロウくん:
どちらを見るべきなのですか。
専任講師:
何を知りたいかによります。
「このプログラム全体が、どれだけ速くなるか」を知りたいのであれば、1.02倍です。実務では、こちらを見ることが多いでしょう。
「依存型を使うと、検査が消えることで、どれだけ得をするか」を知りたいのであれば、1.09倍です。仕組みを理解するには、こちらです。
タロウくん:
第2回でも、似た話がありました。
専任講師:
第2回の第6章です。Erlang の命令数と実行時間を区別しました。
命令数は減っていたのに、最初の測定では実行時間が長くなりました。条件を組み直したところ、記述どおりになりました。
何を測っているのかを決める段階で、答えが変わります。
6-9 この結果を、どう読むか
タロウくん:
先生、1.09倍という数字は、大きいのでしょうか。
専任講師:
第2回で測った数字と比べてみましょう。
| 手法 | 効果 |
|---|---|
| Difference List(第2回) | 数百倍から数万倍 |
| map の融合(第2回) | 1.05倍から4.09倍 |
| 依存型による検査の削減(本章) | 1.09倍 |
タロウくん:
Difference List とは、桁が違います。
専任講師:
そのとおりです。
第2回で述べたとおり、Difference List は計算量そのものを変えます。 O(n²) を O(n) にするので、桁違いの差が出ます。
本章で見たのは、定数倍の改善です。 検査が1回減るだけなので、それ以上にはなりません。
タロウくん:
すると、あまり価値がないということですか。
専任講師:
そうとは言えません。
依存型を使う目的は、速さだけではありません。
| 目的 | 内容 |
|---|---|
| 正しさの保証 | 空のリストから先頭を取ろうとするコードが、コンパイルの段階で拒否される |
| 検査の削減 | 実行時の検査が減る。本章で測ったとおり、1.09倍 |
むしろ、前者が主な目的です。 速さは、副次的な効果です。
タロウくん:
第2回の最適化とは、動機が違うのですね。
専任講師:
よい整理です。
第2回で扱った手法は、速さを得るためのものでした。依存型は、正しさを得るためのものです。速くなるのは、その結果です。
6-10 本章のまとめ
| 観測したこと | 結果 |
|---|---|
| 検査は、生成されたコードから消えるか | Lean 4 と Idris 2 では消える。Rocq では残る |
| Rocq で残るもの | 起こりえない場合の分岐と、Obj.magic __ という到達しない値 |
| 実行時間は短くなるか | Lean 4 で、取り出す処理に限れば1.09倍。繰り返し全体では1.02倍 |
| 第2回の手法と比べて | 定数倍の改善にとどまる。Difference List のような桁違いの差は出ない |
| 依存型を使う主な目的 | 速さではなく、正しさの保証 |
本章で見たことを、図に示します。
次の第7章では、圏論的論理学を正面から扱います。論理の規則そのものを、圏論の言葉で書き直すと何が見えるのかを見ていきます。
第7章 圏論的論理学:論理の規則を、圏の言葉で書く
本章では、圏論的論理学(categorical logic)を扱います。
論理学の問題を、圏論の道具を使って研究する分野 です。
第3章の 3-4 で、内部言語という考え方に触れました。
+圏から型理論を取り出す、という話です*。
本章では、その背景にある分野そのもの を見ていきます。
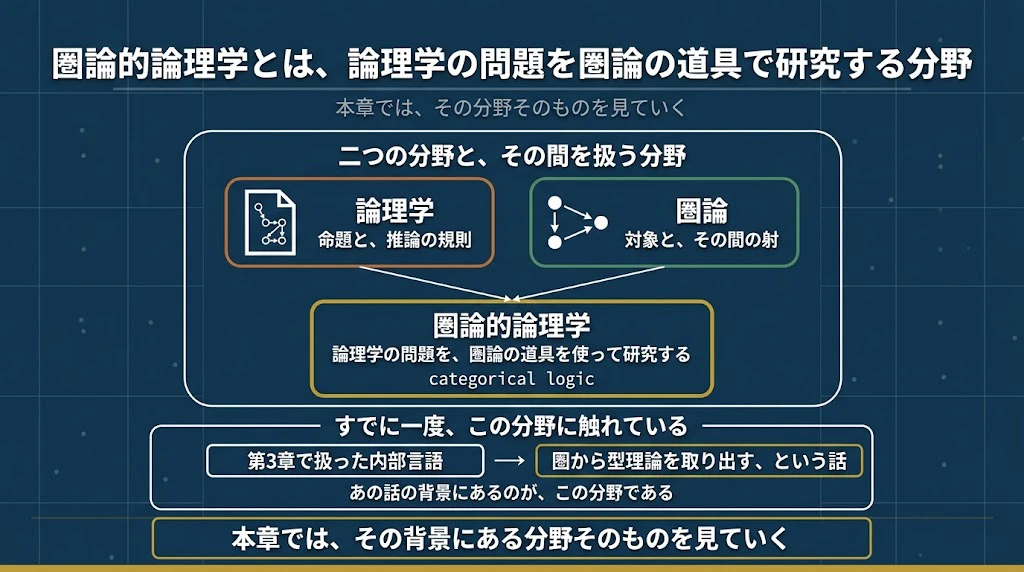
本章は、全体を対話の形で進めます。
用語が多く出てきますが、そのたびにタロウくんが尋ね、専任講師が答えます。
本章では、次の三層を区別します。
| 層 | 内容 |
|---|---|
| ① | 推論規則を射として表す(積・余積・指数) |
| ② | それを支える圏論ライブラリを形式化する(agda-categories等) |
| ③ | 論理と圏の対応そのものを形式化する(UniMath等) |
この三層の関係を、図に示します。
タロウくん:
先生、論理体系にはいろいろな体系があることはこの連載でもとりあげてきましたし、他の記事でも本記事執筆者は記事を書いてきました。
昨日、兄貴が、ある論理公理体系の論理推論規則は、圏論の図式で表現できて、圏論的論理学という研究分野がイギリスのケンブリッジ大学かオックスフォード大学に研究者が集まっていると聞かされました。
僕はそれを聞いて、定理証明言語は、数学の定理の証明の正しさを検証用途だけでなく、圏論的論理学の主張の正しさも検証できるのかな?と気になりソワソワしています。
専任講師:
よい問いです。
ひとつずつ整理しましょう。
まず、お兄さんのおっしゃった分野の名前から確かめます。
この分野は、日本語では「圏論的論理学」、英語では categorical logic と呼ばれています。
論理学の問題を、圏論の道具を使って研究する分野です。
今日は、次の4つの順に話します。
-
(1つ目) 論理の推論規則を圏論で表すとはどういうことか。
-
(2つ目) どの論理体系が、どの種類の圏で表されているか。
-
(3つ目) 研究者がどこに集まっているか。
- (4つ目) 定理証明言語で、圏論的論理学の主張を検証できるか。
タロウくん:
お願いします。
専任講師:
まず、推論規則を圏論で表すとはどういうことか、です。
圏は、対象と、対象から対象への射でできていました。
圏論的論理学では、命題を対象と見なし、証明を射と見なします。
命題 $A$ から命題 $B$ を導く証明があれば、
それを $A$ から $B$ への射と見なすのです。
タロウくん:
証明が、矢印になる のですね。
専任講師:
そうです。
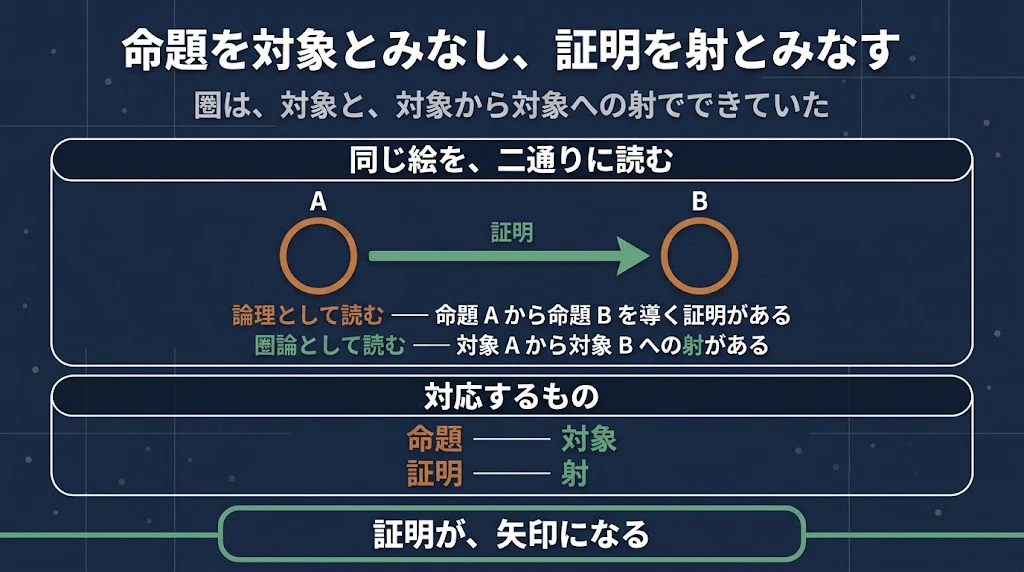
すると、圏の決まりが、そのまま証明の性質になります。
$A$ から $A$ を導く証明は、何もしない証明 です。
これが、恒等射 にあたります。
$A$ から $B$ を導く証明と、$B$ から $C$ を導く証明をつなぐと、$A$ から $C$ を導く証明ができます。
これが、射の合成 にあたります。

タロウくん:
では、「かつ」 や 「ならば」 は、どう表すのでしょうか。
専任講師:
推論規則を、圏の性質として書きます。
たとえば 「かつ」の推論規則 を考えます。
$C$ から $A$ が証明でき、$C$ から $B$ も証明できれば、$C$ から「$A$ かつ $B$」が証明できます。
逆に、$C$ から「$A$ かつ $B$」が証明できれば、$C$ から $A$ も、$C$ から $B$ も証明できます。
圏論では、この性質を持つ対象を、$A$ と $B$ の積と呼びます。
$C$ から $A$ への射と、$C$ から $B$ への射の組 が、
$C$ から 積への射 と ちょうど1対1に対応する、という性質 です。

タロウくん:
推論規則が、積という対象の性質そのものになっている のですね。
専任講師:
そういうことです。
「ならば」 も同じです。
「$A$ かつ $C$」から $B$ が証明できることと、$C$ から「$A$ ならば $B$」が証明できることは、同じことです。
圏論では、この対応を、随伴という関係で表します。
「$A$ かつ」をとる操作と、「$A$ ならば」をとる操作が、随伴の組になっている のです。
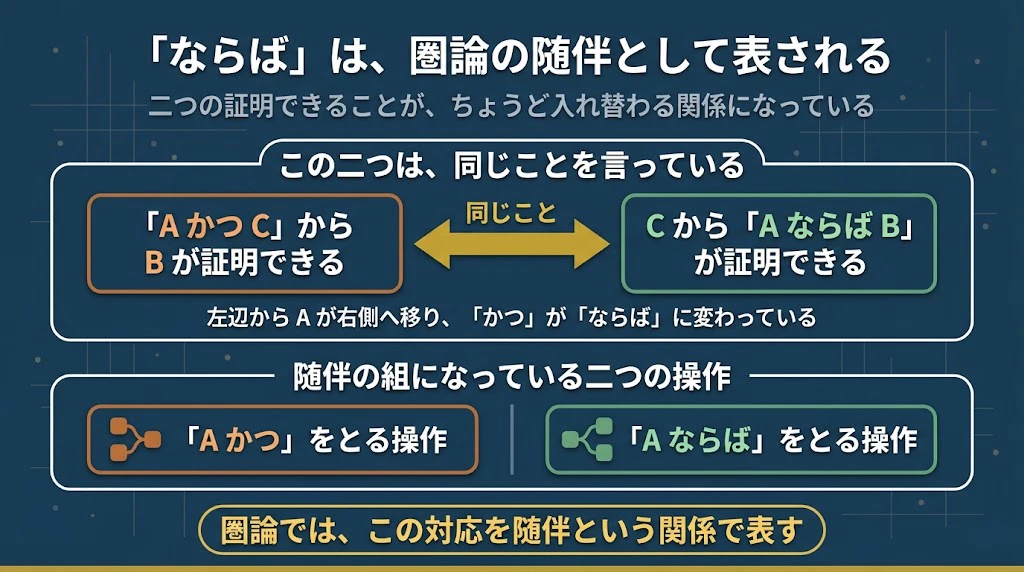
タロウくん:
「$A$ かつ $C$ から $B$」と「$C$ から $A$ ならば $B$」が、行き来できるということですか。
専任講師:
そのとおりです。
関数型言語を書く方には、カリー化 として見覚えがあるはずです。
2つの引数をとる関数と、1つの引数をとって関数を返す関数は、行き来できました。
同じ構造が、論理の「ならば」の中にもある のです。
タロウくん:
では、2つ目の問いです。
どの論理体系が、どの種類の圏で表されているのでしょうか。
専任講師:
代表的なものを表にします。
| 論理体系 | 対応する圏 | 主な典拠 |
|---|---|---|
| 直観主義命題論理 | デカルト閉圏(cartesian closed category) | Lambek と Scott(1986) |
| 型付きラムダ計算 | デカルト閉圏 | Lambek と Scott(1986) |
| 直観主義一階述語論理 | hyperdoctrine。「すべての」と「ある」は、代入の操作の右随伴と左随伴として表される | Lawvere(1969) |
| 直観主義的な高階の型理論 | トポス | Lambek と Scott(1986) |
| 線形論理(linear logic) | *-autonomous category | Seely(1989) |
【上級者向けコラム】前提を「消費」する論理 ── 線形論理とリソース管理
第7章の表に 「線形論理(linear logic)」という論理体系 が挙げられています。
通常の論理では、「$A$が成り立つ」という前提は何度でもコピーして(使い回して)別の証明に使うことができます。
しかし 線形論理 は、「一度使った前提は消費されてなくなる」という「リソース(資源)」の概念を取り入れた論理です。
圏論において、データを自由にコピーしたり捨てたりできることは「デカルト積(組)」の性質 ですが、
線形論理はコピーを許さない「モノイダル圏」という別の構造に対応 します。
この「データ(前提)を一度しか使えない」という発想は、現代では Rustのような言語の「所有権システム」によるメモリ管理や、複製が不可能な「量子計算」の定式化など、実務や最先端の計算機科学に深く結びついています。

【上級者向けコラム】数学の「並行宇宙」 ── トポスと内部論理、そして多様な「器」たち
第7章で、Lawvereらが「トポス(Topos)」の理論を作ったことに触れました。トポスとは、ざっくり言えば「私たちが知っている集合論の代わりになる、数学ができる圏」のことです。
驚くべきことに、トポスごとに「成り立つ論理のルール(内部論理)」が異なります。私たちが普段数学をしている標準的な世界(Setsの圏)では排中律が成り立つ古典論理ですが、別のトポスに行くと「直観主義論理しか成り立たない世界」などが広がっています。圏から内部論理を取り出す(第3章)というのは、ある意味で「その並行宇宙の物理法則(論理)を調べる」ことに似ています。
ただし、重要な点があります。「トポス」はあくまでも、論理を盛るための『器』の候補の1つに過ぎません。第7章の表に登場したように、命題論理を盛る「デカルト閉圏」や、線形論理を盛る「-自律圏(-autonomous category)」など、論理の性質に合わせて複数の『器』が存在します。そして、それらすべての『論理の器』は、圏論の言葉で統一的に表現できるのです。
本稿では、定理証明言語の土台となる論理(直観主義か古典論理か)の違いが、排中律のプログラムとしての実行可能性などにどう影響するか(第5章)を見ました。圏論の視点に立てば、こうした異なる論理体系も、単なる「異なる種類の圏(器)」として俯瞰できます。第7章で紹介した、定理証明言語を使って圏論的論理学の定理を形式化する試みは、いわば「ひとつの論理の器(言語)の中にいながら、圏論という望遠鏡を使って、他のあらゆる論理の器の形を観察し、その正しさを証明する」という、極めてスリリングなメタ構造を持っています。
具体的に言えば、直観主義論理で動くRocqやAgdaを足場としながら、そこでは相容れないはずの古典論理や線形論理の世界を「圏」という箱庭として構築し、その振る舞いを外側から証明しているのです。これは、私たちが住む宇宙の物理法則(定理証明言語の型理論)を信じて、まったく異なる物理法則が支配する別宇宙のシミュレーションを行い、その世界の整合性を確かめているようなものです。ベースとなる言語の推論規則への絶対的な信頼と、あらゆる構造を翻訳できる「圏論」という普遍的な言葉が組み合わさって初めて可能になる、計算機と人間の知的な営みと言えるでしょう。
なお、トポスと論理の関わりや、トポス以外の様々な『論理の器』たちについては、過去記事『トポスと論理の関係 ── ひとつのトポス(数学の宇宙)を選ぶと、なぜ古典論理か直観主義論理が決まるのか ── そして、トポス以外の「器」たち』( https://qiita.com/etale_cohomology/items/5206679c2fd02aea9512 )で詳しく取り上げています。あわせてご参照ください。
タロウくん:
直観主義論理が、いくつも並んでいますね。
専任講師:
よいところに気づきました。
証明と証明の違いを保ったまま圏で表すという点では、直観主義論理のほうが、圏ときれいに対応します。
Lambek と Scott の教科書は、型付きラムダ計算とデカルト閉圏が本質的に同じであることを示しました。
タロウくん:
古典論理は、どうなのでしょうか。
専任講師:
古典論理の証明を、証明の違いを保ったまま圏で表すことは、直観主義論理より難しく、いまも研究が続いています。
control category や Boolean category といった構造が、その候補として研究されています。
タロウくん:
それで、この連載の論理体系の軸で、直観主義論理と古典論理を分けていたのですね。
専任講師:
そういうことです。
初回記事の表で、Agda と Lean 4 は直観主義論理、Isabelle/HOL は古典論理としました。
証明がそのまま計算の手順を与えるかどうか、という違いでした。
いまの表は、その違いを、圏論の側から見たものです。
タロウくん:
3つ目の問いです。
兄は、研究者がケンブリッジ大学かオックスフォード大学に集まっていると言っていました。
専任講師:
お兄さんの話は、半分正しいです。
ケンブリッジ大学のコンピュータ科学科では、圏論と論理、プログラム言語の意味論とのつながりを扱う講義が、毎年開かれています。
教科書には、Lambek と Scott の本と、Pitts の「Categorical Logic」が指定されています。
オックスフォード大学のコンピュータ科学科でも、「Categories, Proofs and Processes」という講義で、圏論と論理のつながりを扱っています。
講義資料は、Abramsky と Tzevelekos の「Introduction to Categories and Categorical Logic」です。
タロウくん:
では、残りの半分は。
専任講師:
研究者は、その2つの大学に限られません。
線形論理と圏の対応を示した Seely は、カナダのマギル大学の研究者です。
日本にも、京都大学数理解析研究所の荒武永史さんのように、圏論的論理学を研究し、日本語で解説している研究者がいます。
イギリスの2つの大学は重要な拠点ですが、研究は世界に広がっています。
タロウくん:
最後の問いです。
定理証明言語は、圏論的論理学の主張の正しさも検証できるのでしょうか。
専任講師:
できます。
実際に、定理証明言語で圏論を形式化したライブラリがいくつもあります。
| 定理証明言語 | 圏論を形式化した例 |
|---|---|
| Lean | mathlib の CategoryTheory |
| Agda | agda-categories |
| Rocq(旧 Coq) | UniMath、category-theory ほか |
| Isabelle/HOL | Archive of Formal Proofs の圏論のエントリ |
さらに、Isabelle/HOL で圏の公理系そのものを形式化し、公理どうしの関係を機械で調べた研究もあります。
タロウくん:
数学の定理だけでなく、圏論や論理についての主張も、検証の対象になるのですね。
専任講師:
そうです。
ここには、もう1つ面白い関係があります。
Agda や Lean は、証明をプログラムとして扱う型理論の上に作られています。
その型理論の意味を与えるのが、いま見た圏論的論理学 です。
つまり、定理証明言語は、圏論的論理学の主張を検証する道具であると同時に、圏論的論理学によって意味を与えられる対象でもある のです。
タロウくん:
定理証明言語を使って、圏論的論理学の主張の正しさを検証するとき、どの定理証明言語が使われますか?
その定理証明言語を使って、圏論的論理学の主張の正しさを検証するコードの実例をみてみたいです。
こういうコードを書くのは、やっぱり、圏論的論理学の定理や学説を生み出していく研究の最前線に身を置いている圏論的論理学者ですか?
それとも圏論的論理学がソフトウェア設計やプログラミング言語設計に使われていて、その分野の実務家がそういうコードを書いているとか、でしょうか。
専任講師:
順に答えます。
まず、どの定理証明言語が使われているかです。
先ほど表で挙げた Lean、Agda、Rocq(旧 Coq)、Isabelle/HOL のいずれでも、圏論の形式化が進んでいます。
タロウくん:
Lean、Agda、Rocq、Isabelle/HOL のいずれでも、圏論の形式化が進んでいるとのことですが、これは、圏論的論理学の形式化、つまり、圏論的論理学の主張を定理証明言語のコードに置き換える動きが進んでいるということですか?僕が知りたいのは後者です。
専任講師:
大事な区別に気づきましたね。
2つの動きを分けて答えます。
1つ目は、圏論一般の形式化です。
圏、関手、随伴、極限といった圏論の定義と定理を、定理証明言語のライブラリとして整備する動きです。
先ほど表で挙げた mathlib や agda-categories は、主にこちらです。
2つ目は、タロウくんが知りたい、圏論的論理学の主張の形式化 です。
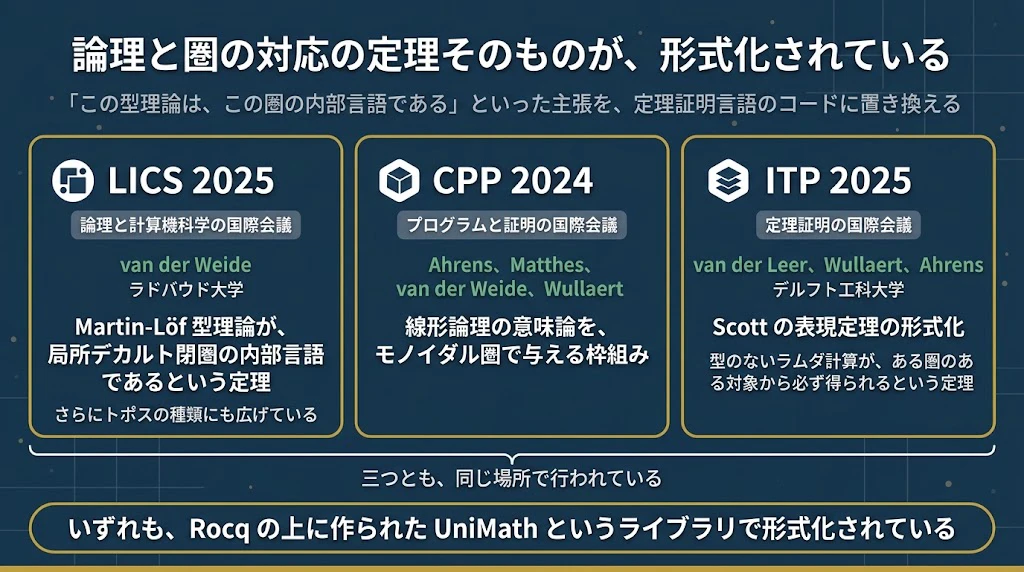
「この論理体系は、この種類の圏で表せる」「この型理論は、この圏の内部言語である」といった、論理と圏の対応の定理そのものを、定理証明言語のコードに置き換える動きです。
タロウくん:
その2つ目は、実際に進んでいるのですか。
専任講師:
進んでいます。
筆者が確かめた例を、3つ挙げます。
1つ目は、オランダのラドバウド大学の van der Weide が、論理と計算機科学の国際会議 LICS 2025 で発表した研究です。
Martin-Löf 型理論が、局所デカルト閉圏という種類の圏の内部言語である、という定理を証明し、さらにトポスの種類にも広げています。
先ほどの表でいえば、「この型理論は、この圏で表せる」という主張を、定理証明言語で確かめたもの です。
2つ目は、Ahrens、Matthes、van der Weide、Wullaert が、プログラムと証明の国際会議 CPP 2024 で発表した研究です。
表に挙げた *線形論理の意味論を、モノイダル圏という種類の圏で与える枠組みを扱っています。
3つ目は、デルフト工科大学の van der Leer、Wullaert、Ahrens が、定理証明の国際会議 ITP 2025 で発表した、Scott の表現定理の形式化 です。
型のないラムダ計算が、ある圏のある対象から必ず得られる、という定理 です。
3つとも、Rocq の上に作られた UniMath というライブラリで行われています。
タロウくん:
圏論的論理学の主張を、本当にコードに置き換えている人たちがいるのですね。
専任講師:
そうです。
ただし、これは 研究の最前線の活動 です。
担っているのは、デルフト工科大学やラドバウド大学などの研究者 です。
タロウくん:
さらに、論理学の推論規則を圏論図式に置き換えて表現する研究が存在するのかも知りたいです。
圏論的論理学はこの研究のことだと理解しているのですが。且つ、又は、故に、などが 圏論図式で表現できるという研究 です。
ただ、wikipediaをみているのですが、圏論的論理学は、先生が言われたような下記の定義で、僕が理解している研究はその部分領域なのかもしれません。
Categorical logic is the branch of mathematics in which tools and concepts from category theory are applied to the study of mathematical logic.
In broad terms, categorical logic represents both syntax and semantics by a category, and an interpretation by a functor.
(出典:Wikipedia「Categorical logic」 https://en.wikipedia.org/wiki/Categorical_logic )
筆者による日本語訳:
圏論的論理学は、圏論の道具と概念を数理論理学の研究に応用する数学の分野である。
大まかに言えば、圏論的論理学は、構文と意味論の両方を圏で表し、解釈を関手で表す。
専任講師:
よい整理です。
タロウくんの理解は、どちらも正しいです。
Wikipedia の定義は、圏論的論理学の全体を指しています。
論理の構文も、その意味も、圏として扱い、構文から意味への解釈を関手として扱う、という広い分野です。
タロウくんが知りたい、推論規則を圏の図式で表す研究は、その中の一部です。
圏論的論理学の出発点にあたる、中心的な部分です。
証明を圏の射として扱うこの部分は、英語では categorical proof theory と呼ばれることもあります。
タロウくん
「且つ」「又は」「故に」は、それぞれ何で表されるのですか。
専任講師:
直観主義命題論理の場合を、表にします。
| 論理 | 圏での表し方 |
|---|---|
| 命題 $A$ | 対象 $A$ |
| $A$ から $B$ が導ける(故に) | $A$ から $B$ への射 |
| $A$ 且つ $B$ | $A$ と $B$ の積 $A$ × $B$ |
| $A$ 又は $B$ | $A$ と $B$ の余積 $A$ + $B$ |
| $A$ ならば $B$ | 指数の対象 $A$ ⇒ $B$ |
| 真 | 終対象 |
| 偽 | 始対象 |
| 「$A$ ならば $B$」と $A$ から $B$ を導く推論(modus ponens) | 評価の射 eval:($A$ ⇒ $B$) × $A$ → $B$ |
タロウくん:
推論規則は、どうなるのでしょうか。
専任講師:
たとえば「且つ」の導入規則は、$C$ から $A$ が導け、$C$ から $B$ が導ければ、$C$ から「$A$ 且つ $B$」が導ける、という規則でした。
圏では、$C$ から $A$ への射 $f$ と、$C$ から $B$ への射 $g$ から、$C$ から積への射 ⟨$f$, $g$⟩ を作る操作にあたります。
「且つ」の 除去規則 は、「$A$ 且つ $B$」から $A$ を 取り出す規則 です。
圏では、積から $A$ への射影 π₁ を合成する操作にあたります。
「又は」の規則は、余積について、この逆向きの形で表されます。
これら 「且つ」「又は」「ならば」「真」「偽」をすべて持つ圏を、bicartesian closed category と呼びます。
日本語の定訳を確かめられなかったため、英語のまま呼びます。
直観主義命題論理の証明は、bicartesian closed category の射として表せます。
「且つ」と「ならば」だけに限れば、先ほどの表に挙げたデカルト閉圏になります。
タロウくん:
兄貴は、Lawvereが圏論的論理学の創始者の1人と言っていました。
先生がイメージされている圏論的論理学と整合はとれていますか?
専任講師:
整合しています。
お兄さんの話は、正しいです。
Lawvere は、圏論的論理学を創始した人物とされています。
1963年の論文で、代数の理論を圏として扱い、その理論の解釈を関手として扱う方法を示しました。
先ほど Wikipedia の定義にあった「解釈を関手で表す」という考え方は、ここから来ています。
さらに Lawvere は、1969年の論文で、「すべての」と「ある」を随伴として表しました。
先ほどの表で、直観主義一階述語論理の行に挙げたものです。
その後、Tierney とともに、トポスの理論を作りました。
タロウくん:
では、僕が知りたい「且つ」「又は」の研究も、Lawvere から始まったのですか。
専任講師:
そこには、もう1人の人物がいます。
Lambek です。
Lambek は、1969年から一連の論文で、圏を、ラベルの付いた演繹体系として扱う研究を始めました。
証明を射として扱い、直観主義命題論理とデカルト閉圏を結び付けたのは、Lambek の仕事です。
タロウくんが知りたい研究は、主にこの Lambek の流れにあります。
タロウくん:
Lawvere と Lambek の、2つの流れがあるのですね。
専任講師:
そうです。
大まかに言えば、Lawvere の流れは、「すべての」「ある」やトポスといった、述語論理と数学の基礎の側を圏で表しました。
Lambek の流れは、「且つ」「ならば」の推論規則と証明の側を、圏で表しました。
どちらも、1970年ごろに圏論的論理学という分野がはっきり形を取るうえで、欠かせない柱です。
先ほどの表にも、2人の仕事がどちらも入っています。
タロウくん:
では、僕が知りたかった研究を、定理証明言語で形式化した例もあるのでしょうか。
専任講師:
あります。
このあと見せる Agda のコードが、まさにその例です。
agda-categories には、「且つ」と「ならば」を持つデカルト閉圏のファイルに加えて、「又は」の余積や、bicartesian closed category のファイルもあります。
先ほど挙げた3つの研究は、命題論理の規則より大きな単位、つまり型理論や線形論理といった論理体系の全体と、圏の対応を扱っています。
タロウくん:
コードの実例も、見せていただけますか。
専任講師:
Agda のライブラリ 【上級者向けコラム】圏論の形式化と圏論的論理学の形式化
圏・関手・自然変換・随伴をライブラリとして形式化することと、「ある論理体系がある種類の圏で意味づけられる」「ある圏の内部言語がある型理論になる」という対応定理を形式化することは、関連しますが別の到達点です。
前者は、大きな定理を組み立てるための基盤です。後者は、その基盤の上で、構文と意味論の対応そのものを定理として機械検査します。agda-categoriesのデカルト閉圏の定義や、本文の ∧-intro・modus-ponens は前者を使って推論規則を記述する小さな例です。UniMath上の内部言語の定理は、より大きな後者の例です。
両者を分けると、読者は「ライブラリがある」ことと「対応定理まで形式化済みである」ことを混同せずに、研究の到達点を理解できます。
agda-categories から、デカルト閉圏を定義したファイルの一部を見てみましょう。
agda-categories は、先ほどの1つ目、圏論一般の形式化のライブラリです。
ただし、デカルト閉圏の部分は、圏論的論理学で「かつ」と「ならば」を表すときの土台そのものです。
土台がどう書かれ、どう機械で検査されているかを見るには、ちょうどよい例です。
このコードは、筆者が考えたものではありません。agda-categories の公開されたソースコードからの引用です。
  λg : C × A ⇒ B → C ⇒ B ^ A
  β : eval ∘ λg f ×id ≈ f
  λ-unique : eval ∘ f ×id ≈ g → f ≈ λg g
出典:
agda-categories(Agda Github Community)、v0.1.7.2、src/Categories/Category/CartesianClosed.agda、68行目、77行目、83行目を引用(2026年9月21日取得。MIT License、Copyright (c) 2019 Agda Github Community)
https://github.com/agda/agda-categories/blob/v0.1.7.2/src/Categories/Category/CartesianClosed.agda
agda-categories について参照した文章(出典):
- J. Z. S. Hu, J. Carette, "Formalizing Category Theory in Agda", Proceedings of the 10th ACM SIGPLAN International Conference on Certified Programs and Proofs (CPP 2021), pp. 327–342, 2021. doi: 10.1145/3437992.3439922
https://dl.acm.org/doi/10.1145/3437992.3439922 - 同論文の arXiv 版(arXiv:2005.07059)
https://arxiv.org/pdf/2005.07059 - agda-categories の GitHub リポジトリ
https://github.com/agda/agda-categories
B ^ A は、「$A$ ならば $B$」にあたる指数の対象です。
1行目の λg は、「$C$ かつ $A$」から $B$ への射を受け取って、$C$ から「$A$ ならば $B$」への射を返します。
先ほど話した「『$A$ かつ $C$』から $B$ が証明できれば、$C$ から『$A$ ならば $B$』が証明できる」という推論規則が、そのまま型として書かれています。
関数型言語でいえば、カリー化です。
2行目に出てくる eval は、先ほどの表の評価の射です。
「$A$ ならば $B$」と $A$ から $B$ を導く推論、つまり「故に」の典型である modus ponens にあたります。
タロウくん:
2行目と3行目は何でしょうか。
専任講師:
2行目の β は、カリー化してから評価すると、元の射に戻る、という等式です。
3行目の λ-unique は、その性質を満たす射は λg で作ったものしかない、という一意性です。
この2つがそろうことで、「$C$ かつ $A$ から $B$ への射」と「$C$ から $A$ ならば $B$ への射」が、ちょうど1対1に対応します。
先ほどの「ならば」の推論規則が、圏の性質として正しく成り立っていることを、Agda が機械的に検査しているのです。
同じファイルには、「$A$ との積」と「$A$ からの指数」が随伴の組になることの証明もあります。
タロウくん:
そのコードは、本当に動くのですか。
専任講師:
筆者が、実際に確かめました。
Agda 2.6.3 と標準ライブラリ 1.7.3 を導入し、agda-categories v0.1.7.2 のこのファイルを型検査したところ、依存する87個のモジュールを含めて、証明はエラーなく通りました。
型検査が通るということは、ファイルの中の証明がすべて正しいと、Agda が認めたということです。
タロウくん:
最後の問いです。
こういうコードを書いているのは、研究者ですか、それとも実務家ですか。
専任講師:
筆者が確かめた範囲では、形式化のコードを書いているのは、主に研究者 です。
agda-categories の論文は、カナダのマクマスター大学の Carette らが、プログラムと証明の国際会議 CPP 2021 で発表しました。
2025年には、オランダのデルフト工科大学の van der Leer、Wullaert、Ahrens が、型のないラムダ計算についての Scott の表現定理を、Rocq の UniMath ライブラリで形式化しています。
Scott の表現定理は、Lambek と Scott の対応の「いとこ」にあたる結果です。
Lean の mathlib は、数学者や計算機科学者を含む大きなコミュニティで開発されています。
タロウくん:
実務家は、関わっていないのでしょうか。
専任講師:
実務家と圏論的論理学の接点は、検証のコードというより、プログラミング言語の設計と実装にあります。
第2回で取り上げた OCaml を、覚えていますか。
OCaml の祖先の Caml という名前は、元々 Categorical Abstract Machine Language の略です。
Curien は、ラムダ計算と、圏論にもとづく組み合わせの計算(categorical combinators)との対応を考えました。
Cousineau は、その対応が ML の言語のコンパイルの手法として使えることに気づきました。
そこから、1985年に Categorical Abstract Machine が作られ、Caml の最初の実装の土台になりました。
ただし、現在の OCaml の実装は、この抽象機械とは関係がありません。名前だけが残っています。
タロウくん:
いま僕たちが使っている言語の名前にまで、圏論的論理学の跡が残っているのですね。
専任講師:
そういうことです。
形式化のコードを書くのは主に研究者ですが、その成果は、言語の設計と実装を通じて、実務家の手元に届いています。
タロウくん:
先生、agda-categories は、圏論一般のライブラリでしたね。
僕が思い描いている、「且つ」や「ならば」の推論規則そのものを、定理証明言語のコードにした例を見てみたいです。
圏論的論理学の定理や主張の正しさを、定理証明言語で検証するコードも見てみたいです。
専任講師:
では、推論規則そのものを書いたコードから見ましょう。
次のコードは、筆者が作成したものです。agda-categories のデカルト閉圏の定義の上に、直観主義命題論理の「且つ」と「ならば」の推論規則を、射を作る操作として書きました。
-- 「且つ」の導入規則:C から A、C から B が導ければ、C から「A 且つ B」が導ける
∧-intro : C ⇒ A → C ⇒ B → C ⇒ A × B
∧-intro f g = ⟨ f , g ⟩

-- 「且つ」の除去規則:「A 且つ B」から A を取り出す
∧-elim₁ : C ⇒ A × B → C ⇒ A
∧-elim₁ h = π₁ ∘ h

-- 「ならば」の導入規則:「C 且つ A」から B が導ければ、C から「A ならば B」が導ける
⇒-intro : C × A ⇒ B → C ⇒ B ^ A
⇒-intro h = λg h

-- modus ponens:C から「A ならば B」と A が導ければ、C から B が導ける
modus-ponens : C ⇒ B ^ A → C ⇒ A → C ⇒ B
modus-ponens f g = eval′ ∘ ⟨ f , g ⟩

-- 導入してすぐ除去すると、元の証明に戻る(証明の正規化の規則)
∧-β₁ : (f : C ⇒ A) (g : C ⇒ B) → ∧-elim₁ (∧-intro f g) ≈ f
∧-β₁ f g = project₁

-- 「ならば」を導入してすぐ modus ponens で使うと、元の証明に戻る(証明の正規化の規則)
⇒-β : (h : C × A ⇒ B) (g : C ⇒ A) → modus-ponens (⇒-intro h) g ≈ h ∘ ⟨ id , g ⟩
⇒-β h g = begin
  eval′ ∘ ⟨ λg h , g ⟩                ≈˘⟨ refl⟩∘⟨ (⁂∘⟨⟩ ○ ⟨⟩-cong₂ identityʳ identityˡ) ⟩
  eval′ ∘ (λg h ⁂ id) ∘ ⟨ id , g ⟩    ≈⟨ pullˡ β′ ⟩
  h ∘ ⟨ id , g ⟩                      ∎
  where open import Categories.Morphism.Reasoning 𝒞 using (pullˡ)
出典:
筆者が作成したコード(2026年9月21日)。Agda 2.6.3、標準ライブラリ 1.7.3、agda-categories v0.1.7.2 で型検査し、エラーなく通ることを確かめた。
タロウくん:
∧-intro や modus-ponens は、先ほどの表の推論規則ですね。
専任講師:
そうです。
∧-intro が「且つ」の導入規則、∧-elim₁ が「且つ」の除去規則、⇒-intro が「ならば」の導入規則、modus-ponens が modus ponens です。
どれも、型を見れば推論規則の形になっています。
たとえば C ⇒ A → C ⇒ B → C ⇒ A × B は、「C から A への射と、C から B への射があれば、C から『A 且つ B』への射が作れる」と読めます。
タロウくん:
最後の ∧-β₁ と ⇒-β は何でしょうか。
専任講師:
推論規則についての定理です。
∧-β₁ は、「且つ」を導入してすぐ除去すると、元の証明に戻る、という定理です。
⇒-β は、「ならば」を導入してすぐ modus ponens で使うと、元の証明に戻る、という定理です。
証明の遠回りを取り除く、証明の正規化の規則にあたります。
ラムダ計算でいえば、β 簡約です。
この2つの定理の証明を、Agda が型検査で正しいと認めました。
タロウくん:
推論規則を書くだけでなく、推論規則についての主張の正しさも、機械で確かめられるのですね。
専任講師:
そういうことです。
ただし、これは入門のための小さな例です。
研究として圏論的論理学の定理を検証するコードは、先ほど挙げた、van der Weide の内部言語の定理や、van der Leer らの Scott の表現定理の形式化のように、はるかに大きな規模になります。
これらは、Rocq の UniMath ライブラリの中で公開されています。
タロウくん:
研究で圏論的論理学の定理を検証するコード(van der Weide や van der Leer らの研究)ははるかに大規模で、UniMath の中で公開されているのですね!
僕はこれから圏論的論理学も少しずつ学んでいきたいと考えているのですが、van der Weide や van der Leer らが定理証明支援系を使って妥当性を検証している圏論的論理学の定理って、どんな定理なんですか?
恥ずかしながら、僕はまだ圏論的論理学の定理としては、どんな定理が論文で提案されているのかすら未学習なんです。
また、別連載では、数学の定理の証明が正しいか検証するのは人間だけだと時間がかかるので、Lean 4などの定理証明支援系が使われている実情を取り上げています。
圏論的論理学の定理も、正しさを人間だけで検証するのは大変だし、論理の飛躍に気付かれるまで数十年かかるリスクもある。だから、定理証明支援系を使うのでしょうか?
専任講師:
学び始めるのに、恥ずかしいことは何もありません。
2つの定理を、順に説明します。
1つ目は、van der Weide が検証した、内部言語の定理です。
先ほど、デカルト閉圏と単純型付きラムダ計算が対応する、という話をしました。
この定理は、同じ種類の対応を、より強い論理で示すものです。
Martin-Löf 型理論という、Agda や Rocq の土台にもなっている型理論があります。
この型理論と、局所デカルト閉圏という種類の圏が、過不足なく対応する、という定理です。
型理論の側で成り立つことと、圏の側で成り立つことが、互いに行き来できるのです。
この定理は、もともと Clairambault と Dybjer が2014年に示したものです。
van der Weide は、これを univalent foundations という数学の基礎の上で証明し直し、さらにトポスの種類にまで広げました。
タロウくん:
デカルト閉圏とラムダ計算の対応の、大人版のようなものですか。
専任講師:
そう考えてよいです。
2つ目は、van der Leer、Wullaert、Ahrens が検証した、Scott の表現定理です。
型のないラムダ計算は、どれも、ある圏の中の「反射的対象」と呼ばれる特別な対象から得られる、という定理です。
論文では、Scott による証明と、Hyland による証明の、2通りの証明を形式化しています。
さらに、証明の中で使う Karoubi 包絡という圏論の構成が、どの数学の基礎を選ぶかによってどう変わるかも、論じています。
タロウくん:
どちらも、論理や計算の体系と、圏とが対応する、という定理なのですね。
専任講師:
そのとおりです。
先ほどの表の「論理体系と、対応する圏」を、証明の細部まで機械で確かめたものと言えます。
タロウくん:
では、定理証明支援系を使う理由は、数学の場合と同じなのでしょうか。
専任講師:
理由の1つは、タロウくんの言うとおり、人間だけで検証するのが大変だから、という点です。
圏論的論理学の証明には、正しいけれど面倒な検査が大量に含まれます。
たとえば、ケンブリッジ大学の Saville は、双圏という構造の上で作業すると、標準的な同型射についての計算が大量に必要になり、その検査は複雑で、しばしば退屈なものになる、と述べています。
出典:
P. Saville, "A type theory for cartesian closed bicategories"(招待講演の要旨)、Proofs, Constructions and Computations Seminar, University of Leeds, 2019年5月8日
https://www.research.ed.ac.uk/en/activities/a-type-theory-for-cartesian-closed-bicategories/
人間の目だけでは、こうした検査の見落としを防ぎにくいのです。
タロウくん:
理由は、それだけですか。
専任講師:
もう1つあります。
形式化することで、証明そのものが見直され、よりよい形になることがあります。
van der Weide の論文は、univalent な圏を使うことで、いくつかの構成と証明が簡単になった、と述べています。van der Leer らの論文も、数学の基礎の選び方が、Karoubi 包絡の構成にどう影響するかを明らかにしています。
出典:
- N. van der Weide, "The internal languages of univalent categories", 40th Annual ACM/IEEE Symposium on Logic in Computer Science (LICS 2025), pp. 112–126, 2025. doi: 10.1109/lics65433.2025.00016。arXiv:2411.06636
https://arxiv.org/pdf/2411.06636 - A. van der Leer, K. Wullaert, B. Ahrens, "Scott's Representation Theorem and the Univalent Karoubi Envelope", 16th International Conference on Interactive Theorem Proving (ITP 2025), LIPIcs 352, Paper 33, 2025。arXiv:2506.22196
https://drops.dagstuhl.de/storage/00lipics/lipics-vol352-itp2025/LIPIcs.ITP.2025.33/LIPIcs.ITP.2025.33.pdf
機械で確かめる作業は、誤りを見つけるだけでなく、理論の理解そのものを深める作業でもあるのです。
タロウくん:
こういうコードは、圏論的論理学者やプログラミング言語の設計理論の研究者が、研究のために書いているのですか?
専任講師:
そうです。
筆者が確かめた範囲では、研究のために書かれています。
書いているのは、圏論的論理学、型理論、プログラミング言語の基礎理論の研究者 です。
たとえば、UniMath での形式化を進める Ahrens はデルフト工科大学、van der Weide はラドバウド大学の研究者です。
数学者も書いています。∞-圏の米田の補題を形式化した論文の著者には、ジョンズ・ホプキンズ大学数学科の Riehl と Weinberger が含まれています。
新しい定理が本当に正しいかを機械で確かめるため、そして後の研究者が使えるライブラリを残すために、書いているのです。
タロウくん:
もう1つ、うかがいたいです。
圏論的論理学の研究用途に特化した定理証明言語 は、ありますか?
専任講師:
圏論的論理学だけに特化し、広く使われている定理証明言語は、筆者が確かめた範囲では見当たりません。
多くの研究は、Lean、Agda、Rocq、Isabelle/HOL といった汎用の定理証明言語の上で、ライブラリとして 行われています。
ただし、圏論の研究のために設計された定理証明言語はあります。
Rzk です。
Rzk は、∞-圏と呼ばれる高次の圏を、型理論の中で直接扱えるように設計された、実験的な定理証明言語です。
イノポリス大学の Kudasov が実装し、Riehl、Weinberger とともに、∞-圏についての米田の補題を初めて形式化しました。
タロウくん:
圏論の研究のための定理証明言語も、生まれているのですね。
専任講師:
そうです。
まだ実験的な段階ですが、研究の最前線では、定理証明言語そのものを、圏論の研究に合わせて設計する試みも始まっています。

本稿の第5章では、定理証明言語が採用する論理体系の違いが、排中律を使った定義の扱いをどう左右するのかを、実機で確かめました。
いま話した圏論的論理学は、その違いを、圏論の側から捉える理論です。
なお、圏論論理学については、本記事執筆者が、さらに詳しく掘り下げた記事をZennで公開しています。
-
【圏論論理学 連載①】「且つ」をAgdaで書いたら、圏論の「積」になった ―─ Curry–Howard対応から圏論的論理学へ
- 【圏論論理学 連載②】論理構成子「ならば」は圏論の「指数対象」だった ―─ agda-categories のコードを読む
🔬 上級者向けコラム:量化子は随伴である
Lawvere は、1969年の論文「Adjointness in Foundations」で、論理の量化子を随伴として特徴づけました。
各型 X の上の命題の全体を P(X) とし、関数 f による代入の操作を f* と書きます。
このとき、「ある」による量化 ∃_f と「すべての」による量化 ∀_f は、代入 f* の左随伴と右随伴になります。
∃_f ⊣ f* ⊣ ∀_f
ここでは、命題について「成り立つかどうか」だけを見ています。
証明の違いまで区別する依存型の世界(局所デカルト閉圏)では、同じ位置に、依存和 Σ_f と依存積 Π_f が現れます。
Σ_f ⊣ f* ⊣ Π_f
第3章の 3-3 で見た局所デカルト閉圏は、まさにこの右随伴 Π_f を持つ圏です。
また、デカルト閉圏では、各対象 A について、「A との積」をとる関手と、「A からの指数」をとる関手が随伴の組になります。
A × - ⊣ A ⇒ -
これは、論理では「かつ」と「ならば」の関係であり、関数型言語ではカリー化にあたります。
このように、論理の結合子や量化子が、随伴という1つの概念で統一的に表される点が、圏論的論理学の中心的な考え方の1つです。
「圏論的論理学」の定訳について参照した文章(出典):
- 荒武永史「圏論的論理学の拡がり」、Logic Winter School 2023、京都大学数理解析研究所、2023年2月23日
https://researchmap.jp/hisashi-aratake/presentations/41535386/attachment_file.pdf - 荒武永史「圏論的論理学への道案内――論理学と数学をつなぐトポス」、『現代思想』2020年7月号 特集=圏論の世界、青土社
https://www.seidosha.co.jp/book/index.php?id=3438
「圏論的論理学」と「圏論的証明論」について参照した文章(出典):
- 荒武永史「圏論的一階述語論理(1)」、Logic Winter School 2023、京都大学数理解析研究所、2023年2月20日(圏論的論理学の3つの重要なアイディアとして函手的意味論、圏の対象を台とするモデル、圏の内部論理を挙げ、それとは別に「Lambekの圏論的証明論」を区別している)
https://researchmap.jp/hisashi-aratake/presentations/41535332/attachment_file.pdf - Wikipedia 日本語版「圏論的論理学」
https://ja.wikipedia.org/wiki/%E5%9C%8F%E8%AB%96%E7%9A%84%E8%AB%96%E7%90%86%E5%AD%A6
論理体系と圏の対応について参照した文章(出典):
- J. Lambek, P. J. Scott, Introduction to Higher Order Categorical Logic, Cambridge Studies in Advanced Mathematics 7, Cambridge University Press, 1986
https://books.google.com/books/about/Introduction_to_Higher_Order_Categorical.html?id=6PY_emBeGjUC - F. W. Lawvere, "Adjointness in Foundations", Dialectica, 23(3/4), pp. 281–296, 1969(Theory and Applications of Categories の再録版)
http://www.tac.mta.ca/tac/reprints/articles/16/tr16.pdf - R. A. G. Seely, "Linear logic, *-autonomous categories and cofree coalgebras", Contemporary Mathematics 92, pp. 371–382, AMS, 1989
https://www.math.mcgill.ca/seely/ - Wikipedia「Categorical logic」
https://en.wikipedia.org/wiki/Categorical_logic
研究の拠点について参照した文章(出典):
- University of Cambridge, Department of Computer Science and Technology, Course pages 2025–26: Category Theory
https://www.cl.cam.ac.uk/teaching/2526/CAT/ - University of Oxford, Department of Computer Science, Categories, Proofs and Processes: 2023-2024
https://www.cs.ox.ac.uk/teaching/courses/2023-2024/catsproofsprocs/
圏論的論理学の形式化の研究と、Caml の由来について参照した文章(出典):
- A. van der Leer, K. Wullaert, B. Ahrens, "Scott's Representation Theorem and the Univalent Karoubi Envelope", 16th International Conference on Interactive Theorem Proving (ITP 2025), LIPIcs 352, Paper 33, 2025(Delft University of Technology)。arXiv:2506.22196
https://drops.dagstuhl.de/storage/00lipics/lipics-vol352-itp2025/LIPIcs.ITP.2025.33/LIPIcs.ITP.2025.33.pdf - N. van der Weide, "The internal languages of univalent categories", 40th Annual ACM/IEEE Symposium on Logic in Computer Science (LICS 2025), pp. 112–126, 2025. doi: 10.1109/lics65433.2025.00016。arXiv:2411.06636
https://arxiv.org/pdf/2411.06636 - B. Ahrens, R. Matthes, N. van der Weide, K. Wullaert, "Displayed Monoidal Categories for the Semantics of Linear Logic", Proceedings of the 13th ACM SIGPLAN International Conference on Certified Programs and Proofs (CPP 2024), pp. 260–273, 2024. doi: 10.1145/3636501.3636956
https://arxiv.org/pdf/2401.11752 - B. Ahrens, P. R. North, N. van der Weide, "Bicategorical type theory: semantics and syntax"(著者の所属:Ahrens はデルフト工科大学、North はユトレヒト大学、van der Weide はラドバウド大学)。arXiv:2201.10662
https://arxiv.org/pdf/2201.10662 - nLab「UniMath project」
https://ncatlab.org/nlab/show/UniMath+project - M. Fiore, P. Saville, "A type theory for cartesian closed bicategories", arXiv:1904.06538(University of Cambridge)
https://arxiv.org/pdf/1904.06538 - OCaml 公式「A History of OCaml」
https://ocaml.org/history - G. Cousineau, P.-L. Curien, M. Mauny, "The categorical abstract machine", LNCS 201, pp. 50–64, 1985(Wikipedia「Categorical abstract machine」の参考文献で確認)
https://en.wikipedia.org/wiki/Categorical_abstract_machine
推論規則と圏の対応(且つ、又は、ならば、modus ponens)について参照した文章(出典):
- "Categorical Proof-Theoretic Semantics", arXiv:2302.09031(直観主義論理の自然演繹の証明を bicartesian closed category で解釈し、積で「且つ」、指数で「ならば」、余積で「又は」を解釈することを説明)
https://arxiv.org/pdf/2302.09031 - S. Abramsky, "No-Cloning In Categorical Quantum Mechanics", arXiv:0910.2401(「且つ」「ならば」の推論規則とデカルト閉圏の射の対応表、評価の射 ev)
https://arxiv.org/pdf/0910.2401 - nLab「bicartesian closed category」(直観主義命題論理の意味論と証明論を与える圏であることを説明)
https://ncatlab.org/nlab/show/bicartesian+closed+category - K. Došen, Z. Petrić, "Bicartesian Coherence Revisited", arXiv:0711.4961(積と余積を持つ圏と、「且つ」「又は」の証明の同一性)
https://arxiv.org/pdf/0711.4961 - "An Introduction to Categorical Proof Theory", arXiv:2408.09488
https://arxiv.org/pdf/2408.09488 - agda-categories v0.1.7.2、
src/Categories/Category/Cocartesian.agda、src/Categories/Category/BicartesianClosed.agda
https://github.com/agda/agda-categories/tree/v0.1.7.2/src/Categories/Category
圏論的論理学の創始者(Lawvere と Lambek)について参照した文章(出典):
- Wikipedia「William Lawvere」(Lawvere が圏論的論理学を創始し、トポス理論を共同で創始したこと。量化子を代入の随伴として特徴づけたこと)
https://en.wikipedia.org/wiki/William_Lawvere - J.-P. Marquis, "Supplement to Category Theory"(文献一覧の「The birth of categorical logic」の節に、Lambek 1968、1969、1972 と Lawvere 1963〜1976 の論文が並ぶ)、Stanford Encyclopedia of Philosophy、2019年
https://plato.stanford.edu/archives/win2019/entries/category-theory/bib.html - McGill University, "Joachim Lambek"(1969年からの一連の論文で、圏をラベル付きの演繹体系と見なす categorical proof theory を導入したこと)
https://www.math.mcgill.ca/triples/lambek97/lamintro.html - A. Rodin, Call for papers: special issue on categorical logic, Logica Universalis, 2010(圏論的論理学が1970年ごろから今日の形で認識されてきたこと、先駆者として Joyal、Lawvere、Lambek、Makkai、Martin-Löf、Scott らの名前)
https://cs.nyu.edu/pipermail/fom/2010-July/014907.html
内部言語の定理、Scott の表現定理、形式化の動機について参照した文章(出典):
- N. van der Weide, "The internal languages of univalent categories", LICS 2025。arXiv:2411.06636(Clairambault と Dybjer(2014)の内部言語の定理を univalent な圏で証明し、Martin-Löf 型理論が局所デカルト閉圏の内部言語であると結論し、トポスの種類に広げたこと。univalent な圏を使うと、いくつかの構成と証明が簡単になること)
https://arxiv.org/pdf/2411.06636 - A. van der Leer, K. Wullaert, B. Ahrens, "Scott's Representation Theorem and the Univalent Karoubi Envelope", ITP 2025(型のないラムダ計算がある圏の反射的対象から得られるという定理の、Scott と Hyland による2通りの証明の形式化。Karoubi 包絡の役割と、基礎の選び方の影響)
https://drops.dagstuhl.de/storage/00lipics/lipics-vol352-itp2025/LIPIcs.ITP.2025.33/LIPIcs.ITP.2025.33.pdf - P. Saville, "A type theory for cartesian closed bicategories", 招待講演、Proofs, Constructions and Computations Seminar, University of Leeds, 2019年5月8日(双圏の上での作業には標準的な同型射についての大量の計算が伴い、その検査は複雑でしばしば退屈であること)
https://www.research.ed.ac.uk/en/activities/a-type-theory-for-cartesian-closed-bicategories/
圏論の研究のための定理証明言語 Rzk と、研究者による形式化について参照した文章(出典):
- N. Kudasov, E. Riehl, J. Weinberger, "Formalizing the ∞-Categorical Yoneda Lemma", Proceedings of the 13th ACM SIGPLAN International Conference on Certified Programs and Proofs (CPP 2024)。arXiv:2309.08340(著者の所属:Kudasov はイノポリス大学、Riehl と Weinberger はジョンズ・ホプキンズ大学数学科)
https://arxiv.org/abs/2309.08340 - N. Kudasov ほか, "Rzk: a Proof Assistant for Synthetic ∞-Categories", arXiv:2607.12207, 2026年7月
https://arxiv.org/abs/2607.12207 - Rzk の GitHub リポジトリ(rzk-lang/rzk)
https://github.com/rzk-lang/rzk - UniMath の GitHub リポジトリ
https://github.com/UniMath/UniMath
定理証明言語での圏論の形式化について参照した文章(出典):
- J. Z. S. Hu, J. Carette, "Formalizing Category Theory in Agda", CPP 2021, pp. 327–342. doi: 10.1145/3437992.3439922
https://github.com/agda/agda-categories - The mathlib Community, "The Lean Mathematical Library", CPP 2020, pp. 367–381. doi: 10.1145/3372885.3373824
https://leanprover-community.github.io/mathlib4_docs/Mathlib/CategoryTheory/Yoneda.html - "Category Theory in Isabelle/HOL as a Basis for Meta-logical Investigation", arXiv:2306.09074
https://arxiv.org/pdf/2306.09074
第8章 Isabelle は、論理体系を選べる
8-1 本章の位置づけ
本章では、Isabelle/HOL を扱います。
なお、本稿では、Isabelle/HOL の実機検証を実施していません。
本章の内容は、すべて文献にもとづくものです。
第4章から第6章までは、実際に処理系を動かして測った結果を示しました。
本章は、その点が異なります。
8-2 Isabelle は、ひとつの処理系ではない
タロウくん:
先生、第5章で「Isabelle/HOL は古典論理を土台としている」と学びました。
専任講師:
はい。ただし、正確には少し違います。
Isabelle は、ひとつの論理体系に固定された処理系ではありません。
タロウくん:
どういうことですか。
専任講師:
Isabelle は、土台となる小さな論理の上に、複数の論理体系を載せられるように作られています。
この土台を、Isabelle/Pure と呼びます。
その上に、いくつもの論理体系が載ります。
| 名前 | 載せている論理体系 |
|---|---|
| Isabelle/HOL | 高階論理(higher-order logic) |
| Isabelle/ZF | Zermelo-Fraenkel 集合論 |
| Isabelle/FOL | 一階述語論理 |
タロウくん:
同じ処理系で、別の論理を使えるのですね。
専任講師:
そのとおりです。
Isabelle/HOL という名前は、「Isabelle の上に HOL を載せたもの」という意味です。
実務でもっとも使われるのは、Isabelle/HOL です。 本稿で「Isabelle/HOL」と書くとき、この組み合わせを指しています。
8-3 土台の上に論理を載せる仕組み
タロウくん:
先生、その仕組みには名前があるのですか。
専任講師:
logical framework と呼びます。
日本語の定訳を確認できなかったため、本稿では英語のまま記します。
ひとつの土台を固定し、その上に複数の論理体系を記述できるようにした仕組みのことです。
タロウくん:
Isabelle だけの仕組みですか。
専任講師:
いいえ。ほかにもあります。
| 処理系 | 土台 |
|---|---|
| Isabelle | Isabelle/Pure(直観主義高階論理の一部) |
| Edinburgh LF、Twelf | λΠ計算 |
| Dedukti | λΠ計算 modulo rewriting |
タロウくん:
土台の上に論理を載せる、というのが共通しているのですね。
専任講師:
そのとおりです。
この仕組みは、1987年にエディンバラ大学の Harper、Honsell、Plotkin が提案しました。
先駆として、1967年にオランダの de Bruijn が始めた Automath があります。
出典:
R. Harper, F. Honsell, G. Plotkin, "A Framework for Defining Logics", LICS 1987, pp. 194–204
拡張版:Journal of the ACM 40(1), pp. 143–184, 1993
8-4 第2回の Standard ML と、同じ構図がある
タロウくん:
先生、この話は、第2回のどこかで出てきましたか。
専任講師:
直接は出てきません。しかし、似た構図はありました。
第2回の第5章で、Standard ML を扱いました。MLton というコンパイラが、モジュールを実行前に取り除いてしまう、という話です。
タロウくん:
モジュールで何重に包んでも、速度が変わらないのでしたね。
専任講師:
はい。そこで扱ったのは、抽象化の層を、実行前に消してしまうという設計でした。
Isabelle の logical framework も、層を持つ設計です。土台の上に論理を載せます。
ただし、目的が違います。
| Standard ML のモジュール | Isabelle の logical framework | |
|---|---|---|
| 何のための層か | プログラムを構造化するため | 複数の論理体系を、ひとつの処理系で扱うため |
| 層はどうなるか | コンパイルの段階で消える | 残る。論理体系を選ぶ仕組みとして働く |
タロウくん:
同じ「層」でも、役割が違うのですね。
専任講師:
そのとおりです。
8-5 高階論理と集合論は、何が違うのか
タロウくん:
先生、Isabelle/HOL と Isabelle/ZF は、何が違うのですか。どちらも数学を書くためのものですよね。
専任講師:
よい問いです。2つの違いを挙げます。
ひとつ目。扱える対象の範囲が違います。
集合論では、クラスの上の関係を扱えます。クラスとは、集合よりも大きな集まりのことです。
高階論理では、クラスの上の関係を取り扱うことができません。
タロウくん:
集合より大きな集まり、ですか。
専任講師:
たとえば「すべての集合の集まり」を考えてください。
これは集合ではありません。集合だとすると、矛盾が生じることが知られています。
こうした大きな集まりを、集合論ではクラスとして扱えます。高階論理では扱えません。
ふたつ目。量化に型が付くかどうかが違います。
タロウくん:
量化とは、「すべての」や「ある」のことですね。
専任講師:
はい。
高階論理では、「すべての」と書くとき、何についての「すべて」かを、型で指定します。
「すべての自然数について」「すべての実数について」という具合です。
集合論では、何についてとも限定せずに「すべて」と書けます。
これを非有界量化と呼びます。
タロウくん:
どちらが便利なのですか。
専任講師:
用途によります。
型が付いていると、扱える範囲は狭まりますが、自動で証明を探す仕組みを作りやすくなります。 探す範囲が限られるからです。
Isabelle/HOL が実務で広く使われるのは、この点が大きいと考えられます。
出典:
荒武永史「圏論的論理学の拡がり」Logic Winter School 2023、京都大学数理解析研究所、2023年2月23日
https://researchmap.jp/hisashi-aratake/presentations/41535386/attachment_file.pdf
8-6 古典論理を選ぶと、何を得て、何を手放すのか
第5章の 5-10 で触れた論点を、あらためて扱います。
タロウくん:
先生、Isabelle/HOL は古典論理なので、排中律をそのまま使えるのでしたね。
専任講師:
はい。第5章で見た問題は、起きません。
排中律を公理として付け加える必要がなく、failwith "AXIOM TO BE REALIZED" のようなコードも生まれません。
タロウくん:
それなら、Isabelle/HOL のほうが便利ではないですか。
専任講師:
証明を書くだけなら、そう言えます。
しかし、手放しているものがあります。
構成的な証明を、そのまま計算内容を持つプログラムとして読むという性質です。
タロウくん:
第2章で学んだ、Curry-Howard 対応ですね。
専任講師:
よく覚えていました。
直観主義論理では、「存在する」と証明するには、実際に作り方を示さなければなりません。だから、その証明はそのままプログラムになります。
古典論理では、「ないとは言えない」という形の証明が認められます。そこからは、何も計算できません。
タロウくん:
すると、Isabelle/HOL では、証明からプログラムを取り出せないのですか。
専任講師:
取り出せます。ただし、別の仕組みを使います。
Isabelle/HOL には、コード生成(code generation)という仕組みがあります。仕様から、実行できるコードを生成します。
証明をそのまま実行するのではなく、実行できる形に改めて書き直す、という手順です。
タロウくん:
遠回りになるのですね。
専任講師:
手順は増えます。しかし、実務では十分に使われています。
【上級者向けコラム】Isabelle/HOLのコード生成は「古典証明の抽出」とは別である
Isabelle/HOLは古典高階論理を基礎にしますが、ここから「任意の証明をそのまま実行プログラムとして取り出せる」とはなりません。古典的な存在証明は、一般にそのまま証人を与える計算ではないからです。
Isabelle/HOLのcode generatorは、実行可能と定められた定義方程式を対象に、ML、Haskell、Scala、OCamlなどのコードを生成する仕組みです。これは、構成的型理論で証明項を消去して得る抽出と、目的も経路も同一ではありません。
この違いは優劣ではなく設計の違いです。Isabelle/HOLでは強力な自動化と古典推論を活用しつつ、実行したい部分は実行可能な定義として整備します。本文で見た「論理体系」と「実行可能性の管理」が別軸であることを、Isabelle/HOLはよく示しています。
8-7 Isabelle/HOL の産業での実績
タロウくん:
先生、Isabelle/HOL は、実際にどこで使われているのですか。
専任講師:
もっともよく知られているのは、seL4 です。
seL4 は、オペレーティングシステムの中核部分(カーネル)で、その正しさが Isabelle/HOL で証明されています。
タロウくん:
オペレーティングシステムの正しさを、証明したのですか。
専任講師:
はい。仕様どおりに動くことを、機械が検査できる形で示しました。
このほか、クラウド基盤の検証にも使われています。この点は、依存型を使わない Isabelle/HOL とは何か ── AWS のクラウド基盤を検証した定理証明系は、なぜ証明を自動で探せるのか で詳しく扱いました。
タロウくん:
第2回で扱った CompCert とは、違うのですか。
専任講師:
違います。使っている処理系が違います。
| 対象 | 使われた処理系 |
|---|---|
| CompCert(C コンパイラ) | Rocq(旧 Coq) |
| seL4(オペレーティングシステムのカーネル) | Isabelle/HOL |
タロウくん:
どちらも、大きなソフトウェアの正しさを証明しているのですね。
専任講師:
そのとおりです。
古典論理か直観主義論理かという違いは、産業で使えるかどうかを左右しません。 どちらの系統でも、実績があります。
【上級者向けコラム】最適化自体が正しいことを証明する ── 証明付きコンパイラの世界
本連載では、圏論の法則を使った「最適化(コードの書き換え)」を見てきました。定理証明言語を使うと、さらに一段上のことができます。それは「コンパイラが行う最適化処理そのものが、プログラムの意味を絶対に壊さない」という定理を証明することです。
第8章で触れたCコンパイラ「CompCert」はまさにこれです。定数畳み込みやレジスタ割り付けといった複雑な最適化アルゴリズムがバグを含んでいないことを、Rocqを使って数学的に証明し尽くしています。
証明を実行時に取り除いたり、検査を省いたりするだけでなく、「変換器自体の正しさを証明する」ことも、定理証明言語が最適化の分野にもたらした非常に強力な武器なのです。
8-8 本章のまとめ
| 事項 | 内容 |
|---|---|
| Isabelle は、ひとつの論理に固定されていない | Isabelle/Pure という土台の上に、HOL、ZF、FOL などを載せられる |
| この仕組みの名前 | logical framework。Edinburgh LF、Dedukti も同じ仕組み |
| 高階論理と集合論の違い | 集合論はクラス上の関係を扱えるが、高階論理は扱えない。高階論理は量化に型が付くが、集合論は非有界量化を許す |
| 古典論理を選んで得るもの | 排中律をそのまま使える。第5章で見た問題が起きない |
| 古典論理を選んで手放すもの | 証明がそのままプログラムになる性質。コード生成という別の仕組みを使う |
| 産業での実績 | seL4 のカーネルの検証など |
本章で見た Isabelle の構造を、図に示します。
本章の内容は、すべて文献にもとづくものです。実機で確かめていません。
次の第9章では、本稿の限界を述べ、第4回への橋渡しをします。
第9章 本稿の限界と、第4回への橋渡し
9-1 本稿の限界
本稿の結論は、次の条件のもとで得られたものです。条件が変われば、結論の一部が変わる可能性があります。
限界を、未測定、比較不能または非同条件、将来の検証課題の3つに分けて示します。
| 限界 | 内容 | 分類 |
|---|---|---|
| Isabelle/HOL を実機で確かめていない | 第8章と、第5章の 5-10 は、文献にもとづくものである | 比較不能または非同条件 |
| Lean 4 の mathlib を使っていない | 数学の形式化でもっとも使われているライブラリを、本稿では扱っていない。Lean 4 自体の測定は、mathlib を使わない範囲で行った | 将来の検証課題 |
| Arend をほとんど扱っていない | 第3章で第3世代の例として挙げたが、実機での測定は行っていない。ホモトピー型理論は、本稿の範囲を超える | 未測定 |
| 測定は、単純な例で行った | 証明を引数に取る関数を繰り返し呼ぶ、長さつきリストから先頭を取り出す、といった単純な例である。実際のプログラムでどうなるかは測っていない | 将来の検証課題 |
| 測定の条件 | 単一の計算機環境で測定した。絶対値は環境によって変わる。倍率の傾向は変わりにくいと考えるが、確かめてはいない | 将来の検証課題 |
| 排中律の測定 | 型検査が通るか、実行できるかを確かめた。実行時間は測っていない | 未測定 |
| 第7章の圏論的論理学 | agda-categories のコードと、筆者が作成したコードの型検査を確かめた。研究の最前線の形式化(UniMath の中の成果)は、コードを読んでいない | 将来の検証課題 |
9-2 測っていないこと
限界の表に加えて、そもそも測っていないことを挙げます。
| 測っていないこと | なぜ測っていないか |
|---|---|
| 型検査にかかる時間 | 本稿では、実行時の速さを中心に測った。型検査の速さは、依存型を使うほど長くなることが知られているが、測っていない |
| 証明を書くのにかかる時間 | 人が証明を書く作業の量は、言語によって大きく違う。測る方法を設計できなかった |
| 大きなライブラリを使った場合 | mathlib や MathComp を使った実際の証明で、本稿の結論が成り立つかは確かめていない |
| メモリの使用量 | 実行時間のみを測った |
タロウくん:
先生、1つ目が気になります。型検査の時間は、測らなくてよいのでしょうか。
専任講師:
本来なら、測るべきです。
第2章で述べたとおり、依存型を使うと型が複雑になり、型検査に時間がかかります。実行が速くなる代わりに、コンパイルが遅くなる可能性があります。
本稿では、その反対側を測っていません。
【上級者向けコラム】なぜ依存型の型検査は時間がかかるのか ── 型検査器の中のインタプリタ
本文の第9章で「依存型を使うと型検査に時間がかかる」と触れました。これは単なる処理系の実装が遅いからではありません。
依存型を持つ言語では、型の中に値が含まれます。たとえば Vec Int (1 + 2) と Vec Int 3 が同じ型であると判定するためには、コンパイラ自身が「1 + 2」を計算(評価)しなければなりません。つまり、型検査器の中にプログラムの実行エンジン(インタプリタ)が組み込まれているのです。
もし型の中に複雑な関数や重い再帰処理を埋め込むと、型検査の最中にその計算が走り、コンパイルに膨大な時間がかかります。これが、依存型の強力な表現力と引き換えになるコンパイル時間のトレードオフの正体です。
タロウくん:
すると、本稿の結論は、片側だけを見たものですか。
専任講師:
そのとおりです。
第6章で「依存型を使うと1.09倍速くなる」と述べましたが、型検査に何倍の時間がかかるようになったかは、測っていません。
実務で判断するには、両方を見る必要があります。
9-3 本稿が答えた2つの問い
本稿の問いを、もう一度示します。
問い1:定理証明言語において、論理体系の違いは何をもたらすのか。
答えは、実行できない定義を書いてしまったとき、いつ誤りに気づくかでした。
| 言語 | いつ気づくか |
|---|---|
| Lean 4 | コンパイルの段階 |
| Rocq、Agda | 実行して初めて |
| Isabelle/HOL | 古典論理なので、この問題が起きない |
この違いを生むのは、論理体系そのものではありません。 Lean 4 も Rocq も Agda も、いずれも直観主義論理を土台としています。分けているのは、処理系が「実行できるかどうか」をいつ検査するかです。
問い2:定理証明言語における「最適化」とは何を指すのか。
答えは、少なくとも3つの異なるものを指す、でした。
| 何の最適化か | 本稿で扱った章 |
|---|---|
| 証明を実行時に取り除くこと | 第4章 |
| 型によって実行時の検査を減らすこと | 第6章 |
| 証明を検査する時間を短くすること | 本稿では測っていない |
測定を示すたびに、どれを扱っているのかを明示する必要があります。
9-4 連載を通じて見えてきたこと
タロウくん:
先生、初回記事から本稿まで読んできて、繰り返し出てくる話があるように思います。
専任講師:
どのような話でしょうか。
タロウくん:
**「コードを読んで分かることと、測って分かることは違う」**という話です。
専任講師:
よく気づきました。3回の記事で、この論点が3度現れています。
| 記事 | 現れた場面 |
|---|---|
| 第2回 第6章 | Erlang の JIT。命令数は14から5に減ったが、最初の測定では実行時間が長くなった |
| 本稿 第4章 | Lean 4 で証明を受け取る箇所が残る。実測では差が出なかった |
| 本稿 第6章 | 検査が消えることをコードで確認。繰り返しのコスト負担を差し引かなければ、差が見えなかった |
タロウくん:
どれも、コードを読んだ予想と、測った結果が食い違っています。
専任講師:
そのとおりです。
生成されたコードを読むことは、仕組みを理解するために必要です。 しかし、それだけでは、実際にどうなるかは分かりません。
タロウくん:
もうひとつ、気づいたことがあります。
専任講師:
お聞きします。
タロウくん:
**「早く気づくか、遅れて気づくか」**という対比が、何度も出てきました。
専任講師:
こちらも、よい整理です。
| 記事 | 対比 |
|---|---|
| 第2回 | 静的型付けの言語はコンパイル時に拒否する。動的型付けの言語は実行するまで分からない |
| 本稿 第5章 | Lean 4 はコンパイル時に拒否する。Rocq と Agda は実行するまで分からない |
タロウくん:
第2回では型付けの違いが分けていて、本稿では処理系の設計が分けていました。
専任講師:
そこが要点です。
同じ形の対比でも、それを生む原因は違います。 だから、「Lean 4 は静的型付けの言語のようなものだ」といった単純な言い方はできません。
連載を通じて現れた2つの論点を、図に示します。
9-5 定理証明言語は、どこで使われているのか
タロウくん:
先生、本稿で扱った言語は、研究室の中だけで使われているのでしょうか。
専任講師:
いいえ。実務でも使われています。
8-7 で CompCert と seL4 に触れました。もうひとつ、最近の事例を挙げます。
ゼロ知識証明の回路検証です。
タロウくん:
ゼロ知識証明というのは、聞いたことがあります。
専任講師:
ブロックチェーンや秘匿計算で使われる技術です。
その中心に、回路と呼ばれる仕組みがあります。計算の手順を、制約の集まりとして書き下したものです。
タロウくん:
その回路に、バグが入ることがあるのですか。
専任講師:
あります。そして、バグがあると、誤った証明が通ってしまいます。
ある研究が、この点を調べました。
SNARK システムにおける回路のバグのおよそ96パーセントが「制約の欠落」である。
タロウくん:
制約の欠落。書くべき条件を、書き忘れたということですか。
専任講師:
そのとおりです。
そして、これはまさに形式証明が事前に検出できる種類の誤りです。
本稿で扱った Lean 4 のほか、Rocq や ACL2 が、この用途で使われています。
タロウくん:
形式証明とゼロ知識証明は、どちらも「証明」という言葉を使いますね。同じものですか。
専任講師:
別のものです。守っている層が違います。
| 何を保証するか | 保証の性質 | |
|---|---|---|
| 形式証明 | 回路の設計が、書き下した仕様を満たすこと | 確率に頼らない保証。ただし、仕様の書き方が正しいこと、処理系の核に誤りがないこと、回路のモデル化が実物と一致することを前提とする |
| ゼロ知識証明 | その回路が正しく実行されたこと | 確率的な保証。誤った証明が受け入れられる確率は、無視できるほど小さく抑えられる |
形式証明の保証は「確率が100パーセント」という意味ではなく、前提が正しいかぎり、論理的に例外がないという意味です。前提そのもの(とくに仕様が意図どおりか)は、別に確かめる必要があります。
形式証明は、設計を1回検証すれば済みます。
ゼロ知識証明は、実行のたびに生成します。
タロウくん:
二重の守りになっているのですね。
専任講師:
そういうことです。
この主題に関心があれば、筆者の別の記事をご覧ください。
同記事の第7話で、この区別を扱っています。
9-6 第4回への橋渡し
タロウくん:
先生、次回は何を扱うのですか。
専任講師:
ビジネス領域への応用です。
これまでの3回は、言語そのものを扱ってきました。次回は、ここまでで見た手法が、実際の業務でどう使われているかを見ていきます。
タロウくん:
定理証明言語が、業務で使われているのですか。
専任講師:
使われています。本稿でも、いくつか触れました。
| 事例 | 使われた処理系 |
|---|---|
| CompCert(C コンパイラ) | Rocq |
| seL4(オペレーティングシステムのカーネル) | Isabelle/HOL |
次回は、こうした事例をさらに扱います。金融、暗号、機械学習といった領域で、証明がどう使われているかを見ていきます。
タロウくん:
本稿で学んだことは、そこでも使えますか。
専任講師:
使えます。
本稿で見た「誰が、いつ、何に気づくか」という論点は、業務でソフトウェアを作るときにも、そのまま当てはまります。
誤りを早く見つけるほど、直すのは容易になります。 コンパイルの段階で見つかる誤りと、運用が始まってから見つかる誤りとでは、対処のしやすさがまったく違います。
タロウくん:
本稿の話が、そこにつながるのですね。
専任講師:
そういうことです。
本稿で扱ったのは、定理証明言語という特殊な道具の話でした。しかし、その背後にある考え方は、どのような開発にも通じます。
9-7 本稿を振り返って
タロウくん:
先生、本稿を読んで、僕は何ができるようになったのでしょうか。
専任講師:
3つ挙げます。
(1つ目)
定理証明言語が何をする言語かを、説明できます。
証明とプログラムが同じものであること、全域性が保証されていること、底が存在しないこと。これらを、人に説明できるようになりました。
(2つ目)
直観主義論理と古典論理の違いが、何をもたらすかを知っています。
排中律を公理として付け加えると何が起きるか。言語によって、いつ誤りに気づくかが違うこと。
(3つ目)
「最適化」という言葉を、何を最適化したのかという対象ごとにわけて議論する目線を獲得しています。
何の速さを問題にしているのか。実行時間か、型検査の時間か。この区別ができれば、測定の結果を正しく読めます。
タロウくん:
最後の点は、定理証明言語に限らず使えそうです。
専任講師:
そのとおりです。
何を測っているのかを明確にすること。 これは、どの分野でも通じる姿勢です。
付録
用語の解説
本稿では、日本語の定訳が確認できた用語は日本語で記し、確認できなかった用語は英語のまま記しています。
日本語で記した用語
| 用語 | 意味 |
|---|---|
| 定理証明言語 | 数学の定理や、プログラムが満たすべき性質を、機械が検査できる形で書くための言語。定理証明支援系とも呼ぶ |
| 依存型(dependent type) | 値に依存する型。「長さ3のリスト」のように、型の中に値が現れる |
| 全域性(totality) | すべての関数が、必ず有限のステップで停止するという性質 |
| 底(bottom) | 評価しても値を返さない式。例外を投げる式や、無限ループがこれにあたる |
| 直観主義論理 | 排中律を公理として置かない論理体系。排中律は一般には証明できないが、否定もされない(「排中律の否定」は証明できず、むしろ「排中律の二重否定」は証明できる)。「存在する」と主張するには、実際に作り方を示す必要がある |
| 古典論理 | 排中律を認める論理体系 |
| 排中律 | 「どんな命題も、成り立つか成り立たないかのどちらかである」という規則 |
| 公理 | 証明なしに正しいと認める前提 |
| 抽出(extraction) | 証明つきのプログラムから、実行できるコードを取り出すこと |
| 恒等律 | 圏の公理のひとつ。どの射 f についても f . id = f かつ id . f = f が成り立つこと |
| 対象、射 | 圏を作る2つの要素。対象は点、射は対象から対象への矢印にあたる |
| デカルト閉圏 | 積(組)と、関数の型を持つ圏 |
| 局所デカルト閉圏 | どの対象についても、その slice category がデカルト閉圏になっている圏 |
| 内部言語(internal language) | ある圏が与えられたとき、その圏を記述する型理論 |
| 線形論理 | 前提を1度しか使えない論理体系 |
| 高階論理(higher-order logic) | 量化に型が付く論理体系。Isabelle/HOL が採用する |
| 非有界量化 | 何についてとも限定せずに「すべて」と書けること。集合論が許す |
| コード生成(code generation) | 仕様から、実行できるコードを生成すること。Isabelle/HOL が持つ仕組み |
英語のまま記した用語
| 用語 | 意味 |
|---|---|
| proof erasure | 証明を実行時に取り除くこと |
| Curry-Howard 対応 | 命題を型とみなし、証明をプログラムとみなす対応 |
| logical framework | ひとつの土台を固定し、その上に複数の論理体系を記述できるようにした仕組み |
| hyperdoctrine | 直観主義一階述語論理に対応する圏論の構造。「すべての」と「ある」が、代入の右随伴と左随伴として現れる |
| bicartesian closed category | 「且つ」「又は」「ならば」「真」「偽」をすべて持つ圏 |
| slice category | ある対象へ向かう射だけを集めて作った圏 |
| univalence | 同型なものを等しいとみなせるという性質。ホモトピー型理論が持つ |
実機検証について
検証した言語
本稿で取り上げた6つの言語のうち、5つについて処理系を導入して動かしました。
このうち、本稿の実験(proof erasure の生成物の確認、古典公理を用いた定義の確認、実行時間の測定)を行ったのは、Agda、Rocq、Lean 4、Idris 2 の4つです。
Arend は、処理系を導入して動作を確かめましたが、本稿の実験は行っていません(Executive Summary の実験表、および第9章の限界の表のとおりです)。
| 本稿の実験を行った言語 | 処理系を導入したが、本稿の実験は行っていない言語 | 処理系を導入していない言語(文献にもとづく) |
|---|---|---|
| Agda、Rocq、Lean 4、Idris 2 | Arend | Isabelle/HOL |
Isabelle/HOL を実施しなかった理由は、Executive Summary で述べたとおりです。本稿が測るのは依存型と proof erasure の働きであり、Isabelle/HOL は依存型を持たないため、同じ条件での比較になりません。
使用した処理系
| 言語 | 処理系 | バージョン |
|---|---|---|
| Agda | agda | 2.6.3(標準ライブラリ 1.7.3、agda-categories 0.1.7.2) |
| Rocq(旧 Coq) | coqc | 8.18.0(MathComp 2.1.0) |
| Lean 4 | lean | 4.15.0 |
| Idris 2 | idris2 | 0.7.0(Chez Scheme を用いてビルド) |
| Arend | Arend.jar | 1.10(Java 21 で実行) |
測定の方法
| 項目 | 内容 |
|---|---|
| 測定の回数 | 原則として5回測定し、中央値を示しました |
| 繰り返しの回数 | 第4章は300万回、第6章は1000万回 |
| 同じ値の使い回しを避けるため | 繰り返しのたびに異なる値を計算する形にしました |
| 繰り返しのコスト負担 | 第6章では、取り出す処理を行わない場合を別に測り、差し引きました |
測定でつまずいた箇所
同じことを試す読者のために、つまずいた箇所を挙げておきます。
| 言語 | つまずいた箇所 | 対処 |
|---|---|---|
| Idris 2 | 実行時に「Required SCHEME env is not set.」で止まる | 環境変数 SCHEME に chezscheme を指定する |
| Idris 2 |
divNat が全域でないため、それを使う関数も「not covering」になる |
全域である関数で例を作る |
| Arend | プロジェクトの設定ファイルを用意しても「Module not found」で失敗する | ファイルを直接指定して実行する |
| Lean 4 | 同じ計算を繰り返すと、2回目以降が 0 ms になる | 毎回異なる値を計算する形に書き換える |
| Lean 4 | 繰り返しの中でデータを作ると、作るコスト負担が測定を覆い隠す | データを繰り返しの外で1つだけ作る形に改める |
確かめた内容
| 章 | 確かめたこと |
|---|---|
| 第4章 | 証明を引数に取る関数から、実行できるコードを取り出し、証明の引数がどうなるかを確認。Lean 4 で実行時間を測定 |
| 第5章 | 排中律を公理として付け加えた定義について、型検査が通るか、実行できるコードが得られるかを確認 |
| 第6章 | 長さつきリストと通常のリストで、生成されたコードに検査が残るかを確認。Lean 4 で実行時間を測定 |
| 第7章 | agda-categories のデカルト閉圏のファイル、および筆者が作成したコードの型検査を確認 |
実験環境と再現手順
本文中の測定について、再現に必要な情報と、全測定値を掲載します。
第4章の測定:証明の引数が残ることに、コスト負担はあるか
測ったプログラム
Lean 4 で、次の2つの関数を定義しました。
def addProof (a b : Nat) (_h : a = a) : Nat := a + b
def addPlain (a b : Nat) : Nat := a + b
addProof は証明を引数に取り、addPlain は取りません。どちらも、計算の内容は同じです。
この2つを、それぞれ300万回の繰り返しの中で呼び出しました。
def loopProof (n k : Nat) : Nat := Id.run do
  let mut s := 0
  for i in [0:n] do s := s + addProof (i+k) 1 rfl
  return s

def loopPlain (n k : Nat) : Nat := Id.run do
  let mut s := 0
  for i in [0:n] do s := s + addPlain (i+k) 1
  return s
繰り返しのたびに k の値を変え、同じ計算結果が使い回されないようにしています。
時間の測り方
IO.monoNanosNow で、計算の前後の時刻を取得し、その差をミリ秒に直しました。
def timeIt (name : String) (f : Unit → Nat) : IO Unit := do
  let t0 ← IO.monoNanosNow
  let r := f ()
  let t1 ← IO.monoNanosNow
  IO.println s!"{name}: {(t1-t0)/1000000} ms (結果 {r % 1000})"
実行の方法
lean --run Bench.lean
全測定値(10回、単位はミリ秒)
| 回 | 証明を引数に取る | 証明を引数に取らない |
|---|---|---|
| 1 | 1018 | 1021 |
| 2 | 1025 | 1015 |
| 3 | 1041 | 1032 |
| 4 | 1025 | 1024 |
| 5 | 1023 | 1018 |
| 6 | 1010 | 1017 |
| 7 | 1011 | 1018 |
| 8 | 1020 | 1017 |
| 9 | 1019 | 1041 |
| 10 | 1028 | 1031 |
| 統計量 | 証明を引数に取る | 証明を引数に取らない |
|---|---|---|
| 最小 | 1,010 ms | 1,015 ms |
| 中央値 | 1,022 ms | 1,020 ms |
| 最大 | 1,041 ms | 1,041 ms |
読み方
両者の中央値の差は2ミリ秒で、倍率にすると1.00倍です。
それぞれの最小値と最大値の幅は、証明を引数に取る場合で31ミリ秒、取らない場合で26ミリ秒です。中央値の差2ミリ秒は、この幅よりはるかに小さくなっています。 本文で「測定の揺れの範囲」と述べたのは、この意味です。
生成された C のコードの確認方法
lean -c Bench.c Bench.lean
生成された Bench.c の中で、l_addProof の定義を読むと、引数が3つあり、そのうち3つ目(証明の引数)が本体で参照されていないことを確かめられます。
第6章の測定:型で保証すると、実行時の検査は減るのか
測ったプログラム
Lean 4 で、通常のリストと、長さつきリスト(Vec)を定義しました。
def headOption (xs : List Nat) : Nat :=
  match xs with | [] => 0 | x :: _ => x

inductive Vec (α : Type) : Nat → Type where
  | nil : Vec α 0
  | cons : α → Vec α n → Vec α (n+1)

def vhead {n : Nat} (v : Vec Nat (n+1)) : Nat :=
  match v with | Vec.cons x _ => x
headOption は空の場合を検査します。vhead は型が長さ1以上を保証しているため、検査しません。
3種類の繰り返しを測りました
def loopEmpty (n : Nat) (c : Nat) : Nat := Id.run do
  let mut s := 0
  for _ in [0:n] do s := s + c
  return s

def loopList (n : Nat) (xs : List Nat) : Nat := Id.run do
  let mut s := 0
  for _ in [0:n] do s := s + headOption xs
  return s

def loopVec (n : Nat) (v : Vec Nat 3) : Nat := Id.run do
  let mut s := 0
  for _ in [0:n] do s := s + vhead v
  return s
loopEmpty は取り出す処理を行わず、繰り返しだけを行います。繰り返しそのもののコスト負担を測るためです。
データは繰り返しの外で1つだけ作り、作るコスト負担が測定に混ざらないようにしています。
繰り返しの回数
1000万回です。
全測定値(5回、単位はミリ秒)
| 回 | 繰り返しだけ | 通常のリスト | 長さつきリスト |
|---|---|---|---|
| 1 | 2650 | 3675 | 3682 |
| 2 | 2757 | 3812 | 3693 |
| 3 | 2696 | 3769 | 3708 |
| 4 | 2686 | 3843 | 3654 |
| 5 | 2713 | 3755 | 3630 |
| 統計量 | 繰り返しだけ | 通常のリスト | 長さつきリスト |
|---|---|---|---|
| 最小 | 2,650 ms | 3,675 ms | 3,630 ms |
| 中央値 | 2,696 ms | 3,769 ms | 3,682 ms |
| 最大 | 2,757 ms | 3,843 ms | 3,708 ms |
差し引きの計算
| 書き方 | 計算 | 取り出す処理のコスト負担 |
|---|---|---|
| 通常のリスト | 3,769 − 2,696 | 1,073 ms |
| 長さつきリスト | 3,682 − 2,696 | 986 ms |
1,073 ÷ 986 = 1.09 となります。
読み方
繰り返し全体では、3,769 ÷ 3,682 = 1.02 倍です。
差し引いた値では、1.09 倍です。
本文の 6-8 と、そこに添えた上級者向けコラムで述べたとおり、この差し引きは「全体時間 = 繰り返しの時間 + 取り出す処理の時間」という分解が成り立つことを前提としています。 コンパイラの最適化によっては、この前提が厳密には成り立たない場合があります。
生成された C のコードの確認方法
lean -c Bench.c Bench3.lean
l_headOption には lean_obj_tag による検査があり、l_vhead___rarg には検査がなく lean_ctor_get で直接取り出していることを確かめられます。
第5章の確認:排中律を公理として付け加えた定義
この章では、時間を測っていません。型検査が通るか、実行できるコードが得られるかを確かめました。
Rocq
Require Import Classical.
Require Import ClassicalDescription.
Require Import Extraction.

Definition decide_classical (P : Prop) : {P} + {~P} := excluded_middle_informative P.

Definition f (n : nat) : nat :=
  if decide_classical (n = 0) then 1 else n.

Extraction Language OCaml.
Extraction "cls2.ml" f.
実行の方法:
coqc cls2.v
抽出された cls2.ml に failwith "AXIOM TO BE REALIZED" が含まれることを確かめられます。
Lean 4
open Classical

def f (n : Nat) : Nat :=
  if Classical.propDecidable (n = 0) matches isTrue _ then 1 else n
実行の方法:
lean Cls2.lean
noncomputable を付けるよう促すエラーが出ることを確かめられます。
Agda
postulate em : (A : Set) → A ⊎ (¬ A)

f : Nat → Nat
f n with em (n ≡ 0)
... | inl _ = 1
... | inr _ = n
実行の方法:
agda --js Cls.agda
生成された JavaScript に exports["em"] = undefined が含まれることを確かめられます。
第6章の確認:他の言語で検査が消えるか
Rocq
Require Import Extraction.
Require Import List.

Definition head_option (xs : list nat) : nat :=
  match xs with nil => 0 | x :: _ => x end.

Inductive vec (A:Type) : nat -> Type :=
| vnil : vec A 0
| vcons : forall n, A -> vec A n -> vec A (S n).
Arguments vnil {A}.
Arguments vcons {A n}.

Definition vhead {n} (v : vec nat (S n)) : nat :=
  match v with vcons x _ => x end.

Extraction Language OCaml.
Extraction "vec.ml" head_option vhead.
抽出された vec.ml で、vhead に | Vnil -> Obj.magic __ という分岐が残ることを確かめられます。
Idris 2
data Vect : Nat -> Type -> Type where
  Nil  : Vect Z a
  (::) : a -> Vect n a -> Vect (S n) a

headOption : List Nat -> Nat
headOption [] = 0
headOption (x :: _) = x

vhead : Vect (S n) Nat -> Nat
vhead (x :: _) = x
実行の方法:
idris2 -o vtest Vec.idr
生成された Chez Scheme のコードで、headOption に (if (null? arg-0) ...) があり、vhead にはないことを確かめられます。
測定について、あらかじめお断りすること
| 項目 | 内容 |
|---|---|
| 測定の回数 | 第4章は10回、第6章は5回。いずれも中央値を本文に示しました |
| 絶対値 | 計算機の性能によって変わります。本文の絶対値を、そのまま再現できるとは限りません |
| 倍率 | 同じ条件で測った値どうしの比です。この傾向は再現しやすいと考えますが、確かめていません |
| 処理系の版 | 本節の冒頭に示した版で測りました。版が変われば、結果も変わる可能性があります |
| コンパイルの設定 | Lean 4 は既定の設定で実行しました。最適化の指定は行っていません |
訂正一覧
公開後に訂正が生じた場合は、この節に追記します。現時点では該当がありません。
関連記事
本連載
| 回 | 表題 |
|---|---|
| 初回 | Hask 圏は、圏ではない ── それでも GHC が圏論を使って最適化できる理由 |
| 第2回 | 圏論から導かれた8つの高速化の手法(リスト処理、モナド、エラー処理)は、Haskell の外でも効くのか |
| 第3回 | 本稿 |
| 第4回 | ビジネス領域への応用(予定) |
本稿と関連する筆者の記事
論理体系について
- 論理はひとつではない ── 圏論的論理学がつなぐ量子論理・トポス・圏論的量子力学
https://qiita.com/etale_cohomology/items/24858c3bd7c7d6833eaa - トポスと論理の関係 ── ひとつのトポス(数学の宇宙)を選ぶと、なぜ古典論理か直観主義論理が決まるのか ── そして、トポス以外の「器」たち
https://qiita.com/etale_cohomology/items/5206679c2fd02aea9512 - 【思考実験】法律は本当に二値論理なのか? ── 多値論理・量子論理・様相論理から眺める法的判断
https://qiita.com/etale_cohomology/items/5d7dfd9186013d64b158
定理証明支援系について
- 依存型を使わない Isabelle/HOL とは何か ── AWS のクラウド基盤を検証した定理証明系は、なぜ証明を自動で探せるのか
https://qiita.com/etale_cohomology/items/6987c76966a3513cd6e0 - MetaPRL とは何か ── computational type theory を土台にした logical framework は、何ができて、何ができなかったのか
https://qiita.com/etale_cohomology/items/9a1a94a686b18808a1b7
型理論について
- Computational type theory とは何か ── 型は先にあるのではなく、計算の振る舞いがあとから型を成す
https://qiita.com/etale_cohomology/items/a830a5ac5013a298fb97 - なぜ De Morgan cubical type theory には Computational type theory の実装がないのか ── Nuprl から RedPRL・cooltt への系譜
https://qiita.com/etale_cohomology/items/4035a0b3f4d40766437c
形式化された定理を調べる
- 形式化された数学定理はどこで調べる?どの定理がどの証明支援系で形式化されたか?――『Formalizing 100 Theorems』から証明コードを読むまで
https://qiita.com/etale_cohomology/items/98ea2db9b9ea01751005
出典一覧
本稿で参照した文献とウェブページを、本文に登場した順に掲げます。
型理論と論理
- M. H. Sørensen, P. Urzyczyn, Lectures on the Curry-Howard Isomorphism, Studies in Logic and the Foundations of Mathematics, Volume 149, Elsevier, 2006
- R. Harper, F. Honsell, G. Plotkin, "A Framework for Defining Logics", LICS 1987, pp. 194–204. 拡張版:Journal of the ACM 40(1), pp. 143–184, 1993
圏論的論理学
- 荒武永史「圏論的論理学の拡がり」Logic Winter School 2023、京都大学数理解析研究所、2023年2月23日. https://researchmap.jp/hisashi-aratake/presentations/41535386/attachment_file.pdf
- 荒武永史「トポス理論入門:Grothendieck トポスと初等トポス」. http://www.math.mi.i.nagoya-u.ac.jp/~kihara/workshop/wakate/aratake.pdf
- N. van der Weide, "The internal languages of univalent categories", LICS 2025, pp. 112–126. doi: 10.1109/LICS65433.2025.00016. arXiv: https://arxiv.org/abs/2411.06636
定理証明支援系のライブラリ
- J. Z. S. Hu, J. Carette, "Formalizing Category Theory in Agda", CPP 2021, pp. 327–342. doi: 10.1145/3437992.3439922. https://github.com/agda/agda-categories