
本稿の位置づけ
本稿は、連載シリーズ『圏論の数学知見は具体的に、各関数型言語のコード最適化にどう役立つのか?(具体的なケースで見る)』 の 第1回目 の記事です。
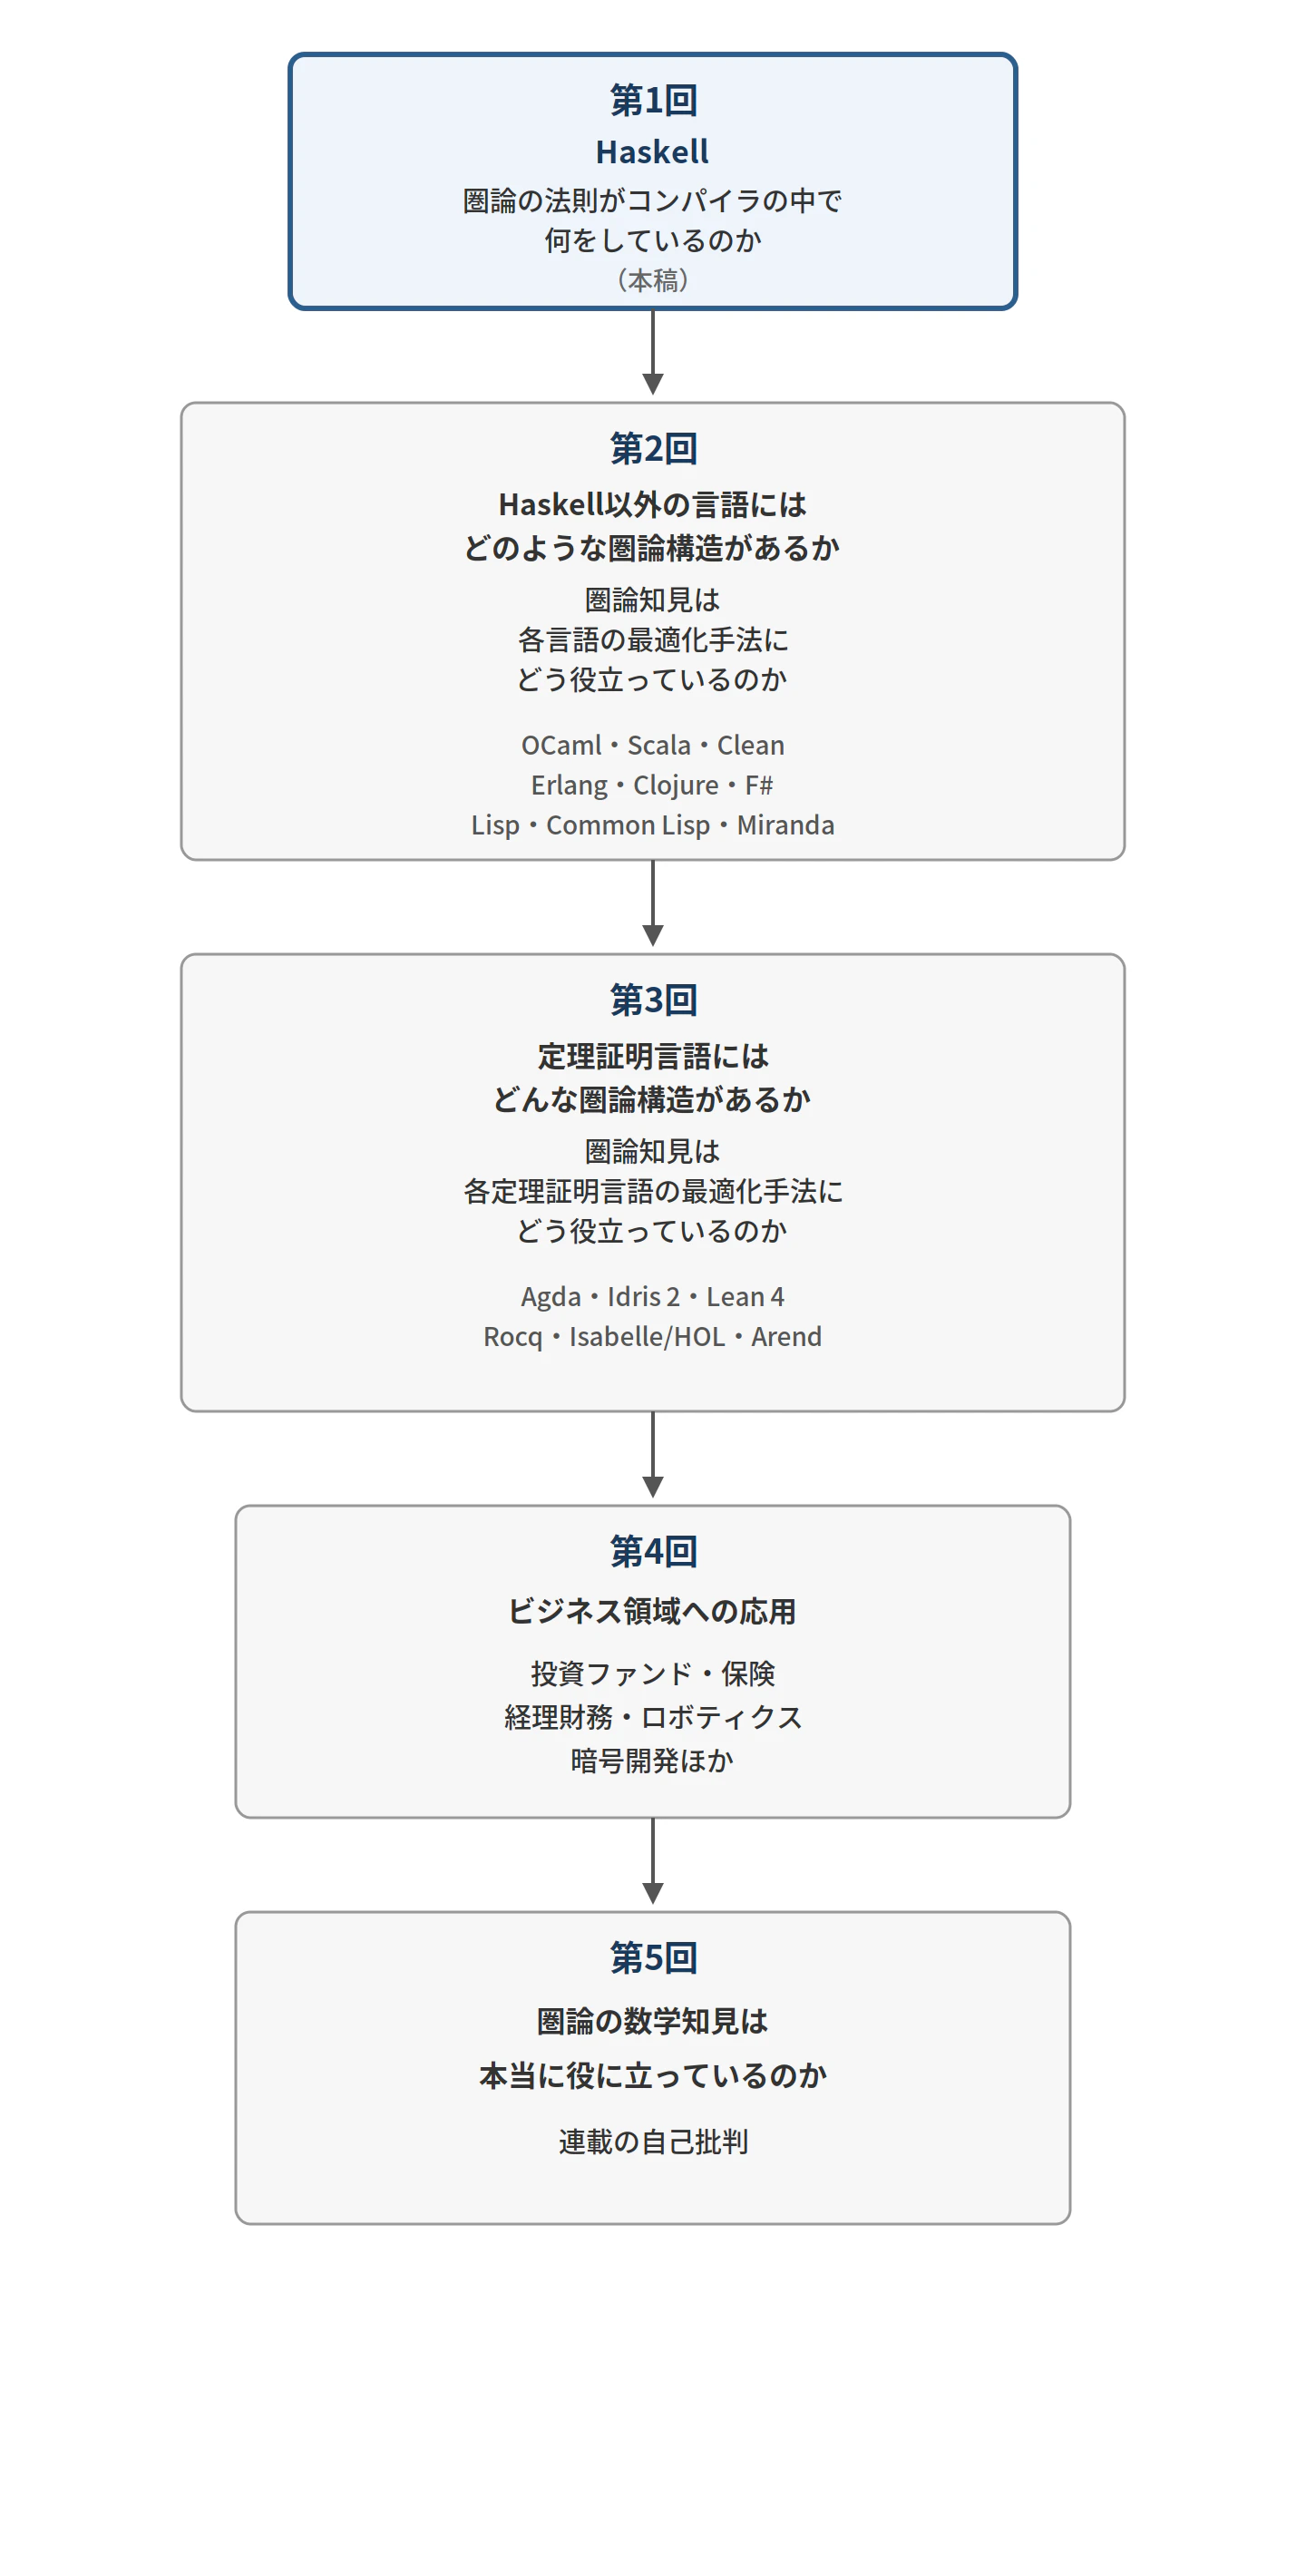
各回のテーマ は以下になります。(初回時点で予定している限り)
-
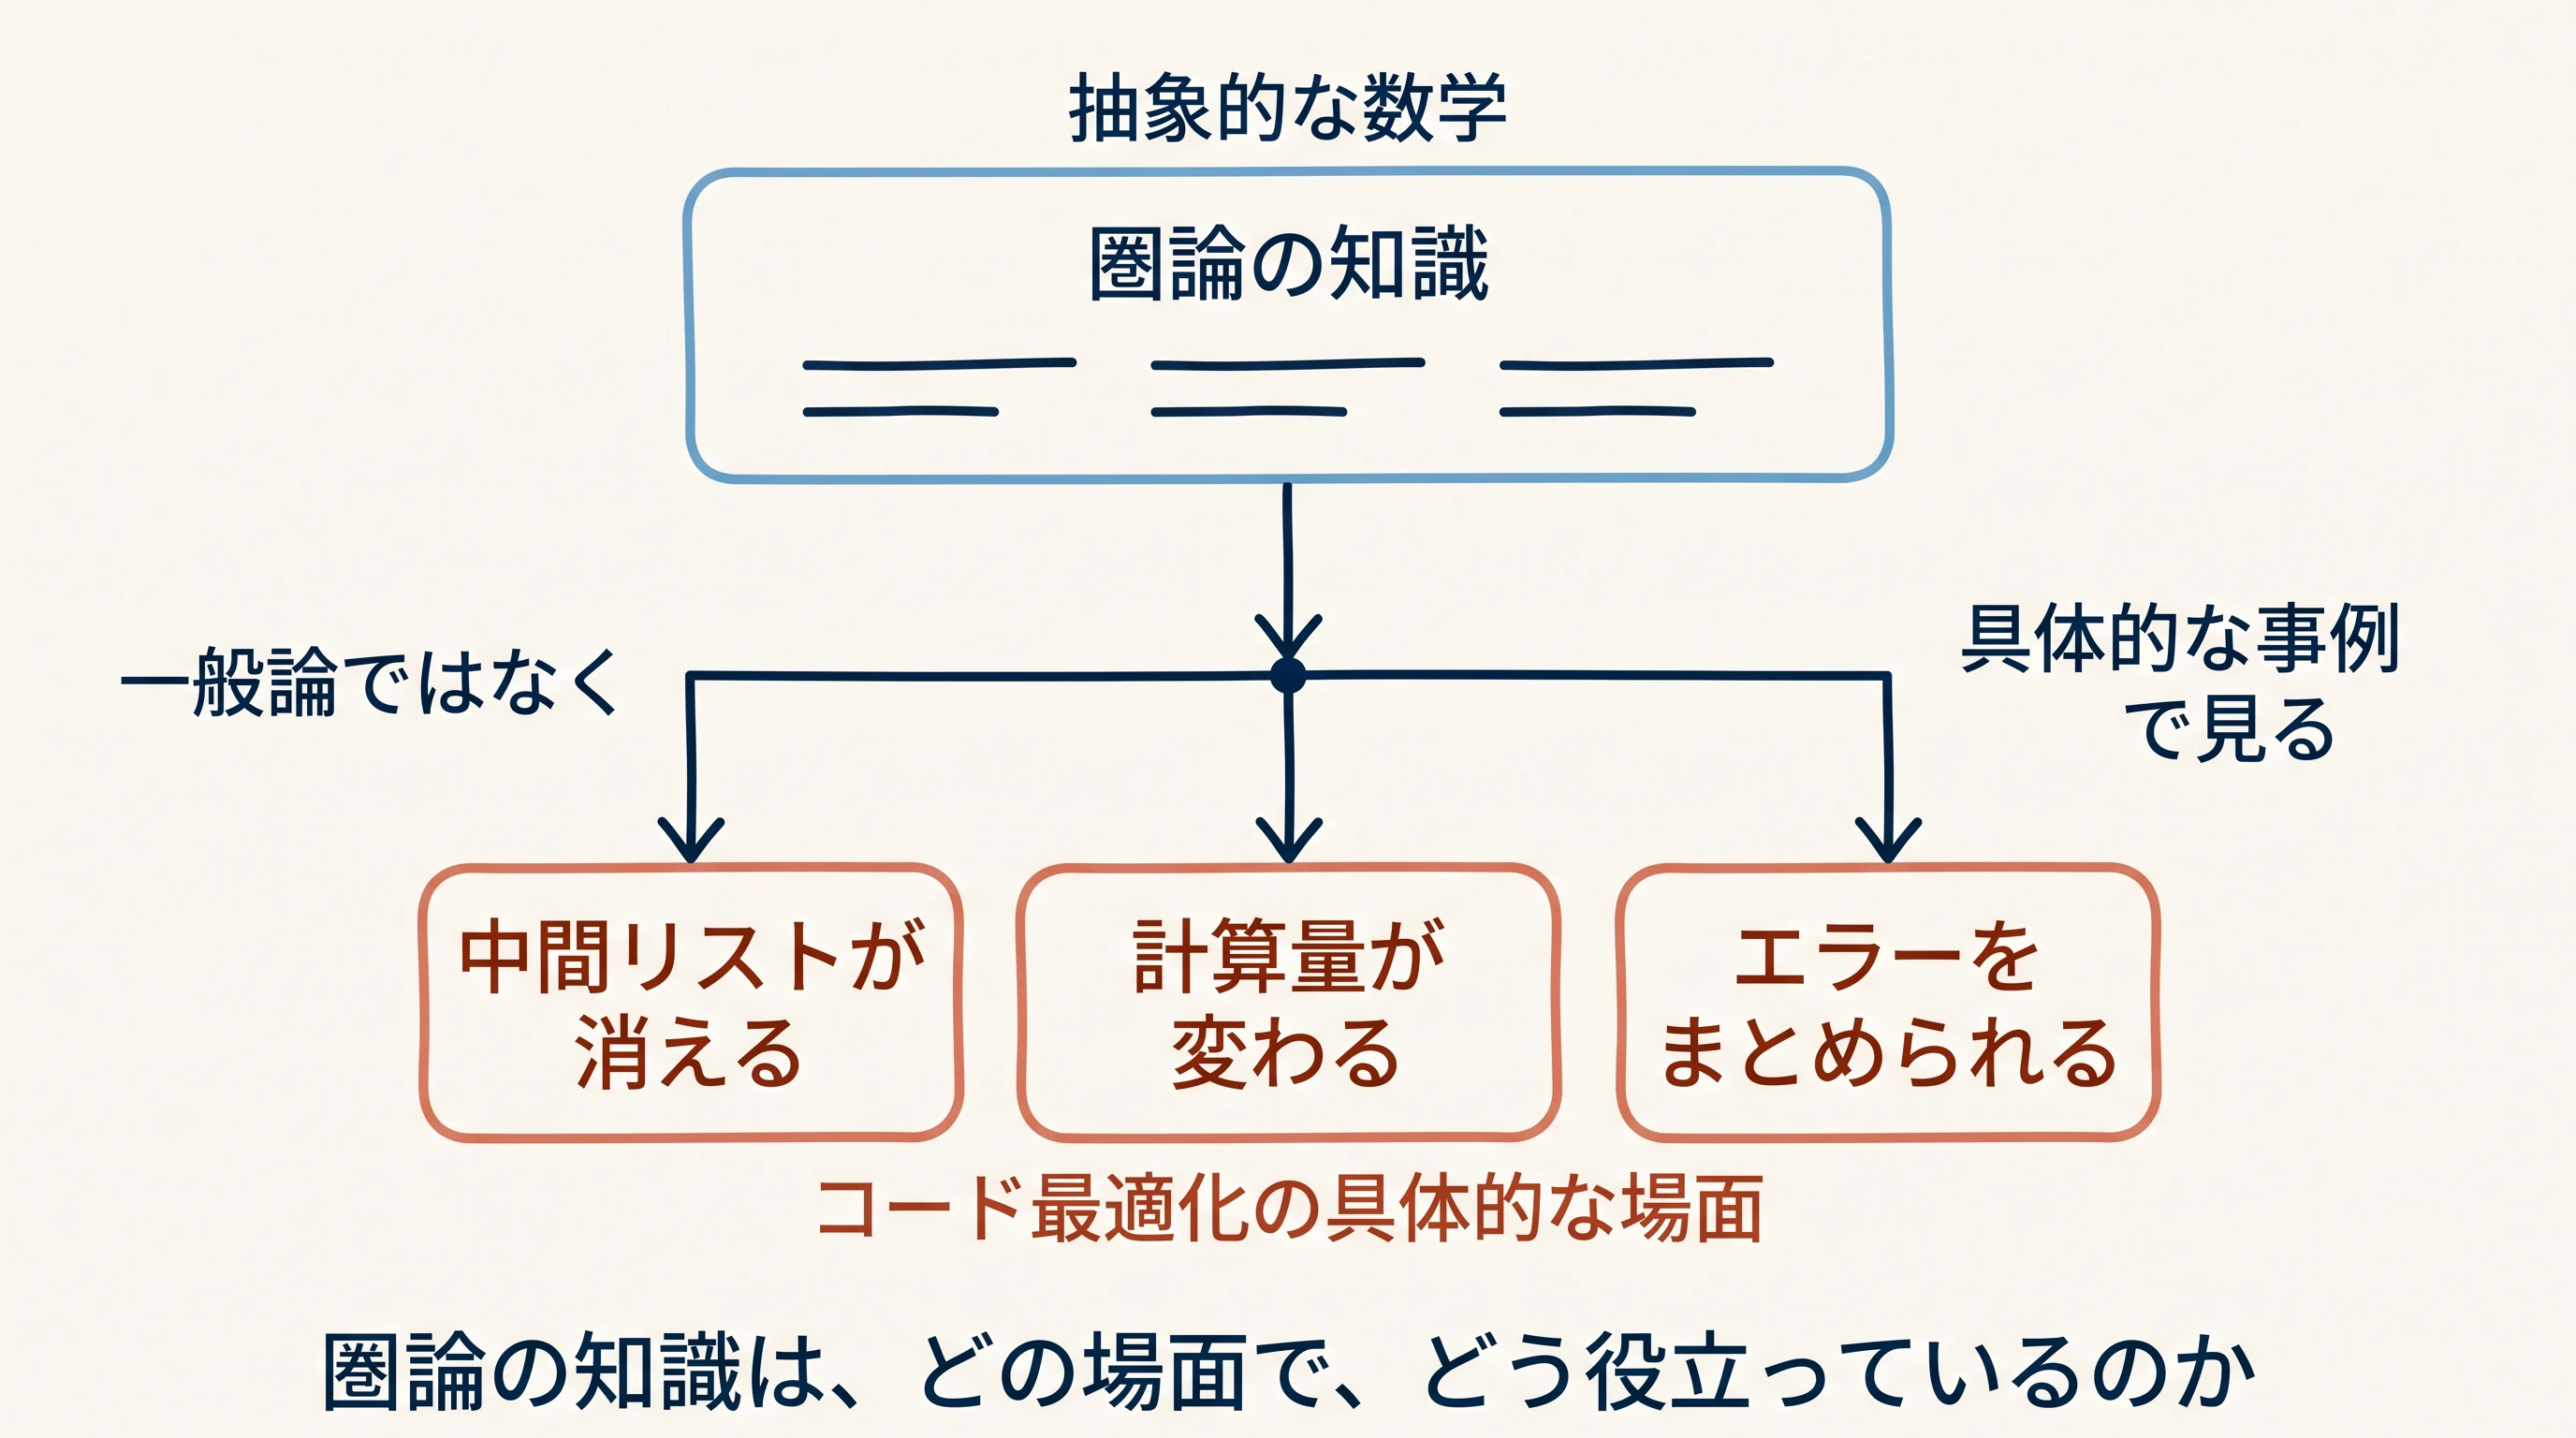
圏論の知識 が、関数型言語や定理証明言語の コード最適化でどう役立っているのか?
コードの最適化が行われる具体的な場面・ユースケース を複数、取り上げます。
なお、本連載シリーズでは、Functor則やMonad則のように、圏論で「〇〇則」と呼ばれる「等式」を、わかりやすく「圏論の法則」と呼ぶことにします。
(正確を期すならば、Functor則やMonad則は、圏論の用語というよりも、Haskellの型クラスに課される法則として語られることが多いものです。圏論の側では、「関手の公理」「モナドの公理」と呼ばれます)
本稿は分かりやすさを優先して、表現の正確性については、犠牲にした部分があります。
- 抽象的な一般論ではなく、コード最適化の事例 を 具体的 に取り上げて、圏論の数学知見がコード最適化にどう役立っているのか を論じます。
-
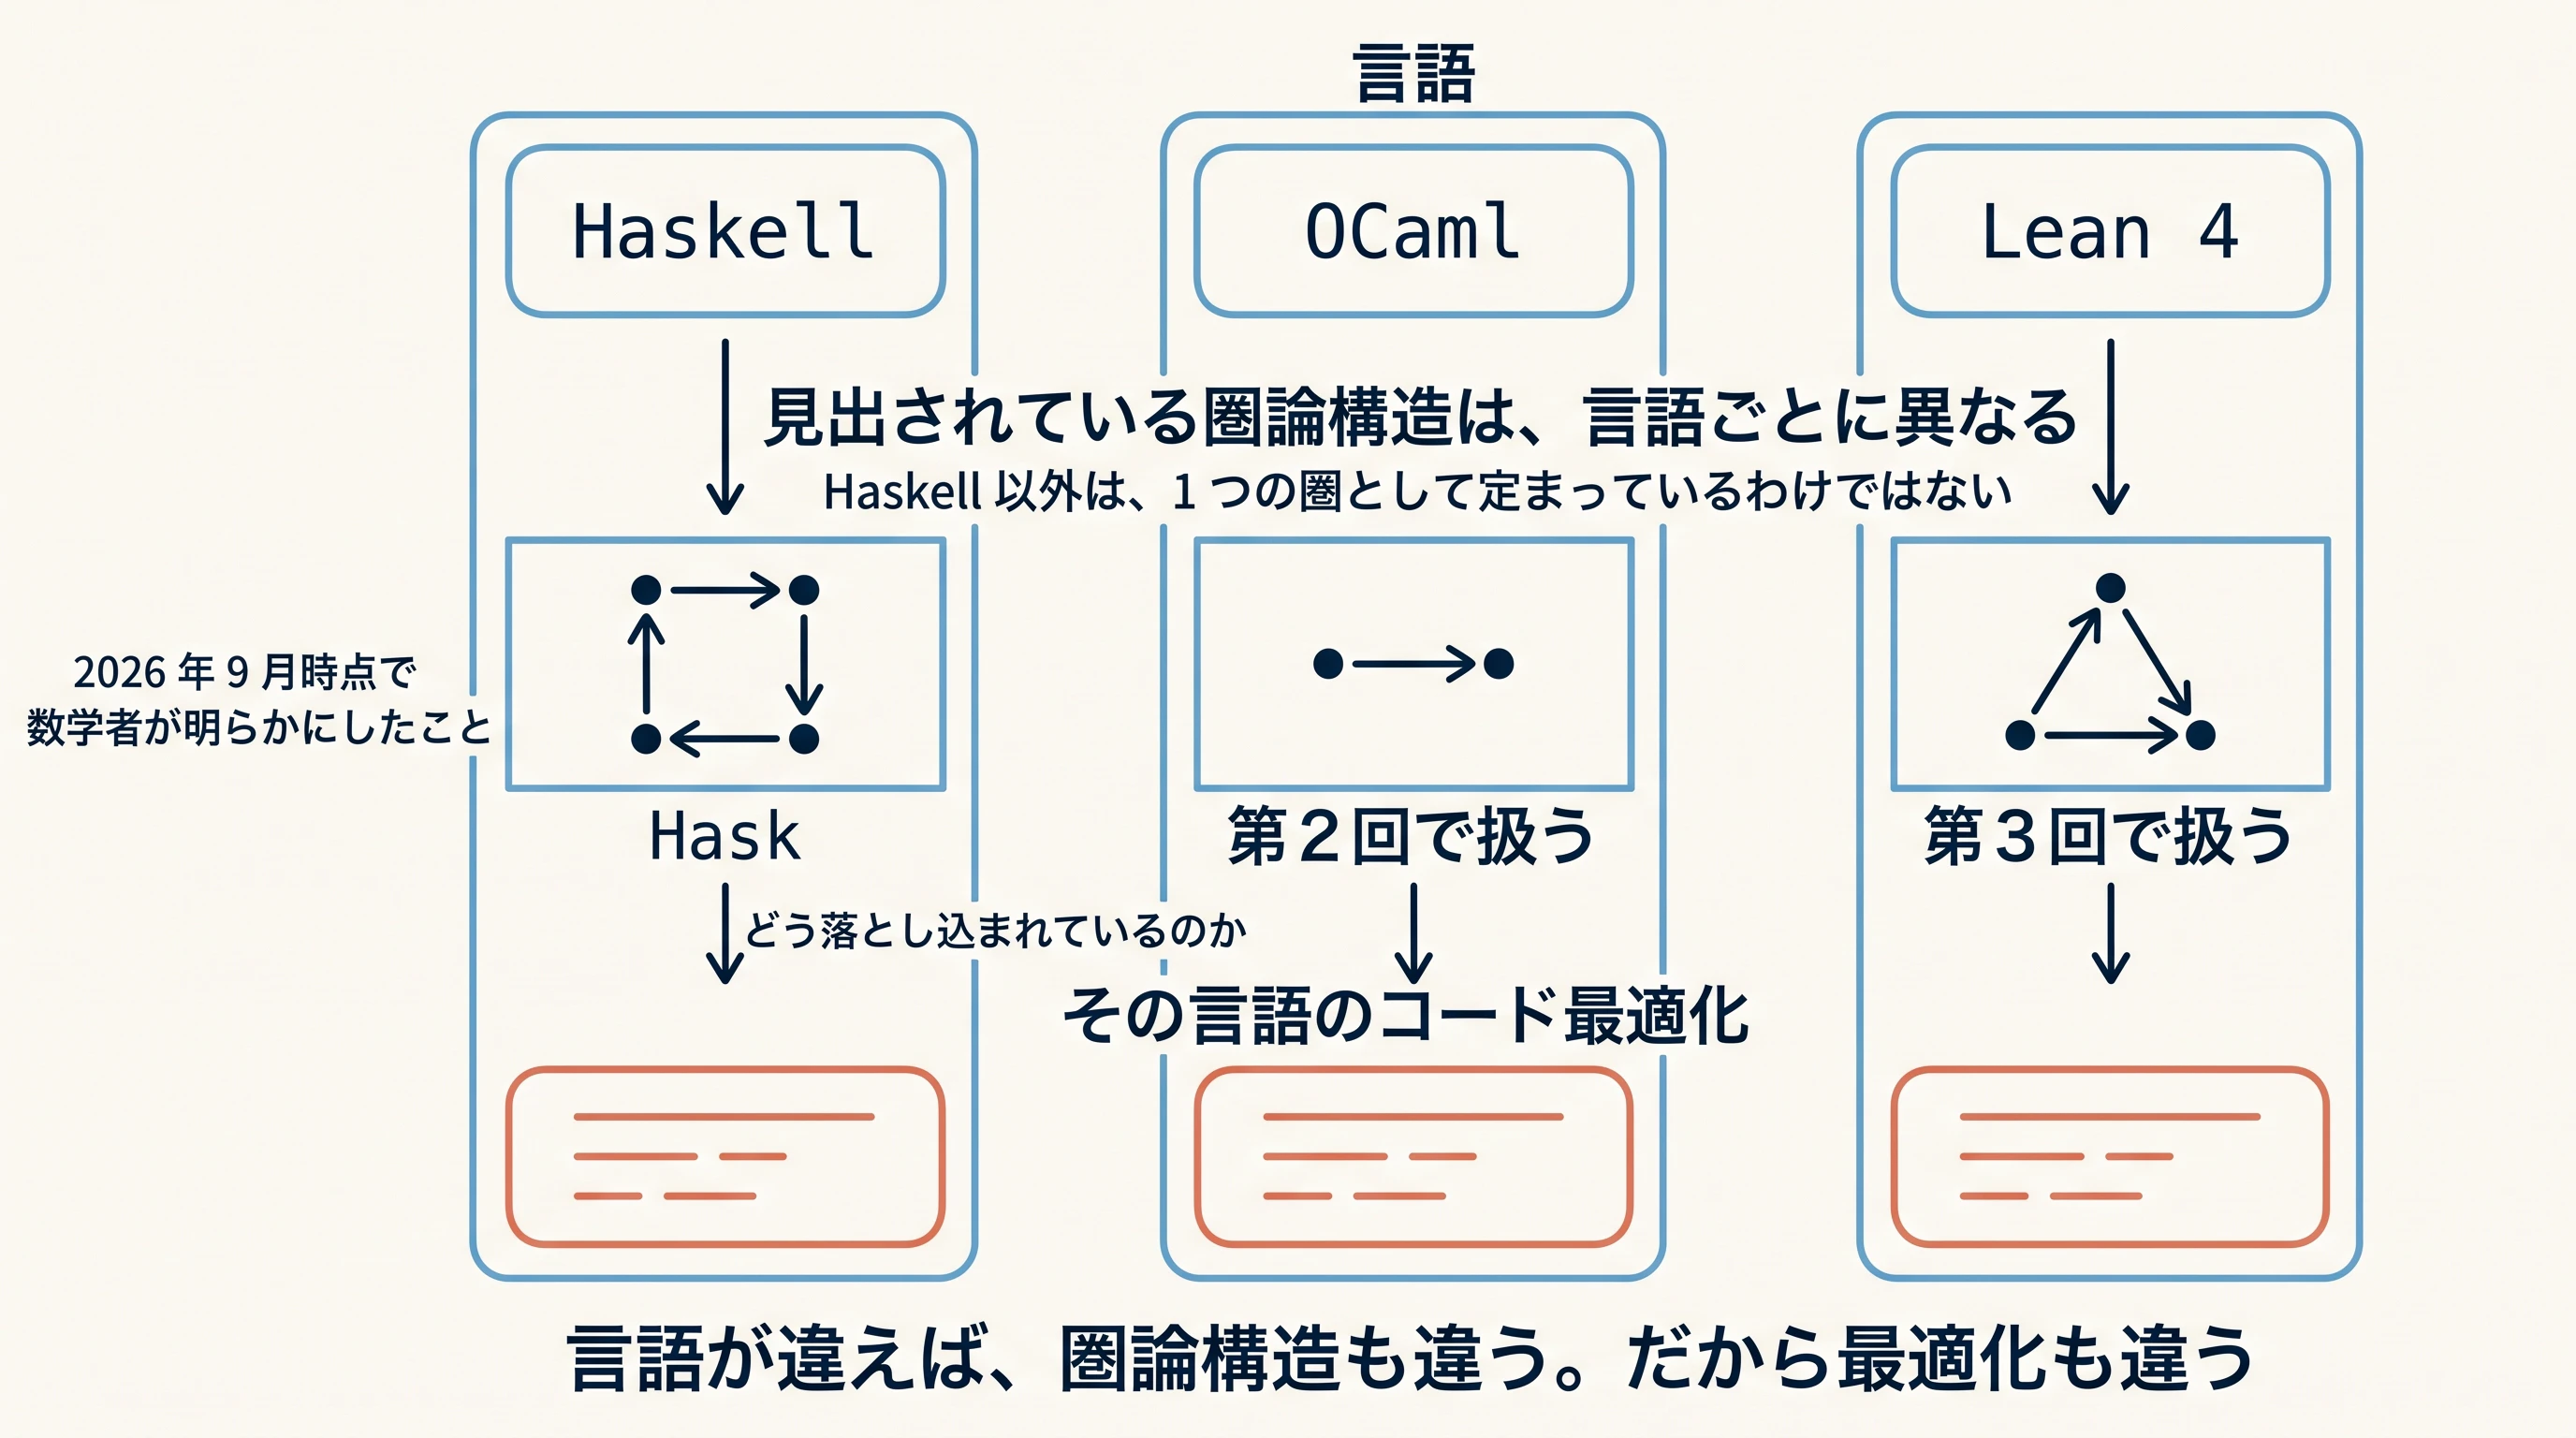
個々の関数型言語・個々の定理証明言語によって、言語が持つ圏論構造は異なります。
そのため、それぞれの言語が持つ圏論構造に関して、2026年9月時点で数学者たちが明らかにしてきた数学知見 が、各言語のコード最適化にどう落とし込まれているのか(抽象的な数学知見がどう具象化されているのか) を取り上げます。
-
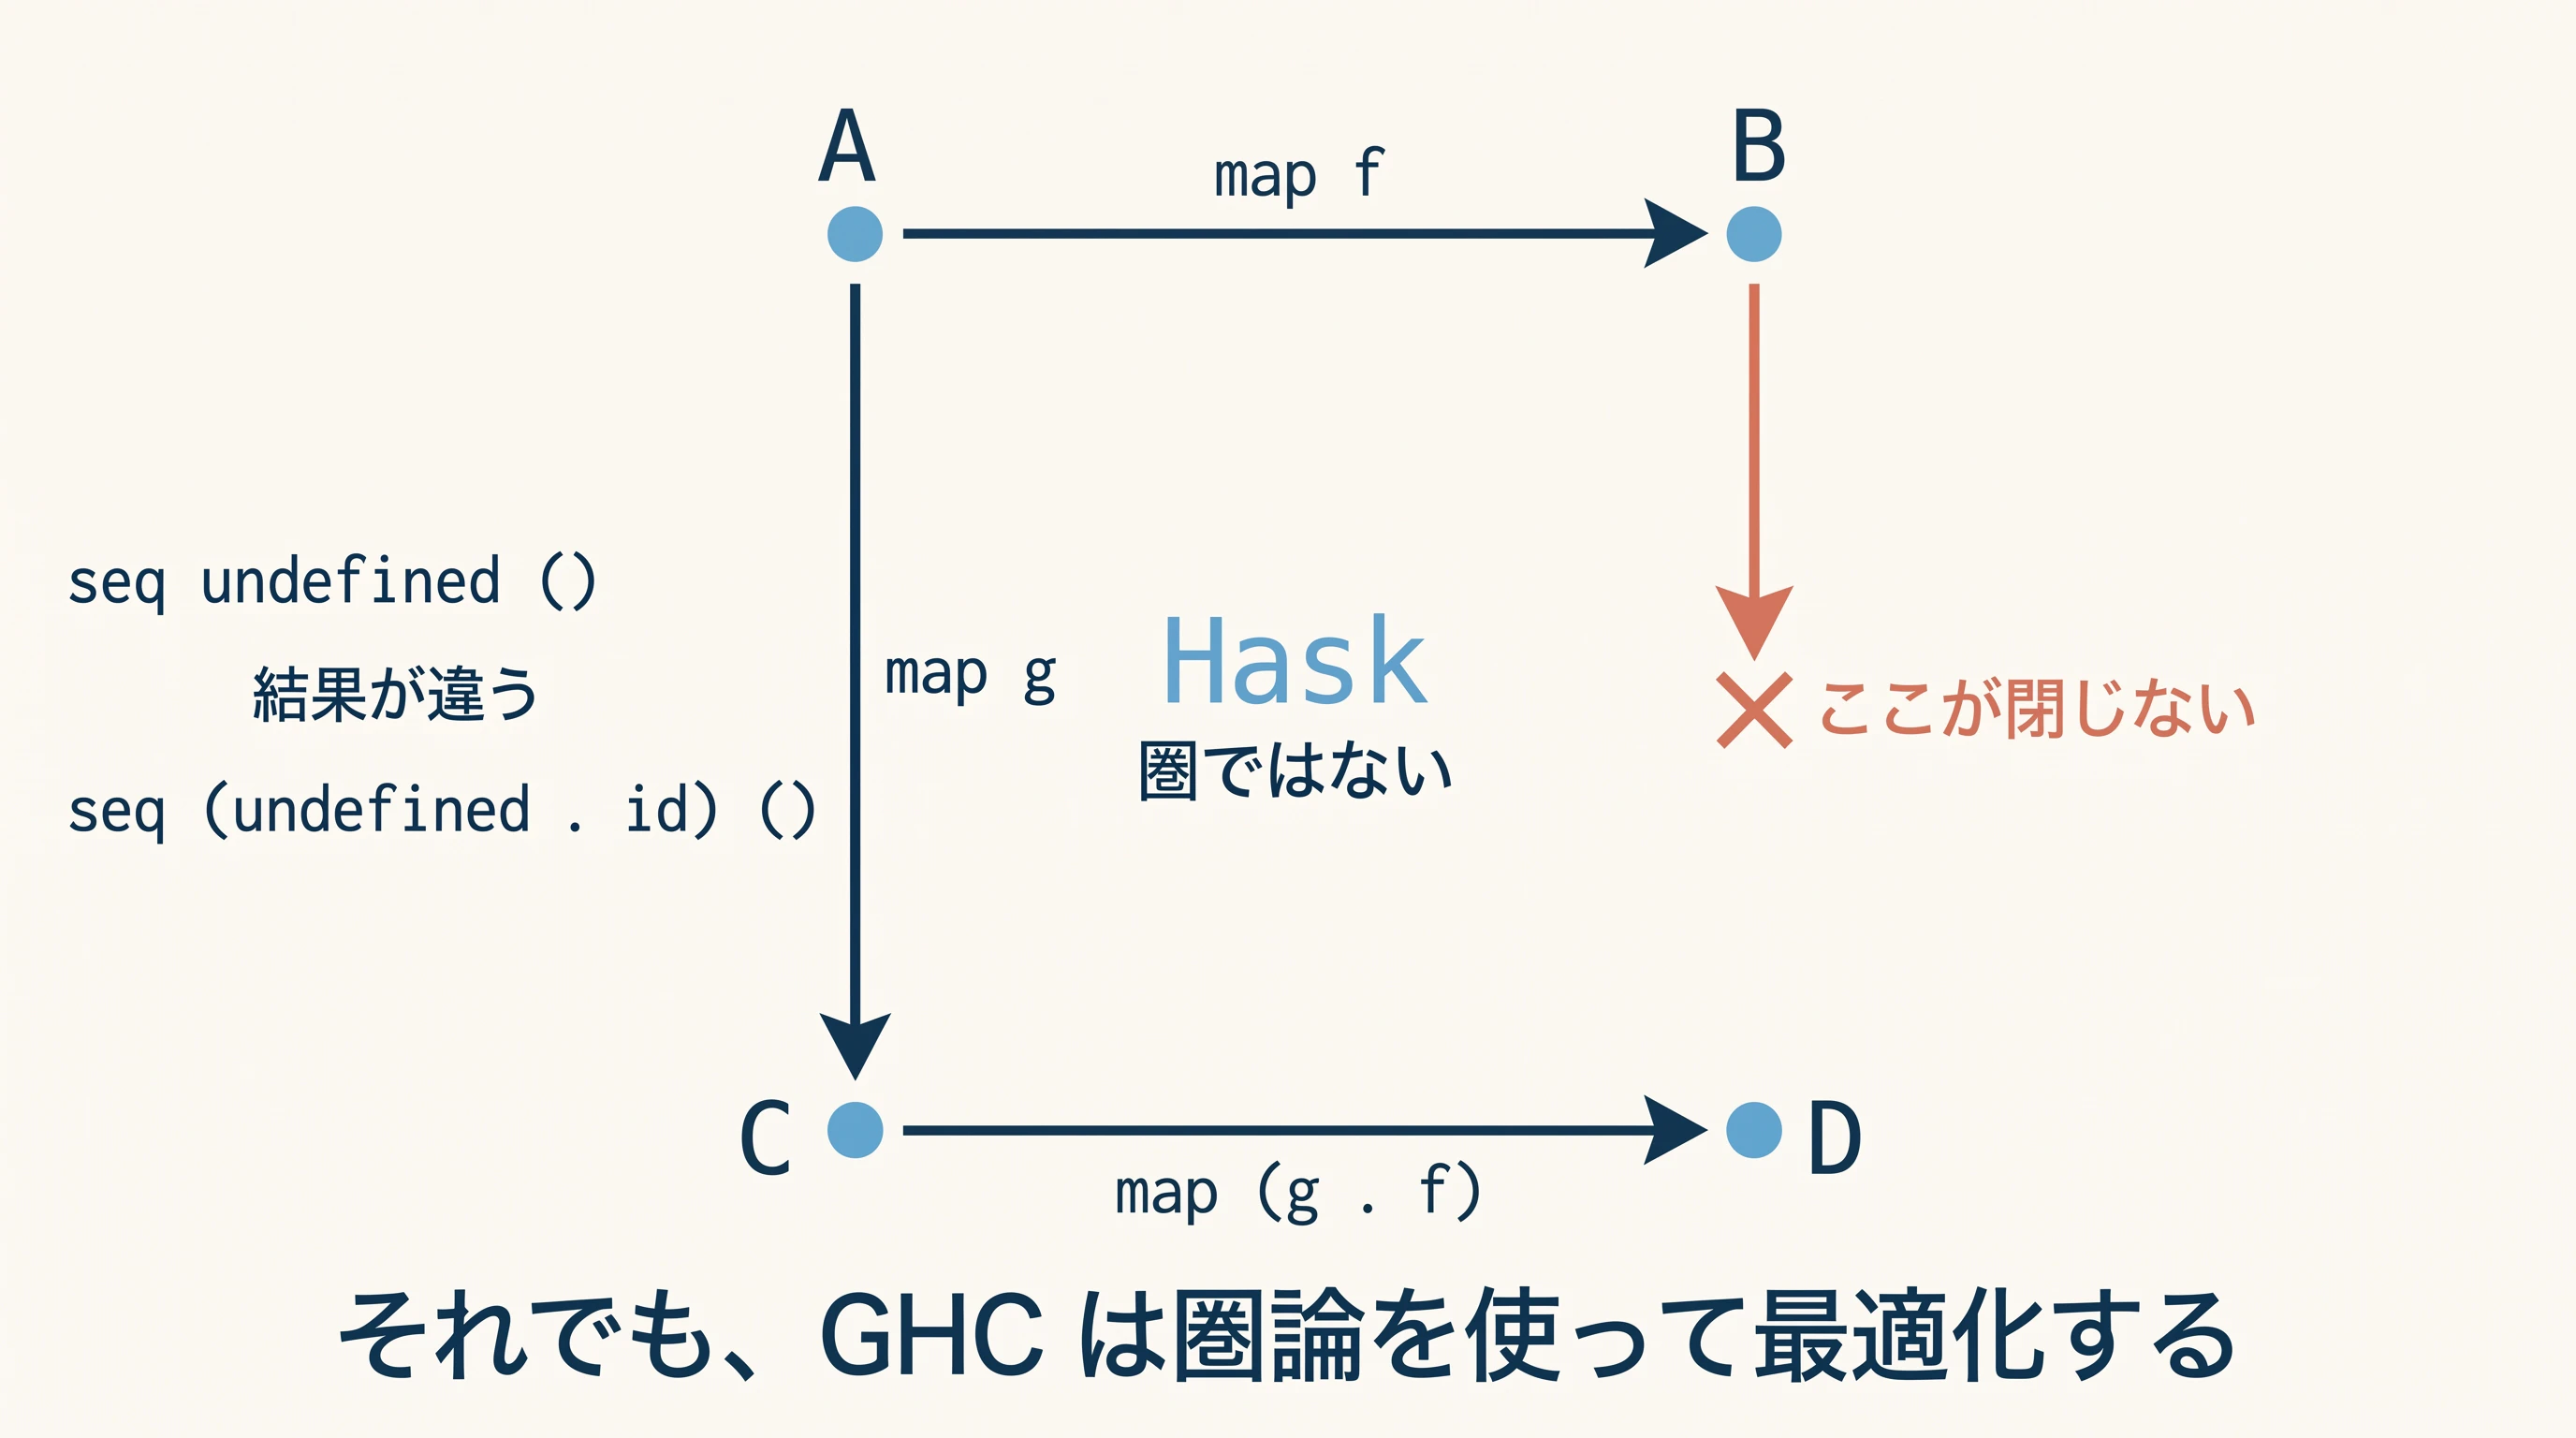
ただし、Haskell 以外の言語について、「1つの圏」が定まっているわけではありません。
Haskell には Hask という呼び名がありますが、他の言語 では、型理論そのものを圏論的に解釈するという形 になります。この違いは、第2回と第3回で扱います。
- コンパイラが実際に行っている書き換えを、実機の出力で確かめます。
連載初回となる本稿は、Haskell を題材とします。
想定読者
-
Haskell を書いたことがある方。 初級者でまったく差し支えございません
-
圏論を学んだことがない方、あるいは学び始めたばかりの方
-
mapやfoldrを使うが、内部で何が起きているかご存じない方
- コンパイラの最適化に関心のある方
前提とする知識
- Haskell の基本的な文法。
map、foldr、型シグネチャが読めること
前提としない知識
- 圏論。本文で必要な範囲を説明いたします
- GHC の内部構造
- 自由定理、パラメトリシティ
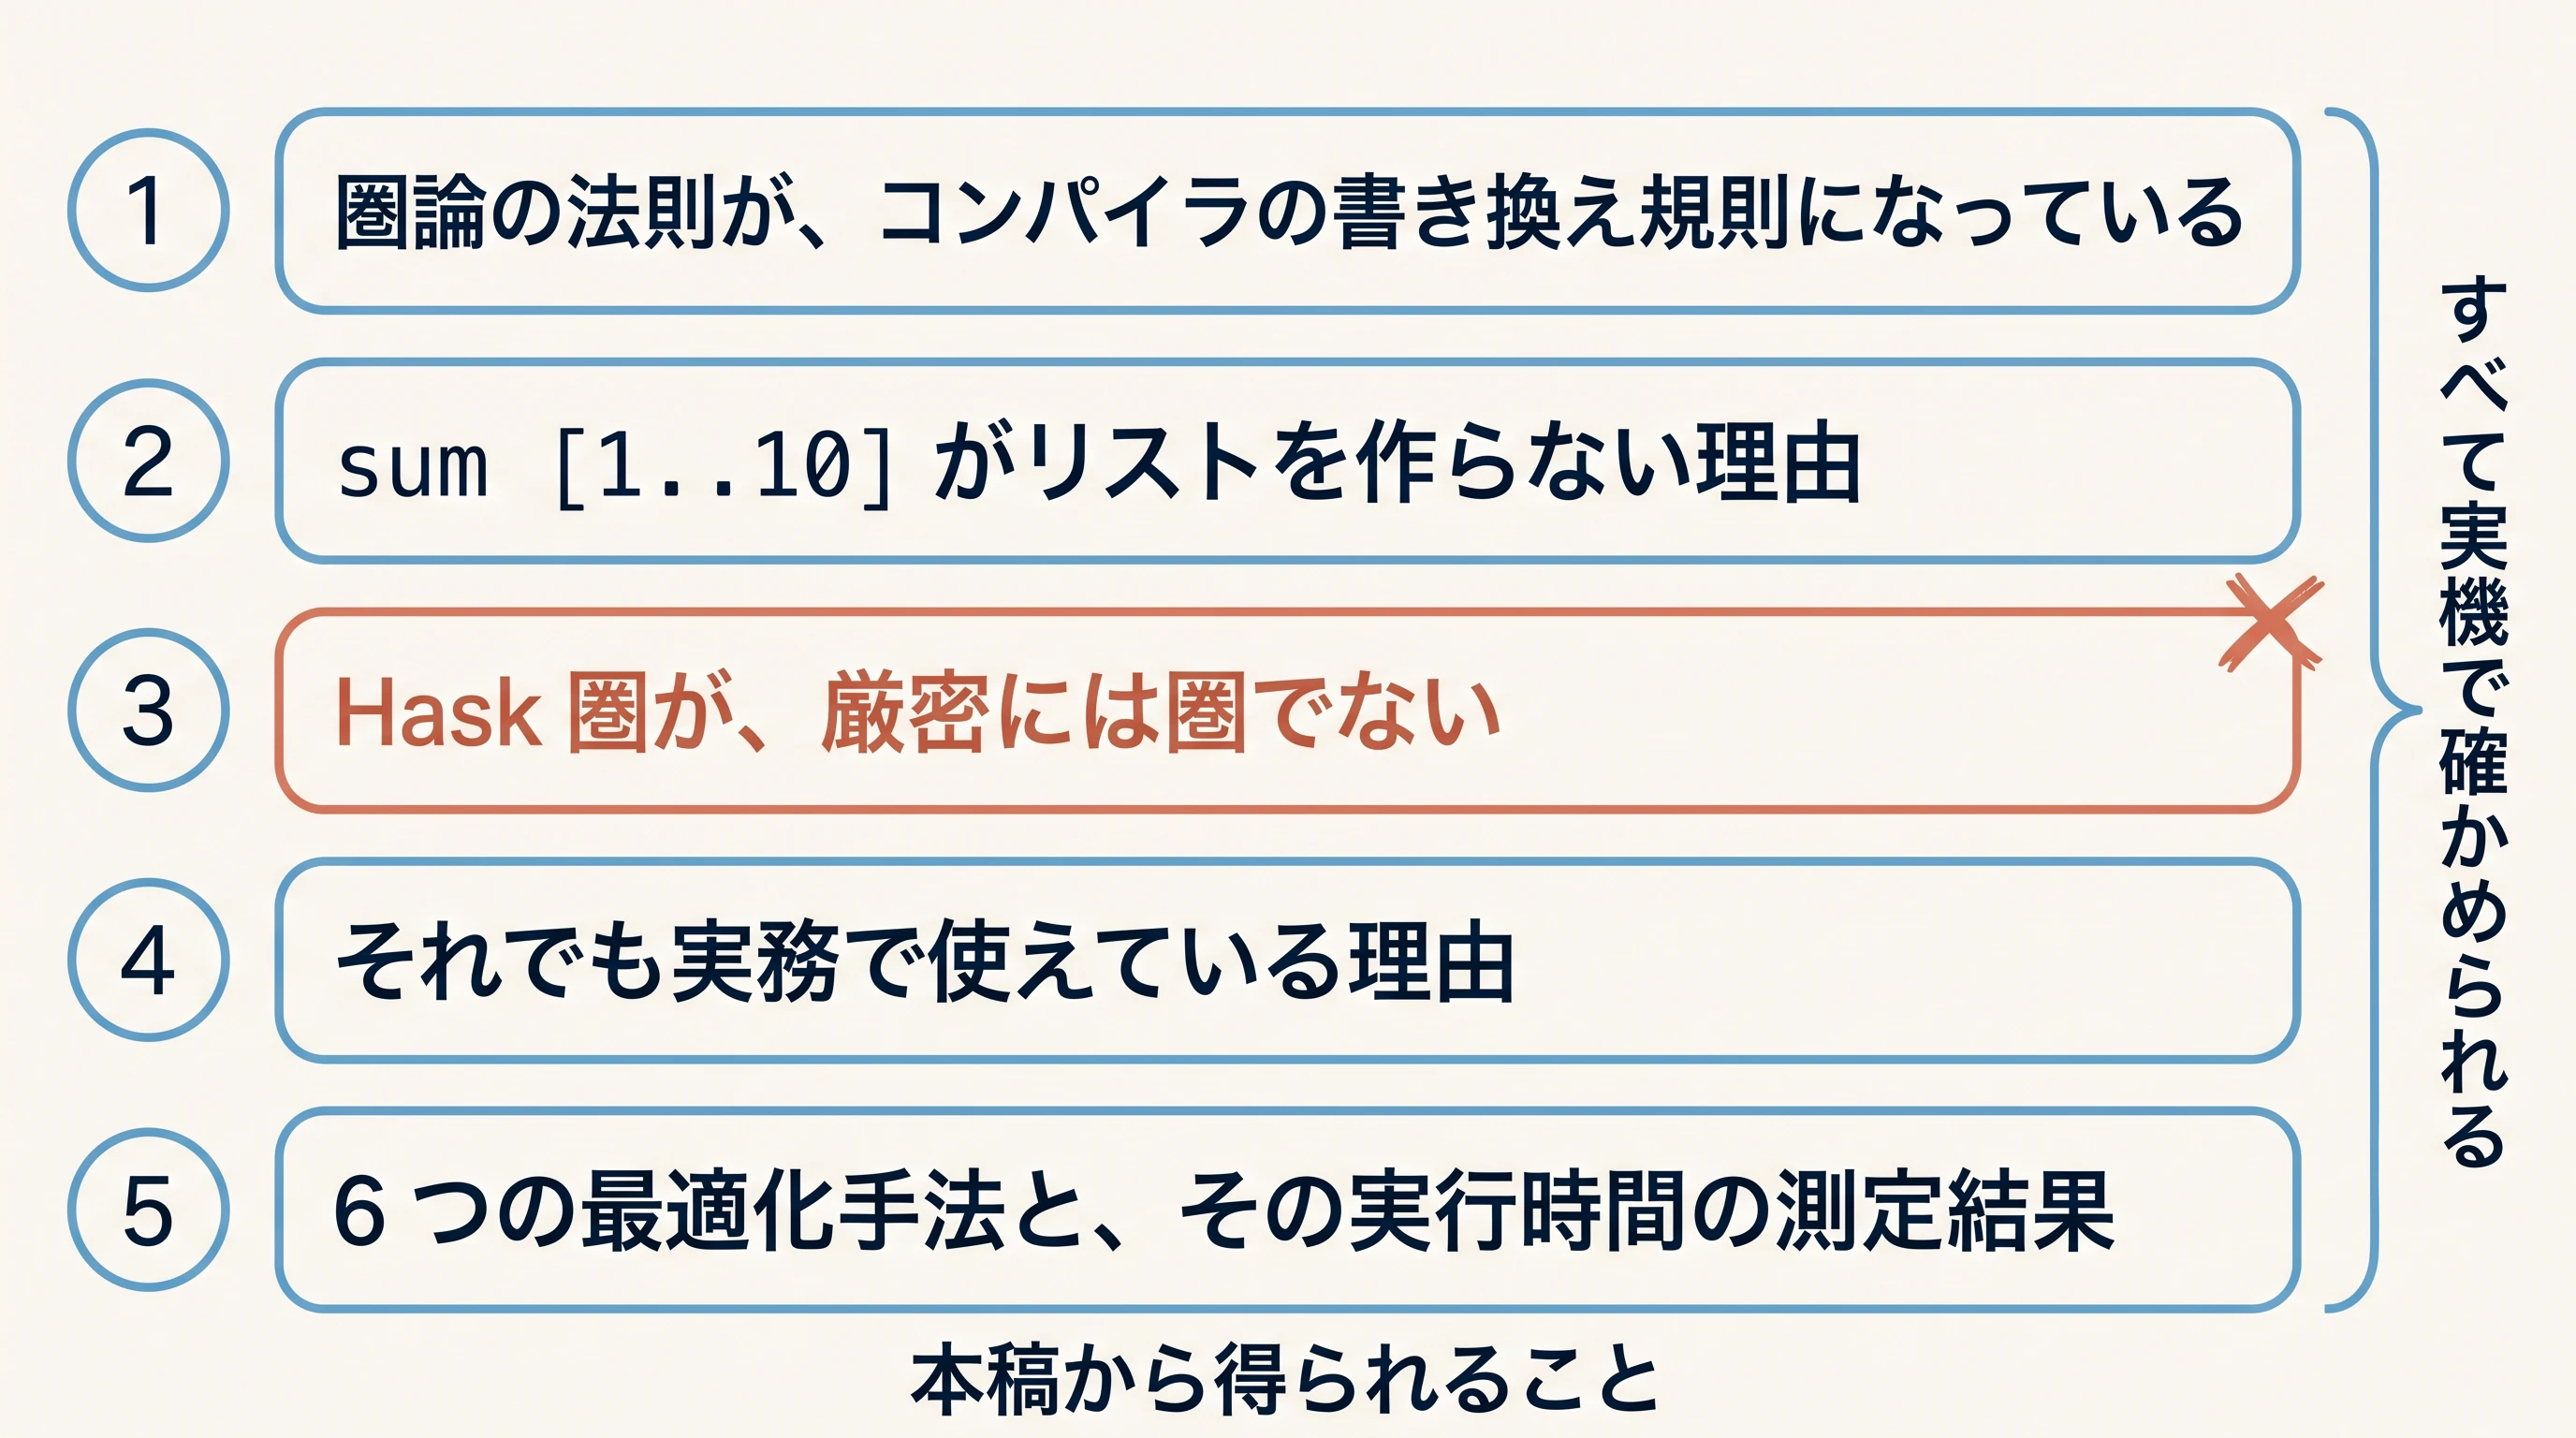
この記事を読んで得られること
-
圏論の法則が、コンパイラの書き換え規則になっているという事実を知ることができる
-
sum [1..10]がリストを作らない理由が分かる
-
Hask 圏が、厳密には圏でないことを、自分の手で確かめられる
-
それでも実務で使えている理由が分かる
- 6つの最適化手法を、最適化の結果、実行時間がどれだけ短縮されたかを実機検証した結果を含めて、知ることができる
Executive Summary
(お忙しくて本文をお読みいただけない方のために、本記事の要旨をまとめました)
圏論を学んでも、それを実際のコード設計にどう落とし込むのかが見えない。
オブジェクト指向のデザインパターンのような、具体的な手引きがほしい。
本連載シリーズは、関数型言語プログラマの方々が抱かれているかもしれない、こうしたお悩み事に向き合うことを試みる記事です。
( 本稿の論旨展開 )
【第1章】
- 圏論の法則とデザインパターンは、何が違うのか を、対話形式 でお伝えします。
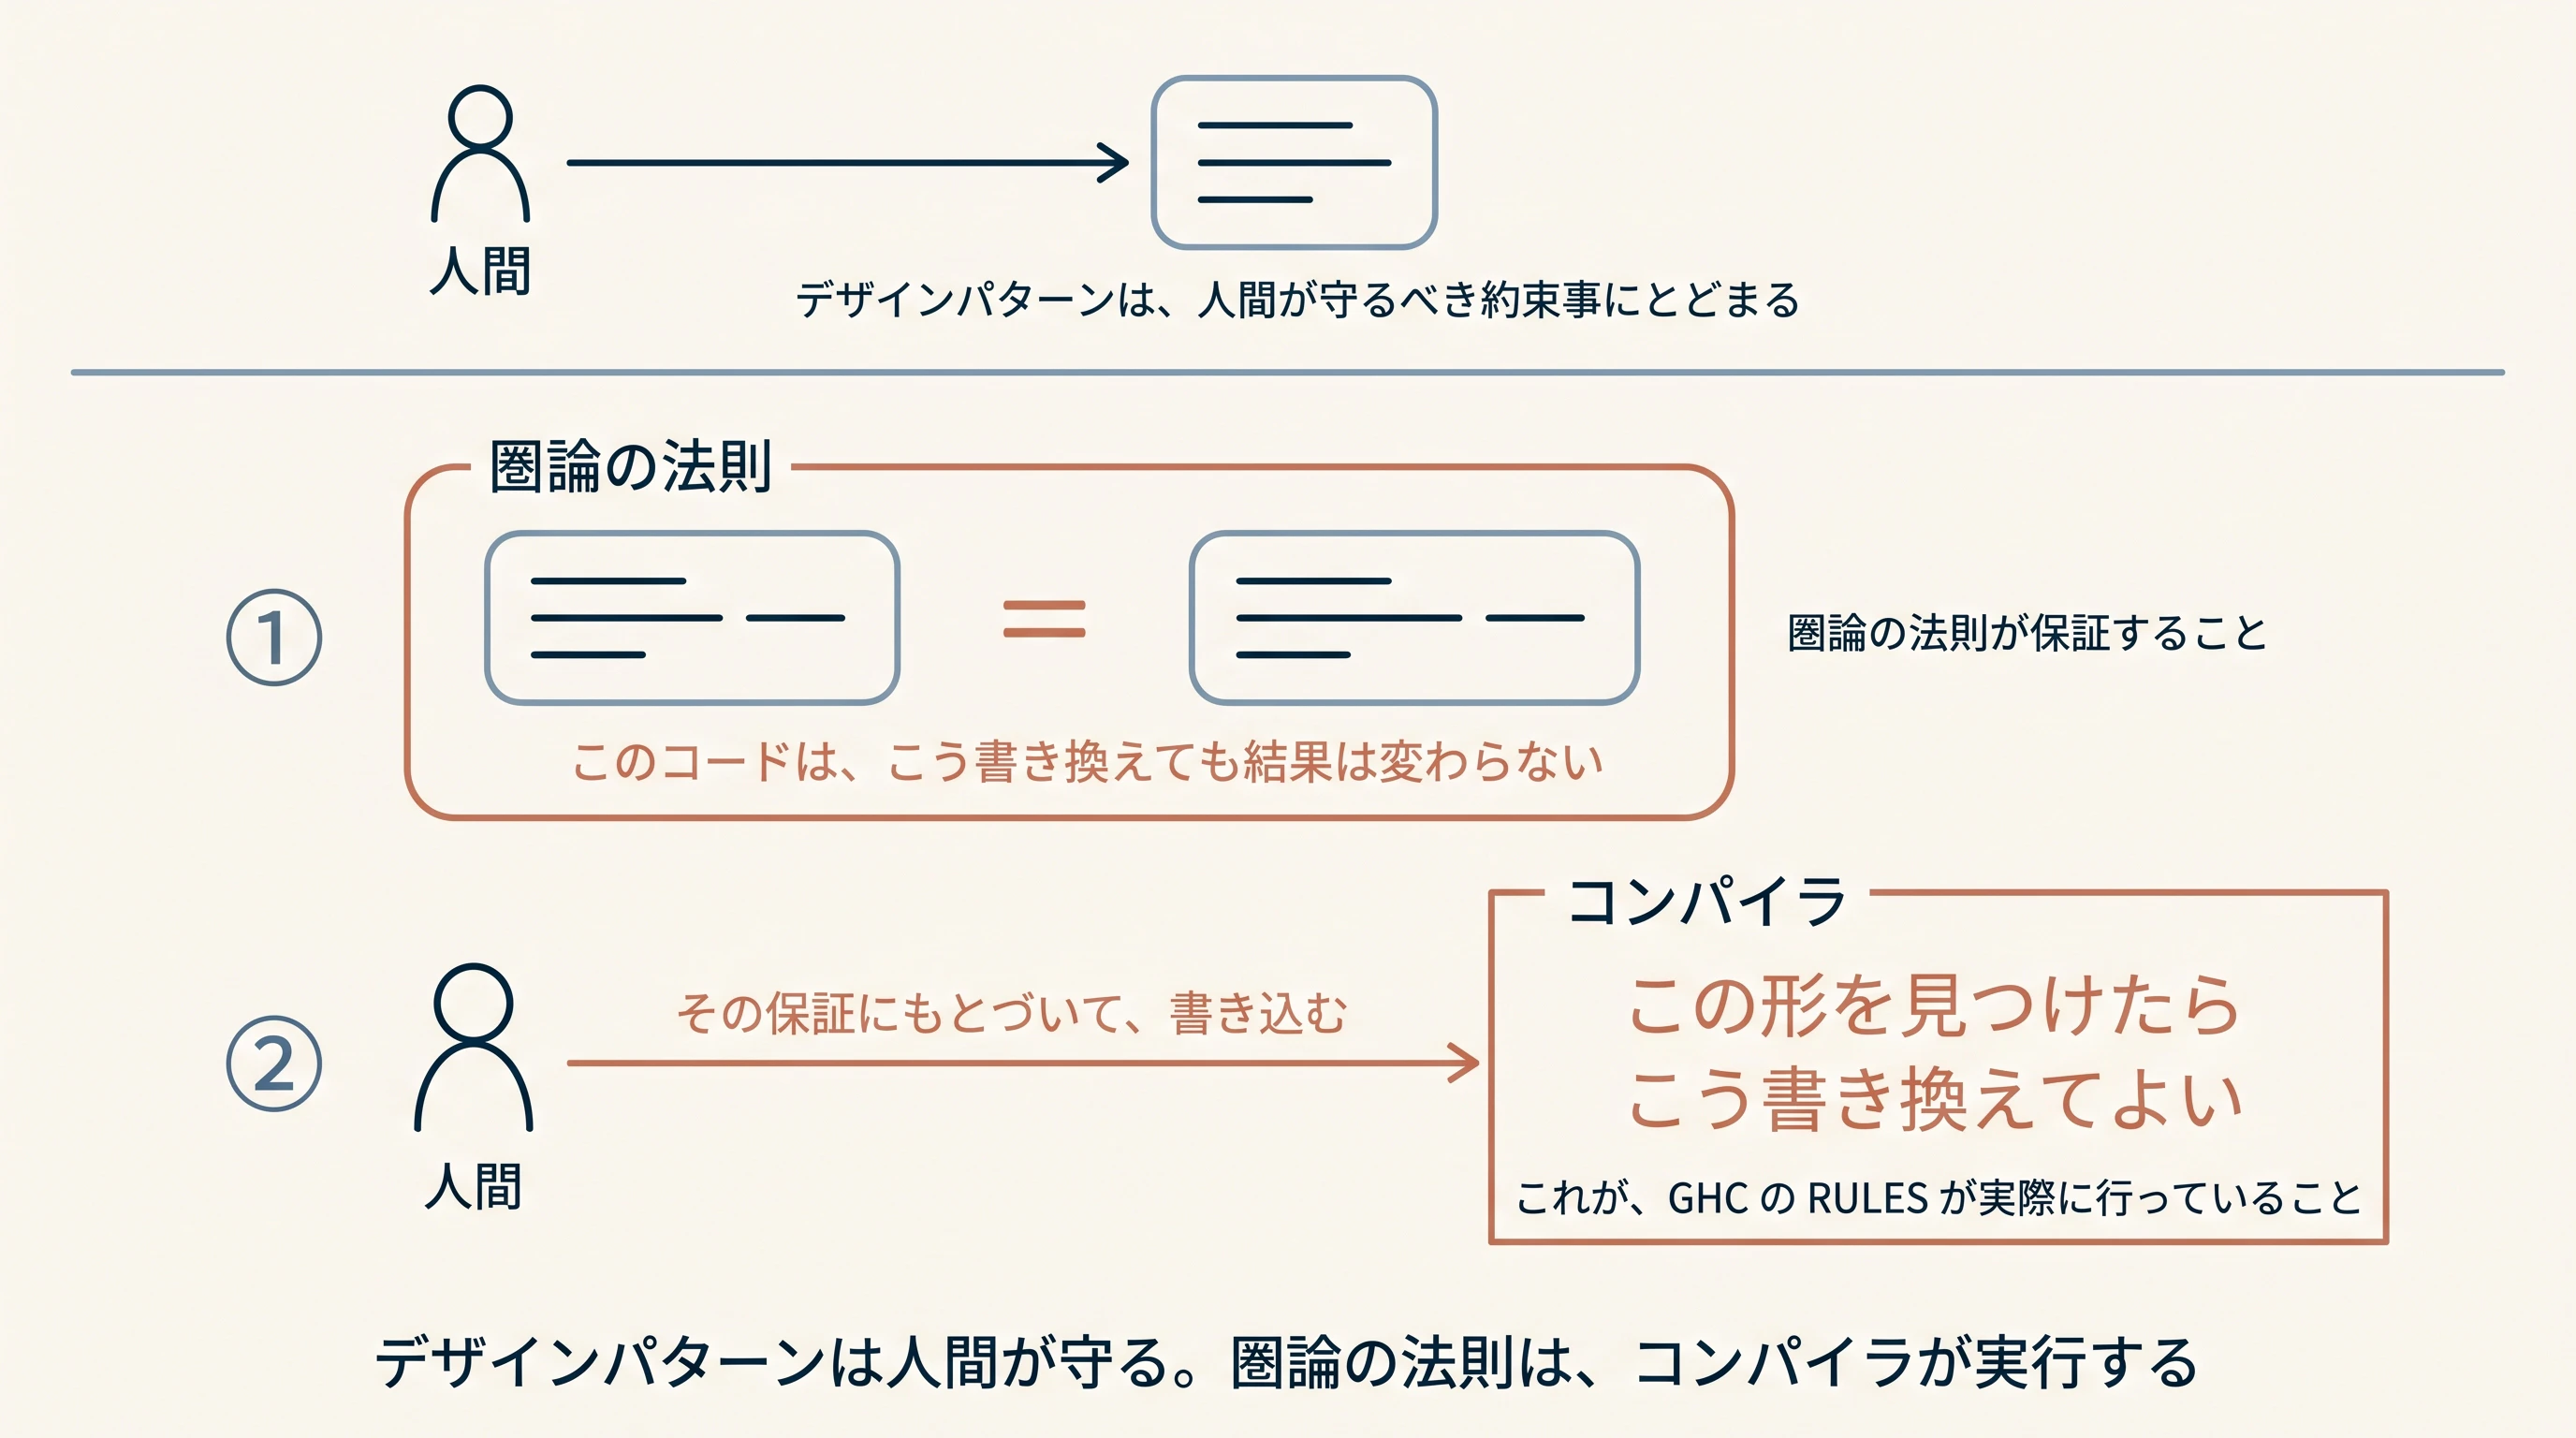
- デザインパターン は、「人間が守るべき約束事」 にとどまるものです。
- それに対して、圏論の法則 は、「このコードは、こう書き換えても結果は変わらない」ことを保証します。
- 人間は、その保証にもとづいて、「この形を見つけたら、こう書き換えてよい」という書き換え指示をコンパイラに書き込みます 。
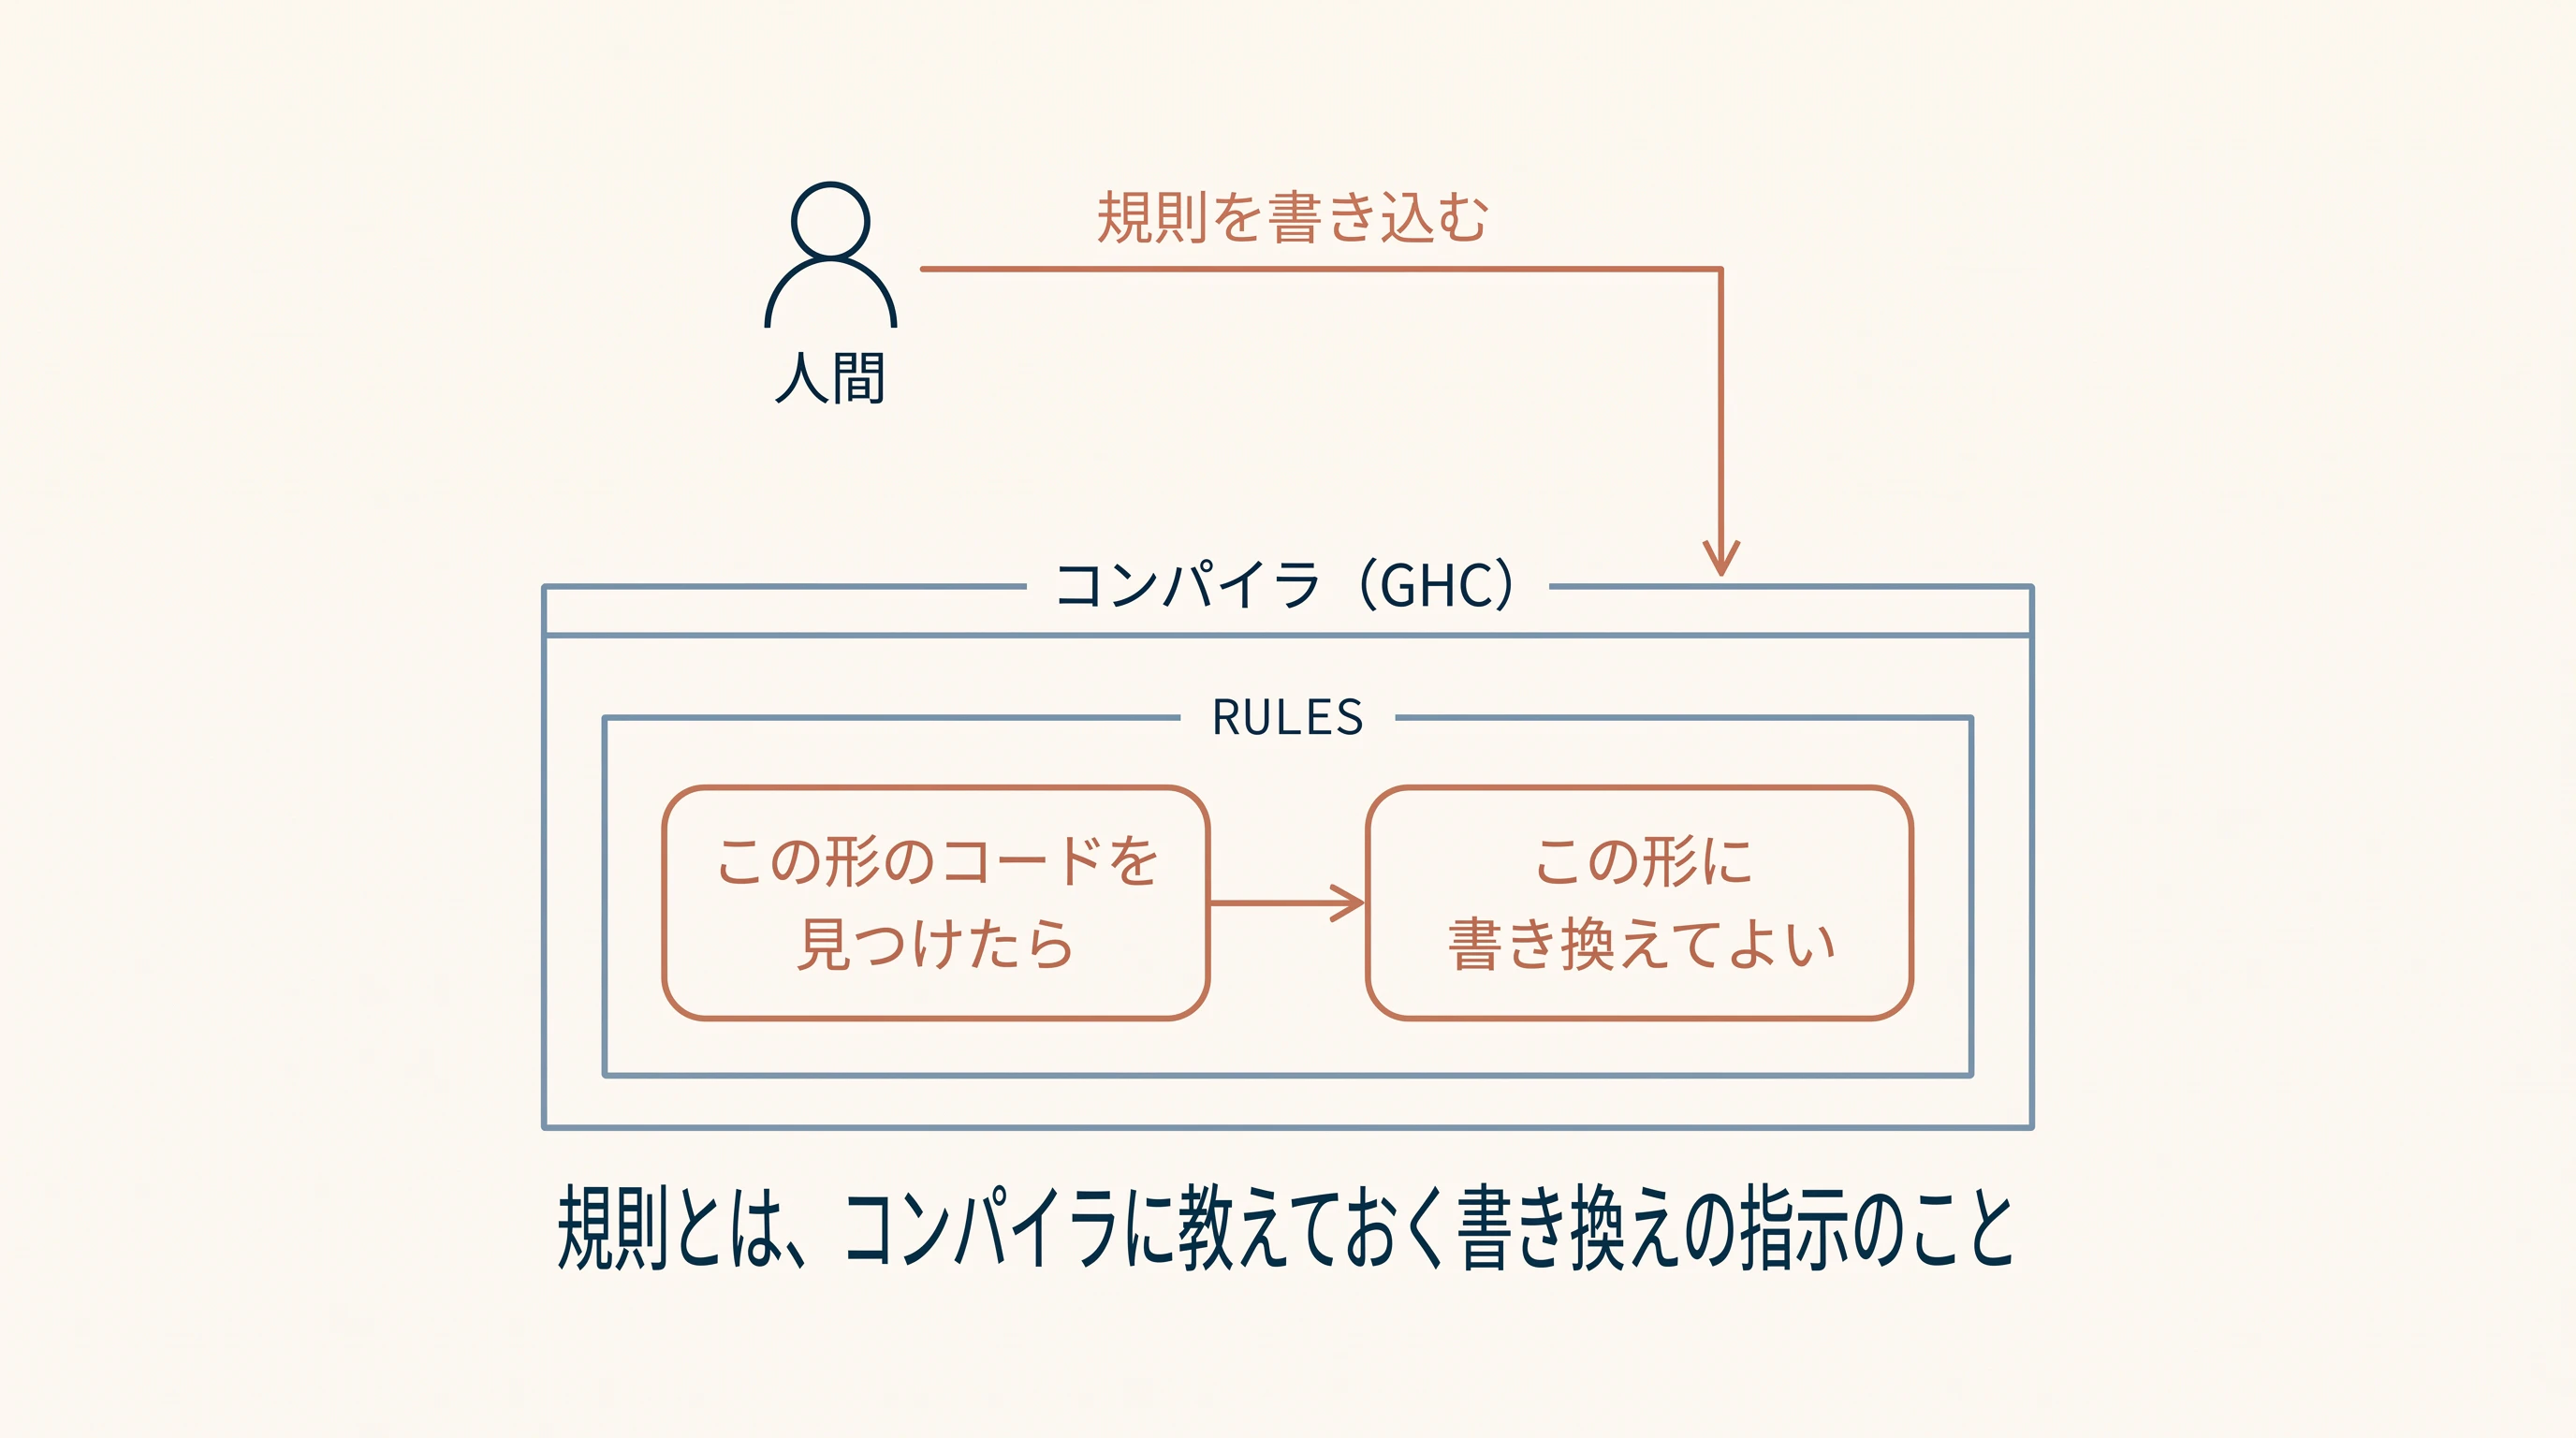
- 以上は、GHCのRULES が実際に行っていることです。なお、RULES とは、GHCに「この形のコードを見つけたら、この形に書き換えてよい」と教えておく仕組みのこと です。
【第2章】
-
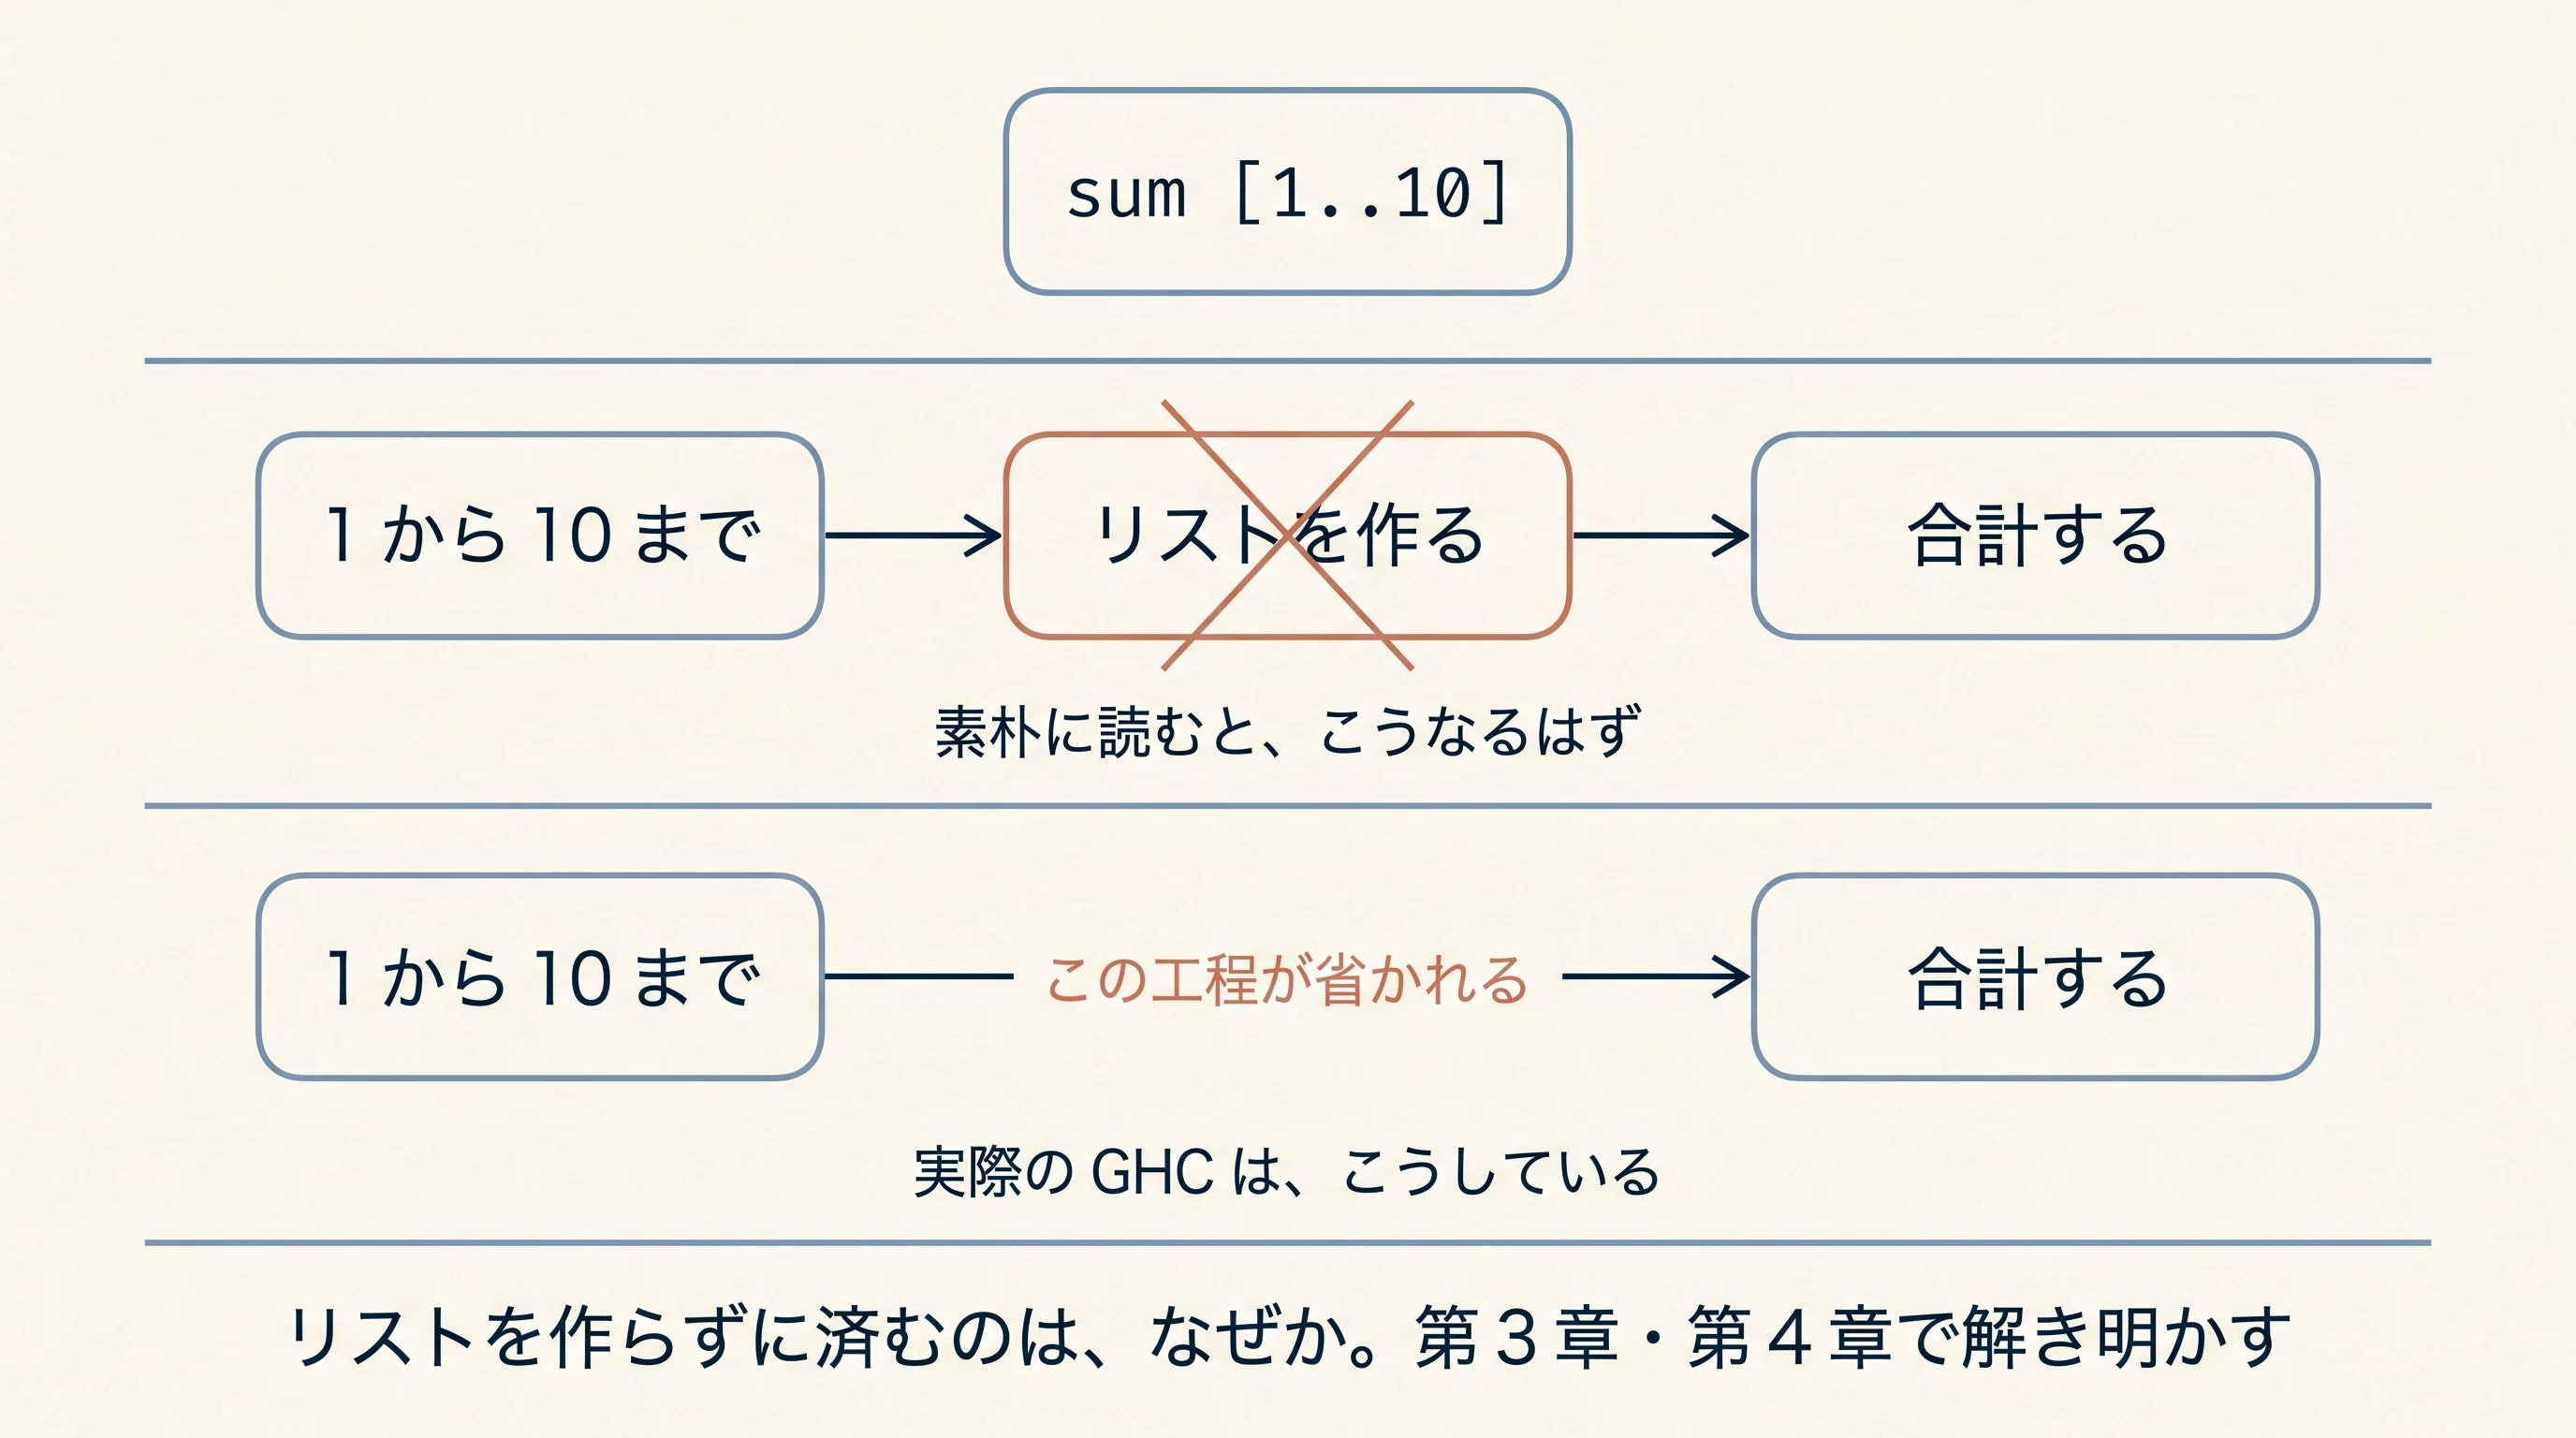
sum [1..10]をHaskellで実行するとき、GHCは内部処理として、リストを作るプロセスを省略し、処理を高速化しているという事実を、実機で確認します。
なお、なぜ、リストを作らずに済むのか という理由は、続く 第3・4章で解説 します。
【第3・4章】
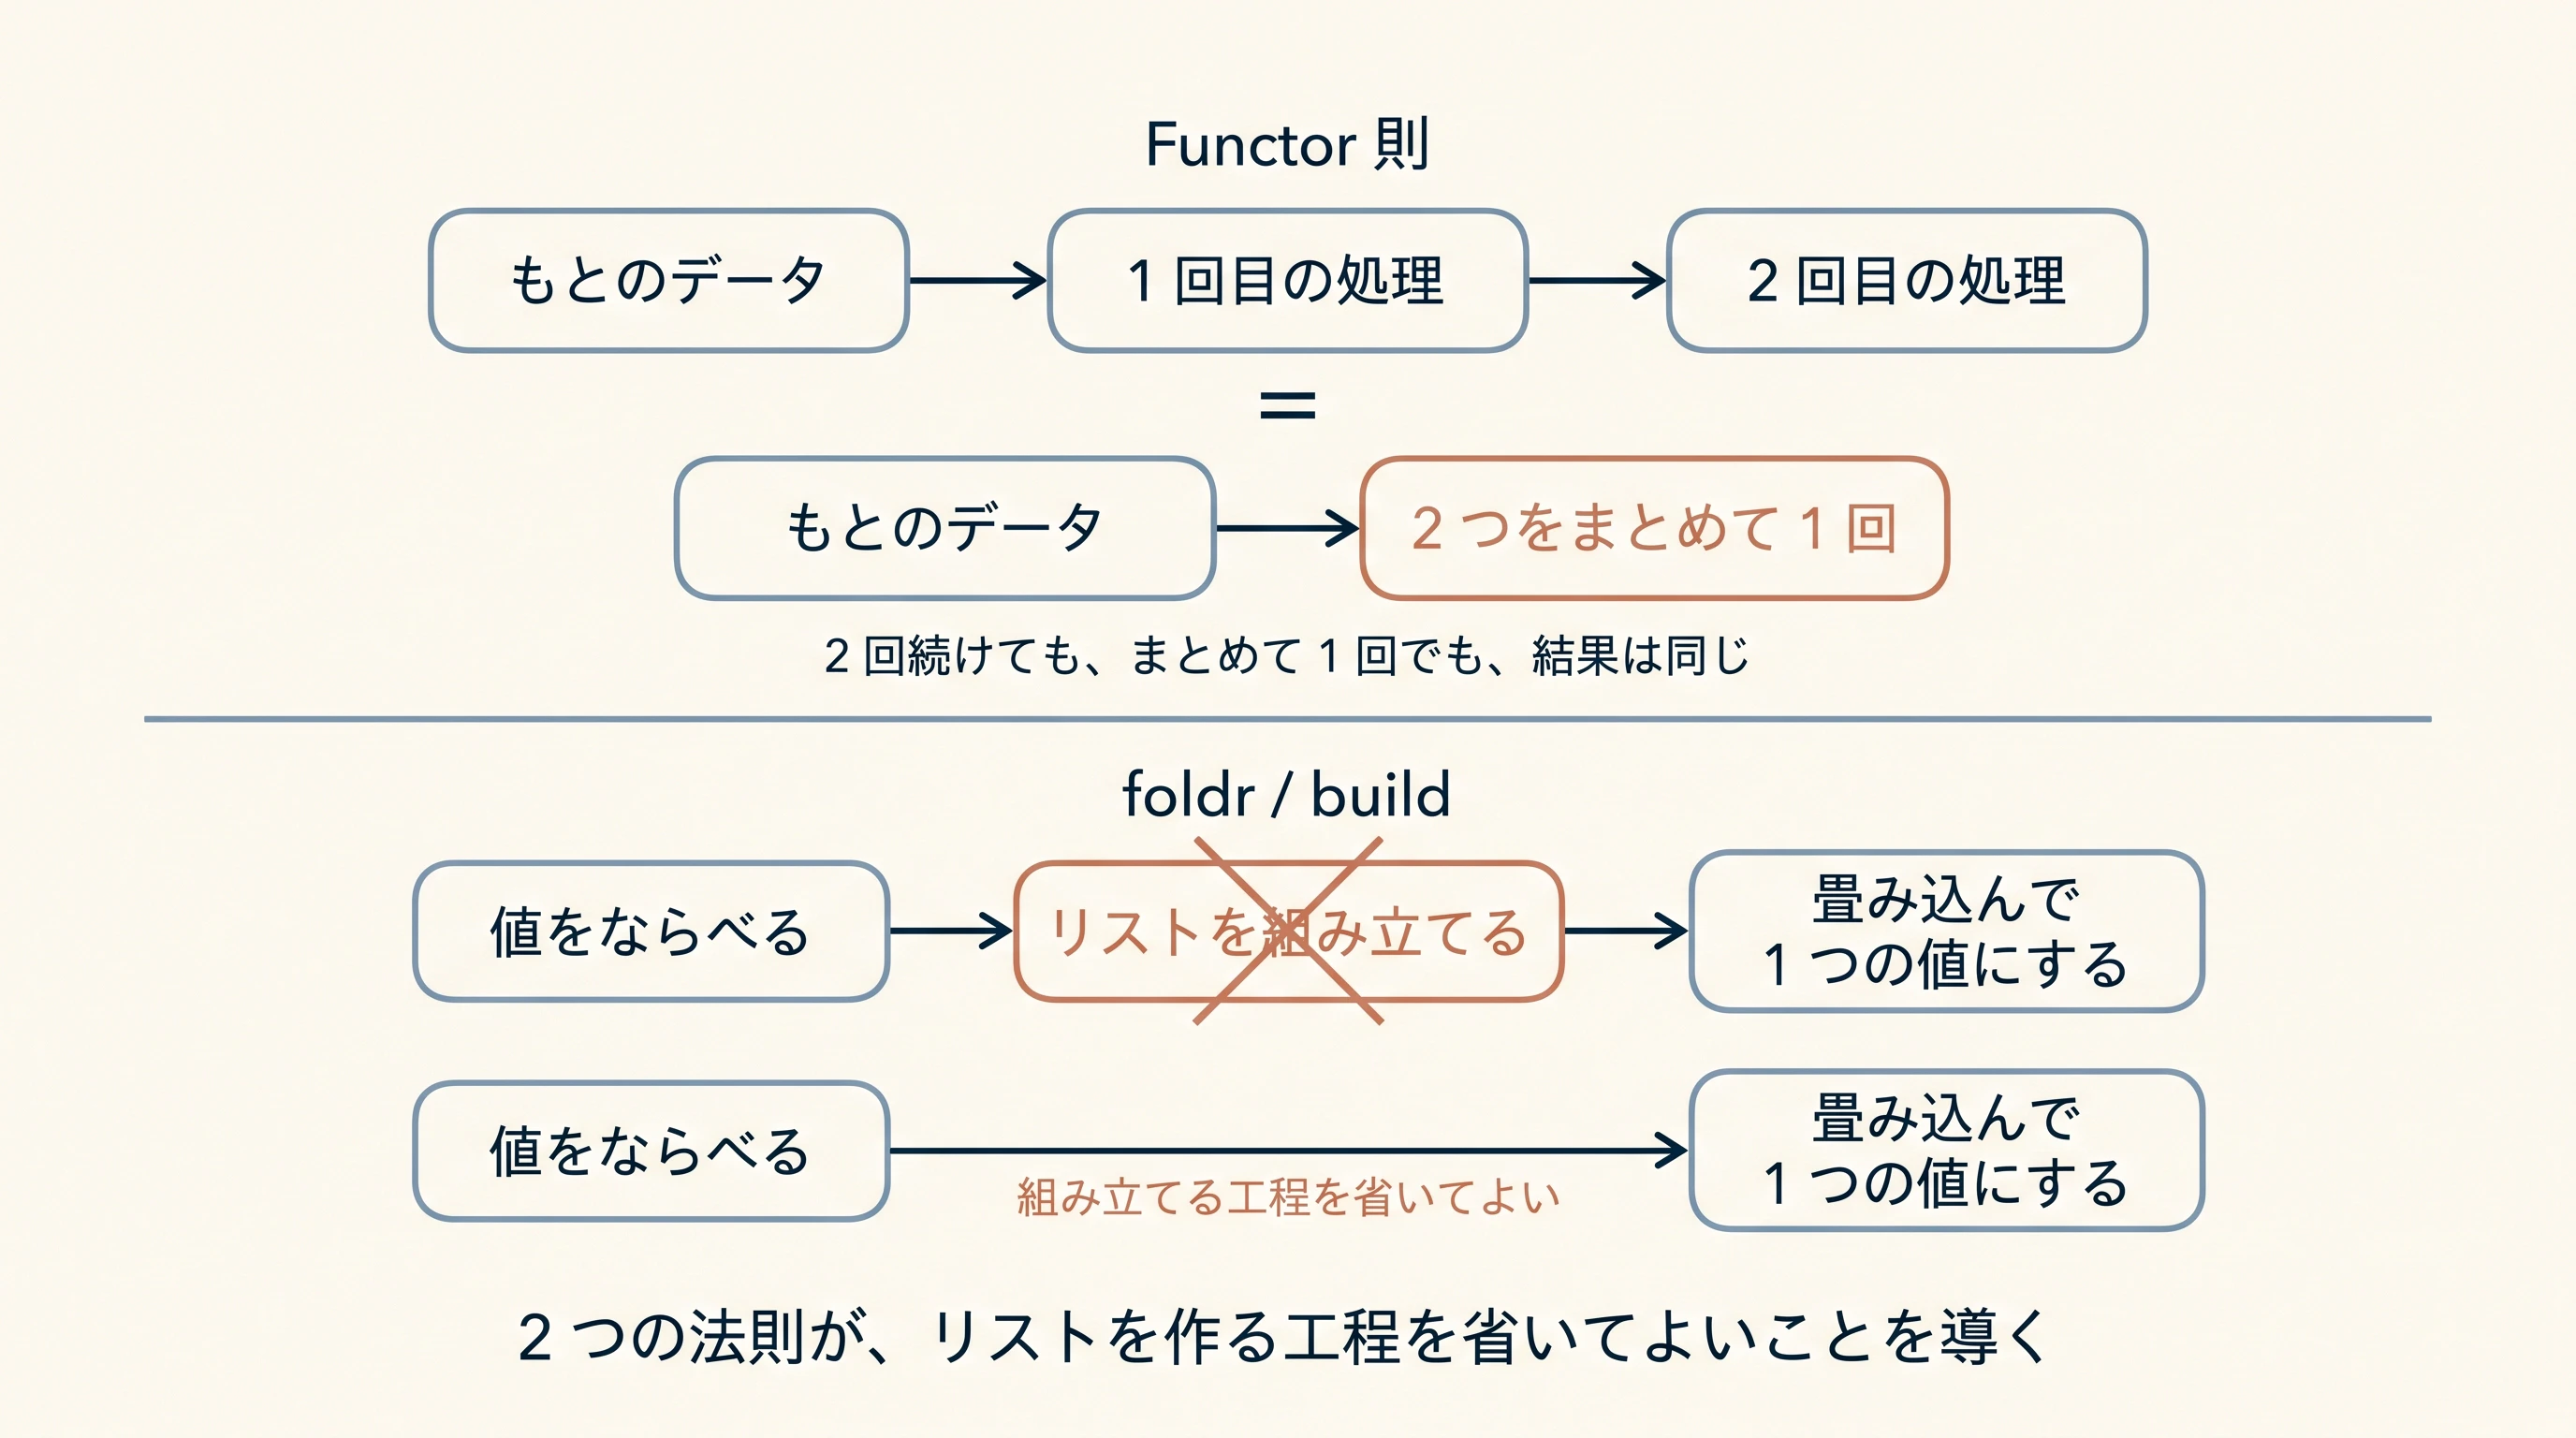
- 圏論の知見である「Functor則」と「foldr/build」という2つの書き換え規則を使うことで、リストを作成する工程を省略しても問題ないことが導き出せます。
この数学知見(圏論知見)を活用することで、リストを作成する工程を省いて、コード実行時間を短縮化します。 - Functor則 とは、「1つずつ処理する操作を2回続けても、2つの処理をまとめて1回で行っても、結果は同じになる」 という法則です。
- foldr/build とは、「リストを組み立てる処理」と「リストを畳み込んで1つの値にする処理」が隣り合ったとき、組み立てる工程を省略してよい という仕組みです。
【第5章】
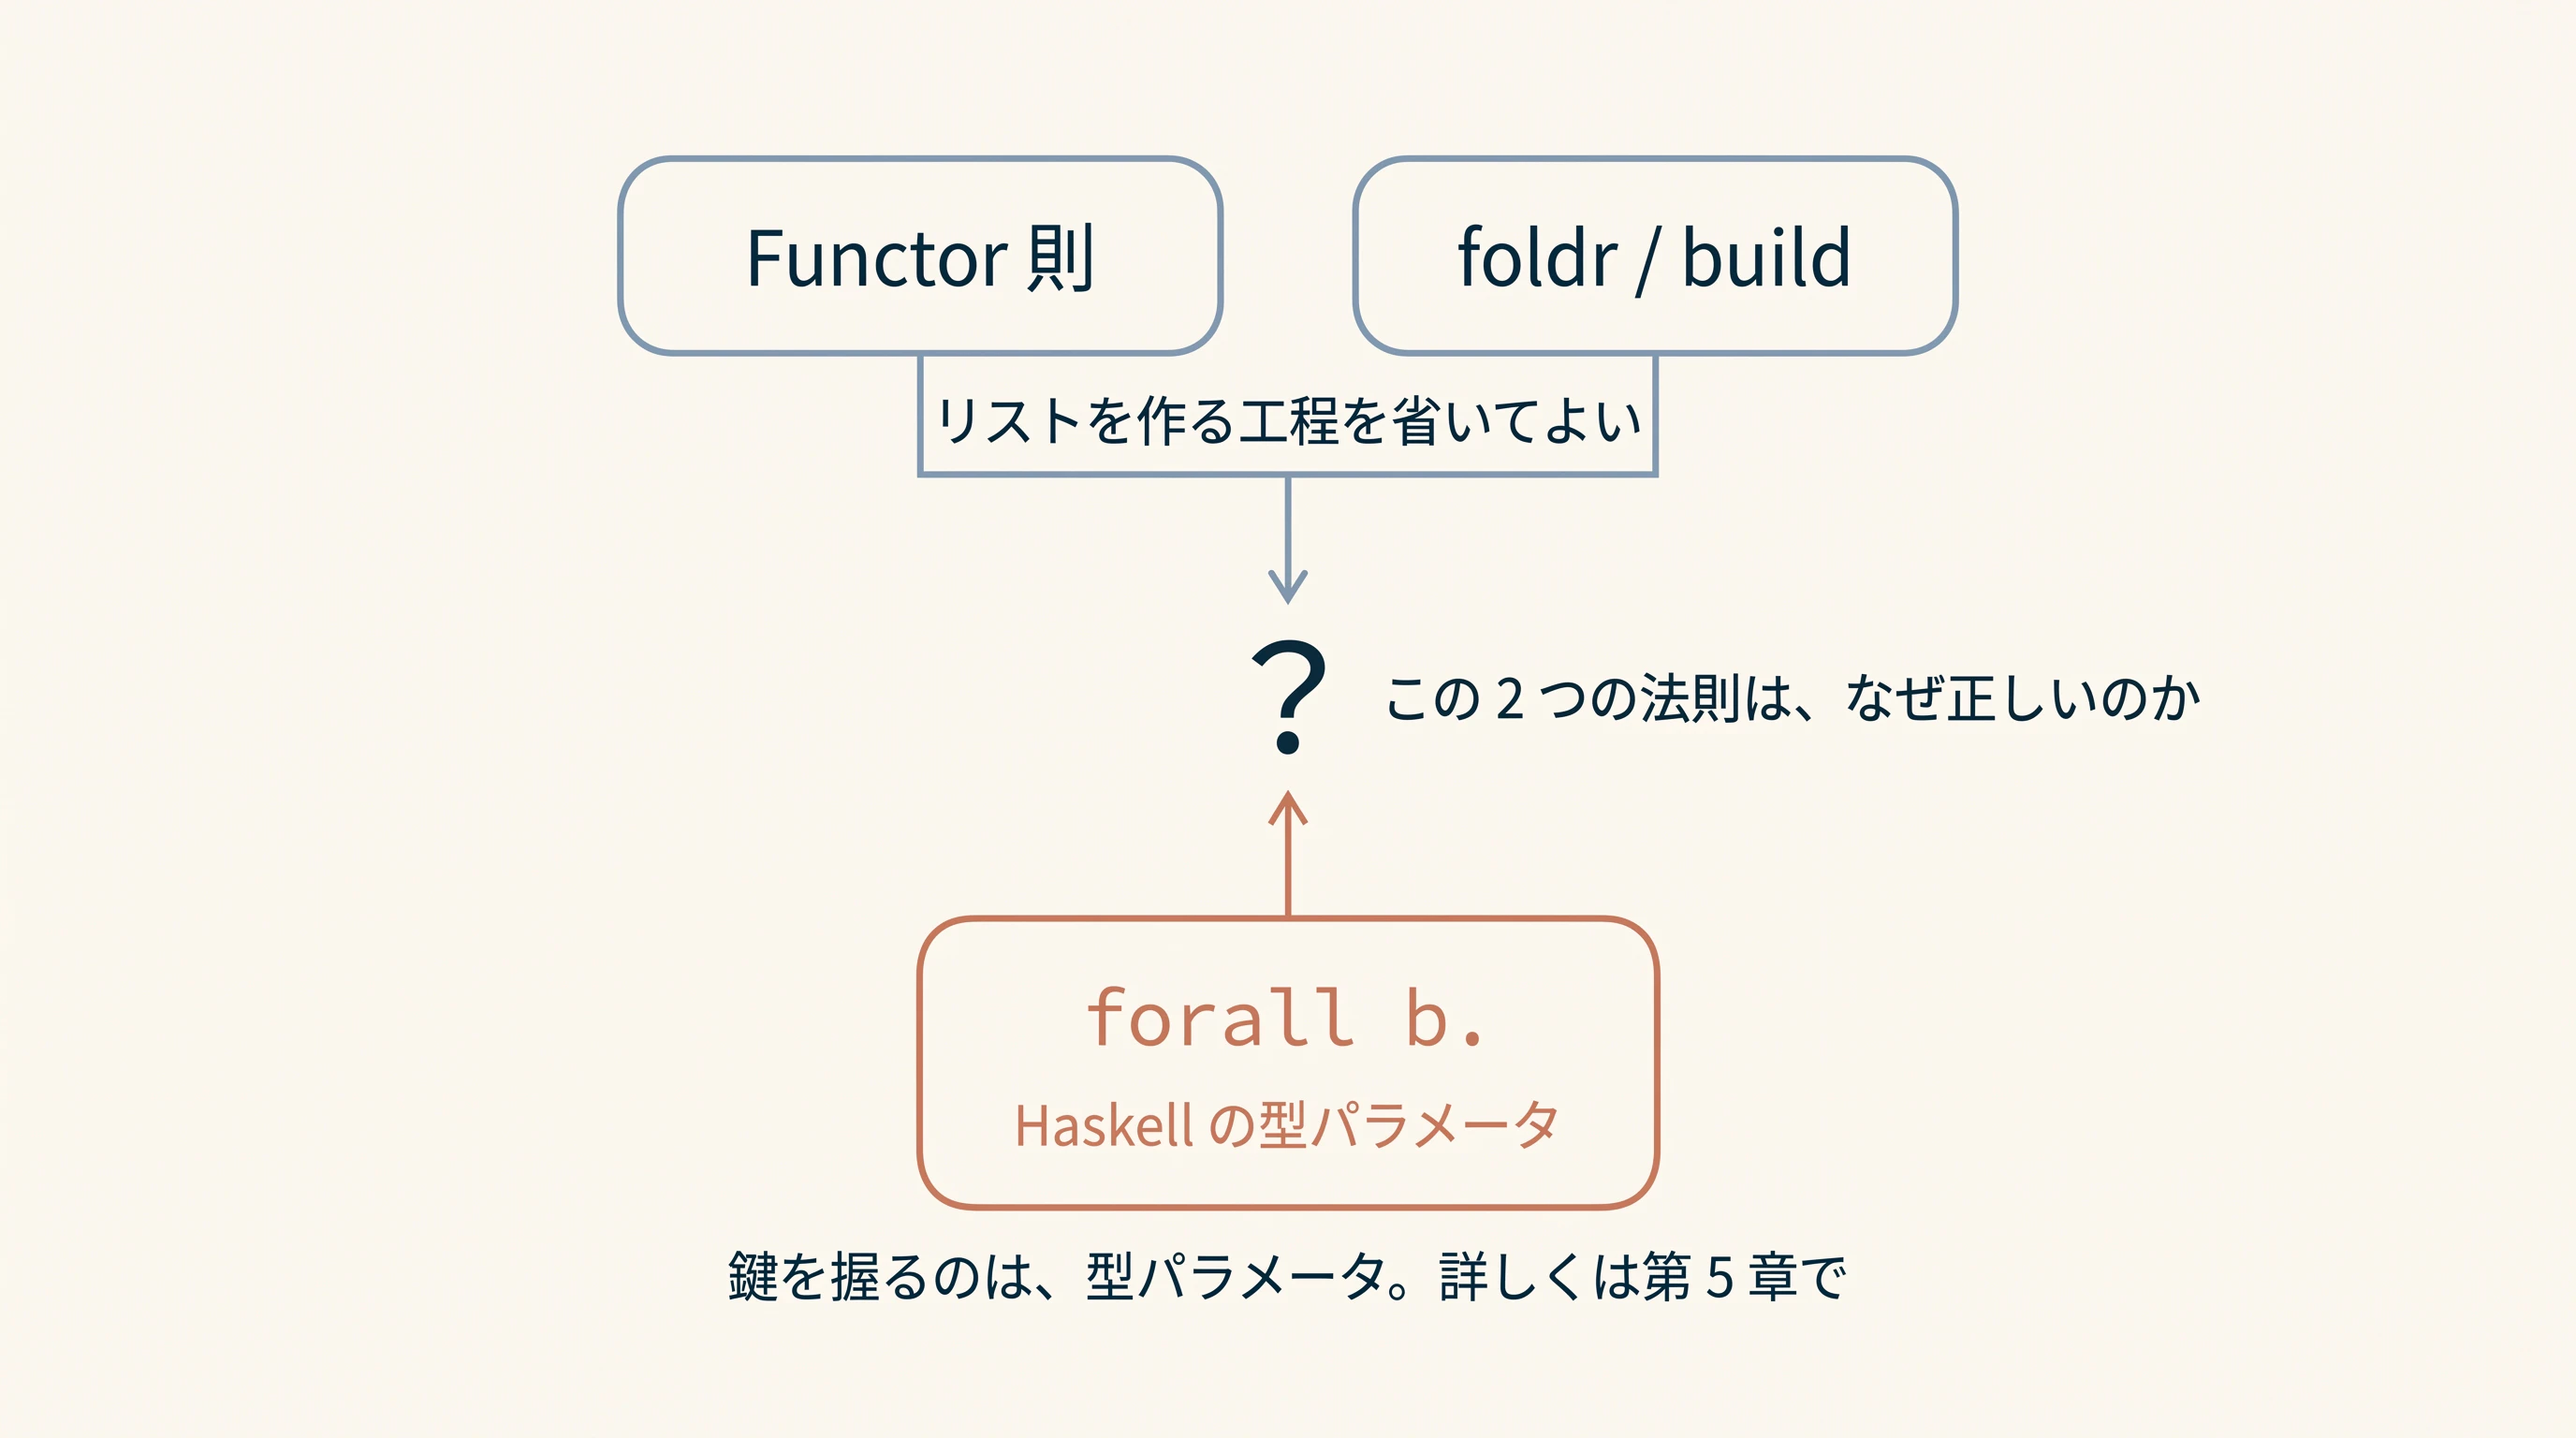
- 第3・4章では、Functor則 と foldr/build によって「リストを作る工程を省いてよい」ことが導かれると述べました。
- では、その2つの法則そのものは、なぜ正しいと言えるのでしょうか。
- 鍵を握るのは、Haskellの型パラメータです。
- この点は、無理に要約すると、かえって分かりづらい文章になります。第5章の対話篇をご一読いただけますと幸いです。
- 本セクションでお伝えすべきことは、型パラメータが関わっているという1点に尽きます。
【第6章】
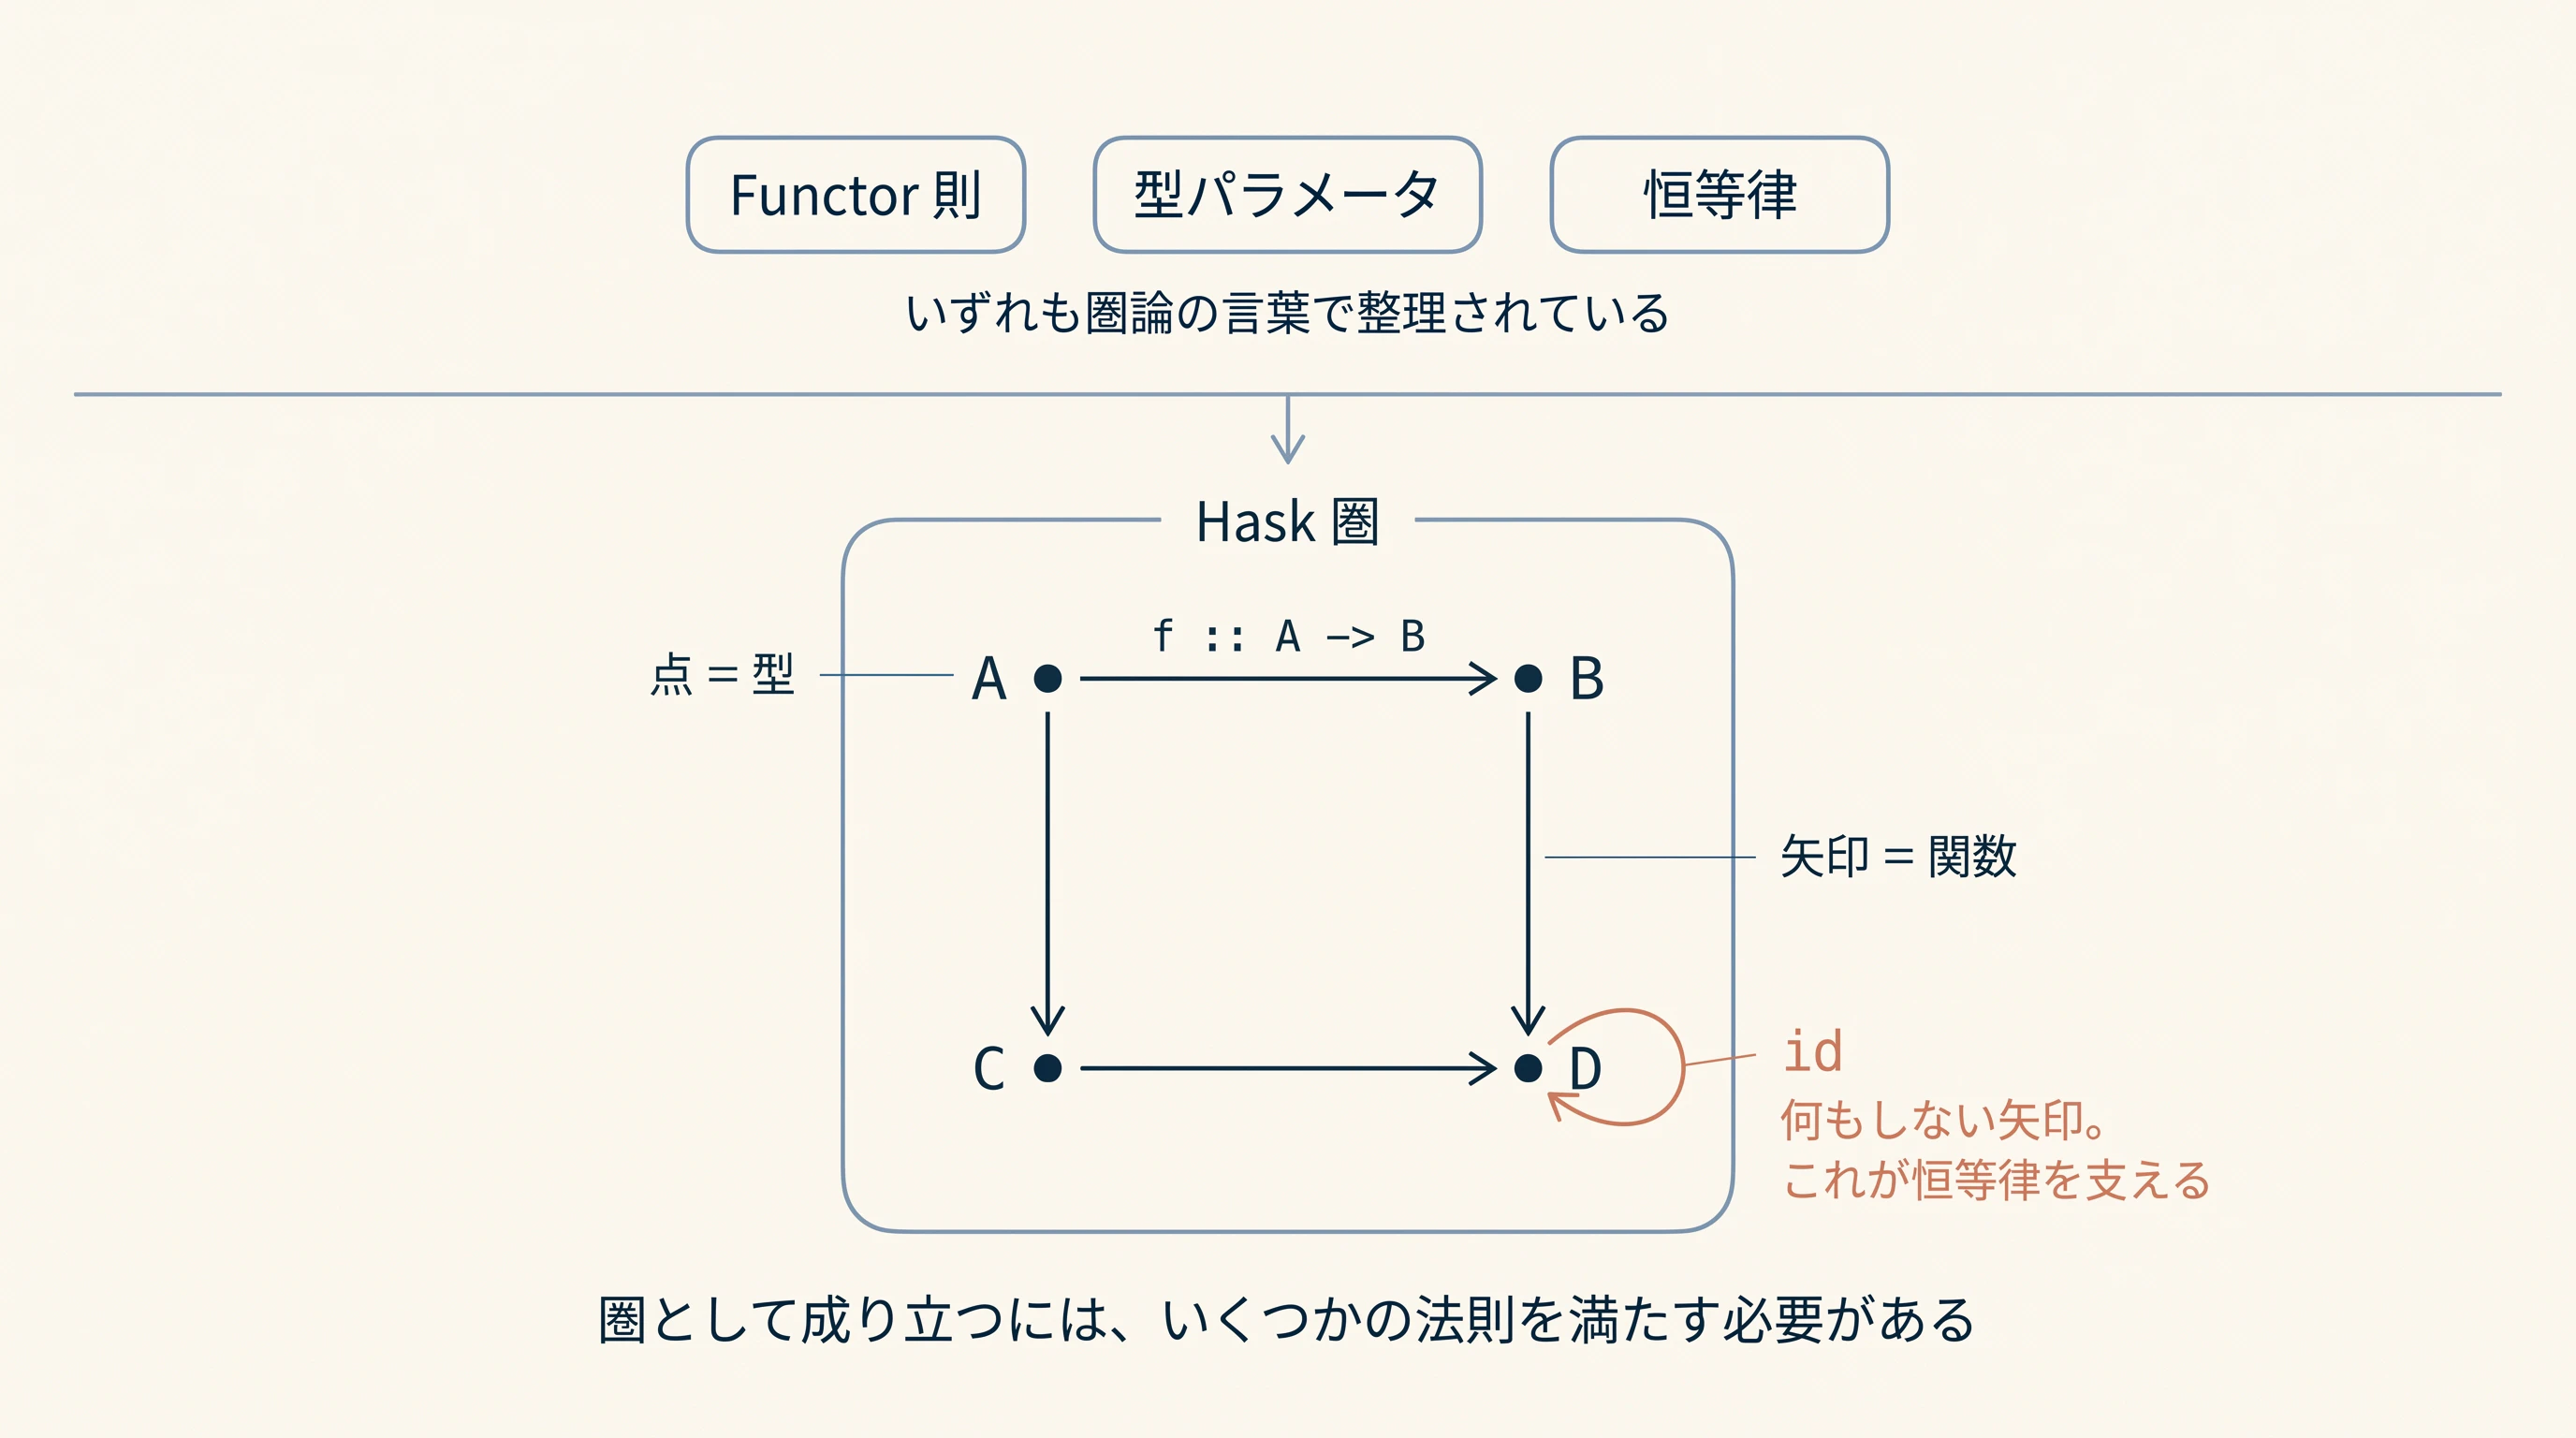
- 第3章から第5章までで使ってきた Functor則 や 型パラメータにもとづく議論 は、いずれも 圏論 の言葉で整理されています。
- そこで、Haskellという言語の構造を圏論の言葉で捉えた Hask圏 を見ていきます。
- Hask圏 とは、Haskellの「型」を点、「関数」を矢印と見なして、Haskell全体を圏論の対象として捉えたもの です。
- 圏 として成り立つには、いくつかの法則を満たす必要 があります。その1つが 恒等律 です。
【第7章】
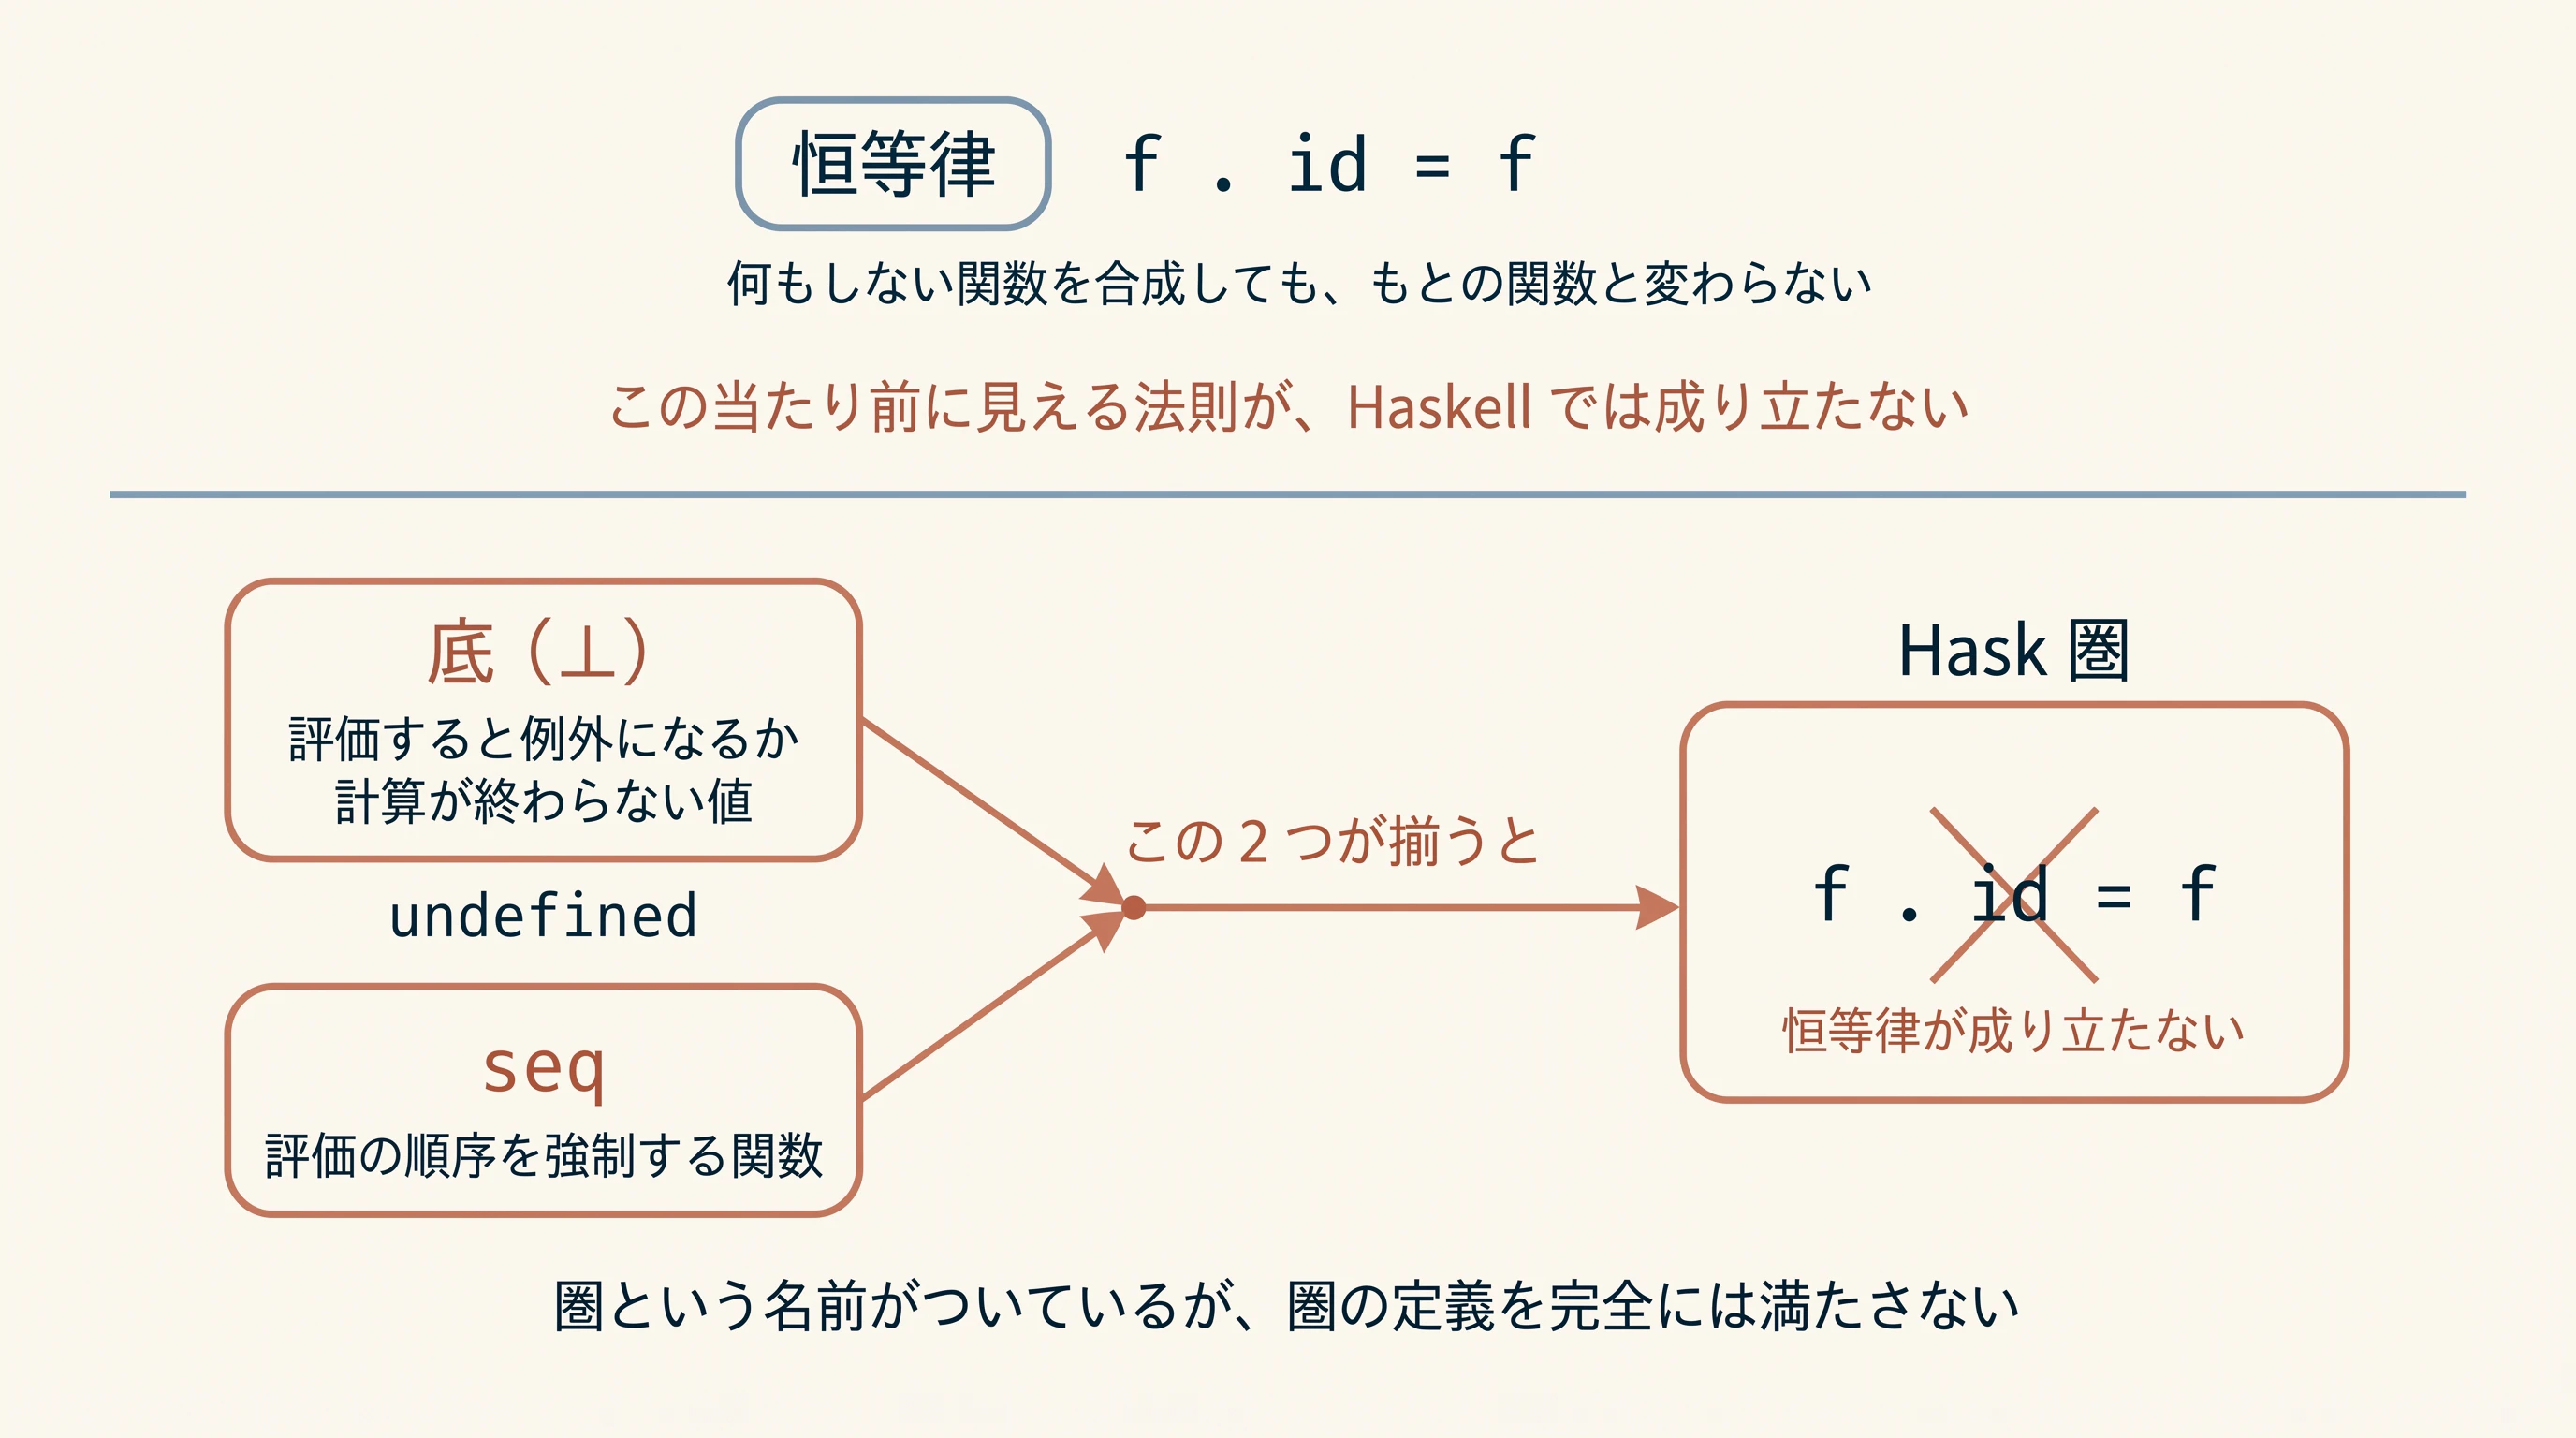
- ところが、その土台は崩れています。
Hask圏は、圏という名前がついていますが、圏の定義を満たしきれていないからです。 - 恒等律 とは、「何もしない関数を合成しても、もとの関数と変わらない」 という当たり前に見える法則です。
-
この法則が、Haskellでは成り立ちません。
本稿では、そのことを実機で再現してご覧いただきます。 - 原因は、
seqという関数と、「底」(⊥) と呼ばれる特殊な値の組み合わせにあります。 -
「底」 とは、評価すると例外になるか、計算が終わらない値 のことです。
undefinedや無限ループがこれにあたります。 -
seqとは、評価の順序を強制する関数 です。
この2つが揃うと、恒等律が成り立たなくなります。 - Hask圏が、上記の理由によって、数学者が定める「圏」(Category)の定義を完全には満たさないこと は、ウェブサイトで検索すると、Haskellを圏論の観点から論じた複数の記事で解説されているのを見つけることができます。
【第8章】
- 恒等律が成り立たないことは、理屈の上だけの問題ではありません。
- GHCが最適化を行った結果、正しく動いていたプログラムが動かなくなった事例が、実際に報告されています。
- 第3・4章で見た「リストを作る工程を省く」という最適化が、誤った書き換えを行ってしまったのです。
【第9章】
- 恒等律が成り立たないにもかかわらず、圏論にもとづく最適化はなぜ安全に働くのでしょうか?
- その答えは、「底を含まない範囲で考えるかぎり、圏論の法則は安全に使える」 ことが、数学的に証明されているからです。
- 2006年の論文が、この点を扱っています。「停止するプログラムが、止まらないプログラムに変わることはない」 ことが示されました。
- ただし、
seqを使うと、この保証の外に出ます。第8章の事例は、まさにその場合でした。
【第10章】
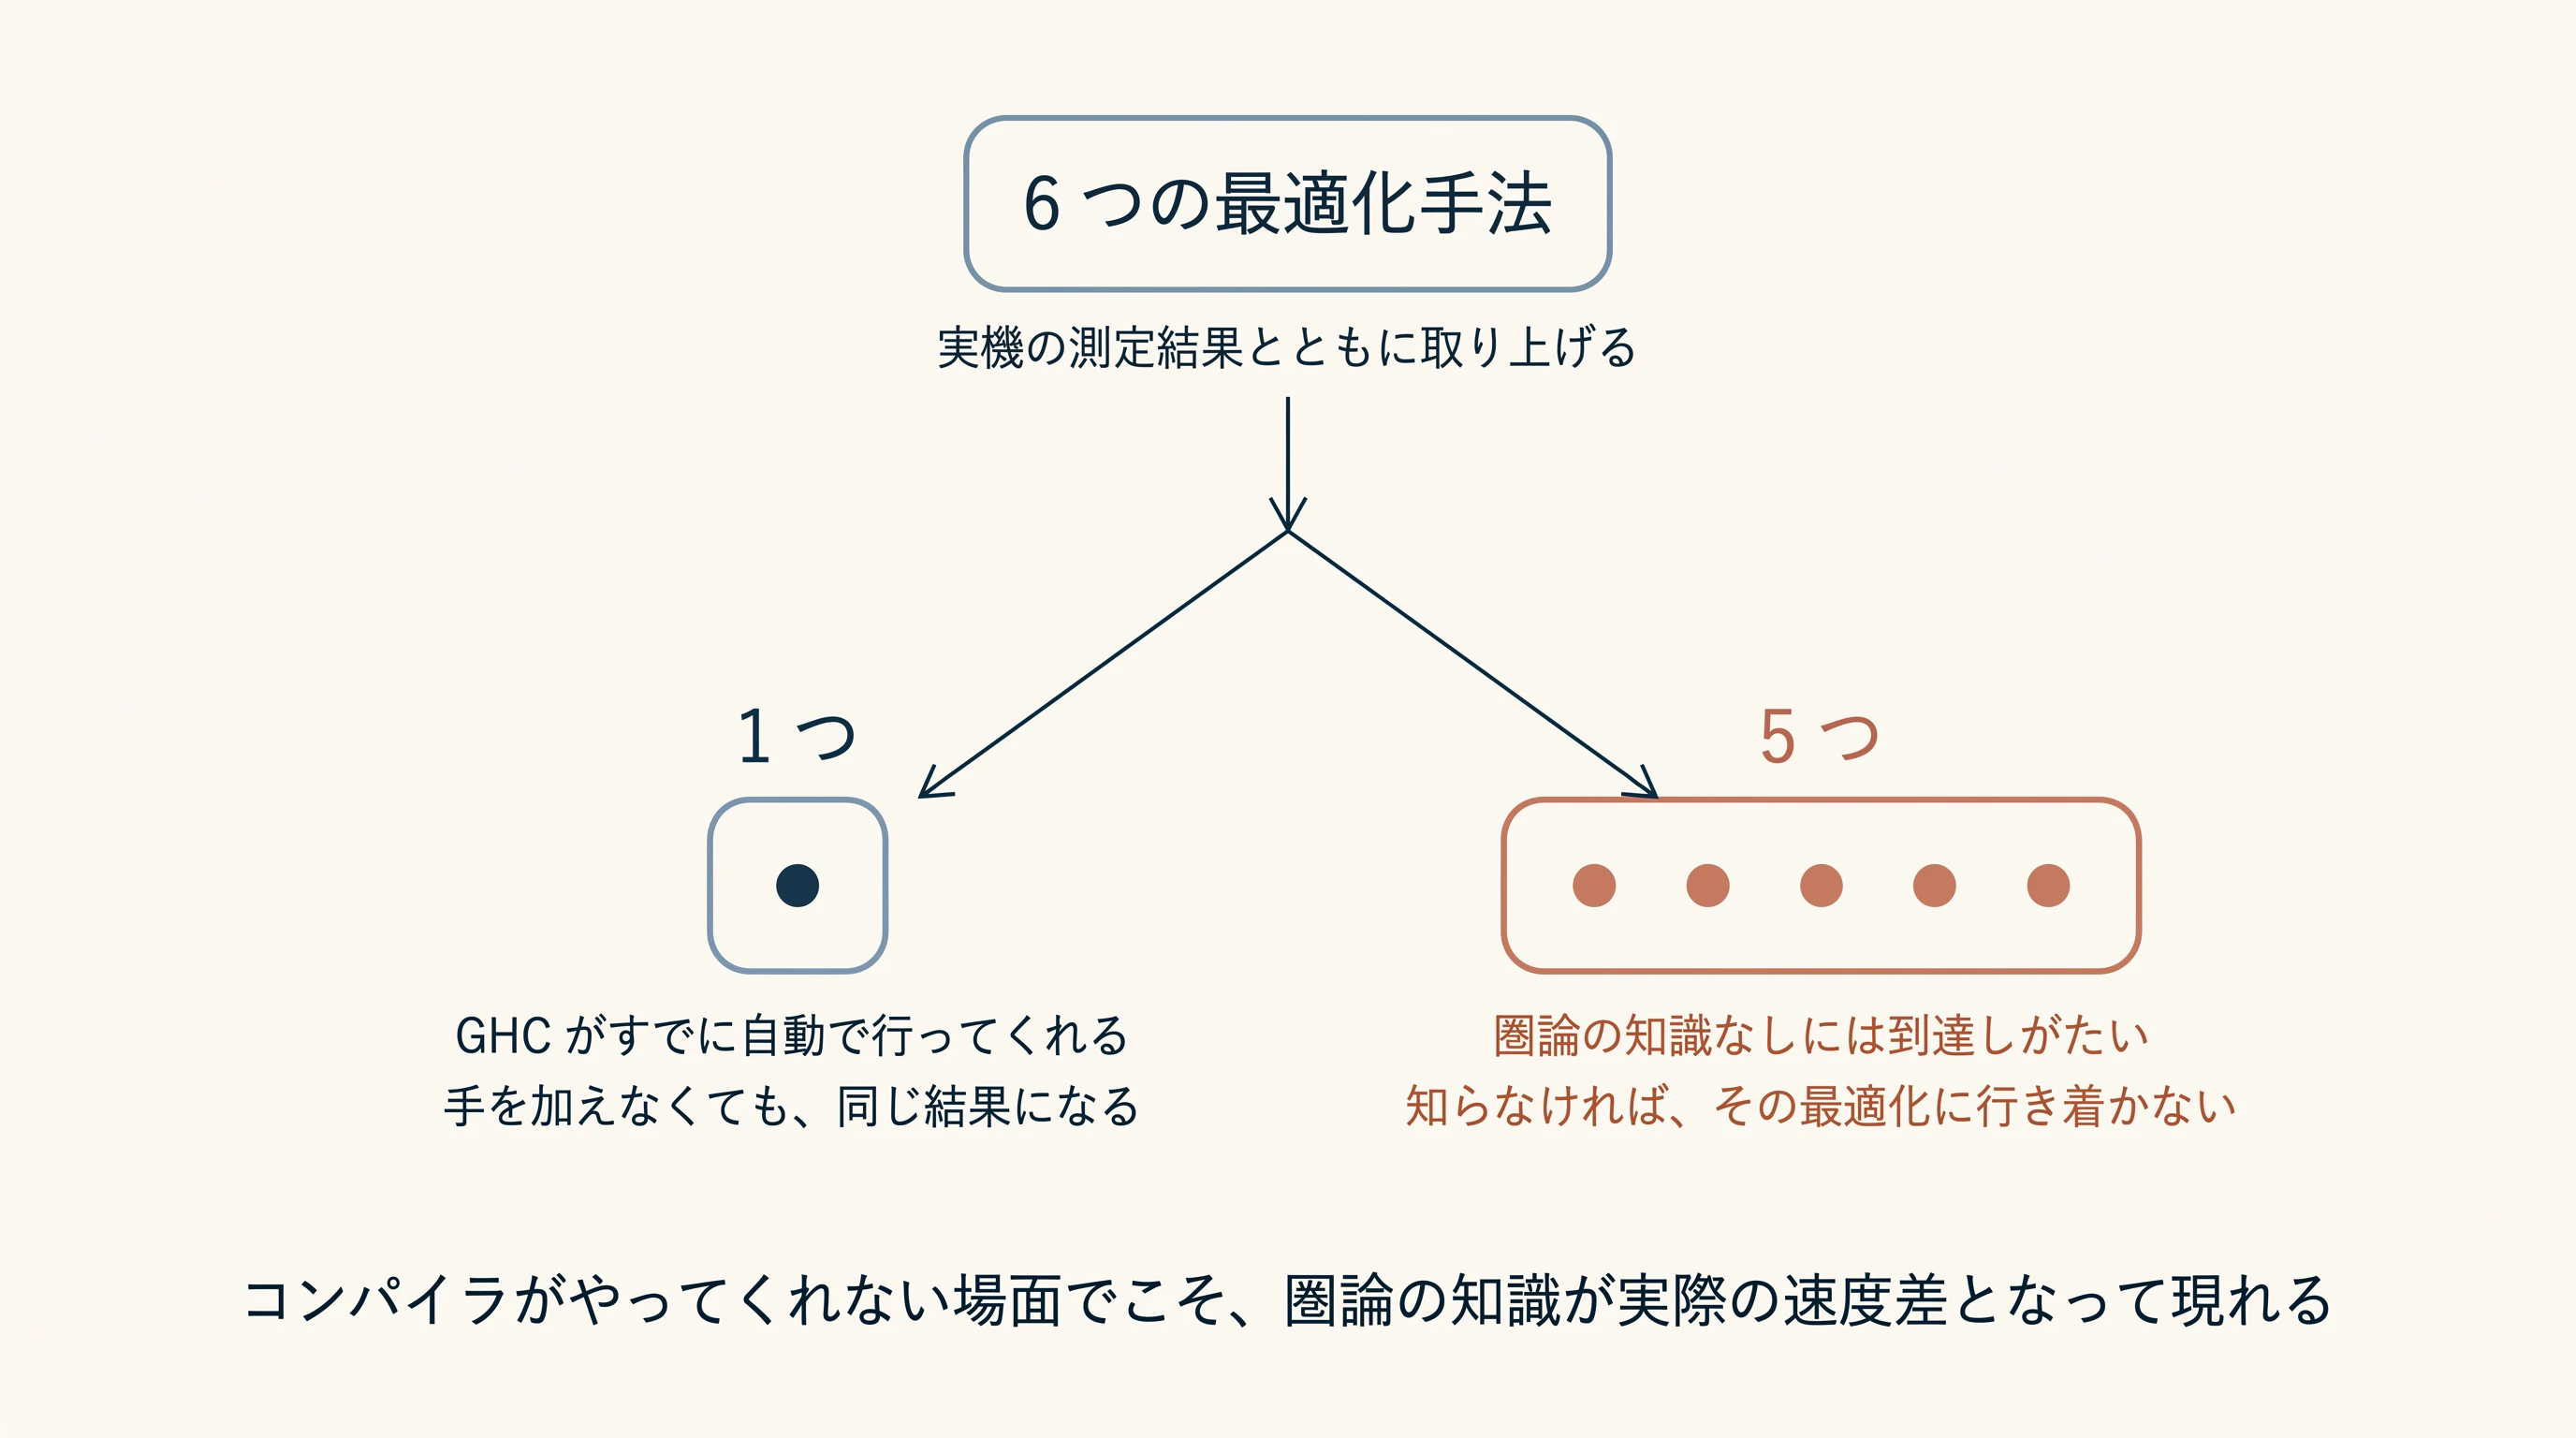
- 最後に、6つの最適化手法を、実機の測定結果とともに取り上げます。
- このうち5つは、圏論の知識なしには到達しがたいものです。
- 残る1つは、GHCがすでに自動で行ってくれているものでした。
プログラマが手を加えなくても、同じ結果になります。 -
この対比こそが、本稿の結論にあたります。
コンパイラがやってくれない場面でこそ、圏論の知識が実際の速度差となって 現れます。
( なぜ、この構成にしたのか )
「圏論の知識が、Haskellのコード最適化にどう活用されているのか」を論じるには、次の3つを順に示す必要があると考えました。
( 1つ目 )
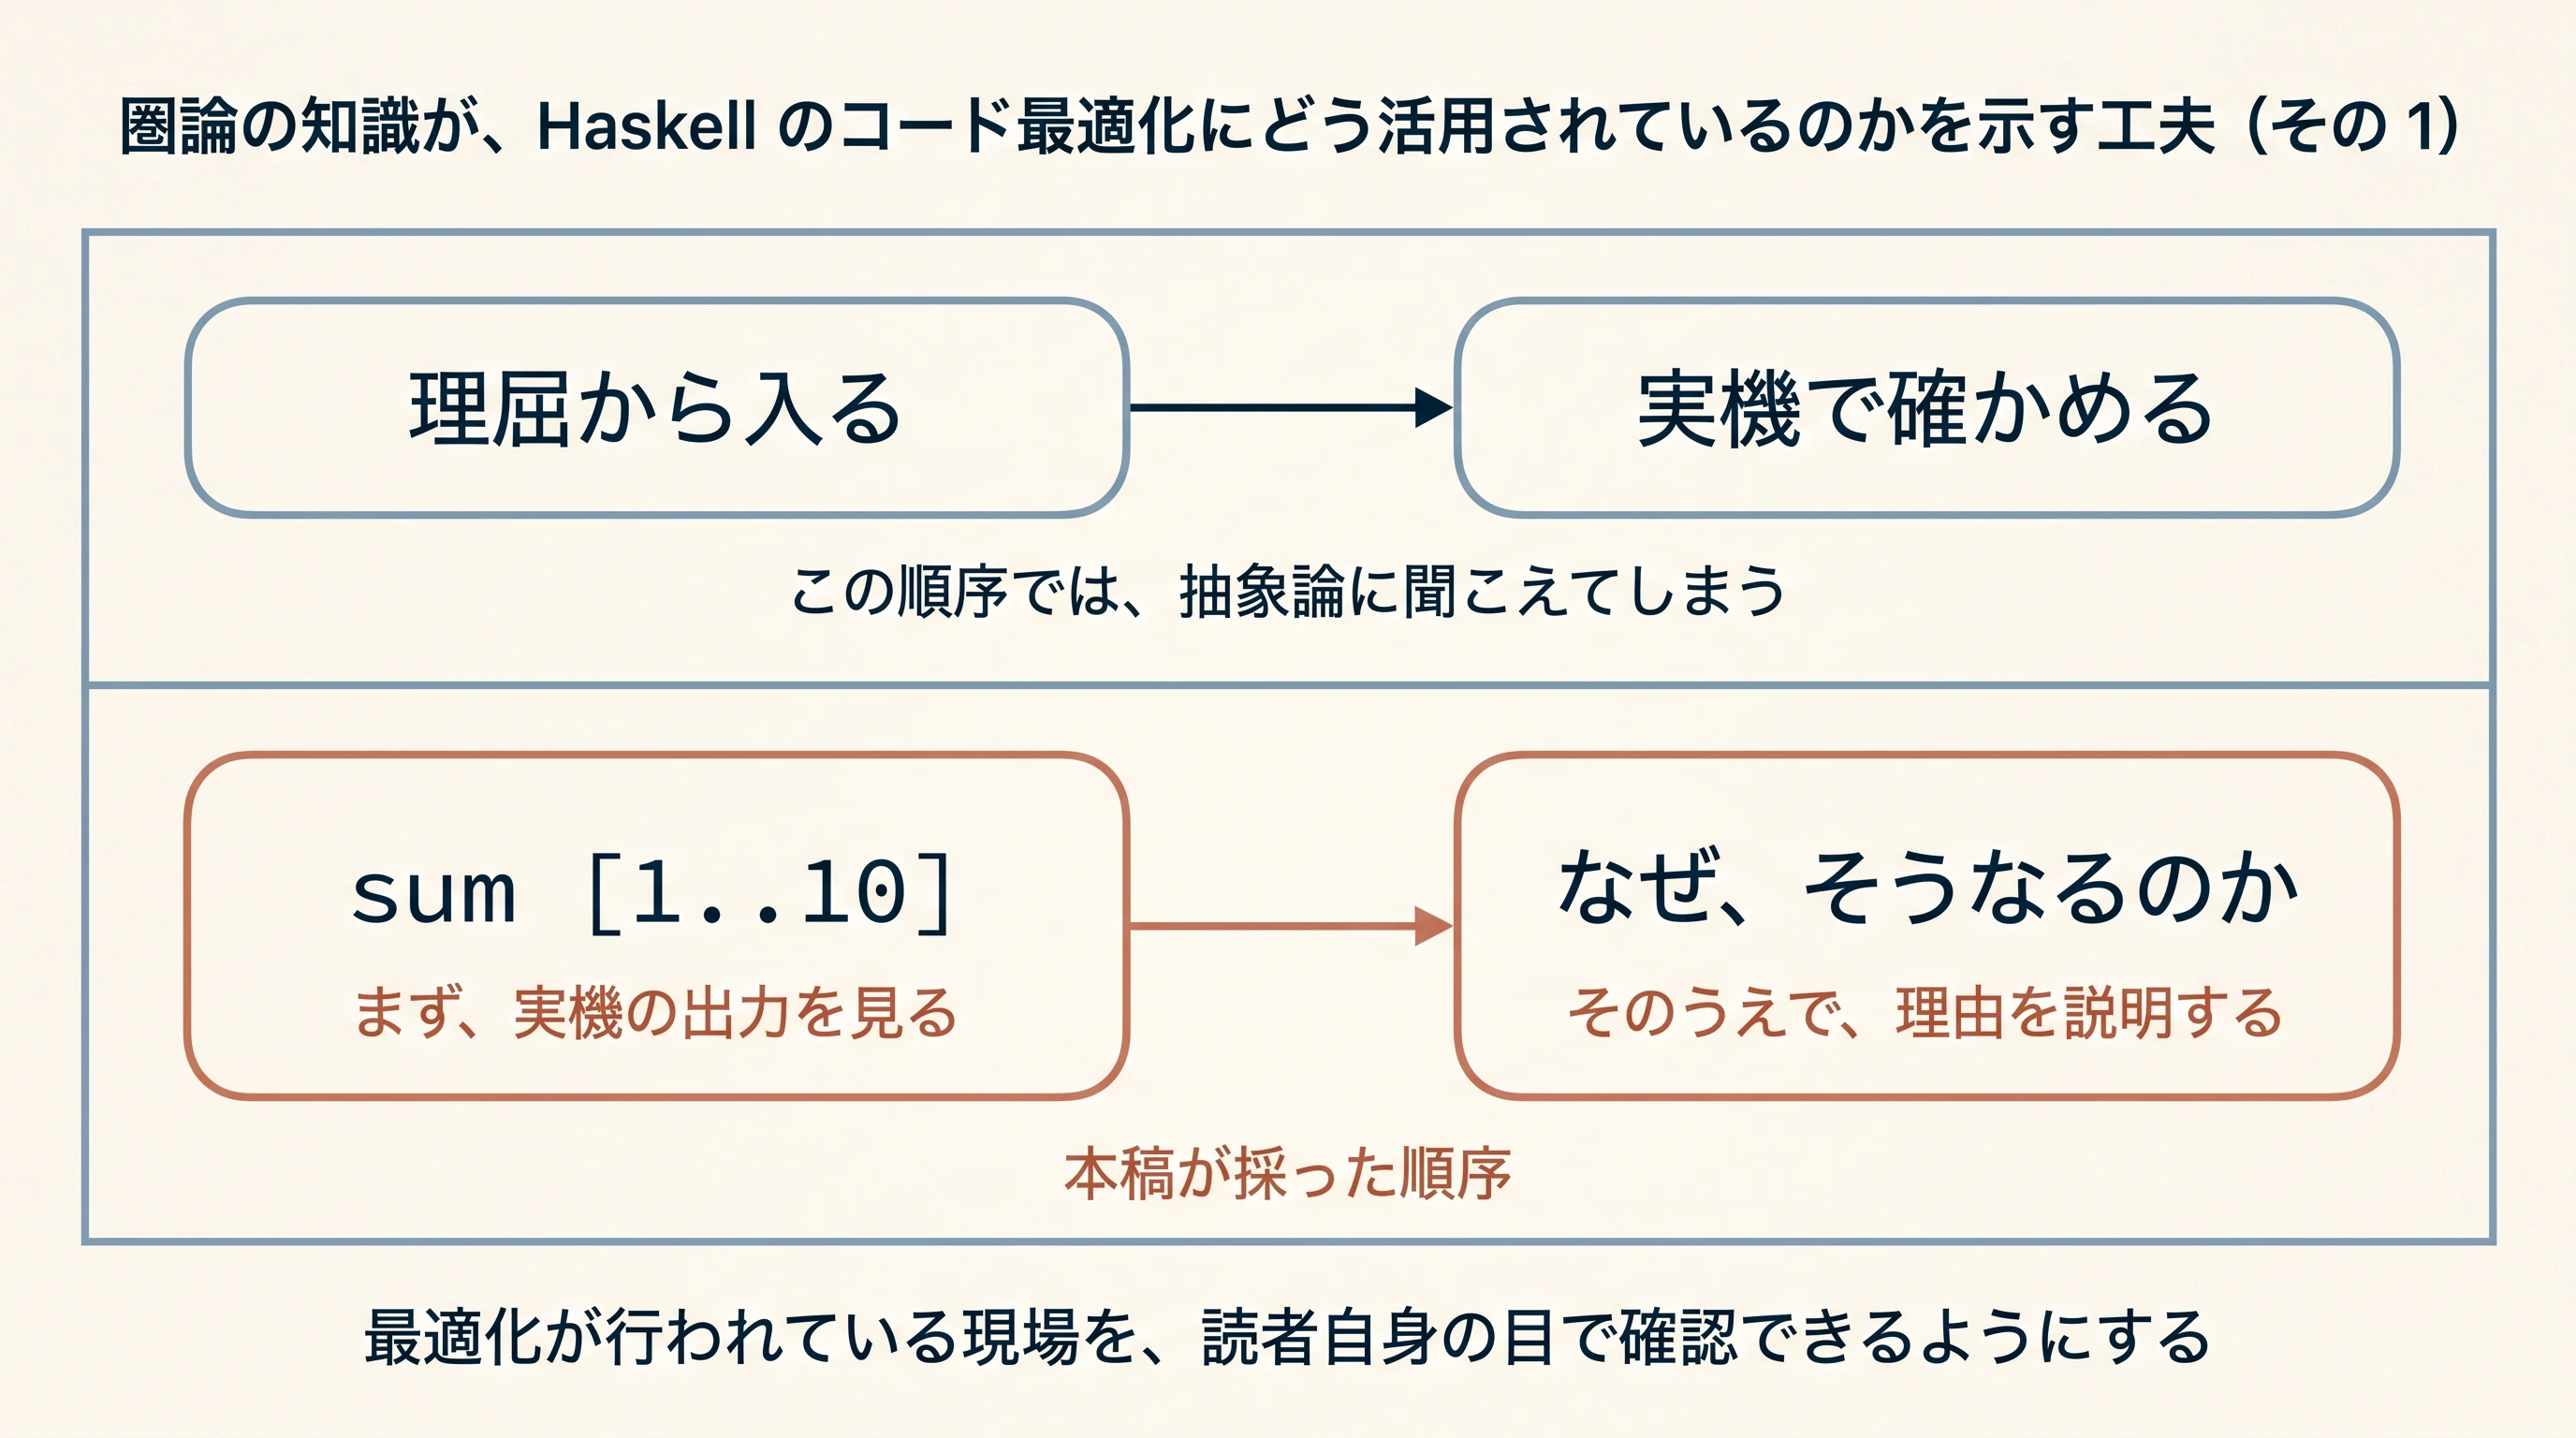
実際に最適化が行われている現場 を、読者自身の目で確認できる こと。
理屈から入ると、抽象論に聞こえます。
そこで、連載初回の本稿では、まずはじめに sum [1..10] の実機出力をご覧いただき、そのうえで 理由を説明する順序としました。
( 2つ目 )
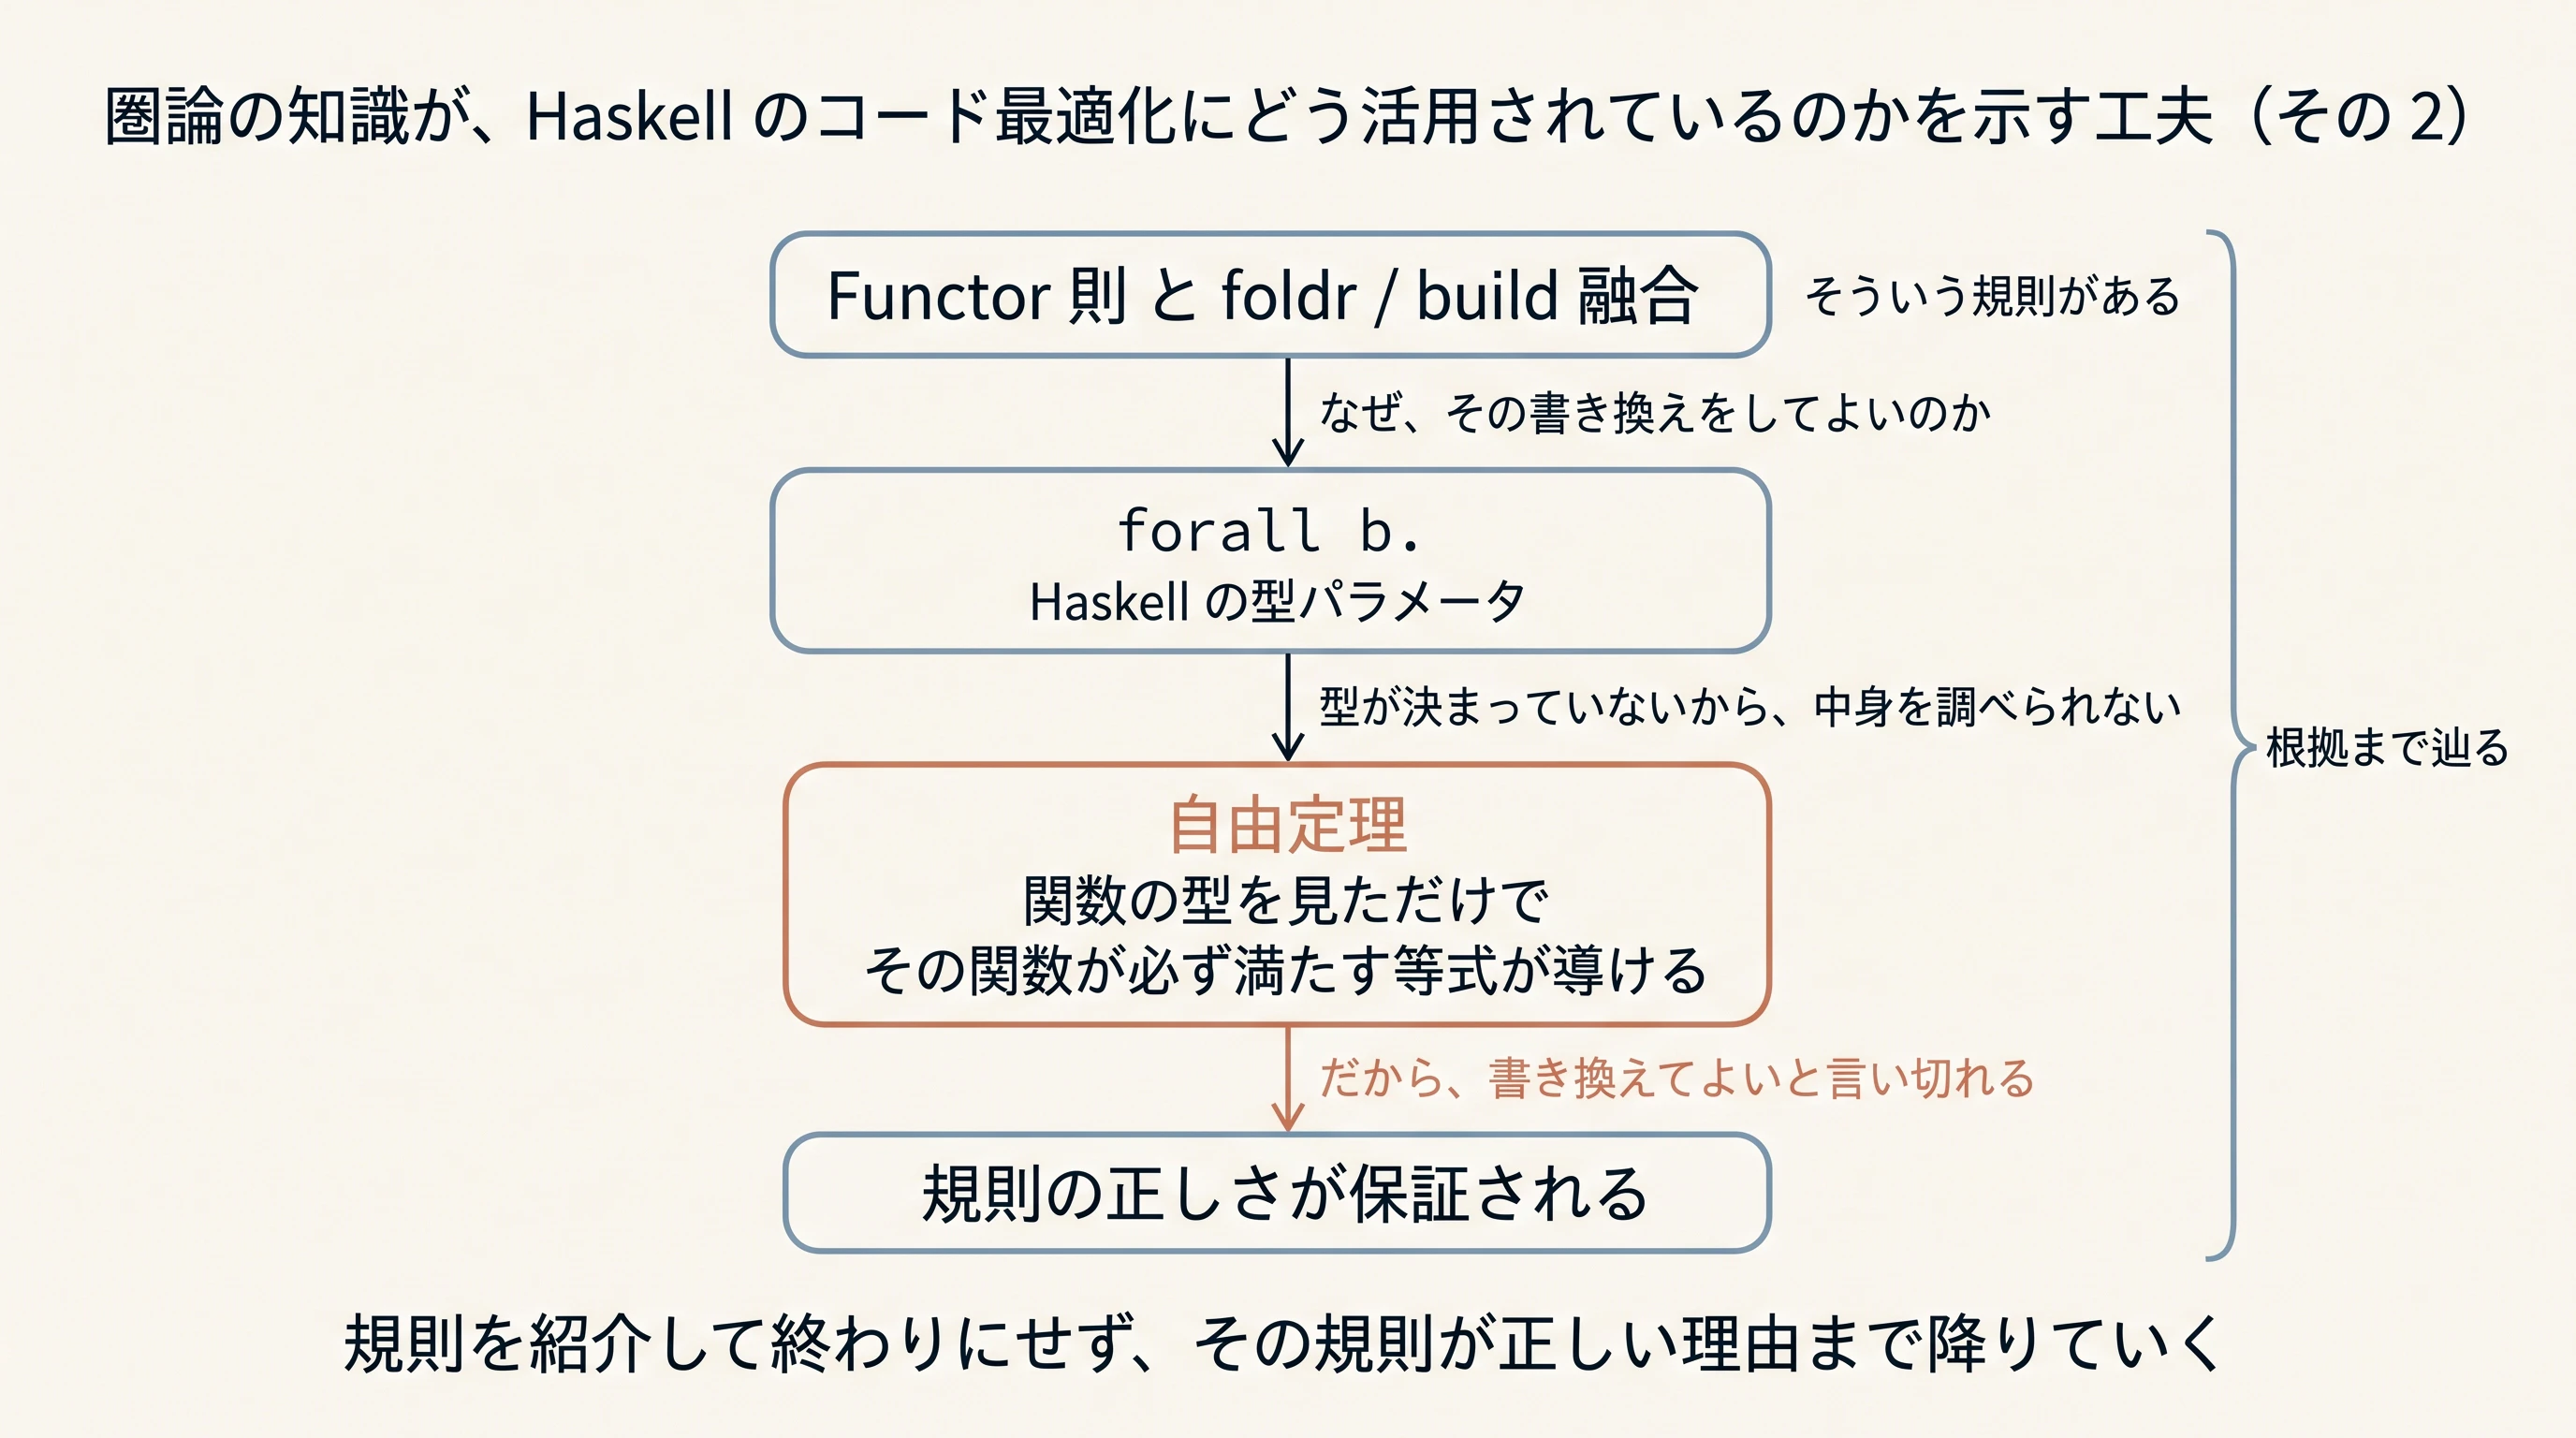
「なぜその書き換えをしてよいのか」の根拠まで辿る こと。
Functor則 や foldr/buildの書き換え規則 を 紹介するだけでは、「そういう規則がある」で終わってしまいます。
その規則がなぜ正しいのかを、自由定理まで遡ります。
なお、自由定理 とは、関数の型を見ただけで、その関数が必ず満たす等式を導き出せる というものです。
関数の中身のコードを、一行も読む必要がありません。
Wadlerの論文の題名 "Theorems for free!" が、この性質をそのまま言い表しています。
定理が、ただで手に入る。 そういう意味です。
( 3つ目 )
その根拠が崩れる場面も、あわせて示す こと。
圏論の有用性だけを述べれば、記事は短くなります。
しかし Hask は厳密には圏ではなく、そのために実際の事故も起きています。
都合のよい面だけを示す記事にはしない、という判断 です。
( 本連載の根本にある問い )
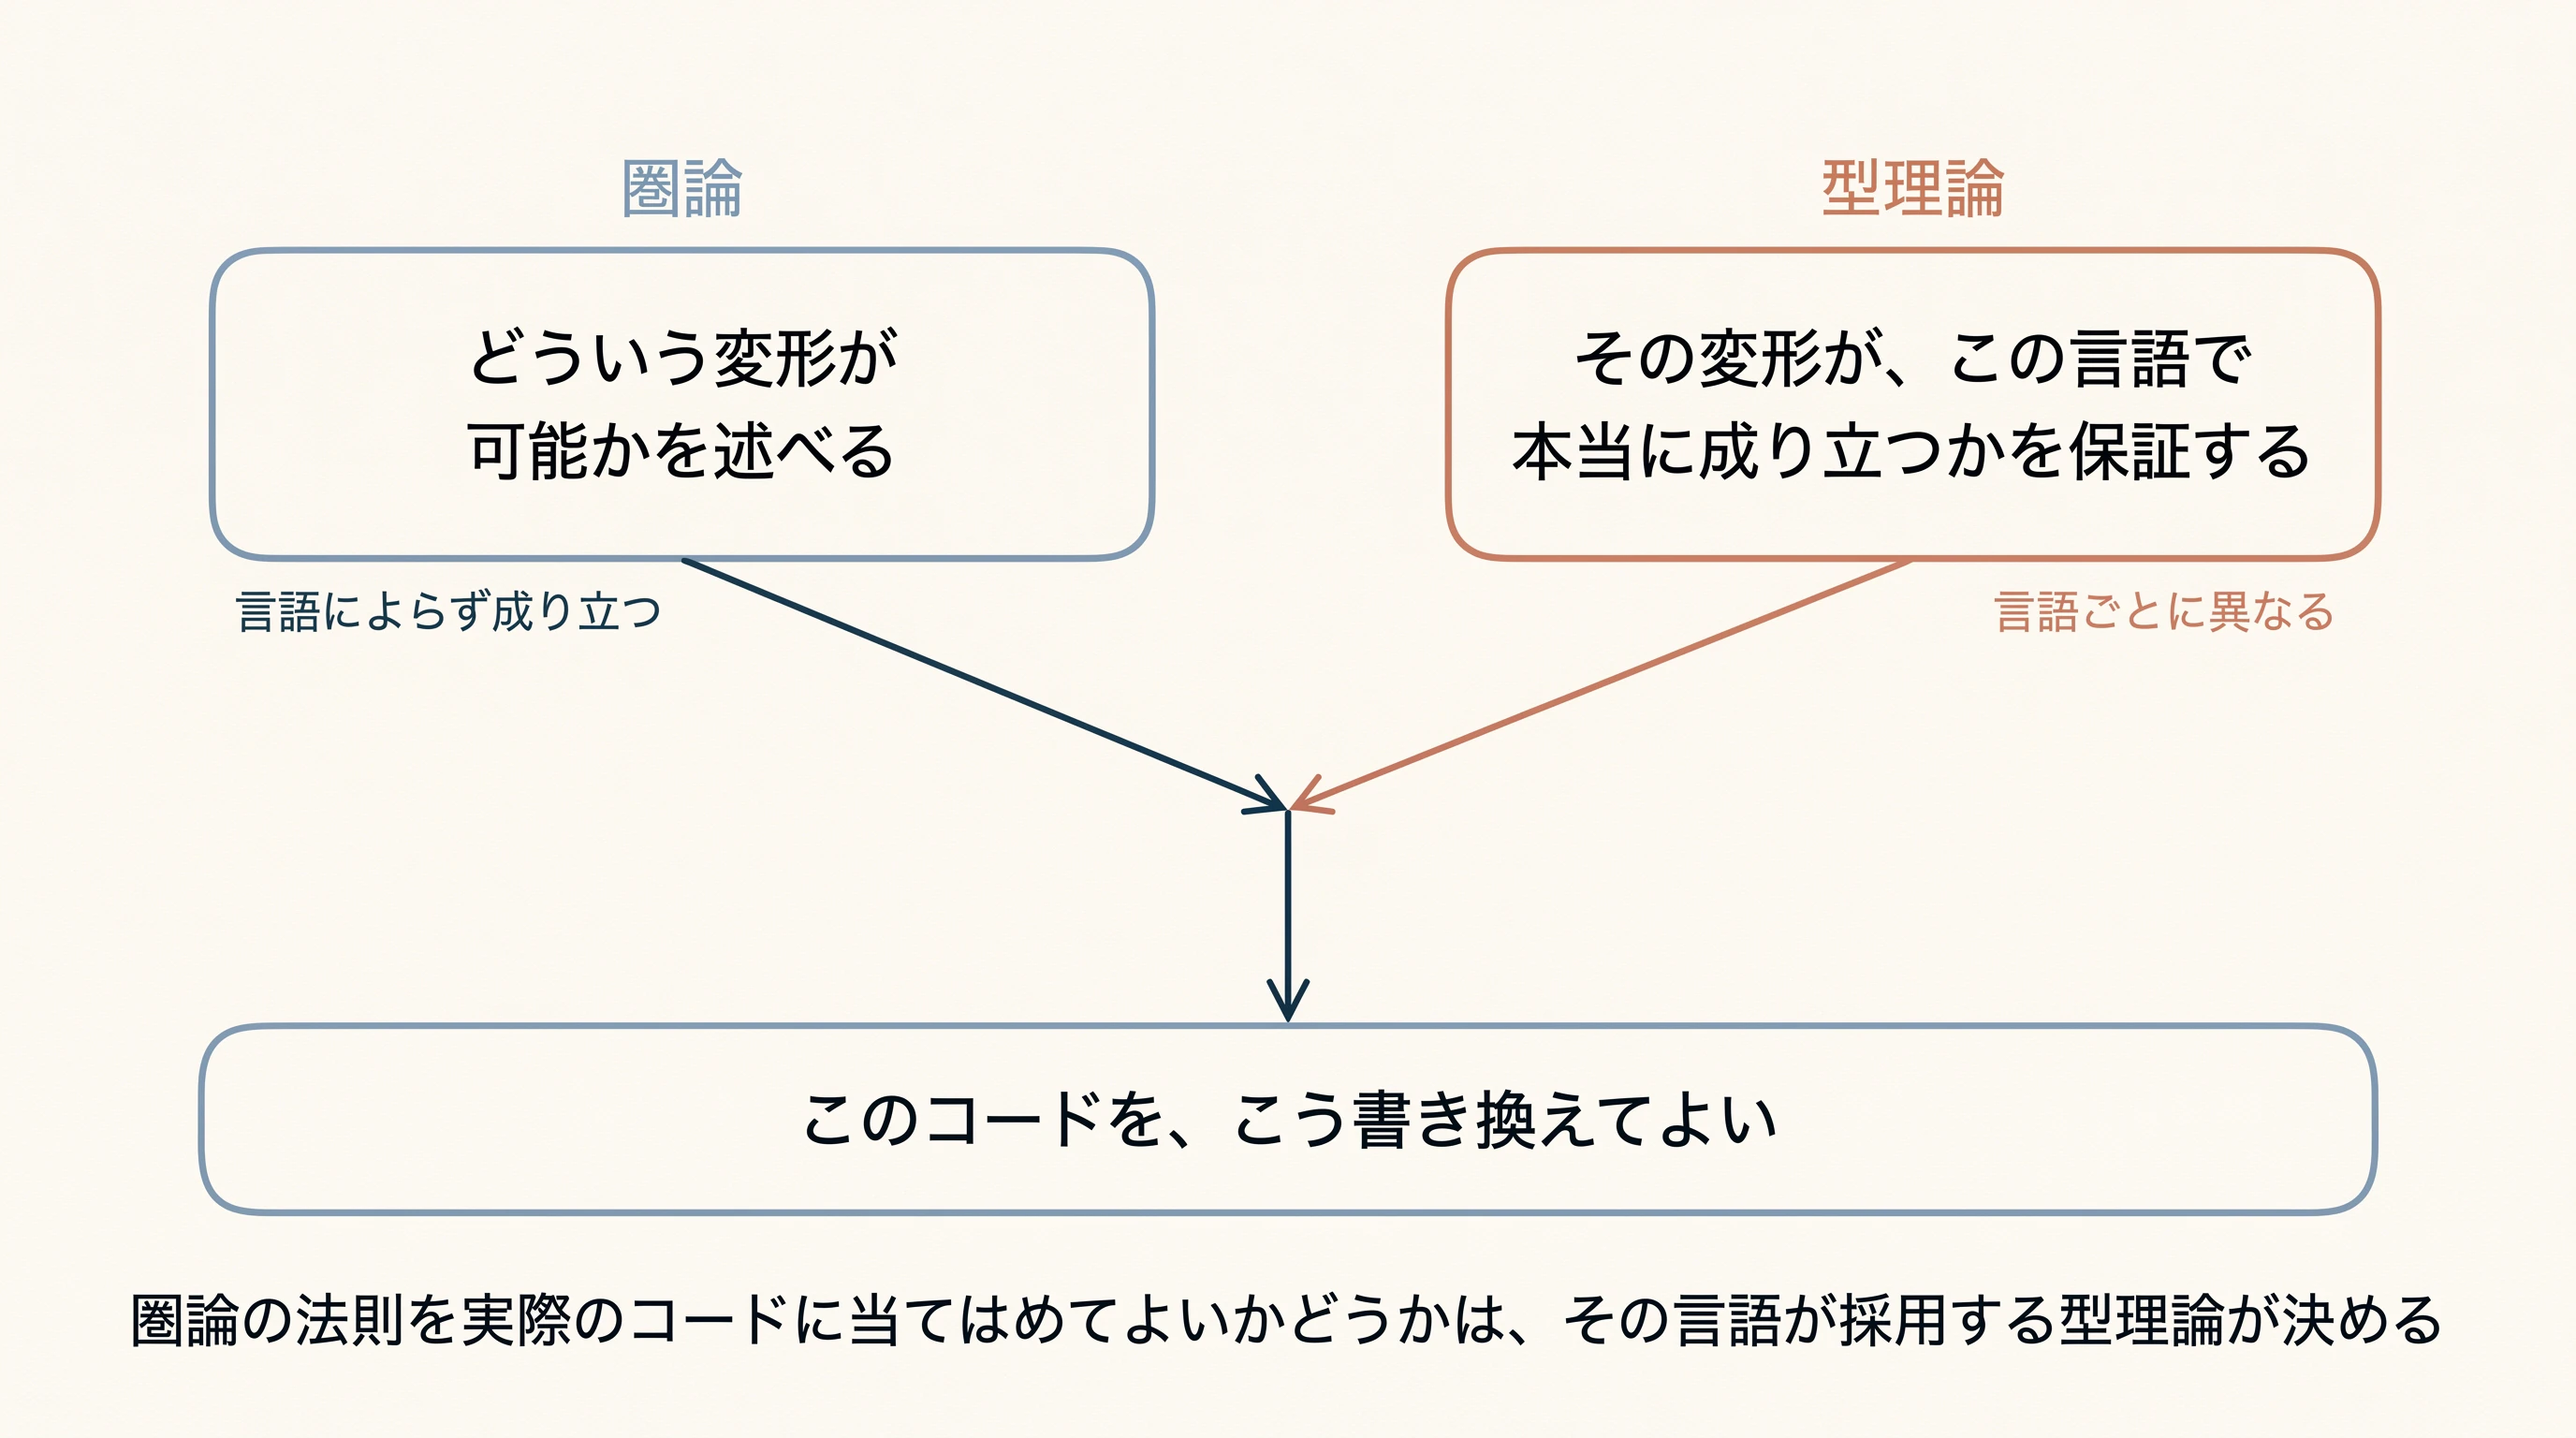
圏論の法則そのものは、どの言語を使っていても変わりません。
しかし、その法則を実際のコードに当てはめてよいかどうかは、その言語が採用する型理論が決めます。
| 最適化に登場する2つの理論 | 各理論が最適化にどう関わるか |
|---|---|
| 圏論 | どういう変形が可能かを述べる |
| 型理論 | その変形が、この言語で本当に成り立つかを保証する |
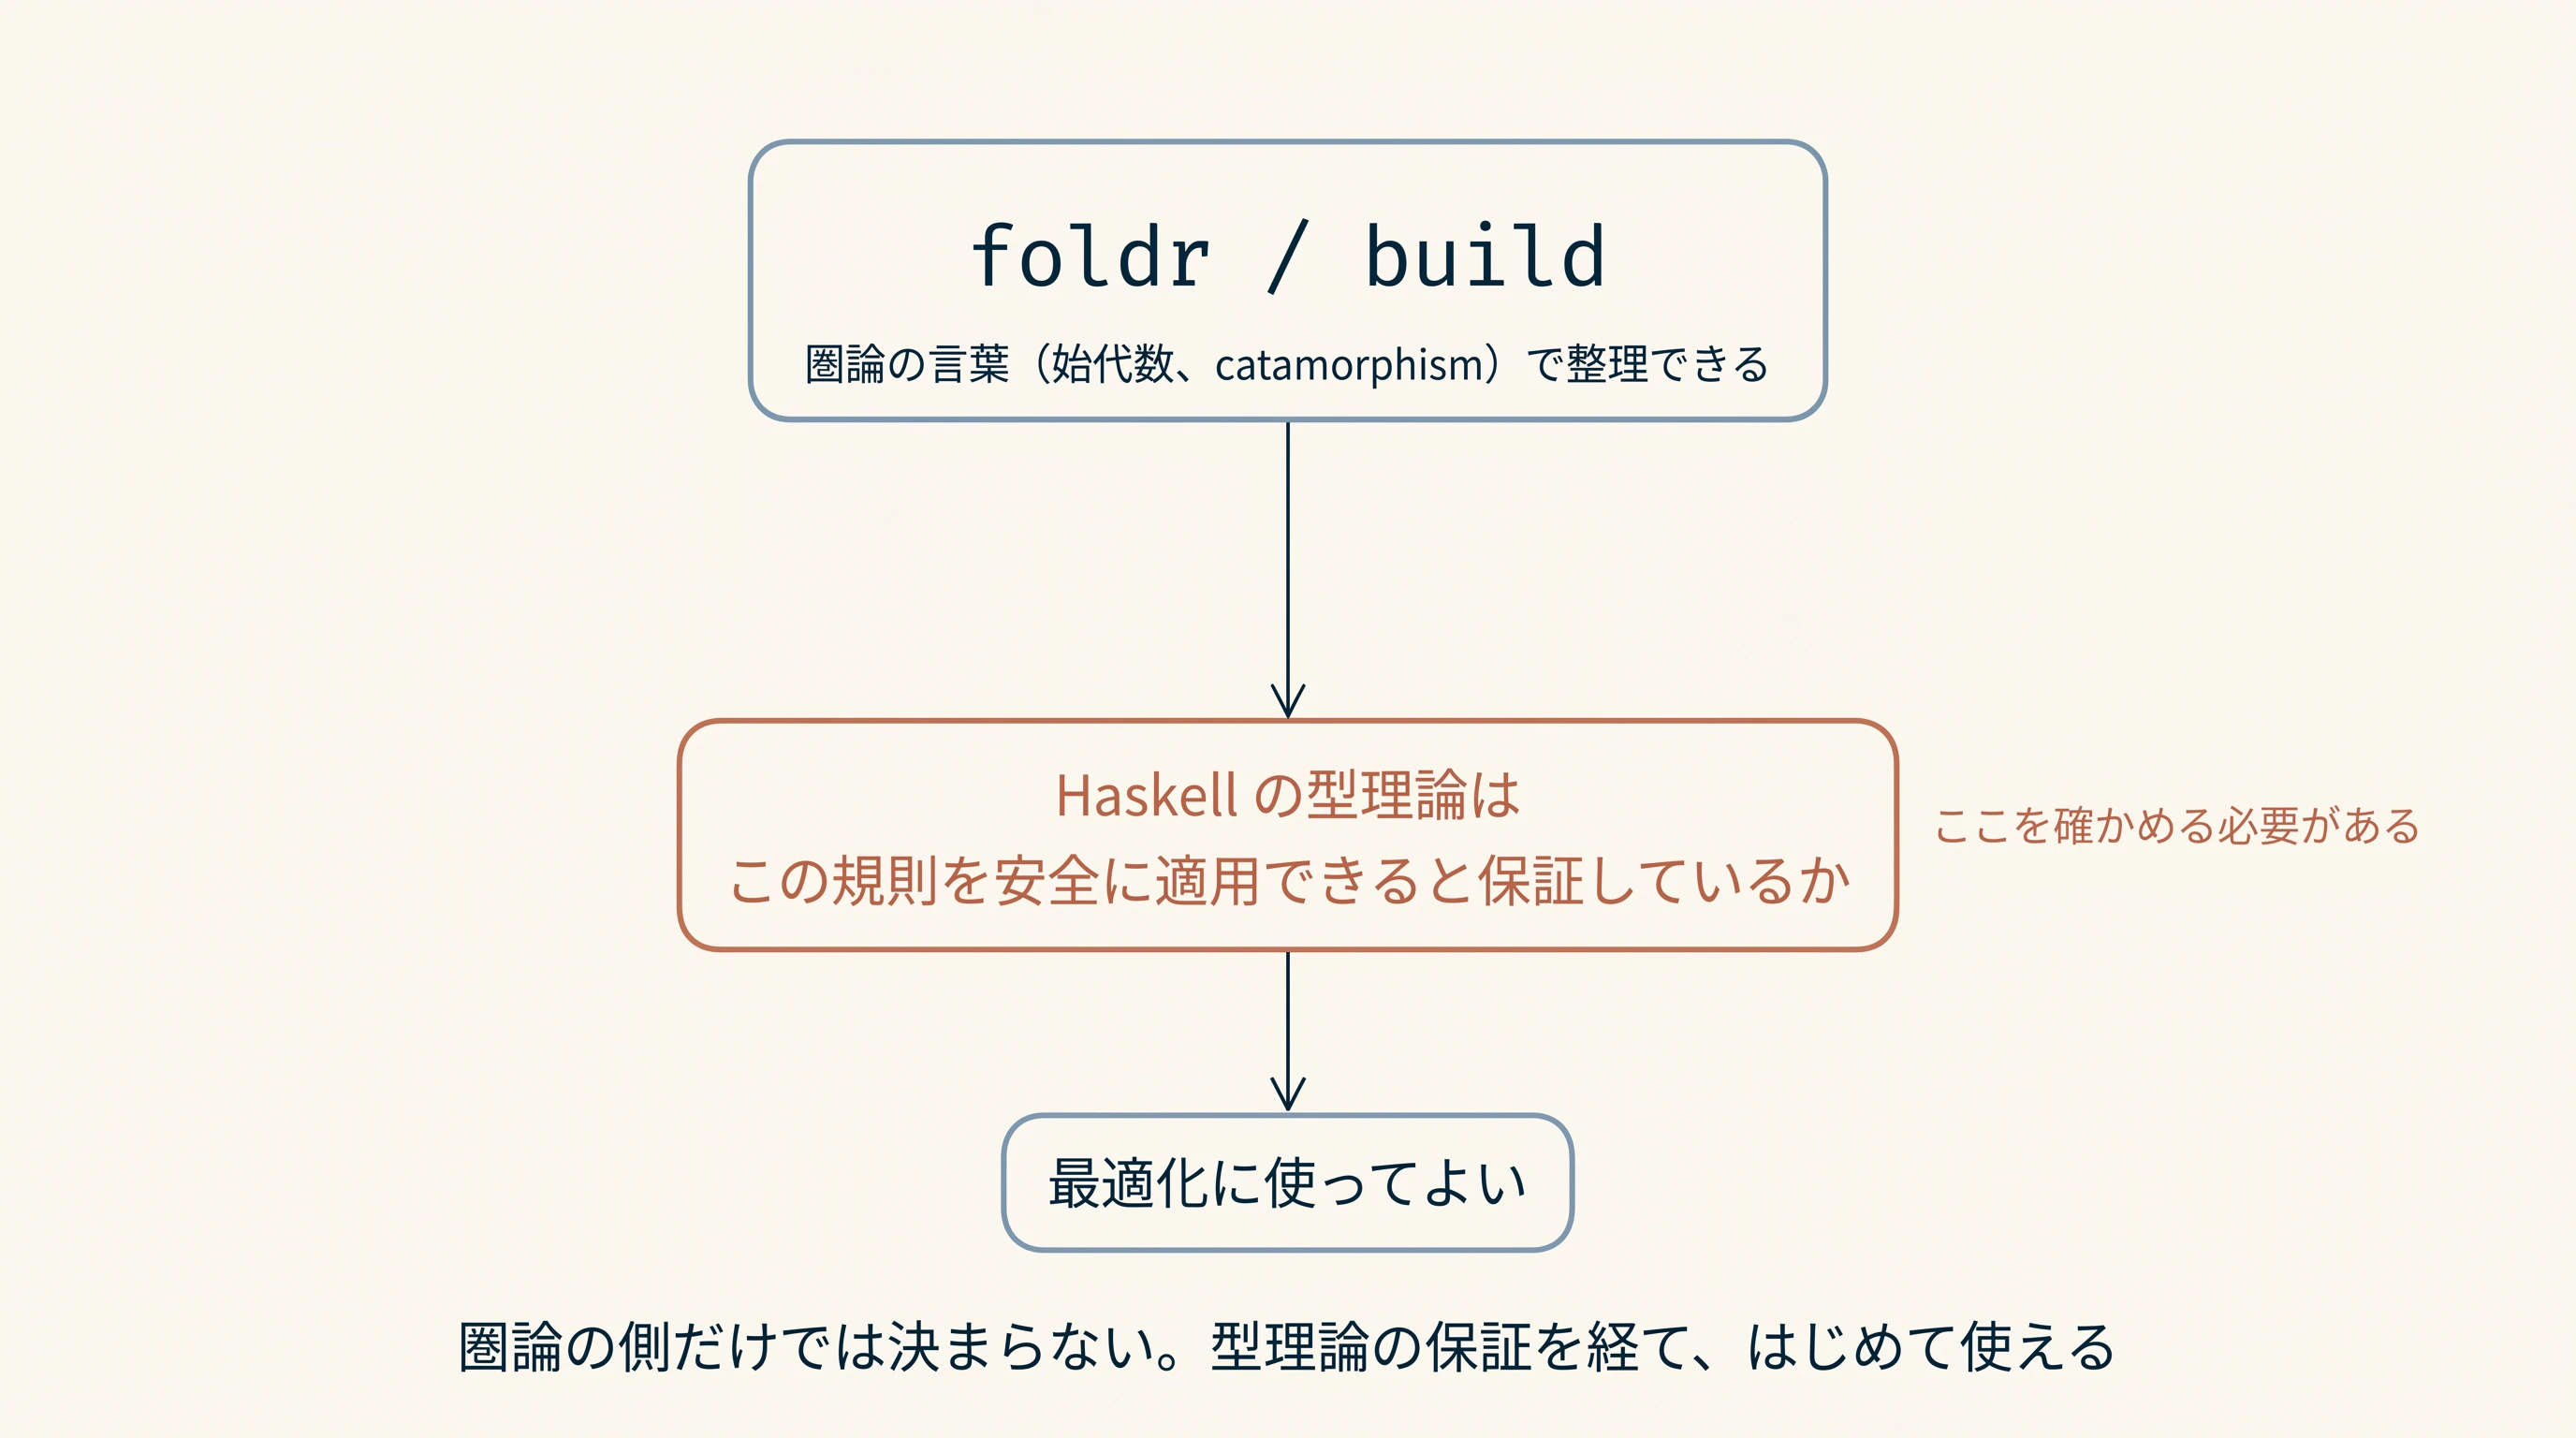
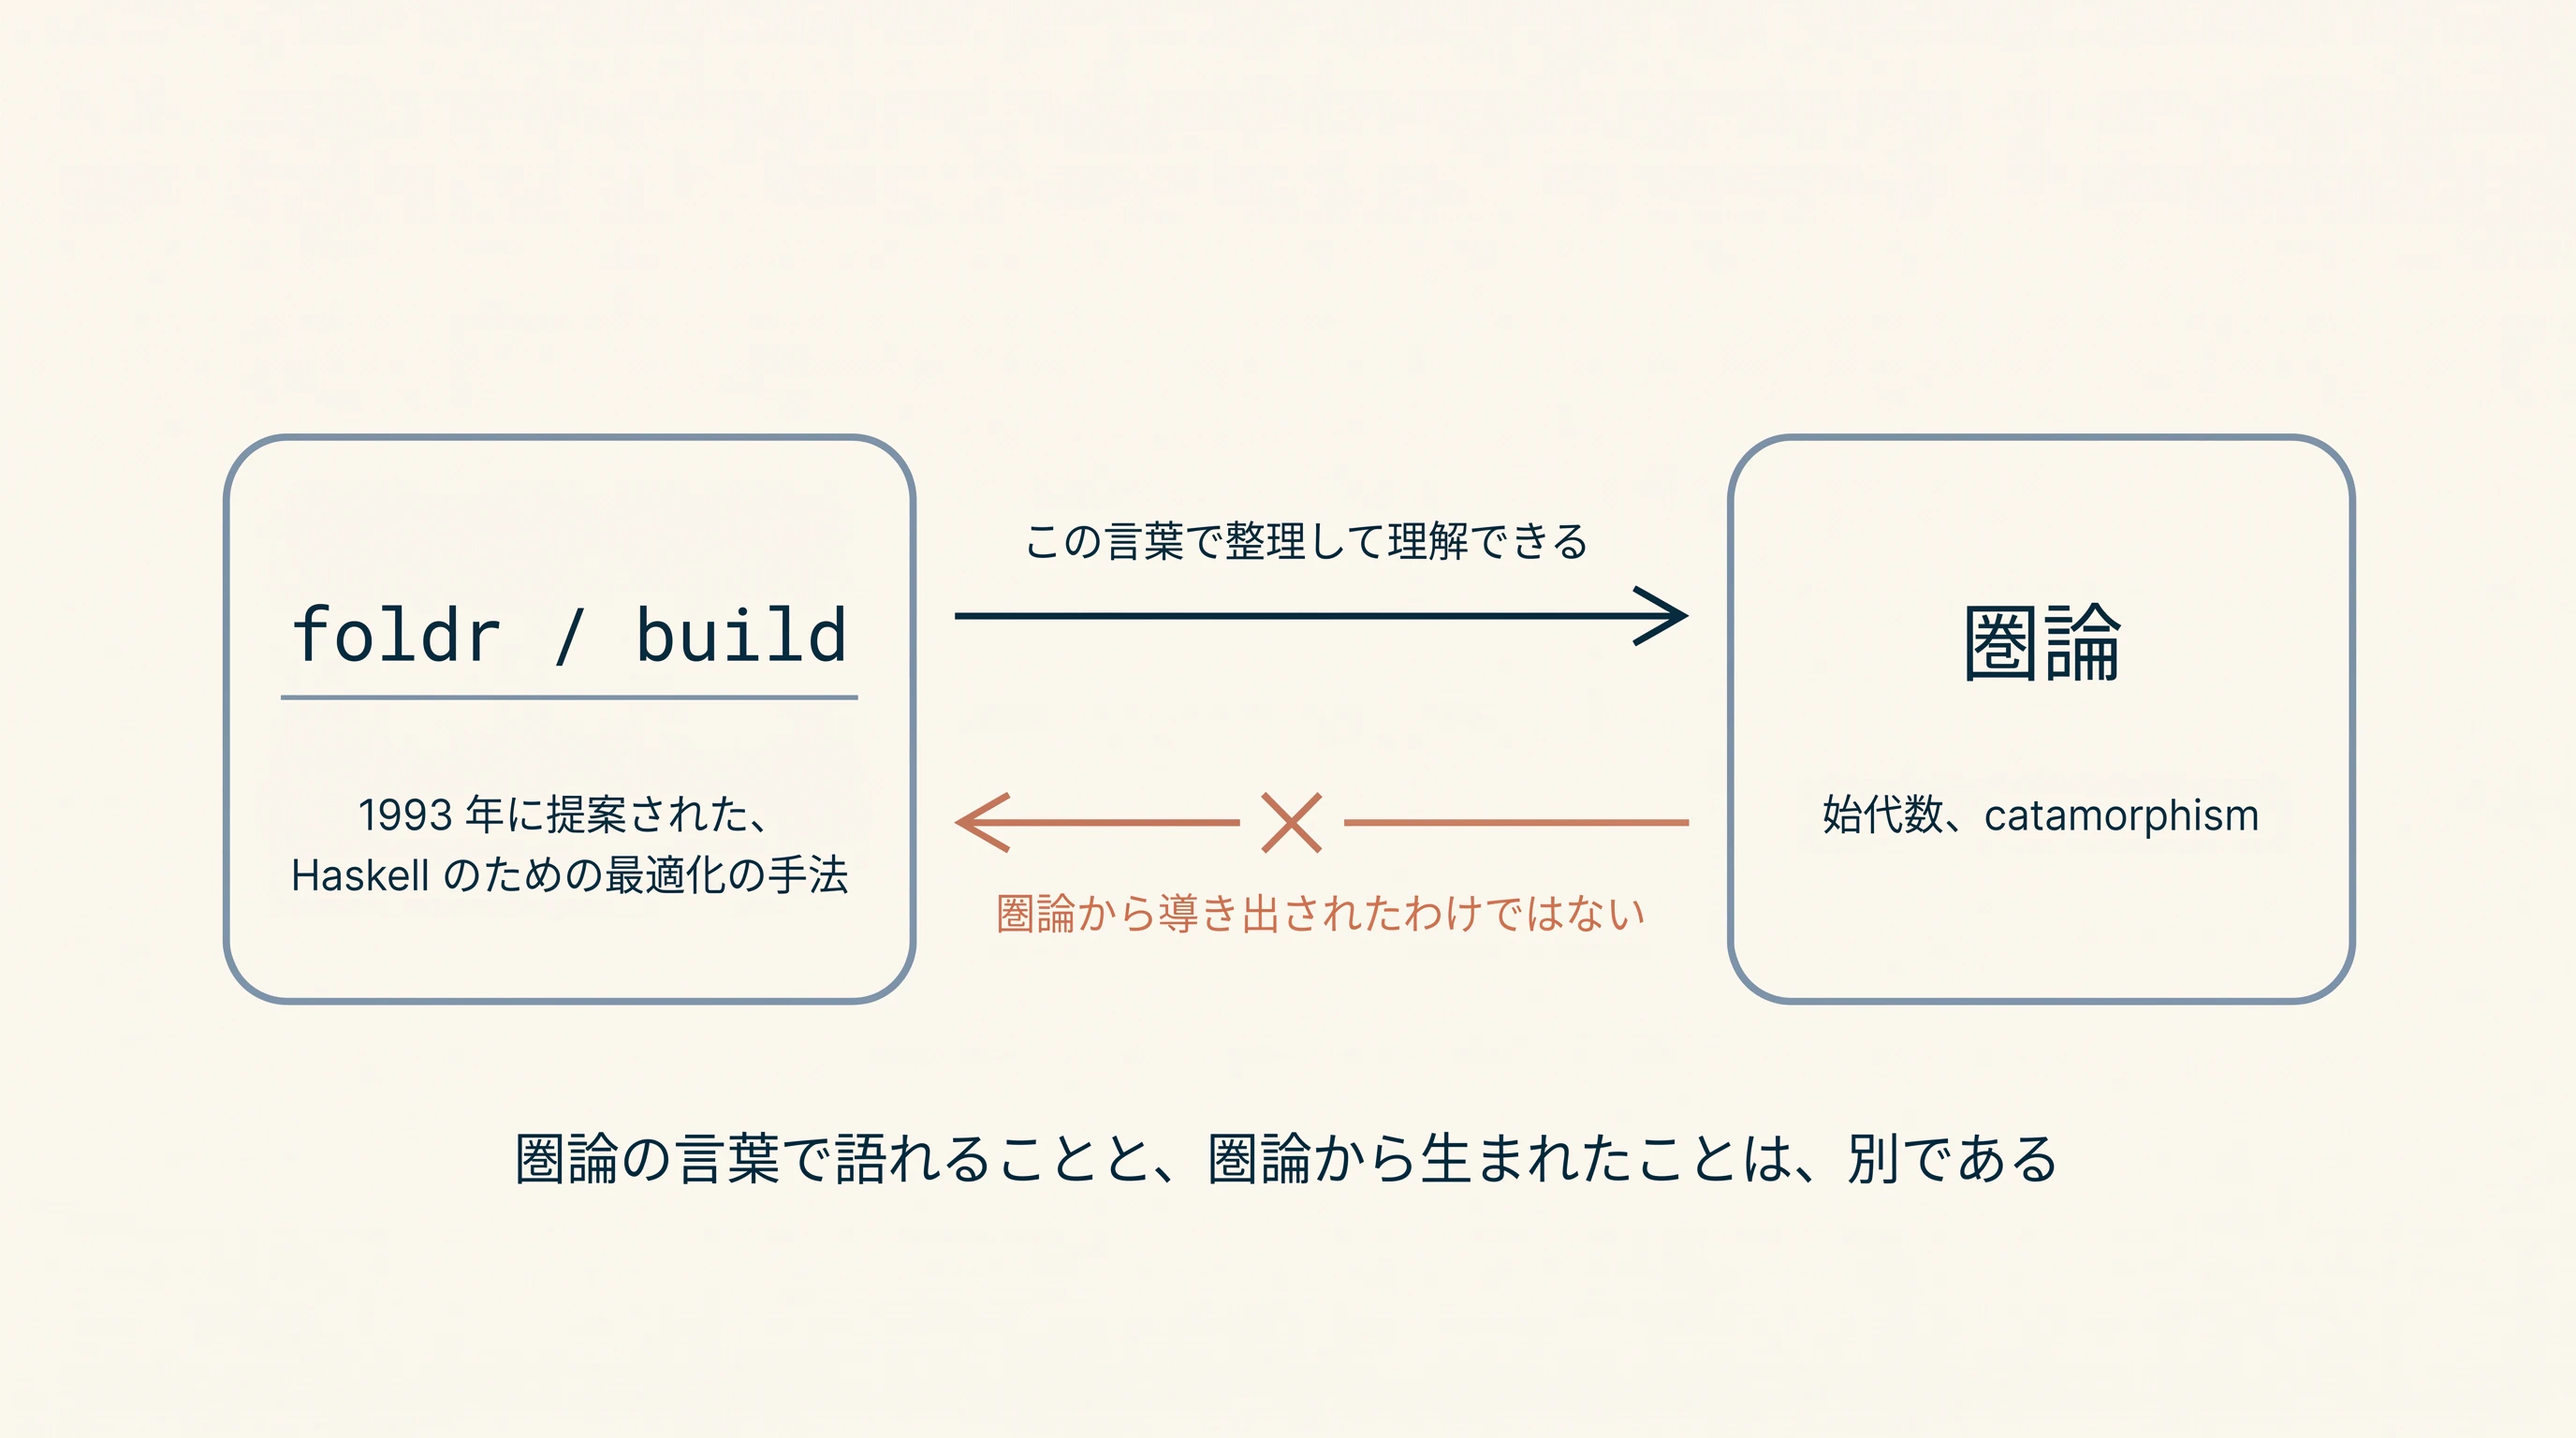
例えば、本稿の第3・4章で扱う foldr/build の規則 は、圏論の言葉(始代数、catamorphism)で整理できる ものです。
しかし、ここで注意が必要です。
この規則をHaskellのコードの最適化に使ってよいかどうかは、圏論の側だけでは決まりません。
Haskellが言語として採用している型理論が、その規則を安全に適用できると保証しているかどうか。そこを確かめる必要があります。
ここで、build と 規則 という2つの語について、簡潔に解説させていただきます。
( build とは何か )
build は、中間のリストを作らずに済ませるために、標準ライブラリの内部で使われる関数 です。Haskellのコードを書くときに、Haskellプログラマが直接使うことはほとんどありません。
buildが何をする関数なのか、具体例で見ていきます。
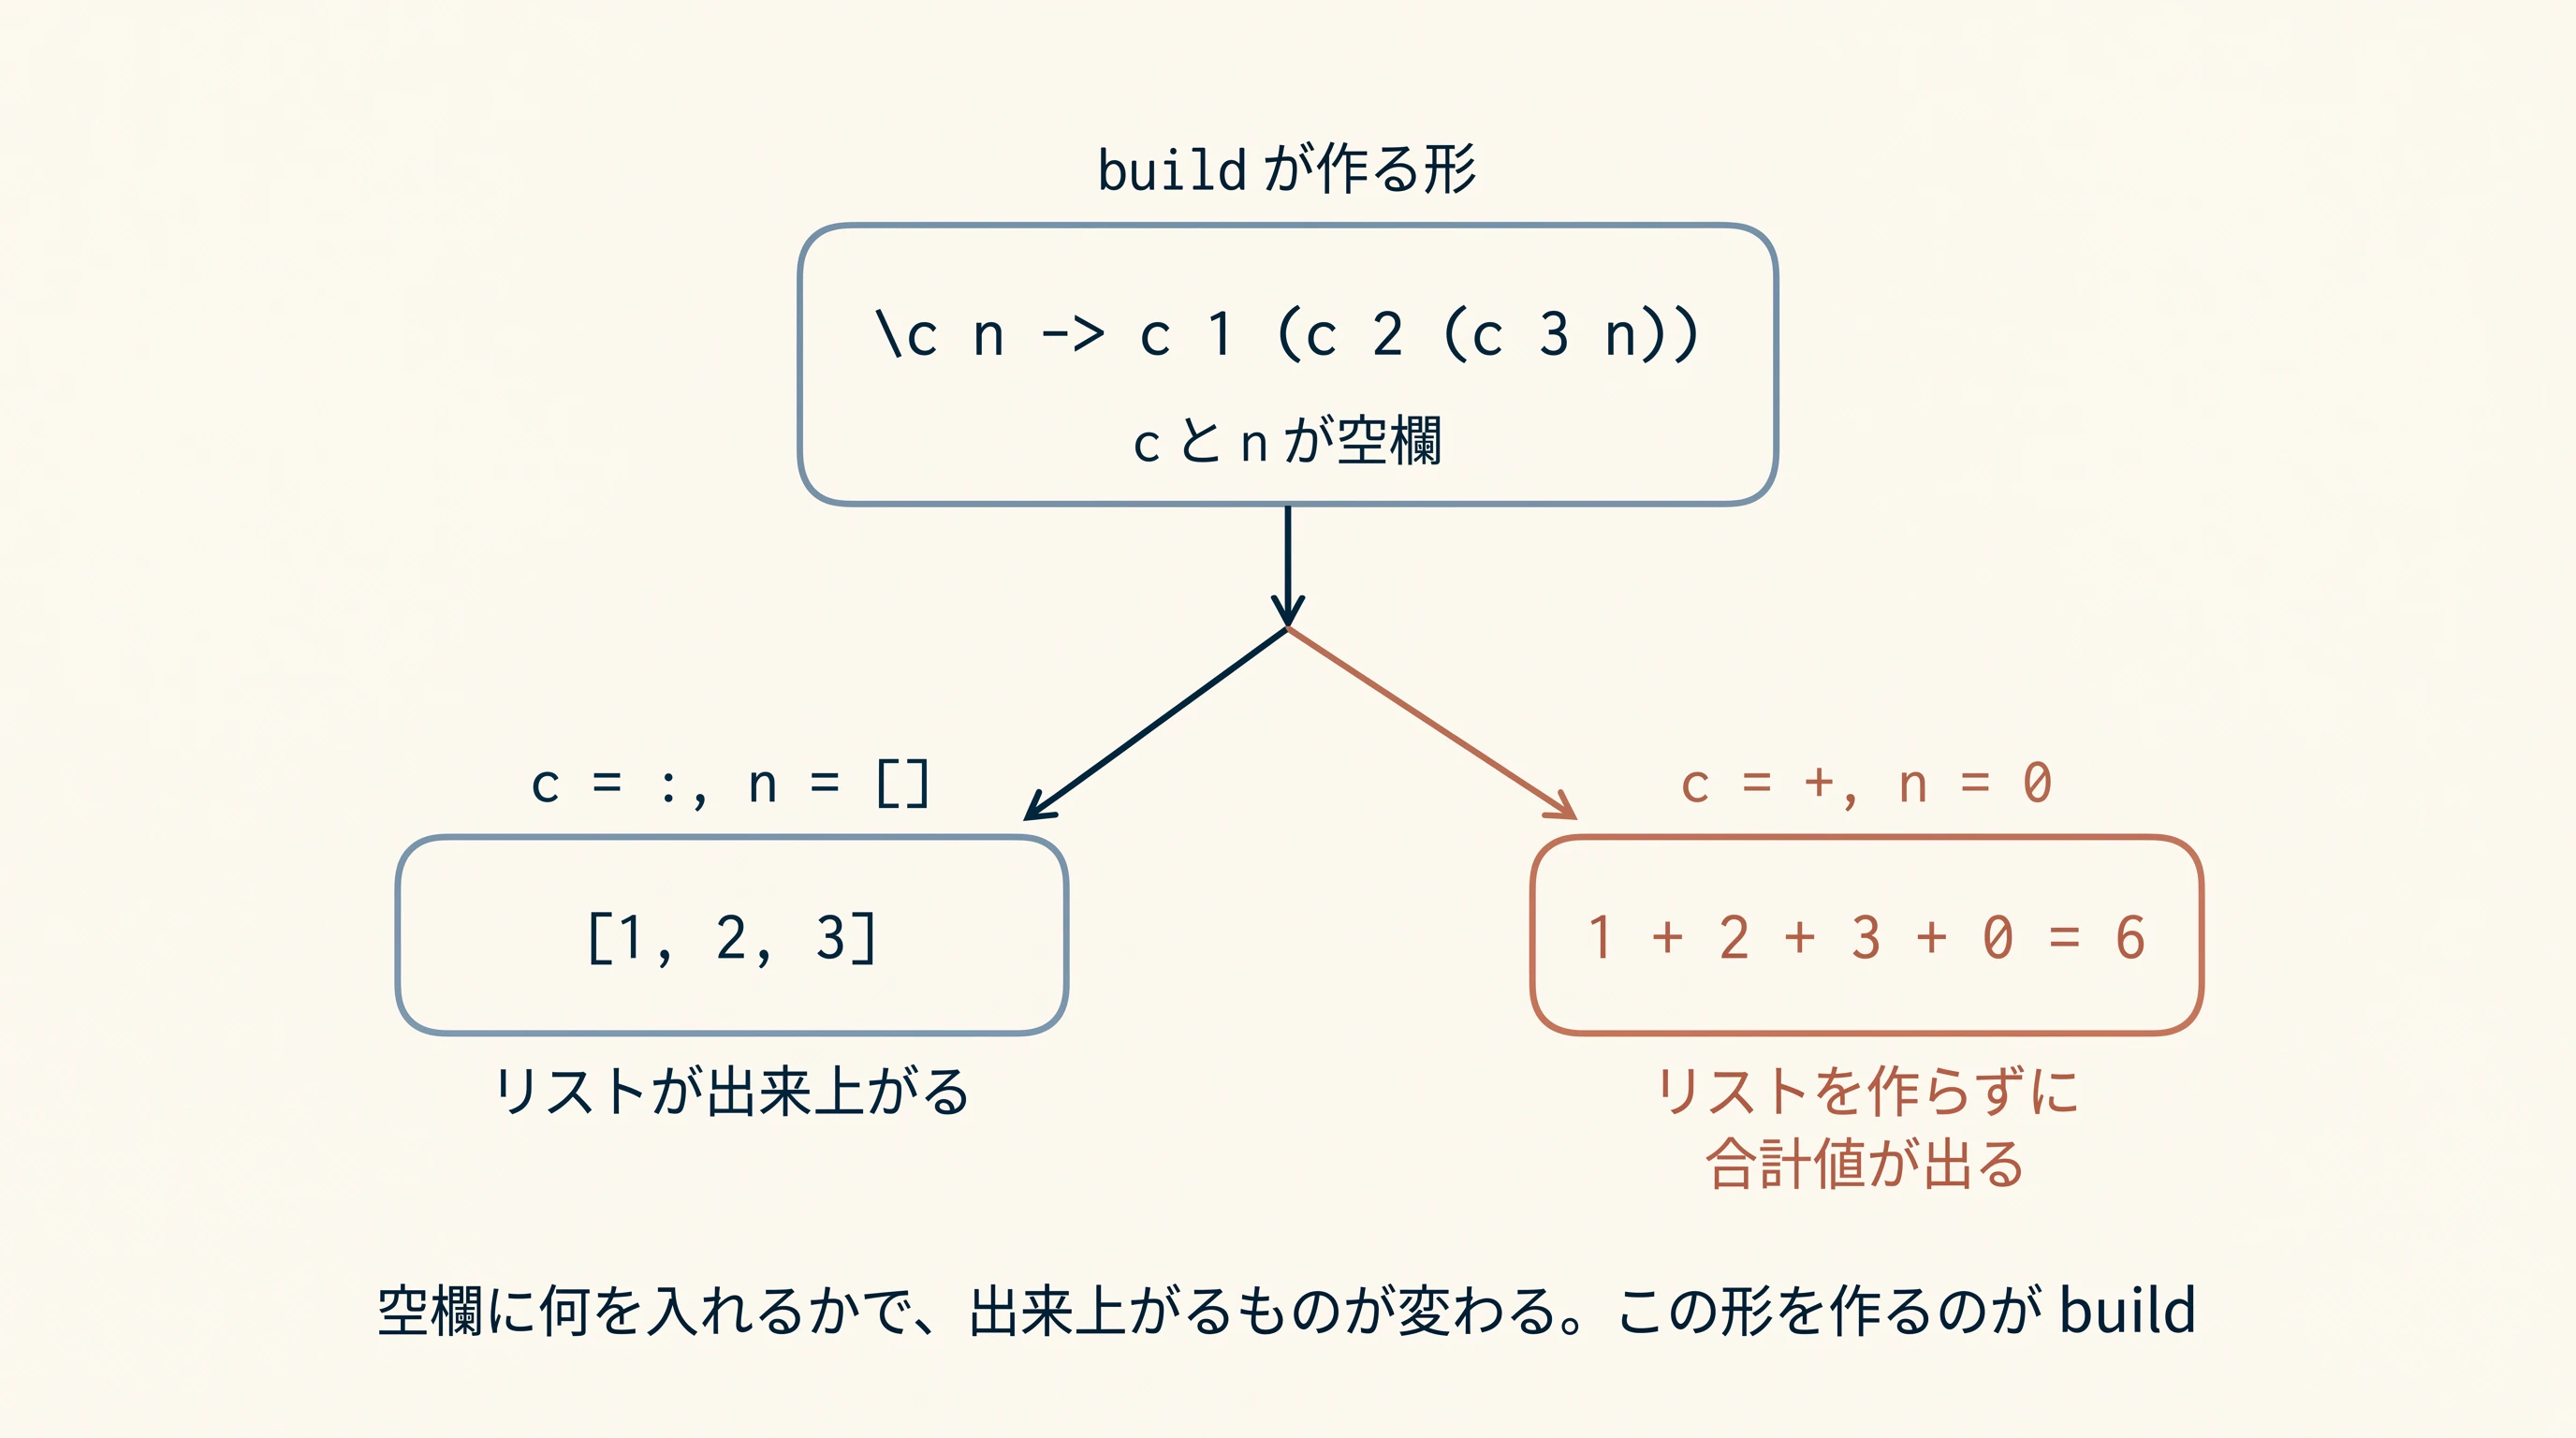
リスト を [1, 2, 3] と書いたとき、その中身は次の形です。
1 : (2 : (3 : []))
: が「要素をつなぐ」、[] が「終わりを示す」役割を担っています。
ここで、その2か所を空欄にしてみます。
\c n -> c 1 (c 2 (c 3 n))
c と n が空欄です。
c に : を、n に [] を入れれば、もとの [1, 2, 3] に戻ります。
ここで、c に + を、n に 0 を入れると、1 + 2 + 3 + 0 となり、リストを作らずに合計値の 6 が出ます。
この「空欄を残した形」を作るのが build です。
( 規則とは何か )
規則 とは、GHCに対して「この形のコードを見つけたら、この形に書き換えてよい」と教えておく指示 のことです。GHCでは RULES という仕組みで書かれます。
( では、foldr/build の規則とは何か )
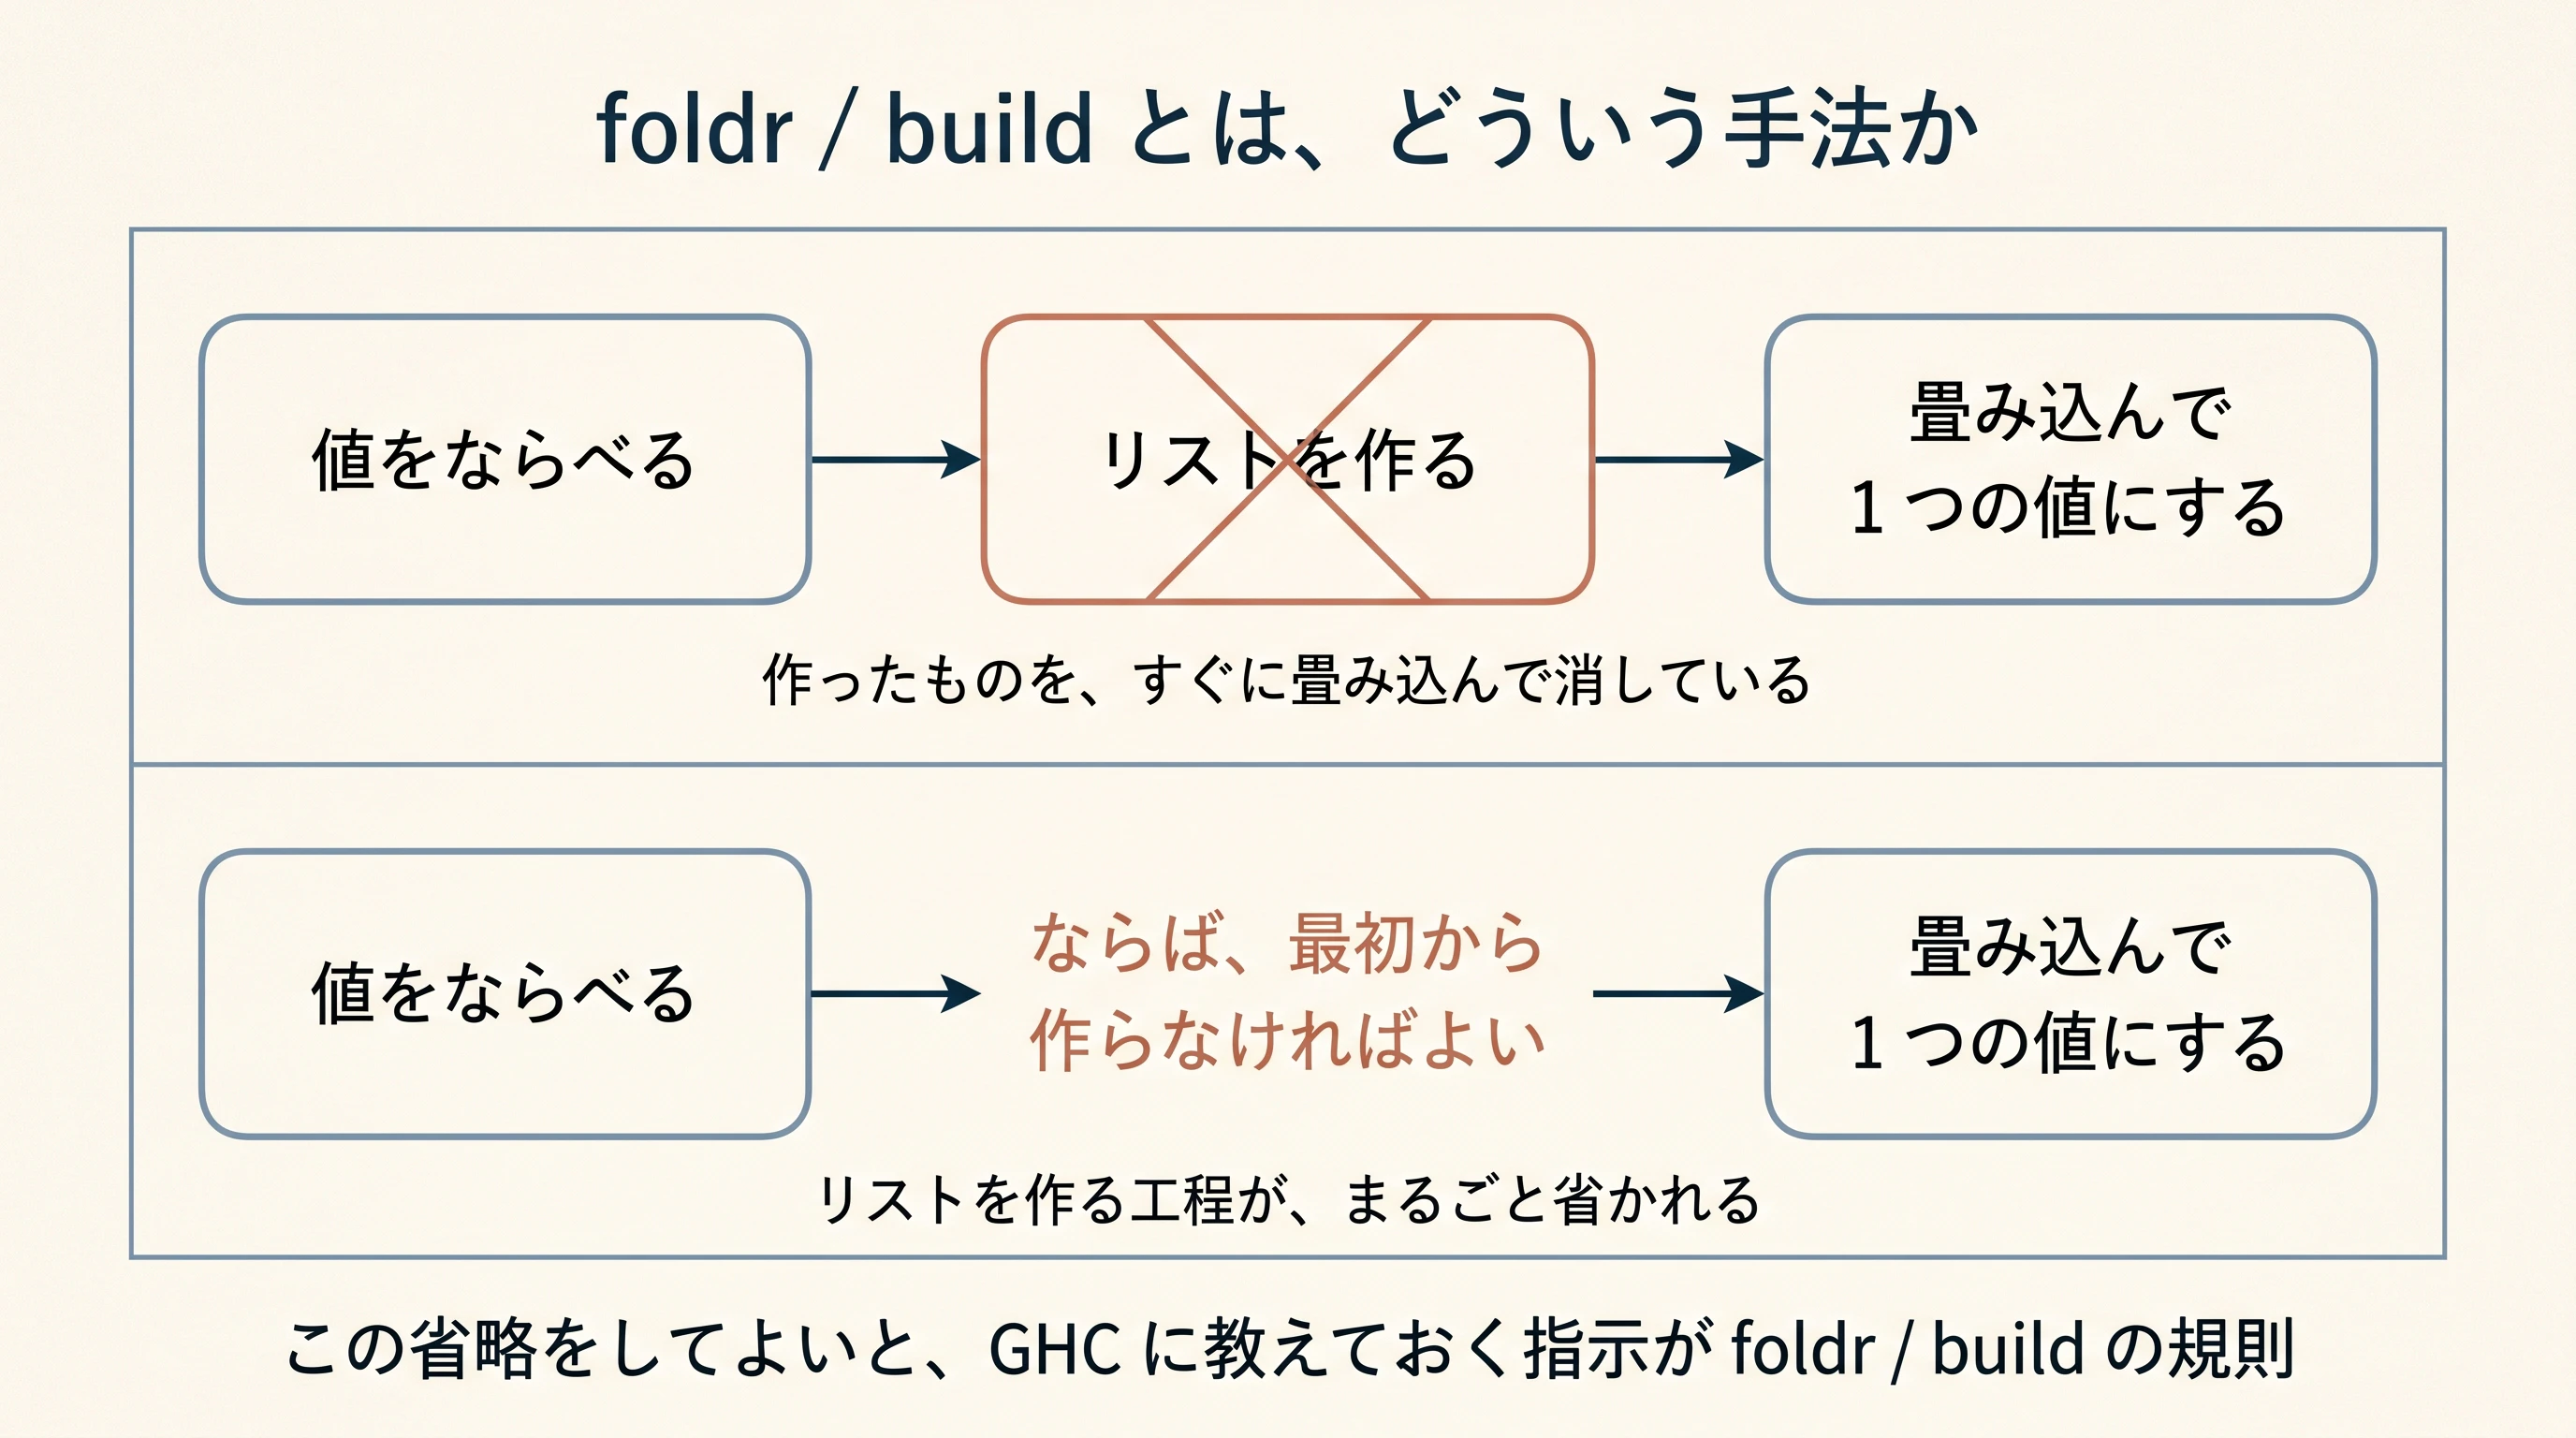
リストを作る処理と、リストを畳み込む処理が隣り合っていたら、リストを作る工程を省いてよい。
そうGHCに教えておく指示のこと です。
foldr/build とは、Gill・Launchbury・Peyton Jones が1993年の論文で提案した、Haskellのための最適化の手法 です。
リストを作る処理と、そのリストを畳み込む処理が隣り合っているとき、リストを作る工程をまるごと省いてしまう、という手法です。
- 作ったものを、すぐに畳み込んで消している。
- ならば、最初から作らなければよい。
そういう発想 です。
この手法は、圏論の言葉(始代数、catamorphism)で整理して理解することができます。
しかし、圏論から導き出された手法ではありません。
なお、Haskellにおいて、この手法が安全に使えることを保証しているもの は、圏論ではなく、自由定理( free theorem ) と呼ばれるもの です。
そして、この自由定理が成り立つ ためには、Haskellの型パラメータ(forall b. という記述) が関わってきます。
以下は、Haskellに限定した議論です。
ここで、自由定理 について、少し長くなりますが、できるだけわかりやすく解説します。
数学では、ある主張が正しいことを証明で示したとき、それを 定理 と呼びます。「三平方の定理」であれば、直角三角形の3辺について成り立つ等式が、証明を経て正しいと確かめられています。
プログラムについても、同じことが言えます。
「この関数とあの関数は、どんな入力に対しても同じ結果を返す」といった 主張は、証明できれば定理に なります。
具体例で見ていきます。
次の 型シグネチャ を持つ関数を考えてください。
f :: [a] -> [a]
リストを受け取って、リストを返す関数です。
ここで、型パラメータ a が使われています。
a に入る型は、具体的にどんな型なのかは、決まっていません。
関数 f について、次の 等式 が成り立ちます。
map g (f xs) = f (map g xs)
「f を通してから g で写す」のと、「g で写してから f を通す」のとは、どちらも同じ結果になるということを示す等式 です。
この等式は、f の中身が何であっても成り立ちます。
f が reverse であっても、tail であっても、take 3 であっても、あるいは誰かが書いた見たこともない関数であっても、成り立ちます。
ただし、この保証には条件があります。
条件が崩れるのは、seq という関数と、「底」(⊥) と呼ばれる特殊な値が絡んだときです。
ここで、「底」 とは、評価すると例外になるか、計算が終わらない値のことです。
undefined や無限ループがこれにあたります。
seq とは、評価の順序を強制する関数です。
この2つが揃うと、左辺では例外にならず、右辺では例外になる、といったことが起こりえます。
両辺の結果が食い違うのです。
詳しくは、本稿の第7章と第8章で扱います。
ここで、関数の型シグネチャを見るだけで、関数の具体的な中身を見ずに済むという点 に話を戻しましょう。
先ほどの議論のとおり、seq と底が絡まないかぎり、map g (f xs) = f (map g xs) という等式は成り立ちます。
この等式が成り立つことを確かめるために、関数 f の中身のコードを一行も読む必要がありません。
関数 f の型シグネチャ f :: [a] -> [a] を見るだけで、そう言い切れます。
ここで重要なのは、Haskellが言語の仕様設計(型システム)として、型パラメータ を採用しているという事実です。
Haskellでは、f :: [a] -> [a] のように型パラメータ a を使って関数を宣言できます。
この時点では、a がどの型になるか(整数型なのか文字列型なのか)は、まだ決まっていません。
つまり、関数 f は、リストの中身が何であるかを知りません。
そのため、sort のようにリストの中の個々の要素について、大小を比べて並べ替えることも、filter even のように条件で選り分けることもできません。
どちらも、中身が何であるかを調べる必要があるからです。
型 a には、順序が定義されていない型も、等値の判定ができない型も入りえます。
関数 f は、そうした型が渡された場合にも動く必要があります。
したがって、関数 f には、大小の比較や等値の判定処理を定義することはできません。
型 a が具体的にどの型であるのかを知らない状態で、関数 f にできるのは、何番目の要素をどこへ置くかを決めること だけです。
- 全部ひっくり返す。
- 先頭をいくつか捨てる。
- 同じものを2度並べる。
リストの中の個々の要素の中身を見ずに、関数 fにできることといったら、上記くらいしかありません。
いずれの操作も、リストの中の個々の要素が何であるかに関係なく、同じように行われるものです。
関数 f は、どの要素を何番目に置くかを、位置だけで決めています。
つまり、3番目の要素を先頭に持ってくると決めたなら、その3番目が 10 であろうと "abc" であろうと、必ず3番目のものを先頭に持ってきます。要素の3番目にある要素の型を知らずに、処理可能なのです。
ところで、map g は、リストの各要素を 関数 g で変換するだけであり、要素の位置を動かしません。
-
リストの並び順の位置を動かす操作
- リストの中の個々の要素を特定の関数
gで変換する操作
この2つは 互いに干渉しません。
互いに干渉しないので、どちらの操作を先に行っても、最終的に得られるリストは同じになります。
これが、map g (f xs) = f (map g xs) という等式が成り立つ理由です。
「型シグネチャだけから導かれる等式」という種類の主張のことを、自由定理 と呼びます。
ここでは、f :: [a] -> [a] と書いた時点で map g (f xs) = f (map g xs) という 等式が成立する という例を取り上げました。
自由定理が当てはまる等式は、他にもあります。
いくつか例を挙げます。
( 例1 )
f :: [a] -> a
リストを受け取って、その要素を1つ返す関数です。
この型からは、次の等式 が導かれます。
g (f xs) = f (map g xs)
( 例2 )
f :: [a] -> Int
リストを受け取って、整数を返す関数です。length のような関数がこれにあたります。
この型からは、次の等式 が導かれます。
f xs = f (map g xs)
リストの中身を g でどう変換しても、返ってくる整数は変わりません。
( 例3 )
f :: (a -> Bool) -> [a] -> [a]
条件を表す関数とリストを受け取って、リストを返す関数です。filter がこれにあたります。
この型からは、次の等式 が導かれます。
map g (f (p . g) xs) = f p (map g xs)
こうした議論を積み重ねてきたのは、数学者ではありません。
プログラミング言語理論を専門とする計算機科学者たちです。
ただし、その手法には数学が用いられています。
圏論と論理学の知見が用いられています。
| 年 | 誰が | 何を示したか |
|---|---|---|
| 1983年 | John C. Reynolds(カーネギーメロン大学) | 多相ラムダ計算の意味論を、関係を用いて定式化した |
| 1989年 | Philip Wadler(グラスゴー大学。Haskellの設計者の一人) | そこから等式を導く方法を示した |
プログラミング言語理論は、計算機科学の一分野です。数学の一分野ではありません。
しかし、その議論は数学の手法によって進められています。
以上、自由定理 について解説させていただきました。
ところで、この 自由定理 を使うためには、ある条件が必要となります。
その条件とは、Haskellの型システムに forall b. という型パラメータの機能が組み込まれていること、です。
型パラメータを持たない型システムを採用した言語 では、圏論の側で同じ整理ができたとしても、foldr/build の規則が「どんな場合にも安全である」と言い切る根拠が失われることになります。
つまり、こういうことです。
- 「この局面には、この圏論知見が使えそうだ」と思いついたとします。
- しかし、それが実際に使えるかどうかは、いま扱っている言語の型理論によって変わります。
- 同じ圏論の法則でも、言語が変われば、使える範囲が変わるのです。
本連載シリーズが、関数型言語と定理証明言語に属するそれぞれの言語について、各言語ごとに切り分けて、解説を行うのは、このような事情を考慮に入れたから です。
| 言語 | その言語の型理論 | 何が変わるか |
|---|---|---|
| Haskell | 多相型と型クラス。評価は非正格 | 底と seq により、恒等律が成り立たない |
| OCaml | 多相型。評価は正格 | 底の扱いが異なるため、成り立つ法則の範囲も異なる |
| Lean 4、Agda | 依存型。全域性が要求される | 底が存在しないため、法則がより素直に成り立つ |
関数型言語や定理証明言語をコーディングするとき、コード最適化の手法を考案する上で、圏論に関する数学知見を持ち合わせているだけでは、残念ながら、十分ではないのです。
「いま自分が選択している(関数型・定理証明)言語が採用する型システムとの関係で、その法則が本当に成り立つか」を確かめる必要があります。
そして、それを確かめる道具が、型理論です。
結論として、圏論と型理論の双方を視野に入れて初めて、関数型言語や定理証明言語をコーディングするとき、コード最適化の手法を考案することができるのです。
本記事の結論
-
圏論の法則は、設計の指針であるだけではありません。 その法則を根拠として人間が書いた書き換え規則が、コンパイラの中で実際の最適化に使われています
-
圏論が出すのは「この書き換えをしてよい」という許可です。 実際に書き換えるのはコンパイラです
-
Hask は、厳密には圏ではありません。
seqと⊥により、恒等律が破れています。筆者はこれを実機で再現しました
-
恒等律が成り立たないために、最適化が失敗した事例があります。 正しく停止していたプログラムが、動かなくなりました
-
それでも使えているのは、「底を含まない部分集合で考える」という約束のうえに立っているからです。 この約束が一定の条件のもとで正当化されることは、POPL 2006 の論文で示されています
-
最適化には2種類あります。 コンパイラが自動で行うものと、プログラマが圏論を知っていなければ到達できないものです
- 後者の例として、Codensity による約3300倍の高速化を実測しました。 これは定数倍の改善ではなく、計算量そのものが変わっています
読者の皆様にお伝えしたいこと
圏論は、コードを速くする魔法ではありません。
圏論 は、「この変形をしてよい」という根拠を与えるもの です。
その根拠なくして、コンパイラは最適化のための書き換えを行うことができません。
この書き換えについては、プログラマが手を動かさなくても、コンパイラが自動で行ってくれる書き換え変換もあります。
しかし、コンパイラが自動で担ってくれない書き換え変換 については、プログラマが圏論の知見と言語が採用している型理論に関する知識に裏打ちされた、「この場面はこう書き換えて問題ない」という確信をもって、最適化を行う必要 があります。
本記事の論旨展開
本稿(連載初回)で扱う最適化手法の一覧
◎印は、本文で実測つきで扱うものです。
| 手法 | 使う数学 | 何が起きるか | |
|---|---|---|---|
| ◎ | map の書き換え規則 | Functor 則 | 中間リストが消える |
| ◎ | foldr/build の書き換え規則 | 始代数、catamorphism | 生成と消費が1段階になる |
| ◎ | Difference List | 自己準同型のモノイド | 連結が $O(n^2)$ から $O(n)$ へ |
| Yoneda / CoYoneda | 米田の補題 |
fmap が関数合成になる |
|
| ◎ | Codensity | Kan 拡張 | bind の再結合が、漸近的に改善する |
| ◎ | Traversable | 自然性 | 走査の回数が減る |
| ◎ | bind の再結合 | Monad 則の結合律 | ネストが平坦になる |
| ◎ | foldMap | Monoid 準同型 | GHC が自動で書き換える |
| ◎ | Applicative による全エラー集約 | 積構造 | Monad にはできない |
| Church 符号化 | 始代数 | データを関数として表す | |
| worker/wrapper 変換 | 同型、随伴 | 速い表現で計算して戻す | |
| stream fusion | 余代数(coalgebra) |
zip や多段もまとめられる |
|
| Cayley 表現 | Cayley の定理 | モノイドを自己準同型へ埋め込む | |
| Free Monad と interpreter | 随伴 | 命令の融合、除去、再順序化 |
第1章 タロウくんの疑問から
前の記事を読んだ、という話
タロウくん:
先生、圏論って、Haskell や、Haskell 以外の関数型言語でエレガントなコードを書くときに、どう参照されているのですか?
Haskellのモナドなどの圏論由来の概念を解説したブログ記事や、市販書籍を読んでいても、Haskellをはじめとした関数型言語のコードの最適化を行うときに、圏論の知見がどう役立つのか、役立たせようと一念発起しても、具体的に圏論の知識をどうコードの組み方に役立てたらよいのか、具体的なイメージが持てなくて悶々としているんです。
いま、以下の記事を読んでいますが、理論的な一般論が書かれていて、具体的なコードの組み方と圏論知識をどう向き合わせるのかが、いま一歩、距離があるように思えてならないんです。
繰り返しになりますが、この記事では、理論的には書いてあることは理解できるのですが、じゃあ、僕が実際に何らかの定理証明言語で関数型プログラミングをするときに、具体的にどうやって、圏論で学んだ数学知識を洗練された、ムダのないコードの設計に落とし込むのか、オブジェクト指向のデザインパターンみたいなイメージに落とし込めないんです。
専任講師:
よく読まれましたね。
そして、その引っかかりは正しいのです。
タロウくん:
正しい、のですか。
専任講師:
あの記事が書いているのは、「熟練者の頭の中で、圏論がどう参照されているか」 です。
型シグネチャ を見た瞬間に、Functor か Applicative か Monad か、どれを選ぶかを判断する。
その判断の地図を、言語化した記事 です。
タロウくん:
はい。
読んでいて、そのあたりの記事の意図は理解できています。
「効果が互いに独立なら Applicative、前の結果に依存するなら Monad」という判断基準も、理解できました。
専任講師:
では、何が足りなかったのでしょうか。
タロウくん:
コードがどう書き換わるのか、どう書き換えるべきなのかが、コーディングの場面ごとに具体的なイメージとして頭の中に描けないんです。
何が足りなかったのか
タロウくん:
オブジェクト指向のデザインパターン だと、こうなっているじゃないですか。
-
Singleton なら、インスタンスを1つに限る。コードはこう書く。
- Observer なら、通知の仕組みを作る。コードはこう書く。
専任講師:
はい。
タロウくん:
でも圏論だと、「この状況では Applicative を使う」まではあるのに、そのあとが見えないんです。
-
Applicative を使うと、コードの書き方がどう変わるのか。
- 書き方が変わった結果、何が良くなるのか。
後者については、改善されたのは、コードの見た目が短くなった、ということだけなのでしょうか。
専任講師:
タロウくんが抱いている不満は、妥当なものです。
あの記事が扱っているのは、「型シグネチャを見た瞬間、どの構造を選ぶか」という判断 です。
記事の末尾に、8つの構造をまとめた表が置かれていました。
| 構造 | 解決する問い | 実務トリガー |
|---|---|---|
| Functor | 中身だけ変えたい |
f a を見て中身を変えたい |
| Applicative | 独立した複数の効果を合成 | 効果が互いに独立 |
| Monad | 前の結果で次を決める | 効果が前の結果に依存 |
| Traversable | 構造と効果を裏返す | 効果つきループ |
「効果が互いに独立なら Applicative、前の結果に依存するなら Monad」
この見極めが、あの記事の中心テーマでした。
タロウくん:
その判断までは、できるようになった気がします。
専任講師:
あの記事には、こういう場面が描かれていました。
『ユーザーIDのリストを受け取り、各IDをAPIで問い合わせる』
for ループを書きかけて、ふと手が止まる。
「これは traverse そのものではないか」と気づいて、十数行が一行に畳まれる。
タロウくん:
あの箇所は、印象に残っています。
専任講師:
しかし、そこで話が終わっているのです。
traverse fetchUser userIds と書けた。
では、その traverse を2回続けて書いたら、どうなるでしょうか。
タロウくん:
……2回、走査することになります。
専任講師:
そこを1回にまとめられます。
あの記事は、その事実を扱っていません。
タロウくん:
「Traversable を使う」と判断できても、そこから先は出てこない。
専任講師:
そういうことです。
最適化されたコードを書くには、別の知識が要ります。
-
traverse f xs >>= traverse gを、1回のtraverseにまとめる -
xs ++ ysという連結を、関数合成に持ち上げる - Free Monad の bind を、Codensity 経由の形に変える
いずれも、「どの構造を選ぶか」とは別の次元の話です。
タロウくん:
別の次元、ですか。
専任講師:
あの記事は、こう書いていました。
型シグネチャを見た瞬間、「これはどの構造か」「強さはどこまで要るか」を、ほぼ無意識のうちに判別しています。
判別まで、です。
判別したあと、コードをどう変形するか。そこは書かれていません。
タロウくん:
構造を選ぶ地図ではあっても、書き換えの手引きではなかった。
| 場面 | 過去記事が書いたこと | 過去記事が書かなかったこと | 本記事が書くこと |
|---|---|---|---|
| リストの各要素に、失敗しうる処理をかける |
for ループを traverse 一行に畳める |
その traverse を2回続けたときに、1回へまとめられること |
Traversable の融合。実測で約4.5倍(10-2) |
| リストを連結する | Monoid の <> で、まとめて扱える |
++ を左に重ねると、計算量が悪化すること |
Difference List。$O(n^2)$ から $O(n)$ へ。n=8,000 で約9,400倍(10-4) |
| Free Monad で bind を重ねる | Free Monad の背後に随伴がある | bind が左に偏ると、計算量が悪化すること | Codensity。約3,300倍から4,700倍(10-5) |
map を2回続ける |
Functor則という等式が成り立つ | その等式が、GHCの書き換え規則になっていること |
GHCのソースにある mapFB 規則を実機で確認(第3章) |
sum [1..10] と書く |
── | リストが作られないこと | foldr/build 融合。Coreの出力で確認(第2章・第4章) |
| 自由定理 | 型を書くだけで定理がついてくると紹介 | その定理が、コンパイラの最適化の根拠になっていること | 自由定理が foldr/build の安全性を保証する(第5章) |
専任講師:
タロウくんが最初に言っていたことを、もう一度確認しましょう。
圏論で学んだ数学知識を、洗練された、ムダのないコードの設計にどう落とし込むのか
この問いに答えるうえで、あの記事に何が足りなかったのか。
そこを整理します。
タロウくん:
お願いします。
専任講師:
まず、あの記事が何を目的としていたかを確かめます。
記事の冒頭に、こう書かれていました。
本記事がお伝えしたいのは、数学の理解ではありません。コードを書くときの思考そのものを、言葉にすることです。
つまり、あの記事の目的は「熟練者の頭の中を言語化すること」でした。
タロウくん:
たしかに、そう書いてありました。
専任講師:
さらに、こうも書かれています。
型シグネチャを見た瞬間、「これはどの構造か」「強さはどこまで要るか」を、ほぼ無意識のうちに判別しています。
判別の瞬間を描くこと。それがあの記事の主題です。
そして、その目的は達成されています。
タロウくん:
では、何が足りなかったのでしょうか。
専任講師:
「判別したあと、コードをどう変形するか」です。
表にします。
| 過去記事 | 本連載 | |
|---|---|---|
| 目的 | 熟練者の頭の中で、圏論がどう参照されているかを言語化する | 圏論の知見が、実際のコード最適化にどう使われているかを示す |
| 問い | 型シグネチャを見た瞬間、何を考えているか | その構造を選んだあと、コードをどう書き換えるか |
| 答えの形 | 8つの構造の地図 | 書き換えの前後と、実機の測定結果 |
| 検証 | 思考の言語化 | GHCのソース、Coreの出力、実行時間 |
| 扱う範囲 | 構造を選ぶところまで | 選んだ構造を使って、コードをどう書き換えるか |
タロウくん:
目的が、そもそも違うのですね。
専任講師:
そうです。そこを見誤ってはいけません。
あの記事は、不完全ではありません。
「熟練者の思考を言語化する」という目的のもとでは、過不足なく書かれています。
タロウくん:
僕が求めていたものが、あの記事の目的と違っていた。
専任講師:
そういうことです。
タロウくんが求めていたのは、「圏論の知識を、ムダのないコードの設計にどう落とし込むか」 でした。
それは、あの記事が答えようとした問いではありません。
タロウくん:
では、本連載は?
専任講師:
具体的な場面ごとに、次の3つを示します。
場面ごとの対応は、次のようになります。
| 場面 | 過去記事が書いたこと | 本連載が書くこと |
|---|---|---|
| リストの各要素に、失敗しうる処理をかける |
for ループを traverse 一行に畳める |
その traverse を2回続けたら、1回にまとめられる。実測で約4.5倍(10-2) |
| リストを連結する | Monoid の <> で、まとめて扱える |
++ を左に重ねると計算量が悪化する。関数合成に持ち上げれば $O(n)$ になる。n=8,000 で約9,400倍(10-4) |
| Free Monad で bind を重ねる | Free Monad の背後に随伴がある | bind が左に偏ると計算量が悪化する。Codensity で解消できる。約3,300倍から4,700倍(10-5) |
map を2回続ける |
Functor則という等式が成り立つ | その等式が、GHCの書き換え規則になっている。ソースコードで確認(第3章) |
sum [1..10] と書く |
── | 不要なリストを作らずに済む。Coreの出力で確認(第2章・第4章) |
| 自由定理 | 型を書くだけで定理がついてくる | その定理が、foldr/build の安全性を保証している(第5章) |
タロウくん:
「この場面では、こう書き換える」という形になっていますね。
専任講師:
タロウくんが求めていた、デザインパターンのような一覧に、最も近い形です。
そして、もう1つ付け加えます。
タロウくん:
何でしょうか。
専任講師:
あの記事は、Haskellだけを扱っていました。
本連載は、第2回からHaskell以外の言語へ進みます。
言語が変われば、同じ圏論の法則でも使える範囲が変わるからです。
タロウくん:
どういうことですか?
なぜ、言語が変わると使える圏論の法則がかわるんですか?
専任講師:
言語ごとに、採用している型理論が違うから です。
たとえば、本記事の第5章で扱う foldr k z (build g) = g k z という規則は、Haskellの型システムに forall b. という記述があるからこそ、安全に使えます。
型パラメータを持たない型システムの言語であれば、圏論の側で同じ整理ができたとしても、その規則が安全だと言い切る根拠が失われます。
タロウくん:
圏論の法則そのものは変わらないのに、使える範囲が変わる。
専任講師:
そういうことです。
第2回 では OCaml や Scala を、
第3回 では Lean 4 や Agda を扱います。
言語ごとに、圏論の法則をコードの最適化にどこまで使えるのかが変わってきます。
タロウくん:
そこまで含めて、はじめて「どう落とし込むか」の答えになる。
専任講師:
そのとおりです。
専任講師:
まさに、そこが本連載の出発点です。
以下のmermaid図をみてください。
前回の記事で書かれていたことが上半分、
この記事で新たに書くのは、下半分です。
タロウくん:
出発点、ですか。
専任講師:
まず、厳密な言い方をしておきます。
デザインパターンは、設計上の語彙です。
ある構造に名前を与え、開発者どうしの意思疎通を助けます。
これに対して、圏論の法則 は、等式です。
その等式があれば、コンパイラは計算の意味を変えずにコードを書き換えることができます。
タロウくん:
……すみません、ほとんど分かりませんでした。
用語の意味から教えていただけますか。
専任講師:
では、こう言い換えます。
デザインパターンは、人間が守る約束事です。
Singleton パターンを使おうと決めても、コンパイラは何もしてくれません。
コードを書くのは、あくまで人間です。
タロウくん:
そうですね。
専任講師:
ところが、圏論の法則は違います。
法則が成り立っていることを根拠に、コンパイラに書き換え規則を与えることができます。
タロウくん:
書き換え規則を与える、ですか?
専任講師:
そうです。
その書き換えは、あなたが気づかないところで、すでに行われています。
実例を知る
専任講師:
たとえば、この1行を書いたとします。
sum [1..10]
これを素朴に読むと、どうなりますか。
タロウくん:
えっと、まず [1,2,3,...,10] というリストが作られて、そのあと sum がそれを足し合わせる、でしょうか。
専任講師:
ふつうは、そう読みます。
ところが、GHC はリストを作りません。
タロウくん:
作らない。
専任講師:
いきなりループになります。
中間のリストは、一度もメモリに置かれません。
タロウくん:
なぜですか。
専任講師:
作ってすぐ壊すものは、最初から作らなくてよいからです。
タロウくん:
それは……分かる気もしますが、コンパイラは、どうやってそれを判断したのですか。
専任講師:
圏論の法則を使って判断しました。
タロウくん:
えっ。
専任講師:
あなたが探していた「具体的にどう落とし込むのか」の答えが、ここにあります。
圏論の知識は、設計の指針であるだけではありません。
圏論の法則を根拠として、人間が書いた書き換え規則が、コンパイラの中で実際の最適化に使われているのです。
デザインパターンとの違い
タロウくん:
つまり、こういうことですか?
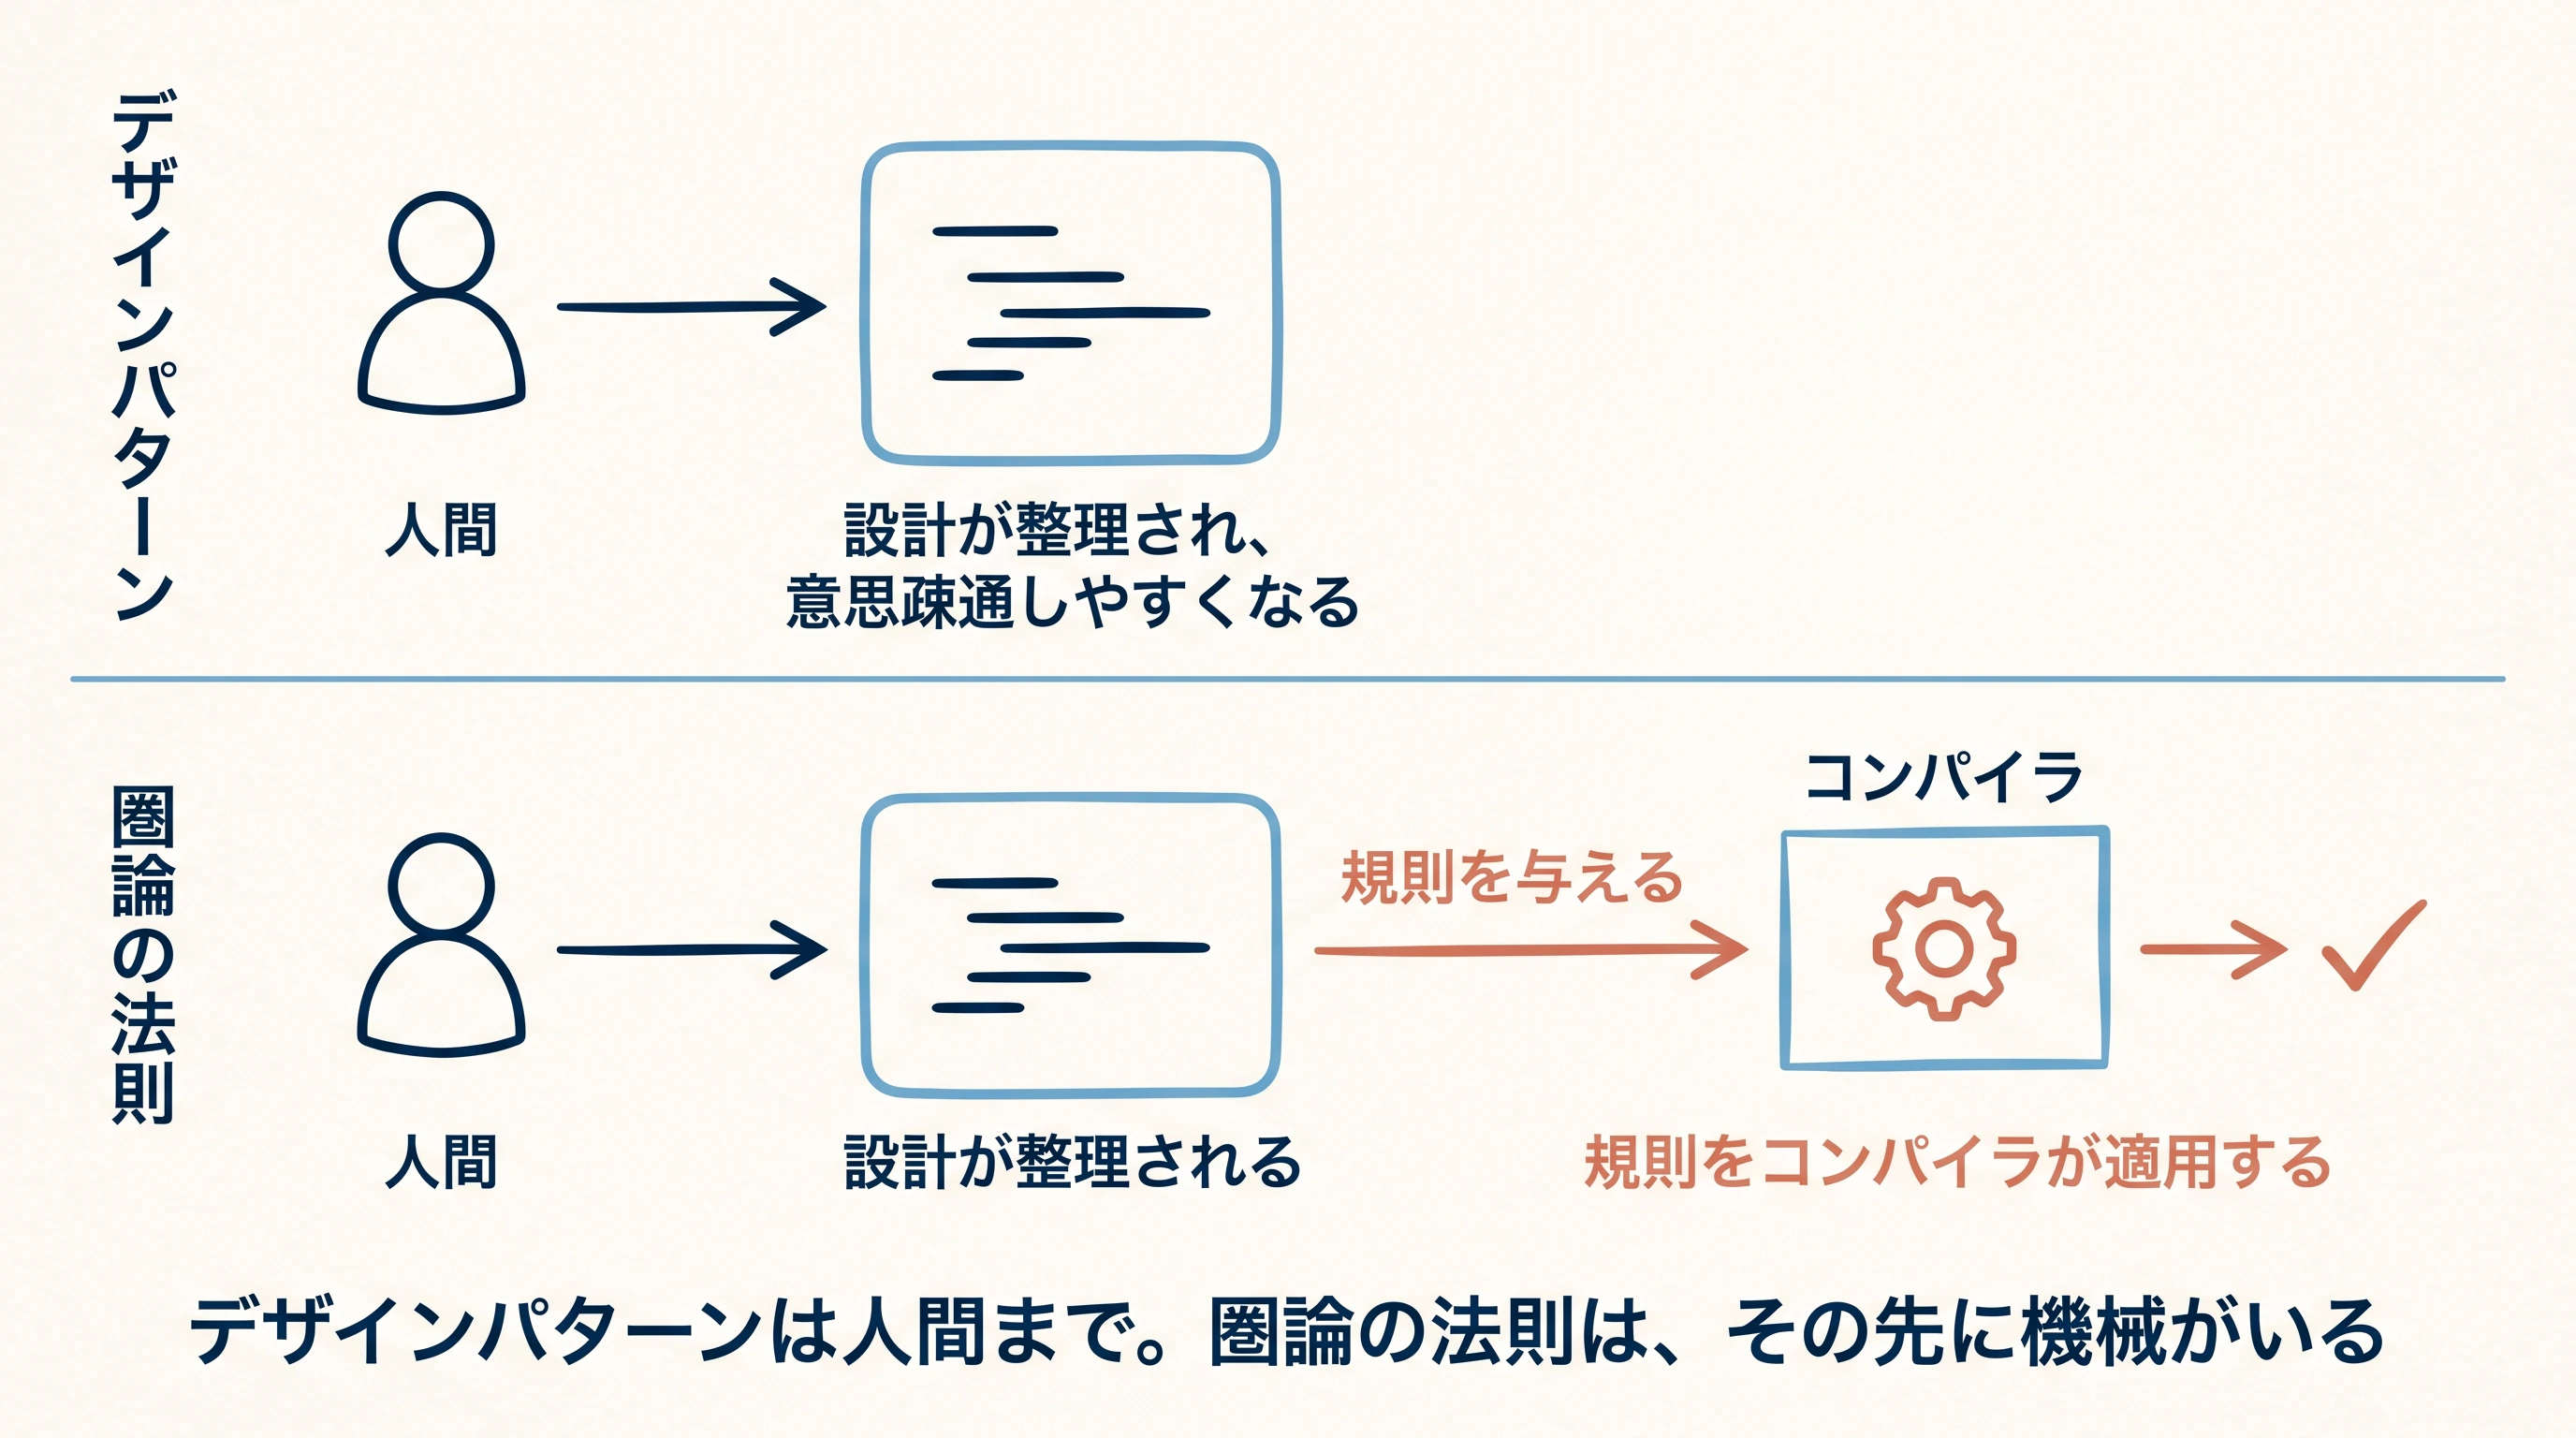
デザインパターン は、人間が読んで、人間が従うもの。
圏論の法則 は、人間が読んで書き換え規則を作り、コンパイラがそれに従う もの。
専任講師:
よい整理です。
より正確には、次のようになります。
| 誰が使うか | 何が起きるか | |
|---|---|---|
| デザインパターン | 人間 | 設計が整理され、意思疎通しやすくなる |
| 圏論の法則 | 人間とコンパイラの両方 | 設計が整理され、それを根拠にした規則をコンパイラが適用する |
タロウくん:
両方なんですね。
専任講師:
はい。
前の記事が書いていたのは、上の段です。
人間の側の話です。
本連載で扱うのは、下の段です。
専任講師:
ここまでは、コンパイラが自動的にHaskellの内部処理の最適化を行ってくれる場合の話 です。
コンパイラが自動で最適化をしてくれない場合 は、人間、つまりHaskellプログラマが、圏論の知見と、Haskellの型システム(型理論)の知見の双方の上にたって、Haskellの能力を十分に引き出した最適化を実現できるコードを組み上げる必要 があります。
最近は、Coding Agent を使ってコードを書いたり、実行した結果を検証するスタイルが当たり前になりつつありますから、プログラマがすべてを考えるというよりも、Coding Agentに対して、必要な知識(圏論知識と言語の型理論の知識)に裏打ちされた適切な質問や指示出しをしたり、必要な場面で「それ、おかしい」・「そうじゃない」といっただめだしをできるようになるべき、という事になると思います。
タロウくん:
AIに任せるにしても、判断できる知識は要る、ということですね。
専任講師:
そう考えています。
さらに、以下についても注意すべきです。
Coding Agentが、圏論にもとづく最適化を、人間の側から求めなくても、自動的に提案してくれる とは 限らないのです。
たとえば traverse を2回続けたコードを見せたとき、 「1回にまとめられます」と指摘が返ってくることもあれば、返ってこないこともあります。
タロウくん:
運任せになってしまう、ということですか。
専任講師:
LLMは確率論で動く(同じ入力に対して、毎回同じ出力が得られるとは限らないという意味で)から、「運任せ」という表現は、思った以上に事態を正確に言い当てているかもしれません。
運任せにしないために、プログラマの側から、AI Agentに対して積極的に、正確な知識と理解を踏まえた適切な問いを投げかける必要があるんです。
例えば、
「この2回の走査は、1回にまとめられないか」
AI Agentに対して、プログラマの側から自発的に、上記のような指示を出せるかどうかは、当のプログラマ自身が、Traversableの融合という手法を知っているかどうか にかかっています。
この場面で、プログラマがそもそも Traversable について未学習だった場合、上記のような問いがプログラムから発せられることはないでしょう。
そして、AI Agentも、「あれ?この局面で、Traversableについて、お尋ねになられないのですか?私から提案しましょうか?」とは、毎回必ず、AI Agentの側から「Traversableを活用した最適化提案」を提示してくれるとは、限らないのです。
(AI Agentの出力は確率論で決まるため)
タロウくん:
最適化を考える上で有用な圏論の知識 と、個々の関数型言語と定理証明言語が採用する型理論に関する知識を、これから教えていただけるのですね?
専任講師:
そういうことです。
但し、代表的な関数型言語と定理証明言語それぞれの言語について、最適化を考える為に有用と思われる圏論の知識と、各言語の型理論に関する知識を、すべてまとめてお伝えすることは私の手に余ります。
そのうちのごく一部について、私ができる範囲でお伝えする、ということになります。
今回も学ぶことが多いですが、見えてくる景色が一段、視野が上がりますので、根気強く、ひとつひとつ着実に理解して、積上げていきましょう。
本記事では、圏論の法則が実際のコード変換になっている例を、8種類 お見せします。
そのすべてについて、次の3つ を示します。
タロウくん:
「こういう状況では、こう書き換わる」という形ですか?
専任講師:
そのとおりです。
あなたが求めていた「デザインパターンのような一覧」に、最も近い形になるはずです。
注意すべき点
専任講師:
ところで、「圏論を使えば、Haskell が自動的に高速になる」ということはありません。
タロウくん:
違うのですか。
専任講師:
実際には、3つの段階を踏みます。
圏論が直接やってくれるのは、1段階目だけ です。
タロウくん:
「この書き換えをしてよい」という許可を出すのが、圏論の役割ということですね?
専任講師:
そのとおりです。
書き換え許可を出すのが圏論、実際に書き換えるのがコンパイラ。
この役割分担を、頭に入れておいてください。
もう1つの主題
専任講師:
そして、もう1つ。
この連載には、最初から最後まで通底する問いがあります。
タロウくん:
何でしょうか。
専任講師:
その書き換え許可は、本当に有効なのか、という問いです。
タロウくん:
どういう意味ですか?
専任講師:
圏論の法則が成り立っているから、書き換えてよい。
そう言いました。
では、その法則は、Haskell において 本当に成り立っているのでしょうか。
タロウくん:
成り立っていないことが、あるのですか。
専任講師:
あります。
しかも、そのせいで、正しく動いていたプログラムが動かなくなった事例が、実際にあります。
タロウくん:
えっ。
専任講師:
その話は、第7章と第8章で扱います。
まずは、うまくいっている例から見ていきましょう。
第2章 sum [1..10] は、リストを作らない
実機で確かめる
第1章で述べたことを、実際に確かめます。
次のファイルを用意します。
module Sum where

mysum :: Int
mysum = sum [1..10]
GHC には、最適化後の中間表現を出力する機能 があります。
Core と呼ばれる表現 です。
Terminal での実行
$ ghc -O2 -ddump-simpl -dsuppress-all -fforce-recomp Sum.hs
| 部分 | 何を指定しているか |
|---|---|
-O2 |
最適化を有効にする |
-ddump-simpl |
最適化後の Core を出力する |
-dsuppress-all |
型注釈などを省き、読みやすくする |
-fforce-recomp |
前回の結果を使わず、必ず再コンパイルする |
出力(抜粋)
mysum = case $wgo3 1# 0# of ww_s178 { __DEFAULT -> I# ww_s178 }
これだけです。
何が書かれているか
$wgo3 という関数を呼び、その結果を I# で包んでいます。
| 記法 | 何を意味するか |
|---|---|
$wgo3 |
GHC が生成したループ関数 |
1#、0#
|
箱に入っていない機械整数。初期値 |
I# |
機械整数を Int の箱に入れる |
リストが、どこにもありません。
[1..10] という記述は、コードから消えています。
GHCの書き換え規則を無効にすると、どうなるか
比べるために、GHCの書き換え規則を無効にしてみます。
Terminal での実行
$ ghc -O2 -fno-enable-rewrite-rules -ddump-simpl -dsuppress-all -fforce-recomp Sum.hs
-fno-enable-rewrite-rules は、GHC の書き換え規則をすべて無効にする指定です。
出力(抜粋)
Rec {
mysum_go3
  = \ x_a17i ->
      : (I# x_a17i)
        (case x_a17i of wild_X1 {
           __DEFAULT -> mysum_go3 (+# wild_X1 1#);
           10# -> []
         })
end Rec }

mysum
  = case integerToInt# mysum1 of wild_a138 { __DEFAULT ->
    case $wgo1 (mysum_go3 1#) wild_a138 of ww_s17x { __DEFAULT ->
    I# ww_s17x
    }
    }
リストが現れました。
タロウくん:
すいません、そのTerminalの出力結果を見て、どこにリストが記述されているのか、僕は理解できないです。
専任講師:
次の1行に注目してください。
: (I# x_a17i)
行頭の : が、リストを作っている記号です。
Haskell で 1 : 2 : 3 : [] と書くときの、あの : です。
タロウくん:
あっ、ここですか。
専任講師:
I# x_a17i の部分が要素です。
x_a17i はGHCが自動で付けた変数名ですので、名前そのものに意味はありません。
それを : でつないでいます。
そのあとの 10# -> [] で、リストの終わりを示しています。
リストが、実際に作られています。
タロウくん:
ちょっと自信がなくなってきました。
この出力結果の読み方って、Haskellの教科書や本やウェブ解説記事に書かれていますか?
専任講師:
Coreの読み方をまとめて解説した入門書は、ほとんどありません。
GHCの公式マニュアルには、出力オプションの一覧があります。
Coreという中間表現が何であるかを説明した資料も、いくつか存在します。
しかし、出力に現れる I# や $wgo3 といった記号の意味を、初学者向けに一覧にした資料は見当たりません。
タロウくん:
では、みなさんどうやって覚えるのですか。
専任講師:
必要に迫られて、少しずつ読めるようになる。 多くの場合、そうです。
ただし、今回の目的であれば、全部を読む必要はありません。
: があるかないか。それだけを見れば済みます。
本章の末尾にあるコラム「Core は『全部読む』より『痕跡を探す』」をご覧ください。
タロウくん:
LLMやCoding Agentに質問すれば事足りますか?
専任講師:
出力を貼り付けて「これは何ですか」と尋ねれば、記号の意味は返ってきます。
その点では、ずいぶん楽になりました。
タロウくん:
では、覚えなくてもいいということですか。
専任講師:
尋ねるべきことが分かっていれば、そうです。
しかし、「中間リストが残っていないか」を確かめたいと思わなければ、そもそも尋ねません。
何を確かめるべきかは、人間の側が決めることです。
2つの出力を比べる
さて、タロウくんと論じてきたリストですが、: という記号が関係しています。
: (I# x_a17i) (...)
これは、リストの構成子だということは、さきほどすでに説明しました。
Haskell で 1 : 2 : 3 : [] と書くときの、あの : です。
つまり、GHCの書き換え規則を無効にすると、実際にリストが作られています。
| 何が起きているか | |
|---|---|
| GHCの書き換え規則を有効にした場合 | ループのみ。リストが存在しない |
| GHCの書き換え規則を無効にした場合 |
: でリストを構成し、そのあと畳み込む |
同じソースコードから、まったく違うものが生成されました。
タロウくんの反応
タロウくん:
本当に消えていますね。
でも、なぜ消せるのでしょうか。
専任講師:
作ったリストを、すぐ壊すからです。
[1..10] がリストを作り、sum がそれを畳み込んで消す。
作って、すぐ壊す。
それなら、最初から作らなくてよい。
タロウくん:
言われてみれば、そのとおりです。
専任講師:
しかし、コンパイラがそれを判断するには、根拠が要ります。
コンパイラは、「作って壊しているから、省いてよい」と、どうやって知るのか。
その根拠が、圏論から来ています。
次章では、この点を取り上げます。
🔬 中上級者向けコラム:Core は「全部読む」より「痕跡を探す」
GHC の Core は、最適化後の中間表現です。
最初は $wgo3、I#、1# のような記号が並び、すべてを読まなければならないように見えるかもしれません。
しかし、性能を確認するだけなら、Core 全体を理解する必要はありません。
今回の目的なら、融合なしの出力に : が現れ、融合ありの出力には現れないことを見れば十分です。
: はリストの構成子ですから、その有無が「中間リストが残ったか」を教えてくれます。
慣れてきたら、次の3つを追うとよいでしょう。
| 記号 | 何を示すか |
|---|---|
case |
場合分け。評価の強制も含む |
$w... |
GHC が生成した worker 関数 |
Int# |
箱に入っていない機械整数 |
これらを追えるようになると、GHC がどのようにループへ落としているかが読めます。
Core は暗号ではありません。最適化の痕跡を探すための、観察記録です。
第3章 もっとも単純な例 ── map の融合
Functor 則から始める
専任講師:
Functor とは、圏から圏への対応であって、恒等射と合成を保つものです。
「合成を保つ」 とは、次の等式が成り立つこと を指します。
$$F(g \circ f) = F(g) \circ F(f)$$
タロウくん:
ひとつずつ、確認させてください。
$F$ というのは、何でしょうか。
専任講師:
Haskell では、fmap にあたります。
リストの場合、fmap は map です。
さきほどの等式を、Haskell に書き直します。
map (g . f) xs = map g (map f xs)
タロウくん:
あっ、これは分かります。
「f を全部に適用してから g を全部に適用する」のと、「g . f を全部に適用する」のが、同じということですね。
専任講師:
そのとおりです。
この等式が最適化になります。
なぜ最適化になるのか
右辺と左辺で、何が違うでしょうか。
| コードの書き方 | 何が起きるか |
|---|---|
map g (map f xs) |
xs を1回走査して中間リストを作り、それをもう1回走査する |
map (g . f) xs |
xs を1回走査するだけ |
右辺 では、中間リストが作られます 。
それに対して、左辺では、中間リストは作られません 。
等式として同じであるならば、左辺で計算したほうが有利 です。
実機で確かめる
次のファイルを用意します。
module MapMap where

f, g :: Int -> Int
f = (+1)
g = (*2)

test :: [Int] -> [Int]
test xs = map g (map f xs)
GHC には、どの書き換え規則が働いたかを表示する機能 があります。
| 部分 | 何を指定しているか |
|---|---|
-O2 |
最適化を有効にする |
-ddump-rule-firings |
どの書き換え規則が実際に働いたかを表示する |
-fforce-recomp |
前回の結果を使わず、必ず再コンパイルする |
MapMap.hs |
コンパイルするファイル名 |
Terminal での実行
$ ghc -O2 -ddump-rule-firings -fforce-recomp MapMap.hs
出力(抜粋)
Rule fired: map (GHC.Base)
Rule fired: map (GHC.Base)
Rule fired: fold/build (GHC.Base)
Rule fired: mapFB (GHC.Base)
Rule fired: mapList (GHC.Base)
5つの規則が、実際に発火("fired)しています。
出力の読み方を説明します。
| 部分 | 何を意味するか |
|---|---|
Rule fired: |
この書き換え規則が、実際に働いたことを示します |
map |
働いた規則の名前です |
(GHC.Base) |
その規則が書かれているモジュールの名前です |
つまり、Rule fired: map (GHC.Base) は、「GHC.Base モジュールに書かれている map という名前の規則が働いた」という意味です。
上から順に、働いた順序どおりに並んでいます。
map が2回現れるのは、もとのコードに map が2つあるためです。
この5つのうち、中間リストを消したのは、次の2つです。
| 規則 | 何をしたか |
|---|---|
fold/build |
build で作ったリストを foldr が畳み込む形を見つけ、リストを作る工程を消した
|
mapFB |
2つの関数 f と g を、1つの関数 f . g にまとめた
|
残る3つは、この2つが働けるように形を整える役割です。
| 規則 | 何をしたか |
|---|---|
map(2回) |
map を build と foldr の形に書き換えた |
mapList |
最後に、map の形に戻した |
タロウくん:
「実際に働いた」と書かれていますが、それは 何の指標で見て「働いた」と言えるのでしょうか。
実行速度ですか。メモリ消費量ですか。それとも、別の指標ですか。
専任講師:
最初の2つ両法です。
中間リストが消える ということは、そのリストのためにメモリを確保しなくて済むということです。
確保しないので、あとで解放する必要もありません。
ガベージコレクションの負担も減ります。
また、リストを1回走査する処理が、まるごと不要になります。
そのぶん、実行時間も短くなります。
タロウくん:
どれくらい短くなるのですか?
専任講師:
この例では、測っていません。
最適化の効果を実測値つきでお見せするのは、第10章です。
そこでは、約4.5倍から約9,400倍まで、手法によって差が出ます。
書き換えられたあとのコードを見る
Terminal での実行
$ ghc -O2 -ddump-simpl -dsuppress-all -fforce-recomp MapMap.hs
出力(抜粋)
test1
  = \ x_aAL ->
      case x_aAL of { I# x1_azk -> I# (+# 2# (*# 2# x1_azk)) }

test = \ xs_awS -> map test1 xs_awS
2つのことが起きています。
(1つ目)
map が1回になりました。
(2つ目)
(2つ目)
2つの関数が、1つにまとめられました。
+# 2# (*# 2# x)
これは $2x + 2$ です。
もとのコードは f = (+1)、g = (*2) でした。
$g(f(x)) = (x+1) \times 2 = 2x + 2$。
たしかに合っています。
関数の合成まで、計算済みの形に潰されています。
GHC のソースを見る
専任講師:
この規則は、GHC のソースコードに実際に書かれています。
確認しましょう。
出典:
GHC 9.4.7、libraries/base/GHC/Base.hs、1357〜1362行目
{-# RULES
"map"       [~1] forall f xs.   map f xs                = build (\c n -> foldr (mapFB c f) n xs)
"mapList"   [1]  forall f.      foldr (mapFB (:) f) []  = map f
"mapFB"     forall c f g.       mapFB (mapFB c f) g     = mapFB c (f.g)
"mapFB/id"  forall c.           mapFB c (\x -> x)       = c
  #-}
タロウくん:
4つありますね。
どれが、2つの map を1つにまとめる役割を担っているのでしょうか。
専任講師:
3番目です。
"mapFB" forall c f g. mapFB (mapFB c f) g = mapFB c (f.g)
右辺に f.g があります。
ここで、2つの関数が合成されています。
この規則の背後にあるのが、リストの Functor 則 です。
3段階で動いている
専任講師:
GHC は、3段階で map の融合を行います。
| 段階 | 規則 | 何をするか |
|---|---|---|
| 1 | "map" |
map を build/foldr の形に書き換える |
| 2 | "mapFB" |
mapFB の合成を潰す。ここで f . g が作られる
|
| 3 | "mapList" |
foldr/mapFB の形を、map に戻す |
さきほど発火した規則を、もう一度ご覧ください。
Rule fired: map (GHC.Base)       ← 段階1
Rule fired: map (GHC.Base)       ← 段階1(2つ目の map)
Rule fired: fold/build (GHC.Base)
Rule fired: mapFB (GHC.Base)     ← 段階2。ここで合成が起きる
Rule fired: mapList (GHC.Base)   ← 段階3
出力の順序が、そのまま3段階に対応しています。
GHC の開発者自身の言葉
専任講師:
この規則群には、長い注釈が付いています。
その最後の一文を、ご覧ください。
出典:
GHC 9.4.7、libraries/base/GHC/Base.hs、1322〜1355行目、Note [The rules for map]
Any similarity to the Functor laws for [] is expected.
筆者による日本語訳:
リストの Functor 則との類似は、意図されたものである。
タロウくん:
「意図されたもの」。
専任講師:
GHC の開発者自身が、この規則が Functor 則に由来すると明記しています。
つまり、圏論の法則が、コンパイラの中にそのまま入っているのです。
タロウくんが求めていた 「具体的にどう落とし込むのか」の、1つ目の答え です。
この章のまとめ
| 内容 | |
|---|---|
| 数学の法則 | $F(g \circ f) = F(g) \circ F(f)$ |
| Haskell | map (g . f) xs = map g (map f xs) |
| GHC の規則 | "mapFB" mapFB (mapFB c f) g = mapFB c (f.g) |
| 結果 | 中間リストが消え、2つの関数が1つにまとめられる |
表の中の4つの行は、いずれも同じことを言っています。
1行目が数学の知見、最下行がコンパイラの中身です
第4章 本丸 ── foldr/build による書き換え
第2章の答え合わせ
第2章で、sum [1..10] がリストを作らないことを見ました。
そのとき発火した規則の中に、次のものがありました。
Rule fired: fold/build (GHC.Base)
これが、本章の主題です。
まず、厳密な言い方から
専任講師:
リストの foldr は、始代数からの唯一の準同型射、すなわち catamorphism として理解できます。
一方 build は、リストの構成を、その構成子を抽象化した形で表現したものです。
両者の合成は hylomorphism をなし、中間のデータ構造を経由せずに計算できることが、始代数の普遍性から従います。
タロウくん:
すみません、ほとんど分かりませんでした。
用語の意味から教えていただけますか。
専任講師:
では、コードで見ましょう。
まず、GHC のソースに書かれている規則を、そのまま見て下さい。
出典:
GHC 9.4.7、libraries/base/GHC/Base.hs、1261〜1263行目
{-# RULES
"fold/build"    forall k z (g::forall b. (a->b->b) -> b -> b) .
                foldr k z (build g) = g k z
中心は、この1行です。
foldr k z (build g) = g k z
タロウくん:
左辺に foldr と build があって、右辺では両方とも消えていますね。
専任講師:
そのとおりです。
それが、この規則のすべてです。
build とは何か
build の定義は、次のとおりです。
build g = g (:) []
タロウくん:
g に、: と [] を渡しているだけに見えます。
専任講師:
そのとおりです。
リストを作る操作は、突き詰めると2つしかありません。
:    要素をつなぐ
[]   空のリストを置く
build は、この2つを「あとから差し込める形」にしておく仕組み です。
タロウくん:
差し込める、とは?
専任講師:
たとえば [1,2,3] は、本来こう書けます。
1 : (2 : (3 : []))
ここで、: と [] の部分に穴を開けます。
\c n -> c 1 (c 2 (c 3 n))
この形にしておけば、c と n に何を入れるかは、あとで決められます。
c に :、n に [] を入れれば、もとのリストに戻ります。
しかし、別のものを入れることもできます。
foldr とは何か
タロウくん
別のものとは、たとえば、どんなものですか?
専任講師:
c に +、n に 0 を入れてみてください。
(+) 1 ((+) 2 ((+) 3 0))
タロウくん:
1 + 2 + 3 + 0 で、6です。
リストを作らず に、リストのすべて要素の合計値が出ました。
専任講師:
それが foldr です。
foldr (+) 0 [1,2,3] = 6
foldr は、リストの : と [] を、別のものに置き換える操作 です。
2つを合わせると
専任講師:
では、foldr と build が隣り合ったら、どうなるでしょうか。
foldr (+) 0 (build (\c n -> c 1 (c 2 (c 3 n))))
build が : と [] を差し込んでリストを作り、foldr がそれを + と 0 に置き換え直す。
タロウくん:
二度手間ですね。
最初から + と 0 を差し込めばいい。
専任講師:
そのとおりです。
それが、この規則 です。
foldr k z (build g) = g k z
リストを作る工程が、まるごと消えます。
タロウくん:
このmermaid図はわかりやすいですね。
先生が最初に言われた、以下の数学の難しい文献に書いてありそうな文章は、このmermaid図に表現された図式を数学の言葉で表現したものですか?
『リストの foldr は、始代数からの唯一の準同型射、すなわち catamorphism として理解できます。
一方 build は、リストの構成を、その構成子を抽象化した形で表現したものです。
両者の合成は hylomorphism をなし、中間のデータ構造を経由せずに計算できることが、始代数の普遍性から従います。』
専任講師:
そのとおりです。
対応を並べてみましょう。
| 図で述べたこと | 数学の言葉 |
|---|---|
foldr が「:」と「[]」を別のものに置き換える |
foldr は catamorphism である |
build が「:」と「[]」を差し込む形にしておく |
build は構成子を抽象化した表現である |
| 差し込んで、すぐ置き換え直している | 両者の合成は hylomorphism をなす |
| だから、リストを作る工程を省いてよい | 中間のデータ構造を経由せずに計算できる |
| そう言い切れる根拠がある | 始代数の普遍性から従う |
タロウくん:
同じことを、2通りの言葉で述べていたのですね。
専任講師:
数学の言葉には、利点があります。
foldr と build だけでなく、他の構造についても同じ議論ができるようになります。
リストに限らず、木でも、その他のデータ構造でも。
タロウくん:
一般化できる、ということですか。
専任講師:
そのとおりです。
ただし、初めて読む人にとっては、図のほうが分かりやすい。
本連載では、両方を並べてお見せします。
タロウくん:
catamorphism 、 hylomorphism はどんな意味ですか?
専任講師:
用語のつくりから説明します。
| 語 | 前半の意味 | 何を指すか |
|---|---|---|
| catamorphism | cata = 下へ | 構造を 畳み込んで、1つの値にする操作 |
| anamorphism | ana = 上へ | 値から、構造を 組み立てる 操作 |
| hylomorphism | hylo = 素材 | 組み立ててから畳み込む、両者を合わせた 操作 |
いずれも、ギリシャ語に由来します。
タロウくん:
では、本章で見たものに当てはめると。
専任講師:
次のようになります。
| 用語 | 本章で見たもの |
|---|---|
| catamorphism |
foldr。リストを畳み込んで、1つの値にする |
| anamorphism |
build にあたるもの。リストを組み立てる |
| hylomorphism |
foldr (+) 0 (build g)。組み立ててから、畳み込む |
タロウくん:
hylomorphism が、まさに二度手間 の形ですね。
専任講師:
そのとおりです。
「組み立ててから畳み込む」という形に名前がついているからこそ、「その形を見つけたら、途中を省いてよい」と一般に論じることができるのです。
用語に戻る
専任講師:
それでは、いま解説した用語を含めて、用語の解説表をお見せします。
| 用語 | いま見たもの |
|---|---|
| catamorphism |
foldr。構造を畳み込む側 |
| anamorphism |
build にあたるもの。構造を作る側 |
| hylomorphism | 両者の合成。作ってから畳む |
| 始代数 | リストという構造を数学的に捉えたもの |
| 普遍性 | 「差し込み方が、ただ1通りに決まる」という性質 |
タロウくん:
「作ってすぐ壊すなら、作らなくていい」。
それだけのことですか。
専任講師:
考え方としては、それだけです。
ただし、「消してよい」と言い切るには根拠が要ります。
その根拠が、始代数の普遍性 です。
その普遍性がなぜ成り立つのか は、次章 で扱います。
用語は原語のまま
catamorphism、anamorphism、hylomorphism には、定着した日本語訳がありません。
和文の研究論文でも、原語のまま用いられています。
出典:
村田康佑、江本健斗「Coq における検証されたプログラム運算の拡張」、日本ソフトウェア科学会第35回大会講演論文集、2018年
http://jssst.or.jp/files/user/taikai/2018/PPL/ppl4-4.pdf
この論文でも、「始代数」は訳され、「catamorphism」は原語のままです。
本連載も、それに従います。
この最適化の原典
出典:
A. Gill, J. Launchbury, S. L. Peyton Jones, "A Short Cut to Deforestation", FPCA 1993, pp. 223–232.
doi: 10.1145/165180.165214
この論文が、foldr/build 融合を提案しました。
日本語では「融合変換」と呼ばれます。
出典:
「boost::proto を用いた融合変換機能付きライブラリの作成」、情報処理学会プログラミング研究会発表資料、2013年
融合変換は、複数の関数や繰り返しを1つにまとめることにより中間データを除去するプログラム変換である。
第5章 なぜ、この規則が正しいと言えるのか
残る疑問
タロウくん:
先生、ひとつ気になることがあります。
foldr k z (build g) = g k z という規則ですが、これはどんな g についても成り立つのでしょうか。
専任講師:
鋭い指摘ですね。
成り立たない g を与えたら、この規則は誤った書き換えをします。
タロウくん:
では、どうやって「大丈夫だ」と言えるのですか。
専任講師:
関数 g の型を見ます。
型が語ること
専任講師:
"fold/build"    forall k z (g::forall b. (a->b->b) -> b -> b) .
                foldr k z (build g) = g k z
関数 g の型に注目してください。
g :: forall b. (a -> b -> b) -> b -> b
タロウくん:
forall b とありますね。
専任講師:
そこがポイントになる部分です。
b は型パラメータです。
関数 g が呼び出される時点まで、b にどの型が入るかは決まっていません。
タロウくん:
それが、なぜ安全の根拠になるのでしょうか?
関数 g にできること
専任講師:
型が決まっていないと、関数 g にできることが限られます。
まず、関数 g は、b 型の値を自分で作り出すことができません。
どの型が入るか分からない以上、その型の値を書き下せない からです。
タロウくん:
たしかに、そうですね。
専任講師:
もう1つあります。
関数 g は、b 型の値がどのような中身を持つかを調べて、その中身に応じて処理を変えることもできません。
タロウくん:
では、関数 g には何ができるのですか。
専任講師:
受け取った2つの引数を使うことだけです。
関数 g が受け取るのは、次の2つです。
(a -> b -> b)    ここでは c と呼びます
b                ここでは n と呼びます
b 型の値を手に入れる方法は、この2つしかありません。
したがって、関数 g が書ける形は、次のようなものに限られます。
\c n -> c 1 (c 2 (c 3 n))
受け取った関数 c を、受け取った値 n に、何回か適用する。
この形しか書けないのです。
タロウくん:
1、2,3は何を意味していますか?
数値型の引数ですか?
専任講師:
この例では、そうです。
ここでは、[1, 2, 3] というリストを作る場合を想定しました。
そのため、1、2、3 という数値が並んでいます。
タロウくん:
では、文字列のリストの場合は、どうなりますか?
専任講師:
次のようになります。
\c n -> c "a" (c "b" (c "c" n))
タロウくん:
中身が変わるだけで、形は同じですね。
専任講師:
そのとおりです。
g の型は forall b. で始まっていますが、これは b についての話です。
リストの要素の型である a のほうは、g を書く人が決めます。
タロウくん:
a は決まっていて、b が決まっていない。
専任講師:
はい。
1、2、3 は a 型の値です。
そして c と n が、b 型に関わります。
関数 g が中身を調べられないのは、b のほうです。
foldr/build の書き換え規則が正しい理由
専任講師:
いま見た組み立て方は、c と n が何であるかに依存しません。
タロウくん:
依存しない、というのは?
専任講師:
c と n に何を渡しても、組み立ての形は変わらないということです。
関数 g は中身を調べられないのですから、渡されたものによって形を変えようがありません。
タロウくん:
あっ。
ここまで見てきたコードの変形を振り返ってみると、以下の順序をたどったんですよね?
まず最初に、以下の関数 g がありました。
g :: forall b. (a -> b -> b) -> b -> b
                ~~~~~~~~~~~~    ~    ~
                1つ目の引数 c   2つ目  返り値
                              の引数 n
そして、関数 g が受け取る2つの引数を、それぞれ c と n と呼ぶことにしました。
(a -> b -> b)    ここでは c と呼びます
b                ここでは n と呼びます
その結果、関数 g は、次のラムダ式(無名関数)に表現し直すことができます。
\c n -> c 1 (c 2 (c 3 n))
受け取った関数 c を、受け取った値 n に、何回か適用する。
build g は、c に : を、n に [] を渡すのでしたね。
そのあと foldr k z が、その : を k に、[] を z に置き換える。
専任講師:
そのとおりです。
差し込んだものを、あとで別のものに置き換えているだけです。
タロウくん:
だったら、最初から k と z を渡せばいい。
専任講師:
それが、この書き換え規則です。
foldr k z (build g) = g k z
組み立ての形が c と n に依存しないからこそ、最初から k と z を渡しても、結果は変わりません。
ここまでを振り返ると、結局いえることは、
リストを作る工程が、まるごと不要になる。
ということが見えてくると思います。
🔬 中上級者向けコラム:本章の議論を抽象化して解説する
本編では、foldr k z (build g) = g k z という規則がなぜ正しいのかを、対話形式で解説しました。
ここでは、同じ議論を、コードの計算過程をたどりながら確認します。
ここで、g は、2つの引数を受け取る関数です。
関数 gの1つ目の引数を c、2つ目の引数を n と呼びます。
g = \c n -> c 1 (c 2 (c 3 n))
build g とは、その g に : と [] を渡すことです。
build g = g (:) []
計算すると、リストが出来上がります。
build g
  = (:) 1 ((:) 2 ((:) 3 []))
  = [1,2,3]
ところで、2つの引数c と n に、別のものを渡せば、別の結果になります。
g (+) 0
  = (+) 1 ((+) 2 ((+) 3 0))
  = 6
そのため、同じ関数 g から、異なる引数を渡すことで、リストを得たり、合計値を得ることができます。
ここで、本章(第5章)の議論に戻ります。
専任講師とタロウくんが対話でたどり着いたのは、次の筋道でした。
関数 g の型に forall b. がある
    ↓
g は b 型の値を作れず、中身も調べられない
    ↓
g にできるのは、受け取った c と n を組み合わせることだけ
    ↓
組み立ての形は、c と n が何であるかに依存しない
    ↓
だから、最初から k と z を渡しても結果は同じ
これが、foldr k z (build g) = g k z という規則が正しいと言える理由です。
以下では、この筋道を、順を追って整理し直します。
1   build g は、c に「:」を、n に「[]」を差し込んで、リストを作る
2   foldr k z は、そのリストの「:」を k に、「[]」を z に置き換える
3   つまり、差し込んでおいたものを、あとから置き換えているだけ
4   だったら、最初から c に k を、n に z を差し込めばよい
型パラメータが必要なのは、4です。
5   4が言えるのは、g が「c と n に何が差し込まれたか」を
    区別できない場合に限る
6   g の型に forall b. と書かれているため、g は b 型の値を区別できない
7   したがって、c に「:」を差し込もうが k を差し込もうが、
    g は同じ手順で組み立てる
8   ゆえに、最初から k と z を差し込んでも、結果は変わらない
もし b が固定された型であれば、g は差し込まれたものを調べて、手順を変えられてしまいます。
その場合、4は成り立ちません。
タロウくん:
先ほどから 「中身を調べられない」 とおっしゃっていますが、それはどういう意味でしょうか。
b にどの型が入るか分からない、という意味ですか?
専任講師:
2つの意味があります。
| 何を知らないのか | |
|---|---|
| 1 |
b にどの型が入るかを知らない |
| 2 |
b 型の値が、具体的にどんな値なのかを見ることができない |
タロウくん:
違いがよく分かりません。
専任講師:
1は、型の話です。
b が整数なのか、文字列なのか、リストなのか。それが決まっていません。
2は、値の話です。
仮に整数が入ってきたとしても、その整数が 3 なのか 100 なのかを、関数 g は見ることができません。
タロウくん:
見ることができないと、何が困るのですか。
専任講師:
「もし 3 だったら、こうする」という処理が書けません。
値を見て処理を変えることが、できないのです。
タロウくん:
ここで問題になっているのは、どちらですか。
専任講師:
2のほうです。
b にはどんな型が来るか分からない以上、関数 g は、b 型の値がどんな値なのかを見て、処理を変えることができません。
だから、c と n に何を渡しても、関数 g は同じ処理を行います。
これを、パラメトリシティ(parametricity)と呼びます。
パラメトリシティが成り立つときには、map g (f xs) = f (map g xs) のような等式が導き出せます。
第5章で見てきた設例の場合は、foldr k z (build g) = g k z のような等式を導き出しました。
この等式のことを、自由定理(free theorem)と呼びます。
Reynolds の抽象化定理 に由来します。
タロウくん:
「自由」というのは?
専任講師:
証明の手間がかからない、という意味です。
Wadler の論文の題名が、そのまま答えになっています。
出典:
P. Wadler, "Theorems for free!", FPCA 1989, pp. 347–359.
doi: 10.1145/99370.99404
要旨からの引用
From the type of a polymorphic function we can derive a theorem that it satisfies. Every function of the same type satisfies the same theorem. This provides a free source of useful theorems, courtesy of Reynolds' abstraction theorem for the polymorphic lambda calculus.
筆者による日本語訳:
多相関数の型から、それが満たす定理を導くことができる。
同じ型を持つすべての関数が、同じ定理を満たす。
多相ラムダ計算に対する Reynolds の抽象化定理のおかげで、これは有用な定理をただで供給してくれる。
自由定理は、圏論の概念なのか
タロウくん:
先生、ひとつ確認させてください。
自由定理は、圏論の概念なのでしょうか?
専任講師:
圏論の概念ではありません。
タロウくん:
そうなのですか。
本連載は圏論の話だと思っていました。
専任講師:
自由定理が生まれたのは、型理論と意味論の分野です。
系譜を示します。
| 何か | 分野 | |
|---|---|---|
| Reynolds の抽象化定理(1983年) | 型パラメータを持つ関数は、どの型が来ても同じ処理を行う。このことを数学的に定式化した | 型理論・意味論 |
| パラメトリシティ | 上の定理が述べている、型についての性質 | 型理論 |
| 自由定理(Wadler 1989年) | パラメトリシティから導かれる等式 | 型理論 |
いずれも、圏論の側から出てきたものではありません。
タロウくん:
では、圏論とは無関係なのですか。
専任講師:
間接的には、関係があります。
パラメトリシティの意味論は、関係を扱う圏を使って与えられます。
Reynolds の抽象化定理そのものが、関係による意味論です。
また、forall b. ... という型は、圏論的には端(end)として解釈できます。
タロウくん:
つながってはいるのですね。
専任講師:
ただし、自由定理を使うのに圏論は要りません。
Wadler の論文も、圏論を使わずに書かれています。
タロウくん:
では、なぜ本記事で扱ったのでしょうか。
専任講師:
第3章と第4章で使った Functor 則と foldr/build の書き換え規則は、圏論の法則でした。
しかし、その法則が Haskell で本当に成り立つかどうかは、圏論だけでは決まりませんでした。
タロウくん:
圏論が「この変形をしてよい」と言っても、Haskell の側でそれが成り立つ保証が別途必要である、ということでしたよね?
専任講師:
そのとおりです。
しっかりと覚えていますね。
その保証を与えているのが、型理論の側から来た自由定理です。
Haskellの場合、型パラメータが言語仕様として定義済みであるという事 が、具体的な条件になりました。
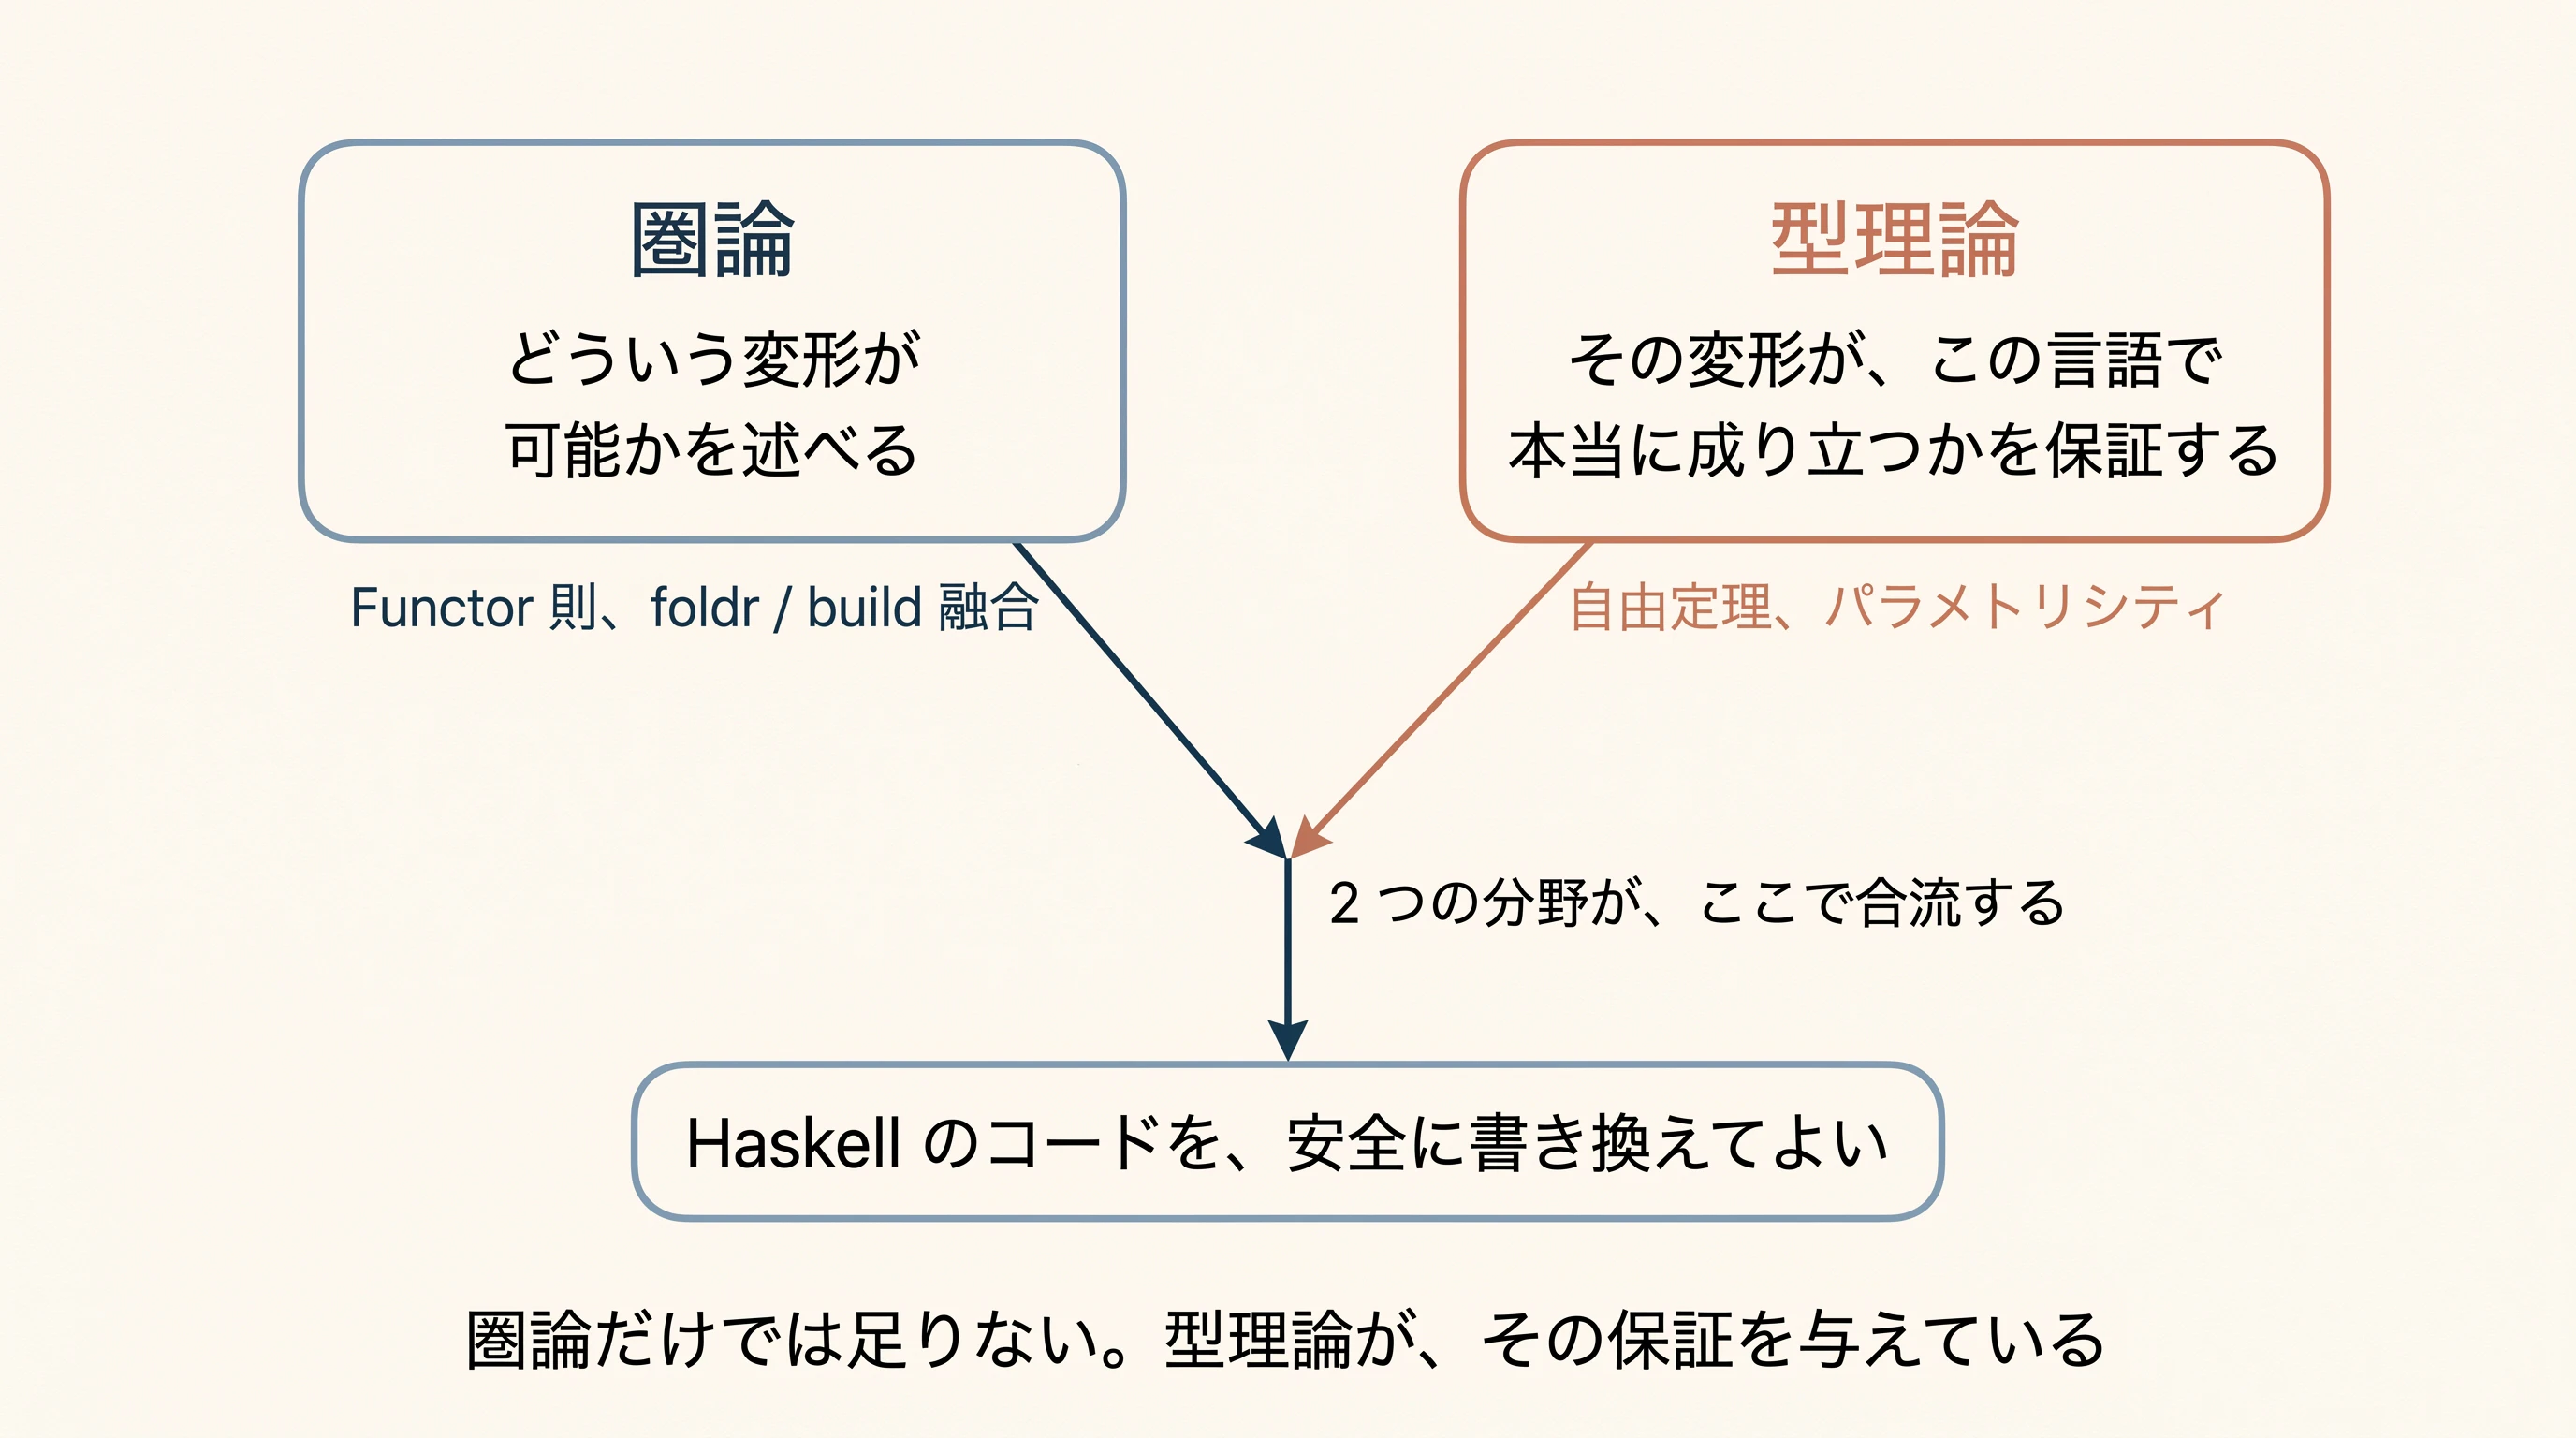
| 最適化に登場する2つの理論 | 各理論が最適化にどう関わるか |
|---|---|
| 圏論 | どういう変形が可能かを述べる |
| 型理論 | その変形が、この言語で本当に成り立つかを保証する |
2つの分野が、ここで合流しています。
タロウくん:
そうすると、この画像の左半分の「圏論」の数学知見としては、この局面で必要なコードの最適化には、この圏論知見が使えそうだ、と思いついたとしても、画像の右半分の「いま扱っている(関数型 or 定理証明)言語が採用する型理論で次第で、その圏論知見を使えるのか、使えないのか、が、言語ごとに変わる、ということ ですか?
専任講師:
まさに、そのとおりです。
圏論の法則は、言語によらず成り立ちます。
しかし、その法則を実際のコードに当てはめてよいかどうかは、その言語の型理論が決めます。
タロウくん:
言語ごとに、答えが違う。
専任講師:
具体例で説明しましょう。
本稿で扱った foldr k z (build g) = g k z という規則は、Haskellの型システムに forall b. があるからこそ成り立ちました。
型パラメータを持たない言語であれば、この規則は使えないのです。
タロウくん:
そうなりますよね。
となると、他の言語では・・・
専任講師:
第2回と第3回で向き合うが、まさにその問いです。
| 言語 | その言語の型理論 | 何が変わるか |
|---|---|---|
| Haskell | 多相型と型クラス。評価は非正格 | 底と seq により、恒等律が成り立たない |
| OCaml | 多相型。評価は正格 | 底の扱いが異なるため、成り立つ法則の範囲も異なる |
| Lean 4、Agda | 依存型。全域性が要求される | 底が存在しないため、法則がより素直に成り立つ |
同じ圏論の法則でも、言語が変われば使える範囲が変わります。
「その言語で、その法則が本当に成り立つか」を確かめる必要があります。
そして、それを確かめる道具が、型理論です。
タロウくん:
圏論だけでは、足りないのですね。
専任講師:
そういうことです。
第7章では、「型パラメータがあるから、この書き換えをしても安全だ」と言えなくなる場面 を 具体的に 取り上げます。
具体的には、undefined のように評価すると例外になる値 と、seq という評価の順序を強制する関数 が 組み合わさった場合 です。
seq は、値の中身ではなく 「その値が今すぐ評価できる形かどうか」 を調べることができます。
そのため、「どの型が来ても同じ処理を行う」という前提が崩れてしまう のです。
自由定理の意義
タロウくん:
型シグネチャを書いただけで、等式が1つ手に入る。
専任講師:
そういうことです。
通常、プログラムの性質を証明するには、実装を読んで、1つずつ確かめます。
ところが、パラメトリシティ が効く場合は、実装を読む必要がありません。
型さえ分かれば、その型を持つすべての関数について、同じ定理が成り立ちます。
タロウくん:
実装を読まずに、性質が分かる。
専任講師:
だからこそ、コンパイラが自動で書き換えられるのです。
人間が1つずつ「この g は大丈夫か」と確かめていたら、間に合いません。
型を見るだけで判断できるから、規則として自動化できます。
ここまでの整理
型              forall b. (a -> b -> b) -> b -> b
    ↓ パラメトリシティ
性質            b の中身を調べられない。受け取ったものを組み立てるしかない
    ↓ 自由定理
等式            foldr k z (build g) = g k z
    ↓ GHC の RULES
実際の書き換え   中間リストが消える
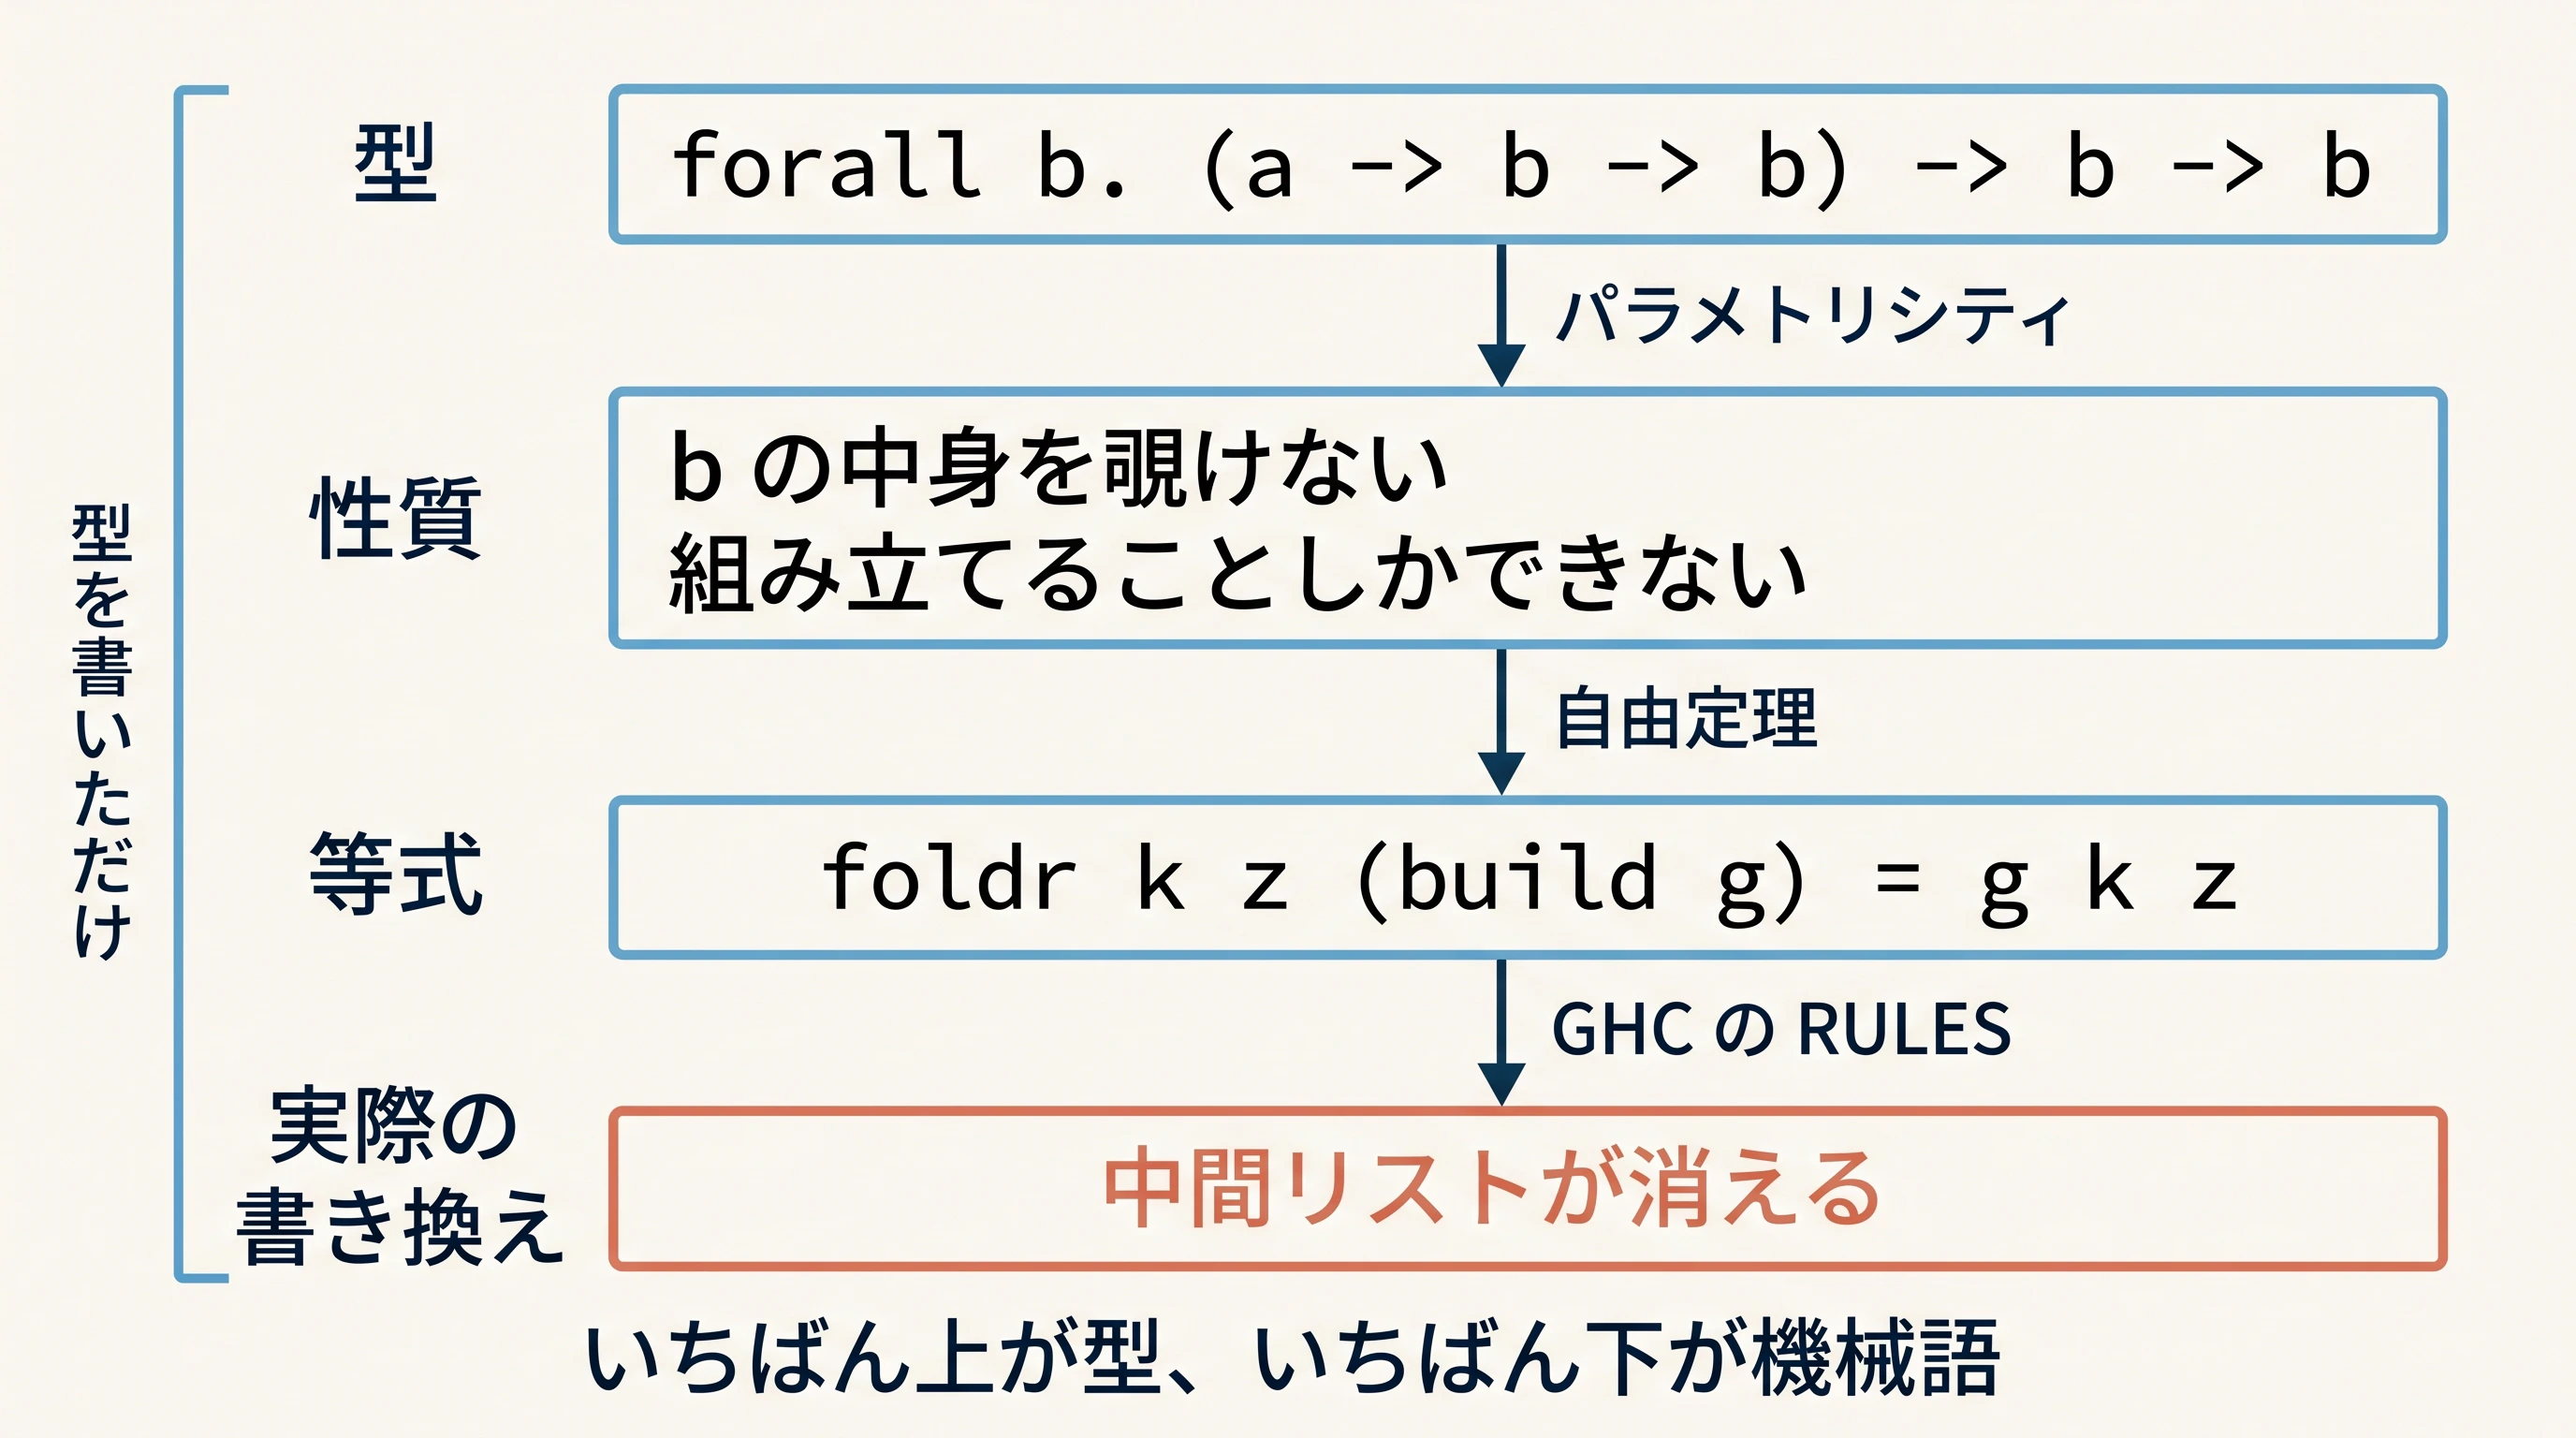
上から下へつながっています。
いちばん上が型、いちばん下が機械語です。
第6章 Hask 圏の登場
そろそろ、圏の話へ
専任講師:
ここまで、Functor 則と始代数という言葉を使ってきました。
どちらも、圏論の用語 です。
そろそろ、その土台を見ておきましょう。
タロウくん:
圏 、というのは何でしょうか。
専任講師:
まず、厳密な言い方をしておきます。
圏 とは、対象の集まりと、対象のあいだの射の集まりからなり、次の2つを満たすものです。
射の合成が定義されていて、結合律を満たす
各対象に恒等射があり、合成について単位元として働く
タロウくん:
いったん、専門用語を使わずに説明していただけますか。
専任講師:
点と矢印です。
点が対象、矢印が射です。
矢印はつなぐことができます。
また、つなぐ順序は結果に影響しません。
そして、各点には「何もしない矢印」がある。
それだけです。
Haskell で考える
専任講師:
Haskell では、次のように対応します。
| 圏論 | Haskell |
|---|---|
| 対象 | 型 |
| 射 | 関数 |
| 合成 | (.) |
| 恒等射 | id |
この圏を、Hask と呼びます。
タロウくん:
型が点で、関数が矢印ですか。
専任講師:
そのとおりです。
f :: A -> B
g :: B -> C
この2つがあれば、合成できます。
g . f :: A -> C
そして、各型には id があります。
id :: A -> A
id x = x
標準ライブラリにも入っている
専任講師:
Haskell の標準ライブラリには、Category という型クラスがあります。
class Category cat where
    id  :: cat a a
    (.) :: cat b c -> cat a b -> cat a c
圏の定義が、そのまま型クラスになっています。
タロウくん:
本当に、圏論がそのまま入っているんですね。
満たすべき法則
専任講師:
圏であるためには、次の3つが成り立たなければなりません。
id . f = f          左恒等律
f . id = f          右恒等律
(h . g) . f = h . (g . f)    結合律
タロウくん:
どれも、当たり前に見えます。
id は何もしないのだから、合成しても変わらない。
専任講師:
そう見えますね。
では、次章で確かめてみましょう。
タロウくん:
……確かめる、のですか。
専任講師:
はい。実際に動かします。
第7章 Hask は圏ではない
実際に動かしてみる
次のファイルを用意します。
import Control.Exception

idF :: a -> a
idF x = x

main :: IO ()
main = do
  r1 <- try (evaluate (seq (undefined :: ()) ())) :: IO (Either SomeException ())
  putStrLn $ "seq undefined ()        = " ++ either (const "bottom") show r1
  r2 <- try (evaluate (seq (undefined . idF :: () -> ()) ())) :: IO (Either SomeException ())
  putStrLn $ "seq (undefined . id) () = " ++ either (const "bottom") show r2
何をしているか説明します。
| 部分 | 何をするか |
|---|---|
undefined |
評価すると例外になる値。底(⊥)と呼ばれます |
seq a b |
a を先に評価してから、b を返す |
try と evaluate
|
例外を捕まえて、Either として受け取る |
seq undefined () は、undefined を先に評価しようとします。
したがって、例外になるはずです。
では、seq (undefined . id) () はどうでしょうか。
タロウくん:
undefined . id は undefined と同じはずですから、やはり例外だと思います。
専任講師:
動かしてみましょう。
Terminal での実行
$ runghc Seq.hs
出力
seq undefined ()        = bottom
seq (undefined . id) () = ()
何が起きたか
タロウくん:
出力結果が異なります。
下は、例外になっていません。
専任講師:
そうです。
() が返っています。
タロウくん:
なぜでしょうか。
undefined . id は undefined と同じはずです。
専任講師:
同じではないのです。
理由
専任講師:
undefined . id を展開してみてください。
undefined . id = \x -> undefined (id x)
タロウくん:
ラムダ式になっています。
専任講師:
そのとおりです。
undefined そのものは、評価すると例外になります。
ところが \x -> ... は、関数です。
関数は、それだけで1つの値として扱われます。
中身を評価しなくても、関数であることは確定しています。
タロウくん:
だから seq が通ってしまう。
専任講師:
はい。
seq は、関数の中身までは評価しません。
恒等律が破れる
さきほどの出力結果を、もう一度見てみましょう。
seq undefined ()        = bottom
seq (undefined . id) () = ()
この2つが違うということは、次を意味します。
$$\mathtt{undefined} \circ \mathtt{id} \neq \mathtt{undefined}$$
右恒等律が、成り立っていません。
タロウくん:
ということは・・・Hask は、圏ではないということですか?
専任講師:
そう結論づけざるをえません。
「Hask圏は圏ではない」は周知の事実
専任講師:
この事実を指摘したのは、Andrej Bauer です。
2016年のブログ記事によります。
出典:
A. Bauer, "Hask is not a category", 2016年
https://math.andrej.com/2016/08/06/hask-is-not-a-category/
引用
It is then immediately noticed that there is a problem because the supposed identity morphisms do not actually work correctly:
seq undefined () = undefinedandseq (undefined . id) () = (), therefore we do not haveundefined . id = undefined.
筆者による日本語訳:
ここで直ちに問題が見つかる。
恒等射であるはずのものが、実際には正しく働かないのである。
seq undefined () = undefined であるのに対し seq (undefined . id) () = () であるから、undefined . id = undefined が成り立たない。
筆者は、これを実機で再現しました。
さきほどの出力が、それです。
原因は2つ
| 原因 | 何が問題か |
|---|---|
| 底(⊥) | すべての型に、評価できない値が存在する |
seq |
評価の順序を強制できるため、⊥ と ⊥ でないものを区別できてしまう |
この2つが揃うと、恒等律が破れます。
HaskellWiki も、これを認めている
出典:
HaskellWiki, "Hask"
https://wiki.haskell.org/Hask
引用
Because of these difficulties, Haskell developers tend to think in some subset of Haskell where types do not have bottom values.
筆者による日本語訳:
こうした困難があるため、Haskell の開発者は、型が底の値を持たないような Haskell の部分集合の中で考える傾向がある。
タロウくん:
「考える傾向がある」。
つまり、そう思うことにしている、ということですか。
専任講師:
そうです。
Hask圏 とは、「底を含まない Haskell の一部分」を指して、そう呼んでいるもの です。
タロウくん:
それで、大丈夫なのでしょうか。
専任講師:
そこが、本記事(この連載初回記事)の中心的な問いです。
次章で、大丈夫でなかった事例をご覧いただきます。
🔬 中上級者向けコラム:なぜ `seq` は何度も話題になるのか
この章で seq が特別なのは、関数に入力を渡したときの結果だけでなく、「その値が今すぐ評価できる形か」まで観測できるからです。
undefined は、評価すると失敗します。
一方、\x -> undefined (id x) のようなラムダ式は、中身を実行すれば失敗しますが、式そのものはひとまず関数値として存在します。
seq は、この違いを見分けられます。
ふつうの関数には、できないことです。
ふつうの関数は、引数を受け取って結果を返すだけです。
「引数が、いまどういう形をしているか」は見られません。
seq だけが、それを見られます。
だからこそ、seq は次の話題で繰り返し登場します。
- 非正格評価
- 最適化
- 自由定理
- 関数の等しさ
いまは「seq は評価のタイミングを観測できる、例外的に強い関数」と覚えれば十分です。
さらに進むときのキーワードは、WHNF(弱頭部正規形)、観測同値、η変換 です。
第8章 最適化が失敗した事例
机上の空論(理論の世界だけの話)ではない
専任講師:
第7章で見た恒等律の破綻は、机上の空論ではありません。
GHCが最適化を行った結果、正しく動いていたプログラムが動かなくなった事例 が知られています。
タロウくん:
動かなくなった、というのは?
専任講師:
HaskellWiki の記述を、そのまま引きます。
出典:
HaskellWiki, "Correctness of short cut fusion"
https://wiki.haskell.org/Correctness_of_short_cut_fusion
引用
There has been at least one occasion where, as a result, a safely terminating program was turned into a failing one "in the wild", with a less artificial example than the ones given above.
筆者による日本語訳:
その結果として、安全に停止するプログラムが失敗するプログラムに変わってしまった事例が、少なくとも1度は実際に起きている。しかも、上に挙げたような人工的な例よりも、ずっと自然な例においてである。
何が起きたのか
タロウくん:
正しく動いていたプログラムが、コンパイラの最適化によって壊れた。
そういうことですか。
専任講師:
そのとおりです。
第4章で見た foldr/build の書き換え規則が、誤った書き換え をしてしまったのです。
タロウくん:
でも、第5章で「自由定理が保証する」とおっしゃいました。
専任講師:
保証するのは、底がない場合です。
底と seq が入ると、自由定理そのものが成り立たなくなります。
順序の整理
ここまでの議論を、逆向きにたどってみます。
最適化が失敗した
    ↑
自由定理が成り立たなかった
    ↑
パラメトリシティが成り立たなかった
    ↑
底(⊥)と seq が存在する
    ↑
Hask が圏ではない
いちばん下の事実が、いちばん上の事故を引き起こしました。
タロウくん:
理論の話が、そのまま実害になっている。
専任講師:
そういうことです。
第1章で見たことを、思い出してください。
圏論が出すのは「この書き換えをしてよい」という許可です。
その許可が、無効だったのです。
記事の主題が、ここで裏返る
専任講師:
本記事は、ここまで「圏論の法則が最適化の根拠になる」と述べてきました。
しかし、法則が成り立たない場所では、その根拠が崩れ去ってしまいます。
その場合、根拠が崩れてしまっていることに気づかないままに、書き換えが行われると、プログラムが壊れてしまう のです。
タロウくん:
では、いま使っている GHC は、大丈夫なのでしょうか。
専任講師:
その質問には、次章で答えることにしましょう。
第9章 Haskは圏ではないのに、Haskellはなぜ圏論にもとづく最適化を使えるのか
専任講師:
ここまでで、2つのことが分かりました。
それにもかかわらず、GHC の書き換え規則は、いまも使われています。
なぜでしょうか。
専任講師:
この問いに答えた論文があります。
部分的な言語における推論 を、全域的な言語の手法で正当化する、というものです。
部分同値関係を用い、その定義域を全域な部分集合に取ることで、2つの言語のあいだの対応を示します。
タロウくん:
日本語としては読めるのですが、何を言っているのかが掴めません。
専任講師:
では、論文の題名から入りましょう。
出典:
N. A. Danielsson, J. Hughes, P. Jansson, J. Gibbons, "Fast and Loose Reasoning is Morally Correct", POPL 2006, pp. 206–217
doi: 10.1145/1111037.1111056
https://www.cs.ox.ac.uk/jeremy.gibbons/publications/fast+loose.pdf
題名を訳すと、こうなります。
大ざっぱな推論は、道徳的に正しい
タロウくん:
論文の題名ですか、これは。
専任講師:
POPL という、この分野で最も権威のある会議の論文です。
何を主張しているのか
専任講師:
論文から引用します。
We call the unjustified reasoning with laws of this sort "fast and loose", and we show, under some mild and unsurprising conditions, that its conclusions are "morally correct". In particular, it is impossible to transform a terminating program into a looping one.
筆者による日本語訳:
この種の法則を用いた、正当化されていない推論を、我々は「大ざっぱ」と呼ぶ。
そして、いくつかの穏やかで驚くにあたらない条件のもとで、その結論が「道徳的に正しい」ことを示す。
とくに、停止するプログラムをループするプログラムに変換することは不可能である。
タロウくん:
最後の一文が、重要ですね。
専任講師:
そこが核心です。
停止するプログラムを、ループするプログラムに変換することは不可能である。
何が保証されたのか
専任講師:
「底を含まない部分集合で考える」という約束は、厳密には正当化されていませんでした。
この論文は、全域的な言語で成り立つ等式を、部分的な言語でも一定の条件のもとで安全に使えることを、数学的に正当化しました 。
したがって、Haskell で底を無視した「大ざっぱな推論」が、一定の条件のもとで安全に使えることを説明できます。
タロウくん:
「ある条件のもと」というのは?
専任講師:
論文の言い方では、「穏やかで驚くにあたらない条件」です。
扱う値が全域であり、有限であること。
日常的なプログラムでは、たいてい満たされています。
第8章の事故との関係
タロウくん:
しかし、第8章では実際に壊れました。
矛盾しませんか。
専任講師:
しません。
第8章の事例は、条件が満たされていなかった場合 です。
具体的には、seq が絡んだ場合 です。
整理します。
| 何が保証されるか | |
|---|---|
| 条件が満たされる場合 | 底(⊥)を無視して、圏論の法則をそのまま使っても、結論は正しい |
| 条件が満たされない場合 | 保証されない。実際に壊れた事例がある |
タロウくん:
条件が満たされているかどうかは、どうやって知るのでしょうか。
専任講師:
それが、いまも難しいところです。
GHC も、すべての場合について確かめているわけではありません。
第9章の結論
専任講師:
Hask は、厳密には圏ではありません。
しかし、底を含まない範囲で考えるかぎり、圏論の法則は安全に使えます。
そして、その「安全に使える」ことは、POPL 2006 の論文で証明されました。
タロウくん:
「そう思うことにしている」だけではなかったのですね。
専任講師:
そのとおりです。
「そう思うことにしている」が、後から正当化されました。
ただし、seq を使うと、その保証の外に出ます。
タロウくん:
だから seq は、慎重に使うべきなのですね。
専任講師:
多くの Haskell プログラマが、そう考えています。
第1章の問いに戻る
専任講師:
第1章で、こう説明しました。
圏論が出すのは「この書き換えをしてよい」という許可です。
この書き換え許可は、条件が付された許可でした。
| 内容 | |
|---|---|
| 条件 | 底を含まない範囲で考えること |
| 保証 | 停止するプログラムは、停止したまま |
| 例外 |
seq を使うと、この保証の外に出る |
圏論の法則をコードの最適化に使ってよいかどうか。その答えが、この表の3行です。
第10章 圏論にもとづく最適化の例をさらに見てみる
この章の主題
専任講師:
ここまで、map の書き換え規則と foldr/build の書き換え規則を見てきました。
どちらも、GHC が自動で行う最適化でした。
この章では、圏論にもとづく最適化の例 を、さらに6つ 見ていきます。
タロウくん:
その6つも、GHCが自動で行ってくれるものですか。
専任講師:
6つのうち、GHCが自動で行ってくれる最適化は、1つだけです。
残る5つは、プログラマが自分で書き換える必要があります。
ですから、プログラマには、圏論の知識と、扱う言語(ここではHaskell)が採用する型理論に関する知識が求められます。
「この形は、こう書き換えてよい」と判断できなければ、書き換えようがありません。
タロウくん:
第1章で僕が知りたかったのは、まさにそこです。
10-1 foldMap ── コンパイラがすでに最適化してくれている
この例を数学者の言葉で厳密に表現すると、以下になります。
モノイド $(M, \cdot, e)$ から $(N, *, e')$ への準同型 $h$ は、次を満たします。
$$h(x \cdot y) = h(x) * h(y)$$
この構造保存性により、次の等式が成り立ちます。
$$\mathtt{foldMap}\ f = \mathtt{fold} \circ \mathtt{map}\ f$$
タロウくん:
噛み砕いて説明していただけますか。
専任講師:
「写してからまとめる」のと「まとめながら写す」のが、同じということです。
mconcat (map Sum xs)   -- 写してから、まとめる
foldMap Sum xs         -- まとめながら、写す
左は中間リストを作りますが、右は作りません。
したがって、右のほうが速いはず です。
タロウくん:
はずです、というのは?
専任講師:
実行時間を測ってみましょう。
測定結果
| n | mconcat . map Sum |
foldMap Sum |
|---|---|---|
| 1,000,000 | 0.000295 秒 | 0.000315 秒 |
| 3,000,000 | 0.001205 秒 | 0.001002 秒 |
タロウくん:
・・・ほとんど同じです。
専任講師:
Core を確認したところ、両方とも中間リストが1つも残っていませんでした。
GHC が、mconcat . map を1回の走査にまとめていたのです。
タロウくん:
手で書き換える必要が、なかった。
専任講師:
この場合は、そうです。
10-2 Traversable ── 2回の走査を1回にまとめる
foldMap では、GHCが自動で最適化を行ってくれました。
これから取り上げる Traversable では、GHCは何もしてくれません。プログラマが自分でコードを書き換える必要があります。
Traversable は、構造を保ちつつ効果を伴う走査を行う関手 です。
Traversable の性質 と Applicative の 合成 を利用すると、条件を満たす走査を1回にまとめることができます。
上記は、圏論に関する数学知見から導き出される結論です。
いま述べた文章を、表で整理します。
| 記述 | 何の知見か |
|---|---|
| Traversable は関手である | 圏論。関手(Functor)は圏論の概念 |
| 構造を保ちつつ効果を伴う走査 | Haskellの型クラスの説明 |
| Applicative の合成 | 圏論。Applicativeはモノイダル関手として圏論的に捉えられる |
| 走査を1回にまとめられる | 上の2つから導かれる結論 |
なお、Traversable の法則そのものは、圏論の論文で定式化されています。
出典:
M. Jaskelioff, O. Rypacek, "An Investigation of the Laws of Traversals", MSFP 2012, EPTCS 76, pp. 40–49
doi: 10.4204/EPTCS.76.5
Traversable を「applicative functor 間の自然変換」として捉える枠組みです。
タロウくん:
具体例で示していただけますか。
専任講師:
リストの各要素に、失敗しうる処理を2回かける場合です。
traverse f xs >>= traverse g
f で走査し、そのあと g でもう一度走査します。
これを、1回にまとめられます。
( 実行時間の測定結果 )
要素数100万のリストに対して。
| 時間 | 結果 | |
|---|---|---|
traverse f のあと traverse g |
0.260 秒 | Just 1000003000000 |
1回の traverse に融合 |
0.058 秒 | Just 1000003000000 |
約4.5倍の高速化です。結果は一致しています。
タロウくん:
こちらは、差が出ましたね。
専任講師:
そこが重要です。
GHC は、2回の走査を1回にまとめる書き換えを、自動で行ってはくれません。
タロウくん:
なぜですか?
専任講師:
traverse は map より複雑だからです。
効果を伴う走査は、書き換えの安全性を判断するのが難しいです。
したがって、プログラマが自分で、2回の走査を1回にまとめる必要があります。
🔬 中上級者向けコラム:なぜ、2回の走査を1回にまとめられるのか
本編では「Traversable の性質と Applicative の合成を利用する」とだけ述べました。
ここでは、その仕組みを簡単に見ておきます。
traverse の型は、次のとおりです。
traverse :: (Traversable t, Applicative f) => (a -> f b) -> t a -> f (t b)
注目していただきたいのは、t と f の位置が入れ替わっている点です。
入力   t a        構造が外、値が内
出力   f (t b)    効果が外、構造が内
traverse は、「構造の中の効果を、外側に集める」操作です。
では、2回の走査を1回にまとめる根拠は何でしょうか。
2つの Applicative を、1つの Applicative として扱えることです。
Compose f g a -- 外側が f、内側が g
f と g がともに Applicative なら、Compose f g も Applicative になります。
したがって、2つの効果を1つにまとめてから、1回だけ走査できます。
【2回走査】
t a ──traverse f──→ F (t b) ──traverse g──→ F (G (t c))

【融合後】
t a ──────traverse combined──────→ Compose F G (t c)
ここでは「2つの効果を Compose でまとめられる」という構造を示しています。
実際の >>= を含む具体的な融合では、さらに効果の合成と平坦化を考える必要があります。
ここで、1点お断りしておきます。
「自然性があるから融合できる」と言い切るのは、省略しすぎです。
実際には、次の複数の要素が関わります。
Traversable の自然性
Traversable の恒等性
Traversable の合成に関する法則
Applicative の合成(Compose)
これらが揃って、はじめて融合が正当化されます。
なお、第3章で見た map の融合と、発想は同じです。
| 2回を1回にする根拠 | |
|---|---|
map |
関数の合成 g . f
|
traverse |
Applicative の合成 Compose F G
|
どちらも「構造を2回たどる計算を、数学的な合成によって1回に変形する」という型です。
本コラムでは、要点のみを述べました。
より詳しい解説は、稿を改めて別の記事として執筆する予定です。
専任講師:
10-1 と 10-2 を並べてください。
| GHC が自動で書き換えるか | 圏論を知る意味 | |
|---|---|---|
| foldMap | 書き換える | なぜ速いのかが分かる |
| Traversable | 書き換えない | 圏論の知識がなければ、2回の走査を1回にまとめるという最適化の考えを思いつくことすらできない |
なお、経験則やライブラリの知識から、同じ最適化に到達することはあり得ます。
圏論が与えるのは、それを数学的に導出する道筋です。
タロウくん:
表の下の行が、僕の求めていたものです。
専任講師:
そうだと思います。
「この状況では、こう書き換える」という手引きが必要なのは、コンパイラがやってくれない場合です。
そして、圏論の知識があるかないかが、そのままプログラムの実行速度の差になって現れます。
10-3 Monad 則の結合律 ── 同じ結果でも速さは違う
これまで同様に、最初に数学者の言葉で、「Monad則の結合律」について説明します。
Monad 則には、結合律が含まれます。
$$(m \mathbin{>!!>!!=} f) \mathbin{>!!>!!=} g = m \mathbin{>!!>!!=} (\lambda x \rightarrow f\ x \mathbin{>!!>!!=} g)$$
これは、Kleisli 圏における射の合成が結合的であることを意味します。
タロウくん:
要するに、どちらの順で計算しても同じ、ということですか?
専任講師:
そのとおりです。
しかし、速さは同じではありません。
( 実行時間の測定結果 )
リストモナドで、bind を n 回重ねた場合。
| n | 左結合 | 右結合 |
|---|---|---|
| 20,000 | 0.001994 秒 | 0.0000074 秒 |
| 40,000 | 0.004192 秒 | 0.0000142 秒 |
約270倍から300倍の差です。
タロウくん:
同じ結果なのに、270倍も。
専任講師:
なぜ、270倍もの差が出るのでしょうか。
リストモナドで bind を重ねると、次の2通りの書き方ができます。
((m >>= f) >>= g) >>= h      -- 左結合
m >>= (\x -> f x >>= (\y -> g y >>= h))   -- 右結合
左結合では、m >>= f の結果を作り、それに g をかけ、さらに h をかけます。
中間のリストが、そのつど作り直されます。
右結合では、要素を1つ取り出すたびに、f、g、h を順にかけます。
中間のリストを、作り直す必要がありません。
中間リストを作らなくて済む処理に書き換えることで、270倍もの高速化が実現できたのです。
この書き換えには、Monad則の結合律という圏論の知識が求められました。
Kleisli圏における射の合成が結合的である、ということです。
つまり、bind をどちらの順序で結合しても、計算結果は変わりません。
そのうえで、Haskellのリストモナドが bind をどう評価するのかという、実装の側の知識が必要になります。
左結合では、bind を重ねるたびに中間リストが作り直されます。
右結合では、作り直されません。
タロウくん:
結果が同じだと圏論が保証し、どちらが速いかはHaskellの実装の話ということですね。
専任講師:
そのとおりです。
タロウくん:
Haskellの型システム(型理論)に関する知識としては、ここではどのような知見が求められるのでしょうか?
専任講師:
ここでは、型理論の知識は要りません。
第5章で扱った foldr/build の場合は、forall b. という型パラメータが、書き換えの安全性を保証していました。
しかし、Monad則の結合律は、型パラメータとは関わりません。
タロウくん:
では、何が必要なのですか。
専任講師:
Haskellのリストモナドが、bind をどう評価するのかという実装の知識です。
左結合では中間リストが作り直され、右結合では作り直されない。
これは、型理論ではなく、処理系の振る舞いの話です。
タロウくん:
場面によって、求められる知識が違うのですね。
専任講師:
そのとおりです。
圏論だけでも、型理論だけでも足りません。
何が必要かは、扱う最適化ごとに変わります。
結合律 に話を戻しましょう。
結合律が保証するのは、「どちらでも同じ結果になる」ことだけです。
「どちらでも同じ速さになる」とは、言っていません。
タロウくん:
第1章で先生がおっしゃったことですね。
圏論が出すのは「この書き換えをしてよい」という許可です。
専任講師:
そうです。
では、変形した結果どちらが速くなるのか。
それは、別の話です。
10-4 Difference List ── 計算量が変わる
Difference Listを数学者の言葉で説明すると、以下のようになります。
集合 $A$ からそれ自身への写像の全体 $\operatorname{End}(A)$ は、写像の合成を演算としてモノイドをなします。
リストを $\operatorname{End}$ に埋め込むことで、連結の計算量を改善させることができます。
タロウくん:
コードで書いたほうが早いかもしれません。
専任講師:
そうしましょう。
素朴なリストの連結は、こうです。
xs ++ ys
この操作は、xs の長さに比例する時間がかかります。
したがって、左に偏って連結を重ねると、計算量が増えます。
(((xs ++ ys) ++ zs) ++ ws)
一方、リストを「関数」として表す方法があります。
newtype DList a = DList ([a] -> [a])

instance Semigroup (DList a) where
  DList f <> DList g = DList (f . g)

instance Monoid (DList a) where
  mempty = DList id
連結が、関数の合成になりました。
関数の合成は、中身を見ません。
したがって、一定時間で済みます。
測定結果
| n | 素朴な ++
|
Difference List |
|---|---|---|
| 2,000 | 22.06 ミリ秒 | 0.0114 ミリ秒 |
| 4,000 | 91.43 ミリ秒 | 0.0204 ミリ秒 |
| 8,000 | 423.83 ミリ秒 | 0.0451 ミリ秒 |
n = 8,000 で、約9,400倍の差です。
n を倍にしたとき、時間がどう変わったかを見てください。
素朴な ++          22.06 → 91.43 → 423.83     約4倍ずつ
Difference List    0.0114 → 0.0204 → 0.0451   約2倍ずつ
タロウくん:
片方は4倍、もう片方は2倍。
専任講師:
n を倍にして時間が4倍になるのは、$O(n^2)$ です。
2倍になるのは、$O(n)$ です。
これは定数倍の改善ではありません。
計算量そのものが変わっています。
Difference Listとは?なぜ高速化できるのか
タロウくん:
そもそも、Difference List とは何でしょうか。
専任講師:
リストを、リストとしてではなく「関数」として持っておく方法です。
newtype DList a = DList ([a] -> [a])
[a] -> [a] は、「リストを受け取って、リストを返す関数」です。
タロウくん:
リストそのものではなく、関数を持つ。
専任講師:
そうです。
[1,2,3] を持つかわりに、「渡されたリストの前に 1,2,3 をくっつける関数」 を持ちます。
タロウくん:
なぜ、そうするのですか。
専任講師:
連結のしかたが変わるからです。
素朴な ++ は、左側のリストを先頭から末尾までたどります。
xs ++ ys なら、xs の長さだけ時間がかかります。
タロウくん:
たどらないと、つなげられないからですね。
専任講師:
Difference List では、連結が関数の合成になります。
DList f <> DList g = DList (f . g)
f . g は、「f と g を順に実行する関数」を作るだけです。
リストの中身には、いっさい触れません。
タロウくん:
たどらないのですか。
専任講師:
たどりません。
だから、xs がどれだけ長くても、一定時間で済みます。
タロウくん:
では、実際のリストは、いつ作られるのですか。
専任講師:
最後に、空のリストを渡したときです。
toList (DList f) = f []
ためておいた関数を、ここで1回だけ実行します。
タロウくん:
連結のたびにリストを作り直さず、最後に1回だけ作る。
専任講師:
そこが、高速化の理由です。
素朴な ++ では、連結のたびに左側をたどり直していました。
Difference List では、たどるのが1回で済みます。
タロウくん:
よくわかりました。
この Difference Listという最適化手法 で使用した 圏論知識 と、Haskell言語の型理論の知識 を表に整理してください。
専任講師:
次のようになります。
| 何の知識か | 具体的な内容 |
|---|---|
| 圏論 | 集合 $A$ からそれ自身への写像の全体 $\operatorname{End}(A)$ は、写像の合成を演算としてモノイドをなす |
| 圏論 | リストのモノイドを、$\operatorname{End}$ のモノイドに埋め込める |
| Haskellの言語機能 |
newtype により、実行時のコストなしに型を付け替えられる |
| Haskellの言語機能 |
Semigroup と Monoid の型クラスに、自分でインスタンスを定義できる |
| 処理系の振る舞い |
++ は左側のリストをたどるため、長さに比例する時間がかかる |
| 処理系の振る舞い | 関数合成 f . g は、中身をたどらないため一定時間で済む |
タロウくん:
型理論そのものは、出てきませんね。
専任講師:
ここでは要りません。
第5章の foldr/build では、forall b. という型パラメータが書き換えの安全性を保証していました。
Difference List では、そうした保証は必要ありません。
モノイドの法則が成り立つことと、newtype が使えること。この2つで足ります。
タロウくん:
ここからは興味本位でお聞きするのですが、Haskell以外の関数型言語や定理証明言語では、Haskellが採用する型システム(型理論)や、場合によっては、言語が採用する論理体系がHaskellとは異なることで、Difference Listという最適化手法を使うことができない言語もあったりするのでしょうか?
この質問は、連載シリーズの次回以降の記事の内容を先取りしてしまう可能性がありますが・・・。気になってしまいまして。
特に、言語は、型システム(型理論)が異なるだけでなく、採用する論理体系が異なることは、過去の複数の記事で、先生との対話篇で議論を積み上げてきた内容です。
専任講師:
ポイントをついた優れた質問ですね。
答えがいのある質問です。
結論を先に言ってしまうと、Difference List は、多くの言語で使えます。
タロウくん:
そうなのですか。
専任講師:
必要なものが、少ないからです。
第5章の foldr/build は、forall b. という型パラメータがなければ、安全だと言い切れませんでした。
Difference List に必要なのは、高階関数が書けることだけです。
関数を値として扱い、関数を合成できる。
それができれば成り立ちます。
タロウくん:
では、どの言語でも同じように使えるのでしょうか。
専任講師:
使えるかどうかと、同じ効果が出るかどうかは、別の話です。
| 言語 | 何が変わるか |
|---|---|
| Haskell | 評価が非正格。連結をためておき、最後に1回だけ実行する |
| OCaml、Scala | 評価が正格。ためておく効果が、Haskellとは異なる形で現れる |
| Lean 4、Agda | 停止性の検査がある。関数として表した場合に、その検査をどう通すかが問題になる |
タロウくん:
定理証明言語では、停止することを証明しなければならないのでしたね。
専任講師:
そのとおりです。
リストを関数に置き換えると、その関数が必ず停止することを、処理系に納得させる必要が生じます。
タロウくん:
論理体系の話が、ここで関わってくるのですね。
専任講師:
第3回で、正面から扱います。
10-5 Codensity ── 漸近的な改善
専任講師:
10-4 と同じ発想を、モナドに適用したものがあります。
まず、数学者の言葉遣いで説明してみます。
関手 $F$ に対する codensity 構成は、次の型で与えられます。
$$\operatorname{Codensity}(F),A = \forall R.,(A \to F R) \to F R$$
Kan 拡張から導かれる構成であり、Free モナドにおける bind の左偏りを解消します。
タロウくん:
Difference List と、同じ発想なのですか。
専任講師:
まったく同じです。
| 手法 | 何を関数に持ち上げるか |
|---|---|
| Difference List | リストを、関数に持ち上げる |
| Codensity | モナドの bind を、関数に持ち上げる |
どちらも、「遅いデータ構造操作を、数学的に同値な関数合成へ持ち上げる」という型 です。
( 測定結果 )
Free モナドで、bind を左結合に n 回重ねた場合。
| n | 素朴な Free | Codensity 経由 |
|---|---|---|
| 3,000 | 0.1156 秒 | 0.0000355 秒 |
| 6,000 | 0.4055 秒 | 0.0000859 秒 |
約3,300倍から4,700倍の差です。
そして、伸び方をご覧ください。
素朴な Free   0.1156 → 0.4055     約3.5倍
Codensity     0.0000355 → 0.0000859   約2.4倍
素朴版は n の2乗に近く、Codensity 版は n に比例しています。
タロウくん:
ここでも、計算量が変わっている。
専任講師:
そのとおりです。
この性質は、Voigtländer によって示されました。
出典:
J. Voigtländer, "Asymptotic Improvement of Computations over Free Monads", MPC 2008, LNCS 5133, pp. 388–403
doi: 10.1007/978-3-540-70594-9_20
題名にある「漸近的な改善」が、いま測った現象です。
タロウくん:
先生、先ほど Difference List のときに、他の言語ではどうなるかを伺いました。
Codensity についても、同じことをお聞きしてよいでしょうか。
専任講師:
どうぞ。
タロウくん:
Haskell以外の言語でも、この手法は使えるのでしょうか。
専任講師:
Difference List より、条件が厳しくなります。
Codensity の型を、もう一度みてください。
$$\operatorname{Codensity}(F),A = \forall R.,(A \to F R) \to F R$$
forall R. があります。
タロウくん:
あっ、型パラメータ ですね。
専任講師:
この型を書けなければ、Codensity は表現できません。
| 言語 | 型パラメータ | Codensity を書けるか |
|---|---|---|
| Haskell |
forall がある |
書ける |
| OCaml | 多相型がある。ただし記述の形が異なる | 書けるが、モジュールの仕組みを使う場合がある |
| Scala | 多相型がある | 書ける |
| Lean 4、Agda | 依存型がある | 書ける。ただし停止性の検査を通す必要がある |
タロウくん:
Difference List のときは「高階関数が書ければよい」でしたが、こちらは型パラメータが要るのですね。
専任講師:
そのとおりです。
同じ「関数に持ち上げる」という発想でも、必要な言語機能が違います。
タロウくん:
言語ごとに、使える手法が変わってくる。
専任講師:
第2回と第3回で、言語ごとに整理します。
タロウくん:
先生、もう1つ伺ってもよろしいでしょうか。
各言語 が採用する 型システム(型理論)の違い が原因になるのではなく、各言語が採用する論理体系(Isabelleの場合は、複数の論理体系をプログラマが選択できるので、選択可能な論理体系の中の特定の論理体系)の違いによって、Haskellで使える(圏論から導き出される)最適化手法が、他言語では使えない、という事例 はあるのでしょうか?
専任講師:
あります。
タロウくん:
どのような場合でしょうか。
専任講師:
古典論理を採用するか、直観主義論理を採用するかで、扱えるものが変わります。
タロウくん:
以前、先生に教えていただいた区別ですね。
専任講師:
直観主義論理では、証明がそのまま計算の手順になります。
古典論理では、そうなるとは限りません。
排中律や二重否定除去を使った証明は、計算の手順を与えないことがあります。
タロウくん:
最適化と、どう関わるのでしょうか。
専任講師:
Isabelle/HOL は、古典論理にもとづいています。
そこで証明した等式を、そのままプログラムの書き換えに使えるとは限りません。
タロウくん:
等式は証明できたのに、書き換えには使えない。
専任講師:
そういう場合があります。
一方、Agda や Lean 4 は直観主義論理にもとづいています。
証明した等式が、計算の手順を伴います。
| 言語 | 論理体系 | 証明した等式の扱い |
|---|---|---|
| Agda、Lean 4 | 直観主義論理 | 証明が計算の手順を与える |
| Isabelle/HOL | 古典論理 | 証明が計算の手順を与えるとは限らない |
| Isabelle/ZF | 集合論にもとづく別の体系 | 扱いがさらに異なる |
タロウくん:
Isabelle では、プログラマが論理体系を選べるのでしたね。
専任講師:
そのとおりです。
同じ処理系を使っていても、どの論理体系を選ぶかで、できることが変わります。
タロウくん:
型理論だけの話ではなかったのですね。
専任講師:
第3回で、正面から扱います。
10-6 Applicative と Monad ── 弱さが機能になる
最後に、実行速度とは違う例をお見せします。
例にならって、最初に専門家の言葉遣いで説明します。
Applicative は、効果の構造が値に依存しません。
そのため、複数の効果を並列に合成でき、エラーを Semigroup で集約できます。
Monad では、前の処理の結果を見てから、次に何をするかが決まります。
そのため、最初の処理が失敗した時点で、次に進めません。
エラーをまとめることができないのです。
タロウくん:
具体例で示していただけますか。
専任講師:
3つの検証を行う場合です。
User <$> vName "" <*> vAge (-1) <*> vEmail "bad"
3つとも失敗する入力を与えます。
出力
Applicative: Left ["name is empty","age is negative","email has no @"]
Monad      : Left ["name is empty"]
タロウくん:
上は3つ、下は1つ。
専任講師:
Applicative は、3つのエラーをすべて集めました。
Monad は、最初のエラーで止まりました。
タロウくん:
なぜ違うのでしょうか。
専任講師:
Monad では、前の処理の結果を見てから、次に何をするかが決まります。
そのため、最初の処理が失敗した時点で、次に進めません。
Applicative では、前の処理の結果を見ることができません。
<*> という演算子の型が、次のようになっているからです。
(<*>) :: f (a -> b) -> f a -> f b
f a の中身である a を取り出す手段が、この型には用意されていません。
中身を取り出せない以上、その中身を見て次の処理を選ぶことは、できません。
そのため、3つの処理は互いに独立に実行されます。
結果として、すべて実行したあとで、結果をまとめることができる のです。
専任講師:
Applicative は、Monad より弱い構造です。
表現力が低い、ということです。
タロウくん:
でも、その弱さのおかげで、エラーを全部集められた。
専任講師:
そこです。
弱いからこそ、できることがあります。
「前の結果に依存しない」と型が保証しているから、独立に評価できる。
タロウくん:
強いほうが、常によいわけではないのですね。
専任講師:
そのとおりです。
必要な強さを見極めることが、設計という仕事 です。
これは、速度の話ではありません。
得られる情報の量の話 です。
タロウくん:
この場面で使用した圏論の知識と、Haskellの型理論の知識を、表に整理していただけますか。
専任講師:
次のようになります。
| 何の知識か | 具体的な内容 |
|---|---|
| 圏論 | Applicative は、モノイダル関手として捉えられる。複数の効果を、積の構造としてまとめられる |
| 圏論 | Semigroup は、結合的な二項演算を持つ構造である。エラーを <> で連結できる |
| 圏論 | Monad は Applicative より強い構造である。強さの序列が、型クラスの階層になっている |
| Haskellの型 |
<*> の型 f (a -> b) -> f a -> f b には、a を取り出す手段がない |
| Haskellの型 |
>>= の型 m a -> (a -> m b) -> m b には、a を受け取ってから m b を決める手段がある |
| Haskellの言語機能 |
Validation のような型を自分で定義し、Applicative インスタンスを与えられる |
タロウくん:
型の形そのものが、できることとできないことを決めているのですね。
専任講師:
そのとおりです。
タロウくん:
この Applicative による全エラー集約は、Haskell以外の言語でも使えるのでしょうか。
専任講師:
言語ごとに整理します。
| 言語 | 型理論の側から見た条件 | 言語の論理体系の側から見た条件 | 使えるか |
|---|---|---|---|
| Haskell | 型クラスがあり、Applicative インスタンスを自分で定義できる |
特に制約はない | 使える |
| OCaml | 型クラスがない。モジュールかファンクタで代用する | 特に制約はない | 記述の形は変わるが、使える |
| Scala | 型クラスを implicit で表現できる | 特に制約はない | 使える |
| Rust | トレイトがあるが、高階型を直接扱えない。Applicative をそのままの形では書けない |
特に制約はない | そのままの形では使えない |
| Lean 4、Agda | 依存型があり、Applicative を定義できる |
直観主義論理。すべての関数が停止することを要求される | 使える。ただし停止性の検査を通す必要がある |
| Isabelle/HOL | 高階論理にもとづく。型クラスに相当する仕組みはある | 古典論理。証明した等式が、計算の手順を与えるとは限らない | 使えるが、実行可能なコードへの変換に制約が生じる場合がある |
タロウくん:
Rust は型理論の側で、Isabelle は論理体系の側で、それぞれ引っかかるのですね。
専任講師:
引っかかる場所が、言語によって違います。
第2回と第3回で、言語ごとに整理します。
この章のまとめ
6つの例を、表にします。
| 手法 | 使う数学 | 実測結果 | GHC が自動でやるか | |
|---|---|---|---|---|
| 10-1 | foldMap | Monoid 準同型 | 差なし | やる |
| 10-2 | Traversable の融合 | 自然性 | 4.5倍 | やらない |
| 10-3 | bind の再結合 | Monad 則の結合律 | 270倍 | やらない |
| 10-4 | Difference List | 自己準同型のモノイド | 9,400倍、計算量が変わる | やらない |
| 10-5 | Codensity | Kan 拡張 | 3,300倍、計算量が変わる | やらない |
| 10-6 | Applicative | 積構造 | 情報量が違う | やらない |
10-1 以外は、すべてプログラマが圏論の知識と、扱う言語の型理論の知識を持っていなければ、その最適化に到達できません。
タロウくん:
先生、6つとも面白かったのですが、少し多すぎて混乱してきました。
自分がコードを書いているとき、どれを思い出せばいいのでしょうか。
専任講師:
手法の名前から入ると、たしかに混乱します。
困っていることから入ってください。
| 困っていること | まず考える候補 | 本記事での例 |
|---|---|---|
| 中間リストを作っている | 中間リストを作らずに済む形に書き換えられないか |
map の書き換え規則、foldr/build の書き換え規則、foldMap
|
++ を何度も左に重ねている |
関数合成に持ち上げられないか | Difference List |
| Free Monad の bind が深くなっている | 継続的な表現に変えられないか | Codensity |
| 同じ構造を何度も走査している | 走査をまとめられないか | Traversable の融合 |
| bind のネストが左に偏っている | 結合の順序を変えられないか | Monad 則の再結合 |
| 独立した検証で、エラーをまとめたい | Monad より Applicative で表せないか | 全エラーの集約 |
タロウくん:
左の列から探せばいいのですね。
専任講師:
そのとおりです。
この表は、暗記するためのものではありません。
「圏論の知識が、問題を見つけるレンズになる」ことを示す表です。
タロウくん:
レンズ、ですか。
専任講師:
「++ を左に重ねている」と気づくには、それが遅いと知っている必要があります。
さらに、「関数合成に持ち上げる」という手があると知っていなければ、直しようがありません。
知識があってはじめて、問題が問題として浮かび上がってきます。
第1章の問いへの答え
タロウくん:
先生、最初の質問に戻ってもいいでしょうか。
専任講師:
どうぞ。
タロウくん:
僕は「圏論をどうコード設計に落とし込むのか」を知りたかったんです。
いま、こういうことだと思いました。
圏論の法則を知っている  →  この変形をしてよいと分かる
                      →  コンパイラがやらない変形なら、自分でやる
                      →  計算量が変わることもある
専任講師:
見事な整理です。
そして、もう1つ付け加えられます。
タロウくん:
何でしょうか。
専任講師:
10-4 と 10-5 は、同じ型でした。
遅いデータ構造操作を、数学的に同値な関数合成へ持ち上げる
この型を知っていれば、新しい場面で応用できます。
「この操作は遅い。関数に持ち上げられないか」と考えられる。
タロウくん:
それが、デザインパターンに近いものですね。
専任講師:
そのとおりです。
専任講師:
Difference List、Codensity、Church 表現、worker/wrapper 変換。
これらが、1つの枠組みで説明されています。
出典:
R. Hinze, "Kan Extensions for Program Optimisation Or: Art and Dan Explain an Old Trick", MPC 2012, LNCS 7342, pp. 324–362
doi: 10.1007/978-3-642-31113-0_16
要旨からの引用
We argue that so-called absolute Kan Extensions underlie this program optimisation. It is known that every Kan extension gives rise to a monad, the codensity monad, and furthermore that every monad is isomorphic to a codensity monad. ... We show that several optimisations are instances of this scheme: Church representations and implementation of backtracking using success and failure continuations, among others.
筆者による日本語訳:
我々は、いわゆる絶対 Kan 拡張が、このプログラム最適化の基礎にあると論じる。
すべての Kan 拡張がモナド、すなわち codensity モナドを生じさせること、さらにすべてのモナドが codensity モナドと同型であることが知られている。
いくつかの最適化が、この枠組みの実例であることを示す。Church 表現や、成功と失敗の継続を用いた後戻りの実装などである。
副題の「Art and Dan が、古い手品を説明する」という言い方も、この論文の性格を表しています。
古くから知られていた手法が、Kan 拡張という1つの概念で説明された、ということです。
🔬 中上級者向けコラム:Difference List と Codensity は「同じ発想」の親戚
Difference List と Codensity は、見た目がかなり違います。
しかし、どちらも同じ発想を共有しています。
Difference List   リストの連結を、関数合成としてためる
Codensity         bind の連鎖を、関数合成としてためる
共通する型を、一文で言えばこうなります。
そのままでは重くなりやすい操作を、関数合成の形へ持ち上げてためる。
この型を一度覚えると、新しい問題に出会ったときにも使えます。
たとえば、次のように考えられるようになります。
左に偏って連結していないか
中間の構造を、何度も作り直していないか
関数として表して、最後に一度だけ実行できないか
ここで大切なのは、常に Codensity を使うことではありません。
遅さの原因が「左に偏った構造の再構築」なのかを見抜き、必要なときにだけ表現を変えることです。
第10章で測ったとおり、効果が出る場合は劇的です。
しかし、効果が出ない場面で使えば、かえって読みにくくなるだけです。
今日扱えなかった事例
タロウくん:
きょうは、関数型言語として最もメジャーな言語のひとつであるHaskellについて、Haskellのコードの書き方をエレガントにしたり、コンパイラであるGHCがコードの実行過程を最適化する具体的な手法を編み出す際に、圏論の数学知見がどう活用されているのかをご説明いただきました。
今回、題材として挙げていただいたのは、List型など、合計8つの最適化手法でした。
| 手法 | 使う数学 | |
|---|---|---|
| 第3章 |
map の書き換え規則 |
Functor 則 |
| 第4章 |
foldr/build の書き換え規則 |
始代数、catamorphism |
| 10-1 | foldMap | Monoid 準同型 |
| 10-2 | Traversable。2回の走査を1回にまとめる | 自然性 |
| 10-3 | bind の再結合 | Monad 則の結合律 |
| 10-4 | Difference List | 自己準同型のモノイド |
| 10-5 | Codensity | Kan 拡張 |
| 10-6 | Applicative による全エラー集約 | 積構造 |
Haskellのコードの最適化で、圏論の数学知見が活用されている具体例としては、関数型言語の研究者やHaskellの実務家の間で広く知られているものに絞ったとき、他にどんな最適化の事例がありますか?
内容を詳しくお聞きすると、この記事が10倍以上に膨らんでしまいますので、具体例だけ、箇条書きにして挙げていただけますか?
専任講師:
よい質問です。
名前だけ、挙げますね。
なお、融合変換(fusion) という専門用語が出てきます。
複数の処理を1つにまとめることで、中間データを作らずに済ませるプログラム変換のこと です。
本記事の第3章と第4章で扱った書き換え規則が、これにあたります。
融合変換 は、関数型言語の研究者 が使用する、日本語の定訳が定まった専門用語です。
英語では fusion、あるいは deforestation と言います。
圏論の研究者が使う用語ではありません。
本記事の第4章で引用した Gill・Launchbury・Peyton Jones の論文の題名 "A Short Cut to Deforestation" が、後者にあたります。
( 融合変換の仲間 )
-
stream fusion ──
vectorとtextが採用している融合の仕組みです。foldr/buildでは扱えないzipや多段の処理も、まとめられます -
foldr/augment 規則 ── GHCに実在する規則です。
++を含む処理の融合に使われます - concatMap の融合 ── 入れ子になったリストを、中間のリストを作らずに処理します
-
Church符号化(Boehm–Berarducci符号化) ── データ構造そのものを関数として表現します。
buildの理論的な正体にあたります
( 表現を持ち上げる仲間 )
-
Yoneda と CoYoneda ── 米田の補題にもとづきます。
fmapを何回重ねても、最後の1回まで構造に触れません - Cayley表現 ── 群論のCayleyの定理にあたるものを、モノイドに適用します。Difference List の一般形です
- worker/wrapper変換 ── 遅い表現と速い表現のあいだに同型を立て、速いほうで計算してから戻します
( 構造を分離する仲間 )
- Free Monad と interpreter ── 命令の記述と実行を分け、あいだで命令をまとめたり省いたりします
-
van Laarhoven表現による lens ──
lensパッケージの基礎です。データの読み書きを、関数の合成として表します - recursion schemes ── catamorphism や anamorphism を、リスト以外のデータ構造にも適用できる形にしたものです
- Bird-Meertens形式主義 ── catamorphism という概念が最初に導入された枠組みです。プログラムを等式で変形していく手法の源流にあたります
( 計算の順序に関わるもの )
- Applicative による並列化 ── 「前の結果に依存しない」ことを型で示すと、複数の処理を並列に評価できます
- Arrow ── Functor、Monad と並ぶ圏論的な抽象です。Kleisli圏の一般化にあたります
- メモ化 ── 同じ計算を2度行わないようにします。Applicativeによる並列化と組み合わせて使われます
( 型クラスに関わるもの )
- SPECIALIZE による型クラス辞書の除去 ── 型クラスを使ったコードから、実行時の辞書渡しを取り除きます
- newtype による表現の付け替え ── 実行時のコストを伴わずに、同じデータに別の法則を与えます
タロウくん:
まだ、こんなにあるんですね。
専任講師:
いずれも、研究者と実務家の双方に知られているものです。
ここで名前だけを挙げたものは、いずれ別の記事で扱います。
タロウくん:
この記事の中の先生との最初の対話で、僕が以下の記事を読んだことをお伝えさせて頂いていたと思います。
この記事には、圏論知見とHaskellプログラミングとの関係について、理論的な観点からいろいろと書かれています。
今回の記事(本記事)で扱ったListの事例と、いま先生に列挙していただいた箇条書きのHaskell最適化具体例との対応関係を教えていただけますか?
できれば、表などにしていただけると助かります。
専任講師:
たしかに、その記事との関係を表に整理すると、その記事と本記事を見比べながら学習しやすくなりますね。
表に書き起こしてみましょう。
タロウくんが読んでいるといった記事は、8つの構造 を取り上げていました。
その8つが、本記事でどう現れたかを表にします。
| 過去に公開済みの記事が扱った構造 | 本記事で扱った最適化 | 本記事で名前だけ挙げた最適化 |
|---|---|---|
| Functor |
map の融合(第3章) |
Yoneda と CoYoneda |
| Applicative | 全エラーの集約(10-6) | Applicativeによる並列化 |
| Monad | bind の再結合(10-3)、Codensity(10-5) | Free Monad と interpreter、Arrow |
| Semigroup・Monoid | foldMap(10-1)、Difference List(10-4) | Cayley表現 |
| Foldable | foldr/build 融合(第4章) | foldr/augment 規則、concatMap の融合 |
| Traversable | Traversable の融合(10-2) | recursion schemes |
| 自然変換 | パラメトリシティと自由定理(第5章) | van Laarhoven表現によるlens |
| 随伴 | ── | worker/wrapper変換、Church符号化 |
タロウくん:
対応しているんですね。
専任講師:
前の記事 は、8つの構造について「どういう場面で、どれを選ぶか」 を述べていました。
本記事 は、その構造を選んだあとで、何が起きるのか を扱っています。
タロウくん:
随伴 のところだけ、左が空欄になっていますね。
専任講師:
そこはお気づきのとおりです。
随伴が関わる最適化は、本記事では名前を挙げるにとどめました。
worker/wrapper変換もChurch符号化も、実機で測っていません。
随伴 については、いずれ独立した記事で扱います。
タロウくん:
1つ気になったことがあります。
本記事で出てきた 始代数 や Kan拡張、米田の補題 は、前の記事には出てきませんでした。
専任講師:
そうですね。
前の記事 が扱ったのは、Haskellの型クラスとして実際に存在するものが中心 でした。
Functor、Applicative、Monad、Monoid、Foldable、Traversable。
いずれも標準ライブラリにあります。
タロウくん:
始代数やKan拡張は、型クラスではありませんね。
専任講師:
これらは、型クラスの背後にある数学の概念 です。
本記事では、最適化の根拠をたどった結果、そこまで降りていくことになりました。
タロウくん:
2つの記事が、つながりました。
### 第3回では新しい数学理論が登場予定
専任講師:
第3回で定理証明言語を扱うとき、ホモトピー型理論(HoTT) という理論が関わる議論が出てきます。
タロウくん:
以前、先生に教えていただいたことがあります。
ただ、だいぶ前のことですので、もう一度ご説明いただけますか。
専任講師:
復習を兼ねて、最初から説明し直しましょう。
ホモトピー型理論(HoTT) は、2006年ごろに生まれた数学の理論です。
「2つのものが等しい」と言うとき、その根拠が1通りとは限らない。
そう考えます。
タロウくん:
等しいことを示す証拠(根拠)が複数ある、のでしたよね?
専任講師:
そうです。
具体例 を挙げましょう。
真偽値の型 Bool を考えてください。
Bool と Bool は、当然ながら等しいです。
しかし、その「等しさ」の根拠は、1つだけではありません。
2通りの対応のつけ方があるからです。
| 何も変えずに対応させる | 論理反転して対応させる | |
|---|---|---|
| 対応づけ |
True → TrueFalse → False
|
True → FalseFalse → True
|
| 比較するもの |
True と TrueFalse と False
|
False と FalseTrue と True
|
| 結果 | 同じ | 同じ |
どちらも「Bool と Bool は等しい」ことの根拠になります。 |
しかし、対応のつけ方そのものは別物です。
タロウくん:
等しさの根拠が、2つある。
専任講師:
そのとおりです。
従来の型理論では、この区別ができませんでした。
等しいなら等しい。根拠は1通りに潰れていたのです。
タロウくん:
今日の議論と、どうつながるのでしょうか。
専任講師:
本記事で A = B という等式を何度も扱いました。
HoTTでは、その等式そのものが型になります。
その型の要素が「2つが等しいことの証明」にあたり、証明が複数あることを許すのです。
タロウくん:
今日は「foldr k z (build g) = g k z は正しい」という話でした。
その等式が、型になる。
専任講師:
発想としては、そうです。
そして、第3回で扱う Arend という言語では、次のような同型が題材になります。
$$A \times (B \times C) \cong (A \times B) \times C$$
組の入れ子の付け替えです。
この同型を使って、データの表現を安全に変換できます。
タロウくん:
今日は「Haskは圏の定義を完全には満たさない」という話でしたが、第3回はもっと先の話になりそうですね。
専任講師:
そのとおりです。
第3回では Agda、Idris 2、Lean 4、Rocq、Isabelle/HOL、Arend を扱います。
このうち Arend と Cubical Agda が、HoTTを計算対象として扱う言語です。
なお、この主題については、筆者が過去に記事を公開しています。
( Arend について )
( ホモトピー型理論について )
-
空間を連続変形しても変わらずに残る本質的な構造(不変量)を取り出す数学 ──「数学のホモトピー理論」は「定理証明言語の型理論」につながる
-
【連載初回】「型」を「空間」として捉え、「2点を結ぶ経路」の数だけ「異なる等しさ」を識別するホモトピー型理論(HoTT)は、数学と情報科学にどう役立つのか
-
【連載第2回】「複数の等しさ」を扱う2つの流派 ── ホモトピー型理論(HoTT)と ∞-圏論のあいだに双方向の橋が開通する日はくるか?(片側車線のみ開通済み)
- ホモトピー型理論(HoTT)の区間 I に、どの数学的代数構造を入れるか ── De Morgan と Cartesian、2つの立方体型理論から実装言語の地図まで
( 「等しさ」を型として扱うことについて )
本連載は、これらの記事をお読みいただかなくても理解できるように書いてまいります。
次回はHaskellを離れて、Haskell以外の代表的な関数型言語であるOCaml、Scala、Clean、Erlangを取り上げます。
-
これらの言語には、どのような圏論構造が見出されているのか。
- その圏論構造に関する数学知見は、各言語の最適化にどう役立っているのか。
この2つの論点に向き合います。
タロウくん:
楽しみにしています。
この主題を扱った書籍はあるのか
タロウくん:
先生、もうひとつ伺ってもよろしいでしょうか。
きょう教えていただいたような内容、つまり「圏論の知見が、実際のコード最適化にどう使われているか」を主題にした本は、すでにあるのでしょうか。
もしあるなら、そちらを読んだほうが早い気もします。
専任講師:
私もいろいろ調べてみたのですが、残念ながら、和書には、見当たりませんでした。
タロウくん:
ない、のですか?
専任講師:
圏論とHaskellを扱う和書は、何冊もあります。
- 雪田修一『圏論入門 ── Haskellで計算する具体例から』日本評論社
- Milewski『プログラマーのための圏論』オーム社
- Bird『関数プログラミング入門 ── Haskellで学ぶ原理と技法』オーム社
しかし、いずれも圏論の入門書です。
Haskellは、圏論を説明するための道具として使われています。
タロウくん:
方向が、逆なのですね。
専任講師:
そのとおりです。
-
既存の和書
圏論を、Haskellを使って説明する
-
本連載シリーズ
圏論の知見が、GHCの中で実際に何をしているかを、実機で確かめる
英文書籍には近いものが2冊ある
専任講師:
英語の書籍には、本連載に近いものが2冊あります。
1冊目は、これです。
出典:
R. Bird, O. de Moor, Algebra of Programming, Prentice-Hall, 1996
プログラムの計算を可能にする代数的なアプローチを記述する。関数と圏、関係と亜圏、データ型、再帰的プログラム、最適化の問題、動的計画法と貪欲アルゴリズムを扱う。
本連載にもっとも近い書籍です。
タロウくん:
「関数と圏」「最適化の問題」。
きょう伺った話と、重なっていますね。
専任講師:
重なる点を、先に挙げます。
- プログラムを 等式で変形する という手法そのもの
- catamorphism を中心に据えている点
- 変形の根拠を 圏論に求める という姿勢
タロウくん:
では、違う点は?
専任講師:
この本は、GHCの実装を扱いません。
実機で測定した数値も、出てきません。
理論の側から、プログラムを等式で変形する手法を体系立てた本 です。
タロウくん:
きょうは、ghc -ddump-simpl の出力を実際に見ました。
専任講師:
そこが違います。
本連載では、次のものを実際に取り上げます。
- GHCのソースコードに書かれているRULES の中身
- 実機で取得したCore の出力
- 実行時間の測定結果
理論と、いま動いているコンパイラの中身を、突き合わせます。
もう1冊
専任講師:
2冊目は、これです。
出典:
R. Bird, Thinking Functionally with Haskell, Cambridge University Press, 2014
根底にある等式の法則を学ぶことで、プログラムの性質を理解し、より効率的にするための計算的推論を適用できるようにする。
等式推論によるプログラムの改善を扱っています。
タロウくん:
こちらも、近そうです。
専任講師:
ただし、圏論は前面に出ません。
等式による変形は扱いますが、その等式が圏論のどの概念に由来するのかは、主題になっていません。
本連載では、そこを逆にします。
「この等式は、圏論のどの法則から来ているのか」を、毎回明示します。
第2回以降で扱うこと
タロウくん:
第2回以降は、どうなりますか?
専任講師:
いま挙げた2冊は、どちらもHaskellだけを扱っています。
本連載は、第2回からHaskellを離れます。
- 【第2回】 OCaml、Scala、Clean、Erlang、Clojure ほか
- 【第3回】 Agda、Idris 2、Lean 4、Rocq、Isabelle/HOL、Arend
- 【第4回】 金融、保険、ロボティクス、暗号開発など産業領域別で有効と考えれる、圏論知見を用いた関数型言語・定理証明言語の最適化事例
複数の言語を横断し、それぞれの言語にどのような圏論構造が見出されているのかを比べます。
タロウくん:
ところで、こうしたテーマを取り扱った文献は、存在するのでしょうか?
専任講師:
見当たりませんでした。
英語の書籍にも、和書にもです。
タロウくん:
では、この連載は・・・
専任講師:
前例のない形になります。
そのぶん、間違いも起こりえます。
お気づきの点がありましたら、ご指摘いただけますと幸いです。
第11章 自分の環境で確かめる
本記事で示した出力は、すべて筆者が自分の環境で得たものです。
同じことを、読者の環境でも確かめられます。
必要なもの
GHC だけです。
$ ghc --version
The Glorious Glasgow Haskell Compilation System, version 9.4.7
筆者は 9.4.7 を使いました。
他のバージョンでも、同様の結果が得られるはずです。
第2章を再現する
次のファイルを作ります。
module Sum where

mysum :: Int
mysum = sum [1..10]
融合あり
$ ghc -O2 -ddump-simpl -dsuppress-all -fforce-recomp Sum.hs
融合なし
$ ghc -O2 -fno-enable-rewrite-rules -ddump-simpl -dsuppress-all -fforce-recomp Sum.hs
2つの出力を見比べてください。
融合なしのほうに : が現れます。
第3章を再現する
module MapMap where

f, g :: Int -> Int
f = (+1)
g = (*2)

test :: [Int] -> [Int]
test xs = map g (map f xs)
どの規則が発火したかを見る
$ ghc -O2 -ddump-rule-firings -fforce-recomp MapMap.hs
融合後のコードを見る
$ ghc -O2 -ddump-simpl -dsuppress-all -fforce-recomp MapMap.hs
第7章を再現する
本記事の山場です。
import Control.Exception

idF :: a -> a
idF x = x

main :: IO ()
main = do
  r1 <- try (evaluate (seq (undefined :: ()) ())) :: IO (Either SomeException ())
  putStrLn $ "seq undefined ()        = " ++ either (const "bottom") show r1
  r2 <- try (evaluate (seq (undefined . idF :: () -> ()) ())) :: IO (Either SomeException ())
  putStrLn $ "seq (undefined . id) () = " ++ either (const "bottom") show r2
$ runghc Seq.hs
恒等律が破れる瞬間を、ご自分の手でご覧いただけます。
第10章の測定を再現する
Difference List の測定に使ったコードを、掲載します。
import Data.List (foldl')
import System.CPUTime
import Control.Monad (forM_)

naive :: Int -> [Int]
naive n = foldl' (\acc i -> acc ++ [i]) [] [1..n]

newtype DList a = DList ([a] -> [a])

instance Semigroup (DList a) where
  DList f <> DList g = DList (f . g)

instance Monoid (DList a) where
  mempty = DList id

toList :: DList a -> [a]
toList (DList f) = f []

single :: a -> DList a
single x = DList (x:)

dl :: Int -> [Int]
dl n = toList (foldl' (\acc i -> acc <> single i) mempty [1..n])

time :: String -> (Int -> [Int]) -> Int -> IO ()
time nm f n = do
  t0 <- getCPUTime
  let r = f n
  r `seq` (length r `seq` return ())
  t1 <- getCPUTime
  putStrLn $ nm ++ " n=" ++ show n ++ ": "
          ++ show (fromIntegral (t1-t0) / 1e9 :: Double) ++ " ms"

main :: IO ()
main = forM_ [2000, 4000, 8000] $ \n -> do
  time "naive (++)  " naive n
  time "DList (Endo)" dl n
  putStrLn ""
$ ghc -O2 -fforce-recomp DL.hs -o dl
$ ./dl
n を変えて、時間の伸び方をご覧ください。
素朴版は4倍ずつ、DList は2倍ずつ増えるはずです。
注意点
測定は、環境によって数値が変わります。
本記事の数値は、筆者の環境での実測値です。
倍率の傾向は再現されるはずですが、絶対値は一致しません。
ここまでのまとめ
1 圏論の法則は、コンパイラの中に実際に入っています
GHC のソースコードに、Functor 則に由来する書き換え規則が書かれています。
開発者自身が、次のように注記しています。
Any similarity to the Functor laws for [] is expected.
(リストの Functor 則との類似は、意図されたものである)
2 sum [1..10] は、リストを作りません
融合を切ると : が現れ、有効にすると消えます。
筆者は、両方の Core を実機で取得しました。
3 圏論が出すのは「許可」です
1   圏論で、同値な変形ができることを示す
2   その変形で、中間データを消す
3   GHC が、実際に書き換える
圏論が担うのは、1番だけです。
4 Hask は、厳密には圏ではありません
seq undefined ()        = bottom
seq (undefined . id) () = ()
恒等律が破れています。筆者は、これを実機で再現しました。
5 恒等律が成り立たないために、最適化が失敗した事例があります
安全に停止するプログラムが、失敗するプログラムに変わった事例があります。
6 それでも使えるのは、「底を含まない範囲で考えてよい」ことが証明されているからです
POPL 2006 の論文が、「底を含まない範囲で考える」という約束の安全性を示しました。
停止するプログラムを、ループするプログラムに変換することは不可能である。
ただし、seq を使うと、この保証の外に出ます。
7 最適化は2種類ある
| 例 | 圏論を知る意味 | |
|---|---|---|
| コンパイラが自動で行う | foldMap、map の融合 | なぜ速いのかが分かる |
| プログラマが自分で行う | Traversable、Difference List、Codensity ほか | 知らなければ、到達できない |
8 計算量そのものが変わる場合がある
Difference List と Codensity は、定数倍の改善ではありません。
Difference List   O(n²) → O(n)
Codensity         同様に、漸近的な改善
9 弱い構造のほうができることもある
Applicative は Monad より弱い構造です。
その弱さゆえに、全エラーを集約できます。
10 共通の型がある
遅いデータ構造操作を、数学的に同値な関数合成へ持ち上げる
Difference List も Codensity も、この型です。
この型を知っていれば、新しい場面で応用できます。
📌 用語のミニ解説
- Functor(ファンクタ、関手)
圏から圏への対応であって、恒等射と合成を保つもの。
Haskell では fmap を持つ型クラスとして現れます。
- Functor 則
$F(g \circ f) = F(g) \circ F(f)$ および $F(\mathrm{id}) = \mathrm{id}$。GHC の mapFB 規則が、前者に対応します。
- 始代数( initial algebra )
ある構造の「もっとも素直な」実現。
リストは、その始代数として理解できます。
- catamorphism
始代数からの唯一の準同型射。
foldr がこれにあたります。
日本語訳は定着しておらず、日本の研究論文でも原語のまま用いられます。
- anamorphism
catamorphism の双対。
構造を作る側です。
- hylomorphism
anamorphism と catamorphism の合成。
作ってから畳む操作です。
中間の構造を実際に作らずに済ませられます。
- 融合変換( fusion / deforestation )
複数の関数や繰り返しを1つにまとめ、中間データを除去するプログラム変換。
foldr/build 融合が、その代表です。
- パラメトリシティ( parametricity )
多相関数が、型変数の中身に依存せず一様に動くという性質。
Reynolds の抽象化定理に由来します。
- 自由定理( free theorem )
パラメトリシティから導かれる等式。
型を書いただけで、証明なしに得られます。
- Hask圏
Haskell の型を対象、関数を射とする圏。
ただし、厳密には圏ではありません。
底を含まない部分集合を指して、そう呼ばれています。
- 底( bottom 、⊥)
評価すると例外になるか、停止しない値。
undefined や無限ループがこれにあたります。
すべての型に存在します。
seq
評価の順序を強制する関数。
seq a b は、a を先に評価してから b を返します。
底と底でないものを区別できてしまうため、圏の法則を壊します。
- 恒等律
$\mathrm{id} \circ f = f$ および $f \circ \mathrm{id} = f$。圏であるための条件の1つです。
- Monoid(モノイド)
結合的な二項演算と、その単位元を持つ構造。
<> と mempty として現れます。
- 自己準同型のモノイド( endomorphism monoid )
集合 $A$ からそれ自身への写像の全体。
写像の合成を演算とし、恒等写像を単位元とします。
Difference List の正体です。
- Kan 拡張( Kan extension )
圏論の構成の1つ。
Codensity、Church 表現、worker/wrapper 変換を、1つの枠組みで説明します。
- Codensity
Kan 拡張から導かれるモナド。
bind の左偏りを解消し、漸近的な改善をもたらします。
- 米田の補題( Yoneda lemma )
圏論の基本定理。
$\mathrm{Nat}(\mathrm{Hom}(A,-), F) \cong F(A)$。
本記事では名前を挙げるに留めました。
- GHC の RULES
GHC に書き換え規則を指定する仕組み。
{-# RULES ... #-} という記法で書きます。
- Core
GHC の中間表現。
-ddump-simpl で出力できます。
最適化の結果を確認するために使います。
実機検証について
本記事に掲載した出力は、すべて筆者が自分の環境で得たものです。
検証環境
| 構成要素 | 版 |
|---|---|
| OS | Ubuntu 24.04 |
| GHC | 9.4.7 |
| base | 4.17.2.0 |
実機で確認したこと
- 融合の有無による Core の差(第2章)
- 規則の発火と、融合後のコード(第3章)
- 恒等律の破れ(第7章)
-
foldMap と
mconcat . mapの比較(第10章) - Traversable の融合(第10章)
- bind の再結合(第10章)
- Difference List の計算量(第10章)
- Codensity の漸近的な改善(第10章)
- Applicative と Monad のエラー集約(第10章)
GHC のソースから確認したこと
-
fold/build規則の定義(libraries/base/GHC/Base.hs、1261〜1263行目) -
map関連の4つの規則(同、1357〜1362行目) -
Note [The rules for map]の注記(同、1322〜1355行目) -
mapFBの定義(同、1318〜1320行目)
取得元は、GHC 9.4.7 リリース版のソースコードです。
確認できなかったこと
- 第8章で言及した、実際に壊れた事例の詳細。 HaskellWiki の記述によるものであり、筆者が具体的なコードを特定したわけではありません
- Church 符号化、worker/wrapper 変換、stream fusion、Cayley 表現。 一覧表で名前を挙げましたが、実測していません
-
米田の補題による
fmapの融合。 筆者は実測しましたが、本記事では紙幅の都合により割愛しました。次回以降で扱います - GHC 9.4.7 以外の版での挙動
測定についての注意
掲載した数値は、筆者の環境における実測値です。
環境によって、絶対値は変わります。
ただし、倍率の傾向は再現されるはずです。
訂正一覧
公開後に訂正した箇所を、ここに追記していきます。
現時点ではありません。
関連記事
本記事の出発点となった記事
熟練者の頭の中で、圏論がどう参照されているかを扱った記事です。
本記事は、その続きにあたります。
あちらが人間の側の話であるのに対し、本記事はコンパイラの側の話です。
代数構造と型について
半群・モノイド・群という積み上げを、型としてどこまで表現できるのかを扱った記事です。
本記事の第10章で扱った Monoid と、直接つながります。
出典一覧
融合変換の原典
- A. Gill, J. Launchbury, S. L. Peyton Jones, "A Short Cut to Deforestation", FPCA 1993, pp. 223–232. doi: 10.1145/165180.165214
-
foldr/build融合を提案した論文です
-
自由定理
- P. Wadler, "Theorems for free!", FPCA 1989, pp. 347–359. doi: 10.1145/99370.99404
- 第5章で引用しました
Hask が圏でないこと
-
A. Bauer, "Hask is not a category", 2016年. https://math.andrej.com/2016/08/06/hask-is-not-a-category/
- 第7章で引用しました
-
HaskellWiki, "Hask". https://wiki.haskell.org/Hask
- 第7章で引用しました
-
HaskellWiki, "Correctness of short cut fusion". https://wiki.haskell.org/Correctness_of_short_cut_fusion
- 第8章で引用しました
大ざっぱな推論の正当化
- N. A. Danielsson, J. Hughes, P. Jansson, J. Gibbons, "Fast and Loose Reasoning is Morally Correct", POPL 2006, pp. 206–217. doi: 10.1145/1111037.1111056
https://www.cs.ox.ac.uk/jeremy.gibbons/publications/fast+loose.pdf- 第9章の中核として引用しました
Kan 拡張による統一
-
R. Hinze, "Kan Extensions for Program Optimisation Or: Art and Dan Explain an Old Trick", MPC 2012, LNCS 7342, pp. 324–362. doi: 10.1007/978-3-642-31113-0_16
- 第10章で引用しました
-
J. Voigtländer, "Asymptotic Improvement of Computations over Free Monads", MPC 2008, LNCS 5133, pp. 388–403. doi: 10.1007/978-3-540-70594-9_20
- 第10章で引用しました
一覧表で名前を挙げたもの
- D. Coutts, R. Leshchinskiy, D. Stewart, "Stream Fusion: From Lists to Streams to Nothing at All", ICFP 2007, pp. 315–326. doi: 10.1145/1291151.1291199
- A. Gill, G. Hutton, "The Worker/Wrapper Transformation", Journal of Functional Programming, 2009
- C. Böhm, A. Berarducci, "Automatic synthesis of typed λ-programs on term algebras", Theoretical Computer Science 39, pp. 135–154, 1985
訳語について
-
村田康佑、江本健斗「Coq における検証されたプログラム運算の拡張」、日本ソフトウェア科学会第35回大会講演論文集、2018年
http://jssst.or.jp/files/user/taikai/2018/PPL/ppl4-4.pdf- 「始代数」は訳され、「catamorphism」は原語のまま用いられています
-
「boost::proto を用いた融合変換機能付きライブラリの作成」、情報処理学会プログラミング研究会発表資料、2013年
- 「融合変換」という訳語を確認しました
GHC のソースコード
- GHC 9.4.7、
libraries/base/GHC/Base.hs
https://github.com/ghc/ghc- 第3章、第4章で引用しました
(連載第2回目記事)
本稿では、Haskell のコンパイラ GHC が、圏論の法則を書き換え規則として使っていることを見てきました。
そこで、次の問いが立ちます。
ここで見た最適化手法は、Haskell でしか使えないのでしょうか。
連載第2回では、この問いを扱います。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年9月25日 |
| タグ | 関数型プログラミング、圏論、OCaml、Scala、Haskell |
取り上げる言語
11の関数型言語を、本稿と同じ4つの軸で整理します。
| グループ | 言語 |
|---|---|
| 静的型付け・非正格評価 | Clean、Miranda |
| 静的型付け・正格評価 | PureScript、OCaml、Standard ML、Scala、F# |
| 動的型付け | Clojure、Erlang、Common Lisp、Lisp |
Lisp を除く10の言語と、比較のための Haskell を、実機で検証します。
ご自身がお使いの言語について、本稿の8つの手法が使えるか、条件付きで使えるか、使えないかを確かめることができます。
本稿の論点との関係
本稿で扱った論点が、第2回でどうなるかを、4つ挙げます。
(1つ目)
本稿の第7章で見た恒等律の破れは、Haskell 固有の問題ではありませんでした。
1985年に登場した Miranda でも、まったく同じ形で再現しました。
非正格評価であることと、seq を持つことの2つがそろえば、同じ問題が生じます。
(2つ目)
本稿の 10-4 で扱った Difference List は、検証した10の言語すべてで桁違いに速くなりました。
計算量そのものが変わる手法だからです。
(3つ目)
Haskell 以外の言語のコンパイラは、map f (map g xs) を map (f . g) xs に自動では書き換えてくれませんでした。
GHC が自動で行う書き換えを、他の言語では、プログラマ自身、ライブラリの作者、言語の設計者が担っています。
(4つ目)
動的型付けの言語では、規則を満たさない関数を書いてもエラーにならず、書き換えの前後で結果が変わりました。
静的型の言語では、同じ関数がコンパイルで拒否されました。
型が守っているのは、書き換えの正しさです。
連載の構成
| 回 | 扱う言語 |
|---|---|
| 初回(本稿) | Haskell |
| 第2回 | 11の関数型言語 |
| 第3回 | 複数の定理証明言語 |
第3回目の記事は、定理証明言語を取り上げます。
本稿と第2回で扱う言語では、論理体系の軸に大きな違いは認められませんでした。
第3回で扱う定理証明言語では、各言語の論理体系が大きく異なります。