
はじめに
本記事は、全4回の連載記事の2本目です。
2026/8/13に公開した連載初回記事の 続編 です。
連載初回の記事では、「AIに数学の証明を書かせる」という研究の全体像を読者の皆様にお届けいたしました。
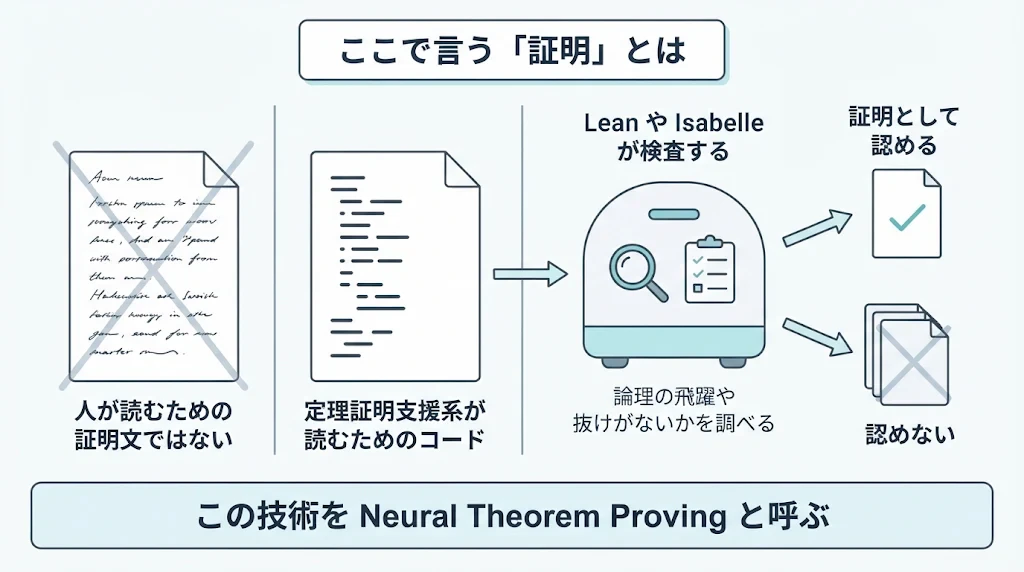
ここで、「証明」 とは、人間が読むことを想定して書かれた数学の定理の証明文ではなく、Lean や Isabelle といった定理証明支援系 に 内容を読んでもらい、証明の過程に論理の飛躍や抜けがないかをチェックしてもらうためのプログラミング言語(定理証明支援言語)のコードのこと です。
AIが書いたコードを機械が検査し、「正しい」と判定されたものだけを証明として認める。
この技術を Neural Theorem Proving と呼びます。
初回記事では、この Neural Theorem Proving にスポットライトを当てて、1997年から2026年までの歴史を追い、競技数学の問題集での正答率が30%から99.6%に達するまでを記録しました。
連載2回目となる本記事では、AIが証明コードをどう学び、どんな形で出力するのかを、実際の Lean のコードと研究例で追います。
本稿(第2回)の主題は、次の問いです。
Neural Theorem Prover と呼ばれる定理証明AIは、タクティク記法と宣言的スタイル記法という2つの書き方のうち、どちらのスタイルで書かれた既存の証明コードを学習し、どちらのスタイルで証明を書いているのか?
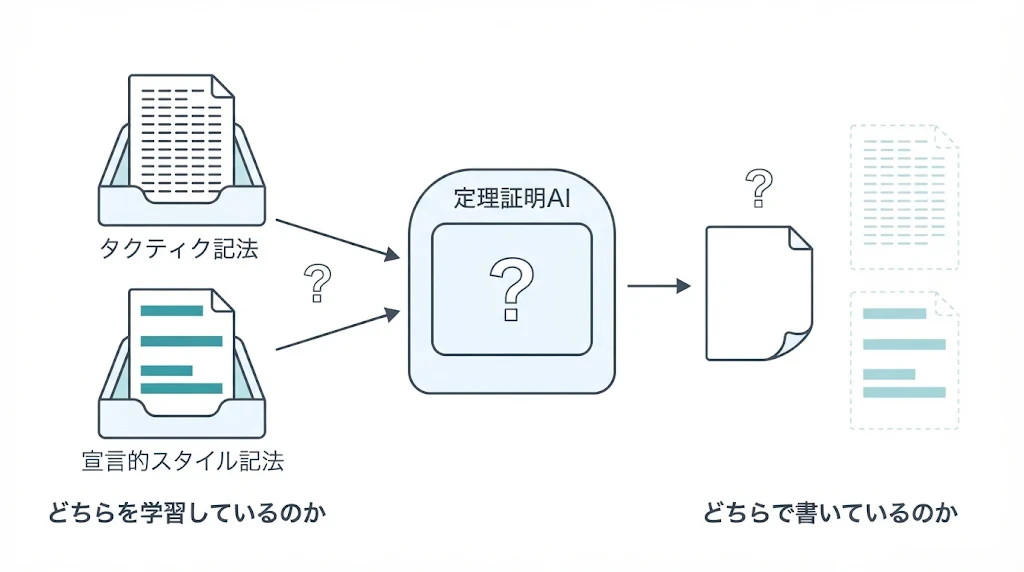
この問いを理解するには、「タクティク記法」 と 「宣言的スタイル記法」 が 何かを知っている必要 があります。
宣言的スタイル は、Lean の多くの入門書では扱われていません。
そこで、先にこの2つを説明します。
本稿の解説方針について
本稿は、定理証明支援系や形式手法をこれから学ぶ方を主な対象とし、各システムの考え方や特徴を直感的に理解できることを重視しています。
そのため、Lean の
haveやタクティクの形式体系上の厳密な分類、各定理証明支援系の専門的な分類上の差異、論文で用いられている数学的な仮定や補題に立ち返った形式的な検証などについては、初学者向けの解説という本稿の目的を優先し、詳細な説明を割愛しています。これらは専門的な議論が不要という意味ではなく、本稿では扱う範囲を意図的に限定しているものです。
より厳密な理解を求める読者は、本文中で紹介する原論文や各システムの公式ドキュメントも併せて参照してください。
まず、2つの書き方を知る
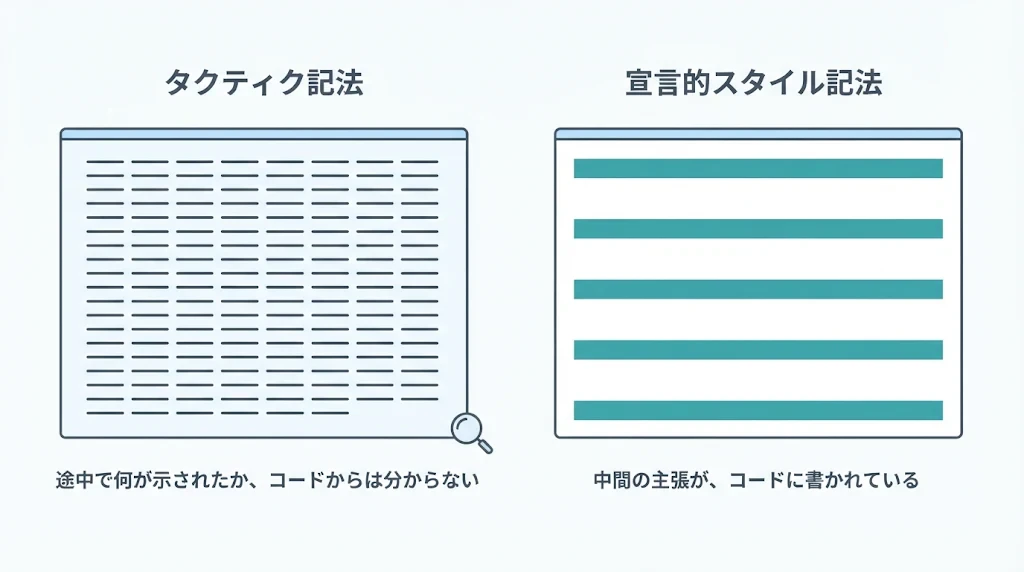
Lean や Isabelle に証明を書く方法は、大きく2つあります。
タクティク記法
「この方針で処理せよ」という命令(タクティク)を、上から順に並べる書き方です。
theorem example1 (a b : ℝ) (h : 0 < a) (h2 : 0 < b) : 0 < a * b := by
  apply mul_pos
  · exact h
  · exact h2
機械学習の文脈に置き換えると、中間変数を一切置かずに、関数呼び出しだけを連ねて書いたコードに似ています。
動きますが、途中の値が何だったかはコードを見ても分かりません。
apply(この定理を当てはめよ)、exact(この仮定がそのまま答えだ) が、タクティク です。
ほかに、simp(簡約せよ)、rw(書き換えよ)、nlinarith(非線形の不等式を解け)、linarith(線形の不等式を解け)、positivity(正であることを示せ)など があります。
Lean 4 の標準的な書き方です。
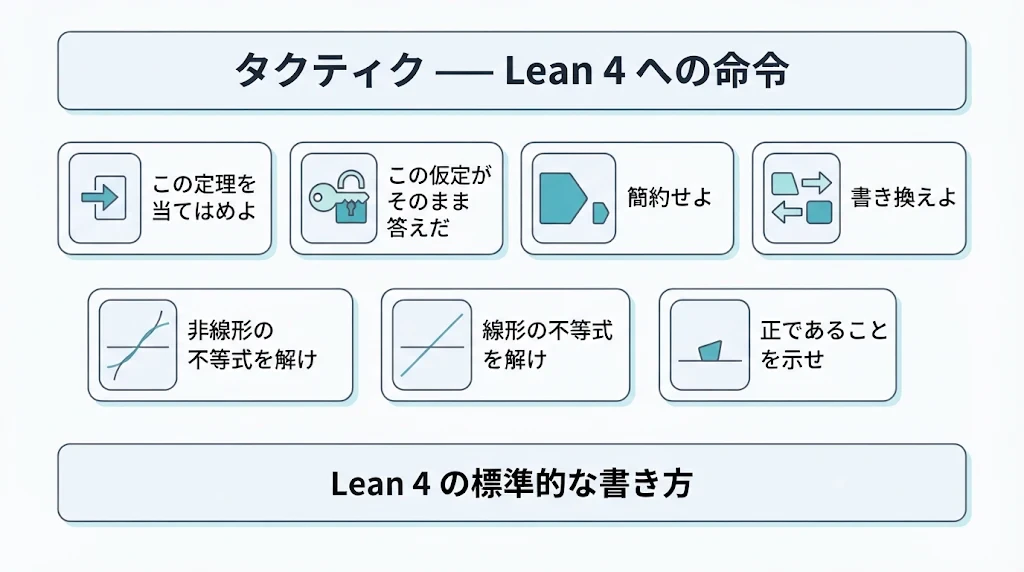
公式教材 Mathematics in Lean も、Lean の数学ライブラリ Mathlib の大半も、タクティク記法で書かれています。
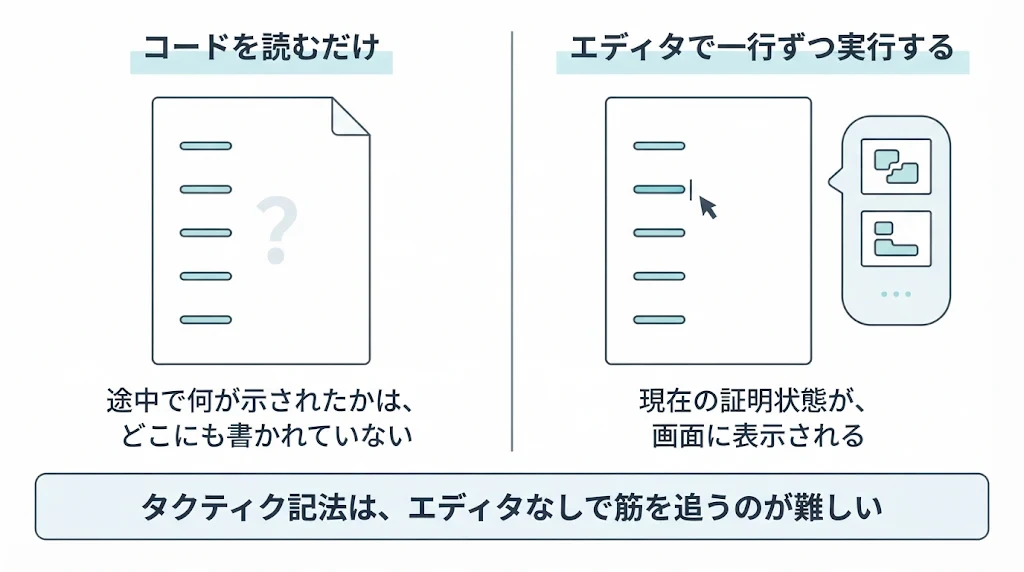
特徴は、途中で何が示されたかがコードに書かれていないことです。
apply mul_pos の後に、証明すべきことが「$0 < a$」と「$0 < b$」の2つに分かれた、という事実は、コードのどこにもありません。
エディタで一行ずつ実行し、画面に表示される「現在の証明状態」を見て初めて分かります。
だから、タクティク記法の証明 は、エディタなしで読んで筋を追うのが難しいのです。
宣言的スタイル記法
「次にこれが成り立つ」という中間の主張を、コードの中に明示しながら進める書き方です。
theorem example2 (a b : ℝ) (h : 0 < a) (h2 : 0 < b) : 0 < a * b := by
  have hab : 0 < a * b := mul_pos h h2
  exact hab
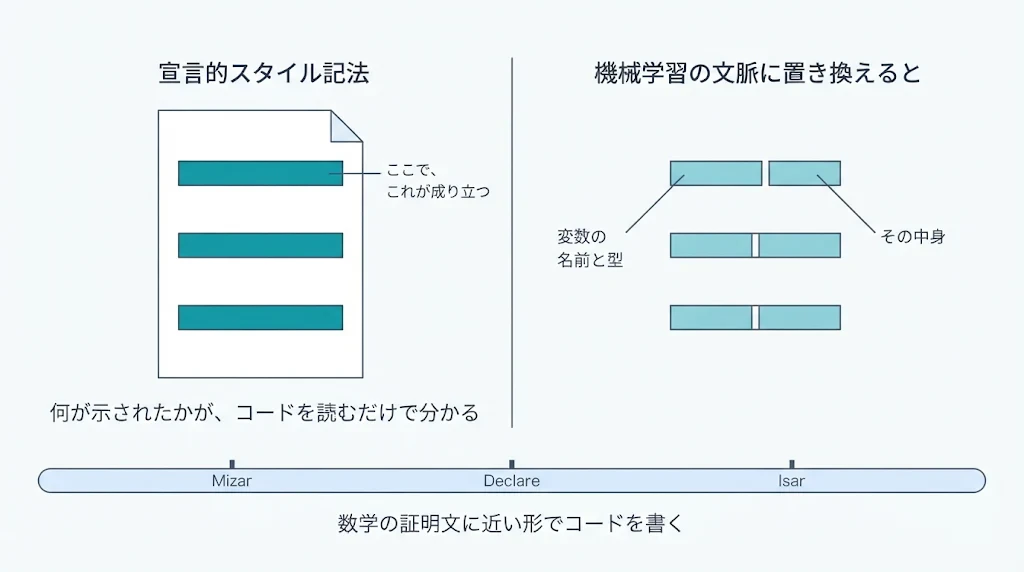
機械学習の文脈に置き換えると、hab = ... と中間変数に名前を付けて、何を計算したかをコードに残すのと同じ発想です。
have hab : 0 < a * b の部分が変数宣言と型注釈にあたり、:= の右側がその中身にあたります。
have hab : 0 < a * b := ... が、「ここで $0 < a \cdot b$ が成り立つ」と宣言している行です。
何が示されたかが、コードを読むだけで分かります。
この書き方は、Isabelle では Isar という専用の言語として整備されており、assume(仮定する)、have(これが成り立つ)、show(これを示す)を並べて書きます。
Mizar という処理系が1970年代から採ってきた流儀で、1997年の Don Syme の Declare、1999年の Isar と続き、数学の証明文にできるだけ近い形でコードを書くことを目指しています。
have は、どちらに属するのか
本稿では、have を「中間の主張を明示する」というコード上の役割から、宣言的スタイルの語として扱います。
ただし、これは説明の便宜です。
Lean 4 では、have 自体も タクティク証明の中で使われ、タクティクの1つとして実装 されています。
だから Lean 4 の証明は、have で「次にこれが成り立つ」と宣言し、その have の中身(:= の右側や by の後)をタクティクで埋める、という混ざった形になります。
  have hab : 0 < a * b := by
    nlinarith [h, h2]
機械学習の文脈に置き換えると、hab という中間変数の「型」だけを先に書き、その値を求める処理はソルバーに任せている形です。
nlinarith は「非線形の不等式を解くソルバーを呼べ」という命令で、具体的な手順は人間が書きません。
この2行で言えば、1行目の have が宣言的スタイル、2行目の nlinarith がタクティクです。
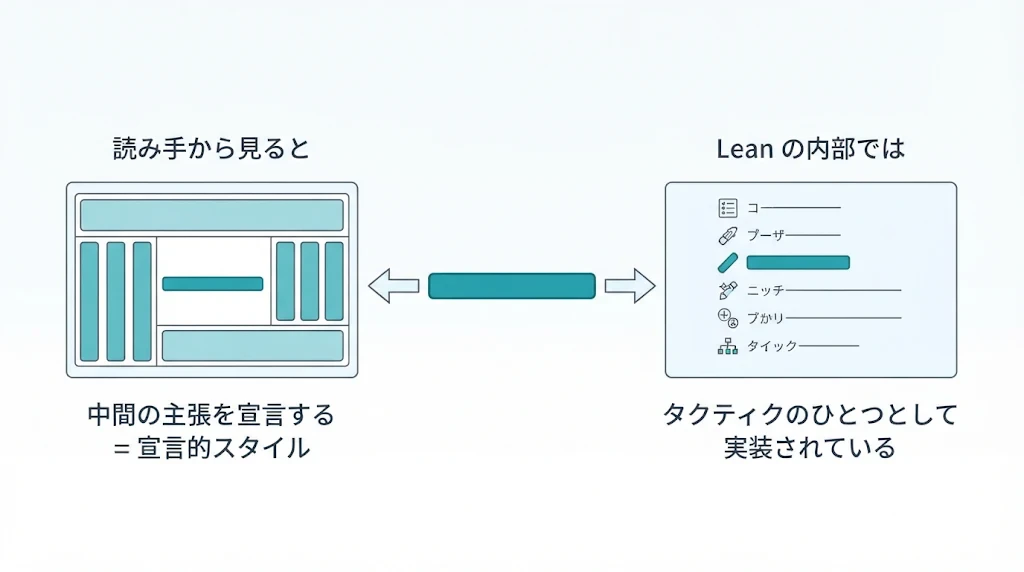
have には、2つの見方が同時に成り立っています。
この二重の見方が、この記事で最も混乱しやすいところ なので、図で整理します。
本稿で「宣言的スタイルで骨格を立て、タクティクで埋める」と言うときは、左側の見方をしています。
have の行が骨格、その中身がタクティク、という対応 で、この先のコードを読んでいきます。
なぜ宣言的スタイルは、入門書や Web の解説に少ないのか
答えを先に言うと、処理系によって事情が違います。
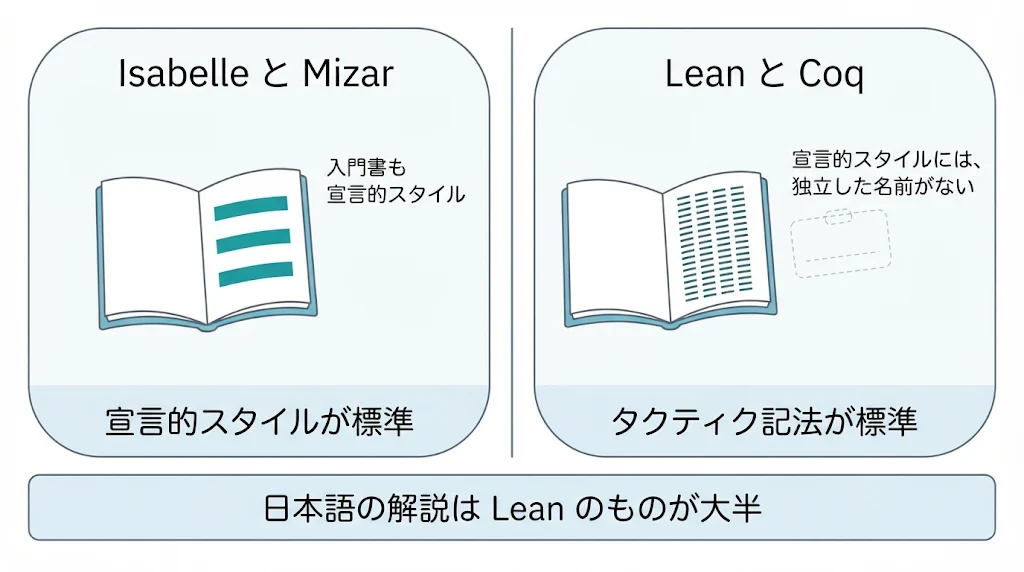
Isabelle と Mizar の世界 では、宣言的スタイルが標準 であり、入門書も宣言的スタイルで 書かれています。
Lean と Coq(現 Rocq)の世界 では、タクティク記法が標準 であり、宣言的スタイルは独立した「スタイル」として名前を与えられていません。
日本語のWeb解説記事はLean について書かれたものが大半なので、宣言的スタイルの解説が少なく見えるのです。
根拠を順に示します。
第1に、処理系の分類そのものが、この2つのスタイルで分かれています。
Freek Wiedijk(ラドバウド大学)は2012年の論文で、定理証明支援系を 「手続き的スタイル(procedural)」 と 「宣言的スタイル(declarative)」 に 分類 し、手続き的スタイル に分類されるのは HOL4、HOL Light、Coq、Metamath など、宣言的スタイル に分類されるのは Mizar と Isabelle/Isar です。
Lean はこの論文より後に作られた処理系ですが、Coq と同じ型理論にもとづく 手続き的スタイルの処理系 です。
出典:
Freek Wiedijk, "A Synthesis of the Procedural and Declarative Styles of Interactive Theorem Proving", Logical Methods in Computer Science 8(1:30), 2012年, §1.1
第2に、Isabelle 側では、宣言的スタイルが公式の入力言語です。
Isar を設計した Markus Wenzel と Wiedijk は、2002年の比較論文で「Isar は Isabelle の公式の入力言語になった。ただし、多くの利用者は依然としてその低水準のタクティク部分だけを使っている」と書いています。
Isabelle の数学ライブラリ IsarMathLib の投稿規約は、第1条に 「宣言的な Isar スタイルのみを使うこと。旧来の Isabelle スタイルの証明は認めない」 と定めています。
IsaMini の論文(本稿の第9部で扱います)も、Isabelle の Archive of Formal Proofs は 宣言的な証明が中心 であり、Coq のライブラリはタクティクに依存している、と比較 しています。
出典
- Markus Wenzel, Freek Wiedijk, "A comparison of Mizar and Isar", Journal of Automated Reasoning 29, 2002年
- IsarMathLib: Style Guide for Contributors
第3に、Lean の公式教材は、タクティク記法を中心に書かれています。
Lean 4 の公式入門書 Theorem Proving in Lean 4 は、証明を 「項スタイル(term-style)」 と 「タクティクスタイル(tactic-style)」 の2つに分け、「タクティクスタイルの証明は、各命令の結果を読者が予測しなければならないため読みにくくなりうるが、短く書きやすい」 と述べています。
Mathlib を使う教材 Mathematics in Lean は、序文で 「タクティクの使用に重点を置く」と明言 しています。
どちらの教材にも 「宣言的スタイル」という章はありません。
have は「タクティクの1つ」として、show や calc とともに「タクティク証明を構造化する方法」の節で紹介されます。
つまり Lean では、本稿が「宣言的スタイル」と呼ぶ書き方が、「タクティク証明の構造化」という名前で、タクティクの中に吸収されています。
名前が無いので、独立した解説も少ない のです。
出典
-
Theorem Proving in Lean 4, 5. Tactics("tactic-style proofs can be harder to read, because they require the reader to predict or guess the results of each instruction. But they can also be shorter and easier to write.")
- Jeremy Avigad, Patrick Massot, Mathematics in Lean, 1. Introduction
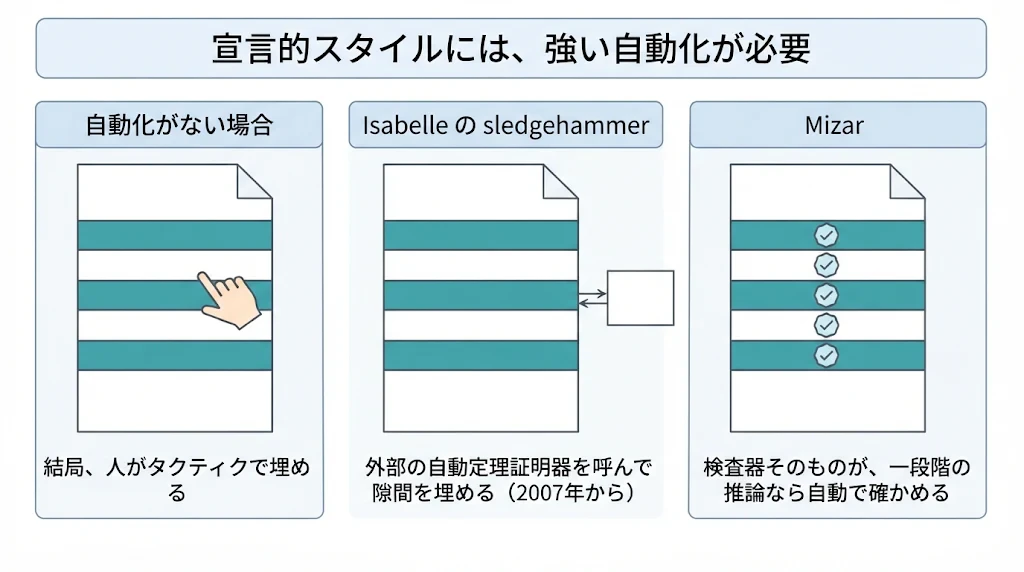
第4に、宣言的スタイルには、強い自動化が前提として必要とされます。
have で 「ここでこれが成り立つ」と宣言しても、その根拠を機械が埋めてくれなければ、結局は人間がタクティクで埋めることになります。
Isabelle には sledgehammer という、外部の自動定理証明器を呼んで隙間を埋める仕組みが2007年からあります 。
Mizar は、検査器そのものが 「一段階の推論なら自動で確かめる」設計 です。
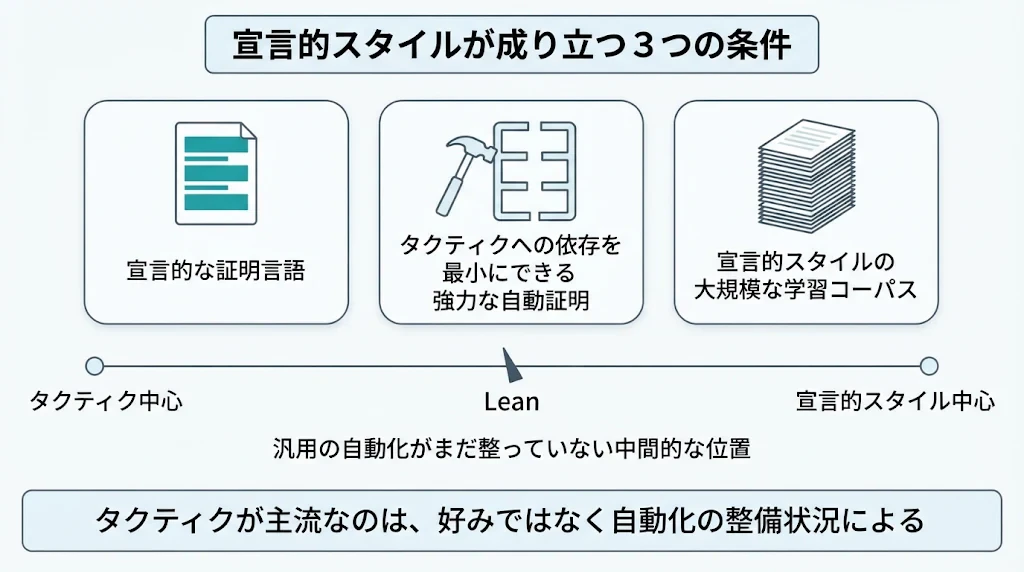
IsaMini の論文は、宣言的スタイルが成り立つ条件 として「宣言的な証明言語」「タクティクへの依存を最小にできる 強力な自動証明 」「 宣言的スタイルの大規模な学習コーパス 」の3つを挙げ、Lean は「ハンマーのような汎用の自動化がまだ整っていないため、タクティクが鍵となる役割を果たし続けている中間的な位置にある」と評しています。
Lean でタクティクが主流なのは、好みの問題ではなく、自動化の整備状況の問題でもあるのです。
出典:
Qiyuan Xu ほか, "IsaMini: Redesigned Isabelle Proof Language for Machine Learning", arXiv:2507.18885, 2025年, §I
では、定理証明の現場では、宣言的スタイルは使われていないのでしょうか。
使われています。ただし、処理系と用途によって割合が違います。
-
Mizar:すべての証明が宣言的スタイルです。1970年代から、ライブラリ全体がこの形で書かれています
-
Isabelle:Archive of Formal Proofs は 宣言的な Isar が中心 です。
ただし、IsaMini の論文の集計では、翻訳前の AFP の証明中で、タクティクを直接適用するapply系の文が全体の37.2%を占めており、宣言的な骨格の中にタクティクが混在 しています
-
Lean:Mathlib の 大半はタクティク記法 ですが、長い証明では
haveで中間の主張を立てる構造化が広く使われて います。
第1回で読んだ Claude のゼータ関数論文の Lean コードも、have31か所・タクティク 33か所でした
- Coq/Rocq:IsaMini の論文は「証明は ほぼ例外なくタクティクに基づく 」と評しています
本稿にとって重要なのは、次の点です。
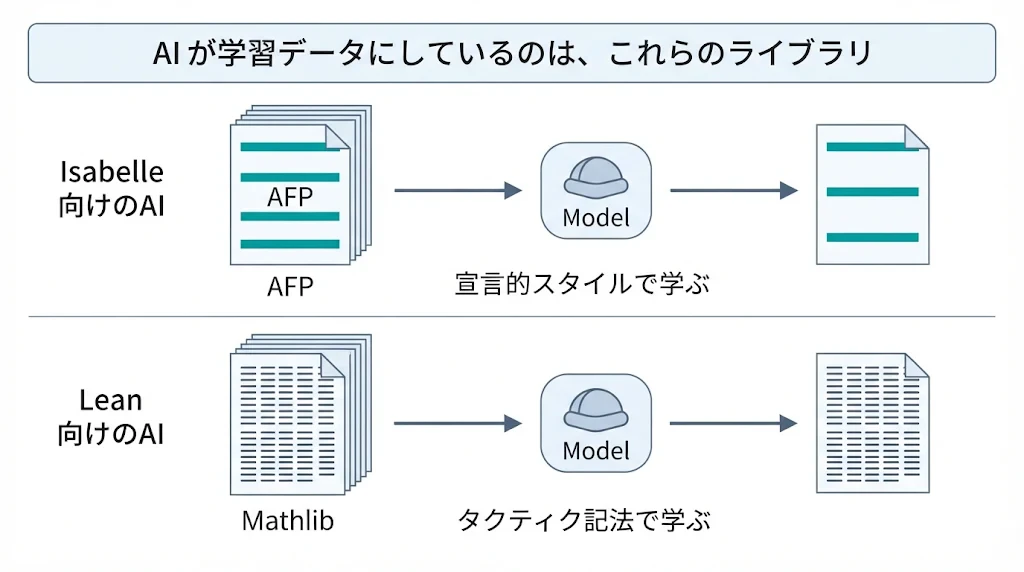
AIが学習データにしているのは、まさにこれらのライブラリです。
Isabelle 向けのAIは宣言的な AFP で学び、
Lean 向けのAIはタクティク中心の Mathlib で学びます。
もう1つ、研究者を Lean へ引き寄せた要因があります。測れるベンチマークの存在です。
miniF2F は Lean 版が整備され、同じ問題集で異なる手法の成績を数値で比べられるようになりました。
連載初回でたどった「正答率30%から99.6%へ」という軌跡は、この比較可能性があって初めて描けたものです。
Isabelle 向けのベンチマーク(PISA など)も存在しますが、参加する研究の数が違います。
測れるところに研究が集まるという傾向は、この分野に限った話ではありません。
つまり「AIはどちらのスタイルで学ぶのか」という問いの答えの半分は、どの処理系を選んだかで決まっています。
残りの半分、すなわち「そのうえでAIがどう書くのか」を、第9部で実物を見ながら確かめます。
連載初回記事との関係
連載初回の記事 では、まず 用語 を解説しました。
Neural Theorem Proving(Prover) という分野を読み解く上で、欠かせない言葉です。
タクティク、宣言的スタイル、miniF2F などのベンチマーク、pass@k という成績の数え方を、ひとつひとつ説明しました。
そのうえで、「AIに定理証明支援系の証明コードを書かせる」という研究の歴史 を、時系列で追いました。
出発点は、1997年の Don Syme による Declare の提案 です。
そこから 2020年の GPT-f、2024年の AlphaProof を経て、2026年の AlphaProof Nexus と Claude のゼータ関数論文 に至ります。
その過程で、競技数学の問題集 miniF2F での正答率が、30%(2020年)から99.6%(2025年) に上がりました。
第1回は、その記録でもあります。
なお、競技数学(competition mathematics)とは、国際数学オリンピック(IMO) や 米国の AMC・AIME のように、高校生が制限時間内に解く数学コンテストの問題を指します。
なぜ、LLM が登場するはるか前の1997年を起点にしたのかをご説明します。
この年に、Don Syme が Declare という定理証明支援系で、「証明の骨格だけを人間が書き、細部は自動証明に任せる」という書き方 を提案したからです。
当時は人間が証明を書くための手法でした。
ところが25年後の2022年、LLM に証明を書かせる研究 Draft, Sketch, and Prove(第1回の第4部)が、自分たちの手法の根拠としてこの Syme の1997年の論文を引用しました。
AIが証明を書くときの型は、1997年に人間のために作られた型の再利用だった、というのが第1回の主張の1つです。
本稿は、その型、すなわち「証明の骨格を have などの宣言で先に立て、各段階の細部はタクティクや自動証明で埋める」という書き方を、内側から確かめる回です。
AIは本当に「骨格を先に立て、細部を後から埋める」という形で学び、その形で証明を書いているのか?
実際に生成されたコードと学習データで検証します。
そして、2020年の GPT-f から2025年の Seed-Prover まで、10 の Neural Theorem Prover(定理証明AI)について、「何を入力され、何を出力し、何で学んだのか」を同じ形で整理します。
なお、部の番号は全4回を通じた連番です。
この記事は 第9部と第10部 にあたります。
第9部では、仕組みを深掘りします。 生成されたコードを一行ずつ読み、学習データがどう作られているかを見ます。
第10部では、対象を広げて一覧します。 10 の研究を、入力・出力・学習データという同じ3点で並べます。
用語の確認(第1回を読んでいない方へ)
本稿で繰り返し使う用語の意味を、ここで短く確認します。
第1回の第1部で解説した内容の要約です。
| 用語 | 本稿での意味 |
|---|---|
| Lean、Isabelle | 定理証明支援系。証明をコードとして書き、正しさを機械が検査する。Lean は Lean 4、Isabelle は Isabelle/HOL を指す |
| タクティク | Lean や Isabelle に対する「この方針で処理せよ」という命令。simp(簡約せよ)、nlinarith(非線形不等式を解け)、rw(書き換えよ)など |
| タクティク記法 | タクティクを並べて証明を書く書き方。途中の主張が見えない |
| 宣言的スタイル記法 |
have(これが成り立つ)、show(これを示す)で中間の主張を明示する書き方。Isabelle では Isar という言語がこれにあたる |
have |
Lean と Isabelle/Isar の両方に登場する語。どちらも中間の主張を示すときに使うが、それぞれの言語における構文であり、同一の構文という意味ではない。本稿で最も頻出する語 |
| sledgehammer | Isabelle の自動証明機能。宣言的スタイルで書いた主張の隙間を、外部の自動定理証明器を呼んで埋める |
| Mathlib、AFP | それぞれ Lean と Isabelle の、証明が蓄積されたライブラリ。AIの学習データの元になる |
| 競技数学(competition mathematics) | 国際数学オリンピック(IMO)、米国の AMC・AIME など、高校生が制限時間内に解く数学コンテストの問題。大学の数学とは違い、初等的な道具で解ける一方、発想の難しさで差がつく |
| miniF2F、PutnamBench、PISA | AIの成績を測る問題集。miniF2F は高校の競技数学から採った488問、PutnamBench は大学生向けのパトナム数学競技の1,697問、PISA は Isabelle の実務的な証明約3,000件。miniF2F-test は、miniF2F を半分に分けた「試験用」の244問 |
| Metamath、HOL | Lean・Isabelle 以外の定理証明支援系。Metamath は2020年の GPT-f が対象にした処理系、HOL(Higher-Order Logic)は Isabelle が土台にする論理体系で、Isabelle/HOL と表記する |
| Isar | Isabelle の宣言的スタイルの証明言語。assume(仮定する)、have(これが成り立つ)、show(これを示す)を並べて書く |
| LLM、基盤モデル、7B/72B | LLM は大規模言語モデル。基盤モデルは追加学習の出発点にする既存のモデル。7B・72B はパラメータ数(70億・720億)で、モデルの規模を表す |
| 事前学習、微調整、強化学習、蒸留 | 事前学習はウェブなどの大量の文章で言語モデルを作ること。微調整(fine-tuning)は特定のデータで追加学習すること。強化学習は、試行の結果に応じた報酬(本稿では「Lean の検査を通ったか」)で学ぶこと。蒸留(distillation)は大きなモデルの出力を小さなモデルに学ばせること。Kimina-Prover-Distill-1.5B の Distill がこれ |
| 補題、部分目標 | 補題(lemma)は本題を証明する途中で用意する小さな定理。部分目標(subgoal)は、いま証明すべきことを分割した一つ一つ。have は補題を書き記す語 |
| 自動定理証明器(ATP)、SMT ソルバー | 人の指示なしに証明を探す外部プログラム。sledgehammer はこれらを呼び出す。Lean-auto や Lean-SMT は、Lean からこれらを呼ぶための新しい仕組み |
| pass@k | k 回試して1回でも正解すれば正解と認める成績。pass@1 は一発勝負、pass@32 は32回試行 |
| 自動形式化(autoformalization) | 日常の言葉で書かれた数学の問題を、AIが Lean などの形式言語へ翻訳すること |
| 素描(sketch) | 証明の骨格。「まずこれを示し、次にこれを示し、最後にこれを結ぶ」という中間の主張の列 |
| 専門家反復(expert iteration) | AIに証明を生成させ、検査を通ったものだけを学習データに加えて学習し直す、という繰り返し |
TL;DR
(この節の専門用語は、上の「用語の確認」を参照してください)
-
人間の証明や素描を学習する Neural Theorem Prover では、宣言的スタイルで骨格を立て、タクティクで隙間を埋める形が見られます。
haveで中間の主張を宣言し、その中身をnlinarithやsimpなどのタクティクで片付ける書き方です
-
学習データ自体が2層構造です。 大きなモデルが証明の素描(宣言的)を作り、小さなモデルが各部分目標の証明(タクティク)を埋め、その組み合わせが学習データになります。DeepSeek-Prover-V2 がその典型です
-
ただし、
haveが並んでいれば読みやすいわけではありません。 論文自身が「最初の数行は自明な変形で、最後の一行が一気に片付けている」と述べ、別の論文は生成された証明を「冗長」と評しています
-
Lean 99.6%・Isabelle 66.0% という成績の差は、記法の優劣ではなく、ライブラリの規模と問題集の性質によるものです
-
どちらのスタイルで書くかは、学習データと学習方式で決まります。
人間の証明や素描で学んだモデルはhaveの列を書き、強化学習と探索で証明を見つけた AlphaProof はhaveをほとんど使いません。
また、Lean での混在は「Lean の自動化が未成熟なために強いられた妥協だ」と指摘する研究(IsaMini、2025年)もあります
-
この記事の第10部で取り上げる10件の Neural Theorem Prover を並べると、入力の形式が見えてきます。
多くは、Lean や Isabelle などの形式言語で書かれた主張を入力にしています。
ただし Draft, Sketch, and Prove のように、日常の言葉で書かれた問題から出発する研究もあります。
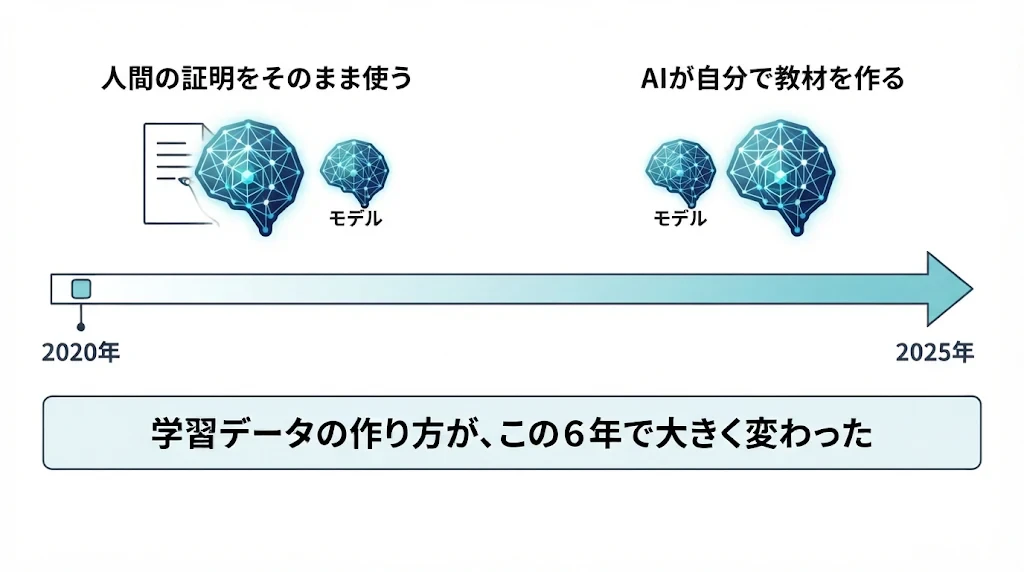
他方で、学習データの作り方は、この6年で大きく変わりました。
方向性としては、「人間の証明をそのまま使う」(2020年)から、「AIが自分で教材を作る」(2025年)への変化 です。
想定読者
-
連載第1回を読まれた方、または 過去に公開済みの記事(タクティクスタイル) と 過去に公開済みの記事(宣言的スタイル) を読まれた方
- Python は書けるが、形式手法や定理証明支援系は専門ではない方
- 機械学習に携わっており、Neural Theorem Prover の学習データと出力の実物を見たい方
本稿の論旨展開
(上の mermaid 図の色の見方) 灰:問い/青:根拠/橙:留保/緑:答え/濃い緑:次回へ
第9部 ── AIは、タクティク記法と宣言的スタイル記法のどちらを学び、どちらで書いているのか
この部の問いは、「Lean や Isabelle 向けの証明を生成するAI(Neural Theorem Prover)は、タクティク記法と宣言的スタイル記法のどちらで学習し、どちらで証明を書いているのか」です。
TL;DR で短く答えました。
ここでは、実際にAIが生成したコードを見ながら詳しく扱います。
タロウくん:
先生、第1回で「AIは have で証明の骨格を立て、タクティクで隙間を埋める」とおっしゃいました。
でも、本当にそう書いているのか、実物を見ないと納得できません。
専任講師:
もっともです。
では、議論の前に、実際に生成されたコードを一本読みましょう。
実際に生成されたコードを、ご覧ください
Goedel-Prover(プリンストン大学などの研究者が2025年に発表した、Lean 4 の証明を生成するオープンソースのモデル)の論文に、生成された証明の典型例が掲載されています。
theorem lean_workbook_13176 (x y z : ℝ) (hx : x > 0) (hy : y > 0) (hz : z > 0)
    (h : x * y * z = 1) :
    1 / (x ^ 2 + x + 1) + 1 / (y ^ 2 + y + 1) + 1 / (z ^ 2 + z + 1) ≥ 1 := by
  -- 分母が正であることを示す
  have h1 : 0 < x ^ 2 + x + 1 := by nlinarith
  have h2 : 0 < y ^ 2 + y + 1 := by nlinarith
  have h3 : 0 < z ^ 2 + z + 1 := by nlinarith
  -- 分母を払う
  field_simp [h1, h2, h3]
  -- 一次算術で扱える形に書き換える
  rw [le_div_iff (by positivity)]
  -- 一次算術で不等式を証明する
  nlinarith [sq_nonneg (x + y + z), sq_nonneg (x - y), sq_nonneg (y - z), sq_nonneg (z - x)]
機械学習の文脈に置き換えると、have の並びは、処理を小さな関数に分けて中間結果に名前を付けていく書き方にあたります。
そして最後の nlinarith の一行が、分けておいた中間結果をすべて引数に渡して、重いソルバーに丸投げしている部分です。
ここから分かること:中間の主張は have で書かれているが、実質的な推論は最後の強力なタクティクに集中している。
見た目は宣言的でも、読んで筋を追えるかどうかは別の問題である。
出典:"Goedel-Prover: A Frontier Model for Open-Source Automated Theorem Proving", arXiv:2502.07640, 2025年、図13。なお、コード中の注釈は原文では英語であり、筆者が日本語に訳しました。
このコードを、読んでみてください。
have h1 : 0 < x ^ 2 + x + 1 ── これは宣言的スタイルの語です。「この時点で、x² + x + 1 は正である」という主張を、コードに書き記しています。
nlinarith、field_simp、rw、positivity ── これらはタクティクです。「この方針で処理せよ」という指示です。
つまり、1つの証明の中に、両方のスタイルが混在しているのです。 そして、その役割分担は明確です。
-
haveが、示すべき中間の主張を宣言する
- タクティクが、その主張を実際に片付ける
過去に公開済みの記事で扱った「骨格を書いて、隙間を埋める」という構図が、そのまま現れています。
ただし、論文自身が懸念を述べています
同じ論文が、この証明の書き方について、次のように述べています。
We observe that the proofs provided by Goedel-Prover-SFT often rely on high-level tactics such as nlinarith and simp_all among others.
These high-level tactics handle multiple reasoning steps internally, delegating the resolution of intermediate steps to their built-in automation. The first several steps involve only trivial transformations of the original problem, whereas the final line uses nlinarith to immediately achieve the goal.
Whether this style of proof is sufficient for complex reasoning remains an important area for exploration.
筆者による日本語訳
Goedel-Prover-SFT が生み出す証明は、
nlinarithやsimp_allといった高水準のタクティクに頼ることが多いと、我々は観察している。 これらの高水準のタクティクは、複数の推論の段階を内部で処理し、中間の段階の解決を、組み込みの自動化に委ねている。最初のいくつかの段階は、元の問題を自明に変形しているだけであり、最後の行がnlinarithを使って一気に目標に到達している。 この様式の証明が、複雑な推論に対して十分であるかどうかは、探究すべき重要な領域として残っている。
(SFT は supervised fine-tuning、教師あり微調整の略で、人間や上位モデルが用意した「主張と証明」の対で追加学習したモデルを指します)
出典:同上、付録F
have によって、骨格らしきものは書かれています。 しかし、その中身のほとんどが、最後の一行の強力なタクティクに押し込まれてしまっているのです。
モデルによって、書き方が違う
同じ問題を複数のモデルに解かせ、生成された証明を比べた研究があります。
The proof generated by DeepSeek-Prover V2 is the longest, around 60 lines. Similar to Kimina-Prover, it also extensively uses have to introduce and prove a series of lemmas.
However, the proof of those lemmas, and its subsequent applications, are broken down into many fine-grained steps involving positivity, nlinarith, linarith, and rw[div_le_div_iff...].
While logically sound, this approach of explicitly stating and proving multiple intermediate steps results in a more verbose proof.
筆者による日本語訳
DeepSeek-Prover V2 が生成した証明が最も長く、約60行である。 Kimina-Prover と同様に、これもまた
haveを多用して、一連の補題を導入し証明している。しかし、それらの補題の証明と、その後の適用は、
positivity、nlinarith、linarith、rw[div_le_div_iff...]といった、多くの細かい段階へ分解されている。論理的には健全であるが、複数の中間の段階を明示的に述べて証明するというこの手法は、より冗長な証明をもたらす。
出典:"MPS-Prover: Advancing Stepwise Theorem Proving by Multi-Perspective Search and Data Curation", arXiv:2505.10962, 2025年
この比較から、2つのことが分かります。
第1に、DeepSeek-Prover V2 も Kimina-Prover も、have を多用しています。
そして第2に、そのことが「冗長」と評されているという点です。
過去に公開済みの記事で扱った論点が、そのまま再現しています。 宣言的スタイルは読みやすいが、長くなる。
学習データは、何でできているのか
では、これらのモデルは何を学んだのでしょうか。 順に見ていきます。
DeepSeek-Prover-V2 の場合
公式の説明には、こうあります。
We prompt DeepSeek-V3 to decompose theorems into high-level proof sketches while simultaneously formalizing these proof steps in Lean 4, resulting in a sequence of subgoals.
We use a smaller 7B model to handle the proof search for each subgoal.
筆者による日本語訳
我々は DeepSeek-V3 に、定理を高水準の証明の素描へ分解させ、同時にそれらの証明の段階を Lean 4 で形式化させる。
その結果、部分目標の列が得られる。
各部分目標の証明の探索は、より小さな7B(パラメータ数70億)のモデルが担う。
出典:deepseek-ai/DeepSeek-Prover-V2
そして、解けた部分目標の証明を組み合わせて完全な証明を作り、それを学習データとするのです。
つまり、学習データは次の2つの層から構成されています。
-
上の層 ── 大きなモデルが作った証明の素描。これは宣言的な構造です
- 下の層 ── 小さなモデルが埋めた各部分目標の証明。これはタクティクです
Kimina-Prover の場合
DeepSeek-Prover-V2 の論文が、両者の違いを説明しています。
In contrast, Kimina-Prover adopts a reverse workflow: it begins by collecting complete formal proofs alongside their informal counterparts, then uses general-purpose reasoning models to retrosynthesize intermediate natural-language reasoning steps.
筆者による日本語訳
対照的に、Kimina-Prover は逆向きの流れを採る。
まず、完全な形式的証明と、それに対応する非形式的な証明を、対にして集める。
そして汎用の推論モデルを使って、その中間にある自然言語の推論の段階を、遡って合成するのである。
出典:"DeepSeek-Prover-V2", arXiv:2504.21801, 2025年
つまり、こうです。
-
DeepSeek-Prover-V2 ── 上から下へ。 素描を作り、それを埋める
- Kimina-Prover ── 下から上へ。 完成した証明から、その途中の考えを復元する
方向は逆ですが、どちらも「日常の言葉での推論」と「形式的な証明」を対応づけようとしています。
Isabelle 向けの研究は、宣言的スタイルを前提にしている
Isabelle を扱う研究は、宣言的スタイルを前提に組み立てられています。
2022年の Draft, Sketch, and Prove 以来、主流となっている手法は次のとおりです。
-
日常の言葉で証明の下書きを書く
-
それを Isar(Isabelle の宣言的スタイルの証明言語)の骨格へ変換する
- 残った隙間を sledgehammer が埋める
2番で生成されるのは、assume、have、show を並べた宣言的スタイルのコードです。
PutnamBench の論文が、その理由を明記しています。
The Isabelle proof assistant (Paulson, 1994), given its declarative nature and powerful symbolic automation, has too been the focus of much attention for neural theorem proving.
筆者による日本語訳
Isabelle は、その宣言的な性質と強力な記号的自動化ゆえに、ニューラル定理証明において多くの注目を集めてきた。
出典:"PutnamBench", arXiv:2407.11214, 2024年
「宣言的な性質」が、研究者を引きつけた理由として挙げられています。
Lean の証明にも、構造はある
Lean の証明は「タクティクの列」だと思われがちですが、ProofAug(清華大学などの研究者による、生成された証明の構造を解析して自動化で補う手法、ICML 2025)の論文の付録に、それを否定する観察が書かれています。
Although Lean proofs can be completely tactic-based, block-structures starting with
byare very common as well, especially for the proofs of Olympics-level math problems.As a result, Lean proofs are also amendable for proof structure analysis.
筆者による日本語訳
Lean の証明は完全にタクティクだけで書くこともできるが、
byで始まるブロック構造もまた、非常によく見られる。 とりわけ数学オリンピック水準の問題の証明においてそうである。その結果、Lean の証明もまた、証明の構造分析にかけることができる。
出典:
"ProofAug", ICML 2025, 付録C
そして実際、ProofAug の Lean 4 版は、Kimina-Prover-Preview-Distill-1.5B(Kimina-Prover の出力を蒸留して作った、パラメータ数15億の小型モデル)の miniF2F-test での pass@1 の成績を、44.3%から50.4%へ引き上げました。
Isabelle 向けに作られた手法が、Lean でも成果を上げたのです。
その理由が、「Lean の証明にも構造があるから」という点にあります。
Lean の混在は、自動化の不足が強いた妥協か ── IsaMini の指摘
タロウくん:
先生、ここまでの話だと、Lean では have とタクティクを混ぜるのが当たり前のように聞こえます。
それは、混ぜるのが良いからですか。それとも、混ぜざるを得ないからですか。
専任講師:
「混ぜざるを得ないからだ」と正面から主張する論文があります。
南洋理工大学と MBZUAI の研究者による IsaMini(2025年7月)です。
Isabelle の証明言語 Isar を、LLM(大規模言語モデル)向けに再設計した研究です。
論文は、宣言的スタイルの NTP に必要な条件を3つ挙げています。
-
宣言的な証明言語があること
-
タクティクへの依存を最小にできる、強力な自動証明があること
- 宣言的スタイルで書かれた、大規模な学習コーパスがあること
そして、Isabelle はこの3つを満たすと述べます。
Isabelle の標準ライブラリと Archive of Formal Proofs は約540万行・約35.6万証明で、Lean の Mathlib は約120万行だと比較しています。
にもかかわらず、研究者は Lean へ移った。 論文はそう述べ、その帰結をこう書いています。
On the other hand, researchers have turned to Lean, where they have had to settle for impure declarative approaches that interweave tactics due to Lean's limited automation infrastructure; they have also expended significant resources building and expanding declarative-style training corpora. Even these imperfect methods yield excellent results.
(筆者による日本語訳)
**他方で、研究者たちは Lean へ移った。そこでは Lean の自動化基盤が限られているために、タクティクを織り交ぜる不純な宣言的手法で妥協せざるを得ず、宣言的スタイルの学習コーパスを構築し拡張することに多大な資源を費やしてもきた。
それでも、これらの不完全な手法は優れた結果を生んでいる。**
出典:
Qiyuan Xu, Renxi Wang, Haonan Li, David Sanán, Conrad Watt, "IsaMini: Redesigned Isabelle Proof Language for Machine Learning", arXiv:2507.18885, 2025年
ここから分かること:
Lean で have とタクティクが混ざるのは、設計上の最善だからではなく、Lean の自動化が追いついていないためだ、というのがこの論文の立場である。
タロウくん:
・・・「不純な宣言的手法」。
本稿で見てきた have +タクティクの形は、妥協の産物だということですか。
専任講師:
この論文の立場では、そうです。
同じ論文は、2024年以降に arXiv に出た Neural Theorem Proving(NTP)の論文58本のうち、Isabelle を使うものは8本だけだとも数えています。
条件が揃っている Isabelle が使われない理由として、論文は2つを挙げます。
-
機械学習向けの並行 REPL 基盤(AIが生成した証明を Isabelle に大量に並列で検査させる仕組み)が無かったこと
-
Isar が人間向けに作られすぎていること。
hence・moreover・ultimatelyのような連結詞や、this・thatのような代名詞は、数学者の書き方には近いが、LLM には学びにくい。
ある実験では、Isar を生成しようとした失敗の76%が構文エラーだった、と引いています
そこで論文は、Isar から人間向けの装飾を削ぎ落とした MiniLang という言語を設計しました。
Archive of Formal Proofs の約85%を機械的に MiniLang へ翻訳して学習データにし、PISA ベンチマーク(Isabelle の Archive of Formal Proofs から無作為に採った約3,000の証明目標。
競技数学ではなく、実務的な証明が対象)で、同じ基盤モデル(DeepSeek-Prover-Base v1.5)の pass@1 を Isar の40.2%から MiniLang の69.1%へ 引き上げたと報告しています。
タロウくん:
言語を変えただけで、29ポイント。
専任講師:
ただし、自動化を切ると逆転します。
論文は、Sledgehammer を無効にしてタクティクだけで証明させると、MiniLang は Isar より約5ポイント劣ると報告し、次の知見を掲げています。
Finding: A beneficial proof language for declarative NTP is not necessarily beneficial for tactic-based NTP.
(筆者による日本語訳)
知見:宣言的な NTP に有利な証明言語が、タクティク型の NTP にも有利とは限らない。
タロウくん:
・・・宣言的な骨格を書かせるなら、隙間を埋める自動化が必要。
自動化が無いなら、タクティクを書かせるほうがいい。
専任講師:
IsaMini の論文は、そう説明しています。
Lean の自動化基盤が限られていることが、have とタクティクを織り交ぜる方式が取られる一因だ、という分析です。
ただし、これは同論文の見方であり、Lean における混在の理由をすべて説明する唯一の説ではありません。
本稿は、これを有力な説明の1つとして紹介するにとどめます。
なお、この評価には時点の注記が要ります。
2025年には、Lean 向けの自動証明基盤として Lean-auto(Lean 4 と自動定理証明器の橋渡し)、Lean-SMT(SMT ソルバーを呼ぶタクティク)、LeanHammer(Isabelle の sledgehammer に相当する仕組み)が相次いで発表されました。
IsaMini の「Lean の自動化基盤は限られている」という評価は2025年前半時点のものであり、本稿の公開時点では状況が動いています。
Lean での have とタクティクの比率は、今後変わりうると見ておくべきです。
書き方は、学習の仕方で決まる ── AlphaProof との対比
タロウくん:
先生、第1回で AlphaProof の証明を読みました。
あれには have がほとんど無く、複数のタクティクが1行に詰め込まれていました。
本稿で見た Goedel-Prover や DeepSeek-Prover-V2 の証明とは、まるで違います。
専任講師:
良い観察です。その差は、学習の仕方の差です。
第1回の第6部で見たとおり、AlphaProof は約100万の問題を自動形式化して作った約8,000万の Lean の問題に対し、強化学習と探索で証明を見つけています。
報酬は「Lean の検査を通るか」だけで、人間の書き方を模倣する圧力がありません。
だから、通りさえすれば、タクティクを詰め込んだ読みにくい証明になります。
変数名が u、hz、b になるのも、同じ理由です。
一方、本稿で見た Goedel-Prover、Kimina-Prover、DeepSeek-Prover-V2 は、人間が書いた証明や、人間の書き方を模した素描を対にしたデータで学んでいます。
だから have の列が出てきます。
タロウくん:
・・・つまり「AIはどちらのスタイルで書くか」という問いの答えは、「学習データと学習方式による」ということですか。
専任講師:
そうです。
人間の証明で学んだモデルは、人間に似た骨格を書く。
検査を通ることだけを報酬にして探索したモデルは、骨格を書かない。
そして、第1回の後半で読んだ Claude のゼータ関数の論文の Lean コードは、have が31か所、タクティクが33か所と、ほぼ同数でした。
人間の数学論文を読んで育った汎用モデルが、人間の書き方に寄るのは自然なことです。
数で確かめる ── Mathlib と生成コードを実際に数える
タロウくん:
先生、ここまで事例で見てきましたが、本当にそうなのでしょうか。
have が実際にどれだけ使われているかを、数で確かめられませんか。
専任講師:
確かめられます。
Mathlib も、生成された証明も、公開されています。
数えてみましょう。
人間が書いた証明では、どうか
まず、Mathlib を数えます。
Lean 4 の数学ライブラリで、人間が書いた証明の集まりです。
数え方の中核は、正規表現2本です。
import re

# theorem / lemma の宣言を拾う
DECL = re.compile(
    r'^\s*(?:@\[[^\]]*\]\s*)?'
    r'(?:private\s+|protected\s+|nonrec\s+|noncomputable\s+)*'
    r'(theorem|lemma)\s')

# have の出現。行頭、空白の後、· の後、<;> の後を数える
HAVE = re.compile(r'(?:^|\s|·\s*|<;>\s*)have\s')

def count(block):
    """1つの定理について、(行数, have の個数)を返す。"""
    body = re.sub(r'--.*', '', block)              # 行コメントを除く
    body = re.sub(r'/-.*?-/', '', body, flags=re.S)  # ブロックコメントを除く
    lines = [l for l in body.split('\n') if l.strip()]
    return len(lines), len(HAVE.findall(body))
あとは、ファイルを DECL で定理の単位に区切り、1件ずつ count に渡して集計するだけです。
宣言の区切り方と、長さ別の集計を含む全体は、折りたたみの中に収めました。
count_have.py の全文(94行)
"""
Mathlib の証明の中で、`have` がどれだけ使われているかを数える。

使い方
  git clone --depth 1 --filter=blob:none --sparse https://github.com/leanprover-community/mathlib4.git
  cd mathlib4 && git sparse-checkout set Mathlib && cd ..
  python3 count_have.py mathlib4/Mathlib

注意:
Lean 4 の構文を正確に解析しているわけではない。
行頭の字句を見る単純な方法で、おおよその傾向をつかむためのもの。

"""
import re
import sys
from collections import Counter
from pathlib import Path

# theorem / lemma の宣言を拾う
DECL = re.compile(
    r'^\s*(?:@\[[^\]]*\]\s*)?'
    r'(?:private\s+|protected\s+|nonrec\s+|noncomputable\s+)*'
    r'(theorem|lemma)\s')

# have の出現。行頭、空白の後、· の後、<;> の後を数える
HAVE = re.compile(r'(?:^|\s|·\s*|<;>\s*)have\s')

BUCKETS = [(1, 1, '1行'), (2, 3, '2〜3行'), (4, 10, '4〜10行'),
           (11, 30, '11〜30行'), (31, 100, '31〜100行'), (101, 10**9, '101行以上')]

def split_declarations(text):
    """ファイルを宣言の単位に粗く分割する。字下げのない行を区切りとみなす。"""
    lines = text.split('\n')
    blocks, cur, in_decl = [], [], False
    for ln in lines:
        if DECL.match(ln):
            if in_decl and cur:
                blocks.append('\n'.join(cur))
            cur, in_decl = [ln], True
        elif in_decl:
            if ln.strip() and not ln[0].isspace() and not ln.lstrip().startswith(('|', '·')):
                blocks.append('\n'.join(cur))
                cur, in_decl = [], False
            else:
                cur.append(ln)
    if in_decl and cur:
        blocks.append('\n'.join(cur))
    return blocks

def strip_comments(block):
    body = re.sub(r'--.*', '', block)
    return re.sub(r'/-.*?-/', '', body, flags=re.S)

def bucket(n):
    for lo, hi, name in BUCKETS:
        if lo <= n <= hi:
            return name
    return BUCKETS[-1][2]

def main(root):
    rows = []                      # (行数, have の個数)
    for f in sorted(Path(root).rglob('*.lean')):
        try:
            text = f.read_text(encoding='utf-8')
        except Exception:
            continue
        for block in split_declarations(text):
            body = strip_comments(block)
            lines = [l for l in body.split('\n') if l.strip()]
            rows.append((len(lines), len(HAVE.findall(body))))

    n = len(rows)
    with_have = sum(1 for _, h in rows if h > 0)
    total = sum(h for _, h in rows)
    print(f"定理・補題の数   : {n:,}")
    print(f"have を含むもの  : {with_have:,} 件 ({with_have / n * 100:.1f}%)")
    print(f"1件あたり平均   : {total / n:.2f} 個\n")

    print("--- 証明の長さ別 ---")
    print("  証明の長さ      定理の数   have を含む割合   1件あたりの have")
    for _, _, name in BUCKETS:
        sub = [r for r in rows if bucket(r[0]) == name]
        if not sub:
            continue
        w = sum(1 for _, h in sub if h > 0)
        t = sum(h for _, h in sub)
        print(f"  {name:12s} {len(sub):10,d}   {w / len(sub) * 100:12.1f}%   {t / len(sub):14.2f}")

if __name__ == "__main__":
    main(sys.argv[1] if len(sys.argv) > 1 else 'mathlib4/Mathlib')
実行結果です。
集計の条件を書いておきます。
2026年11月時点の Mathlib の main ブランチ、ファイル8,705本、約237万行です。
Mathlib は日々更新されるため、別の時点で実行すれば数字は変わります。
再現したい方は、取得したコミットを控えておくことをお勧めします。
定理・補題の数   : 192,515
have を含むもの  : 17,619 件 (9.2%)
1件あたり平均   : 0.19 個

--- 証明の長さ別 ---
  証明の長さ      定理の数   have を含む割合   1件あたりの have
  1行               15,150            0.0%             0.00
  2〜3行            99,270            0.4%             0.00
  4〜10行           62,438           12.2%             0.15
  11〜30行          13,860           57.4%             1.22
  31〜100行          1,750           92.0%             5.05
  101行以上             47          100.0%            16.57
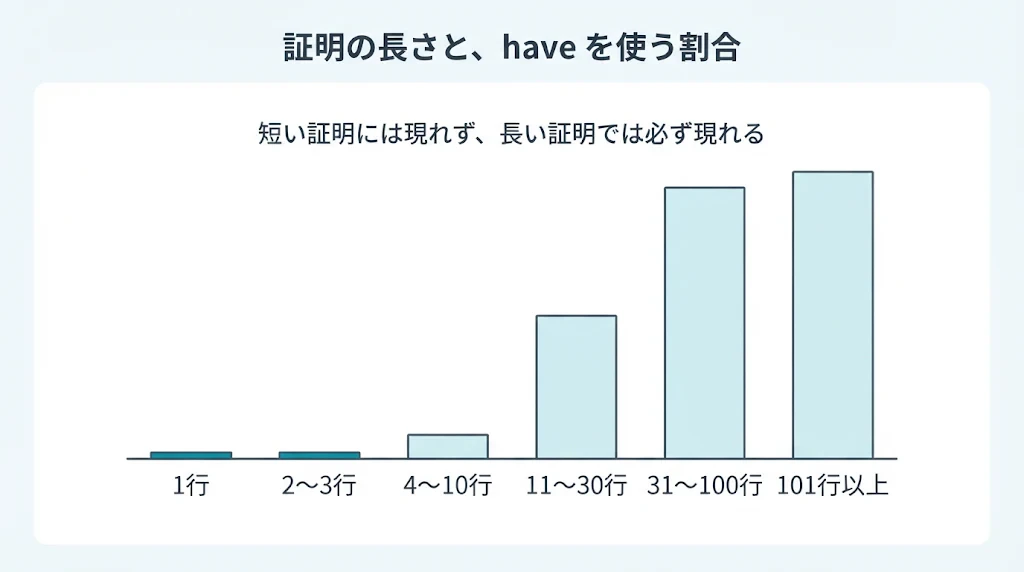
まず、全体の数字に驚かされます。
Mathlib の定理19万件のうち、
haveを含むのは 9.2% だけです。
しかし、長さ別に見ると、様子がまったく違います。
1行の証明では、have は一度も使われません。
2〜3行でも、0.4%です。
ところが11〜30行になると57.4%、31〜100行では 92.0%、101行以上では 100% が have を含みます。
つまり、こういうことです。
Mathlib の大多数は短い補題で、中央値はわずか3行です。
そういう証明に have は要りません。
haveは、証明が長くなったときに現れます。
そして長い証明では、ほぼ例外なく使われています。
ここで、第1回と第9部のここまでの話がつながります。
AIが解こうとしている miniF2F の問題は、1行では終わりません。
最初から、have が必要な長さの領域で勝負しているのです。
生成された証明では、どうか
次に、AIが生成した証明を数えます。
DeepSeek-Prover-V2 の公式リポジトリには、miniF2F を解いた証明が438本、そのまま公開されています。
1本目との違いは、2点だけです。
第1に、生成証明は1ファイルに1証明なので、import などのヘッダを落として本体だけを取り出します。
第2に、行数をそろえて比べます。
生成証明は長いので、全体の平均を比べるだけでは「長いから have が多い」で終わってしまうからです。
from count_have import HAVE, split_declarations, strip_comments

def analyze_generated(root):
    """生成された証明。1ファイル1証明。import などのヘッダを落とす。"""
    rows = []
    for f in sorted(Path(root).rglob('*.lean')):
        text = f.read_text(encoding='utf-8')
        i = text.find('theorem ')
        if i < 0:
            continue
        body = strip_comments(text[i:])
        lines = [l for l in body.split('\n') if l.strip()]
        rows.append((len(lines), len(HAVE.findall(body))))
    return rows

# 行数の区間ごとに、生成と人間を並べて集計する
for lo, hi, label in [(1, 10, '1〜10行'), (11, 30, '11〜30行'),
                      (31, 100, '31〜100行'), (101, 10**9, '101行以上')]:
    g = [r for r in gen if lo <= r[0] <= hi]
    m = [r for r in ml  if lo <= r[0] <= hi]
    ...
compare_generated.py の全文(74行)
"""
AIが生成した証明と、人間が書いた証明で、have の使い方を比べる。

生成側:DeepSeek-Prover-V2 が miniF2F を解いた証明
  git clone --depth 1 https://github.com/deepseek-ai/DeepSeek-Prover-V2.git
  cd DeepSeek-Prover-V2 && unzip minif2f-solutions.zip -d sol && cd ..

人間側:Mathlib の証明(count_have.py と同じ取得方法)

行数をそろえて比べる点が重要。
生成証明は長いので、全体の平均を比べるだけでは「長いから have が多い」で終わってしまう。
"""
import re
import sys
from pathlib import Path
from count_have import HAVE, split_declarations, strip_comments

def analyze_generated(root):
    """生成された証明。1ファイル1証明。import などのヘッダを落とす。"""
    rows = []
    for f in sorted(Path(root).rglob('*.lean')):
        text = f.read_text(encoding='utf-8')
        i = text.find('theorem ')
        if i < 0:
            continue
        body = strip_comments(text[i:])
        lines = [l for l in body.split('\n') if l.strip()]
        rows.append((len(lines), len(HAVE.findall(body))))
    return rows

def analyze_mathlib(root):
    rows = []
    for f in sorted(Path(root).rglob('*.lean')):
        try:
            text = f.read_text(encoding='utf-8')
        except Exception:
            continue
        for block in split_declarations(text):
            body = strip_comments(block)
            lines = [l for l in body.split('\n') if l.strip()]
            rows.append((len(lines), len(HAVE.findall(body))))
    return rows

def summarize(name, rows):
    n = len(rows)
    with_have = sum(1 for _, h in rows if h > 0)
    total = sum(h for _, h in rows)
    med = sorted(l for l, _ in rows)[n // 2]
    print(f"  {name:26s} {n:7,d}件   中央値 {med:4d}行   "
          f"have を含む {with_have / n * 100:5.1f}%   1件平均 {total / n:5.2f}個")

if __name__ == "__main__":
    gen = analyze_generated(sys.argv[1] if len(sys.argv) > 1 else 'DeepSeek-Prover-V2/sol')
    ml = analyze_mathlib(sys.argv[2] if len(sys.argv) > 2 else 'mathlib4/Mathlib')

    print("=== 全体の比較 ===")
    summarize("生成(DeepSeek-Prover-V2)", gen)
    summarize("人間(Mathlib 全体)", ml)

    print("\n=== 行数をそろえた比較 ===")
    for lo, hi, label in [(1, 10, '1〜10行'), (11, 30, '11〜30行'),
                          (31, 100, '31〜100行'), (101, 10**9, '101行以上')]:
        g = [r for r in gen if lo <= r[0] <= hi]
        m = [r for r in ml if lo <= r[0] <= hi]
        print(f"\n【{label}】")
        if g:
            summarize("生成(DeepSeek-Prover-V2)", g)
        if m:
            summarize("人間(Mathlib)", m)
実行結果です。
=== 全体の比較 ===
  生成(DeepSeek-Prover-V2)         438件   中央値   35行   have を含む  96.8%   1件平均 20.89個
  人間(Mathlib 全体)             192,515件   中央値    3行   have を含む   9.2%   1件平均  0.19個

=== 行数をそろえた比較 ===

【1〜10行】
  生成(DeepSeek-Prover-V2)          38件   中央値    7行   have を含む  71.1%   1件平均  1.26個
  人間(Mathlib)                176,858件   中央値    3行   have を含む   4.5%   1件平均  0.06個

【11〜30行】
  生成(DeepSeek-Prover-V2)         160件   中央値   22行   have を含む  98.8%   1件平均  5.92個
  人間(Mathlib)                 13,860件   中央値   15行   have を含む  57.4%   1件平均  1.22個

【31〜100行】
  生成(DeepSeek-Prover-V2)         176件   中央値   48行   have を含む  99.4%   1件平均 17.58個
  人間(Mathlib)                  1,750件   中央値   40行   have を含む  92.0%   1件平均  5.05個

【101行以上】
  生成(DeepSeek-Prover-V2)          64件   中央値  152行   have を含む 100.0%   1件平均 79.08個
  人間(Mathlib)                     47件   中央値  113行   have を含む 100.0%   1件平均 16.57個
この数字から分かること
第1に、本稿の主張は裏づけられました。
今回集計した DeepSeek-Prover-V2 の生成証明では、96.8% が have を含みます。
このモデルについては、have を使って宣言的な骨格を立てる傾向が確認できました。
第2に、しかしそれだけではありません。
行数をそろえて比べても、AIは人間の3倍から5倍の
haveを使っています。
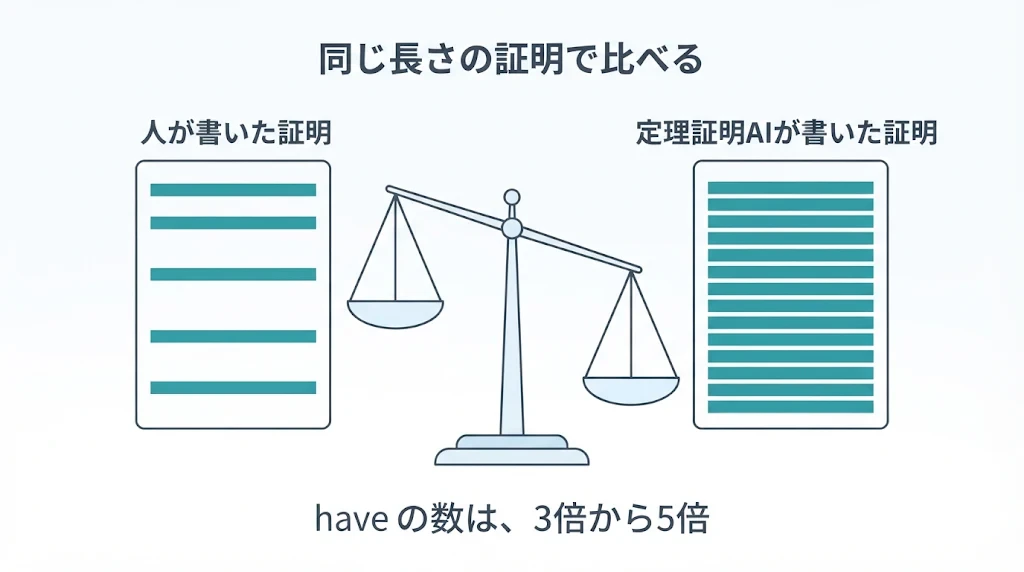
| 証明の長さ | 生成 | 人間 | 倍率 |
|---|---|---|---|
| 11〜30行 | 5.92個 | 1.22個 | 4.9倍 |
| 31〜100行 | 17.58個 | 5.05個 | 3.5倍 |
| 101行以上 | 79.08個 | 16.57個 | 4.8倍 |
第3に、これが「冗長」という評価の正体です。
本稿の前半で、DeepSeek-Prover-V2 の生成コードが別の論文から「冗長」と評されていることに触れました。
その評価が、数字で裏づけられた形になります。
同じ長さの証明を書くのに、AIは人間の何倍もの中間の主張を立てています。
第4に、長さそのものも違います。
生成証明の中央値は35行、101行を超えるものが64本あります。
Mathlib で101行を超える証明は、19万件のうち47件だけです。
タロウくん:
・・・定理証明AIは、人間なら書かない長さと密度で、have を並べているのですか?
専任講師:
そのとおりです。
そして、ここで本稿の前半の論点に戻ります。
have が並んでいることと、読んで筋が追えることは、同じではありません。
なお、この集計の限界を書いておきます。
この方法は、Lean 4 の構文を正確に解析しているわけではありません。
行頭の字句を見る単純な方法です。
have が文字列や識別子の一部として現れる場合も数えてしまいますし、宣言の区切りの判定も粗いものです。
また、比べたのは DeepSeek-Prover-V2 の1モデルだけです。
他のモデルでは違う結果になる可能性があります。
数字は、おおよその傾向を示すものとして読んでください。
手元で動かさなくても、この節は読み飛ばさずに済みます。
この集計から持ち帰っていただきたいのは、**「AIは人間より長く、密に have を並べる」**という傾向そのものです。
数字を確かめたい方のために環境構築の手順も書きますが、結果だけ読んで次に進んでいただいて構いません。
この節で使った2本のスクリプトは、筆者(Etale Cohomology)の GitHub で公開しています。
記事に載せた全文と同じものです。
取得して、そのまま実行できます。
出典
- Mathlib 4(leanprover-community/mathlib4)。2026年11月時点の main ブランチ
- DeepSeek-Prover-V2 公式リポジトリの
minif2f-solutions.zip。https://github.com/deepseek-ai/DeepSeek-Prover-V2
整理します
| 学習データの上の層 | 学習データの下の層 | 生成されるコード | |
|---|---|---|---|
| DeepSeek-Prover-V2(Lean) | 証明の素描(宣言的) | 各部分目標の証明(タクティク) | have の列+タクティク。約60行 |
| Kimina-Prover(Lean) | 完成した証明から遡って合成した日常の言葉の推論 | 完全な形式的証明 | have を多用 |
| Goedel-Prover(Lean) | 日常の言葉の問題を自動形式化した約164万件の Lean 4 の主張 | 専門家反復で、それらの主張にモデル自身が付けた証明 | have の列+高水準タクティク |
| Draft, Sketch, and Prove 以降(Isabelle) | 日常の言葉の下書き | Isar の骨格+sledgehammer | Isar の骨格 |
| AlphaProof(Lean) | 自動形式化した約8,000万の主張(素描なし) | 強化学習と探索で見つけた証明 | タクティクの詰め込み。have はほぼ無し |
| 研究用 Claude(Lean、第1回参照) | 人間の数学論文・コード(汎用モデル) | ── | have 31か所、タクティク 33か所 |
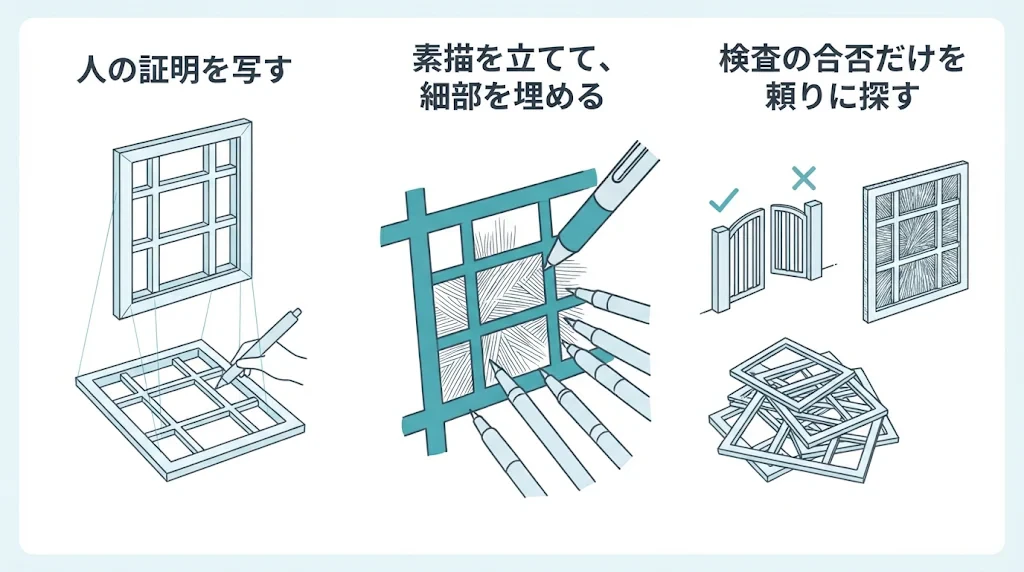
学習の仕方は、大きく3つの型に分かれます。
型Ⅰから型Ⅲへ進むほど、人間の書き方を模倣する圧力が弱くなります。
そして、それがそのまま、生成されるコードの形に現れます。
次のことが言えます。
第1 に、人間の証明や素描で学んだモデルでは、どちらの言語でも、have による宣言的な構造が使われています。
第2 に、その have の中身は、タクティクや自動化で埋められています。
第3 に、学習データ自体が、「素描と、その中身」という2層構造で作られています。
第4 に、強化学習と探索だけで証明を見つけた AlphaProof には、この構造がありません。書き方は学習の仕方で決まります。
つまり、答えはこうです
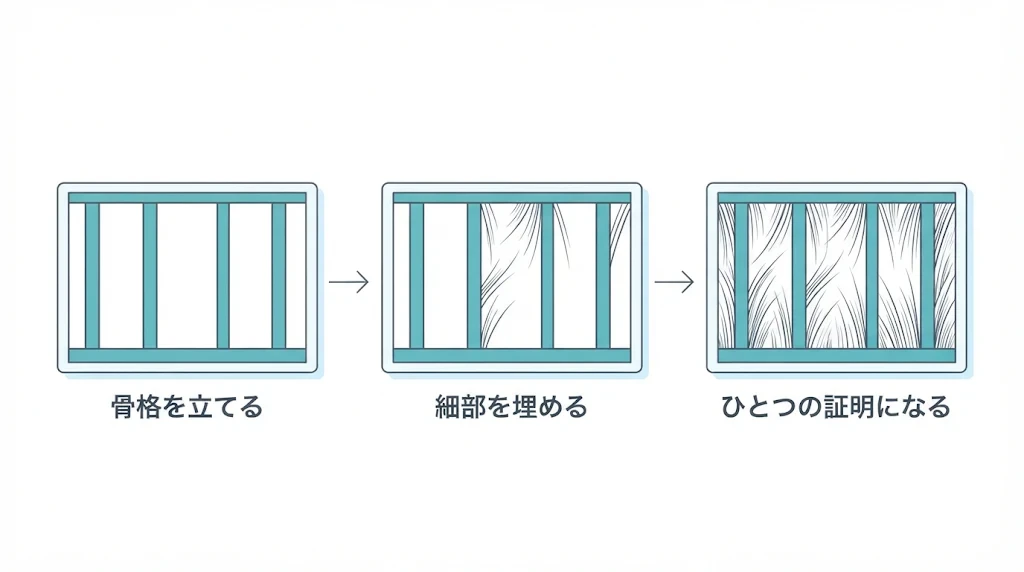
人間の証明や素描を学ぶモデルでは、宣言的な骨格を立て、タクティクで埋める形が見られます。
そして、生成するコードも、その形をしています。
ただし、すべてのAIがそうなるわけではありません。
強化学習と探索を中心に証明を見つけるモデルでは、同じ形になるとは限りません。
生成される証明のスタイルは、学習データと学習方式によって決まります。
この点は、このあとの「書き方は、学習の仕方で決まる」で詳しく扱います。
過去に公開済みの記事の最後で、次のように書きました。
「タクティクで探し、宣言的スタイルで残す」
AIの研究では、順序が逆になっています。
「宣言的スタイルで骨格を立て、タクティクで埋める」
しかし、どちらの場合も、2つのスタイルが役割を分担しているという点は同じです。
ただし、その骨格の質は問われています
最後に、注意すべき点を申し上げます。
have が並んでいれば、読みやすいわけではありません。
先ほど見た Goedel-Prover の例では、最初の数行が自明な変形であり、最後の一行がすべてを片付けていました。
そして DeepSeek-Prover V2 の証明は、約60行の細かい段階に分解され、「冗長」と評されました。
この「冗長さ」は、2026年には数字で測られ始めています。
生成された Lean の証明を圧縮する研究が相次いでいます。
ProofOptimizer は、Goedel-Prover-V2 が生成した証明について、証明の長さを miniF2F で87.9%、PutnamBench で57.2% 短縮できたと報告しています。
(LeanPolish の論文による転記)
つまり、元の証明には、検査を通すうえでは必須でない記述が多く含まれていたということです。
証明の本数が減ったのではなく、1本あたりの長さが縮んだ、という数字です。
Proof-Refactor(2026年)は、その原因をこう整理しています。
検証器は「コンパイルが通ること」しか報酬にしない。
だから、再利用できる議論がインライン化され、既存の定義があるのに問題専用の定義が作られ、重い自動化と拡大した資源上限に頼った証明が生まれる、と。
出典
-
"LeanPolish: Verified Supervision for Lean Proof Compression", arXiv:2609.38384, 2026年(ProofOptimizer の短縮率は同論文の関連研究節より)
- "Proof-Refactor: Refactoring Generated Formal Proofs into Modular Artifacts", arXiv:2606.03743, 2026年
【筆者の見解】
宣言的スタイルの語を使うことと、読みやすい証明を書くことは、別のことだと筆者は考えます。
過去に公開済みの記事で、「宣言的スタイルの本質は語彙ではなく、論理構造をコードに残すことにある」と述べました。
AIが have を並べても、その一つ一つが自明な変形であったり、根拠がすべて自動化に委ねられていたりすれば、論理構造は残りません。
「have の多さと読みやすさは別だ」というこの論点は、本連載の第1回の記事の第8部で触れました。
本連載の第4回の記事の第14部で、「そもそも形式化された証明を人間が読む必要はあるのか」という問いとあわせて改めて扱います。
なお、Lean と Isabelle の成績には差があります
miniF2F での記録は、Lean が99.6%、Isabelle が66.0%です。
ただし、この2つの数値は、条件を揃えて比べたものではありません。 使ったモデルも、試行回数も、問題集の版も違います。
そして、この差はスタイルの違いによるものではありません。
HybridProver という研究の論文には、こう書かれています。
More work uses LLMs for Lean and gets better results on miniF2F than for Isabelle, because Lean is mainly used for mathematics, with the largest math library, and miniF2F is a mathematical benchmark suite.
In contrast, Isabelle users tend to focus more on system verification.
筆者による日本語訳
Lean を対象に LLM を使う研究のほうが多く、miniF2F での成績も Isabelle より良い。
それは、Lean が主に数学に使われ、最大の数学ライブラリを持ち、そして miniF2F が数学の問題集だからである。
対照的に、Isabelle の利用者はシステム検証により重きを置く傾向がある。
出典:
"HybridProver: Augmenting Theorem Proving with LLM-Driven Proof Synthesis and Refinement", arXiv:2505.15740, 2025年
つまり、差を生んでいるのは、ライブラリの規模と、問題集の性質です。
Lean と Isabelle の成績差の背景は、本連載の第1回の記事の第7部で詳しく扱いました。
第10部 ── 各AIは、何を入力され、何を出力し、何で学んだのか
本記事には、多数のAIが登場します。
それぞれについて、次の3点を整理します。
-
推論のときに、何を与えられたのか
-
何を出力したのか
- 学習には、何を使ったのか
AlphaProof については、本連載の第1回の記事の第6部で詳しく扱いました。
DeepSeek-Prover-V2 と Kimina-Prover の学習データについては、第9部で扱いました。
ここでは、それらを含む 10 の Neural Theorem Prover を、同じ3点で並べて見ていきます。
この記事で取り上げる10件は、次のとおりです。
- GPT-f
- Thor
- Draft, Sketch, and Prove
- Baldur
- LeanDojo と ReProver
- AlphaProof
- Kimina-Prover
- DeepSeek-Prover-V2
- Seed-Prover
- Prover Agent。
AlphaProof は第1回で詳しく扱ったため、ここでは表の中だけに登場します。
この10件を選んだ基準を書いておきます。
第1に、入力・出力・学習データが論文で確認できること。
第2に、方式が互いに異なること。
一手ずつ生成するもの、丸ごと生成するもの、素描を立てるもの、エージェントとして組み合わせるものを、それぞれ含めました。
第3に、Lean と Isabelle の両方を含めること。
網羅的な一覧ではありません。
この分野には、ここに挙げていない研究が多数あります。
本稿が参照した研究は、2026年10月までに公開されたものです。
この分野の進展は速く、記事の公開後に状況が変わる可能性があります。
タロウくん:
先生、第9部で「学習データが2層になっている」という話を聞きましたが、他の Neural Theorem Prover も同じなのでしょうか。
専任講師:
同じではありません。
2020年の GPT-f は人間の証明をそのまま使い、2022年の Draft, Sketch, and Prove は専用の学習をしていません。
並べて見ると、作り方が時代とともに変わっているのが分かります。
GPT-f(2020年、OpenAI)
言語モデルで形式的証明を生成するという研究の、出発点となった論文です。
入力 ── Metamath という定理証明支援系(Lean や Isabelle より古く、証明を記号の置き換え規則だけで検査する処理系)の「ゴール」、つまり、いま示すべき主張です。文字列として与えられます。
出力 ── 「証明の一手」(proofstep)です。具体的には、適用すべき定理と、その定理の変数に何を代入するかの組です。
論文には、入力と出力の対応が明記されています。
The proofstep objective we use for training is a conditional language modeling objective that is asked to generate the PROOFSTEP given a GOAL, which is directly applicable to proof searches.
筆者による日本語訳
学習に用いる proofstep の目的関数は、GOAL が与えられたときに PROOFSTEP を生成するよう求める、条件付きの言語モデリングの目的関数である。これは証明の探索に直接適用できる。
学習データ ── 3段階に分かれています。
第1段階(事前学習) ── Common Crawl、arXiv、GitHub、Mathematics Stack Exchange などの一般的なウェブのデータ。
第2段階(微調整) ── Metamath の set.mm ライブラリ。人間が書いた証明の集まりです。約37,000の定理から、およそ300万の証明の一手が取り出されました。
第3段階(専門家反復) ── モデル自身が見つけた証明を、学習データに戻します。
規模
最大のモデルで7億7,400万パラメータ、36層。
成果
23個の短縮された証明が、Metamath の公式ライブラリに採用されました。
深層学習に基づく定理証明AIが書いた証明が、形式数学の共同体に受け入れられた最初の事例とされています。
出典:S
tanislas Polu, Ilya Sutskever, "Generative Language Modeling for Automated Theorem Proving", arXiv:2009.03393, 2020年
Kimina-Prover(2025年、Numina と Kimi)
(Numina は競技数学向けのオープンなデータ集合を作っている非営利の研究プロジェクト、Kimi は中国の Moonshot AI が開発する LLM の名称です。両者の共同研究なので Kimina と名付けられています)
入力
Lean 4 の定理の主張です。
出力
ここが特徴的です。
思考のブロックと、Lean のコードが、交互に織り込まれた形で出力されます。
論文は、この形式を formal reasoning pattern(形式的推論のパターン)と呼んでいます。
「思考と証明を交互に学ばせる」という発想自体は、Lean-STaR(Haohan Lin, Zhiqing Sun, Sean Welleck, Yiming Yang、ICLR 2025)が先に示したものです。
Kimina-Prover は、それを大規模な強化学習と組み合わせました。
思考のブロックでは、モデルが日常の言葉で戦略を述べ、問題を分解し、途中の推論を素描します。
その中に、部分的な Lean のコードが混じることもあります。
そして最後に、完全な Lean の証明が出力されます。
学習データ
NuminaMath-LEAN という、競技数学から採った10万件の Lean 4 の主張と証明の集まりです。
このデータ集合は、人間が注釈を付けた Lean 4 のコーパスとしては最大とされています。
基盤モデル
Qwen2.5-72B(Alibaba が公開している、パラメータ数720億の LLM)。
学習の方法
Kimi k1.5 の強化学習の仕組みを使います。報酬は単純です。 生成した Lean のコードが検査を通れば1、通らなければ0。
成績
Preview 版(2025年4月)は miniF2F-test(miniF2F の試験用244問)で pass@8192(8,192回試して1回でも通れば正解)で80.7%。正式版の Kimina-Prover-72B(2025年7月)は pass@32 で84.0%、エラー修正を1回加えると86.4%、pass@1024 で87.7%、テスト時強化学習の探索を併用すると92.2%と報告されています。
注目すべき点
Lean のエラーメッセージを読み、修正を提案できます。 1から書き直すより、はるかに効率が良いと報告されています。
出典:
- Numina & Kimi Team, "Kimina-Prover Preview: Towards Large Formal Reasoning Models with Reinforcement Learning", arXiv:2504.11354, 2025年
-
AI-MO/Kimina-Prover-72B, Hugging Face(2025年7月。pass@32 で84.0%、TTRL 探索併用で92.2%)
- NuminaMath-LEAN, Hugging Face
DeepSeek-Prover-V2(2025年、DeepSeek)
学習データの作り方は第9部で扱いました。ここでは入出力を中心に、要点のみ記します。
入力
Lean 4 の定理の主張。
出力
have による骨格と、タクティクによる証明を組み合わせた Lean 4 のコード。約60行になることもあります。
学習データの作り方が、特徴的です。
-
大きなモデル(DeepSeek-V3)が、定理を高水準の証明の素描へ分解する
-
同時に、その素描を Lean 4 で形式化し、部分目標の列にする
-
小さな7Bのモデルが、各部分目標を証明する
-
解けた証明を組み合わせて、完全な証明を作る
- その完全な証明と、最初の素描を対にして、学習データにする
つまり、AIが自分で教材を作っています。
出典:ZZ Ren ほか, "DeepSeek-Prover-V2", arXiv:2504.21801, 2025年
Thor(2022年)
入力
Isabelle の証明状態。
出力
次に書くべき証明の一手。ただし、「ここで sledgehammer を呼ぶべきか」という判断も含みます。
学習データ
Isabelle の Archive of Formal Proofs。
特徴
言語モデルと、既存の自動証明の仕組みを組み合わせました。 前提選択という難所を、sledgehammer に任せる発想です。
Draft, Sketch, and Prove(2022年)
入力
日常の言葉で書かれた数学の問題。
出力
3段階で変化します。
-
日常の言葉による証明の下書き
-
Isar の骨格(
assume、have、showを並べたもの。細部は空欄)
sledgehammerが空欄を埋めた、完全な証明
学習データ
既存の大規模言語モデルを、そのまま使いました。 専用の学習は行っていません。
この点が重要です。
手法の側で工夫することで、汎用のモデルでも形式証明が書けることを示しました。
Baldur(2023年)
入力 ── 2通りあります。
証明を生成するとき
定理の主張。
証明を修復するとき
前回の失敗した証明と、そのときのエラーメッセージ。
出力
Isabelle の証明全体。
学習データ
Isabelle/HOL(高階論理を土台にした Isabelle の標準的な体系)の6,336個の定理を含む、実際の証明の集まり。
特徴 ── 失敗から学べる点です。エラーメッセージを渡すと、証明を直せます。
LeanDojo と ReProver(2023年)
入力
Lean の証明状態。
出力
次のタクティク。
学習データ
Mathlib から抽出した証明。そして、この抽出の仕組みそのものが公開されました。
特徴
前提選択を、検索の問題として扱います。 「いま必要な定理はどれか」を、巨大なライブラリから探し出す仕組みです。
Seed-Prover(2025年、ByteDance)
(ByteDance は TikTok を運営する中国企業で、その AI 研究部門 Seed が開発しました)
入力
Lean 4 の定理の主張。
出力
Lean 4 の証明全体。
学習データ
論文には構成についての記述がありますが、詳細は公開されていません。
特徴
本連載の第1回の記事の第1部で引用したとおり、論文は「一手ずつ生成する方式」と「丸ごと生成する方式」の両方の難点を指摘したうえで、補題を中心に据えた反復の仕組みを採りました。
成績
miniF2F の試験用244問のうち243問、すなわち99.6%。
出典:
"Seed-Prover: Deep and Broad Reasoning for Automated Theorem Proving", arXiv:2507.23726, 2025年
Prover Agent(2025年、京都大学ほか)
(本稿で扱った10件のうち、日本の研究機関によるものはこの1件です。小型のモデルを組み合わせる構成で、大規模な計算資源を前提にしない方向を示しています)
本連載の第3回の記事の第12部で詳しく扱いますので、ここでは入出力のみ記します。
入力
Lean 4 の定理の主張。
出力
Lean 4 の証明。そして、その過程で補助的な補題も生成します。
学習データ
専用の追加学習は行っていません。 既存の推論用の大規模言語モデルと、8B の証明モデルを組み合わせる構成です。
構成
3つの役割が協調します。
-
日常の言葉で推論する大規模言語モデル
-
形式的な証明を書く小型のモデル(8B。パラメータ数80億)
- Lean からの応答
特徴
補助的な補題を自分で生成する点です。それは証明の部分目標に限らず、特殊な場合や、仮定から導かれる有用でありうる事実も含みます。
出典:
Kaito Baba ほか, "Prover Agent: An Agent-Based Framework for Formal Mathematical Proofs", arXiv:2506.19923, ICML 2025
整理します
成績の数字を比べるときの注意
本文には pass@1、pass@32、pass@8192 など、試行回数の違う成績が出てきます。
pass@8192 は 8,192 回試して1回でも通れば正解と数えるので、pass@1 より高い数字が出るのは当然です。
試行回数が違う成績どうしは、単純に比較できません。
以下の表には成績の列を置いていないのも、同じ理由です。
| Neural Theorem Prover | 入力 | 出力 | 学習データ | 正しさを保証するもの |
|---|---|---|---|---|
| GPT-f(2020) | Metamath のゴール | 証明の一手(定理と代入) | set.mm の約300万の一手 | Metamath の検査器 |
| Thor(2022) | Isabelle の証明状態 | 次の一手、および sledgehammer の呼び出し判断 | Archive of Formal Proofs | Isabelle の検査器 |
| DSP(2022) | 日常の言葉の問題 | Isar の骨格 → 完全な証明 | 専用の学習なし(汎用モデルを使用) | Isabelle の検査器+sledgehammer |
| Baldur(2023) | 定理、または失敗した証明とエラー | Isabelle の証明全体 | Isabelle/HOL の6,336定理 | Isabelle の検査器(エラーを入力に戻す) |
| ReProver(2023) | Lean の証明状態 | 次のタクティク | Mathlib から抽出 | Lean の検査器 |
| AlphaProof(2024) | 人間が Lean へ翻訳した主張 | Lean の証明全体 | 約100万の日常の言葉の問題を自動形式化して作った、約8,000万の Lean の問題 | Lean の検査器(学習の報酬そのもの) |
| Kimina-Prover(2025) | Lean 4 の主張 | 思考と Lean コードが交互に並ぶ出力 | NuminaMath-LEAN(10万件) | Lean 4 の検査器 |
| DeepSeek-Prover-V2(2025) | Lean 4 の主張 |
have の骨格+タクティク |
AIが自分で作った素描と証明の対 | Lean 4 の検査器(学習データの選別にも使う) |
| Seed-Prover(2025) | Lean 4 の主張 | Lean 4 の証明全体 | 論文に構成の記述はあるが、詳細は未公開 | Lean 4 の検査器(反復の判断材料) |
| Prover Agent(2025) | Lean 4 の主張 | Lean 4 の証明+補助的な補題 | 専用の追加学習なし(既存の推論用 LLM と、8B の証明モデルを組み合わせ) | Lean 4 の検査器(エージェントの応答として使う) |
最後の列に注目してください。
10件すべてで、正しさを保証しているのは検査器であり、AIではありません。
違うのは、検査器をいつ使うかです。
初期の研究は、生成が終わった後に検査するだけでした。
その後、検査の結果を入力に戻すもの(Baldur)、学習の報酬にするもの(AlphaProof)、学習データの選別に使うもの(DeepSeek-Prover-V2)、反復の判断材料にするもの(Seed-Prover、Prover Agent)が現れます。
検査器が、後工程から、学習と生成の内側へ移動してきたというのが、この列が示す流れです。
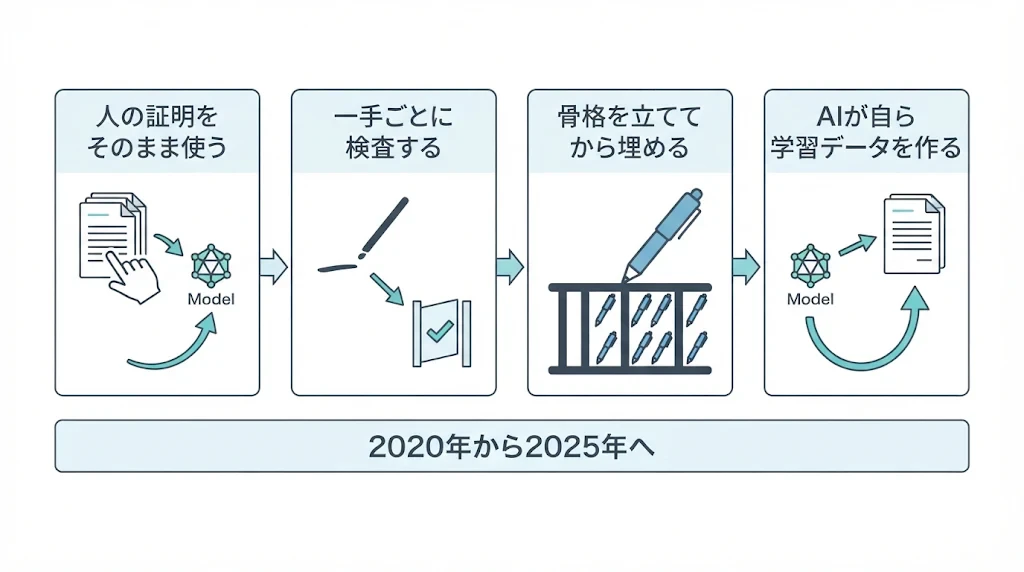
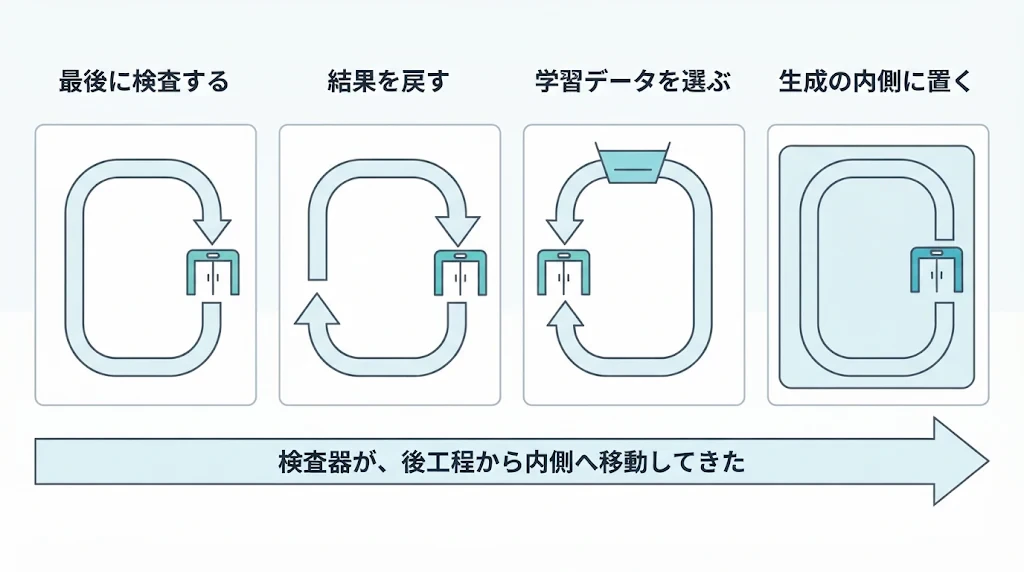
この表が示す大きな流れを、先に図にします。
(この図は代表的な転換点だけを示したものです。年代は重なり合っており、新しい方式が古い方式を置き換えたわけではありません。)
この表から、2つのことが読み取れます。
第1に、多くの研究では、入力は Lean や Isabelle などの形式言語で書かれた主張です。
ただし、例外があります。 Draft, Sketch, and Prove は、日常の言葉で書かれた問題から出発します。
どこから入力するかは、研究の設計によって異なります。
そして、形式言語を入力とする研究では、日常の言葉から形式言語への翻訳が別の工程として残ります。
AlphaProof の時点では、この翻訳は人間が行っていました。
その部分を自動化する研究が、autoformalization です。
第2に、学習データの作り方が、時代とともに変わっています。
2020年は、人間が書いた証明をそのまま使いました。
2025年には、AIが自分で教材を作るようになりました。 DeepSeek-Prover-V2 の手法が、その典型です。
そして、その循環がどこまで続くのかは、まだ分かりません。
第3に、生成される証明のスタイルは、この表の「学習データ」列で決まります。
人間の証明や素描で学んだ行は have の骨格を書き、自動形式化した主張に強化学習と探索を当てた AlphaProof の行は、骨格を書きません。
この記事で持ち帰っていただきたい4点
長い記事になりましたので、最後に要点をまとめます。
-
入力は、多くの場合すでに形式化された主張です。
日常の言葉から Lean や Isabelle への翻訳は、別の研究課題(autoformalization)になっています。
-
出力の方式は、研究によって違います。
証明の一手ずつを出すものから、証明全体を一度に出すものまであります。
-
学習データは、人間の証明から、AIが作ったデータへ広がりました。
2020年は人間の証明をそのまま使い、2025年にはAI自身が教材を作っています。
-
生成されたコードの読みやすさは、正しさとは別の問題です。
haveが並んでいても、実質的な推論が最後の一行に集中していることがあります。
検査を通ることと、人間が読んで筋を追えることは、同じではありません。
自分で試すための入口
本稿を読んで、実際に触ってみたくなった方のために、入口を3つ挙げます。
1.Lean 4 をブラウザで試す
インストールせずに Lean 4 を動かせる環境があります。
Lean 4 Web(https://live.lean-lang.org/)です。
Mathlib も読み込まれているので、本稿に出てきた have と nlinarith の例をそのまま貼り付けて動かせます。
日本語で学ぶなら、Lean 4 による定理証明(Theorem Proving in Lean 4 の日本語訳)が公開されています。
2.本稿の集計を、自分の手で再現する
「数で確かめる」の節で使った2本のスクリプトは、筆者(Etale Cohomology)の GitHub で公開しています。
どちらも標準ライブラリだけで動きます。
追加のインストールは不要で、必要なのはデータの取得だけです。
なお、Lean や Mathlib をビルドする必要はありません。
集計はソースコードを文字列として読むだけなので、git clone と unzip ができれば動きます。
Mathlib のソースは数百MB、生成証明は数MBです。
# Mathlib(ソースだけを取得する。履歴とビルド済みファイルを落とさない)
git clone --depth 1 --filter=blob:none --sparse https://github.com/leanprover-community/mathlib4.git
cd mathlib4 && git sparse-checkout set Mathlib && cd ..

# DeepSeek-Prover-V2 の生成証明
git clone --depth 1 https://github.com/deepseek-ai/DeepSeek-Prover-V2.git
cd DeepSeek-Prover-V2 && unzip minif2f-solutions.zip -d sol && cd ..

python3 count_have.py mathlib4/Mathlib
python3 compare_generated.py
集計の条件を変えれば、本稿が出していない数字も出せます。
Mathlib のどの分野で have が多いか。
calc や show はどう使われているか。
他のモデルの生成結果が手に入れば、同じ方法で比べられます。
3.公開されているモデルを実行する
本稿で扱ったモデルのいくつかは、重みが公開されています。
Goedel-Prover や、Kimina-Prover の蒸留版(1.5B)などです。
1.5B であれば、家庭用の GPU でも動きます。
ただし、生成された証明を 検査する には、Lean 4 と Mathlib をローカルに構築する必要があります。
生成するだけなら手軽ですが、「通ったかどうか」まで確かめるには、そこが必要になります。
本稿の主題に照らせば、この検査の工程こそが本体です。
本連載の記事
-
第1回:AIが数学の証明を書けるようになった6年間 ── Neural Theorem Proving の全体像を、正答率30%から99.6%への軌跡とともに読む(公開済み)
-
第2回:定理証明を自動で行う Neural Theorem Prover は、「タクティク記法」と「宣言的スタイル記法」のどちらで学習し、証明の答案を提出するのか(この記事)
-
第3回:誰が動かしているか ── この分野を牽引する研究者・組織・国家(近日公開)
- 第4回:何が争われているか ── 「そもそも形式化は必要か」という立場の隔たり(近日公開)
次回は
第3回では、この分野を誰が動かしているかを扱います。
牽引する研究者と機関。 そして日本、アメリカ、中国、フランス、ポーランド、ドイツの動向を、国家政策と実際の研究の両面から見ます。
関連記事
過去に公開済みの連載(前編・後編)
実務での形式検証
-
「テスト通ったから大丈夫」を卒業しよう──LLM生成コードをLean4/Dafnyで形式検証する方法
- 96%の開発者がAI生成コードを信用していないのに48%が検証せずデプロイしている──Leanstralという解決策
定理証明支援系の入門
形式手法と、その限界
出典
生成されたコードと、その分析
- Yong Lin ほか, "Goedel-Prover: A Frontier Model for Open-Source Automated Theorem Proving", arXiv:2502.07640, 2025年(生成された証明の実例は図13)
-
"MPS-Prover: Advancing Stepwise Theorem Proving by Multi-Perspective Search and Data Curation", arXiv:2505.10962, 2025年(複数モデルの生成コードの比較)
- Haoxiong Liu, Jiacheng Sun, Zhenguo Li, Andrew C. Yao, "ProofAug: Efficient Neural Theorem Proving via Fine-grained Proof Structure Analysis", ICML 2025, PMLR 267, 39568〜39586頁(Lean の証明にもブロック構造がある、付録C。Lean 4 版で Kimina-Prover-Preview-Distill-1.5B の pass@1 を 44.3% → 50.4%)
- Thomas Hubert ほか(Google DeepMind), "Olympiad-level formal mathematical reasoning with reinforcement learning", Nature, 2025年11月12日(約100万問を自動形式化して約8,000万の Lean の問題を生成)
各AIの入力・出力・学習データ
- Stanislas Polu, Ilya Sutskever, "Generative Language Modeling for Automated Theorem Proving", arXiv:2009.03393, 2020年(GPT-f)
- Numina & Kimi Team, "Kimina-Prover Preview: Towards Large Formal Reasoning Models with Reinforcement Learning", arXiv:2504.11354, 2025年
-
AI-MO/Kimina-Prover-72B, Hugging Face
-
NuminaMath-LEAN, Hugging Face(Kimina-Prover 72B の学習に使われた10万件の Lean 4 コーパス)
- ZZ Ren ほか, "DeepSeek-Prover-V2", arXiv:2504.21801, 2025年
-
deepseek-ai/DeepSeek-Prover-V2(学習データの作り方)
-
"DeepSeek-Prover-V1.5: Harnessing Proof Assistant Feedback for Reinforcement Learning and Monte-Carlo Tree Search", arXiv:2408.08152, ICLR 2025
-
"Seed-Prover: Deep and Broad Reasoning for Automated Theorem Proving", arXiv:2507.23726, 2025年
- Kaito Baba ほか, "Prover Agent: An Agent-Based Framework for Formal Mathematical Proofs", arXiv:2506.19923, ICML 2025
- Emily First, Markus N. Rabe, Talia Ringer, Yuriy Brun, "Baldur: Whole-Proof Generation and Repair with Large Language Models", ESEC/FSE 2023
- Albert Q. Jiang ほか, "Draft, Sketch, and Prove: Guiding Formal Theorem Provers with Informal Proofs", ICLR 2023
証明のスタイル(手続き的・宣言的)と、各処理系の標準
- Freek Wiedijk, "A Synthesis of the Procedural and Declarative Styles of Interactive Theorem Proving", Logical Methods in Computer Science 8(1:30), 2012年(手続き的スタイルと宣言的スタイルによる処理系の分類)
- Markus Wenzel, Freek Wiedijk, "A comparison of Mizar and Isar", Journal of Automated Reasoning 29, 2002年(Isar が Isabelle の公式入力言語になったこと)
-
IsarMathLib: Style Guide for Contributors(宣言的 Isar のみを認める規約)
- Jeremy Avigad, Leonardo de Moura, Soonho Kong, Sebastian Ullrich, Theorem Proving in Lean 4, 5. Tactics(項スタイルとタクティクスタイルの対比)
- Jeremy Avigad, Patrick Massot, Mathematics in Lean, 1. Introduction(タクティク重点の方針)
- Qiyuan Xu ほか, "IsaMini", §I(Lean を手続き的と宣言的の中間に位置づけ、AFP の
apply系が37.2%)
証明言語の設計と、生成された証明の質
- Qiyuan Xu, Renxi Wang, Haonan Li, David Sanán, Conrad Watt, "IsaMini: Redesigned Isabelle Proof Language for Machine Learning", arXiv:2507.18885, 2025年(Lean の混在は自動化不足による妥協、AFP と Mathlib の規模比較、MiniLang による PISA の改善)
- Haohan Lin, Zhiqing Sun, Sean Welleck, Yiming Yang, "Lean-STaR: Learning to Interleave Thinking and Proving", ICLR 2025
- Yicheng Qian, Joshua Clune, Clark Barrett, Jeremy Avigad, "Lean-auto: An Interface between Lean 4 and Automated Theorem Provers", arXiv:2505.14929, 2025年
- Abdalrhman Mohamed ほか, "Lean-SMT: An SMT tactic for discharging proof goals in Lean", arXiv:2505.15796, 2025年
-
"LeanPolish: Verified Supervision for Lean Proof Compression", arXiv:2609.38384, 2026年
-
"Proof-Refactor: Refactoring Generated Formal Proofs into Modular Artifacts", arXiv:2606.03743, 2026年
- Thomas Hubert ほか(Google DeepMind), "Olympiad-level formal mathematical reasoning with reinforcement learning", Nature, 2025年11月12日(AlphaProof の学習方式)
Isabelle 側の研究
- George Tsoukalas ほか, "PutnamBench: Evaluating Neural Theorem-Provers on the Putnam Mathematical Competition", arXiv:2407.11214, NeurIPS 2024(Isabelle の宣言的な性質について。引用文は原文どおりで、「has too been」は原文の表現)
- "HybridProver: Augmenting Theorem Proving with LLM-Driven Proof Synthesis and Refinement", arXiv:2505.15740, 2025年