
英語の講義スライドPDFを、見た目を崩さずに日本語へ置き換える処理を PyMuPDF で書きました。つまずいた点をまとめます。図の中のラベルは画像なので別の処理(macOS の Vision で OCR)にしていて、この記事では PDF にテキストとして入っている文字を扱います。
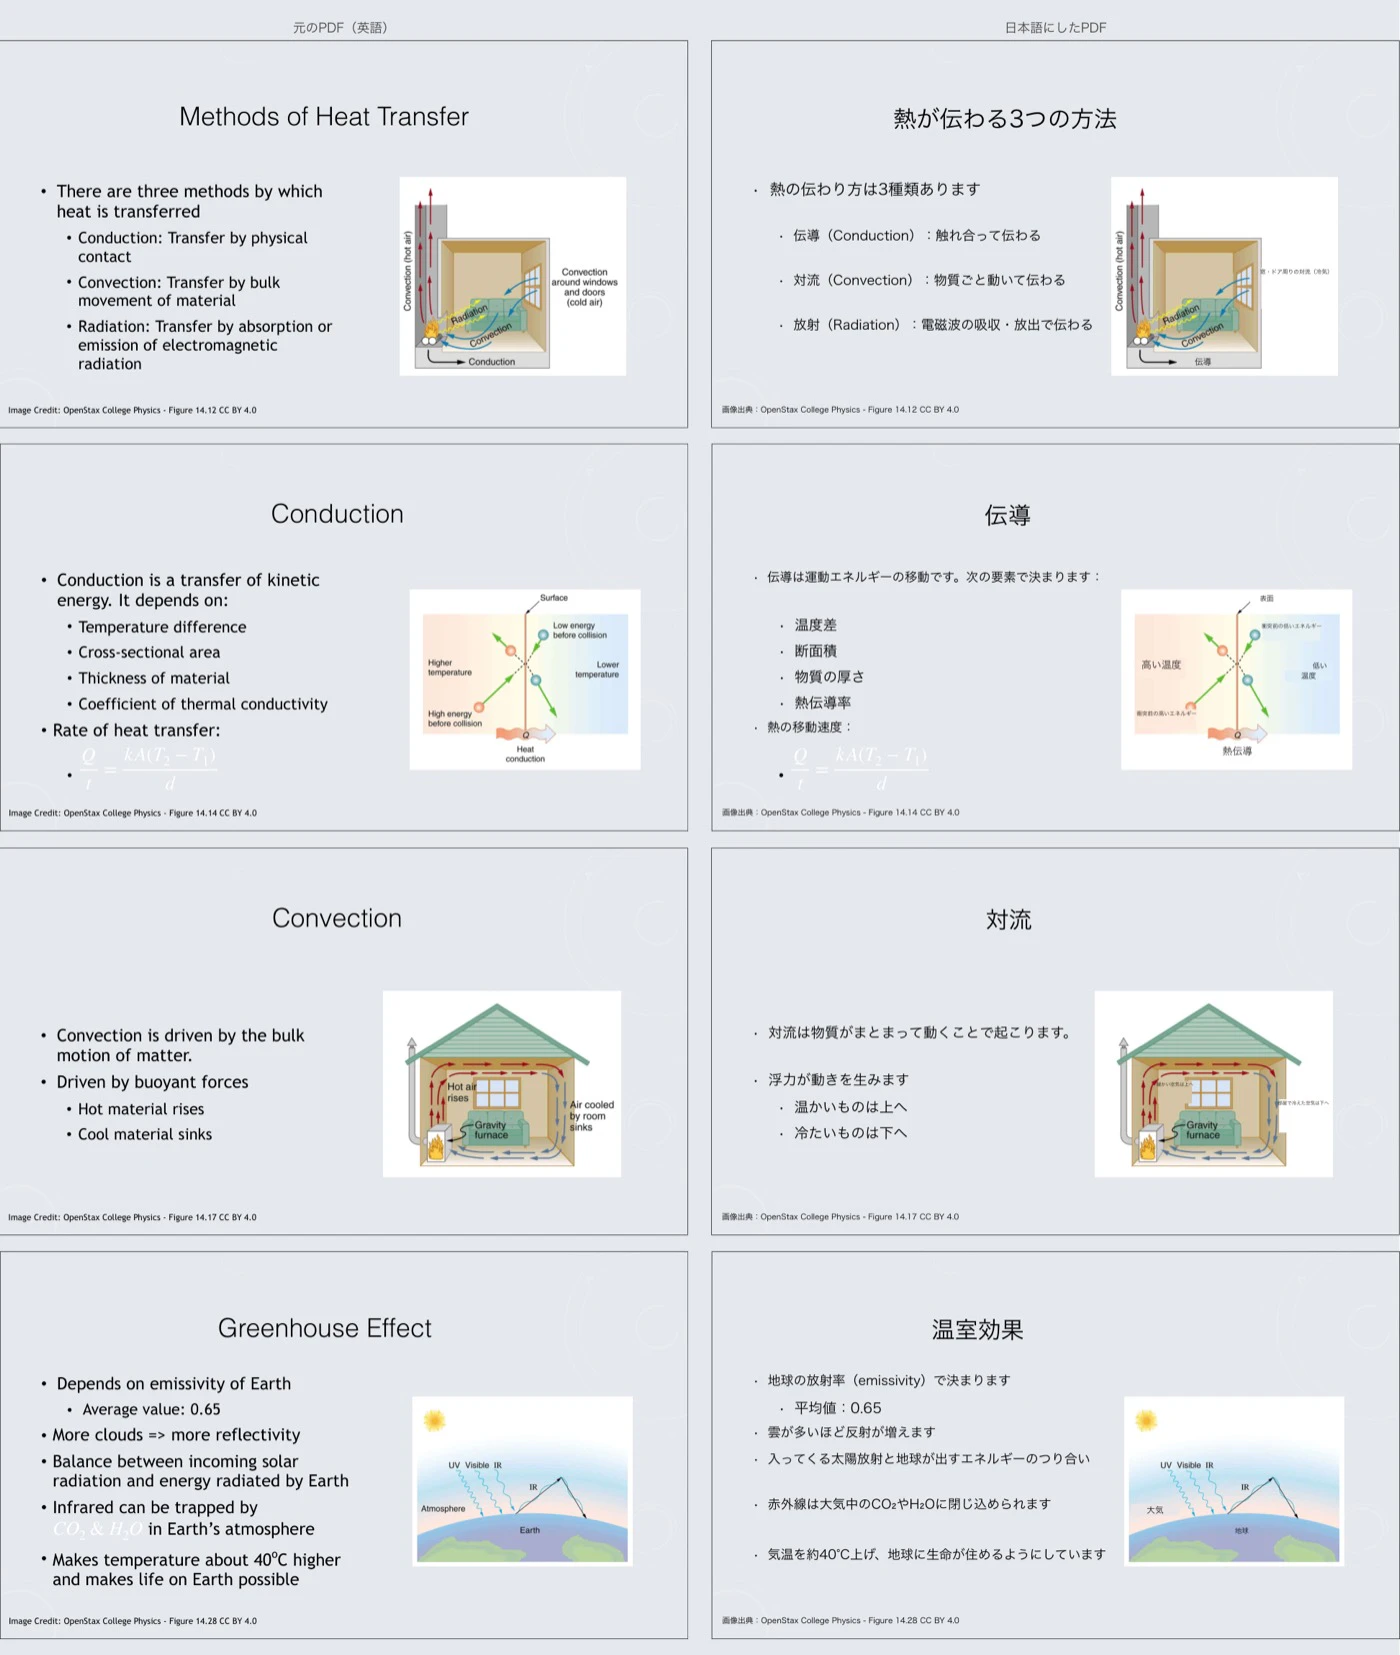
全体の流れ
-
page.get_text("dict")の span を、翻訳の単位(段落)にまとめる - 段落ごとに訳す(訳文は
{原文: 訳文}の辞書にしておく) - 訳文を入れる枠を決める
- 枠に収まる文字の大きさを決める(同じスタイルの段落は同じ倍率にそろえる)
- 元の文字だけを消す(redaction)
-
insert_htmlboxで訳文を書く
1. span を段落にまとめる
PDF の文字は行や span ごとにばらばらなので、そのまま訳すと文の途中で切れます。次の条件でまとめました。
- 同じ行でも span の間が 12pt 以上あいていたら別の段落にする(表や2段組みの列)
- 次の行が同じ x 位置から始まり、行の間が文字サイズの 1.2 倍以内で、文字サイズもほぼ同じなら同じ段落にする
- 前の行が箇条書きの記号(•)や番号だけなら、ぶら下がりインデントの分(40pt 未満)右にずれていても続きとみなす
for g in reversed(groups[-3:]):
    gx0 = g[0][0]["bbox"][0]
    gy1 = max(s["bbox"][3] for cc in g for s in cc)
    gt = g[0][0]["text"].strip()
    ok = abs(gx0 - x0) < 6 or (0 < x0 - gx0 < 40 and re.match(r"^(•|\d\.?$)", gt))
    if ok and 0 <= y0 - gy1 + 3 < g[0][0]["size"] * 1.2 and abs(g[0][0]["size"] - c[0]["size"]) < 1:
        g.append(c); merged = True; break
段落ごとに、位置(bbox)・文字サイズ・フォント名・色と、元の span の bbox をすべて持たせておきます。span の bbox は、あとで文字を消すときに使います。
2. 元の文字だけを消す
add_redact_annot は、何も指定しないと消した場所を白で塗ります。背景に色や図形があるスライドだと白い四角が残るので、fill=False にします。さらに apply_redactions で、画像と線画には触らず文字だけを消すよう指定します。
for sb in unit["spans"]:
    page.add_redact_annot(pymupdf.Rect(sb) + (-0.3, -0.3, 0.3, 0.3), fill=False)
page.apply_redactions(
    images=pymupdf.PDF_REDACT_IMAGE_NONE,
    graphics=pymupdf.PDF_REDACT_LINE_ART_NONE,
    text=pymupdf.PDF_REDACT_TEXT_REMOVE,
)
段落の bbox 全体ではなく span ごとに消しているのは、段落の四角に重なっている別の文字(図のラベルなど)まで消さないためです。
3. 訳文の枠を広げる
元の bbox のままだと日本語が窮屈なので、右と下に、ぶつかるものがない所まで広げました。
- 文字を囲む四角形(
page.get_drawings()で取れる矩形)があれば、その内側まで - 右に別の段落や画像があれば、その手前(8pt あける)まで
- 下に別の段落があれば、その手前まで
- どれもなければ、ページの端から少し内側まで
4. 日本語フォントと insert_htmlbox
insert_htmlbox は HTML と CSS で書けるので、色・太字・箇条書きをそのまま表せます。フォントは pymupdf.Archive に入れたフォルダから、CSS の @font-face で読み込みます。macOS のヒラギノは .ttc なので、fontTools で1書体だけ .otf として取り出して使いました。
arch = pymupdf.Archive("jafont")  # JP.otf を置いたフォルダ
CSS = "@font-face {font-family: K; src: url(JP.otf);} * {font-family: K; line-height: 1.25; margin:0; padding:0;}"
rc = page.insert_htmlbox(box, html, css=CSS, archive=arch, scale_low=0.3)
# rc[0] が負なら入りきらなかった。rc[1] は実際に使われた縮小率
細かいところでは、次のようにしました。
- 日本語は英字より字面が大きく見えるので、最初の文字サイズは元の 90%(30pt 以上の見出しは 80%)から始める
- 「伝導(Conduction)」のような英語の併記が途中で折り返されないよう、空白で区切った語を
<span style="white-space:nowrap">で包む - 箇条書きは、負の
text-indentが効かなかったので<ul><li>にする(2行目以降もちゃんとぶら下がる) - 元のフォント名に
Boldが入っていればfont-weight:boldを付ける
5. 同じスタイルの段落は同じ倍率にそろえる
scale_low=0.3 にしておくと、入りきらない段落は自動で縮みます。ただ、段落ごとに縮み方が違うと、同じスライドの箇条書きが行ごとにばらばらの大きさになります。
そこで、一度空のドキュメントに試し書きして段落ごとの縮小率を測り、(ページ, 文字サイズ, フォント, 色) が同じグループの中で一番小さい倍率にそろえてから、本番の PDF に書きました。
tmp = pymupdf.open(); scales = {}
for i, (pno, u, box) in enumerate(plan):
    pg = tmp.new_page(width=d[pno].rect.width, height=d[pno].rect.height)
    rc = pg.insert_htmlbox(box, html_for(u, base(u)), css=CSS, archive=arch, scale_low=0.3)
    scales[i] = rc[1] if rc[0] >= 0 else 0.3

groups = {}
for i, (pno, u, _) in enumerate(plan):
    groups.setdefault((pno, round(u["size"], 1), u["font"], u["color"]), []).append(i)
final = {i: min(scales[j] for j in idx) for idx in groups.values() for i in idx}
最後に d.subset_fonts() で使った文字だけをフォントに残してから保存すると、ファイルが大きくなりすぎません。
訳さずに残したもの
- 数式、数字だけの段落、出典や参考文献は訳しません(辞書に入れない段落はそのまま残ります)
- 処理の最後に「訳されずに残った、英字を含む段落」を一覧で出し、出典など残してよいものだけか確かめます
おわりに
この PDF は、Claude に MCP サーバーの BCD をつないで、私の Mac 上で上の処理を書かせて作りました(AI が手元のファイルを読んだりプログラムを実行したりできるようになります)。同じ手順を、プログラムを書かない人向けにまとめたページはこちらです。
素材:「Lecture 5 - Heat Transfer」Robert Wagner, Introduction to Physical Science(LibreTexts), CC BY 4.0。図:OpenStax College Physics, CC BY 4.0。日本語版も同じ CC BY 4.0 です。