
1. はじめに
PostgreSQL から ClickHouse へフェデレーテッドクエリを投げる拡張機能 pg_clickhouse を、2026 年 6 月に v0.3 で試して記事にしました1。TPC-H の 22 クエリを「PostgreSQL だけで答える経路」と「ClickHouse 経由の経路」で実行し、どこまでが ClickHouse 側にプッシュダウンされるかを見たものです。
そこから 3 か月で v0.10.0 が出ました。公式ブログは、完全にプッシュダウンされる TPC-H クエリが 12 本から 16 本に増えたと書いています2。
With the release of v0.10.0, our scoreboard has moved from 12 of 22 TPC-H queries fully pushed down to 16, leaving only 6 to go to finish off the set.
同じクエリ・同じ手順で測り直しました。クエリ本文は 1 文字も変えていません。前作と違うのは 1 つで、両方の経路が同じ答えを返すかを確かめる工程を足したことです。
先にこの記事の前提を書きます。ここに載せる数字は、東京リージョンのマネージドサービスをデフォルトの構成で作った、ある 1 つの環境で測ったものです。公式ブログの数字は SF1 を MacBook Pro M4 Max(36 GB)のローカル環境で測ったもの3なので、計測した環境が違います。本数が 1 本一致しない点は 4.3 章で扱いますが、これは公式が間違っているという主張ではありません。この構成ではこうなった、という報告として読んでください。
1.1. 結論(先出し)
プッシュダウンの結果です。
- 完全にプッシュダウンされたのは 17 本 / 22 本。前作は 13 本(厳しい定義)ないし 14 本(集計 1 段だけ残る定義)だった
- 公式の「16 of 22」との差は 1 本で、その 1 本は Q16。公式は Q16 をプッシュダウンされない 6 本に挙げているが、こちらの環境では 1 つの
Foreign Scanにまとまった - ClickHouse 経由が速かったのは SF1 で 12 本、SF10 で 15 本
測り方について分かったことです。
- 速さを測る前に、両方の経路が同じ答えを返すかを確かめる必要がある。確かめずに測った 1 回目は、22 本中 10 本で ClickHouse 側が 0 行を返しており、倍率が最大 321 倍まで実際より大きく出ていた
- 0 行になった原因は
char(n)の末尾空白詰めだった。これを直すと、今度は Q05 が ClickHouse 側のメモリ不足でエラーになった -
EXISTSの中に不等号があると、ClickHouse 側が違う答えを返す。行数も所要時間も変わらないため、値を突き合わせないと分からない
前作の考察にあった「パラメータ化されているから遅い」という説明は、生ログと照らすと事実として違っていました。前作は公開後に訂正しています。
1.2. 検証ゴール
| # | 確かめること | 確認できれば OK の条件 |
|---|---|---|
| 1 | 両方の経路が同じ答えを返すか | 22 クエリの返り値を 1 本ずつ突き合わせ、一致しないものを性質で分類できる |
| 2 | 完全プッシュダウンの本数と顔ぶれが v0.3 から変わるか | 分類の定義を先に決めたうえで、本数と増減したクエリをクエリ名で挙げられる |
| 3 | SF1 と SF10 で倍率がどう変わるか | それぞれで ClickHouse 経由が速いクエリの本数を数え、1.00 をまたいだクエリをクエリ名で挙げられる |
1 番目は前作には無かった項目で、今回の作業時間の大半をここに使いました。
2. 検証環境
2.1. 構成
Managed Postgres と ClickHouse は、どちらも ClickHouse Cloud のサービスとして東京リージョンに作りました。この 2 つの間には、向きの違う 2 本の経路があります。
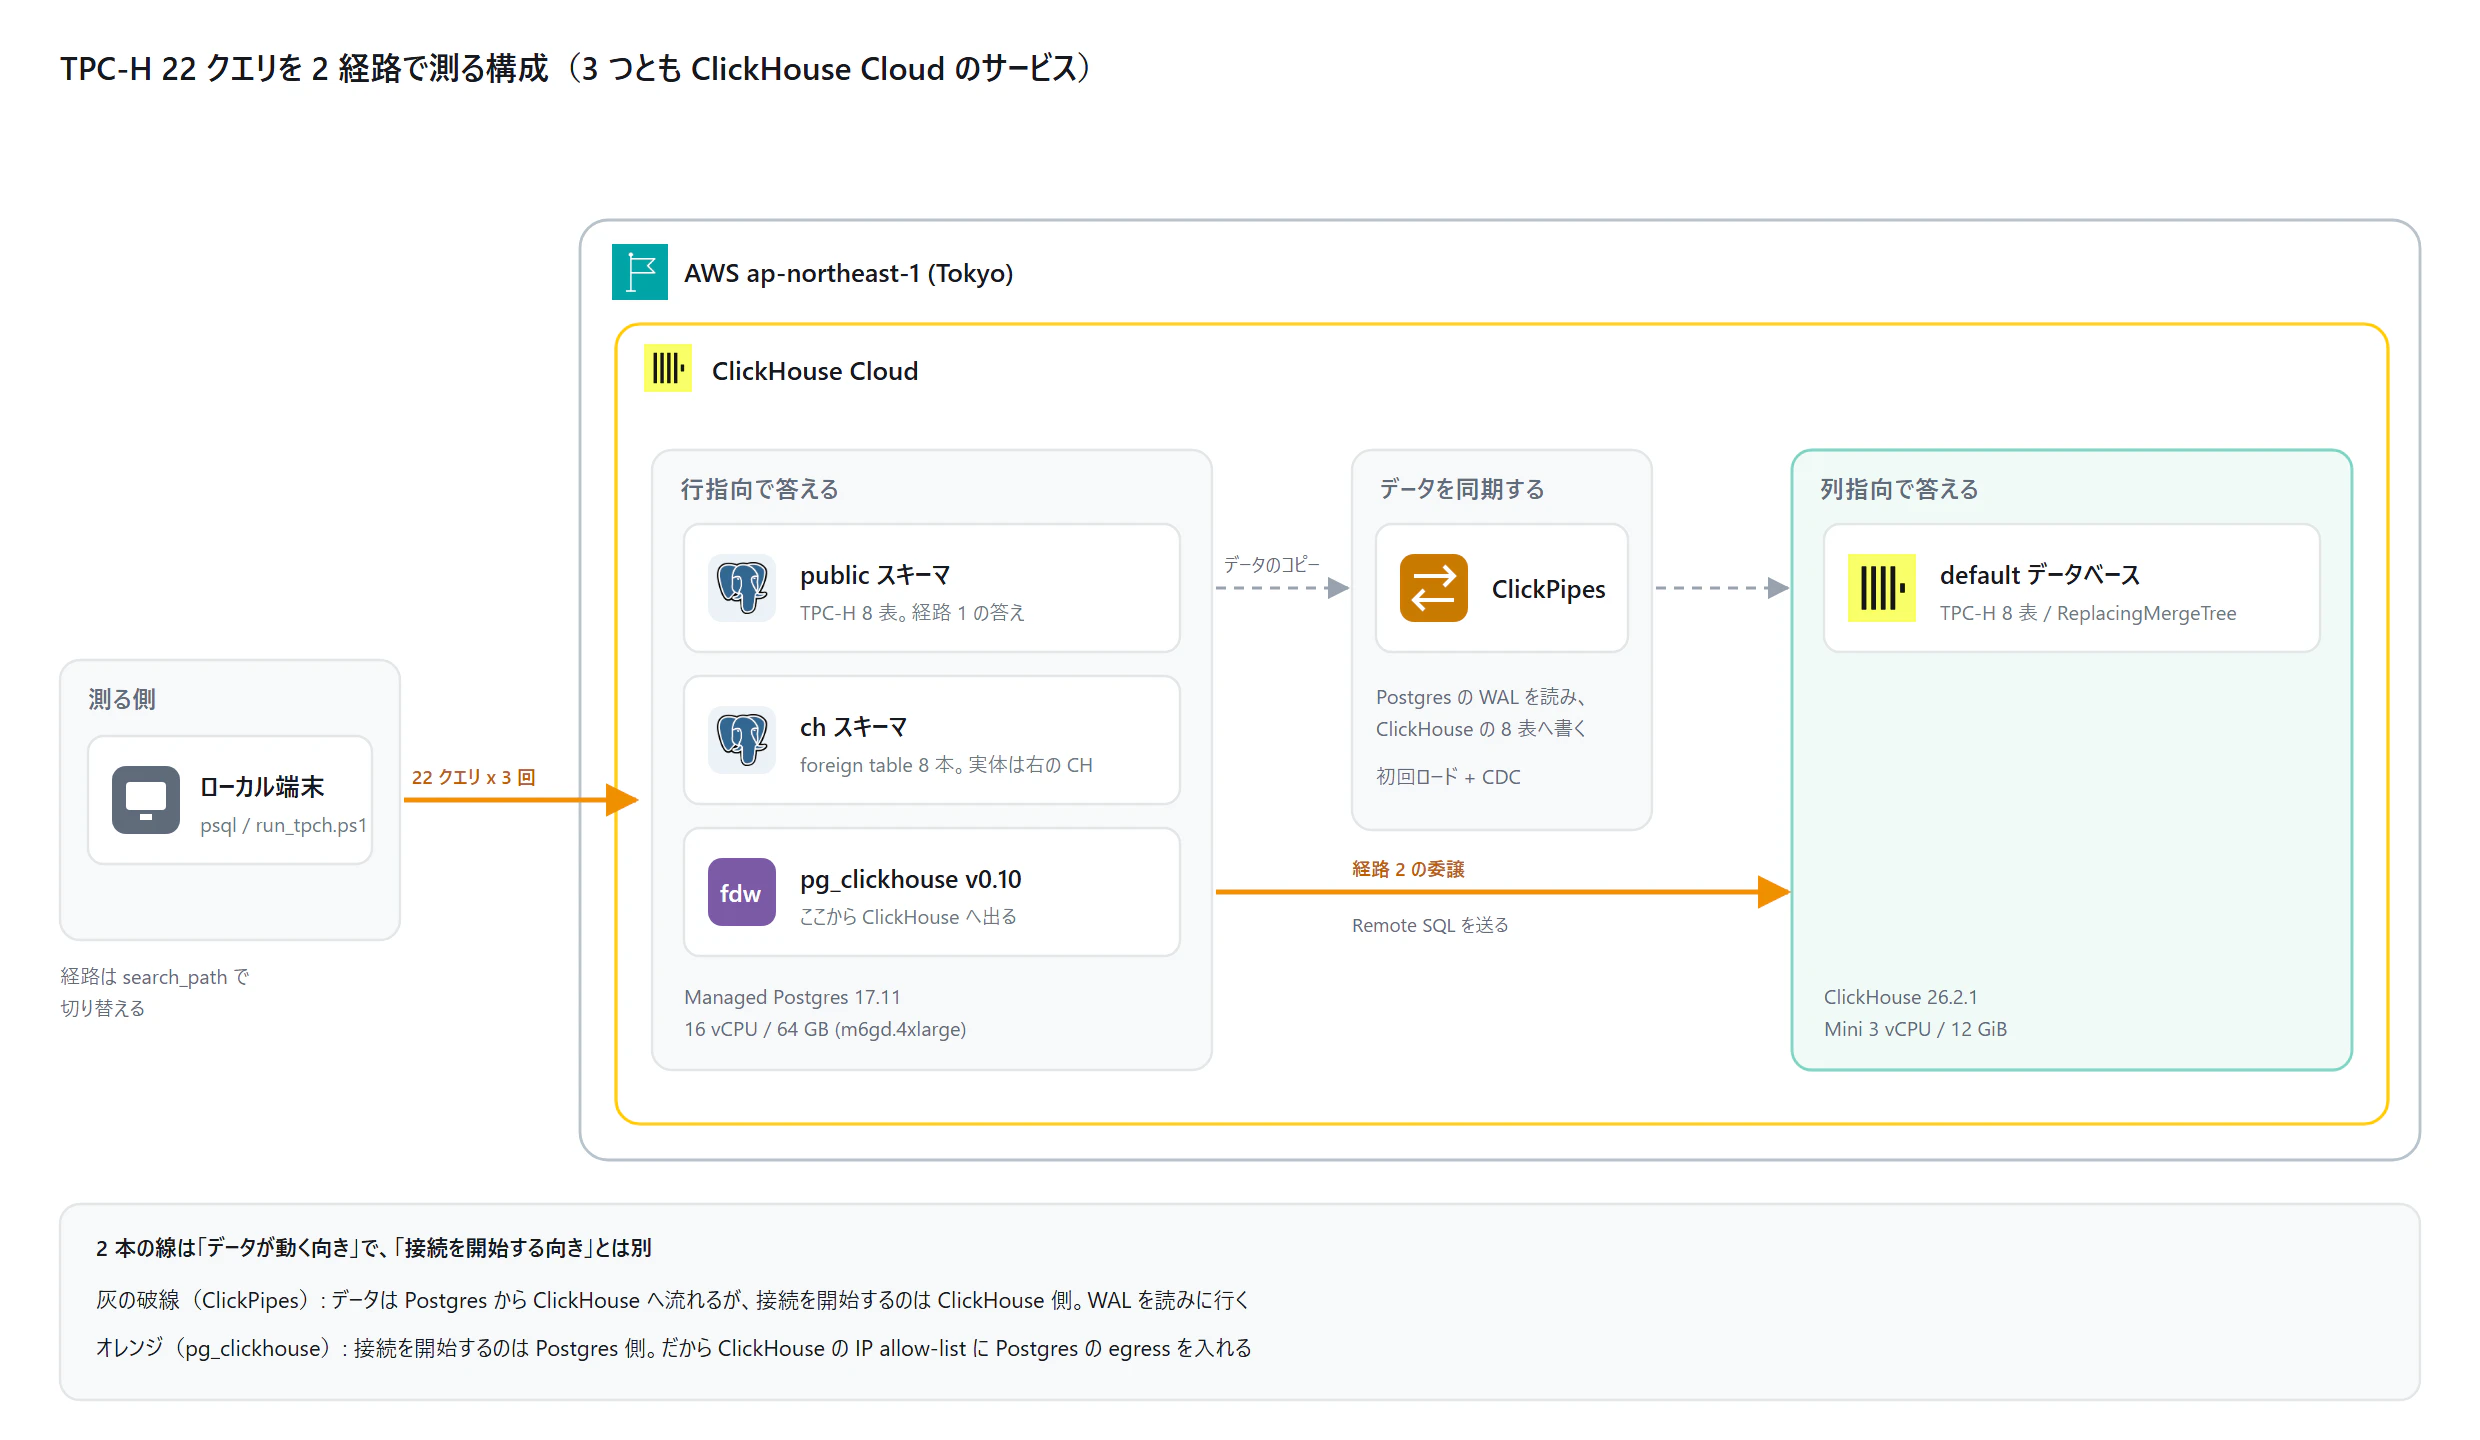
上の図の破線が ClickPipes で、Postgres の WAL を読んで ClickHouse 側の 8 つのテーブルへ書き込みます。変更分を継続的に取り込む仕組み(CDC)です。オレンジが pg_clickhouse で、ch スキーマの外部テーブルを参照したときに Postgres から ClickHouse へ SQL を送ります。以降、こちらを ch 経路と呼びます。
データが動く向きは同じ左から右ですが、接続を始める側は逆です。ClickPipes は ClickHouse 側から Postgres を読みに行き、pg_clickhouse は Postgres 側から ClickHouse へ接続します。この向きを取り違えると、ClickHouse の IP 許可リストに入れるべき IP を間違えます。
| 項目 | 値 |
|---|---|
| Managed Postgres | PostgreSQL 17.11、16 vCPU / 64 GB RAM(m6gd.4xlarge)、ap-northeast-1 |
| pg_clickhouse | 0.10(pg_extension.extversion の実測値) |
| ClickHouse | 26.2.1、Mini(3 vCPU / 12 GiB RAM)、ap-northeast-1 |
| 同期 | ClickPipes(Initial load + CDC)、エンジンはデフォルトの ReplacingMergeTree
|
| データ | TPC-H のスケールファクタ SF1(lineitem 6,001,215 行)と SF10(同 59,986,052 行) |
| 計測クライアント | 手元の Windows PC から psql |
コンソールの表示も並べておきます。上が Managed Postgres、下が ClickHouse のスケーリング設定です。
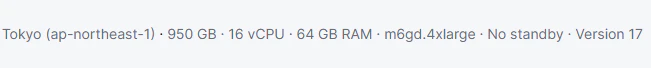
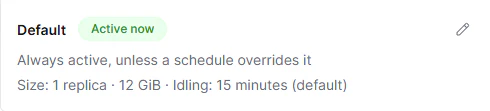
両エンジンのスペックは揃っていません。Postgres が 16 vCPU / 64 GB なのに対し、ClickHouse は 3 vCPU / 12 GiB です。マネージドサービスのデフォルトの組み合わせをそのまま使ったためで、このスペックの差は 7 章で改めて扱います。
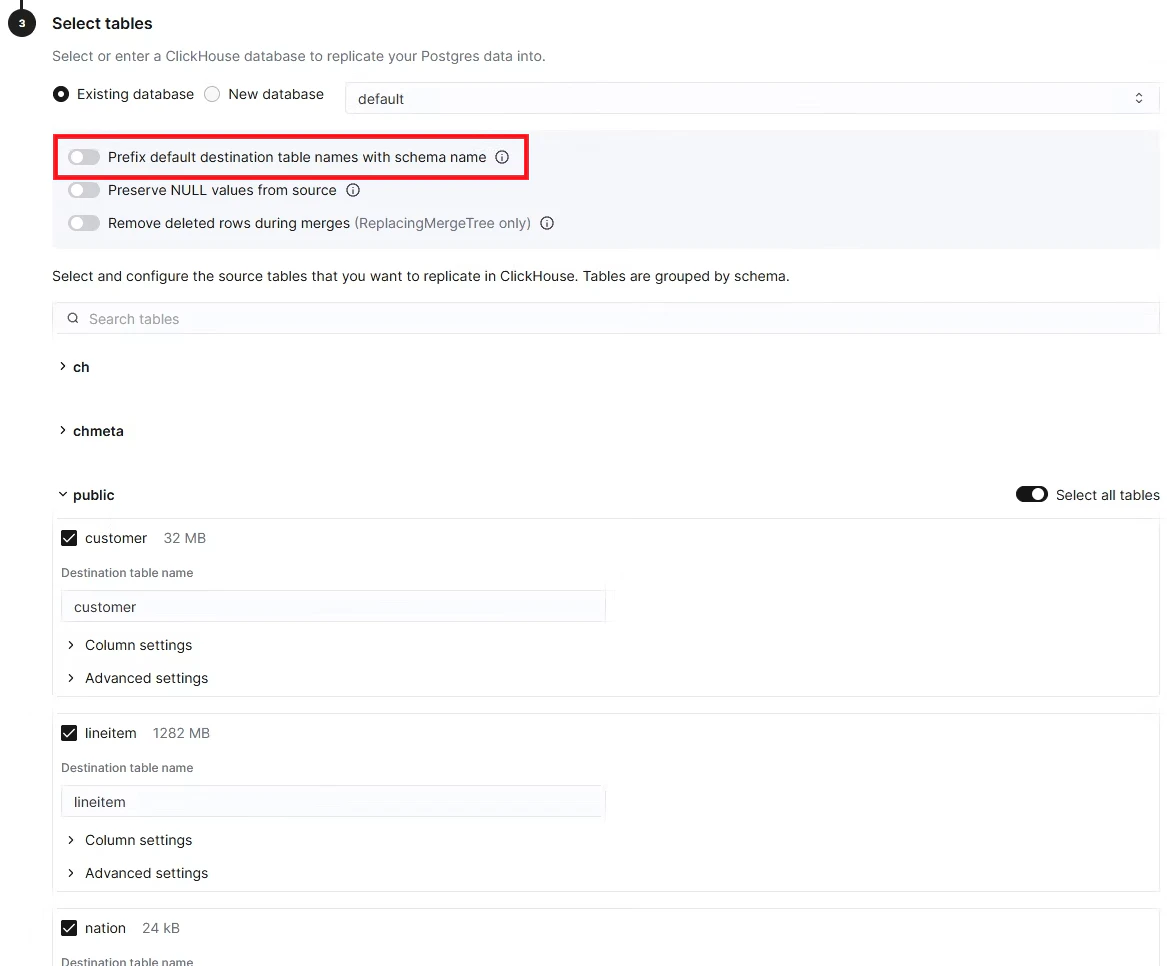
同期の設定で 1 か所だけ、この記事の測り方の都合で変えた項目があります。公式の推奨ではありません。ClickPipes のウィザードにある「Prefix default destination table names with schema name」は初期状態で有効で、そのままだと ClickHouse 側のテーブル名が public_lineitem のようになります。今回は search_path を切り替えて経路を選ぶので、テーブル名が変わると設計が成り立ちません。無効にしてから進めます。
2.2. スキーマは TPC-H の定義から 1 か所変えている
TPC-H の仕様は r_name や c_mktsegment などを char(n) で定義します。今回はこの 16 列を varchar(n) に変えました。列の長さ・NOT NULL・列順は仕様のままです。
理由は 3 章に書きます。char(n) のまま測ると、ch 経路が 22 本中 10 本で 0 行を返し、比較になりませんでした。
2.3. 前作から変わったもの
前作から変わったのは pg_clickhouse のバージョンだけではありません。サービスを作り直したので、下の 4 つが同時に変わりました。
| 項目 | 前作(v0.3) | 今回(v0.10) |
|---|---|---|
| pg_clickhouse | 0.3 | 0.10 |
| PostgreSQL | 17.10 | 17.11 |
| インスタンス | 16 vCPU / 64 GB(m8gd.4xlarge) | 16 vCPU / 64 GB(m6gd.4xlarge) |
| ClickHouse | 25.12 | 26.2.1 |
インスタンスに注目してください。vCPU 数と RAM の表示は同じですが、m8g は Graviton4 世代、m6g は Graviton2 世代です。コンソールで選べるのは vCPU と RAM までなので、同じ選択をしても割り当てられるハードウェアが同じとは限りませんでした。
そのため、この記事では前作の所要時間と今回の所要時間を並べません。比べるのは、プッシュダウンの分類と、同じ環境の中での public 経路と ch 経路の倍率だけです。倍率は分母である PostgreSQL 側の所要時間に依存するので、環境が違えば倍率の大小も比べられません。
2.4. 計測のしかた
主指標は EXPLAIN (ANALYZE, VERBOSE) が返すサーバ側の Execution Time で、3 回実行した平均を使います。クライアントとサーバの往復を含まない値です。経路の切り替えは search_path で行い、public なら PostgreSQL 単独、ch, public なら外部テーブル経由になります。クエリ 1 本あたりの上限は 300 秒に設定しました。
ClickHouse は 15 分アイドルで停止する初期設定のままにしています。停止から復帰したクエリが混ざると最初の 1 本だけ遅くなりますが、ClickPipes の CDC が動き続けていたため、SF1 と SF10 のどちらも計測の直前 30 分と計測中に停止していませんでした。
EXPLAIN (ANALYZE) を主指標にしたのは、手元の PC から東京リージョンへ接続しているためです。psql が表示する所要時間はクライアントとサーバの往復を含むので、ローカル環境の回線のばらつきが計測値に混ざります。
とはいえ、クライアント側がボトルネックになっていないことは確かめておく必要があります。psql の \timing が出す所要時間も同じログに残していたので、2 つの値を突き合わせました。クライアント側で測った所要時間がサーバ側の実行時間を上回った割合は、中央値で 1.00 から 1.02、最大でも 1.15 です。クライアントも回線も、この計測ではボトルネックになっていないと判断しました。
3. 答えを突き合わせる
3.1. 分類と倍率を出したあとで、行数が合っていなかった
最初は前作と同じ手順で測りました。22 クエリを 2 経路 3 回ずつ SF1 と SF10 で実行し、分類と倍率の表を作り、考察まで書いたところで両経路の結果行数を並べると、一致していませんでした。SF10 の例です。
| クエリ |
public 経路 |
ch 経路 |
|---|---|---|
| Q02 | 100 行 | 0 行 |
| Q07 | 4 行 | 0 行 |
| Q20 | 1,804 行 | 0 行 |
| Q16 | 27,840 行 | 29,000 行 |
SF1 で 10 本、SF10 で 9 本が違っていました。実行計画も所要時間もエラーの有無も正常に見えるので、Execution Time と Remote SQL: だけを見ていると気づけません。
3.2. char(n) の末尾空白が ClickHouse 側に残る
原因はスキーマでした。PostgreSQL の char(n) は値を空白で詰めて保存し、比較では末尾の空白を無視します4。ところが ClickPipes で複製すると ClickHouse 側の型は String になり、空白が値の一部として残ります。外部テーブルはこれを text として扱うので、n_name = 'CANADA' は ch 経路では 1 件も一致しません。Q16 だけ行数が増えるのも同じ理由で、p_brand <> 'Brand#45' が全件に一致するためです。
スキーマの char(n) を varchar(n) に変えて入れ直したところ、値が完全に一致するクエリは 8 本から 16 本になりました。以降の数字はすべて varchar 版です。前作も同じ条件で測っており、公開後に訂正して 1 節を追加しています1。
3.3. EXISTS の中に不等号があると答えが変わる
残った差のうち Q21 だけは性質が違いました。行数はどちらも 100 行なのに、値が違います。SF10 の結果の 1 行目です。
| 経路 | 1 行目のサプライヤ | numwait |
|---|---|---|
public |
Supplier#000062538 | 24 |
ch |
Supplier#000003645 | 17 |
Remote SQL: を見ると EXISTS は LEFT SEMI JOIN に変換されていて、ここまでは公式の説明どおりです2。ただ、EXISTS の中にあった不等号が ON 句ではなく外側の WHERE 句に置かれていました。
LEFT SEMI JOIN "default".lineitem r5 ON (((r3.o_orderkey = r5.l_orderkey)))
WHERE ((r5.l_suppkey <> r2.l_suppkey)) AND ...
ClickHouse に直接 SQL を投げ、不等号の置き場所だけを変えて比べました。SF10 の lineitem で、l_orderkey < 100000 の行のうち「同じ注文に別の仕入先の行があるもの」を数えたものです。
| 経路・書き方 | 答え |
|---|---|
| PostgreSQL 単独 | 96,874 |
ClickHouse に直接投げ、不等号を ON 句に置く |
96,874 |
ClickHouse に直接投げ、不等号を WHERE 句に置く |
75,382 |
pg_clickhouse 経由(WHERE 句に置く SQL を生成する) |
75,382 |
ClickHouse の LEFT SEMI JOIN は、一致した右側の行のうち 1 行の値を WHERE 句から参照できます。そこに不等号を置くと、その 1 行に対してだけ判定することになり、条件を満たす別の行があっても落とされます。ON 句に置けば「1 行でもあるか」の判定になり、PostgreSQL と同じ答えになります。
この現象を直す PR が 2026-08-14 に出ています5。本記事の執筆時点では未マージで、v0.10 には含まれていません。
3.4. 空白詰めを直したあとに出た Q05 のメモリ不足
varchar で入れ直して SF10 を測ると、Q05 が 3 回ともエラーになりました。
DB::Exception: (total) memory limit exceeded: would use 10.81 GiB
Mini は 12 GiB です。char(n) のときは絞り込みが 1 行も一致せず 0 行を即座に返していたので、このエラーは出ていませんでした。空白詰めがあると、遅いクエリが速く見えるだけでなく、エラーになるクエリも成功したように記録されます。
3.5. 残った差の分類
EXPLAIN を外して同じクエリを両経路で実行し、diff で比べました。行数が一致しても中身が一致するとは限りません。Q17 のようなスカラー集計は入力が 0 行でも 1 行返しますし、0 行同士の一致も判断材料になりません。
| 性質 | クエリ | 中身 | 倍率を読めるか |
|---|---|---|---|
| 完全に一致 | 16 本 | 読める | |
| 桁数だけの差 | Q01 / Q14 / Q17 |
3295493.512857142857 対 3295493.51285714
|
読める |
| 桁の切り捨て | Q08 |
0.03882014251433219622 対 0.0388
|
読めるが注意 |
| 閾値のずれ | Q22 | 件数が 1 ずつ多い | 読めるが注意 |
| 答えが違う | Q21 | 3.3 章の不等号の件 | 読めない |
以降の倍率は、この表を前提に読んでください。
4. プッシュダウンはどこまで増えたか
4.1. 分類の定義を先に決める
前作は「22 本中 14 本が完全プッシュダウン」と本文の 5 か所に書いていました。ところが、その 14 本がどのクエリなのかも、何をもって「完全」としたのかも残していませんでした。これでは今回との差を出せません。
そこで、測る前に定義を決めました。判断材料は EXPLAIN (VERBOSE) の実行計画で、Foreign Scan より上に PostgreSQL 側の処理がどれだけ残っているかを見ます。
| ラベル | 定義 |
|---|---|
| 完全(厳しい定義) |
Foreign Scan より上に PostgreSQL 側のプランノードが 1 つも無い |
| 完全(緩い定義) | 上に残るのが集計 1 ノードだけ(Aggregate / HashAggregate など) |
| 部分 |
Remote SQL: はあるが、上の 2 つに当てはまらない |
| なし |
Remote SQL: が出ない |
定義を 2 つ持ったのは、公式の「16 of 22」がどちらの数え方かを原文から読み取れなかったためです。両方の本数を出しておけば、本数が合わなかったときに「数え方の違いなのかどうか」を切り分けられます。
分類は 1 本の抽出スクリプトで行い、前作のログにも同じスクリプトをかけました。前作の本文にある 14 本と一致したので、前作と今回を同じ数え方で比べられます。
4.2. 完全プッシュダウンは 17 本になった
SF1 で測った分類の内訳です。
| 分類 | v0.3 | v0.10 |
|---|---|---|
| 完全(厳しい定義) | 13 本 | 17 本 |
| 完全(緩い定義まで含める) | 14 本 | 17 本 |
| 部分 | 7 本 | 5 本 |
| プランが出ない | 1 本 | 0 本 |
v0.10 では緩い定義に当てはまるクエリが 1 本も無くなりました。集計だけが PostgreSQL 側に残る分類は無くなり、Foreign Scan 1 つで終わる形か、明らかに部分的な形かのどちらかに分かれています。
分類が変わったのは次の 5 本です。
| クエリ | v0.3 | v0.10 | v0.3 で PostgreSQL 側に残っていた処理 |
|---|---|---|---|
| Q02 | 部分 | 完全 |
Limit / Nested Loop / Materialize
|
| Q16 | 部分 | 完全 |
Sort / GroupAggregate / Merge Join ほか |
| Q17 | 完全(緩い定義) | 完全 |
Aggregate 1 つ |
| Q22 | 部分 | 完全 |
Sort / HashAggregate / Hash Anti Join
|
| Q18 | プランが出ない | 部分 | (前作は打ち切られてプランが出ていない) |
Q18 だけ性質が違います。前作は上限時間に達して打ち切られ、プラン自体が出ていませんでした。今回は完走してプランが出たので、「増えた」ではなく「初めて数えられた」が正確です。
SF10 でも同じ分類を取り直しました。違ったのは Q05 の 1 本だけで、これは ClickHouse 側がメモリ不足でエラーになりプランが出なかったためです(3.4 章)。それ以外の 21 本は SF1 とまったく同じ分類でした。プッシュダウンされるかどうかはデータ量に左右されない、という前作の結論は、今回もそのまま当てはまります。
4.3. 公式の 16 本との差は Q16 の 1 本
公式ブログは、プッシュダウンされない 6 本をクエリ名で挙げています。
Six queries remain unpushed: Q13, Q15, Q16, Q18, Q20, Q21.
こちらで部分に分類されたのは Q13 / Q15 / Q18 / Q20 / Q21 の 5 本でした。6 本のうち 5 本は公式と一致し、Q16 だけが一致しません。こちらの環境では、Q16 は 1 つの Foreign Scan にまとまりました。
SELECT r2.p_brand, r2.p_type, r2.p_size, count(DISTINCT r1.ps_suppkey)
FROM "default".partsupp r1
  ALL INNER JOIN "default".part r2 ON (((r1.ps_partkey = r2.p_partkey)))
WHERE ((r2.p_brand <> 'Brand#45'))
  AND ((r2.p_type NOT LIKE 'MEDIUM POLISHED%'))
  AND ((r2.p_size IN (49,14,23,45,19,3,36,9)))
  AND ((NOT (r1.ps_suppkey IN (
        SELECT q1_1.s_suppkey FROM "default".supplier q1_1
        WHERE ((q1_1.s_comment LIKE '%Customer%Complaints%'))))))
GROUP BY r2.p_brand, r2.p_type, r2.p_size
ORDER BY count(DISTINCT r1.ps_suppkey) DESC NULLS FIRST, ...
NOT IN がサブクエリのまま 1 文に収まっています。公式は、Q16 をプッシュダウンできない理由をこう説明しています。
what blocks them is that PostgreSQL flattens their subqueries into anti/semi-joins whose inputs are themselves joins, and the deparser doesn't yet walk a join tree on both sides of a join.
PostgreSQL がサブクエリを結合の形に書き換えてしまうと、pg_clickhouse はそれを ClickHouse 向けの SQL に組み立て直せない、という説明です。ところがこちらの環境では、PostgreSQL は Q16 の NOT IN を結合に書き換えていませんでした。前作(v0.3)のプランを見ると、Filter: (NOT (ANY (partsupp.ps_suppkey = (hashed SubPlan 1).col1))) とあり、サブクエリとして残っています。v0.10 の CHANGELOG は、今回追加したプッシュダウンの対象をこう書いています。
Added pushdown for subqueries the planner cannot flatten into joins (SubPlans)
結合に書き換えられずに残ったサブクエリは、こちらの Q16 に当てはまります。
最初に確認したのは列の NULL 許容です。NOT IN は NULL の扱いがあるため、列が NULL を許すと PostgreSQL は anti-join に書き換えられません。実際に確認したところ、supplier.s_suppkey も partsupp.ps_suppkey も PostgreSQL 側・外部テーブル側の両方で NOT NULL で、ClickHouse 側の型も Nullable ではない Int32 でした。NULL 許容は原因ではありませんでした。
なぜ公式の環境では結合に書き換えられ、こちらではサブクエリのまま残ったのかは特定できていません。1 章に書いたとおり、この記事は「この構成ではこうなった」までを報告するものです。
なお、一次ソースの側にも一致しない点があります。ブログと README の表は Q15 と Q20 をプッシュダウンされない側に置いていますが、同じリポジトリの CHANGELOG は v0.10 でカバーした対象として Covers TPC-H Q2, Q11, Q15, Q17, Q20, and Q22 shapes. と書いており6、Q15 と Q20 が両方に登場します。「サブクエリの書き方をカバーした」ことと「クエリ全体が完全にプッシュダウンされる」ことは別の話だと読めますが、どちらが正しいという判定はしていません。
5. パラメータの有無ではなく、実行計画を見る
先に用語を 1 つ決めておきます。pg_clickhouse が ClickHouse へ送る SQL は、EXPLAIN (VERBOSE) の Remote SQL: という行に出ます。この SQL には {p1:Int32} のような文字列が混ざることがあり、実行時に値を入れる場所を表しています。以降、これを「パラメータ化されている」と呼びます。
5.1. 前作の記述と生ログの突き合わせ
前作は、SF を上げても倍率が変わらなかった 4 本(Q08 / Q16 / Q19 / Q22)を、相関サブクエリがパラメータ化されて外側の行ごとに ClickHouse へ送られるから、と説明していました。生ログを読み直すと、4 本のうち {p1:...} があるのは Q22 だけで、しかもそれはクエリ全体で 1 回しか評価されない InitPlan でした。実際にパラメータ化されていたのは Q02 / Q11 / Q17 / Q20 / Q22 の 5 本です。前作は公開後に訂正しています1。
5.2. 同じ「パラメータ化」でも中身は 2 種類ある
{p1:...} が実行計画のどこから来ているかで 2 つに分かれます。InitPlan はクエリ全体で 1 回だけ評価されるスカラーのサブクエリ、SubPlan は外側の行ごとに評価されうる相関サブクエリです。
| クエリ | v0.3 の {p1:...} の出どころ |
評価される回数 |
|---|---|---|
| Q02 |
SubPlan(Nested Loop の Join Filter の中) |
外側の行ごと |
| Q17 |
SubPlan(Foreign Scan の Filter の中) |
外側の行ごと |
| Q20 |
SubPlan(Filter の中) |
外側の行ごと |
| Q11 | InitPlan |
1 回 |
| Q22 | InitPlan |
1 回 |
文字列の有無だけでは、1 回なのか行の数だけなのかは分かりません。実行計画のどこにぶら下がっているかを見る必要があります。なお、前作の倍率そのものが使えない数字だったので(3 章)、どちらの書き方が速いかは前作のデータからは言えません。この章で言えるのは、実行計画の構造が v0.10 でどう変わったか、までです。
5.3. v0.10 で無くなったのは SubPlan のほう
v0.10 で {p1:...} がどうなったかを見ると、SubPlan 側と InitPlan 側の 2 つに分かれました。
| クエリ | v0.3 | v0.10 |
|---|---|---|
| Q02 / Q17 / Q20 |
SubPlan あり |
SubPlan が無くなり、{p1:...} も消えた |
| Q11 / Q22 |
InitPlan あり |
InitPlan のまま。{p1:Decimal} は残っている |
Q02 で何が起きたかが分かりやすい例です。v0.3 の Q02 は Remote SQL: が 3 文に分かれていて、そのうち 1 文が値を入れる書き方でした。
SELECT min(r1.ps_supplycost)
FROM "default".partsupp r1
  ALL INNER JOIN "default".supplier r2 ON (((r1.ps_suppkey = r2.s_suppkey)))
  ALL INNER JOIN "default".nation r3 ON (((r2.s_nationkey = r3.n_nationkey)))
  ALL INNER JOIN "default".region r4 ON (((r3.n_regionkey = r4.r_regionkey)))
WHERE ((r4.r_name = 'EUROPE')) AND (({p1:Int32} = r1.ps_partkey))
v0.10 では Remote SQL: が 1 文になり、同じサブクエリが相関したまま中に入りました。{p1:Int32} があった位置に、外側の別名 r1.p_partkey がそのまま書かれています。
... AND (((SELECT min(q1_1.ps_supplycost)
           FROM "default".partsupp q1_1, "default".supplier q1_2,
                "default".nation q1_3, "default".region q1_4
           WHERE (((r1.p_partkey) = q1_1.ps_partkey))
             AND ((q1_2.s_suppkey = q1_1.ps_suppkey))
             AND ((q1_2.s_nationkey = q1_3.n_nationkey))
             AND ((q1_3.n_regionkey = q1_4.r_regionkey))
             AND ((q1_4.r_name = 'EUROPE'))) = r3.ps_supplycost)) ...
PostgreSQL 側で行ごとに繰り返していた処理が、ClickHouse 側の相関サブクエリ 1 文に置き換わったことになります。CHANGELOG の書き方とも一致します。
Added pushdown for subqueries the planner cannot flatten into joins (SubPlans)
5.4. パラメータが残っても往復は行数に比例しない
Q11 と Q22 には v0.10 でも {p1:Decimal} が残ります。ただしこれは前作で問題として挙げた構成ではありません。Q22 のプランを見ると、Foreign Scan の下に InitPlan 1 がぶら下がっています。
Foreign Scan  (actual time=82.718..85.254 rows=7 loops=1)
  Relations: Aggregate on ((customer) LEFT ANTI JOIN (orders))
  InitPlan 1
    ->  Foreign Scan  (actual time=20.201..21.773 rows=1 loops=1)
          Output: (avg(customer_1.c_acctbal))
          Relations: Aggregate on (customer)
内側の Foreign Scan は rows=1 loops=1 で、平均値を 1 回取得するだけです。その結果が {p1:Decimal} として外側の 1 文に入ります。ClickHouse への往復は 2 回で、行の数には比例しません。
そして Q22 は、この構成のまま v0.3 の部分プッシュダウンから完全プッシュダウンに変わりました。v0.3 では Sort / HashAggregate / Hash Anti Join が PostgreSQL 側に残っていましたが、v0.10 では anti-join と集計まで ClickHouse 側の 1 文に入っています。{p1:...} の有無は v0.3 と v0.10 で変わっていないのに、分類は変わりました。ここでも、この文字列は分類の手がかりになっていません。
6. SF1 と SF10 の倍率
6.1. 22 クエリの一覧
倍率は「PostgreSQL 単独の所要時間 ÷ ClickHouse 経由の所要時間」で、1.00 を超えると ClickHouse 経由のほうが速いことを表します。分母はそれぞれのスケールで測った PostgreSQL 側の値なので、SF1 の倍率と SF10 の倍率を引き算しても意味はありません。同じ行の中で 1.00 をまたいだかどうかを見てください。
| クエリ | 分類 | SF1 | SF10 | 答えの一致 |
|---|---|---|---|---|
| Q01 | 完全 | 5.14 | 6.27 | 桁数だけ差 |
| Q02 | 完全 | 2.65 | 7.63 | 一致 |
| Q03 | 完全 | 1.30 | 2.68 | 一致 |
| Q04 | 完全 | 0.51 | 0.65 | 一致 |
| Q05 | 完全 | 0.06 | 測れず | 一致(SF10 はエラー) |
| Q06 | 完全 | 1.21 | 1.75 | 一致 |
| Q07 | 完全 | 2.13 | 2.30 | 一致 |
| Q08 | 完全 | 0.19 | 0.29 | 桁が切り捨て |
| Q09 | 完全 | 1.52 | 1.67 | 一致 |
| Q10 | 完全 | 0.91 | 1.45 | 一致 |
| Q11 | 完全 | 1.28 | 2.70 | 一致 |
| Q12 | 完全 | 2.25 | 1.90 | 一致 |
| Q13 | 部分 | 1.42 | 1.37 | 一致 |
| Q14 | 完全 | 0.63 | 0.86 | 桁数だけ差 |
| Q15 | 部分 | 0.86 | 0.90 | 一致 |
| Q16 | 完全 | 2.91 | 7.05 | 一致 |
| Q17 | 完全 | 1.99 | 2.37 | 桁数だけ差 |
| Q18 | 部分 | 0.07 | 1.38 | 一致 |
| Q19 | 完全 | 0.10 | 0.10 | 一致 |
| Q20 | 部分 | 2.10 | 9.65 | 一致 |
| Q21 | 部分 | 0.17 | 0.17 | 違う |
| Q22 | 完全 | 0.86 | 1.96 | 閾値のずれ |
Q05 は SF10 で ClickHouse 側がエラーになったため倍率がありません(3.4 章)。SF1 では 256.7 ms に対し 4,522.1 ms で、この時点ですでに ch 経路のほうが 17 倍以上遅くなっていました。
6.2. ClickHouse 経由が速いのは 12 本から 15 本へ
| SF1 | SF10 | |
|---|---|---|
| ClickHouse 経由が速い(1.00 超) | 12 本 | 15 本 |
スケールを上げると増える、という点は前作と同じでした。1.00 をまたいだのは Q10・Q18・Q22 の 3 本で、逆向きに変わったクエリはありません。
伸び方が大きいのは Q20(2.10 から 9.65)と Q16(2.91 から 7.05)、Q02(2.65 から 7.63)です。逆に Q08 は 0.19 から 0.29 で、両方のスケールとも PostgreSQL 側が 3 倍から 5 倍速いままでした。
6.3. Q22 は SF10 で判定が変わった
Q22 は SF1 と SF10 で判定が変わったクエリです。
| スケール | PostgreSQL 単独 | ClickHouse 経由 | 倍率 |
|---|---|---|---|
| SF1 | 93.9 ms | 109.2 ms | 0.86 |
| SF10 | 757.7 ms | 385.7 ms | 1.96 |
SF1 では 100 ms 前後で、ネットワークの往復と ClickHouse 側の起動が占める割合が大きい領域です。データ量が 10 倍になって初めて、ClickHouse 経由のほうが速くなりました。倍率が 1.00 付近で終わった項目は、差が無いのではなく、その規模では差が出ないだけかもしれません。
なお Q22 は 3.5 章のとおり、ch 経路では各グループの件数が 1 件多く出ています。倍率もその分を含んだ値です。
7. 考察
7.1. プッシュダウンの分類は速さの指標ではない
分類と倍率を並べると、両者が対応していないことが分かります。
| クエリ | 分類 | SF1 | SF10 |
|---|---|---|---|
| Q08 | 完全 | 0.19 | 0.29 |
| Q19 | 完全 | 0.10 | 0.10 |
| Q20 | 部分 | 2.10 | 9.65 |
Q08 と Q19 は結合も集計も 1 文で ClickHouse に出ているのに、両方のスケールとも PostgreSQL のほうが速いままです。逆に Q20 は PostgreSQL 側に Sort や Hash Join が残った部分プッシュダウンなのに、SF10 で 9.65 倍になりました。しかも Q20 は、公式ブログがプッシュダウンされない 6 本に挙げているクエリです。
プッシュダウンの分類が答えているのは「どこで計算したか」であって、「速いかどうか」ではありません。分類が 13 本から 17 本に増えても、PostgreSQL のほうが速いままのクエリは v0.10 でも変わりません。
7.2. ch 経路の所要時間は、ほぼ ClickHouse の中で使われている
ClickHouse で実行されたクエリは system.query_log に記録されるので、外部テーブル経由でそれを読めば、ch 経路の所要時間のうち何 ms が ClickHouse の中で使われたかが分かります。
SF10 の Q08 は 3 回の平均が 6,901 ms でした。こちらが PostgreSQL 側で測った ch 経路の値は 6,906.6 ms です。99.9 パーセントが ClickHouse の中で、外部テーブルの層とネットワークの上乗せは数 ms でした。同じデータを PostgreSQL は 1,991.4 ms で処理しています。
Q05 のエラーも同じ場所で起きています。ClickHouse 側は 16 秒ほどかけてメモリ使用量が 10 GB に達し、そこで打ち切られていました。
ここから先は確かめていませんが、2 章に書いた計算資源の差が候補と考えられます。PostgreSQL 側が 16 vCPU / 64 GB、ClickHouse 側が Mini の 3 vCPU / 12 GiB で、CPU コア数で約 5 倍の差があります。Q08 のときの ClickHouse 側は 78,668,615 行を読み、メモリを約 4.3 GB 使っていました。確かめるには ClickHouse 側のサービスサイズを上げて同じ 22 クエリを実行し、Q08 の倍率と Q05 の成否が変わるかを見る必要があります。
7.3. 公式の数字をどう読むか
公式ブログと README の計測は、SF1 のデータを MacBook Pro M4 Max(36 GB)のローカル環境で行ったものです。手元の 1 台に PostgreSQL と ClickHouse が同居しているので、ネットワークの往復はほとんど乗りません。一方こちらは、東京リージョンのマネージドサービス 2 つの間を TLS で往復する構成です。
そのうえで、プッシュダウンの本数(16 対 17)はほぼ再現しました。プッシュダウンされるかどうかはプランを組み立てる段階で決まるので、環境が違っても揃いやすいのだと思われます。倍率のほうは環境の影響を強く受けるので、公式の数字と突き合わせても意味がありません。
読者が自分の環境で確かめるとしたら、本数は再現を期待してよく、倍率は自分で測るしかない、という切り分けになります。
7.4. Q18 が SF10 で速くなったのは LIMIT が早く効いたため
Q18 は前作では上限時間に達して打ち切られ、今回は両方のスケールで完走しました。
| スケール | PostgreSQL 単独 | ClickHouse 経由 | 倍率 |
|---|---|---|---|
| SF1 | 3,356.3 ms | 47,492.8 ms | 0.07 |
| SF10 | 12,767.8 ms | 9,231.2 ms | 1.38 |
データが 10 倍になったのに、ClickHouse 経由は 47.5 秒から 9.2 秒へ縮んでいます。実行計画の形は同じで、部分プッシュダウンのまま PostgreSQL 側に Limit / GroupAggregate / Nested Loop が残っています。違ったのは、外側の Foreign Scan が実際に読んだ行数でした。
| スケール | 外側の Foreign Scan が返した行数 |
Join Filter で捨てた行数 |
最終行数 |
|---|---|---|---|
| SF1 | 6,001,215 | 342,057,684 | 57 |
| SF10 | 1,861 | 928,417 | 100 |
Q18 は LIMIT 100 で終わるクエリです。SF1 では条件を満たす注文が 57 件しかなく 100 に届かないため、PostgreSQL は ClickHouse から返る結合結果 600 万行を最後まで読み、Nested Loop で 3.4 億回の比較をしていました。SF10 では 100 件目が出た時点で打ち切られ、外側は 1,861 行しか読んでいません。3 回の実行すべてで同じ行数でした。所要時間を決めているのはデータ量ではなく、LIMIT が途中で効くかどうかです。
なお、前作の Q18 は SF1 で 30 秒、SF10 で 300 秒の時点で打ち切られていました。今回の上限は 300 秒です。前作の SF1 は上限が違っていた可能性があるので、「完走するようになった」を性能の改善として読むことはできません。
8. まとめ
pg_clickhouse v0.10 で TPC-H 22 クエリを測りました。今回分かったことを 3 つ挙げます。
- 経路を切り替えて速さを比べるなら、先に両方の経路が同じ答えを返すか確かめる。行数だけでは足りない。スカラー集計は入力が空でも 1 行返すし、0 行同士の一致も判断材料にならない
- 完全プッシュダウンは 13 本ないし 14 本から 17 本に増えた。分類の定義を明記したうえで数えれば、公式の「16 of 22」ともほぼ揃う
- プッシュダウンの分類と速さは別物である。完全にプッシュダウンされても PostgreSQL のほうが速いクエリ(Q08・Q19)も、部分プッシュダウンのまま 9.65 倍になるクエリ(Q20)もある
参考
-
Postgres から ClickHouse へフェデレーテッドクエリ(pg_clickhouse)(前作。v0.3 で TPC-H 22 本を SF1 / SF10 で測ったもの) ↩ ↩2 ↩3
-
pg_clickhouse v0.10.0 のリリース記事(ClickHouse 公式ブログ。完全プッシュダウンが 12 本から 16 本になったこと、EXISTS をセミ結合として送ることが書かれている) ↩ ↩2
-
pg_clickhouse の TPC-H テストケース(README。22 クエリの一覧表と、計測が SF1・MacBook Pro M4 Max / 36 GB で行われたことが書かれている) ↩
-
PostgreSQL の文字型(公式ドキュメント。
character(n)は空白で詰めて保存され、比較時に末尾の空白が意味を持たないことが書かれている) ↩ -
Emit SEMI join inner conditions in the ON clause(pg_clickhouse PR #347)(
EXISTSの相関条件がON句ではなくWHERE句に置かれ、行が少なく返る問題の修正。2026-08-14 作成、執筆時点で未マージ) ↩ -
pg_clickhouse の CHANGELOG(v0.10.0 の項に、結合に書き換えられないサブクエリ(SubPlan)のプッシュダウンを追加したこととカバー範囲が書かれている) ↩