
ユーザーから「先週返品した商品が、まだ返金されていません」と届いたとする。返金規約を調べるだけなら単純だが、実際には本人確認、返品の到着確認、決済状態の参照、返金処理の要否判断、ユーザーへの説明までが一つの問い合わせに含まれる。
これを1体の汎用Agentに任せると、Promptにはあらゆる規約と例外が入り、利用可能なツールも増え、会話履歴と顧客データが同じContextへ流れ込む。モデルを強くしても、責任範囲の膨張そのものは消えない。
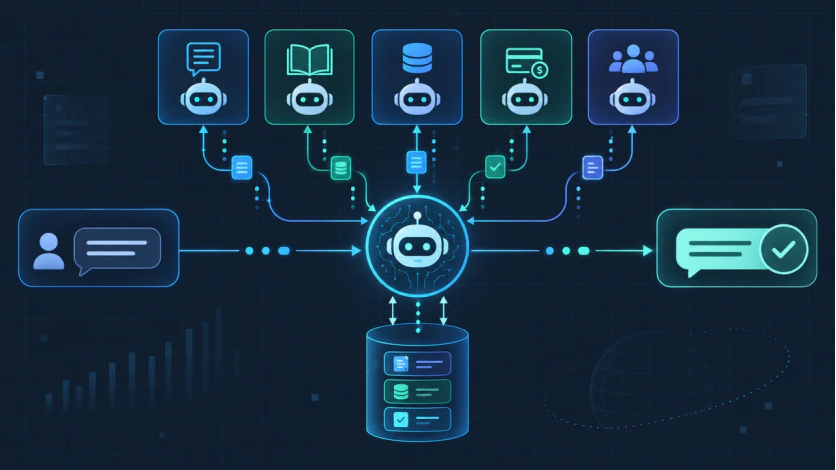
分ける単位は「機能名」ではなく境界
問い合わせ対応でMulti-Agentが効くのは、仕事を細かく数えるからではない。扱う情報、権限、失敗時の影響が異なる処理を切り離せるからだ。たとえば受付Agentは目的と不足情報を整理する。Knowledge Agentは返金規約と根拠を返す。Customer Agentは本人確認済みの範囲で注文・決済状況を読む。Action Agentは許可された操作だけを実行する。Supervisor Agentは各結果を突き合わせ、次の担当を決める。
ここで重要なのは、Supervisorを「全部知っている万能Agent」に戻さないことだ。専門Agentが見た生データを丸ごと集めれば、結局Contextは再び肥大化する。Supervisorが必要とするのは、根拠付きの事実、未完了タスク、許可された次の操作である。
会話全文ではなく、タスク状態を受け渡す
Agent間のHandoffでは、自然言語の要約だけに依存すると、確認済みの事実と推測が混ざりやすい。最小構成でも、次のような共有状態を別に持たせたい。
{
  "case_id": "C-1042",
  "goal": "返金遅延の原因を確認し、次の処理を決める",
  "identity": {"customer_id": "...", "verified": true},
  "facts": [
    {"key": "return_received", "value": true,
     "source_ref": "returns/RT-8821"},
    {"key": "refund_status", "value": "pending",
     "source_ref": "payments/P-4402"}
  ],
  "pending_tasks": ["refund_eligibility_check"],
  "allowed_actions": ["create_refund_request"],
  "owner": "supervisor",
  "state_version": 7
}
puts 'code block.'
この構造があると、Knowledge Agentは顧客の決済情報を読む必要がなく、Action Agentも会話の感情表現まで受け取らずに済む。source_refを残せば、別Agentが結論だけを信じるのではなく根拠へ戻れる。state_versionは並行処理で古い結果が新しい状態を上書きする事故を防ぐために使える。
Supervisorは「司令塔」より「交通整理」に近い
実装では、Supervisorに自由な再計画をさせるほど賢く見える一方、同じAgentを何度も呼ぶループや、失敗した専門Agentの結果を別Agentが前提にしてしまう連鎖も起きる。そこで、各タスクにowner・期限・最大試行回数を持たせ、失敗は文章でごまかさず状態として返す。Action Agentが失敗したら、返信生成へ進まず、Supervisorが再試行・代替経路・人への確認のいずれかを選ぶ。この程度の制約は、Agentの自由を奪うというより責任を読める形にする。
分けないほうがよい問い合わせもある
一方、単発の営業時間確認のように、参照する知識も権限も一つで、ツールが少ないなら、1体のAgentまたは決定的なWorkflowのほうが速くて保守しやすい。Multi-Agent化には推論回数、遅延、状態同期、テスト対象が増えるコストがある。役割名を付けただけのAgentを量産しても、境界が同じなら複雑さを移しただけだ。
私なら「異なるデータ境界」「異なる実行権限」「独立して検証したい責任」のどれかが現れた時点で、分割を検討する。
どこから分けるか
企業の問い合わせでは、知識、顧客情報、業務操作、人との協働がもともと別の領域にある。Udeskに関わるAIカスタマーサポートの実践でも、将来は一つの万能Botを膨らませるより、専門性の異なるAgentが必要な状態だけを共有する設計が重要になると考えている。
皆さんなら、問い合わせ対応を長期運用するとき、1体の汎用Agentを育て続けますか。それとも、どの境界が見えた段階で専門Agentへ分けますか。