
はじめに
2026年10月、Anthropic の認定資格「Claude Certified Architect – Foundations(CCAR-F)」に 770 点(合格ライン 720 点) で合格しました。この記事では、実際の勉強の進め方、スコアレポートから見えた弱点、本番で役立った解答のコツをまとめます。学習期間は1週間(毎晩1〜2時間)で、開発経験がある人向けの記録です。
先に結論:失点が集中したのは「要点をまとめただけで、問題形式で練習していなかった分野」でした。これから受ける方は、同じ落とし穴を避けてください。
私のバックグラウンドと学習時間
学習期間は1週間、毎晩1〜2時間で、合計はおよそ10時間前後です。短期間で済んだのは、クラウドでの設計経験という土台があったからだと思います。
- 普段の仕事:AWS 上でクラウドサービスを開発しています。
- 保有資格:AWS Certified Solutions Architect – Professional。
- 開発経験:あり。
CCAR-F も AWS の Professional 試験と同じく、長めのシナリオから制約を読み取り、もっともらしい選択肢の中から最適解を選ぶ形式です。「過剰な設計を選ばない」「要件をすべて満たすかを確認する」といった解き方は、そのまま使えました。
一方で、Claude 固有の仕組み(stop_reason、tool_choice、Batch API、MCP のスコープなど)は知識がないと解けません。1週間の大半は、この部分の要点整理と練習問題に使いました。
試験の基本情報
60問・120分、6つのシナリオから4つが出題され、720点以上で合格です。以下は公式 Exam Guide v1.0(2026年7月発効)にもとづく情報です。
| 項目 | 内容 |
|---|---|
| 試験コード | CCAR-F |
| 問題数/時間 | 60問/120分 |
| 出題形式 | 単一選択と複数選択(各問で選ぶ数が明記される) |
| 構成 | 6つのシナリオからランダムに4つ |
| 合格点 | 100〜1000点のスケールで720点 |
| 受験料 | 125米ドル(受験ごと) |
| 受験方法 | Pearson VUE の監督付き。オンラインまたはテストセンター |
| 結果 | 合否、総合スコア、テスト目標(objective)ごとの正答率 |
| 有効期間 | 12か月。期限内の更新は無料(監督なしのオンラインテスト)、失効後は全額で再受験 |
| 再受験の待機期間 | 14日→30日→90日。12か月で最大4回 |
ドメインと配点比率
| ドメイン | テーマ | 比率 |
|---|---|---|
| Domain 1 | Agentic Architecture & Orchestration | 27% |
| Domain 2 | Tool Design & MCP Integration | 18% |
| Domain 3 | Claude Code Configuration & Workflows | 20% |
| Domain 4 | Prompt Engineering & Structured Output | 20% |
| Domain 5 | Context Management & Reliability | 15% |
6つのシナリオ:Customer Support Resolution Agent/Code Generation with Claude Code/Multi-Agent Research System/Developer Productivity with Claude/Claude Code for CI/CD/Structured Data Extraction
勉強の進め方
「出題範囲の地図 → 要点まとめ → 単項練習 → シナリオ練習 → 誤答のルール化」の順で進めました。Claude と対話しながら、ノートと練習問題を作っていきました。
- 出題範囲の地図を作る:公式 Exam Guide の Task Statement(1.1〜5.6)をすべて表にし、「解説済み」「練習済み」「要復習」の状態を管理しました。
- ドメインごとに要点ノートを作る:各ドメインの冒頭に「総原則」を3〜4行、末尾に「よくある引っかけ選択肢」の表をつけました。
- Task Statement 単位の練習:1問ずつ出題範囲を絞って解きます。Domain 1 と 2.1 を中心に 31問すべて正解でした。
- シナリオ形式の練習:出題範囲を伏せた8問セット(単一・複数選択の混在)です。Domain 1(カスタマーサポート)で 5/8 でした。
- 誤答をルールに変える:間違えた問題ごとに「なぜその選択肢を選んだか」「次に使うルール」を1行で書きました。
単項練習で全問正解でも、シナリオ形式では点が落ちます。シナリオ問題はどの範囲の問題かを教えてくれず、引っかけ選択肢ももっともらしいからです。
スコアレポートの振り返り
総合 770 点で合格しましたが、テスト目標ごとに見ると 100% と 0% がはっきり分かれました。全29目標のうち、18目標が 100% でした。
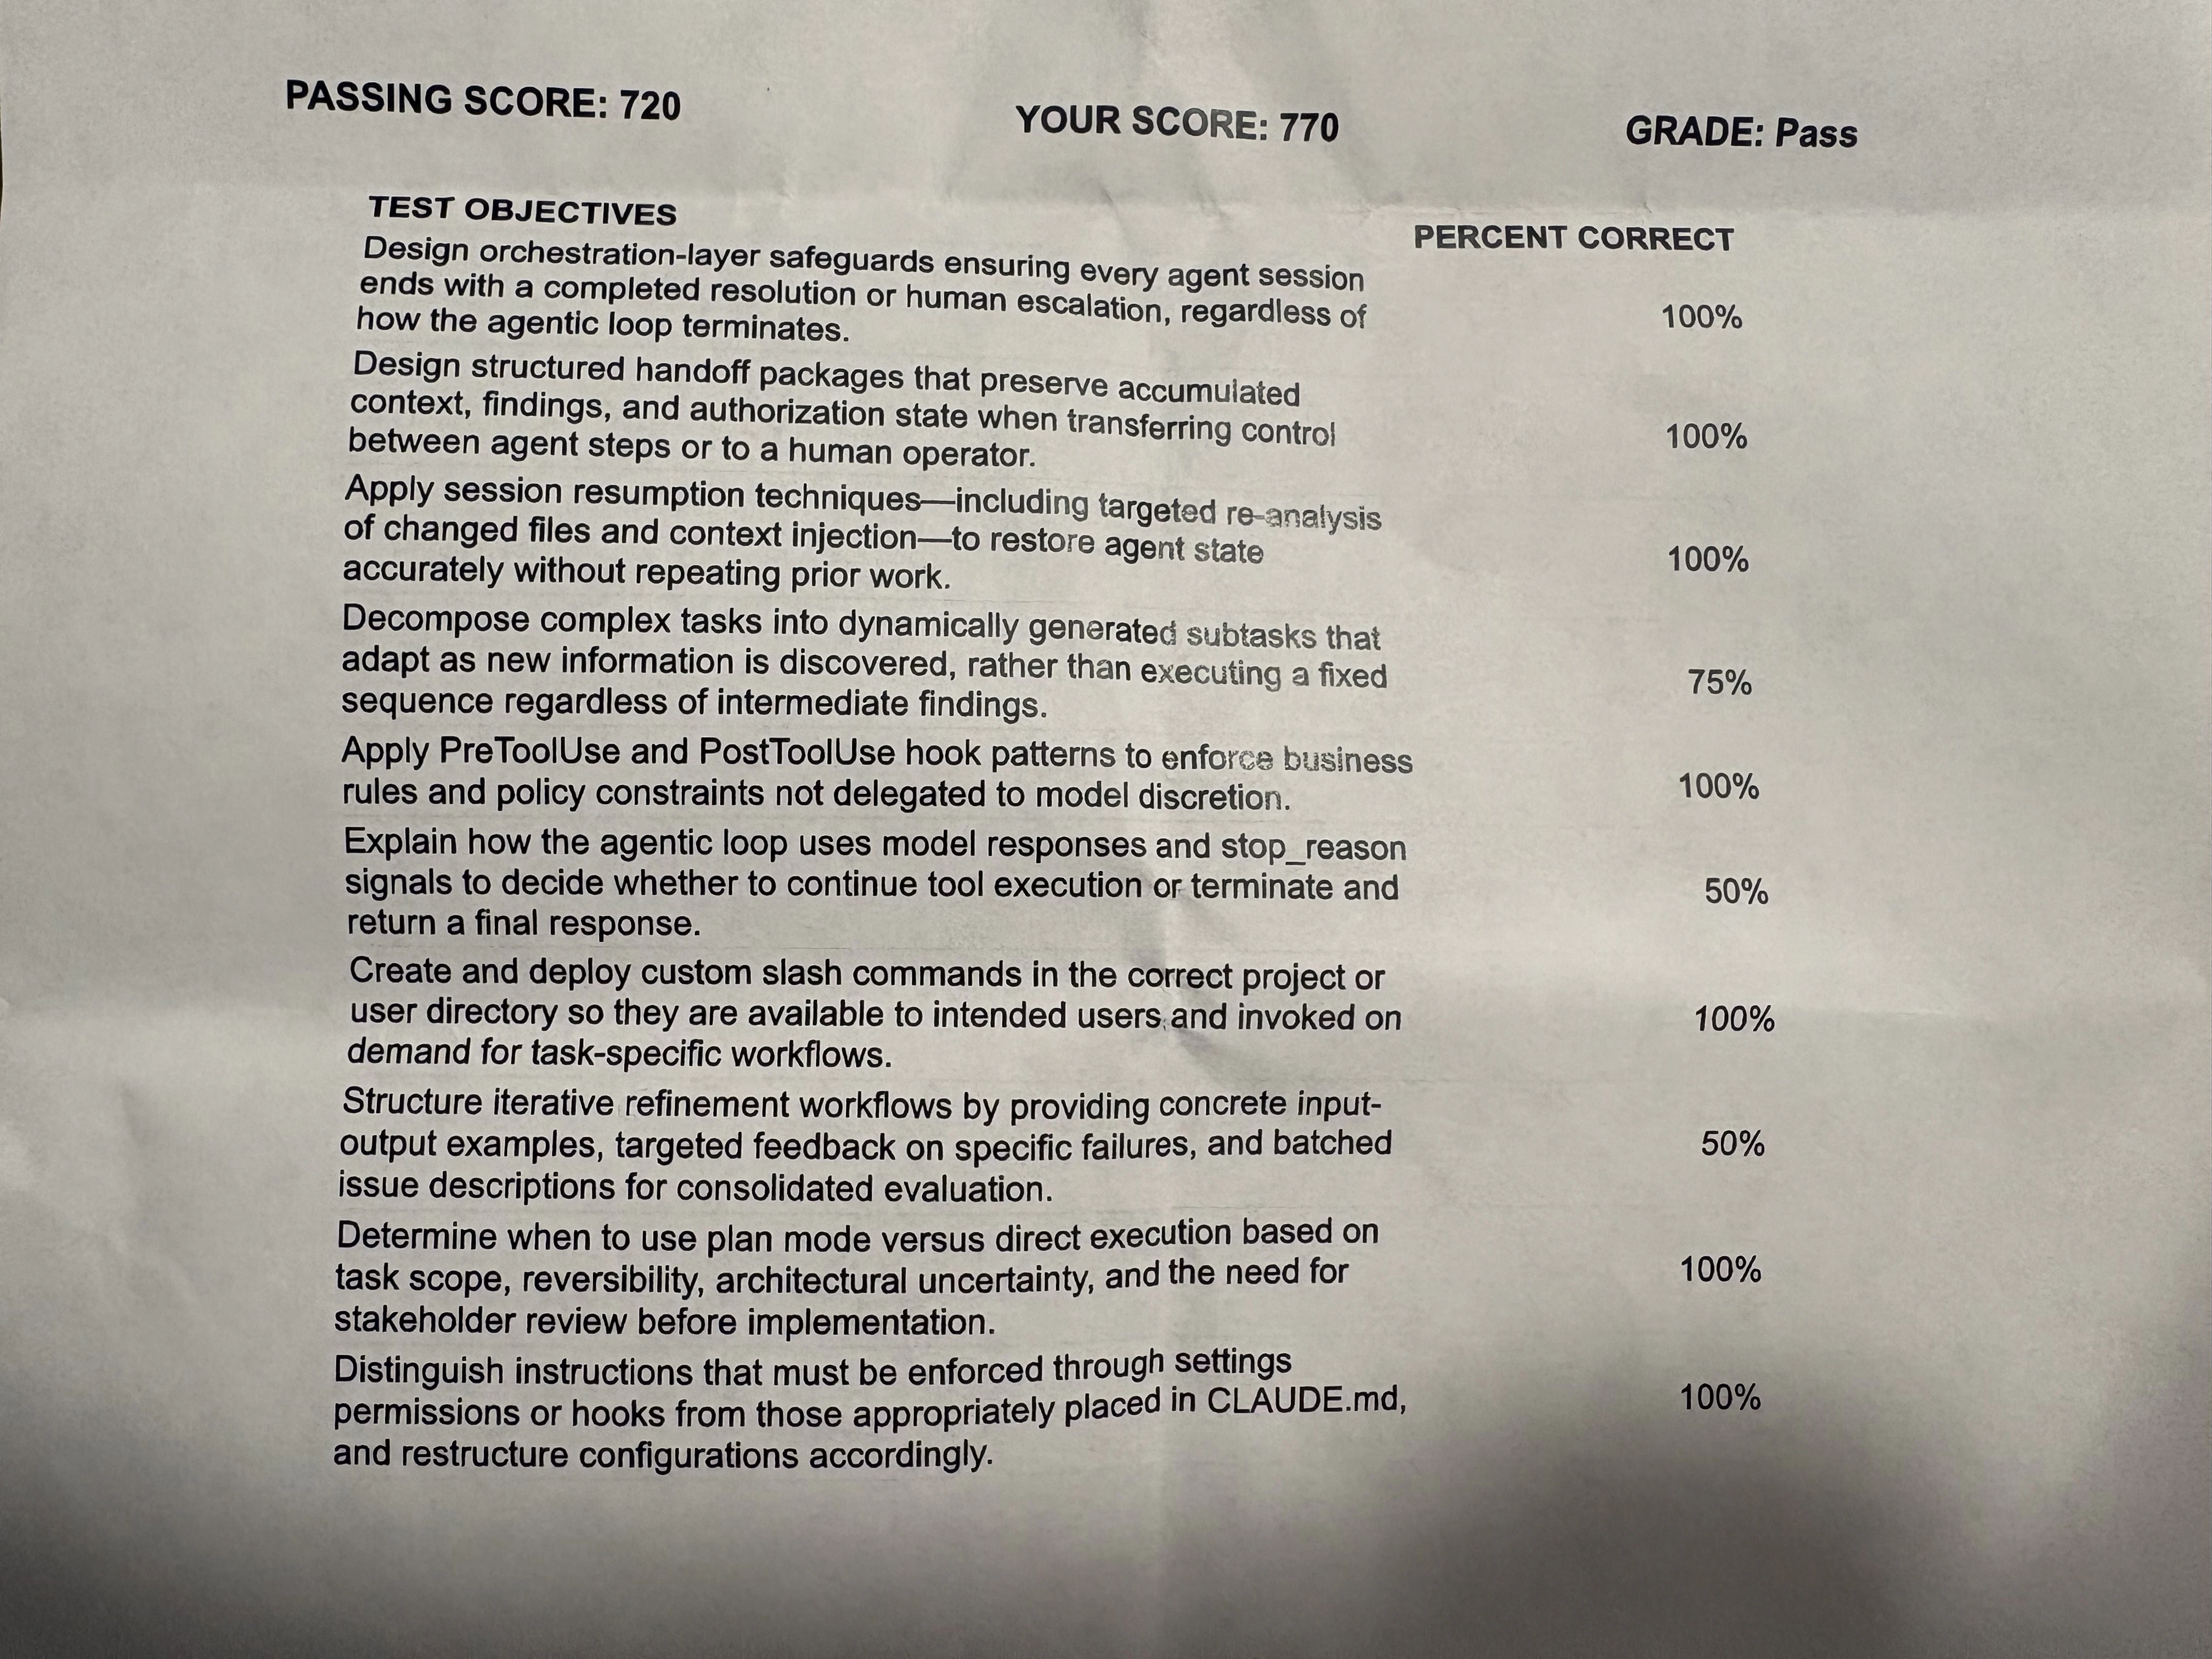

※ スコアレポートに載っているのはテスト目標と正答率だけで、試験問題の内容は含まれていません。
100% だった主な分野:PreToolUse/PostToolUse フックによるルールの強制、構造化された引き継ぎ、セッション再開、エスカレーション判断、MCP の構造化エラー、スラッシュコマンドの配置、plan mode の判断、CLAUDE.md と settings/hooks の使い分け、長い探索でのコンテキスト管理、tool_choice による実行順序の制御。
正答率 75% 以下だった分野(低い順)
| テスト目標(要約) | 対応する Task Statement | 正答率 | 本番前の準備状況 |
|---|---|---|---|
| 同期 Messages API と Message Batches API の使い分け | 4.5 | 0% | 要点まとめのみ |
| 最も信頼できる構造化出力の方法(tool use+JSON schema/プロンプト指定/prefill) | 4.3 | 0% | 練習1問 |
tool use+JSON schema と tool_choice で会話的な応答を防ぐ |
4.3・2.3 | 0% | 練習数問 |
| ツール説明の拡充(使用例、入力形式、類似ツールとの区別) | 2.1 | 0% | 練習4問すべて正解 |
| MCP サーバーの統合(スコープ、環境変数展開、ツール検出) | 2.4 | 25% | 練習1問 |
stop_reason によるエージェントループの制御 |
1.1 | 50% | 練習済み |
| 反復改善(入出力例、失敗への具体的フィードバック、問題をまとめて伝える) | 3.5 | 50% | 要点まとめのみ |
| Grep/Glob/Read による段階的なコードベース探索 | 2.5 | 50% | 要点まとめのみ |
| 信頼度や文書の特徴による人手レビューの振り分け | 5.5 | 67% | 要点まとめのみ |
| 欠損や曖昧さを表現できる抽出スキーマ設計 | 4.3 | 67% | 練習1問 |
| 動的なタスク分解 | 1.6 | 75% | 練習済み |
25%・67%・75% という数字から、1目標あたりの問題数は2〜4問程度と推測できます。1問の差で数字が大きく動くので、傾向として読むのが適切です。
最大の教訓:まとめただけの分野は本番で崩れる
0% だった4目標のうち3つは Domain 4(構造化出力・Batch API)で、どれも「要点まとめのみ」か「練習1問」の分野でした。ノートには「tool_choice を any にすると必ずツールが呼ばれる」「Batch API は最大24時間で遅延保証なし」と書いていたのに、問題の形で判断した経験がほとんどありませんでした。
逆に、練習で間違えて「次に使うルール」を書いた分野は本番で強くなりました。人への引き継ぎ、フックによる強制、エスカレーション判断は、どれも 100% でした。
ただし、練習済みでも安心はできません。ツール説明(2.1)は単項練習で4問すべて正解でしたが、本番では 0% でした。単独の問題で正解できても、シナリオの中で「最初に打つべき手」として選べるとは限りません。
もう一つの注意点は、スコアレポートの目標が Exam Guide の文言より少し広いことです。prefill による出力形式の指定、settings の permissions、ファイル編集ごとに lint やテストを走らせる PostToolUse フック、@ 参照・CLAUDE.md・インライン説明の使い分けなどが目標として並んでいました。
ドメイン別の重点ポイント
各ドメインで「これだけは押さえる」という点を、本番で問われた目標を中心にまとめます。
Domain 1:Agentic Architecture & Orchestration(27%)
-
ループの継続・終了は
stop_reasonだけで判断する。"tool_use"なら続行、"end_turn"なら終了です。「完了しました」という文言やテキストの有無では判断しません。反復回数の上限は安全装置で、主な停止手段ではありません。 - ツール結果はすべて同じ user メッセージに入れ、
tool_use_idで対応づけます。失敗もis_error: trueで返し、捨てません。 -
subagent は会話履歴を継承しない。必要な情報は Task prompt に書きます。AgentDefinition の
descriptionは「どの subagent を選ぶか」、Task prompt は「何を渡すか」です。 - 金額・本人確認・コンプライアンスのように必ず守るべきルールは、フックや前提条件チェックでコード強制します。止めたときは理由と次の手順を返します。
- 手順が事前にわかる → prompt chaining、調べて初めてわかる → 動的分解。
- セッション:コンテキストがほぼ有効 →
--resumeして変更ファイルを伝える。大半が古い → 新セッション+構造化サマリー。同じ基点から複数案を比べる →fork_session。 - 人への引き継ぎは、顧客ID・根本原因・金額・推奨対応を構造化して渡します。会話ログの転送や一言メモは不十分です。
Domain 2:Tool Design & MCP Integration(18%)
- ツールの選び間違いは、まずツール説明を直す。何をするか、いつ使うか(使用例)、入力形式、出力、使わない場面(類似ツールとの境界)の5要素です。最初の一手でツール統合やルーティング層を選びません。
- エラーは
isError: trueに、カテゴリ(一時的・入力・業務・権限)とisRetryableを添えて返します。失敗を空の結果に偽装しません。 - 1エージェントあたり4〜5ツールが目安で、役割外のツールは渡しません。
-
MCP のスコープ:チーム共有は
.mcp.json、個人・実験用は~/.claude.json。秘密情報は${ENV_VAR}で展開し、リポジトリに書きません。 - 組み込みツール:内容の検索は Grep、パスの検索は Glob。Grep で入口を見つけ、Read で import をたどります。最初に全ファイルを読みません。Edit が一意の文字列を見つけられず失敗したら Read+Write。
Domain 3:Claude Code Configuration & Workflows(20%)
-
~/.claude/CLAUDE.mdは自分だけに効きます。「新メンバーに指示が届かない」→ 誰かのユーザーレベルに書かれている、が定番の診断です。 -
.claude/rules/のファイルにpaths(glob)を書くと、一致するファイルを編集するときだけ読み込まれます。テストファイルのように各ディレクトリに散らばった対象に有効です。 - チーム用コマンドは
.claude/commands/、個人用は~/.claude/commands/。skill ではcontext: fork、allowed-tools、argument-hintが問われます。 - 必ず守らせたいことは settings の permissions やフック、ガイダンスは CLAUDE.md。PostToolUse フックなら、ファイル編集のたびにフォーマット・lint・テストを確実に走らせられます。
- 変更範囲が大きい、複数案がある、アーキテクチャ判断や不可逆な変更を含む、関係者のレビューが必要 → plan mode。
- 反復改善:言葉で伝わらないなら入出力例を2〜3個。テストを先に書いて失敗を返す。互いに影響する問題は1つのメッセージでまとめて伝え、独立した問題は1つずつ直します。
- CI では
-pで非対話にし、--output-format jsonと--json-schemaで機械が読める出力にします。レビューは生成とは別のインスタンスで行います。
Domain 4:Prompt Engineering & Structured Output(20%)
- 厳密なスキーマ準拠が必要なら tool use+JSON schema。プロンプトでの形式指定や prefill では、形式が崩れる可能性が残ります。
-
tool_choice:"auto"はテキストだけ返すことがある。"any"は必ずいずれかのツールを呼ぶ(文書タイプ不明で複数スキーマがあるとき)。{"type":"tool","name":"X"}は X を強制(特定の手順を先に実行させるとき)。会話的な返答が下流の処理を壊すなら"auto"は使いません。 - スキーマが保証するのは文法で、意味ではありません。明細の合計と総額の不一致などは、
stated_totalとcalculated_totalを両方抽出して検出します。 - 原文にないかもしれない項目は nullable、enum には
"unclear"や"other"+説明欄を用意し、モデルが値を捏造しないようにします。 - 再試行するときは、原文・失敗した結果・具体的なエラーを一緒に返します。情報が原文にそもそもない場合、再試行は無意味です。
-
Batch API:コスト50%減、最大24時間、遅延保証なし、
custom_idで結果を対応づけ、1リクエスト内で複数ターンのツール呼び出しは不可。開発者が待つマージ前チェックには使わず、夜間レポートや週次監査に使います。 - 「慎重に」「確信があるものだけ」ではなく、報告する・しないの具体的な基準を書きます。few-shot は曖昧なケースに絞って2〜4個。
Domain 5:Context Management & Reliability(15%)
- API はステートレスなので、会話履歴は毎回のリクエストに含めます。
- 金額・日付・注文番号は「case facts」ブロックとして要約の外に置き、毎回送ります。
- lost in the middle 対策として、重要な結論は冒頭に置き、詳細は見出しで区切ります。ツール出力は必要なフィールドだけに絞ります。
- エスカレーション:顧客が人を明示的に求めたら即転送。苛立っているだけなら共感して解決策を示し、再度求められたら転送。ポリシーの空白は転送。感情分析やモデルの自己申告の信頼度は根拠にしません。
- 長い探索は scratchpad ファイル、subagent への切り出し、
/compactで支えます。 - 人手レビュー:全体の精度は内訳の弱さを隠します。文書タイプ別・フィールド別に精度を確かめ、高信頼度の結果も層化抽出で点検し、信頼度はラベル付きの検証セットで校正します。
- 出典は claim と source の対応を保持し、矛盾するデータは両方の値を出典つきで残します。
解答のコツ
迷ったときは「根本原因を直しているか」「問題文の制約をすべて満たしているか」の2点で選択肢を絞りました。練習中に書きためたルールから、効果が大きかったものを10個挙げます。
- 「保証する」「必ず」が出たらコードで強制する。フックや前提条件チェックを選びます。プロンプトや few-shot は遵守の確率を上げるだけです。
- 「最初の一手」は最小で、症状に直結する修正。ツール説明の改善などを選び、ツールの統合・削除やルーティング層の追加といった大きな改修は選びません。
- 問題文の制約をすべて確認する。「コンプライアンスを守りつつ一次解決率も維持」なら、ツールごと削除する案は後半を満たしません。
-
どのコンポーネントの問題かを特定する。subagent が正しく選ばれたのに失敗 → Task prompt に情報が足りない。選び間違い →
descriptionの問題。 - 「速くする」前に「その処理は必要か」を問う。簡単な質問に全 subagent を並列で走らせる案は、不要な呼び出しを速くしているだけです。
-
「情報がない」ことを表現する手段を用意する。nullable、
"unclear"、カバレッジの欠落の明示がないと、モデルは値を作ります。 - 全部渡すより、必要な情報を構造化して渡す。会話ログの転送や記憶の全共有は、たいてい誤答です。
- フックは、コードで判定できる明確なルールにだけ使う。語調や意図の判断など、意味の理解が必要なことはプロンプトに任せます。
- 止めるなら PreToolUse。PostToolUse の時点では操作はもう実行されています。止めたあとは別の手順へ誘導し、能力ごと取り上げません。
- 複数選択は、正解同士で1つの完全な解決策になる。先にアンチパターンを消し、残りが組み合わさるかを見ます。
よく出る引っかけ選択肢
一見よさそうでも、根本原因を外しているか、制約の一部しか満たさない選択肢がこれです。
| 引っかけ選択肢 | なぜ違うか |
|---|---|
| 必ず守るべきルールをプロンプトで強調する/few-shot を足す | 確率的な手段で「保証」しようとしている |
| より強いモデル、より大きいコンテキストウィンドウに替える | 設計の問題を能力で補おうとしている。入ることと注意深く読めることは別 |
| 複数回実行して多数決の結果だけ残す | たまにしか見つからない本物の問題を消してしまう |
| 違反したらセッションを終了する/ツールごと削除する | 要件の半分しか満たさず、正常な処理まで壊す |
| subagent 同士を直接通信させる | coordinator を迂回し、観測性とエラー処理が失われる |
| 会話履歴をまるごと渡す | 情報が多すぎる。必要な項目を構造化して渡す |
| ツール選択ミスにまず few-shot を足す | ツール説明・数・境界という根本原因が残る |
| 失敗時に空の結果を返す | 障害を「データなし」という事実に偽装している |
| 業務ルールのエラーも自動で再試行する | 何度試しても結果は同じ |
文書タイプが不明なのに tool_choice: "auto"
|
テキストだけ返ってくることがある。"any" を使う |
| マージ前チェックを Batch API に移して節約する | 遅延保証がなく、開発者が待てない |
| 原文にないかもしれない項目を必須にする | モデルが値を捏造する。nullable にする |
秘密情報を .mcp.json に直接書く |
リポジトリにコミットされる。${ENV_VAR} を使う |
チーム共有の設定を ~/.claude に置く |
自分にしか効かない。プロジェクトの .claude/ に置く |
| 大規模な変更を直接実行し「問題が出たら plan mode」 | 複雑さは要件にすでに書かれている |
| 感情分析やモデルの自己申告の信頼度でエスカレーションを決める | どちらも問題の複雑さとは無関係で、信頼できない |
| PostToolUse で操作を「阻止」する | タイミングが遅い。すでに実行済み |
これから受ける方へ:おすすめの学習プラン
すべての Task Statement を、少なくとも数問は問題の形で解いてから本番に臨んでください。私の失点はほぼ全部、そこを省いた分野から出ています。
- 公式 Exam Guide と公式サンプル問題12問を最初に読む。Task Statement を一覧表にして、進み具合を管理します。
- 要点まとめだけで終わらせない。各 Task Statement で2〜3問は解きます。特に Domain 4(構造化出力・Batch API)と Domain 2 の後半(MCP 統合・組み込みツール)は、まとめるだけで済ませがちです。
- 単項練習のあとにシナリオ形式で解く。出題範囲を伏せた8問セットで、目標は 7/8 以上です。
- 間違えたら1行のルールにする。「なぜその選択肢を選んだか」と「次に使うルール」を書くと、同じ型の問題で迷わなくなります。
- 直前はサンプル問題と引っかけ一覧を見直す。可能なら60問・4シナリオの通し模試を1回解きます。
ネットの練習問題について:私が解いたのは、GitHub の paullarionov/claude-certified-architect にある練習問題です。日本語の学習ガイド、練習テスト、Anki デッキもそろっています。出題スタイルに慣れるには役立ちますが、問題と答えを丸暗記するのはおすすめしません。私は本番で、見たことのある問題に一度も出会いませんでした。1問ごとに「なぜこの選択肢が正解で、ほかが違うのか」を説明できるようにしておく方が、初見の問題に対応できます。
用語の注意:Exam Guide では subagent を起動するツールを「Task tool」と呼びます。最新の SDK では Agent に改名されていますが、試験では Task で考えます。prompt caching の実装詳細、streaming、レート制限、OAuth、computer use、画像理解、トークン計算、ファインチューニングは出題範囲外です。
この記事が、これから受ける方の役に立てばうれしいです。
著者について
AI 動画エージェント Vividemo の開発者です。Vividemo は、テキスト・画像・製品 URL・手持ちの映像から、製品デモや解説動画、マーケティング動画を作るサービスです。リサーチ、構成、台本、絵コンテ、素材の各段階でユーザーの承認を待ちながら進みます。
この試験で学んだエージェントループ、フックによる制御、人の承認を挟む設計は、まさに日々の開発で向き合っているテーマでした。