
はじめに
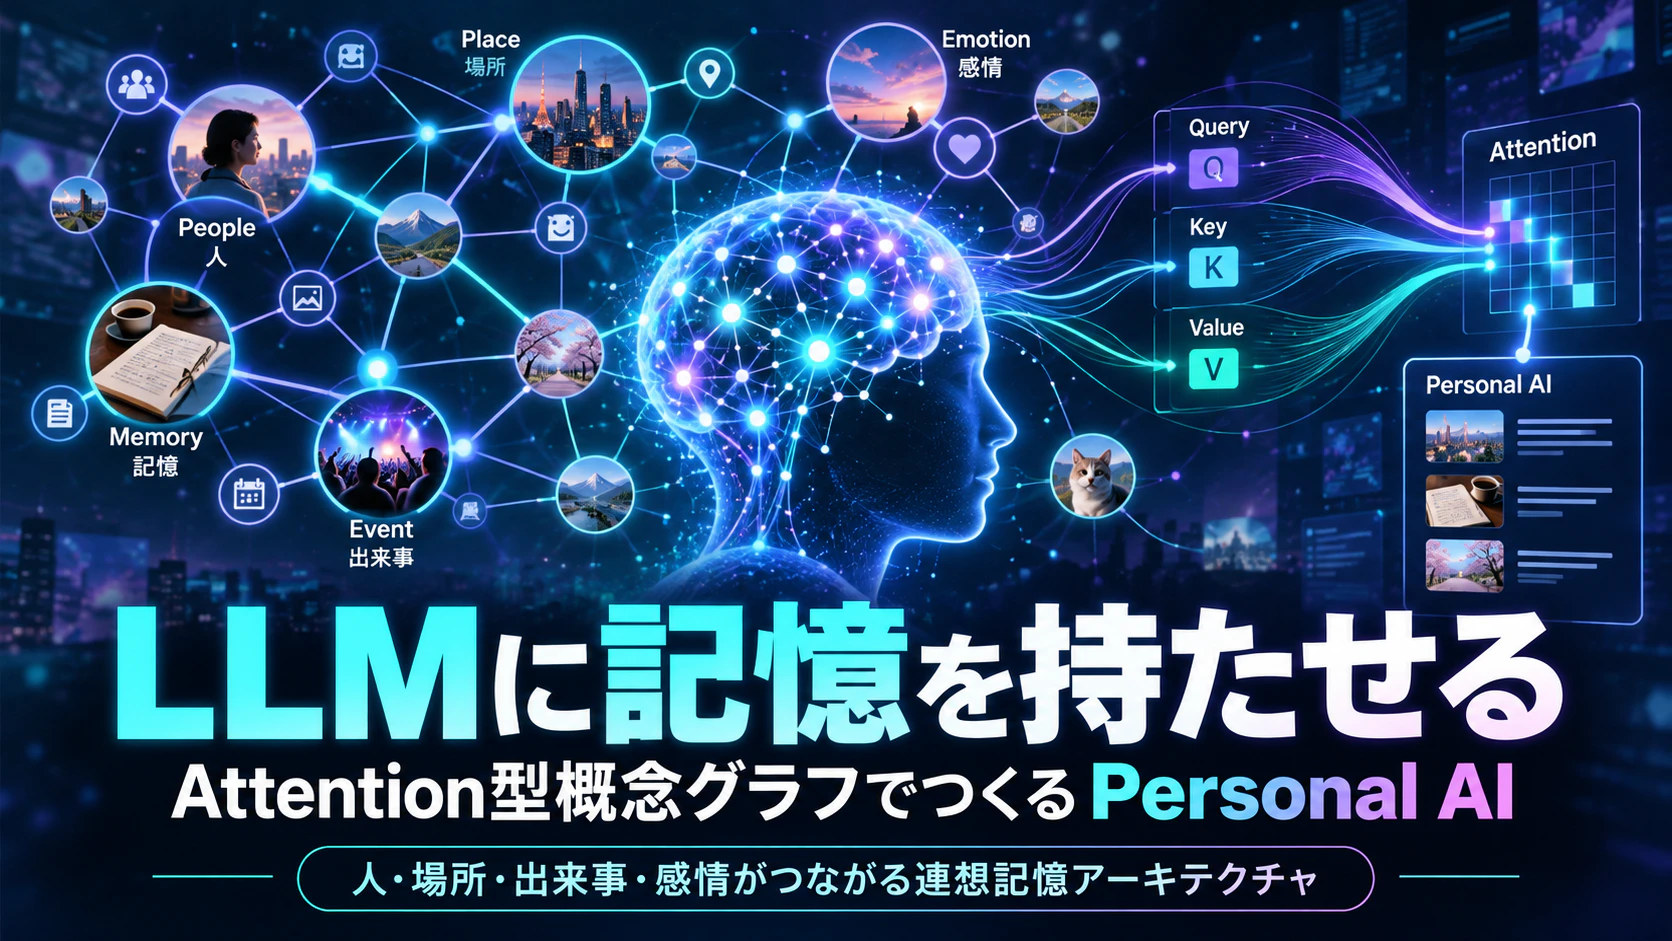
前回までに、個人の記憶を概念IDで管理する方法を考えた。
例えば、
ID1:登山
ID2:食事
ID3:満腹感
ID4:気分転換
といった具合だ。
しかし、ここで一つ重要なことに気づいた。
人間が思い出すのは、概念そのものではなく、概念に結び付いた経験ではないだろうか。
「登山」という言葉を知っていることと、誰かと一緒に山に登った日のことを覚えていることは違う。
雨が降っていたこと。
途中で予定を変更したこと。
下山するころには暗くなっていたこと。
そんな経験が、その人にとっての記憶になる。
今回は、概念IDと経験IDを分離し、Personal AIの記憶モデルを作り直す。
1. 概念は検索の入口にすぎない
例えば、次のような日記を保存したとする。
10月20日、丹沢山に登った。途中から雨になり、下山時には暗くなっていた。同行者とライトを使って下山した。
従来のRAGでは、この日記を文章として分割し、Embeddingして検索する方法が一般的だ。
しかし、今回の設計では、まず日記に関係する概念を抽出する。
ID1:登山
ID5:丹沢山
ID6:雨
ID7:同行者
ID8:暗闇
そして、元の日記には別のIDを付ける。
E101:10月20日の丹沢登山
つまり、
概念ID → 経験ID → 日記本文
という構造になる。
これなら「登山」という概念から複数の日記を検索できる。
一方、「雨」や「同行者」という別の概念からも、同じ日記へアクセスできる。
概念は記憶を探すための索引であり、経験が記憶の実体になる。
2. Personal AIに必要なのは個人的な結合
ここでもう一つ重要なのが、個人固有の関連性である。
例えば、
気分転換 → 登山
という関係は、一般的なLLMでも推論できる。
しかし、
気分転換
    ↓
登山
    ↓
六甲山
    ↓
いつもの友人
    ↓
過去の登山日記
という関連性は、その人の経験を記憶していなければ再現できない。
ここにPersonal AIの意味がある。
一般的な概念の関連性だけなら、LLM自身がすでに大量の知識を持っている。
外部記憶に保存したいのは、一般知識ではなく、その人だけが持つ経験や関係性だ。
3. 結合重みは何のためにあるのか
例えば「気分転換」という概念に、次のような記憶が関連しているとする。
| 関連する概念 | 結合重み |
|---|---|
| 登山 | 0.9 |
| 温泉 | 0.7 |
| 音楽 | 0.3 |
| 食事 | 0.2 |
この数値は説明用の仮値だ。
ここでの重みは、何が正しいかを判断するためのCriteriaではない。
過去の経験によって、その人の中でどの概念が強く結び付いているかを表す値である。
例えば、気分転換として登山を繰り返していれば、登山との結合が強まるかもしれない。
すると、次に「気分転換したい」と発言したとき、登山に関する記憶が優先的に検索される。
ただし、重みが最大だからといって、必ずその選択肢を提案するわけではない。
その日の天候や時間、体調などは、現在の会話に基づいてLLMが判断する。
つまり、
結合重みは記憶を呼び出す優先度であり、意思決定そのものではない。
4. データモデルを最小限にする
今回のモデルでは、まず3つの情報を管理する。
Concepts:概念
ID1:登山
ID2:食事
ID3:満腹感
ID4:気分転換
ID5:丹沢山
Experiences:経験
E101:丹沢登山の日記
E102:六甲山での登山
E103:友人と食事した記録
Links:関連性と重み
ID4 ─0.9─ ID1
ID1 ─0.8─ ID5

ID1 ─ E101
ID5 ─ E101

ID1 ─ E102
ID2 ─ E103
概念と概念の結合、概念と経験の結合を保持する。
これだけで、個人の連想記憶を表現するための基本構造ができる。
すべてを複雑なグラフDBで実装する必要はない。
5. 最初はSQLiteでよい
概念が数百から数千程度なら、最初から専用のベクトルDBを導入する必要があるとは限らない。
まずはSQLiteで実装する。
例えば、以下のようなテーブル構造である。
CREATE TABLE concepts (
    id INTEGER PRIMARY KEY,
    name TEXT NOT NULL UNIQUE
);

CREATE TABLE experiences (
    id INTEGER PRIMARY KEY,
    title TEXT,
    content TEXT,
    created_at TEXT
);

CREATE TABLE concept_links (
    source_id INTEGER NOT NULL,
    target_id INTEGER NOT NULL,
    weight REAL NOT NULL,
    PRIMARY KEY (source_id, target_id)
);

CREATE TABLE experience_links (
    concept_id INTEGER NOT NULL,
    experience_id INTEGER NOT NULL,
    weight REAL DEFAULT 1.0,
    PRIMARY KEY (concept_id, experience_id)
);
今回の最小モデルでは、概念間の結合を無向として扱い、source_idとtarget_idを小さいIDから順に保存する。
人物や場所の同一性を判定したり、経験の日付を管理したりする機能は、必要に応じて拡張すればよい。
ここで重要なのは、概念の数と経験の数を分離できたことだ。
登山日記が100件増えても、「登山」という概念を100個作る必要はない。
6. 記憶はどう成長するのか
新しい日記が追加されたときの処理は単純だ。
新しい日記
    ↓
LLMが概念を抽出
    ↓
既存の概念IDと照合
    ↓
必要なら概念を追加
    ↓
経験IDを発行
    ↓
経験と概念を結合
    ↓
概念間の結合重みを更新
例えば、新しい登山日記が登録されたとする。
その経験に「登山」「気分転換」という関連が確認できれば、両者の結合を強化する候補になる。
一方、文章中に単に同時に登場しただけなら、強い関連があるとは限らない。
その違いはLLMによって推論する。
ただし、AIが推測した関連性を本人が明言した事実と同等には扱わない。
元の日記を残しておけば、後から結合を見直すこともできる。
7. 概念は増やしすぎない
ここで問題になるのが、概念IDの増殖である。
例えば、
食事
ご飯
食べること
という言葉が出てきた場合、それぞれ別のIDが必要だろうか。
同じ意味で使用されているなら、一つの概念IDに統合できる。
一方、
食事
満腹感
は関連しているが、意味は違う。
こちらは別の概念として保持する。
つまり、LLMには概念の新規登録だけでなく、既存概念との照合も担当させる。
概念の同一性と関連性を混同しないことが重要になる。
8. ベクトル検索は本当に必要なのか
最初の構想では、概念IDをベクトル空間で扱うことを考えていた。
しかし、概念IDが200個や500個程度なら、別の方法も考えられる。
例えば、概念一覧をLLMへ渡し、
「現在の会話に関連する概念IDを3件選択してください」
と指示するだけでも実装可能だ。
この場合、専用のEmbeddingモデルもベクトルDBも必要ない。
もちろん、概念が増えればトークン数や応答時間の問題が発生する。
また、概念一覧だけで意味を正確に識別できるとは限らない。
しかし、最初から大規模な検索基盤を構築する必要はない。
まずはSQLiteとLLMだけで検証する。
性能上の問題が明らかになった段階で、Embedding検索やグラフ探索を追加すればよい。
9. 本当のポイントは二段階検索
今回の設計を一つの流れにすると、次のようになる。
ユーザーの発言
       ↓
LLMが注目概念を推論
       ↓
概念IDを検索
       ↓
関連する概念IDを取得
       ↓
経験IDを検索
       ↓
日記・会話・出来事を取得
       ↓
LLMが回答を生成
一般的なRAGでは、質問から直接文章を検索する。
今回の方式では、その間に概念層を挟む。
従来のRAG

質問 → 文章検索 → 回答
今回の方式

質問 → 概念検索 → 経験検索 → 回答
違いは、日記を直接検索しないことだ。
概念を経由することで、同じ経験をさまざまな観点から探せるようになる。
さらに、概念間の結合重みを更新していけば、一般的な意味の近さだけではなく、個人固有の経験に基づく検索が可能になる。
10. まとめ
今回、記憶のデータモデルを整理し直した。
記憶の中心は概念IDではない。
概念IDは検索の入口であり、その先に経験IDが存在する。
また、Attentionだけで記憶が成長するわけではない。
個人の経験によって概念同士の結合が変化し、その重みを次回の検索に利用することが重要になる。
そして、概念数が少ない段階では、必ずしもベクトルDBやGraphRAGは必要ない。
SQLiteとLLMだけでも、基本的な構造を実装できる。
今回の設計を一文でまとめるなら、
「個人の経験を概念へ整理し、概念間の結合を育て、その概念から経験へ戻る記憶システム」
である。
これなら、仕組みそのものはそれほど複雑ではない。
次回は、実際に自然言語から概念IDを選択し、関連する経験を取得する部分をPythonで実装する。
次回:第4部「なぜ概念層を挟むのか ― 二段階検索の実装」
概念IDを利用した記憶検索を、SQLiteとLLMで実際に動かしてみる。
EmbeddingやベクトルDBを使わずに、どこまで個人の経験を検索できるか検証する。
タグ: LLM / RAG / Python / SQLite / PersonalAI