

これまでの記事
2025アドベントカレンダーで、情報幾何学に関する連載をしています。
今回が第4回目の記事になります。
はじめに
情報幾何学的なアプローチで言語モデルを扱った時流に乗った論文の一つとして、今年初めに ACL 2025 Outstanding Papers に採択された、京都大学と理化学研究所の研究チームによる論文を紹介します。この研究は、言語モデルを 対数尤度 を用いてパラメトライズし、モデルのクラスタリングやパラメータ空間を幾何学的に解釈する手法を提案しています。
TL;DR
-
提案手法:
1,000以上の言語モデルを、共通のテキストセットに対する「対数尤度ベクトル」を用いて特徴付け、分類・可視化する新しい手法 -
理論的背景:
対数尤度ベクトル(を二重中心化したもの: q座標系)は、実は Euclid距離の2乗がモデル間のKLダイバージェンスに近似的に等しいことが示される。つまり、q座標系が確率分布の類似度を幾何学的に解釈できる座標系になっている -
結果:
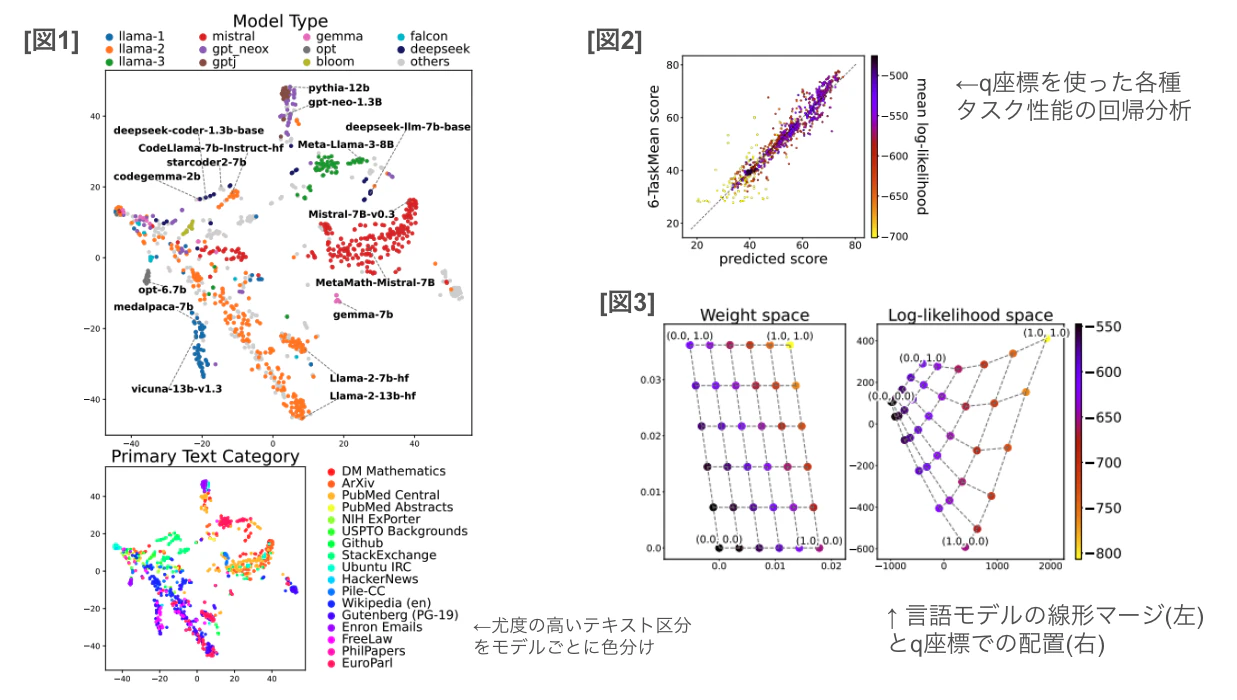
モデルファミリーが解釈可能な形でクラスタリングされた[図1]。q座標は、モデルのタスク性能を説明できるほどのモデルの情報を含み、未知のタスクの性能予測などにも利用できる[図2]。また、モデルの重みを線形に加重マージさせた時のq座標系での"歪み"を可視化[図3]。新しい言語モデルの性質を幾何学的に予測することなどの応用に期待される
言語モデルの"座標"としての対数尤度ベクトル
言語モデルとは、突き詰めて言えば、先行するトークン列 $ y_0, y_1, \cdots, y_{t-1}$ を条件として、次のトークン$y_t$を予測する条件付き確率
\mathbb{P}[y_t| y_0, y_1,\cdots, y_{t-1}]
を、大規模な重みパラメータを持つモデルで再現したものです。つまり、ありとあらゆるトークン列 $y_0,y_1,\cdots, y_t$についての上記の条件付き確率が、言語モデルの特徴のすべてを表します。別の表現をすると、トークン列としてのテキスト$x=(y_0,y_1,\cdots,y_t)$を言語モデルが生成する確率、
p(x) = \prod_{i=1}^t \mathbb{P}[y_i | y_0,y_1,\cdots,y_{i-1}]
つまり テキスト$x$の尤度 が、すべてのテキスト$x$について分かれば、言語モデルの特徴がすべて表されることになります。
前回の記事で離散分布に対する情報幾何を議論したときに、分布の分離度(divergence)の存在を出発点に分布を座標づけようとすれば、事象$i$の確率$p_i$やその対数$\ln p_i$が座標として自然と導入されました。言語モデルについても、重みパラメータのような人為的なものではなく、テキスト尤度を使った座標づけが本質的だというのはとても自然です。
特徴ベクトルとq座標の構成
論文では、10,000テキストを多種多様なテキスト区分から抽出して、対数尤度ベクトル $l = ( \ln p(x _i)) _{i=1}^{10,000} $ を、1000以上の言語モデルについて求めています。
実用的な面では、テキスト尤度そのものを利用するアイデアは計算量的にも優れており、従来の「生成されたテキストの類似度を測る」という分類アプローチよりも、生成の計算コストが抑えられる利点があります。
この10,000次元の対数尤度ベクトルを 1000モデル分並べ、前処理として行方向と列方向を平均周りに中心化の処理を行った座標系$q$を、モデル座標として扱います。
$q$座標系の理論的な意義は、論文で述べられている次の近似式がよく示しています。
2D_{\mathrm KL}(p_i, p_j) \simeq \frac 1N \|q_i - q_j\|^2
$i, j$は言語モデルのラベルであり、$p_i, p_j$ は各言語モデルの確率分布、$q_i, q_j$は各言語モデルの$q$座標です。上の式から、2つの言語モデルの分離度は、$q$座標系では、Euclid距離の2乗として幾何学的に解釈できるということが従います。
クラスタリングと座標空間での可視化
$q$座標を用いた、t-SNEにより2次元に圧縮したクラスタリングの結果が[図1]で、眺めてみると妥当な結果が得られているように見えて面白いです。例えば
- 同じベースモデルから派生したモデル(llama, mistral, gemma系列)は、自然と近くに集まり、明確なクラスタになっている
- Code系モデル (deepseek-coder, codellama, codegennma系列など) のようなコーディングに特化したモデル群が、自然言語系のモデルとは離れて密集している
- モデルごとに、テキスト尤度が高い傾向のあるテキストドメイン(数学、arXiv論文、医療系、など)で、クラスターが固まっている
といったことが図から発見できます。
言語モデルの2次元マッピングという、わかりやすく解釈可能なアウトプットを、実用的な計算コストで得られるというだけでも有意義だと思います。
モデルの重みと q座標系の関係
この論文では、さらに踏み込んで$q$座標系が、言語モデルの重み空間とどのような幾何学的関係にあるのかも考察しています。
アイデアは非常にシンプルで、同じパラメータ構造をもつ3つのモデル(ベースモデル$W_0$と、そこから派生した2つのモデル$W_1, W_2$)を用意し、その重みを線形に混ぜ合わせる
W(\alpha, \beta) = W_0 + \alpha (W_1 - W_0) + \beta (W_2 - W_0)
ことで、新しいモデル作成し、加重パラメータ$\alpha, \beta$ を変化させた時に $q$座標系でどのような軌跡を描くかを見ています。
[図3]は$\alpha,\beta=0, 0.2, \cdots, 1.0$ に対して加重されたモデルに対する結果であり、
- 重みの空間では、モデルは当然ながら格子状に整然と並ぶ(線形結合で作っているため)
- $q$座標に変換してプロットすると、格子構造は維持されつつ、全体が歪んだ形状となる
ことがわかります。
$q$座標系ではEuclid距離の2乗が、KLダイバージェンスを近似することが示されましたが、つまり、$q$座標系で見ている距離感は、モデルの出力分布そのものの「情報量的な距離」を表しています。重みパラメータは分布の距離と直結する自然パラメータではないので、仮にそれを線形に変化させても、確率分布としての変化は線形でなく曲がった軌跡を描くわけです。
[図3]の歪みは、ニューラルネットワークのパラメータ空間(重み)と、それによって表現される確率分布の空間(統計的多様体)の構造の違いを反映する好例になっていると言えるわけです。
まとめ
情報幾何学的なアプローチで、最も注目されている言語モデルに新しい味方を提供された論文 Mapping 1,000+ Language Models via the Log Likelihood-Vector をちょっと詳しく読みました。
原論文は、自然な発想で描かれているので言語モデルの専門家でなくても十分読めますし、Appendixも丁寧に描かれていて勉強になります。ぜひ興味がある方はご一読なさってみてください。