
この記事は AIHubMix が作成しました。数値は Artificial Analysis の 2026年11月11日スナップショットで、AIHubMix 上のライブ検証は実施していません。
TL;DR
- Gemini 4 Carbon は Argon をベースに、1ターンあたりの思考トークンを増やしたモデルです。
- Carbon High は AA 指数 60.03(104モデル中4位)、1タスク 7.76ドル、25.6分でした。Argon High は 50.41、9.95ドル、29.0分です。
- 最初の回答トークンは Carbon が67.1秒、Argon が40.1秒。待ち時間の短い対話には Argon、キューやベンダー側バックグラウンドのエージェントには Carbon が向きます。ただし、そのネイティブ経路は AIHubMix では未確認です。
Argon から変わる点
Carbon のモデル ID は gemini-4-carbon です。Google が文書化するコンテキストは1,048,576トークン、思考レベルは low / medium / high(既定は medium)、標準出力上限は65,536トークンです。Google のネイティブ長文デコードは入力を除いて最大1,048,576トークンまで対応しますが、AIHubMix が Carbon について文書化しているのは Chat Completions だけです。ゲートウェイでは65,536以下にしてください。Google は Argon からの移行でリクエストスキーマを変更する必要はないと説明しています。
測定値
Carbon は、1タスクの料金を下げながら AA 指数を上げられるのでしょうか。4つの構成を料金と品質の2軸で比べます。
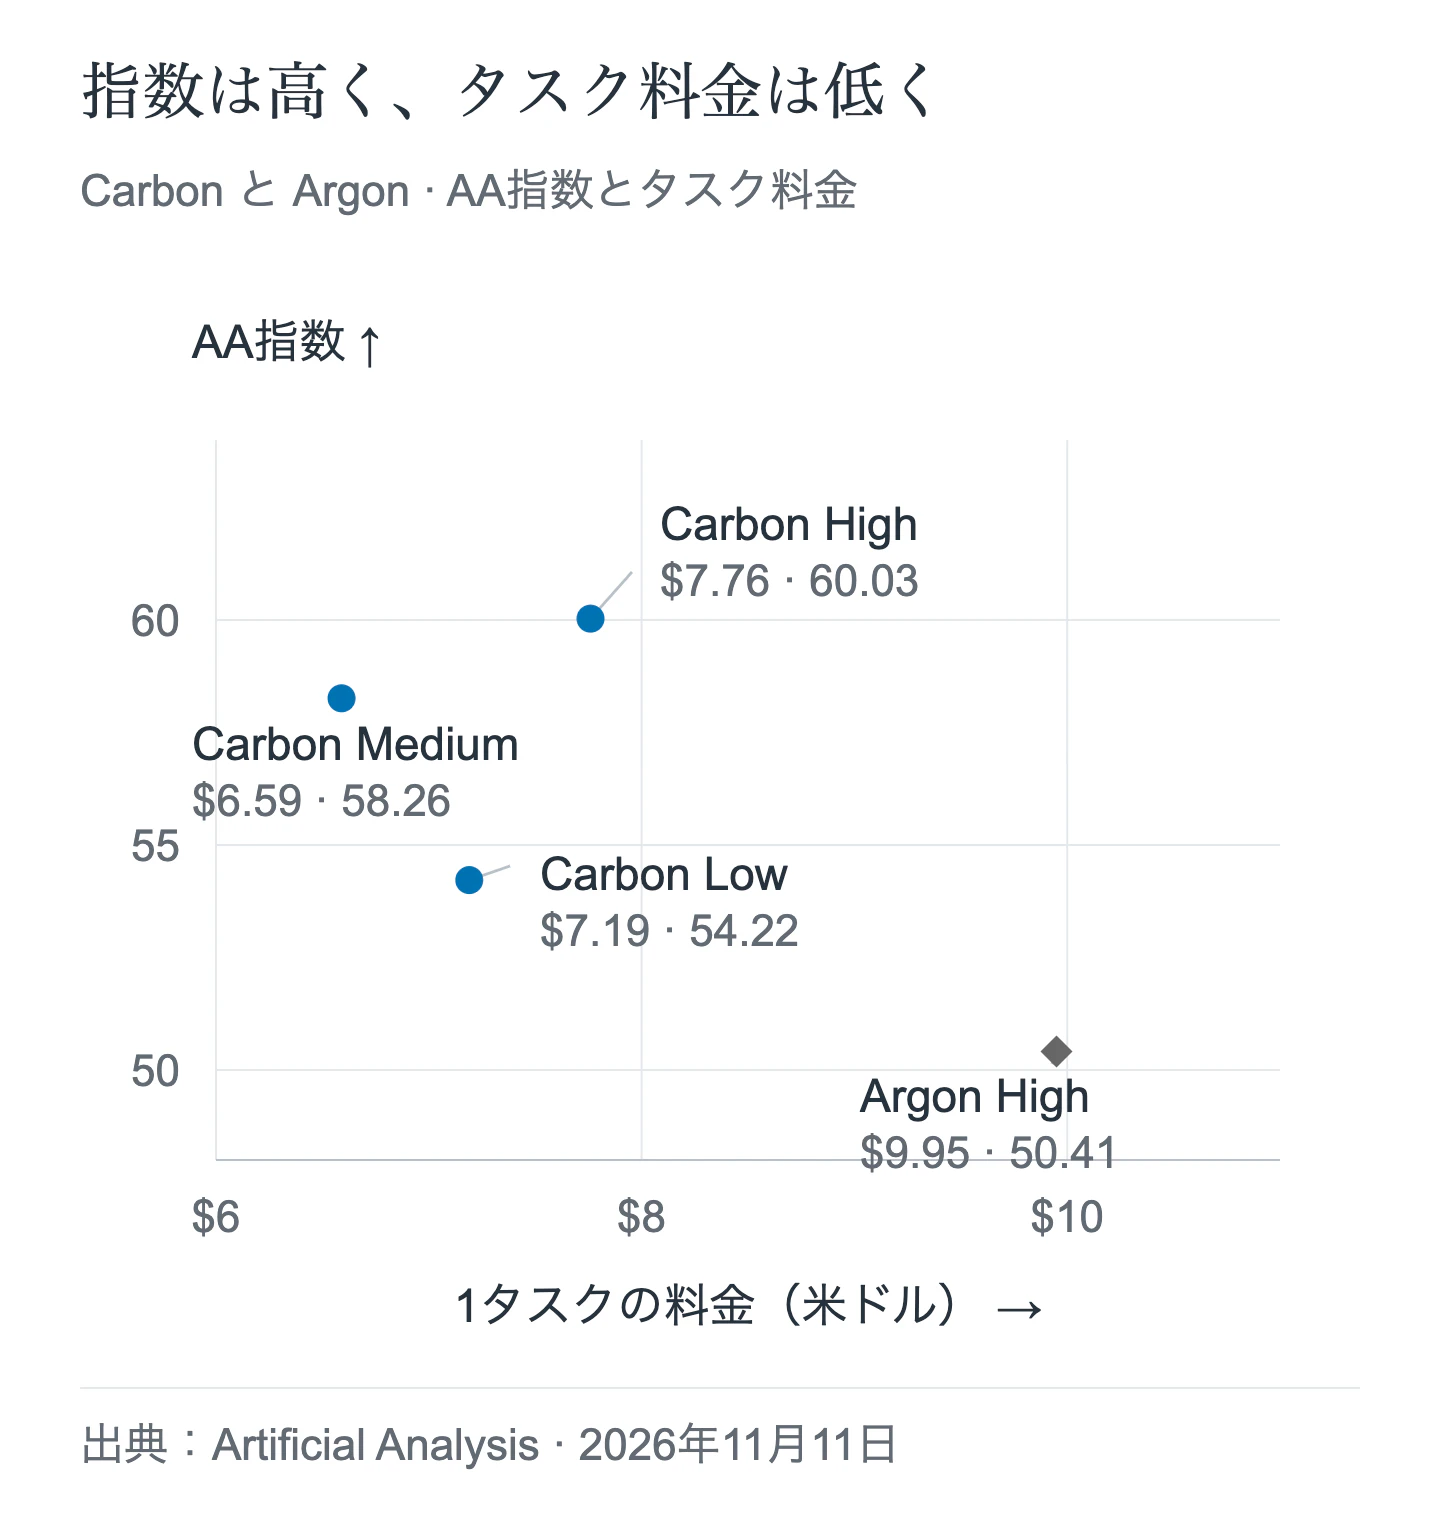
AA 指数と1タスクあたりの料金(米ドル)の比較です。出典:Artificial Analysis、2026年11月11日。料金は入力4ドル・出力20ドル/100万トークンの標準価格で計算され、正確な値は次の表に記載しています。
Carbon High は Argon High より左上にあり、料金が低く AA 指数が高い結果です。この測定で最も安い Carbon の設定は Medium でした。Low は最安料金ではなく、最初の回答までの待ち時間を短くする選択肢です。これは AA のタスク料金であり、AIHubMix のリクエスト請求額ではありません。
| モデル | AA指数 | 1タスクの料金 | 1タスクの分数 | 最初のトークン |
|---|---|---|---|---|
| Carbon High | 60.03 | 7.76ドル | 25.6 | 67.1秒 |
| Carbon Medium | 58.26 | 6.59ドル | 23.3 | 23.2秒 |
| Carbon Low | 54.22 | 7.19ドル | 22.6 | 12.9秒 |
| Argon High | 50.41 | 9.95ドル | 29.0 | 40.1秒 |
Carbon Low は Medium より1タスク料金が高かったため、割引設定とは考えないでください。Coding Agent Index v2 でも Carbon High は4位、Argon High は11位でした。
価格と選び方
Google の導入価格は11月30日まで入力2ドル/100万トークン、出力10ドルです。12月1日から4ドル/20ドルになります。AIHubMix は現在 Carbon をこの導入価格で掲載しています。
Carbon はバッチ処理や品質重視のエージェント向けですが、ネイティブの背景実行は AIHubMix では未確認です。対話や補完など、画面の前で短時間の返答が必要な場合は Argon を検討してください。
AIHubMix での呼び出し
AIHubMix が Carbon について文書化しているのは、テキスト入力の Chat Completions です。Responses、Anthropic Messages、ネイティブ Gemini 入力、画像/PDF 入力、reasoning_effort のマッピング、ネイティブの長文デコードとツール動作は未確認です。max_tokens は65,536以下にします。
import os
from openai import OpenAI

client = OpenAI(base_url="https://aihubmix.com/v1", api_key=os.environ["AIHUBMIX_API_KEY"])
response = client.chat.completions.create(
    model="gemini-4-carbon",
    messages=[{"role": "user", "content": "Summarise this incident report and list follow-ups."}],
    max_tokens=16384,
)
print(response.choices[0].message.content)
まとめ
- タスク完了の品質と料金を優先するなら Carbon。
- 最初の返答を速くするなら Argon。
- 実際の20〜50件を両方で測り、最初のトークン時間とタスク料金でルーティングを決めます。
あわせて読みたい:Gemini 4 Carbon シリーズ
参考
- Gemini 4 Carbon model card(Google DeepMind)
- Gemini 4 Carbon: what's new(Google AI Studio)
- Gemini 4 Carbon(Artificial Analysis)