
この記事で分かること
- WindowsでPortable Computerを起動し、Qwen3.8 27Bベースのモデルを動かしてみた顛末
- MCP接続を巡ってローカルモデルが見せた、思いがけない粘り強さ
- 本命だったコーディング用途で、実際に何が起きたか
- ローカルとフロンティアモデル、結局どう使い分けるのが得なのか
きっかけ
9/17のニュースで「Perplexity『Portable Computer』がWindows+RTXへ」という見出しを見かけた。
ざっくり言うと、Perplexityのローカルエージェント「Portable Computer」がついにWindows版に対応し、ローカルモデルとしてQwen系の27Bモデルをワンクリックで導入できるようになった、という話だ。しかも、ローカルモデルには荷が重いタスクは、フロンティアモデルへエスカレーションできる機能まで用意されているという。
実はローカルLLMにHarnessを組まなきゃな……と前々から思っていた。以前、自作のフロンティアモデルベースのAgent Harnessシステムにローカルモデルを載せてみたことがあるのだが、見事にコケてしまい、そのまま放置していた。その後は別件でなかなか時間が取れずにいたので、Portable Computerは再挑戦にちょうどいい機会だと思い、試してみることにした。
Perplexityって何者で、Portable Computerとは何なのか
まずはPerplexityとPortable Computerについて簡単に説明を。
Perplexityとは、Googleさん曰く「リアルタイムのウェブ検索と生成AIを組み合わせた対話型の次世代AI検索エンジン」だ。「Perplexity(困惑)」という社名と相まって、初見だと何をする会社か掴みにくいかもしれない。ただロゴだけは一度見たら忘れないと思う。某カーテンメーカーにそっくりなので(w)。
その Perplexity リリースしたのが「Portable Computer」というローカルエージェント製品だ。名前だけ見ると可搬型のPCそのものを想像しそうになるが、実態は違う。対応するNVIDIA RTX GPU(VRAM 24GB以上)を積んだ自分のPCの中に、ローカルモデルだけでなく、オーケストレーター、プランナー、ツールルーター、スケジューラー、永続タスクキュー、ローカル検索インデックスまで丸ごと持ち込んで動かす、という意味での「Portable」らしい。つまり「持ち運べるコンピュータ」ではなく、「手元のPCそのものを、指示を出せば勝手に働く一つの計算機に仕立てる」というニュアンスの名前だと理解している。Perplexity公式:Portable Computer
利用にはPerplexity ProまたはMaxの契約が必要。Portable Computer自体に追加料金はない。契約するとそれぞれにComputer Creditという、いわゆるトークンが付与される。このトークンはPortable Computer内でフロンティアモデルを使用する時に利用される。なお、ローカルで完結した処理はComputer Creditsを消費しない。
欲しかったのはモデルではなくAgent Harness
ローカルLLMを動かすだけなら今はそう難しくない。VRAMを積んだGPUと推論ランタイムがあれば、モデル自体はわりとあっさり動く。
だが、モデルが起動することと、仕事を任せられることは別の話だ。依頼を分解し、道具を選び、失敗したら原因を切り分け、経過を保持しながら作業を続ける――この「現場監督」の役割が無いと、優秀なだけの作業員を現場に放り込んだところで仕事は前に進まない。この現場監督にあたる仕組みを、本記事ではAgent Harness(モデルに計画・ツール利用・再試行・権限制御などを与える実行基盤)と呼ぶ。
Perplexityに期待したのは、まさにこのAgent Harnessの部分だった。普段は手元のGPUで処理し、ローカルモデルで手に負えないときだけフロンティアモデルにエスカレーションできるなら、コストと機密性を両立できる。渡りに船、というやつだ。
実験その1:使い慣れたMCPを繋がせてみる
試したのは、MCP(Model Context Protocol)――AI Agentが外部のデータやツールを共通形式で利用するための規格――を使った接続だった。USB端子に対応機器を挿すように、異なるAIクライアントから同じRAGや業務ツールを呼び出せる点に価値がある。
依頼したことはシンプルだった。「既存のMCPサーバーへ接続して、使えるツールと取得できる情報を確認してほしい」。接続情報には、普段Claude Codeで使っているJSON設定をそのまま渡した。接続先は自分で運用している実際のRAGシステムだ(APIキーやコレクション名はここには書かない)。
単純な接続確認だから、数分から十数分もあれば終わるだろうと高を括っていた。
ところが、画面はなかなか「接続できました」と言ってくれない。それどころか、フロンティアモデルへ切り替わる気配もなく、ローカルモデルがひたすら一人で粘り続けている。
あれ、これ固まってる……?
不安になりながら画面を眺めていると、ログには次のような作業が順番に流れていた。
接続先への到達性を確認 → HTTPレスポンスを確認 → 設定ファイルを探索 → MCPのセッション情報を確認 → 複数のエンドポイントを試行 → 認証ヘッダーの形式を変更 → サーバー側のAPIキー不一致を疑う
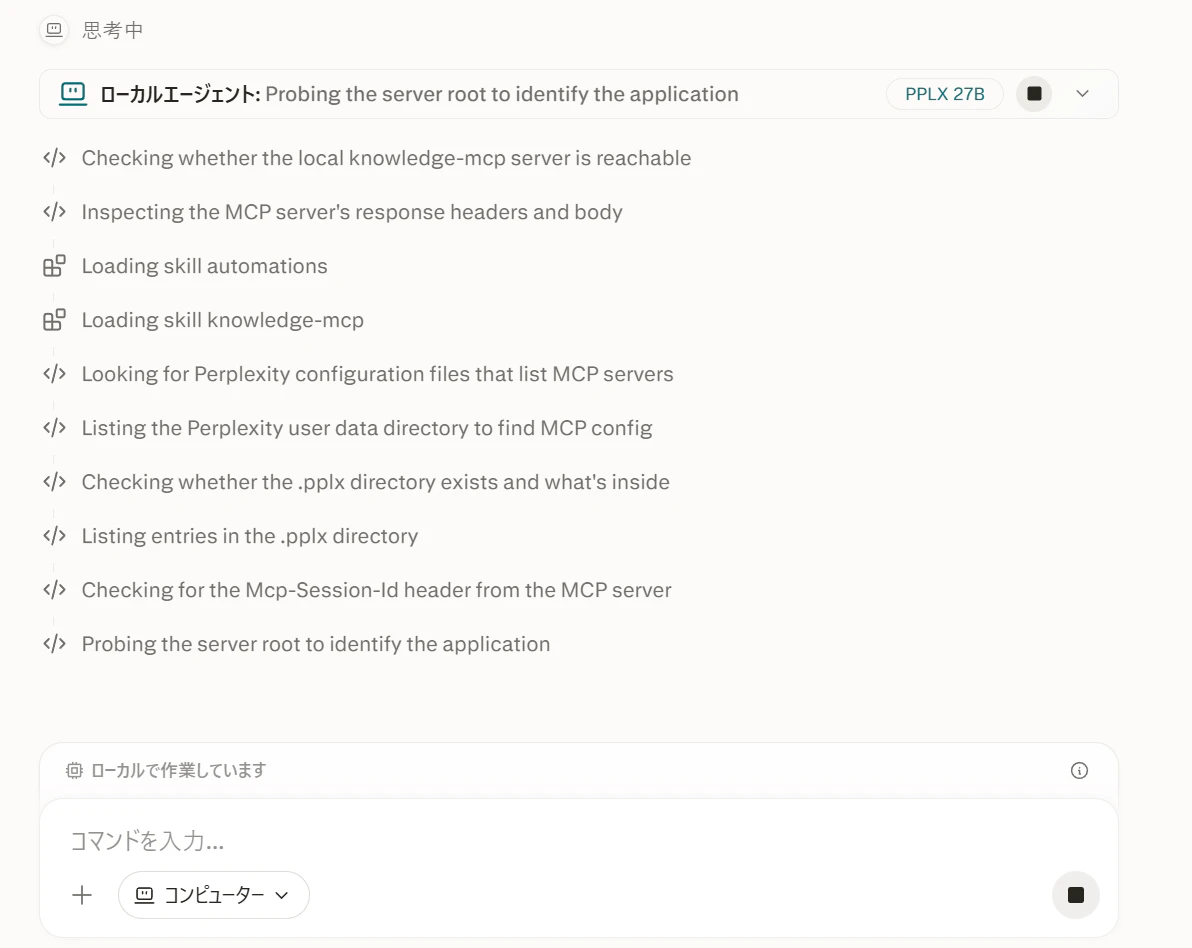
眺めていて分かったのは、同じ失敗を闇雲に繰り返しているのではない、ということだった。/health は200 OKを返すのに /mcp/ 以下だけが一貫して401 Unauthorizedを返す――この差分から、ネットワーク障害やサーバー停止ではなく認証まわりの問題だと絞り込んでいる。
| 確認対象 | 結果 | 判断 |
|---|---|---|
| GET /health | 200 | サーバーとDBは稼働中 |
| GET・POST /mcp/ | 401 | MCP側の認証で拒否 |
| Bearer認証/ヘッダー変更 | 401 | 認証方式かキーが不一致 |
最終的にPortable Computerが出した結論は、「クライアントに渡されたキーと、サーバープロセスが読み込んでいるキーが一致していない可能性が高い」というものだった。
ここまでの所要時間、約2時間8分。
正直、対話しながら使う道具としては失格の速度だ。同じ調査をフロンティアモデルに投げれば、体感では数分で片づくだろう。ただし同一条件で計測した比較ではないので、正確に何倍と言えるものではない。言えるのは「体感で一桁倍以上は遅かった」ということだけだ。
それでも、この2時間を「無駄に待たされた」とだけ片づける気にはなれなかった。ログを目で追う限り、迷走していたわけではないからだ。到達性→HTTPレスポンス→設定→認証、と順序立てて仮説を変えていた。推論能力が足りずに堂々巡りしていたわけではない。
問題は 「解けない」ことではなく「諦めない」こと だった。2時間強、ずっとローカルだけで粘っていた。
――ここで、冒頭の話を思い出してほしい。「荷が重いと判断したらフロンティアへ」というエスカレーション機能が備わっているという話。実はエスカレーションは自動切り替えではなかったのだ。手元の情報をフロンティアモデルへ渡す前に、必ずユーザーの承認を求める設計だ。つまり今回2時間もローカルで粘っていたのは不具合ではなく、こちらが一度も「フロンティアに聞いていいよ」と言っていないのだから当然の挙動だった。仕様どおりに動いていただけなのだ。
とはいえ、仕事で使う側からすると「何分粘ったら一度聞きに来てほしい」という実行時間の目安は欲しくなる。今の粘り方は、隣で待つ人間には少々長すぎる。
正しいAPIキーを渡すと、接続はあっさり成功した。そこからMCPのツールを一通り呼んで、検索・一覧取得・ヘルスチェックなどの結果をまとめるまでに、さらに約25分。無事に接続作業は完了した。
利用したローカルモデルについて
セットアップ時にPortable Computerが新規にダウンロードしていたのは、PPLX 27B(17.7GB)、Qwen 27B(19.9GB)、llama.cppの3つだった。
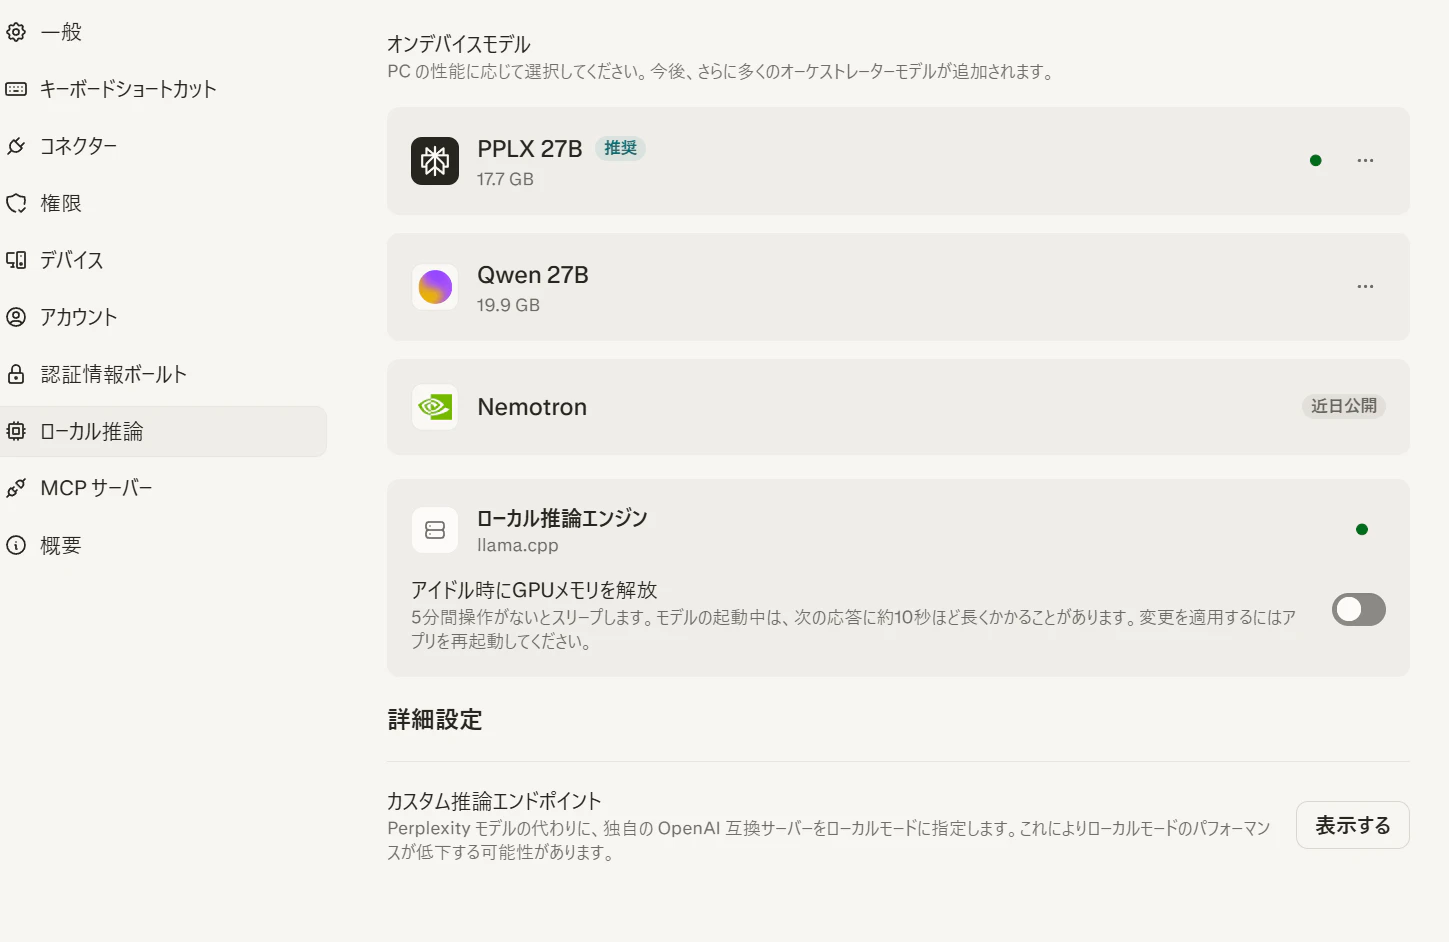
Hugging FaceにあるモデルではなくPortable Computer専用のモデルをダウンロードしていた。
正直、この3つをダウンロードしたので、最初は「PPLX 27BはQwen 27Bとllama.cppをつなぐアダプタか何かだろう」と考えていた。「Qwen 27B」というモデルをダウンロードしていることから、「PPLX 27B」はいかにも橋渡し役っぽいと感じたので。
――しかしこれは外れだった。
公式情報を確認して理解した。正体はこうだ。
- PPLX 27Bは、Qwen 3.8 27BをPerplexityがpost-train(追加学習)したモデル本体そのもの。アダプタ層ではない。
- llama.cppはモデルではなく推論ランタイム。GGUF形式のモデルをローカルGPU上で動かすための実行エンジンにすぎない。
つまり構造は「llama.cppというランタイムの上でPPLX 27Bが動く」という、拍子抜けするほど素直な形だった。Harnessのロジックはモデルの中にはなく、Perplexityアプリ側のAgent層(Planner/Orchestrator/Scheduler)が持っていると見るのが自然だ。Perplexity公式:Introducing Portable Computer
画面に流れていた「Checking…」「Inspecting…」「Probing…」といった逐次の作業表示も、モデルが自由に喋っているというより、Agent Harness側がステップを管理している証拠だと思う。素のQwenを単体で走らせただけでは、まずここまで整理された動きにはならない。この差分こそがPerplexityのAgent Harnessの仕事だ。
なお、現在の公式製品ページではWindowsのRTX PCで選べるローカルモデルはPPLX 27Bと案内されている。Qwen 3.8 27B自体はDGX Spark向けとされていて、今回セットアップ時にQwen関連のデータも確認できてはいるものの、「ダウンロードされている構成要素」と「UI上で実行モデルとして選べるもの」は別物として扱う必要がありそうだ。
実験その2:いよいよコーディングを試す
ここまでは前哨戦だ。今回の本当の目的は、ローカルLLMでコーディング環境を用意すること。うちのRTX 3090君を、夜間に勝手に働いてくれる今より高性能なローカルCoding Agentに仕立てたかった。
計画では、業務とは切り離した研究用リポジトリだけを触らせ、git add/commit/push、merge、rebase、resetの類は禁止して、ファイルの読み書きとテスト実行だけを許可するつもりだった。これが動けば、CursorやClaude Codeとは別枠で、電気代だけで働くローカル要員が手に入る。
わくわくしながら新規プロジェクトを作成してみた。
が、次の瞬間目が点になった……プロジェクト配下では、ローカルモデルを選択できなかった。選べるのはGPT、Claude、GLM、Kimi、Grok、DeepSeekといった、いずれもフロンティアモデルばかり。
なんじゃそりゃ......
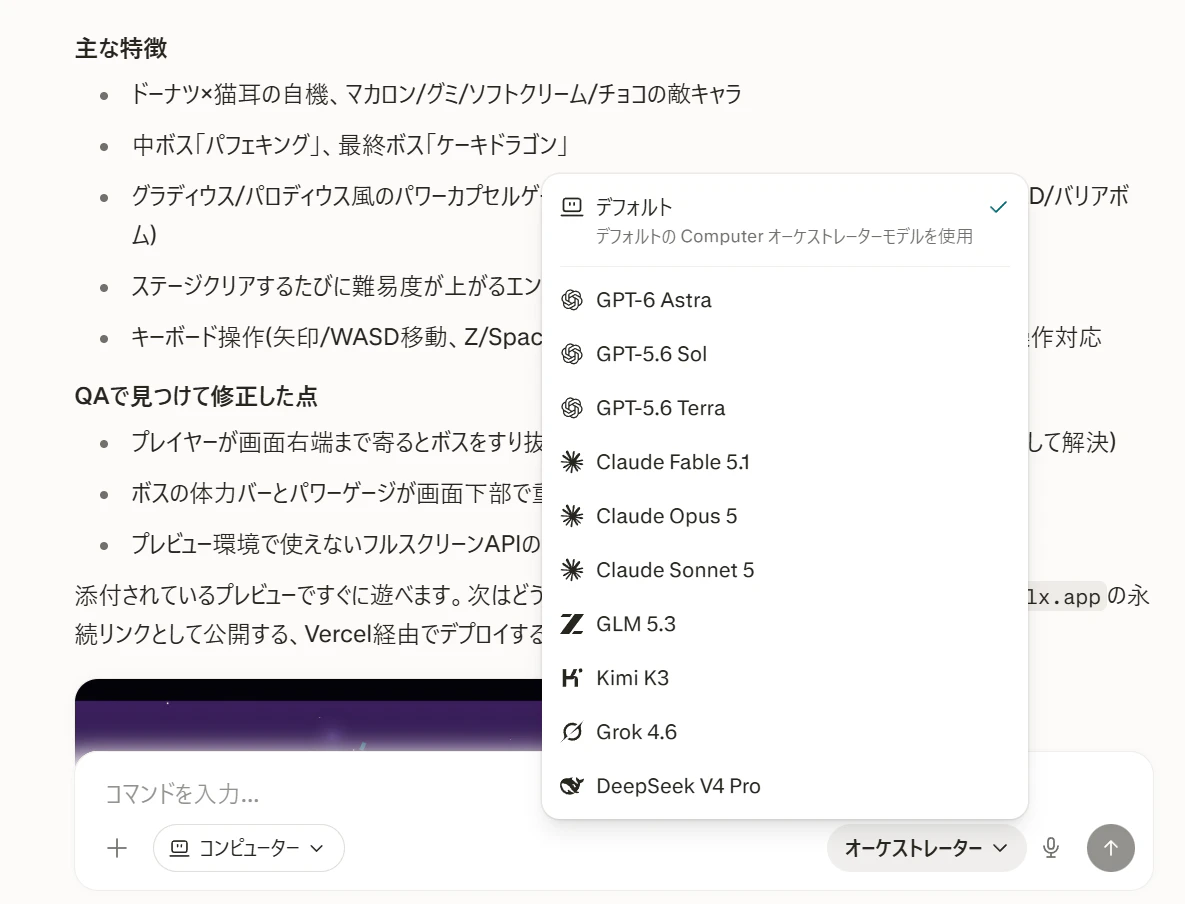
たしかにリリース情報にも「コーディング」の一文字も書かれていなかった。確かにそうだが、えー......まだコーディングに利用出来ないの? 非常に期待していた分、選択肢にないのを見ると、それなりに堪える。
公式ドキュメント上は、許可したフォルダ内のコードをローカルモデルで読み書きできる、とされている。ファイル単位の検索や操作は想定内のはずだ。だが、Computer側の本格的なコーディングワークフロー――ゼロからプロジェクトを組み立てるような作業――は、現状フロンティアモデルのオーケストレーターが前提になっている。
MCPの接続調査ができること自体は立派だ。しかし同じ調査は、MCPにアクセスできるフロンティアモデル(ChatGPT、Claude Code、Codexなど)でもできる。しかも向こうの方が格段に速い。
Portable Computerに課金した理由は、調査エージェントがもう一つ欲しかったからではない。RTX 3090を使い、フロンティアモデルの利用枠を消費せず、Harness付きのCoding Agentを動かしたかったからだ。
その中心的な期待は、今回は満たされなかった。と思う...正直まだ触り始めたばかりなので何かを見落としている可能性は否めない。もしかしたらローカルモデルでコーディング出来る方法があるのかもしれない。 もしあるのならご教示いただけると助かります
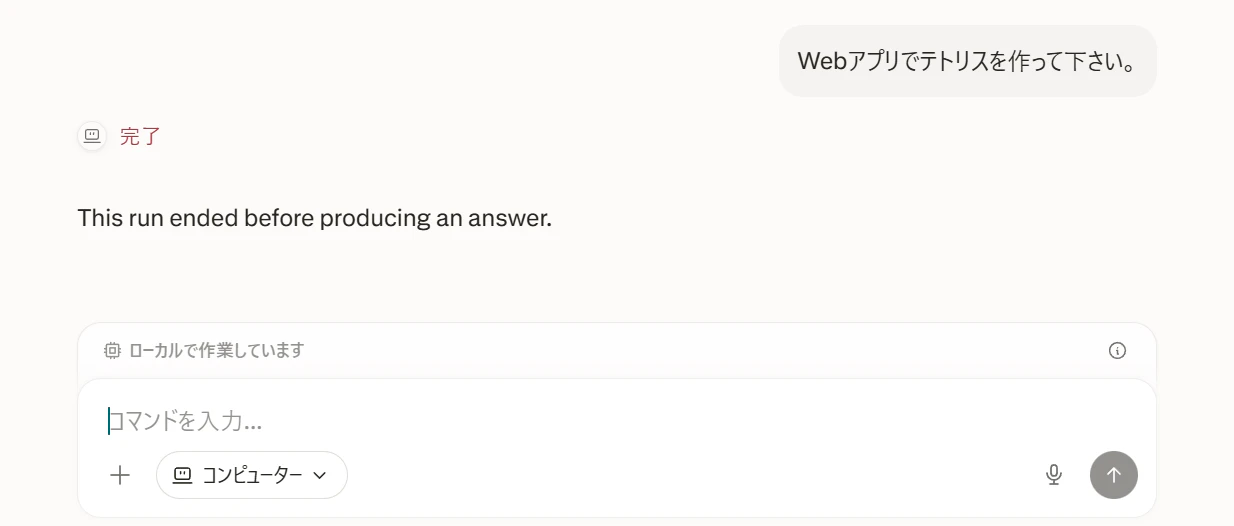
お約束の対話型にコードを書かせる方法でも失敗😖
で、結局これは何なのか
ここまで読むと、Portable Computerをこき下ろしているように見えるかもしれない。だが、技術的な評価はもう少し複雑だ。
27Bクラスのローカルモデルが、2時間以上にわたって破綻せず、しかも到達性→HTTP応答→設定→認証という順序で問題を切り分け続けた。素のQwen系モデルへ長いプロンプトを投げただけでは、まずこの品質を安定して再現できない。この差を生んでいるのがPerplexity側のHarnessだ。
モデルの性能をエンジンの馬力だとすれば、Harnessは変速機・ナビ・計器・運転支援をまとめた車体にあたる。馬力だけ高くても、長距離を安全に走れるとは限らない。今回分かったのは、27Bモデルがフロンティアモデルに近づいたということではなく、適切なHarnessを与えれば、27Bクラスでも長時間のエージェント作業をかなり秩序立てて続けられるということだった。
| 観点 | 評価 |
|---|---|
| ローカルAgentの継続力 | 高い。2時間以上の調査を破綻せず継続 |
| 調査の筋道 | 妥当。到達性から認証へ順番に切り分けた |
| MCP接続 | 成功。ツール探索とRAG検索まで到達 |
| 対話速度 | 厳しい。人間が隣で待つには遅い |
| フロンティアへの切り替え | 承認制。実行時間の目安が欲しい |
| ローカルコーディング | 期待したプロジェクト開発では選べず |
| コスト | ローカル完結なら消費0。ただし電気代とGPU占有時間はゼロではない |
現時点なら、日中の開発はIDE統合型のフロンティアAgentに任せ、Portable Computerには過去資料の照合、影響範囲調査、RAG検索、夜間の棚卸しといった「人間が隣で待たなくていい仕事」を渡す、という分担になりそうだ。フロンティアモデルへ出したくないデータの処理や、時間を気にしない大量処理であれば、ローカルであること自体が価値になる。逆に、対話しながらの高速な開発や、フロンティアモデルの完全な代替を期待するなら、今は肩透かしを食らう。
まとめ
RTX 3090 24GBでPortable Computerを試した結果、MCPの認証問題を特定するまでに約2時間8分、正しいAPIキーを渡してからツール検証を終えるまでにさらに約25分かかった。速くはない。
それでもローカルの27Bモデルは迷走せず、到達性、HTTP応答、設定、認証という順番で問題を切り分けた。Harness付きローカルAgentとしての完成度は、想像していたより高かった。
一方、本命だったローカルコーディングでは、プロジェクトのオーケストレーターにPPLX 27Bを選ぶことすらできなかった。ここが今回いちばんの肩透かしだ。
Portable Computerを「ローカル版のコーディングAI」として期待すると、現状はまだ早い。だが「時間を気にせず横で働かせるAgent Harness付きの夜間調査員」と割り切るなら、月々の枠内で3090を働かせられる悪くない選択肢になる。
Windows版が出たのはつい最近だ。実行時間の目安設定とローカルコーディングが解放されたら、この評価は一気に変わると思う。AIの動向は早い。しばらくPortable Computerの動向は注視してみたい。
こちらもよく読まれています
- 月々の高額AI請求を見て本気で「ローカルLLMでClaude Codeを動かせないか」ためした話
- ローカルLLMはClaude Codeフレームで使えるか? ―― 月々の高額AI請求を見て本気で「ローカルLLMでClaude Codeを動かせないか」ためした話
- AIエージェントの「認可されたはずの操作」が改ざん・逸脱される Authorization-Execution Gap 攻撃リスクと安全な実行完全性(Execution Integrity)検証設計チップス(テスト修正)
- MCP(Model Context Protocol)入門 — AIエージェントと外部ツールをつなぐ標準規格
- Claude Codeのベストな開発手法についてエージェントチームと議論してみた