
はじめに
前回は、Django + DRF で記事一覧 API をローカルに立てました。ただ、記事は admin から手入力した1件だけです。
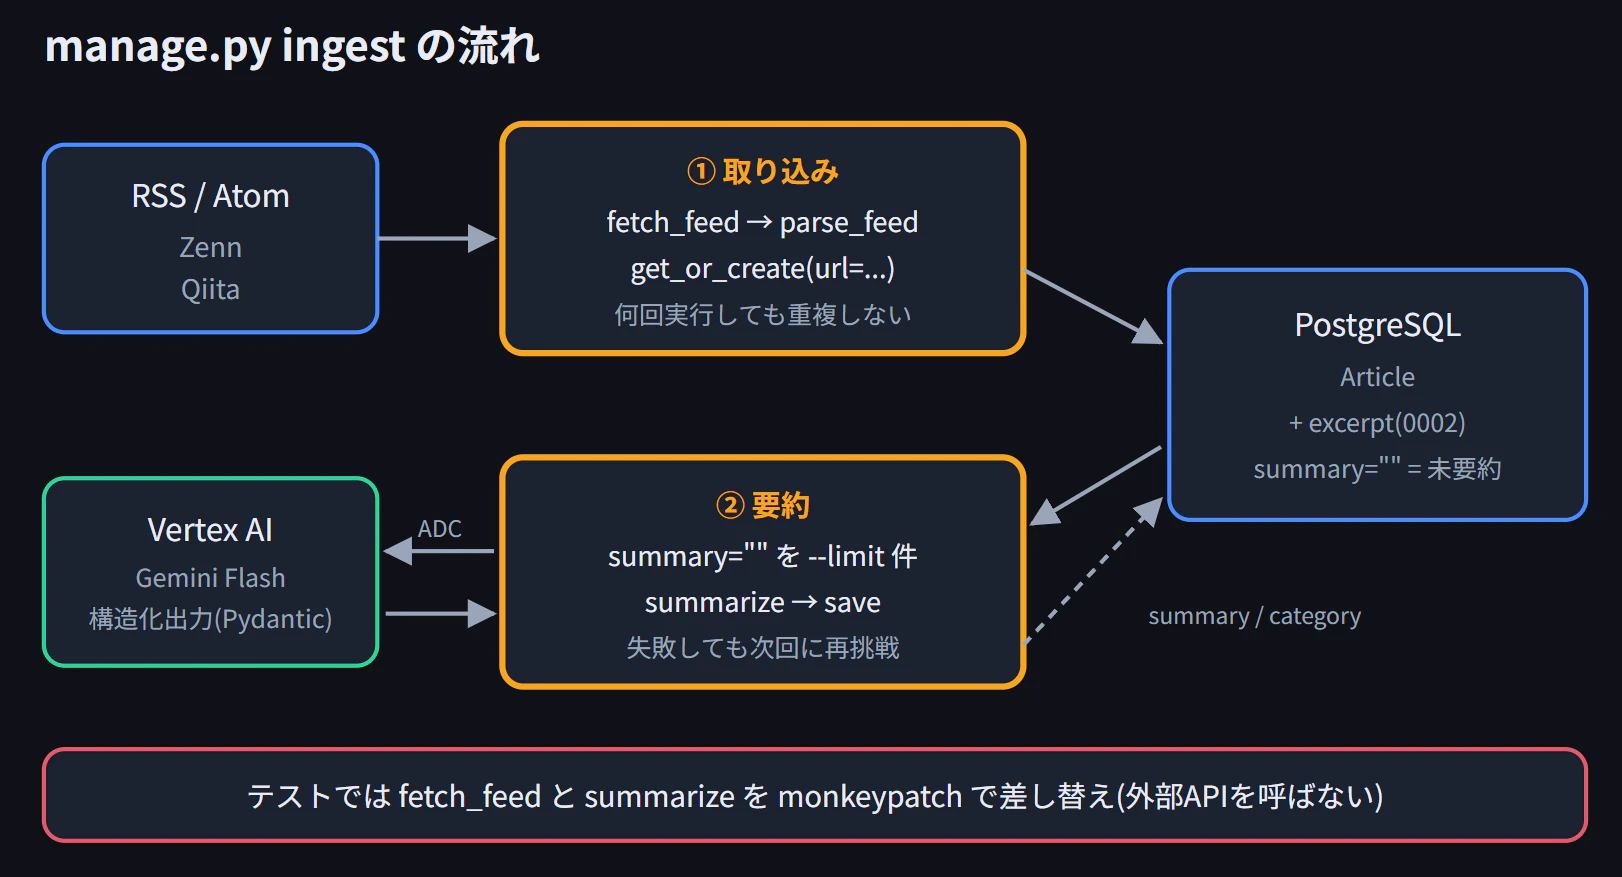
今回は manage.py ingest という管理コマンドを作ります。Zenn / Qiita の RSS から記事を取り込み、Vertex AI の Gemini で要約とカテゴリ分けをするところまで進めます。
この記事のゴール
- Vertex AI を使うための GCP プロジェクトを用意する
- モデルに本文抜粋のフィールドを足して、2回目のマイグレーションをする
- RSS の取得とパースを関数に切り出す
- Gemini の構造化出力で、要約とカテゴリを Pydantic モデルとして受け取る
- 管理コマンド
ingestを作る。何回実行しても記事が重複しないようにする - 外部 API を呼ばずに pytest でテストする
TS版からの設計の変更
TS版では、Cloud Run の HTTP エンドポイントで「取得 → 要約 → 保存」をまとめてやっていました。Django 版では次のように変えます。
| TS版 | Django版 | |
|---|---|---|
| 実行の入口 | HTTP エンドポイント | 管理コマンド(manage.py ingest) |
| 処理の単位 | 取得と要約を1件ずつ続けて実行 | 取得と要約を2段階に分ける |
| カテゴリ | Gemini に自由に付けさせる | 決めた選択肢から選ばせる |
| 重複排除 | ドキュメントID = URL |
get_or_create + unique=True
|
取得と要約を分けるのがいちばん大きな変更です。まず RSS の記事を全部 DB に入れます。そのあと「要約が空の記事」を上限件数まで要約します。こうしておくと、要約が途中で失敗した記事も次の実行で自動的に拾い直されます。
カテゴリを選択肢にしたのは、TS版で ai AI 機械学習 のように表記ゆれが出ていたからです。
1. Vertex AI を使えるようにする
GCP プロジェクトは TS版とは分けて、新しく作ります。課金を分けて見られるし、あとで丸ごと消すのも簡単です。
プロジェクトIDは世界で一意にする必要があるので、末尾に数字などを付けてください。
$PROJECT = "tech-digest-django-xxxx"
gcloud projects create $PROJECT --name="tech-digest-django"
課金アカウントを紐づけます。IDは gcloud billing accounts list で確認できます。
gcloud billing projects link $PROJECT --billing-account=XXXXXX-XXXXXX-XXXXXX
gcloud services enable aiplatform.googleapis.com --project=$PROJECT
ローカルからは、自分のアカウントの ADC(Application Default Credentials)で呼びます。API キーは使いません。
gcloud auth application-default login
gcloud auth application-default set-quota-project $PROJECT
set-quota-project は、ADC で API を呼んだときの課金や割り当てを、どのプロジェクトに付けるかの設定です。
2. パッケージを入れる
uv add feedparser httpx google-genai
| パッケージ | 役割 |
|---|---|
| feedparser | RSS / Atom のパース |
| httpx | HTTP クライアント |
| google-genai | Gemini の SDK(Vertex AI 経由でも使える) |
google-genai は Pydantic に依存しているので、Pydantic は一緒に入ります。
3. 設定を足す
backend/.env に追記します。
GOOGLE_CLOUD_PROJECT=tech-digest-django-xxxx
GEMINI_MODEL=gemini-2.5-flash
config/settings.py の末尾に追記します。
GOOGLE_CLOUD_PROJECT = env("GOOGLE_CLOUD_PROJECT", default="")
GEMINI_MODEL = env("GEMINI_MODEL", default="gemini-2.5-flash")
プロジェクトIDは明示的に渡します。TS版で、省略したら gcloud のデフォルトプロジェクトに向いてハマったことがあるからです。モデル名も環境変数にしておくと、モデルが新しくなったときにコードを触らずに切り替えられます。
4. モデルに本文抜粋を足す
要約を取得と別のタイミングでやるので、RSS の本文抜粋を DB に残しておく必要があります。
    summary = models.TextField(blank=True)
    excerpt = models.TextField(blank=True)  # 追加
    category = models.CharField(max_length=50, blank=True, db_index=True)
uv run python manage.py makemigrations digest
uv run python manage.py migrate
Migrations for 'digest':
  digest\migrations\0002_article_excerpt.py
    + Add field excerpt to article
Running migrations:
  Applying digest.0002_article_excerpt... OK
digest/migrations/0002_article_excerpt.py ができます。スキーマの変更がファイルとして残るので、本番 DB にも同じ変更を CI から当てられます。Firestore にはなかった仕組みです。
5. RSS の取得とパース
from dataclasses import dataclass
from datetime import UTC, datetime

import feedparser
import httpx
from django.utils.html import strip_tags

FEEDS = {
    "zenn": "https://zenn.dev/feed",
    "qiita": "https://qiita.com/popular-items/feed",
}

USER_AGENT = "tech-digest-django/0.1"


@dataclass(frozen=True)
class FeedEntry:
    url: str
    title: str
    source: str
    published_at: datetime
    excerpt: str


def parse_feed(content: str | bytes, source: str) -> list[FeedEntry]:
    parsed = feedparser.parse(content)
    entries = []
    for e in parsed.entries:
        link = e.get("link")
        published = e.get("published_parsed") or e.get("updated_parsed")
        if not link or not published:
            continue
        entries.append(
            FeedEntry(
                url=link,
                title=e.get("title", "")[:300],
                source=source,
                published_at=datetime(*published[:6], tzinfo=UTC),
                excerpt=strip_tags(e.get("summary", ""))[:2000],
            )
        )
    return entries


def fetch_feed(source: str) -> list[FeedEntry]:
    res = httpx.get(
        FEEDS[source],
        headers={"User-Agent": USER_AGENT},
        timeout=10,
        follow_redirects=True,
    )
    res.raise_for_status()
    return parse_feed(res.content, source)
ポイントは次のとおりです。
-
通信する
fetch_feedと、パースするだけのparse_feedを分ける:parse_feedは文字列を渡すだけでテストできる -
published_parsedは UTC のstruct_time:feedparser がタイムゾーンを UTC にそろえてくれるので、tzinfo=UTCを付けてdatetimeにする -
strip_tags:RSS の本文には HTML タグが入っていることがあるので、Django 標準の関数で落とす - リンクか日付がない記事は飛ばす:モデルの必須項目を埋められないため
6. Gemini で要約する
from enum import StrEnum
from functools import cache

from django.conf import settings
from google import genai
from google.genai import types
from pydantic import BaseModel, Field


class Category(StrEnum):
    AI = "ai"
    WEB = "web"
    FRONTEND = "frontend"
    BACKEND = "backend"
    INFRA = "infra"
    DATA = "data"
    SECURITY = "security"
    MOBILE = "mobile"
    OTHER = "other"


class Summary(BaseModel):
    summary: str = Field(description="記事の要約。日本語で3文以内")
    category: Category


PROMPT = """以下の技術記事を要約し、カテゴリを1つ選んでください。

タイトル: {title}
本文抜粋: {excerpt}
"""


@cache
def _client() -> genai.Client:
    return genai.Client(
        vertexai=True,
        project=settings.GOOGLE_CLOUD_PROJECT,
        location="global",
    )


def summarize(title: str, excerpt: str) -> Summary:
    res = _client().models.generate_content(
        model=settings.GEMINI_MODEL,
        contents=PROMPT.format(title=title, excerpt=excerpt),
        config=types.GenerateContentConfig(
            response_mime_type="application/json",
            response_schema=Summary,
            temperature=0.2,
        ),
    )
    if not isinstance(res.parsed, Summary):
        raise ValueError(f"unexpected response: {res.text}")
    return res.parsed
ポイントは次のとおりです。
-
構造化出力:
response_schemaに Pydantic モデルを渡すと、Gemini がそのスキーマどおりの JSON を返します。res.parsedにはSummaryのインスタンスが入ります。TS版では返ってきた JSON を自分でパースしていました -
カテゴリを
StrEnumにする:選択肢以外の値は返ってこなくなるので、表記ゆれがなくなる -
vertexai=Trueとlocation="global":API キーではなく ADC で認証して、Vertex AI 経由で呼ぶ -
クライアントは
@cacheで遅延生成:import しただけでは認証が走らないので、テストで困らない
7. 管理コマンド ingest を作る
Django は アプリ/management/commands/名前.py に置いたファイルを、manage.py 名前 で実行できるコマンドとして認識します。__init__.py も2つ必要です。
New-Item -ItemType File -Force digest\management\__init__.py, digest\management\commands\__init__.py
import httpx
from django.core.management.base import BaseCommand

from digest.feeds import FEEDS, fetch_feed
from digest.models import Article
from digest.summarizer import summarize


class Command(BaseCommand):
    help = "RSS から記事を取り込み、未要約の記事を要約する"

    def add_arguments(self, parser):
        parser.add_argument("--limit", type=int, default=10, help="1回で要約する最大件数")
        parser.add_argument("--skip-summary", action="store_true", help="取り込みだけ行う")

    def handle(self, *args, **options):
        created = self._fetch()
        summarized, failed = 0, 0
        if not options["skip_summary"]:
            summarized, failed = self._summarize(options["limit"])
        self.stdout.write(
            self.style.SUCCESS(f"created={created} summarized={summarized} failed={failed}")
        )

    def _fetch(self) -> int:
        created = 0
        for source in FEEDS:
            try:
                entries = fetch_feed(source)
            except httpx.HTTPError as e:
                self.stderr.write(f"[{source}] fetch failed: {e}")
                continue
            for entry in entries:
                _, is_new = Article.objects.get_or_create(
                    url=entry.url,
                    defaults={
                        "title": entry.title,
                        "source": entry.source,
                        "published_at": entry.published_at,
                        "excerpt": entry.excerpt,
                    },
                )
                created += is_new
        return created

    def _summarize(self, limit: int) -> tuple[int, int]:
        ok, ng = 0, 0
        targets = Article.objects.filter(summary="").order_by("-published_at")[:limit]
        for article in targets:
            try:
                result = summarize(article.title, article.excerpt)
            except Exception as e:
                self.stderr.write(f"[{article.pk}] summarize failed: {e}")
                ng += 1
                continue
            article.summary = result.summary
            article.category = result.category.value
            article.save(update_fields=["summary", "category", "updated_at"])
            ok += 1
        return ok, ng
ポイントは次のとおりです。
-
get_or_create:URL で探して、なければ作る。何回実行しても同じ記事は1件にしかならない -
--limit:1回の実行で Gemini を呼ぶ回数に上限をかける。課金が想定外に膨らまないようにするため -
1件の失敗で全体を止めない:取得も要約も、失敗したらログを出して次へ進む。要約に失敗した記事は
summaryが空のまま残るので、次回の実行で再挑戦される -
update_fields:変更した列だけを UPDATE する。auto_nowのupdated_atは、ここに含めないと更新されない
8. 動かしてみる
まずは Gemini を呼ばずに、取り込みだけ試します。
uv run python manage.py ingest --skip-summary
created=50 summarized=0 failed=0
Zenn と Qiita のフィードから、合わせて50件が入りました。
もう一度実行して、created=0 になることを確認します。
uv run python manage.py ingest --skip-summary
created=0 summarized=0 failed=0
get_or_create が既存の URL を見つけるので、2回目は1件も増えません。
次に、3件だけ要約します。
uv run python manage.py ingest --limit 3
created=0 summarized=3 failed=0
admin を開くと、要約とカテゴリが入った記事を確認できます。API でカテゴリを絞り込むとこうなります。
http://localhost:8000/api/articles/?category=ai
HTTP 200 OK
Allow: GET, HEAD, OPTIONS
Content-Type: application/json
Vary: Accept

{
    "count": 1,
    "next": null,
    "previous": null,
    "results": [
        {
            "id": 3,
            "url": "https://zenn.dev/xxxx/articles/xxxx",
            "title": "テニス解析をピックルボールに使ってみた:四隅の指定でコートの俯瞰表示を補う①",
            "source": "zenn",
            "published_at": "2026-10-22T15:31:34+09:00",
            "summary": "テニス映像解析ツールをピックルボールの試合映像に適用し、ボール追跡、コート検出、人物位置の俯瞰表示を試みました。テニス用の自動コート推定ではずれが生じたため、固定カメラを前提にコートの四隅を手動指定し、ピックルボール用の俯瞰図に変換する処理を追加しています。",
            "category": "ai"
        }
    ]
}
指示どおり、日本語で3文以内の要約になっています。カテゴリも選択肢の ai が入りました。前回作った filterset_fields の絞り込みが、Gemini の付けたカテゴリでそのまま使えます。
9. テストする
外部の RSS や Gemini を呼ぶと、テストが遅くなります。結果も毎回変わってしまいます。そこで、通信する部分は差し替えます。
パースのテスト
from datetime import UTC, datetime
from digest.feeds import parse_feed
RSS = """<?xml version="1.0"?>
<rss version="2.0"><channel><title>Zenn</title>
<item>
<title>記事A</title>
<link>https://zenn.dev/u/articles/a</link>
<pubDate>Fri, 16 Oct 2026 10:00:00 GMT</pubDate>
<description><p>本文です</p></description>
</item>
<item>
<title>日付なし</title>
<link>https://zenn.dev/u/articles/b</link>
</item>
</channel></rss>"""
def test_parse_feed():
entries = parse_feed(RSS, "zenn")
assert len(entries) == 1
entry = entries[0]
assert entry.url == "https://zenn.dev/u/articles/a"
assert entry.published_at == datetime(2026, 10, 16, 10, 0, tzinfo=UTC)
assert entry.excerpt == "本文です"
日付のない記事が飛ばされることと、HTML タグが落ちることも一緒に確認しています。
コマンドのテスト
from datetime import UTC, datetime

import pytest
from django.core.management import call_command

from digest.feeds import FeedEntry
from digest.models import Article
from digest.summarizer import Category, Summary

TARGET = "digest.management.commands.ingest"

ENTRY = FeedEntry(
    url="https://zenn.dev/u/articles/a",
    title="A",
    source="zenn",
    published_at=datetime(2026, 10, 16, tzinfo=UTC),
    excerpt="本文",
)


@pytest.fixture
def fake_io(monkeypatch):
    monkeypatch.setattr(f"{TARGET}.FEEDS", {"zenn": "dummy"})
    monkeypatch.setattr(f"{TARGET}.fetch_feed", lambda source: [ENTRY])
    monkeypatch.setattr(
        f"{TARGET}.summarize",
        lambda title, excerpt: Summary(summary="要約", category=Category.AI),
    )


@pytest.mark.django_db
def test_ingest_is_idempotent(fake_io):
    call_command("ingest")
    call_command("ingest")

    assert Article.objects.count() == 1
    article = Article.objects.get()
    assert article.summary == "要約"
    assert article.category == "ai"
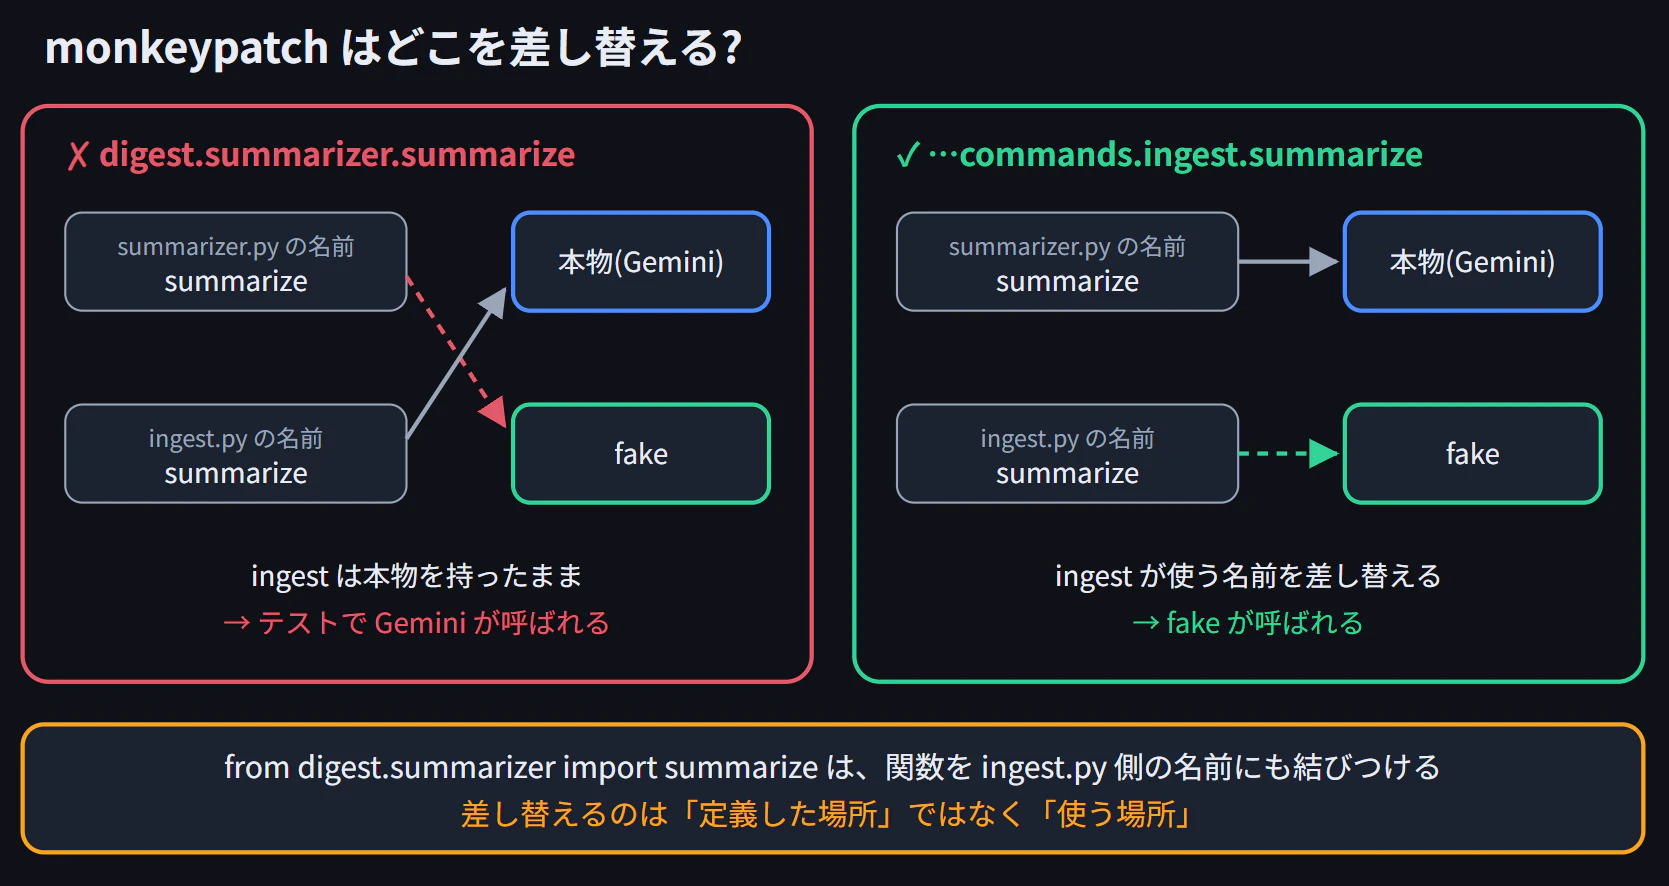
差し替える先は digest.summarizer.summarize ではなく、digest.management.commands.ingest.summarize です。ingest.py は from ... import summarize で関数を自分のモジュールに取り込んでいます。なので、取り込んだ側の名前を差し替えないと効きません。
uv run pytest
collected 3 items

tests\test_articles.py .                                                    [ 33%]
tests\test_ingest.py .                                                      [ 66%]
tests\test_feeds.py .                                                       [100%]

================================== 3 passed in 3.84s ==================================
前回のテストと合わせて3本、外部 API を呼ばずに4秒弱で終わります。
つまずいたところ
import の typo は ruff で先に見つける
  File "C:\projects\tech-digest-django\backend\digest\feeds.py", line 1, in <module>
    from dataclasses import datablass
ImportError: cannot import name 'datablass' from 'dataclasses'
E ModuleNotFoundError: No module named 'digest.feed'
原因:どちらも typo です。dataclass を datablass に、digest.feeds を digest.feed に打ち間違えていました。
対処:名前を直す。手で打つなら、実行する前に uv run ruff check . をかけると早いです。1つ目のような typo なら、「dataclass が未定義」「datablass が未使用」と、実行する前に教えてくれます。2つ目のようなモジュール名の間違いは ruff では拾えないので、pytest で気づくことになります。
フォルダ名を変えたら、また pytest が動かない
PS C:\projects\tech-digest-django\backend> uv run pytest
Failed to canonicalize script path
原因:前回の記事と同じです。リポジトリ名に合わせてフォルダ名を変えたあと、.venv を作り直していませんでした。uv run python manage.py ... は動くので気づきにくいのですが、pytest.exe は古いパスを見たままです。
対処:.venv を作り直す。
Remove-Item -Recurse -Force .venv; uv sync
フォルダを動かしたら uv sync し直す、を習慣にしておくと安心です。
コスト
- 固定費:なし。ローカルの Postgres と、呼んだ分だけ課金される Vertex AI だけ
-
Gemini:Flash 系は安いので、数件〜数十件の要約なら誤差の範囲。
--limitで上限もかけている
まとめ
- 管理コマンドで、RSS の取り込みと要約を API から切り離した
- 取得と要約を2段階に分けたので、失敗した記事は次回に自動で再挑戦される
- Gemini の構造化出力と
StrEnumで、カテゴリの表記ゆれをなくした - 通信部分を差し替えて、外部 API なしでテストした
次回は Vertex AI の embedding で記事をベクトル化します。pgvector に入れて、「似てる記事」を返す API を作ります。