
変更履歴
- 2026-11-07:公開
初めに
AWS Certified Generative AI Developer – Professional(AIP-C01)の資格勉強のために、出題範囲のサービスを実際に動かす「AIP 基礎編」を全 7 本で書いている。
この記事はその 2 本目で、1 本目は 基盤モデル(Foundation Model、FM)の呼び出し方と選び方。シリーズの全体と構成の理由は 1 本目に書いた。
RAG は、問いに近い文書の一部を探し、それを根拠に答えを作らせる仕組み。Amazon Bedrock(AWS の生成 AI のサービス)でこの仕組みを作る機能が Knowledge Bases である。文書は丸ごと入れず、小さな断片に分けて入れておき、問いに近い断片を探す。この断片をチャンクと呼ぶ。
どこで分けるかで、1 つのチャンクに入る文が変わる。決まりの 1 文が周りの文に埋もれることも、関係する 2 つの条が別のチャンクに分かれることもある。文書のうち、答えを作るモデルが読めるのは、検索で取り出したチャンクだけである。根拠の入ったチャンクを検索で取れないと、モデルへの指示文(プロンプト)をどう書いても、その根拠は使えない。
チャンクの分け方、検索に使う数値(ベクトル)の保存先、文書に付ける年や版などの情報(メタデータ)での絞り込みは、試験の範囲にも入っている(試験ガイドの Task 1.4・1.5)。ただ、設定の説明を読むだけでは、違いが答えにどう出るかが見えない。そこで、同じ文書を分け方を変えて Knowledge Bases に入れ、返ってくる根拠と答えを比べた。
検証は 2026-11-07、東京リージョン(ap-northeast-1)、Python の boto3(AWS を操作する SDK)1.43.114 で行った。
結論
架空の会社の社内規程を 5 つ書いて Knowledge Bases に入れ、9 つの問いを投げた。規程のチャンクへの分け方を 3 通りに変え、検索で返る部分と答えがどう変わるかを比べた。3 通りは、決まった長さで切る「固定長」、文の意味で切る「意味」、大小 2 段に分ける「階層」である。
規程 5 つくらいなら、どの分け方でも答えの根拠は見つかった。分け方で変わったのは、返ったチャンクに規程の題名と施行日(規程が効き始める日)が入るかどうかと、答えの中身である。
- 根拠:答えが文書にある 7 問は、どの分け方でも、検索で返る上位 5 件のチャンクに根拠が入っていた。同じ規程の離れた 2 つの条を 1 件で返したのは階層だけだった
- 版の見分け:経費精算規程には、締め日が 20 日の 2025 年版と、25 日の 2026 年版(現行)の 2 つを入れた。版を指定せずに締め日を聞く問いを 3 回ずつ投げて、3 回とも 25 日だけを答えたのは階層だけだった。階層は大きいチャンクで返すので題名と施行日が入り、それが効いた可能性がある
- 絞り込み:2026 年で絞ると、締め日は 25 日に定まった。現行版だけに絞ると旧版が消え、変更前の 20 日を言えなくなった。メタデータを付けていない文書を絞ると 0 件になり、エラーは出なかった
- 答えのぶれ:答えのばらつきを最も小さくする設定(
temperature0)でも答えは揺れた。同じ分け方で日当が 3,000 円にも 3,500 円にもなり、中国語や英語の答えも出た。プロンプトで、言語と「記載が無い」の答え方はそろった - S3 Vectors(今回のベクトルの保存先):意味の検索と文字列の検索を合わせるハイブリッド検索を指定すると、
ValidationExceptionというエラーで止まった。検索結果を別のモデルで並べ直す再ランクと、問いを小さく分けて検索する問いの分解は使えた
本記事の構成
1〜2 章で仕組みと検証環境を説明し、3〜6 章に結果を書く。7 章に要件ごとの選び方をまとめる。
検証の全体像は以下の通り。
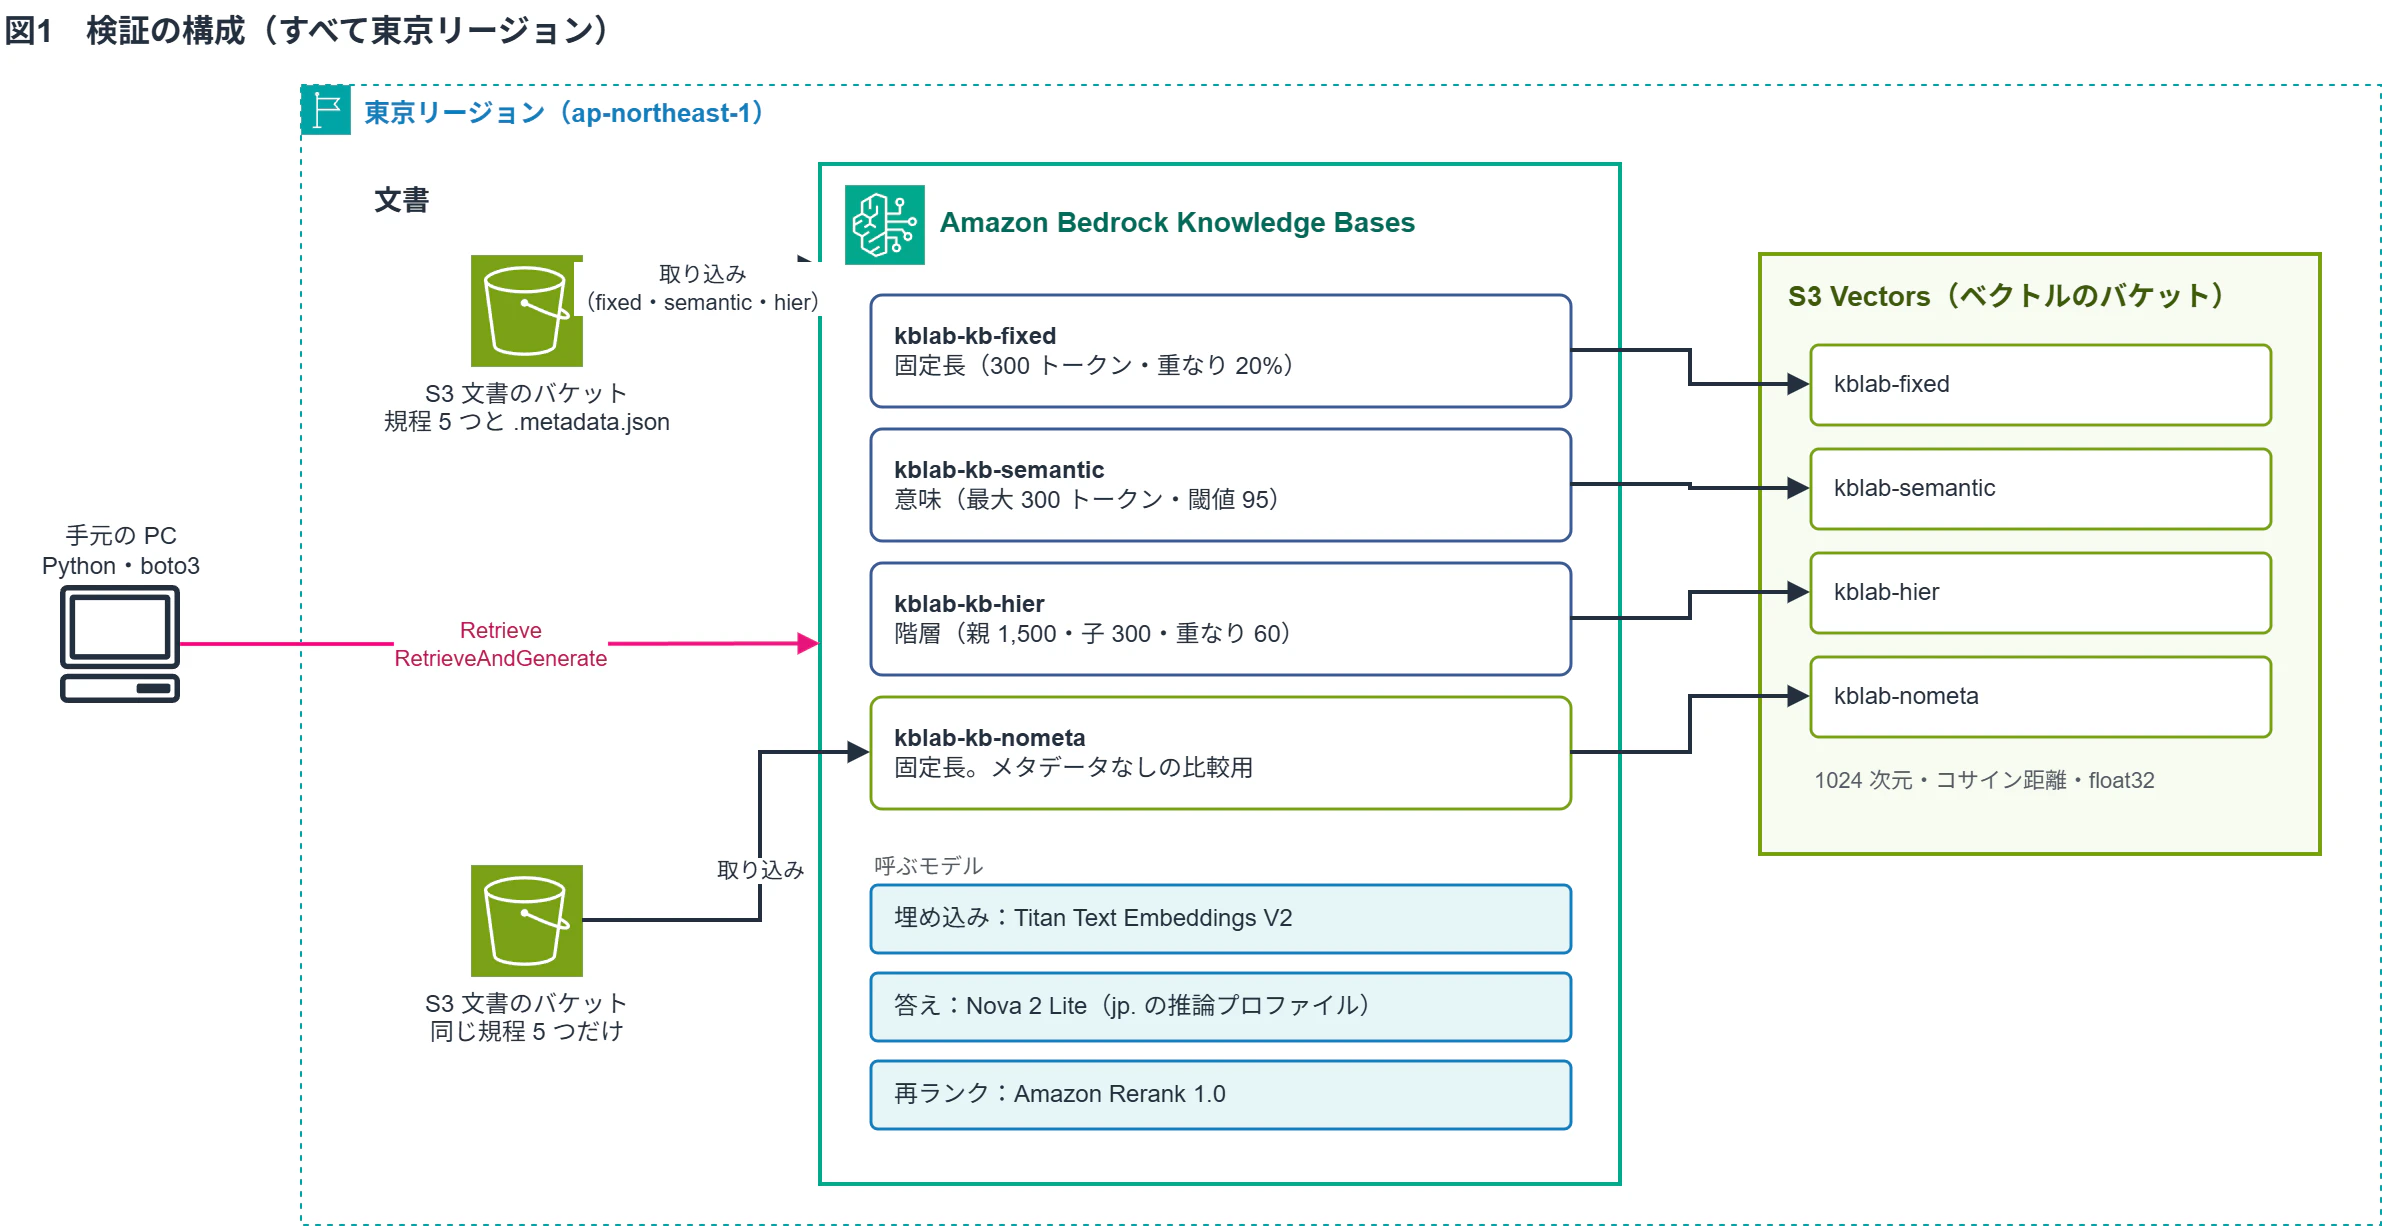
文書を置く S3 のバケットは、メタデータの有無で 2 つに分けた。そこから検索の単位を 4 つ作り、手元の Python から問いを投げた。
1. Knowledge Bases の仕組み
Knowledge Bases は、RAG の取り込みから答えを作るまでを Bedrock の中で持つ機能。以下、この機能で作る 1 つの検索の単位を「ナレッジベース」と書く。
検索の土台は埋め込みである。埋め込みは、文章を数値の並び(ベクトル)に変える処理で、意味の近い文章は近い数値になる。文書と問いの両方をベクトルにすると、近さを計算で比べられる。
流れは 3 段に分かれる。
- 取り込み(コンソールでは「同期」):データソース(文書を読みに行く先。今回は S3 のバケット)の文書をチャンクに分け、埋め込みのモデルでベクトルに変えて、ベクトルの置き場に入れる。
- 取り出し(
Retrieve):問いをベクトルにして、近いチャンクを返す。答えは作らない。 - 答えを作る(
RetrieveAndGenerate):取り出したチャンクを基盤モデルに渡し、引用つきの答えを返す。
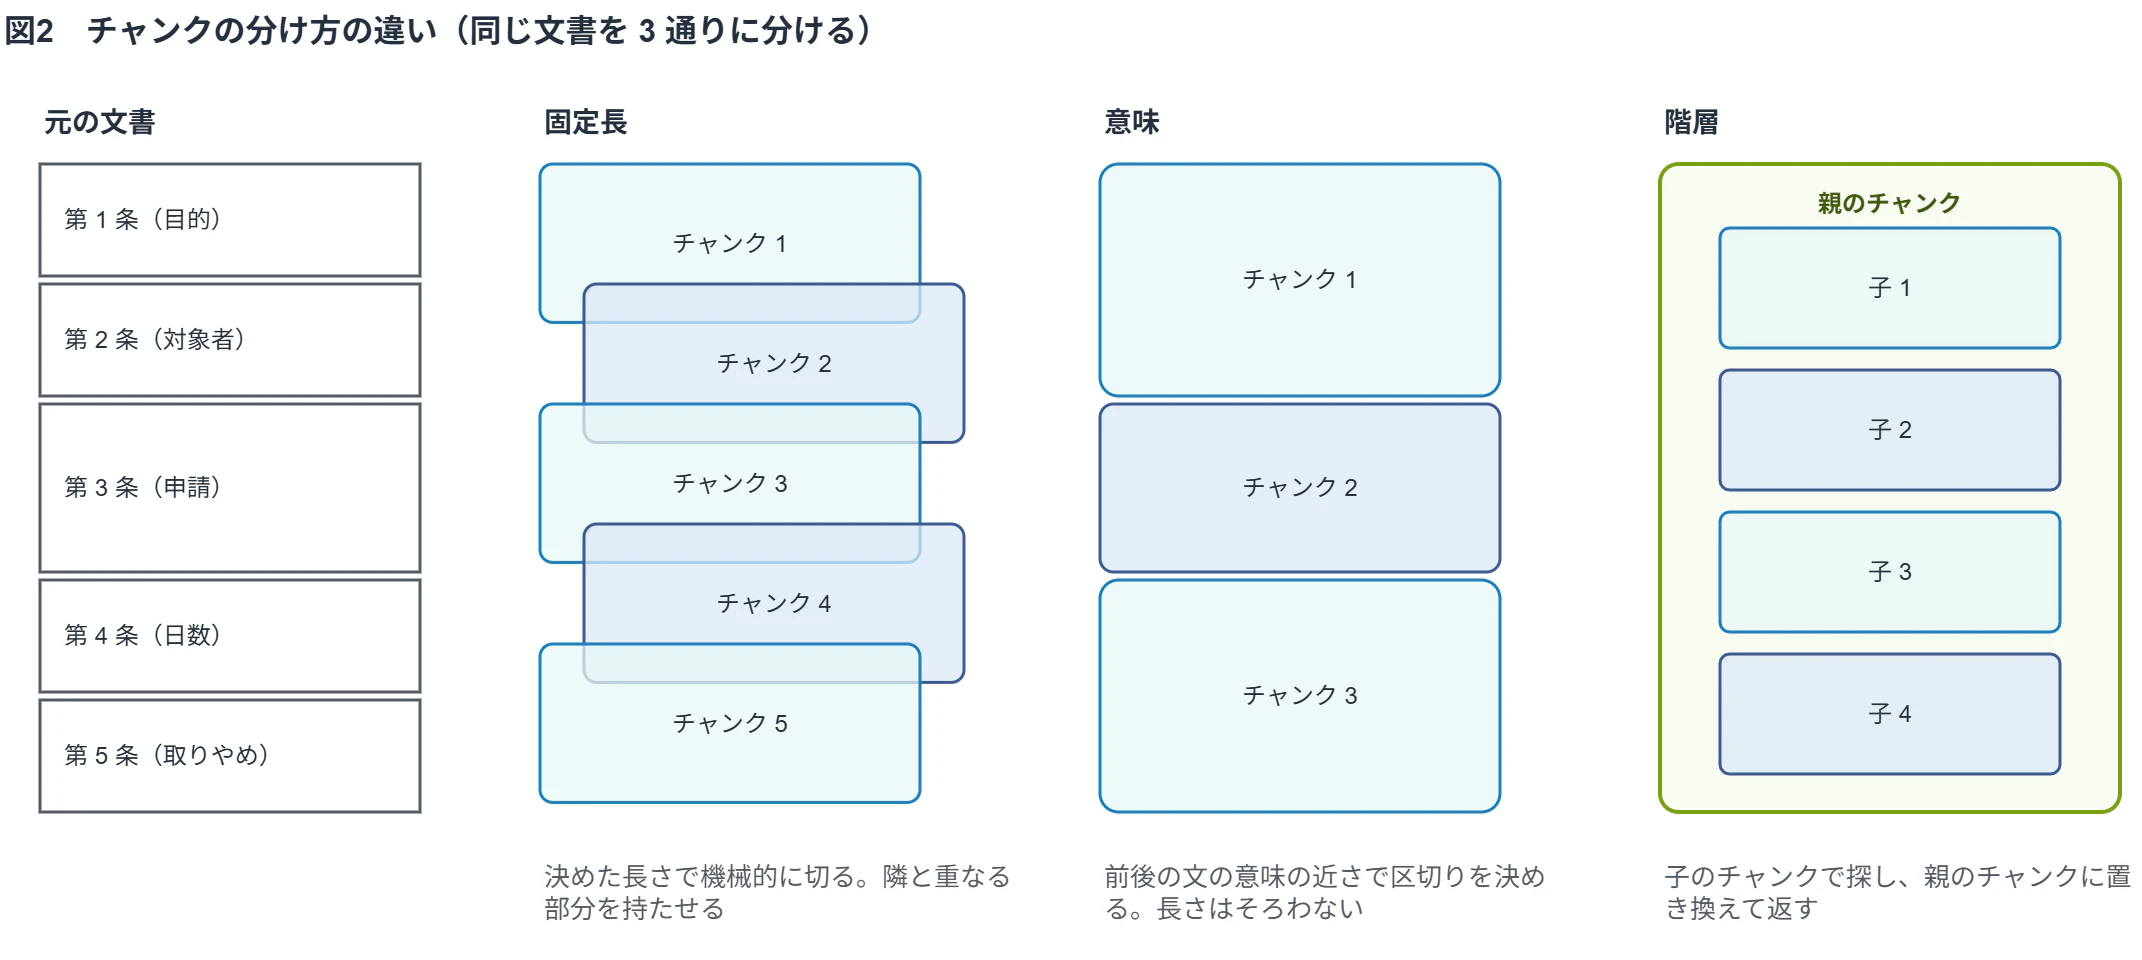
チャンクの分け方は、次の 5 通りから選ぶ(公式)。長さはトークンで数える。トークンはモデルが文章を処理するときの単位で、文字数とは一致しない。
- 既定:約 300 トークンで、文の区切りを守って分ける。
- 固定長:トークン数と重なりの割合を決めて分ける。重なりは、隣のチャンクと同じ文を持たせる量である。
- 階層:大きいチャンク(親)と、それを細かくしたチャンク(子)の 2 段に分ける。検索は子で当て、親に置き換えて返す。
- 意味(semantic):文どうしの意味の近さで区切りを決める。基盤モデルを使うので、その分の費用がかかる。
- 分けない:1 文書を 1 チャンクにする。
ベクトルを保存して検索する先がベクトルの置き場で、OpenSearch Serverless・Aurora PostgreSQL(pgvector)・Neptune Analytics・S3 Vectors などから選ぶ。今回は S3 Vectors を使った。動かしていない間は保存の料金だけで、OpenSearch Serverless のように動かしている間ずっとかかる料金が無いため。その代わり、検索は意味の近さで探すセマンティック検索だけで、文字列の検索も合わせるハイブリッド検索は使えない(ハイブリッド検索に対応するのは RDS・OpenSearch Serverless・MongoDB Atlas。公式)。
置き場と埋め込みを Bedrock に任せる Managed Knowledge Base という形もある。ただ、分け方は既定・固定長・分けないの 3 つで、意味と階層を比べられない。なので今回は、置き場を自分で用意する形にした(公式)。
2. 検証環境
比べるのは次の 4 つ。
- 分け方(3 章):固定長は長さで機械的に切り、意味は文の内容で切り、階層は大小 2 段に分ける。区切りの決め方が違う 3 つを比べる
- メタデータ(4 章):旧版と現行版のように本文がほとんど同じ文書は、近さの検索では分けにくい。絞り込みでどこまで分けられるか、絞りすぎると何が起きるかを見る。メタデータを付けない場合とも比べる
- 答えの生成(5 章):根拠が取れても、答えに出るとは限らない。文書に無いことを聞いたときの振る舞いも見る
- 取り込み直し(6 章):規程は改定される。文書を直したとき、ベクトルの置き場がどう追いつくかを見る
使ったものは以下の通り。
- ベクトルの置き場:S3 Vectors(1024 次元〈数値の個数〉・コサイン距離〈ベクトルの近さの測り方〉・float32〈数値の保存形式〉)
- 埋め込みのモデル:Amazon Titan Text Embeddings V2(
amazon.titan-embed-text-v2:0。1024 次元) - 答えを作るモデル:Amazon Nova 2 Lite(
jp.amazon.nova-2-lite-v1:0)。モデルの ID の代わりに、処理するリージョンをまとめて指定する推論プロファイルを使った。jp.は東京と大阪で処理する - 再ランクのモデル:Amazon Rerank 1.0(
amazon.rerank-v1:0)。検索結果を問いに近い順に並べ直す
文書は、公開されている文書ではなく、架空の会社の社内規程を 5 つ書いた(日本語・Markdown・計 6,700 字ほど)。答えが決まっているので比べやすく、それぞれに答えが分かれそうな仕掛けを入れた。表・長い条・旧版と現行版の同居を仕込みやすいので、社内規程にした。括弧の中は、あとで絞り込みに使う年・部署・版の値である。
- 旅費規程(2026 年版):役職ごとの日当の表。課長は 3,000 円、部長は 3,500 円(年 2026・部署 総務・版 current)
- 経費精算規程(2025 年版):締め日が毎月 20 日。2025 年 4 月 1 日施行(年 2025・部署 経理・版 old)
- 経費精算規程(2026 年版):締め日が毎月 25 日。2026 年 4 月 1 日施行。ほかは 2025 年版とほぼ同じ文(年 2026・部署 経理・版 current)
- 在宅勤務規程:申請の締切(3 営業日前)と上限の日数(1 か月に 8 日)を、4 つの条を挟んだ第 4 条と第 9 条に置いた(年 2026・部署 人事・版 current)
- 情報セキュリティ規程:約 1,800 字の長い条の途中に、パスワードは 12 文字以上という決まりを 1 文だけ置いた(年 2026・部署 情報システム・版 current)
施行日は、その規程が効き始める日である。経費精算規程は 2 つの版が同居していて、施行日の新しい 2026 年版が現行、2025 年版が旧版になる。
メタデータは、文書の本文とは別に付ける情報で、検索の対象を絞る条件に使える。文書と同じ場所に置く <ファイル名>.metadata.json で付けた。2026 年版の経費精算規程の例は以下。
{
  "metadataAttributes": {
    "year": { "value": { "type": "NUMBER", "numberValue": 2026 }, "includeForEmbedding": false },
    "department": { "value": { "type": "STRING", "stringValue": "経理" }, "includeForEmbedding": false },
    "edition": { "value": { "type": "STRING", "stringValue": "current" }, "includeForEmbedding": false }
  }
}
includeForEmbedding: false は、ベクトルには混ぜないが、検索の条件には使える設定である。分け方の比較に混ざらないよう、こうした。比べるために、同じ文書をメタデータなしで入れたナレッジベース(分け方は固定長)も 1 つ作った。
S3 Vectors では、ベクトルバケットの中に索引(ベクトルインデックス)を作り、そこにベクトルを入れる。今回はナレッジベースを 4 つ作るので、索引も 4 つ作った。索引には、チャンクの本文を入れる AMAZON_BEDROCK_TEXT と、Bedrock が管理する情報を入れる AMAZON_BEDROCK_METADATA も入る。この 2 つは検索の条件に使わないので、索引を作るときに「絞り込めないメタデータ」に指定する。あとから変えられない設定である。.metadata.json で付けた year などは別の値で、検索の条件に使える。
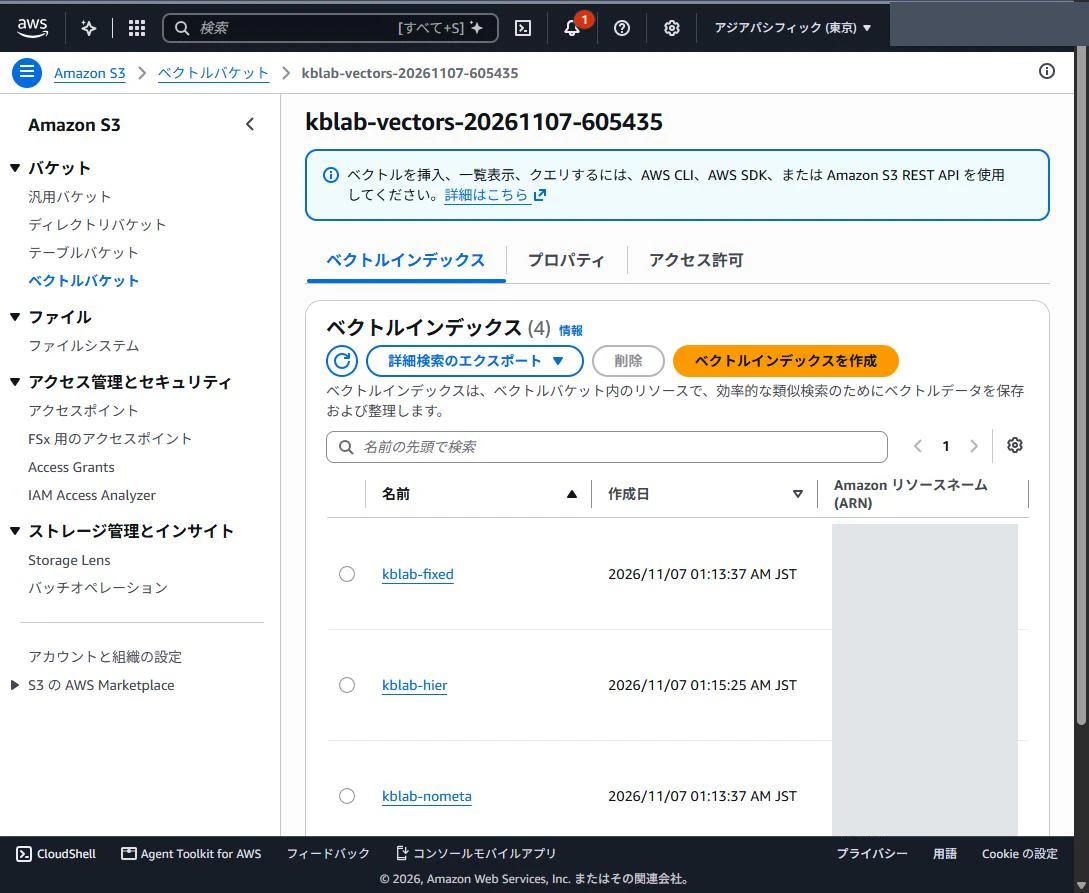
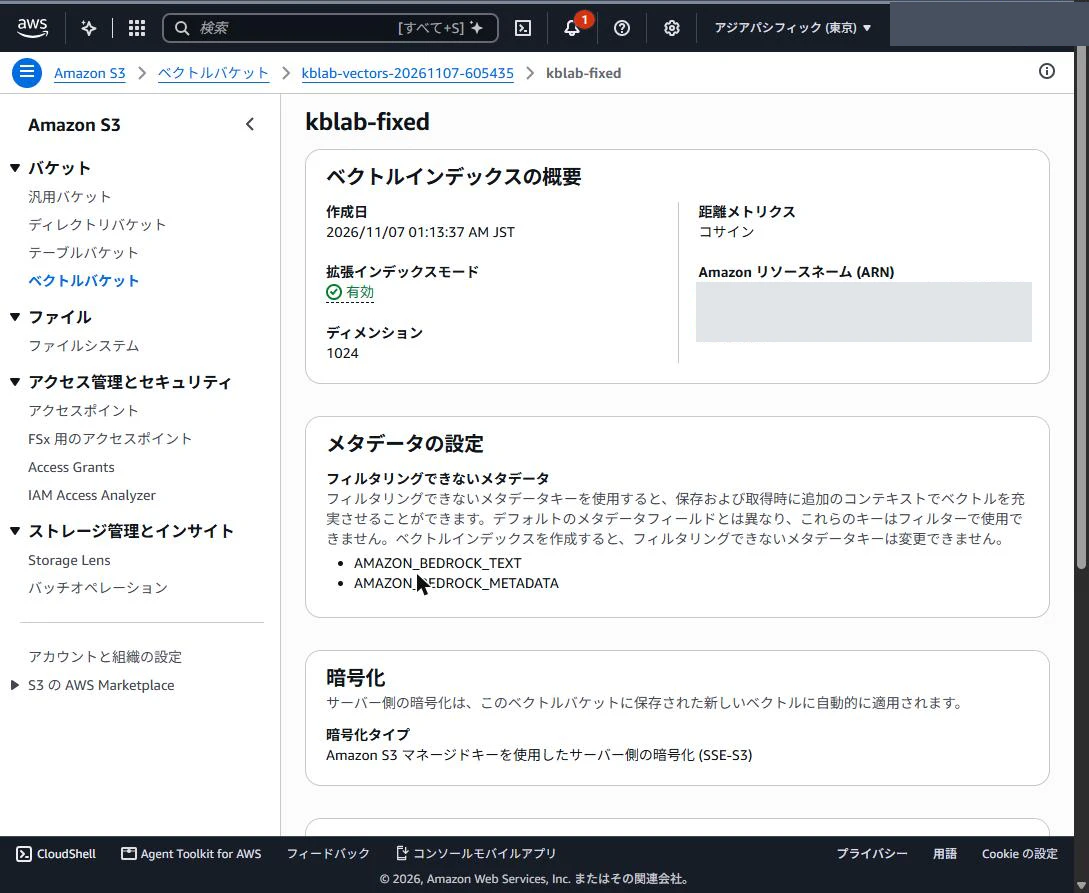
図5 で、1024 次元・コサイン距離と、絞り込めないメタデータの 2 つを確かめられる。
ナレッジベースは 4 つ作った。3 つは分け方だけが違い、残りの 1 つは固定長でメタデータを付けていない。一覧・概要・データソースの画面は以下の通り。
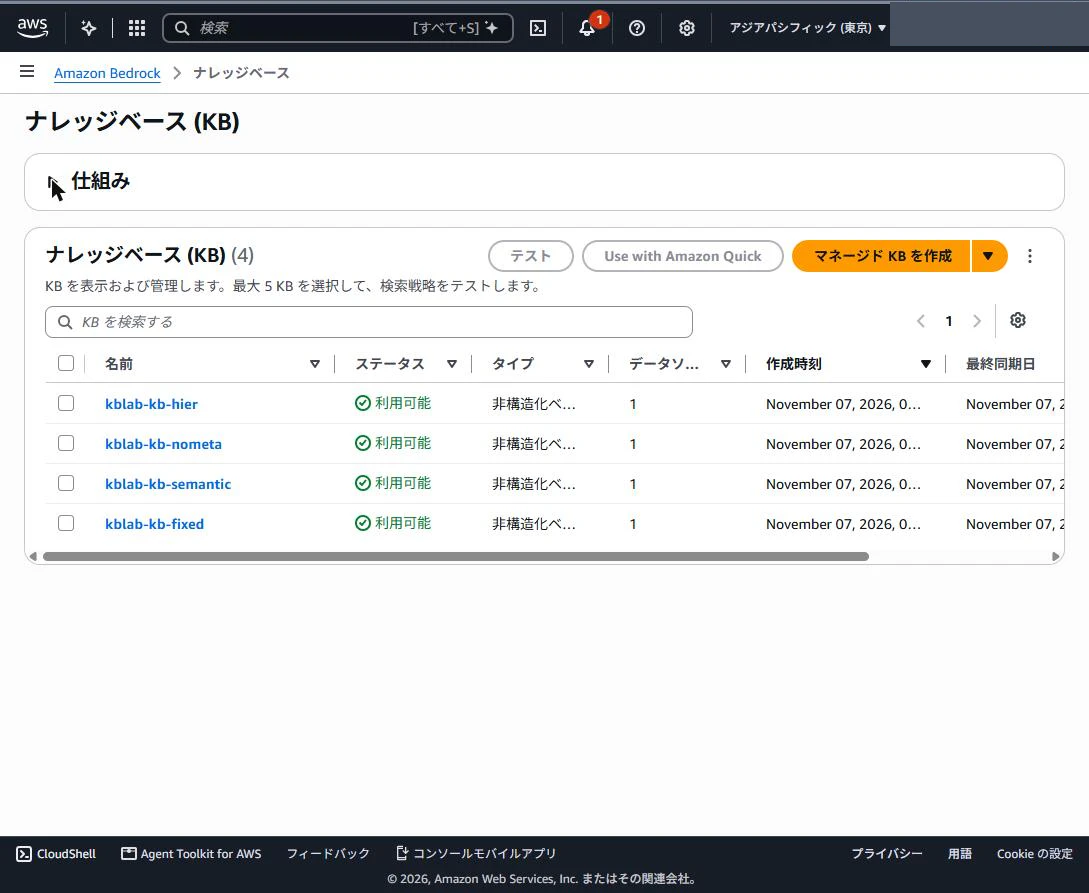
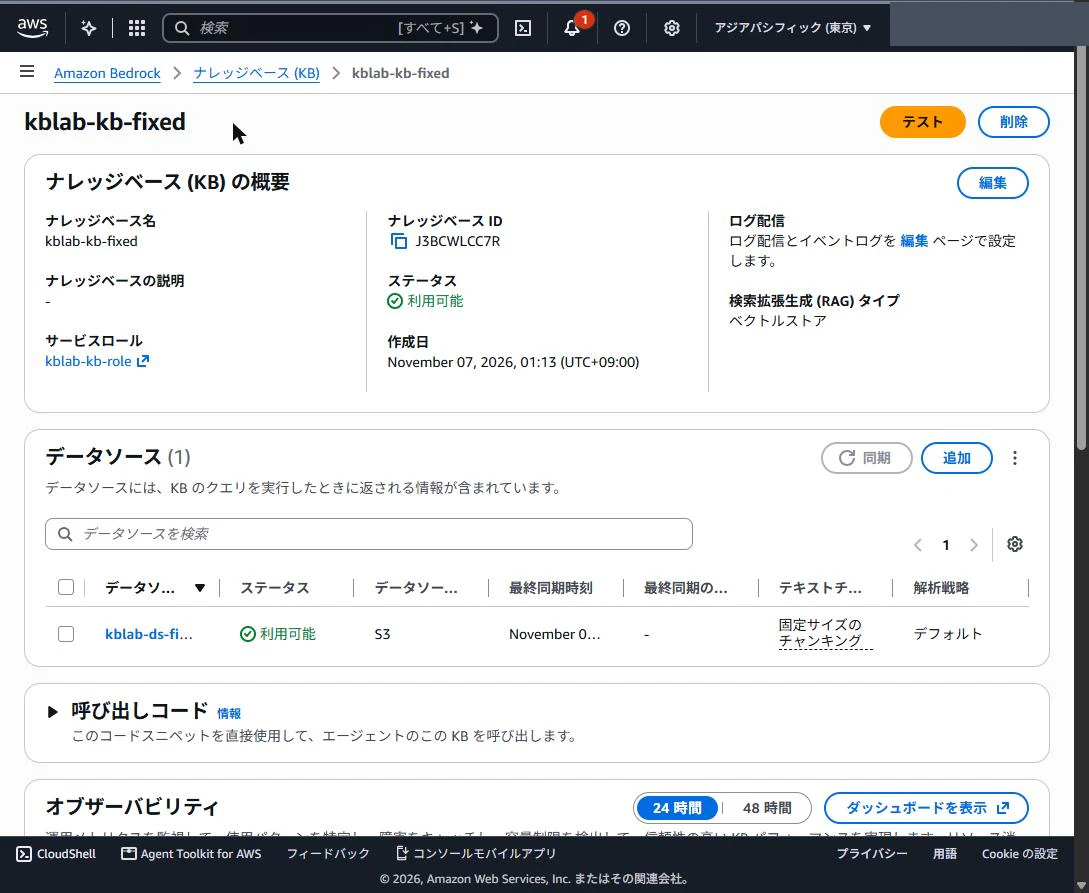
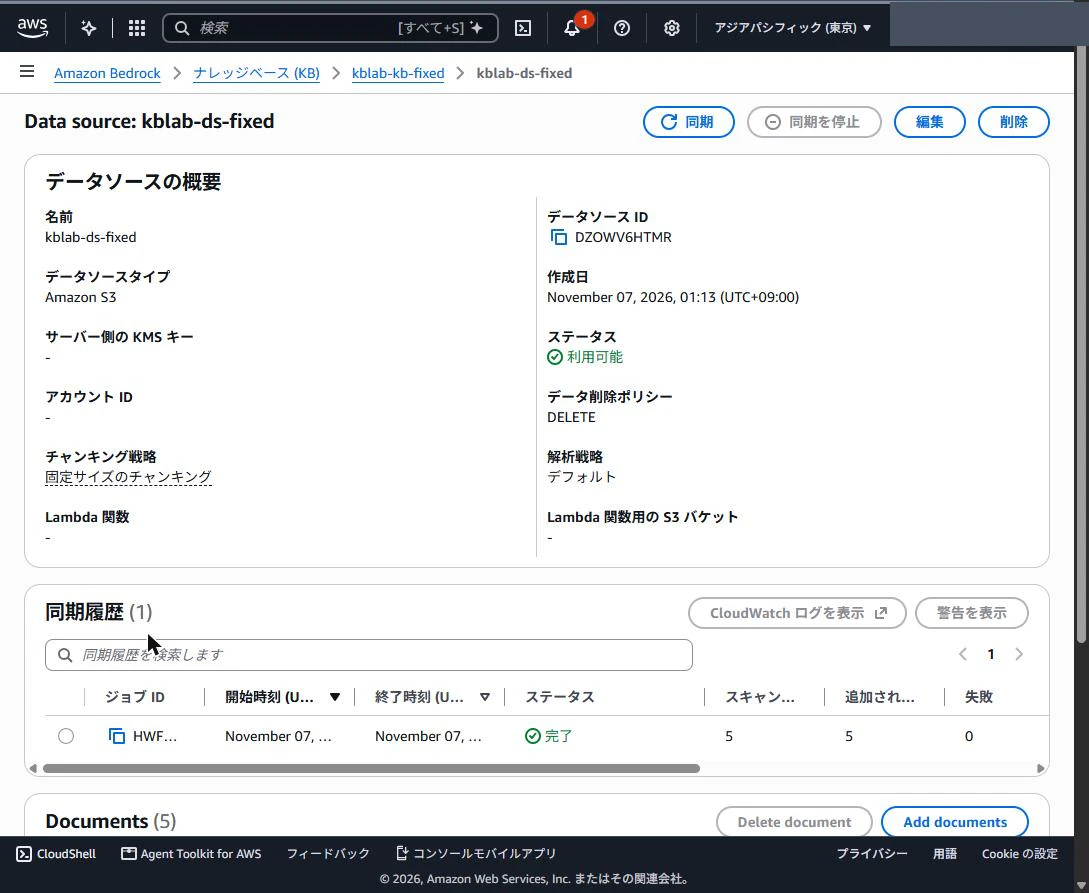
図8 の同期履歴は、取り込みの記録である。読み方は 6 章で書く。
問いは 9 つ。
| # | 問い | 正解 | 見たいこと |
|---|---|---|---|
| Q1 | 課長の出張の日当はいくらか | 3,000 円 | 表の中の 1 マスを取れるか。表のある文書は分け方とは別の動きをする(3.2 で書く) |
| Q2 | 経費精算の締め日はいつか | 現行は毎月 25 日(旧版は 20 日) | 版を指定しないとき、2 つの版が両方当たるか。現行を選べるか。年で絞ると変わるか |
| Q3 | 在宅勤務は何日前までに申請し、月に何日までか | 3 営業日前まで、1 か月に 8 日まで | 離れた 2 か所を両方取れるか |
| Q4 | パスワードは何文字以上か | 12 文字以上 | 長い条に埋もれた 1 文が上位に来るか |
| Q5 | 在宅勤務の上限と、経費精算の締め日を教えて | 1 か月に 8 日。締め日は現行が毎月 25 日 | 2 つのことを 1 文で聞く。締め日は版を指定しない。問いの分解で変わるか |
| Q6 | 社用車の使い方は | 文書に無い | 文書に無いことを聞く。「分からない」と答えるか |
| Q7 | 情報システム部の規程を全部挙げて | 情報セキュリティ規程 | 部署で絞ると変わるか |
| Q8 | 締め日が変わったのはいつからか | 2026 年 4 月 1 日に 20 日から 25 日へ | 2 つの版を合わせないと答えられない。版で絞ると答えられなくなるか |
| Q9 | 自家用車で出張したときのガソリン代はいくら出るか | 文書に無い | 近い語はあるが答えは文書に無い。作り話をしないか |
Q2 と Q5 は、問いの中で版を指定していない。正誤を見るのではなく、言われなくても現行の値を選べるかを見る問いである。
分け方は 3 通りで比べる。semantic は以下「意味」と書く。
- 固定長:300 トークン・重なり 20%
- 意味:最大 300 トークン・
bufferSize1・区切りの閾値 95 パーセンタイル。bufferSizeは、文を比べるときに前後の文をいくつ含めるかの値である。閾値は、隣り合う文のまとまりがどれくらい似ていなければ区切るかを決める値で、95 は AWS のブログの推奨値である - 階層:親 1,500・子 300・重なり 60 トークン。公式は S3 Vectors では勧めていない。トークン数が合わせて 8,000 を超えるような設定だと、メタデータの上限に当たることがあるためである(公式)。今回は費用を抑えるために S3 Vectors を選び、分け方の比較に階層も入れたかったので、親と子を小さめにして試した。5 つの規程は取り込めたが、長い文書でも同じとは言えない
コンソールでの見え方は以下の通り。データソースの「チャンキング戦略」の語を押すと、値が出る。
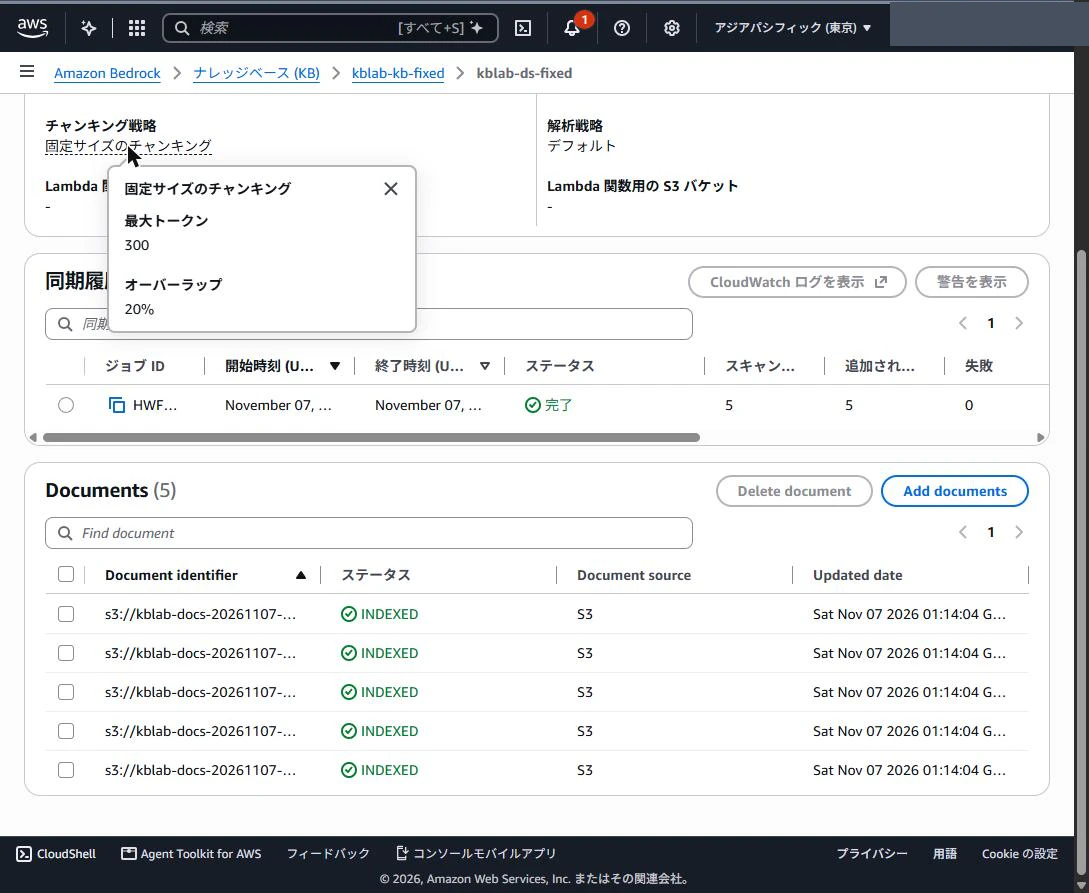
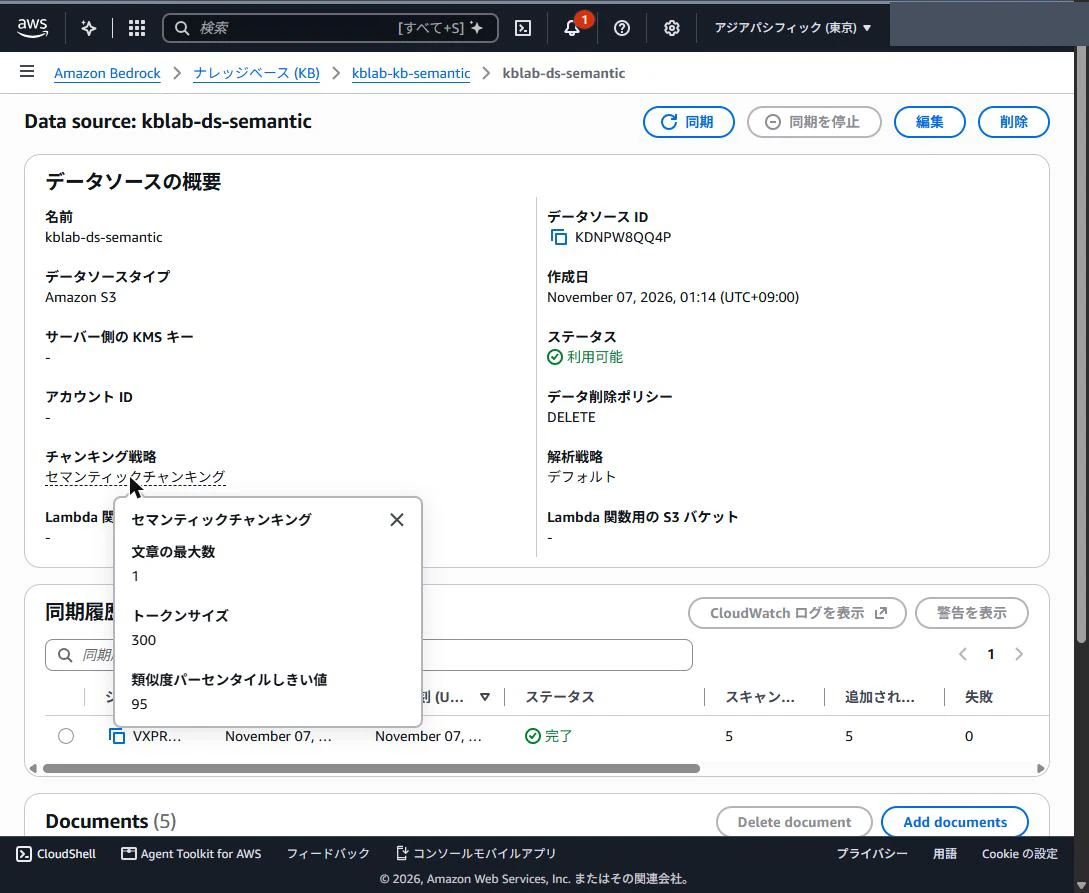
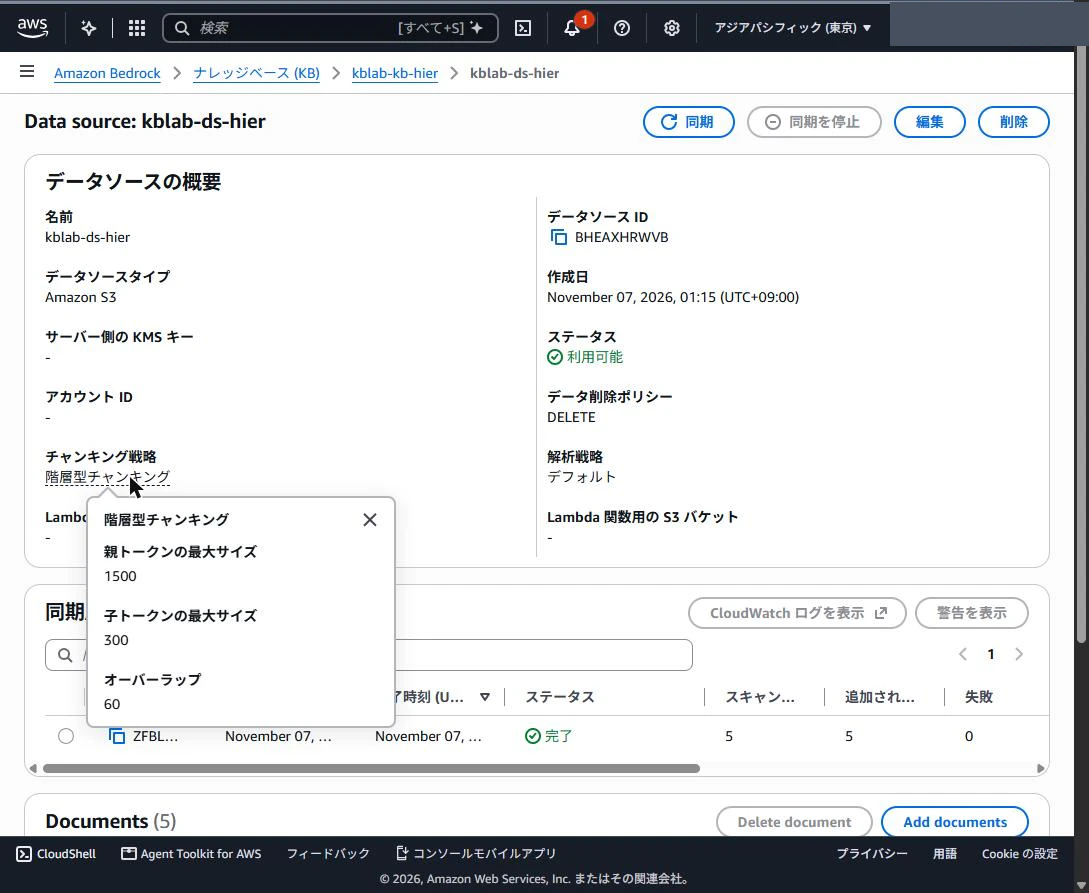
図9〜11 のとおり、固定長も意味も上限は 300 だが、実際のチャンクの長さは同じにならない。3 章に実測の字数を併記する。
3. チャンクの分け方で取り出しを比べる
3.1 何個に分かれたか
分け方で、チャンクの数と長さがどう変わるかを先に見た。字数は索引に入ったチャンクの本文で、階層は子のチャンクの値。取り込みの時間は 10 秒単位の目安である。
| 分け方 | チャンクの数 | 字数の最小 | 字数の中央値 | 字数の最大 | 取り込みの時間 |
|---|---|---|---|---|---|
| 固定長 | 33 個 | 56 字 | 235 字 | 294 字 | 10 秒 |
| 意味 | 31 個 | 33 字 | 235 字 | 288 字 | 20 秒 |
| 階層 | 35 個 | 56 字 | 235 字 | 293 字 | 10 秒 |
規程は条ごとに短いので、3 つとも中央値は同じ 235 字だった。意味の分け方の最小 33 字は、文の区切りで切り出された短いチャンクである。
3.2 根拠は何位に出たか
チャンクが違えば、問いに当たる順位も変わるはずである。Q1〜Q9 を Retrieve で上位 5 件まで取り、要る根拠の列の順に、返った結果の何位に入っていたかを書く。同じ数字が続くのは、1 件に複数の根拠が入っていたという意味である。スコアは分け方をまたいで比べていない。
| 問い | 要る根拠 | 固定長 | 意味 | 階層 |
|---|---|---|---|---|
| Q1 | 課長の日当 | 1 | 1 | 1 |
| Q2 | 2026 年版・2025 年版の締め日 | 2・3 | 1・2 | 2・3 |
| Q3 | 申請の期限・月の日数 | 1・5 | 1・4 | 1・1(同じ親チャンク) |
| Q4 | パスワードの文字数 | 1 | 1 | 1 |
| Q5 | 月の日数・現行の締め日 | 1・4 | 1・3 | 1・3 |
| Q7 | 情報セキュリティ規程 | 1 | 1 | 1 |
| Q8 | 旧版の締め日・現行の締め日・施行日 | 2・3・5 | 2・1・5 | 2・3・3 |
答えのある 7 問は、どの分け方でも根拠が上位 5 件にそろった。文書が 5 つと少ないので、取り逃すほどの競合が無かったとも言える。
Q4 の結果は以下。1 件目の末尾と 2 件目の末尾に同じ文があり、固定長の重なりが見える。
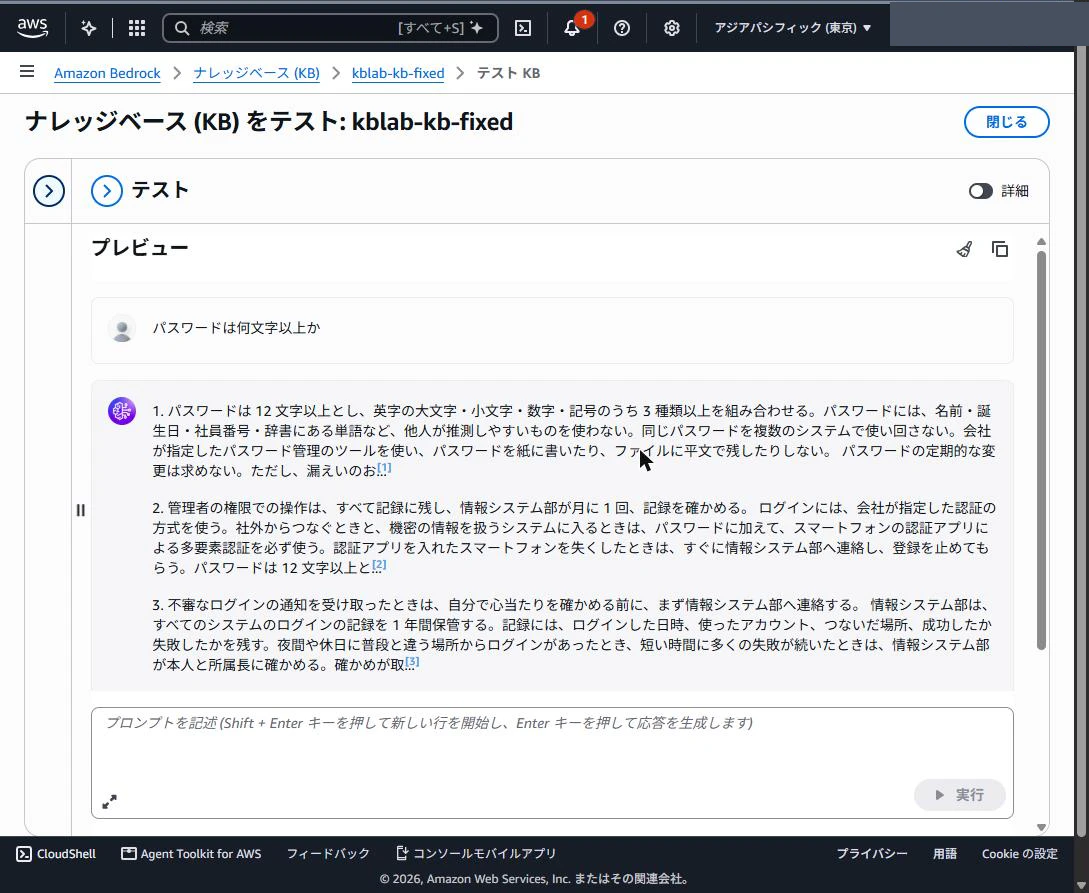
階層は返り方が違う。Q3 は頼んだ 5 件に対して 2 件で、1 件目は 1,291 字あった。子のチャンクで当て、親のチャンクに置き換えて返すためで、離れた第 4 条と第 9 条が 1 件に入った。
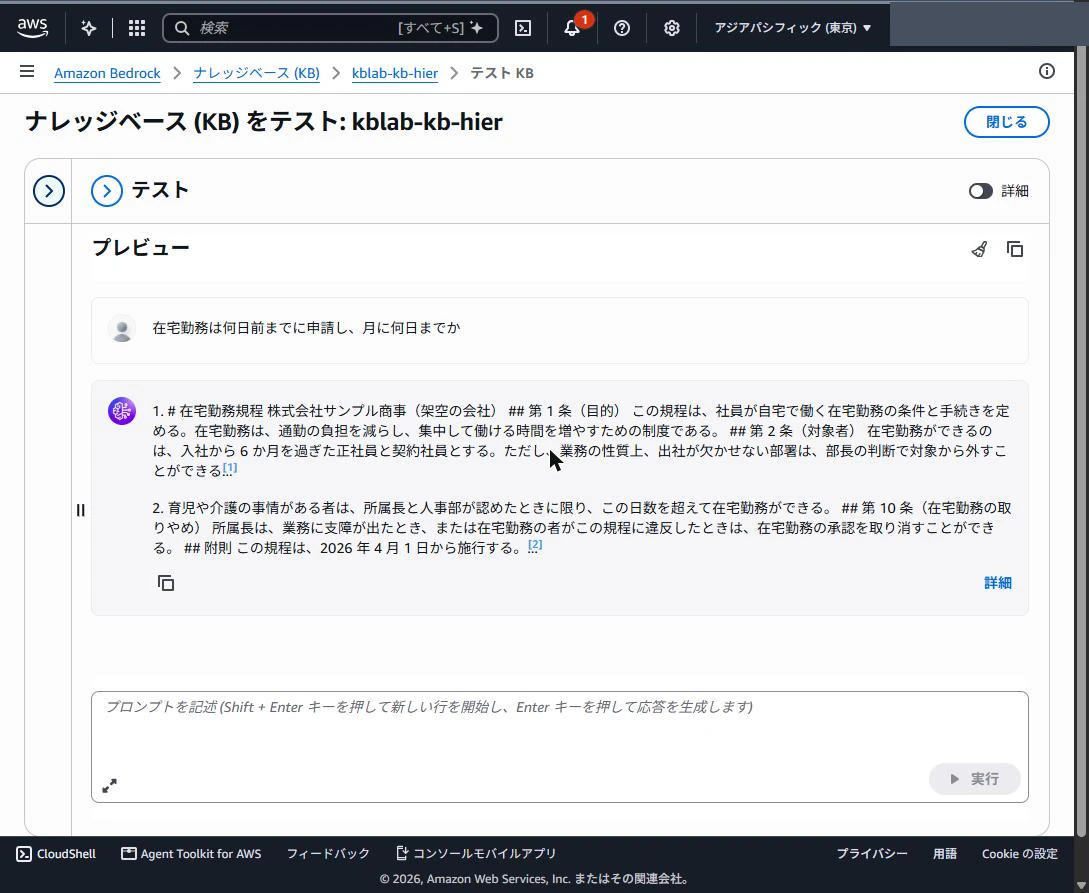
表の入った旅費規程は、分け方と別の動きをした。Q1 は 3 つとも 1 件だけが返り、本文は 1,084 字で規程のほぼ全文だった。1,084 字は検索で返った本文の長さで、索引のチャンクの長さではない。公式によると、Markdown の表があると、当たったチャンクが表全体やページ全体の文脈に置き換わり、同じ文脈のチャンクは 1 件にまとまる(公式)。今回の Q1 もこの動きに見えるので、分け方の優劣の材料にしない。
Q2 でも、固定長と階層の 1 位はこの旅費規程だった。締め日の問いなので本来は外れで、問いとの近さを表すスコアは 0.91 だった。このスコアは同じ検索の中で順位を決める値で、高くても答えが入っているとは限らない。外れが 1 位になった原因は確認できていない。
3.3 検索の種類を指定する
S3 Vectors はハイブリッド検索に対応しない。明示したときにどうなるかを見るため、Q1 を指定なし・SEMANTIC・HYBRID で投げた。指定なしと SEMANTIC は同じ結果で、HYBRID はどの分け方でもエラーになった。
ValidationException: HYBRID search type is not supported for search operation on index <ナレッジベースの ID>.
注意:HYBRID の明示はエラーになる
公式の文書は、対応しない置き場では「セマンティック検索になる」と書く(公式)。これは指定しないときの話で、HYBRID を明示すると止まる。
コンソールでは切り替えが無効になっていて、S3 ベクトルバケットはハイブリッド検索に対応しないと表示される。
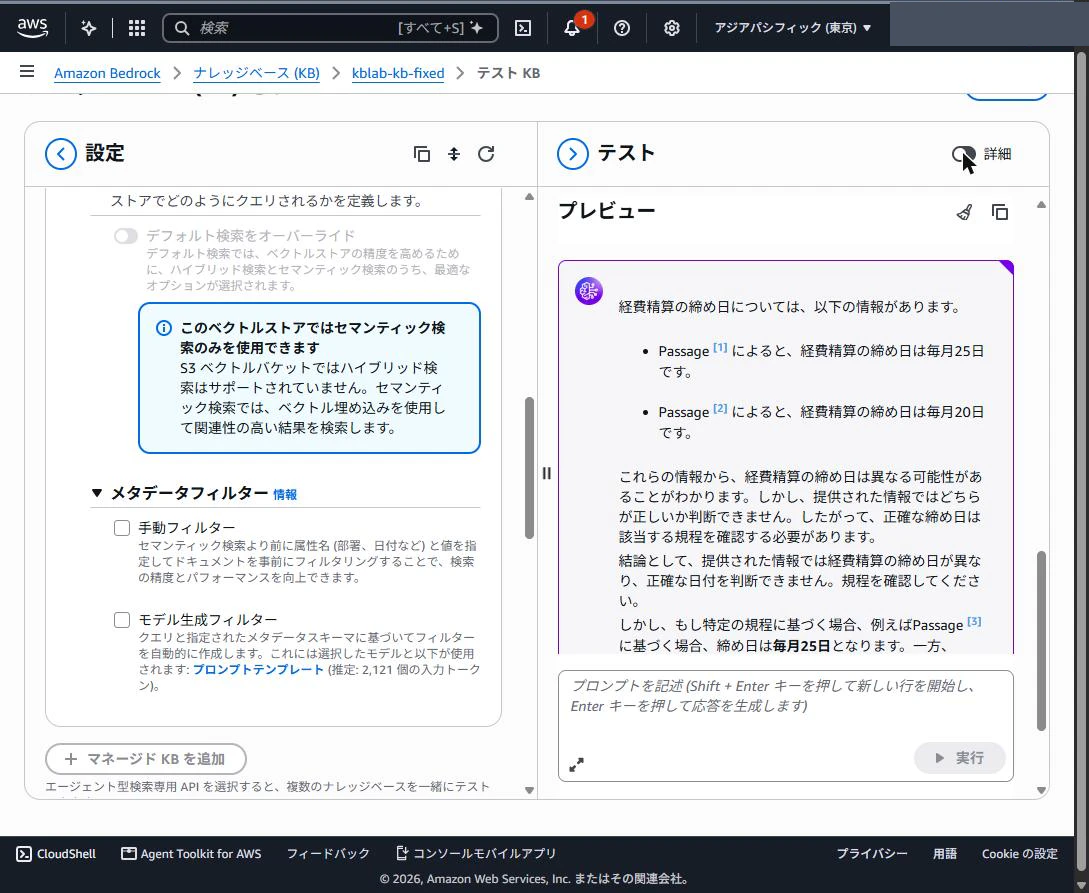
同じ画面のメタデータのフィルターは、4 章で使う。
3.4 再ランクを掛ける
再ランクは、検索で返った候補を、別のモデルで問いに近い順に並べ直す機能である。長い条に埋もれた文が、並べ替えで上がるかを見た。Q4 の上位 10 件を、前後の件数をそろえて Amazon Rerank 1.0 で並べ替えた。S3 Vectors のナレッジベースでも動いた。
ただ、ここは狙いどおりにならなかった。パスワードの文は再ランクの前から 3 つとも 1 位で、順位の改善は測れていない。再ランク後のスコアは固定長で 1 位が 0.81、2 位が 0.33、3 位以下が 0 だった。これは再ランクのモデルの値で、ベクトル検索のスコアとは別の物差しである。何件残すかの判断には、別の検証が要る。
Retrieve で再ランクを使うと、サービスロール(Knowledge Bases が AWS の操作に使う IAM ロール)に bedrock:Rerank と再ランクのモデルの bedrock:InvokeModel が要る(公式)。コンソールでは、テストの設定の欄で再ランクのモデルを選ぶ。
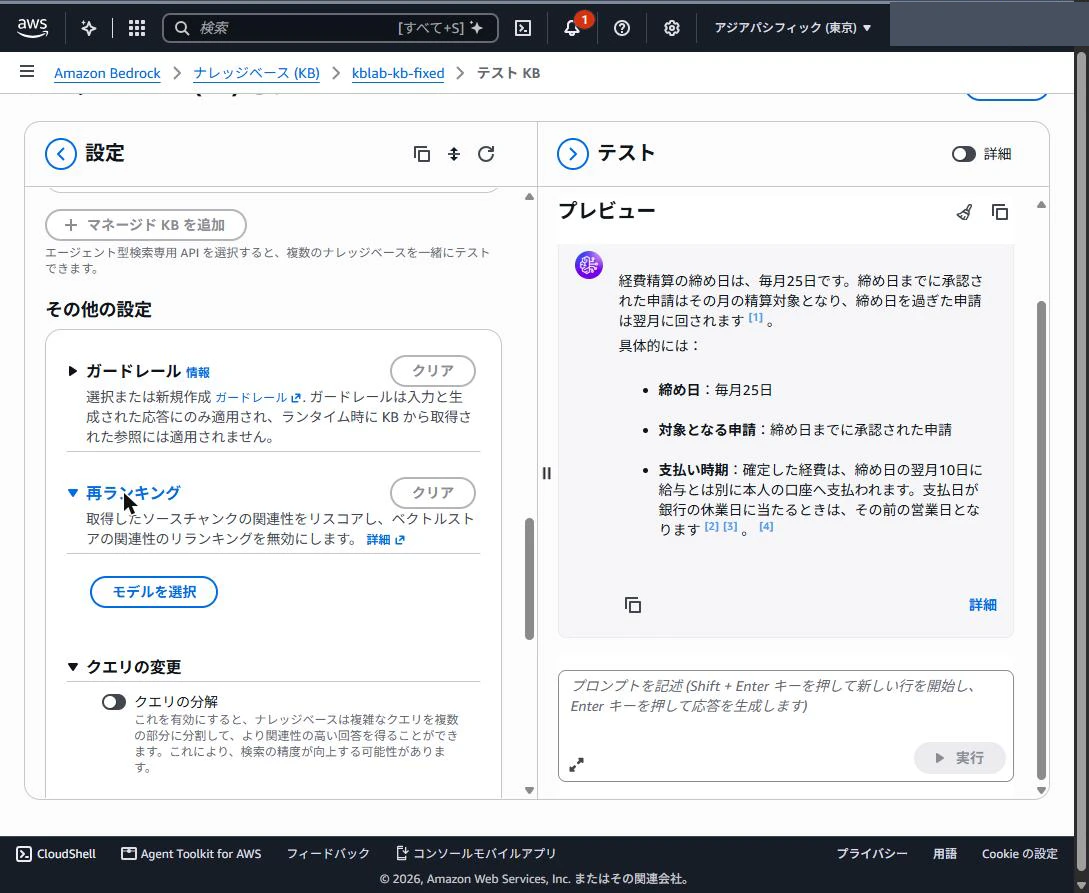
同じ欄に、5 章で使う問いの分解もある。
4. メタデータで絞る
本文がほとんど同じ 2 つの版は、近さの検索では分けにくい。絞り込みでどこまで分けられるかを見た。取り出したチャンクの詳細を開くと、.metadata.json で付けた値が見える。
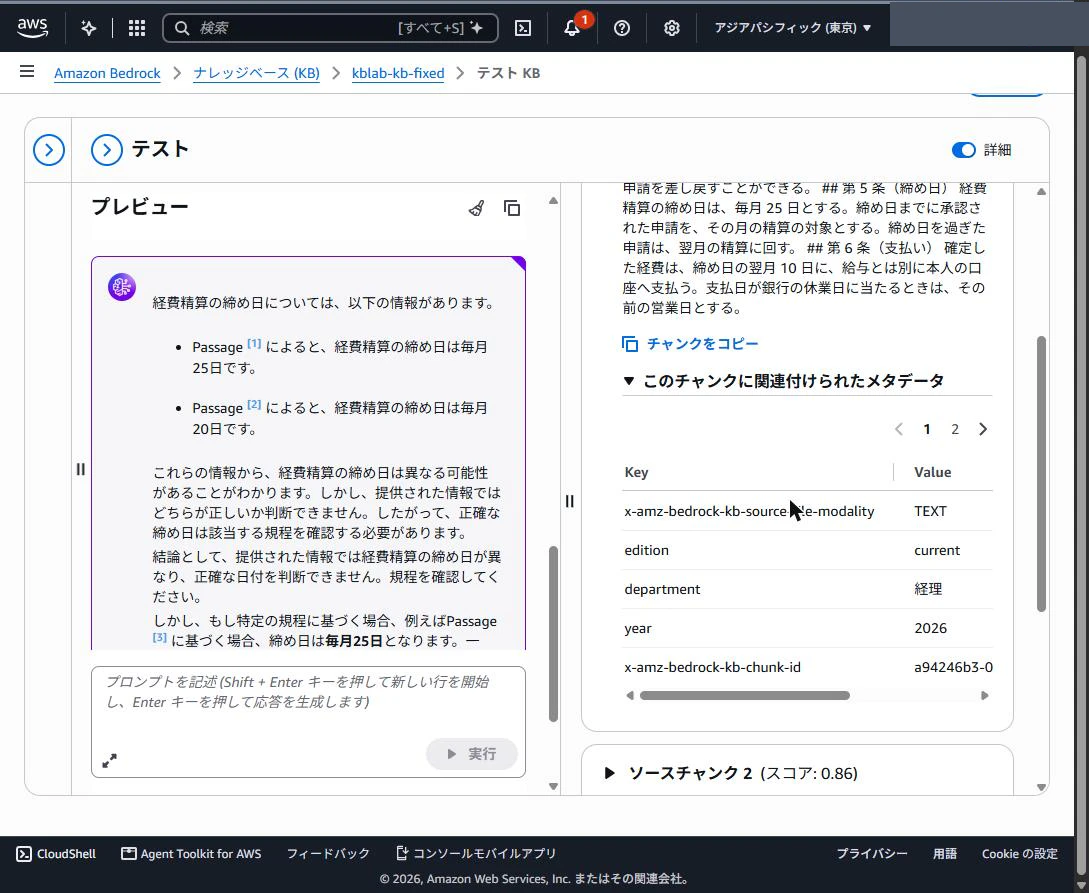
分け方は固定長で、3 つの問いの Retrieve の上位 5 件を、絞る前後で比べた。
| 問い | 絞る条件 | 絞る前 | 絞った後 |
|---|---|---|---|
| Q2 | year = 2026 |
2025 年版と 2026 年版が両方入る | 2025 年版が消え、5 件は 2026 年の規程だけ |
| Q7 | department = 情報システム |
5 件すべて情報セキュリティ規程 | 変わらない |
| Q8 | edition = current |
両方の版が入る | 旧版が消え、5 件はほかの現行の規程で埋まる |
同じ条件で RetrieveAndGenerate に答えも作らせた。Q2 は、絞ると答えが「毎月 25 日」に定まった。コンソールのテストでは、手動フィルターに year = 2026 と書くだけで試せる。
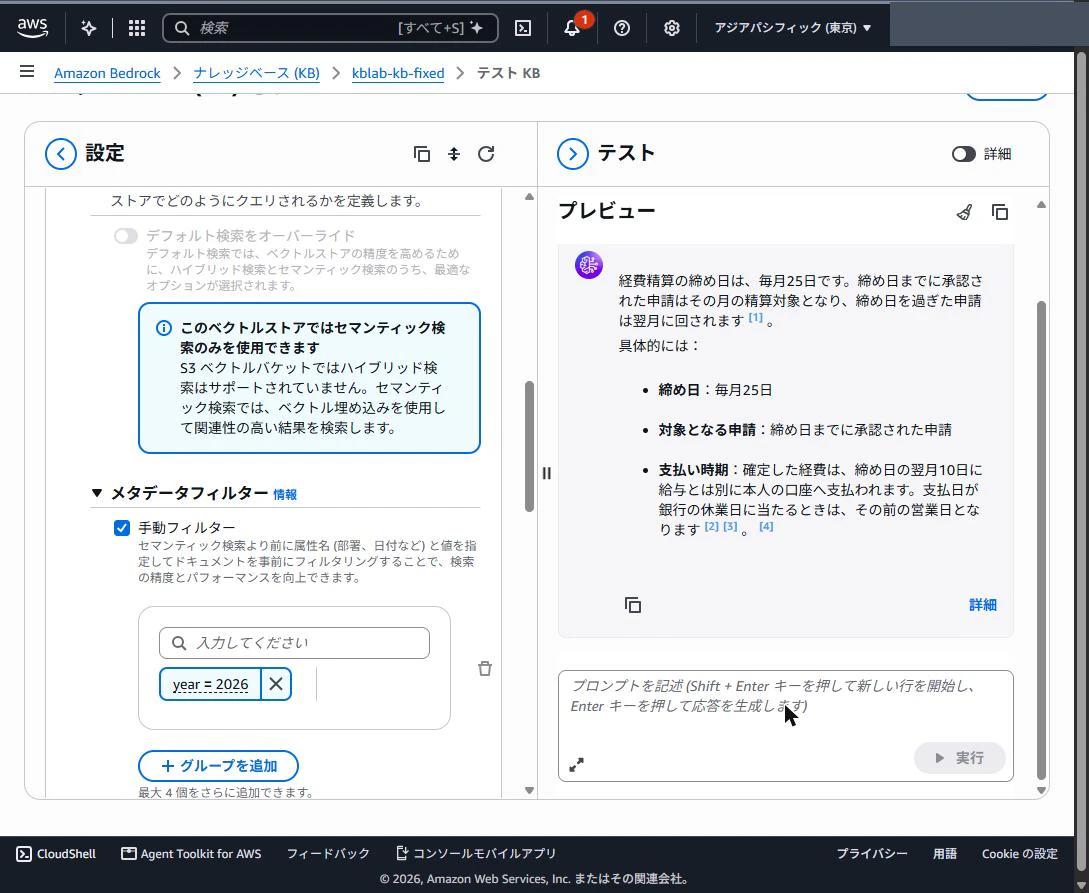
Q7 は、5 つの規程のうち該当が 1 つという今回の条件での話で、検索が規程の一覧を保証するわけではない。
Q8 は絞りすぎの例になった。旧版が消えるので、答えは「2026 年 4 月 1 日から毎月 25 日」となり、変更前の 20 日を言えなくなった。変わった事実を聞く問いに、現行だけで絞ってはいけない。
メタデータを付けないとき
同じ文書を .metadata.json なしで入れたナレッジベースでも、Q2・Q7・Q8 を比べた。
- 取り込み:走査したメタデータの数が 5 から 0 になる。ほかの数は同じ
- 絞らないとき:3 問とも、メタデータありのナレッジベースと本文まで同じ結果が返った。メタデータを埋め込みに含めていないため
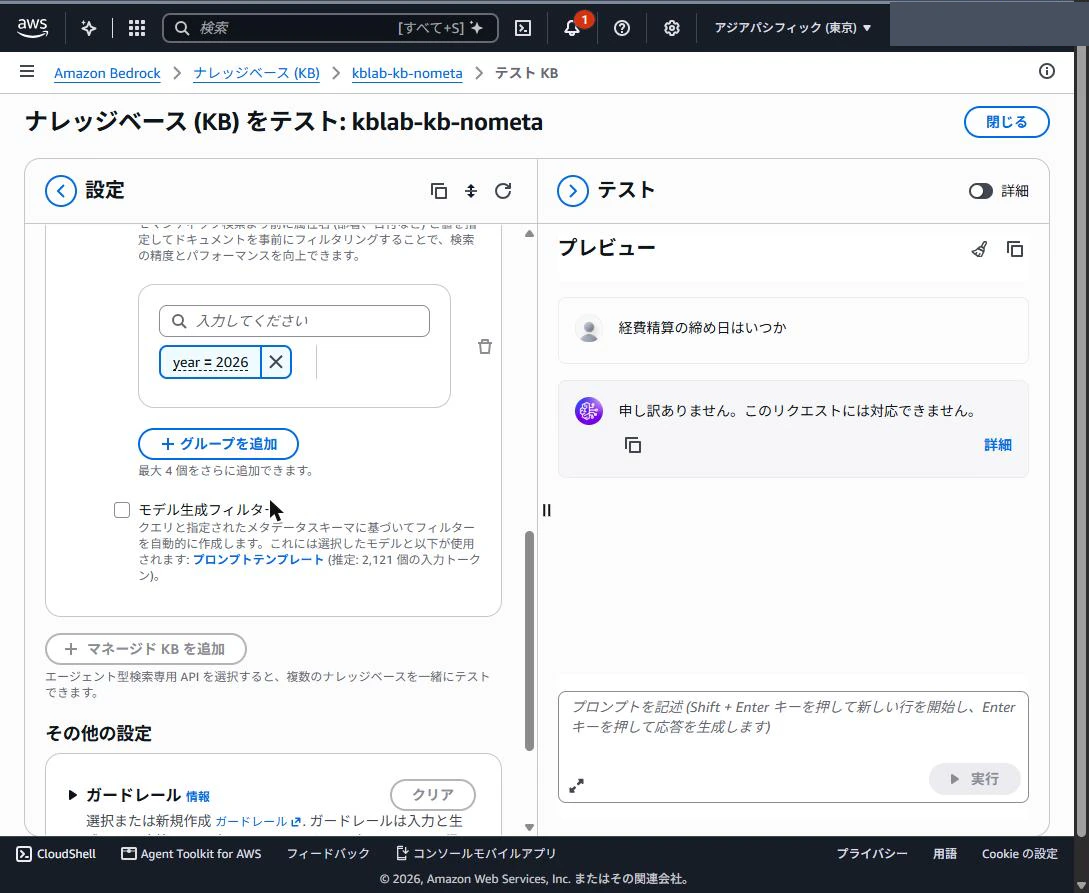
- 同じ条件で絞ったとき:3 問とも検索結果の全体が 0 件。エラーにはならない
0 件のとき、コンソールのテストでは定型の文が返る。
注意:0 件でもエラーにならない
絞り込みの指定が誤っていても、エラーとして出ない。答えが返らないときは、文書に .metadata.json が付いているかを見る。
絞らずに Q2 の答えを作らせると、「25 日または 20 日」と両方を挙げた。どちらが現行かを、メタデータでは判断できない。
5. 答えを生成する
RetrieveAndGenerate で、固定長・意味・階層に同じ条件で問いを投げた。モデルは Nova 2 Lite の jp. の推論プロファイル、上位 5 件、temperature 0(答えのばらつきを決める値で、0 が最も小さい)、最大 512 トークン。
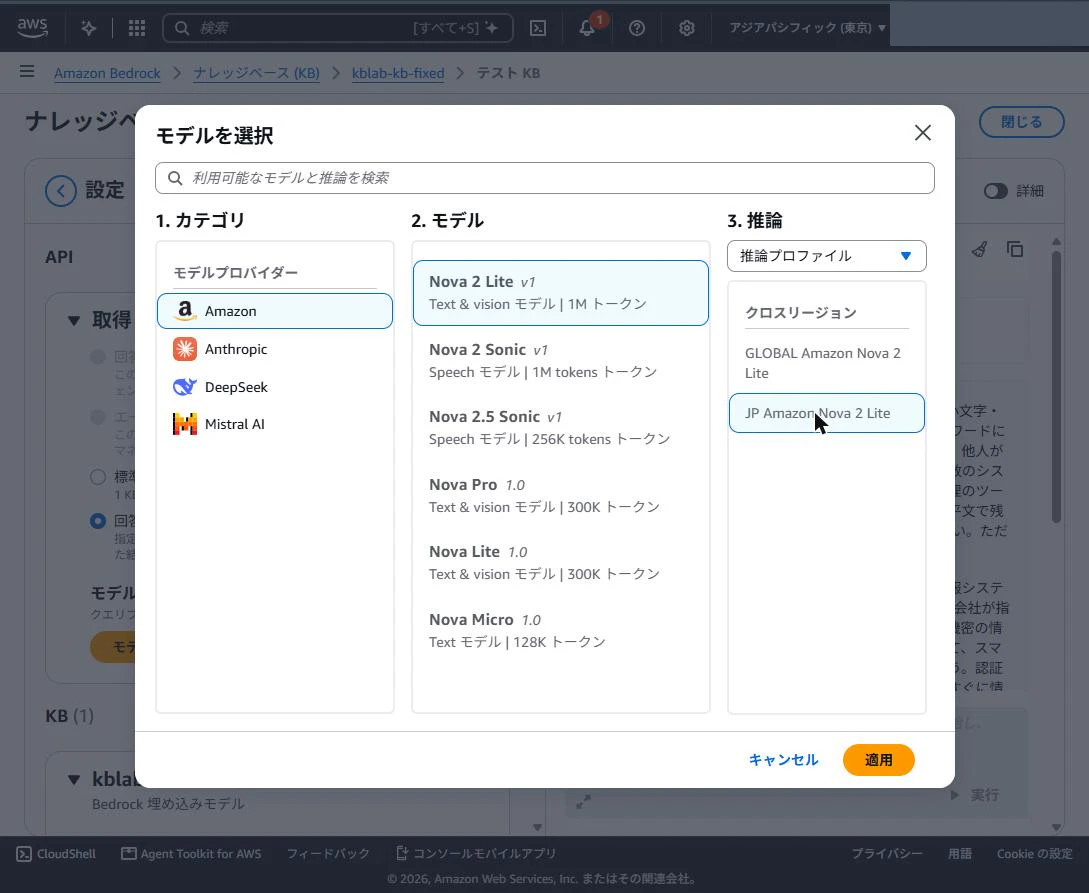
Q1〜Q6・Q9 は、3 つの分け方に 1 回ずつ投げた。そのうち Q1・Q5・Q6・Q9 は分け方で答えが違ったので、2 回足して 3 回にした。Q8 は、3 つの分け方に 2 回ずつ投げた。固定長は 4 章の 1 回を足して 3 回、意味と階層は 2 回で、回数はそろっていない。優劣ではなく、この回数での観察である。
結果は以下で、数字は回数を表す。Q1 だけは 1・2・3 回目の値を書いた。Q5 は版を指定していないので、25 日と 20 日を並べた答えは誤りとは言えない。ここで見ているのは、現行の値を選べたかである。Q5 のもう 1 つの問いである在宅勤務の上限は、全部の回で 8 日と答えた。
| 問い | 固定長 | 意味 | 階層 |
|---|---|---|---|
| Q1 日当(正解 3,000 円) | 3,000・3,000・3,500 | 3,500・3,000・3,500 | 3,000・3,000・3,000 |
| Q5 締め日(現行は 25 日) | 20 日と結論 1・25 日と 20 日を並べた答え 2 | 並べた答え 2・25 日 1 | 25 日 3 |
| Q6 社用車(文書に無い) | 無いと答えた 2・一般論を書いた 1 | 一般論 2・無いと答えた 1 | 無いと答えた 3 |
| Q8 変わった時期(2026-04-01 に 20 日から 25 日) | 前後を取り違えた 2・正しい 1 | 特定できないと答えた 1・値の前後を言わなかった 1 | 正しい 2 |
| Q9 ガソリン代(文書に無い) | 無いと答えた 2・対象になると踏み込んだ 1 | 無いと答えた 3 | 無いと答えた 2・実費で精算されると踏み込んだ 1 |
Q1 は、3 つとも同じ規程の全文を渡している。それでも同じ分け方で値が割れたので、これは分け方の差ではなく生成の揺らぎである。3,500 円は部長の行の値で、表の隣の行を読んでいた。答えの言語も、Q1 は 9 回すべて中国語だった。
Q5 の締め日は、分け方で答えが違った。固定長と意味のチャンクは条の本文だけで、どちらの版かが本文に無い。階層の親チャンクには「経費精算規程(2026 年版)」の見出しと施行日が入る。Q2 は 1 回ずつだが、階層だけが 2026 年版の 25 日と答えた。Q8 も階層は 2 回とも正しく、言語は英語だった。どれも少ない回数の観察で、見出しと施行日が効いたというのは、返ったチャンクの中身からの推測である。
固定長の Q2 の答えは以下。検索結果を指す Passage の語がそのまま出ていて、規程が 2 つあるとだけ答えている。
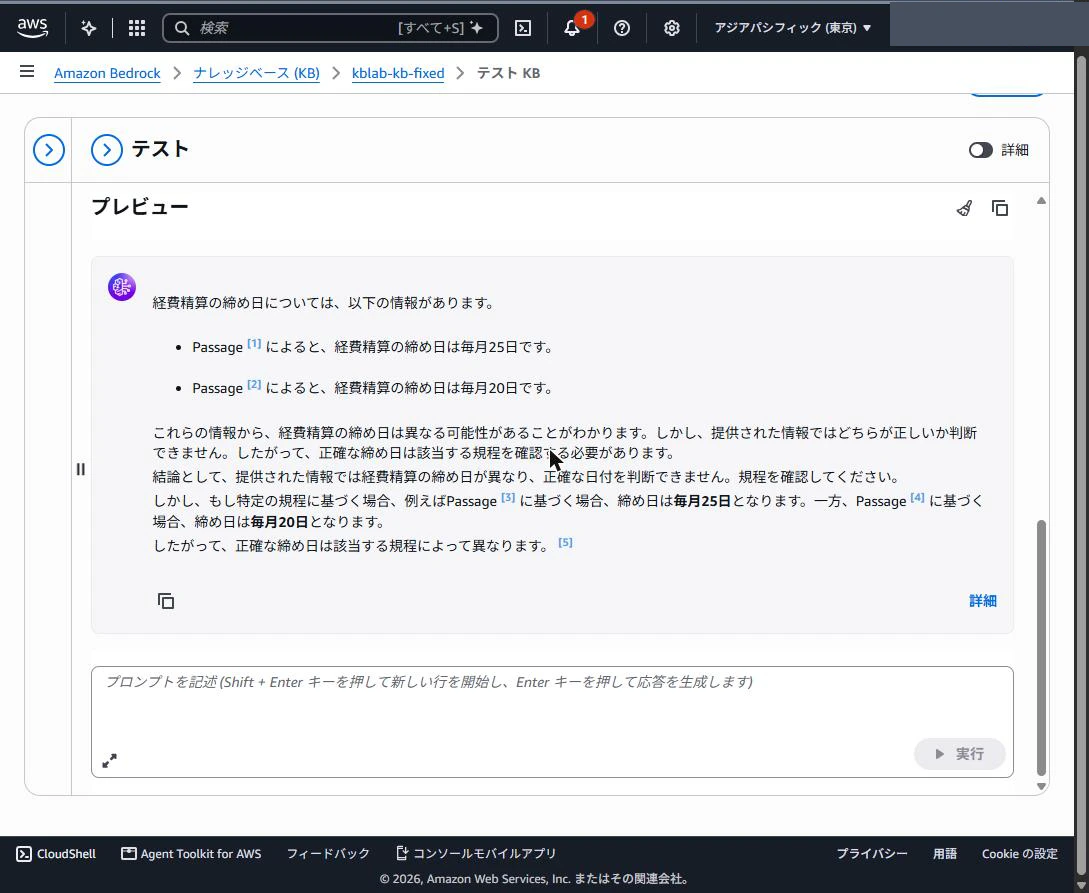
答えの右の詳細で、引用したチャンクを開ける。条の本文だけで、どの版かが分からないことが画面でも見える。
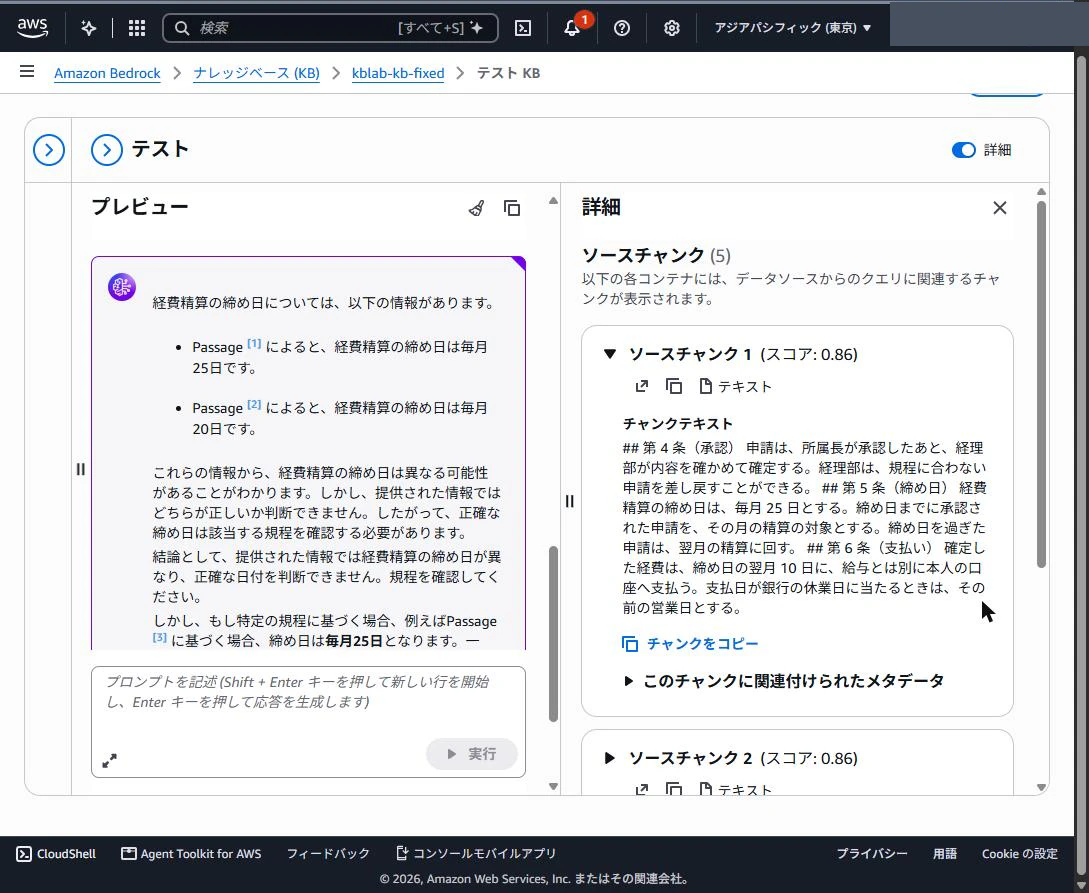
Q6 は引用の扱いにも注意が要る。意味の答えの一般論は、社用車の記述が無い旅費規程を引用元に示していた。引用があることと、答えが文書に書いてあることは別である。
問いの分解
問いの分解は、いくつものことを聞く問いを小さな問いに分けて検索する機能である(公式)。Q5 に QUERY_DECOMPOSITION を付けると、3 つとも「1 か月に 8 日」と「毎月 25 日」を答えた(1 回ずつ)。2 つのことを 1 文で聞く問いでは効果が見えた。
プロンプトを変える
generationConfiguration(答えの作り方の設定)に、言語と答え方を指定するプロンプトのテンプレートを渡した。6 章で文書を書き換えたあとの固定長に、Q1・Q2・Q6・Q8・Q9 を 2 回ずつ投げている。文書が変わったあとの追加の観察で、既定のプロンプトとの厳密な比較ではない。
$ で囲んだ語は、実行時に置き換わる目印である。$search_results$ には検索結果が、$output_format_instructions$ には答えの形式と引用の指示が入る。$output_format_instructions$ を消すと、答えに引用が付かない(公式)。
あなたは社内規程の質問に答える係です。次の検索結果だけを根拠に、必ず日本語で答えてください。
規程の版が複数あるときは、施行日の新しい版を現行として答えてください。
検索結果に答えが無いときは、推測せず「規程に記載がありません」とだけ答えてください。

$search_results$

$output_format_instructions$
Q1 は 2 回とも日本語で 3,000 円になり、Q2 は書き換えた「毎月末日」を答え、Q6 と Q9 は 2 回とも記載が無いと答えた。一方で Q8 は、2026 年版を 20 日、2025 年版を末日と答え、版の前後を取り違えたままだった。言語と答え方は抑えられるが、文書の読み取りの誤りまでは直らない。
6. 文書を直して取り込み直す
規程は改定される。文書を直したときの追いつき方を見るため、2026 年版の締め日を「毎月末日」に書き換えて S3 に上げ直し、固定長のデータソースだけ同期した。
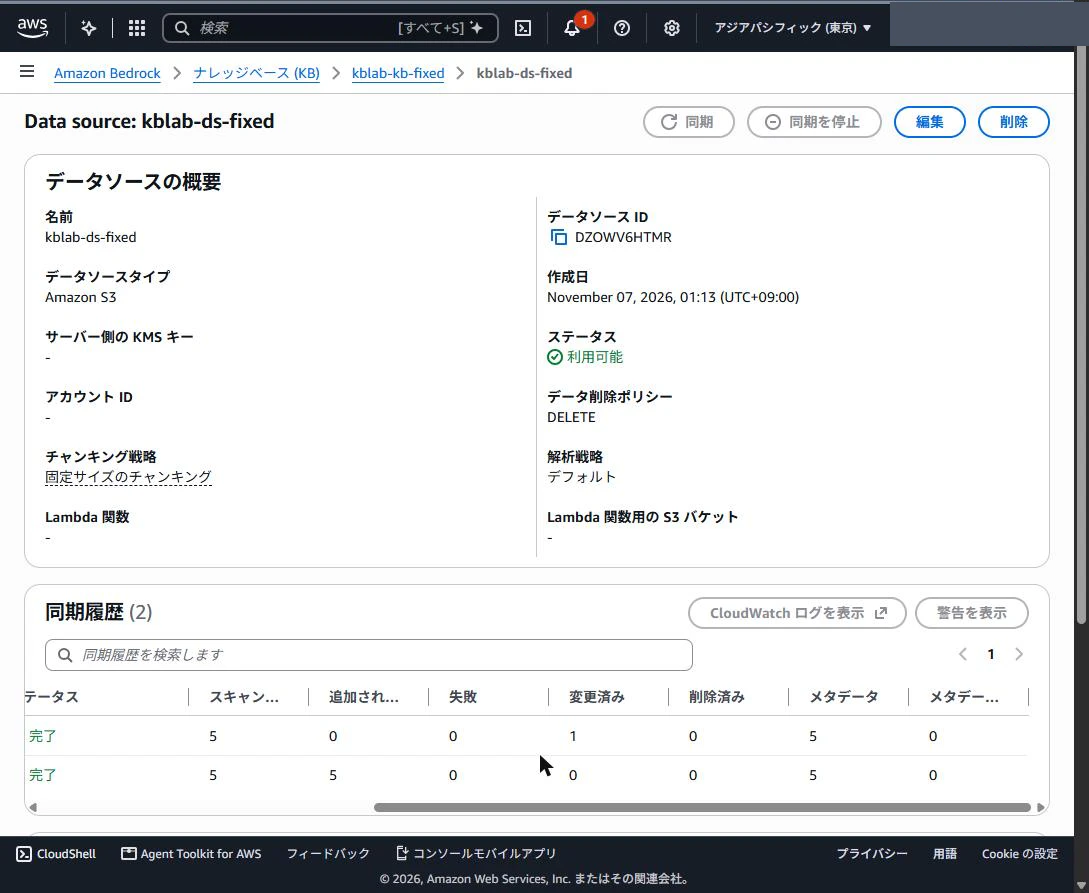
取り込みの統計では、初回は読んだ文書(走査)が 5・追加が 5 で、書き換えのあとは走査 5・追加 0・変更 1 だった。走査は 5 つとも行い、入れ直したのは変わった 1 つだけである。時間はどちらも 10 秒で、文書が少ないので差は見えていない。
Q2 を投げ直すと、固定長は「毎月末日」のチャンクを返した。同じバケットを見ている別のナレッジベースでも、同期していない意味のナレッジベースは 25 日のままだった。文書を直しただけでは検索の結果は変わらず、データソースごとの同期が要る。
データソースの詳細では、文書ごとの状態も見られる。
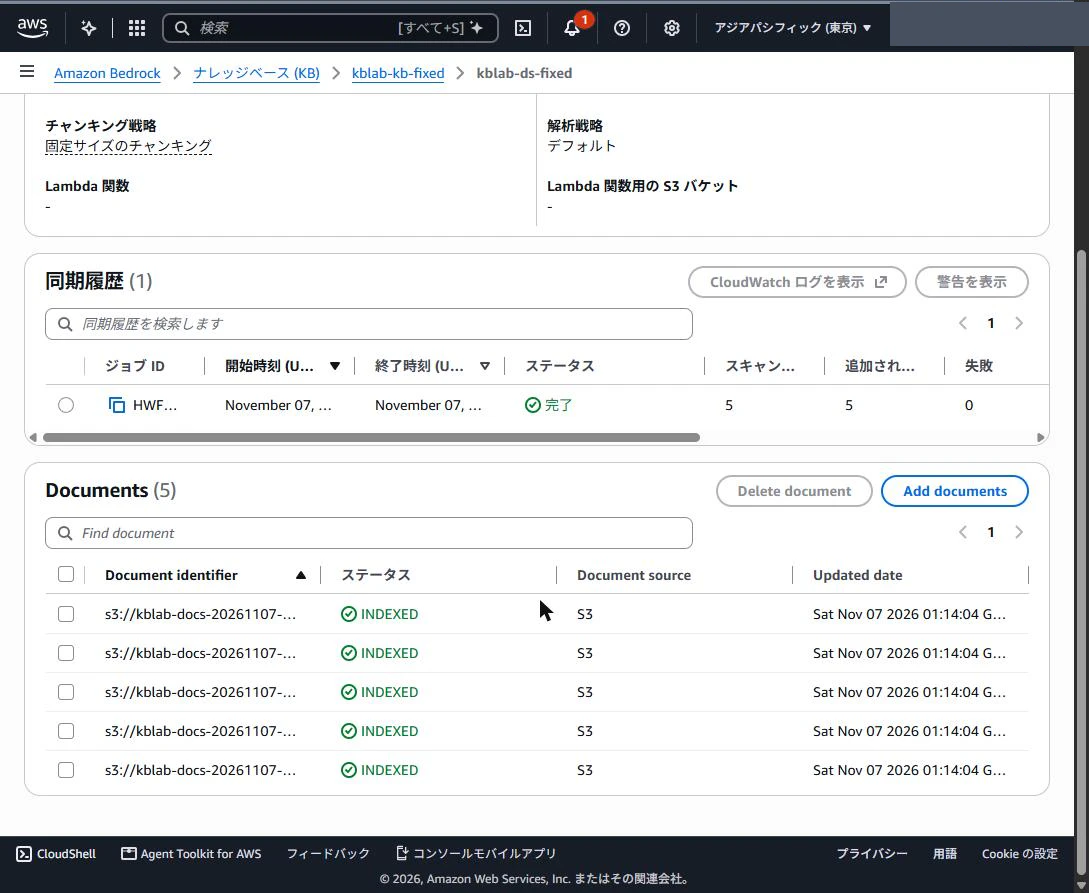
どの文書が取り込まれたかを、1 つずつ確かめられる。
7. 試験の論点
要件ごとの選び方に直すと、以下のようになる。
| 要件 | 選ぶもの | 今回の根拠 |
|---|---|---|
| 使っていない間の料金を抑えたい | S3 Vectors | 保存量と要求の量に応じた課金で、常に動くサーバーの料金が無い。実額の比較はしていない |
| キーワードも合わせて検索したい | OpenSearch Serverless など | S3 Vectors では HYBRID が止まる |
| 離れた条や、見出しの文脈まで渡したい | 階層 | 親チャンクで返る。件数は減る。公式は S3 Vectors では勧めていない |
| 改定で旧版が残る文書から現行だけ答えたい | メタデータで絞る | 年で絞ると 25 日に定まった |
| 変わった事実を聞く | 旧版と現行版を両方含む条件にする | 現行版だけに絞ると旧版が消える |
| 答えの言語や「無いときの答え方」を決めたい | プロンプトのテンプレート | 5 問を 2 回ずつの範囲で、言語と記載が無いときの答え方がそろった |
どの分け方が一般に良いかまでは、今回の結果では言えない。5 つの規程ではどれも根拠が取れたので、文書が増えて根拠を取り逃す場面は試せていない。
最後に
5 つの規程の規模では、根拠はどの分け方でも取れた。今回の範囲では、階層の親チャンクに見出しと施行日が入り、現行の締め日を答えられた。
見落としやすい動きが 2 つある。メタデータなしで絞ると 0 件でもエラーにならない。S3 Vectors で HYBRID を明示すると止まる。